AI Code Review für kleine Teams: Tools, Kosten und Grenzen 2026
Sechs Code-Review-Tools im Vergleich: Kosten für fünf Entwickler, Fehlalarme, GitHub und GitLab sowie Datenaufbewahrung bei Bots und Coding-Agenten.



Für AI Code Review in kleinen Teams ist CodeRabbit Essentials ein guter Einstieg: $150 pro Monat für fünf Entwickler. Wer bereits Codex oder Claude Code abonniert hat, kann diese zunächst für eine Prüfung vor dem Öffnen eines PR nutzen. Greptile, Cursor Bugbot und der verwaltete Review-Dienst von Claude kommen infrage, wenn Arbeitsablauf und nutzungsabhängige Kosten passen. Codex Security erfüllt eine eigene Aufgabe bei der Sicherheitsprüfung.
Preise und Tarifnamen wurden am 2. Oktober 2026 anhand der Anbieterwebsites geprüft. Die folgenden Budgets beziehen sich auf fünf aktive menschliche Entwickler, Preise in US-Dollar vor Steuern, ohne Aktionsrabatte und mit monatlicher Abrechnung. Auf monatliche Vergleichswerte bei Jahreszahlung wird ausdrücklich hingewiesen. Die Nutzungsbeispiele gehen von 100 abgeschlossenen Review-Durchläufen pro Monat aus, gleichmäßig auf die Entwickler verteilt. Das sind Annahmen für die Budgetplanung, kein behaupteter Branchendurchschnitt.
AI Code Review für kleine Teams: Die Tools im Überblick
CodeRabbit ist die naheliegende Wahl als kostenpflichtiger PR-Bot, wenn ein kleines Team seine bestehenden Pull Requests verlässlich prüfen lassen möchte. Ein vorhandenes Coding-Agent-Abonnement ist der bessere erste Ansatz, wenn das Team Reviews vor dem Push zuverlässig selbst anstößt. Dieser Unterschied ist für die Auswahl wichtiger als die Platzierung eines Anbieters in einem Benchmark.
Der Abopreis deckt den Zugang oder ein Kontingent ab. Er umfasst nicht zwangsläufig jeden Review-Durchlauf, den ein Team auslösen kann. Wird ein PR beim Öffnen, nach einer Korrektur und nach einem Rebase geprüft, können mehrere abrechenbare Durchläufe entstehen. Auch ein Budget für fünf Lizenzen verändert sich, wenn nur ein Teil der Entwickler aktive Autoren sind, andere Agent-Aufgaben dasselbe Kontingent verbrauchen oder zusätzliche Credits gekauft werden.
Die Entscheidungsregel: Ein dedizierter automatischer Reviewer lohnt sich, wenn das manuelle Anfordern von Reviews im Prozess scheitert. Ein vorhandener Agent passt, wenn Reviews bereits zuverlässig stattfinden und eine weitere Prüfung auf funktionale Fehler gebraucht wird. Ein Sicherheitsreviewer kommt hinzu, wenn es um für Angreifer erreichbare und ausnutzbare Schwachstellen geht.
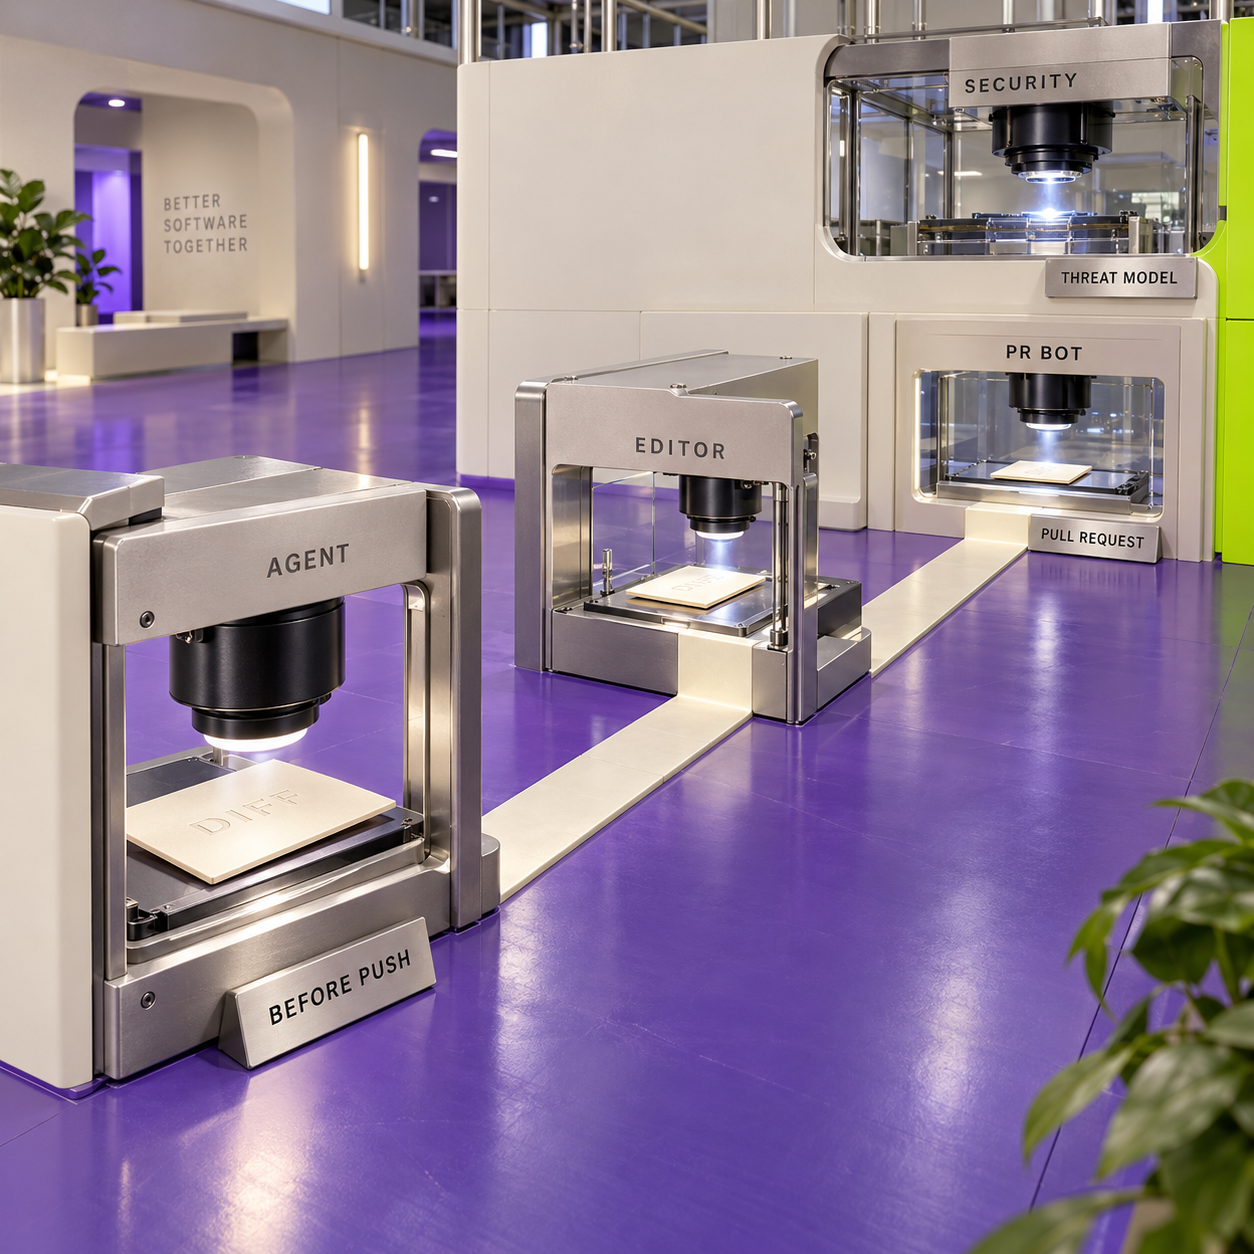
An welcher Stelle prüft die KI den Code?
Der Ort des Reviews bestimmt, wer einen Befund sieht, wann der Autor ihn beheben kann und wie verlässlich die Prüfung tatsächlich stattfindet.
Ein PR-Bot wie CodeRabbit oder Greptile überwacht ein angebundenes Repository und veröffentlicht Befunde im Pull Request. Damit landet die Prüfung dort, wo das Team ohnehin über den Merge entscheidet. Der Autor muss keinen Terminalbefehl im Kopf behalten.
Ein Reviewer eines Editor-Anbieters wie Cursor Bugbot verbindet die Prüfung mit dem Schreiben und Korrigieren von Code. Bugbot prüft auch gehostete PRs; dafür müssen nicht alle Mitwirkenden in Cursor programmieren. Sein besonderer Nutzen liegt darin, eine geprüfte Änderung zur Korrektur an einen Agenten zurückgeben zu können.
Ein Coding-Agent im Review-Einsatz kann einen Branch oder Diff prüfen, bevor daraus ein PR wird. Codex bietet auch angebundene Cloud-Reviews. Claude Code hat sowohl einen lokalen Review-Befehl als auch einen separat abgerechneten verwalteten GitHub-Dienst. Für diese Varianten müssen Budget und Datenaufbewahrung getrennt bewertet werden.
Ein Sicherheitsreviewer arbeitet mit dem Bedrohungsmodell: Was kann ein Angreifer kontrollieren, welche Grenzen überschreitet der Code, und führt ein verdächtiger Ausführungspfad tatsächlich zu einer Schwachstelle? Codex Security ergänzt das allgemeine Code-Review um diese enger gefasste Aufgabe.
Ein lokaler Checkout bedeutet nicht, dass auch die Modellinferenz lokal stattfindet. Claude Code und Codex können Befehle auf dem eigenen Rechner ausführen und zugleich Prompts und relevanten Code an ihren Modelldienst senden. Ebenso löscht das Entfernen eines Cloud-Containers nicht unbedingt den daraus entstandenen Review-Bericht.
PR-Bots: CodeRabbit und Greptile
CodeRabbit: Der erste Kandidat für automatische Reviews
CodeRabbit ist ein mit dem Repository verbundener KI-Reviewer, der Zusammenfassungen und zeilenbezogene Hinweise in PRs veröffentlicht. Er passt, wenn gewöhnliche Änderungen regelmäßig ohne verlässliche Vorprüfung ins menschliche Review gelangen. Über die Konfiguration lässt sich das Feedback eingrenzen; die kostenpflichtigen Tarife bieten eine übersichtliche Grundlage für das Lizenzbudget. Ein Upgrade sollte erst erfolgen, wenn die dafür nötige Funktion oder Nutzungsgrenze konkret benannt werden kann.
Urteil: CodeRabbit Essentials ist der erste dedizierte Bot, den ein Team mit fünf Personen testen sollte. Die monatlichen Lizenzkosten von $150 sind gut nachvollziehbar, solange die Spitzenlast beim Review innerhalb der Tarifgrenzen bleibt.
Besonders geeignet für: Kleine Teams, die automatische Hinweise zu gewöhnlichen Änderungen auf GitHub oder GitLab wollen.
Besonderheit: Review-Profile, pfadspezifische Anweisungen und aus Feedback gewonnener Kontext direkt im PR-Ablauf.
Preise: Essentials $30, Team $60, Advanced $90 pro Entwickler und Monat; Enterprise auf Anfrage.
Kostenloser Test: 14 Tage. Die kostenlosen Funktionen für private Repositories sind eingeschränkter als die kostenpflichtigen PR-Reviews.
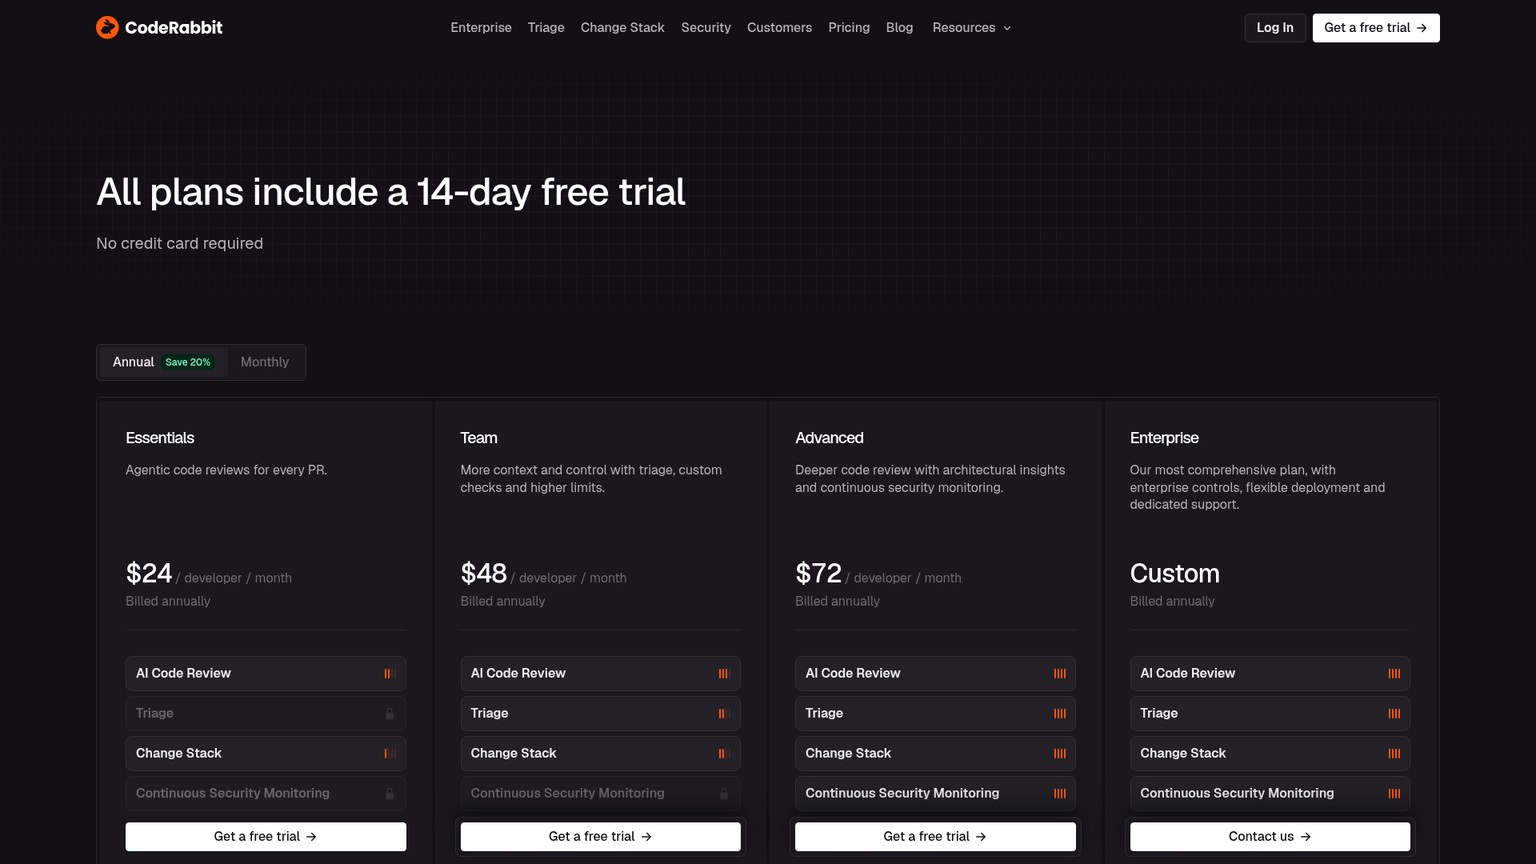
Alle Tarife und die Kosten für fünf Entwickler
Die aktuellen Tarife heißen Free, Essentials, Team, Advanced und Enterprise. Bei Jahreszahlung sinken die ausgewiesenen kostenpflichtigen Preise auf $24, $48 und $72 pro Entwickler und Monat. Für fünf Entwickler entspricht das $120, $240 beziehungsweise $360 pro Monat, verbunden mit Jahresverpflichtungen von $1,440, $2,880 und $4,320. Bei monatlicher Zahlung kostet dasselbe Team $150, $300 oder $450. Für Enterprise ist ein Angebot nötig. Diese Preise stammen von der aktuellen Preisseite und aus der offiziellen Tarifdokumentation.
Free liefert Zusammenfassungen privater PRs, aber nicht den vollständigen kostenpflichtigen Review-Dienst für private PRs. CodeRabbit bietet außerdem kostenlose Kontingente für lokale Reviews und kostenlose Reviews für öffentliche Open-Source-Projekte. Wer als CTO automatische Fehlerbefunde für privaten Code benötigt, sollte einen kostenpflichtigen Tarif einplanen: Eine Zusammenfassung ersetzt keine Prüfung auf funktionale Fehler.
Essentials ist der sinnvolle Einstieg. Team ergänzt unter anderem umfangreicheren Kontext aus mehreren Repositories und eigene Prüfungen; Advanced fügt tiefere Sicherheits- und Architekturfunktionen hinzu. Solche Upgrades sollten einen konkreten Bedarf erfüllen. Allein die Tatsache, dass fünf Entwickler zusammenarbeiten, macht den Tarif namens Team nicht notwendig.
Fehlalarme reduzieren und Reviews abstimmen
Das Profil quiet eignet sich als Startpunkt, wenn das Team nur Hinweise zu wesentlichen Problemen möchte. Das Standardprofil chill ist ausgewogen; assertive erzeugt bewusst mehr Feedback und kann kleinteilig wirken. Das sind dokumentierte Einstellungen für das Verhalten, keine gemessenen Präzisionsgarantien. Pfadfilter können generierte Dateien vom Review ausnehmen. Pfadspezifische Anweisungen sollten die tatsächlichen Invarianten sensibler Codebereiche beschreiben. Die Einstellungen liegen in .coderabbit.yaml oder im Dashboard. Konfigurationsreferenz.
Für einen Abrechnungsdienst wäre etwa die Vorgabe hilfreich, dass ein erneuter Versuch keine doppelte Belastung auslösen darf und bei einer Erstattung die Prüfspur erhalten bleiben muss. „Sei gründlich“ hilft dem Reviewer weniger. Ein Befund sollte die geänderte Zeile, den erreichbaren Aufrufer und die Fehlerbedingung belegen. Formatierungsregeln, die der Linter ohnehin erzwingt, bleiben Aufgabe der CI.
Bei einem falschen Kommentar hilft eine Erklärung der schützenden Bedingung mehr als die bloße Antwort, der Bot liege falsch. Benennt er einen echten, aber bewusst akzeptierten Zielkonflikt, sollte die Reichweite dieser Ausnahme festgehalten werden. Pauschale Anweisungen, eine ganze Fehlerklasse zu ignorieren, können auch den nächsten tatsächlichen Defekt unterdrücken.
GitHub, GitLab und Datenaufbewahrung
CodeRabbit dokumentiert direkte Integrationen mit GitHub.com, GitHub Enterprise Server, GitLab.com und selbstverwaltetem GitLab. Einen selbstverwalteten Code-Host anzubinden ist etwas anderes, als den Reviewer auf der eigenen Infrastruktur zu betreiben. Die Enterprise-Option für Selbsthosting ist für 500 oder mehr Lizenzen dokumentiert und damit kein üblicher Einkaufsweg für ein Team mit fünf Personen. Unterstützte Plattformen.
Der wiederverwendbare Cache für Repository und Abhängigkeiten ist standardmäßig aktiviert und läuft spätestens nach sieben Tagen ab. Er beschleunigt Reviews und dient nicht dem Training; die gespeicherten Daten sind außer bei Open-Source-Projekten verschlüsselt. Mit reviews.disable_cache auf true lässt er sich abschalten. Die Regel von sieben Tagen betrifft den aufbereiteten Repository-Cache. Die Datenschutzerklärung beschreibt separat Vektor-Embeddings für personalisierte Reviews und die Möglichkeit, der Speicherung zu widersprechen. Eine einheitliche veröffentlichte Löschfrist für sämtliche Artefakte nennt sie nicht. Cache-Dokumentation.
Review-Kommentare bleiben außerdem nach den Regeln des jeweiligen Hosts in GitHub oder GitLab bestehen. Eine interne Aufbewahrungsrichtlinie sollte Quellcode-Caches, erlernten Kontext und veröffentlichte Kommentare als getrennte Datensätze behandeln.
- Automatische Reviews finden in der bestehenden PR-Diskussion statt.
- Ruhige, ausgewogene und nachdrückliche Profile machen die gewünschte Feedback-Praxis ausdrücklich einstellbar.
- Pfadspezifische Anweisungen können unterschiedliche Risiken innerhalb des Repositories beschreiben.
- GitHub und GitLab sind als Integrationsziele dokumentiert.
- Kostenlose Zusammenfassungen privater PRs ersetzen keine kostenpflichtige Fehlerprüfung.
- Stunden- und Dateigrenzen bleiben relevant, auch ohne monatliche PR-Obergrenze.
- Das Ablaufen des Repository-Caches legt nicht die Lebensdauer sämtlichen erlernten Kontexts fest.
Ein Repository mit typischer Arbeit anbinden
CodeRabbit in einem gewöhnlichen aktiven Repository installieren und den Zugriff auf die Repositories beschränken, die tatsächlich geprüft werden sollen. Mit Essentials beginnen, sofern keine dokumentierte Anforderung einen anderen Tarif verlangt.
Kurze, konkrete Review-Vorgaben festlegen
quiet wählen, generierte Dateien ausschließen und die Invarianten in riskanten Codebereichen beschreiben. Eine konkrete Fehlerbedingung verlangen und Lint-Regeln nicht duplizieren.
Befunde einordnen, bevor der Einsatz ausgeweitet wird
Das Team sollte Kommentare als nützlich, falsch, bereits abgedeckt oder zutreffend, aber zu unwichtig einordnen. Im Pilotbetrieb bleibt automatisches Feedback beratend. Neben der Rechnung sollte auch das stündliche Nutzungsmuster geprüft werden.
Greptile: Für gezielt konfigurierten Repository-Kontext
Greptile ist ein KI-Reviewer für PRs, der das Repository einbezieht und Review-Regeln, verzeichnisspezifische Einstellungen sowie Lernen aus Feedback bietet. Er ist eine starke Alternative für Teams, die das Review-Verhalten an ihre Codebasis anpassen und die Nutzung je Autor verwalten wollen. Die Kostenfalle liegt in der Annahme, eine Lizenz für $30 kaufe unbegrenzt viele Reviews zum selben Preis.
Urteil: Greptile ist eine überzeugende Alternative zu CodeRabbit. Review-Aufwand und Obergrenze für zusätzliche Nutzung sollten jedoch feststehen, bevor der Bot bei jedem Push aktiv wird.
Besonders geeignet für: Teams, die repositoryspezifische Standards und genaue Kontrolle über die veröffentlichten Kommentare wollen.
Besonderheit: Getrennte Einstellungen für Review-Aufwand, Kommentarkategorien, Wichtigkeit und verzeichnisspezifisches Verhalten.
Preise: Starter kostenlos für einen aktiven Entwickler; Pro $30 pro aktivem Entwickler und Monat zuzüglich zusätzlicher Credits; Enterprise auf Anfrage.
Kostenloser Test: 14 Tage; geeignete nichtkommerzielle Open-Source-Projekte können kostenlosen Zugang beantragen.
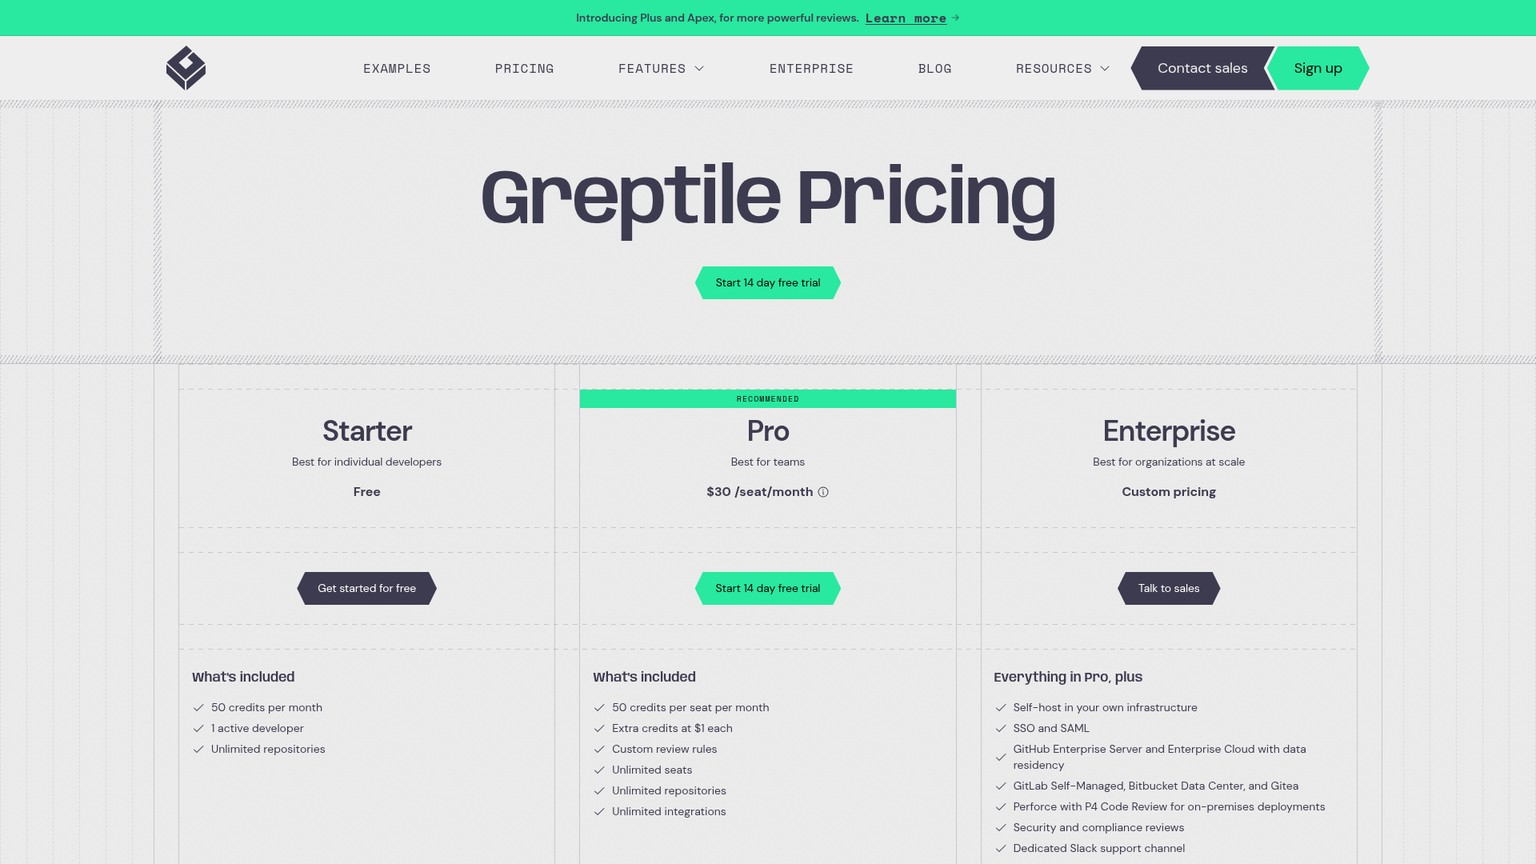
Alle Tarife und die Kosten für fünf Entwickler
Starter umfasst einen aktiven Entwickler, unbegrenzt viele Repositories und 50 Credits pro Monat. Pro enthält 50 Credits pro aktivem Entwickler; zusätzliche Credits kosten jeweils $1. Enterprise hat individuelle Preise und bietet Optionen wie Selbsthosting, SSO und Integrationen mit selbstverwalteten Code-Hosts. Rabatte für jährliche oder mehrjährige Verträge werden ausgehandelt; einen einheitlichen veröffentlichten Jahrespreis gibt es nicht. Aktuelle Preise.
Die Aufwandsstufen sind Base mit 1 Credit, Plus mit 3 und Apex mit 10. Auto wählt die Stufe für jeden PR einzeln und ist deshalb kein Review zum Festpreis. Diese Werte beschreiben Arbeits- und Abrechnungseinheiten. Sie belegen nicht, dass ein teureres Review eine niedrigere Fehlalarmquote hat.
Als aktiver Entwickler zählt ein Autor, dem im Abrechnungszeitraum ein abgeschlossenes Review berechnet wurde. Reviews werden dem PR-Autor zugeordnet; ungenutzte enthaltene Credits werden nicht teamweit zusammengelegt. Abgerechnet werden abgeschlossene Durchläufe, einschließlich neuer Läufe nach konfigurierten Ereignissen, nicht einzelne PRs. Löst ein anderer Reviewer die Prüfung aus, wandert die Rechnung dadurch nicht zu ihm. Abrechnungsdokumentation.
Ein Autor mit 70 Base-Reviews überschreitet sein Kontingent beispielsweise um 20 Credits. Ein anderer Autor mit nur 10 Reviews kann ihm die ungenutzten Credits nicht übertragen. Das Flex Usage Limit der Organisation sollte auf den akzeptierten Zusatzbetrag gesetzt werden; $0 deaktiviert Reviews über das Kontingent hinaus. Autoren mit verbleibendem eigenem Kontingent können auch nach Erreichen dieser Obergrenze weiter Reviews erhalten.
Fehlalarme reduzieren und Reviews abstimmen
strictness steuert, welche Befunde veröffentlicht werden: 1 ist ausführlich, 2 der ausgewogene Standard und 3 auf kritische Probleme beschränkt. commentTypes wählt Hinweise zu Logik, Syntax oder Stil aus. Wenn die CI bereits die Formatierung erzwingt, vermeidet ein Start mit Logik und Syntax offensichtliche Doppelarbeit. Die empfohlene Konfiguration in .greptile/ unterstützt verzeichnisspezifische Überschreibungen; die ältere Variante über greptile.json im Repository-Stamm bleibt verfügbar. Weniger kleinteiliges Feedback.
Strictness und Aufwand lösen verschiedene Probleme. Eine höhere Strictness begrenzt die veröffentlichten Kommentare. Der Wechsel von Base zu Apex verändert Arbeitsaufwand und Credit-Verbrauch. Eine höhere Rechnung ersetzt keine Definition dafür, was einen handlungsrelevanten Befund ausmacht.
Nützliche Befunde positiv und irrelevante negativ bewerten, jeweils mit einer kurzen Begründung. Das kann etwa die dokumentierte Garantie sein, dass ein verdächtiger Wert nicht null sein kann. Die Ausnahme sollte auf den Code begrenzt bleiben, in dem sie tatsächlich gilt. Automatische Auslöser lassen sich einschränken, wenn häufige Pushes Reviews immer wieder neu starten, bevor eine Änderung bereit ist.
Für die Abgrenzung des Datenzugriffs ist ein Detail besonders wichtig: ignorePatterns schließt Dateien vom PR-Review aus, aber nicht von der Repository-Indizierung. Keine Kommentare zu einer generierten Datei zu wollen und dem Anbieter den Zugriff auf ein vertrauliches Verzeichnis verwehren zu wollen, sind unterschiedliche Anforderungen.
GitHub, GitLab und Datenaufbewahrung
Greptile unterstützt Reviews auf gehostetem GitHub und GitLab. GitHub Enterprise Server und GitLab Self-Managed stehen auf der Preisseite unter den Enterprise-Funktionen. Solche Bereitstellungsanforderungen sollten daher nicht ohne Prüfung einer gewöhnlichen Pro-Lizenz zugeschrieben werden.
Laut Sicherheitsseite bleibt verschlüsselter Quellcode im Cache, bis der Zugriff in GitHub oder GitLab widerrufen wird; danach wird er gelöscht. Greptile speichert außerdem Embeddings von Pfaden, Dokumentation und generierten Docstrings. Die Lebensdauer dieses Caches hängt am Zugriff und ist keine feste Frist von sieben Tagen. Chat-Protokollierung lässt sich deaktivieren. Die Richtlinie erlaubt Training und Verbesserung mit deidentifizierten Kundendaten; über das Konto kann weiterem Training widersprochen werden. Sicherheits- und Datenrichtlinie.
Ein Administrator kann die Löschung von Kundendaten anfordern. Genannt werden 24 Stunden für die endgültige Löschung aus Produktionssystemen und 30 Tage für die Vernichtung von Backups, mit einer möglichen Verlängerung zur Untersuchung eines Vorfalls. Trainingseinstellung und Löschverfahren sollten während des Tests festgehalten werden. Die allgemeine Aussage, dass Daten verschlüsselt sind, beantwortet nicht die Frage nach ihrer Speicherdauer.
- Wichtigkeitsfilter und Kommentarkategorien bieten konkrete Möglichkeiten, unnötiges Feedback zu reduzieren.
- Verzeichnisspezifische Einstellungen können verschiedene Teams innerhalb eines Monorepos abbilden.
- Feedback kann festhalten, warum ein Vorschlag zutrifft oder nicht zutrifft.
- Eine ausdrückliche Flex-Obergrenze macht zusätzliche Review-Ausgaben kontrollierbar.
- Enthaltene Credits gehören einzelnen Autoren und gleichen die Lastspitze eines anderen Autors nicht aus.
- Höherer Aufwand und häufige Wiederholungen können die Monatsrechnung deutlich erhöhen.
- Ein beim Review ignorierter Pfad wird weiterhin indiziert.
- Quellcode-Caching und Trainingseinstellungen müssen bei der Beschaffung ausdrücklich geprüft werden.
Für die engere Auswahl zwischen diesen Bots hilft Greptile im Vergleich mit CodeRabbit. Falls beide nicht passen, bietet Alternativen zu CodeRabbit weitere Kandidaten. Auch dort gelten dieselben Prüfungen zu aktuellen Preisen und Grenzen des Datenzugriffs.
Der Reviewer aus dem Editor-Umfeld: Cursor Bugbot
Cursor Bugbot: Wenn Prüfung und Korrektur bereits in Cursor stattfinden
Cursor Bugbot ist Cursors KI-Reviewer für Pull Requests und Änderungen vor dem Push. Er eignet sich für Teams, die Cursor bereits nutzen und Befunde nahtlos in ihren Korrekturablauf zurückführen wollen. Zugleich ist er ein angebundener PR-Bot. „Reviewer aus dem Editor-Umfeld“ beschreibt also seine Produktzugehörigkeit und beschränkt den Einsatz nicht auf Prüfungen innerhalb der IDE.
Urteil: Bugbot gehört für ein Cursor-Team auf die Auswahlliste. Das Budget sollte allerdings die Nutzung abbilden, statt jedem Entwickler eine frühere separate Bugbot-Lizenz für $40 hinzuzurechnen.
Besonders geeignet für: Cursor-Teams, die Branch-Reviews, PR-Feedback und agentengestützte Korrekturen verbinden.
Besonderheit: Bugbot kann einen vor dem Push geprüften Diff später wiedererkennen und ein erneutes Remote-Review vermeiden.
Preise: Nutzungsabhängige Bugbot-Abrechnung; Cursor-Abotarife und Review-Ausgaben sind getrennte Budgetposten.
Kostenloser Test: Die zitierte Dokumentation verspricht keinen separaten aktuellen Bugbot-Test.
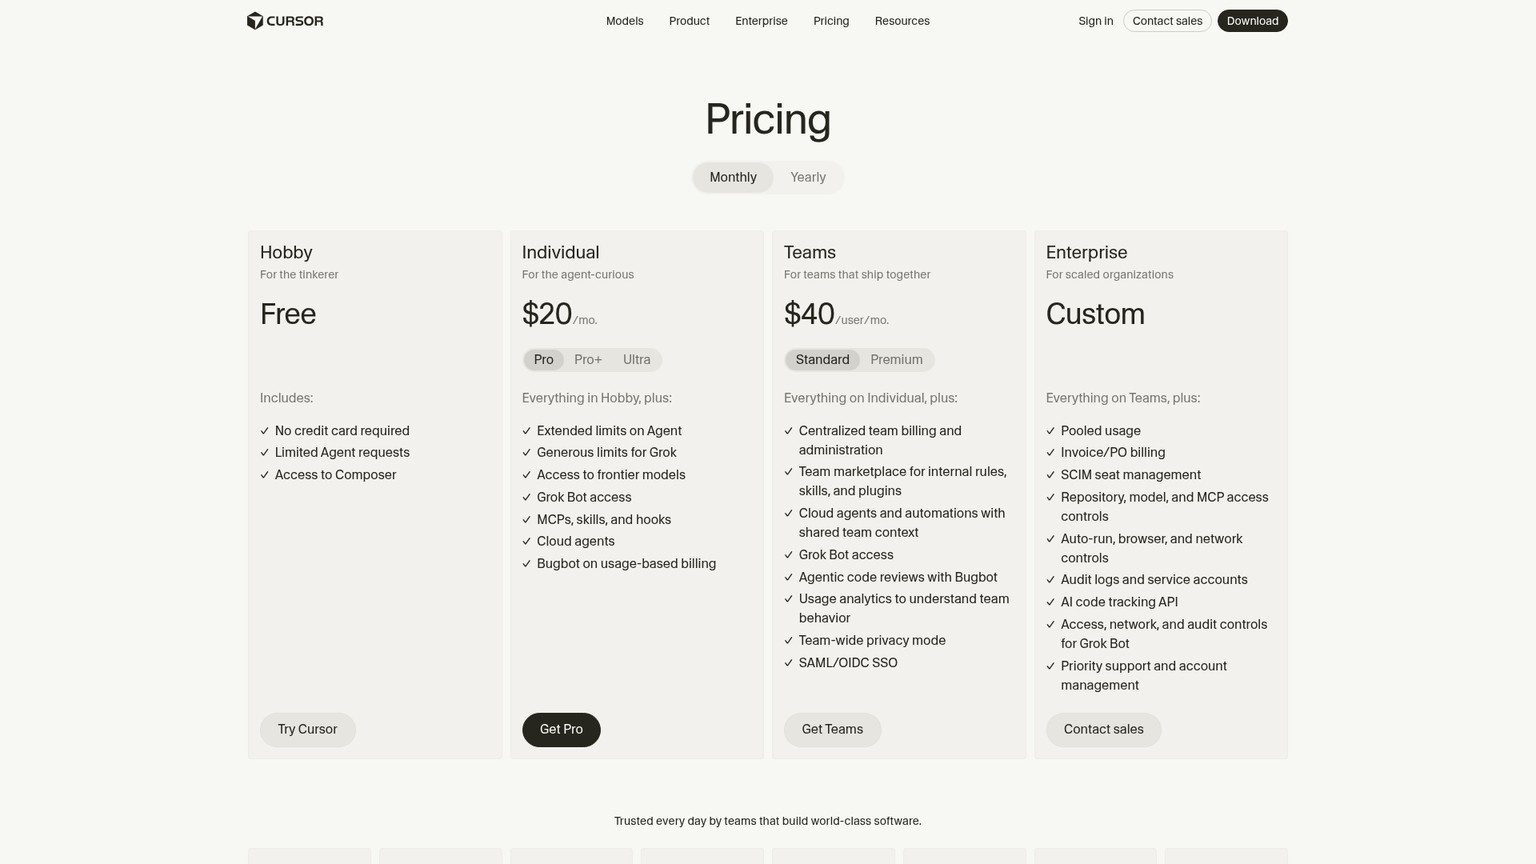
Alle Tarife und die Kosten für fünf Entwickler
Die US-Tarife von Cursor umfassen den kostenlosen Hobby-Tarif, Pro für $20 pro Monat, Pro Plus für $60 und Ultra für $200. Fünf Einzelabonnements kosten $100, $300 oder $1,000 monatlich. Bei Teams kosten Standard-Lizenzen $40 pro Nutzer und Monat, Premium-Lizenzen $120. Die Grundkosten für fünf Lizenzen liegen damit bei $200 beziehungsweise $600. Enterprise wird individuell angeboten. Der nur in Indien erhältliche Start-Tarif kostet ₹649 pro Monat einschließlich Steuern und enthält Bugbot nicht; er ist deshalb keine günstigere Review-Stufe für diesen Vergleich. Aktuelle Tarifdokumentation.
Bugbot hat für Teams und Einzelpersonen auf nutzungsabhängige Abrechnung umgestellt. Teams nutzt bedarfsgerecht abgerechnete Nutzung; bei Einzelpersonen wird zunächst das enthaltene Kontingent verbraucht, bevor zusätzliche Ausgaben entstehen. Cursor nennt einen Durchschnitt von $1.00 bis $1.50 pro Bugbot-Durchlauf, abhängig von Größe und Komplexität. Dieser Durchschnitt hilft bei der Budgetplanung, ist aber weder ein Festpreis noch eine Zusage für den nächsten PR. Bestandskunden wechseln bei ihrer ersten Verlängerung nach dem 8. Juni 2026 von der bisherigen Lizenzabrechnung. Ein noch nicht verlängerter Jahresvertrag kann daher weiterhin einen historischen Lizenzpreis ausweisen. Umstellung der Abrechnung.
Hobby ist kein zugesicherter kostenloser automatischer Bugbot-Dienst für ein privates Team mit fünf Personen. Auch die enthaltenen Kontingente der Einzeltarife haben konkurrierende Verwendungen. Ein Pro-Abonnement sollte deshalb nicht als Garantie für eine feste Anzahl kostenloser Reviews dargestellt werden.
Fehlalarme reduzieren und Reviews abstimmen
Bugbot braucht eigene Review-Anweisungen. Projektspezifische Vorgaben gehören in .cursor/BUGBOT.md, ergänzt um Dateien mit passendem Geltungsbereich für bestimmte Verzeichnisse. Gewöhnliche Cursor-Editorregeln in .cursor/rules/*.mdc gelten nicht für Bugbot. Team- und Repository-Regeln liefern zusätzliche Vorgaben; die ausführliche Review-Ausgabe zeigt, welche Regeln einbezogen wurden. Bugbot-Dokumentation.
Repository-Einstellungen wie Aufwand und Auslöser gehören in .cursor/config/bugbot.yaml. Bugbot liest diese Datei aus dem Standardbranch. Ein PR kann deshalb nicht über seine geänderte Kopie das eigene Review-Verhalten beeinflussen. Das hält die Review-Vorgaben stabil, während sich der geprüfte Branch verändert.
Ein guter Einstieg ist das standardmäßig aktivierte inkrementelle Review. Bei raschen Aktualisierungen kann manuelles Auslösen helfen, wenn mehr Diskussion entsteht, als das Team verarbeiten kann. Die Aufwandsstufen Low, Default, High und Smart beeinflussen Arbeitsumfang und Nutzung. Smart kann Vorgaben dazu berücksichtigen, wann eine Änderung genauer untersucht werden soll. Höherer Aufwand ist kein gemessenes Mittel gegen unnötiges Feedback.
Bugbot nutzt die vorhandene PR-Diskussion als Kontext. Die menschliche Begründung für einen akzeptierten Zielkonflikt sollte im Thread stehen. Bevor dem Modell vorgeworfen wird, Anweisungen ignoriert zu haben, sollte geprüft werden, ob sie überhaupt enthalten waren. Die Prüfung vor dem Push über /review-bugbot kann einen identischen Patch auf dem angebundenen Host erkennen und ein weiteres Remote-Review überspringen. So lässt sich doppelte Review-Arbeit vermeiden.
GitHub, GitLab und Datenaufbewahrung
GitHub einschließlich Enterprise Server sowie GitLab einschließlich Self-Hosted sind als Ziele dokumentiert. Reine Review-Nutzung und Autofix haben unterschiedliche betriebliche Voraussetzungen: Autofix verwendet Cloud-Agent-Credits und setzt aktivierte Speicherung voraus. Soll es eingeschaltet werden, gehört diese zusätzliche Aktivität ins Budget.
Bugbot folgt Cursors Datenverarbeitungsrichtlinie. Im Privacy Mode trainiert Cursor nicht mit Kundendaten und hält Vereinbarungen zur Nichtaufbewahrung von Daten bei Modellanbietern aufrecht. Genannte Ausnahmen betreffen Missbrauchsuntersuchungen und ausdrücklich gekennzeichnete oder vom Administrator aktivierte Modelle ohne ZDR. Außerdem gibt es temporäre verschlüsselte Datei-Caches. Bei deaktiviertem Privacy Mode können Speicherung und Training erlaubt sein. Datennutzung bei Cursor.
Diese Kontrollen bedeuten nicht, dass „nie etwas gespeichert wird“. PR-Kommentare und erlernte Review-Regeln sind Aufzeichnungen des Arbeitsablaufs. Die zitierten Seiten nennen keine einheitliche Löschfrist für alle Bugbot-Artefakte. Die verbindliche Datenschutzeinstellung des Teams und mögliche Ausnahmen bei gewählten Modellen sollten geprüft werden.
- Befunde führen in den Korrekturablauf zurück, den das Cursor-Team bereits nutzt.
- Ein Review vor dem Push kann eine doppelte Remote-Prüfung desselben Patches vermeiden.
- Die Konfiguration im Standardbranch hält Review-Vorgaben stabil.
- GitHub und GitLab werden als Review-Hosts unterstützt.
- Nutzungsabhängige Abrechnung macht die Kosten von Review-Aktivität und Aufwand abhängig.
- Bestehende IDE-Regeln werden nicht automatisch zu Bugbot-Anweisungen.
- Autofix bringt zusätzlichen Credit-Verbrauch und Speicheranforderungen mit sich.
Coding-Agenten im Review-Einsatz: Codex und Claude Code
Codex code review: Vorhandenen Agenten nutzen, dann über Automatisierung entscheiden
Codex code review ist OpenAIs Review-Arbeitsablauf mit einem Coding-Agenten, lokal und über angebundene Repositories verfügbar. Er passt für Teams, die Codex bereits nutzen und Änderungen vor der menschlichen Freigabe nochmals prüfen lassen wollen. Durch seine Cloud-Integrationen kommt Codex auch für automatische Reviews infrage und ist nicht nur ein Befehl, an den Entwickler selbst denken müssen.
Urteil: Mit dem bereits bezahlten Codex-Zugang beginnen. Bei einem neuen geschäftlichen Workspace starten fünf monatliche Business-Lizenzen bei $125; Review-Kapazität und zusätzliche Credits werden getrennt bewertet.
Besonders geeignet für: Teams, die Codex zum Programmieren und Prüfen einsetzen, insbesondere mit Bedarf an gemeinsamen Workspace-Kontrollen.
Besonderheit: Repository-Anweisungen in AGENTS.md steuern das Review; native GitLab-Reviews sind inzwischen als Beta dokumentiert.
Preise: Plus $20 monatlich; Pro $100, $200 oder $500; Business $25/Nutzer monatlich oder $20 bei Jahreszahlung; Enterprise und Edu auf Anfrage.
Kostenloser Test: Kein separater Code-Review-Test und kein fester Preis pro PR angegeben.
Alle Tarife und die Kosten für fünf Entwickler
ChatGPT Free kostet $0, Go kostet $8 pro Monat. Beide bieten einen eingeschränkten lokalen Codex-Zugang, abhängig vom Rollout. Die Preisseite führt Cloud-Integrationen wie automatische Reviews ausdrücklich bei Plus für $20 auf. Pro bietet monatliche Stufen für $100, $200 und $500. Business kostet bei monatlicher Abrechnung $25 pro Nutzer oder bei Jahreszahlung umgerechnet $20 pro Nutzer und Monat, mit mindestens zwei Nutzern. Enterprise und Edu benötigen ein Angebot. Codex-Preise.
Fünf Plus-Abonnements kosten $100 pro Monat. Fünf gleichartige Pro-Abonnements kosten $500, $1,000 oder $2,500. Fünf Business-Lizenzen kosten bei monatlicher Abrechnung $125 oder bei Jahreszahlung umgerechnet $100 pro Monat mit einer Jahresverpflichtung von $1,200. Ein günstiges Privatkundenabo und ein zentral verwalteter geschäftlicher Workspace sind unterschiedliche Anschaffungen, auch wenn beide Code prüfen können.
Die Nutzung per API-Schlüssel ist eine weitere Möglichkeit für CLI, SDK oder IDE und wird anhand der Tokens abgerechnet. Cloud-Funktionen wie gehostete GitHub-Code-Reviews sind darin nicht enthalten. API-Credits sollten daher nicht in der Erwartung gekauft werden, denselben angebundenen Review-Dienst freizuschalten.
Fehlalarme reduzieren und Reviews abstimmen
Auf GitHub meldet der dokumentierte Standard P0- und P1-Probleme, also dringende und hoch priorisierte Befunde. Das bevorzugt bewusst Hinweise zu wesentlichen Problemen. Ein Abschnitt Code Review Rules in den geltenden AGENTS.md-Dateien sollte festlegen, was im jeweiligen Pfad als relevanter Defekt zählt. Codex liest die Anweisungen, die für die geänderten Dateien gelten. Dokumentation zu GitHub-Reviews.
Nützliche Regeln beschreiben Tatsachen: Ein Endpunkt ist nur intern erreichbar; eine Migration muss alte und neue Leser unterstützen; ein nullable Feld wird durch einen bestimmten Aufrufer abgesichert. Der Reviewer sollte benennen, wie eine geänderte Zeile diese Vorgabe verletzt. Lange Anweisungen, „jedes denkbare Problem“ zu finden, fördern Hypothesen, die ein kleines Team anschließend widerlegen muss.
Ein lokales oder manuell angefordertes Review vor dem Push erlaubt dem Autor, die Belege zu prüfen, ohne eine öffentliche Kommentarrunde zu beginnen. Bei wichtigen Änderungen hilft eine erneute Prüfung mit Fokus auf Diff und Repository-Belege. Ein Agent, der die Implementierung geschrieben hat, kann dieselbe falsche Annahme auch in seiner Erklärung weiterführen. Menschliche Freigabe und gezielte Tests sollten deshalb Teil des Ablaufs bleiben.
GitHub, GitLab und Datenaufbewahrung
GitHub unterstützt angeforderte Reviews mit @codex review und im Repository konfigurierte automatische Reviews. Native GitLab-Code-Reviews sind in der Beta und auf allen ChatGPT-Tarifen verfügbar, so die aktuelle GitLab-Dokumentation. Erforderlich sind eine Projektumgebung und aktivierte Aktivitätsübermittlung. Selbstverwaltete und Dedicated-Installationen brauchen zusätzlich eine Einrichtung durch den Administrator und eine Review-Identität. Manuelle GitLab-Reviews können P0-, P1- und P2-Befunde enthalten; automatische Reviews sind standardmäßig auf P0 und P1 beschränkt. Dokumentation zu GitLab-Reviews.
Die Beta sollte auf dem tatsächlich eingesetzten GitLab-Host geprüft werden. „GitLab-Unterstützung“ ersetzt weder die passende Verbindung noch Berechtigungen und Hooks. Sie bedeutet auch nicht, dass jede separate Codex-Security-Funktion dieselbe Integration bietet.
Bei der Aufbewahrung gilt: Codex mit ChatGPT-Authentifizierung folgt den Datenrichtlinien des Workspaces. Bei API-Authentifizierung gelten dagegen die Einstellungen der API-Organisation zu Datenfreigabe und Aufbewahrung. Business gibt an, geschäftliche Daten standardmäßig nicht für das Training zu nutzen; Enterprise enthält Kontrollen für Aufbewahrung und Datenresidenz. Die zitierten Seiten veröffentlichen keine einheitliche Tagesfrist für sämtliche Artefakte aus Codex-Cloud-Reviews. Unterschied zwischen Authentifizierung und Datenrichtlinien.
Der Workspace-Verantwortliche sollte die tatsächlichen Regeln für Cloud-Aufgaben und Review-Verläufe nennen. Eine Aussage zur API-Aufbewahrung darf nicht ungeprüft in die Freigabe eines mit ChatGPT authentifizierten Cloud-Reviewers übernommen werden.
- Ein vorhandenes Codex-Abonnement kann Programmierung und Review abdecken.
- Geltende Repository-Anweisungen vermitteln dem Reviewer die Projektannahmen.
- Automatische GitHub-Reviews und die native GitLab-Beta bieten gehostete Varianten.
- Business bietet einen gemeinsamen Workspace statt getrennter Privatkundenkonten.
- Das enthaltene Kontingent wird mit anderen Codex-Aufgaben geteilt.
- Ein API-Schlüssel aktiviert den angebundenen GitHub-Review-Dienst nicht.
- GitLab-Beta und selbstverwaltete Einrichtung müssen auf der Installation des Teams geprüft werden.
- Keine einzelne öffentliche Aufbewahrungsfrist beschreibt sämtliche Cloud-Review-Artefakte.
Claude Code: Lokale Prüfung und verwaltete PR-Reviews getrennt bewerten
Claude Code ist Anthropics Coding-Agent mit einem lokalen Review-Befehl und einem separaten verwalteten Code-Review-Dienst. Der lokale Befehl passt, wenn das Team bereits in Claude Code arbeitet und vor dem Öffnen eines PR zuverlässig eine Prüfung anfordern kann. Verwaltete Reviews kommen für ausgewählte GitHub-Änderungen mit erheblichen möglichen Auswirkungen infrage, sofern automatische und separat abgerechnete Verifikation ins Budget passt.
Urteil: Für fünf Entwickler zunächst das lokale Claude-Code-Review nutzen. Verwaltete Reviews bei jedem gewöhnlichen Push verursachen erhebliche neue Ausgaben, auch wenn das Team bereits berechtigte Lizenzen besitzt.
Besonders geeignet für: Claude-Code-Teams, die einen Branch vor der Übergabe an einen Menschen prüfen lassen.
Besonderheit: Lokale Reviews laufen mit eigenem Kontext; verwaltete Reviews bieten dedizierte Anweisungen nur für die Prüfung und Verifikation.
Preise: Pro $20 monatlich für die lokale Nutzung; Team Standard $25/Nutzer monatlich; verwaltete Reviews durchschnittlich $15 bis $25 pro Durchlauf, separat abgerechnet.
Kostenloser Test: Kein separater Test für verwaltete Reviews zugesichert; der verwaltete Dienst ist eine Research Preview für berechtigte Team- und Enterprise-Organisationen.
Alle Tarife und die Kosten für fünf Entwickler
Claude Free kostet $0, ist aber nicht das kostenpflichtige Claude-Code-Abonnement. Pro kostet $20 pro Monat oder $200 im Voraus für ein Jahr. Die Seite zeigt den Jahrespreis gerundet als $17 pro Monat an. Fünf Pro-Abonnements kosten deshalb $100 monatlich oder $1,000 jährlich, was effektiv etwa $83.33 pro Monat entspricht. Aktuelle Claude-Preise.
Max 5x kostet $100 pro Monat, Max 20x kostet $200. Fünf gleichartige Lizenzen ergeben damit $500 oder $1,000 monatlich. Das sind Nutzungsstufen des Abonnements und keine festen Review-Anzahlen. Max-Preise.
Team Standard kostet $25 pro Lizenz und Monat oder $20 bei Jahreszahlung: Für fünf Lizenzen sind das $125 monatlich oder umgerechnet $100 bei Jahreszahlung. Premium kostet pro Lizenz $125 monatlich oder umgerechnet $100 bei Jahreszahlung: für fünf Lizenzen $625 monatlich oder umgerechnet $500 bei Jahreszahlung. Die zugehörigen Jahresverpflichtungen betragen $1,200 und $6,000. Enterprise nennt einen jährlich abgerechneten monatlichen Vergleichspreis von $20 pro Lizenz zuzüglich Nutzung zu API-Tarifen. Rechnerisch ergeben fünf Lizenzen $100 vor Nutzungskosten, vorbehaltlich der Vertragsvoraussetzungen. Education wird für Institutionen individuell bepreist, API-Zugang nach Nutzung. Für beide gibt es deshalb keinen allgemeinen Festpreis für fünf Entwickler.
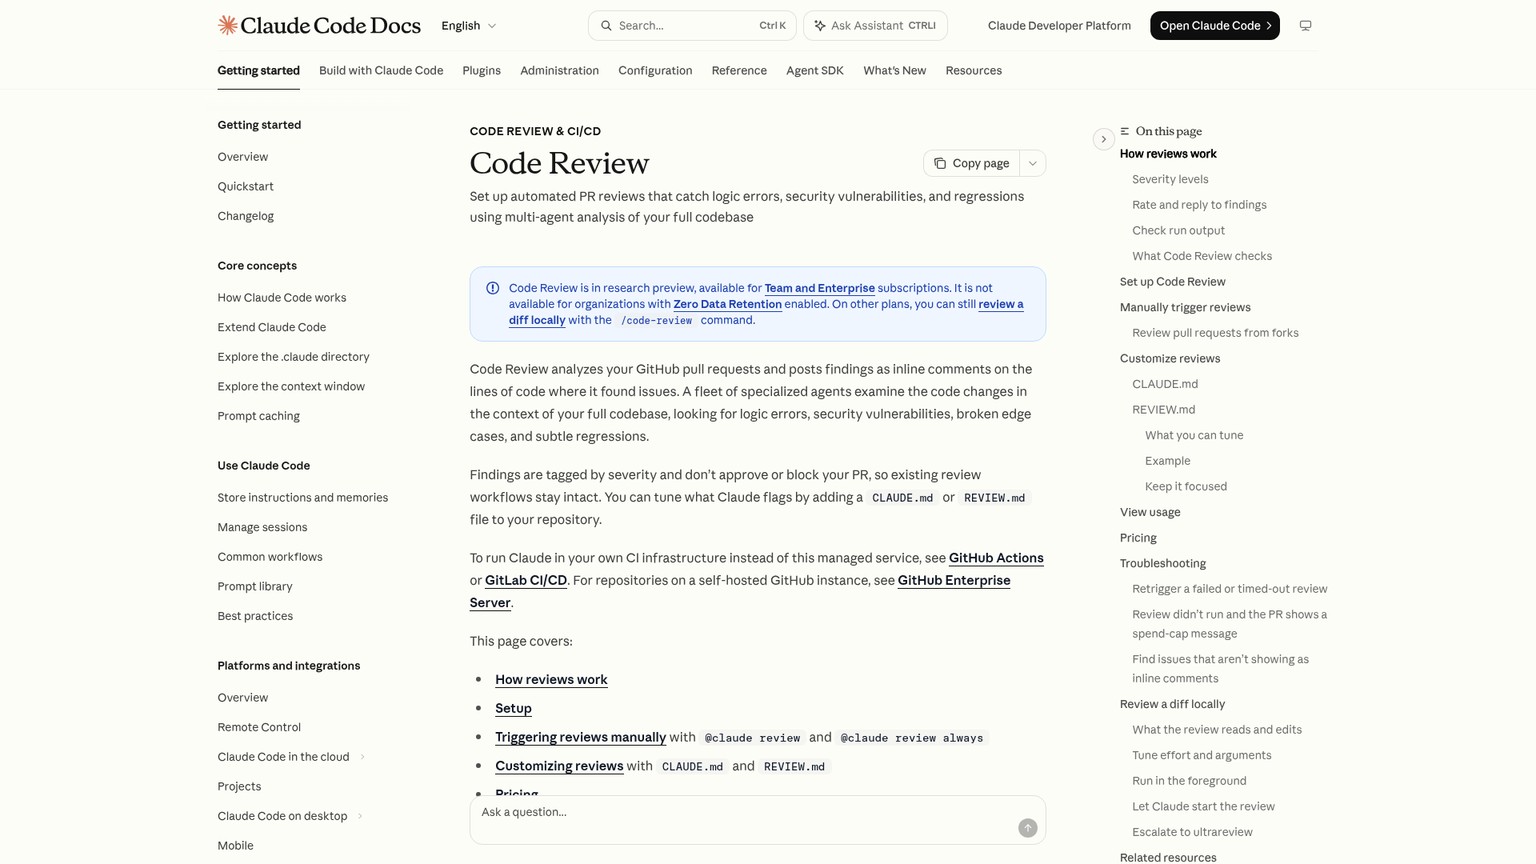
Der verwaltete Dienst ist als Research Preview für Team und Enterprise verfügbar, aber nicht für Organisationen mit aktivierter Zero Data Retention. Seine Token-Abrechnung ist vom enthaltenen Tarifkontingent getrennt. Anthropic nennt einen Durchschnitt von $15 bis $25 pro Review, abhängig von Änderung, Codebasis und Verifikationsaufwand. Preise und Zugangsvoraussetzungen für verwaltete Reviews.
Manuell ausgelöste verwaltete Reviews sind sinnvoll, wenn ein kleines Team Änderungen an Zahlungen, Authentifizierung oder eine schwierige Migration gezielt genauer prüfen lassen will. Ein Review bei jedem Push vervielfacht die Ausgaben. Die monatliche Ausgabenobergrenze des Code-Review-Dienstes sollte gesetzt und das Verhalten bei ihrem Erreichen dem Team klar sein.
Fehlalarme reduzieren und Reviews abstimmen
Das lokale /code-review läuft als Hintergrundreviewer mit eigenem Kontext und kann einen Diff, Branch oder PR prüfen. Niedrigere Aufwandsstufen bevorzugen weniger Befunde mit höherer Sicherheit; breitere Reviews können auch Vorschläge zum Aufräumen des Codes enthalten. Die Fehlerbedingung sollte benannt werden. Optionale Bereinigung bleibt von Problemen getrennt, die eine Freigabe verhindern.
Entscheidend ist die Unterscheidung der Anweisungsdateien. Lokale Reviews lesen CLAUDE.md, nicht REVIEW.md. Verwaltetes Code Review nutzt CLAUDE.md als Projektkontext und REVIEW.md für reviewspezifisches Verhalten. Ein lokales Review übernimmt daher nicht automatisch die sorgfältig formulierten reinen Review-Vorgaben des verwalteten Dienstes.
Für verwaltete Reviews sollte REVIEW.md Schweregrade definieren, bereits durch CI erzwungene Kategorien unterdrücken, generierte Dateien ausnehmen und Quellcode-Belege für Aussagen über das Verhalten verlangen. Die Regeln sollten auch beschreiben, wann eine erneute Prüfung abgeschlossen ist: Sobald ein wesentlicher Befund behoben wurde, sollte neu entdeckte kosmetische Arbeit denselben PR nicht endlos verlängern. Kurze, auf die tatsächlichen Risiken konzentrierte Review-Vorgaben sind leichter zu pflegen als ein allgemeines Programmierhandbuch.
Der verwaltete Dienst genehmigt den PR nicht und blockiert den Merge auch nicht allein aufgrund gefundener Probleme. Sollen Befunde einen Merge verhindern, braucht das Team einen ausdrücklichen Prozess, der sie mit dieser Entscheidung verbindet. Der Autor sollte einen Befund mit Belegen anfechten können; nicht jede Bot-Anmerkung darf automatisch zum Veto werden.
GitHub, GitLab und Datenaufbewahrung
Verwaltetes Code Review ist der GitHub-PR-Dienst. Lokale Reviews können GitLab-Änderungen prüfen und mit einem aktuellen unterstützenden Client und glab Befunde als Merge-Request-Notiz veröffentlichen. Claude kann auch in der eigenen GitLab CI/CD laufen. Diese lokalen oder selbst betriebenen Varianten sollten nicht als gleichwertiger verwalteter GitLab-Bot dargestellt werden.
Die Aufbewahrung hängt von Konto und Dateneinstellung ab. Daten aus den Privatkundentarifen Pro und Max werden fünf Jahre bei erlaubter Modellverbesserung oder 30 Tage ohne diese Erlaubnis aufbewahrt. Für die kommerzielle Nutzung über Team, Enterprise und API wird standardmäßig eine Frist von 30 Tagen genannt. Zero Data Retention für qualifizierte Enterprise-Kunden muss separat aktiviert werden; eine Enterprise-Lizenz schaltet sie nicht automatisch ein. Verwaltetes Code Review unterstützt sie nicht. Datennutzung bei Claude Code.
Lokale CLI-Protokolle werden außerdem im Klartext unter ~/.claude/projects/ gespeichert. Die standardmäßige Bereinigungsfrist von 30 Tagen lässt sich ändern. Für dort fortgesetzte Desktop- oder Cowork-Sitzungen gelten separate Standardausnahmen. Die Übermittlung von Protokollen über /feedback, /bug oder /share eröffnet einen eigenen Aufbewahrungsweg von fünf Jahren. Neben der Speicherung beim Anbieter gehören deshalb auch lokale Dateien und Support-Einsendungen in die Teamrichtlinie.
- Vorhandener kostenpflichtiger Claude-Code-Zugang kann Reviews vor dem Öffnen des PR abdecken.
- Ein eigener Review-Kontext gibt dem Autor eine weitere Prüfung des Diffs.
- Reine Review-Anweisungen des verwalteten Dienstes können Belege verlangen und unnötige Nachprüfungen begrenzen.
- Lokale und selbst betriebene Abläufe ermöglichen den Einsatz mit GitLab.
- Die variablen Kosten pro verwaltetem Durchlauf kommen zu den berechtigten Lizenzen hinzu.
- Lokale und verwaltete Reviews verwenden unterschiedliche Anweisungsdateien.
- Verwaltete Reviews konzentrieren sich auf GitHub und sind mit Zero Data Retention nicht verfügbar.
- Privatkundeneinstellungen, lokale Protokolle und Feedback-Einsendungen haben unterschiedliche Aufbewahrungsfristen.
Sicherheitsorientierte Prüfung: Codex Security
Codex Security: Für Untersuchungen anhand des Bedrohungsmodells
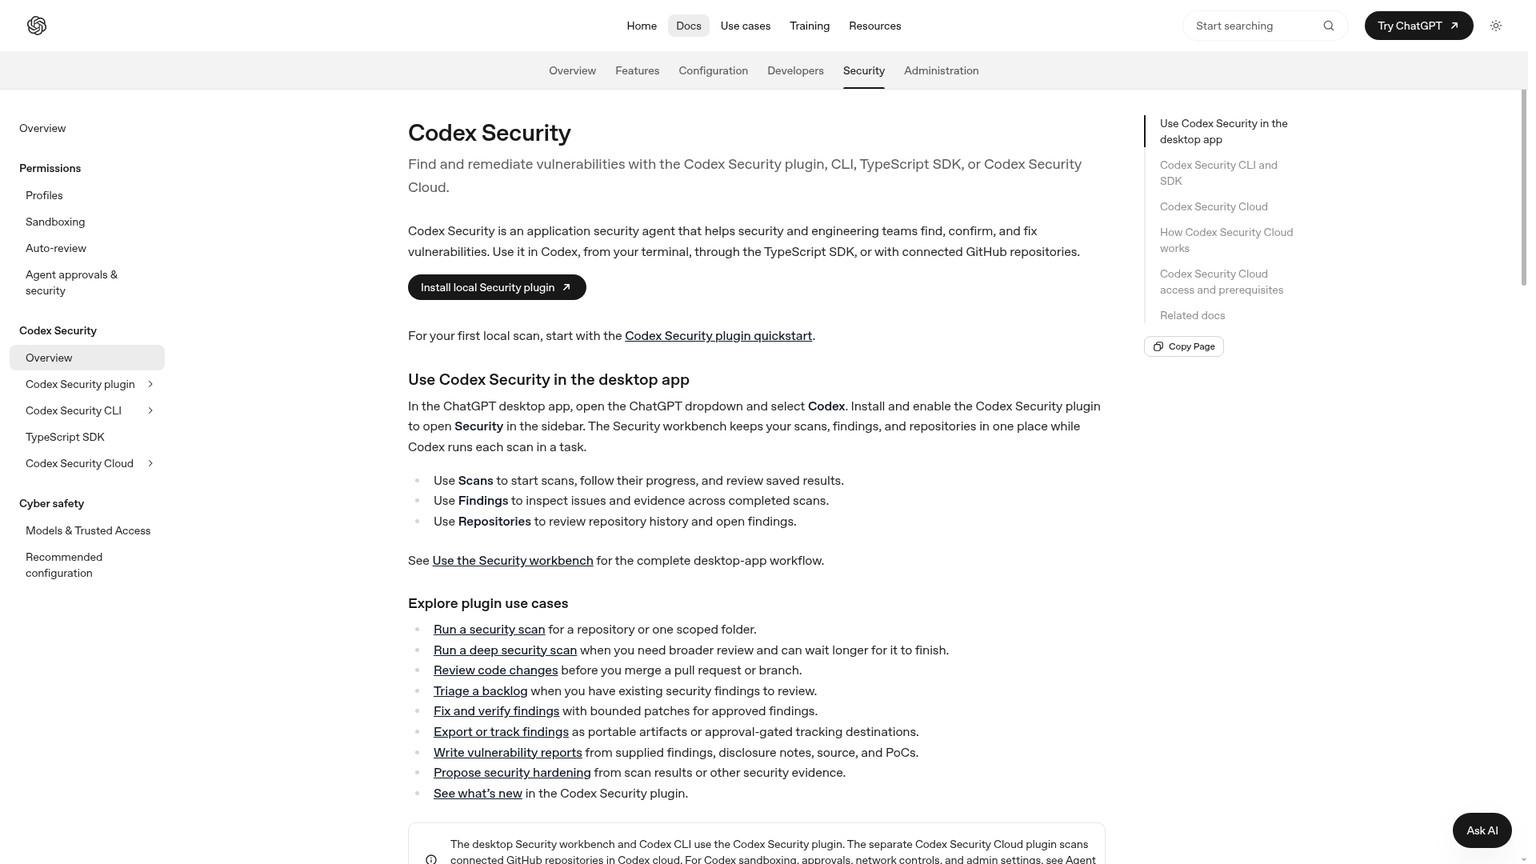
Codex Security ist OpenAIs Agent für Anwendungssicherheit. Er untersucht Schwachstellen mit Repository-Kontext und Bedrohungsmodell. Er passt, wenn das Team klären muss, ob ein Angreifer einen verdächtigen Pfad erreichen und ausnutzen kann. Damit ergänzt er die Prüfung auf funktionale Fehler und die bereits vorhandenen deterministischen CI-Prüfungen.
Urteil: Codex Security für die Sicherheitsfrage einsetzen, mit dokumentiertem Zugang und Meldeschwellen. Ein allgemeines Review ohne Kommentare ist kein Beleg dafür, dass die Anwendung sicher ist.
Besonders geeignet für: Kleine Teams mit Änderungen an Authentifizierung, Autorisierung, nicht vertrauenswürdigen Eingaben oder anderen Sicherheitsgrenzen.
Besonderheit: Untersuchung mit Bedrohungsmodell und Validierungsversuchen sowie getrennten Meldeschwellen für automatische und manuelle Reviews.
Preise: Security Review ist auf Pro, Business, Enterprise und Edu verfügbar; es verbraucht enthaltenes Codex-Kontingent oder ChatGPT-Credits.
Kostenloser Test: Kein garantierter separater Test. Tarifberechtigung und Security-Zugriff des Workspaces müssen geprüft werden.
Tarife und die Kosten für fünf Entwickler
Es gibt kein veröffentlichtes separates Codex-Security-Abonnement mit festem Lizenzpreis, der sich mit fünf multiplizieren ließe. Security Review ist auf Plus nicht verfügbar. Die berechtigten Pro-Basispreise bleiben $100, $200 oder $500 pro Monat, für fünf Lizenzen also $500, $1,000 oder $2,500. Business kostet $25 pro Nutzer monatlich oder umgerechnet $20 bei Jahreszahlung: für fünf $125 beziehungsweise $100. Enterprise und Edu haben individuelle Preise. Der Basispreis kauft den berechtigten Tarif; Security-Zugriff und Credit-Verbrauch müssen weiterhin geprüft werden. Berechtigung für Security Review.
Fehlalarme reduzieren und Reviews abstimmen
Das Bedrohungsmodell sollte Schutzgüter, Vertrauensgrenzen, Fähigkeiten der Angreifer und Sicherheitsannahmen benennen. Ein Reviewer muss bei einem öffentlichen Endpunkt ohne Authentifizierung zu einer anderen Bewertung kommen können als bei einer eingeschränkten Verwaltungsfunktion. Bleibt dieser Kontext unausgesprochen, lässt sich eine spekulative Warnung schwerer klären.
Automatisches Security Review meldet standardmäßig Befunde der Stufen High und Critical; manuelle Anfragen enthalten Medium, High und Critical. Mindestschweregrade lassen sich unabhängig voneinander setzen und pfadspezifisch überschreiben. Die Schwelle bestimmt, welche Befunde auf GitHub veröffentlicht werden. Der vollständige Bericht bleibt in Codex erhalten. Die Kommentarausgabe zu filtern entfernt deshalb nicht den zugrunde liegenden Bericht.
Sicherheitsscans können versuchen, Schwachstellen zu validieren. Ein nicht validierter Befund ist nicht automatisch ein Fehlalarm: Die Umgebung oder der Reproduktionsversuch kann unvollständig sein. Einstiegspunkt, Voraussetzungen eines Exploits und Belege sollten vorliegen, bevor über Korrektur, Unterdrückung oder weitere Untersuchung entschieden wird. Die Security-FAQ erklärt Scan und Validierung.
Die CLI bietet einen Befehl zum Markieren von Fehlalarmen mit einer Fundstellen-ID und Begründung. Dazu kommen ein vom Schweregrad abhängiges Fehlschlagen der CI und eine Obergrenze für geschätzte Kosten. Die Begründung sollte die tatsächliche schützende Bedingung festhalten. Eine geschätzte Obergrenze hilft bei der Arbeitssteuerung, ist aber keine garantierte Rechnungsobergrenze. CLI-Referenz.
GitHub, GitLab und Datenaufbewahrung
Gehostetes Security Review dokumentiert GitHub-Auslöser wie @codex security review, die Prüfung beim Öffnen eines PR, bei jedem Push oder gemeinsam mit dem allgemeinen Code-Review. Die lokale CLI kann in GitLab CI/CD laufen und SARIF ausgeben, ein standardisiertes maschinenlesbares Format für Sicherheitsbefunde. Das ist ein dokumentierter Sicherheitsweg für GitLab. Daraus folgt kein nativer gehosteter GitLab-Security-Bot, der der allgemeinen Codex-Beta entspricht.
Cloud-Scans verwenden temporäre isolierte Repository-Container und zerstören sie nach dem Extrahieren der Ergebnisse. Die Berichte und extrahierten Artefakte bestehen weiterhin. Es gilt die Aufbewahrungsrichtlinie des Workspaces. Ein kurzlebiger Ausführungscontainer macht den gesamten Dienst nicht zu einem Angebot ohne Datenaufbewahrung.
Die CLI speichert Scan-Ausgaben standardmäßig auch unter $CODEX_HOME/state/plugins/codex-security/scans/, einschließlich einer lokalen Workbench-Datenbank. Die Löschung dieser Dateien und veröffentlichter CI-Artefakte liegt beim Team. Ein Schwachstellenbericht kann sensible Codepfade offenlegen, selbst wenn der Repository-Klon bereits entfernt wurde.
- Das Bedrohungsmodell lenkt die Untersuchung auf erreichbare Sicherheitsrisiken.
- Validierung kann mehr Belege liefern als ein spekulativer Codekommentar.
- Getrennte Meldeschwellen reduzieren automatische Unterbrechungen durch Befunde niedriger Schwere.
- CLI und GitLab CI/CD ermöglichen einen selbst betriebenen Sicherheitsablauf.
- Plus enthält Security Review nicht; auch berechtigte Tarife benötigen freigeschalteten Zugang.
- Der Dienst ersetzt weder allgemeine Fehlerprüfung noch deterministische Sicherheitschecks.
- GitLab-CI-Unterstützung erfordert eine andere Einrichtung als ein nativer gehosteter Review-Bot.
- Kurzlebige Ausführung hinterlässt dennoch Berichte sowie lokale oder CI-Artefakte, deren Aufbewahrung geregelt werden muss.
Ein echter PR, geprüft von drei Bots
Eine öffentliche Änderung am Negativ-Cache zeigt, warum sich überschneidende Kommentare und spätere Reviews eingeordnet werden müssen. jdx/mise-versions PR #224 wurde am 6. Juni 2026 gemergt und ergänzte Caching für fehlgeschlagene GitHub-Release-Anfragen. Ein Negativ-Cache merkt sich einen Fehler vorübergehend, damit wiederholte Anfragen den vorgelagerten Dienst nicht erneut aufrufen.
CodeRabbit, Greptile und Cursor Bugbot haben alle Kommentare in diesem PR hinterlassen. Der Verlauf enthält erste Reviews und spätere Prüfungen überarbeiteter Commits. Er belegt konkret, welche Probleme die Produkte angesprochen haben. Er ist jedoch kein Experiment, in dem alle drei denselben unveränderten Commit mit identischen Einstellungen erhielten.
CodeRabbit erkannte das Problem beim Erhalten des Fehlers. Schlägt die GitHub-Anfrage fehl und wirft auch der Versuch, diesen Fehler zu speichern, eine Ausnahme, kann die Cache-Ausnahme den hilfreichen ursprünglichen Fehler ersetzen. Ein Aufrufer, der einen Fehler des vorgelagerten Dienstes erwartet, etwa ein fehlendes Release, behandelt den Fehlschlag dann womöglich falsch. Der Bot benannte ein eng umrissenes Problem und verlangte nicht bloß allgemein eine Umstrukturierung.
Greptile erkannte den Geltungsbereich der Anfragenbegrenzung. Ein 403 kann bedeuten, dass ein bestimmtes Token sein Rate Limit erreicht hat. Wird das als Fehler der angefragten Ressource gecacht, verhindert es die Token-Rotation, obwohl ein anderes Token erfolgreich sein könnte. In dieser Implementierung konnte daraus ein fünfminütiges Fehlerfenster entstehen. Greptile verlangte außerdem Tests für Ablauf und fehlerspezifische Lebensdauern. Diese Testforderung betrifft die Abdeckung und ist kein weiterer unabhängig belegter Laufzeitfehler.
Bugbot erkannte veralteten Zustand und später einen weiteren Randfall. Die erste Warnung betraf ein negatives Ergebnis, das nach einem erfolgreichen Abruf hätte gelöscht werden müssen. Bugbot sprach auch den 403 wegen des Rate Limits an und überschnitt sich damit mit Greptile. Nach der ersten Korrektur wies ein späterer Bugbot-Kommentar auf eine sekundäre Rate-Limit-Antwort hin, die über Retry-After erkannt wird und vom überarbeiteten Klassifizierer weiterhin übersehen wurde.
Der erste Folgepatch schützt den ursprünglichen Fehler vor Fehlern beim Cache-Schreiben, löscht den Negativ-Cache nach Erfolg, verhindert Negativ-Caching erkannter Rate Limits und ergänzt passende Tests. Der nächste Patch berücksichtigt Retry-After bei der Rate-Limit-Klassifizierung und testet dies. Diese geprüften Codeänderungen stützen den praktischen Nutzen der Kommentare.
KI-Code-Review-Benchmark: Was dieser PR tatsächlich zeigt
Dieser PR erlaubt einen Vergleich einzelner Befunde, aber keine Rangliste der Anbieter. CodeRabbit lieferte einen Hinweis zur Fehlerbehandlung. Greptile und Bugbot überschnitten sich bei einem Rate-Limit-Problem. Bugbots späterer Durchlauf prüfte eine geänderte Implementierung und fand einen weiteren Randfall. Einfach Kommentare zu zählen würde die Zahl eigenständiger Fehler übertreiben und die unterschiedlichen Eingaben ausblenden.
Der Thread enthält keinen von Menschen vollständig bewerteten Satz aus richtigen und falschen Befunden. Er kann deshalb weder die Fehlalarmquote noch die Erkennungsquote der einzelnen Tools belegen. Korrekturen nach Kommentaren sind nützliche Hinweise, zeigen aber nicht jeden übersehenen Defekt. Für einen CTO folgt daraus: Handlungsrelevante Befunde, Überschneidungen und das Verhalten bei erneuten Reviews prüfen und anschließend einen vergleichbaren Pilotversuch mit eigenen Änderungen durchführen.
Welches Tool passt zu welchem Team?
Zuerst den Review-Ort wählen, den das Team verlässlich betreiben kann, dann die dort anfallende Arbeit bepreisen. Die erste Auswahlliste sollte klein genug bleiben, dass das Team Befunde bewerten kann und nicht nur Integrationen installiert.
KI-Code-Reviews auf GitHub
CodeRabbit Essentials wählen, wenn unmittelbar ein dedizierter automatischer Reviewer für gewöhnliche private PRs benötigt wird und seine Grenzen zur Arbeitslast passen. $150 monatlich für fünf Entwickler ergeben ein klares Grundbudget und direkte Möglichkeiten zur Abstimmung.
Greptile wählen, wenn repositoryspezifische Review-Regeln und Verzeichniseinstellungen den zusätzlichen Aufwand für Credits je Autor rechtfertigen. Mit einer festgelegten Aufwandsstufe und Flex-Obergrenze beginnen. Die Befunde bei typischen Änderungen mit CodeRabbit vergleichen; der öffentliche PR entscheidet diesen Einkauf nicht für die eigene Codebasis.
Bugbot wählen, wenn Cursor bereits den Programmierablauf bildet und das Team den Wechsel zwischen Prüfung vor dem Push, PR-Diskussion und Korrekturen schätzt. Bei vorhandenen Lizenzen zählen die zusätzlichen Review-Kosten. Ohne vorhandene Lizenzen muss die gesamte Rechnung aus Abonnement und Nutzung bewertet werden.
KI-Code-Reviews auf GitLab
CodeRabbit und Greptile bieten direkte GitLab-Reviews; Anforderungen an selbstverwaltete Bereitstellungen müssen mit den jeweiligen Tarifen abgeglichen werden. Bugbot dokumentiert ebenfalls GitLab und Self-Hosted. Für eine herkömmliche Bot-Installation sind diese nativen Wege der erste Ansatz.
Codex dokumentiert inzwischen native GitLab-Reviews in der Beta, einschließlich selbstverwalteter Einrichtung. Der Test sollte auf dem Host und mit dem Berechtigungsmodell stattfinden, die das Team tatsächlich nutzt. Lokale Reviews mit Claude Code und selbst betriebene CI sind gültige GitLab-Optionen, müssen aber durch den eigenen Arbeitsablauf ausgeführt werden. Ebenso ist Codex Securitys dokumentierter GitLab-CI-Weg eine selbst betriebene Sicherheitsintegration und keine Zusage für einen gehosteten GitLab-Security-Bot.
Welches Review-Tool lohnt sich bei einem vorhandenen Agent-Abo?
Zunächst Codex oder lokales Claude Code einsetzen, wenn der Autor vor der Übergabe der Änderung zuverlässig eine Prüfung anfordern kann. Der Coding-Agent-Zugang ist bereits bezahlt. Entscheidend ist, ob zusätzlicher Verbrauch und Befunde nützlich sind. Die passenden Anweisungen gehören in die Dateien, die diese Review-Variante tatsächlich liest.
Ein automatischer PR-Reviewer wird zur besseren Wahl, sobald das manuelle Auslösen unzuverlässig ist oder Reviewer zu jeder Änderung eine dauerhafte gemeinsame Diskussion brauchen. Ein etwas günstigeres Abo gleicht Reviews, die vergessen werden, nicht aus. Umgekehrt lässt sich ein zweiter automatischer Dienst schwer rechtfertigen, wenn der vorhandene Review-Weg regelmäßig handlungsrelevante Defekte findet, ohne eine weitere Kommentarwarteschlange zu erzeugen.
Verwaltete Claude-Reviews gezielt einsetzen, wenn eine Änderung die zusätzlichen Verifikationskosten rechtfertigt. Codex Security für Sicherheitsgrenzen und Untersuchungen ergänzen, mit ausdrücklich geklärtem Zugang und Umgang mit Berichten. Keine der Anschaffungen sollte mit einer allgemeinen Modellrangliste begründet werden.
Welche KI-Code-Review-Tools sind kostenlos?
Greptile Starter ist ein echter kostenloser Einstieg für einen aktiven Entwickler, nicht für fünf. CodeRabbit Free bietet bei privaten PRs Zusammenfassungen statt des vollständigen privaten Review-Produkts; seine Open-Source- und lokalen Kontingente können dennoch nützlich sein. Der eingeschränkte Codex-Zugang über Free und Go sollte nicht mit demselben automatischen GitHub-Kontingent wie Plus gleichgesetzt werden. Die dokumentierte Berechtigung zur GitLab-Beta ist eine separate Aussage. Claude Free ist keine kostenlose Claude-Code-Lizenz.
Ein privates Team mit fünf Personen sollte zunächst bereits bezahlten Zugang nutzen und die tatsächlichen Grenzen prüfen. „Kostenlos zu installieren“ und „jeden privaten PR kostenlos prüfen“ sind unterschiedliche Budgetversprechen.
Fehlalarme: Review-Vorgaben vor dem Pilotversuch festlegen
Unnötiges Review-Feedback hat verschiedene Ursachen, und nur ein Teil davon sind Fehlalarme. Ein Fehlalarm behauptet einen Defekt, der unter den tatsächlichen Bedingungen des Programms nicht auftritt. Ein zutreffender kosmetischer Vorschlag kann trotzdem wenig nützen. Ein doppelter Befund wiederholt Arbeit, die bereits diskutiert wird. Ein spekulativer Sicherheitshinweis muss womöglich erst untersucht werden, bevor sich eine solche Einordnung begründen lässt.
Jeder handlungsrelevante Kommentar zu einem funktionalen Fehler sollte das geänderte Verhalten, den erreichbaren Ausführungspfad, die Auswirkungen und die Quellcode-Belege benennen. Ein konkreter Aufrufer oder Test hilft mehr als eine selbstbewusste Schweregradmarkierung. Der Autor sollte einen strittigen Befund erklären; bei wichtigen Fällen sollte ein weiterer Entwickler die Meinungsverschiedenheit klären.
Ein Pilot kann mit 20 repräsentativen PRs beginnen. Das ist ein vorgeschlagener Bewertungsumfang, keine Produktgrenze. Enthalten sein sollten typische Änderungen des Teams: gewöhnliche Anpassungen, eine Migration, Fehlerbehandlung und eine Sicherheitsgrenze. Für die verglichenen Bots müssen Commit, Anweisungen und Auslösereinstellungen gleich bleiben. Eigenständige Befunde als nützlich, falsch, bereits abgedeckt oder zutreffend, aber zu unwichtig einordnen; ungeprüfte Bedenken getrennt halten.
Gemessen werden sollte die tatsächlich entstandene Arbeit: Welche Befunde haben den Patch oder seine Tests verändert, welche brauchten Klärung, welche wurden ignoriert? Dieselbe Grundursache über mehrere Tools hinweg nur einmal zählen. Im öffentlichen PR war die erneute Meldung des Rate-Limit-Cache-Fehlers durch einen anderen Reviewer eine Bestätigung, kein weiterer unabhängiger Defekt.
Die konkrete Ursache unnötigen Feedbacks gezielt bearbeiten. CodeRabbits Profil begrenzt Hinweise; Greptiles Strictness und Kategorien begrenzen veröffentlichte Kommentare. Bugbot braucht eigene Anweisungen und sinnvolle Auslöser, Codex geltende Review-Regeln und Claude die passende Datei für lokale oder verwaltete Reviews. Codex Security braucht Bedrohungsannahmen und Belege. Mehr Aufwand ohne klarere Eingaben kann mehr Arbeit erzeugen, ohne die Entscheidung zu verbessern.
Die Regel zur menschlichen Freigabe muss ausdrücklich feststehen. Ein stiller Bot kann Befunde gefiltert, einen Pfad übersprungen, sein Kontingent erschöpft oder die Änderung nicht verstanden haben. Keine Kommentare bedeuten kein vollständiges Audit.
Wie wurden die Tools ausgewählt?
Diese sechs Produkte decken die hier betrachteten Review-Orte ab: dedizierte PR-Bots, den Reviewer eines Editor-Anbieters, Coding-Agenten und sicherheitsorientierte Untersuchungen. Die Auswahl bevorzugt einen Arbeitsablauf, den ein kleines Team übernehmen kann, berechenbare Kosten und Kontrollen, mit denen sich irrelevantes Feedback bestreiten oder reduzieren lässt.
Preise, Tarifnamen und Funktionen wurden am 2. Oktober 2026 anhand primärer Anbieterseiten geprüft. Die Summen für fünf Entwickler und die gleichmäßig verteilten Review-Szenarien sind daraus berechnet. Die Belege zum echten PR stammen aus geprüften öffentlichen Bot-Kommentaren und Diffs der Folgecommits. Die Produkte wurden anhand von Dokumentation und öffentlichen Belegen verglichen; private Praxistests wurden für diesen Artikel nicht durchgeführt.
Benchmark-Behauptungen der Anbieter haben die Empfehlungen nicht bestimmt. Ein Ergebnis auf einer anderen Code-Sammlung belegt weder unnötiges Feedback noch Integrationsaufwand oder Rechnung für das eigene Repository. Die stärksten Belege hier sind enger gefasst: konkrete Befunde in einem nachvollziehbaren PR, aktuelle Einstellungen und ausdrückliche Budgetannahmen.
Ein breiterer Katalog könnte weitere Bots und statische Analysewerkzeuge enthalten. Ohne dieselbe Prüftiefe würden zusätzliche Einträge die Entscheidung jedoch weniger hilfreich machen. Kein aktiver Affiliate-Partner passt überzeugend in diese KI-Reviewer-Auswahl; deshalb wurde keiner als bezahlte Empfehlung eingefügt. Tool-Links folgen dem üblichen monetarisierten Linksystem der Website, sofern ein passendes Programm existiert. Die kommerzielle Verfügbarkeit hat das Urteil nicht bestimmt.
Welche Kaufentscheidungen sind zu vermeiden?
CodeRabbit Free nicht als verpflichtenden Reviewer für funktionale Fehler in privatem Code einplanen. Eine Zusammenfassung liefert nicht das kostenpflichtige Review, das hier beschafft werden soll. Stattdessen den kostenpflichtigen Tarif testen und die Befunde bewerten.
Greptile nicht als „$30 für unbegrenzte Reviews“ kaufen. Aufwand, erneute Durchläufe und nicht übertragbare Autorenkontingente verändern die Kosten. Vor einem breiten automatischen Einsatz eine Flex-Obergrenze wählen.
Neue Bugbot-Käufe nicht mit dem früheren separaten Lizenzpreis kalkulieren. Relevant sind die aktuelle nutzungsabhängige Abrechnung, das Cursor-Abonnement des Teams und mögliche Autofix-Aktivität.
Verwaltete Claude-Reviews nicht bei jedem gewöhnlichen Push einsetzen, wenn die zusätzliche Nutzungsrechnung nicht ins Budget passt. Die lokale Review-Variante ist eine andere Kaufentscheidung. Der verwaltete Dienst sollte Arbeit vorbehalten bleiben, deren Risiko die geschätzten Kosten rechtfertigt.
Codex Security nicht als Ersatz für allgemeines Review kaufen. Es untersucht eine Sicherheitsfrage und benötigt berechtigten Zugang. Es entscheidet nicht, ob ein Feature die Produktanforderung erfüllt oder eine betriebliche Migration akzeptabel ist.
Keine Konfiguration sollte die Bot-Freigabe zur einzigen Merge-Entscheidung machen. CI, menschliches Review und die Möglichkeit, einen Befund anzufechten, müssen mit dem tatsächlichen Veröffentlichungsrisiko verbunden bleiben.
Häufige Fragen
Gibt es KI-Tools für Code-Reviews?
Ja. CodeRabbit und Greptile prüfen angebundene PRs, Cursor Bugbot verbindet Reviews mit Cursors Arbeitsablauf, und Codex sowie Claude Code können Änderungen als Coding-Agenten prüfen. Codex Security ergänzt einen enger gefassten Weg zur Untersuchung von Schwachstellen. Vor dem Preisvergleich sollten Ort der Prüfung und Verhalten bei der Befundmeldung feststehen.
Welche KI eignet sich am besten für kleine Teams?
CodeRabbit Essentials ist hier die Standardempfehlung für ein kleines Team, das einen dedizierten Bot für regelmäßiges automatisches PR-Feedback sucht: $150 monatlich für fünf Entwickler innerhalb der Tarifgrenzen. Ein vorhandener Codex- oder Claude-Code-Ablauf ist der bessere Einstieg, wenn das Team Reviews bereits zuverlässig anfordert. Sicherheitsarbeit benötigt eine eigene Entscheidung über den Prüfungsumfang.
Kann ChatGPT Code prüfen?
Ja. ChatGPT kann bereitgestellten Code besprechen; Codex bietet mit berechtigtem Zugang einen Coding- und Review-Ablauf mit Repository-Kontext. Eine Chat-Antwort zu einem eingefügten Ausschnitt hat anderen Kontext als ein angebundenes Codex-Review. Die Dateneinstellungen des Kontos sollten geprüft werden. Es darf nicht angenommen werden, dass das Modell Dateien untersucht hat, die es nie erhalten hat.
Welche 5 Code-Review-Tools kommen infrage?
Die fünf hier verglichenen Optionen für allgemeine Reviews sind CodeRabbit, Greptile, Cursor Bugbot, Codex code review und Claude Code. Codex Security ist das sechste vorgestellte Produkt und erfüllt eine separate Sicherheitsaufgabe. Die Gliederung folgt dem Arbeitsablauf, keiner allgemeinen Benchmark-Rangliste.
Ist Code-Review durch KI überflüssig geworden?
Nein. KI-Reviews können Defekte erkennen und Autoren bei der Vorbereitung einer Änderung unterstützen. Das Team muss aber weiterhin Produktabsicht, Betriebsrisiken und akzeptable Zielkonflikte bewerten. Menschliche Freigabe und CI liefern zudem Belege, die das bloße Ausbleiben von Bot-Kommentaren nicht ersetzen kann.
Worin unterscheiden sich Copilot und CodeRabbit beim Code-Review?
GitHub Copilot code review ist Teil von GitHubs Assistenten-Arbeitsablauf. CodeRabbit ist dagegen ein dedizierter Reviewer mit dokumentierten GitHub- und GitLab-Integrationen und eigener Review-Konfiguration. Beide benötigen den richtigen Repository-Kontext und Regeln für strittige Befunde. Die GitHub-Dokumentation zu Copilot-Reviews beschreibt, wie Reviews angefordert und verwendet werden.
Warum sind manche mit Copilot unzufrieden?
Für die Vorlieben aller Nutzer gibt es keine einzelne belastbare Erklärung. Für einen CTO zählt, ob dem Reviewer Repository-Kontext fehlt, ob er bestehende Prüfungen wiederholt oder Kommentare erzeugt, mit denen das Team nichts anfangen kann. Diese Ergebnisse sollten an eigenen PRs verglichen werden. Eine Beschwerde oder Anbieterbehauptung ist keine gemessene Fehlalarmquote.
Kann Copilot Code-Reviews durchführen?
Ja. GitHub dokumentiert das Anfordern von Copilot-Reviews und den Umgang mit dem Feedback. Allein seine Verfügbarkeit macht Copilot aber weder zur automatischen Wahl für GitLab noch zum Ersatz für eine dedizierte Sicherheitsuntersuchung. Maßstab bleibt der tatsächlich benötigte Arbeitsablauf.
Gibt es für Code-Reviews eine bessere KI als Copilot?
Für ein bestimmtes Team kann ein anderes Tool besser passen. CodeRabbit oder Greptile können den Bedarf an einem dedizierten PR-Bot erfüllen, Bugbot kann zu einem Cursor-Ablauf passen, und ein vorhandener Coding-Agent kann das Review vor dem Push abdecken. Entscheidend sind handlungsrelevante Befunde, unnötiges Feedback, Host-Unterstützung und tatsächliche Ausgaben. Kein Anbieterbenchmark beantwortet alle diese Fragen.
Mit der Einrichtungscheckliste für Claude Code und Codex lässt sich der Coding-Agent-Arbeitsablauf aufbauen, bevor ein weiteres Review-Abonnement hinzukommt.
- Zuletzt aktualisiert
- 2. Okt. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
KI E-Mails schreiben: Welcher Assistent lohnt sich 2026?
Mit KI E-Mails schreiben, den Posteingang filtern und alte Absprachen finden: Fyxer, SaneBox und weitere Assistenten im Preis- und Datenschutzvergleich.2. Okt. 2026AI
Granola-Alternative finden: Welches Meeting-Tool passt?
Welche Granola-Alternative passt? Circleback, MeetGeek, Krisp und weitere Tools im Vergleich: Windows, botfreie Aufnahmen, Teamfunktionen und Preise.1. Okt. 2026AI
Gamma Kosten 2026: Welcher Tarif lohnt sich wann?
Gamma Kosten im Vergleich: Free, Plus, Pro und Ultra mit Preisen in USD, Credits, Exporten und Teamkosten. So lässt sich das passende Abo gezielt auswählen.1. Okt. 2026AI
Wispr Flow Kosten 2026: Welcher Tarif lohnt sich?
Was Wispr Flow für Einzelne und Teams kostet: Gratislimits, Monats- und Jahrespreise, Bildungsrabatte und günstigere Diktieralternativen im Vergleich.1. Okt. 2026AI
Meta Muse: KI für kleine Unternehmen richtig einsetzen
Meta Muse für kleine Unternehmen einrichten: Konten verbinden, Wochenberichte prüfen und Freigaben festlegen. Mit Preisen, Grenzen und einem Praxisbeispiel.1. Okt. 2026AI
Gemini 4 Argon: Was der Wechsel kostet und wann er sich lohnt
Gemini 4 Argon hat begrenzten Zugang und später höhere Preise. Was API-Kosten, Benchmarks und Ausgabelimit für eine fundierte Wechselentscheidung bedeuten.1. Okt. 2026AI
Wispr Flow: Kosten, Erfahrungen und Grenzen (Oktober 2026)
Wispr Flow im Überblick: aktuelle Preise, Nutzerberichte, Coding-Prompts und Datenschutz. Wann Free reicht, Pro sich lohnt oder Superwhisper besser passt.1. Okt. 2026AI