OpenAI Pricing 2026: Mit GPT-6.1 Sol das API-Budget planen
OpenAI-API-Kosten für GPT-6.1 Sol, Luna und Astra: drei Monatsbudgets mit Tokenpreisen, Suche, Containern sowie Sprach- und Bildverarbeitung.



Die Tarife auf OpenAI Pricing machen GPT-6.1 Sol zum sinnvollen Ausgangspunkt für den Coding-Agenten eines kleinen Teams: $2 pro Million Eingabetokens, $0.10 für Eingaben aus dem Cache und $10 für die Ausgabe. In den folgenden monatlichen Budgetbeispielen kostet die angegebene API-Nutzung insgesamt $159.40, wenn klar abgegrenzte Supportaufgaben und Zusammenfassungen per Batch an GPT-6 Luna gehen und Sol die Programmierarbeit übernimmt. GPT-6 Astra lohnt sich, wenn die eingesparte Arbeit seine höheren Kosten rechtfertigt.
Am 3. Oktober 2026 anhand der aktuellen API-Preisseite von OpenAI geprüft. Sämtliche Anbietertarife stammen von dieser Seite. Die Nutzungsmengen sind ausdrücklich als Annahmen ausgewiesen; die Kosten wurden mit diesen Tarifen berechnet.
Die OpenAI API ist die Schnittstelle, die eine Anwendung aufruft und deren Nutzung nach Verbrauch abgerechnet wird. Die Rechnung hängt davon ab, welche Daten in das Modell eingehen, welche es ausgibt und welche kostenpflichtigen Tools die Anwendung nutzt.
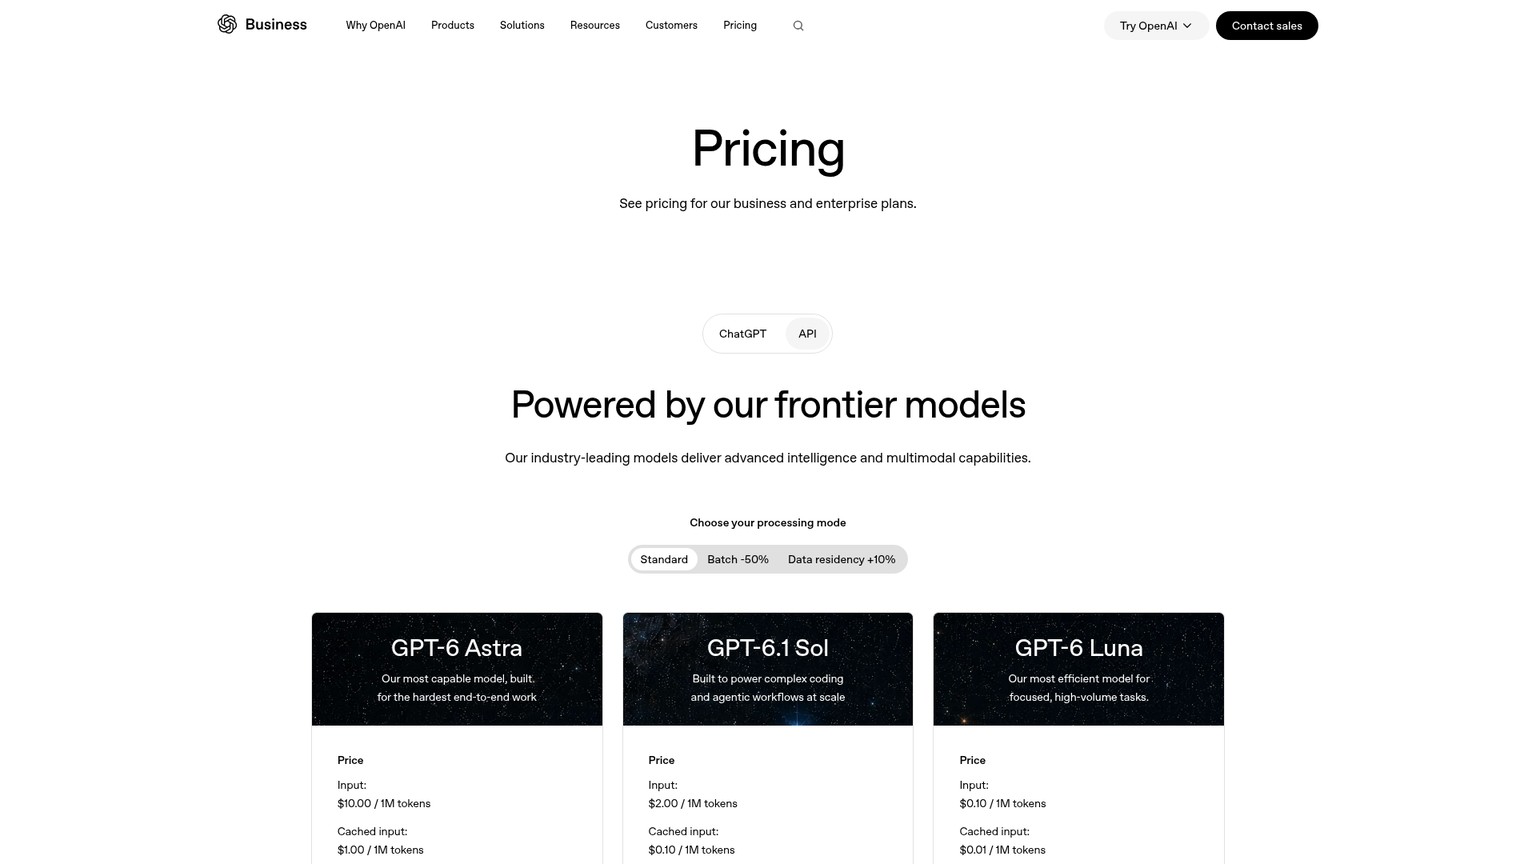
OpenAI Pricing: Welche API-Tarife gelten?
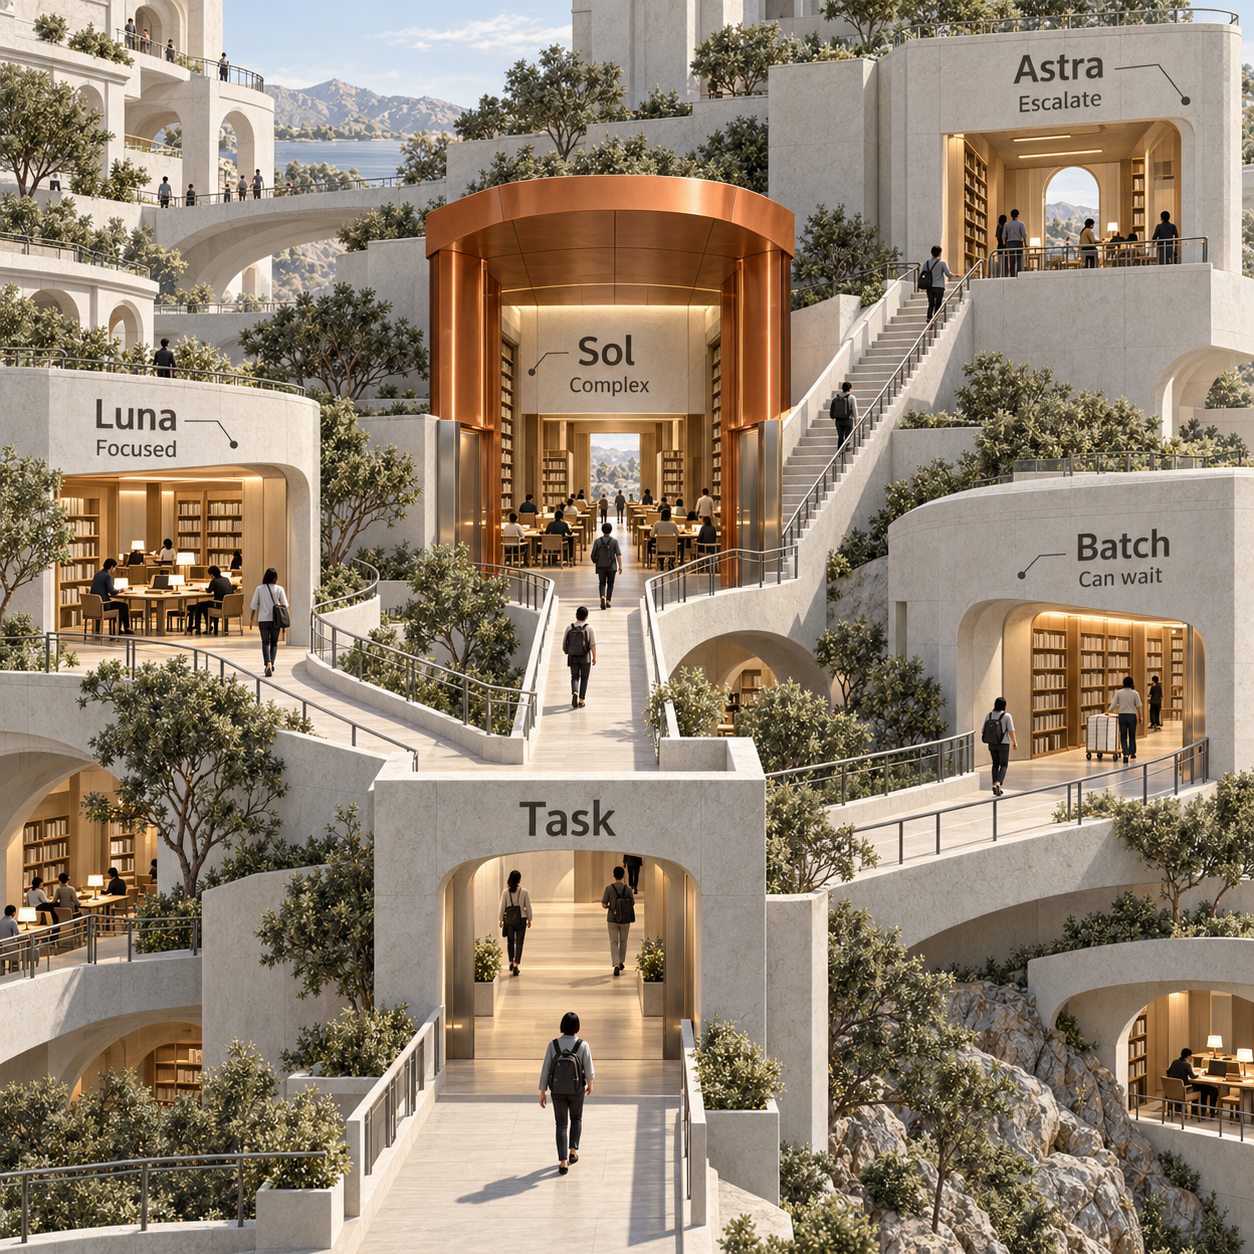
GPT-6.1 Sol kostet pro Million Tokens $2 für die Eingabe, $0.10 für Eingaben aus dem Cache und $10 für die Ausgabe. OpenAI positioniert das Modell für anspruchsvolle Programmieraufgaben und Workflows mit Agenten. GPT-6 Luna richtet sich an klar abgegrenzte Aufgaben mit hohem Volumen, GPT-6 Astra an die schwierigsten Aufgaben, die vollständig bearbeitet werden sollen.
Die Tabelle enthält sämtliche Modelle, die im abgerufenen API-Preisbereich aufgeführt waren. Sie ist kein historischer Modellkatalog. Die Tokenpreise sind in USD pro 1M Tokens angegeben. Bei zeitabhängigen Tarifen stehen Minuten und Sekunden ausdrücklich dabei. Die Tarife der drei führenden Textmodelle gelten für die Standard-Verarbeitung bei Kontextlängen unter 272K. Gemeint ist die Datenmenge, die ein einzelner Request mitführt. Diese Grenze bestimmt den Preis; sie sagt nichts über die maximale Kontextlänge der Modelle aus.
Quelle: OpenAI-API-Preise, geprüft im Oktober 2026. „Nicht angegeben“ bedeutet, dass die Quelle diesen Tarif nicht nennt. Daraus folgt kein kostenloses Ausgabekontingent. „Nicht aufgeschlüsselt“ bedeutet, dass der angezeigte Preis zeitabhängig ist und nicht nach Ein- und Ausgabe von Tokens getrennt wird.
GPT-6 Sol ist in den API-Preiszeilen dieser Seite nicht aufgeführt. Der Name bezeichnet ein anderes Modell als GPT-6.1 Sol. Deshalb ordnet diese Bestandsaufnahme dem älteren Modell keinen Preis zu und übernimmt auch nicht stillschweigend die Tarife des neueren Modells. Modelle und Abrechnungsgrößen, die in der Quelle fehlen, darunter Embedding-Tarife, bleiben außerhalb dieser Preisübersicht.
Mit welchem Modell sollte ein kleines Team starten?
Für einen Coding-Agenten oder eine vielseitige Anwendung ist GPT-6.1 Sol der Ausgangspunkt. Ein Modellwechsel sollte sich an erfolgreich abgeschlossener Arbeit messen lassen. Diese Empfehlung ergibt sich aus der Positionierung des Anbieters und den Budgetrechnungen, nicht aus einer unabhängig ermittelten Rangliste der Modellleistung.
Sols Tarife für ungecachte Eingaben und Ausgaben liegen bei einem Fünftel der Astra-Tarife. Bei Eingaben aus dem Cache ist es ein Zehntel. Für kleine Teams, die den Kontextbedarf ihres Agenten noch ermitteln, bietet Sol damit eine brauchbare Basis: Erst lässt sich die geleistete Arbeit bewerten, bevor bei jedem Request der Aufpreis für Astra anfällt.
Luna eignet sich als Kandidat für eng umrissene Aufgaben mit klaren Abnahmekriterien. Ein Supportklassifikator, der eine bekannte Kategorie auswählt, oder ein Zusammenfassungsmodell, dessen Ausgabe sich anhand der Quelle prüfen lässt, passt eher dazu als eine offene Programmieraufgabe. Das sind vorgeschlagene Einsatzmuster, keine Aussagen darüber, dass eines der Modelle die eigenen Prüfungen bereits bestanden hätte. Lunas niedriger Tarif verliert seinen Nutzen, sobald fehlgeschlagene Arbeit mehr kostet, als die Tokens einsparen.
Astra sollte für Aufgaben verfügbar bleiben, bei denen Fehler teuer werden. Im folgenden Programmierbeispiel kostet Astra bei identischer abgerechneter Nutzung $410 pro Monat mehr als Sol. Der Wechsel rechnet sich, wenn er Nacharbeit im Wert von mehr als diesem Betrag vermeidet. Ein hoher Preis allein belegt das nicht.
Teams, die bereits GPT-6 Sol verwenden, sollten ihre bisherige Budgetplanung beibehalten, bis sich die tatsächlich abgerechnete Nutzung und die abgenommenen Ergebnisse mit GPT-6.1 Sol vergleichen lassen. Diese Seite enthält keinen Tarif für das ältere Sol, aus dem sich eine Ersparnis durch die Migration berechnen ließe.
Was kostet eine Million Tokens?
Für eine Million OpenAI-Tokens gibt es keinen einheitlichen Preis. Ein Token ist eine Einheit der vom Modell verarbeiteten Daten. Die Eingabe umfasst das an das Modell gesendete Material, die Ausgabe das erzeugte und abgerechnete Material. Eingaben aus dem Cache sind wiederverwendete Eingaben, die die API zum günstigeren Cache-Tarif abrechnet.
Eine Million ungecachte Eingabetokens plus eine Million Ausgabetokens kosten $60 bei Astra, $12 bei Sol oder $0.60 bei Luna. Das sind insgesamt zwei Millionen abgerechnete Tokens. Eine Million Tokens insgesamt, gleichmäßig auf ungecachte Eingabe und Ausgabe verteilt, kosten entsprechend $30, $6 oder $0.30.
Für die Rechnung eines Textmodells müssen neue Eingaben und Eingaben aus dem Cache getrennt werden:
Tokenkosten = neue Eingabe / 1M × Eingabetarif + Eingabe aus dem Cache / 1M × Cache-Tarif + Ausgabe / 1M × Ausgabetarif.
Wenn der Nutzungsbericht die gesamte Eingabe und den Cache-Anteil ausweist, ergibt sich die neue Eingabe aus der Gesamteingabe abzüglich des Cache-Anteils. Wer zunächst alle Eingabetokens zum Tarif für neue Eingaben berechnet und anschließend den Cache-Anteil hinzurechnet, zählt ihn doppelt.
Bei Sol sind Eingaben aus dem Cache 95% günstiger als ungecachte Eingaben. Eine Million Ausgabetokens kosten aber weiterhin genauso viel wie 100 Millionen Eingabetokens aus dem Cache. Eine große Cache-Ersparnis rechtfertigt deshalb keine unbegrenzte Ausgabe. Für das Budget zählt die abgerechnete Ausgabe der gesamten Agentenaufgabe, nicht nur die abschließende Antwort, die der Nutzer sieht.
OpenAI-API-Kosten berechnen: drei Monatsszenarien
Mit der vorgeschlagenen Aufgabenverteilung kosten die drei Szenarien $159.40 pro Monat. Das ist ein Planungsbeispiel für den Betreiber einer kleinen Anwendung, keine gemessene Produktionsrechnung und kein Versprechen, dass die Modelle gleich gute Ergebnisse liefern.
Für jeden einzelnen Request wird angenommen, dass er unter die Standard-Preisbedingung der Quelle mit einem Kontext unter 272K fällt. Die Cache-Mengen stehen für tatsächlich abgerechnete Cache-Treffer. Die Ausgabemengen umfassen sämtliche abgerechneten Ausgaben über alle Aufrufe hinweg. Tool-Nutzung ist enthalten, soweit sie ausdrücklich genannt wird. Abonnements, Hosting und andere nicht angegebene Abrechnungsgrößen sind in diesen Summen nicht enthalten. Die Rechnung basiert auf den aktuellen OpenAI-Tarifen.
Supportbot: $13.90 mit Luna
Angenommen werden 10,000 Gespräche pro Monat. Über alle Aufrufe eines Gesprächs hinweg sind 1,000 neue Eingabetokens, 4,000 Eingabetokens aus dem Cache und 500 Ausgabetokens eingeplant. Daraus ergeben sich monatlich 10M neue Eingabetokens, 40M Eingabetokens aus dem Cache und 5M Ausgabetokens. Hinzu kommen angenommene 1,000 Websuchaufrufe im Monat.
Bei Luna kosten die Tokens:
10 × $0.10 + 40 × $0.01 + 5 × $0.50 = $3.90.
Die Suchaufrufe kosten zusätzlich $10. Insgesamt sind es damit $13.90 beziehungsweise $1.39 pro 1,000 Gespräche. Bei identischer Nutzung kostet Sol $74 für Tokens plus $10 für die Suche, also $84. Astra kostet $390 für Tokens plus $10 für die Suche, also $400.
Luna ist der wirtschaftliche Kandidat, wenn der Bot eine klar abgegrenzte Supportaufgabe übernimmt und seine Antworten die Abnahmekriterien erfüllen. Diese Rechnung setzt voraus, dass das wiederverwendete Material zum Cache-Tarif abgerechnet werden kann. Ohne Cache-Treffer gelten alle 50M Eingabetokens als neue Eingaben: Lunas Tokenkosten steigen dann auf $7.50 und die Gesamtkosten auf $17.50. Diese Auswirkung gehört in die Planung, bevor ein erwarteter Cache-Treffer als Ersparnis angesetzt wird.
Coding-Agent: $140 mit Sol
Angenommen werden 1,000 Programmieraufgaben pro Monat. Über sämtliche Bearbeitungsschritte einer Aufgabe hinweg sind 15,000 neue Eingabetokens, 100,000 Eingabetokens aus dem Cache und 5,000 Ausgabetokens eingeplant. Monatlich ergibt das 15M neue Eingabetokens, 100M Eingabetokens aus dem Cache und 5M Ausgabetokens. Eine Aufgabe kann mehrere Requests umfassen; die Werte beziehen sich auf die gesamte Aufgabe.
Zusätzlich werden 2,000 Websuchaufrufe und 1,000 Containersitzungen angenommen. Jede Sitzung nutzt 1 GB und entspricht der in der Quelle angegebenen Sitzungseinheit von 20 Minuten.
Sols Tokenrechnung lautet:
15 × $2 + 100 × $0.10 + 5 × $10 = $90.
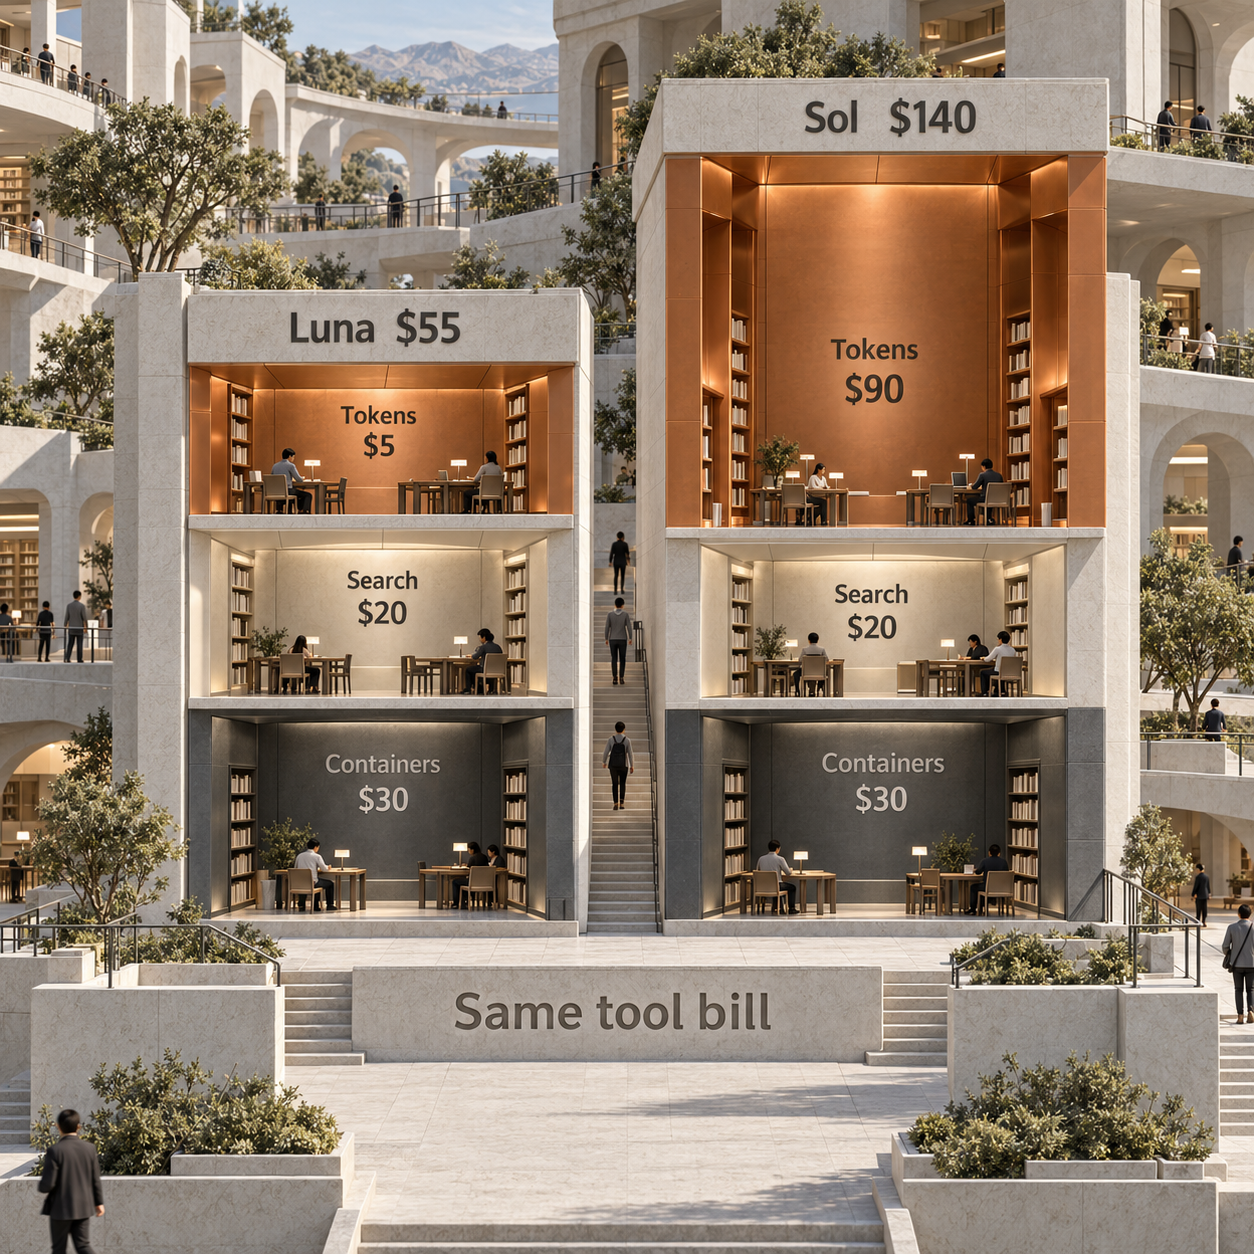
Die Suche kostet $20, die Container kosten 1,000 × $0.03 = $30. Insgesamt sind das $140 pro Monat beziehungsweise $0.14 pro Aufgabe.
Bei identischen abgerechneten Mengen kostet Astra $500 für Tokens plus dieselben $50 für Tools, insgesamt $550. Bei Luna sind es $5 für Tokens plus $50 für Tools, insgesamt $55.
Das günstigere Modell beseitigt die Tool-Kosten nicht. Der Wechsel von Sol zu Luna spart in diesem Beispiel $85 pro Monat. Verursacht die Programmierarbeit dadurch zusätzliche Nacharbeit im Wert von mehr als $85, ist die Ersparnis aufgebraucht. Für den Wechsel zu Astra braucht es den umgekehrten Nachweis: genügend vermiedene Nacharbeit, um den Aufpreis von $410 zu rechtfertigen. Diese Entscheidungsgrundlage liefert ein reiner Tokenpreisvergleich nicht.
Zusammenfassungen per Batch: $5.50 mit Luna
Angenommen werden 20,000 Dokumente pro Monat mit jeweils 4,000 ungecachten Eingabetokens und 300 Ausgabetokens. Das ergibt 80M Eingabe- und 6M Ausgabetokens. Cache-Treffer und Tool-Kosten werden nicht angesetzt. Die Zusammenfassungen können asynchron innerhalb des Zeitfensters von 24 Stunden verarbeitet werden, das die Batch API vorsieht.
Lunas Tokenkosten bei Standard-Verarbeitung wären 80 × $0.10 + 6 × $0.50 = $11. Mit dem in der Quelle genannten Batch-Rabatt von 50% ergeben sich $5.50 pro Monat beziehungsweise $0.275 pro 1,000 Zusammenfassungen.
Dieselben Batch-Mengen kosten $110 mit Sol und $550 mit Astra. Das günstigere Modell passt, solange die Zusammenfassungen den geforderten Standard erfüllen. Einzelne schwierige Dokumente können an ein stärkeres Modell gehen, wenn ihre Korrekturkosten das rechtfertigen. Ein Kunde, der auf eine sofortige Antwort wartet, stellt einen anderen Anwendungsfall dar und sollte nicht als asynchrone Batch-Arbeit budgetiert werden.
Das gesamte Monatsbudget
Die vorgeschlagene Verteilung ergibt $13.90 für Support mit Luna + $140 für Programmierarbeit mit Sol + $5.50 für Batch-Zusammenfassungen mit Luna = $159.40.
Wer Sol für alle drei Aufgaben einsetzt, zahlt $334. Mit Astra für alle drei sind es $1,500. Mit Luna für alle drei sind es $74.40, sofern seine Ergebnisse die Anforderungen erfüllen. Diese Vergleiche halten die abgerechneten Token- und Tool-Mengen konstant. Sie setzen nicht voraus, dass die Modelle in der Praxis gleich viele Versuche brauchen.
Für den Betreiber einer Anwendung entscheidet genau dieser Unterschied über die Rechnung. Ein Modell, das mehr Bearbeitungsschritte benötigt, kann mehr Eingabetokens, Ausgabetokens, Suchaufrufe und Sitzungen verbrauchen. Deshalb sollten zuerst die Kosten pro abgenommenem Gespräch, abgeschlossener Programmieraufgabe oder brauchbarer Zusammenfassung verglichen werden, bevor der niedrigste Tarif auf das gesamte Produkt übertragen wird.
Was kosten die OpenAI Batch API und Datenresidenz?
Batch senkt die aufgeführten Eingabe- und Ausgabekosten um 50%; für Datenresidenz wird ein Aufschlag von 10% angezeigt. Die Preisseite von OpenAI führt diese Verarbeitungsoptionen getrennt von den Standard-Tarifen auf.
Batch verarbeitet Aufgaben asynchron innerhalb von 24 Stunden. Das passt zu nächtlichen Dokumentzusammenfassungen, Kategorisierung und anderen Aufgaben, deren Frist dieses Zeitfenster erlaubt. Im Zusammenfassungsbeispiel wird der Rabatt nur auf neue Eingaben und Ausgaben angewendet. Es setzt also weder einen rabattierten Cache-Tarif noch rabattierte Tool-Gebühren voraus.
Bei Modell-Tokenkosten von $90 ergibt der Datenresidenz-Aufschlag $99, also zusätzliche $9. Dieses Beispiel belegt weder, ob Suche und Container genauso behandelt werden, noch wie sich Datenresidenz mit anderen Verarbeitungsmodi kombinieren lässt. Der Preisbereich enthält nicht genügend Angaben, um diese Kombinationen hier zu berechnen.
Die Seite beschreibt außerdem Fast mode und Flex processing. Fast ist eine nach Verbrauch bezahlte Option für höhere Geschwindigkeit; Flex bietet niedrigere Kosten im Austausch für langsamere Antworten und gelegentliche Nichtverfügbarkeit. Für beide nennt dieser Bereich keine genauen Tarife. Deshalb wird für die Budgets kein Preisfaktor erfunden.
Tools können die Mindestkosten bestimmen
Suchaufrufe und Containersitzungen müssen getrennt von Modell-Tokens gezählt werden. Eine Tokenschätzung kann stimmen, während das Monatsbudget trotzdem zu niedrig ausfällt, weil eine Aufgabe weitere kostenpflichtige Ressourcen aufruft.
Was kostet die Websuche über die OpenAI API?
Die Websuche kostet $10 pro 1,000 Aufrufe. Laut Preisseite sind die Tokens der Suchinhalte kostenlos. Das entspricht $0.01 pro Aufruf: 100 Aufrufe kosten $1, 10,000 kosten $100. Die separat abgerechnete Modellarbeit gehört weiterhin in die Tokenbilanz. Quelle: OpenAI-API-Preise.
Im Supportbeispiel kosten 1,000 Suchaufrufe mehr als sämtliche Luna-Tokens zusammen. Die Suchhäufigkeit sollte deshalb eine bewusste Produktentscheidung sein. Eine Antwort, die aktuelle Informationen braucht, kann eine Suche rechtfertigen. Eine Antwort auf Grundlage bereits mitgelieferter Supportregeln sollte dagegen nicht automatisch ein Suchbudget erhalten.
Container werden pro Sitzung abgerechnet
Container sind Ausführungsumgebungen, die zusammen mit Modellen genutzt werden. Sie kosten $0.03 für 1 GB oder $1.92 für 64 GB, jeweils pro Sitzung von 20 Minuten und pro Container. Die Preisseite datiert diese Sitzungsabrechnung auf den 31. März 2026. In dieser Bestandsaufnahme vom Oktober liegt das Datum bereits zurück. Die ältere Formulierung „Now“ auf der Seite rechtfertigt nicht die Annahme, es falle nur eine dauerhafte Gebühr pro Container an. Quelle: OpenAI-API-Preise.
Das Programmierbeispiel setzt ausdrücklich 1,000 Sitzungen mit jeweils einem GB voraus. Es behauptet nicht, dass jede Programmieraufgabe genau eine Sitzung verbraucht. Sitzungen müssen als eigene Abrechnungsgröße gezählt werden, besonders wenn Aufgaben mehrere Container nutzen oder sich über mehrere Sitzungseinheiten erstrecken.
Zum aufgeführten Tarif für 64 GB würden diese 1,000 Sitzungen $1,920 kosten. Bei unveränderten Sol-Tokens und Suchaufrufen stiege das Monatsbudget für die Programmierarbeit von $140 auf $2,030. Die Sitzungsgebühr des größeren Containers ist 64-mal so hoch wie die des kleineren. Für Zwischengrößen nennt diese Seite keinen Preis; deshalb werden hier keine Preise dazwischen errechnet.
Was kostet die OpenAI Realtime API?
GPT-Realtime-2.1 hat unterschiedliche Tarife für Audio, Text und Bildeingaben. Audiotokens sind eine eigene Abrechnungsgröße für Sprachanwendungen. Sie dürfen nicht wie Texttokens behandelt oder ohne belegte Umrechnungsregel in Minuten übersetzt werden.
Eine Million ungecachte Audio-Eingabetokens plus eine Million Audio-Ausgabetokens kosten bei GPT-Realtime-2.1 $32 + $64 = $96. Dieselben Tokenmengen kosten bei GPT-Realtime-2.1 mini $10 + $20 = $30. Für Text- und Bildeingaben gelten die eigenen Zeilen in der Tabelle. Quelle: OpenAI-API-Preise.
Bei zeitabhängig abgerechneten Aufgaben ist GPT-Live-1 das Gesprächsmodell. GPT-Live-Transcribe übernimmt die Transkription in Echtzeit, GPT-Transcribe die asynchrone Transkription und GPT-Realtime-Translate die Übersetzung in Echtzeit. Mit den angezeigten Minutentarifen kosten 1,000 Minuten entsprechend $50, $17, $4.50 oder $34. Das sind unterschiedliche Aufgaben, keine austauschbaren Sprachtarife. Die Seite nennt keine Umrechnung, die dem Realtime-Beispiel mit Audiotokens eine entsprechende Minutenzahl zuordnen würde.
Was kostet die OpenAI Image API?
Für GPT-Image-2.5 Sunburst und GPT-Image-2.5 Flare sind dieselben Tokenpreise aufgeführt. Beide kosten pro Million Tokens $8 für Bildeingaben, $2 für Bildeingaben aus dem Cache und $30 für Bildausgaben. Textprompts kosten $5 für die Eingabe oder $1.25 für Eingaben aus dem Cache. OpenAI positioniert Sunburst für präzise Bildbearbeitung und Flare für schnelle Bilderzeugung im Alltag. Quelle: OpenAI-API-Preise.
Eine angenommene Million erzeugter Bildtokens plus eine Million ungecachter Textprompt-Tokens kosten bei beiden Modellen $30 + $5 = $35. Das bedeutet nicht eine Million Bilder. Die Preisseite erklärt, dass Bilder in Tokens umgerechnet werden. Für diese Rechnung legt sie aber keine feste Tokenzahl pro erzeugtem Bild fest.
Bildaufgaben sollten anhand der tatsächlich abgerechneten Bild- und Textmengen budgetiert werden. Aus einem Tokentarif lässt sich kein fester Preis pro Bild versprechen. Auch ein Preisunterschied zwischen diesen Modellen lässt sich daraus nicht als Auswahlgrund ableiten, denn die Seite weist keinen aus.
Abonnements, kostenlose Nutzung und weitere Abrechnungsfragen
Ein ChatGPT-Abonnement bezahlt nicht die API-Rechnung einer Anwendung. OpenAI trennt die API-Abrechnung ausdrücklich von ChatGPT Plus, Business, Enterprise und Edu. Für die Entscheidung über ein Abonnement hilft der Leitfaden zu ChatGPT-Preisen. Die Nutzung der Anwendung benötigt ein eigenes Budget.
Wie werden Codex und die API-Nutzung abgerechnet?
Codex ist das Programmierprodukt von OpenAI. Entscheidend ist, auf welchem Weg die Nutzung bezahlt wird. Für separat abgerechnete API-Aktivität gelten die oben beschriebenen Modelle sowie die Token- und Tool-Tarife. Kontingente eines Produktabonnements sind eine andere Anschaffung. Bei dieser Entscheidung hilft der Leitfaden zu Codex-Preisen.
Ein Abonnementplatz für einen Entwickler macht den Supportbot, die automatisierten Programmieraufgaben oder die Batch-Zusammenfassungen nicht zu vorausbezahlter App-Nutzung. Produktabonnements und die nach Verbrauch abgerechnete API-Nutzung der Anwendung gehören deshalb in getrennte Budgetpositionen.
Gibt es ein kostenloses Kontingent für die OpenAI API?
Die abgerufene Preisseite nennt kein allgemeines kostenloses API-Tokenkontingent. Sie erklärt ausdrücklich, dass die Nutzung von Playground, der Browseroberfläche zum Ausprobieren von Requests, wie reguläre API-Nutzung abgerechnet wird. Experimente sollten nicht allein deshalb als kostenlos eingeplant werden, weil sie außerhalb der eigenen Anwendung stattfinden.
Wer ausschließlich die kostenlose ChatGPT-Nutzung benötigt, muss möglicherweise nie API-Nutzung kaufen. Sobald die eigene Anwendung kostenpflichtige API-Requests stellt, begründet die kostenlose App-Nutzung jedoch kein kostenloses Produktionsbudget.
Diese Quelle nennt weder einen allgemeinen API-Studierendenrabatt noch eine API-Erstattungsregelung, eine Gültigkeitsdauer von Guthaben oder eine jährliche Zusage zu Tokenpreisen. Diese Lücken beweisen nicht, dass es keine kontospezifischen Angebote oder gesonderten Regelungen gibt. Sie bedeuten, dass diese Preisübersicht solche Zusagen nicht machen kann. Insbesondere dürfen Erstattungs- oder Jahresabrechnungsbedingungen eines Abonnements nicht auf ein API-Budget übertragen werden.
Das Budget für nächste Woche an abgeschlossener Arbeit ausrichten
Mit Sol starten und die gesamte Aufgabe messen, bevor der Modelltarif optimiert wird. Das nächste Budget sollte auf der beobachteten, abgerechneten Nutzung beruhen, nicht auf der Wortzahl der letzten Antwort.
Eine Ausgangsbasis erfassen
Für repräsentative Aufgaben über sämtliche Bearbeitungsschritte hinweg neue Eingaben, Eingaben aus dem Cache, abgerechnete Ausgaben, Suchaufrufe und Containersitzungen erfassen. Das Abnahmeergebnis der Aufgabe zusammen mit ihren Kosten festhalten.
Klar abgegrenzte Aufgaben passend zuordnen
Luna für gezielte Aufgaben erproben, deren Ergebnisse überprüfbar sind. Arbeit ohne Zeitdruck in Batch verarbeiten. Die Zuordnung nur beibehalten, wenn die Ausgabe die Abnahmekriterien erfüllt.
Den Aufpreis mit vermiedener Nacharbeit vergleichen
Bei schwierigen Aufgaben Astras zusätzliche API-Kosten dem Wert der vermiedenen Korrekturen gegenüberstellen. Maßgeblich sind die tatsächlichen Versuche und die Tool-Nutzung, nicht die Annahme, jedes Modell verbrauche identische Tokenmengen.
Laut OpenAIs Preis-FAQ kann die Durchsetzung monatlicher Budgetgrenzen verzögert erfolgen; für Überschreitungen bleibt der Nutzer verantwortlich. Das konfigurierte Budget ist deshalb eine Ausgabenkontrolle mit dieser ausdrücklich genannten Einschränkung. Die tatsächliche Nutzung sollte überwacht werden. Hinweise zur Projektstruktur und zur Wiederaufnahme des Betriebs enthält der Leitfaden zu API-Budgetkontrollen.
Häufige Fragen
Was kostet OpenAI?
Die Nutzung der OpenAI API wird nach Modell, Tokens und Tools abgerechnet. Für Standard-Requests unterhalb der angegebenen Kontextgrenze kostet Sol pro Million Tokens $2 für die Eingabe, $0.10 für Eingaben aus dem Cache und $10 für die Ausgabe. Diese API-Preisübersicht nennt keinen einheitlichen Monatspreis für eine gesamte Anwendung.
Ist die ChatGPT API günstiger als ChatGPT Plus?
Das hängt von der Nutzung und den Anforderungen ab. Die API-Rechnung einer Anwendung kann klein ausfallen. Bezahlt werden damit jedoch nach Verbrauch abgerechnete Anwendungsaufrufe, während das Abonnement den Zugang zum Produkt bietet. OpenAI erklärt, dass API-Nutzung getrennt von ChatGPT-Abonnements abgerechnet wird.
Wie lassen sich Preise und Kosten verschiedener LLM-APIs vergleichen?
Vor einem Anbieterwechsel müssen Eingaben, Eingaben aus dem Cache, Ausgaben, Tool-Nutzung und erfolgreiche Abschlüsse auf eine vergleichbare Basis gebracht werden. Das OpenAI-Programmierszenario in diesem Artikel kostet bei identischer Nutzung $55 mit Luna, $140 mit Sol und $550 mit Astra; ausreichende Qualität bleibt die Voraussetzung für die Abnahme. Diese Bestandsaufnahme enthält keine verifizierten Preise anderer Anbieter.
Lohnt es sich, für OpenAI zu bezahlen?
Es lohnt sich, wenn abgenommene Arbeit mehr spart, als API-Nutzung und daraus entstehende Nacharbeit kosten. Für Programmieraufgaben ist Sol der Ausgangspunkt. Astra kommt infrage, wenn vermiedene Korrekturen den Aufpreis rechtfertigen. Luna passt dort, wo seine Ergebnisse dieselben erforderlichen Prüfungen bestehen.
Lohnen sich $20 für ChatGPT?
Ein ChatGPT-Abonnement lohnt sich, wenn seine Funktionen und die eingesparte Zeit die Gebühr rechtfertigen. Es bezahlt nicht die hier berechnete Nutzung einer Anwendung. Die Entscheidung über dieses API-Budget bleibt deshalb separat.
Ist die OpenAI API kostenlos oder kostenpflichtig?
Die Seite führt kostenpflichtige Modell- und Tool-Nutzung auf und nennt kein allgemeines kostenloses API-Kontingent. Außerdem werden Playground-Requests laut Seite wie reguläre API-Requests abgerechnet. Eine kostenlose ChatGPT-Nutzung begründet keine kostenlose API-Nutzung.
Ist die OpenAI API teuer?
Das entscheiden die Aufgabe und die eingesetzten Tools. Der angenommene Supportmonat kostet $13.90 mit Luna, der Programmiermonat mit Sol $140. Beide Werte hängen von den angegebenen abgerechneten Mengen ab. Ein niedriger Tokentarif beseitigt keine Such- oder Containergebühren.
Welche kostenlosen KI-APIs sind am besten?
Diese Preisseite nennt kein allgemeines kostenloses Kontingent für die OpenAI API. Luna ist eine günstige kostenpflichtige Option für klar abgegrenzte Aufgaben, deren Ergebnisse die eigenen Prüfungen bestehen. Ein kostenloses API-Kontingent eines Anbieters braucht eine eigene aktuelle Prüfung, bevor es in ein Produktionsbudget eingeplant wird.
Was kostet 1 Million Tokens bei OpenAI?
Für eine Million ungecachte Eingabetokens kostet Astra $10, Sol $2 und Luna $0.10. Für eine Million Ausgabetokens sind es $50, $10 und $0.50. Eine Million Eingabetokens plus eine Million Ausgabetokens ergeben zwei Millionen abgerechnete Tokens und kosten insgesamt $60, $12 oder $0.60.
Gibt es für die OpenAI API einen Studierendenrabatt?
Die für diesen Artikel geprüfte Preisseite nennt keinen allgemeinen API-Studierendenrabatt. Ein Studierendenangebot für ein anderes OpenAI-Produkt darf nicht als API-Guthaben eingeplant werden, sofern dessen eigene Bedingungen diesen Vorteil nicht ausdrücklich vorsehen.
Welche Erstattungsregeln gelten für die OpenAI API?
Die geprüfte Preisseite nennt keine API-Erstattungsregelung. Dieser Artikel verspricht deshalb weder Erstattungen noch überträgt er Regeln von ChatGPT-Abonnements auf API-Käufe.
Haben sich die OpenAI-API-Preise 2026 geändert?
Die aktuelle Seite datiert die Abrechnung von Containersitzungen je 20 Minuten ausdrücklich auf den 31. März 2026. Sie enthält keine historische Reihe der Modellpreise. Deshalb behauptet diese Bestandsaufnahme vom Oktober weder, wann sich Modell-Tokenpreise geändert haben, noch nennt sie frühere Preise.
Vor der Wahl eines anderen Tarifs sollten Aufgaben und Abnahmekriterien feststehen. Die Checkliste zur Prüfung von KI-Workflows im Unternehmen gibt es bei der Newsletter-Anmeldung.
- Zuletzt aktualisiert
- 3. Okt. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Pi Coding Agent einrichten: in 28 Minuten zum ersten Test
Pi 1.0 installieren, den vorhandenen Modellzugang verbinden und die erste Aufgabe abschließen: mit AGENTS.md, Preismodell und klar benannten Grenzen.3. Okt. 2026Build
KI-Agenten ohne Programmieren: 8 Tools im Vergleich 2026
KI-Agenten ohne Code erstellen: Acht Tools im Vergleich – mit Preisen, Abrechnung, Integrationen und den Grenzen zwischen Konfiguration, API und Code.1. Okt. 2026Build
Lovable Pricing 2026: Tarife und Credits richtig kalkulieren
Lovable Pricing: Pro ab $25, Business ab $50 pro Monat. Tarife, Credit-Zukäufe, Cloud und App-KI im Detail – mit Beispielbudget für ein internes Tool.1. Okt. 2026Build
Vulnerability Scanner mit Codex Security: Cloud, PRs und CI
Codex Security als Vulnerability Scanner einrichten: Cloud, PR-Reviews und CLI für CI. Mit Teamkosten, Gogs-Befunden und SARIF – samt nötiger Zusatzprüfungen.30. Sept. 2026Build
LearnWorlds Pricing 2026: Welcher Tarif sich wirklich rechnet
LearnWorlds kostet ab $29 pro Monat. Der Vergleich zeigt, wann Pro Trainer günstiger ist, welche KI-Credits enthalten sind und wo Zusatzkosten entstehen.30. Sept. 2026Build
Notion Alternative: Wann ChatGPT Space die bessere Wahl ist
ChatGPT Space oder Notion? Der Vergleich zeigt, wann die Notion Alternative für KI-Briefings überzeugt – und wann Datenbanken, Rechte und Exporte zählen.30. Sept. 2026Build
WebMCP mit Kitesurf: Browser-Aktionen sicher ausführen
So verbindet sich ein Agent mit Kitesurf, findet WebMCP-Tools und führt geprüfte Browser-Aktionen aus – inklusive Einrichtung, Grenzen und Fallbacks.30. Sept. 2026Build