Agente de voz IA: el costo real de llamar con GPT-Live-1
Calcula el costo real de un agente de voz IA con GPT-Live-1: sesión de voz, razonamiento, herramientas, telefonía y costo por llamada resuelta.



GPT-Live-1 deja clara una de las partidas del costo de un agente de voz IA: la sesión de voz cuesta $0.05 por minuto. Desde el 10 de septiembre de 2026, los equipos pueden simplificar el circuito de escucha y habla, pero la cifra que realmente importa para el presupuesto sigue siendo el costo total de una llamada resuelta, incluido el razonamiento del backend, las herramientas y el servicio telefónico.
Agente de voz IA: los cinco centavos solo cubren la voz
GPT-Live-1 es un modelo de voz full-duplex. Esto significa que puede escuchar mientras habla: quien llama puede interrumpir, hacer una pausa, corregir un dato o responder brevemente sin esperar a que termine un turno rígido.
Ese detalle cambia la arquitectura del sistema. Un agente de voz tradicional suele encadenar reconocimiento de voz, un modelo de lenguaje y síntesis de voz. La aplicación debe trasladar la información entre cada etapa y decidir qué hacer cuando ambas partes hablan al mismo tiempo.
GPT-Live-1 concentra la conversación en vivo en una sola capa de voz. Escucha, habla, sigue el ritmo de la interacción y decide cuándo conviene enviar una tarea más compleja al backend. Allí se puede comprobar una reserva, consultar una cuenta, usar una herramienta o interpretar una política.
El backend se mantiene separado a propósito. Se puede recurrir a la delegación con Responses, mediante la cual GPT-Live-1 envía el trabajo a un modelo de texto de OpenAI configurado por el equipo, o a la delegación del cliente, donde la propia aplicación ejecuta cualquier modelo, agente o servicio y devuelve el resultado. Así, la voz permanece igual mientras se elige un cerebro más económico o más potente según la tarea.
La conexión telefónica también se factura por separado. Una llamada entrante puede llegar a GPT-Live-1 mediante un troncal SIP —la conexión por internet que suministra un operador telefónico— o mediante una aplicación que retransmite el audio. OpenAI gestiona la sesión Live; el operador conserva la gestión del número y del tráfico telefónico.
Ese es el cambio presupuestario completo. En este flujo ya no hace falta calcular el reconocimiento y la generación de voz como dos etapas independientes de modelos de OpenAI. Aun así, hay que llevar tres cuentas por separado.
La factura tiene tres componentes
La primera trampa está en el reloj. La facturación de GPT-Live-1 abarca toda la sesión activa, desde que empieza hasta que se cierra. Los silencios cuentan. La espera de una herramienta también. Silenciar el micrófono no detiene el cobro.
La segunda trampa consiste en considerar gratuito el backend porque funciona detrás de la conversación. No lo es. Con la tarifa estándar para contexto corto, GPT-5.6 Luna cuesta $0.20 por millón de tokens de entrada y $1.20 por millón de tokens de salida. En GPT-5.6 Terra, los precios son $2.00 y $12.00; en GPT-6 Astra, $10.00 y $50.00. La comparación correcta no es qué modelo tiene la tarifa por token más baja, sino qué combinación completa el trabajo de forma fiable, con menos tiempo total de llamada y menos repeticiones.
Una reserva muestra el costo real de la llamada
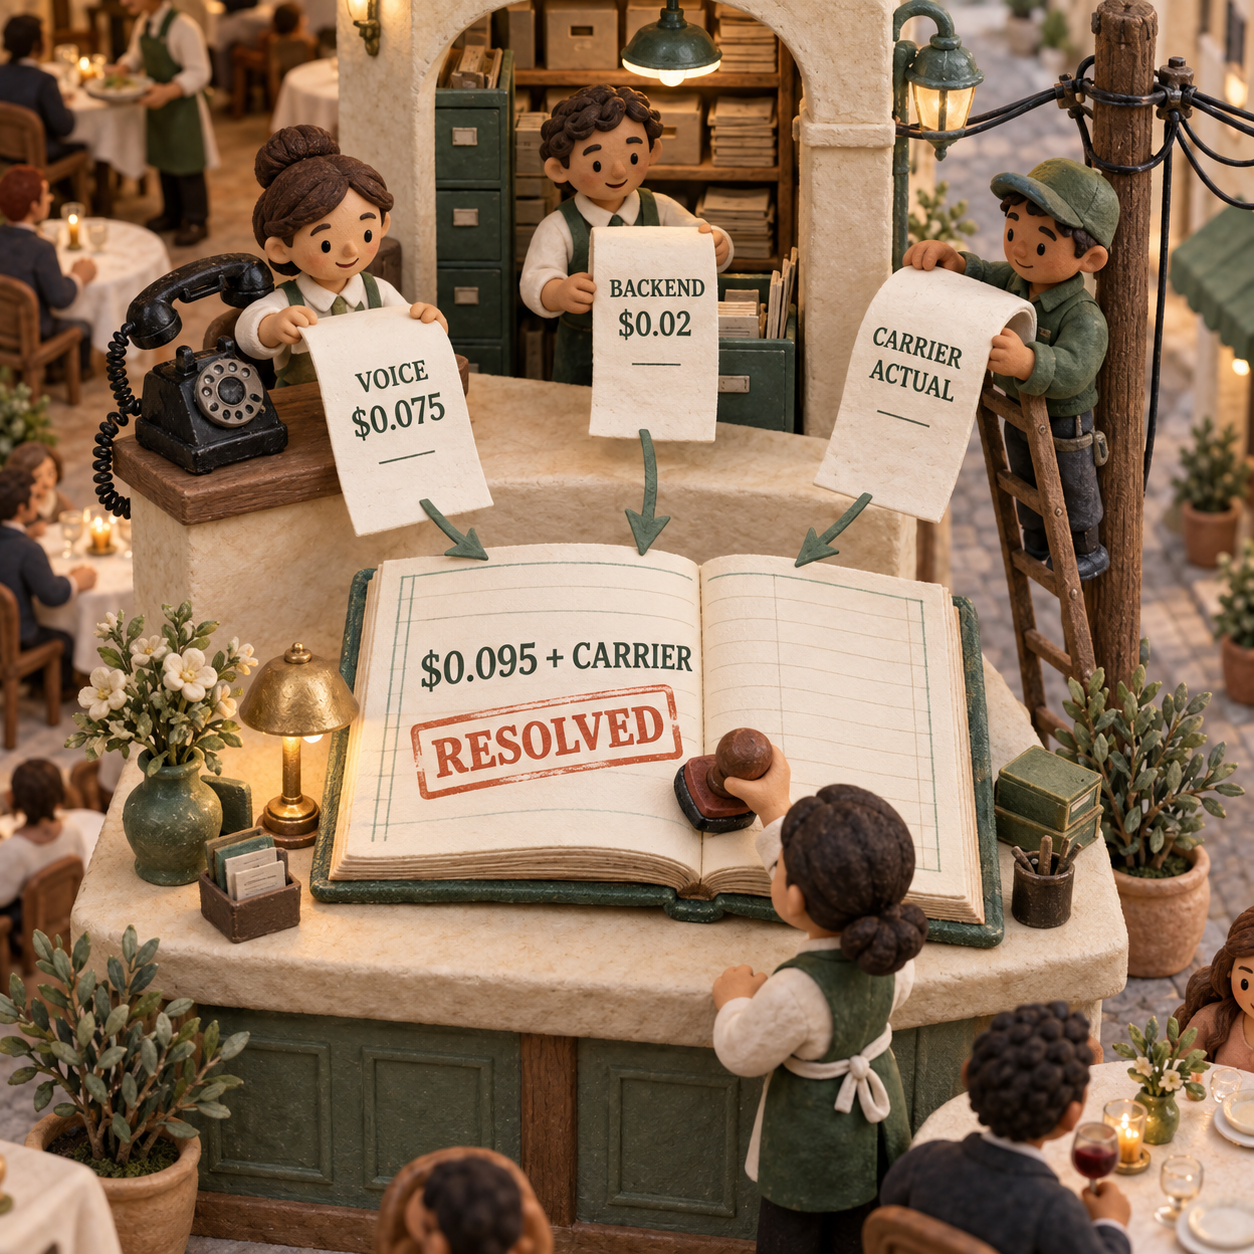
Pensemos en una llamada entrante de 90 segundos para reservar en un restaurante. El ejemplo de costos de OpenAI ofrece un punto de partida sencillo:
- Voz: 90 segundos divididos entre 60 y multiplicados por $0.05 equivalen a $0.075.
- Backend: para este ejemplo, se supone que el uso medido del modelo y las herramientas suma $0.02.
- Subtotal de voz y backend: $0.095.
- Servicio telefónico: se añade el cargo del operador correspondiente a esa llamada.
Por tanto, la llamada no cuesta $0.075. En este ejemplo cuesta $0.095 más el servicio telefónico. Si la reserva queda confirmada, ese es el costo directo de ejecución de una reserva resuelta. Si el agente falla y una persona tiene que repetir el trabajo, la llamada fallida sigue formando parte del numerador al calcular el costo por resolución.
Por eso es más honesto dejar el cargo del operador como una variable que inventar una tarifa de mercado para cerrar la suma. OpenAI no fija ese precio: hay que tomarlo de la factura del proveedor correspondiente.
Además, las partidas se afectan entre sí. Un backend más rápido puede justificar una tarifa por token superior si permite cerrar antes la sesión Live. Reducir en un minuto el tiempo de apertura ahorra $0.05 en voz. En cambio, un backend barato puede elevar el costo total si obliga a repetir datos, se demora con las herramientas o no logra completar la reserva.
Cómo encaja en el flujo de una llamada real
Un restaurante puede conectar GPT-Live-1 a su número de reservas entrantes y limitar bien su cometido. La capa de voz conduce la conversación. Un backend económico comprueba la disponibilidad y prepara la reserva. La aplicación confirma el horario definitivo, registra la reserva e impide que un resultado tardío termine apartando una hora equivocada.
Un equipo de soporte puede reutilizar el mismo frontend con distintas políticas de backend. Las consultas rutinarias sobre pedidos pueden ir a un modelo que priorice el costo. Un cargo disputado o una excepción a una política puede enviarse a un modelo más potente o a una persona. La ventaja no está en pedirle a un solo modelo de voz que haga todo, sino en ajustar el costo de razonamiento a cada tarea sin cambiar la experiencia hablada.
Para un equipo de producto que ya opera una cadena de reconocimiento de voz, modelo y síntesis de voz, la decisión es distinta. GPT-Live-1 puede eliminar código de integración y facilitar el manejo del habla simultánea, pero la migración solo compensa si la mejora en la finalización de tareas o el mantenimiento justifica el esfuerzo. La comparativa más amplia sobre el costo de los agentes de voz IA sigue siendo útil al decidir entre desarrollar o contratar.
Una aplicación web puede conectarse mediante WebRTC y eliminar por completo la partida del operador telefónico. Aun así, paga la duración de Live y el trabajo del backend. Este lanzamiento no cambia nada para los agentes solo de texto, los flujos por lotes ni las aplicaciones donde nadie necesita hablar.
El piloto telefónico mínimo que aporta datos útiles
La ruta SIP directa comienza cuando el proveedor envía una llamada entrante a OpenAI y el webhook recibe el ID de una sesión Live. Esta es la estructura de aceptación documentada:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
La clave de API permanece en el backend de confianza. SIP negocia el formato de audio, por lo que se omite audio.format. La delegación del cliente deja en manos de la aplicación el modelo del backend, las herramientas, los permisos y los registros de uso.
Para un piloto de reservas entrantes, el trabajo es lo bastante acotado como para medirlo con claridad.
Defina un único resultado
El criterio de éxito debe ser una reserva confirmada, no una conversación agradable. Guarde la hora solicitada, la hora finalmente reservada y si una persona tuvo que intervenir.
Registre cada partida de costo
Conserve durante la llamada la cifra acumulada más reciente de segundos de voz. Si el cierre es normal, sustituya ese valor por el uso final de
session.closed. Guarde una sola vez el ID de cada respuesta del backend junto con su uso de tokens y herramientas. Una esos registros con el detalle de la llamada del operador.Pruebe interrupciones reales
Incluya las pausas, correcciones, voces de fondo y respuestas breves habituales de quienes llaman. Revise la transcripción, la acción ejecutada por el backend y el audio que la persona realmente oyó. Que una respuesta del backend haya terminado no demuestra que el resultado se haya reproducido por voz.
Compare el costo por tarea completada
Sume durante el piloto el gasto de voz, backend y servicio telefónico, y divídalo entre las reservas confirmadas. Incluya en el gasto las llamadas fallidas, los reintentos y las transferencias a personas. Compare el resultado con el sistema actual usando los mismos guiones de llamada.
La gestión de interrupciones debe probarse con datos propios
GPT-Live-1 está diseñado para el habla simultánea, pero un ejemplo de lanzamiento no equivale a un acuerdo de nivel de servicio. Andrew Hsu, cofundador y CTO de Speak, afirma que la evaluación inicial de Speak redujo casi un 80% las interrupciones durante las pausas de reflexión frente a sus sistemas anteriores basados en turnos. Es un resultado propio del entorno de tutoría de idiomas de Speak.
Una línea ruidosa de restaurante, una persona que dicta un número de pedido a soporte y un paciente que duda antes de decir una fecha son situaciones distintas. El prompt, el códec telefónico, el jitter del operador, la latencia de las herramientas y los controles de reproducción de la aplicación influyen en la experiencia de quien llama. No existe una mejora universal y defendible de interrupciones o latencia que se pueda trasladar sin más a una proyección.
También importa el caso límite en producción. Si alguien interrumpe y cambia el viernes por el jueves, la corrección hablada no cancela automáticamente la tarea del backend correspondiente al viernes. La aplicación debe modificar o cancelar el trabajo anterior, ignorar cualquier resultado tardío y evitar que un reintento genere una segunda reserva.
Por ahora, la conexión SIP directa de GPT-Live solo admite llamadas entrantes. El endpoint de creación de sesiones Live no inicia llamadas SIP salientes, así que las campañas de salida siguen necesitando una ruta asociada gestionada por un proveedor. Los equipos que necesiten empezar por llamadas salientes deben validar esa ruta antes de planificar una migración.
Qué hacer el lunes
Si se gestiona una cola de reservas o soporte entrante, conviene instrumentar un piloto acotado. Los segundos de voz, el uso del backend, los cargos del operador, las tareas completadas, las transferencias y los fallos de interrupción deben quedar en el mismo registro. También hay que enfrentar un backend orientado al ahorro con el modelo más potente que el equipo crea necesitar.
Tiene sentido avanzar cuando el costo total por llamada resuelta mejora el de la arquitectura actual y las personas pueden corregir al agente sin que se ejecuten acciones obsoletas. Es mejor esperar si la única ventaja es el titular de $0.05, o si el operador y la ruta de llamadas salientes aún no están resueltos. El lanzamiento puede ignorarse en trabajos solo de texto y en experiencias de voz que ya cumplen sus objetivos de costo y finalización.
Para recibir más análisis claros sobre cambios que afectan los costos operativos, puede suscribirse al boletín.
- Última actualización
- 14 sept 2026
- Categoría
- Explained
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

ChatGPT para Windows: Appshots reduce la copia manual de contexto
Con Appshots, ChatGPT para Windows adjunta la ventana activa a un chat. Aprende a configurar la función, medir el ahorro y evitar exponer datos sensibles.14 sept 2026Explained
Cómo la CDN de Vercel reduce el uso de Functions en FastAPI
Vercel ahora sirve archivos estáticos elegibles de FastAPI desde su CDN. Descubre qué solicitudes dejan de usar Functions y cuáles aún las necesitan.13 sept 2026Explained
Clave API OpenAI: cómo rotarla antes de que caduque
Planifica la rotación de una clave API OpenAI antes de su caducidad: responsable, ventana de reemplazo, presupuesto y verificación sin interrupciones.13 sept 2026Explained
Gestión de credenciales en Vercel Connect: quién debe tener el control
Vercel Connect ya permite asignar un responsable a los conectores compartidos. Así funciona el permiso Connector Manager y dónde están sus límites.13 sept 2026Explained
Cloudflare R2: cómo indexar archivos sin extensión con AI Search
Cloudflare R2 ya permite que AI Search indexe archivos sin extensión mediante un Content-Type válido. Descubre qué cambia y qué trabajo sigue pendiente.12 sept 2026Explained
Vercel Sandbox 64 GB: más espacio para tareas de agentes
Vercel Sandbox duplica el disco de trabajo de 32 GB a 64 GB. Descubre qué cambia para repositorios, compilaciones y agentes de código más grandes.12 sept 2026Explained
Cloudflare Workers acorta el historial de Workflows: cómo ajustar la retención
Cloudflare Workers reduce a 7 días la retención predeterminada de nuevos Workflows de pago. Aprende a separar historial, evidencia y costo de almacenamiento.11 sept 2026Explained