Trazas de Cloudflare Workers: detecta la llamada lenta
Sigue una solicitud lenta entre Cloudflare Workers y Durable Objects, identifica la llamada que la retrasa y calcula el costo del tracing antes de activarlo.



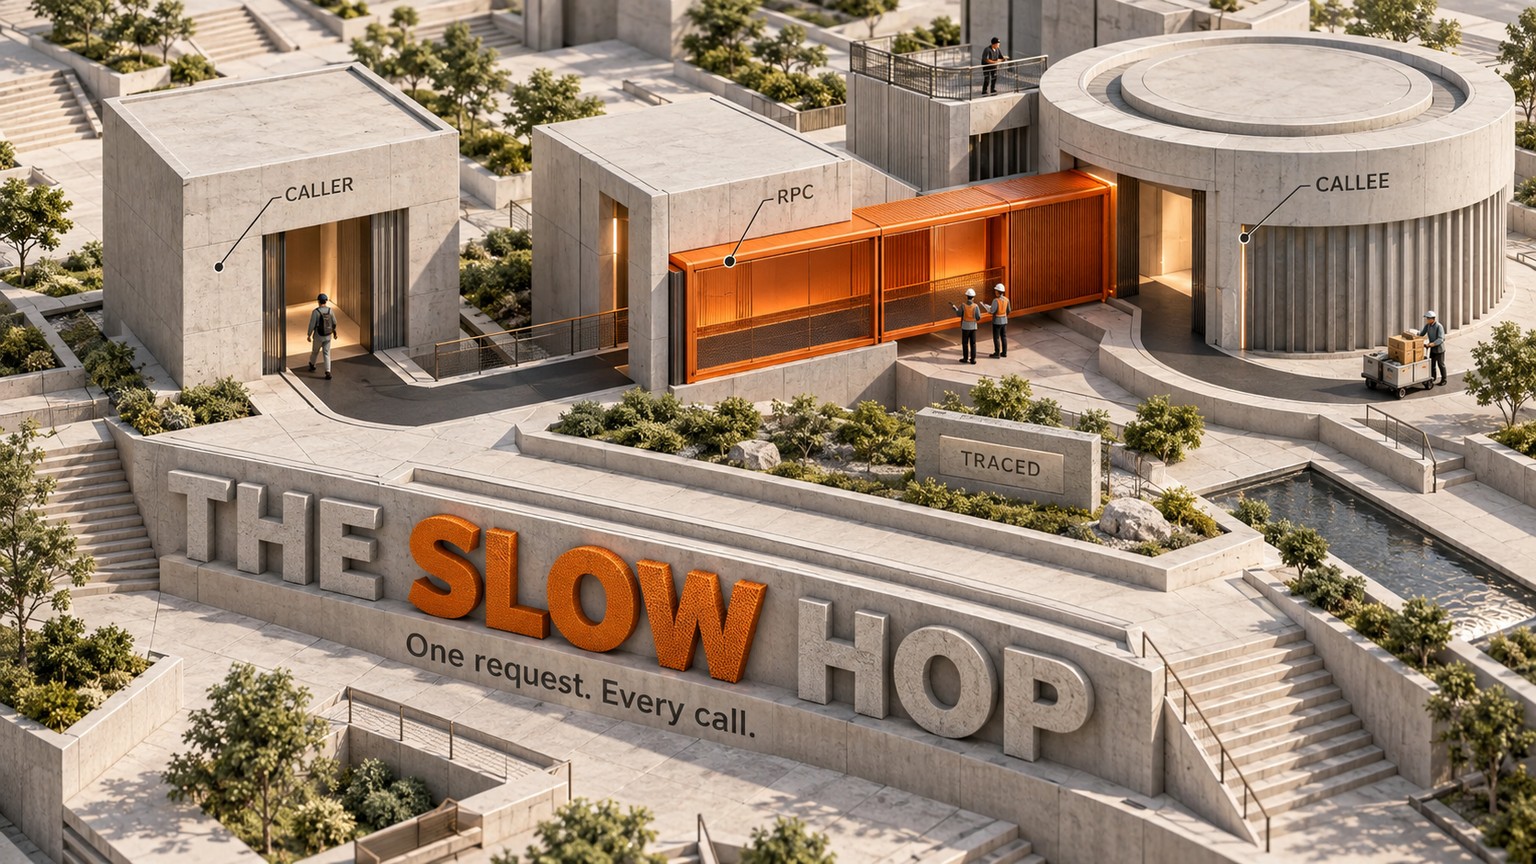
El 17 de septiembre de 2026, Cloudflare facilitó la tarea de localizar el origen de una solicitud lenta: las trazas de Cloudflare Workers ahora pueden seguir una llamada RPC de JavaScript hasta otro Worker o Durable Object, en lugar de detenerse en quien la inicia. Así es posible ver qué servicio y qué método frenaron la solicitud antes de añadir spans manuales o culpar a toda la arquitectura.
El cambio clave: ya no falta el tramo intermedio
RPC puede parecer más complejo de lo que es. En Cloudflare Workers, una llamada a procedimiento remoto ocurre cuando un Worker invoca un método público de JavaScript en otro Worker o Durable Object mediante un binding. En el código parece una llamada a un método local, pero el trabajo se ejecuta en otro lugar.
Una traza es la cronología de una solicitud. Cada segmento cronometrado dentro de ella es un span. Hasta este lanzamiento, esa cronología se interrumpía cuando quien hacía la llamada cruzaba un límite RPC de JavaScript. Era posible ver que el Worker A iniciaba la llamada, pero no vincularla claramente con el trabajo que se ejecutaba en el Worker B o en un Durable Object.
El lanzamiento de Cloudflare del 17 de septiembre completa ese tramo. Una misma traza ahora puede mostrar la sesión del lado que llama, cada llamada a un método, la invocación del destinatario, las llamadas anidadas y los callbacks hacia otro Worker. Cloudflare registra esos spans de forma automática cuando las trazas están habilitadas. Esta instrumentación de la plataforma no exige añadir un SDK de observabilidad ni modificar el código de la aplicación.
El span de sesión funciona como contenedor de la sesión RPC en el lado que llama. Las llamadas que reutilizan esa sesión aparecen dentro de él. Los spans de cada llamada muestran la ruta del método o la propiedad, mientras que el destinatario recibe su propio span de invocación. Los cambios de color indican cuándo la ejecución pasa de un Worker a otro o entra en un Durable Object.
Lo que antes era un límite vacío se convierte así en un mapa de responsabilidades.
Cómo seguir una solicitud con las trazas de Cloudflare Workers
Pensemos en una solicitud de cliente a POST /checkout.
Primero llega a un Worker de checkout. Ese Worker llama a inventory.reserve() en un Worker de inventario y luego a order.commit() en un Durable Object de pedidos. El cliente solo percibe un checkout lento, pero la aplicación tiene tres puntos donde podría estar la espera.
Antes de este cambio, la traza del checkout podía terminar en la llamada RPC. Para reconstruir el resto había que reunir los logs de cada servicio, emparejar identificadores o crear spans personalizados.
Ahora la traza puede mantener unida toda la solicitud. Es posible desplegar la sesión RPC, localizar los spans de los métodos reserve y commit, ver las invocaciones posteriores y comparar dónde se concentra el tiempo transcurrido. Los spans raíz también pueden incluir el Cloudflare Ray ID, el nombre del Worker, el punto de entrada, el resultado, el tiempo de CPU y el tiempo total. Son referencias útiles para que quien responde a un incidente encuentre la solicitud correcta.
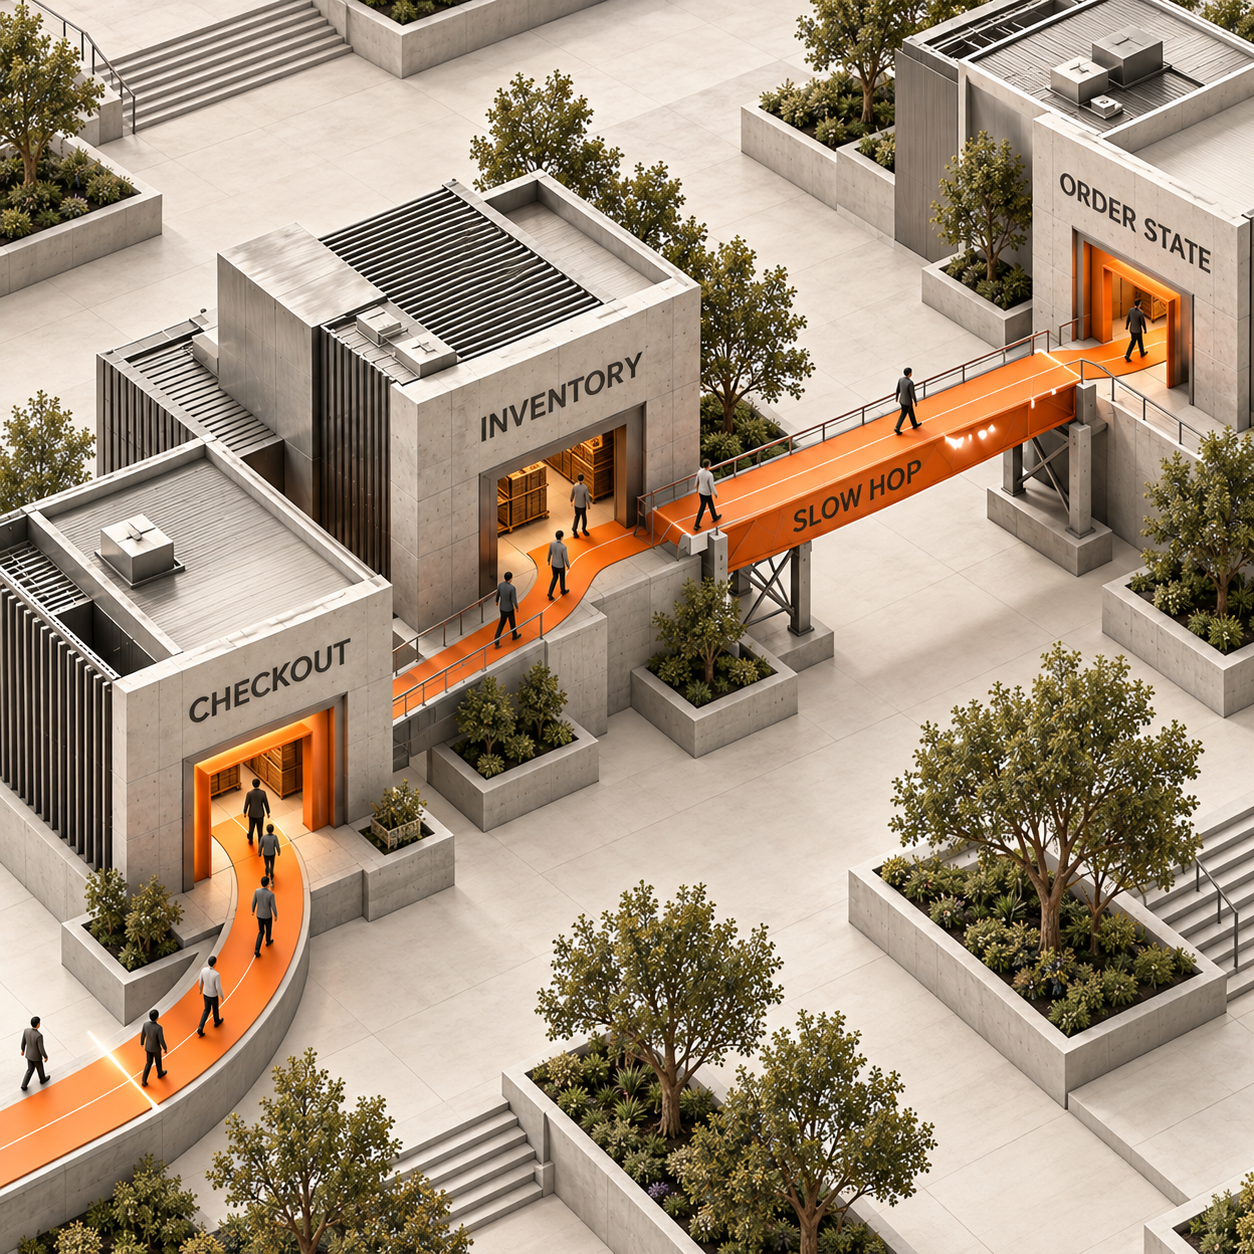
La nueva vista no demuestra por qué un método es lento. Indica dónde conviene investigar a continuación. Si la invocación de inventario concentra casi toda la espera, hay que revisar su almacenamiento o una dependencia externa. Si el span más largo corresponde a la llamada al Durable Object, toca examinar el handler de ese objeto y sus operaciones de almacenamiento. Si quien llama ya acumula demora antes de iniciar cualquiera de las dos llamadas RPC, los servicios posteriores no son el primer sospechoso.
Quién obtiene valor de esta función
Un fundador independiente con el backend dividido
Quien gestione checkout, inventario y estado de pedidos en Workers separados puede reproducir una compra lenta y seguirla a lo largo de todo el recorrido en Cloudflare. La ventaja es un área de corrección más acotada: se investiga el Worker o Durable Object responsable de la demora, en lugar de reabrir todos los servicios.
Un responsable de backend en un producto con estado
Una aplicación de colaboración puede enviar la acción de una sala desde un Worker en el edge hasta un Durable Object de esa sala. La persona responsable del backend puede separar el tiempo consumido por quien llama del invertido dentro del objeto con estado y entregar la traza al equipo encargado de ese límite.
Un ingeniero de plataforma con servicios internos en Workers
Un equipo de plataforma puede tener varios Workers conectados mediante bindings de servicio, con stubs devueltos y callbacks que forman un recorrido difícil de reconstruir a partir de logs. Los spans de sesión y de método muestran qué llamadas reutilizaron una sesión, qué Worker ejecutó cada parte y dónde entró una llamada anidada en el recorrido.
Un responsable de soporte que convierte un reporte en evidencia
Soporte puede pedir a ingeniería que reproduzca la misma ruta mientras los detalles del incidente siguen frescos. La traza resultante permite entregar un servicio y un límite de método concretos, en vez de decir que «el checkout se sintió lento». Eso aporta valor incluso si la solución final todavía requiere logs, un profiler o el plan de ejecución de una consulta de base de datos.
Haz primero una prueba acotada
El primer despliegue útil debe cubrir un solo recorrido de solicitud, no todos los Workers de producción a la vez.
Elige un recorrido visible para el cliente
Selecciona una solicitud que ya atraviese un límite RPC entre Workers o entre un Worker y un Durable Object, y que tenga un caso lento reproducible. Anota la ruta, las llamadas posteriores a métodos que esperas ver y el momento en que harás la reproducción.
Habilita las trazas en Wrangler
Añade a la configuración de Wrangler del Worker que atiende ese recorrido el ajuste documentado por Cloudflare:
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }Despliega esa configuración mediante el proceso habitual de lanzamiento. Este interruptor habilita los spans automáticos de Cloudflare; no requiere un SDK dentro del Worker.
Reproduce una solicitud lenta
Ejecuta una vez la misma solicitud bajo condiciones controladas. Conserva la ruta, la marca de tiempo y el Cloudflare Ray ID si el flujo de soporte o logging ya los registra. Un entorno controlado da resultados más limpios porque la tasa de muestreo predeterminada de las trazas es
1: cuando no se configura otra tasa, se traza el 100% de las solicitudes entrantes.Lee la traza desde afuera hacia adentro
En Cloudflare, ve a Workers & Pages, selecciona el Worker y abre Observability. Busca la solicitud reproducida y despliega su traza. Empieza por la solicitud raíz; después sigue la sesión RPC, el span del método del lado que llama, la invocación del destinatario y cualquier llamada anidada a un Durable Object. Usa el ancho de los spans y los campos de tiempo total para localizar el límite que merece la siguiente investigación.
Calcula el costo antes de ampliar el despliegue
Registra cuántos spans creó la traza reproducida. Luego estima los eventos de traza mensuales con
sampled requests × average spans per sampled trace. Añade los eventos de logs que ya consumen la misma cuota de observabilidad. Esa cantidad de spans medida es el dato necesario para decidir el muestreo en producción.
El costo se calcula por span, no por solicitud
Las trazas de Workers son gratuitas durante su periodo beta inicial. Esto cambia el 1 de octubre de 2026. A partir de esa fecha, cada span cuenta como un evento de observabilidad y comparte la misma cuota y los mismos precios que Workers Logs.
Los equipos Enterprise deben consultar su contrato. El resto debe prestar atención a la unidad de facturación: una sola solicitud de cliente puede generar un span raíz, un span de sesión RPC, spans de llamadas a métodos, invocaciones del destinatario y spans de bindings anidados. Contar únicamente las solicitudes no permite calcular la factura de las trazas.
La documentación de trazas de Cloudflare indica que el valor predeterminado de head_sampling_rate es 1, es decir, 100%. Su ejemplo para tráfico elevado usa 0.05, con lo que se trazan cinco de cada cien solicitudes entrantes. Es un ejemplo de control, no una respuesta universal.
El muestreo al inicio deja claro el intercambio. Una tasa menor reduce el volumen de eventos, pero la decisión se toma cuando comienza la solicitud. Una solicitud lenta poco frecuente puede quedar fuera de la muestra. Conviene usar el muestreo completo en una reproducción controlada o en un entorno debidamente aislado y, después, elegir la tasa de producción a partir del tráfico real y de los spans medidos por traza.
La retención también cambia la gestión de incidentes. Las trazas del plan Free duran 3 días y las del plan Paid, 7 días. Si los reportes de clientes llegan después de ese plazo, es posible que la traza necesaria ya no exista. La regla operativa es sencilla: hay que reproducir e investigar mientras la evidencia siga disponible, o exportar las trazas a un sistema cuya retención se ajuste al proceso del equipo.
Los límites reales
Las trazas de Workers siguen en beta abierta. Los nombres de spans y atributos pueden cambiar, y Cloudflare señala que algunos atributos aún están incompletos.
Algunos spans que no corresponden a operaciones de I/O pueden mostrar 0 ms aunque el trabajo haya tardado más. El Workers Runtime no actualiza el tiempo hasta que se produce un evento de I/O, por lo que un cero no demuestra que un fragmento de JavaScript no haya consumido tiempo.
La continuidad automática de la traza también termina fuera de Cloudflare. Cuando se exportan trazas de Workers, Cloudflare todavía no propaga los identificadores de traza a servicios externos. Una llamada a un proveedor de pagos o a una base de datos alojada en otro lugar no enlazará automáticamente su traza del lado del proveedor con la cronología de Workers.
Por último, este lanzamiento tiene un alcance limitado. Un solo Worker sin límites RPC de JavaScript no obtiene una nueva vista entre servicios. Las trazas generales de Workers pueden seguir siendo útiles para fetches, bindings y handlers, pero el cambio del 17 de septiembre aporta más valor a las aplicaciones que ya están distribuidas entre Workers o Durable Objects.
Qué conviene hacer ahora
Actúa esta semana si las solicitudes de clientes atraviesan bindings de servicio o Durable Objects y el equipo todavía debe unir varios logs para encontrar un salto lento. Empieza por el recorrido que más trabajo costoso genera a soporte o durante los incidentes.
Es mejor esperar si la aplicación aún consta de un solo Worker o si la demora sospechosa se encuentra por completo en un proveedor externo. Este lanzamiento no crea una traza conectada fuera de Cloudflare.
Si las trazas ya están habilitadas, revisa los nuevos spans RPC antes de añadir instrumentación personalizada. Añade spans propios solo cuando la traza automática revele un vacío importante dentro del método bajo tu responsabilidad.
El siguiente paso es pequeño: habilita observability.traces.enabled para un recorrido real, reproduce la solicitud lenta, examina la sesión RPC y los spans de método, y anota la tasa de muestreo, el promedio de spans por traza, el periodo de retención y el consumo previsto de la cuota antes de ampliar el despliegue.
Si quieres recibir una nota operativa clara cuando un cambio de plataforma modifique el trabajo o la factura, suscríbete al newsletter.
- Última actualización
- 17 sept 2026
- Categoría
- Explained
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Vercel Hobby y el límite de 10GB: qué despliegues están en riesgo
Vercel Hobby puede borrar previews y puntos de rollback antes de 30 días si el equipo supera 10GB. Descubre qué protege y cómo revisar el historial.17 sept 2026Explained
Cloudflare AI Gateway: controla quién paga cuando falta una clave
Evita que una clave ausente cargue el consumo de IA al saldo de Cloudflare. Configura AI Gateway, prueba el HTTP 400 y separa pagador y presupuesto.17 sept 2026Explained
Cloudflare Workers Python: conecta bases de datos con Hyperdrive
Cloudflare Workers Python ya se conecta a PostgreSQL y MySQL mediante Hyperdrive. Qué cambia, cuánto cuesta y cómo probarlo sin arriesgar producción.16 sept 2026Explained
Agente de voz IA con Gemini 3.8 Live: consultas sin silencios
Descubre cómo Gemini 3.8 Live mantiene la conversación mientras las herramientas trabajan en segundo plano y cómo medir el costo real por tarea completada.16 sept 2026Explained
Permisos Cloudflare Workers: aísle el despliegue de cada cliente
Configure permisos Cloudflare Workers para que cada token de despliegue alcance un solo cliente, sin ignorar bindings, rutas ni políticas heredadas.15 sept 2026Explained
Claude Code ya limita el acceso de red a cada comando
Claude Code 2.1.271 limita el acceso de red al comando que lo necesita. Aprende a instalar dependencias sin dejar el registro abierto al resto del trabajo.15 sept 2026Explained
Agentes de IA con Vercel AI SDK: cuándo paga la suscripción y cuándo la API
Vercel AI SDK ya puede cargar el uso del modelo a una suscripción autenticada en el host. Descubre qué credencial paga y por qué Sandbox se cobra aparte.15 sept 2026Explained