Cloudflare WorkersのRPCトレースで遅延箇所を特定する
Cloudflare WorkersのRPCトレースで、遅い顧客リクエストを別のWorkerやDurable Objectまで追跡。担当サービスとメソッドを見つける手順、サンプリング率、保持期間、2026年10月1日以降のスパン単位の料金まで、チェックアウトの例で実践的に解説します。



2026年9月17日、Cloudflareは、遅い顧客リクエストの原因を切り分けやすくしました。Cloudflare Workersのトレーシングが呼び出し元で途切れず、JavaScript RPC呼び出しの先にある別のWorkerやDurable Objectまで追跡できるようになったためです。手動でスパンを追加したりスタック全体を疑ったりする前に、どのサービスのどのメソッドがリクエストを滞らせたのかを確認できます。
Cloudflare Workersの分散トレーシングで埋まった「空白区間」
RPCは、言葉の印象ほど複雑ではありません。Cloudflare Workersにおけるリモートプロシージャコールとは、あるWorkerがバインディングを介し、別のWorkerやDurable Objectで公開されているJavaScriptメソッドを呼び出す仕組みです。コード上はローカルメソッドの呼び出しに見えても、実際の処理は別の場所で走ります。
トレースは、1件のリクエストを時系列で表したものです。その中で計測される個々の処理単位をスパンと呼びます。今回のリリース以前は、呼び出し元がJavaScript RPCの境界を越えたところで、この時系列が途切れていました。Worker Aが呼び出したことは分かっても、その呼び出しとWorker BやDurable Objectで動く処理をきれいに結び付けられなかったのです。
Cloudflareが9月17日に公開したアップデートは、この空白を埋めます。同じトレース上で、呼び出し元側のセッション、各メソッド呼び出し、呼び出し先の実行、ネストした呼び出し、さらに別のWorkerへのコールバックまで確認できるようになりました。トレーシングを有効にすれば、これらのスパンはCloudflareが自動で記録します。このプラットフォーム側の計測に、オブザーバビリティSDKの追加やアプリケーションコードの変更は必要ありません。
セッションスパンは、呼び出し元側のRPCセッションをまとめるコンテナです。同じセッションを再利用する呼び出しは、その配下に並びます。個々の呼び出しスパンにはメソッド名やプロパティパスが記録され、呼び出し先には独立した実行スパンが作られます。実行がWorker間を移動したときやDurable Objectに入ったときは、色の変化で区別できます。
これまで空白だった境界が、どの処理を誰が担っているかを示すマップに変わります。
1件のチェックアウトを端から端まで追う
POST /checkoutへの顧客リクエストを例にします。
リクエストは、まずチェックアウト用のWorkerに到達します。このWorkerが在庫管理用Workerのinventory.reserve()を呼び出し、続いて注文管理用Durable Objectのorder.commit()を呼び出します。顧客から見えるのは遅いチェックアウト1件だけですが、アプリケーション内には待ち時間が発生し得る場所が3か所あります。
従来は、チェックアウトのトレースがRPC呼び出しで途切れることがありました。その先を復元するには、各サービスのログや照合用の識別子、あるいはカスタムスパンが必要でした。
今は、リクエスト全体を1本のトレースとして維持できます。RPCセッションを展開し、reserveとcommitのメソッドスパンを探し、後続の実行を確認しながら、どこに実時間が偏っているかを比較できます。ルートスパンにはCloudflare Ray ID、Worker名、エントリーポイント、結果、CPU時間、実時間も記録できるため、インシデント対応者が対象のリクエストを絞り込む手掛かりになります。
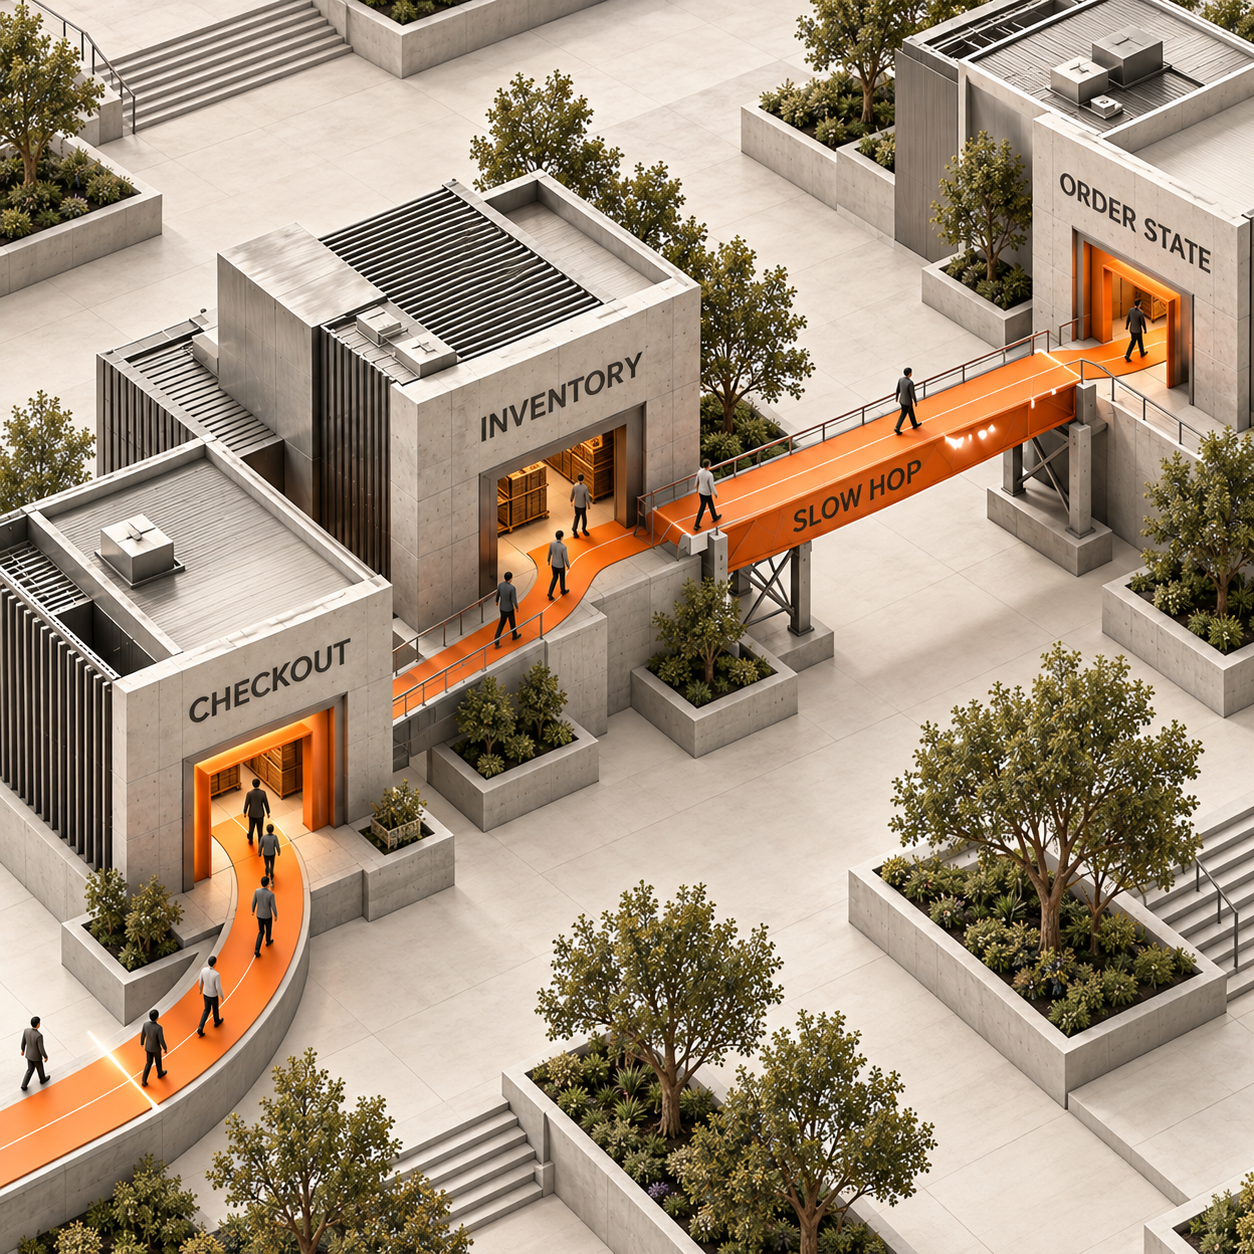
この新しい表示だけで、メソッドが遅い理由まで証明できるわけではありません。分かるのは、次に調べるべき場所です。待ち時間の大半を在庫管理側の実行が占めるなら、そのストレージや上流の依存先を確認します。Durable Object呼び出しのスパンが長いなら、そのオブジェクトのハンドラーとストレージ処理を調べます。どちらのRPCが始まるより前に呼び出し元が遅いなら、後続サービスを最初に疑うべきではありません。
この機能が役立つチーム
バックエンドを分割して運用する個人創業者
チェックアウト、在庫、注文状態を別々のWorkerで運用している創業者なら、遅い購入処理を1件再現し、Cloudflare上の経路全体を追えます。調査対象を絞れるのが大きな利点です。すべてのサービスを洗い直すのではなく、遅延を抱えるWorkerまたはDurable Objectに集中できます。
ステートフルなプロダクトを率いるバックエンド責任者
コラボレーションアプリでは、ルーム内の操作をエッジWorkerからルーム用Durable Objectへ渡すことがあります。バックエンド責任者は、呼び出し元で費やした時間とステートフルなオブジェクト内で費やした時間を分け、境界を担当するチームにトレースを引き渡せます。
社内Workerサービスを支えるプラットフォームエンジニア
プラットフォームチームでは、複数のWorkerがサービスバインディングでつながり、返されたスタブやコールバックによって、ログだけでは復元しにくい経路ができることがあります。セッションスパンとメソッドスパンを見れば、どの呼び出しがセッションを再利用したか、各区間をどのWorkerが実行したか、ネストした呼び出しがどこで経路に入ったかを把握できます。
問い合わせを検証可能な証拠に変えるサポート責任者
サポート担当者は、インシデントの詳細が新しいうちに、同じ経路を再現するようエンジニアリングへ依頼できます。得られたトレースには、「チェックアウトが遅く感じた」という報告だけでなく、サービス名とメソッドの境界が残ります。最終的な修正にログ、プロファイラー、データベースのクエリプランが必要だとしても、この情報は有用です。
月曜に試す最小テスト
最初の導入で有効なのは、本番の全Workerへ一斉展開することではなく、1本のリクエスト経路を試すことです。
顧客から見える経路を選ぶ
Worker間、またはWorkerからDurable ObjectへのRPC境界をすでに越えており、遅い状態を繰り返し再現できるリクエストを選びます。ルート、想定される後続メソッドの呼び出し、再現する時刻を書き留めてください。
Wranglerでトレースを有効にする
対象経路を処理するWorkerのWrangler設定に、Cloudflareのドキュメントにある設定を追加します。
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }通常のリリース手順で、この設定をデプロイします。このスイッチでCloudflareの自動スパンが有効になります。Worker内にSDKを組み込む必要はありません。
遅いリクエストを1件再現する
管理された条件で、同じリクエストを1回実行します。サポートやログの運用ですでに取得しているなら、ルート、タイムスタンプ、Cloudflare Ray IDを控えてください。別の値を設定しない場合、デフォルトのトレースサンプリング率は
1、つまり受信リクエストの100%がトレース対象になるため、管理された環境のほうが明瞭な結果を得られます。外側から内側へトレースを読む
CloudflareでWorkers & Pagesを開き、Workerを選択してObservabilityへ進みます。再現したリクエストを探してトレースを展開してください。ルートリクエストから始め、RPCセッション、呼び出し元のメソッドスパン、呼び出し先の実行、ネストしたDurable Object呼び出しの順に追います。スパンの幅と実時間のフィールドを使い、次に調査すべき境界を特定します。
展開前に料金への影響を測る
再現したトレースが生成したスパン数を記録します。次に、月間トレースイベント数を
サンプリング対象リクエスト数 × サンプリング対象トレース当たりの平均スパン数で見積もります。同じオブザーバビリティ枠を使う既存のログイベントも加えてください。ここで実測したスパン数が、本番環境のサンプリング方針を決める材料になります。
課金単位はリクエストではなくスパン
Workersのトレーシングは、初期ベータ期間中は無料です。2026年10月1日からは仕組みが変わり、各スパンが1件のオブザーバビリティイベントとして数えられ、Workers Logsと同じ利用枠と料金体系を共有します。
Enterpriseチームは契約内容を確認する必要があります。それ以外の利用者も、課金単位には注意が必要です。1件の顧客リクエストから、ルートスパン、RPCセッションスパン、メソッド呼び出しスパン、呼び出し先の実行、ネストしたバインディングスパンが生成される可能性があります。リクエスト数だけでは、トレースの料金は分かりません。
Cloudflareのトレーシングドキュメントによると、デフォルトのhead_sampling_rateは1、つまり100%です。高トラフィック環境の例では0.05が使われ、受信リクエスト100件のうち5件をトレースします。これは制御方法の例であり、どの環境にも当てはまる正解ではありません。
ヘッドサンプリングでは、トレードオフが明確です。比率を下げればイベント量は減りますが、対象にするかどうかはリクエストの開始時に決まります。まれに発生する遅いリクエストが選ばれない可能性もあります。管理された再現テストや適切に隔離した環境では全件をサンプリングし、その後、実際のトラフィックと1トレース当たりの実測スパン数を基に本番環境の比率を決めてください。
保持期間は、インシデント対応の進め方にも影響します。Freeプランのトレースは3日、Paidプランでは7日で消えます。その期間を過ぎてから顧客報告が届くと、必要なトレースがすでに失われているかもしれません。運用上の原則は単純です。証拠が残っているうちに再現して確認するか、運用に必要な保持期間を備えたシステムへトレースをエクスポートします。
現時点で知っておくべき制約
Workersのトレーシングは、まだオープンベータです。スパン名や属性名は変更される可能性があり、一部の属性はまだ不完全だとCloudflareは説明しています。
I/Oを伴わない一部のスパンでは、実際には処理に時間がかかっていても0 msと表示されることがあります。Workers RuntimeはI/Oイベントが発生するまで時間を更新しないため、ゼロ表示だからといって、そのJavaScript処理に時間がかからなかったとは断定できません。
Cloudflareの外に出ると、自動的なトレースの接続も途切れます。Workersのトレースをエクスポートする際、Cloudflareはまだ外部サービスへトレースIDを伝播しません。決済事業者や外部ホスティングのデータベースを呼び出しても、事業者側のトレースがWorkersの時系列へ自動的につながることはありません。
また、今回のリリースは対象が限定されています。JavaScript RPCの境界を持たない単一のWorkerでは、サービス横断の新しい表示は得られません。一般的なWorkersトレーシングはfetch、バインディング、ハンドラーの確認に引き続き役立ちますが、9月17日の変更が最も効くのは、すでに複数のWorkerやDurable Objectへ分割されたアプリケーションです。
今やるべきこと
顧客リクエストがサービスバインディングやDurable Objectを横断し、遅い区間を探すために複数のログをつなぎ合わせているなら、今週中に試す価値があります。サポートやインシデント対応で最もコストの高い経路から始めてください。
アプリケーションがまだ単一のWorkerで動いている場合や、疑わしい遅延が外部事業者の中だけにある場合は、導入を待って構いません。このリリースでは、Cloudflareの外までつながったトレースは作れません。
すでにトレーシングを有効にしているなら、カスタム計測を加える前に、新しいRPCスパンを確認してください。自動トレースによって、自分たちが管理するメソッド内に意味のある空白が見つかった場合にだけ、カスタムスパンを追加します。
月曜に実行する作業は小さくまとめられます。実際の1経路でobservability.traces.enabledを有効にし、遅いリクエストを再現して、RPCセッションとメソッドスパンを確認します。そのうえで展開範囲を広げる前に、サンプリング率、1トレース当たりの平均スパン数、保持期間、想定される利用枠の消費量を書き留めてください。
プラットフォームの変更によって作業や料金が変わるとき、要点を1本の明快な運用メモで受け取りたい方は、ニュースレターにご登録ください。
- 最終更新
- 2026年9月17日
- カテゴリー
- Explained
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
Vercel 料金の盲点:Hobbyのプレビューは30日以内でも消える
Vercel Hobbyでは、Deployment Storageが10GBを超えると、保護されていないプレビューやロールバック先が通常の30日を待たずに削除される可能性があります。残るデプロイの条件、履歴を守る監査手順、Proの月額$20を含むVercel 料金の考え方を、実務で迷わないよう具体的に整理します。2026年9月17日Explained
Cloudflare AI Gatewayで請求先の取り違えを防ぐ方法
Cloudflare AI Gatewayで顧客のプロバイダーキー欠落時に、Unified Billingへフォールバックして自社負担になるのを防ぐ方法を解説。Require provider credentialsとBYOKの優先順位、HTTP 400の検証、Spend limitとの違いを実務目線で整理します。2026年9月17日Explained
Cloudflare Workers Pythonで既存DBへ直結、ブリッジを外せるか
Cloudflare Workers Python環境で、Hyperdrive経由のPostgreSQL/MySQL直接接続が可能になりました。データベース専用ブリッジを外せる条件、Workers Paidの料金、対応ドライバー、キャッシュとSQLの制約、安全な接続テストの手順を解説します。2026年9月16日Explained
音声AIエージェントを止めないGemini 3.8 Liveの非同期ツール呼び出し
Gemini 3.8 Liveの非同期関数呼び出しで、音声AIエージェントは照会処理中も会話を継続できます。料金の見方、Extended Thinkingとの使い分け、完了判定、重複実行を防ぐ実装、検証すべき運用指標まで、電話対応への導入ポイントを実務目線で分かりやすく整理します。2026年9月16日Explained
Cloudflare Workers デプロイをクライアント単位で分離する権限設計
Cloudflare Workers デプロイをクライアント単位で安全に分離する方法を解説します。4つのロール、アカウント所有APIトークン、Wranglerの設定、バインディングやDurable Objects、Routesに残る権限上の注意点まで、制作会社が実運用へ移す手順を具体的に整理しました。2026年9月15日Explained
Claude Code セキュリティ:依存関係のインストールだけに通信を許可する
Claude Code 2.1.271では、サンドボックスの自動モードでネットワーク許可をコマンド単位に限定できます。依存関係のインストール時だけレジストリを開き、その後のビルドやテストへ通信権限を引き継がせない設定方法、適用範囲、永続許可との違い、見落としやすい制約を実務目線で解説します。2026年9月15日Explained
Vercel AI SDKの料金設計:既存サブスクリプションでエージェント費用を抑える
Vercel AI SDKがClaude CodeやCodexなどの既存サブスクリプションを使う仕組みを解説。認証情報の優先順位、プラン利用枠とAPI・AI Gatewayの請求先、Vercel Sandboxに残る実行コストまで、どの経路が誰に向くかを実例と設定手順で整理します。2026年9月15日Explained