Agentes de IA: tres presupuestos para saber cuánto pagar
Compara agentes de IA listos para usar, plataformas sin código y API, con precios en USD y tres presupuestos para 1,000 correos de soporte al mes.
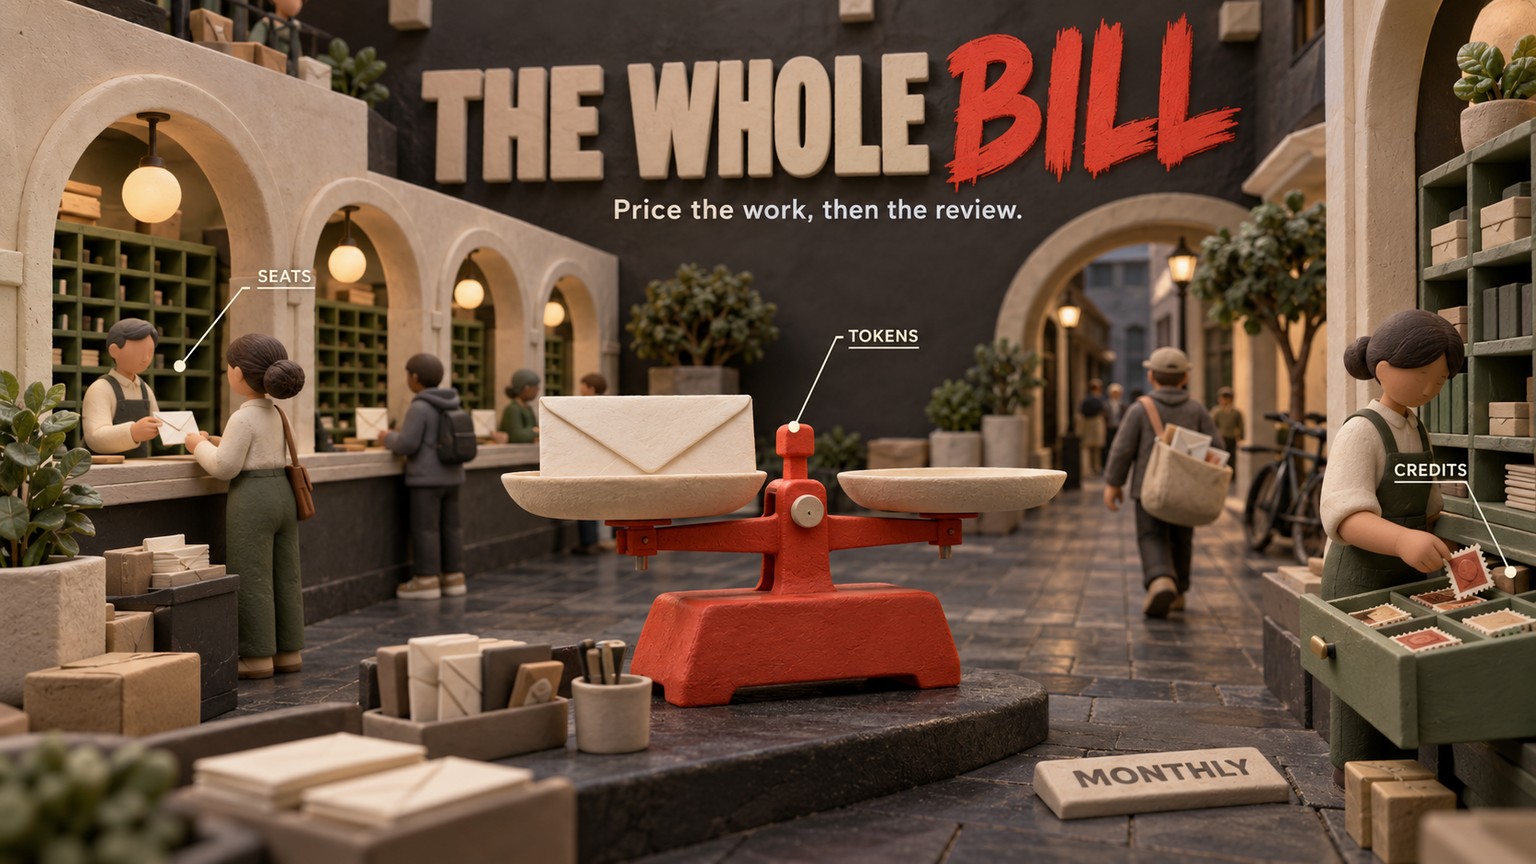
Para atender 1,000 correos de soporte al mes con agentes de IA, los presupuestos de software que calculamos aquí son de $82 con un agente listo para usar, $25.50 al mes como costo equivalente de una plataforma alojada con facturación anual y $10.50 con un flujo propio que usa una API. En todos los casos hacen falta revisión humana, una bandeja de entrada y alguien que se haga cargo cuando algo falle. La cifra que sirve para decidir es el costo mensual por respuesta aceptada.
Agentes de IA: tres formas de pagar por el mismo trabajo
Un agente de IA usa un modelo para completar una tarea y ejecutar acciones en tus herramientas. En soporte, puede leer un correo, buscar la política que corresponde y preparar una respuesta. Comprar acceso al modelo no incluye la conexión con la bandeja de entrada, el proceso de aprobación ni un servicio de soporte completo.
La factura depende de cuánto de ese sistema contrates:
- Un agente listo para usar: pagas por un asistente ya preparado, normalmente mediante una suscripción o una licencia por usuario. Cada licencia corresponde a una cuenta de usuario de pago. Esa suscripción también puede tener límites de uso.
- Una plataforma sin código: conectas los pasos del proceso y pagas por créditos, tareas o ejecuciones del flujo. Una ejecución es un recorrido completo del flujo; un crédito es la unidad con la que el proveedor mide el trabajo facturable.
- Un flujo propio que usa una API: tu software solicita trabajo a un modelo mediante una API, la interfaz que permite a los programas comunicarse. Pagas por los tokens, los fragmentos de texto que el modelo lee y genera, además del alojamiento y de cualquier herramienta de pago.
Son tres formas de contratar el mismo trabajo, cada una con responsabilidades distintas. Quien funda una empresa puede contratar la preparación de borradores en su bandeja de entrada. Quien dirige operaciones puede montar el flujo. Un equipo de backend puede hacerse cargo del software que lo ejecuta.
Los precios se comprobaron en las páginas de los proveedores el 7 de octubre de 2026. Todos los importes en dólares están expresados en USD. Las tarifas anuales se indican como tales, y los totales calculados son previsiones basadas en supuestos explícitos, no pruebas de rendimiento. Registra las horas de configuración por separado de la factura recurrente.
Precios publicados y unidades de facturación
Las filas de los modelos usan las tarifas habituales, sin caché, descuentos por procesamiento en lotes ni recargos por velocidad. Ante el mismo correo, distintos modelos pueden consumir cantidades diferentes de tokens y producir respuestas de distinta calidad. Una tarifa más baja solo resulta útil si las respuestas cumplen el nivel de calidad que exige tu soporte.
Las demás filas requieren el mismo cuidado. La tarifa inicial de Lindy no garantiza 1,000 respuestas: la redacción de borradores está dentro de un amplio rango de 2 a 250 créditos para tareas cotidianas, y enviar un correo requiere aprobación. Cada usuario activo adicional suma otra licencia de pago. Reglas de uso y aprobación de Lindy.
Los créditos de Gumloop cubren más que texto. Sus reglas actuales de pago por uso valoran cada crédito en $0.005, cobran al menos 1 crédito por llamada exitosa a un conector y 5 créditos por minuto de sesión activa, antes de la comisión habitual de orquestación del 8%. Cómo contabiliza Gumloop todos los créditos.
Si usas tu propia clave de API del modelo, sigues pagando las herramientas y el cómputo, y la comisión del agente pasa al 16% según la política actual de pago por uso; las cuentas antiguas pueden conservar reglas anteriores. Esa comisión se calcula sobre lo que habría costado la ejecución completa, incluido el uso del modelo que ahora pagas a tu proveedor. No la calcules solo sobre los cargos de herramientas que quedan.
El mismo trabajo: responder 1,000 correos de soporte al mes
Tomemos un caso concreto. Una pequeña empresa recibe 1,000 correos de soporte distintos que pueden responderse con su política vigente. El flujo prepara las respuestas y una persona revisa y envía las que acepta.
Reservamos 100 intentos adicionales de redacción, para un total de 1,100 intentos. Ese 10% es un margen de planificación, no una afirmación sobre la tasa de reintentos de ningún producto. Los ejemplos no incluyen archivos adjuntos, búsquedas en internet ni servicios de pago para enriquecer datos. La bandeja de entrada existente queda fuera del subtotal del nuevo software.
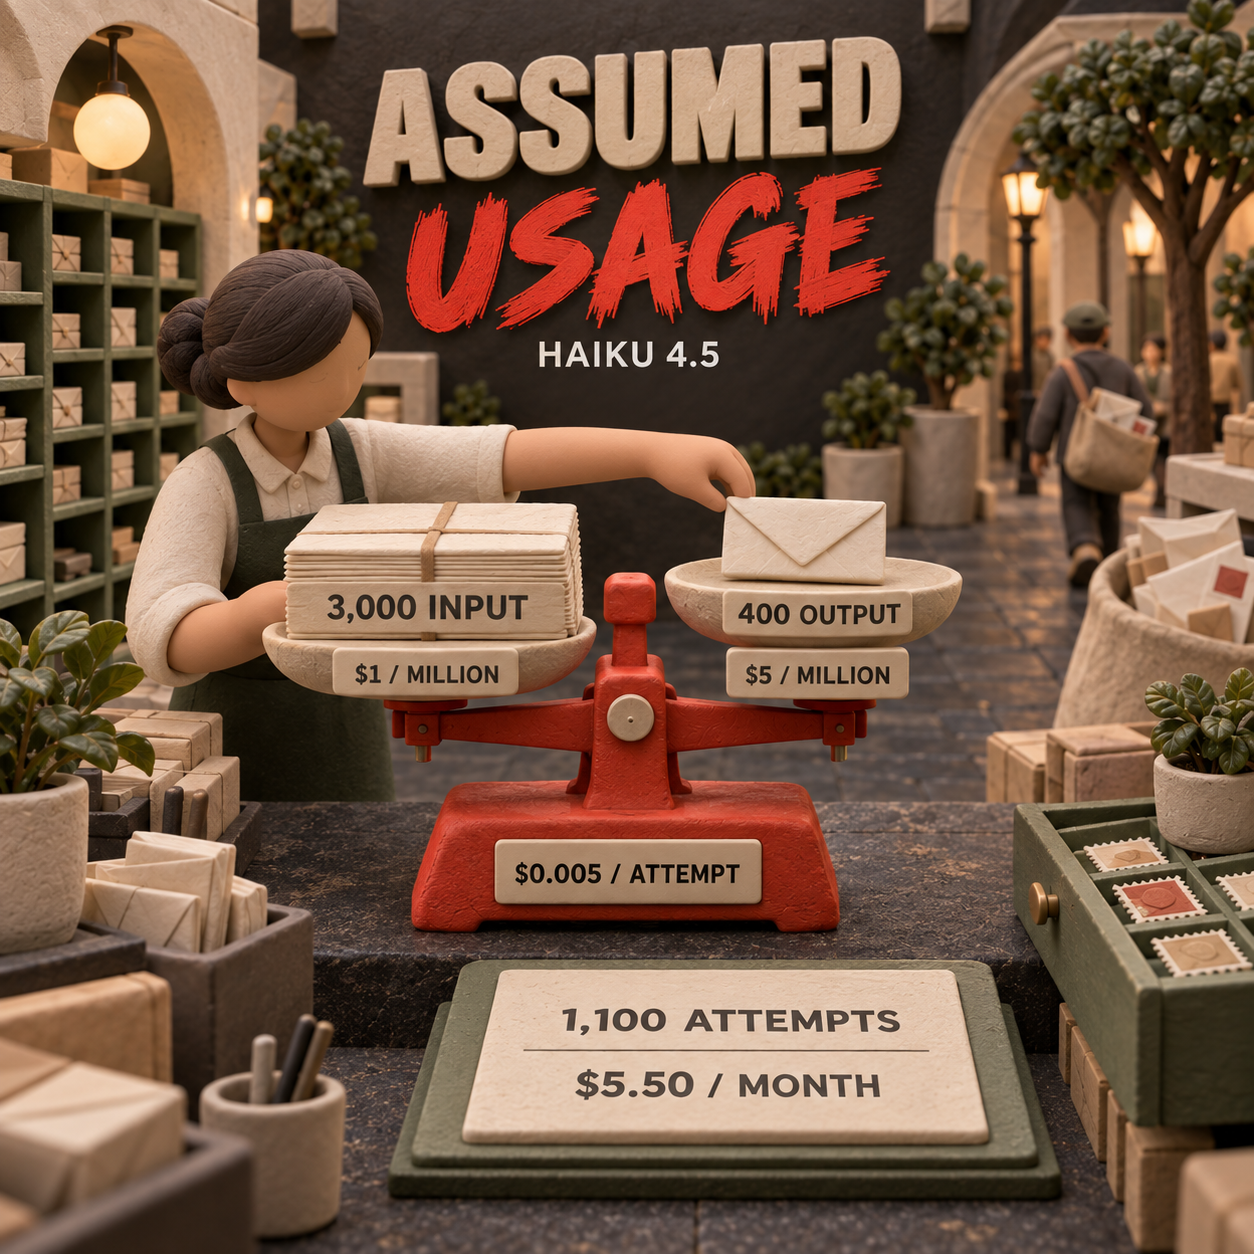
Las previsiones de la plataforma y la API suponen 3,000 tokens de entrada y 400 tokens de salida facturados por intento completo. Esas cantidades cubren una sola llamada al modelo; si el flujo hace varias llamadas, hay que sumar su consumo. El servicio listo para usar decide internamente cómo utiliza el modelo, así que lo relevante es su unidad publicada de facturación por tarea.
Opción 1: Marblism cuesta $82/mes para clasificar correos y redactar borradores con sus funciones propias
Quien dirige una empresa SaaS y usa Eva, de Marblism, paga con una bolsa compartida de horas contabilizadas. Son valores fijos asignados a cada tarea, no un cronómetro que mida cuánto tarda la IA: clasificar un correo nuevo consume 20 segundos y redactar una respuesta consume 5 minutos. Valores por tarea y planes de capacidad de Marblism.
Para este trabajo:
- Clasificar 1,000 correos nuevos: 1,000 × 20 segundos = 5.56 horas.
- Pedir 1,100 borradores de respuesta, incluidos los intentos adicionales: 1,100 × 5 minutos = 91.67 horas.
- Trabajo total contabilizado: 97.22 horas.
Ese consumo cabe en el plan de 100 horas por $82 con facturación mensual. El plan base de 50 horas por $44 no alcanza. Con la opción anual, el plan de 100 horas equivale a $45/mes, con facturación anual. El resto del trabajo de IA de la cuenta consume esa misma bolsa.
Eva prepara los borradores en tu bandeja de entrada; una persona los revisa y pulsa enviar. Por tanto, este presupuesto cubre respuestas de soporte asistidas, y la aprobación sigue siendo responsabilidad tuya. Cómo gestiona Eva las respuestas.
Hay otra cuestión de capacidad que puede cambiar la factura. Marblism contabiliza por separado cada acción de integración con una aplicación o ejecución de una automatización, a razón de 25 segundos. Si tu configuración añade una de esas acciones por intento, suma 7.64 horas y el total llega a 104.86 horas. Necesitarías el plan de 150 horas por $120/mes. La estimación de $82 solo cubre la clasificación y la redacción con las funciones propias de Marblism; revisa el desglose de uso antes de añadir otras acciones.
Opción 2: n8n con Claude equivale a $25.50/mes
Quien dirige operaciones en un comercio electrónico puede conectar el correo de soporte entrante, la política correspondiente y una llamada al modelo, y guardar después un borrador para revisión. La integración de n8n con Gmail permite leer mensajes y crear borradores, y su integración con Anthropic permite usar tu propia clave de API. Operaciones con Gmail, credenciales de Anthropic.
Supongamos que la configuración genera una ejecución completa del flujo por intento. Las 1,100 ejecuciones caben en las 2,500 ejecuciones incluidas en Starter. Los pasos dentro de una ejecución no cuentan cada uno como una ejecución adicional, pero las nuevas ejecuciones que se activen también deben caber en tu cuota. Definición de ejecución y plan de n8n.
Si usas tu propia clave de Anthropic, la factura del modelo se paga aparte:
1,100 × 3,000 = 3.3 millones de tokens de entrada.
1,100 × 400 = 0.44 millones de tokens de salida.
Con las tarifas verificadas de Haiku, 3.3 × $1 + 0.44 × $5 = $5.50. Al sumar el equivalente de $20/mes del plan anual, el presupuesto de software queda en $25.50/mes como costo equivalente. n8n aloja Starter, así que este ejemplo no añade una suscripción de alojamiento aparte.
También conviene distinguir los dos saldos de créditos de n8n. Los créditos de Assistant pagan la ayuda para crear flujos y resolver sus problemas. Los créditos de Gateway pagan los modelos a los que se llama durante la ejecución de los flujos. Este ejemplo usa tu propia clave de Anthropic en lugar de créditos de Gateway. Los créditos incluidos de Assistant no cubren esa factura del modelo. Los dos sistemas de créditos.
Opción 3: un flujo propio con la API de Claude y alojamiento cuesta $10.50/mes
Un equipo de backend puede ejecutar el mismo flujo acotado en su propia aplicación: recibir el correo, aportar la política, solicitar un borrador y guardarlo para revisión humana. Con las mismas cantidades supuestas de tokens, Haiku sigue costando $5.50/mes.
Para poner una cifra concreta al alojamiento, Cloudflare Workers Paid parte de $5 por cuenta al mes e incluye 10 millones de solicitudes y 30 millones de milisegundos de CPU. El ejemplo supone que la aplicación y su pequeño almacén de datos se mantienen dentro de las cantidades incluidas. Precios de Workers y de los servicios de datos incluidos.
El subtotal de software es $5.50 + $5 = $10.50/mes. El cálculo supone una bandeja de entrada existente, ninguna herramienta opcional de pago y ningún otro trabajo que consuma la cuota de la cuenta. Workers también tiene un plan Free; habría que comprobar por separado si sus límites encajan con tu implementación.
Con las mismas cantidades de tokens, Sonnet costaría $11 en tokens, o $16 con ese alojamiento. GPT-6 Luna costaría $0.55 en tokens, o $5.55 con alojamiento. Son comparaciones de tarifas, no pruebas de que los tres modelos resuelvan tus correos con la misma calidad.
El bajo subtotal de la API viene acompañado de responsabilidades: tu equipo mantiene la conexión con la bandeja de entrada, el almacenamiento de borradores, la gestión de errores y el comportamiento del modelo. La guía de precios de la API de Claude profundiza en las tarifas de los modelos, la caché y el procesamiento en lotes cuando ya hayas medido tu carga de trabajo.
Cómo estimar los tokens de una tarea
Empieza por todo lo que recibe el modelo, no solo por el correo del cliente. Las instrucciones, los mensajes anteriores, los fragmentos de la política, las descripciones de herramientas y sus resultados pueden sumar tokens de entrada. Cada llamada posterior al modelo puede volver a procesar parte de ese material. Cómo contabiliza Claude los tokens al usar herramientas.
Para un cálculo inicial en una hoja de cálculo, supongamos que las instrucciones ocupan 800 tokens, el correo y la conversación ocupan 400, y la política pertinente ocupa 1,800. Eso suma 3,000 tokens de entrada. Para el borrador, supongamos 400 tokens de salida facturados. Son supuestos de planificación que debes sustituir por mediciones, no cantidades de consumo típicas prometidas por un proveedor.
Cuenta toda la entrada para el modelo elegido
Envía la solicitud completa al endpoint de recuento de tokens del modelo. El contador de Claude es gratuito y específico para cada modelo, pero ofrece una estimación; las solicitudes que usan la mayoría de las herramientas alojadas o conexiones con herramientas externas requieren, en cambio, el consumo real indicado en la respuesta. Contar palabras como atajo no permite determinar la factura. Recuento de tokens de Claude.
Mide la tarea completa
Procesa correos representativos con tu configuración real. Registra los tokens de entrada y salida facturados en todas las llamadas al modelo, incluidos los borradores adicionales y los reintentos. Si activas la caché, registra su uso por separado. En una plataforma basada en créditos, consulta el desglose completo de la tarea: en Gumloop, el contador de créditos de la cabecera del chat abre el panel de detalles. Desglose de costos de Gumloop.
Multiplica por los intentos y suma los cargos fijos
Costo por intento = (tokens de entrada × tarifa de entrada + tokens de salida × tarifa de salida) ÷ 1,000,000. Costo mensual de tokens = ese costo × intentos mensuales. Después suma la tarifa de la plataforma o del alojamiento y las herramientas que se facturan por separado.
Para Haiku, (3,000 × $1 + 400 × $5) ÷ 1,000,000 = $0.005 por intento. Con 1,100 intentos, son los $5.50 del ejemplo anterior. Si una tarea requiere varias llamadas, suma sus costos antes de multiplicar por las tareas mensuales; no calcules solo el costo del borrador final.
Los costos que suelen quedar fuera del cálculo
Revisión humana y correcciones. Con un supuesto de 30 segundos por correo aceptado, revisar 1,000 respuestas requiere 500 minutos, o 8.33 horas. A un minuto por respuesta, son 16.67 horas. Multiplica las horas medidas de revisión, corrección y traspaso por tu costo total por hora de trabajo, incluidos los costos laborales indirectos. Compáralas con el tiempo que antes llevaba atender esa misma cola de correos.
Reintentos y decisiones adicionales. Los ejemplos reservan 100 intentos adicionales. Tu agente también puede clasificar la solicitud, recuperar información y comprobar su borrador mediante llamadas separadas al modelo. Incluye esas llamadas y el trabajo fallido en la factura mensual, aunque solo cuentes la respuesta aceptada como resultado.
Llamadas a herramientas. Una factura baja de tokens no cubre todas las herramientas. La búsqueda web de Claude cuesta $10 por 1,000 búsquedas, más los tokens de los resultados. Una búsqueda por intento en este ejemplo añadiría $11 en cargos por búsquedas y más tokens de entrada. Un agente de soporte que responde a partir de tu propia política puede no necesitar ninguna. Precios de las búsquedas de Claude.
Datos y otras API. Revisa los servicios que usa el flujo: bandeja de entrada, sistema de soporte, CRM, base de datos, almacenamiento de documentos y enriquecimiento de datos. Un conector incluido permite establecer la conexión; no paga automáticamente la suscripción ni el consumo del servicio conectado. Mantén visibles los costos existentes y los nuevos para calcular tanto el presupuesto operativo total como el gasto adicional que genera este agente.
Mantenimiento y capacidad. Alguien tendrá que corregir credenciales que fallen, documentos de políticas desactualizados y cambios en el comportamiento. Registra ese tiempo. Las bolsas incluidas en las suscripciones también tienen límites: otras tareas pueden consumir las mismas horas o créditos y obligarte a pasar a un plan de mayor capacidad.
Para agentes de atención al cliente que se facturan por casos resueltos, la guía sobre desarrollar una solución propia o contratar un servicio de atención al cliente aborda esa decisión de compra por separado. Mantén los cálculos económicos de ese proyecto separados de la previsión de software recurrente de este artículo.
Qué medir durante los primeros 30 días
- Resultados: correos recibidos, respuestas aceptadas, incidencias reabiertas y casos transferidos a una persona.
- Cada unidad de consumo: usuarios de pago, horas, créditos, ejecuciones, tokens de entrada y salida, y llamadas facturables a herramientas.
- Trabajo adicional: intentos por respuesta aceptada, correcciones y ejecuciones repetidas.
- Tiempo humano: revisión, traspasos y mantenimiento, en comparación con el flujo anterior.
- Otros cargos: alojamiento, almacenamiento, API conectadas y el siguiente plan de capacidad.
- Costo por respuesta aceptada: todos los costos de software, herramientas y trabajo humano atribuibles, divididos entre las respuestas aceptadas. Si mides casos cerrados, registra por separado el costo por caso resuelto.
Elige una forma de pago que puedas gestionar
Quien funda una empresa SaaS y quiere borradores en su bandeja de entrada esta semana puede empezar con un asistente listo para usar. Antes de contratarlo, comprueba que el consumo incluido cubra toda la cola de correos y asigna a la persona que revisará las respuestas. La ventaja es disponer de un entorno de trabajo ya preparado; la cifra que debes vigilar es cuántas respuestas se aceptan por mes pagado.
Quien dirige operaciones en un comercio electrónico y necesita combinar correo, políticas y datos de pedidos puede usar una plataforma para crear flujos. Prueba el flujo completo en un piloto y revisa su desglose de ejecuciones o créditos. Añade las consultas de pago a datos de pedidos antes de comparar su factura con la de un servicio más sencillo de redacción de borradores.
Quien lidera un equipo de backend y cuenta con alguien que pueda mantener el flujo puede optar por la API. Empieza con una tarea de soporte acotada y evalúa el modelo más económico que cumpla tus requisitos de calidad para las respuestas. El ahorro en tokens solo ayuda si el tiempo continuo de desarrollo y revisión cabe en el presupuesto.
El mismo método sirve para otros trabajos. Quien dirige ventas debe contar cada mensaje de seguimiento y cada acción de enriquecimiento de datos, además de los prospectos contactados. Quien gestiona operaciones financieras debe contar las consultas de datos, las llamadas al modelo y la revisión de cada informe programado, y comparar después el informe aceptado con el tiempo de trabajo manual que sustituye.
Espera antes de ampliar el uso autónomo si todavía no puedes definir qué es un resultado correcto o quién se ocupa de las excepciones. Si tu flujo actual basado en reglas ya completa el trabajo de forma fiable, añadir un modelo supone una nueva factura sin un beneficio demostrado.
Encontrarás más análisis prácticos de herramientas y presupuestos en el boletín.
- Última actualización
- 7 oct 2026
- Categoría
- Explained
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Audio a texto con Grok Voice Transcribe 2.0: mismo precio y nuevo modelo predeterminado
Grok Voice Transcribe 2.0 mantiene el precio por hora, pero cambia el modelo predeterminado. Qué revisar antes de migrar flujos de audio a texto.20 sept 2026Explained
Cloudflare Browser Run: cómo depurar un trabajo fallido antes de repetirlo
Cloudflare Browser Run reúne logs, solicitudes de red y el DOM final para diagnosticar un trabajo fallido antes de volver a ejecutarlo, sin adivinar.19 sept 2026Explained
Cómo usar componentes privados de tu sistema de diseño en v0
v0 ya instala paquetes npm privados. Aprende a conectar los componentes de tu sistema de diseño, proteger credenciales y medir el trabajo antes de publicar.19 sept 2026Explained
Claude Code precio: Auto Mode elimina cargos del clasificador
Claude Code 2.1.278 elimina el cargo separado del clasificador en sesiones elegibles. Aprende a verificar la ruta del servidor antes de ajustar el presupuesto.19 sept 2026Explained
Vercel CLI: activa Turbo en un solo despliegue
Activa Vercel Turbo en un despliegue urgente sin cambiar la configuración del proyecto. Compara el costo adicional de compilación con el tiempo ahorrado.18 sept 2026Explained
ChatGPT para Word elimina el copiar y pegar entre aplicaciones
ChatGPT para Word permite redactar y revisar sin cambiar de aplicación. Revisa el acceso al complemento, los límites de uso y un flujo práctico.18 sept 2026Explained
Google Antigravity: cómo migrar trabajos locales antes del 5 de octubre
Google Antigravity cierra el agente de mayo el 5 de octubre. Descubre qué trabajos solo cambian de ID y cuáles requieren adaptar sus herramientas locales.18 sept 2026Explained