Durable Objects Cloudflare : le tracing RPC révèle le service qui ralentit la requête
Le tracing Cloudflare Workers suit désormais les appels JavaScript RPC jusque dans les Durable Objects pour repérer le service qui ralentit une requête.



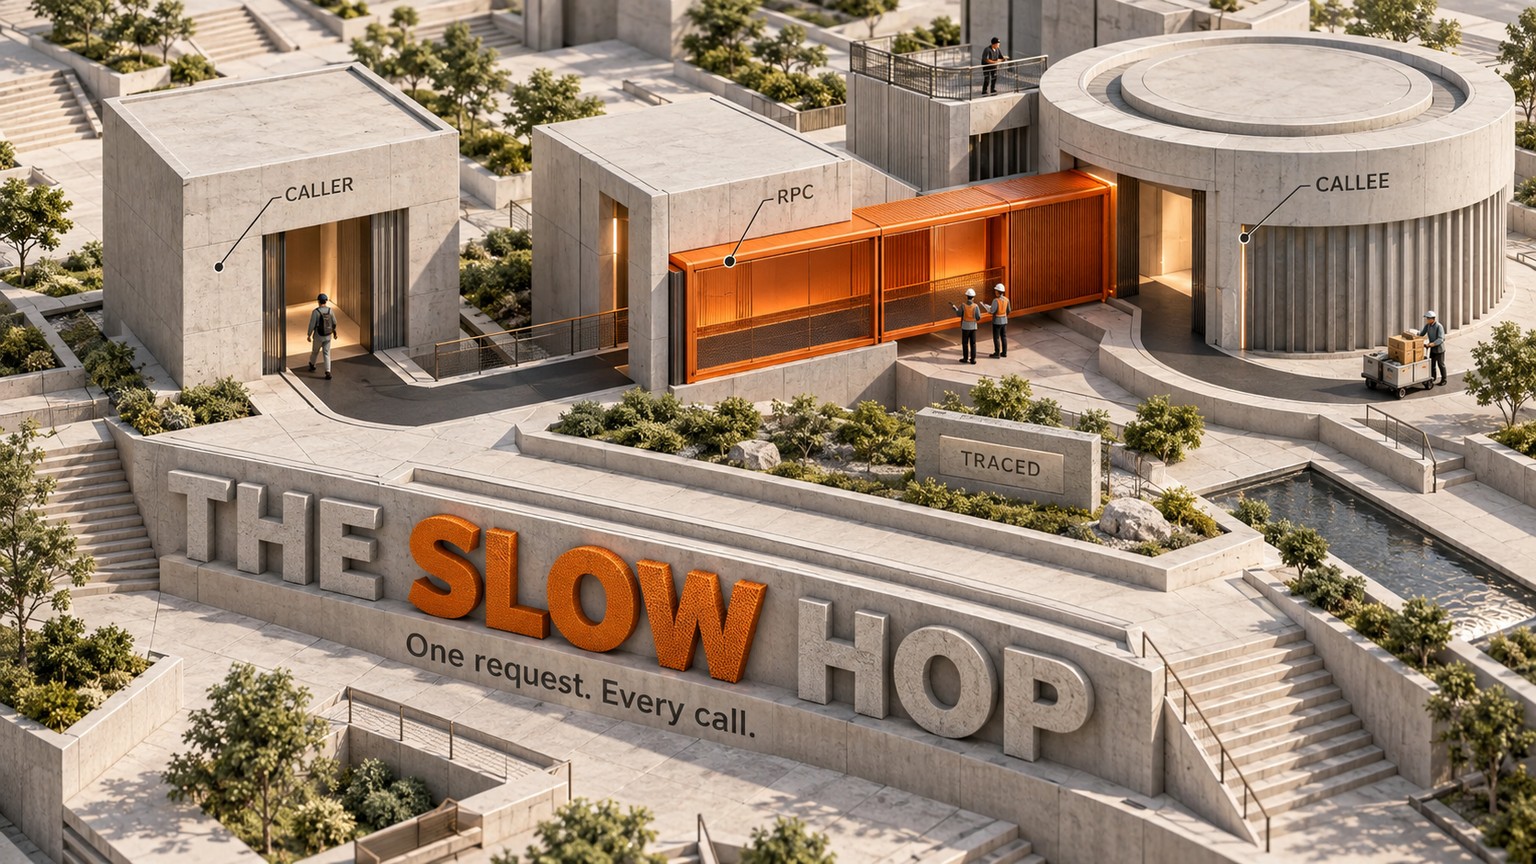
Le 17 septembre 2026, Cloudflare a facilité l’attribution des requêtes client lentes : le tracing des Workers et des Durable Objects Cloudflare peut désormais suivre un appel JavaScript RPC jusque dans un autre Worker ou un Durable Object, sans s’arrêter à l’appelant. Avant d’ajouter des spans manuels ou de mettre toute la stack en cause, on voit enfin quel service et quelle méthode ont retardé la requête.
Durable Objects Cloudflare : le maillon manquant du tracing
Le sigle RPC paraît plus complexe que le mécanisme. Dans Cloudflare Workers, un appel de procédure distante correspond à un Worker qui appelle, via un binding, une méthode JavaScript publique exposée par un autre Worker ou un Durable Object. Dans le code, l’appel ressemble à celui d’une méthode locale ; son exécution a pourtant lieu ailleurs.
Une trace restitue la chronologie d’une requête. Chaque segment chronométré est un span. Jusqu’à cette mise à jour, la chronologie s’interrompait dès que l’appelant franchissait une frontière JavaScript RPC. On voyait le Worker A lancer l’appel, sans pouvoir le relier proprement au traitement exécuté dans le Worker B ou dans un Durable Object.
La mise à jour publiée par Cloudflare le 17 septembre comble ce vide. Une même trace peut maintenant afficher la session côté appelant, chaque appel de méthode, l’invocation côté appelé, les appels imbriqués et les callbacks vers un autre Worker. Une fois le tracing activé, Cloudflare enregistre automatiquement ces spans. Cette instrumentation intégrée à la plateforme ne demande ni SDK d’observabilité ni modification du code applicatif.
Le span de session sert de conteneur à la session RPC côté appelant. Les appels qui réutilisent cette session y sont regroupés. Chaque span d’appel indique le chemin de la méthode ou de la propriété, tandis que l’appelé reçoit son propre span d’invocation. Les changements de couleur signalent le passage de l’exécution d’un Worker à l’autre ou vers un Durable Object.
La frontière jusqu’ici opaque devient ainsi une carte des responsabilités.
Suivre une requête de commande de bout en bout
Prenons une requête client vers POST /checkout.
Elle arrive d’abord dans un Worker chargé du checkout. Celui-ci appelle inventory.reserve() sur un Worker de stock, puis order.commit() sur un Durable Object de commande. Côté client, il n’y a qu’une validation de commande lente ; côté application, l’attente peut provenir de trois endroits.
Avant cette évolution, la trace du checkout pouvait s’arrêter à l’appel RPC. Pour reconstituer la suite, il fallait rapprocher les journaux de chaque service à l’aide d’identifiants communs, ou instrumenter soi-même les spans.
Désormais, la trace conserve toute la requête dans un même fil. Il devient possible de déplier la session RPC, de repérer les spans des méthodes reserve et commit, d’observer les invocations en aval, puis de comparer la répartition du temps écoulé. Les spans racine peuvent aussi contenir le Cloudflare Ray ID, le nom du Worker, l’entrypoint, le résultat, le temps CPU et le temps écoulé : autant de points d’appui concrets pour retrouver la bonne requête pendant un incident.
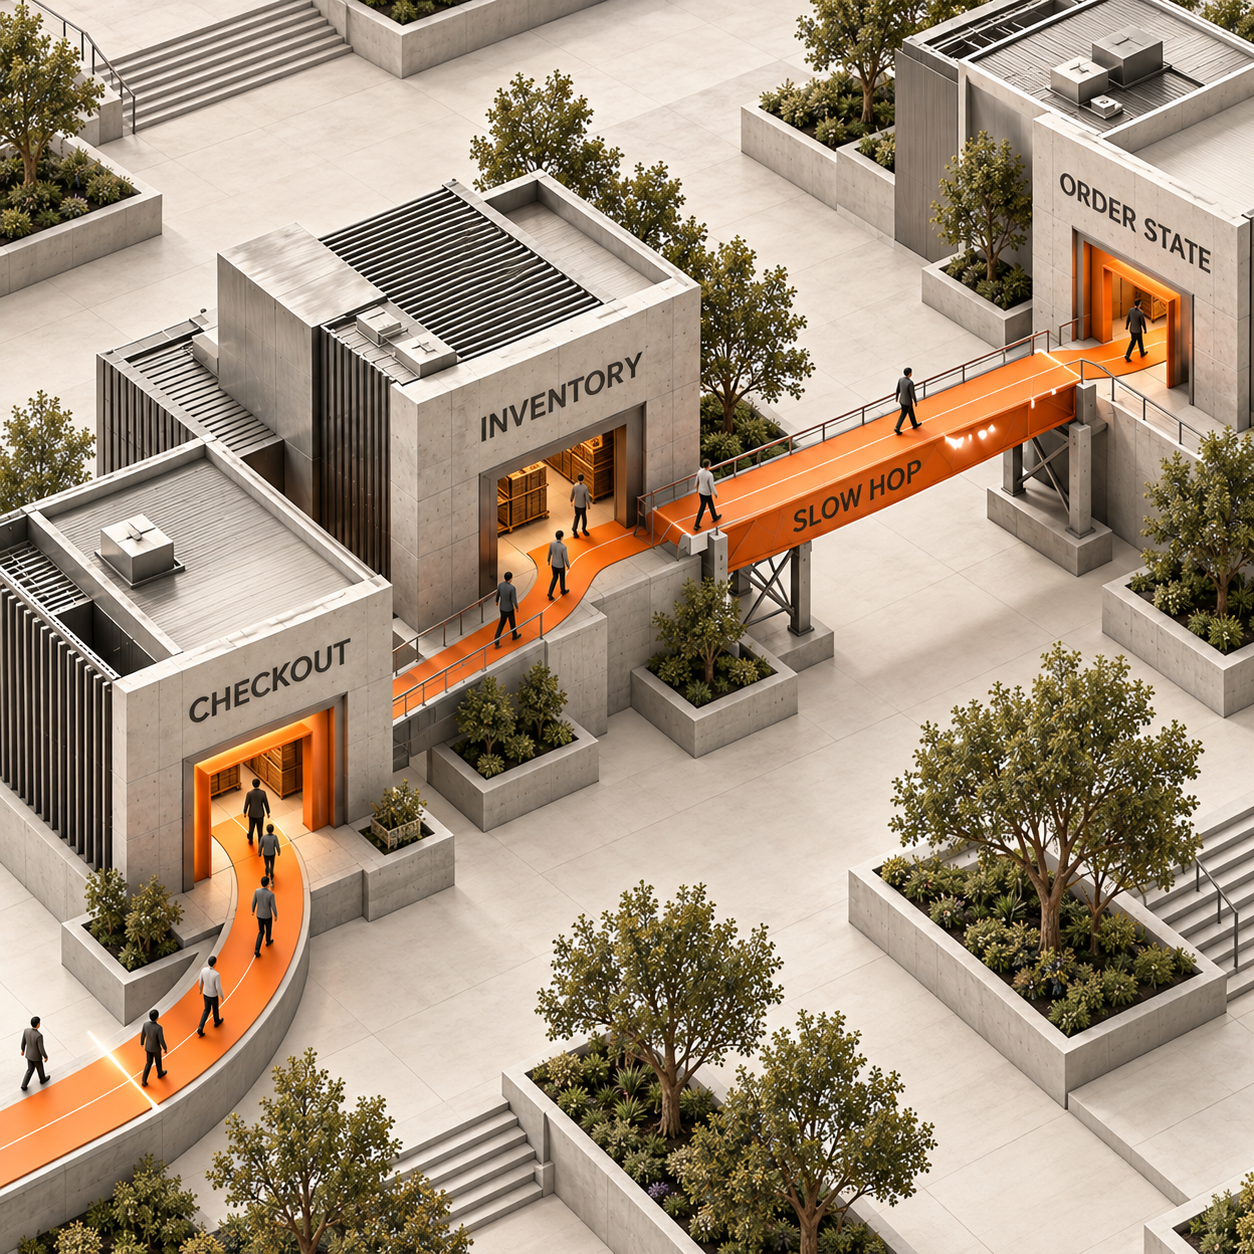
Cette vue n’explique pas à elle seule pourquoi une méthode ralentit. Elle indique où poursuivre l’enquête. Si l’invocation du service de stock concentre l’essentiel de l’attente, il faut examiner son stockage ou sa dépendance en amont. Si le span du Durable Object est le plus large, l’attention doit se porter sur son handler et ses accès au stockage. Et si le temps s’accumule chez l’appelant avant le début du moindre RPC, les services en aval ne sont pas les premiers suspects.
À qui ce tracing Cloudflare Workers est-il utile ?
Un fondateur solo avec un backend réparti
Un fondateur qui répartit le checkout, le stock et l’état des commandes entre plusieurs Workers peut reproduire un achat lent et suivre tout son parcours dans Cloudflare. Le périmètre du correctif se resserre : l’enquête cible le Worker ou le Durable Object qui porte le délai, au lieu de rouvrir chaque service.
Un responsable backend sur un produit avec état
Dans une application collaborative, une action effectuée dans une room peut passer d’un Worker en périphérie à un Durable Object associé à cette room. Le responsable backend distingue alors le temps passé chez l’appelant de celui consommé dans l’objet avec état, puis transmet la trace à l’équipe propriétaire de cette frontière.
Un ingénieur plateforme avec des services Workers internes
Une équipe plateforme peut relier plusieurs Workers par des service bindings, avec des stubs retournés et des callbacks qui rendent le parcours difficile à reconstruire depuis les journaux. Les spans de session et de méthode montrent quels appels ont réutilisé une session, quel Worker a exécuté chaque étape et où un appel imbriqué a rejoint le parcours.
Un responsable support qui transforme un signalement en preuve
Le support peut demander à l’équipe technique de reproduire le même parcours pendant que les détails de l’incident sont encore disponibles. La trace permet de transmettre le nom d’un service et la frontière d’une méthode, plutôt qu’un vague « la commande semblait lente ». Cette précision reste utile même si le correctif exige ensuite des journaux, un profiler ou le plan d’exécution d’une requête de base de données.
Le test à lancer lundi
Pour un premier déploiement utile, mieux vaut cibler un seul parcours de requête que tous les Workers de production à la fois.
Choisir un parcours visible par le client
Sélectionnez une requête qui franchit déjà une frontière RPC entre deux Workers, ou entre un Worker et un Durable Object, et dont la lenteur peut être reproduite. Notez la route, les appels de méthode attendus en aval et l’heure prévue pour la reproduction.
Activer les traces dans Wrangler
Ajoutez à la configuration Wrangler du Worker concerné le réglage documenté par Cloudflare :
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }Déployez cette configuration selon votre processus habituel. Ce réglage active les spans automatiques de Cloudflare ; aucun SDK ne doit être ajouté au Worker.
Reproduire une requête lente
Exécutez une fois la même requête dans des conditions maîtrisées. Conservez sa route, son horodatage et le Cloudflare Ray ID si vos processus de support ou de journalisation l’enregistrent déjà. Un environnement contrôlé simplifie l’analyse : par défaut, le taux d’échantillonnage des traces vaut
1. Autrement dit, 100% des requêtes entrantes sont tracées tant qu’aucune autre valeur n’est définie.Lire la trace de l’extérieur vers l’intérieur
Dans Cloudflare, ouvrez Workers & Pages, sélectionnez le Worker, puis Observability. Retrouvez la requête reproduite et dépliez sa trace. Partez de la requête racine, puis suivez la session RPC, le span de méthode côté appelant, l’invocation côté appelé et tout appel imbriqué vers un Durable Object. La largeur des spans et les champs de temps écoulé révèlent la frontière à examiner ensuite.
Évaluer la facture avant de généraliser
Relevez le nombre de spans créés par cette trace. Estimez ensuite le volume mensuel d’événements avec la formule
sampled requests × average spans per sampled trace. Ajoutez les événements de logs qui consomment déjà le même quota d’observabilité. Ce nombre de spans mesuré guidera votre choix d’échantillonnage en production.
La facture dépend des spans, pas des requêtes
Le tracing Workers reste gratuit pendant sa phase bêta initiale. La règle change le 1er octobre 2026 : à partir de cette date, chaque span compte comme un événement d’observabilité et partage le quota ainsi que la tarification de Workers Logs.
Les équipes sous contrat Enterprise doivent en vérifier les conditions. Pour les autres, l’unité de facturation mérite toute l’attention : une seule requête client peut générer un span racine, un span de session RPC, des spans d’appel de méthode, des invocations côté appelé et des spans de binding imbriqués. Le simple nombre de requêtes ne permet donc pas d’anticiper la facture du tracing.
La documentation de Cloudflare sur le tracing indique que la valeur par défaut de head_sampling_rate est 1, soit 100%. Dans son exemple destiné aux forts volumes, Cloudflare utilise 0.05, ce qui revient à tracer cinq requêtes entrantes sur cent. C’est un levier de maîtrise, pas une valeur universelle.
L’échantillonnage en amont rend le compromis très clair. Réduire le taux diminue le nombre d’événements, mais la décision est prise dès le début de la requête. Une lenteur rare peut donc échapper à la sélection. Gardez un échantillonnage complet pour une reproduction contrôlée ou un environnement suffisamment isolé ; en production, choisissez le taux à partir du trafic réel et du nombre de spans effectivement mesuré par trace.
La rétention change également la gestion des incidents. Avec l’offre Free, les traces restent disponibles 3 jours ; avec l’offre Paid, 7 jours. Si les signalements arrivent après ce délai, la trace nécessaire peut déjà avoir disparu. La règle opérationnelle tient en une phrase : reproduire et analyser tant que la preuve existe encore, ou exporter les traces vers un système dont la durée de conservation correspond au processus de l’équipe.
Les limites à connaître
Workers tracing est encore en bêta ouverte. Les noms des spans et des attributs peuvent évoluer, et Cloudflare précise que certains attributs restent incomplets.
Certains spans qui n’effectuent aucune entrée-sortie peuvent afficher 0 ms alors que le traitement a duré plus longtemps. Le Workers Runtime n’actualise le temps qu’au moment d’un événement d’entrée-sortie : une valeur nulle ne prouve donc pas qu’une portion de JavaScript n’a rien coûté.
Le suivi automatique s’interrompt aussi à la sortie de Cloudflare. Lors de l’export des traces Workers, Cloudflare ne propage pas encore les identifiants de trace aux services externes. L’appel d’un prestataire de paiement ou d’une base de données hébergée ailleurs ne reliera donc pas automatiquement la trace du fournisseur à la chronologie des Workers.
Enfin, cette mise à jour a une portée précise. Un Worker isolé, sans frontière JavaScript RPC, ne bénéficie d’aucune nouvelle vue interservices. Le tracing général de Workers peut toujours aider à analyser les fetches, les bindings et les handlers ; l’évolution du 17 septembre concerne surtout les applications déjà réparties entre plusieurs Workers ou Durable Objects.
Quelle décision prendre maintenant ?
Agissez cette semaine si les requêtes client traversent des service bindings ou des Durable Objects et que l’équipe doit aujourd’hui recouper plusieurs journaux pour repérer l’étape qui ralentit le parcours. Commencez par le parcours qui coûte le plus cher en temps de support ou de gestion d’incident.
Attendez si l’application tient encore dans un seul Worker, ou si le ralentissement suspecté se trouve entièrement chez un prestataire externe. Cette mise à jour ne crée pas de trace unifiée hors de Cloudflare.
Si le tracing est déjà actif, examinez les nouveaux spans RPC avant d’ajouter une instrumentation sur mesure. N’ajoutez des spans personnalisés qu’après avoir repéré, dans la trace automatique, un réel manque de visibilité à l’intérieur de la méthode dont vous êtes responsable.
L’action à mener lundi reste modeste : activer observability.traces.enabled sur un parcours réel, reproduire la requête lente, examiner la session RPC et les spans de méthode, puis consigner le taux d’échantillonnage, le nombre moyen de spans par trace, la fenêtre de rétention et la consommation de quota prévue avant d’étendre le déploiement.
Pour recevoir une note opérationnelle claire lorsqu’une évolution de plateforme change le travail à accomplir ou la facture, inscrivez-vous à la newsletter.
- Dernière mise à jour
- 17 sept. 2026
- Catégorie
- Explained
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Rétention des déploiements Vercel : les 30 jours ne sont plus garantis
Sur Vercel Hobby, dépasser 10GB de stockage peut entraîner la suppression d’anciens déploiements avant 30 jours. Voici ce qui reste protégé.17 sept. 2026Explained
Cloudflare AI Gateway : bloquez les requêtes sans clé avant la facture
Cloudflare AI Gateway peut refuser toute requête sans clé fournisseur avant Unified Billing. Découvrez quand le HTTP 400 s’applique et qui reste facturé.17 sept. 2026Explained
Cloudflare Hyperdrive ouvre vos bases existantes à Python
Cloudflare Hyperdrive connecte les Python Workers à PostgreSQL et MySQL. Découvrez quand supprimer la passerelle réduit vraiment les coûts et la complexité.16 sept. 2026Explained
Agent vocal IA : Gemini 3.8 Live passe aux outils asynchrones
Gemini 3.8 Live laisse un agent vocal IA parler pendant l’exécution des outils. Découvrez l’impact sur les réservations, le suivi client et les coûts.16 sept. 2026Explained
Cloudflare Worker : cloisonner les droits de déploiement par client
Cloudflare permet de limiter un token de déploiement à un seul Worker et de séparer diagnostic, revue de code et mise en production pour chaque client.15 sept. 2026Explained
Claude Code peut limiter l’accès réseau à une seule commande
Claude Code peut désormais limiter l’accès réseau à une seule commande en mode auto sandboxé, pour installer des dépendances sans élargir toute la session.15 sept. 2026Explained
Abonnement Claude Code : qui paie avec Vercel AI SDK ?
Vercel AI SDK peut imputer les agents à un abonnement Claude Code ou ChatGPT existant. Comprenez l’ordre des identifiants, les coûts et les limites.15 sept. 2026Explained