RPC JavaScript no Cloudflare Workers revela a chamada lenta
Veja como o tracing de RPC JavaScript conecta Workers e Durable Objects, aponta a chamada lenta e ajuda a calcular o custo antes de ampliar o uso.
Publicado em
 Por Omid Saffari



Em 17 de setembro de 2026, a Cloudflare facilitou a tarefa de atribuir a origem de uma solicitação lenta de cliente: o tracing de RPC JavaScript no Cloudflare Workers agora acompanha a chamada até outro Worker ou Durable Object, em vez de parar em quem chamou. Assim, dá para identificar qual serviço e qual método seguraram a solicitação antes de criar spans manuais ou culpar a stack inteira.
RPC JavaScript agora revela o trecho que faltava
RPC parece mais complicado do que realmente é. No Cloudflare Workers, uma chamada de procedimento remoto acontece quando um Worker invoca um método JavaScript público de outro Worker ou Durable Object por meio de um binding. No código, ela se parece com uma chamada de método local, embora o trabalho seja executado em outro lugar.
Um trace mostra a linha do tempo de uma solicitação. Cada trecho cronometrado dentro dele é um span. Antes deste lançamento, essa linha do tempo parava quando o chamador atravessava uma fronteira de RPC JavaScript. Era possível ver o Worker A fazer a chamada, mas não relacioná-la com clareza ao trabalho executado no Worker B ou em um Durable Object.
O lançamento da Cloudflare em 17 de setembro preenche essa lacuna. Agora, o mesmo trace pode exibir a sessão do lado do chamador, cada chamada de método, a invocação no destino, chamadas aninhadas e callbacks para outro Worker. A Cloudflare registra esses spans automaticamente assim que o tracing é ativado. Essa instrumentação da plataforma dispensa a inclusão de um SDK de observabilidade e não exige mudanças no código da aplicação.
O span de sessão funciona como contêiner da sessão RPC no lado do chamador. As chamadas que reutilizam a sessão ficam dentro dele. Cada span de chamada carrega o caminho do método ou da propriedade, enquanto o destino recebe seu próprio span de invocação. Mudanças de cor sinalizam quando a execução passa de um Worker para outro ou entra em um Durable Object.
Com isso, uma fronteira opaca vira um mapa claro de responsabilidade.
Acompanhe uma solicitação de checkout do começo ao fim
Considere uma solicitação de cliente para POST /checkout.
Ela chega primeiro a um Worker de checkout. Esse Worker chama inventory.reserve() em um Worker de estoque e, depois, order.commit() em um Durable Object de pedidos. Para o cliente, existe apenas um checkout lento; na aplicação, a espera pode estar em três lugares.
Antes da mudança, o trace do checkout podia terminar na chamada RPC. Para reconstruir o restante, seria preciso consultar os logs de cada serviço, cruzar identificadores ou criar spans personalizados.
Agora, o trace mantém toda a solicitação conectada. É possível expandir a sessão RPC, localizar os spans dos métodos reserve e commit, ver as invocações seguintes e comparar onde está concentrado o tempo total. Os spans raiz também podem trazer Cloudflare Ray ID, nome do Worker, entrypoint, resultado, tempo de CPU e tempo total. São referências úteis para quem precisa encontrar a solicitação certa durante um incidente.
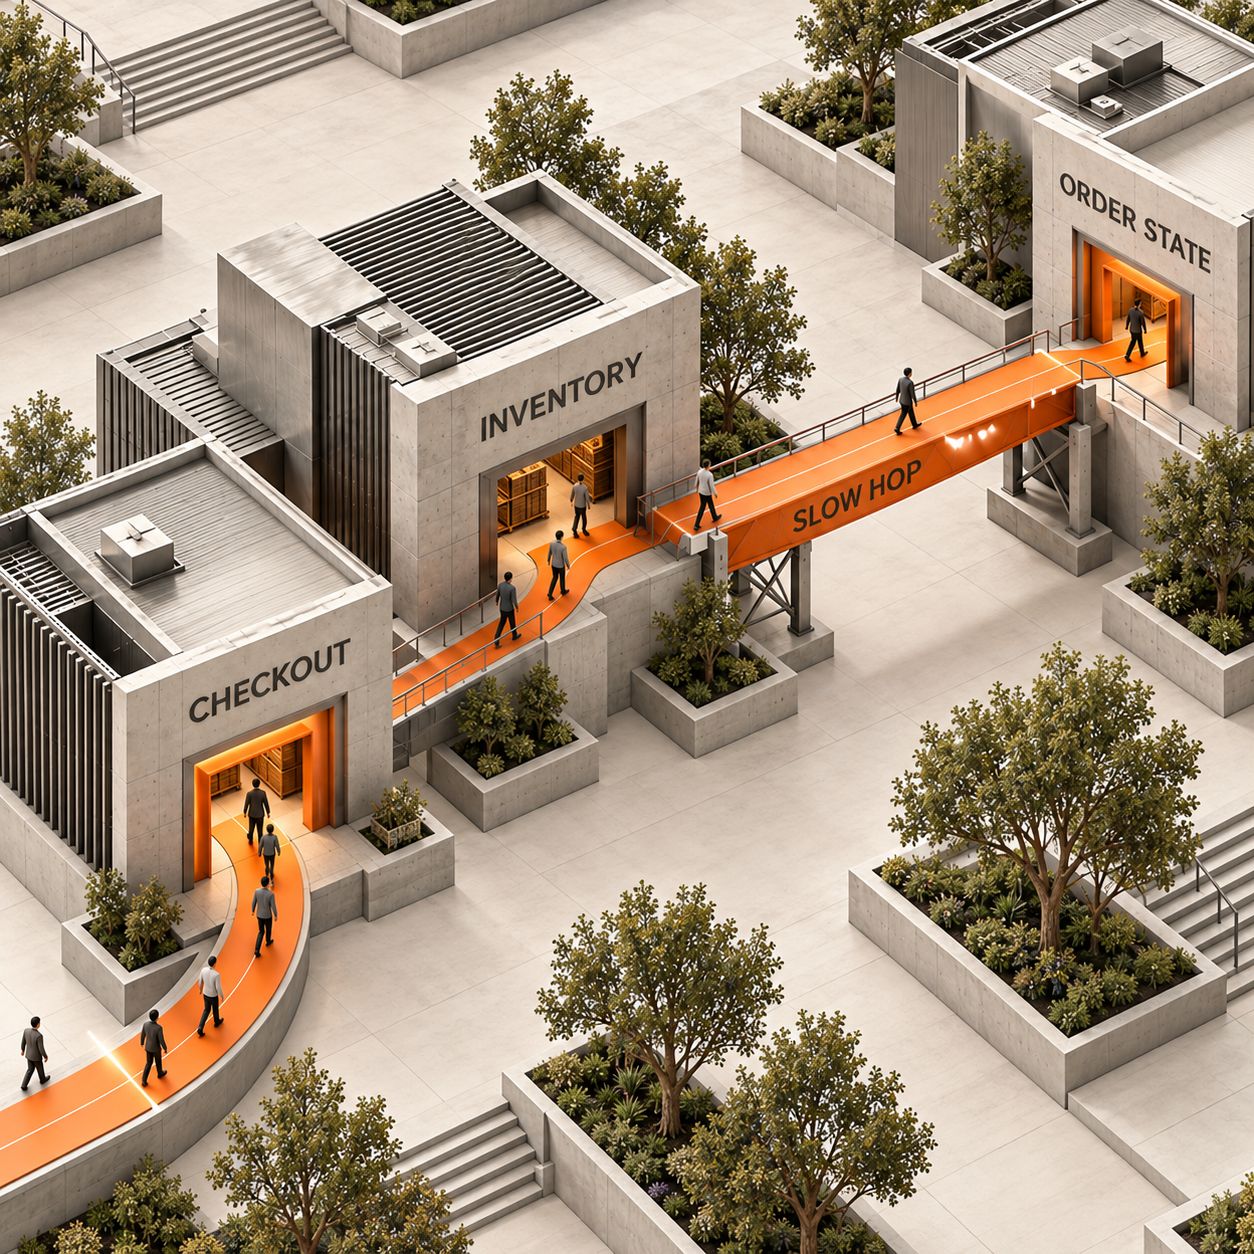
A nova visualização não explica por que um método está lento. Ela aponta onde investigar em seguida. Se a invocação do estoque concentra a maior parte da espera, examine o armazenamento ou a dependência externa desse serviço. Se a chamada ao Durable Object aparece como o span mais largo, verifique o handler do objeto e suas operações de armazenamento. Se a lentidão está no chamador antes mesmo de qualquer RPC começar, os serviços seguintes não são os primeiros suspeitos.
Quem ganha com isso
Um fundador solo com o backend dividido
Quem mantém checkout, estoque e estado do pedido em Workers separados pode reproduzir uma compra lenta e acompanhar todo o percurso dentro da Cloudflare. O ganho é reduzir a área de investigação: a análise se concentra no Worker ou Durable Object responsável pelo atraso, sem reabrir todos os serviços.
A liderança de backend de um produto com estado
Em um app de colaboração, uma ação dentro de uma sala pode sair de um Worker na borda e chegar a um Durable Object da própria sala. A liderança de backend consegue separar o tempo gasto no chamador daquele consumido pelo objeto com estado e, então, entregar o trace à equipe responsável por essa fronteira.
Engenharia de plataforma com serviços internos em Workers
Uma equipe de plataforma pode ter vários Workers ligados por service bindings, com stubs retornados e callbacks formando um caminho difícil de reconstruir apenas com logs. Os spans de sessão e de método mostram quais chamadas reutilizaram uma sessão, qual Worker executou cada etapa e onde uma chamada aninhada entrou no fluxo.
Suporte transformando relato em evidência
O suporte pode pedir que a engenharia reproduza a mesma rota enquanto os detalhes do incidente ainda estão frescos. O trace resultante acrescenta ao repasse o nome do serviço e a fronteira do método, em vez de apenas dizer que “o checkout estava lento”. Isso continua útil mesmo quando a correção final exige logs, um profiler ou o plano de consulta do banco de dados.
Comece na segunda-feira com um teste controlado
Para começar, faça o rollout em um único caminho de solicitação, não em todos os Workers de produção de uma vez.
Escolha um caminho visível para o cliente
Selecione uma solicitação que já atravesse uma fronteira RPC entre Workers ou entre um Worker e um Durable Object e que tenha um caso lento reproduzível. Registre a rota, as chamadas de método esperadas nos serviços seguintes e o horário em que o teste será reproduzido.
Ative os traces no Wrangler
Adicione à configuração do Wrangler no Worker responsável por esse caminho a opção documentada pela Cloudflare:
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }Faça o deploy dessa configuração pelo fluxo normal de releases. A opção ativa os spans automáticos da Cloudflare sem exigir um SDK dentro do Worker.
Reproduza uma solicitação lenta
Execute uma vez a mesma solicitação em condições controladas. Guarde a rota, o timestamp e o Cloudflare Ray ID, caso o fluxo de suporte ou de logs já o capture. Um ambiente controlado produz um resultado mais limpo porque a taxa padrão de amostragem de traces é
1: quando nenhuma outra taxa é definida, 100% das solicitações recebidas entram no tracing.Leia o trace de fora para dentro
Na Cloudflare, acesse Workers & Pages, selecione o Worker e abra Observability. Encontre a solicitação reproduzida e expanda o trace. Comece pela solicitação raiz; depois, siga a sessão RPC, o span do método no chamador, a invocação no destino e qualquer chamada aninhada a um Durable Object. Use a largura do span e os campos de tempo total para localizar a fronteira que merece a próxima investigação.
Calcule a conta antes de ampliar o uso
Registre quantos spans o trace reproduzido criou. Depois, estime os eventos mensais de tracing como
sampled requests × average spans per sampled trace. Some também os eventos de log que já consomem a mesma cota de observabilidade. A quantidade medida de spans será a base para decidir a amostragem em produção.
O custo é por span, não por solicitação
O tracing do Workers é gratuito durante o período beta inicial. Isso muda em 1º de outubro de 2026. A partir dessa data, cada span passa a contar como um evento de observabilidade e compartilha a mesma cota e a mesma tabela de preços do Workers Logs.
Equipes Enterprise precisam consultar o próprio contrato. Para todos os demais, o ponto importante é a unidade de cobrança: uma única solicitação de cliente pode gerar um span raiz, um span de sessão RPC, spans de chamadas de método, invocações no destino e spans de bindings aninhados. Só a quantidade de solicitações não permite prever a conta de tracing.
A documentação de tracing da Cloudflare informa que o valor padrão de head_sampling_rate é 1, ou 100%. No exemplo de alto tráfego, a taxa é 0.05, o que rastreia cinco de cada cem solicitações recebidas. Esse exemplo é um mecanismo de controle, não uma resposta universal.
A amostragem no início da solicitação deixa o trade-off evidente. Uma taxa menor reduz o volume de eventos, mas a decisão acontece antes de a solicitação ser processada. Por isso, uma solicitação lenta e rara pode ficar de fora. Use amostragem integral em uma reprodução controlada ou em um ambiente devidamente isolado; depois, escolha a taxa de produção com base no tráfego real e no número de spans medido em cada trace.
A retenção também muda o fluxo de resposta a incidentes. No plano Free, os traces duram 3 dias; no Paid, 7 dias. Se o relato do cliente chegar depois desse intervalo, o trace necessário talvez já tenha desaparecido. A regra operacional é simples: reproduza e examine enquanto a evidência ainda existe ou exporte os traces para um sistema cuja retenção atenda ao processo da equipe.
Os limites, sem maquiagem
O Workers tracing ainda está em beta aberto. Os nomes de spans e atributos podem mudar, e a Cloudflare informa que alguns atributos continuam incompletos.
Alguns spans que não envolvem I/O podem exibir 0 ms mesmo quando o trabalho levou mais tempo. O Workers Runtime só atualiza o tempo quando ocorre um evento de I/O. Portanto, zero não prova que um trecho de JavaScript não consumiu tempo.
O trace também deixa de ser automático fora da Cloudflare. Ao exportar traces do Workers, a Cloudflare ainda não propaga os IDs de trace para serviços externos. Em uma chamada a um provedor de pagamentos ou a um banco de dados hospedado em outro lugar, o trace do lado do fornecedor não será conectado automaticamente à linha do tempo do Workers.
Por fim, este lançamento tem alcance específico. Um único Worker sem fronteira de RPC JavaScript não recebe uma nova visão entre serviços. O tracing geral do Workers ainda pode ajudar a analisar fetches, bindings e handlers, mas a mudança de 17 de setembro é especialmente relevante para aplicações que já estão divididas entre Workers ou Durable Objects.
O que fazer agora
Vale agir ainda nesta semana se as solicitações dos clientes atravessam service bindings ou Durable Objects e a equipe ainda precisa combinar vários logs para localizar um trecho lento. Comece pelo caminho que mais custa em trabalho de suporte ou resposta a incidentes.
Vale esperar se a aplicação ainda roda em um único Worker ou se a suspeita de lentidão está inteiramente em um provedor externo. Este lançamento não cria um trace conectado fora da Cloudflare.
Se o tracing já está ativo, examine os novos spans de RPC antes de acrescentar instrumentação personalizada. Crie spans próprios somente quando o trace automático revelar uma lacuna relevante dentro do método sob responsabilidade da equipe.
O próximo passo, já na segunda-feira, é pequeno: ative observability.traces.enabled para um caminho real, reproduza a solicitação lenta, examine a sessão RPC e os spans de método e, antes de ampliar o rollout, registre a taxa de amostragem, a média de spans por trace, a janela de retenção e o consumo de cota esperado.
Se você quer receber uma nota operacional objetiva sempre que uma mudança de plataforma afetar o trabalho ou a conta, assine a newsletter.
- Publicado
- Categoria
- Explained
- Idioma
Agente de IA: o custo mensal de planos, plataformas e APIs
Compare assinaturas, plataformas no-code e APIs para um agente de IA, com três orçamentos mensais e os custos de uso, revisão humana e manutenção.7 de out. de 2026Explained
Converter áudio em texto com Grok 2.0 custa $0.10/h no modo batch
Entenda como converter áudio em texto com Grok Voice Transcribe 2.0, por que o batch segue em $0.10 por hora e como evitar mudanças silenciosas na API.20 de set. de 2026Explained
Automação de navegador: como investigar falhas no Cloudflare Browser Run
O novo painel Inspect do Cloudflare Browser Run reúne logs, rede e DOM final para diagnosticar falhas antes de executar a automação de navegador novamente.19 de set. de 2026Explained
Design system privado no v0: componentes reais desde o protótipo
Veja como conectar um design system privado ao v0 com NPM_TOKEN ou NPM_RC, proteger credenciais e reduzir retrabalho na passagem para produção.19 de set. de 2026Explained
Claude Code preço: como a versão 2.1.278 corta cobranças do modo automático
Veja quando o Claude Code 2.1.278 deixa de cobrar o classificador do modo automático, como validar a sessão e por que gateways ainda podem gerar custos.19 de set. de 2026Explained
Deploy Vercel com Turbo: mais velocidade só quando importa
Aprenda a acelerar um deploy Vercel urgente com Turbo sem mudar a configuração do projeto e calcule quanto o tempo economizado acrescenta à fatura.18 de set. de 2026Explained
ChatGPT Word elimina o copia e cola entre aplicativos
O ChatGPT Word cria rascunhos, resume e revisa textos sem sair do documento. Veja como instalar, controlar custos e evitar mudanças sem revisão.18 de set. de 2026Explained