Tracing Cloudflare Workers: come individuare il servizio che rallenta una richiesta
Il tracing Cloudflare Workers ora segue le chiamate RPC tra Worker e Durable Object: come isolare il servizio lento e stimare costi e conservazione.



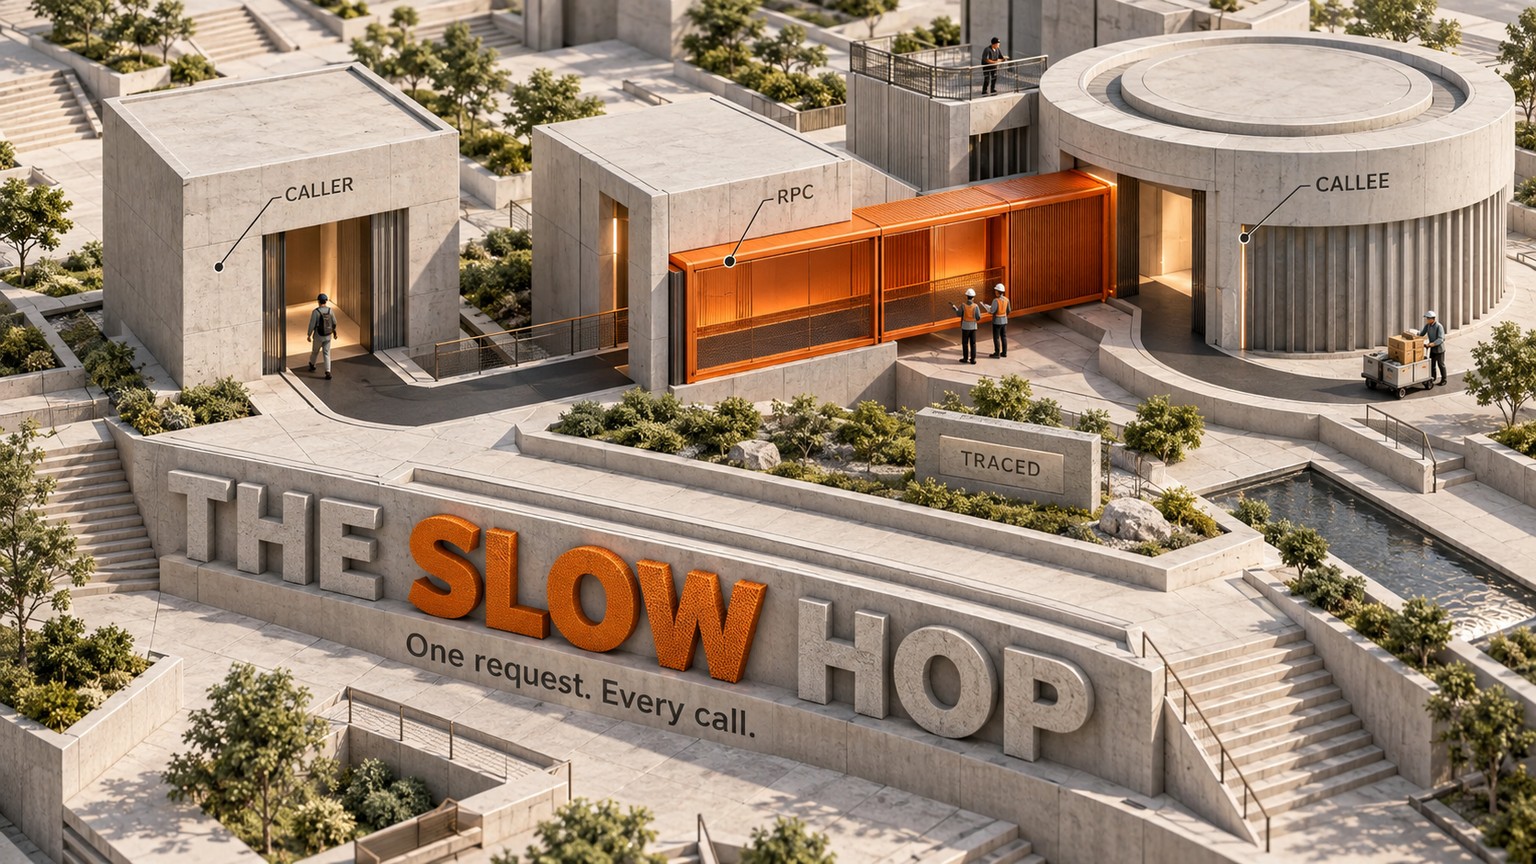
Il 17 settembre 2026, Cloudflare ha reso più semplice capire dove nasce il rallentamento di una richiesta utente: il tracing Cloudflare Workers può ora seguire una chiamata RPC JavaScript anche quando entra in un altro Worker o Durable Object, anziché fermarsi al chiamante. Così si vede quale servizio e quale metodo hanno trattenuto la richiesta, prima di aggiungere span manuali o attribuire la colpa all’intero stack.
Il tracing Cloudflare Workers colma il vuoto tra i servizi
RPC sembra un concetto più complesso di quanto sia in realtà. In Cloudflare Workers, una chiamata di procedura remota avviene quando un Worker richiama, tramite un binding, un metodo JavaScript pubblico esposto da un altro Worker o da un Durable Object. Nel codice appare come una normale chiamata a un metodo locale, ma l’elaborazione avviene altrove.
Una trace è la sequenza temporale di una singola richiesta. Ogni segmento cronometrato al suo interno è uno span. Prima di questo rilascio, la sequenza si interrompeva quando il chiamante attraversava un confine RPC JavaScript: si vedeva il Worker A effettuare la chiamata, ma non era possibile collegarla in modo chiaro al lavoro eseguito nel Worker B o in un Durable Object.
Il rilascio Cloudflare del 17 settembre colma questa lacuna. La stessa trace può ora mostrare la sessione dal lato chiamante, ogni chiamata di metodo, l’invocazione del destinatario, le chiamate annidate e i callback verso un altro Worker. Cloudflare registra automaticamente questi span una volta abilitato il tracing. Per questa strumentazione della piattaforma non occorre aggiungere un SDK di osservabilità né modificare il codice dell’applicazione.
Lo span di sessione racchiude la sessione RPC dal lato chiamante. Le chiamate che riutilizzano la sessione sono annidate al suo interno. I singoli span delle chiamate riportano il percorso del metodo o della proprietà, mentre il destinatario riceve un proprio span di invocazione. I cambi di colore indicano quando l’esecuzione passa da un Worker all’altro o entra in un Durable Object.
Così, un confine prima invisibile diventa una mappa delle responsabilità.
Seguire una richiesta di checkout dall’inizio alla fine
Prendiamo una richiesta utente a POST /checkout.
La richiesta raggiunge prima un Worker di checkout. Questo Worker chiama inventory.reserve() su un Worker di inventario e poi order.commit() su un Durable Object degli ordini. L’utente vede soltanto un checkout lento, ma nell’applicazione l’attesa può trovarsi in tre punti diversi.
Prima di questa modifica, la trace del checkout poteva terminare in corrispondenza della chiamata RPC. Per ricostruire il resto servivano i log di ogni servizio, identificatori corrispondenti oppure span personalizzati.
Ora la trace può mantenere unita l’intera richiesta. È possibile espandere la sessione RPC, individuare gli span dei metodi reserve e commit, vedere le invocazioni a valle e confrontare dove si concentra il tempo trascorso. Gli span radice possono inoltre includere Cloudflare Ray ID, nome del Worker, entrypoint, esito, tempo CPU e wall time: riferimenti utili per chi deve individuare la richiesta corretta durante un incidente.
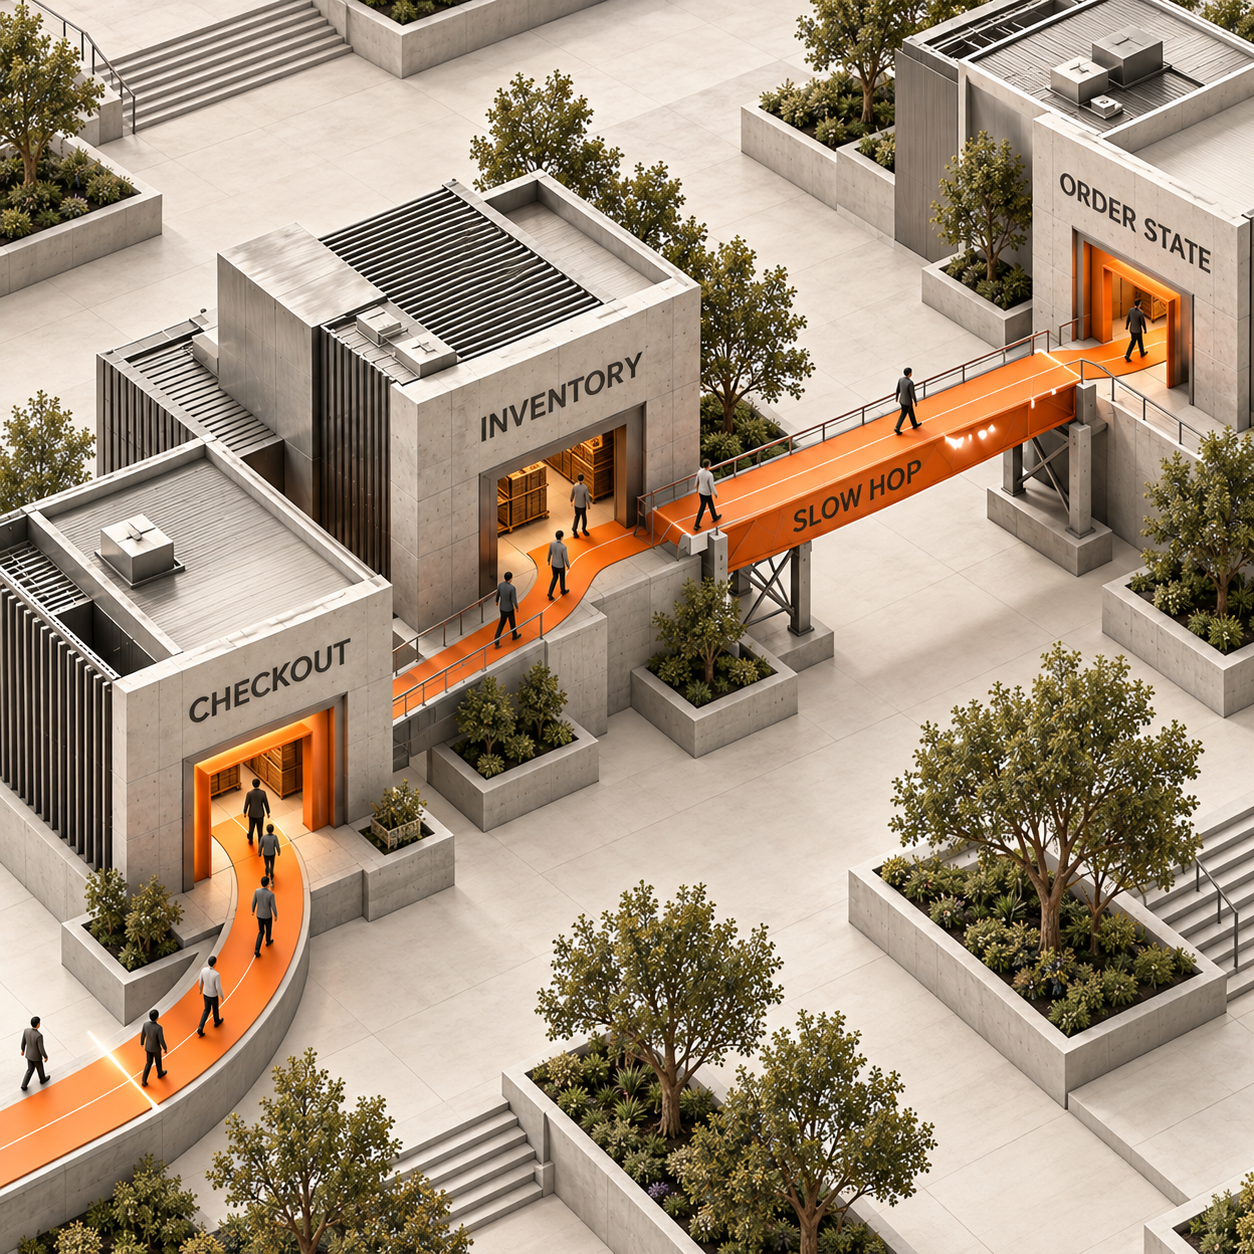
La nuova vista non dimostra perché un metodo sia lento, ma indica dove proseguire l’indagine. Se l’invocazione dell’inventario assorbe gran parte dell’attesa, occorre esaminarne lo storage o una dipendenza a monte. Se lo span più ampio è quello della chiamata al Durable Object, vanno controllati il relativo handler e le operazioni sullo storage. Se invece il chiamante è già lento prima dell’avvio di entrambe le RPC, i servizi a valle non sono il primo indiziato.
Chi può trarne vantaggio
Un founder con un backend suddiviso
Chi gestisce da solo checkout, inventario e stato degli ordini in Worker separati può riprodurre un singolo acquisto lento e seguirlo lungo l’intero percorso Cloudflare. Il vantaggio è un’area d’intervento più circoscritta: si analizza il Worker o il Durable Object responsabile del ritardo, senza dover riaprire ogni servizio.
Un responsabile backend per un prodotto con stato
Un’app di collaborazione può instradare un’azione eseguita in una stanza da un Worker edge a un Durable Object della stanza. Il responsabile backend può separare il tempo trascorso nel chiamante da quello speso nell’oggetto con stato, quindi consegnare la trace al team responsabile di quel confine.
Un platform engineer con servizi Worker interni
Un team di piattaforma può avere diversi Worker collegati tramite service binding, con stub restituiti e callback che creano un percorso difficile da ricostruire dai log. Gli span di sessione e di metodo mostrano quali chiamate hanno riutilizzato una sessione, quale Worker ha eseguito ogni parte e dove una chiamata annidata è entrata nel percorso.
Un responsabile del supporto che trasforma una segnalazione in una prova
Il supporto può chiedere al team di engineering di riprodurre lo stesso percorso mentre i dettagli dell’incidente sono ancora recenti. La trace ottenuta aggiunge al passaggio di consegne un servizio e un confine di metodo precisi, al posto di un generico «il checkout sembrava lento». Rimane utile anche quando la correzione finale richiede comunque log, un profiler o il piano di esecuzione di una query al database.
Il test da fare lunedì
Per il primo rollout è più utile scegliere il percorso di una singola richiesta, non tutti i Worker in produzione contemporaneamente.
Scegli un percorso visibile all’utente
Scegli una richiesta che attraversi già un confine RPC da Worker a Worker o da Worker a Durable Object e per la quale esista un caso lento riproducibile. Annota la route, le chiamate di metodo a valle previste e l’orario in cui la riprodurrai.
Abilita il tracing in Wrangler
Aggiungi alla configurazione Wrangler del Worker che gestisce quel percorso l’impostazione documentata da Cloudflare:
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }Distribuisci la configurazione seguendo il normale processo di rilascio. Questa opzione abilita gli span automatici di Cloudflare e non richiede un SDK all’interno del Worker.
Riproduci una richiesta lenta
Esegui una volta la stessa richiesta in condizioni controllate. Conserva route, timestamp e Cloudflare Ray ID, se il flusso di supporto o logging già lo acquisisce. Un ambiente controllato è preferibile perché il tasso di campionamento predefinito delle trace è
1: se non viene impostato un valore diverso, viene tracciato il 100% delle richieste in ingresso.Leggi la trace dall’esterno verso l’interno
In Cloudflare, vai su Workers & Pages, seleziona il Worker e apri Observability. Trova la richiesta riprodotta ed espandine la trace. Parti dalla richiesta radice, quindi segui la sessione RPC, lo span del metodo chiamante, l’invocazione del destinatario ed eventuali chiamate annidate a Durable Object. Usa l’ampiezza dello span e i campi del wall time per individuare il confine su cui proseguire l’indagine.
Calcola il costo prima del rollout
Annota quanti span ha generato la trace riprodotta. Stima quindi gli eventi di tracing mensili con la formula
sampled requests × average spans per sampled trace. Aggiungi gli eventi di log che consumano già la stessa quota di osservabilità. Il numero di span misurato è il dato da cui partire per decidere il campionamento in produzione.
Il costo si calcola per span, non per richiesta
Il tracing di Workers è gratuito durante il periodo iniziale di beta. La situazione cambia il 1 ottobre 2026: da quella data ogni span conta come un evento di osservabilità e condivide la stessa quota e gli stessi prezzi di Workers Logs.
I team Enterprise devono verificare il proprio contratto. Per tutti gli altri, il dato da non perdere di vista è l’unità di fatturazione: una singola richiesta utente può generare uno span radice, uno span di sessione RPC, span delle chiamate di metodo, invocazioni del destinatario e span di binding annidati. Il solo numero di richieste non basta per stimare il costo delle trace.
La documentazione Cloudflare sul tracing indica che il valore predefinito di head_sampling_rate è 1, cioè il 100%. Nell’esempio ad alto traffico viene usato 0.05, che traccia cinque richieste in ingresso ogni cento. È un esempio di controllo dei volumi, non una risposta valida in ogni situazione.
L’head sampling rende evidente il compromesso. Un tasso più basso riduce il volume degli eventi, ma la decisione viene presa all’inizio della richiesta e una richiesta lenta rara potrebbe non essere selezionata. Usa il campionamento completo per una riproduzione controllata o in un ambiente adeguatamente isolato; scegli poi il tasso di produzione in base al traffico reale e agli span misurati per ogni trace.
Anche la conservazione modifica il flusso di gestione degli incidenti. Le trace del piano Free restano disponibili per 3 giorni, quelle del piano Paid per 7 giorni. Se le segnalazioni degli utenti arrivano dopo questa finestra, la trace necessaria potrebbe essere già scomparsa. La regola operativa è semplice: riproduci e analizza il problema finché le prove sono disponibili, oppure esporta le trace in un sistema con tempi di conservazione adeguati al processo.
I limiti, senza giri di parole
Il tracing di Workers è ancora in beta aperta. I nomi degli span e degli attributi possono cambiare e, secondo Cloudflare, alcuni attributi sono ancora incompleti.
Alcuni span non legati a operazioni di I/O possono mostrare 0 ms anche se il lavoro ha richiesto più tempo. Il Workers Runtime non aggiorna il tempo finché non si verifica un evento di I/O, quindi uno zero non dimostra che un blocco di JavaScript non abbia avuto alcun costo.
Fuori da Cloudflare, inoltre, la trace non prosegue automaticamente. Quando si esportano le trace di Workers, Cloudflare non propaga ancora gli ID di trace ai servizi esterni. Una chiamata verso un provider di pagamenti o un database ospitato altrove non unirà automaticamente la trace del fornitore alla timeline di Workers.
Infine, questo rilascio ha un ambito circoscritto. Un singolo Worker senza confini RPC JavaScript non ottiene una nuova vista tra servizi. Il tracing generale di Workers può comunque aiutare con fetch, binding e handler, ma la modifica del 17 settembre è particolarmente utile per le applicazioni già distribuite tra più Worker o Durable Object.
Cosa fare adesso
Conviene agire questa settimana se le richieste degli utenti attraversano service binding o Durable Object e il team deve ancora combinare più log per individuare un passaggio lento. Parti dal percorso che genera il lavoro di supporto o di gestione degli incidenti più costoso.
Meglio aspettare se l’applicazione usa ancora un solo Worker o se il ritardo sospetto si trova interamente presso un provider esterno. Questo rilascio non crea una trace unificata fuori da Cloudflare.
Se il tracing è già attivo, esamina i nuovi span RPC prima di aggiungere strumentazione personalizzata. Aggiungi span personalizzati soltanto quando la trace automatica rivela una lacuna significativa all’interno del metodo di cui sei responsabile.
L’intervento di lunedì è circoscritto: abilita observability.traces.enabled per il percorso di una richiesta reale, riproduci la richiesta lenta, esamina la sessione RPC e gli span di metodo, quindi annota tasso di campionamento, media degli span per trace, finestra di conservazione e consumo di quota previsto prima di estendere il rollout.
Se vuoi ricevere una nota operativa chiara ogni volta che una modifica alla piattaforma cambia il lavoro o i costi, iscriviti alla newsletter.
- Ultimo aggiornamento
- 17 set 2026
- Categoria
- Explained
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Vercel Hobby oltre 10GB: la regola dei 30 giorni non basta più
Con Vercel Hobby, superati 10GB di Deployment Storage, preview e rollback non protetti possono sparire prima dei 30 giorni. Ecco cosa proteggere.17 set 2026Explained
Cloudflare AI Gateway: come evitare addebiti sul conto sbagliato
Cloudflare AI Gateway blocca le richieste senza chiavi del provider prima che i costi finiscano su Unified Billing. Scopri come configurarlo e testarlo.17 set 2026Explained
Cloudflare Workers Python: accesso ai database esistenti
Con Cloudflare Workers Python, PostgreSQL e MySQL passano da Hyperdrive: quando eliminare il bridge, quali costi restano e come testare la migrazione.16 set 2026Explained
Gemini Live mantiene fluide le chiamate mentre i tool lavorano
Gemini 3.8 Live mantiene attiva la conversazione mentre API e calendari lavorano in background. Costi, rischi e test per gli agenti vocali AI.16 set 2026Explained
Permessi Cloudflare Workers: circoscrivere il deploy per cliente
I permessi Cloudflare Workers consentono di limitare un token CI a un singolo Worker: ruoli, scope, binding e passaggio di consegne al cliente.15 set 2026Explained
Claude Code sandbox: la rete si apre per un solo comando
Claude Code 2.1.271 limita l’accesso alla rete al singolo comando nella sandbox, così l’installazione non lascia il registry aperto al resto del job.15 set 2026Explained
Abbonamento Claude Code in Vercel AI SDK: chi paga il conto
Scopri come Vercel AI SDK usa un abbonamento Claude Code o Codex, quali credenziali determinano il costo e perché Vercel Sandbox resta a pagamento.15 set 2026Explained