Gemini Live mantiene fluide le chiamate mentre i tool lavorano
Gemini 3.8 Live mantiene attiva la conversazione mentre API e calendari lavorano in background. Costi, rischi e test per gli agenti vocali AI.




Il 15 settembre 2026, Google ha portato in disponibilità generale Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking. La novità che conta in Gemini Live è semplice: un agente vocale può continuare ad aggiornare chi è al telefono mentre il calendario, il sistema degli ordini o l'API di prenotazione svolgono in background le operazioni più lente.
Con Gemini Live, la chiamata non si ferma più durante il lookup
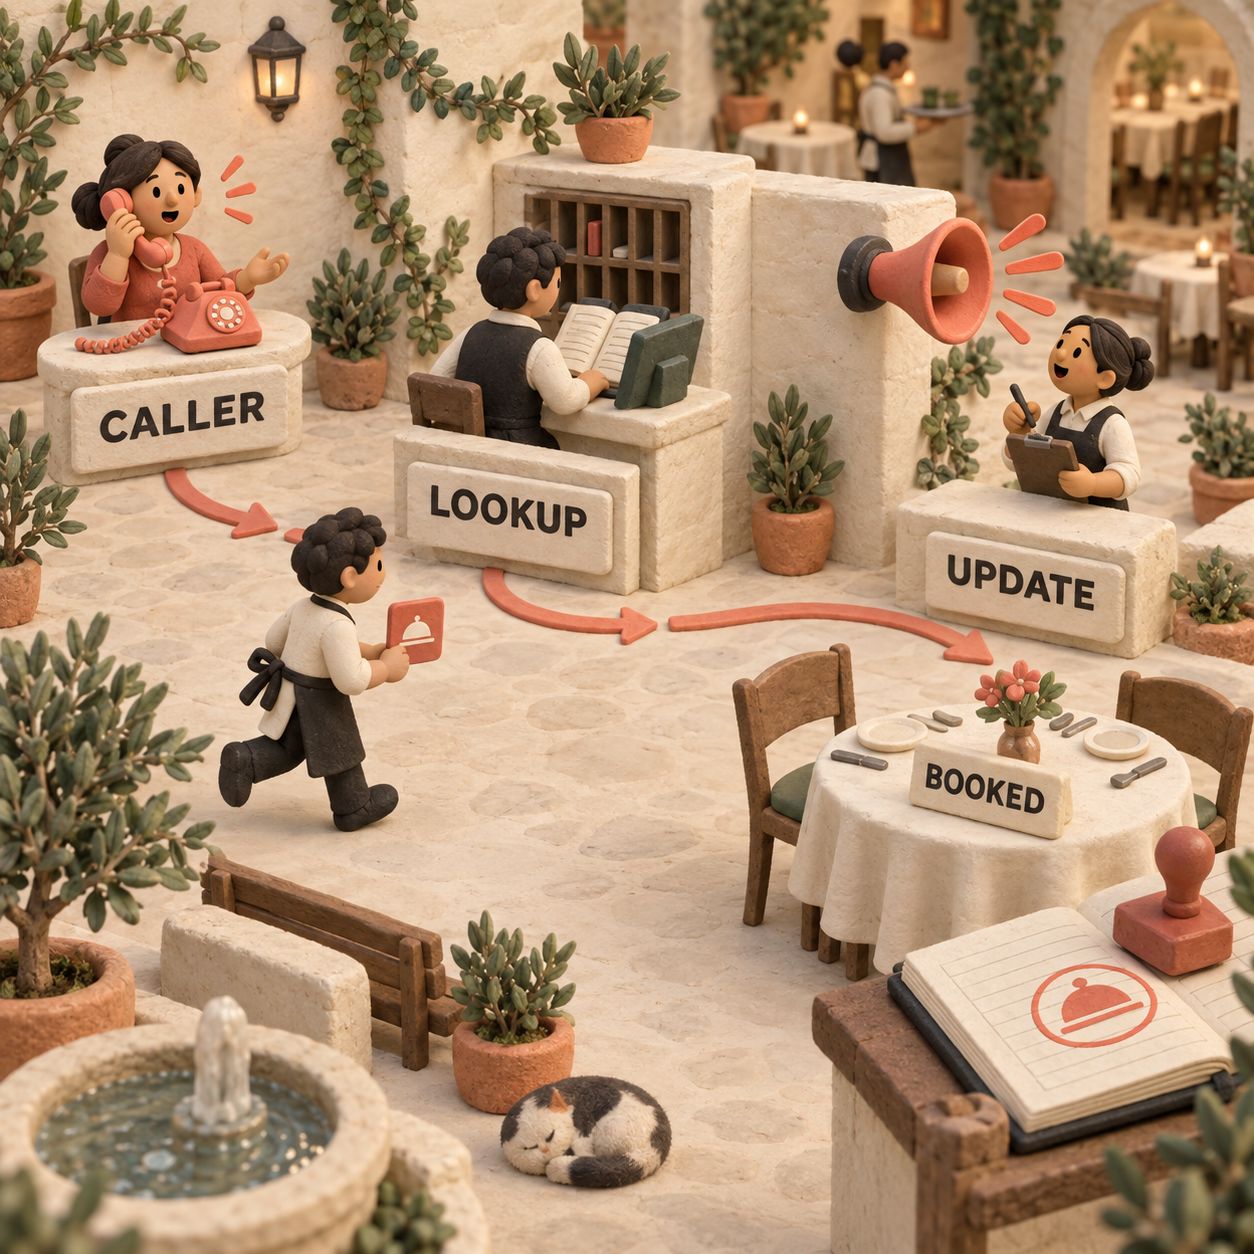
Un agente vocale deve gestire due attività contemporaneamente: sostenere una conversazione naturale e portare a termine un'operazione concreta in un altro sistema.
È il secondo compito a creare i momenti più imbarazzanti. L'agente interroga l'API di prenotazione per trovare uno slot libero, aspetta e lascia la persona nel silenzio. Chi chiama ripete la richiesta, domanda se ci sia ancora qualcuno in linea oppure riaggancia. E se l'applicazione interpreta quella ripetizione come una nuova istruzione, rischia anche di avviare due volte la stessa operazione.
Gemini 3.8 Live cambia questo flusso grazie al function calling asincrono. In pratica, il tool può continuare a lavorare senza bloccare l'intera sessione live. Nel frattempo, chi è al telefono può aggiungere informazioni, correggere un dettaglio o ricevere un aggiornamento mentre il lookup è ancora in corso.
Gemini 3.8 Live Extended Thinking fa un passo ulteriore: può ragionare su un'attività composta da più passaggi e comunicare brevi aggiornamenti mentre i tool sono in esecuzione. Nell'esempio di Google, gestisce una prenotazione di viaggio consultando più sistemi senza interrompere la conversazione live.
Questo non significa che Gemini effettui prenotazioni in autonomia. È sempre l'applicazione a ricevere la chiamata di funzione, interrogare il calendario o il sistema degli ordini e restituire il risultato. Il modello gestisce la conversazione che accompagna questo lavoro.
L'ultima colonna nasconde la trappola più insidiosa in produzione. Con Extended Thinking, turnComplete: true può indicare soltanto la fine di un aggiornamento vocale intermedio, mentre il lookup è ancora in corso. Chiudere la sessione, abilitare il pulsante di prenotazione o segnare l'attività come completata in quel momento produce falsi completamenti.
La metrica di business è il costo per attività completata
Parlare mentre un tool lavora non genera automaticamente un risparmio. Può aumentare l'output del modello durante l'attesa e, se la conversazione si allunga, far rielaborare una quantità maggiore di contesto nei turni successivi. La funzione crea valore solo se questa continuità porta a più prenotazioni concluse, meno chiamate abbandonate o meno interventi manuali.
Google indica le stesse tariffe standard per entrambi i nuovi modelli: l'input audio costa $0.005 al minuto e l'output audio $0.018 al minuto. L'input testuale costa $0.75 per 1 milione di token, mentre l'output testuale, inclusi i token di ragionamento, costa $4.50 per 1 milione di token.
Consideriamo una chiamata di prenotazione di cinque minuti, durante la quale il modello parla per due minuti. Poiché l'audio proattivo è sempre attivo, il calcolo essenziale del nuovo audio è $0.025 per cinque minuti di input più $0.036 per due minuti di output. Il subtotale grezzo dell'audio è quindi $0.061.
Non è il costo finale della chiamata.
La guida alla fatturazione della Live API spiega che, in una sessione persistente, il contesto accumulato può essere elaborato di nuovo nei turni successivi. Le trascrizioni aggiungono costi per i token di testo; Extended Thinking può aggiungere output di ragionamento. Calendario, CRM, operatore telefonico, hosting, tentativi ripetuti e passaggi a un operatore umano restano fuori dal subtotale audio di Google.
Meglio usare questa formula:
Costo per attività completata = spesa complessiva per modello, tool, telefonia, infrastruttura, tentativi ripetuti e interventi umani, divisa per il numero di attività completate e verificate.
Un'attività completata non è una trascrizione gradevole. Per un servizio di appuntamenti, significa un ID di prenotazione scritto una sola volta, riletto correttamente e accettato dalla persona al telefono. Per l'assistenza sugli ordini, significa eseguire l'azione corretta sull'ordine associato all'account giusto. Per un trasferimento, vuol dire raggiungere la coda prevista mantenendo intatto il contesto.
Google restituisce periodicamente in usageMetadata il totale dei token consumati. Collega quel dato all'ID della chiamata al tool, alla sessione dell'operatore telefonico, al risultato aziendale finale e all'eventuale lavoro umano. Otterrai così un registro verificabile per ogni chiamata, invece di una stima al minuto da accettare sulla fiducia.
I numeri del lancio non sostituiscono questo test pilota. Per Extended Thinking, Google dichiara il 68.6% nel benchmark tau-Voice e il 35.1% nella relativa versione bancaria. Questi risultati indicano che vale la pena testare il modello nei workflow vocali basati su agenti; non dicono quale percentuale di persone riuscirà a completare una prenotazione nel tuo calendario, con le tue regole e la tua connessione telefonica.
Quattro flussi di lavoro in cui l'attesa fa la differenza
Uno studio dentistico che fissa un appuntamento
Il responsabile operativo può lasciare che l'agente raccolga il giorno preferito, avvii una verifica delle disponibilità e comunichi che la ricerca è ancora in corso mentre il calendario risponde. Il vantaggio non è soltanto eliminare il silenzio: è confermare più appuntamenti, riducendo le richiamate da parte dello staff.
La regola di sicurezza è netta: un aggiornamento vocale non equivale a una prenotazione. Il sistema deve creare l'appuntamento solo dopo che la persona ha scelto uno degli orari restituiti; inoltre, ogni nuovo tentativo deve riutilizzare una chiave di idempotenza, così una sola chiamata non potrà generare due volte lo stesso appuntamento.
Un team ecommerce che verifica un ordine
L'assistenza può mantenere la persona nella stessa conversazione mentre l'agente consulta il sistema degli ordini. Se la richiesta passa da «dov'è il mio pacco?» a «cambia l'indirizzo di consegna», l'applicazione deve considerare attiva la richiesta più recente e annullare o ignorare il lavoro ormai superato.
Il beneficio è ridurre i passaggi a un operatore nei casi ordinari. Il rischio è fornire la risposta giusta a una domanda vecchia, quando la conversazione è già andata oltre.
Un team viaggi che modifica una prenotazione
Ricerca dei voli, controlli delle policy, disponibilità alberghiera e confronto delle tariffe rendono questo scenario più adatto a Extended Thinking. Il modello può raccontare l'avanzamento mentre esegue più funzioni non bloccanti.
I pagamenti e le modifiche ai biglietti devono restare subordinati a una conferma. Una voce naturale non riduce il livello di approvazione richiesto per un'azione irreversibile.
Una coda di assistenza tecnica che diagnostica un problema dell'account
Una rapida verifica dell'account è adatta a Gemini 3.8 Live. Una diagnosi che raccoglie più log e controlla una configurazione può invece giustificare Extended Thinking.
La distinzione conta, perché un ragionamento più approfondito non è gratuito. Instrada le richieste in base alla complessità, poi confronta i tassi di risoluzione e di escalation. Non affidare ogni reimpostazione di password al percorso più pesante solo perché il nome del modello ispira maggiore sicurezza.
Implementa il ciclo di vita in background prima della linea telefonica
Inizia con una sessione attivata da testo e un tool stub. In questo modo puoi isolare il comportamento asincrono prima che operatore telefonico, microfono, bridge audio e calendario di produzione aggiungano altri quattro punti in cui cercare gli errori.
L'esempio seguente usa l'attuale SDK Python di Google, la configurazione di Extended Thinking, una funzione dichiarata non bloccante, il modello di risposta del tool e i campi interaction_status e usageMetadata. Salva l'audio restituito a 24 kHz nel file response.wav. Il risultato del tool è uno stub locale, quindi non interagisce con un calendario reale.
pip install -U google-genai
export GEMINI_API_KEY="YOUR_API_KEY"import asyncio
import wave
from google import genai
from google.genai import types
client = genai.Client()
model = "gemini-3.8-live-extended-thinking"
check_availability = types.FunctionDeclaration(
name="check_availability",
description="Checks the calendar for the next available appointment.",
behavior="NON_BLOCKING",
parameters={
"type": "OBJECT",
"properties": {},
},
)
config = types.LiveConnectConfig(
response_modalities=["AUDIO"],
thinking_config=types.ThinkingConfig(thinking_level="low"),
tools=[types.Tool(function_declarations=[check_availability])],
)
async def main():
async with client.aio.live.connect(model=model, config=config) as session:
await session.send_client_content(
turns={
"parts": [
{"text": "Find the next available appointment and keep me updated."}
]
}
)
with wave.open("response.wav", "wb") as audio:
audio.setnchannels(1)
audio.setsampwidth(2)
audio.setframerate(24000)
async for message in session.receive():
status = getattr(message, "interaction_status", None)
if message.data is not None:
audio.writeframes(message.data)
if message.usage_metadata:
print("Tokens:", message.usage_metadata.total_token_count)
if message.tool_call:
replies = []
for call in message.tool_call.function_calls:
replies.append(
types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": "Tuesday morning is available."},
)
)
await session.send_tool_response(function_responses=replies)
if status == "IDLE":
print("Interaction complete")
break
if __name__ == "__main__":
asyncio.run(main())L'errore più probabile è interrompere l'ascolto al primo turnComplete. Extended Thinking potrebbe aver appena detto «Sto controllando» ed essere ancora in attesa del tool. Continua ad ascoltare finché interaction_status non diventa IDLE e conserva l'associazione fra l'ID della chiamata al tool e il risultato aziendale finale.
Per un agente telefonico in produzione, aggiungi il bridge audio soltanto quando questo loop si comporta correttamente. Il confronto più ampio dei costi degli agenti vocali aiuta a scegliere l'operatore e i livelli di orchestrazione da affiancare al modello. Per confrontare la misurazione a token di Google con una tariffa vocale più semplice lato front end, l'analisi dei costi di chiamata di GPT-Live-1 mostra perché il denominatore basato sulle attività completate è importante in entrambi i casi.
Costruisci il test pilota attorno a un registro, non a una demo
Scegli un solo evento di completamento
Parti da un flusso ben delimitato, per esempio un appuntamento confermato. Definisci l'esatto evento nel database che dimostra il completamento e indica tutti gli stati che corrispondono a errore, abbandono, lavoro duplicato o passaggio a un operatore umano.
Registra l'intero ciclo di vita live
Salva l'ID di sessione, ogni ID di chiamata ai tool, i cambiamenti di
interaction_status, gli orari di avvio e fine dei tool eusageMetadata. Una frase usata per riempire l'attesa indica avanzamento, non completamento.Riunisci ogni livello di costo
Associa allo stesso record della chiamata l'utilizzo di Gemini, i costi del calendario o del CRM, le tariffe dell'operatore telefonico, l'infrastruttura, i tentativi ripetuti e il tempo dello staff. Non confrontare il subtotale audio esemplificativo di Google pari a $0.061 con il costo complessivo della soluzione esistente.
Metti alla prova i percorsi di errore
Interrompi l'agente, cambia la data richiesta mentre è in corso un lookup, provoca un timeout del tool, fai restituire al tool l'assenza di disponibilità e chiudi la chiamata prima del risultato. Verifica che le chiamate ai tool ormai obsolete non possano registrare una prenotazione.
Confronta le attività completate
Esegui gli stessi tipi di chiamata nel flusso attuale e in quello nuovo. Confronta completamenti verificati, abbandoni, lavoro di escalation, azioni duplicate e costo totale per attività completata. Dichiara un risparmio solo dopo aver riconciliato tutti questi dati.
I limiti, senza giri di parole
Il modello può riempire il silenzio, ma non può rendere veloce un calendario lento, riparare una connessione telefonica scadente o decidere che cosa la tua azienda consideri davvero concluso.
Le sessioni solo audio sono limitate a 15 minuti, a meno di aggiungere tecniche di gestione della sessione per sostenere conversazioni più lunghe. Il limite di contesto per l'audio nativo è di 128,000 token. Inoltre, il costo delle chiamate lunghe e ricche di turni non coincide con una semplice stima basata sulla durata, perché il contesto precedente può essere elaborato di nuovo.
La sicurezza resta responsabilità dell'applicazione. Un browser che si collega direttamente deve usare token temporanei, non una chiave API standard. Prenotazioni, rimborsi o modifiche all'account richiedono comunque autenticazione, convalida, idempotenza e una traccia di audit.
Il percorso asincrono introduce un ulteriore rischio in produzione: il lavoro obsoleto. Se chi chiama modifica la richiesta mentre un tool è in esecuzione, il vecchio risultato può arrivare in seguito. Gestisci esplicitamente lo stato dell'attività e scarta i risultati che non corrispondono più all'intento corrente.
La mossa di lunedì: misura una sola coda ben delimitata
Agisci questa settimana se le attese silenziose dei tool inducono le persone a ripetersi, abbandonare una prenotazione o richiedono un intervento manuale dello staff. Usa Gemini 3.8 Live per i lookup diretti ed Extended Thinking per un unico flusso davvero articolato. Entrambi devono alimentare lo stesso registro dei completamenti.
Aspetta se non sai ancora dimostrare il completamento nel tuo sistema, se il percorso con l'operatore telefonico non è stabile o se il flusso include un'azione irreversibile senza un passaggio di conferma. Prima del nuovo modello serve il registro.
Questa release non è rilevante per i prodotti solo testuali, per i flussi vocali i cui tool rispondono già subito o per un agente telefonico che raggiunge già gli obiettivi di completamento, escalation e costo. Un modello nuovo non è un motivo sufficiente per sostituire un sistema misurato.
Per altre analisi chiare sui cambiamenti che incidono su costi operativi e flussi di lavoro, iscriviti alla newsletter.
- Ultimo aggiornamento
- 16 set 2026
- Categoria
- Explained
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Permessi Cloudflare Workers: circoscrivere il deploy per cliente
I permessi Cloudflare Workers consentono di limitare un token CI a un singolo Worker: ruoli, scope, binding e passaggio di consegne al cliente.15 set 2026Explained
Claude Code sandbox: la rete si apre per un solo comando
Claude Code 2.1.271 limita l’accesso alla rete al singolo comando nella sandbox, così l’installazione non lascia il registry aperto al resto del job.15 set 2026Explained
Abbonamento Claude Code in Vercel AI SDK: chi paga il conto
Scopri come Vercel AI SDK usa un abbonamento Claude Code o Codex, quali credenziali determinano il costo e perché Vercel Sandbox resta a pagamento.15 set 2026Explained
Cloudflare Browser Run: host approvati e revisioni senza controllo
Cloudflare Browser Run limita i job agli host approvati, gestisce le dipendenze e offre revisioni Live View in sola lettura, senza controllo interattivo.14 set 2026Explained
AI voice agent: il costo reale di una chiamata con GPT-Live-1
GPT-Live-1 costa $0.05 al minuto, ma il budget di un AI voice agent include anche backend, strumenti e traffico telefonico. Ecco come calcolarlo.14 set 2026Explained
ChatGPT Windows: con Appshots il contesto entra nella chat
Scopri come usare Appshots in ChatGPT Windows per allegare una finestra alla chat, ridurre il copia-incolla del contesto e controllare i dati condivisi.14 set 2026Explained
Vercel Functions: i file statici FastAPI ora passano dalla CDN
Con Vercel, i file statici idonei di FastAPI passano dalla CDN senza invocare Functions: ecco cosa cambia per costi, sicurezza e metriche reali.13 set 2026Explained