AI voice agent: il costo reale di una chiamata con GPT-Live-1
GPT-Live-1 costa $0.05 al minuto, ma il budget di un AI voice agent include anche backend, strumenti e traffico telefonico. Ecco come calcolarlo.



Con GPT-Live-1, una voce del budget di un AI voice agent diventa immediata da calcolare: la sessione vocale costa $0.05 al minuto. Dal 10 settembre 2026 il ciclo di ascolto e risposta è più semplice, ma il dato che conta resta il costo complessivo di una chiamata risolta, compresi il ragionamento del backend, gli strumenti e il trasporto telefonico.
AI voice agent: i cinque centesimi coprono la voce
GPT-Live-1 è un modello vocale full duplex. In pratica, può ascoltare mentre parla: chi chiama può interrompere, fare una pausa, correggere un dettaglio o dare un breve cenno di conferma senza dover attendere la fine di un turno rigido.
Questo cambia l'architettura del sistema. Un agente vocale tradizionale spesso mette in sequenza speech-to-text, modello linguistico e text-to-speech. L'applicazione deve trasferire le informazioni a ogni passaggio e stabilire che cosa fare quando le due parti parlano nello stesso momento.
GPT-Live-1 gestisce la conversazione in tempo reale in un unico livello vocale. Ascolta, parla, segue i tempi e decide quando affidare al backend un'attività più complessa. Il backend può verificare una prenotazione, consultare i dati di un account, chiamare uno strumento o valutare una policy.
Il backend resta volutamente separato. Si può usare la delega tramite Responses, con cui GPT-Live-1 invia il lavoro a un modello testuale OpenAI configurato dal team, oppure la delega al client, in cui è l'applicazione a eseguire qualsiasi modello, agente o servizio e a restituire il risultato. La voce non cambia, mentre per ogni attività si può scegliere un motore più economico o più approfondito.
Anche il collegamento telefonico è una componente distinta. Una chiamata in entrata può raggiungere GPT-Live-1 tramite un trunk SIP, cioè la connessione internet fornita da un operatore telefonico, oppure attraverso un'applicazione che inoltra l'audio. OpenAI gestisce la sessione Live; l'operatore continua a gestire il numero e il trasporto telefonico.
È qui che cambia il budget. Per questo percorso non serve più calcolare il riconoscimento e la generazione vocale come due fasi separate dei modelli OpenAI. Restano però tre conti da tenere distinti.
Quanto costa davvero un AI voice agent
La prima insidia è il cronometro. La fatturazione di GPT-Live-1 segue la sessione attiva dall'apertura alla chiusura. Il silenzio conta. Conta anche il tempo trascorso in attesa di uno strumento. Disattivare il microfono non ferma la fatturazione.
La seconda insidia è considerare gratuito il backend perché lavora dietro la conversazione. Non lo è. I prezzi standard per contesti brevi di GPT-5.6 Luna sono $0.20 per milione di token in input e $1.20 per milione di token in output. Per GPT-5.6 Terra sono $2.00 e $12.00; per GPT-6 Astra, $10.00 e $50.00. Il confronto giusto non riguarda il modello con il costo per token più basso, ma la combinazione che porta a termine il lavoro in modo affidabile con il minor tempo complessivo di chiamata e il minor numero di attività da rifare.
Una prenotazione rivela il costo reale
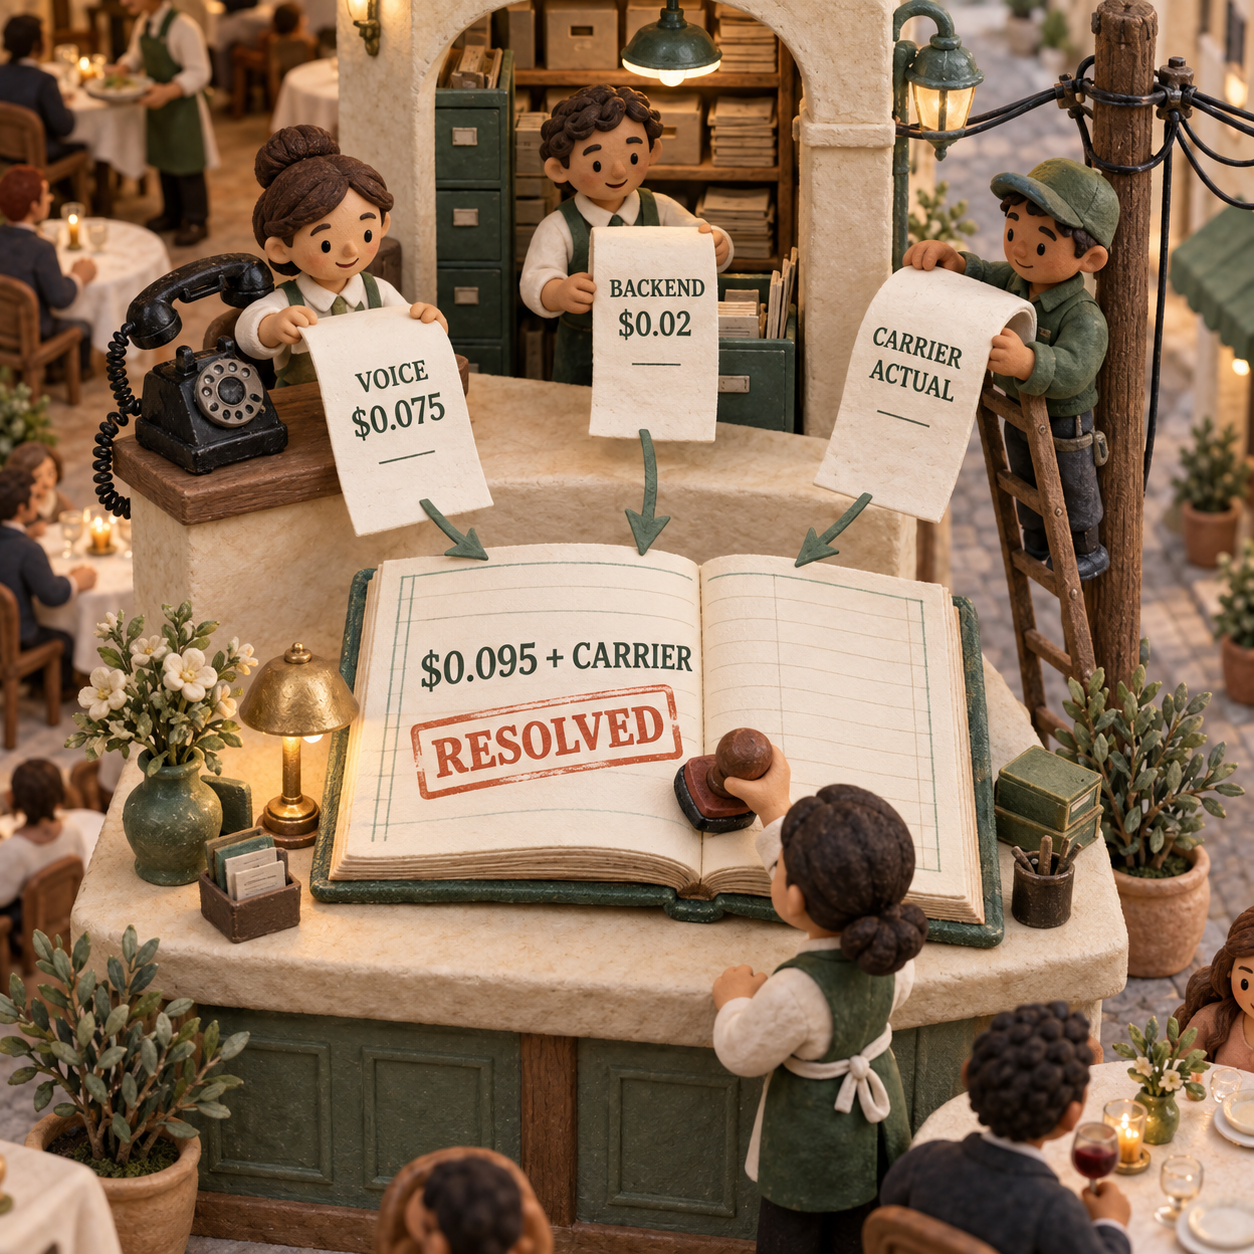
Consideriamo una chiamata in entrata di 90 secondi per prenotare un tavolo. L'esempio di costo fornito da OpenAI offre un punto di partenza chiaro:
- Voce: 90 secondi divisi per 60, moltiplicati per $0.05, equivalgono a $0.075.
- Backend: si ipotizza che, in questo esempio, l'uso misurato del modello e degli strumenti ammonti a $0.02.
- Subtotale voce più backend: $0.095.
- Trasporto telefonico: va aggiunto il costo addebitato dall'operatore per quella chiamata effettiva.
La chiamata, quindi, non costa $0.075. In questo esempio costa $0.095 più il trasporto telefonico. Se la prenotazione viene confermata, questa è la spesa operativa diretta per una prenotazione risolta. Se l'agente fallisce e una persona deve ripetere il lavoro, la chiamata non riuscita resta al numeratore quando si calcola il costo per risoluzione.
Per questo è più corretto lasciare simbolica la voce relativa all'operatore, anziché inserire nel totale una tariffa di mercato inventata. OpenAI non stabilisce quel costo: bisogna ricavarlo dalla fattura del proprio provider.
C'è poi un'altra interazione da considerare. Un backend più veloce può giustificare un costo per token superiore se consente di chiudere prima la sessione Live. Un minuto in meno di sessione aperta fa risparmiare $0.05 sulla voce. Un backend più economico può invece aumentare il costo totale se costringe il chiamante a ripetere i dettagli, rallenta in attesa degli strumenti o non porta a termine la prenotazione.
Come si inserisce in un flusso di chiamata reale
Un ristoratore può collegare GPT-Live-1 a un numero dedicato alle prenotazioni in entrata e mantenere molto circoscritto il compito. Il livello vocale conduce la conversazione. Un backend economico verifica la disponibilità e prepara la prenotazione. L'applicazione conferma la fascia oraria definitiva, registra la prenotazione e impedisce che un risultato tardivo riservi l'orario sbagliato.
Un responsabile dell'assistenza può usare lo stesso frontend con policy diverse per il backend. Le normali verifiche sugli ordini possono essere affidate a un modello attento ai costi; una contestazione su un addebito o un'eccezione alle regole può passare a un modello più approfondito o a una persona. Il vantaggio non sta nell'usare un solo modello vocale per qualsiasi compito, ma nello scegliere il costo del ragionamento in base all'attività, mantenendo uniforme l'esperienza parlata.
Per un team di prodotto che dispone già di una catena speech-to-text, modello e text-to-speech, la valutazione è diversa. GPT-Live-1 può eliminare codice di raccordo e semplificare la gestione delle sovrapposizioni vocali, ma la migrazione conviene soltanto se il nuovo sistema migliora abbastanza il completamento delle attività o la manutenzione da ripagare il lavoro richiesto. Il confronto più ampio sui costi degli agenti vocali AI resta utile quando la scelta è tra sviluppo interno e acquisto.
Un team che sviluppa applicazioni browser può collegarsi tramite WebRTC ed eliminare del tutto la voce di costo dell'operatore telefonico. Continuerà comunque a pagare la durata Live e il lavoro del backend. Gli agenti solo testuali, i flussi batch e le applicazioni in cui nessuno deve parlare non sono interessati da questa uscita.
Il progetto pilota telefonico più piccolo che abbia senso
Il percorso SIP diretto inizia quando il provider invia a OpenAI una chiamata in entrata e il webhook riceve l'ID di una sessione Live. Questa è la struttura di accettazione documentata:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
La chiave API rimane nel backend fidato. SIP negozia il formato audio, quindi audio.format va omesso. Con la delega al client, l'applicazione mantiene il controllo su modello di backend, strumenti, autorizzazioni e registri di utilizzo.
Per un progetto pilota dedicato alle prenotazioni in entrata, il perimetro è abbastanza ristretto da mantenere pulita la misurazione.
Scegli un solo risultato
Il criterio di successo deve essere una prenotazione confermata, non una conversazione gradevole. Salva l'orario richiesto, quello effettivamente prenotato e l'eventuale intervento di una persona.
Registra ogni voce di costo
Durante la chiamata conserva il dato cumulativo più recente sui secondi di voce. In caso di chiusura corretta, sostituiscilo con l'utilizzo finale riportato in
session.closed. Registra una sola volta ogni ID di risposta del backend, insieme all'utilizzo di token e strumenti, poi collega questi dati al dettaglio della chiamata fornito dall'operatore.Prova le interruzioni reali
Riproduci le pause, le correzioni, le voci di sottofondo e i brevi cenni di conferma tipici di chi chiama. Controlla la trascrizione, l'azione eseguita dal backend e l'audio effettivamente ascoltato dal chiamante. Una risposta del backend completata non dimostra che il risultato sia stato pronunciato.
Confronta il costo per attività completata
Somma, per l'intero progetto pilota, la spesa per voce, backend e trasporto, quindi dividila per le prenotazioni confermate. Includi nella spesa chiamate non riuscite, nuovi tentativi e passaggi a operatori umani. Confronta il risultato con il sistema attuale usando gli stessi copioni di chiamata.
Le prestazioni sulle interruzioni vanno misurate sul campo
GPT-Live-1 è progettato per gestire il parlato sovrapposto, ma un esempio di lancio non equivale a un livello di servizio garantito. Andrew Hsu, cofondatore e CTO di Speak, afferma che nella prima valutazione di Speak le interruzioni durante le pause di riflessione sono diminuite di quasi l'80% rispetto ai precedenti sistemi a turni. È un risultato ottenuto nel contesto del tutor linguistico di Speak.
Una linea rumorosa di un ristorante, un cliente dell'assistenza che legge un numero d'ordine e un paziente che esita prima di una data rappresentano carichi di lavoro diversi. Prompt, codec telefonico, jitter dell'operatore, latenza degli strumenti e controlli di riproduzione dell'applicazione incidono tutti sull'esperienza di chi chiama. Non esiste un miglioramento universale e attendibile di interruzioni o latenza da copiare in una previsione.
Conta anche il caso limite in produzione. Se il chiamante interrompe e sposta la richiesta da venerdì a giovedì, la correzione pronunciata non annulla automaticamente il lavoro già avviato per venerdì nel backend. L'applicazione deve modificare o annullare il vecchio compito, ignorare un risultato tardivo e impedire che un nuovo tentativo crei una seconda prenotazione.
Al momento, il SIP diretto di GPT-Live copre le chiamate in entrata. L'endpoint di creazione delle sessioni Live non avvia una chiamata SIP in uscita; per le campagne outbound serve quindi ancora un percorso gestito da un provider partner. I team che hanno come priorità le chiamate in uscita dovrebbero verificare questo percorso prima di pianificare la migrazione.
Che cosa fare lunedì
Se gestisci una coda di prenotazioni o assistenza in entrata, misura un solo progetto pilota ben circoscritto. Registra nello stesso record secondi di voce, utilizzo del backend, costi dell'operatore, attività completate, passaggi a una persona e problemi nelle interruzioni. Metti alla prova un backend attento ai costi contro il modello più approfondito che ritieni necessario.
Procedi se il costo completo per chiamata risolta è inferiore a quello dello stack attuale e chi chiama può correggere l'agente senza generare azioni obsolete. Aspetta se l'unico vantaggio è il prezzo di richiamo di $0.05, oppure se operatore e percorso outbound non sono ancora definiti. Questa uscita si può ignorare per le attività esclusivamente testuali e per le esperienze vocali che raggiungono già gli obiettivi di costo e completamento.
Per ricevere altre analisi chiare sui cambiamenti che incidono sui costi operativi, iscriviti alla newsletter.
- Ultimo aggiornamento
- 14 set 2026
- Categoria
- Explained
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

ChatGPT Windows: con Appshots il contesto entra nella chat
Scopri come usare Appshots in ChatGPT Windows per allegare una finestra alla chat, ridurre il copia-incolla del contesto e controllare i dati condivisi.14 set 2026Explained
Vercel Functions: i file statici FastAPI ora passano dalla CDN
Con Vercel, i file statici idonei di FastAPI passano dalla CDN senza invocare Functions: ecco cosa cambia per costi, sicurezza e metriche reali.13 set 2026Explained
Rotazione chiavi API OpenAI: il piano operativo contro gli stop
Le chiavi API di progetto OpenAI ora possono scadere. Un piano operativo per sostituirle, verificarle e revocarle senza fermare agenti e servizi.13 set 2026Explained
Gestione credenziali in Vercel Connect: chi può intervenire
Vercel Connect introduce Connector Permissions: scopri come affidare la gestione credenziali condivise a un responsabile senza concedergli il ruolo Owner.13 set 2026Explained
Cloudflare R2: come indicizzare file senza estensione
Cloudflare R2 ora permette ad AI Search di indicizzare file senza estensione tramite Content-Type. Ecco cosa cambia, quali limiti restano e come procedere.12 set 2026Explained
Vercel Sandbox raddoppia il disco per i job più pesanti
Vercel Sandbox passa da 32 GB a 64 GB: cosa cambia per agenti AI, monorepo e build, come misurare il picco e valutare costi reali e persistenza.12 set 2026Explained
Cloudflare Workflows: la nuova retention richiede una scelta esplicita
I nuovi Workflow su Workers Paid conservano gli stati completati e in errore per 7 giorni. Ecco come impostare la retention senza perdere prove utili.11 set 2026Explained