KI-Telefonassistent mit Gemini 3.8 Live: Keine Funkstille bei Tool-Aufrufen
Gemini 3.8 Live hält Anrufende während langsamer Tool-Aufrufe auf dem Laufenden. So messen Teams Kosten, Abschlüsse und Risiken im realen Betrieb.


Am 15. September 2026 machte Google Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking allgemein verfügbar. Für einen KI-Telefonassistenten ist daran vor allem eines relevant: Er kann Anrufende auf dem Laufenden halten, während Kalender, Bestellsystem oder Buchungs-API die langsame Arbeit im Hintergrund erledigen.
Warum der KI-Telefonassistent bei der Abfrage nicht mehr verstummt
Ein Voice-Agent erledigt meist zwei Aufgaben gleichzeitig: Er muss ein natürliches Gespräch führen und parallel dazu in einem anderen System tatsächlich etwas anstoßen.
Genau bei dieser zweiten Aufgabe werden Telefonate schnell unangenehm. Der Agent fragt bei der Buchungs-API nach einem freien Termin, wartet – und lässt die anrufende Person in der Stille hängen. Sie wiederholt ihre Bitte, fragt, ob noch jemand da ist, oder legt auf. Wertet die Anwendung die Wiederholung als neue Anweisung, kann sie dieselbe Aufgabe zudem doppelt starten.
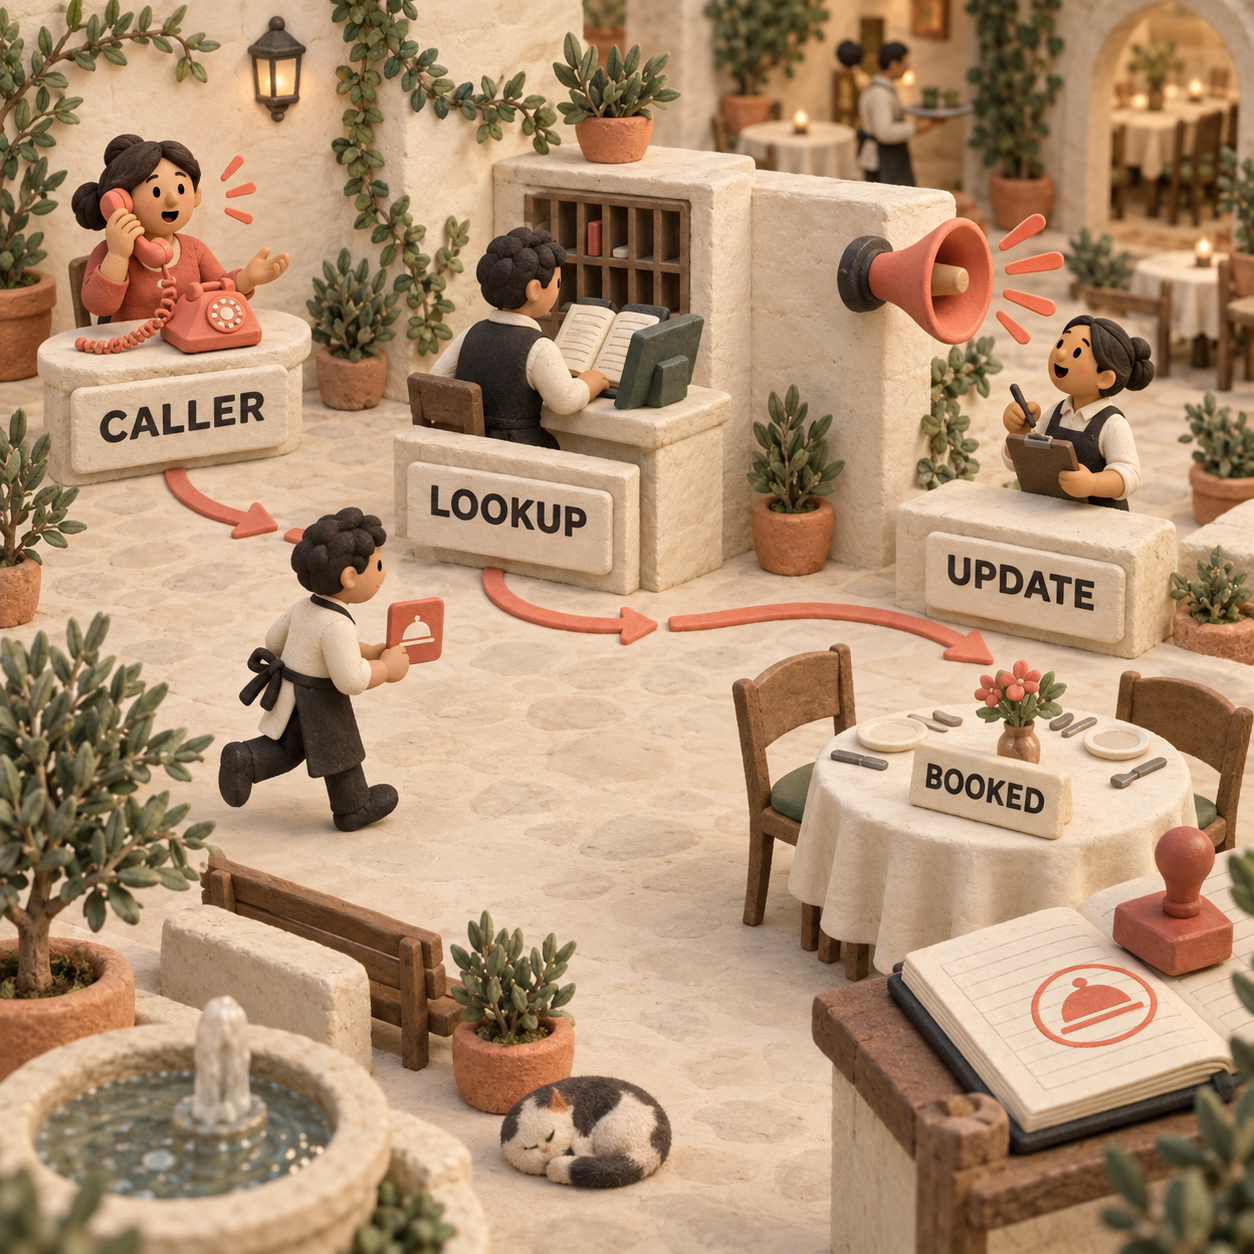
Gemini 3.8 Live verändert diesen Ablauf durch asynchrone Funktionsaufrufe. Das Tool kann also weiterarbeiten, ohne die gesamte Live-Sitzung anzuhalten. Während die Abfrage noch läuft, kann die anrufende Person zusätzliche Angaben machen, ein Detail korrigieren oder einen Zwischenstand hören.
Gemini 3.8 Live Extended Thinking geht einen Schritt weiter. Das Modell kann eine mehrstufige Aufgabe durchdenken und kurze Fortschrittsmeldungen sprechen, während die Tools laufen. Googles eigenes Beispiel zeigt eine Reisebuchung, bei der mehrere Systeme geprüft werden, ohne das laufende Gespräch zu unterbrechen.
Das bedeutet nicht, dass Gemini selbstständig etwas bucht. Die Anwendung empfängt weiterhin den Funktionsaufruf, führt die Kalender- oder Bestellabfrage aus und sendet das Ergebnis zurück. Das Modell übernimmt das Gespräch rund um diesen Vorgang.
Die letzte Spalte birgt die Falle für den Produktivbetrieb. Bei Extended Thinking kann turnComplete: true lediglich bedeuten, dass eine gesprochene Zwischenmeldung beendet ist. Die Abfrage kann trotzdem noch laufen. Wer dann die Sitzung schließt, die Buchungsschaltfläche freigibt oder die Aufgabe als erledigt markiert, erzeugt falsche Abschlüsse.
Entscheidend sind die Kosten pro abgeschlossener Aufgabe
Gesprochene Überbrückungen sparen nicht automatisch Geld. Während ein Tool arbeitet, können zusätzliche Modellausgaben entstehen; bei einem längeren Gespräch muss in späteren Turns womöglich mehr Kontext erneut verarbeitet werden. Das Feature lohnt sich erst, wenn diese Kontinuität zu mehr abgeschlossenen Buchungen, weniger abgebrochenen Anrufen oder weniger manueller Nacharbeit führt.
Google nennt für beide neuen Modelle dieselben Standardpreise: Audioeingaben kosten $0.005 pro Minute, Audioausgaben $0.018 pro Minute. Texteingaben kosten $0.75 pro 1 Million Tokens; für Textausgaben einschließlich Thinking-Tokens fallen $4.50 pro 1 Million Tokens an.
Nehmen wir einen fünfminütigen Buchungsanruf, bei dem das Modell zwei Minuten lang spricht. Weil proaktives Audio dauerhaft aktiviert ist, lautet die einfache Rechnung für neue Audiodaten: $0.025 für fünf Minuten Eingabe plus $0.036 für zwei Minuten Ausgabe. Der reine Audio-Zwischenbetrag beträgt damit $0.061.
Das sind noch nicht die endgültigen Gesprächskosten.
Laut Abrechnungsleitfaden der Live API kann die persistente Sitzung den bis dahin angesammelten Kontext in späteren Turns erneut verarbeiten. Transkriptionen verursachen zusätzliche Text-Token-Kosten. Extended Thinking kann weitere Thinking-Ausgaben erzeugen. Kalender, CRM, Telefonanbieter, Hosting, Wiederholungsversuche und menschliche Eskalationen sind in Googles Audio-Zwischenbetrag nicht enthalten.
Die bessere Formel lautet:
Kosten pro abgeschlossener Aufgabe = sämtliche Ausgaben für Modell, Tools, Telefonie, Infrastruktur, Wiederholungsversuche und Eskalationen geteilt durch die Zahl verifiziert abgeschlossener Aufgaben.
Ein angenehmes Transkript ist noch keine abgeschlossene Aufgabe. Bei einer Termin-Hotline zählt eine genau einmal gespeicherte Buchungs-ID, die korrekt vorgelesen und von der anrufenden Person bestätigt wurde. Im Bestellsupport muss die richtige Aktion dem richtigen Kundenkonto zugeordnet sein. Bei einer Weiterleitung muss die vorgesehene Warteschlange erreicht werden, ohne dass der Kontext verloren geht.
Google liefert regelmäßig Summen der verbrauchten Tokens in usageMetadata. Verknüpfen Sie diesen Datensatz mit der Tool-Call-ID, der Sitzung des Telefonanbieters, dem endgültigen Geschäftsergebnis und jedem menschlichen Arbeitsschritt. So entsteht für jeden Anruf ein prüfbares Kostenprotokoll statt einer Minutenschätzung, der man blind vertrauen muss.
Die veröffentlichten Kennzahlen ersetzen diesen Piloten nicht. Google meldet für Extended Thinking 68.6% im tau-Voice-Aufgabenbenchmark und 35.1% in dessen Banking-Variante. Die Werte zeigen, dass sich das Modell für agentische Sprachanwendungen testen lässt. Sie sagen nicht voraus, wie viele Anrufende mit dem eigenen Kalender, den eigenen Richtlinien und der eigenen Telefonverbindung tatsächlich eine Buchung abschließen.
Vier Abläufe, bei denen die Wartezeit zählt
Terminvereinbarung in einer Zahnarztpraxis
Die Betriebsleitung kann den Agenten den Wunschtag erfragen, die Verfügbarkeit prüfen und während der Antwortzeit des Kalenders melden lassen, dass die Suche noch läuft. Der Nutzen liegt nicht allein in der kürzeren Stille, sondern in mehr bestätigten Terminen und weniger Rückrufen durch das Praxisteam.
Dabei gilt eine strikte Sicherheitsregel: Eine gesprochene Zwischenmeldung ist keine Reservierung. Das System darf erst buchen, nachdem die anrufende Person einen angebotenen Termin gewählt hat. Wiederholungsversuche müssen denselben Idempotenzschlüssel verwenden, damit ein Anruf nicht zweimal denselben Termin anlegt.
Bestellstatus im E-Commerce prüfen
Das Supportteam kann die anrufende Person im selben Gespräch halten, während der Agent das Bestellsystem abfragt. Wechselt die Anfrage von „Wo ist mein Paket?“ zu „Ändern Sie die Lieferadresse“, muss die Anwendung die neuere Bitte als aktiv behandeln und veraltete Arbeit abbrechen oder ignorieren.
Das kann bei Routinefällen Übergaben vermeiden. Das Risiko: Die korrekte Antwort auf eine überholte Frage trifft ein, nachdem das Gespräch längst beim nächsten Anliegen ist.
Umbuchung im Reisegeschäft
Flugsuche, Richtlinienprüfung, Hotelverfügbarkeit und Tarifvergleich machen diesen Ablauf zu einem besseren Einsatzgebiet für Extended Thinking. Während mehrere nicht blockierende Funktionen laufen, kann das Modell den Fortschritt schildern.
Zahlungen und Ticketänderungen brauchen weiterhin einen Bestätigungsschritt. Eine natürlich klingende Stimme senkt nicht die Freigabeanforderungen für unumkehrbare Aktionen.
Kontoproblem im technischen Support diagnostizieren
Eine schnelle Kontoabfrage gehört auf Gemini 3.8 Live. Sammelt eine Diagnose mehrere Protokolle und prüft eine Konfiguration, kann Extended Thinking gerechtfertigt sein.
Diese Trennung ist wichtig, denn tieferes Schlussfolgern ist nicht kostenlos. Routen Sie nach Komplexität der Aufgabe und vergleichen Sie anschließend Lösungs- und Eskalationsquoten. Nicht jedes Zurücksetzen eines Passworts braucht den aufwendigeren Pfad, nur weil der Modellname sicherer klingt.
Erst den Hintergrundprozess verdrahten, dann die Telefonleitung
Beginnen Sie mit einer textgesteuerten Sitzung und einem Tool-Stub. So lässt sich das asynchrone Verhalten isoliert prüfen, bevor Telefonanbieter, Mikrofon, Audio-Bridge und Produktivkalender vier weitere Fehlerquellen hinzufügen.
Das folgende Beispiel entspricht dem aktuellen Python SDK von Google und verwendet die Extended-Thinking-Konfiguration, eine nicht blockierende Funktionsdeklaration, das Muster für Tool-Antworten sowie die Felder interaction_status und usageMetadata. Zurückgegebenes Audio mit 24 kHz schreibt es in response.wav. Das Tool-Ergebnis stammt aus einem lokalen Stub; ein echter Kalender wird nicht angesprochen.
pip install -U google-genai
export GEMINI_API_KEY="YOUR_API_KEY"import asyncio
import wave
from google import genai
from google.genai import types
client = genai.Client()
model = "gemini-3.8-live-extended-thinking"
check_availability = types.FunctionDeclaration(
name="check_availability",
description="Checks the calendar for the next available appointment.",
behavior="NON_BLOCKING",
parameters={
"type": "OBJECT",
"properties": {},
},
)
config = types.LiveConnectConfig(
response_modalities=["AUDIO"],
thinking_config=types.ThinkingConfig(thinking_level="low"),
tools=[types.Tool(function_declarations=[check_availability])],
)
async def main():
async with client.aio.live.connect(model=model, config=config) as session:
await session.send_client_content(
turns={
"parts": [
{"text": "Find the next available appointment and keep me updated."}
]
}
)
with wave.open("response.wav", "wb") as audio:
audio.setnchannels(1)
audio.setsampwidth(2)
audio.setframerate(24000)
async for message in session.receive():
status = getattr(message, "interaction_status", None)
if message.data is not None:
audio.writeframes(message.data)
if message.usage_metadata:
print("Tokens:", message.usage_metadata.total_token_count)
if message.tool_call:
replies = []
for call in message.tool_call.function_calls:
replies.append(
types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": "Tuesday morning is available."},
)
)
await session.send_tool_response(function_responses=replies)
if status == "IDLE":
print("Interaction complete")
break
if __name__ == "__main__":
asyncio.run(main())Ein Fehler ist besonders wahrscheinlich: die Schleife beim ersten turnComplete zu verlassen. Extended Thinking kann bereits „Ich prüfe das“ gesagt haben und trotzdem noch auf das Tool warten. Hören Sie weiter zu, bis interaction_status den Wert IDLE hat, und verknüpfen Sie die Tool-Call-ID weiterhin mit dem späteren Geschäftsergebnis.
Bei einem produktiven Telefonagenten sollte die Audio-Bridge erst hinzukommen, wenn diese Schleife zuverlässig funktioniert. Der ausführlichere Kostenvergleich für Voice-Agents hilft bei der Auswahl der Telefonie- und Orchestrierungsebenen rund um das Modell. Wer Googles Token-Zähler mit einem einfacheren Endkundenpreis für Sprachnutzung vergleicht, sieht in der Kostenanalyse für GPT-Live-1-Anrufe, warum bei beiden die abgeschlossene Aufgabe in den Nenner gehört.
Den Piloten um ein Abschlussprotokoll bauen, nicht um eine Demo
Ein eindeutiges Abschlussereignis festlegen
Wählen Sie einen eng umrissenen Ablauf, etwa einen bestätigten Termin. Definieren Sie exakt das Datenbankereignis, das den Abschluss belegt, und benennen Sie jeden Zustand, der als Fehler, Abbruch, doppelte Arbeit oder menschliche Eskalation zählt.
Den gesamten Live-Lebenszyklus protokollieren
Speichern Sie die Sitzungs-ID, jede Tool-Call-ID, Änderungen an
interaction_status, Start- und Endzeit jedes Tools sowieusageMetadata. Eine gesprochene Überbrückung zeigt Fortschritt an, keinen Abschluss.Alle abgerechneten Ebenen zusammenführen
Ordnen Sie die Nutzung von Gemini, Gebühren für Kalender oder CRM, Telefonkosten, Infrastruktur, Wiederholungsversuche und Arbeitszeit demselben Anrufdatensatz zu. Vergleichen Sie Googles beispielhaften Audio-Zwischenbetrag von $0.061 nicht mit einer Komplettrechnung des bisherigen Anbieters.
Fehlerpfade gezielt testen
Unterbrechen Sie den Agenten, ändern Sie das gewünschte Datum während einer laufenden Abfrage, lassen Sie das Tool in ein Timeout laufen, geben Sie keine verfügbaren Termine zurück und legen Sie vor dem Ergebnis auf. Stellen Sie sicher, dass veraltete Aufrufe keine Buchung speichern können.
Abgeschlossene Aufgaben vergleichen
Lassen Sie dieselben Anruftypen durch den bisherigen und den neuen Ablauf laufen. Vergleichen Sie verifizierte Abschlüsse, Abbrüche, Eskalationsaufwand, doppelte Aktionen und die Gesamtkosten pro abgeschlossener Aufgabe. Sprechen Sie erst von Einsparungen, wenn diese Datensätze übereinstimmen.
Die tatsächlichen Grenzen
Das Modell kann Stille überbrücken. Es kann weder einen langsamen Kalender beschleunigen noch eine schlechte Telefonverbindung reparieren oder festlegen, was im Unternehmen als erledigt gilt.
Reine Audiositzungen sind auf 15 Minuten begrenzt, sofern für längere Gespräche keine Techniken zur Sitzungsverwaltung ergänzt werden. Das Kontextlimit für natives Audio liegt bei 128,000 Tokens. Lange Gespräche mit vielen Turns kosten außerdem anders als eine einfache Zeitschätzung vermuten lässt, weil alter Kontext erneut verarbeitet werden kann.
Die Sicherheit bleibt Aufgabe der Anwendung. Ein Browser mit direkter Verbindung sollte kurzlebige Tokens statt eines regulären API-Schlüssels verwenden. Buchung, Erstattung oder Kontoänderung benötigen weiterhin Authentifizierung, Validierung, Idempotenz und einen Audit-Trail.
Der asynchrone Pfad schafft ein weiteres Produktionsrisiko: veraltete Arbeit. Ändert eine anrufende Person ihre Anfrage, während ein Tool läuft, kann das alte Ergebnis später eintreffen. Verwalten Sie den Aufgabenstatus ausdrücklich und verwerfen Sie Ergebnisse, die nicht mehr zur aktuellen Absicht passen.
Der nächste Schritt am Montag: eine klar begrenzte Warteschlange instrumentieren
Handeln Sie noch diese Woche, wenn stille Tool-Wartezeiten dazu führen, dass Anrufende sich wiederholen, Buchungen abbrechen oder dem Personal Nacharbeit verursachen. Setzen Sie Gemini 3.8 Live für direkte Abfragen und Extended Thinking für einen wirklich mehrstufigen Ablauf ein. Beide gehören hinter dasselbe Abschlussprotokoll.
Warten Sie, wenn der Abschluss im eigenen System noch nicht nachweisbar ist, die Anbindung des Telefonanbieters noch nicht stabil steht oder der Ablauf eine unumkehrbare Aktion ohne Bestätigungsschranke enthält. Zuerst braucht es den Datensatz, dann das neue Modell.
Für reine Textprodukte ist diese Veröffentlichung ebenso wenig relevant wie für Sprachabläufe, deren Tools bereits sofort antworten, oder für einen funktionierenden Telefonagenten, der seine Zielwerte bei Abschluss, Eskalation und Kosten schon erreicht. Ein neues Modell ist kein Grund, ein gemessenes System zu ersetzen.
Weitere verständliche Analysen zu Veränderungen, die Betriebskosten und Arbeitsabläufe tatsächlich beeinflussen, gibt es im Newsletter.
- Zuletzt aktualisiert
- 16. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained