Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.
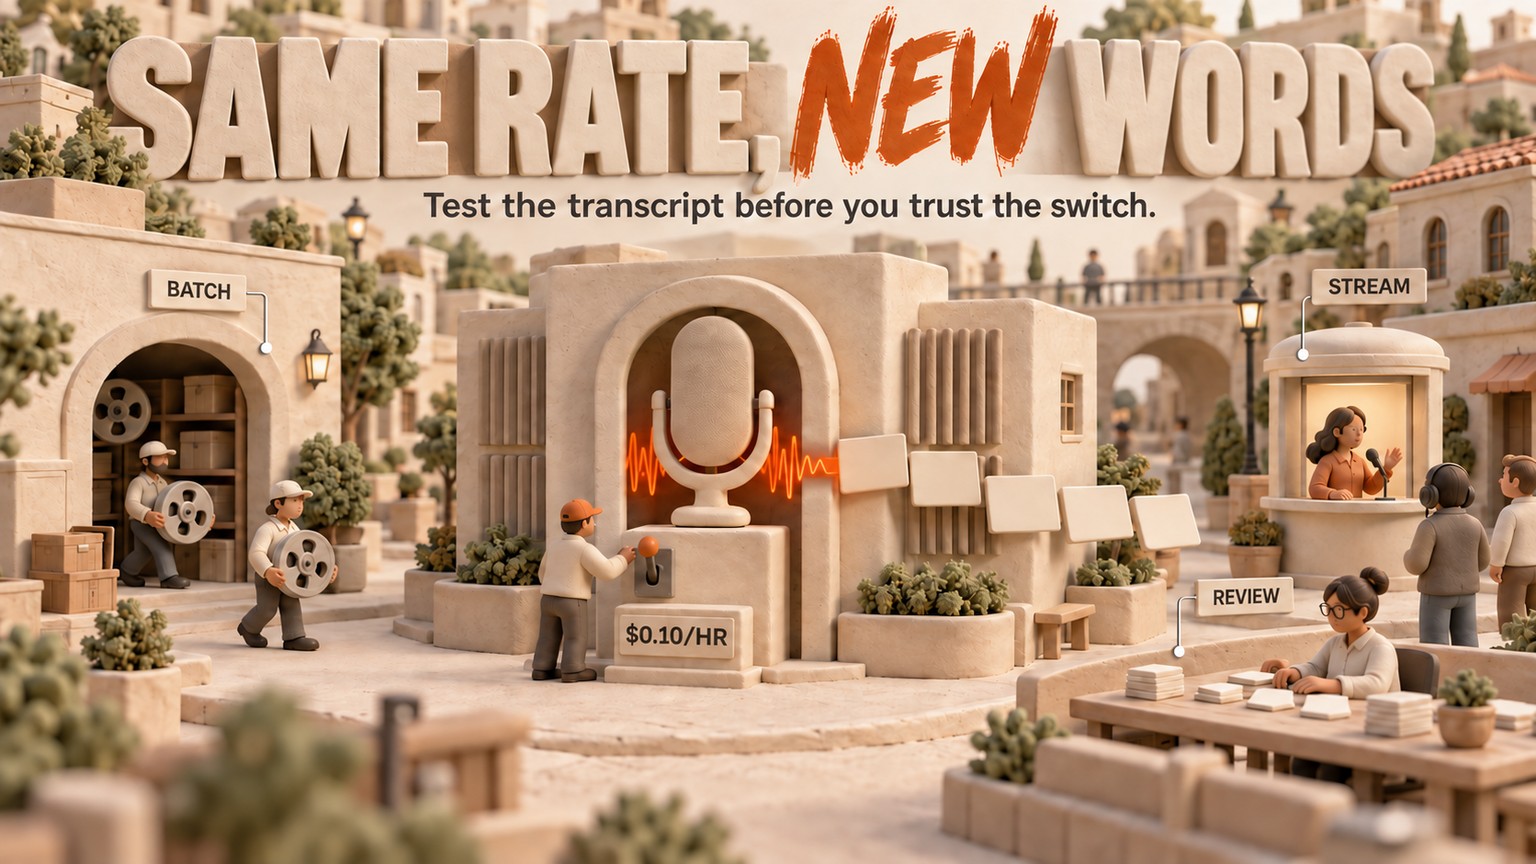
Audio transkribieren kostet mit Grok Voice Transcribe 2.0 weiterhin $0.10 pro Stunde im Batch und $0.20 pro Stunde im Streaming. Der Haken: In der aktuellen Dokumentation hat sich das Standardmodell geändert. Derselbe API-Aufruf ohne festgelegtes Modell kann deshalb einen anderen Transkripttext liefern – und damit auch die nachgelagerten Arbeitsschritte verändern.
Was hat sich tatsächlich geändert?
xAI hat Grok Voice Transcribe 2.0 am 18. September 2026 veröffentlicht. Das Modell löst Grok Voice Transcribe 1.0 als aktuelle Speech-to-Text-Lösung ab: Es wandelt aufgezeichnete oder live übertragene Sprache in Text um, den andere Produkte und Workflows weiterverarbeiten können.
Die beiden Betriebsarten sind schnell erklärt. Batch sendet eine Datei oder Audio-URL an einen REST-Endpunkt, sobald die Aufnahme vorliegt. Streaming überträgt das Audiosignal noch während des Gesprächs per WebSocket. So können Untertitel, Agentenantworten oder Live-Unterstützung reagieren, bevor der Anruf beendet ist.
Laut der Veröffentlichungsseite können bestehende Integrationen das 2.0-Modell ohne Codeänderungen erhalten. Das klingt bequem, ist aber genau der Punkt, auf den Betreiber achten müssen: Nennt eine Anfrage kein Modell, entscheidet der Anbieter, wann sich die Ausgabe ändert.
An der Preisliste hat sich nichts geändert. Batch bleibt bei $0.10 pro Audiostunde, Streaming bei $0.20 pro Audiostunde. Sprechertrennung, die Wörter einzelnen Sprechern zuordnet, sowie Zeitstempel auf Wortebene und die Gewichtung von Schlüsselbegriffen sind in diesen Preisen enthalten.
Audio transkribieren: Die API-Kosten bleiben stabil, der Workflow vielleicht nicht
Auf API-Ebene ist die Rechnung eindeutig:
Streaming kostet das Doppelte des Batch-Tarifs. Bei 1,000 Audiostunden beträgt der Aufpreis $100. Er lohnt sich, wenn das Warten auf die fertige Aufnahme das Produkt unbrauchbar machen würde – etwa bei Live-Untertiteln, Echtzeitunterstützung in Anrufen oder einem Sprachagenten, der seine nächste Antwort festlegen muss.
Liegt die Audiodatei bereits im Speicher, macht Streaming das Transkript nicht automatisch nützlicher. Medienarchive, Podcast-Rückstände, aufgezeichnete Interviews oder nächtliche Anrufanalysen sollten in der Regel im Batch laufen und vom niedrigeren Preis profitieren.
Die API ist nur ein Teil des Budgets. Für den Betrieb zählt diese Gleichung:
Gesamtkosten der Transkription = Ausgaben für die Audio-API + Kosten der manuellen Korrektur + nachgelagerte Nacharbeit
Der erste Posten ergibt sich aus der Preisliste. Der zweite hängt von der Prüfzeit und den vollständigen Stundenkosten der prüfenden Person ab. Der dritte entsteht, wenn geänderte Wörter, Sprecherzuordnungen, Zeitstempel oder formatierte Zahlen eine Untertiteldatei, Qualitätsbewertung, CRM-Notiz, einen Suchindex oder eine automatisierte Aktion verändern.
Genau darin liegt die geschäftliche Folge dieses Releases. Die Audioausgaben können unverändert bleiben, während die Gesamtkosten für ein brauchbares Transkript steigen oder sinken. Solange kein repräsentatives Audiomaterial getestet wurde, ist weniger Korrekturaufwand nur eine Möglichkeit – keine Einsparung, die in eine Prognose gehört.
Wer kann das Modell nutzen – und was ändert sich jeweils?
Leitung eines Kundensupports mit gespeicherten Anrufen
Ein Supportteam kann aufgezeichnete Gespräche für $0.10 pro Audiostunde im Batch verarbeiten, die Sprechertrennung aktivieren und Produktnamen als Schlüsselbegriffe übergeben. Die direkten API-Kosten bleiben planbar. Für die Migration zählt, ob 2.0 die Zeit verringert oder erhöht, die zur Korrektur von Namen, Kontodaten und Sprecherzuordnungen nötig ist.
Der Nutzen ist kein abstrakter Genauigkeitswert. Entscheidend ist eine kürzere Korrekturwarteschlange, ohne dass nachgelagert mehr Fehler entstehen. Beides sollte gemessen werden, bevor der Produktions-Pin geändert wird.
Produktteam mit einem Live-Sprachagenten
Bei einem Sprachagenten würde es den Zweck des Produkts verfehlen, bis zum Ende des Anrufs zu warten. Streaming zu $0.20 pro Audiostunde rechtfertigt den höheren Preis, weil das Transkript Teil des Live-Regelkreises ist. Beide Modelle sollten bei Pausen, Zahlen, Unterbrechungen und Schlüsselbegriffen verglichen werden. Anschließend sind die Aktionen zu prüfen, die diese Transkripte auslösen.
Ein Transkript kann für Menschen sauberer wirken und trotzdem einen Workflow stören: Ein anders formatierter Wert kann eine Suche verändern, eine verschobene Sprechergrenze den Agenten zu früh antworten lassen. Der Abnahmetest muss deshalb die nachgelagerte Aktion einschließen, nicht nur den Text.
Medienbetrieb, der Untertitel ausliefert
Eine Agentur, die Interviews oder Kundenvideos verarbeitet, sollte Batch verwenden, die Zeitstempel in den Vergleich einbeziehen und dieselben schwierigen Namen sowie überlappenden Sprecher mit beiden festgelegten Modellen testen. Der Nutzen bemisst sich an der Korrekturzeit und der Qualität der Untertitelübergabe, nicht am aggregierten Benchmark des Anbieters.
Eine API ist eine Komponente, keine redaktionelle Arbeitsoberfläche. Wer einen Browser-Editor, Meeting-Bot, Untertitel-Workflow oder eine Übergabe an menschliche Fachkräfte benötigt, findet diese Optionen im Vergleich fertiger Transkriptionstools.
Mehrsprachiges SaaS-Supportteam
xAI gibt an, dass 2.0 in den eigenen Auswertungen zweimal so genau wie 1.0 sei. Außerdem soll die Wortfehlerrate im eigenen mehrsprachigen Kurzphrasen-Datensatz von 20.6% auf 6.8% gesunken sein. Diese Vergleiche stammen vom Anbieter; für diesen Artikel wurden sie nicht selbst getestet.
Ein mehrsprachiges Supportteam sollte den tatsächlichen Mix aus Sprachen, Akzenten, Telefonleitungen, Namen und Sprachwechseln stichprobenartig prüfen. Ein aggregierter Fortschritt zeigt weder, ob die Sprachen mit dem größten Ticketvolumen besser abschneiden, noch ob sich die Korrekturzeit so stark verändert, dass die Personalplanung betroffen ist.
Modell festlegen, dann Ausgabe testen
Der minimale Batch-Aufruf ist kurz. Dieses cURL-Beispiel entspricht der dokumentierten xAI-Anfrage und nennt das 2.0-Modell ausdrücklich:
curl -X POST https://api.x.ai/v1/stt \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -F model=grok-voice-transcribe-2.0 \
  -F file=@audio.mp3
Entscheidend ist das Modellfeld. Mit dem expliziten Pin grok-voice-transcribe-2.0 liegt die Wahl beim Betreiber. Als vorübergehende Vergleichsbasis erlauben die aktuellen Dokumente weiterhin grok-voice-transcribe-1.0. In einer Multipart-Anfrage muss das Dateifeld zuletzt stehen, weil xAI darauf hinweist, dass später folgende Optionsfelder möglicherweise ignoriert werden.
Für beide Seiten des Migrationstests müssen dieselben Anfrageeinstellungen gelten. Werden Modell, Sprechertrennung, Formatierung, Behandlung von Füllwörtern und Schlüsselbegriffe gleichzeitig geändert, lässt sich die Ursache einer abweichenden Ausgabe nicht mehr bestimmen.
Alle Anfragen ohne Modell-Pin finden
Batch- und Streaming-Codepfade nach Aufrufen durchsuchen, in denen
modelfehlt. Dazu gehören Hintergrundjobs, interne Tools, Staging-Umgebungen und Anbieterintegrationen, die den Endpunkt möglicherweise kapseln. Die aktuelle Dokumentation leitet Anfragen ohne Modell nun an 2.0 weiter.Einen repräsentativen Audiosatz zusammenstellen
Reale Beispiele für die Bedingungen auswählen, mit denen das System arbeitet: saubere Aufnahmen, verrauschte Anrufe, überlappende Sprecher, Akzente, Produktnamen, E-Mail-Adressen, Kontocodes und die Sprachen mit tatsächlichem Volumen. Vertrauliche Daten gemäß der bestehenden Richtlinie entfernen oder schützen.
1.0 und 2.0 mit identischen Einstellungen ausführen
Beide Modelle ausdrücklich festlegen und alle anderen Optionen konstant halten. Transkripttext, Zeitstempel, Sprecherzuordnungen sowie die Ausgabe jeder Zusammenfassung, Suche, Bewertung oder automatisierten Aktion speichern, die diese Daten verarbeitet.
Abweichungen für Menschen und Systeme messen
Die Korrekturzeit pro Audiostunde erfassen. Fehler bei Namen, Zahlen, Sprecherzuordnung und Zeitstempeln markieren. Danach das nachgelagerte Ergebnis vergleichen, denn eine Transkriptänderung ist nur relevant, wenn sie den vorgesehenen Zweck unterstützt oder beeinträchtigt.
Produktionsmodell festlegen
2.0 festlegen, sobald das Modell die Abnahmetests besteht. 1.0 nur als dokumentierte, vorübergehende Rückfalloption behalten, solange es verfügbar ist. Eine langfristige Planung sollte sich nicht auf ein unveröffentlichtes Abschaltdatum stützen.
Was dabei ehrlich gesagt werden muss
Der Preis ist verifiziert. Die Arbeitsersparnis ist es nicht.
Die Genauigkeitsangaben von xAI sind gute Gründe für einen Test, aber kein Modell für die Personalplanung. Unterschiedliches Audiomaterial kann zu unterschiedlichen Ergebnissen führen. Eine niedrigere Wortfehlerrate bedeutet nicht automatisch weniger Prüfminuten oder eine sicherere Automatisierung.
Auch die Formulierung zum Übergang hat sich schneller verändert als die Ankündigung. Auf der Seite vom 18. September heißt es, der Standardwechsel stehe bald bevor; die aktuelle Dokumentation zeigt 2.0 bereits als Standard, wenn kein Modell angegeben wird. Diese Abweichung ist ein weiterer Grund, das Produktionsmodell ausdrücklich festzulegen, statt sich auf einen veränderlichen Alias zu verlassen.
Die Preise von $0.10 und $0.20 decken schließlich nur die Audioverarbeitung ab. Nicht enthalten sind die Kosten für die Prüfwarteschlange, Integrationsarbeit, Speicherung, Wiederholungsversuche oder eine falsche nachgelagerte Aktion. Diese Posten sollten getrennt bleiben, damit eine günstige API keinen teuren Workflow verdeckt.
Was jetzt zu tun ist
Noch diese Woche handeln, wenn eine xAI-Speech-to-Text-Anfrage das Modell nicht nennt oder die Produktion auf 1.0 festgelegt ist. Alle Aufrufe erfassen, den repräsentativen Audiosatz testen und ein Produktionsmodell ausdrücklich festlegen.
Streaming nur einsetzen, wenn ein bereits während des Sprechens eintreffendes Transkript das Produktergebnis verändert. Für Aufnahmen, die warten können, ist Batch die richtige Wahl: Die enthaltene Sprechertrennung, die Zeitstempel und die Optionen für Schlüsselbegriffe kosten auf Audioebene nur halb so viel.
Abwarten, wenn lediglich Anbieter bewertet werden und kein xAI-Transkript in einen aktiven Workflow einfließt. 2.0 gehört auf die Auswahlliste, doch vor einer Migration sollten die gesamten Korrektur- und Folgekosten mit eigenem Audiomaterial verglichen werden.
Nicht betroffen sind Systeme, die xAI Speech-to-Text nicht verwenden, sowie Integrationen, die 2.0 bereits festlegen und dessen Ausgabe validiert haben. Eine auf 1.0 festgelegte Integration ist vorerst stabil. Den Migrationstest sollte das dennoch nicht verzögern, denn xAI hat die Einstellung bereits angekündigt.
Der nächste Schritt am Montag ist einfach: repräsentatives Audiomaterial mit 1.0 und 2.0 unter denselben Einstellungen verarbeiten, Korrekturzeit und nachgelagerte Unterschiede messen und anschließend das Modell festlegen, das den Test besteht. Dank unveränderter Preisliste bleibt das API-Budget übersichtlich. Die Transkriptprüfung schützt den Workflow darum herum.
Eine praktische Einordnung dazu, wann sich ein KI-Preis oder Workflow tatsächlich ändert, liefert der Newsletter.
- Zuletzt aktualisiert
- 20. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained
Distributed Tracing für Cloudflare Workers: langsame RPC-Aufrufe finden
Distributed Tracing in Cloudflare Workers zeigt RPC-Aufrufe über Worker und Durable Objects hinweg. So lassen sich langsame Anfragen leichter zuordnen.17. Sept. 2026Explained