Distributed Tracing für Cloudflare Workers: langsame RPC-Aufrufe finden
Distributed Tracing in Cloudflare Workers zeigt RPC-Aufrufe über Worker und Durable Objects hinweg. So lassen sich langsame Anfragen leichter zuordnen.



Seit dem 17. September 2026 macht Cloudflare Distributed Tracing für langsame Kundenanfragen deutlich aussagekräftiger: Das Workers-Tracing folgt einem JavaScript-RPC-Aufruf jetzt bis in einen anderen Worker oder ein Durable Object, statt beim Aufrufer zu enden. So wird sichtbar, welcher Dienst und welche Methode die Anfrage ausgebremst haben – noch bevor manuelle Spans ergänzt oder der gesamte Stack verdächtigt wird.
Distributed Tracing schließt die entscheidende Lücke
RPC klingt komplizierter, als es ist. Bei Cloudflare Workers bedeutet ein Remote Procedure Call, dass ein Worker über ein Binding eine öffentliche JavaScript-Methode eines anderen Workers oder Durable Objects aufruft. Im Code sieht das wie ein lokaler Methodenaufruf aus, tatsächlich läuft die Arbeit jedoch an anderer Stelle.
Ein Trace bildet den zeitlichen Ablauf einer einzelnen Anfrage ab. Jeder darin gemessene Abschnitt ist ein Span. Bis zu diesem Release endete diese Zeitleiste an der JavaScript-RPC-Grenze des Aufrufers. Zwar war zu erkennen, dass Worker A einen Aufruf startete, doch dieser ließ sich nicht sauber mit der Ausführung in Worker B oder einem Durable Object verbinden.
Cloudflares Release vom 17. September schließt diese Lücke. Derselbe Trace kann nun die aufruferseitige Sitzung, jeden Methodenaufruf, die Ausführung beim Empfänger, verschachtelte Aufrufe und Callbacks in einen weiteren Worker zeigen. Cloudflare erfasst diese Spans automatisch, sobald Tracing aktiviert ist. Für diese Plattforminstrumentierung sind weder ein zusätzliches Observability-SDK noch Änderungen am Anwendungscode nötig.
Der Session-Span bildet den Rahmen für die RPC-Sitzung auf der aufrufenden Seite. Aufrufe, die dieselbe Sitzung wiederverwenden, erscheinen darin. Die einzelnen Call-Spans enthalten den Methoden- oder Property-Pfad; die Ausführung beim Empfänger erhält einen eigenen Invocation-Span. Farbwechsel markieren, wann die Ausführung zwischen Workern oder in ein Durable Object wechselt.
Aus einer unsichtbaren Grenze wird damit eine Karte der Zuständigkeiten.
Eine Checkout-Anfrage durchgängig verfolgen
Als Beispiel dient eine Kundenanfrage an POST /checkout.
Zuerst erreicht sie einen Checkout-Worker. Dieser ruft inventory.reserve() in einem Inventory-Worker und anschließend order.commit() in einem Order-Durable-Object auf. Für den Kunden ist lediglich ein langsamer Checkout sichtbar, in der Anwendung kann die Wartezeit jedoch an drei Stellen entstehen.
Vor dieser Änderung konnte der Checkout-Trace am RPC-Aufruf enden. Um den weiteren Ablauf zu rekonstruieren, mussten die Logs jedes Dienstes, passende Kennungen oder selbst definierte Spans zusammengeführt werden.
Jetzt bleibt die Anfrage in einem Trace verbunden. Die RPC-Sitzung lässt sich aufklappen, die Methodenspans reserve und commit werden sichtbar, die nachgelagerten Ausführungen lassen sich verfolgen und die Verteilung der Wall Time vergleichen. Root-Spans können außerdem die Cloudflare Ray ID, den Worker-Namen, den Entrypoint, das Ergebnis sowie CPU-Zeit und Wall Time enthalten. Damit erhält das Incident-Response-Team belastbare Anhaltspunkte, um die richtige Anfrage zu finden.
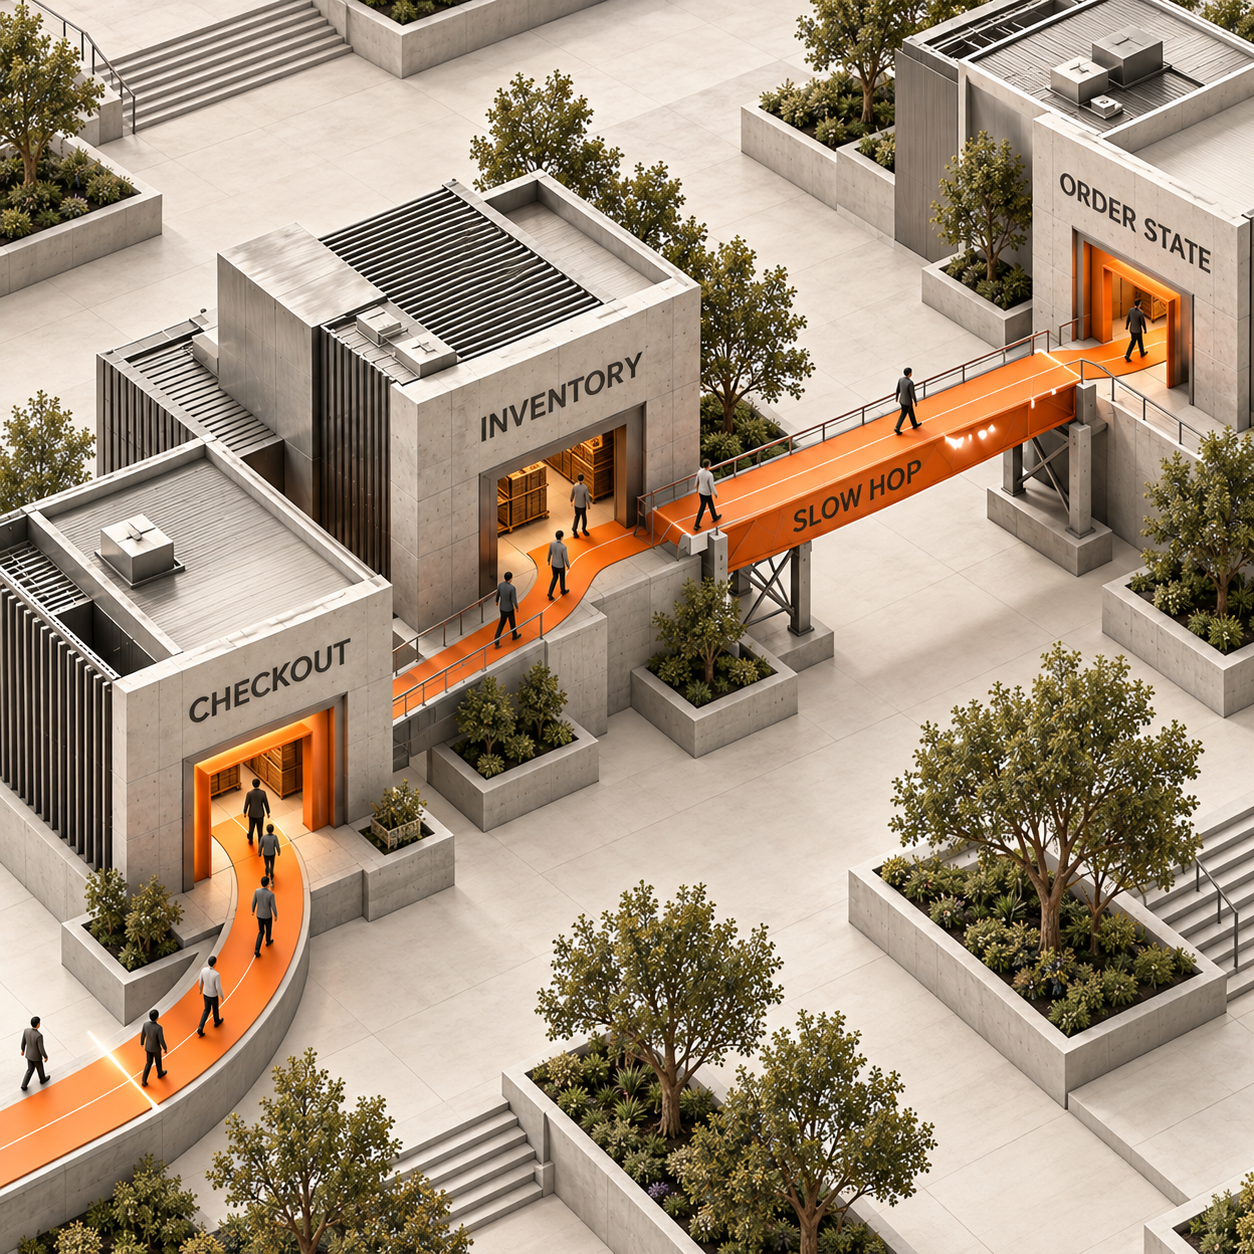
Die neue Ansicht erklärt nicht, warum eine Methode langsam ist. Sie zeigt, wo die nächste Untersuchung ansetzen sollte. Wenn die Inventory-Ausführung den Großteil der Wartezeit verursacht, sind deren Storage oder vorgelagerte Abhängigkeiten zu prüfen. Ist der Span des Durable-Object-Aufrufs besonders breit, lohnt sich ein Blick in dessen Handler und Storage-Zugriffe. Und wenn der Aufrufer bereits vor Beginn der beiden RPCs langsam ist, sind die nachgelagerten Dienste nicht die ersten Verdächtigen.
Wer davon profitiert
Solo-Gründer mit aufgeteiltem Backend
Wer Checkout, Inventory und Bestellstatus als getrennte Worker betreibt, kann einen einzelnen langsamen Kauf reproduzieren und über den gesamten Cloudflare-Pfad verfolgen. Der entscheidende Vorteil ist ein kleinerer Suchraum: Untersucht wird der Worker oder das Durable Object, in dem die Verzögerung liegt, statt jeden Dienst erneut zu öffnen.
Backend-Leitung für ein zustandsbehaftetes Produkt
Eine Kollaborations-App kann eine Raumaktion über einen Edge-Worker an ein Room-Durable-Object weiterreichen. Die Backend-Leitung kann die Zeit im Aufrufer von der Zeit im zustandsbehafteten Objekt trennen und den Trace anschließend an das Team übergeben, das für diese Grenze verantwortlich ist.
Plattformingenieur mit internen Worker-Diensten
In einem Plattformteam können mehrere Worker über Service Bindings verbunden sein, während zurückgegebene Stubs und Callbacks einen Pfad erzeugen, der sich aus Logs nur schwer rekonstruieren lässt. Session- und Methodenspans zeigen, welche Aufrufe eine Sitzung wiederverwendet haben, welcher Worker den jeweiligen Abschnitt ausgeführt hat und wo ein verschachtelter Aufruf in den Pfad gelangte.
Support-Leitung: vom Bericht zum belastbaren Hinweis
Der Support kann das Entwicklungsteam bitten, denselben Pfad zu reproduzieren, solange die Incident-Details noch präsent sind. Bei der Übergabe nennt der resultierende Trace dann einen konkreten Dienst und eine Methodengrenze statt nur „der Checkout war langsam“. Das ist selbst dann hilfreich, wenn für die eigentliche Fehlerbehebung weiterhin Logs, ein Profiler oder ein Datenbankabfrageplan nötig sind.
So gelingt der Praxistest am Montag
Für den ersten Rollout ist ein einzelner Anfragepfad sinnvoller als alle produktiven Worker auf einmal.
Einen für Kunden sichtbaren Pfad auswählen
Geeignet ist eine Anfrage, die bereits eine RPC-Grenze zwischen Workern oder zwischen einem Worker und einem Durable Object überschreitet und einen reproduzierbaren langsamen Fall hat. Route, erwartete nachgelagerte Methodenaufrufe und geplanter Zeitpunkt der Reproduktion sollten vorab feststehen.
Tracing in Wrangler aktivieren
Die von Cloudflare dokumentierte Einstellung wird in die Wrangler-Konfiguration des Workers aufgenommen, der diesen Pfad verarbeitet:
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }Diese Konfiguration wird über den üblichen Release-Prozess ausgerollt. Der Schalter aktiviert die automatischen Spans von Cloudflare; ein SDK im Worker ist dafür nicht erforderlich.
Eine langsame Anfrage reproduzieren
Dieselbe Anfrage wird unter kontrollierten Bedingungen einmal ausgeführt. Route, Zeitstempel und Cloudflare Ray ID sollten festgehalten werden, sofern der Support- oder Logging-Prozess sie bereits erfasst. Eine kontrollierte Umgebung liefert ein klareres Bild, denn die voreingestellte Trace-Sampling-Rate beträgt
1: Ohne einen abweichenden Wert werden 100% der eingehenden Anfragen verfolgt.Den Trace von außen nach innen lesen
In Cloudflare zunächst Workers & Pages, dann den Worker und anschließend Observability öffnen. Dort die reproduzierte Anfrage suchen und ihren Trace aufklappen. Die Analyse beginnt bei der Root-Anfrage und folgt danach der RPC-Sitzung, dem Methodenspan des Aufrufers, der Ausführung beim Empfänger und möglichen verschachtelten Durable-Object-Aufrufen. Span-Breite und Wall-Time-Felder zeigen, welche Grenze als Nächstes untersucht werden sollte.
Die Kosten vor dem Rollout abschätzen
Zuerst wird erfasst, wie viele Spans der reproduzierte Trace erzeugt hat. Die monatlichen Trace-Events lassen sich dann als
sampled requests × average spans per sampled traceschätzen. Hinzu kommen die Log-Events, die dasselbe Observability-Kontingent beanspruchen. Die gemessene Span-Anzahl ist die Grundlage für die Sampling-Entscheidung in der Produktion.
Abgerechnet wird pro Span, nicht pro Anfrage
Während der ersten Betaphase ist Workers Tracing kostenlos. Das ändert sich am 1. Oktober 2026. Ab diesem Datum zählt jeder Span als ein Observability-Event und fällt unter dasselbe Kontingent und dieselbe Preisstruktur wie Workers Logs.
Enterprise-Teams müssen ihren Vertrag prüfen. Für alle anderen ist vor allem die Abrechnungseinheit wichtig: Eine einzige Kundenanfrage kann einen Root-Span, einen RPC-Session-Span, Methodenspans, Ausführungen beim Empfänger und Spans verschachtelter Bindings erzeugen. Aus der Zahl der Anfragen allein lässt sich die Tracing-Rechnung daher nicht ableiten.
Cloudflares Tracing-Dokumentation nennt für head_sampling_rate den Standardwert 1, also 100%. Im Beispiel für hohen Traffic wird 0.05 verwendet; damit werden fünf von hundert eingehenden Anfragen verfolgt. Dieses Beispiel ist ein Steuerungsinstrument, keine allgemeingültige Empfehlung.
Beim Head Sampling ist der Zielkonflikt klar: Eine niedrigere Rate reduziert das Event-Volumen, doch die Auswahl erfolgt bereits zu Beginn der Anfrage. Eine seltene langsame Anfrage kann dadurch durchs Raster fallen. Für eine kontrollierte Reproduktion oder eine ausreichend isolierte Umgebung eignet sich vollständiges Sampling. Die Produktionsrate sollte anschließend anhand des tatsächlichen Traffics und der gemessenen Spans pro Trace festgelegt werden.
Auch die Aufbewahrungsdauer verändert den Incident-Prozess. Im Free-Tarif bleiben Traces 3 Tage, im Paid-Tarif 7 Tage erhalten. Treffen Kundenmeldungen erst nach diesem Zeitfenster ein, kann der benötigte Trace bereits verschwunden sein. Die praktische Regel lautet deshalb: reproduzieren und analysieren, solange die Belege noch vorhanden sind – oder die Traces in ein System exportieren, dessen Aufbewahrungsdauer zum eigenen Prozess passt.
Die Grenzen des Features
Workers Tracing befindet sich weiterhin in einer offenen Betaphase. Namen von Spans und Attributen können sich ändern; laut Cloudflare sind einige Attribute noch unvollständig.
Einige Spans ohne I/O können 0 ms anzeigen, obwohl die Ausführung länger gedauert hat. Die Workers Runtime aktualisiert die Zeit erst bei einem I/O-Ereignis. Ein Nullwert beweist daher nicht, dass ein JavaScript-Abschnitt keine Zeit benötigt hat.
Außerhalb von Cloudflare endet die automatische Verknüpfung ebenfalls. Beim Export von Workers-Traces überträgt Cloudflare Trace-IDs noch nicht an externe Dienste. Ein Aufruf bei einem Zahlungsanbieter oder einer anderswo gehosteten Datenbank verbindet deren anbieterseitigen Trace daher nicht automatisch mit der Workers-Zeitleiste.
Schließlich ist dieses Release eng umrissen. Ein einzelner Worker ohne JavaScript-RPC-Grenze erhält dadurch keine neue dienstübergreifende Ansicht. Allgemeines Workers Tracing kann bei Fetches, Bindings und Handlern weiterhin helfen; die Änderung vom 17. September ist jedoch vor allem für Anwendungen relevant, die bereits auf mehrere Worker oder Durable Objects verteilt sind.
Was jetzt zu tun ist
Ein zeitnaher Test lohnt sich, wenn Kundenanfragen Service Bindings oder Durable Objects durchlaufen und das Team derzeit mehrere Logs zusammensetzen muss, um einen langsamen Übergang zu finden. Der beste Ausgangspunkt ist der Pfad, der den teuersten Support- oder Incident-Aufwand verursacht.
Abwarten ist sinnvoll, wenn die Anwendung noch aus einem einzigen Worker besteht oder die vermutete Verzögerung vollständig bei einem externen Anbieter liegt. Dieses Release erzeugt außerhalb von Cloudflare keinen verbundenen Trace.
Ist Tracing bereits aktiviert, sollten zunächst die neuen RPC-Spans geprüft werden, bevor eigene Instrumentierung hinzukommt. Eigene Spans sind erst dann sinnvoll, wenn der automatische Trace innerhalb der eigenen Methode eine relevante Lücke erkennen lässt.
Der erste Schritt am Montag bleibt überschaubar: observability.traces.enabled für einen realen Anfragepfad aktivieren, die langsame Anfrage reproduzieren, RPC-Sitzung und Methodenspans prüfen und anschließend Sampling-Rate, durchschnittliche Spans pro Trace, Aufbewahrungsfenster und erwartete Kontingentnutzung dokumentieren, bevor der Rollout ausgeweitet wird.
Wer eine klare operative Einordnung wünscht, sobald eine Plattformänderung den Arbeitsaufwand oder die Rechnung beeinflusst, kann den Newsletter abonnieren.
- Zuletzt aktualisiert
- 17. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Vercel Hobby: Alte Deployments können vor Ablauf von 30 Tagen verschwinden
Bei Vercel Hobby sind alte Deployments nicht mehr 30 Tage sicher. Der Leitfaden zeigt, welche Previews und Rollback-Ziele bei mehr als 10GB geschützt bleiben.17. Sept. 2026Explained
Cloudflare AI Gateway: Schutz vor Kosten auf der falschen Rechnung
Cloudflare AI Gateway blockiert Anfragen ohne passenden Provider-Schlüssel vor Unified Billing. So bleiben Kundenausgaben auf dem richtigen Konto.17. Sept. 2026Explained
Cloudflare Hyperdrive verbindet Python Workers direkt mit bestehenden Datenbanken
Cloudflare Hyperdrive verbindet Python Workers direkt mit PostgreSQL und MySQL. Was das für Architektur, Kompatibilität und Hostingkosten bedeutet.16. Sept. 2026Explained
KI-Telefonassistent mit Gemini 3.8 Live: Keine Funkstille bei Tool-Aufrufen
Gemini 3.8 Live hält Anrufende während langsamer Tool-Aufrufe auf dem Laufenden. So messen Teams Kosten, Abschlüsse und Risiken im realen Betrieb.16. Sept. 2026Explained
Cloudflare Worker: Rechte für Client-Deployments begrenzen
Cloudflare erlaubt Berechtigungen pro Worker. So trennen Agenturen Debugging, Codezugriff, Deployment und Löschrechte sauber zwischen Kundenprojekten.15. Sept. 2026Explained
Claude Code Auto Mode begrenzt Netzwerkzugriff pro Befehl
Claude Code Auto Mode begrenzt Registry-Zugriff auf einen einzelnen Installationsbefehl. So bleibt die Sandbox für spätere Schritte wieder geschlossen.15. Sept. 2026Explained
Claude Code Kosten: Wer im Vercel AI SDK wirklich zahlt
Claude Code Kosten im Vercel AI SDK: So bestimmen Abo, Provider-Schlüssel und AI Gateway die Modellrechnung, während die Sandbox separat berechnet wird.15. Sept. 2026Explained