Claude Code Kosten: Wer im Vercel AI SDK wirklich zahlt
Claude Code Kosten im Vercel AI SDK: So bestimmen Abo, Provider-Schlüssel und AI Gateway die Modellrechnung, während die Sandbox separat berechnet wird.





Vercel hat am 14. September 2026 geändert, welches Konto für einen eingebetteten Coding-Agenten zahlt. Das AI SDK kann jetzt ein unterstütztes, auf dem Host bereits angemeldetes Agenten-Abo verwenden. Für die Claude Code Kosten und die Ausgaben anderer geeigneter Agenten gilt damit: Der nächste geeignete Modelllauf verursacht bis zum Ende des Plankontingents $0 zusätzliche Gebühren. Die Sandbox-Rechenleistung wird weiterhin separat abgerechnet.
Was sich bei Claude Code Kosten ändert – und was nicht
Das AI SDK bietet eine Schicht, über die sich vollständige Coding-Agenten hinter einer einheitlichen HarnessAgent-Schnittstelle ausführen lassen. Vercel bezeichnet jeden Adapter als Harness, weil er weit mehr als einen Modellaufruf kapselt: Der Agent bringt eigene Tools, sein Verhalten im Arbeitsverzeichnis, Sitzungsstatus, Berechtigungen und Komprimierung mit.
Dieser Unterschied ist entscheidend. Das Release verbessert nicht die Programmierfähigkeiten von Claude Code, Codex, Cursor oder einem anderen Agenten. Stattdessen erhält der Adapter eine weitere Quelle für Zugangsdaten: eine native Abo-Sitzung auf dem Rechner, auf dem die Anwendung läuft.
Vor dieser Änderung benötigte ein eingebetteter Lauf ausdrücklich Zugangsdaten des Providers oder von AI Gateway. Jetzt kann ein geeigneter Adapter auf das bereits auf dem Host authentifizierte Abo zurückgreifen. Damit diese Zugangsdaten gefunden werden, sind weder Änderungen am Anwendungscode noch neue Einstellungen nötig.
Das Release nennt neun Adapter: Claude Code, Cline, Codex, Cursor, fx, GitHub Copilot, Grok Build, OpenCode und Pi. Das ist keine pauschale Zusage für jedes Konto. Der zugrunde liegende Agent muss die Anmeldung per Abo unterstützen, und seine eigenen Tarifregeln bestimmen weiterhin, was mit dieser Anmeldung genutzt werden darf.
Die geschäftliche Konsequenz ist einfach: Derselbe Aufruf von agent.generate() kann je nach vorhandenen Zugangsdaten drei verschiedene Budgets belasten.
Die Reihenfolge der Zugangsdaten entscheidet über die Rechnung
Es gibt drei Authentifizierungsmodi. Standardmäßig gilt auto. Bei direkten Adaptern wie Claude Code und Codex sieht die Reihenfolge in der Praxis so aus:
Hier kann eine unauffällige Umgebungsvariable die gesamte Abrechnung verändern. Ein Claude-Code-Lauf im Modus direct verwendet ANTHROPIC_API_KEY oder ANTHROPIC_AUTH_TOKEN vor dem Claude-Abo. Ein Codex-Lauf nutzt OPENAI_API_KEY oder CODEX_API_KEY vor dem ChatGPT-Anspruch.
Bei auto kommt eine weitere Ebene hinzu. Wird ein Gateway-Zugang gefunden, hat dieser Vorrang vor dem Provider-Schlüssel und dem Abo.
Netzwerkweg und Abrechnungsquelle sind nicht bei jedem Adapter identisch. fx sendet Modellanfragen in direct und ai-gateway weiterhin über AI Gateway. Ein unterstütztes natives Abo kann der Adapter jedoch jetzt auflösen, wenn keine passende Umgebungsvariable gesetzt und ai-gateway nicht ausgewählt ist. Bevor diese Tabelle als allgemeine Transportübersicht dient, lohnt sich deshalb der Blick auf die jeweilige Adapterseite.
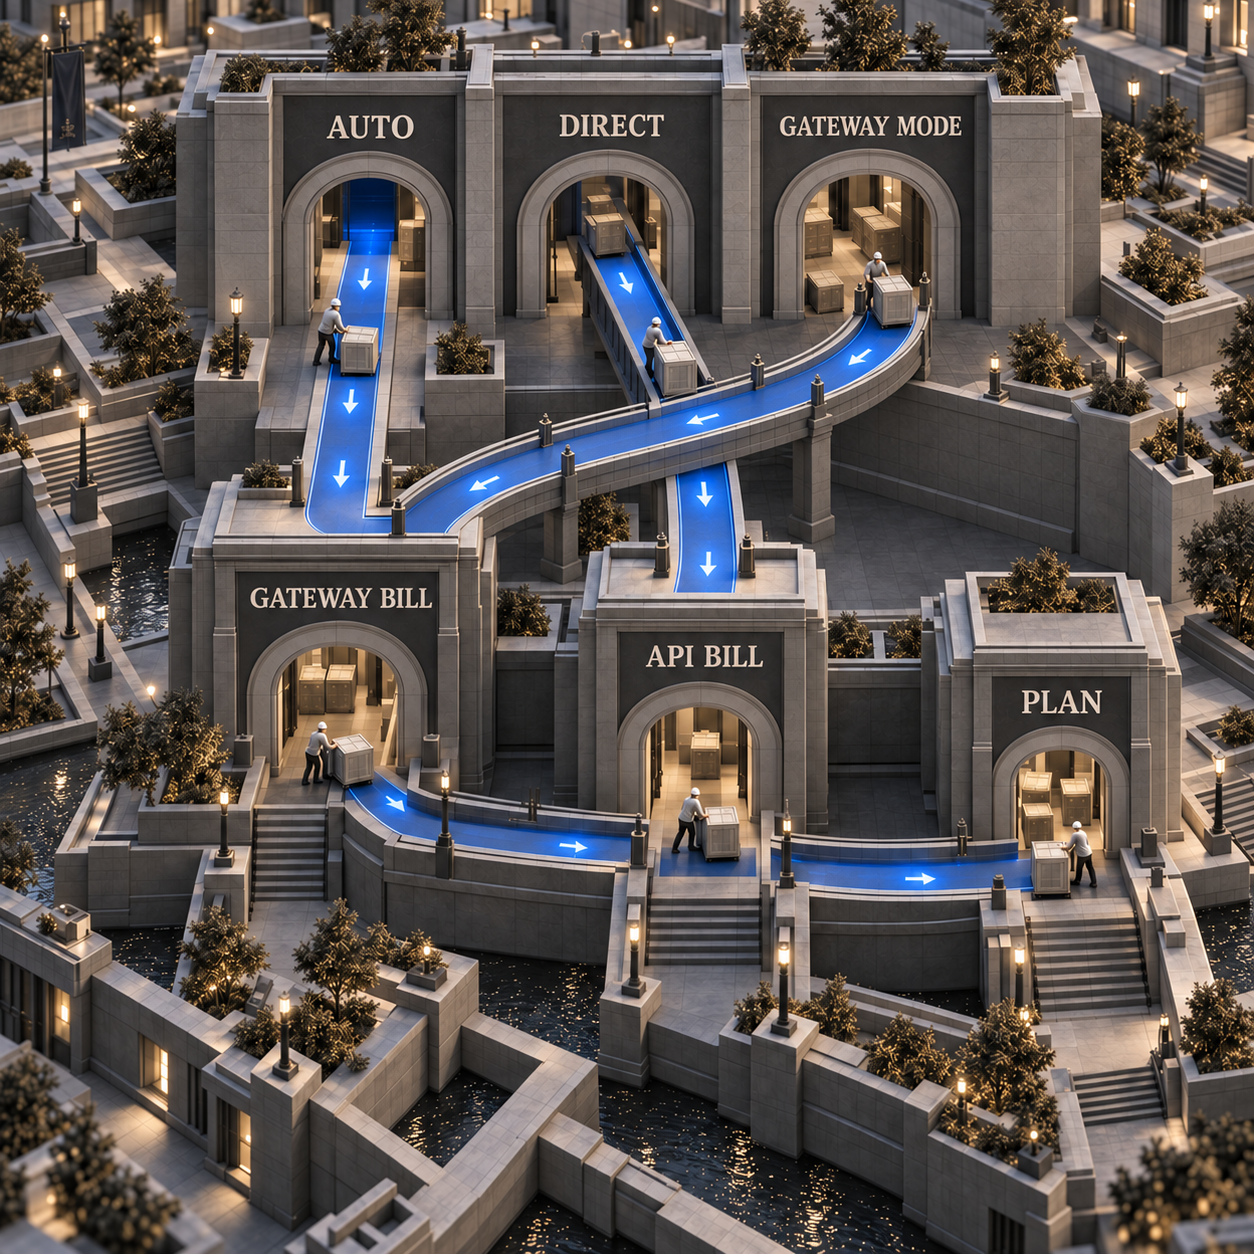
Diese Sicherheitsgrenze ist besser, als ein unverarbeitetes OAuth-Token in eine isolierte Maschine zu kopieren. Vercel löst die Zugangsdaten auf dem Host auf und erneuert OAuth ebenfalls dort. Unterstützt die Sandbox die Transformation von Anfragen, sieht der Agent nur einen Platzhalter; erst auf dem Host wird das echte Geheimnis in die passende ausgehende Anfrage eingesetzt.
Das hält das Geheimnis aus der Sandbox heraus. Aus einem persönlichen Abo wird dadurch jedoch keine gemeinsam nutzbare Unternehmenskapazität.
So setzt sich die Rechnung zusammen
Die Modellkosten können in ein Plankontingent wandern. Die Laufzeitkosten wandern nicht mit.
Plankontingent
Claude Code ist derzeit das anschaulichste Beispiel. Claude Pro kostet bei monatlicher Zahlung $20 oder $200 für ein Jahr. Claude Max kostet $100 oder $200 pro Monat für die 5x- beziehungsweise 20x-Nutzung von Pro. Wer bereits einen dieser Tarife bezahlt, trägt bei einem geeigneten Lauf mit nativer Authentifizierung keine separate Modellgebühr, bis das gemeinsame Kontingent aufgebraucht ist.
Das Wort gemeinsam ist dabei wörtlich zu nehmen. Anthropic erklärt derzeit, dass Claude Agent SDK, claude -p und Drittanbieter-Apps auf Basis des Agent SDK weiterhin auf die Abo-Limits angerechnet werden. Außerdem zählen claude.ai, Claude Code und Claude Desktop zum selben Nutzungslimit. Der Claude-Code-Adapter von Vercel verwendet das Agent SDK von Anthropic. In der Praxis konkurriert eingebettete Arbeit daher mit den übrigen Claude-Aktivitäten des Abonnenten.
Bei OpenAI folgt die Budgetlogik demselben Muster, verwendet aber andere Messgrößen. ChatGPT Plus kostet $20 pro Monat, Codex ist in den ChatGPT-Tarifen enthalten und die Limits unterscheiden sich je nach Tarif. Codex teilt sich ein Agentenkontingent mit ChatGPT Work, ChatGPT for Excel und Workspace Agents, sofern diese Produkte verfügbar sind. Berechtigte Plus- und Pro-Nutzer können nach Verbrauch der enthaltenen Nutzung Guthaben kaufen; dabei handelt es sich jedoch nicht um API-Guthaben.
Der Abo-Pfad bedeutet also keine kostenlose Inferenz. Er nutzt im Voraus bezahlte Kapazität mit einer variablen Obergrenze. Wer Hintergrundaufgaben in den Adapter verschiebt, spart heute womöglich API-Kosten und verkürzt morgen die interaktive Sitzung der Person.
Direkte Provider-API
Hat ein Provider-Schlüssel Vorrang, zahlt das nutzungsabhängig abgerechnete Konto dieses Anbieters. Claude Sonnet 4.6 kostet zu den üblichen API-Preisen derzeit $3 pro Million Eingabe-Token und $15 pro Million Ausgabe-Token. OpenAIs GPT-5.6 Luna kostet $0.20 pro Million Eingabe-Token, $0.02 pro Million zwischengespeicherte Eingabe-Token und $1.20 pro Million Ausgabe-Token.
Auf diesem API-Pfad lassen sich Kosten sauber zuordnen. Der Aufwand einer Coding-Agenten-Aufgabe wird dadurch aber noch nicht leicht vorhersehbar. Repository-Größe, Gesprächsverlauf, Reasoning-Aufwand, Wiederholungsversuche und Tool-Schleifen verändern den Token-Verbrauch. Gemessen werden sollten abgeschlossene Aufgaben, nicht Prompts.
AI Gateway
Hat ein Gateway-Zugang Vorrang, landet die Nutzung in AI Gateway. Vercel berechnet den Listenpreis des vorgelagerten Anbieters ohne Token-Aufschlag oder Plattformgebühr. Üblicherweise wird ein vorausbezahltes Gateway-Guthaben belastet; Enterprise-Kunden können stattdessen eine gebündelte Vercel-Rechnung nutzen.
Dieser Pfad schafft für ein Team eine zentrale Kostenstelle. Außerdem stehen dem Team Gateway-Budgets zur Verfügung. Umgeht ein Lauf das Gateway zugunsten eines nativen Abos, greifen diese Kontrollen nicht. Die Entscheidung zwischen geringeren Grenzkosten und zentraler Budgetsteuerung sollte daher bewusst fallen.
Sandbox-Rechenleistung
Jede Agentenlaufzeit des AI SDK arbeitet weiterhin in einer Sandbox. In Vercels Standardregion iad1 kostet Sandbox $0.128 pro aktiver CPU-Stunde und $0.0212 pro bereitgestellter GB-Stunde. Während der Prozess auf Modell- oder Netzwerk-I/O wartet, pausiert die CPU-Abrechnung; der Speicher wird über die gesamte Laufzeit weiter berechnet.
Vercels eigenes Beispiel zur Validierung von KI-Code läuft fünf Minuten mit zwei vCPUs und vier GB Arbeitsspeicher. Bei 100% CPU-Auslastung kostet es ungefähr $0.03. Stünde das vollständige Pro-Guthaben von $20 ausschließlich für genau diese Arbeitslast zur Verfügung, ergäbe die Rechnung eine grobe Obergrenze von 666 Läufen, bevor kostenpflichtige Sandbox-Nutzung anfällt. Die reale Kapazität wird abweichen, weil andere Vercel-Dienste das Guthaben ebenfalls verbrauchen können, Aufgaben unterschiedliche Ressourcen benötigen und für Datenübertragung oder Speicher weitere Kosten entstehen können.
Damit umfasst das Gesamtbudget:
- Abo-Pfad: bestehender Tarifpreis, gemeinsames Kontingent und zusätzlich die Sandbox.
- Provider-Pfad: nutzungsabhängig berechnete Provider-Token und zusätzlich die Sandbox.
- Gateway-Pfad: Provider-Token zum Listenpreis auf dem Gateway-Guthaben oder der Rechnung und zusätzlich die Sandbox.
Welcher Pfad passt zu welchem Einsatz?
Soloselbstständige mit einem internen Repository-Helfer
Wer als Gründer bereits Claude Pro oder ChatGPT Plus bezahlt, kann ein Tool für Tests, Fehlerbehebungen oder Repository-Zusammenfassungen mit geringem Volumen hinter HarnessAgent betreiben, direct auswählen und die geeignete Modellarbeit vom nativen Tarif abdecken lassen. In der Pilotphase entfällt damit ein weiteres Modellguthaben.
Der Einsatz sollte intern begrenzt bleiben und auf der Nutzungsseite des Providers beobachtet werden. Dasselbe Abo finanziert auch die Arbeit des Gründers im Terminal und in der App. Ein Hintergrundprozess kann also die Kapazität aufbrauchen, die später am Tag gebraucht wird.
Technische Leitung einer Agentur mit standardisierten Abläufen
Eine Agentur kann jedem namentlich zugeordneten Operator eine abgegrenzte Repository-Aufgabe geben und auf dem Host dessen geeignetes Abo verwenden. Entscheidend ist weniger die Wahl des Adapters als die Kontrolle, dass vor dem Start keine Provider-API-Variablen vorhanden sind.
So erhält die Finanzabteilung eine klare Regel: Für begrenzte interne Arbeit wird zuerst das Plankontingent genutzt; die Provider-API kommt nur zum Einsatz, wenn bewusst ein Schlüssel eingebunden wurde. Zugleich muss das Login einer Person nicht in der gesamten Agentur geteilt werden.
Plattformteam mit gemeinsam genutzter Automatisierung
Ein Plattformteam sollte unbeaufsichtigte oder gemeinsam genutzte Aufgaben in der Regel fest auf ai-gateway einstellen. Damit entfällt zwar das Fenster mit $0 zusätzlichen Abo-Kosten, doch das Team bekommt einen einzigen Rechnungseigentümer, einen gemeinsamen Guthabenpool oder eine Rechnung sowie Ausgabenlimits, die zum Dienst statt zu einer Person gehören.
Die ältere Erklärung zum fx-Adapter trifft in einem wichtigen Punkt weiterhin zu: In beiden fx-Modi laufen Modellanfragen über AI Gateway. Geändert hat sich am 14. September die Rückfalllogik für Zugangsdaten. Die Abschnitte zur Einrichtung und zu den Kosten müssen jetzt ein unterstütztes natives Abo berücksichtigen, sofern keine höher priorisierten Zugangsdaten greifen.
SaaS-Gründer mit Agentenfunktionen für Kunden
Bei einer kundenorientierten Coding-Funktion darf das Abo eines Mitarbeiters nicht als Kapazitätsplan dienen. Kundennutzung wird gemeinsam erzeugt, schwankt und muss Personalwechsel überstehen. Sinnvoller sind AI Gateway oder ein Provider-API-Konto mit eindeutigem Eigentümer; die Sandbox gehört anschließend in die Stückkostenrechnung.
Der separate Überblick über Agenten für bestehende Abos beantwortet, welchen lokalen oder quelloffenen Client einzelne Entwickler mit einem bereits vorhandenen Tarif nutzen sollten. Bei diesem Release geht es dagegen darum, eine unterstützte Laufzeit in eine AI-SDK-Anwendung einzubetten. Die Anmeldung kann ähnlich sein, das Betriebsmodell ist es nicht.
Einen Claude-Code-Lauf über das Plankontingent abrechnen
Dieser Weg eignet sich für eine abgegrenzte interne Aufgabe auf einem Host, auf dem sich der namentlich zugeordnete Nutzer bereits bei Claude Code angemeldet hat. Mit der dokumentierten Einstellung des Claude-Code-Adapters wird bewusst direct gewählt. Dadurch kann das Vercel-OIDC-Token die Sandbox authentifizieren, ohne die Modellarbeit an das Gateway umzuleiten.
Dokumentierte Pakete installieren
In einem bestehenden Node-Projekt werden das zentrale Agentenpaket, der Claude-Code-Adapter und der Adapter für Vercel Sandbox ergänzt.
Bashpnpm add @ai-sdk/harness @ai-sdk/harness-claude-code @ai-sdk/sandbox-vercelAuf dem Host anmelden
Claude Code wird auf demselben Host gestartet. Bei der Anmeldung ist das Claude-Konto mit dem geeigneten Abo auszuwählen.
BashclaudeVERCEL_OIDC_TOKENbleibt für die Sandbox verfügbar. Soll das Abo zahlen, muss die Prozessumgebung geprüft undANTHROPIC_API_KEYsowieANTHROPIC_AUTH_TOKENfür diesen Lauf entfernt werden. Jede der beiden Provider-Variablen hat Vorrang vor der nativen Anmeldung.Direkten Pfad erzwingen
Der folgende Inhalt wird als
agent.mjsgespeichert. Der Code nutzt die dokumentierte Auswahldirect, die aktuelle Sandbox-Laufzeitnode24und den für die Bridge erforderlichen freigegebenen Port4000.JavaScriptimport { HarnessAgent } from '@ai-sdk/harness/agent'; import { createClaudeCode } from '@ai-sdk/harness-claude-code'; import { createVercelSandbox } from '@ai-sdk/sandbox-vercel'; const agent = new HarnessAgent({ harness: createClaudeCode({ auth: 'direct' }), model: 'claude-sonnet-4-6', sandbox: createVercelSandbox({ runtime: 'node24', ports: [4000], }), }); const session = await agent.createSession(); let exitCode = 0; try { const result = await agent.generate({ session, prompt: 'Create a short TODO.md for this repository.', }); console.log(result.text); } catch (err) { exitCode = 1; console.error(err); } finally { await session.destroy(); process.exit(exitCode); }Beide Abrechnungsbelege prüfen
Zunächst wird eine einzelne harmlose Aufgabe ausgeführt. Auf der Nutzungsseite des Providers muss sich anschließend das Plankontingent verändert haben, ohne dass eine neue API-Gebühr entstanden ist. Danach folgt die Kontrolle des Sandbox-Postens unter Vercel Usage.
Taucht die Modellanfrage in AI Gateway auf, hatte ein Gateway-Zugang Vorrang. Verzeichnet das API-Dashboard des Providers eine Gebühr, hatte ein Provider-Zugang Vorrang. In beiden Fällen sollte die Umgebung korrigiert werden, bevor der Pilot ausgeweitet wird.
Die tatsächlichen Grenzen
Die native Anmeldung ist an den Host gebunden. Sie ist kein fertiger OAuth-Ablauf für sämtliche Kunden einer Anwendung und bündelt auch nicht die individuellen Kontingente eines Teams.
Auch die Plankapazität verändert sich. Laut OpenAI hängen die Codex-Limits vom Tarif und von der Aufgabe ab. Anthropic zufolge richtet sich die Claude-Nutzung nach Modell, Aufgabenkomplexität, Kontext und Aufwand. Keiner der beiden Anbieter nennt für diesen Vercel-Pfad eine feste Zahl an Produktionsläufen.
Die Agentenpakete des AI SDK sind weiterhin experimentell; zwischen Releases sind inkompatible Änderungen möglich. Für einen überwachten internen Piloten kann das vertretbar sein. Bevor daraus ein Leistungsversprechen an Kunden wird, sollten Abhängigkeiten jedoch festgeschrieben, die Auswahl der Zugangsdaten getestet und ein Gateway- oder Provider-Pfad vorbereitet werden.
Der nächste Schritt am Montag
Ausgewählt werden eine interne Repository-Aufgabe und ein geeigneter Nutzer. Der Adapter wird auf direct gesetzt, die Provider-Variablen auf dem Host werden erfasst und die Aufgabe wird einmal ausgeführt. Zu protokollieren ist, welches Abrechnungs-Dashboard eine Veränderung zeigt, ob sich das Plankontingent geändert hat, welche Sandbox-Kosten entstanden sind und ob die Aufgabe abgeschlossen wurde.
Wer bereits einen unterstützten Tarif besitzt und einen klar begrenzten internen Ablauf hat, kann noch diese Woche beginnen. Abwarten ist sinnvoll, wenn der zugrunde liegende Agent keine Anmeldung per Abo unterstützt oder der experimentelle Paketstatus nicht zur eigenen Abhängigkeitsrichtlinie passt. Wenn zentrale Budgets und gemeinsam verantworteter Produktionsbetrieb wichtiger sind als die marginale Modellkostenersparnis, bleibt ai-gateway die richtige Wahl. Wer ausschließlich gewöhnliche Modell-Provider des AI SDK aufruft und HarnessAgent nie verwendet, ist von der Änderung nicht betroffen.
Weitere praxisnahe Erklärungen dazu, wie KI-Tools reale Budgets und Arbeitsabläufe verändern, gibt es im Newsletter.
- Zuletzt aktualisiert
- 15. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Cloudflare Browser Run: Guardrails für sichere Kunden-Reviews
Cloudflare Browser Run begrenzt Sitzungen auf freigegebene Hosts und macht Live View schreibgeschützt. Was das für sichere Kunden-Reviews und Kosten bedeutet.14. Sept. 2026Explained
KI-Telefonassistent mit GPT-Live-1: Was Anrufe wirklich kosten
GPT-Live-1 kostet $0.05 je Sprachminute. Die Rechnung zeigt, was ein KI-Telefonassistent mit Backend, Tools und Telefonie pro Anruf wirklich kostet.14. Sept. 2026Explained
ChatGPT Desktop App: So sparen Appshots unter Windows Kopierarbeit
Mit Appshots übergibt die ChatGPT Desktop App unter Windows ein aktives Fenster an den Chat. Das spart Kopierarbeit, verlangt aber eine genaue Prüfung.14. Sept. 2026Explained
Vercel Functions umgehen: FastAPI-Dateien direkt aus dem CDN
Vercel Functions liefern geeignete FastAPI-Static-Files nicht mehr selbst aus. So sinken Function-Aufrufe und Compute-Nutzung; CDN-Nutzung und Transfer bleiben.13. Sept. 2026Explained
OpenAI API Key mit Ablaufdatum: So gelingt die Rotation ohne Ausfall
OpenAI API Keys können ablaufen. Dieser Leitfaden zeigt, wie Teams Ersatzschlüssel bereitstellen, produktiv prüfen und ohne Ausfall rotieren.13. Sept. 2026Explained
Connector Manager in Vercel: Klare Zuständigkeit für gemeinsame Zugangsdaten
Mit dem Connector Manager begrenzen Vercel-Teams, wer gemeinsame Verbindungen pflegt – ohne Provider-Rechte, Laufzeitzugriff und Freigaben zu vermischen.13. Sept. 2026Explained
Cloudflare R2: Dateien ohne Dateiendung in AI Search indexieren
Cloudflare R2: AI Search erkennt Dateien ohne Endung jetzt am HTTP-Content-Type. So bleiben stabile Objektschlüssel erhalten – samt Prüf- und Kostenregeln.12. Sept. 2026Explained