Cloudflare Hyperdrive verbindet Python Workers direkt mit bestehenden Datenbanken
Cloudflare Hyperdrive verbindet Python Workers direkt mit PostgreSQL und MySQL. Was das für Architektur, Kompatibilität und Hostingkosten bedeutet.


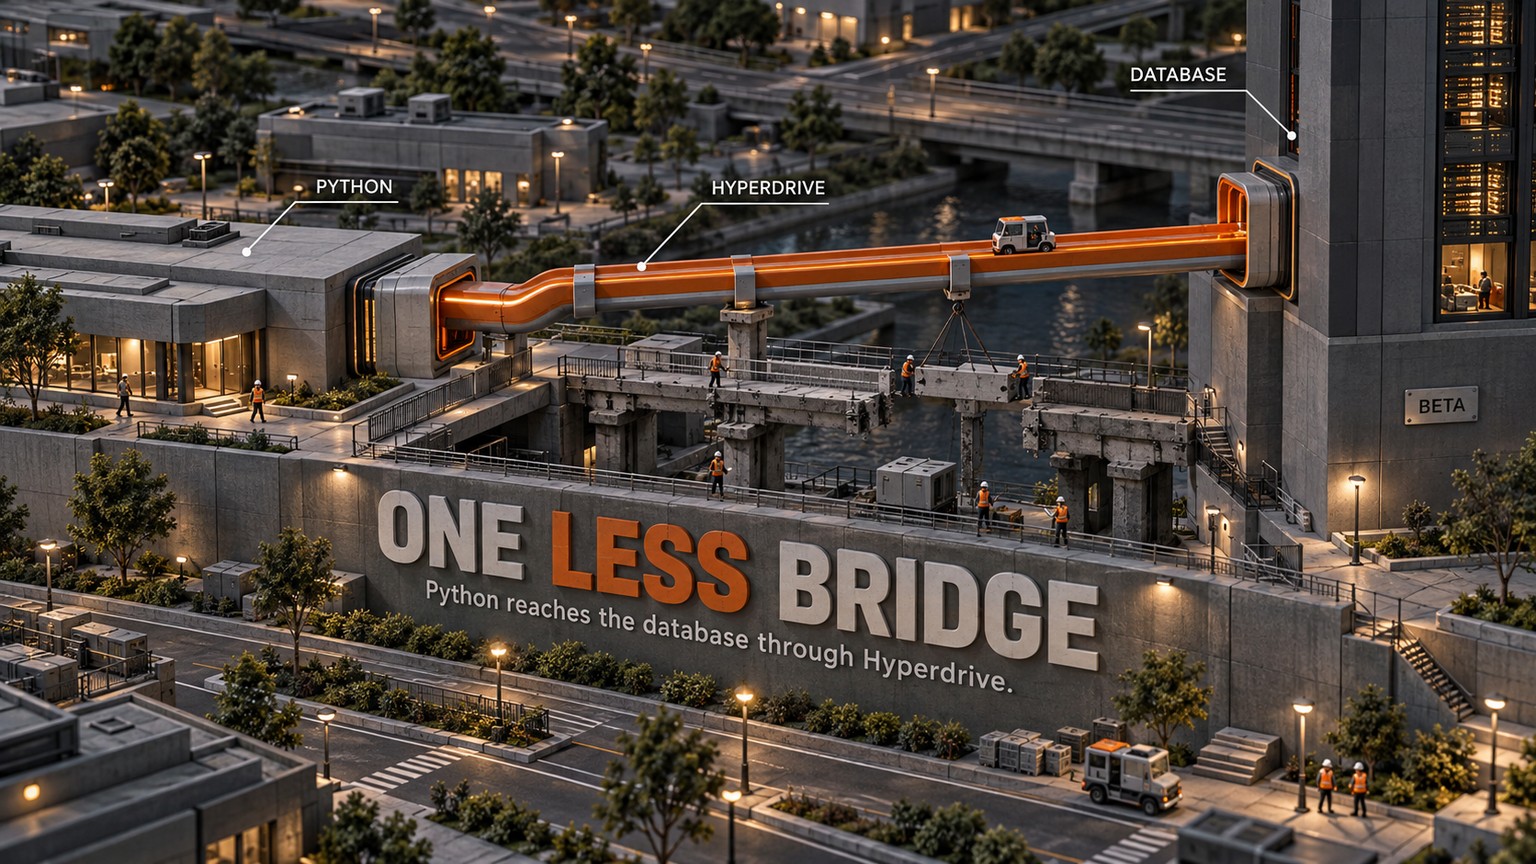
Am 16. September 2026 hat Cloudflare Python Workers über Cloudflare Hyperdrive einen direkten Weg zu PostgreSQL und MySQL eröffnet. Brauchte ein Worker bislang allein für den Zugriff auf eine bestehende Datenbank einen separaten HTTP-Dienst, lässt sich dieser nun womöglicherweise streichen. Das verändert sowohl die Architektur als auch die monatlichen Kosten.
Cloudflare Hyperdrive: Die Datenbank bleibt, wo sie ist
Der eigentliche Vorteil dieser Neuerung liegt darin, was nicht mehr umziehen muss.
Hyperdrive ist eine verwaltete Verbindungsschicht zwischen einem Cloudflare Worker und einer vorhandenen PostgreSQL- oder MySQL-Datenbank. Es handelt sich weder um eine neue Datenbank noch kopiert der Dienst Datensätze zu Cloudflare. Der Python-Code baut mit einem regulären Datenbanktreiber eine TCP-Verbindung auf und verwendet dafür die Verbindungsdaten eines Hyperdrive-Bindings. Hyperdrive verwaltet im Hintergrund den dauerhaften Verbindungspool zur Datenbank.
Damit ändert sich der bisher gängige Behelf. Konnte ein Python Worker nicht direkt auf seine Datenbank zugreifen, rief er womöglich eine kleine API oder einen Server auf, dessen einzige Aufgabe darin bestand, SQL auszuführen. Der Pfad sah so aus:
Vorher: Python Worker → Datenbank-Bridge → PostgreSQL oder MySQL
Jetzt: Python Worker → Hyperdrive → PostgreSQL oder MySQL
Cloudflare baut die Verbindung in der Nähe des Workers auf und hält gepoolte Verbindungen nahe an der Ursprungsdatenbank bereit. Der Hyperdrive-Leitfaden zählt bei einem herkömmlichen Aufbau sieben Roundtrips, bevor die erste Abfrage startet: einen für TCP, drei für TLS und drei für die Datenbankauthentifizierung. Wird der Pool wiederverwendet, entfällt dieser vollständige Verbindungsaufbau bei jedem kurzlebigen Worker-Aufruf.
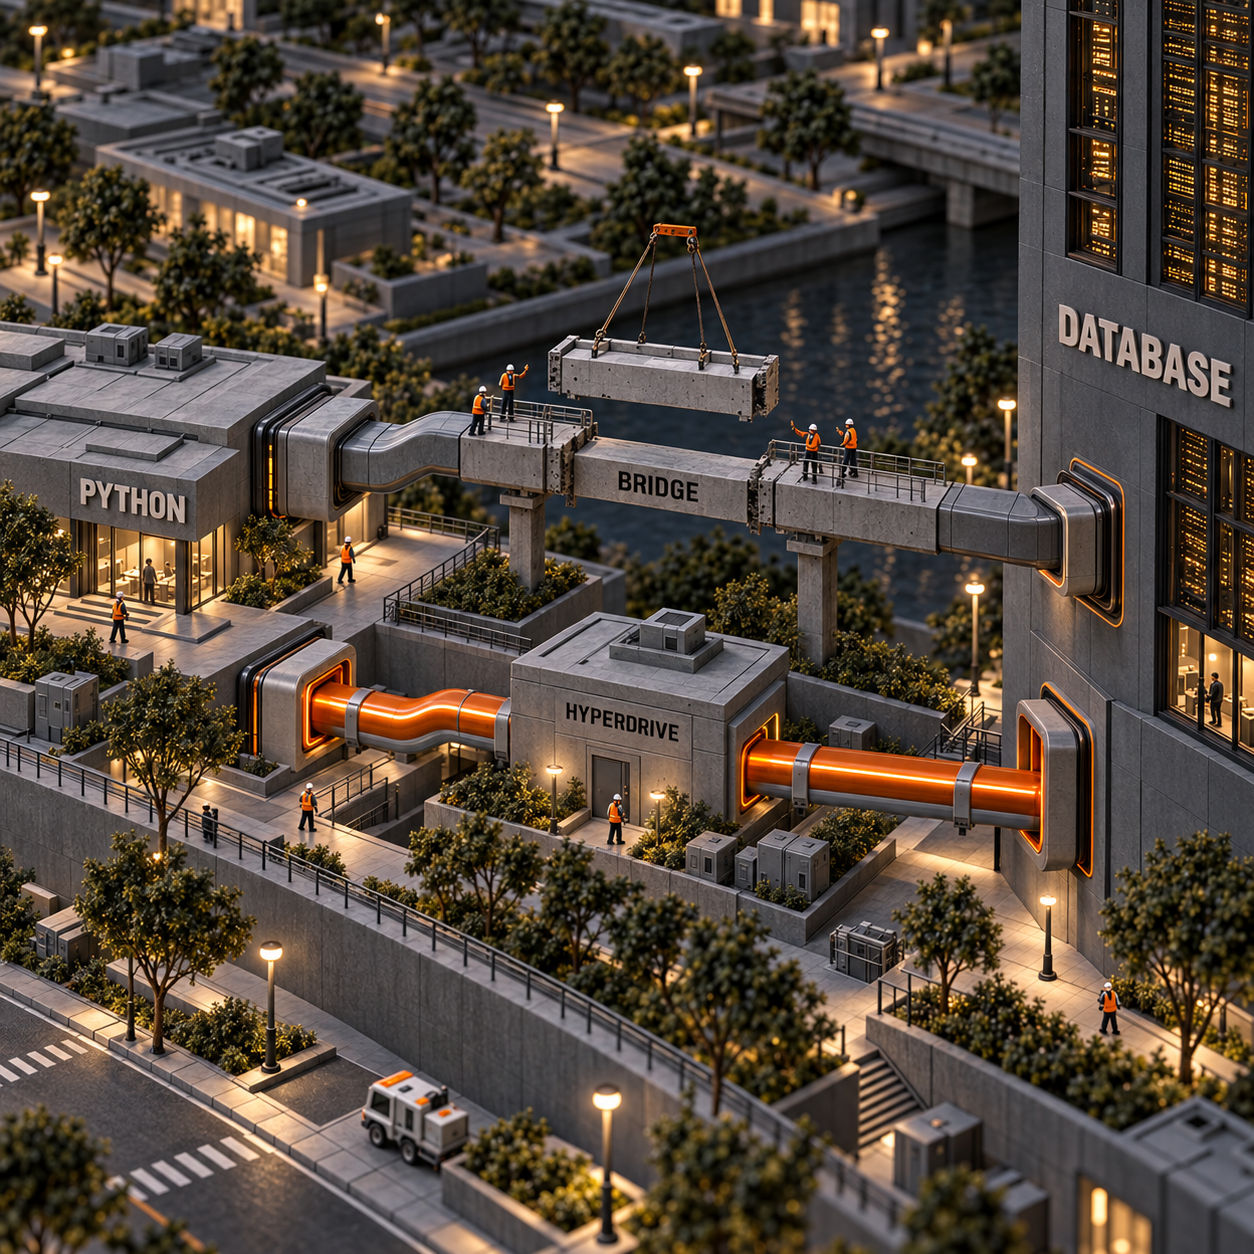
Der unterstützte Pfad ist klar eingegrenzt. Python Workers benötigen ein Kompatibilitätsdatum vom 2026-09-08 oder später; das Feature befindet sich weiterhin in der Betaphase. Für PostgreSQL hat Cloudflare asyncpg, pg8000 und psycopg getestet, für MySQL außerdem aiomysql und pymysql. Empfohlen werden asyncpg und aiomysql.
Laut Cloudflare können auch andere TCP-Treiber funktionieren. Das ist jedoch keine Zusage, dass jedes Paket, jedes ORM oder jede bestehende Anwendung kompatibel ist. Eine passende Datenbank öffnet lediglich das erste Tor der Migration.
Welche Kostenposition sich verändert
Am eindeutigsten fällt der Kostenvorteil aus, wenn die Python-Anwendung bereits auf Workers läuft und eine Bridge nur deshalb bezahlt wird, weil der Worker Datenbankzugriff benötigt.
Die Rechnung ist einfach:
Aktuelle Monatskosten = Datenbank + Worker + Bridge-Host
Mögliche Monatskosten = Datenbank + Worker
Die Datenbankrechnung bleibt bestehen. Der integrierte Verbindungspool und das Abfrage-Caching von Hyperdrive kosten im Tarif Workers Paid keinen separaten Aufpreis; auch für ausgehenden Datenverkehr berechnet Hyperdrive nichts. Bleibt das Konto innerhalb der bereits enthaltenen Workers-Nutzung, beträgt der zusätzliche Cloudflare-Betrag für diesen Verbindungspfad daher $0. Die tatsächlich mögliche Einsparung entspricht der Rechnung des Bridge-Hosts, die danach wirklich entfällt.
Auch der Wartungsaufwand gehört in dieselbe Rechnung. Mit der Bridge können zugleich ein Deployment, ein Healthcheck, ein Satz Zugangsdaten, ein Log-Stream und eine Fehlerdomäne verschwinden. Diesem Aufwand sollte erst dann ein Geldwert zugewiesen werden, wenn klar ist, wer die Komponente betreut und wie oft sie Probleme verursacht.
Für ein neues kostenpflichtiges Konto beginnt Workers Paid bei $5 pro Konto und Monat. Enthalten sind monatlich 10 Millionen Anfragen und 30 Millionen CPU-Millisekunden. Jede weitere Million Anfragen kostet $0.30, jede weitere Million CPU-Millisekunden $0.02. Datenbankabfragen über Hyperdrive werden in diesem Tarif als unbegrenzt ausgewiesen.
Für einen kleinen Machbarkeitstest reicht der Free-Tarif. Er umfasst täglich 100,000 Worker-Anfragen und 100,000 Hyperdrive-Datenbankabfragen sowie 10 Millisekunden CPU-Zeit je Aufruf. Diese Zähler sind voneinander getrennt. Eine Anfrage, die mehrere SQL-Anweisungen ausführt, kann entsprechend mehrere Datenbankabfragen verbrauchen.
Wer die Neuerung sofort nutzen kann
Soloselbstständige mit einem FastAPI-Dienst
Angenommen, eine Gründerin oder ein Gründer betreibt einen FastAPI Worker vor einer verwalteten PostgreSQL-Datenbank. Daneben läuft ein kleiner Container, der HTTP-Aufrufe entgegennimmt und SQL ausführt. Enthält dieser Container keine Geschäftslogik, lässt sich mit asyncpg prüfen, ob Hyperdrive ihn ersetzen kann.
Der Gewinn besteht nicht in einer neuen Datenbank. Schema, Backups und Anbieter bleiben erhalten, während ein Dienst wegfällt, der lediglich als Verbindungsadapter diente. Sinnvoll ist, zunächst eine Route zu migrieren, Ergebnis und Latenz zu vergleichen und die Bridge erst zu entfernen, wenn sich das Verhalten in der Produktion deckt.
Kleine Agenturen mit MySQL-Datenbanken ihrer Kunden
Eine kleine Agentur betreut womöglich mehrere schlanke Python-APIs, die jeweils auf die MySQL-Datenbank eines Kunden zugreifen. Mit dem neuen Pfad kann sie aiomysql oder pymysql direkt im Worker testen, statt für jede geeignete Anwendung einen Datenbank-Proxy bereitzustellen.
Der Nutzen liegt in einheitlichen Abläufen. Die Agentur kann einen einheitlichen Worker-Deployment-Pfad nutzen und pro Datenbank eine Hyperdrive-Konfiguration verwalten. Die Bridge bleibt dagegen notwendig, wenn sie Mandanten autorisiert, Schemas übersetzt, Vorgänge protokolliert oder andere Aufgaben übernimmt, die über das bloße Weiterreichen von Abfragen hinausgehen.
Plattformteams mit einem leseintensiven Endpunkt
Ein Plattformteam muss nicht das gesamte Backend migrieren. Es kann einen einzelnen öffentlichen, leseintensiven Python-Endpunkt zu Workers verlagern, die regionale Datenbank behalten und Hyperdrive die Verbindungen zum Ursprungssystem poolen lassen.
Gerade hier braucht das Caching eine bewusste Entscheidung. Hyperdrive speichert geeignete Lesezugriffe standardmäßig 60 Sekunden im Cache und kann während der erneuten Validierung für weitere 15 Sekunden ein veraltetes Ergebnis ausliefern. Bei öffentlichen Katalog- oder Inhaltsdaten kann das vertretbar sein. Für Authentifizierung, Berechtigungen, Abrechnungsstatus und Lesezugriffe unmittelbar nach einem Schreibvorgang empfiehlt sich eine separate Hyperdrive-Konfiguration mit deaktiviertem Cache.
Der frühere Vergleich von Django und FastAPI hilft weiterhin bei der Framework-Wahl. Diese Neuerung verschiebt einen Teil der Entscheidung: PostgreSQL oder MySQL beizubehalten, ist für Python Workers nun ein dokumentierter Weg. Damit ist jedoch nicht automatisch der Rest einer Django- oder FastAPI-Anwendung freigegeben.
Der kleinste sichere Verbindungstest
Für den Test eignet sich eine MySQL-Datenbank außerhalb der Produktion mit einem eingeschränkten Testbenutzer. Ziel ist, den Verbindungspfad mit SELECT 1 nachzuweisen – nicht, eine vollständige Migration mit Kundendaten zu proben.
Zunächst wird eine Hyperdrive-Konfiguration ohne Cache erstellt, damit der erste Test einen frischen Roundtrip zur Datenbank misst:
npx wrangler hyperdrive create python-db-test --connection-string="mysql://user:password@HOSTNAME_OR_IP_ADDRESS:PORT/database_name" --caching-disabledDie von Wrangler ausgegebene Konfigurations-ID kommt in die Datei wrangler.toml. Das folgende Datum liegt nach dem vorgeschriebenen Mindestdatum 2026-09-08:
name = "python-hyperdrive"
main = "src/main.py"
compatibility_date = "2026-09-16"
compatibility_flags = ["python_workers"]

[[hyperdrive]]
binding = "HYPERDRIVE"
id = "<HYPERDRIVE_CONFIG_ID>"
Anschließend wird der Treiber in pyproject.toml ergänzt:
[project]
dependencies = [
    "aiomysql",
]
Danach folgt der von Cloudflare dokumentierte Verbindungstest in src/main.py:
import aiomysql
from workers import Response, WorkerEntrypoint


class Default(WorkerEntrypoint):
    async def fetch(self, request):
        hd = self.env.HYPERDRIVE
        connection = await aiomysql.connect(
            host=hd.host,
            port=int(hd.port),
            user=hd.user,
            password=hd.password,
            db=hd.database,
            ssl=None,
        )
        try:
            cursor = await connection.cursor()
            await cursor.execute("SELECT 1")
            result = await cursor.fetchone()
            return Response.json({"result": result[0]})
        finally:
            connection.close()
Bereitgestellt wird der Worker mit dem dokumentierten Befehl für Python Workers:
uv run pywrangler deployUngewohnt wirkt häufig die Zeile ssl=None. Im Beispiel von Cloudflare beschreibt sie die Treiberverbindung vom Worker zu Hyperdrive. Die Verbindung von Hyperdrive zur Ursprungsdatenbank erfordert weiterhin TLS; unsichere Klartextverbindungen zum Ursprungssystem werden nicht unterstützt.
Die Bridge ist optional, aber nicht automatisch überholt
Die Neuerung betrifft einen Verbindungspfad. Sie macht aus Python Workers keinen uneingeschränkten CPython-Server.
Unterstützt werden reine Python-Pakete, PyEmscripten-Wheels und in Pyodide enthaltene Pakete. Cloudflare bezeichnet die Unterstützung von WebAssembly-Paketen weiterhin als frühes Stadium; schon eine fehlende Abhängigkeit kann die Migration stoppen. Die Dokumentation zu Treibern und ORMs unterstützt derzeit nur synchrones SQLAlchemy. Asynchrones SQLAlchemy funktioniert nicht, weil die Workers-Umgebung keine greenlet-Unterstützung bietet.
Auch das Datenbankprotokoll setzt Grenzen. Hyperdrive unterstützt PostgreSQL 9.0 bis 17.x und MySQL 5.7 bis 8.x sowie MariaDB. SQL Server und MongoDB werden nicht unterstützt. Bei PostgreSQL entfallen Advisory Locks sowie LISTEN und NOTIFY; bei MySQL sind weder Multi-Statement-Abfragen noch Prepared Statements auf Protokollebene möglich. Für Free und Paid gilt gleichermaßen eine maximale Abfragedauer von 60 Sekunden.
Pooling verändert zudem die Annahmen über Sitzungen. Hyperdrive verwendet Transaktions-Pooling: Nach dem Ende einer Transaktion kehrt die Ursprungsverbindung in den Pool zurück. Code, der erwartet, dass ein Sitzungszustand über mehrere Transaktionen hinweg bestehen bleibt, muss deshalb geprüft werden. Lange Transaktionen können außerdem den Pool ausschöpfen und damit den Vorteil paralleler Verbindungen zunichtemachen.
Der nächste sinnvolle Schritt am Montag
Am Montag sollte nicht die ganze Anwendung migriert werden. Zuerst gilt es zu prüfen, ob eine reine Datenbank-Bridge überhaupt noch eine Daseinsberechtigung hat.
Einen entbehrlichen Pfad auswählen
Eine Datenbank oder Replik außerhalb der Produktion mit einem eingeschränkten Benutzer anlegen. Geeignet ist eine Route, die einen unkritischen Datensatz liest und weder von Sitzungszustand und Sperren noch von unmittelbar nach einem Schreibvorgang aktuellen Daten abhängt.
Den Verbindungstest ausführen
Den oben gezeigten kleinen Worker bereitstellen und prüfen, ob
SELECT 1über Hyperdrive erfolgreich ist. Fehlerrate, CPU-Zeit und Gesamtlaufzeit des Workers sowie die Zahl der Datenbankverbindungen festhalten.Echten Treiber und echte Abfrage testen
Die Testabfrage durch den tatsächlichen Treiber der Route und eine repräsentative Abfrage ersetzen. Zurückgegebene Daten, Transaktionsverhalten, Cache-Einstellung und Pool-Auslastung mit der bestehenden Bridge vergleichen.
Den Wegfall durchrechnen
Die monatliche Hostingrechnung der Bridge sowie die Stunden für Bereitstellung, Updates, Überwachung und Wiederherstellung notieren. Davon die zusätzliche Workers-Nutzung und den laufenden Hyperdrive-Aufwand abziehen. Die Bridge erst löschen, wenn sowohl diese Rechnung als auch der Kompatibilitätstest dafür sprechen.
Ein Schritt noch in dieser Woche lohnt sich, wenn die Bridge ausschließlich dem Datenbankzugriff dient, PostgreSQL oder MySQL verwendet wird und ein getesteter Treiber die Route abdeckt. Abwarten ist sinnvoll bei asynchronem SQLAlchemy, einem nicht verfügbaren Paket, nicht unterstütztem SQL-Verhalten oder strenger Read-after-write-Konsistenz, die noch nicht separat behandelt wird. Keine Auswirkungen hat die Neuerung, wenn die Anwendung auf ihrem bisherigen Server bleibt oder die Bridge Geschäftslogik enthält, die Hyperdrive nicht ersetzt.
Wer auch die nächste Plattformänderung in eine konkrete Entscheidung für Montag übersetzt haben möchte, kann den Newsletter abonnieren.
- Zuletzt aktualisiert
- 16. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained