KI-Telefonassistent mit GPT-Live-1: Was Anrufe wirklich kosten
GPT-Live-1 kostet $0.05 je Sprachminute. Die Rechnung zeigt, was ein KI-Telefonassistent mit Backend, Tools und Telefonie pro Anruf wirklich kostet.



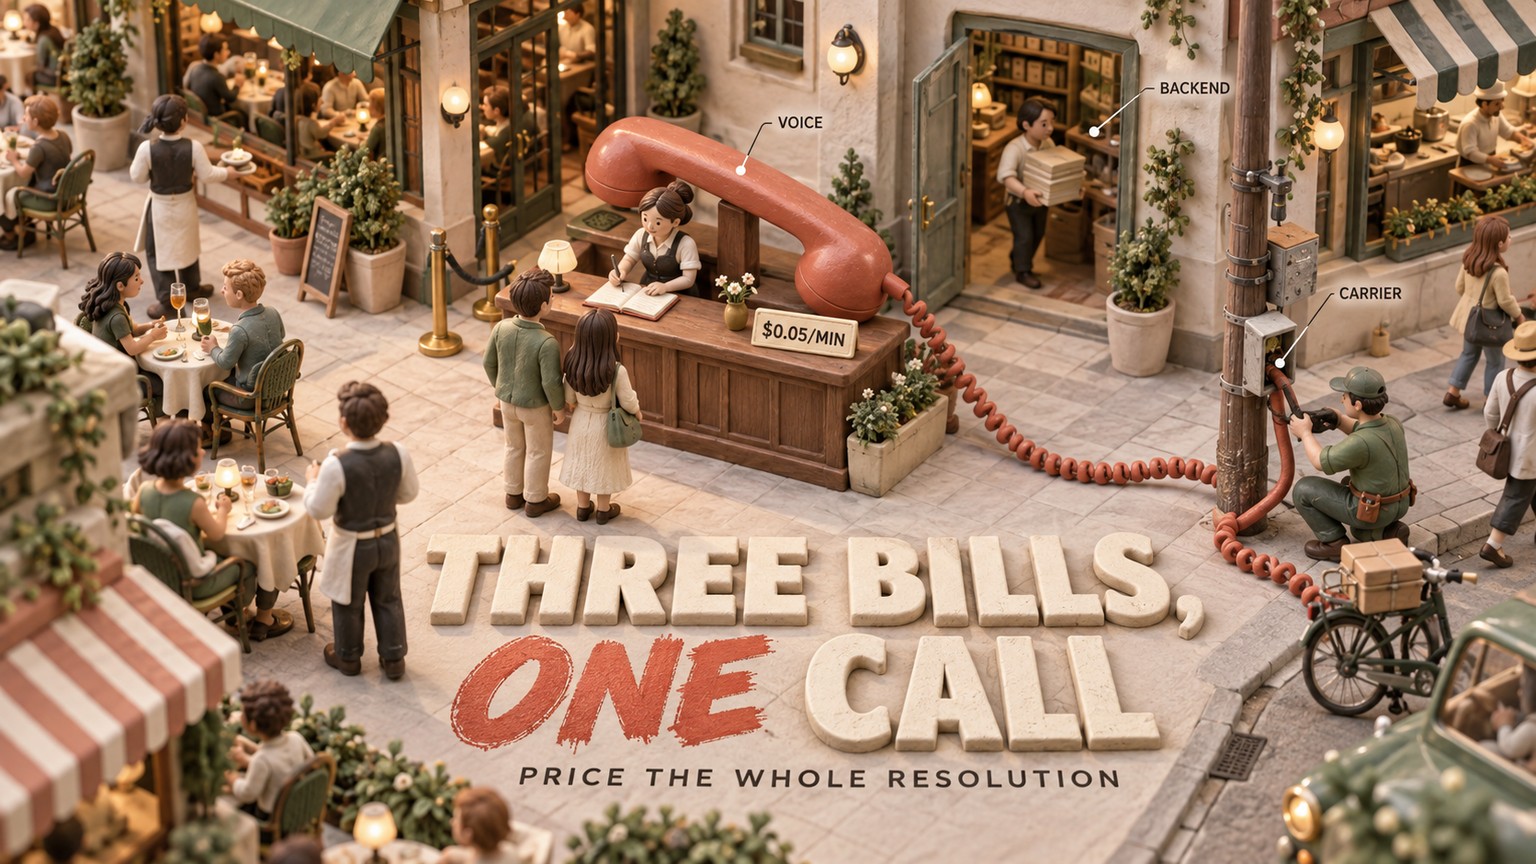
Für einen KI-Telefonassistenten macht GPT-Live-1 einen Kostenblock leicht kalkulierbar: Die Sprachsitzung kostet $0.05 pro Minute. Seit dem 10. September 2026 können Teams den Sprech- und Hördialog vereinfachen. Für die Budgetplanung zählt trotzdem der Gesamtpreis eines erfolgreich abgeschlossenen Anrufs – einschließlich Backend-Reasoning, Tools und Telefontransport.
Was kostet ein KI-Telefonassistent? Die Stimme ist nur eine Position
GPT-Live-1 ist ein Vollduplex-Sprachmodell. Es kann also zuhören, während es spricht. Anrufende können dadurch unterbrechen, pausieren, eine Angabe korrigieren oder mit einer kurzen Bestätigung reagieren, ohne das Ende eines starren Sprecherwechsels abwarten zu müssen.
Das verändert den Aufbau des Systems. Ein klassischer Sprachagent verkettet häufig Spracherkennung, ein Sprachmodell und Sprachsynthese. Die Anwendung muss Informationen über jede Schnittstelle weiterreichen und festlegen, was geschieht, wenn beide Seiten gleichzeitig reden.
GPT-Live-1 bündelt das Live-Gespräch in einer einzigen Sprachschicht. Das Modell hört zu, spricht, behält das Timing im Blick und entscheidet, wann anspruchsvollere Arbeit an ein Backend abgegeben wird. Dort kann etwa eine Reservierung geprüft, ein Kontodatensatz gelesen, ein Tool aufgerufen oder eine Richtlinie im Detail bewertet werden.
Das Backend bleibt bewusst getrennt. Bei der Responses-Delegation übergibt GPT-Live-1 Aufgaben an ein konfiguriertes OpenAI-Textmodell. Bei der Client-Delegation führt die eigene Anwendung ein beliebiges Modell, einen Agenten oder einen Dienst aus und gibt das Ergebnis zurück. So bleibt die Stimme gleich, während je nach Aufgabe ein günstigeres oder leistungsfähigeres Modell arbeiten kann.
Auch die Telefonverbindung ist ein eigener Baustein. Ein eingehender Anruf kann GPT-Live-1 über einen SIP-Trunk erreichen – also über die von einem Telefonieanbieter bereitgestellte Internetverbindung – oder über eine Anwendung, die das Audio weiterleitet. OpenAI betreibt die Live-Sitzung; Rufnummer und Telefontransport bleiben beim Carrier.
Darin liegt die eigentliche Budgetänderung. Für diesen Weg müssen Spracherkennung und Sprachausgabe nicht mehr als zwei getrennte OpenAI-Modellstufen kalkuliert werden. Dafür gilt es, drei Kostenblöcke sauber auseinanderzuhalten.
Die Rechnung besteht aus drei Kostenblöcken
Die erste Falle ist die Uhr. Die Abrechnung von GPT-Live-1 läuft vom Beginn der aktiven Sitzung bis zu ihrem Ende. Stille zählt. Wartezeit auf ein Tool zählt ebenfalls. Auch ein stummgeschaltetes Mikrofon stoppt die Abrechnung nicht.
Die zweite Falle besteht darin, das Backend für kostenlos zu halten, nur weil es hinter dem Gespräch arbeitet. Das ist es nicht. Bei der Standardpreisgestaltung für kurze Kontexte kostet GPT-5.6 Luna $0.20 je eine Million Input-Tokens und $1.20 je eine Million Output-Tokens. Bei GPT-5.6 Terra sind es $2.00 beziehungsweise $12.00, bei GPT-6 Astra $10.00 beziehungsweise $50.00. Entscheidend ist nicht, welches Modell den niedrigsten Tokenpreis hat. Entscheidend ist, welche Kombination die Aufgabe zuverlässig mit der geringsten gesamten Gesprächsdauer und möglichst wenig Nacharbeit abschließt.
Eine Reservierung zeigt die tatsächliche Rechnung
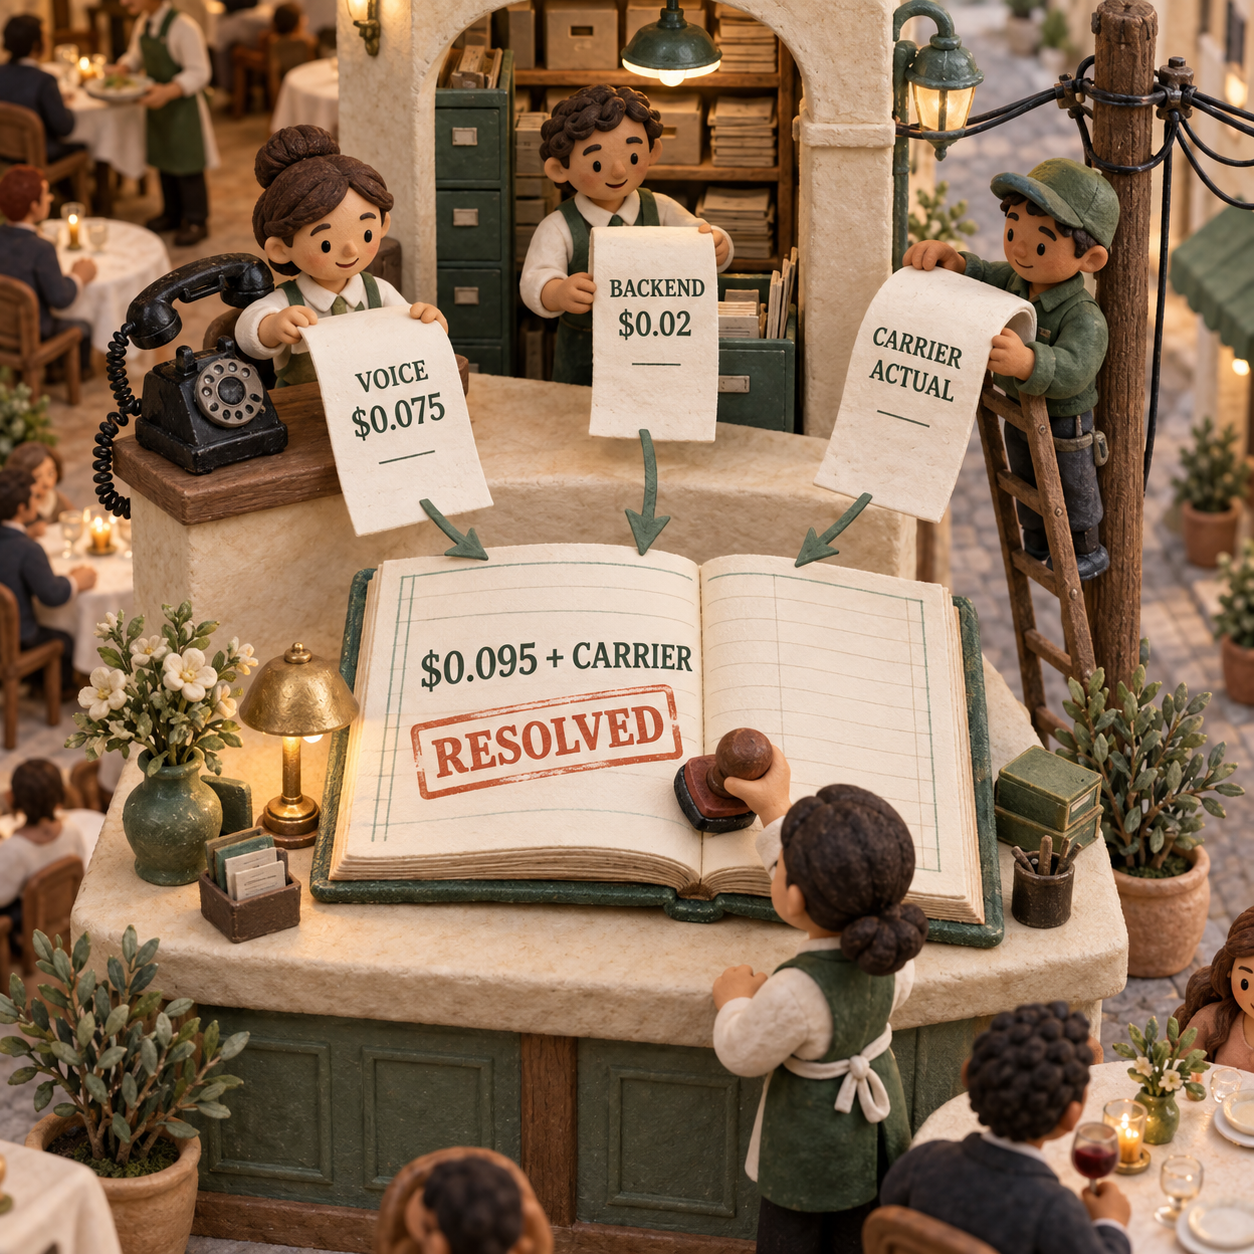
Als Beispiel dient ein 90 Sekunden langer eingehender Anruf für eine Restaurantreservierung. Das Kostenbeispiel von OpenAI liefert dafür einen klaren Ausgangspunkt:
- Sprache: 90 Sekunden geteilt durch 60, multipliziert mit $0.05, ergeben $0.075.
- Backend: Für dieses Beispiel wird angenommen, dass die gemessene Modell- und Tool-Nutzung insgesamt $0.02 kostet.
- Zwischensumme aus Sprache und Backend: $0.095.
- Telefontransport: Hinzu kommt die Carrier-Gebühr für diesen konkreten Anruf.
Der Anruf kostet also nicht $0.075, sondern in diesem Beispiel $0.095 zuzüglich Telefontransport. Wird die Reservierung bestätigt, sind das die direkten Laufzeitkosten einer erfolgreich erledigten Reservierung. Scheitert der Agent und muss ein Mensch die Arbeit wiederholen, bleibt der fehlgeschlagene Anruf im Zähler, wenn die Kosten je erfolgreichem Abschluss berechnet werden.
Deshalb ist eine symbolische Carrier-Position ehrlicher als ein frei erfundener Marktpreis in der Gesamtsumme. OpenAI legt diese Gebühr nicht fest; der Transportpreis muss aus der Rechnung des eigenen Anbieters stammen.
Hinzu kommt ein weiterer Zusammenhang: Ein schnelleres Backend kann trotz höherem Tokenpreis günstiger sein, wenn es die Live-Sitzung früher beendet. Eine Minute weniger Sitzungszeit spart $0.05 an Sprachkosten. Ein billigeres Backend kann unterm Strich teurer werden, wenn Anrufende Angaben wiederholen müssen, Tools lange brauchen oder die Reservierung scheitert.
So fügt sich das Modell in einen echten Anrufablauf ein
Ein Restaurantbetrieb kann GPT-Live-1 für eine eingehende Reservierungsnummer einsetzen und die Aufgabe bewusst eng halten. Die Sprachschicht führt das Gespräch. Ein kostengünstiges Backend prüft die Verfügbarkeit und bereitet die Buchung vor. Die Anwendung bestätigt den endgültigen Termin, schreibt die Reservierung und verhindert, dass ein verspätetes Ergebnis den falschen Zeitpunkt bucht.
Die Leitung eines Supportteams kann dasselbe Frontend mit anderen Backend-Regeln verwenden. Einfache Bestellabfragen können an ein auf geringe Kosten optimiertes Modell gehen. Bei strittigen Abbuchungen oder Ausnahmen von einer Richtlinie übernimmt ein leistungsfähigeres Modell oder ein Mensch. Der Vorteil liegt nicht darin, dass ein Sprachmodell jede Aufgabe erledigt. Vielmehr lassen sich die Reasoning-Kosten je nach Aufgabe wählen, während das Gesprächserlebnis einheitlich bleibt.
Für ein Produktteam mit einer bestehenden Kette aus Spracherkennung, Modell und Sprachsynthese stellt sich die Frage anders. GPT-Live-1 kann Code für die Übergaben überflüssig machen und überlappende Sprache leichter beherrschbar machen. Die Migration lohnt sich jedoch nur, wenn das neue System die Aufgabenerfüllung oder die Wartbarkeit so weit verbessert, dass der Umstellungsaufwand gedeckt ist. Der umfassendere Kostenvergleich für KI-Sprachagenten bleibt hilfreich, wenn zwischen Eigenentwicklung und Zukauf entschieden wird.
Ein Team mit einer Browser-App kann WebRTC nutzen und die Kostenposition des Telefonieanbieters vollständig streichen. Die Live-Dauer und die Backend-Arbeit bleiben kostenpflichtig. Reine Textagenten, Batch-Workflows und Anwendungen ohne Sprachbedarf sind von dieser Veröffentlichung nicht betroffen.
Der kleinste sinnvolle Pilot für einen KI-Telefonassistenten
Beim direkten SIP-Weg sendet der Anbieter einen eingehenden Anruf an OpenAI; der eigene Webhook erhält daraufhin eine Live-Sitzungs-ID. So sieht der dokumentierte Request zur Annahme des Anrufs aus:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
Der API-Schlüssel bleibt im vertrauenswürdigen Backend. SIP handelt das Audioformat aus, deshalb bleibt audio.format weg. Bei der Client-Delegation liegen Backend-Modell, Tools, Berechtigungen und Nutzungsdaten in der Verantwortung der eigenen Anwendung.
Für einen Piloten mit eingehenden Reservierungsanrufen ist der Ablauf kurz genug, um die Messung übersichtlich zu halten.
Ein eindeutiges Ergebnis festlegen
Als Erfolg zählt eine bestätigte Reservierung, nicht bloß ein angenehmes Gespräch. Erfasst werden die gewünschte Zeit, die tatsächlich gebuchte Zeit und die Frage, ob ein Mensch übernehmen musste.
Jeden Kostenblock erfassen
Während des Anrufs wird der jeweils neueste kumulative Stand der Sprachsekunden gespeichert. Bei einem regulären Ende ersetzt die endgültige Nutzung aus
session.closeddiesen Wert. Jede Backend-Antwort-ID wird genau einmal zusammen mit ihrer Token- und Tool-Nutzung erfasst. Diese Datensätze werden mit dem Einzelverbindungsnachweis des Carriers verknüpft.Echte Unterbrechungen testen
Getestet wird mit den Pausen, Korrekturen, Hintergrundgesprächen und kurzen Bestätigungen, die Anrufende tatsächlich verwenden. Zu prüfen sind das Transkript, die Aktion des Backends und das Audio, das bei der anrufenden Person tatsächlich ankam. Eine abgeschlossene Backend-Antwort beweist nicht, dass das Ergebnis ausgesprochen wurde.
Kosten je abgeschlossenem Vorgang vergleichen
Sprach-, Backend- und Transportkosten des Piloten werden addiert und anschließend durch die bestätigten Reservierungen geteilt. Fehlgeschlagene Anrufe, Wiederholungen und Übergaben an Menschen bleiben in den Kosten enthalten. Das Ergebnis wird anhand derselben Anrufskripte mit dem bestehenden System verglichen.
Ob Unterbrechungen besser funktionieren, müssen eigene Daten zeigen
GPT-Live-1 ist für überlappende Sprache ausgelegt, doch ein Einführungsbeispiel ist kein belastbares Service-Level-Versprechen. Andrew Hsu, Mitgründer und CTO von Speak, berichtet, dass erste Tests bei Speak die Unterbrechungen während Denkpausen gegenüber den bisherigen Systemen mit starren Sprecherwechseln um fast 80% reduzierten. Dieses Ergebnis stammt aus der Sprachlern-Anwendung von Speak.
Ein Anruf aus einem lauten Restaurant, ein Supportanruf mit vorgelesener Bestellnummer und ein Patient, der vor einem Datum innehält, sind andere Einsatzfälle. Prompting, Telefoncodec, Carrier-Jitter, Tool-Latenz und die eigene Wiedergabesteuerung beeinflussen allesamt, was die anrufende Person erlebt. Eine allgemeingültige Verbesserung bei Unterbrechungen oder Latenz lässt sich daraus nicht seriös in eine Prognose übernehmen.
Auch der Randfall im Produktivbetrieb ist wichtig. Unterbricht eine anrufende Person und ändert Freitag in Donnerstag, stoppt die gesprochene Korrektur nicht automatisch die Backend-Arbeit für Freitag. Die Anwendung muss die alte Aufgabe ändern oder abbrechen, ein verspätetes Ergebnis ignorieren und verhindern, dass ein erneuter Versuch eine zweite Buchung anlegt.
Direktes GPT-Live-SIP unterstützt derzeit eingehende Anrufe. Der Endpunkt zum Erstellen einer Live-Sitzung startet keinen ausgehenden SIP-Anruf. Für ausgehende Kampagnen ist daher weiterhin ein vom Anbieter betriebener Partnerpfad nötig. Teams mit Priorität auf ausgehenden Anrufen sollten diesen Weg prüfen, bevor sie eine Migration planen.
Was am Montag auf die Aufgabenliste gehört
Für eine eingehende Reservierungs- oder Supportwarteschlange empfiehlt sich ein eng begrenzter, instrumentierter Pilot. Sprachsekunden, Backend-Nutzung, Carrier-Gebühren, abgeschlossene Vorgänge, Übergaben und Fehler bei Unterbrechungen gehören in denselben Datensatz. Dabei sollte ein kostenbewusstes Backend gegen das leistungsfähigere Modell antreten, das voraussichtlich nötig ist.
Die Umstellung ist sinnvoll, wenn die Gesamtkosten je erfolgreich abgeschlossenem Anruf unter denen des bisherigen Systems liegen und Anrufende den Agenten korrigieren können, ohne veraltete Aktionen auszulösen. Abwarten ist besser, wenn nur die Schlagzeile mit $0.05 überzeugt oder Carrier und Weg für ausgehende Anrufe noch ungeklärt sind. Für reine Textarbeit und bereits wirtschaftliche, zuverlässige Spracherlebnisse ist die Veröffentlichung ohne Bedeutung.
Weitere verständliche Analysen zu Änderungen, die die Betriebskosten wirklich bewegen, gibt es im Newsletter.
- Zuletzt aktualisiert
- 14. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained