Cloudflare Workers RPC 链路追踪:慢请求卡在哪一跳,一眼看清
Cloudflare Workers 现已支持跨 JavaScript RPC 边界追踪请求,把调用方、下游 Worker、Durable Object、嵌套调用与回调串进同一条时间线。本文详解慢请求定位、span 读取、采样设置和按 span 计费逻辑,帮助团队在全面启用前测清事件量、保留期与配额影响。
发布于
 作者 Omid Saffari



2026 年 9 月 17 日,Cloudflare 让慢请求的责任边界更容易定位:Cloudflare Workers 链路追踪现在能沿着 JavaScript RPC 调用进入另一个 Worker 或 Durable Object,不再停在调用方。还没添加手动 span,也不用先怀疑整套系统,就能看出究竟是哪项服务、哪个方法拖慢了请求。
Cloudflare Workers 链路追踪补上的,是中间那一段
RPC 并没有听起来那么复杂。在 Cloudflare Workers 中,远程过程调用就是一个 Worker 通过 binding,调用另一个 Worker 或 Durable Object 暴露的 JavaScript 方法。代码写起来像本地方法调用,实际工作却在别处执行。
Trace 是一次请求的完整时间线,其中每个带计时的片段叫作 span。在这次更新之前,一旦调用方跨过 JavaScript RPC 边界,这条时间线就会中断。你能看到 Worker A 发起调用,却无法把它与 Worker B 或 Durable Object 中真正执行的工作清楚地连起来。
Cloudflare 9 月 17 日发布的更新 补上了这段空白。现在,同一条 trace 可以依次呈现调用方的 session、每次方法调用、被调用方的 invocation、嵌套调用,以及回调到另一个 Worker 的过程。只要启用 tracing,Cloudflare 就会自动记录这些 span。平台会直接完成这层埋点,不需要接入可观测性 SDK,也不用修改应用代码。
Session span 是调用方 RPC session 的容器;复用同一 session 的调用都会收在其中。每个 call span 会记录方法名或属性路径,被调用方则拥有自己的 invocation span。执行从一个 Worker 转移到另一个 Worker,或进入 Durable Object 时,颜色也会随之变化。
原本空白的边界,就这样变成了一张责任归属图。
顺着一次结账请求追下去
以一条发往 POST /checkout 的客户请求为例。
请求先进入 checkout Worker。它会在 inventory Worker 上调用 inventory.reserve(),再在 order Durable Object 上调用 order.commit()。客户感受到的只是一次缓慢的结账,但等待时间可能落在应用里的三处不同位置。
在这次更新之前,checkout 的 trace 可能到 RPC 调用处就戛然而止。要还原后续过程,只能分别查阅各项服务的日志、比对标识符,或自行添加 span。
现在,一条 trace 就能把整次请求串起来。展开 RPC session 后,可以找到 reserve 和 commit 的 method span,看到下游 invocation,并比较实际耗时究竟集中在哪里。Root span 还可以携带 Cloudflare Ray ID、Worker 名称、entrypoint、outcome、CPU time 和 wall time,为处理事故的人提供定位目标请求所需的线索。
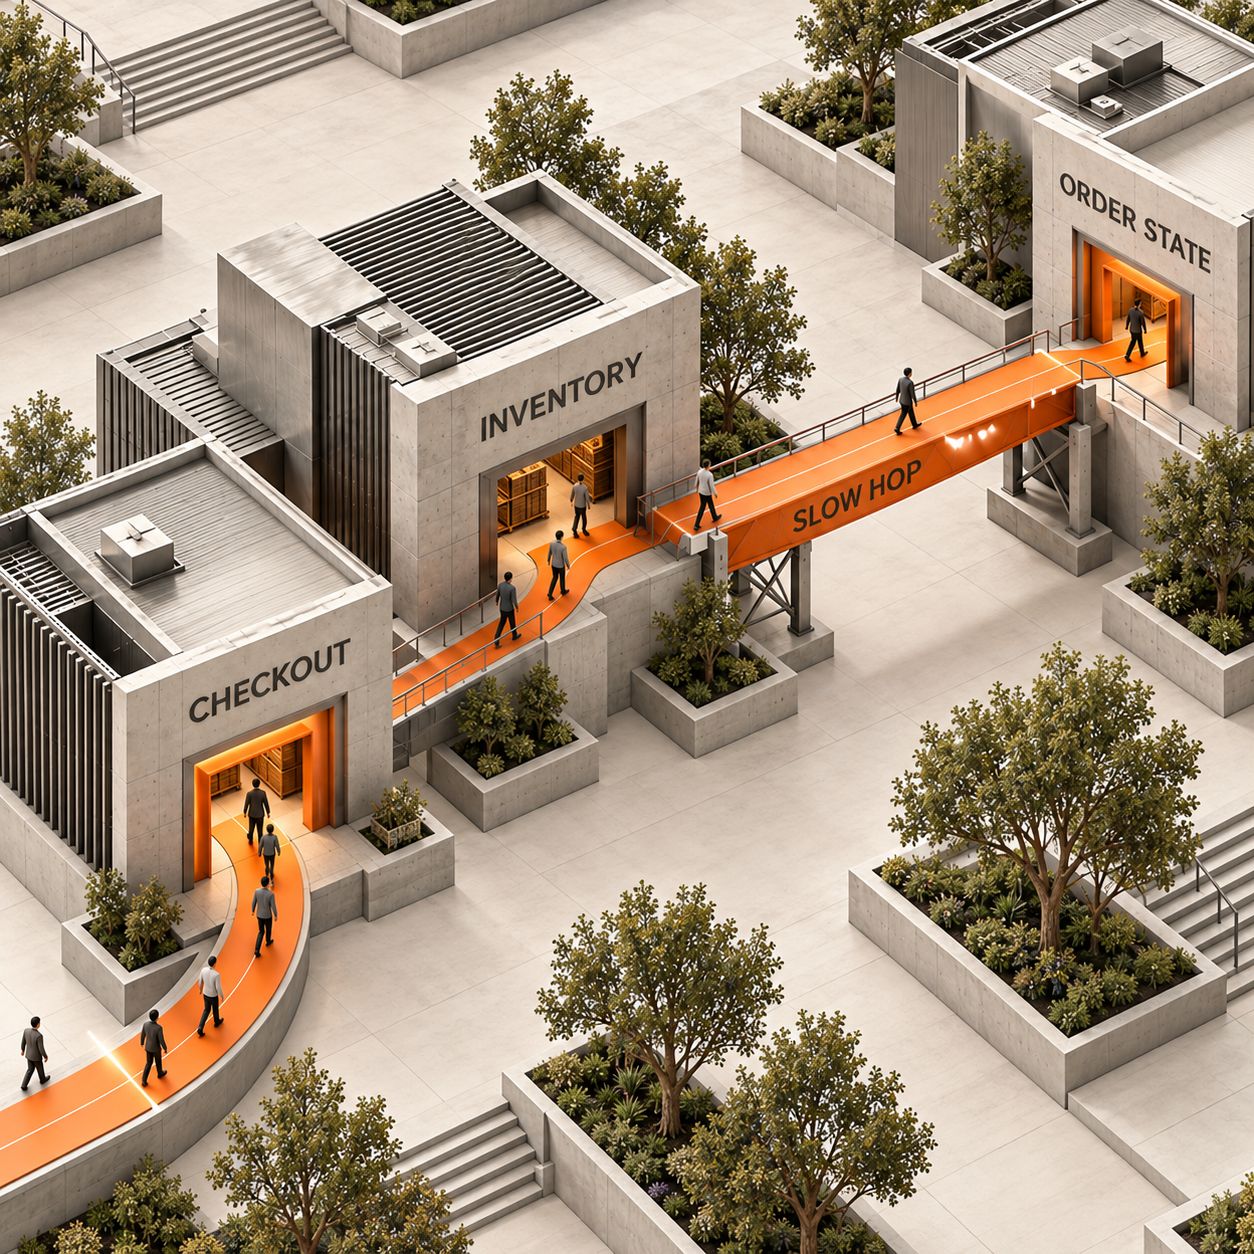
这个新视图无法直接证明某个方法为什么慢,却能告诉你下一步该查哪里。如果大部分等待时间落在 inventory invocation,就检查它的存储或上游依赖;如果 Durable Object 调用对应的 span 最宽,就检查该对象的 handler 和存储操作;如果还没开始任何 RPC,调用方就已经很慢,那么下游服务不该是最先被怀疑的对象。
哪些团队最能从中受益
后端已经拆分的独立创业者
把 checkout、inventory 和 order state 分别运行在不同 Worker 上的创业者,可以复现一次缓慢购买,并沿着整条 Cloudflare 路径查下去。最大的收益是缩小排查面:只调查真正承载延迟的 Worker 或 Durable Object,不必重新翻查每项服务。
负责有状态产品的后端负责人
一款协作应用可能会让房间操作先经过边缘 Worker,再进入该房间对应的 Durable Object。后端负责人可以区分时间究竟花在调用方还是有状态对象内部,再把 trace 交给负责该边界的团队。
维护内部 Worker 服务的平台工程师
平台团队可能通过 service binding 连接了多个 Worker,返回的 stub 和回调又让整条路径很难从日志中复原。Session span 和 method span 能显示哪些调用复用了同一 session、每个环节由哪个 Worker 执行,以及嵌套调用从哪里进入这条路径。
需要把客户反馈变成证据的支持负责人
趁事故细节还清晰,支持团队可以请工程团队复现同一条路径。得到的 trace 会明确指出服务名称和方法边界,比“结账感觉很慢”更适合交接。即便最终仍需查看日志、性能分析器或数据库查询计划,这份证据同样有用。
先用一条路径做“周一测试”
第一次上线时,最有价值的做法是先选一条请求路径,而不是一次性覆盖所有生产 Worker。
选一条客户能感知的路径
选择一条已经跨过 Worker-to-Worker 或 Worker-to-Durable Object RPC 边界、而且可以稳定复现慢速情况的请求。记下路由、预期发生的下游方法调用,以及准备复现的时间。
在 Wrangler 中启用 trace
按照 Cloudflare 文档,为处理这条路径的 Worker 在 Wrangler 配置中加入以下设置:
Jsonc{ "$schema": "./node_modules/wrangler/config-schema.json", "observability": { "traces": { "enabled": true } } }按团队平时的发布流程部署这项配置。这个开关会启用 Cloudflare 的自动 span,不要求在 Worker 内接入 SDK。
复现一次慢请求
在受控条件下只运行一次相同请求。保留路由和时间戳;如果支持或日志流程已经记录 Cloudflare Ray ID,也一并保留。受控环境更清晰,因为如果没有另行设置,默认 trace 采样率是
1,也就是追踪 100% 的传入请求。从外向内阅读 trace
在 Cloudflare 中进入 Workers & Pages,选择对应 Worker,再打开 Observability。找到刚刚复现的请求并展开 trace。先看根请求,随后依次查看 RPC session、调用方的 method span、被调用方的 invocation,以及嵌套的 Durable Object 调用。结合 span 宽度与 wall-time 字段,找到最值得继续调查的边界。
扩大上线前先算清账单
记录这次复现生成了多少个 span,再用
sampled requests × average spans per sampled trace估算每月的 trace 事件数量。别忘了加上同样占用可观测性配额的现有日志事件。实测得到的 span 数量,才是决定生产采样率的依据。
成本按 span 计算,不按请求计算
Workers tracing 在最初的 beta 阶段免费。这一安排会在 2026 年 10 月 1 日改变:从当天起,每个 span 都按一个 observability event 计数,并与 Workers Logs 共用配额和定价。
Enterprise 团队需要查看各自的合同。其他团队则要特别留意计费单位:一次客户请求可能生成 root span、RPC session span、method-call span、被调用方 invocation 和嵌套 binding span。只看请求数量,算不出 trace 账单。
Cloudflare 的 tracing 文档 说明,head_sampling_rate 的默认值是 1,即 100%。文档中的高流量示例使用 0.05,也就是每百个传入请求追踪 5 个。这只是一个控制手段,并非适用于所有场景的标准答案。
Head sampling 的取舍很直接:采样率越低,事件量越少,但是否采样会在请求一开始就决定,罕见的慢请求可能恰好没被选中。受控复现或隔离程度合适的环境可以使用全量采样;生产环境的采样率,则应根据实际流量和实测的每条 trace span 数量来定。
保留期也会改变事故处理流程。Free 套餐的 trace 保留 3 天,Paid 套餐保留 7 天。如果客户反馈晚于这个窗口才到达,需要的 trace 可能已经消失。操作原则很简单:趁证据还在时复现并检查;否则,就把 trace 导出到满足团队保留期要求的系统中。
这项能力有哪些明确限制
Workers tracing 仍处于公开测试阶段。Span 和属性的名称可能改变,Cloudflare 也表示部分属性仍不完整。
有些非 I/O span 即使实际执行时间更长,也可能显示 0 ms。Workers Runtime 要等到发生 I/O 事件才会更新时间,因此显示为零并不能证明某段 JavaScript 没有耗时。
离开 Cloudflare 后,trace 也无法继续自动贯通。导出 Workers trace 时,Cloudflare 目前还不会把 trace ID 传递给外部服务。因此,调用支付服务商或托管在其他地方的数据库时,外部供应商一侧的 trace 不会自动接到 Workers 时间线上。
最后,这次更新的适用范围很窄。对于没有 JavaScript RPC 边界的单个 Worker,它不会带来新的跨服务视图。常规 Workers tracing 对 fetch、binding 和 handler 仍可能有帮助,但 9 月 17 日的更新,主要惠及已经拆分到多个 Worker 或 Durable Object 的应用。
现在该怎么做
如果客户请求会跨过 service binding 或 Durable Object,而团队目前需要拼接多份日志才能找到缓慢的那一跳,就该在本周行动。先从最消耗支持或事故处理成本的路径开始。
如果应用仍只有一个 Worker,或怀疑延迟完全发生在外部服务商内部,可以暂缓。这次更新不会在 Cloudflare 之外创建贯通的 trace。
如果 tracing 已经启用,先查看新增的 RPC span,再决定是否添加自定义埋点。只有当自动 trace 显示你负责的方法内部仍存在明显空白时,才需要自定义 span。
周一要做的事情并不复杂:为一条真实请求路径启用 observability.traces.enabled,复现慢请求,检查 RPC session 与 method span,然后在扩大上线范围前,记下采样率、每条 trace 的平均 span 数量、保留期和预期配额用量。
如果希望平台变化影响工作方式或账单时,只收到一条清晰的操作提示,欢迎订阅邮件通讯。
- 发布日期
- 语言
AI智能体成本怎么算?三种方案的月度账单拆解
AI智能体成本不能只看订阅价或 token 单价。本文以每月回复 1,000 封客服邮件为例,拆解成品助手、无代码工作流平台和自建 API 三种方案的账单,说明额度、年付首笔支出、重试、工具调用与人工审核怎样影响预算,帮你算清每条审核通过回复的真实成本,并判断哪种方案适合团队持续运营。2026年10月7日Explained
Grok 语音转文字升级 2.0:价格不变,默认模型已切换
Grok Voice Transcribe 2.0 的批处理仍为每音频小时 $0.10,流式处理仍为 $0.20,但省略 model 参数时默认模型已经切换。本文拆解价格、适用场景和迁移风险,并给出用真实音频对比 1.0 与 2.0、核对人工校正时间和下游结果,再显式锁定生产模型的操作清单。2026年9月20日Explained
Cloudflare Browser Run 加强浏览器自动化调试:失败任务先查再重跑
Cloudflare 为已完成的 Browser Run 录制加入 Inspect 面板,可集中查看控制台日志、网络请求、HAR 和最终 DOM。本文讲清如何启用 Session Recording、按 target 获取网络轨迹,并判断哪些失败应先查现有证据,哪些仍需截图与应用日志,减少浏览器重跑和人工复现时间。2026年9月19日Explained
v0 接入 npm 私有包:让原型直接复用团队组件库
v0 现已支持通过共享环境变量安装 npm 私有包,让原型直接复用团队现有组件库。本文拆解 NPM_TOKEN 与 NPM_RC 的适用场景、最小权限配置、真实仓库交接检查,以及上线前仍需补齐的文档、安全与工程验证,帮助团队判断这项能力能否减少组件替换返工,并厘清凭证如何留在模型与沙箱文件系统之外。2026年9月19日Explained
Claude Code 自动模式不再单收分类器费用,但有前提
Claude Code 2.1.278 可在符合条件的 API 与 Enterprise 会话中取消自动模式分类器的单独费用,但网关、区域或凭证仍可能触发计费回退。本文说明如何通过 /status 确认服务端路径、排查 safeguards 等透传字段,并在调整智能体预算前验证真实生产链路。2026年9月19日Explained
Vercel 构建费用新机制:Turbo 可按单次部署启用
Vercel 现在允许 Pro 和 Enterprise 项目仅为一次部署启用 Turbo,无需修改项目默认构建机器。本文拆解 GitHub、CLI 与 API 三种用法,并用同一组计费数据说明何时值得为紧急发布支付更高的 Vercel 构建费用,以及如何验证下一次部署已恢复原配置。2026年9月18日Explained
ChatGPT for Word 上线:写文档不再来回复制
ChatGPT for Word 将起草、摘要、选中文本修改和基础排版直接带进 Word 侧边栏。本文详解插件的安装条件、Microsoft 与 ChatGPT 双重管理权限、共享用量和 token 费率、数据边界,以及一套可执行的文档编辑流程,帮助团队判断是否值得启用,并用真实文档衡量省下的搬运时间与新增的审核成本。2026年9月18日Explained