Cloudflare R2: cómo indexar archivos sin extensión con AI Search
Cloudflare R2 ya permite que AI Search indexe archivos sin extensión mediante un Content-Type válido. Descubre qué cambia y qué trabajo sigue pendiente.

Cloudflare AI Search eliminó un obstáculo relacionado con los nombres de archivo al ingerir contenido desde Cloudflare R2 el 11 de septiembre de 2026. Si los documentos están guardados bajo claves estables sin extensión, ahora es posible conservar esas claves y hacer que los objetos se puedan buscar con solo almacenar en cada uno un Content-Type HTTP compatible.
Esto permite retirar una etapa de cambio de nombre del flujo de ingesta. Lo que no elimina es la limpieza de metadatos, la indexación ni la comprobación que confirma que el documento realmente llegó al buscador.
Qué cambió en realidad
Cloudflare AI Search es un servicio gestionado para buscar dentro de contenido propio. Una de sus fuentes puede ser un bucket de R2, el almacenamiento de objetos de Cloudflare. AI Search lee el bucket, convierte los documentos compatibles en texto consultable y crea el índice que utiliza cuando una aplicación envía una búsqueda.
Antes de esta actualización, la vía segura para detectar el tipo de archivo dependía de su extensión. Una clave como manual.pdf indica al indexador qué clase de archivo está procesando. Una clave estable como documents/manual-alpha no lo hace.
Ahora AI Search también puede recurrir al Content-Type HTTP habitual de un objeto sin extensión. application/pdf señala que los bytes corresponden a un PDF. text/markdown identifica contenido Markdown. Cloudflare también incluye text/plain, application/json, text/html y text/csv entre los tipos compatibles.
Las extensiones no han desaparecido. Cloudflare sigue considerando que una extensión reconocida es la vía de detección preferida y más rápida. La alternativa nueva resulta útil cuando modificar la clave rompería URL, referencias en bases de datos, asociaciones entre tenants, firmas o un contrato de carga que ya está en producción.
Conviene distinguir dos conceptos. Content-Type es un metadato HTTP del objeto de R2. No es el metadato personalizado que AI Search emplea para aplicar filtros como categoría, cliente o estado del documento. Esos campos personalizados viajan en encabezados x-amz-meta-* y requieren un esquema en AI Search. Añadir x-amz-meta-content-type no sustituye al campo HTTP verdadero.
La actualización modifica la ingesta desde la fuente, es decir, el punto en el que un documento entra al índice. No cambia el modelo que redacta una respuesta después de recuperar el contenido. La actualización de GLM-5.3 Flash interviene en esa etapa posterior de generación.
Cloudflare R2 simplifica el sistema de nombres
Las claves opacas son habituales por buenas razones. Un producto puede usar como clave de R2 un ID estable de la base de datos, de modo que el objeto cambie sin que cambie su dirección. Un servicio documental puede evitar exponer el nombre original del archivo de un cliente. Una URL firmada puede depender de la clave exacta.
La solución anterior consistía en crear para la copia destinada al buscador un nombre con extensión, o bien incorporar una etapa de cambio de nombre antes de que AI Search viera el objeto. Eso genera otra identidad que almacenar, conciliar y limpiar.
La actualización permite mantener intacta la clave original cuando sus metadatos HTTP ya son correctos. Esa es la simplificación útil del flujo de trabajo.
Esta es la estimación del trabajo de ingesta antes y después. Se trata de un modelo de proceso, no de un benchmark medido ni de un ahorro prometido.
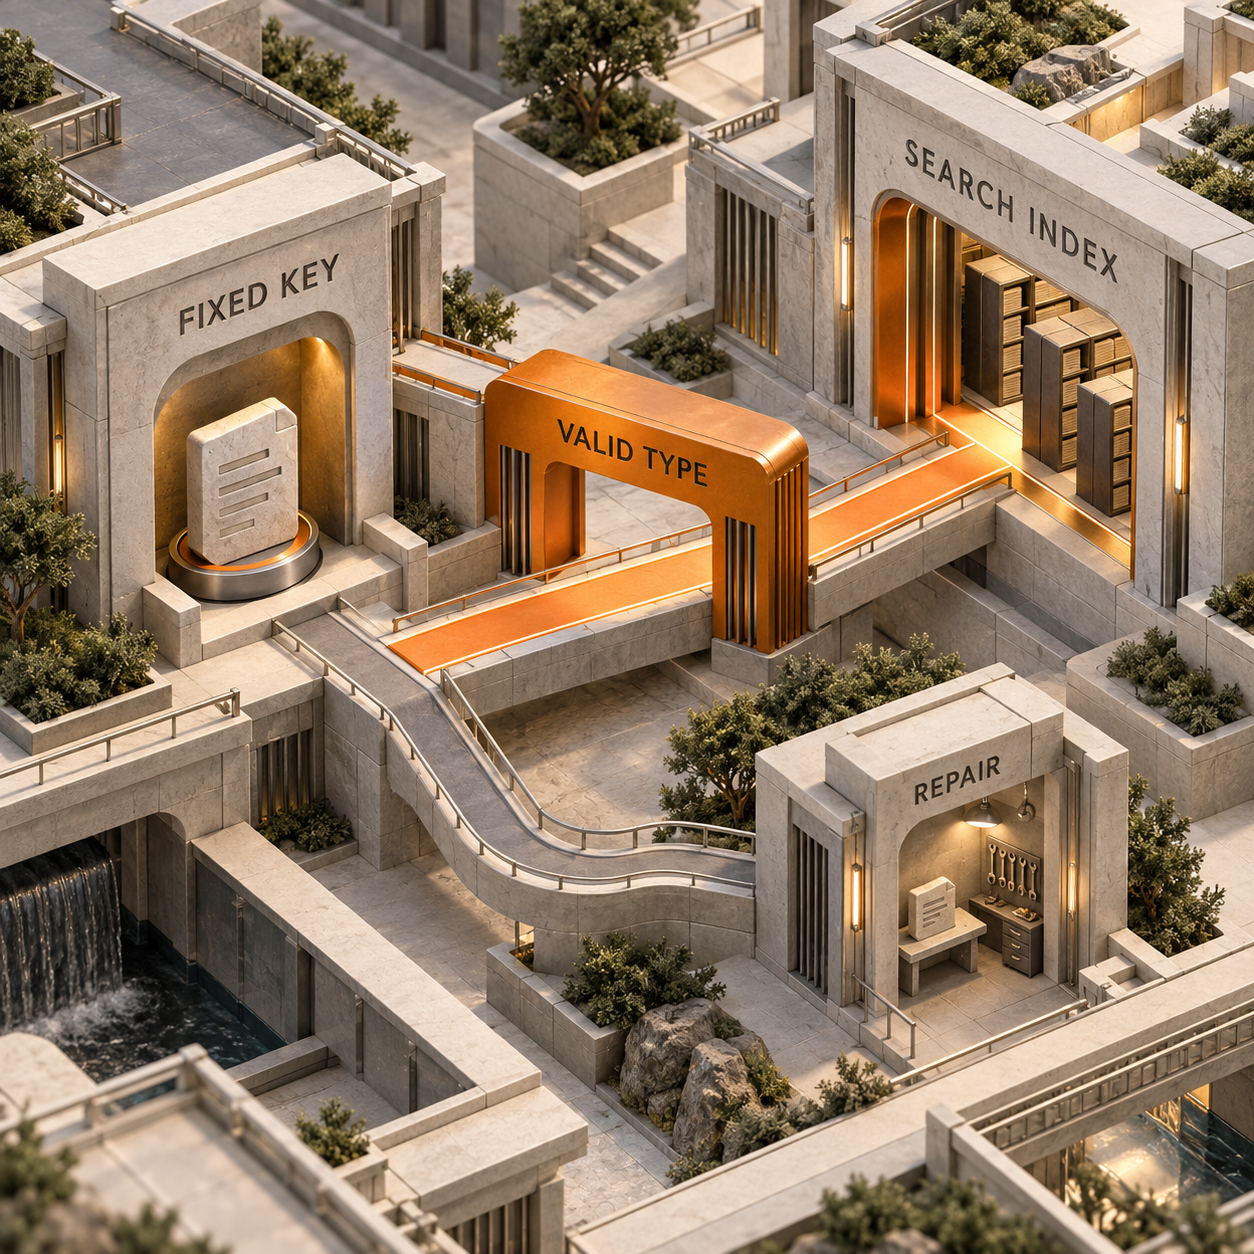
La tabla evita deliberadamente atribuir un ahorro económico. Cloudflare no publicó cuánto tiempo permite ahorrar esta función, y la versión tampoco corrige por sí sola los metadatos existentes.
Cuánto cuesta el trabajo que todavía queda
AI Search es gratuito durante su beta abierta dentro de los límites del plan de Workers. El almacenamiento y la indexación vectorial están incluidos. El uso de Workers AI y AI Gateway puede facturarse por separado, pero este cambio en la ingesta no modifica esas tarifas.
Reparar metadatos sí puede repercutir en la factura de R2. ListObjects, PutObject y CopyObject cuentan como operaciones de clase A. HeadObject y GetObject, que una herramienta de reparación puede utilizar para inspeccionar o leer un objeto, cuentan como operaciones de clase B.
En el almacenamiento Standard, las solicitudes de clase A cuestan $4.50 por millón después de la franquicia mensual gratuita de 1 millón. Infrequent Access no ofrece un nivel gratuito y cobra $9.00 por millón de solicitudes de clase A. También puede cobrar $0.01 por GB cuando se leen o copian objetos.
De ahí surge una regla presupuestaria sencilla. Un objeto cuyo Content-Type sea correcto no necesita ninguna reparación específica para cambiarle el nombre. Si el valor es incorrecto, puede seguir siendo necesaria una escritura o una copia, según la herramienta elegida. Hay que contabilizar esas operaciones antes de programar una limpieza de todo el bucket.
La escala también importa en AI Search. El límite por instancia es de 100,000 archivos con Workers Free. Workers Paid admite 1 millón de archivos, o 500,000 cuando está activada la búsqueda híbrida. El límite de 4 MB por archivo es el mismo en ambos planes.
Quién puede aprovecharlo desde mañana
Una persona que dirige un SaaS y usa ID de carga estables
Se puede conservar la clave de R2 que ya guarda la base de datos y hacer que el sistema de carga adjunte el tipo MIME real al escribir el objeto. Así, el buscador de soporte puede ingerir ese mismo objeto sin una segunda columna para el nombre del archivo ni un proceso por lotes que genere copias para búsqueda.
El beneficio es tener menos identidades que conciliar cuando un cliente sustituye, elimina o mueve un documento. El sistema de carga aún debe rechazar un tipo binario genérico si se espera que el objeto llegue a ser consultable.
Un equipo de plataforma con un bucket heredado
El primer paso es listar los objetos sin extensión junto con sus metadatos HTTP, comparar cada valor con los tipos MIME compatibles de Cloudflare y aislar los fallos. Conviene reparar una muestra pequeña antes de modificar todo el bucket.
Así la migración queda acotada. El presupuesto de reparación se destina únicamente a los objetos que lo necesitan, mientras que las claves con metadatos válidos pasan directamente a la sincronización y la verificación.
Un equipo de producto multi-tenant
Es posible conservar claves de objeto opacas que no revelen los nombres originales y definir Content-Type mediante una comprobación confiable del lado del servidor durante la carga. Cuando cada tenant necesite su propio límite de indexación, los filtros por ruta o los prefijos de AI Search se aplican por separado.
El resultado es una arquitectura coherente. La identidad del objeto almacenado permanece separada de su presentación como archivo, mientras el indexador recibe un tipo que puede validar.
Una agencia que gestiona bases de conocimiento de clientes
El procedimiento operativo debe separar las dos funciones de los metadatos. El Content-Type HTTP determina si se puede ingerir un archivo sin extensión. Los campos personalizados x-amz-meta-* determinan cómo filtrar los resultados indexados una vez definido su esquema.
Esto facilita el diagnóstico. Cuando falta un documento, el equipo revisa primero los metadatos de ingesta antes de cambiar las reglas de filtrado o el modelo de respuesta.
Cómo indexar en Cloudflare R2 un objeto sin extensión
La API de R2 para Workers de Cloudflare acepta los encabezados de la solicitud mediante httpMetadata. El siguiente Worker mantiene la ruta de la solicitud como clave del objeto y rechaza las cargas que llegan sin Content-Type.
Vincule un bucket de R2 como DOCS en wrangler.jsonc:
{
  "$schema": "./node_modules/wrangler/config-schema.json",
  "name": "r2-document-upload",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-11",
  "r2_buckets": [
    {
      "binding": "DOCS",
      "bucket_name": "your-bucket"
    }
  ]
}
A continuación, utilice este Worker:
interface Env {
  DOCS: R2Bucket;
}

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "PUT") {
      return new Response("Method Not Allowed", { status: 405 });
    }

    const key = new URL(request.url).pathname.replace(/^\//, "");
    const contentType = request.headers.get("content-type");

    if (!key || !contentType) {
      return new Response("Key and Content-Type are required");
    }

    await env.DOCS.put(key, request.body, {
      httpMetadata: request.headers,
    });

    return new Response(`Stored ${key}`);
  },
} satisfies ExportedHandler<Env>;
Ejecute npx wrangler dev, asigne a WORKER_URL la dirección local que muestra Wrangler y cargue un PDF local en un destino sin extensión:
curl "$WORKER_URL/documents/manual-alpha" \
  --request PUT \
  --header "Content-Type: application/pdf" \
  --data-binary @manual.pdf
Este ejemplo demuestra que la parte de almacenamiento funciona; no demuestra que el contenido se haya indexado. En producción, se debe añadir autorización, obtener el tipo mediante una inspección confiable en lugar de depender únicamente del nombre enviado por el usuario y compararlo con la lista de formatos compatibles de Cloudflare.
La realidad: una carga correcta no garantiza que el archivo se pueda buscar
Las escrituras en R2 ofrecen consistencia fuerte, por lo que tanto el objeto como sus metadatos quedan visibles después de una escritura correcta. La indexación de AI Search es un proceso asíncrono independiente. Una solicitud de sincronización puede aceptarse y, aun así, el elemento puede fallar más tarde.
Las instancias conectadas a R2 se sincronizan cada 6 horas de forma predeterminada. Se puede elegir un intervalo de 1, 2, 4, 6, 12 o 24 horas, o iniciar un trabajo manualmente:
npx wrangler ai-search jobs create <INSTANCE_NAME>Las sincronizaciones manuales de una fuente pueden ejecutarse, como máximo, una vez cada 30 segundos. Repetir el intento no corrige unos metadatos defectuosos.
Después del trabajo, hay que revisar los registros de los elementos, sus detalles o las estadísticas de la instancia. unsupported_type es el error de elemento pertinente cuando AI Search no puede aceptar el tipo de archivo detectado. Corrija el objeto y vuelva a sincronizar ese elemento o la fuente.
El cambio no afecta a quienes ya utilizan una extensión reconocida en todas las claves de R2. Tampoco afecta a las fuentes de AI Search basadas en un sitio web o en el almacenamiento integrado, en lugar de un bucket externo de R2. Un formato no compatible o un archivo demasiado grande no pasan a ser indexables gracias a esta novedad.
Qué hacer el lunes
Hay que empezar por una auditoría, no por una reescritura masiva.
Localizar los objetos sin extensión que se omitieron
Liste los objetos de R2 incluyendo
httpMetadata, avance por todas las páginas hasta quetruncatedsea false y aísle las claves cuyo último segmento no tenga extensión. Compare esas claves con los registros de elementos de AI Search y los fallosunsupported_type.Clasificar los metadatos
Separe los tipos MIME compatibles de los valores ausentes, mal formados, incompatibles o definidos como
application/octet-stream. No incluya los campos personalizadosx-amz-meta-*en esta comprobación, porque resuelven un problema distinto.Reparar una importación pequeña
Elija una muestra pequeña y representativa de los formatos que realmente almacena. Escriba o copie cada objeto con el
Content-TypeHTTP correcto y conserve la clave original cuando la herramienta lo permita.Sincronizar y comprobar la recuperación
Inicie una única sincronización de la fuente. Espere a que terminen los elementos, revise sus registros y después busque una frase conocida dentro de cada documento. Una escritura correcta en el almacenamiento no es la meta; sí lo es obtener un pasaje de la fuente como resultado.
Ampliar el lote solo después de comprobarlo
Calcule las operaciones de clase A y clase B que generará el método de reparación, confirme la clase de almacenamiento de R2 y solo entonces amplíe el lote. Actualice al mismo tiempo el sistema de carga para que los nuevos objetos sin extensión lleguen con metadatos compatibles.
Conviene actuar esta semana si las claves estables u opacas de R2 han obligado a mantener una segunda vía de nombres para AI Search. Es mejor esperar si los objetos actuales no tienen información de tipo confiable, porque antes de reescribirlos hace falta un plan de clasificación. No es necesario hacer nada si las extensiones reconocidas ya cubren correctamente toda la ingesta.
Si quiere convertir el próximo cambio de plataforma en una decisión operativa, suscríbase al boletín.
- Última actualización
- 12 sept 2026
- Categoría
- Explained
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Audio a texto con Grok Voice Transcribe 2.0: mismo precio y nuevo modelo predeterminado
Grok Voice Transcribe 2.0 mantiene el precio por hora, pero cambia el modelo predeterminado. Qué revisar antes de migrar flujos de audio a texto.20 sept 2026Explained
Cloudflare Browser Run: cómo depurar un trabajo fallido antes de repetirlo
Cloudflare Browser Run reúne logs, solicitudes de red y el DOM final para diagnosticar un trabajo fallido antes de volver a ejecutarlo, sin adivinar.19 sept 2026Explained
Cómo usar componentes privados de tu sistema de diseño en v0
v0 ya instala paquetes npm privados. Aprende a conectar los componentes de tu sistema de diseño, proteger credenciales y medir el trabajo antes de publicar.19 sept 2026Explained
Claude Code precio: Auto Mode elimina cargos del clasificador
Claude Code 2.1.278 elimina el cargo separado del clasificador en sesiones elegibles. Aprende a verificar la ruta del servidor antes de ajustar el presupuesto.19 sept 2026Explained
Vercel CLI: activa Turbo en un solo despliegue
Activa Vercel Turbo en un despliegue urgente sin cambiar la configuración del proyecto. Compara el costo adicional de compilación con el tiempo ahorrado.18 sept 2026Explained
ChatGPT para Word elimina el copiar y pegar entre aplicaciones
ChatGPT para Word permite redactar y revisar sin cambiar de aplicación. Revisa el acceso al complemento, los límites de uso y un flujo práctico.18 sept 2026Explained
Google Antigravity: cómo migrar trabajos locales antes del 5 de octubre
Google Antigravity cierra el agente de mayo el 5 de octubre. Descubre qué trabajos solo cambian de ID y cuáles requieren adaptar sus herramientas locales.18 sept 2026Explained