Claude Code MCP Timeout richtig einstellen
Claude Code MCP Timeout gezielt setzen: Startwartezeit, Verbindungs- und Tool-Timeouts sauber trennen und benötigte Server vor Jobs sicher prüfen.


Der Claude Code MCP Timeout für die Wartezeit vor dem ersten nicht interaktiven Durchlauf lässt sich mit CLAUDE_CODE_MCP_STARTUP_WAIT_MS auf eine Höchstdauer in Millisekunden begrenzen. Mit 0 entfällt diese Wartezeit. Geplante Jobs erhalten so ein klares Zeitbudget für ihre Startbereitschaft. Damit werden jedoch weder der Timeout für die MCP-Verbindung noch der Timeout eines MCP-Tools oder die Frist für den gesamten Job festgelegt.
Claude Code MCP Timeout: die Kurzantwort
Mit CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check" wartet der erste Durchlauf bis zu fünf Sekunden auf den Start der MCP-Server. Kann der Job beginnen, ohne dass ein MCP-Server bereit ist, wird CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0 gesetzt.
Claude Code 2.1.274 führte diese Variable am 17. September 2026 ein. Die Versionshinweise legen zwei Punkte genau fest: Der Wert begrenzt die Wartezeit des ersten nicht interaktiven Durchlaufs in Millisekunden, und 0 bedeutet, dass gar nicht gewartet wird. Einen Standardwert für die neue Variable nennen sie nicht. Bei unbeaufsichtigten Jobs sollte der Wert deshalb ausdrücklich gesetzt werden, damit weder eine künftige Standardeinstellung noch eine systemweite Umgebungsvariable unbemerkt die Startrichtlinie verändert.
Nicht interaktiv ist ein Lauf, der mit -p oder --print gestartet wird, etwa eine CI-Prüfung, ein Cronjob oder eine per SDK angestoßene Aufgabe. Für interaktive Terminalsitzungen ist dieser Schalter nicht gedacht.
In der Praxis gilt folgende einfache Regel:
Diese Bereiche sind Betriebsempfehlungen und keine Standardwerte von Anthropic. Vor einer einheitlichen Festlegung sollten die eigenen Server gemessen werden.
Was die Startwartezeit tatsächlich steuert
Der erste Durchlauf lässt sich mit einer Zugabfahrt vergleichen, jeder MCP-Server mit einem Anschlussbahnsteig. CLAUDE_CODE_MCP_STARTUP_WAIT_MS bestimmt, wie lange der Zug am Bahnhof auf Umsteigende wartet. Die Variable legt weder fest, wie lange einzelne Reisende den Bahnhof zu erreichen versuchen dürfen, noch wie lange die Arbeit nach dem Einsteigen dauern darf oder wann die gesamte Reise enden muss.
Genau dieser enge Geltungsbereich ist beabsichtigt. Vor 2.1.274 griffen Betreiber häufig zu MCP_TIMEOUT, obwohl diese Variable eine andere Uhr steuert. Nun kann ein geplanter Job für den ersten Durchlauf ein kurzes Bereitschaftsfenster wählen, ohne fälschlich anzunehmen, jede Serververbindung und jeder spätere Tool-Aufruf bräuchten dieselbe Frist.
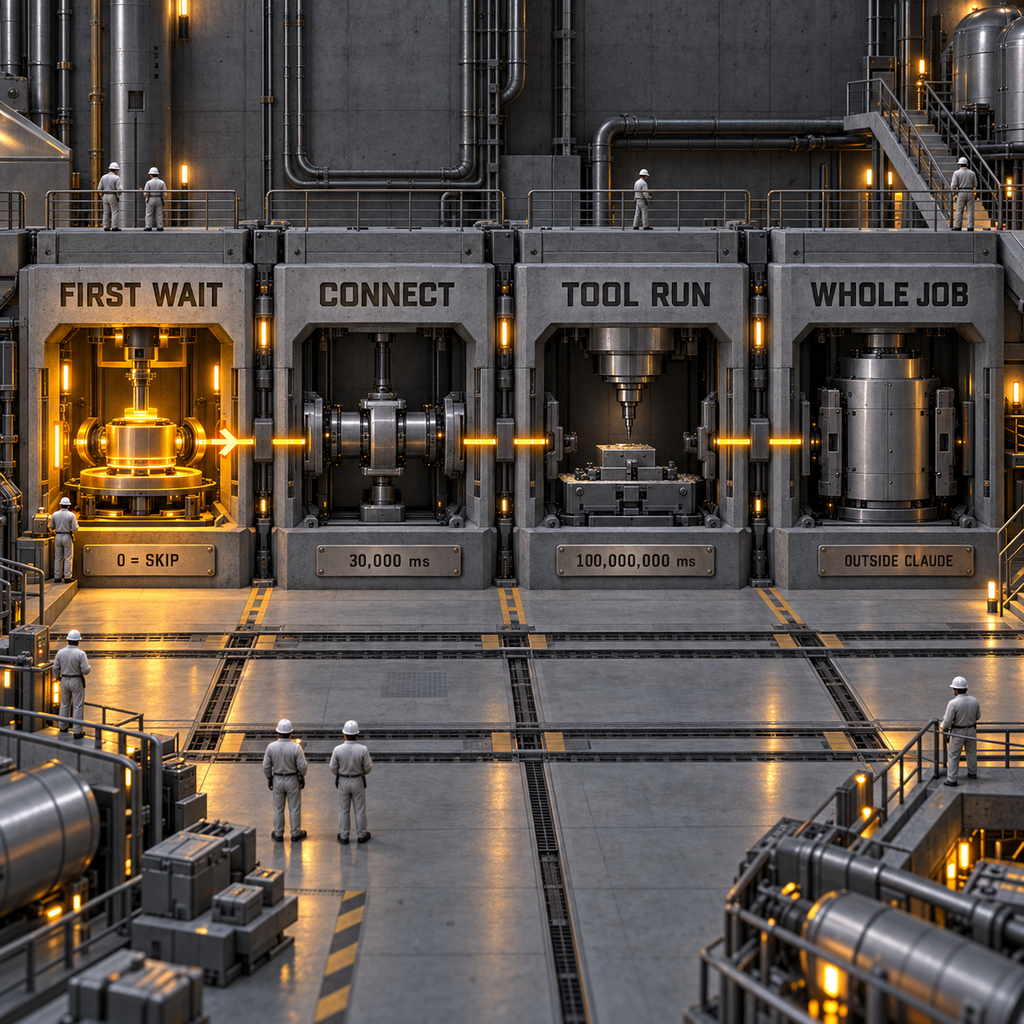
Vier Uhren, vier unterschiedliche Fehlerentscheidungen
Eine robuste Konfiguration benennt jede Uhr und weist ihr genau eine Aufgabe zu.
Daneben gibt es MCP_CONNECT_TIMEOUT_MS mit einem Standardwert von 5,000 ms für gebündelte blockierende Verbindungen beim Start. Die Variable gilt für blockierendes Startverhalten, etwa bei MCP_CONNECTION_NONBLOCKING=0 oder einem Server mit alwaysLoad: true. Anthropics Referenz der Umgebungsvariablen grenzt sie ausdrücklich von MCP_TIMEOUT ab.
Bei Tool-Aufrufen überschreibt ein timeout-Feld für einen einzelnen Server in .mcp.json den Wert von MCP_TOOL_TIMEOUT für diesen Server. Das ist sinnvoll, wenn eine Abfrage im Data Warehouse nachvollziehbar länger dauert als der Abruf eines Tickets. Die neue Wartezeit des ersten Durchlaufs ändert sich dadurch weiterhin nicht.
Diese Abgrenzung erklärt zugleich, warum 0 kein universeller Geschwindigkeitsschalter ist. Ist die Tool-Suche aktiviert und benötigt der Prompt später einen Server, der noch die Verbindung aufbaut, wartet Claude Code innerhalb von ToolSearch. Ohne Tool-Suche kommt WaitForMcpServers zum Einsatz. Wer die Wartezeit am Eingang überspringt, verlagert sie womöglich nur an eine spätere Stelle im Job.
Ein ausführbarer Test mit langsamem Server
Die Grenze lässt sich mit einem lokalen stdio-Server nachvollziehen, der ausschließlich seine MCP-Initialisierungsantwort verzögert. Der folgende Inhalt wird als slow-mcp.mjs gespeichert:
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
Über slow-mcp.json wird Claude Code mit dem Server verbunden:
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
Gestartet wird der Test mit CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose.
Das Flag --strict-mcp-config schließt nicht zugehörige Server aus Benutzer- und Projektkonfigurationen vom Test aus. Das Stream-Format zeigt das frühe Ereignis system/init einschließlich Name und Status jedes MCP-Servers. Bei einer ungültigen übergebenen Konfiguration enthält es außerdem mcp_server_errors.
Das Ergebnis der lokalen Prüfung
Für eine Startprüfung vor der Authentifizierung mit Claude Code 2.1.274 kam dieser 5,000 ms langsame Server zum Einsatz. Da die Umgebung nicht angemeldet war, endete der Lauf bei der Authentifizierung. Die Messung erfasst ausschließlich den Start und damit genau die untersuchte Grenze.
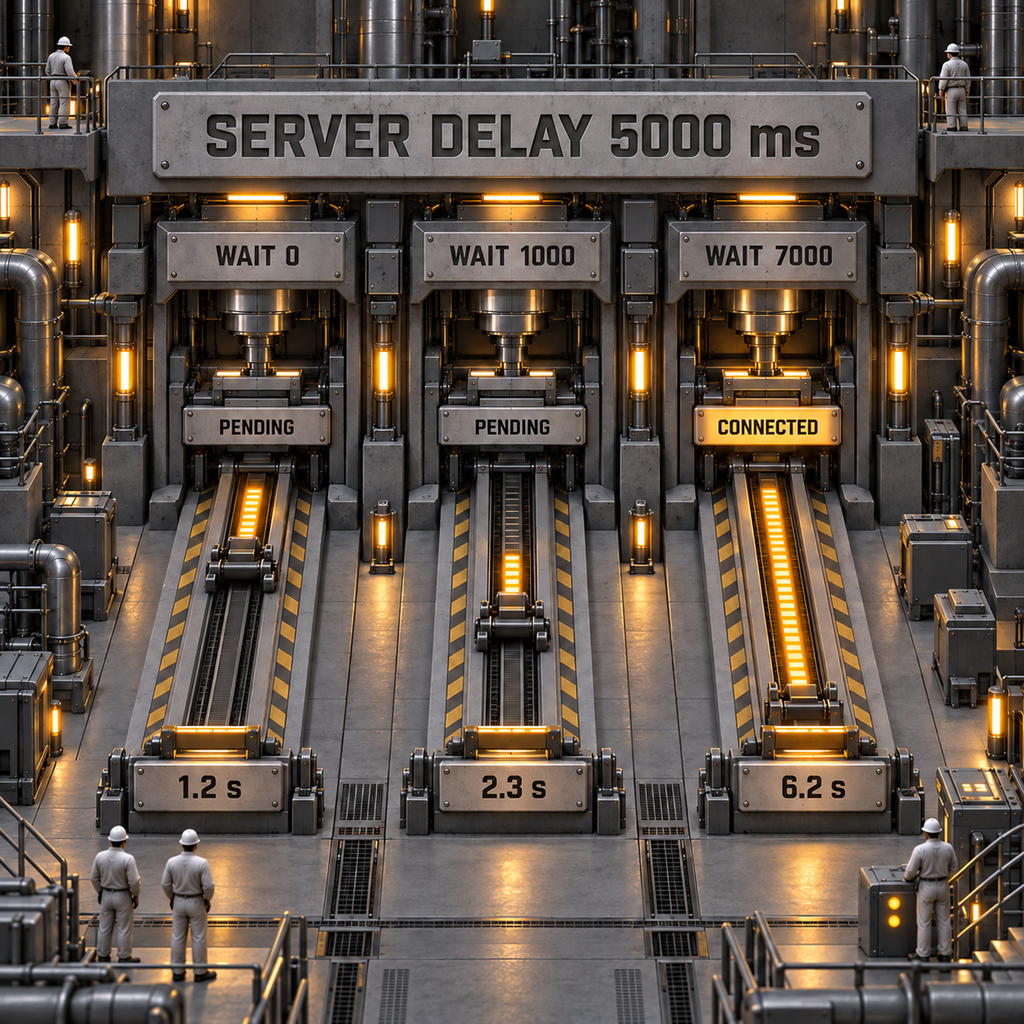
Die gemessenen Zeiten enthalten den Startaufwand von Claude Code und npx und eignen sich deshalb nicht als Zielwerte für einen Service. Entscheidend ist das eindeutige Ergebnis: Mit 0 und 1,000 ms gab die Prüfung des ersten Durchlaufs den Weg frei, während der Server noch ausstehend war; bei 7,000 ms meldete derselbe Server den Status verbunden. Weder die Modelllatenz noch die Gesamtdauer des Jobs wurden hier gemessen.
Bereitschaft vor der eigentlichen Arbeit ausdrücklich prüfen
Ein Timeout beantwortet lediglich die Frage: „Wie lange wird gewartet?“ Ein produktiver Job muss zusätzlich klären: „Welche Tools sind erforderlich?“
Dafür eignet sich eine zweiteilige Prüfung:
- Vor dem Start der eigentlichen Aufgabe wird für jeden erforderlichen entfernten Endpunkt oder lokalen Serverbefehl eine Zustandsprüfung ausgeführt. Bei konfigurierten und freigegebenen Servern meldet
claude mcp listZustände wie verbunden, Authentifizierung erforderlich oder Verbindung fehlgeschlagen. - Im Claude-Code-Stream wird
system/init.mcp_serversgeprüft. Der benannte Server muss denstatus: "connected"haben; zudem darfmcp_server_errorsfür diesen Server keinen Eintrag enthalten. Zwischengespeicherte oder optionale Server werden anhand einer ausdrücklichen Positivliste behandelt.
Ist ein erforderlicher Server noch ausstehend, muss der Lauf beendet werden, bevor ein Arbeitsergebnis akzeptiert wird. Bei einem optionalen Server kann der eingeschränkte Betrieb protokolliert und der Job fortgesetzt werden. Damit ist die Wartezeit eine Eingabe für die Richtlinie, aber nicht die Richtlinie selbst.
Besondere Vorsicht verlangt der Discovery-Cache. Ein entfernter Server mit zwischengespeicherter Tool-Liste kann bei der Initialisierung als ausstehend erscheinen und sich erst beim ersten Tool-Aufruf verbinden. Für optionale Tools ist das nützlich, ein verbindliches Bereitschaftsversprechen erfüllt es jedoch nicht. Die Prüfung eines erforderlichen Tools sollte eine aktive Verbindung verlangen oder eine eigene Zustandsprüfung durchführen.
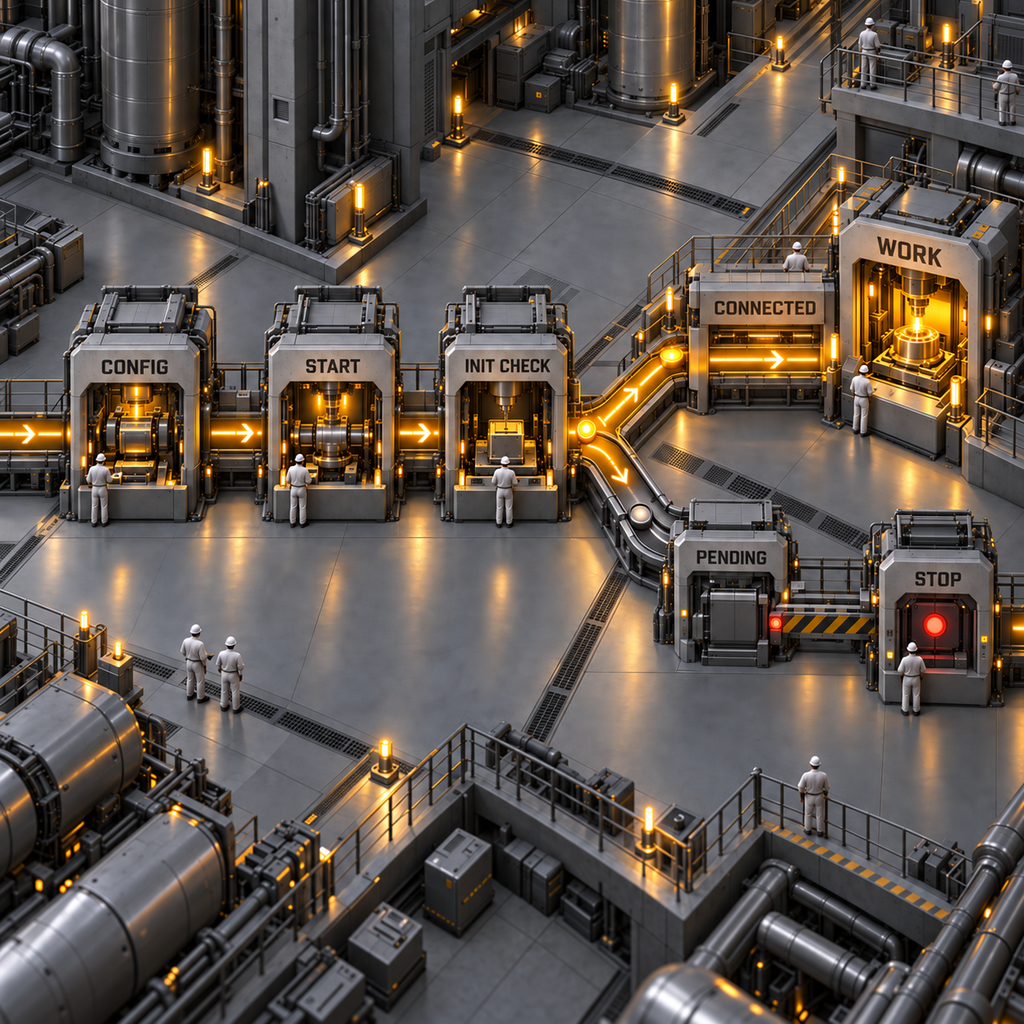
Abschließend braucht der gesamte Prozess eine Frist auf Scheduler-Ebene. Die Startwartezeit kann nicht verhindern, dass eine Modellanfrage, ein Bash-Befehl, ein Hook oder ein späterer Aufruf eines MCP-Tools den Rest des verfügbaren Zeitfensters verbraucht.
Wirtschaftlich zählt vor allem, wie schnell Fehler sichtbar werden
Die Einsparung an Rechenzeit ist real, wird aber leicht überschätzt. Angenommen, 10,000 monatliche Jobs würden sonst volle 30 Sekunden warten und erhalten stattdessen ein Zeitbudget von 3 Sekunden für den ersten Durchlauf. Die maximal zurückgewonnene Kapazität beträgt dann 4,500 Runner-Minuten.
GitHub führt einen gehosteten Standard-Linux-Runner mit 2 Kernen derzeit zu $0.006 pro Minute und einen macOS-Runner zu $0.062 pro Minute. Zu diesen Preisen entsprechen 4,500 Minuten vor Berücksichtigung der Inklusivminuten $27 für Linux-Laufzeit oder $279 für macOS-Laufzeit. GitHub rundet die Nutzung jedes Jobs außerdem auf eine volle Minute auf. Eine Verbesserung um 27 Sekunden kann daher ohne jede Auswirkung auf die Rechnung bleiben, wenn der gesamte Lauf im selben Abrechnungsintervall endet.
Der größere Nutzen liegt im Betrieb. Ein Job, dessen Bereitschaftsprüfung nach drei Sekunden fehlschlägt, lässt dem Scheduler Zeit für einen neuen Versuch, die Alarmierung der zuständigen Person oder den Wechsel auf einen Fallback. Startet ein Job dagegen unbemerkt ohne Datenbank oder Ticketsystem, kann ein plausibles, aber unvollständiges Ergebnis entstehen. Dessen Erkennung und Rückabwicklung kostet mehr als die Runner-Zeit.
Wer zugleich große Antworten begrenzen möchte, findet im Leitfaden zu den Ausgabelimits von Claude-Code-Tools die davon unabhängige Ausgabeseite des Workflows. Für unbeaufsichtigte Installationen und Netzwerkrichtlinien lässt sich diese Bereitschaftsprüfung mit dem Netzwerkzugriff pro Befehl kombinieren.
Sieben Workflows mit besonders großem Nutzen
1. Geplante Finanz- und Betriebsberichte
Ein Finanzverantwortlicher erstellt um 6 Uhr morgens einen Bericht, der einen Warehouse-MCP-Server benötigt. Dieser Server wird als erforderlich markiert, seine gemessene Kaltstartzeit erhält einen kleinen Puffer, und ohne Verbindung endet der Lauf. Der Vorteil beschränkt sich nicht auf eine kürzere Ausführung. So entsteht kein überzeugend wirkender Bericht allein aus Repository-Dateien, während die aktuellen Zahlen nicht verfügbar waren.
2. Automatisierte Risikoprüfungen für Pull Requests
Ein Plattformteam lässt Claude Code bei jedem risikoreichen Pull Request laufen und erwartet Tools von GitHub, einem Ticketsystem und einem Sicherheitsscanner. Die Prüfung kann den Scanner und GitHub voraussetzen, das Ticketsystem aber als optional behandeln. Entwickler erhalten einen schnellen, nachvollziehbaren Fehler statt einer Prüfung, in der ausgerechnet die wichtigsten Belege unbemerkt fehlen.
3. Jobs zur Release-Koordination
Ein Release-Manager nutzt einen geplanten Agenten, um zusammengeführte Änderungen, offene Störungen und den Deployment-Status abzugleichen. Für jede Quelle lässt sich eine eigene Bereitschaftsregel benennen. Ist der Deployment-MCP-Server nicht erreichbar, endet der Job, bevor er Versionshinweise entwirft, die einen sicheren Release suggerieren.
4. Nächtliche Vorsortierung von Supportfällen
Ein Supportteam lässt einen Job Tickets gruppieren, den Kontoverlauf prüfen und Antwortentwürfe erstellen. Helpdesk- und Kundendatenserver sind erforderlich, Slack kann optional bleiben. Eine begrenzte Wartezeit hält die Warteschlange in Bewegung. Zugleich verhindert die Bereitschaftsregel, dass fehlender privater Kundenkontext durch Vermutungen ersetzt wird.
5. Assistenten für die Reaktion auf Störungen
Ein Ingenieur in Rufbereitschaft startet aus einer Warnmeldung einen nicht interaktiven Diagnoselauf. Ein kurzes Startbudget zeigt, ob Protokolle und Metriken tatsächlich erreichbar sind. Fehlt einer der erforderlichen Server, kann der Wrapper sofort auf das manuelle Runbook verweisen, statt das Zeitfenster der Störung für eine Teildiagnose zu verbrauchen.
6. Automatisch skalierte kurzlebige Runner
Ein Team startet für jeden Agentenjob einen frischen Container. Lokale stdio-Server können beim Laden von Paketen, bei Authentifizierungshelfern oder bei der Schemaerkennung Kaltstartkosten verursachen. Wer diese Starts misst, kann ein ehrliches Bereitschaftsbudget von sieben Sekunden von einer dauerhaften Behelfslösung für einen fehlerhaften Server unterscheiden.
7. Mandantenfähige Agentenprodukte
Ein Produkt bedient Kunden mit unterschiedlichen MCP-Verbindungen. Ein Mandant benötigt möglicherweise Salesforce, ein anderer Linear und ein dritter gar keine externen Tools. Mit einer Liste erforderlicher Server pro Lauf kann dieselbe Orchestrierungsebene für jeden Mandanten eine kurze Wartezeit wählen, ohne die langsamste Integration zum Standard für alle zu machen.
Drei sinnvolle Produktideen
1. MCP-Bereitschaftsprüfung für Claude Code CI
Hier liegt die stärkste Chance. Das Produkt wäre ein schlanker Runner-Wrapper, der die Richtlinie für erforderliche Server einliest, Claude Code mit einer ausdrücklichen Wartezeit startet, system/init aufzeichnet und einen maschinenlesbaren Bereitschaftsfehler zurückgibt, bevor das Ergebnis des Agenten akzeptiert wird.
Die Nachfrage ist eng umrissen, aber wirtschaftlich relevant: claude code automation verzeichnet rund 140 Suchanfragen pro Monat in den USA, in den Vorschlagsdaten einen Anstieg von 200% im Jahresvergleich und einen CPC von $10.88. Außerdem wird danach gefragt, wie Claude Code automatisch ausgeführt und mit MCP konfiguriert werden kann. Diese Fragen bringen das Einrichtungsproblem unmittelbar auf den Punkt.
Die kleinste verkaufbare Version ist eine CLI mit Richtliniendatei, Annotationen für GitHub Actions und JSON-Nachweisen für jeden Lauf. Die Schwierigkeit liegt in der Distribution. Anthropic kann umfassendere native Bereitschaftsregeln ergänzen; dauerhaften Wert müssen deshalb der Verlauf mehrerer Läufe, Warnmeldungen und die Unterstützung mehrerer Agent-Runtimes schaffen.
2. Linter für Timeout-Richtlinien
Dieses Tool würde Shell-Skripte, CI-Dateien, Einstellungen und .mcp.json durchsuchen und falsch kombinierte Uhren markieren: eine Startwartezeit von null trotz erforderlicher Tools, eine kurze Jobfrist zusammen mit einem Tool-Timeout von 28 Stunden oder eine unbegrenzte optionale Integration.
Das genaue Keyword mcp server timeout erreicht rund 10 Suchanfragen pro Monat in den USA und weist im Jahresvergleich einen gemeldeten Trend von -67% auf. Eine verwandte Suche lautet MCP_TOOL_TIMEOUT; außerdem wird danach gefragt, wie sich der Claude-Code-Timeout erhöhen lässt. Das reicht als Nachfrage für ein Feature innerhalb der Bereitschaftsprüfung, aber nicht für ein eigenständiges Unternehmen.
Ein MVP benötigt Parser für GitHub Actions, gängige Shell-Syntax und die MCP-Konfiguration von Claude Code sowie klare Korrekturvorschläge. Das Risiko liegt in trügerischer Sicherheit: Aus einer statischen Konfiguration lässt sich die tatsächliche Kaltstartverteilung eines Servers ohne Laufzeitmessungen nicht erkennen.
3. Starttelemetrie für geplante Agenten
Dieses Produkt würde aus system/init-Ereignissen einen Zeitverlauf für Verbindungslatenz, ausstehende Zustände, ungültige Konfigurationen und eingeschränkte Läufe erstellen. Plattformteams würden für Trends und Warnmeldungen über viele Repositorys hinweg zahlen, statt JSONL-Dateien von Hand zu lesen.
Es teilt sich die 140 monatlichen Suchanfragen für claude code automation; claude code browser automation steuert weitere 40 bei und verzeichnet in den Vorschlagsdaten ebenfalls einen Anstieg von 200% im Jahresvergleich. Das umfassendere Signal: Teams überführen Claude Code in wiederholbare Jobs, bei denen Nachweise über den Start zu einer betrieblichen Aufgabe werden.
Das MVP besteht aus einem Ereignissammler, einer Zuordnung erforderlicher und optionaler Server sowie Warnmeldungen, sobald die Bereitschaft ein Serviceziel überschreitet. Die Schwierigkeit liegt in der Vertraulichkeit der Daten. MCP-Namen und Tool-Metadaten können interne Systeme offenlegen; Schwärzung und Selbsthosting gehören daher zum Produkt und sind kein späteres Extra für Unternehmenskunden.
Grenzen und eine ehrliche Einordnung
Diese Steuerung löst einen kleinen, aber wertvollen Teil zuverlässiger Automatisierung. Sie repariert keinen defekten MCP-Server, authentifiziert keinen abgelaufenen Connector, verkürzt keinen späteren Tool-Aufruf und beendet nicht den gesamten Claude-Code-Prozess.
Für einen Job, dessen erste sinnvolle Aktion MCP benötigt, sollte 0 nicht verwendet werden. Bei der Initialisierung kann dann pending erscheinen, und die Wartezeit kehrt womöglich bei der Tool-Suche zurück. Ebenso wenig sollte der Wert so lange erhöht werden, bis instabile Server gesund wirken. HTTP- und SSE-Server wiederholen vorübergehende Fehler beim ersten Verbindungsaufbau; Authentifizierungsfehler und nicht gefundene Ressourcen erfordern dagegen Änderungen an der Konfiguration. Eine längere Wartezeit verzögert diese Erkenntnis nur.
Auch stdio-Server stellen nach einem Verbindungsabbruch mitten in der Sitzung nicht automatisch eine neue Verbindung her. Ein großzügiges Startfenster sagt nichts über ihren Zustand zehn Minuten später aus.
Die beste Richtlinie ist streng und unspektakulär: eine kurze, ausdrücklich festgelegte Wartezeit für den ersten Durchlauf, benannte erforderliche Server, eine Statusprüfung, ein eigener Tool-Timeout und eine äußere Jobfrist. Dieses Zusammenspiel liefert verwertbare Fehler statt rätselhafter Verzögerungen.
Wie lässt sich der Claude-Code-Timeout erhöhen?
Entscheidend ist der Timeout für die tatsächlich langsame Phase. CLAUDE_CODE_MCP_STARTUP_WAIT_MS steuert die MCP-Bereitschaftswartezeit des ersten nicht interaktiven Durchlaufs, MCP_TIMEOUT den Serverstart, MCP_TOOL_TIMEOUT oder ein timeout pro Server die Tool-Ausführung und die Begrenzung des Runners den gesamten Job.
Wie lässt sich Claude Code automatisch ausführen?
Claude Code wird mit -p oder --print nicht interaktiv gestartet. Zusätzlich braucht es festgelegte Berechtigungen für unbeaufsichtigte Tools, eine äußere Scheduler-Frist und eine ausdrückliche MCP-Bereitschaftsprüfung. Die Startwartezeit allein macht einen automatisierten Job nicht sicher.
Warum läuft Claude Code immer wieder in einen Timeout?
Zuerst muss in den Protokollen die betroffene Phase bestimmt werden. Eine Verzögerung vor system/init deutet auf die Start- oder Verbindungsbereitschaft hin. Ein Fehler während eines MCP-Tool-Aufrufs verweist auf Begrenzungen des Tools, der Leerlaufzeit oder der Netzwerkanfrage. Beendet die CI den Prozess, ist wahrscheinlich die äußere Jobfrist erreicht.
Wie wird Claude Code mit MCP konfiguriert?
MCP lässt sich in der Projekt- oder Benutzerkonfiguration einrichten oder über eine Datei mit --mcp-config übergeben. Für reproduzierbare Jobs kommen --strict-mcp-config, eine ausdrückliche Wartezeit für den ersten Durchlauf und die Prüfung erforderlicher Server in system/init hinzu. Allein aus ihrer Konfiguration darf nicht auf eine bestehende Verbindung geschlossen werden.
Am Montag genügt zunächst ein geplanter Claude-Code-Job: die Kaltstarts seiner erforderlichen MCP-Server messen, die kleinste realistische Wartezeit festlegen und bei einem ausstehenden erforderlichen Server abbrechen, bevor dem Ergebnis vertraut wird. Wenn diese Zuverlässigkeitsschicht in allen Agenten-Workflows aufgebaut werden soll, unterstütze ich gern beim produktiven System.
- Zuletzt aktualisiert
- 17. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
KI-Crawler blockieren, ohne die Suche zu verlieren
Cloudflare trennt Suche und KI-Training. So lassen sich KI-Crawler blockieren, migrierte Regeln prüfen und Googlebot für die Indexierung offenhalten.16. Sept. 2026Build
Diktierprogramm kostenlos und offline: Murmure im Praxistest
Murmure im Praxistest: Wie gut das kostenlose Offline-Diktierprogramm Fachbegriffe erkennt, welche Hardware genügt und was lokale oder Remote-LLMs ändern.14. Sept. 2026Build
Video API mit FFmpeg: Was RenderIO wirklich kostet
Was kostet die RenderIO Video API? Der Vergleich zeigt Credits, Aufpreise und exakte Wechselpunkte für Starter, Growth und Business im Praxiseinsatz.14. Sept. 2026Build
Diktierprogramm kostenlos: Was Dictare tatsächlich kostet
Diktierprogramm kostenlos: Dictare läuft lokal für $0. Der Preisvergleich zeigt, welche Kosten für Coding-Agent, Hardware, Einrichtung und Strom bleiben.13. Sept. 2026Build
Claude Code Plugin testen: Native Evals als Release-Gate
So messen native Evals, ob ein Claude Code Plugin das Verhalten von Claude verbessert – mit A/B-Vergleich, deterministischen Gradern und einem CI-Gate.12. Sept. 2026Build
KI Telefonassistent: Cloudflare-Latenz gezielt debuggen
Cloudflares turnmetrics zeigt pro Sprach- und Text-Turn, wodurch ein KI-Telefonassistent ausgebremst wird – von Transkription und Modell bis TTS.12. Sept. 2026Build
Untertitel in Video einbrennen: der Rendi-Workflow
Untertitel in Video einbrennen mit Rendi: SRT prüfen, API-Auftrag senden, Darstellung festlegen und die fertige MP4 zuverlässig kontrollieren.11. Sept. 2026Build