KI-Crawler blockieren, ohne die Suche zu verlieren
Cloudflare trennt Suche und KI-Training. So lassen sich KI-Crawler blockieren, migrierte Regeln prüfen und Googlebot für die Indexierung offenhalten.



KI-Crawler blockieren, ohne die Suche auszubremsen: Search auf Allow und Training auf Disallow AI Training setzen. Anschließend sowohl die migrierten Einstellungen als auch die von Cloudflare ausgelieferte robots.txt prüfen. Das ist jetzt entscheidend, denn Cloudflare hat die Bedeutung von Block am 15. September 2026 geändert. Seither kann Block auch Mehrzweck-Crawler wie Googlebot, Applebot und Bingbot vom Suchzugriff auf die Website ausschließen.
KI-Crawler blockieren: die sichere Konfiguration im Überblick
Für die meisten Websites, die auf Suchzugriffe angewiesen sind, ist die richtige Wahl eindeutig: Search erlauben, Training ablehnen und separat festlegen, was Agents dürfen.
Cloudflares Erklärung vom 15. September ist eindeutig: Wer Training verhindern und die Suche erhalten will, wählt Disallow AI Training. Ältere Anleitungen, die zu Training: Block raten, sind überholt. Vor der Änderung waren Mehrzweck-Crawler von dieser Sperre ausgenommen. Das gilt jetzt nicht mehr.
Die Steuerung ist in jedem Cloudflare-Tarif enthalten; ein kostenpflichtiges Feature-Upgrade ist nicht nötig. Statt für ein weiteres Blockierprodukt zu zahlen, muss nun geprüft werden, ob Richtlinie und tatsächliches Verhalten übereinstimmen. Zum Vergleich: Eine Lizenz für Screaming Frog SEO Spider kostet in den USA $279 pro Jahr, während ein spezialisierter Dienst zur robots.txt-Überwachung einen Tarif für $129 pro Monat bewirbt. Cloudflare liefert die Steuerung. Eine Prüfschleife bleibt trotzdem unverzichtbar.
Was Disallow AI Training tatsächlich bewirkt
Disallow ist eine Präferenz mit gezielter Durchsetzung. Block dagegen ist eine verschlossene Tür.
Ein Mehrzweck-Crawler lässt sich wie ein Lieferwagen mit zwei Aufträgen verstehen. Der eine lautet: „Diese Seite für die Suche indexieren.“ Der andere: „Diese Seite für das Modelltraining verwenden.“ Wird der Lieferwagen blockiert, fallen beide Aufträge weg. Disallow AI Training lässt einen nachvollziehbar handelnden Betreiber den Suchauftrag weiter ausführen, weist den Trainingsauftrag aber zurück.
Cloudflare unterscheidet drei Arten automatisierter Zugriffe:
- Search erstellt einen Suchindex.
- Training trainiert ein Modell oder stimmt es weiter ab.
- Agent besucht eine Website im Auftrag einer Person, etwa als Chat-Abrufdienst oder Browser-Agent.
Die neue Training-Option weist Bot Preference Sync an, die passenden Anweisungen gegen Training in der robots.txt zu veröffentlichen. Nachvollziehbare Mehrzweck-Crawler kommen weiterhin für den Suchzugriff infrage. Reine Trainings-Crawler von Amazon, Anthropic, Meta und OpenAI werden blockiert, ohne dass deren separate Such-Crawler ebenfalls ausgesperrt werden.
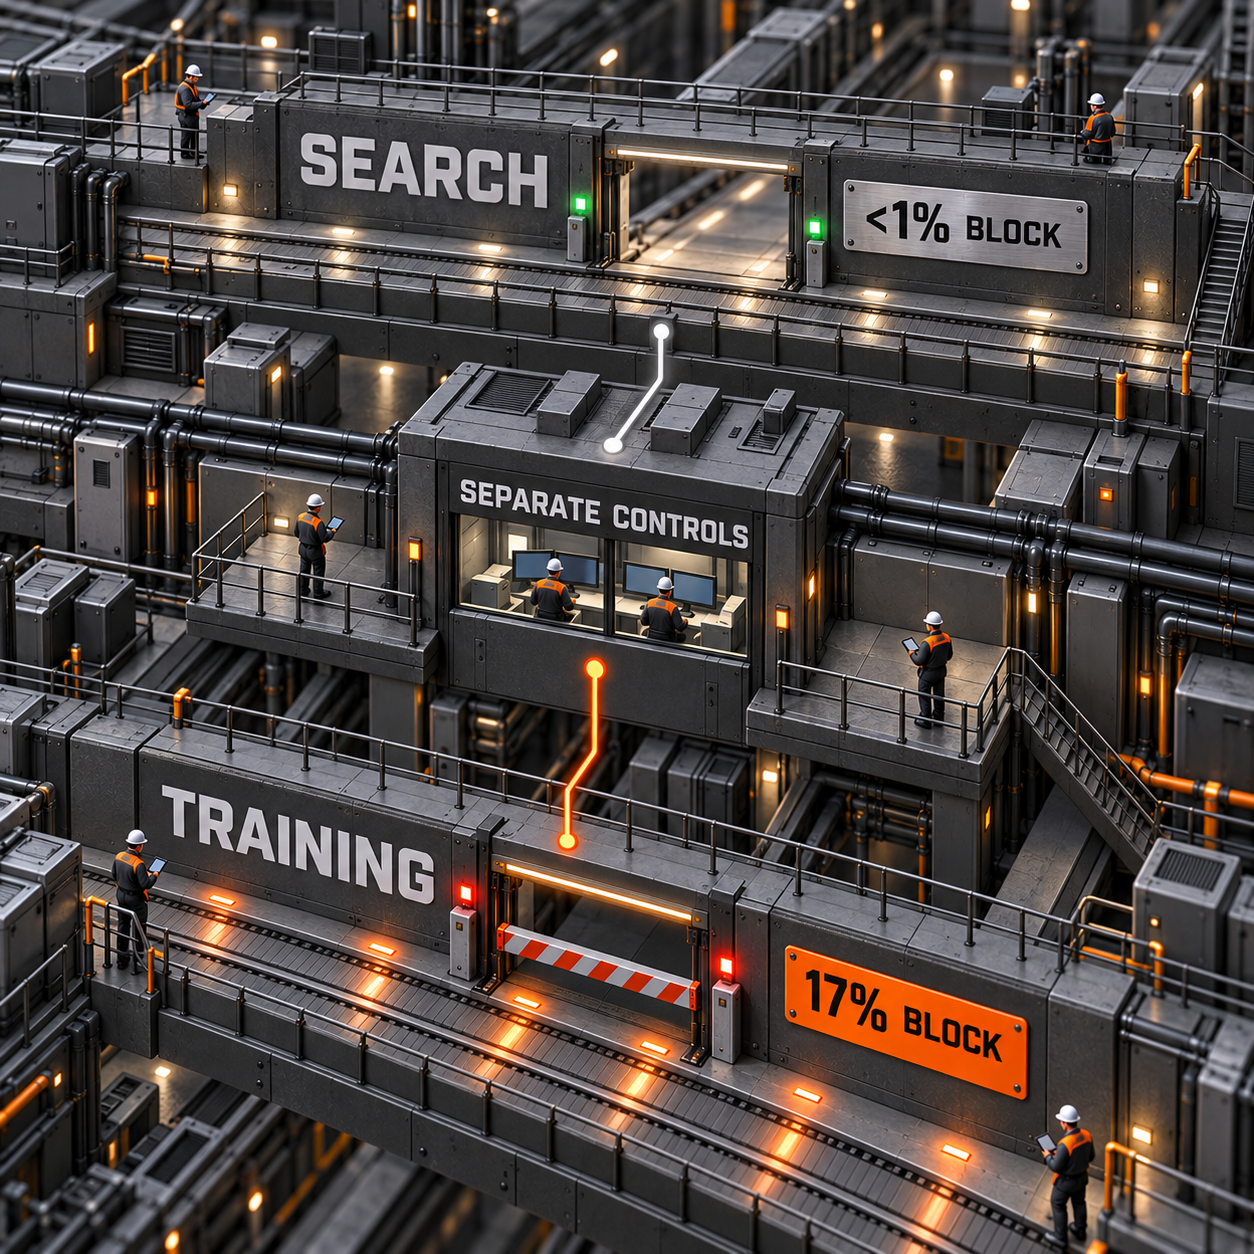
Cloudflare zufolge blockieren weniger als 1% seiner Websites Such-Bots, während 17% irgendeinen Mechanismus gegen Training aktivieren. Genau diese Lücke erklärt das Produktdesign: Ein einzelner Schalter „Block AI“ war zu grob für das, was Websitebetreiber tatsächlich erreichen wollen.
Eine wichtige Einschränkung bleibt: Eine robots.txt-Anweisung ist kein Kraftfeld. Für sich allein erkennt sie weder, wer crawlt, noch zu welchem Zweck. Und einen Crawler, der sie ignoriert, kann sie nicht stoppen. Cloudflare verbindet die veröffentlichte Präferenz deshalb mit Netzwerkklassifizierung und Blockierung für Crawler, die sich nicht für den nachvollziehbaren Zugang qualifizieren.
„Accountable“ heißt nicht, dass heute schon alles verfügbar ist
Das Cloudflare-Label Accountable sollte als Status mit verbindlicher Roadmap verstanden werden, nicht als Beleg dafür, dass jede zugesagte Steuerungsmöglichkeit bereits existiert.
Um sich zu qualifizieren, muss ein Betreiber Anforderungen erfüllen oder sich dazu verpflichten. Dazu gehören ein Opt-out vom Training, ein Opt-out von KI-Zusammenfassungen, Transparenz auf URL-Ebene und die Zusicherung, dass die Ablehnung von Training der klassischen Suche nicht schadet. Auf diese Formulierung kommt es an.
- Google: Google-Extended lässt sich per robots.txt ausschließen. Laut Google wirkt sich diese Entscheidung nicht auf das Suchranking aus. Zudem bietet Google eine Webmaster-Steuerung für generative Suche und entsprechende Berichte. Zusätzliche Transparenz für Google-Extended auf URL-Ebene wurde jedoch noch als Neuerung für die Wochen nach der Ankündigung beschrieben.
- Apple: Applebot-Extended unterstützt ein Training-Opt-out über robots.txt. Für KI-Zusammenfassungen unterstützt Apple außerdem
nosnippetsowie die Kennzeichnung von Paywalls. Eine Prüfung auf URL-Ebene war am Tag der Ankündigung noch nicht verfügbar und wurde als Vorhaben für das darauffolgende Jahr beschrieben. - Microsoft: Bing verfolgt derzeit einen anderen Ansatz. Websitebetreiber können
NOARCHIVEzusammen mit Bings Tools Block URLs oder Content Removal verwenden. Microsoft plant für Anfang 2027, dass Bingbot eine domainweite No-Training-Präferenz in robots.txt berücksichtigt. Bis dahin übermittelt Cloudflares Einstellung Disallow AI Training diese Präferenz nicht automatisch über robots.txt an Bing.
Das ehrliche Versprechen ist also enger als „Ein Schalter steuert jede Nutzung überall“. Die neue Einstellung macht die sichere Entscheidung zwischen Suche und Training deutlich verständlicher. Bing erfordert derzeit dennoch eine separate Prüfung.
Migrierte Cloudflare-Einstellungen prüfen
Die meisten Einstellungen werden automatisch übernommen. Bezeichnungen und Auswirkungen haben sich jedoch so stark verändert, dass eine Kontrolle unverzichtbar ist.
Hat eine Domain die detaillierten Einstellungen für Search, Training und Agent bislang nicht verwendet, überträgt Cloudflare die alte Einstellung Block AI Bots nach diesem Schema:
Wurden die detaillierten Einstellungen bereits genutzt, behalten Search und Agent ihren praktischen Zustand. Training: Allow bleibt Allow. Sowohl Training: Block als auch Training: Block on pages with ads werden zu Disallow AI Training.
So läuft die Migrationsprüfung ab:
- Die Domain in Cloudflare öffnen, Security Settings aufrufen und anschließend Configure AI bot policies wählen.
- Vor jeder Änderung die aktuellen Werte für Search, Training und Agent dokumentieren.
- Search auf Allow setzen, wenn organische Auffindbarkeit wichtig ist.
- Training auf Disallow AI Training setzen, wenn das Training abgelehnt werden soll, ohne nachvollziehbare Mehrzweck-Crawler aus der Suche zu entfernen.
- Die Agent-Richtlinie nach ihren eigenen Kriterien wählen. Cloudflare bietet für Agents keine Disallow-Präferenz an, weil dafür noch keine etablierte Internet-Anweisung existiert.
- Prüfen, ob Bot Preference Sync aktiviert ist, wenn Cloudflare die kategorieweite Richtlinie in robots.txt veröffentlichen soll.
- Die Richtlinie speichern und anschließend das öffentlich sichtbare Ergebnis kontrollieren, statt die Dashboard-Beschriftung als Beweis zu betrachten.
Für neue werbefinanzierte Domains folgt die von Cloudflare empfohlene Voreinstellung bereits diesem Muster: Preference Sync ist aktiviert, Search erlaubt, Training abgelehnt und Agents werden auf Seiten mit Werbung blockiert. Bei neuen Domains ohne Werbemonetarisierung sind zunächst alle drei Zugriffsarten erlaubt.
Suchzugriff nach der Änderung verifizieren
Ein korrekt aussehender Schalter ist nur der erste Kontrollpunkt. Die Richtlinie muss von außen nach innen geprüft werden.
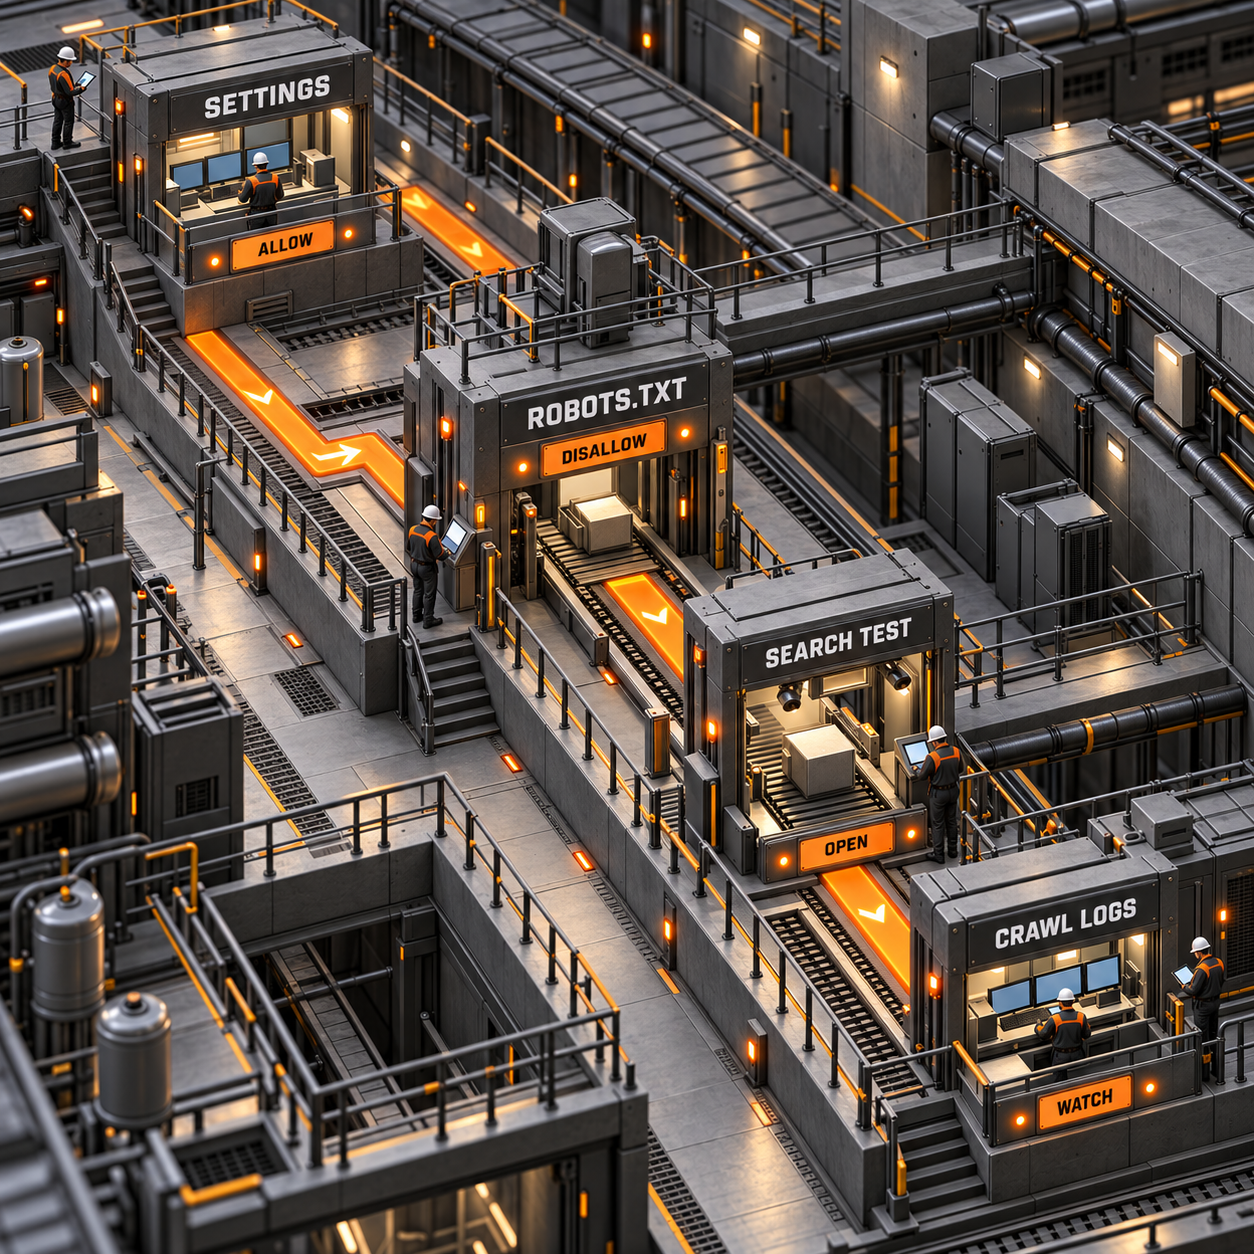
Die Prüfung besteht aus vier Teilen:
- Einstellungen: Kontrollieren, ob Search auf Allow und Training auf Disallow AI Training steht. Agent separat prüfen.
- robots.txt: Die live ausgelieferte Datei
/robots.txtvon der öffentlichen Domain abrufen. Bot Preference Sync stellt seine erzeugten Regeln einer vorhandenen Datei voran; die ursprünglichen Disallow-Anweisungen bleiben also erhalten. Beide Abschnitte auf Konflikte prüfen. - Suchverhalten: Repräsentative URLs mit den Webmaster-Tools und Berichten des Suchmaschinenbetreibers prüfen. Aus dem Wort „Disallow“ allein lässt sich kein gesperrter Suchzugriff ableiten. Es gilt für die Trainingsidentität oder -präferenz, nicht für den klassischen Suchzweck eines nachvollziehbaren Mehrzweck-Crawlers.
- Crawler-Aktivität: In AI Crawl Control Anfragen, Einhaltung der robots.txt und unerwartete Sperren beobachten. Cloudflare kann Maßnahmen für einzelne Crawler anwenden und protokolliert deren Aktivität. Damit ist dies der praktischste Ort, um eine Richtlinie zu erkennen, die anders wirkt als beabsichtigt.
Benutzerdefinierte Regeln verdienen besondere Aufmerksamkeit. Bot Preference Sync bildet die kategorieweite Richtlinie ab, übernimmt aber keine komplexen Einzelregeln in die erzeugte Datei. Wer eine Lizenzausnahme für einen Crawler, pfadspezifische Logik oder eine eigene WAF-Regel nutzt, muss diese Ebenen manuell abgleichen. Ist eine kategorieweite Richtlinie zu grob, lässt sich Sync in Cloudflare abschalten und die Datei selbst pflegen.
Wer von der neuen Trennung am meisten profitiert
Am stärksten profitieren Unternehmen, die Geld verdienen, wenn ein Mensch ihre Seite besucht, ihr Archiv aber nicht in Trainingsdaten wiederfinden möchten.
Das Händlerbeispiel zeigt zugleich eine Grenze: Diese Einstellungen gelten auf Domain-Ebene. Sie sind kein eingebautes Einwilligungssystem für einzelne Artikel. Getrennte Zonen können unterschiedliche Richtlinien tragen. Innerhalb einer Zone gilt jedoch eine gemeinsame Haltung zu Search, Training und Agent, sofern keine spezifischeren Regeln ergänzt werden.
Was sich zu bauen lohnt
Das stärkste Produkt ist ein Regressionsmonitor für Crawler-Richtlinien, nicht noch ein robots.txt-Generator.
1. Regressionsmonitor für Crawler-Richtlinien
Sinnvoll ist ein Monitor für Agenturen und Teams mit vielen Websites. Er liest die Cloudflare-Richtlinie, ruft die ausgelieferte robots.txt ab, prüft repräsentative Suchzugriffe und schlägt Alarm, sobald diese Ebenen auseinanderlaufen.
Die Nachfrage rund um diese Aufgabe ist sichtbar: robots.txt generator kommt auf etwa 1,000 Suchanfragen pro Monat in den USA, google indexing checker auf ungefähr 110. Bestehende Tools zeigen außerdem, dass Budgets vorhanden sind. Ein Produkt zur robots.txt-Überwachung nennt $129 pro Monat für einen Tarif mit fünf Domains, ein Desktop-Tool zur Überwachung von SEO-Änderungen kostet einmalig $179.
Die kleinste verkaufsfähige Version braucht vier Dinge: Import von Cloudflare-Zonen, Abgleich zwischen Richtlinie und robots.txt, geplante Prüfungen sowie einen E-Mail- oder Slack-Alarm mit der exakten Änderung. Crawler-Aktivität und Webmaster-Daten sollten erst ergänzt werden, wenn der zentrale Drift-Detektor zuverlässig funktioniert.
Die Schwierigkeit liegt im Nachweis. Konfiguration und beobachtete Anfragen können zeigen, was die Website veröffentlicht und blockiert hat. Sie können nicht beweisen, dass ein Modellanbieter bereits gesammelte Daten gelöscht hat. Der Burggraben muss daher aus verlässlichen Nachweisen über viele Domains hinweg bestehen, nicht aus einem hübscheren Schalter.
2. Cloudflare-Migrationsauditor
Ein fokussierter Audit kann Zonen aufspüren, die nach der Migration noch riskante Einstellungskombinationen verwenden, und für eine Agentur, Verlagsgruppe oder Franchise-Organisation einen Maßnahmenbericht erstellen.
cloudflare block ai bots erreicht etwa 50 Suchanfragen pro Monat in den USA bei einem CPC von $13.19. google indexing checker steuert weitere 110 monatliche Suchanfragen rund um das befürchtete Problem bei. Das ist weniger Nachfrage als im Generator-Markt. Der Preis für bezahlte Klicks deutet jedoch darauf hin, dass Suchende ein akutes Betriebsproblem lösen müssen.
Das MVP kann die API-Felder für Search, Training, Agent und Bot Preference Sync auslesen, die öffentliche robots.txt abrufen und jede Zone als suchfreundlich, absichtlich blockiert oder inkonsistent klassifizieren. Ein präsentationsfertiges Nachweispaket stellt Einstellung und beobachtete Datei nebeneinander.
Das Risiko liegt in der Abhängigkeit von der Plattform. Cloudflare kann denselben Portfolio-Bericht ergänzen, und der Bedarf steigt vor allem rund um Migrationen. Tragfähiger wird das Geschäftsmodell, wenn der Audit als Einstiegsprodukt dient und anschließend eine laufende Regressionsüberwachung für Cloudflare und andere Edge-Anbieter verkauft wird.
Was diese Einstellung nicht löst
Sie schafft eine klarere Richtliniengrenze, ist aber keine vollständige Antwort auf die Nutzung von Inhalten durch KI.
- Bereits erfasstes Material wird nicht gelöscht. Cloudflare beschreibt Crawler-Präferenzen und Anfragesteuerung, keine rückwirkende Löschung.
- Es gibt keine Garantie, dass jeder Betreiber robots.txt beachtet. Cloudflare ergänzt für Crawler außerhalb des nachvollziehbaren Zugangs zwar eine Durchsetzung im Netzwerk. Der Mehrzweck-Zugang hängt aber weiterhin davon ab, dass der Betreiber die Präferenz respektiert.
- Das Opt-out gilt nicht für jede KI-Zusammenfassung. Die Steuerung von Zusammenfassungen erfolgt separat; eine breitere zentrale Steuerung beschreibt Cloudflare als künftige Aufgabe.
- Für Agents gibt es keinen Disallow-Zustand.
- Komplexe benutzerdefinierte Einzelregeln für Crawler werden nicht in Bot Preference Sync übertragen.
- Die No-Training-Präferenz für Bing wird noch nicht automatisch über robots.txt ausgedrückt. Bings aktuelle
NOARCHIVE- und Webmaster-Einstellungen müssen separat geprüft werden. - Dies ist nicht Cloudflare AI Search zur Indexierung von R2-Dateien. Dabei handelt es sich um ein anderes Produkt und einen anderen Ablauf.
Block ist die richtige Wahl, wenn ein Crawler tatsächlich vollständig verschwinden soll. Disallow AI Training passt, wenn die Auffindbarkeit über die Suche weiterhin zum Geschäftsmodell gehört. Genau um diese Unterscheidung geht es bei der Änderung im September.
Die Aufgabe für Montag
In der kommenden Woche drei repräsentative Domains auswählen: eine werbefinanzierte Website, eine suchmaschinenorientierte Website und eine Domain mit benutzerdefinierten Crawler-Regeln. Die migrierten Werte für Search, Training und Agent dokumentieren, ausschließlich Websites mit eindeutigem Geschäftsziel umstellen und anschließend die live ausgelieferte robots.txt sowie den Crawler-Bericht beim Änderungsticket ablegen. Bestehen alle drei die Prüfung, kann derselbe evidenzbasierte Ablauf auf das gesamte Portfolio ausgeweitet werden.
Wie lässt sich KI-Training deaktivieren?
Bei einer von Cloudflare verwalteten Domain ist Disallow AI Training die richtige Training-Einstellung, wenn eine No-Training-Präferenz veröffentlicht werden soll und nachvollziehbare Mehrzweck-Crawler für die Suche verfügbar bleiben sollen. Block passt nur, wenn auch die Auswirkungen auf die Suche durch Mehrzweck-Crawler akzeptabel sind.
Kann man sämtliche KI-Zugriffe blockieren?
Crawler-Kategorien oder einzelne Crawler lassen sich blockieren. „Sämtliche KI-Zugriffe“ umfasst allerdings mehrere unterschiedliche Aufgaben. Cloudflare trennt Search-, Training- und Agent-Traffic, damit jede automatisierte Nutzung separat erlaubt oder gesperrt werden kann. Eine Training-Sperre entfernt weder KI-generierte Inhalte aus Suchprodukten noch bereits erfasste Daten.
Wie lässt sich der KI-Modus in der Suche deaktivieren?
Cloudflares Crawler-Einstellung schaltet die KI-Suchfunktion für Nutzer nicht aus. Sie steuert den Zugriff auf die eigene Domain. Google und andere Betreiber bieten separate Einstellungen für generative Zusammenfassungen an; klassische Indexierung und Trainingspräferenzen bleiben davon getrennte Entscheidungen.
Wenn eine solche Audit- und Monitoring-Schicht für Crawler-Richtlinien im Unternehmen entstehen soll, finden sich weitere Informationen unter KI-Produktionssysteme.
- Zuletzt aktualisiert
- 16. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Diktierprogramm kostenlos und offline: Murmure im Praxistest
Murmure im Praxistest: Wie gut das kostenlose Offline-Diktierprogramm Fachbegriffe erkennt, welche Hardware genügt und was lokale oder Remote-LLMs ändern.14. Sept. 2026Build
Video API mit FFmpeg: Was RenderIO wirklich kostet
Was kostet die RenderIO Video API? Der Vergleich zeigt Credits, Aufpreise und exakte Wechselpunkte für Starter, Growth und Business im Praxiseinsatz.14. Sept. 2026Build
Diktierprogramm kostenlos: Was Dictare tatsächlich kostet
Diktierprogramm kostenlos: Dictare läuft lokal für $0. Der Preisvergleich zeigt, welche Kosten für Coding-Agent, Hardware, Einrichtung und Strom bleiben.13. Sept. 2026Build
Claude Code Plugin testen: Native Evals als Release-Gate
So messen native Evals, ob ein Claude Code Plugin das Verhalten von Claude verbessert – mit A/B-Vergleich, deterministischen Gradern und einem CI-Gate.12. Sept. 2026Build
KI Telefonassistent: Cloudflare-Latenz gezielt debuggen
Cloudflares turnmetrics zeigt pro Sprach- und Text-Turn, wodurch ein KI-Telefonassistent ausgebremst wird – von Transkription und Modell bis TTS.12. Sept. 2026Build
Untertitel in Video einbrennen: der Rendi-Workflow
Untertitel in Video einbrennen mit Rendi: SRT prüfen, API-Auftrag senden, Darstellung festlegen und die fertige MP4 zuverlässig kontrollieren.11. Sept. 2026Build
KI Agenten mit OpenAI: Agents API oder Agents SDK?
KI Agenten mit OpenAI: Agents API und Agents SDK im Vergleich – mit Sitzungszustand, Laufzeitkontrolle, Sandbox-Kosten und Migrationsaufwand.11. Sept. 2026Build