Cloudflare R2: Dateien ohne Dateiendung in AI Search indexieren
Cloudflare R2: AI Search erkennt Dateien ohne Endung jetzt am HTTP-Content-Type. So bleiben stabile Objektschlüssel erhalten – samt Prüf- und Kostenregeln.

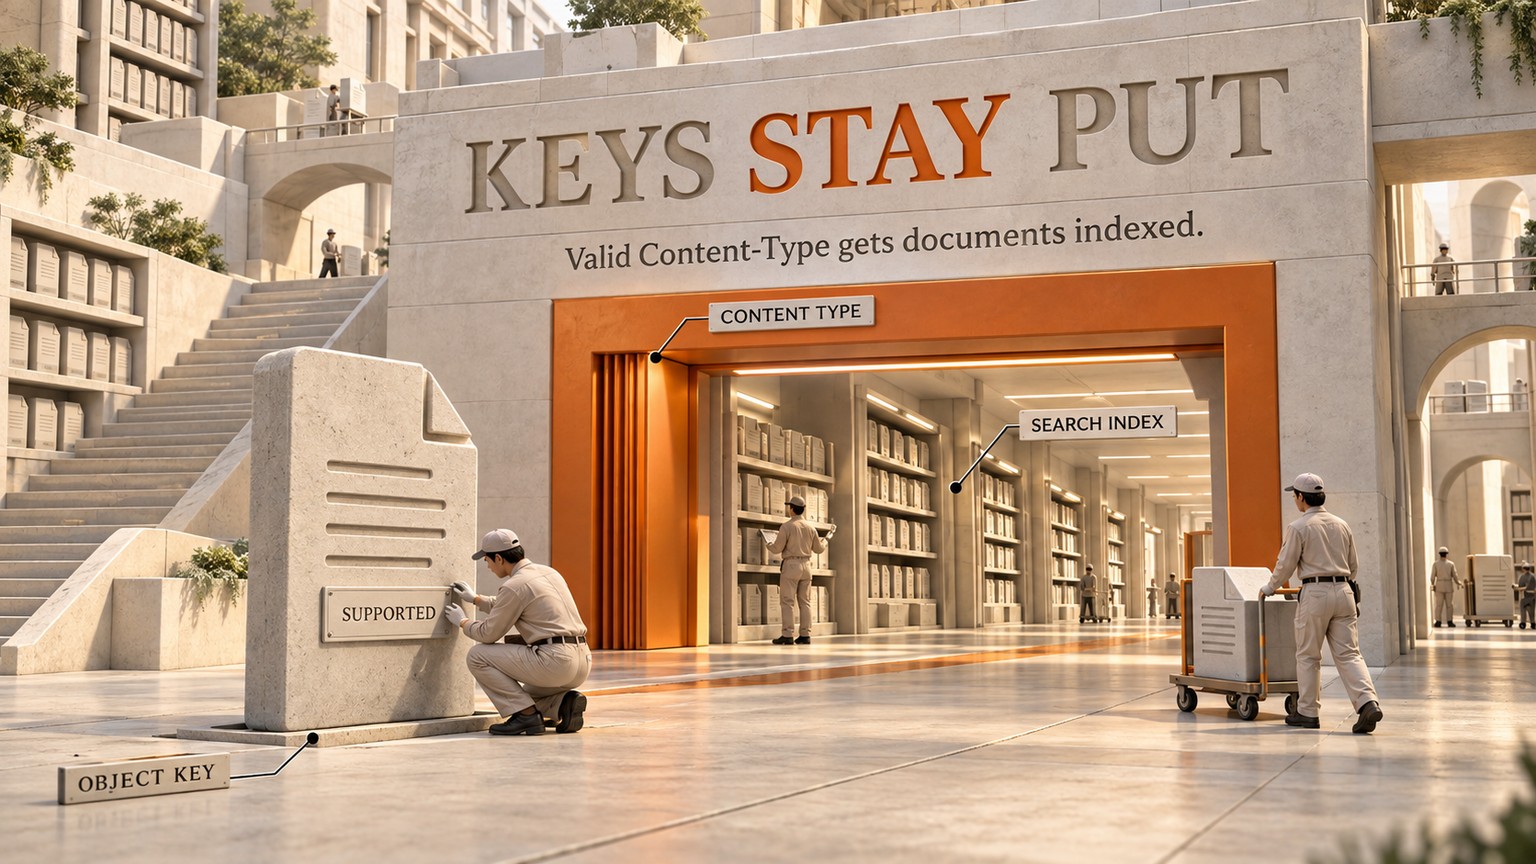
Cloudflare AI Search hat am 11. September 2026 ein Problem bei der Aufnahme von Dateien aus Cloudflare R2 beseitigt. Liegen Dokumente unter stabilen Schlüsseln ohne Dateiendung, müssen diese Schlüssel nun nicht mehr geändert werden: Ein unterstützter HTTP-Content-Type am jeweiligen Objekt genügt, damit die Dateien durchsuchbar werden können.
Damit kann ein kompletter Umbenennungsschritt aus dem Aufnahmeprozess entfallen. Die Bereinigung der Metadaten, die Indexierung und die Kontrolle, ob ein Dokument tatsächlich in der Suche angekommen ist, bleiben dennoch nötig.
Was sich bei Cloudflare R2 tatsächlich geändert hat
Cloudflare AI Search ist ein verwalteter Suchdienst für eigene Inhalte. Als Datenquelle kann unter anderem ein R2-Bucket dienen – der Objektspeicher von Cloudflare. AI Search liest den Bucket aus, wandelt unterstützte Dokumente in durchsuchbaren Text um und erstellt den Index, den eine Anwendung bei Suchanfragen nutzt.
Vor diesem Update war die Dateiendung der verlässliche Weg zur Formaterkennung. Ein Schlüssel wie manual.pdf verrät dem Indexer den Dateityp. Bei einem stabilen Schlüssel wie documents/manual-alpha fehlt dieses Signal.
Bei Objekten ohne Dateiendung kann AI Search nun stattdessen den üblichen HTTP-Content-Type verwenden. application/pdf weist die Bytes als PDF aus, text/markdown als Markdown. Zu den unterstützten Typen zählt Cloudflare außerdem text/plain, application/json, text/html und text/csv.
Dateiendungen sind damit nicht überflüssig. Cloudflare bezeichnet eine erkannte Endung weiterhin als bevorzugten und schnelleren Erkennungsweg. Der neue Pfad ist vor allem dann relevant, wenn eine Änderung des Schlüssels URLs, Datenbankreferenzen, Mandantenzuordnungen, Signaturen oder einen bestehenden Upload-Vertrag beschädigen würde.
Eine Abgrenzung ist entscheidend: Content-Type ist ein HTTP-Metadatum des R2-Objekts. Es handelt sich nicht um die benutzerdefinierten Metadaten, die AI Search für Filter wie Kategorie, Kunde oder Dokumentstatus verwendet. Diese Felder werden in x-amz-meta-*-Headern übertragen und benötigen ein Schema in AI Search. Ein zusätzliches x-amz-meta-content-type ersetzt das echte HTTP-Feld nicht.
Das Update betrifft die Quellenaufnahme, also den Punkt, an dem ein Dokument in den Index gelangt. Das Modell, das nach dem Abruf eine Antwort formuliert, ändert sich dadurch nicht. Das GLM-5.3-Flash-Update greift erst in dieser späteren Generierungsphase.
Der praktische Gewinn: ein Benennungssystem weniger
Opake Schlüssel sind aus gutem Grund verbreitet. Ein Produkt kann eine stabile Datenbank-ID als R2-Schlüssel verwenden, damit sich das Objekt ändern kann, ohne dass sich seine Adresse ändert. Ein Dokumentendienst möchte möglicherweise den ursprünglichen Dateinamen eines Kunden nicht offenlegen. Auch eine signierte URL kann vom exakten Schlüssel abhängen.
Die bisherige Umgehungslösung bestand darin, für die Suchkopie einen Namen mit Dateiendung anzulegen oder die Datei umzubenennen, bevor AI Search sie sah. Dadurch entsteht eine weitere Identität, die gespeichert, abgeglichen und später bereinigt werden muss.
Sind die HTTP-Metadaten bereits korrekt, kann der ursprüngliche Schlüssel nach dem Update unverändert bleiben. Genau darin liegt die relevante Vereinfachung des Ablaufs.
Die folgende Gegenüberstellung zeigt den geschätzten Aufwand vor und nach der Änderung. Sie ist ein Prozessmodell, kein gemessener Benchmark und keine zugesicherte Einsparung.
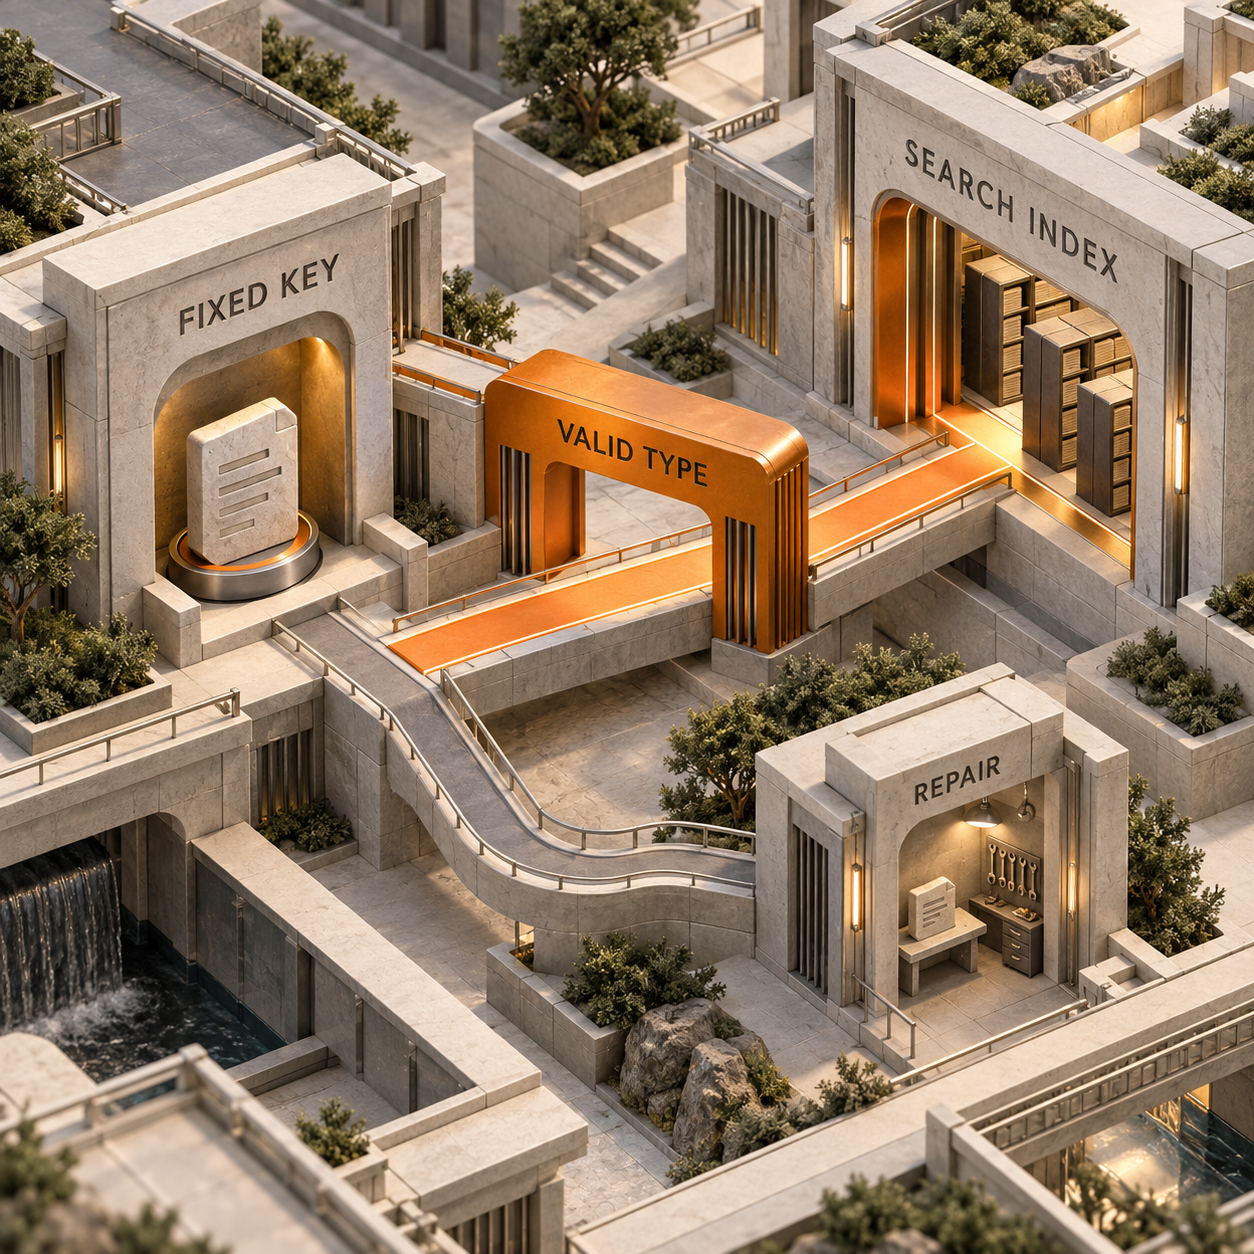
Die Tabelle enthält bewusst keine Kostenersparnis. Cloudflare hat für dieses Feature keine Zeitersparnis veröffentlicht, und das Release korrigiert vorhandene Metadaten nicht automatisch.
Welche Kosten weiterhin anfallen
Während der offenen Betaphase ist AI Search kostenlos, solange die Grenzen des jeweiligen Workers-Tarifs eingehalten werden. Speicher und Vektorindexierung sind enthalten. Die Nutzung von Workers AI und AI Gateway kann weiterhin separat berechnet werden; an diesen Preisen ändert die neue Aufnahmefunktion nichts.
Das Korrigieren von Metadaten kann sich dagegen auf die R2-Rechnung auswirken. ListObjects, PutObject und CopyObject zählen als Class-A-Operationen. HeadObject und GetObject, mit denen ein Reparatur-Tool ein Objekt gegebenenfalls prüft oder liest, zählen als Class-B-Operationen.
Beim Standard-Speicher kosten Class-A-Anfragen nach dem monatlichen Freikontingent von 1 Million $4.50 pro Million. Infrequent Access bietet kein Freikontingent und berechnet $9.00 pro Million Class-A-Anfragen. Werden Objekte gelesen oder kopiert, können zusätzlich $0.01 pro GB anfallen.
Daraus ergibt sich eine belastbare Budgetregel: Ein Objekt mit korrektem Content-Type erfordert keine umbenennungsspezifische Reparatur. Bei einem falschen Wert kann je nach eingesetztem Tool weiterhin ein Schreib- oder Kopiervorgang nötig sein. Vor einer Bereinigung des gesamten Buckets sollten diese Operationen gezählt werden.
Auch auf der Seite von AI Search ist die Größenordnung relevant. Im Workers-Free-Tarif liegt das Limit pro Instanz bei 100,000 Dateien. Workers Paid erlaubt 1 Million Dateien beziehungsweise 500,000 bei aktivierter Hybrid Search. Das Dateilimit von 4 MB gilt für beide Tarife.
Wer davon sofort profitiert
Solo-SaaS-Gründer mit stabilen Upload-IDs
Der bereits in der Datenbank gespeicherte R2-Schlüssel kann bestehen bleiben, während der Uploader beim Schreiben des Objekts den tatsächlichen MIME-Typ hinterlegt. Die Supportsuche kann dasselbe Objekt aufnehmen, ohne eine zweite Dateinamensspalte oder einen Batch-Job für Suchkopien zu benötigen.
Der Vorteil: Wenn ein Kunde ein Dokument ersetzt, löscht oder verschiebt, müssen weniger Identitäten abgeglichen werden. Der Upload muss einen generischen Binärtyp dennoch ablehnen, wenn das Objekt später durchsuchbar sein soll.
Plattformtechniker mit einem Legacy-Bucket
Zunächst werden Objekte ohne Dateiendung samt HTTP-Metadaten aufgelistet und ihre Werte mit den von Cloudflare unterstützten MIME-Typen abgeglichen. Fehlerfälle lassen sich so isolieren. Vor einer Bearbeitung des gesamten Buckets sollte eine kleine Stichprobe korrigiert werden.
So bleibt die Migration überschaubar: Das Reparaturbudget fließt nur in Objekte, bei denen es tatsächlich nötig ist. Schlüssel mit gültigen Metadaten wechseln direkt in die Synchronisierungs- und Prüfphase.
Produktteams mit mehreren Mandanten
Opake Objektschlüssel, die keine ursprünglichen Dateinamen preisgeben, können erhalten bleiben. Beim Upload setzt eine vertrauenswürdige serverseitige Prüfung den Content-Type. Pfadfilter oder Präfixe in AI Search werden davon getrennt konfiguriert, wenn jeder Mandant eine eigene Indexierungsgrenze benötigt.
Das sorgt für eine konsistente Architektur: Die Speicheridentität bleibt unabhängig von der Dateidarstellung, während der Indexer weiterhin einen validierbaren Typ erhält.
Agenturen, die Wissensdatenbanken für Kunden betreiben
Die beiden Metadatenaufgaben sollten im Runbook getrennt werden. Der HTTP-Content-Type entscheidet, ob eine Datei ohne Endung aufgenommen werden kann. Benutzerdefinierte x-amz-meta-*-Felder bestimmen nach Definition ihres Schemas, wie sich indexierte Ergebnisse filtern lassen.
Das vereinfacht die Fehlersuche: Fehlt ein Dokument, prüft das Team zuerst die Metadaten der Quellenaufnahme, bevor es Filterregeln oder das Antwortmodell ändert.
Cloudflare R2: Datei ohne Endung korrekt bereitstellen
Die R2 Workers API von Cloudflare nimmt Anfrage-Header als httpMetadata entgegen. Der folgende Worker behält den Anfragepfad als Objektschlüssel bei und lehnt Uploads ab, die ohne Content-Type eintreffen.
Ein R2-Bucket wird als DOCS in wrangler.jsonc gebunden:
{
  "$schema": "./node_modules/wrangler/config-schema.json",
  "name": "r2-document-upload",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-11",
  "r2_buckets": [
    {
      "binding": "DOCS",
      "bucket_name": "your-bucket"
    }
  ]
}
Anschließend kommt dieser Worker zum Einsatz:
interface Env {
  DOCS: R2Bucket;
}

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "PUT") {
      return new Response("Method Not Allowed", { status: 405 });
    }

    const key = new URL(request.url).pathname.replace(/^\//, "");
    const contentType = request.headers.get("content-type");

    if (!key || !contentType) {
      return new Response("Key and Content-Type are required");
    }

    await env.DOCS.put(key, request.body, {
      httpMetadata: request.headers,
    });

    return new Response(`Stored ${key}`);
  },
} satisfies ExportedHandler<Env>;
Nach npx wrangler dev wird WORKER_URL auf die von Wrangler ausgegebene lokale Adresse gesetzt. Anschließend lässt sich ein lokales PDF unter einem Ziel ohne Dateiendung hochladen:
curl "$WORKER_URL/documents/manual-alpha" \
  --request PUT \
  --header "Content-Type: application/pdf" \
  --data-binary @manual.pdf
Dieses Beispiel belegt nur, dass die Speicherung funktioniert – nicht die Indexierung. Für den Produktivbetrieb sind eine Autorisierung, eine vertrauenswürdige Inhaltsprüfung statt der alleinigen Ableitung aus einem vom Nutzer gelieferten Dateinamen und ein Abgleich mit der von Cloudflare unterstützten Liste erforderlich.
Erfolgreich hochgeladen heißt noch nicht durchsuchbar
Schreibvorgänge in R2 sind stark konsistent. Nach einem erfolgreichen Schreiben sind Objekt und Metadaten daher sichtbar. Die Indexierung in AI Search ist jedoch ein separater asynchroner Job. Eine Synchronisierungsanfrage kann angenommen werden, obwohl das Element später dennoch fehlschlägt.
R2-gestützte Instanzen werden standardmäßig alle 6 Stunden synchronisiert. Als Intervall stehen 1, 2, 4, 6, 12 oder 24 Stunden zur Wahl. Alternativ lässt sich ein Job manuell starten:
npx wrangler ai-search jobs create <INSTANCE_NAME>Manuelle Quellensynchronisierungen können höchstens einmal alle 30 Sekunden ausgeführt werden. Weitere Versuche beheben keine fehlerhaften Metadaten.
Nach Abschluss des Jobs sollten Elementprotokolle, Elementdetails oder Instanzstatistiken geprüft werden. unsupported_type ist der relevante Fehler auf Elementebene, wenn AI Search den erkannten Dateityp nicht akzeptieren kann. Nach der Korrektur des Objekts wird das einzelne Element oder die Quelle erneut synchronisiert.
Wer bereits für jeden R2-Schlüssel eine erkannte Dateiendung verwendet, ist von der Änderung nicht betroffen. Gleiches gilt, wenn AI Search statt eines externen R2-Buckets eine Website oder den integrierten Speicher als Quelle nutzt. Ein nicht unterstütztes Format oder eine zu große Datei wird durch das Update nicht indexierbar.
Der Fahrplan für Montag
Am Anfang steht ein Audit, keine pauschale Neuschreibung.
Übersprungene Objekte ohne Dateiendung finden
R2-Objekte einschließlich
httpMetadataauflisten, bistruncatedden Wert false hat, und Schlüssel herausfiltern, deren letztes Pfadsegment keine Dateiendung besitzt. Diese Schlüssel mit den Elementprotokollen von AI Search und Fehlern vom Typunsupported_typeabgleichen.Metadaten klassifizieren
Unterstützte MIME-Typen von fehlenden, fehlerhaften, nicht unterstützten und auf
application/octet-streamgesetzten Werten trennen. Benutzerdefiniertex-amz-meta-*-Felder gehören nicht in diese Prüfung, weil sie ein anderes Problem lösen.Kleine Importstichprobe korrigieren
Eine kleine, repräsentative Auswahl aus den tatsächlich gespeicherten Formaten zusammenstellen. Jedes Objekt mit dem korrekten HTTP-
Content-Typeschreiben oder kopieren und den ursprünglichen Schlüssel beibehalten, sofern das eingesetzte Tool dies zulässt.Synchronisieren und Abruf nachweisen
Eine Quellensynchronisierung auslösen, den Abschluss der Elemente abwarten und ihre Protokolle prüfen. Anschließend nach einer bekannten Formulierung aus jedem Dokument suchen. Ein erfolgreicher Speichervorgang ist nicht das Ziel; erst eine zurückgegebene Quellpassage liefert den Nachweis.
Erst nach erfolgreicher Prüfung ausweiten
Die durch das Reparaturverfahren entstehenden Class-A- und Class-B-Operationen schätzen, die R2-Speicherklasse bestätigen und erst dann den Batch vergrößern. Gleichzeitig den Uploader aktualisieren, damit neue Objekte ohne Dateiendung bereits mit unterstützten Metadaten eintreffen.
Noch in dieser Woche lohnt sich die Umstellung, wenn stabile oder opake R2-Schlüssel bisher einen zweiten Benennungspfad für AI Search erzwungen haben. Sind die Typinformationen vorhandener Objekte nicht vertrauenswürdig, sollte zunächst ein Klassifizierungsplan stehen. Wer bereits über erkannte Dateiendungen sauber indexiert, muss nichts ändern.
Wenn auch die nächste Plattformänderung in eine konkrete Betriebsentscheidung übersetzt werden soll, geht es hier zum Newsletter.
- Zuletzt aktualisiert
- 12. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained