Bloquear bots de IA en Cloudflare sin cerrar el paso a los buscadores
Configura Cloudflare para bloquear bots de IA dedicados al entrenamiento sin cerrar el acceso de los buscadores. Revisa la migración y el robots.txt.



Para bloquear bots de IA dedicados al entrenamiento sin cerrar el paso a los buscadores, configura Search en Allow, Training en Disallow AI Training y comprueba tanto los ajustes migrados como el archivo robots.txt que sirve Cloudflare. Es importante hacerlo ahora: el 15 de septiembre de 2026, Cloudflare cambió lo que significa Block. Desde entonces, esta opción también puede impedir que rastreadores de uso mixto como Googlebot, Applebot y Bingbot accedan a tu sitio para la búsqueda.
La configuración segura para bloquear bots de IA
Para la mayoría de los sitios que dependen de los buscadores, la decisión es sencilla: permitir Search, rechazar Training y decidir por separado qué pueden hacer los agentes.
La explicación de Cloudflare del 15 de septiembre no deja lugar a dudas: usa Disallow AI Training si quieres impedir el entrenamiento y mantener la búsqueda. No sigas una guía anterior que recomiende elegir Training: Block. Antes del cambio, el bloqueo no incluía a los rastreadores de uso mixto. Ahora sí.
El control está disponible en todos los planes de Cloudflare, por lo que no hay que pagar una ampliación específica. El costo deja de estar en comprar otro producto de bloqueo y pasa a comprobar que la política declarada coincida con el comportamiento real. Como referencia, una licencia de Screaming Frog SEO Spider cuesta $279 al año en EE. UU., mientras que un producto específico para vigilar robots.txt anuncia un plan de $129 al mes. Cloudflare aporta el control, pero todavía hace falta un ciclo de verificación.
Qué hace realmente Disallow AI Training
Disallow expresa una preferencia con aplicación selectiva; Block equivale a cerrar la puerta.
Imagina un rastreador de uso mixto como una furgoneta que lleva dos órdenes de trabajo. Una dice «indexar esta página para la búsqueda». La otra, «usar esta página para entrenar un modelo». Bloquear la furgoneta detiene ambas tareas. Disallow AI Training permite que un operador sujeto a compromisos mantenga la tarea de búsqueda y rechace la de entrenamiento.
Cloudflare divide el tráfico automatizado en tres comportamientos:
- Search crea un índice de búsqueda.
- Training entrena o ajusta un modelo.
- Agent visita el sitio por encargo de una persona, como un asistente que consulta una página o un agente que utiliza el navegador.
La nueva opción de Training indica a Bot Preference Sync que publique en robots.txt las instrucciones pertinentes para impedir el entrenamiento. Los rastreadores de uso mixto que cumplen los requisitos siguen pudiendo acceder con fines de búsqueda. Los rastreadores dedicados al entrenamiento de Amazon, Anthropic, Meta y OpenAI quedan bloqueados sin arrastrar con ellos a sus rastreadores de búsqueda independientes.
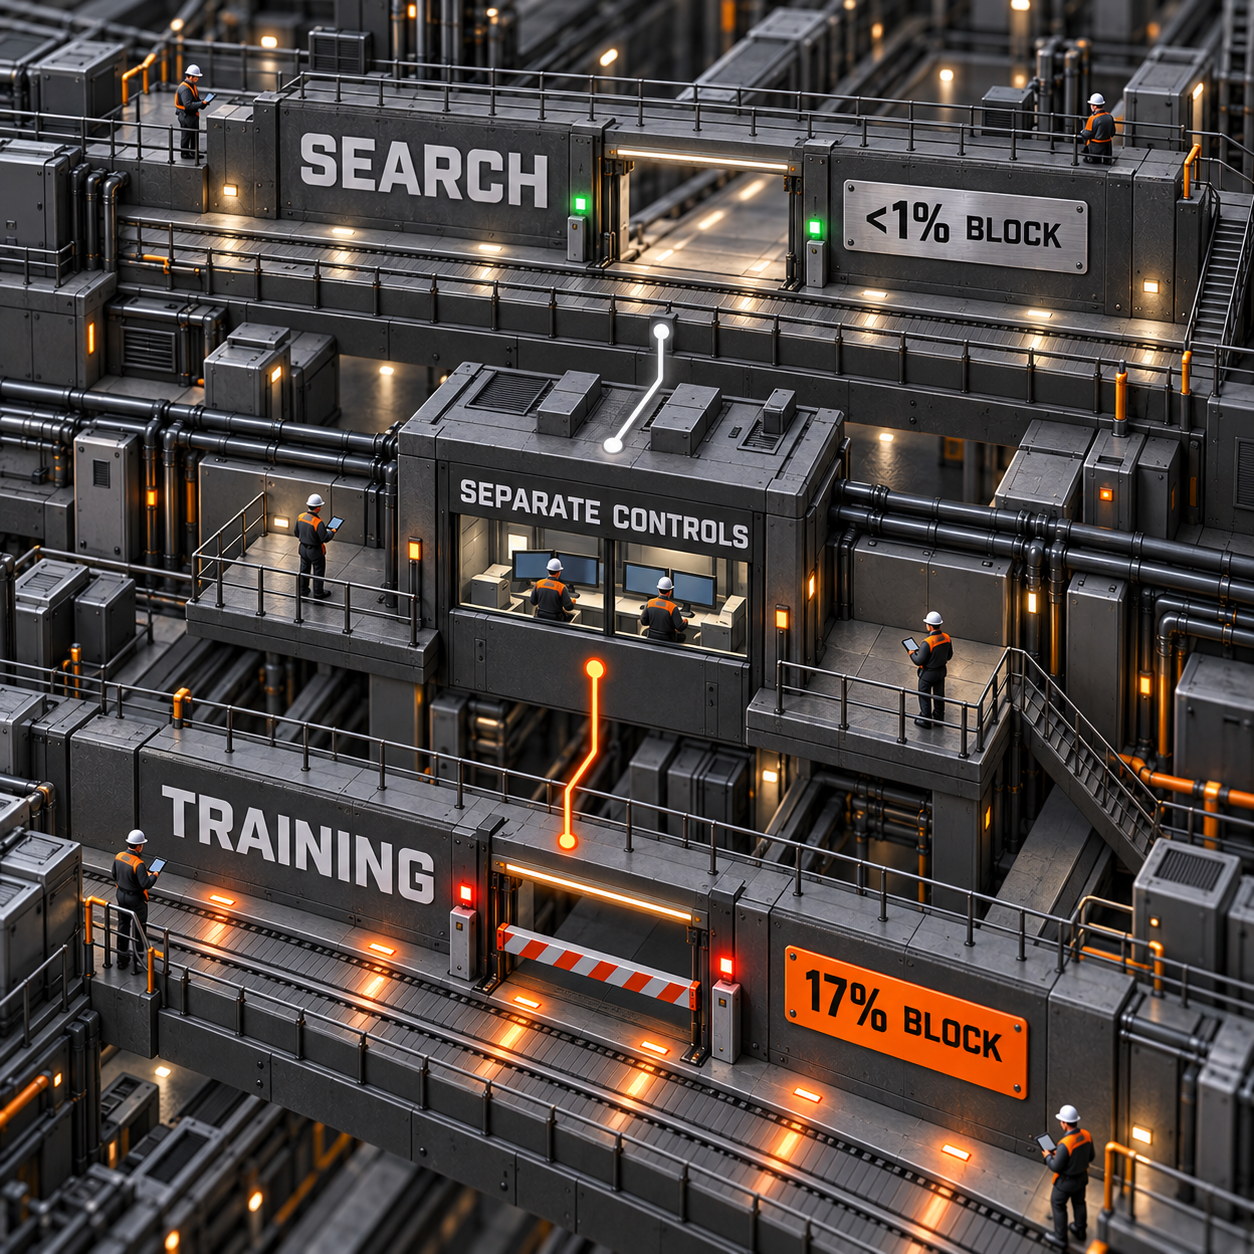
Cloudflare informa que menos del 1% de sus sitios bloquea los bots de Search, mientras que el 17% activa algún mecanismo para bloquear Training. Esa distancia explica el diseño del producto. Un único interruptor para bloquear la IA era demasiado tosco para lo que realmente buscan los propietarios de sitios.
Hay una distinción importante: una instrucción de robots.txt no es un campo de fuerza. Por sí sola, no puede identificar quién rastrea, saber con qué propósito lo hace ni detener a quien decide ignorarla. Cloudflare combina la preferencia publicada con la clasificación de red y el bloqueo de los rastreadores que no reúnen las condiciones de la vía responsable.
Accountable no siempre significa disponible hoy
La etiqueta Accountable de Cloudflare debe entenderse como un estado respaldado por una hoja de ruta, no como prueba de que cada control prometido ya existe.
Para obtenerla, un operador debe cumplir —o comprometerse a cumplir— requisitos sobre la exclusión del entrenamiento, la exclusión de resúmenes de IA, la visibilidad por URL y la garantía de que rechazar el entrenamiento no perjudicará la búsqueda tradicional. Ese matiz importa.
- Google: Google-Extended puede excluirse mediante robots.txt, y Google afirma que esa decisión no afecta el posicionamiento en la búsqueda. También ofrece un control para webmasters sobre la búsqueda generativa y sus informes. La transparencia adicional de Google-Extended por URL todavía se describía como una función prevista para las semanas posteriores al anuncio.
- Apple: Applebot-Extended admite la exclusión del entrenamiento mediante robots.txt. Apple también admite
nosnippetpara los resúmenes de IA y el etiquetado de muros de pago. La inspección por URL no estaba disponible el día del anuncio y se presentó como trabajo para el año siguiente. - Microsoft: la vía actual de Bing es distinta. Los propietarios de sitios pueden utilizar
NOARCHIVEjunto con las herramientas Block URLs o Content Removal de Bing. Microsoft prevé que Bingbot respete una preferencia de no entrenamiento a nivel de dominio a comienzos de 2027. Hasta entonces, Disallow AI Training de Cloudflare no envía automáticamente esa preferencia a Bing mediante robots.txt.
Por eso, la promesa honesta es más limitada que «un interruptor controla todos los usos en todas partes». La nueva opción aclara mucho mejor la decisión segura entre búsqueda y entrenamiento, pero hoy Bing todavía exige una comprobación aparte.
Comprueba qué migró Cloudflare
La mayoría de los ajustes se trasladan de forma automática, pero las etiquetas y sus efectos cambiaron lo suficiente como para justificar una auditoría.
Si un dominio nunca utilizó los controles granulares de Search, Training y Agent, Cloudflare transforma el ajuste anterior Block AI Bots de esta manera:
Si el dominio ya usaba los controles granulares, Search y Agent conservan su estado práctico. Training: Allow sigue como Allow. Tanto Training: Block como Training: Block on pages with ads se convierten en Disallow AI Training.
Realiza esta comprobación de la migración:
- Abre el dominio en Cloudflare, ve a Security Settings y después a Configure AI bot policies.
- Anota los valores actuales de Search, Training y Agent antes de modificar nada.
- Configura Search como Allow si el descubrimiento orgánico es importante.
- Configura Training como Disallow AI Training si quieres rechazar el entrenamiento sin retirar de la búsqueda a los rastreadores de uso mixto que cumplen los requisitos.
- Elige la política de Agent según sus propios méritos. Cloudflare no ofrece una preferencia Disallow para los agentes porque todavía no existe una directiva establecida en Internet.
- Confirma que Bot Preference Sync esté activado si quieres que Cloudflare publique la política por categorías en robots.txt.
- Guarda la política y examina después el resultado público; la etiqueta del panel, por sí sola, no demuestra nada.
En los dominios nuevos financiados con anuncios, la configuración recomendada por Cloudflare ya sigue este patrón: Preference Sync activado, Search permitido, Training rechazado y los agentes bloqueados en las páginas con anuncios. Los dominios nuevos que no monetizan con publicidad comienzan con los tres comportamientos permitidos.
Cómo verificar el acceso de los buscadores tras el cambio
Que el interruptor parezca correcto es apenas el primer punto de control. Verifica la política desde fuera hacia dentro.
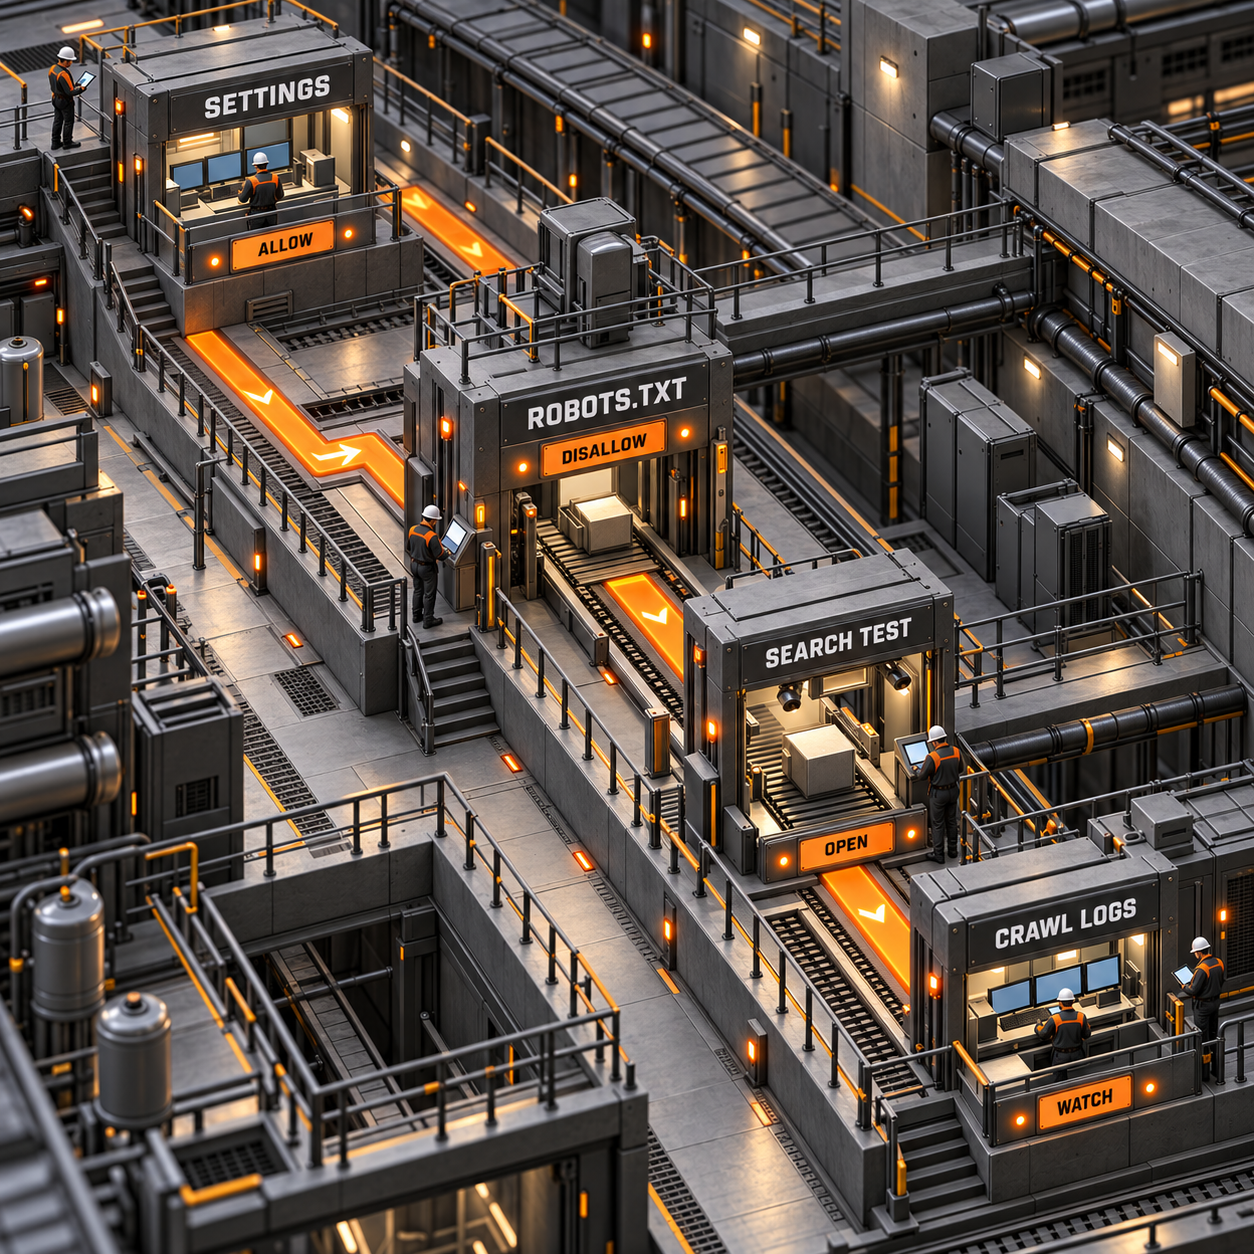
Aplica esta comprobación en cuatro partes:
- Ajustes: confirma que Search indique Allow y Training, Disallow AI Training. Revisa Agent por separado.
- robots.txt: solicita el archivo
/robots.txtpublicado en el dominio. Bot Preference Sync antepone sus reglas generadas a un archivo existente, de modo que tus directivas Disallow originales permanecen. Busca conflictos en ambas secciones. - Comportamiento en buscadores: utiliza las herramientas para webmasters y los informes del buscador para revisar URL representativas. No deduzcas el acceso de búsqueda solo por la palabra «Disallow». Se aplica a la identidad o preferencia de entrenamiento, no al propósito de búsqueda tradicional de un rastreador de uso mixto sujeto a compromisos.
- Actividad de rastreadores: consulta AI Crawl Control para revisar solicitudes, cumplimiento de robots.txt y bloqueos inesperados. Cloudflare permite aplicar acciones por rastreador y registra la actividad, por lo que es el lugar práctico para detectar una política cuyo comportamiento no coincide con la intención.
Las reglas personalizadas merecen especial atención. Bot Preference Sync refleja una política para toda una categoría, pero no incorpora al archivo generado la lógica de reglas individuales complejas. Si existe una excepción de licencia para un rastreador, lógica específica por ruta o una regla WAF personalizada, compara esas capas manualmente. Cloudflare permite desactivar Sync y mantener el archivo de forma manual cuando una política por categorías resulta demasiado amplia.
Quién obtiene más valor de esta separación
El mayor beneficiario es cualquier negocio que gana dinero cuando una persona llega a la página, pero no quiere que su archivo termine absorbido como datos de entrenamiento.
El ejemplo del comercio también revela una limitación: estos controles operan a nivel de dominio. No constituyen un sistema integrado de consentimiento por artículo. Las zonas separadas pueden aplicar políticas distintas, pero cada zona adopta una sola postura para Search, Training y Agent, salvo que se añadan reglas más específicas.
Qué conviene construir
La oportunidad más sólida es un monitor de regresiones en la política de rastreadores, no otro generador de robots.txt.
1. Monitor de regresiones de políticas de rastreo
Crea para agencias y equipos que gestionan varios sitios un monitor que lea la política de Cloudflare, solicite el robots.txt publicado, compruebe el acceso representativo de los buscadores y envíe una alerta cuando esas capas se desalineen.
La demanda alrededor de esta tarea es visible: robots.txt generator recibe unas 1,000 búsquedas mensuales en EE. UU. y google indexing checker, alrededor de 110. Las herramientas existentes también demuestran que hay presupuesto. Un producto para vigilar robots.txt anuncia $129 al mes en su plan para cinco dominios, mientras que un monitor de cambios SEO de escritorio cuesta $179 en un solo pago.
La versión mínima vendible necesita cuatro elementos: importar zonas de Cloudflare, comparar la política con robots.txt, ejecutar comprobaciones programadas y enviar una alerta por correo electrónico o Slack con el cambio exacto. La actividad de los rastreadores y los datos para webmasters pueden añadirse cuando el detector básico de desajustes ya resulte fiable.
El límite está en la prueba. La configuración y las solicitudes observadas pueden mostrar qué publicó y bloqueó el sitio. No pueden demostrar que un proveedor de modelos haya eliminado datos recopilados con anterioridad. La ventaja competitiva debe ser una evidencia fiable para muchos dominios, no un interruptor más atractivo.
2. Auditor de migración de Cloudflare
Crea una auditoría específica que encuentre zonas con combinaciones todavía arriesgadas tras la migración y genere un informe de corrección para una agencia, un grupo editorial o una red de franquicias.
cloudflare block ai bots recibe unas 50 búsquedas mensuales en EE. UU. con un CPC de $13.19, y google indexing checker suma otras 110 búsquedas mensuales relacionadas con el resultado que se quiere evitar. Es una demanda menor que la del mercado de generadores, pero el precio del clic sugiere que quien busca tiene un problema operativo real.
El MVP puede leer los campos de la API correspondientes a Search, Training, Agent y Bot Preference Sync, solicitar el robots.txt público y clasificar cada zona como segura para la búsqueda, bloqueada a propósito o incoherente. El resultado debe ser un paquete de evidencias listo para el cliente, con el ajuste y el archivo observado uno junto al otro.
El límite es el riesgo de plataforma. Cloudflare podría añadir el mismo informe para carteras, y la necesidad aumenta alrededor de las migraciones. El mejor negocio consiste en usar la auditoría como producto de entrada y vender después una vigilancia continua de regresiones en Cloudflare y otros proveedores de infraestructura perimetral.
Lo que este control no resuelve
Este es un límite de política más claro, no una respuesta completa al uso de contenido por parte de la IA.
- No borra material ya recopilado. Cloudflare describe preferencias de rastreo y controles de solicitudes, no una eliminación retroactiva.
- No garantiza que todos los operadores respeten robots.txt. Cloudflare añade aplicación en la red para los rastreadores ajenos a la vía Accountable, pero la vía de uso mixto todavía depende de que el operador respete la preferencia.
- No excluye el sitio de todos los resúmenes de IA. Los controles de resúmenes son independientes, y Cloudflare presenta un control centralizado más amplio sobre estos resúmenes como trabajo futuro.
- No ofrece un estado Disallow para los agentes.
- No traslada reglas personalizadas complejas por rastreador a Bot Preference Sync.
- Todavía no expresa automáticamente en robots.txt la preferencia de no entrenamiento de Bing. Revisa por separado
NOARCHIVEy los controles actuales para webmasters de Bing. - No es la indexación de archivos de R2 mediante Cloudflare AI Search. Ese es otro producto y otro flujo de trabajo.
Elige Block cuando de verdad quieras que el rastreador desaparezca. Elige Disallow AI Training cuando el descubrimiento mediante buscadores siga formando parte del modelo de negocio. Esa distinción es el sentido del cambio de septiembre.
Tu próximo paso el lunes
Elige tres dominios representativos la próxima semana: un sitio financiado con publicidad, un sitio impulsado por la búsqueda y un dominio con reglas de rastreo personalizadas. Registra los valores migrados de Search, Training y Agent, cambia solo los sitios cuyo objetivo de negocio esté claro y guarda el robots.txt publicado y el informe de rastreadores junto al ticket del cambio. Si los tres superan la prueba, aplica la misma revisión basada en evidencias a toda la cartera.
¿Cómo impedir el entrenamiento de IA?
En un dominio gestionado por Cloudflare, configura Training como Disallow AI Training si quieres publicar una preferencia contraria al entrenamiento y mantener disponibles para la búsqueda los rastreadores de uso mixto que cumplen los requisitos. Usa Block solo si también aceptas el efecto sobre la búsqueda de esos rastreadores.
¿Se puede bloquear todo el contenido de IA?
Es posible bloquear categorías o rastreadores individuales, pero «todo el contenido de IA» mezcla varias funciones distintas. Cloudflare separa el tráfico de Search, Training y Agent para que puedas decidir qué usos automatizados permites. Bloquear Training no elimina de los productos de búsqueda el material generado por IA ni borra los datos ya recopilados.
¿Cómo desactivo el modo IA en la búsqueda?
El ajuste de rastreadores de Cloudflare no desactiva para los usuarios una experiencia de búsqueda con IA. Controla el acceso a tu dominio. Google y otros operadores ofrecen controles separados para los resúmenes generativos, mientras que la indexación tradicional y las preferencias de entrenamiento siguen siendo decisiones distintas.
Si quieres que construya para tu empresa esta capa de auditoría y vigilancia de políticas de rastreo, consulta sistemas de IA en producción.
- Última actualización
- 16 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Memoria de agentes de IA (AI agent memory): usos y costos
Aprende qué debe conservar un agente de IA: contexto, sesiones, memoria persistente y archivos. Compara costos y evita datos obsoletos o cruces entre usuarios.5 oct 2026Build
Pinecone pricing: planes y costos de 1M a 100M de vectores
Precios de Pinecone verificados en octubre de 2026: Starter gratis, Builder a $20, mínimos de pago y costos de 1M a 100M de vectores según las consultas.5 oct 2026Build
Lovable gratis y alternativas: precios, límites y cómo elegir
Compara Lovable gratis y sus alternativas por créditos, backend y exportación. Revisa precios, límites y qué implica migrar una app que ya funciona.5 oct 2026Build
LLM observability en 2026: qué herramienta conviene a tu equipo y cuánto cuesta
Compara Langfuse, LangSmith, Helicone, Phoenix, Braintrust y Datadog por tamaño de equipo, costos para 100,000 ejecuciones mensuales y opciones de alojamiento.5 oct 2026Build
OpenCode: tu agente de IA para programar, paso a paso
Aprende a usar OpenCode: instala el agente, conecta tus modelos, configura AGENTS.md y plugins, revisa los cambios y entiende los costos de API y Zen.4 oct 2026Build
Netlify gratis y de pago: planes, créditos y costos en 2026
Compara Netlify gratis, Personal y Pro: precios en USD, consumo de créditos y presupuestos mensuales para un sitio, una app Next.js o una agencia.4 oct 2026Build
Softr: opiniones, precios y límites para elegir bien
Descubre si Softr encaja con tu portal de clientes o herramienta interna: precios, permisos, límites de usuarios y registros, funciones de IA y alternativas.4 oct 2026Build