OpenAI API pricing : quels budgets pour GPT-6.1 Sol ?
Tarifs de l’API OpenAI vérifiés en octobre 2026 : budgets GPT-6.1 Sol, Luna et Astra, coûts de recherche, de conteneurs, d’audio et d’images.



La grille OpenAI API pricing fait de GPT-6.1 Sol un point de départ raisonnable pour l’agent de développement d’une petite équipe : $2 par million de tokens en entrée, $0.10 pour l’entrée en cache et $10 en sortie. Dans les budgets mensuels présentés ci-dessous, confier le support ciblé et les résumés par lots à GPT-6 Luna, tout en gardant Sol pour le développement, revient à $159.40 pour les usages API précisés. Choisissez GPT-6 Astra lorsque le travail qu’il vous épargne justifie sa facture plus élevée.
Tarifs vérifiés sur la page de tarification de l’API OpenAI le 3 octobre 2026. Tous les tarifs du fournisseur ci-dessous proviennent de cette page. Les volumes de travail sont des hypothèses explicites ; les calculs s’appuient sur ces tarifs.
L’API OpenAI est l’interface que votre application appelle et dont l’usage est facturé à la consommation. La facture dépend de ce que vous envoyez au modèle, de ce qu’il génère et des outils payants utilisés par l’application.
OpenAI API pricing : quels sont les tarifs des modèles ?
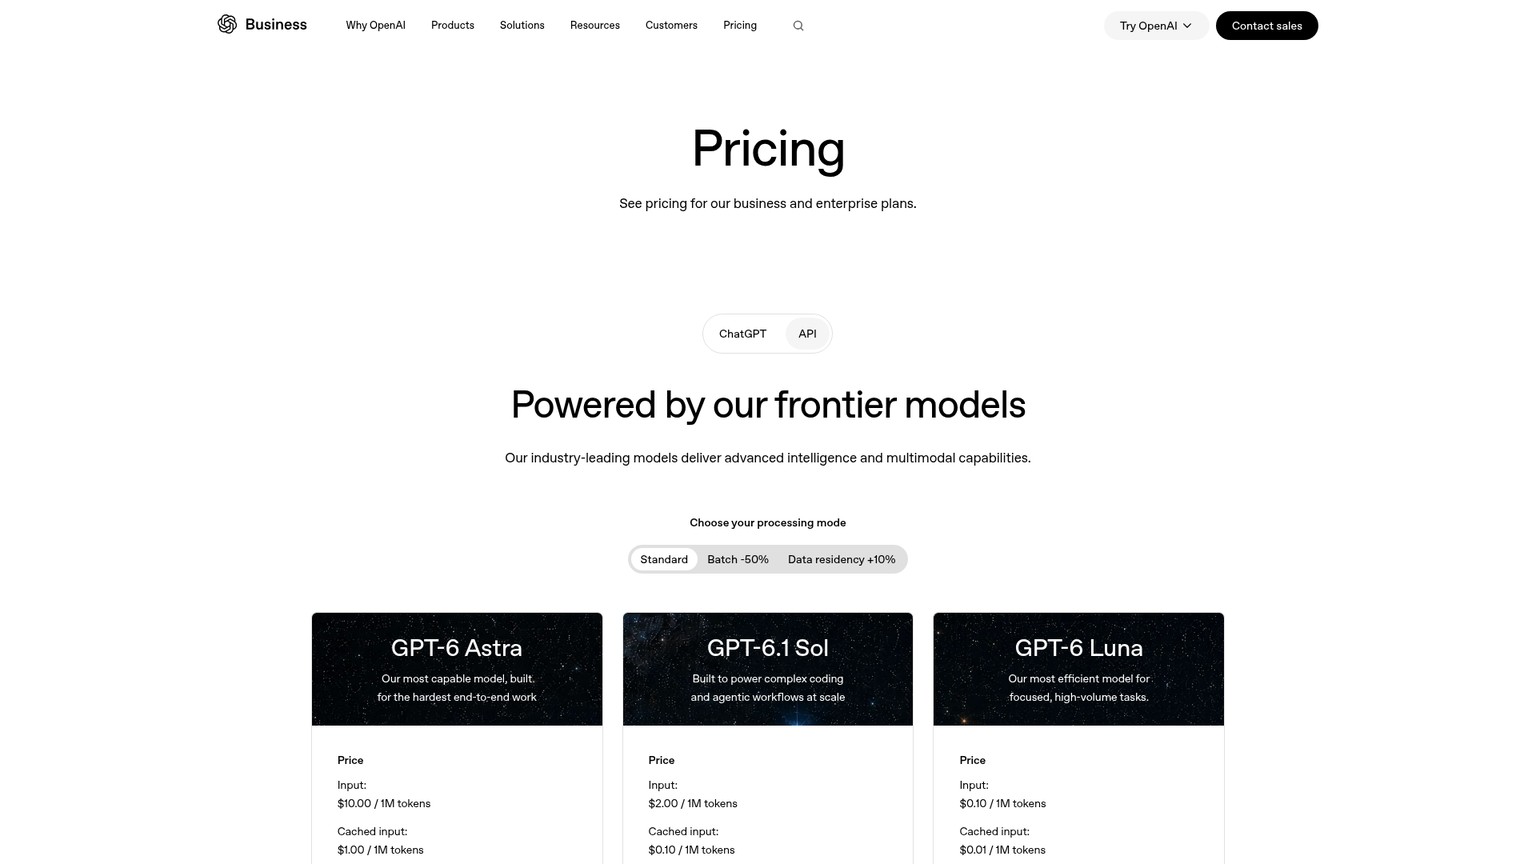
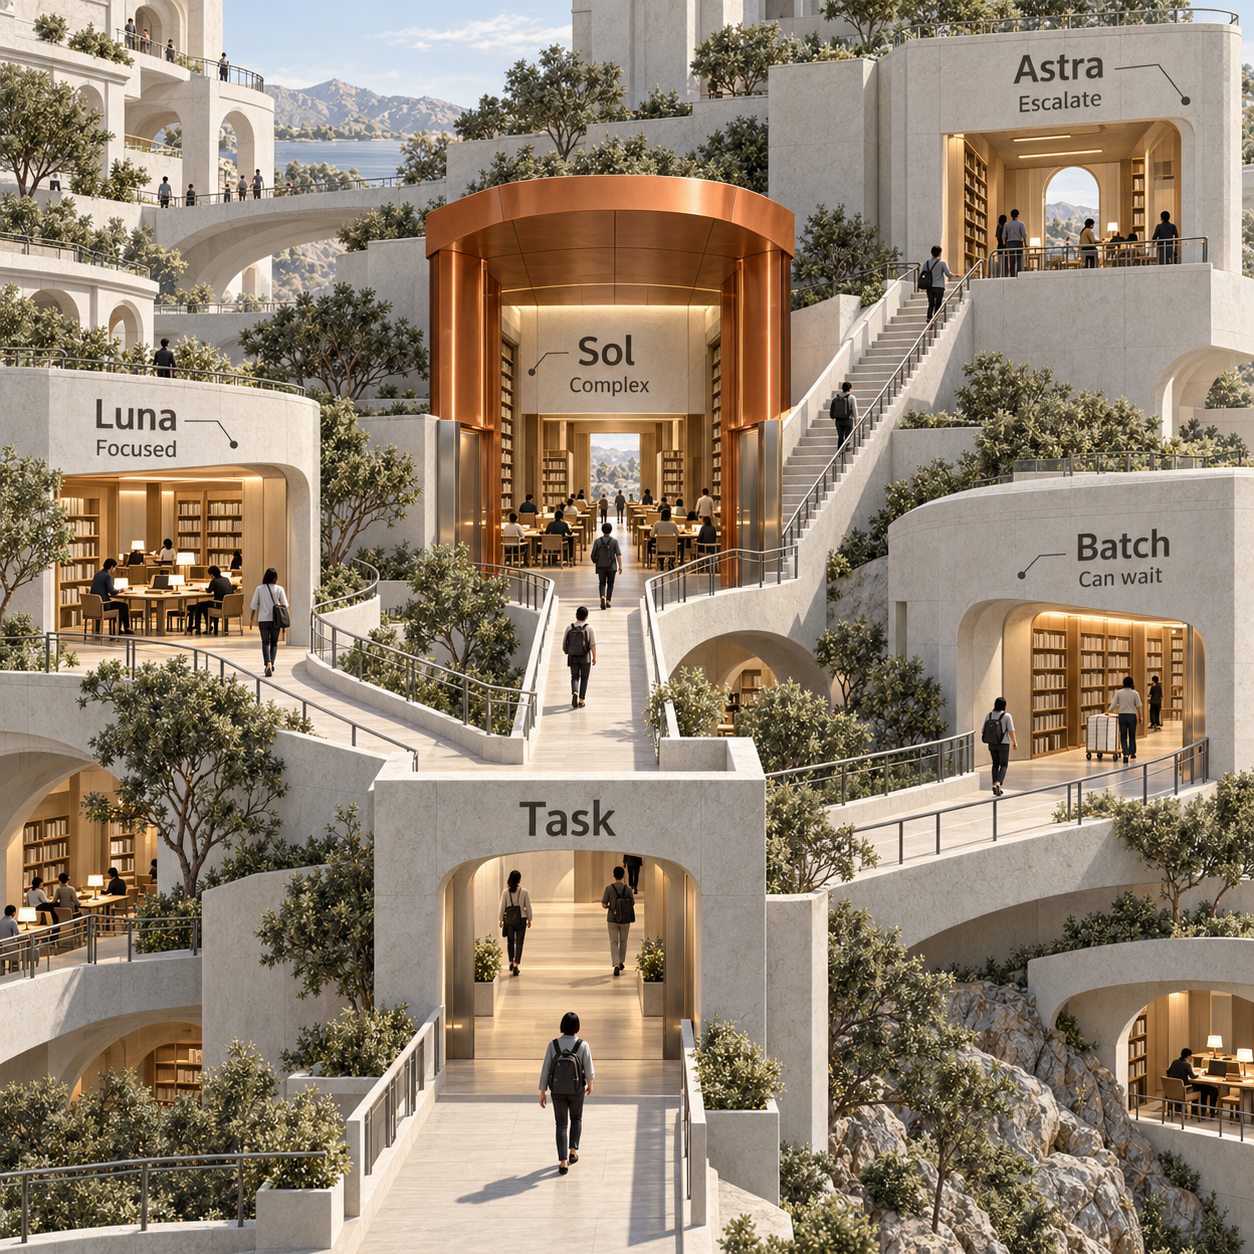
GPT-6.1 Sol coûte $2 en entrée, $0.10 pour l’entrée en cache et $10 en sortie par million de tokens. OpenAI le destine au développement complexe et aux workflows d’agents. GPT-6 Luna vise les tâches ciblées à fort volume, tandis que GPT-6 Astra s’adresse aux missions les plus difficiles à réaliser de bout en bout.
Le tableau reprend l’ensemble des modèles mis en avant dans l’onglet de tarification API consulté. Il ne constitue pas un catalogue historique. Les tarifs par tokens sont exprimés en USD pour 1M de tokens. Les lignes facturées à la durée indiquent explicitement les minutes et les secondes. Pour les trois principaux modèles de texte, les tarifs correspondent au traitement Standard avec un contexte inférieur à 272K, c’est-à-dire la quantité de contenu transmise dans une requête. Cette condition délimite un tarif ; elle n’indique pas la capacité de contexte maximale des modèles.
Source : tarifs de l’API OpenAI, vérifiés en octobre 2026. « Non indiqué » signifie que la source ne fournit pas ce tarif, et non qu’elle accorde un quota gratuit en sortie. « Non ventilé » signifie que le prix affiché repose sur la durée, sans distinguer les tokens d’entrée et de sortie.
GPT-6 Sol ne figure pas dans les lignes de tarifs API de cette page. Son nom diffère de GPT-6.1 Sol : cet état des lieux n’attribue donc aucun prix à l’ancien modèle et ne lui applique pas implicitement les tarifs du nouveau. Les modèles et unités de facturation absents de la source, notamment les tarifs des embeddings, sortent du périmètre de cette grille.
Quel modèle choisir par défaut dans une petite équipe ?
Pour un agent de développement ou une application généraliste, commencez par GPT-6.1 Sol, puis justifiez chaque changement par les résultats du travail accompli. Cette recommandation découle du positionnement annoncé par le fournisseur et des calculs de budget. Elle ne repose pas sur un classement de performances mesuré de manière indépendante.
Les tarifs d’entrée hors cache et de sortie de Sol représentent un cinquième de ceux d’Astra. Son tarif d’entrée en cache en représente un dixième. Pour une petite équipe qui cherche encore à déterminer le contexte nécessaire à son agent, Sol offre ainsi une base pratique : vous pouvez évaluer le travail avant de payer le surcoût d’Astra sur chaque requête.
Réservez Luna à une tâche bien délimitée, avec des critères de validation clairs. Un outil qui classe les demandes de support dans des catégories connues, ou un outil de résumé dont le résultat peut être vérifié à partir de la source, s’y prête mieux qu’une mission de développement ouverte. Ce sont des pistes de déploiement, pas une affirmation selon laquelle ces modèles ont déjà réussi vos tests. Le faible tarif de Luna perd son intérêt lorsque les échecs coûtent plus cher que les économies de tokens.
Gardez Astra disponible pour les tâches dont les échecs coûtent cher. Dans l’exemple de développement ci-dessous, choisir Astra plutôt que Sol ajoute $410 par mois, à usage facturé identique. Le passage à Astra devient rentable s’il évite davantage de frais de reprise. Un prix élevé ne prouve pas, à lui seul, que ce sera le cas.
Si votre équipe utilise déjà GPT-6 Sol, conservez son budget actuel jusqu’à pouvoir comparer l’usage réellement facturé et les résultats validés avec ceux de GPT-6.1 Sol. Cette page ne fournit aucun tarif pour l’ancien Sol permettant de calculer une économie liée à la migration.
Combien coûte un million de tokens ?
Il n’existe pas de prix unique pour un million de tokens OpenAI. Un token est une unité de contenu traitée par le modèle. L’entrée correspond au contenu envoyé ; la sortie, au contenu généré qui vous est facturé. L’entrée en cache est une entrée réutilisée que l’API facture au tarif réduit du cache.
Un million de tokens d’entrée hors cache plus un million de tokens de sortie coûtent $60 sur Astra, $12 sur Sol ou $0.60 sur Luna. Cela représente deux millions de tokens facturés. Un million de tokens au total, répartis à parts égales entre entrée hors cache et sortie, coûtent respectivement $30, $6 ou $0.30.
Pour calculer la facture d’un modèle de texte, séparez l’entrée hors cache de l’entrée en cache :
Coût des tokens = entrée hors cache / 1M × tarif d’entrée + entrée en cache / 1M × tarif du cache + sortie / 1M × tarif de sortie.
Si votre relevé d’usage indique l’entrée totale et l’entrée en cache, l’entrée hors cache correspond à la différence entre les deux. Facturer toute l’entrée au tarif hors cache, puis ajouter l’entrée en cache, revient à compter cette dernière deux fois.
Sur Sol, l’entrée en cache coûte 95% moins cher que l’entrée hors cache. Mais un million de tokens de sortie coûtent toujours autant que 100 millions de tokens d’entrée en cache. Une forte économie sur le cache ne justifie pas de générer du contenu sans limite. Comptez toute la sortie facturée pendant la mission de l’agent, au lieu de budgéter seulement la réponse finale visible par l’utilisateur.
Calculer le prix de l’API OpenAI : trois budgets mensuels
Avec la répartition proposée, les trois usages coûtent $159.40 par mois. Cet exemple aide une petite structure à prévoir le budget de son application. Il ne s’agit ni d’une facture mesurée en production ni d’une promesse de résultats équivalents entre les modèles.
Chaque requête est supposée respecter la condition de contexte inférieur à 272K associée aux tarifs Standard de la source. Les volumes en cache correspondent à des accès au cache réellement facturés comme tels. Les volumes de sortie incluent toute la sortie facturée sur l’ensemble des appels. L’activité des outils est incluse lorsqu’elle est précisée ; les abonnements, l’hébergement et les autres unités de facturation non mentionnées sont exclus. Les calculs utilisent les tarifs OpenAI en vigueur.
Bot de support : $13.90 avec Luna
Prenons 10,000 conversations par mois. Sur l’ensemble des appels d’une conversation, prévoyez 1,000 tokens d’entrée hors cache, 4,000 tokens d’entrée en cache et 500 tokens de sortie. Les totaux mensuels sont de 10M en entrée hors cache, 40M en entrée en cache et 5M en sortie. Ajoutons 1,000 appels de recherche web dans le mois.
Avec Luna, les tokens coûtent :
10 × $0.10 + 40 × $0.01 + 5 × $0.50 = $3.90.
Les recherches ajoutent $10, pour un total de $13.90, soit $1.39 pour 1,000 conversations. À usage identique, Sol coûte $74 en tokens et $10 en recherches, soit $84. Astra coûte $390 en tokens et $10 en recherches, soit $400.
Luna est le candidat économique si le bot assure une mission de support bien délimitée et que ses réponses respectent vos critères de validation. Ce calcul suppose que le contenu réutilisé bénéficie effectivement du tarif en cache. Sans accès au cache, les 50M de tokens d’entrée sont tous facturés hors cache : le sous-total des tokens de Luna passe à $7.50 et le total à $17.50. C’est cette sensibilité qu’il faut consigner avant de considérer un accès attendu au cache comme une économie acquise.
Agent de développement : $140 avec Sol
Prenons 1,000 tâches de développement par mois. Sur l’ensemble des échanges d’une tâche, prévoyez 15,000 tokens d’entrée hors cache, 100,000 tokens d’entrée en cache et 5,000 tokens de sortie. Le mois représente donc 15M en entrée hors cache, 100M en entrée en cache et 5M en sortie. Une tâche peut comprendre plusieurs requêtes ; ces volumes sont les totaux par tâche.
Ajoutons 2,000 appels de recherche web et 1,000 sessions de conteneur, chacune utilisant 1 GB et l’unité de session de 20 minutes indiquée par la source.
La facture de tokens de Sol est la suivante :
15 × $2 + 100 × $0.10 + 5 × $10 = $90.
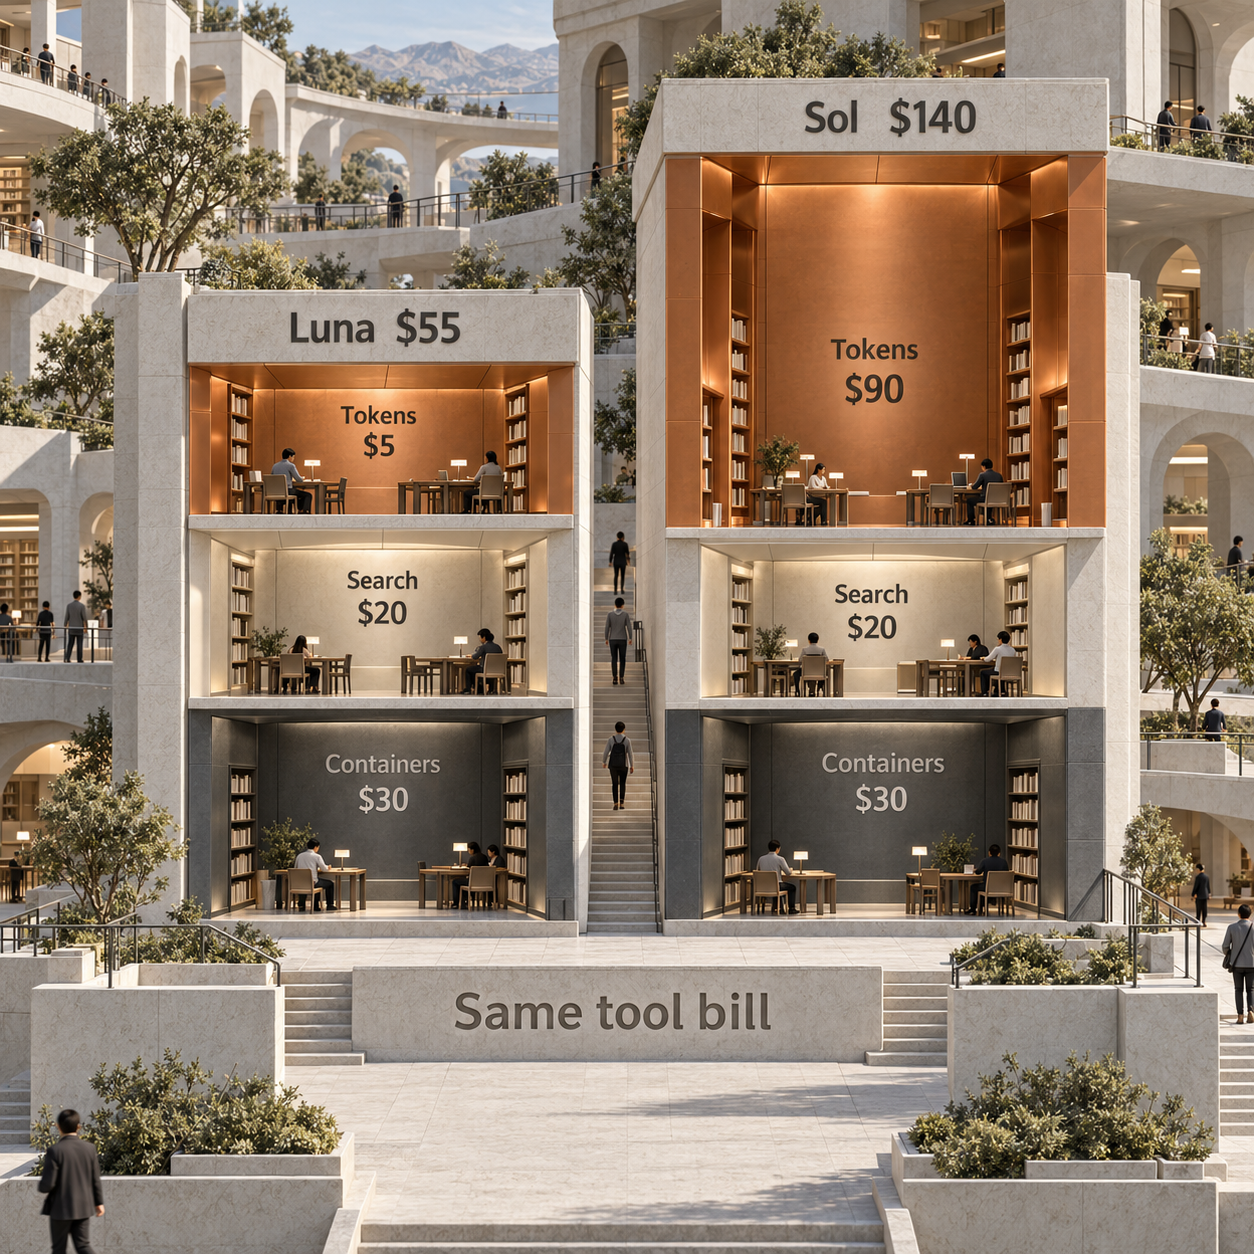
Les recherches coûtent $20 et les conteneurs 1,000 × $0.03 = $30. Le total atteint $140 par mois, soit $0.14 par tâche.
À volumes facturés identiques, Astra coûte $500 en tokens et les mêmes $50 en outils, soit $550 au total. Luna coûte $5 en tokens et $50 en outils, soit $55 au total.
Un modèle moins cher ne supprime pas la facture des outils. Passer de Sol à Luna économise $85 par mois dans cet exemple. Si le code produit entraîne plus de $85 de reprises supplémentaires, l’économie disparaît. Passer à Astra exige la démonstration inverse : assez de reprises évitées pour justifier son surcoût de $410. C’est la règle de décision qu’une comparaison limitée aux tokens ne peut pas fournir.
Résumés par lots : $5.50 avec Luna
Prenons 20,000 documents par mois, avec chacun 4,000 tokens d’entrée hors cache et 300 tokens de sortie. Cela représente 80M de tokens d’entrée et 6M de tokens de sortie. Nous ne prévoyons ni accès au cache ni frais d’outils, et les résumés peuvent être traités de façon asynchrone dans le délai de 24 heures de l’API Batch.
Le coût des tokens de Luna en Standard serait de 80 × $0.10 + 6 × $0.50 = $11. La remise Batch de 50% indiquée par la source le ramène à $5.50 par mois, soit $0.275 pour 1,000 résumés.
Les mêmes volumes traités en Batch coûtent $110 sur Sol et $550 sur Astra. Utilisez le modèle moins cher lorsque les résumés atteignent le niveau attendu ; confiez les documents difficiles à un modèle plus puissant lorsque le coût de leur correction le justifie. Un client qui attend une réponse immédiate représente un autre usage : son budget ne doit pas être calculé comme celui d’un traitement Batch asynchrone.
Le budget mensuel total
La répartition proposée donne $13.90 pour le support sur Luna + $140 pour le développement sur Sol + $5.50 pour les résumés Batch sur Luna = $159.40.
Utiliser Sol pour les trois usages coûte $334. Utiliser Astra pour les trois coûte $1,500. Utiliser Luna pour les trois coûte $74.40, à condition que son travail soit acceptable. Ces comparaisons gardent constants les volumes de tokens et d’outils facturés ; elles ne supposent pas que les modèles nécessitent le même nombre de tentatives en pratique.
Pour l’exploitant d’une application, cette distinction détermine la facture. Un modèle qui demande davantage d’échanges peut consommer davantage d’entrée, de sortie, d’appels de recherche et de sessions. Comparez le coût par conversation validée, tâche de développement accomplie ou résumé utilisable avant d’appliquer le tarif le plus bas à tout le produit.
API Batch OpenAI : tarifs et résidence des données
Batch réduit de 50% les frais d’entrée et de sortie affichés ; la résidence des données ajoute un surcoût annoncé de 10%. La page de tarification d’OpenAI présente ces options de traitement séparément des tarifs Standard.
Batch exécute les tâches de façon asynchrone sur 24 heures. Il convient aux résumés de documents pendant la nuit, à la catégorisation et aux autres tâches dont l’échéance autorise ce délai. Dans l’exemple de résumé, la remise porte uniquement sur l’entrée hors cache et la sortie. Le calcul ne suppose donc aucune remise sur l’entrée en cache ou sur les frais d’outils.
Pour un sous-total de tokens de modèle de $90, le surcoût de résidence porte la facture à $99, soit $9 supplémentaires. Cet exemple ne permet pas de savoir si les recherches ou les conteneurs reçoivent le même traitement, ni comment la résidence se combine avec les autres modes. L’onglet de tarification ne donne pas assez de détails pour calculer ces combinaisons ici.
La page décrit également le mode Fast et le traitement Flex. Fast est une option de rapidité facturée à la consommation ; Flex propose un coût réduit en contrepartie de réponses plus lentes et d’une indisponibilité occasionnelle. Cet onglet ne fournit de tarif précis pour aucun des deux : aucun multiplicateur inventé n’est donc appliqué à ces budgets.
Les outils peuvent fixer le coût minimal
Comptez les appels de recherche et les sessions de conteneur séparément des tokens du modèle. L’estimation des tokens peut être correcte alors que le budget mensuel reste trop bas, parce qu’une tâche mobilise d’autres ressources payantes.
Combien coûte la recherche web dans l’API OpenAI ?
La recherche web coûte $10 pour 1,000 appels, et la page précise que les tokens du contenu de recherche sont gratuits. Cela représente $0.01 par appel : 100 appels coûtent $1 ; 10,000 coûtent $100. Le travail du modèle, facturé séparément, doit toujours figurer dans votre total de tokens. Source : tarifs de l’API OpenAI.
Dans l’exemple de support, 1,000 recherches coûtent plus cher que l’ensemble des tokens de Luna. La fréquence de recherche doit donc relever d’un choix produit explicite. Une réponse qui exige des informations à jour peut justifier une recherche ; une réponse fondée sur une politique de support déjà fournie ne devrait pas entraîner automatiquement des frais de recherche.
Conteneurs : la session est l’unité de facturation
Les conteneurs, environnements d’exécution utilisés avec les modèles, coûtent $0.03 pour 1 GB ou $1.92 pour 64 GB, par session de 20 minutes et par conteneur. La page de tarification fait démarrer cette facturation par session le 31 mars 2026, une date déjà passée dans cet état des lieux d’octobre. Son ancien libellé « Now » ne justifie pas de supposer un paiement unique et permanent par conteneur. Source : tarifs de l’API OpenAI.
L’exemple de développement repose volontairement sur 1,000 sessions d’un gigaoctet. Il n’affirme pas que chaque tâche de développement consomme exactement une session. Comptez les sessions comme une unité distincte, surtout lorsque les tâches utilisent plusieurs conteneurs ou couvrent plusieurs unités de session.
Au tarif affiché pour 64 GB, ces 1,000 sessions coûteraient $1,920. Avec les mêmes tokens Sol et les mêmes recherches, le budget mensuel de développement passerait de $140 à $2,030. Les frais de session du grand conteneur sont 64 fois ceux du petit. La page ne donne aucun prix pour les tailles intermédiaires ; aucun n’est donc interpolé ici.
Quels sont les tarifs de l’API Realtime OpenAI ?
GPT-Realtime-2.1 applique des tarifs différents à l’audio, au texte et aux images en entrée. Les tokens audio sont une unité de facturation de la voix. Il ne faut ni les assimiler à des tokens de texte ni les convertir en minutes avec une règle non documentée.
Un million de tokens audio d’entrée hors cache plus un million de tokens audio de sortie coûtent $32 + $64 = $96 sur GPT-Realtime-2.1. Les mêmes volumes coûtent $10 + $20 = $30 sur GPT-Realtime-2.1 mini. Les entrées de texte et d’image ont leurs propres lignes dans le tableau. Source : tarifs de l’API OpenAI.
Pour les usages facturés à la durée, GPT-Live-1 est le modèle de conversation, GPT-Live-Transcribe assure la transcription vocale en direct, GPT-Transcribe la transcription asynchrone et GPT-Realtime-Translate la traduction en temps réel. Aux tarifs affichés par minute, 1,000 minutes coûtent respectivement $50, $17, $4.50 ou $34. Ce sont des tâches différentes, pas des forfaits vocaux interchangeables. La page ne fournit aucune conversion permettant de ramener l’exemple de tokens audio Realtime à un nombre équivalent de minutes.
Quels sont les tarifs de l’API d’images OpenAI ?
GPT-Image-2.5 Sunburst et GPT-Image-2.5 Flare affichent les mêmes tarifs par tokens. Les deux facturent $8 pour l’entrée image, $2 pour l’entrée image en cache et $30 pour la sortie image, par million de tokens. Les prompts textuels coûtent $5 en entrée ou $1.25 en entrée en cache. OpenAI met en avant la précision de retouche de Sunburst et la rapidité de génération au quotidien de Flare. Source : tarifs de l’API OpenAI.
En supposant un million de tokens d’image générés et un million de tokens de prompt textuel hors cache, le coût est de $30 + $5 = $35 sur l’un ou l’autre modèle. Cela ne signifie pas un million d’images. La page précise que les images sont converties en tokens, mais elle ne fixe pas un nombre constant de tokens par image générée pour ce calcul.
Prévoyez le budget d’image à partir des unités image et texte réellement facturées. Évitez de promettre un prix fixe par image à partir d’un tarif par tokens, ou de choisir entre ces modèles sur une différence de prix que cette page ne montre pas.
Abonnements, accès gratuit et questions de facturation
Un abonnement ChatGPT ne règle pas la facture API de votre application. OpenAI distingue explicitement la facturation API des abonnements ChatGPT Plus, Business, Enterprise et Edu. Consultez le guide des tarifs ChatGPT pour choisir un abonnement et budgétez séparément l’usage de votre application.
Comment budgéter l’usage API de Codex ?
Codex est le produit de développement d’OpenAI ; la distinction utile porte sur la manière dont vous payez son usage. Pour budgéter une activité API facturée séparément, utilisez les unités de modèle, de tokens et d’outils décrites plus haut. Les quotas inclus dans les offres du produit relèvent d’un autre achat. Le guide des tarifs Codex traite de ce choix d’abonnement.
Acheter un accès pour un développeur ne prépaie pas l’usage applicatif d’un bot de support, d’un agent de développement automatisé ou d’un outil de résumé par lots. Gardez des lignes budgétaires distinctes pour les abonnements aux produits et pour la consommation API de l’application.
L’API OpenAI propose-t-elle un quota gratuit ?
La page de tarification consultée ne mentionne aucun quota général de tokens API gratuits. Elle indique explicitement que l’usage du Playground, l’interface de navigateur permettant de tester des requêtes, est facturé comme l’usage API habituel. Ne considérez pas vos essais comme gratuits au seul motif qu’ils se déroulent hors de votre application.
Une personne qui utilise uniquement l’offre gratuite de ChatGPT peut ne jamais avoir besoin d’acheter de l’usage API. Dès que votre application envoie des requêtes API payantes, le choix d’une application gratuite ne justifie plus un budget de production nul.
Cette source n’énonce ni réduction étudiante universelle pour l’API, ni politique de remboursement API, ni expiration des crédits, ni engagement annuel sur le prix des tokens. Ces omissions ne prouvent pas l’absence d’offres propres à certains comptes ou de règles publiées ailleurs. Elles signifient que cet état des lieux tarifaire ne peut pas en promettre. En particulier, ne transposez pas les conditions de remboursement ou de facturation annuelle d’un abonnement dans un budget API.
Fixer le budget de la semaine prochaine à partir du travail accompli
Commencez avec Sol et mesurez la tâche entière avant d’optimiser le tarif du modèle. Votre prochain budget doit reposer sur l’usage facturé observé, plutôt que sur le nombre de mots de la réponse finale.
Établir une référence
Sur des tâches représentatives, relevez l’entrée hors cache, l’entrée en cache, la sortie facturée, les recherches et les sessions de conteneur pour tous les échanges. Conservez le résultat de validation de la tâche avec son coût.
Orienter les tâches ciblées vers le traitement adapté
Essayez Luna sur les tâches ciblées dont les résultats peuvent être vérifiés. Confiez à Batch le travail qui peut attendre. Conservez cette répartition uniquement si les résultats respectent les critères de validation.
Comparer le surcoût aux reprises évitées
Pour les tâches difficiles, comparez le coût API supplémentaire d’Astra à la valeur des corrections qu’il évite. Utilisez les tentatives et l’usage des outils réellement observés, sans supposer que tous les modèles consomment les mêmes tokens.
La FAQ tarifaire d’OpenAI précise que l’application du budget mensuel peut être retardée et que les dépassements restent à votre charge. Considérez le budget configuré comme un moyen de contrôler les dépenses assorti de cette limite, et surveillez l’usage réel. Pour la structure des projets et les workflows de reprise, consultez le guide des contrôles de budget API.
Questions fréquentes
Combien coûte OpenAI ?
L’usage de l’API OpenAI est facturé selon le modèle, les tokens et les outils. Pour les requêtes Standard respectant la limite de contexte indiquée, Sol coûte $2 en entrée, $0.10 en entrée en cache et $10 en sortie par million de tokens. Cette grille API ne propose pas de prix mensuel unique pour toute une application.
L’API ChatGPT coûte-t-elle moins cher que ChatGPT Plus ?
Cela dépend de l’usage et de vos besoins. La facture API d’une application peut être faible, mais elle paie des requêtes applicatives à la consommation, pas l’expérience produit d’un abonnement. OpenAI précise que l’usage API est facturé séparément des abonnements ChatGPT.
Comment comparer les tarifs et les coûts des différentes API de LLM ?
Comparez les fournisseurs sur une même base : entrée, entrée en cache, sortie, usage des outils et tâches accomplies avec succès. À usage identique, le scénario de développement OpenAI présenté ici coûte $55 sur Luna, $140 sur Sol et $550 sur Astra, la qualité restant une condition de validation. Cet état des lieux ne contient aucun tarif vérifié d’autres fournisseurs.
Est-ce rentable de payer pour OpenAI ?
Oui, lorsque le travail validé fait économiser plus que le coût de l’usage API et des reprises qui en résultent. Commencez les tâches de développement sur Sol ; passez à Astra quand les corrections évitées justifient son surcoût, et utilisez Luna lorsque son travail respecte les mêmes exigences.
Un abonnement ChatGPT à $20 vaut-il le coût ?
Payez un abonnement ChatGPT lorsque ses fonctionnalités et le temps gagné justifient son prix. Il ne couvre pas l’usage applicatif calculé ici : cette dépense API reste donc une décision distincte.
L’API OpenAI est-elle gratuite ou payante ?
La page indique des usages payants pour les modèles et les outils, sans quota général d’API gratuit. Elle précise aussi que les requêtes du Playground sont facturées comme les requêtes API habituelles. Une offre ChatGPT gratuite ne signifie pas que l’API est gratuite.
L’API OpenAI coûte-t-elle cher ?
Cela dépend de la tâche et des outils qu’elle utilise. Le mois de support hypothétique coûte $13.90 sur Luna, tandis que le mois de développement sur Sol coûte $140. Les deux montants dépendent des volumes facturés indiqués ; un faible tarif de tokens ne supprime pas les frais de recherche ou de conteneurs.
Quelles sont les meilleures API d’IA gratuites ?
La page de tarification ne mentionne aucun quota général d’API OpenAI gratuit. Luna est une option payante à bas coût pour les tâches ciblées dont les résultats respectent vos critères. Avant d’intégrer le quota gratuit d’un fournisseur à un budget de production, il faut le vérifier à partir de ses conditions en vigueur.
Combien coûte 1 million de tokens OpenAI ?
Pour un million de tokens d’entrée hors cache, Astra coûte $10, Sol $2 et Luna $0.10. Pour un million de tokens de sortie, ils coûtent $50, $10 et $0.50. Un million de tokens d’entrée plus un million de tokens de sortie représentent deux millions de tokens facturés, pour un total de $60, $12 ou $0.60.
OpenAI propose-t-il une réduction étudiante pour l’API ?
La page de tarification vérifiée pour cet article ne mentionne aucune réduction étudiante universelle pour l’API. Ne considérez pas une offre étudiante portant sur un autre produit OpenAI comme un crédit API, sauf si ses conditions prévoient explicitement cet avantage.
Quelle est la politique de remboursement de l’API OpenAI ?
La page de tarification vérifiée n’énonce aucune politique de remboursement API. Cet article ne promet donc aucun remboursement et n’applique pas les règles des abonnements ChatGPT aux achats API.
Les tarifs de l’API OpenAI ont-ils changé en 2026 ?
La page actuelle fait explicitement démarrer la facturation des conteneurs par session de 20 minutes le 31 mars 2026. Elle ne fournit pas d’historique des tarifs des modèles. Cet état des lieux d’octobre n’affirme donc pas quand les prix des tokens ont changé et ne cite aucun tarif antérieur.
Définissez les tâches et leurs critères de validation avant de choisir une autre offre. Recevez la checklist d’audit des workflows d’IA en entreprise en vous abonnant à la newsletter.
- Dernière mise à jour
- 3 oct. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Pi Coding Agent : installer et prendre en main Pi 1.0
Installez Pi 1.0, connectez votre compte de modèle et lancez une première tâche. Un guide avec AGENTS.md, les coûts des fournisseurs et les limites de Pi.3 oct. 2026Build
Créer un agent IA sans code : le comparatif de 8 plateformes en 2026
Comparez 8 plateformes pour créer un agent IA sans code : tarifs, usages, intégrations et limites pour choisir selon votre équipe et vos workflows.1 oct. 2026Build
Lovable Pricing : combien coûte un mois de crédits en 2026 ?
Lovable : Pro à $25 par mois, Business à $50. Comparez les abonnements, recharges, crédits Cloud et IA avec un budget détaillé pour un outil interne.1 oct. 2026Build
Scanner de vulnérabilités : déployer Codex Security en équipe
Configurez Codex Security Cloud, la revue des pull requests et la CLI : coûts d’équipe en USD, cas Gogs, SARIF en CI et contrôles à conserver.30 sept. 2026Build
LearnWorlds pricing 2026 : tarifs, frais et coût réel
LearnWorlds pricing dès $29/mois : comparez Starter, Pro Trainer et Learning Center, leurs frais, crédits IA et seuils pour choisir sans surpayer.30 sept. 2026Build
ChatGPT Space est-il une vraie alternative à Notion ?
ChatGPT Space est-il une vraie alternative à Notion ? Comparez prix, collaboration, permissions et export pour choisir le bon système de travail avec l’IA.30 sept. 2026Build
Automatisation web : exploiter WebMCP avec Kitesurf
Découvrez comment connecter Kitesurf à WebMCP, exécuter une action structurée, vérifier le résultat et prévoir un fallback fiable pour votre automatisation web.30 sept. 2026Build