Cloudflare: como bloquear treinamento de IA sem prejudicar a busca
Configure o Cloudflare para bloquear treinamento de IA sem perder indexação. Veja o ajuste correto, valide o robots.txt e evite bloquear Googlebot e Bingbot.



Para bloquear treinamento de IA sem interromper os crawlers de busca, defina Search como Allow, selecione Disallow AI Training em Training e depois confira tanto as configurações migradas quanto o arquivo robots.txt entregue pelo Cloudflare. Essa verificação se tornou essencial porque, em 15 de setembro de 2026, o Cloudflare mudou o significado de Block. Agora, essa opção também pode impedir que crawlers de uso misto, como Googlebot, Applebot e Bingbot, acessem seu site para fins de busca.
Como bloquear treinamento de IA sem perder a busca
Para a maioria dos sites que dependem de tráfego orgânico, a configuração é simples: permita Search, desautorize Training e decida separadamente o que os Agents podem fazer.
A explicação publicada pelo Cloudflare em 15 de setembro é direta: use Disallow AI Training quando quiser impedir treinamento e preservar a busca. Não siga tutoriais antigos que recomendam Training: Block. Antes da mudança, crawlers de uso misto ficavam fora desse bloqueio. Agora não ficam mais.
O controle está disponível em todos os planos do Cloudflare, portanto não é preciso comprar um upgrade para ter acesso ao recurso. O custo deixa de ser o de mais um produto de bloqueio e passa a ser o de conferir se política e comportamento estão alinhados. Como referência, uma licença do Screaming Frog SEO Spider custa $279 por ano nos EUA, enquanto um produto dedicado ao monitoramento de robots.txt anuncia um plano de $129 por mês. O Cloudflare fornece o controle, mas a rotina de verificação continua necessária.
O que Disallow AI Training realmente faz
Disallow registra uma preferência com aplicação seletiva; Block funciona como uma porta trancada.
Imagine um crawler de uso misto como uma van de entregas com duas ordens de serviço. Uma diz “indexe esta página para a busca”. A outra diz “use esta página para treinar um modelo”. Bloquear a van interrompe os dois trabalhos. Disallow AI Training permite que um operador considerado Accountable mantenha a tarefa de busca e descarte a de treinamento.
O Cloudflare divide o tráfego automatizado em três comportamentos:
- Search cria um índice de busca.
- Training treina ou faz o ajuste fino de um modelo.
- Agent acessa o site em nome de uma pessoa, como um recurso de busca em chats ou um agente que opera o navegador.
A nova opção de Training orienta o Bot Preference Sync a publicar no robots.txt as instruções correspondentes de proibição de treinamento. Crawlers de uso misto classificados como Accountable continuam aptos a acessar o site para busca. Já os crawlers dedicados a treinamento da Amazon, Anthropic, Meta e OpenAI são bloqueados sem levar junto os crawlers separados que essas empresas usam para busca.
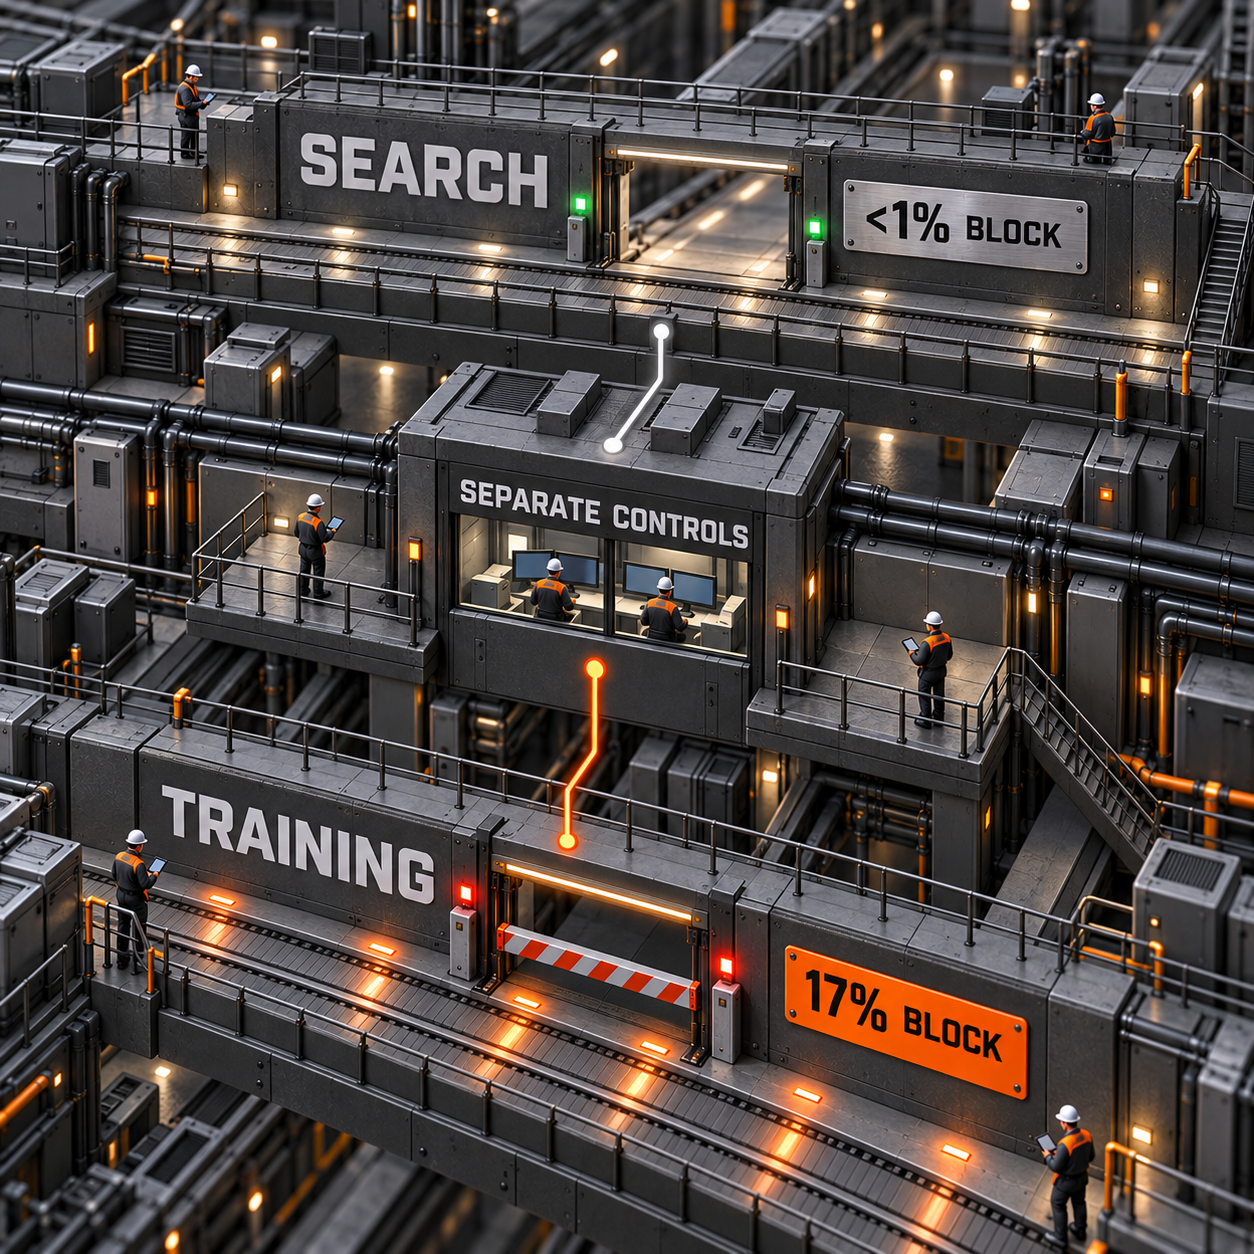
Segundo o Cloudflare, menos de 1% de seus sites bloqueiam bots de Search, enquanto 17% ativam algum mecanismo para bloquear Training. Essa distância explica o desenho do produto: um único botão Block AI era impreciso demais para o que os responsáveis pelos sites realmente desejam.
Há uma distinção importante. Uma instrução no robots.txt não é um campo de força. Sozinha, ela não consegue identificar quem está rastreando, descobrir por que o acesso está acontecendo nem deter um crawler que ignore a regra. O Cloudflare combina a preferência publicada com classificação de rede e bloqueio dos crawlers que não atendem aos critérios do caminho Accountable.
Accountable ainda não significa disponibilidade imediata
Encare o rótulo Accountable do Cloudflare como um status apoiado por um roadmap, não como prova de que todo controle prometido já está disponível.
Para se qualificar, o operador precisa cumprir ou se comprometer com requisitos que abrangem a recusa de treinamento, a recusa de resumos de IA, a visibilidade por URL e a garantia de que rejeitar treinamento não prejudicará a busca tradicional. Essa escolha de palavras faz diferença.
- Google: o Google-Extended pode ser bloqueado no robots.txt, e o Google afirma que essa decisão não afeta o ranking de busca. A empresa também oferece aos webmasters um controle para busca generativa e relatórios. A transparência adicional do Google-Extended por URL ainda era descrita como uma entrega para as semanas seguintes ao anúncio.
- Apple: o Applebot-Extended aceita a recusa de treinamento via robots.txt. A Apple também oferece
nosnippetpara resumos de IA e identificação de paywall. A inspeção por URL não estava disponível no dia do anúncio e foi apresentada como um trabalho para o ano seguinte. - Microsoft: o caminho atual do Bing é diferente. Responsáveis por sites podem combinar
NOARCHIVEcom as ferramentas Block URLs ou Content Removal do Bing. A Microsoft prevê que, no início de 2027, o Bingbot passe a respeitar uma preferência de não treinamento em nível de domínio no robots.txt. Até lá, o ajuste Disallow AI Training do Cloudflare não envia automaticamente essa preferência ao Bing pelo robots.txt.
Portanto, a promessa honesta é mais limitada do que “um botão controla todos os usos em qualquer lugar”. A nova configuração deixa muito mais clara a decisão segura entre busca e treinamento, mas o Bing ainda exige uma verificação separada hoje.
Confira o que o Cloudflare migrou
A maioria das configurações é transferida automaticamente, mas os rótulos e seus efeitos mudaram o suficiente para justificar uma auditoria.
Se um domínio nunca usou os controles granulares de Search, Training e Agent, o Cloudflare converte a configuração antiga de Block AI Bots da seguinte forma:
Quando o domínio já usava os controles granulares, Search e Agent mantêm seu estado prático. Training: Allow continua como Allow. Tanto Training: Block quanto Training: Block on pages with ads passam a ser Disallow AI Training.
Siga esta verificação após a migração:
- Abra o domínio no Cloudflare, acesse Security Settings e depois Configure AI bot policies.
- Antes de alterar qualquer item, registre os valores atuais de Search, Training e Agent.
- Defina Search como Allow se a descoberta orgânica for importante.
- Defina Training como Disallow AI Training se quiser recusar treinamento sem retirar da busca os crawlers de uso misto considerados Accountable.
- Escolha a política de Agent de acordo com suas próprias necessidades. O Cloudflare não oferece uma preferência Disallow para Agents porque ainda não existe uma diretiva consolidada na Internet para isso.
- Confirme que o Bot Preference Sync está ativado se quiser que o Cloudflare publique no robots.txt a política definida para a categoria.
- Salve a política e inspecione o resultado público, em vez de tratar o rótulo do painel como comprovação.
Para novos domínios financiados por anúncios, a predefinição recomendada pelo Cloudflare já segue esse padrão: Preference Sync ativado, Search permitido, Training desautorizado e Agents bloqueados em páginas com anúncios. Domínios novos que não monetizam com publicidade começam com os três comportamentos permitidos.
Como verificar o acesso à busca depois da mudança
Um botão aparentemente correto é apenas o primeiro ponto de controle. Verifique a política de fora para dentro.
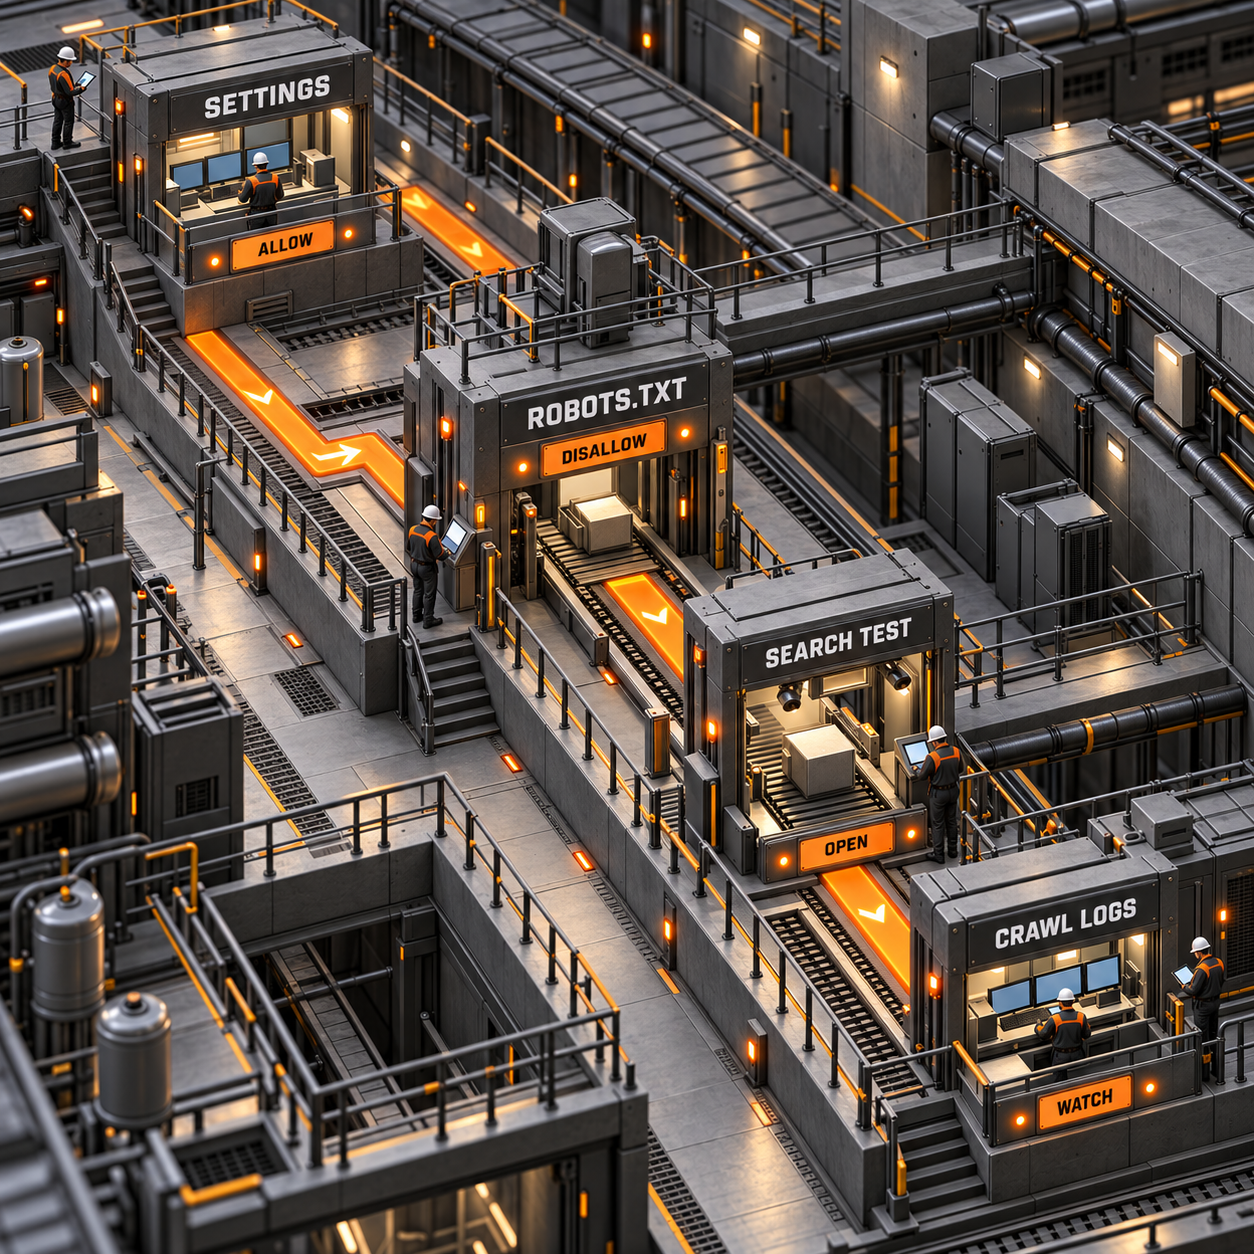
Use esta checagem em quatro partes:
- Configurações: confirme que Search exibe Allow e Training exibe Disallow AI Training. Avalie Agent separadamente.
- robots.txt: busque o arquivo
/robots.txtpublicado no domínio. O Bot Preference Sync insere suas regras geradas antes de um arquivo existente, portanto suas diretivas Disallow originais permanecem. Procure conflitos nas duas partes. - Comportamento na busca: use as ferramentas para webmasters e os relatórios do operador de busca para inspecionar URLs representativas. Não deduza o acesso à busca apenas pela palavra “Disallow”. Ela se aplica à identidade ou preferência de treinamento, não à finalidade de busca tradicional de um crawler de uso misto classificado como Accountable.
- Atividade dos crawlers: acompanhe no AI Crawl Control as requisições, a conformidade com o robots.txt e bloqueios inesperados. O Cloudflare permite aplicar ações por crawler e registra a atividade, tornando esse o lugar prático para identificar uma política que se comporta de maneira diferente da pretendida.
Regras personalizadas exigem atenção extra. O Bot Preference Sync reflete a política geral da categoria, mas não incorpora regras individuais complexas ao arquivo gerado. Se houver uma exceção de licenciamento para um crawler, lógica específica por caminho ou uma regra WAF personalizada, compare essas camadas manualmente. Quando uma política geral por categoria for ampla demais, o Cloudflare permite desativar o Sync e manter o arquivo por conta própria.
Quem mais ganha com a nova separação
O maior beneficiado é qualquer negócio que ganha dinheiro quando uma pessoa chega à página, mas não quer ver seu acervo absorvido por dados de treinamento.
O exemplo do varejista também revela uma limitação: esses controles operam no nível do domínio. Eles não são um sistema nativo de consentimento por artigo. Zonas separadas podem adotar políticas diferentes, mas cada zona recebe uma única postura para Search, Training e Agent, a menos que você mesmo adicione regras mais específicas.
O que vale a pena construir
O produto mais forte é um monitor de regressões em políticas de crawlers, não mais um gerador de robots.txt.
1. Monitor de regressões em políticas de crawlers
Crie um monitor para agências e equipes com vários sites que leia a política do Cloudflare, busque o robots.txt publicado, teste o acesso de busca em URLs representativas e envie um alerta quando essas camadas saírem de sincronia.
A demanda aparece nas buscas relacionadas à tarefa: robots.txt generator recebe cerca de 1,000 buscas mensais nos EUA, e google indexing checker, cerca de 110. As ferramentas existentes também confirmam que há orçamento. Um produto de monitoramento de robots.txt anuncia $129 por mês em um plano para cinco domínios, enquanto um monitor de alterações de SEO para desktop cobra $179 uma única vez.
A menor versão que já pode ser vendida precisa de quatro recursos: importação de zonas do Cloudflare, comparação entre política e robots.txt, verificações agendadas e um alerta por email ou Slack com a alteração exata. Acrescente a atividade dos crawlers e os dados para webmasters depois que o detector principal de divergências conquistar confiança.
O desafio é a comprovação. Configurações e requisições observadas mostram o que o site publicou e bloqueou. Elas não provam que um fornecedor de modelos apagou dados já coletados. A vantagem competitiva precisa vir de evidências confiáveis em muitos domínios, não de um botão mais bonito.
2. Auditor de migração do Cloudflare
Crie uma auditoria focada em encontrar zonas que ainda tenham combinações arriscadas após a migração e gere um relatório de correção para uma agência, grupo editorial ou rede de franquias.
cloudflare block ai bots recebe cerca de 50 buscas mensais nos EUA, com um CPC de $13.19, enquanto google indexing checker acrescenta outras 110 buscas mensais ligadas ao resultado que essas pessoas temem. A demanda é menor que a do mercado de geradores, mas o preço do clique sugere que quem faz essa busca enfrenta um problema operacional real.
O MVP pode ler os campos de API para Search, Training, Agent e Bot Preference Sync, buscar o robots.txt público e classificar cada zona como segura para busca, bloqueada de propósito ou inconsistente. Exporte um pacote de evidências pronto para o cliente, exibindo lado a lado a configuração e o arquivo observado.
O risco é depender da plataforma. O Cloudflare pode adicionar o mesmo relatório de portfólio, e a necessidade ganha força principalmente durante migrações. O negócio mais promissor é usar a auditoria como produto de entrada e depois vender o monitoramento contínuo de regressões para Cloudflare e outros provedores de edge.
O que esse controle não resolve
Esta é uma fronteira de política mais clara, não uma solução completa para o uso de conteúdo por IA.
- Ela não apaga material já coletado. O Cloudflare descreve preferências para crawlers e controles de requisição, não uma exclusão retroativa.
- Ela não garante que todo operador respeite o robots.txt. O Cloudflare acrescenta aplicação em rede para crawlers fora do caminho Accountable, mas o caminho de uso misto ainda depende de o operador respeitar a preferência.
- Ela não remove você de todos os resumos de IA. Os controles de resumo são separados, e o Cloudflare apresenta um controle centralizado mais amplo para resumos como trabalho futuro.
- Ela não oferece o estado Disallow para Agents.
- Ela não converte regras personalizadas e complexas de cada crawler para o Bot Preference Sync.
- Ela ainda não expressa automaticamente a preferência de não treinamento do Bing pelo robots.txt. Confira separadamente o
NOARCHIVEe os controles atuais para webmasters do Bing. - Ela não é a indexação de arquivos do R2 pelo Cloudflare AI Search sem renomeá-los. Esse é outro produto, com outro fluxo de trabalho.
Escolha Block quando realmente quiser eliminar o crawler. Escolha Disallow AI Training quando a descoberta pela busca ainda fizer parte do modelo de negócio. Essa diferença é a razão de ser da mudança de setembro.
Sua ação para segunda-feira
Na próxima semana, escolha três domínios representativos: uma propriedade financiada por anúncios, um site orientado por busca e um domínio com regras personalizadas para crawlers. Registre os valores migrados de Search, Training e Agent, altere apenas os sites cujo objetivo de negócio estiver claro e salve o robots.txt publicado e o relatório de crawlers junto ao chamado da mudança. Se os três passarem, aplique a mesma verificação baseada em evidências ao restante do portfólio.
Como desativar o treinamento de IA?
Em um domínio gerenciado pelo Cloudflare, defina Training como Disallow AI Training quando quiser publicar uma preferência de não treinamento e, ao mesmo tempo, manter disponíveis para busca os crawlers de uso misto classificados como Accountable. Use Block somente se também aceitar o impacto na busca causado pelo bloqueio desses crawlers.
Existe alguma forma de bloquear todo conteúdo de IA?
É possível bloquear categorias de crawlers ou crawlers individuais, mas “todo conteúdo de IA” mistura funções diferentes. O Cloudflare separa o tráfego de Search, Training e Agent para que você escolha quais usos automatizados serão permitidos. Bloquear Training não remove material gerado por IA dos produtos de busca nem apaga dados já coletados.
Como desativar o modo IA na busca?
A configuração de crawlers do Cloudflare não desativa para os usuários uma experiência de busca com IA. Ela controla o acesso ao seu domínio. O Google e outros operadores oferecem controles separados para resumos generativos, enquanto a indexação tradicional e as preferências de treinamento continuam sendo decisões distintas.
Se quiser construir para sua empresa uma camada como essa de auditoria e monitoramento de políticas para crawlers, conheça os sistemas de IA em produção.
- Última atualização
- 16 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Digitação por voz com Murmure: análise do app offline
Testei o Murmure para digitação por voz offline, com dicionário, regras e LLM opcional. Veja onde ele acerta, quais limites pesam e para quem serve.14 de set. de 2026Build
FFmpeg API da RenderIO: preços, créditos e limites
FFmpeg API da RenderIO: veja preços, cobrança por créditos, limites técnicos e quando compensa migrar entre os planos Starter, Growth e Business.14 de set. de 2026Build
Transcrição de voz com Dictare: preço e custo real
Veja quanto custa o Dictare, o que a transcrição de voz local inclui e quais despesas com agente, máquina e manutenção entram no custo real.13 de set. de 2026Build
Como testar plugins do Claude Code e medir sua contribuição
Veja como testar plugins do Claude Code com evals nativos, comparar resultados com um controle sem plugin e limitar custos antes de levar o teste ao CI.12 de set. de 2026Build
IA de voz no Cloudflare: encontre a origem da latência
Aprenda a usar o turnmetrics do Cloudflare para localizar atrasos, silêncios e falhas em cada etapa de um agente de IA de voz antes de trocar fornecedores.12 de set. de 2026Build
Como colocar legenda em vídeo com SRT usando o Rendi
Veja como colocar legenda em vídeo com um arquivo SRT e a API do Rendi, do envio ao controle de qualidade do MP4, sem manter o FFmpeg na sua infraestrutura.11 de set. de 2026Build
Agentes de IA da OpenAI: Agents API ou Agents SDK?
Compare a OpenAI Agents API e o Agents SDK em controle de sessões, runtime, custos de sandbox e migração para escolher a base certa para seus agentes de IA.11 de set. de 2026Build