Web scraping em 2026: 8 ferramentas para cada tipo de coleta
Compare oito ferramentas de web scraping para agentes de IA, monitoramento sem código e coleta em escala, com preços, franquias e limites de cada serviço.




Firecrawl é a primeira opção a avaliar para entregar páginas limpas a um agente de IA; Browse AI, para um monitoramento que a equipe de operações consiga manter; e Bright Data, para coletas em que o acesso aos sites é o gargalo. As melhores ferramentas de web scraping resolvem necessidades diferentes: Firecrawl e Context.dev partem de $19/mês na cobrança mensal, mas pedir JSON estruturado muda o consumo de créditos. Antes de escolher o fornecedor, defina o formato da entrega, a frequência da coleta e quem vai corrigir uma execução que falhar.
Ferramentas de web scraping: comparação rápida
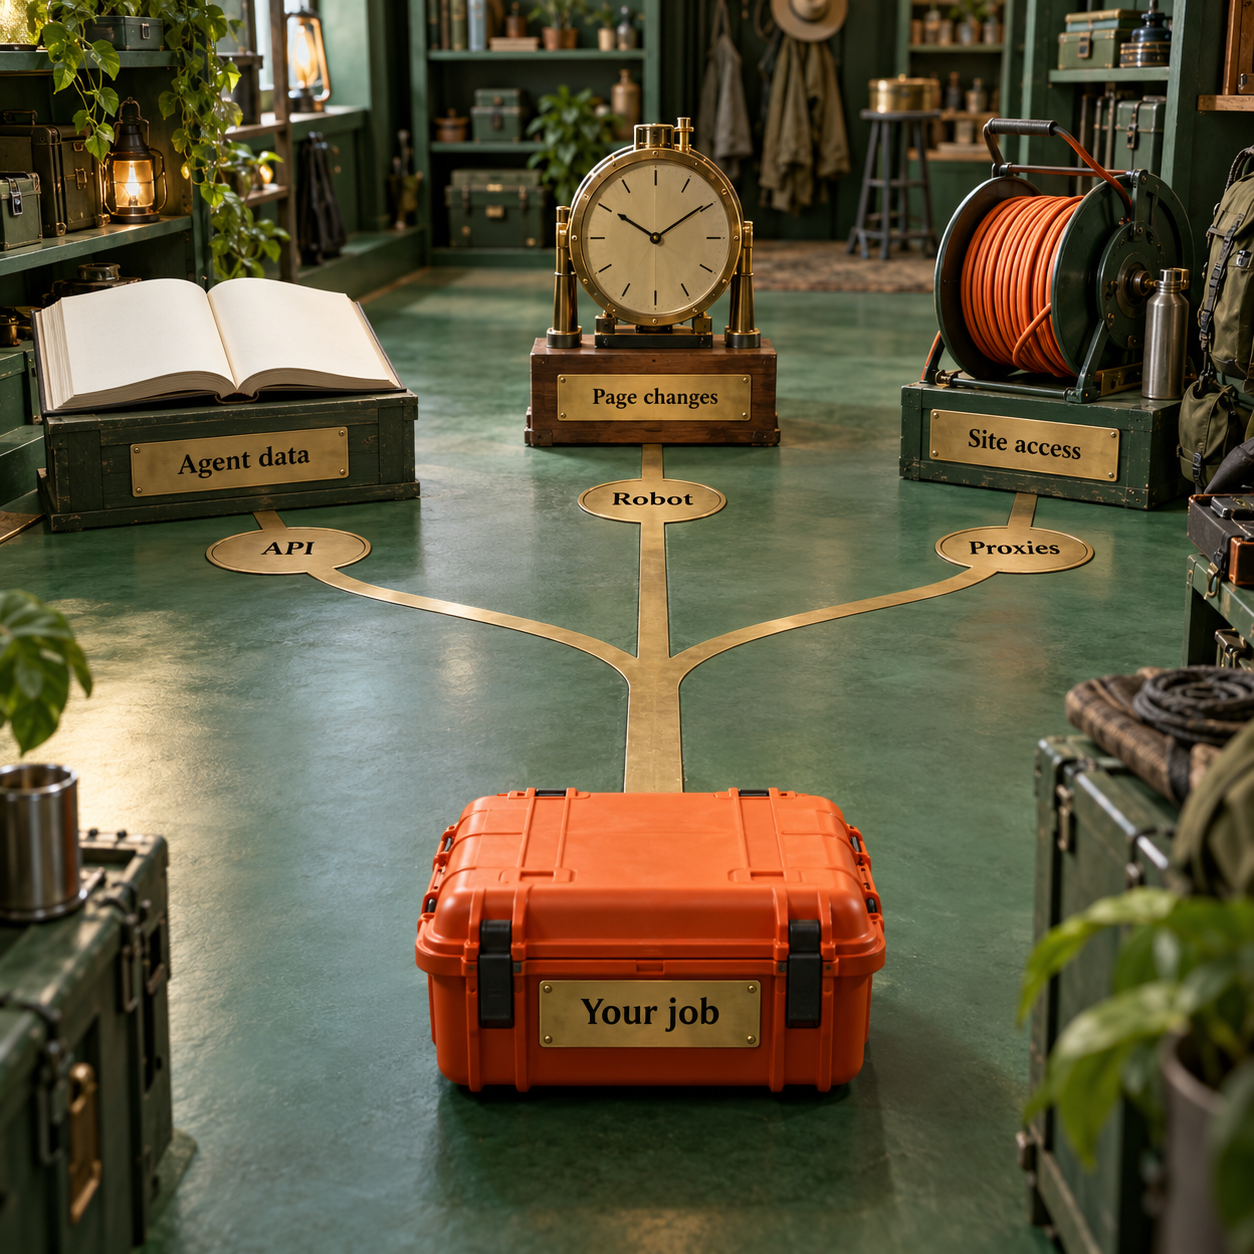
Contrate a parte que falta no seu fluxo de trabalho. Uma API de scraping — um serviço que seu software chama para obter dados de páginas — atende ao desenvolvedor que está construindo um agente ou uma base de dados. Um robô sem código atende à pessoa de operações que precisa repetir uma coleta. Já uma rede de proxies, que encaminha o tráfego por outros endereços IP, atende a um scraper que você já mantém e que precisa acessar melhor os sites de destino.
Os preços e as franquias abaixo foram conferidos nas páginas dos fabricantes em 6 de outubro de 2026. As ofertas anuais estão identificadas, e os testes gratuitos aparecem separados das franquias renováveis. A coluna de entrada mostra a oferta paga inicial; a última indica o que é possível avaliar sem contratar um plano.
A tabela ajuda a montar uma seleção inicial. Ela não equipara um registro entregue a uma página visitada ou a um gigabyte. O cupom de proxies da Bright Data, RESIGB50, anuncia 50% de desconto por três meses. Use essa tarifa temporária no orçamento de avaliação e a tarifa normal na previsão de gastos recorrentes.
Defina a entrega e quem vai cuidar dela
Há três decisões de contratação diferentes aqui, e a ferramenta muda conforme a necessidade. Quem está carregando documentação em um assistente, quem acompanha preços de concorrentes e quem atualiza uma grande base de anúncios não deve começar pela mesma comparação de produtos.
Primeiro uso: transformar páginas em conteúdo útil para um agente
Comece por Firecrawl ou Context.dev quando a entrega esperada for conteúdo de páginas ou campos estruturados dentro da sua aplicação. Markdown é texto legível que preserva títulos e links, útil quando um agente de IA precisa consultar o documento. JSON organiza campos com nomes, como produto, preço, moeda e disponibilidade, e atende a fluxos que precisam validar e comparar registros.
Essa diferença afeta tanto a qualidade quanto o custo. Um assistente de suporte muitas vezes consegue trabalhar com uma página de documentação limpa. Um alerta de preço precisa do campo de preço, da moeda, da variante correta do produto e de uma marca de data e hora. Enviar uma página a um modelo não define qual dos vários preços interessa ao seu negócio.
Também diferencie scrape, que obtém uma página, crawl, que segue os links de um site para obter várias páginas, e map, que descobre URLs. Se você já mantém uma lista confiável de URLs, repetir a descoberta pode dar mais trabalho sem melhorar o fluxo de dados. Se a documentação do site continua crescendo, a descoberta faz parte da coleta.
Segundo uso: acompanhar páginas conhecidas sem exigir manutenção de código
Escolha Browse AI para gravar uma tarefa de extração e monitorar mudanças com autonomia para a equipe de operações. Escolha Octoparse quando a criação visual de tarefas e uma estrutura paga de extração na nuvem fizerem mais sentido. Nesse contexto, um robô é uma sequência salva de ações e instruções de extração. Ele não substitui um funcionário de forma geral.
Por exemplo, uma pessoa responsável por operações pode precisar de título, preço e disponibilidade de uma lista de produtos de um fornecedor toda manhã. A entrega útil é uma planilha com colunas estáveis e uma sinalização clara quando algum campo desaparece. Essa pessoa deve conseguir inspecionar a tarefa e ajustá-la quando o site mudar.
Defina o que conta como mudança antes de escolher a frequência. Uma alteração no rodapé não importa para a disponibilidade em estoque. A simples reordenação de uma lista não deveria indicar que todos os produtos foram substituídos. Mantenha um identificador estável, compare os campos relevantes e encaminhe dados ausentes para revisão, em vez de sobrescrever silenciosamente o valor válido de ontem.
Terceiro uso: coletar em escala quando o acesso é o gargalo
Avalie Bright Data, Zyte ou ScrapingBee quando seu software já controla o agendamento e a base de dados, mas obter as páginas de destino está ficando difícil. Um serviço de desbloqueio gerencia o acesso, incluindo novas tentativas e seleção de proxies. A definição do significado dos dados continua sendo sua.
A Bright Data também oferece Scraper APIs específicas por site e, assim, pode entregar um registro mais completo em vez de apenas acesso à rede. Apify ocupa outra posição útil: um Actor mantido para o site de destino talvez já implemente a extração de que você precisa. Um Actor é um programa reutilizável na nuvem que você configura e executa.
A escolha depende de quem assume cada responsabilidade. Se você precisa de uma lógica de extração mantida por terceiros, avalie uma Scraper API ou um Actor. Se quer preservar sua própria lógica de interpretação dos dados, avalie uma API de busca de páginas ou um serviço de proxies. Pagar pelo acesso bruto esperando receber uma base pronta sai caro.
Oito ferramentas e os limites que pesam na escolha
Cada ferramenta abaixo atende a uma necessidade recorrente específica. A numeração facilita a consulta; a melhor escolha para cada uso depende da entrega, dos limites e das responsabilidades descritos na respectiva seção.
1. Firecrawl: por onde começar para entregar páginas a agentes
Firecrawl é uma API de scraping que transforma sites em conteúdo de páginas utilizável, e é a primeira opção a avaliar para um agente apoiado em documentação. As funções Scrape, Crawl e Map cobrem a obtenção de páginas, a navegação pelos links do site e a descoberta de URLs, com papéis distintos. Quem está criando um assistente de suporte pode mapear a documentação, selecionar os caminhos relevantes e coletar essas páginas em Markdown. Escolha Firecrawl quando a entrega for conteúdo de páginas limpo; reconsidere quando a principal necessidade for monitorar uma planilha sob responsabilidade de operações.
Ideal para: Desenvolvedores que alimentam um agente de IA com documentação, artigos ou páginas de referência.
Destaque: Funções separadas de scrape, crawl e map, com Markdown e extração estruturada.
Preço: Hobby $19/mês ou $16/mês na cobrança anual; 5,000 créditos mensais.
Opção gratuita: Plano Free recorrente com 1,000 créditos/mês, sem exigir cartão.
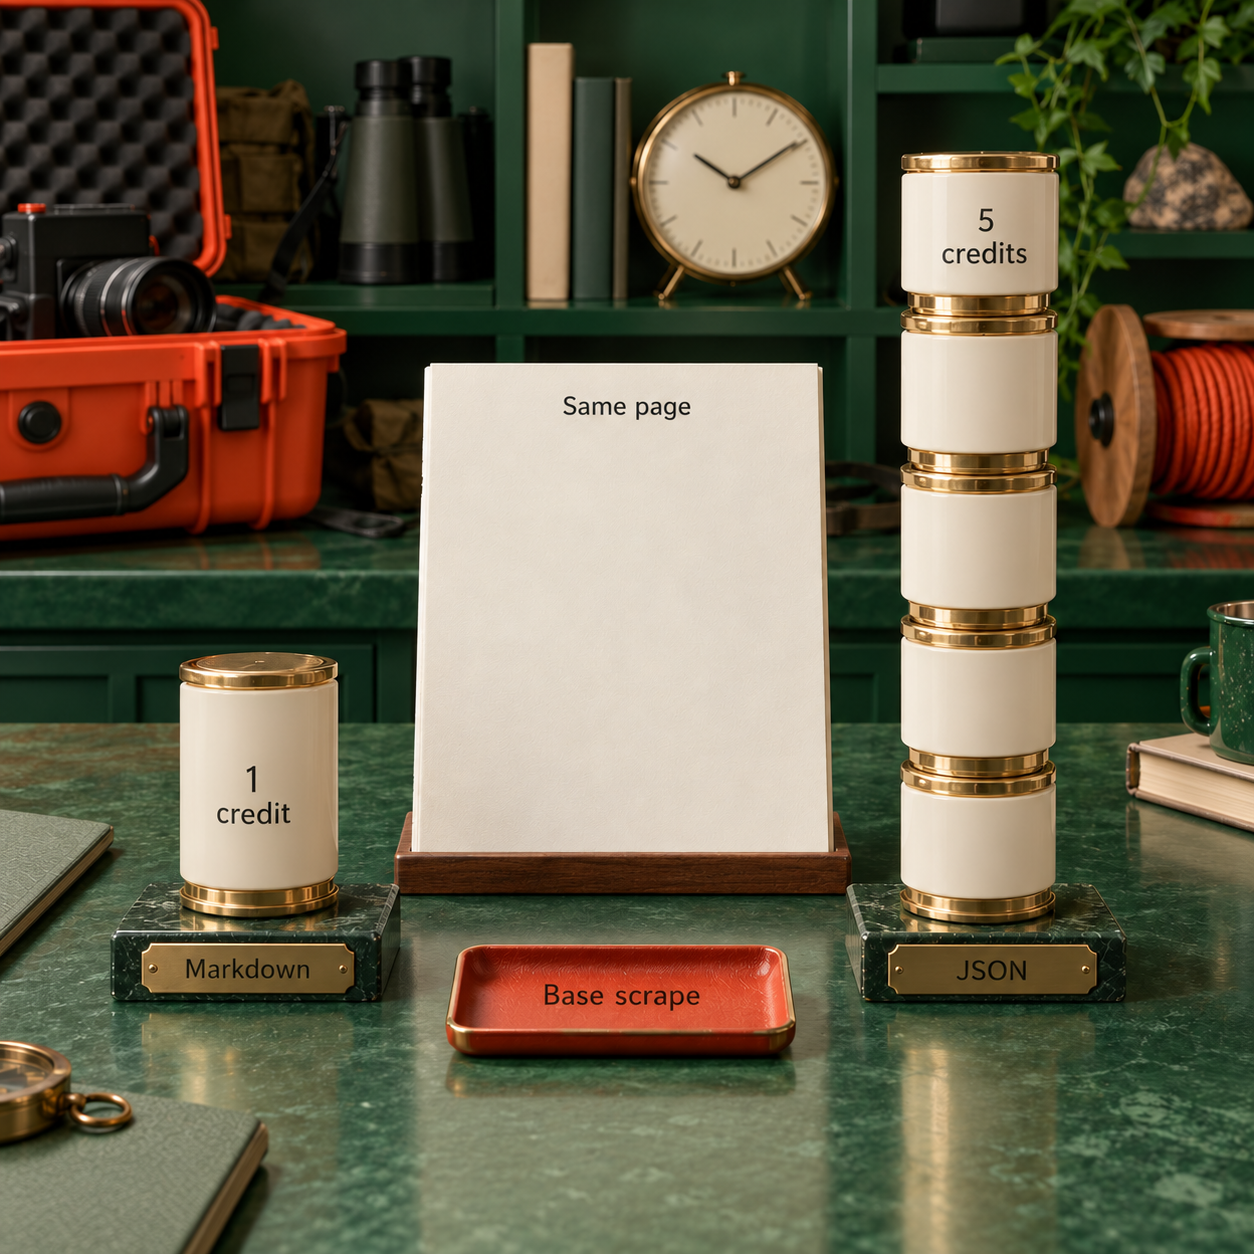
Uma página básica obtida por scrape ou crawl custa 1 crédito. A extração de JSON acrescenta 4 créditos, de modo que uma requisição padrão de página mais JSON custa 5 créditos. Assim, o Hobby permite 5,000 páginas básicas ou 1,000 páginas com JSON padrão se todo o saldo for usado apenas nessa operação. A mesma assinatura rende quantidades bem diferentes conforme a entrega solicitada. Detalhes dos preços do Firecrawl.
Na cobrança mensal, a sequência completa de planos é Free por $0, Hobby por $19 com 5,000 créditos, Standard por $99 com 100,000, Growth por $399 com 500,000 e Scale por $749 com 1,000,000. Enterprise tem preço personalizado. Os equivalentes mensais exibidos para a cobrança anual são $16, $83, $333 e $599/mês, com faturas anuais de $190, $990, $3,990 e $7,190, respectivamente. Esses são os valores apresentados pelo fabricante, com os arredondamentos que ele utiliza. Todos os planos do Firecrawl.
O primeiro limite é o tamanho solicitado do crawl. A documentação do Firecrawl informa um limite padrão de 10,000 páginas e diz que uma tarefa pode ser recusada quando os créditos disponíveis não cobrem o limite solicitado. Por isso, mesmo um site pequeno no Hobby pode exigir um limit menor e explícito antes que o crawl obtenha a primeira página. O próximo limite é a simultaneidade: Hobby permite 5 requisições simultâneas, Standard 25, Growth 50 e Scale 100. Comprar mais créditos não altera o limite de requisições paralelas do plano atual. Funcionamento do crawl.
A validação da entrega também importa. O Firecrawl informa que um scrape sem resultado não é cobrado, mas uma página de erro retornada pelo site de destino, como 403 ou 404, custa um crédito. Leia o status do destino e o conteúdo retornado antes de inseri-lo na base de conhecimento. Uma página de erro bem convertida para Markdown continua sendo uma página de erro.
- Scrape, crawl e map permitem decidir separadamente como descobrir e obter páginas.
- Markdown atende à ingestão de documentos; JSON atende a um esquema definido de campos.
- A franquia gratuita recorrente permite avaliar uma pequena carga de trabalho agendada.
- Recargas pagas permitem ampliar o uso antes de mudar de plano.
- A extração estruturada reduz bastante a quantidade de páginas coberta pela franquia básica.
- Um limite padrão alto de crawl pode ultrapassar o saldo de uma conta pequena.
- Páginas de erro retornadas podem ser cobradas e exigem validação própria.
- Os créditos de Hobby, Standard e Growth normalmente não se acumulam para o período seguinte.
Mapeie a fonte antes de coletar tudo
Use o Map playground para descobrir as URLs da documentação. Mantenha os caminhos que respondem às perguntas reais do seu assistente. Mapear descobre os endereços; fazer scraping deles é uma operação separada.
Escolha a entrega útil mais econômica
Comece com Markdown para um assistente apoiado em documentos. Use um esquema JSON quando o fluxo seguinte precisar de campos nomeados. Confira uma página de produto representativa que mostre o preço normal e o promocional antes de assumir que o esquema está claro.
Defina um limite de crawl que caiba no saldo
Para o conjunto ilustrativo de 120 páginas, defina um
limitexplícito de 120. Filtre os caminhos para evitar que o crawler gaste o saldo em páginas de blog ou de conta sem relação com a coleta.Salve o resultado e as evidências de validação
Armazene a URL de origem, o horário da coleta, o status do destino e o conteúdo no seu próprio armazenamento. A documentação do Firecrawl informa que resultados de crawls concluídos ficam disponíveis pela API por 24 horas; por isso, a resposta da coleta não deve ser sua única cópia.
Planeje a próxima execução
Faça o agendador da sua aplicação revisitar o conjunto de fontes aprovadas. Separe no orçamento as cobranças de descoberta, extração e monitoramento, e defina quem recebe um aviso quando uma fonte deixa de retornar o conteúdo esperado.
Se você precisa substituir uma implementação existente do Firecrawl, a comparação de alternativas ao Firecrawl aprofunda a migração e os critérios de aceitação. Trocar de fornecedor e passar da ingestão de documentos ao monitoramento sem código são decisões diferentes.
2. Browse AI: monitoramento sob controle de operações
Browse AI é uma plataforma de scraping e monitoramento sem código que grava uma tarefa em um robô reutilizável. Atende a quem acompanha preços de produtos, vagas ou entradas de diretórios em um conjunto conhecido de sites. A pessoa responsável pode gravar os campos a extrair e enviar os resultados para uma planilha ou um fluxo conectado. O limite decisivo combina páginas, linhas extraídas e domínios monitorados: “robôs ilimitados” não significa dados ilimitados.
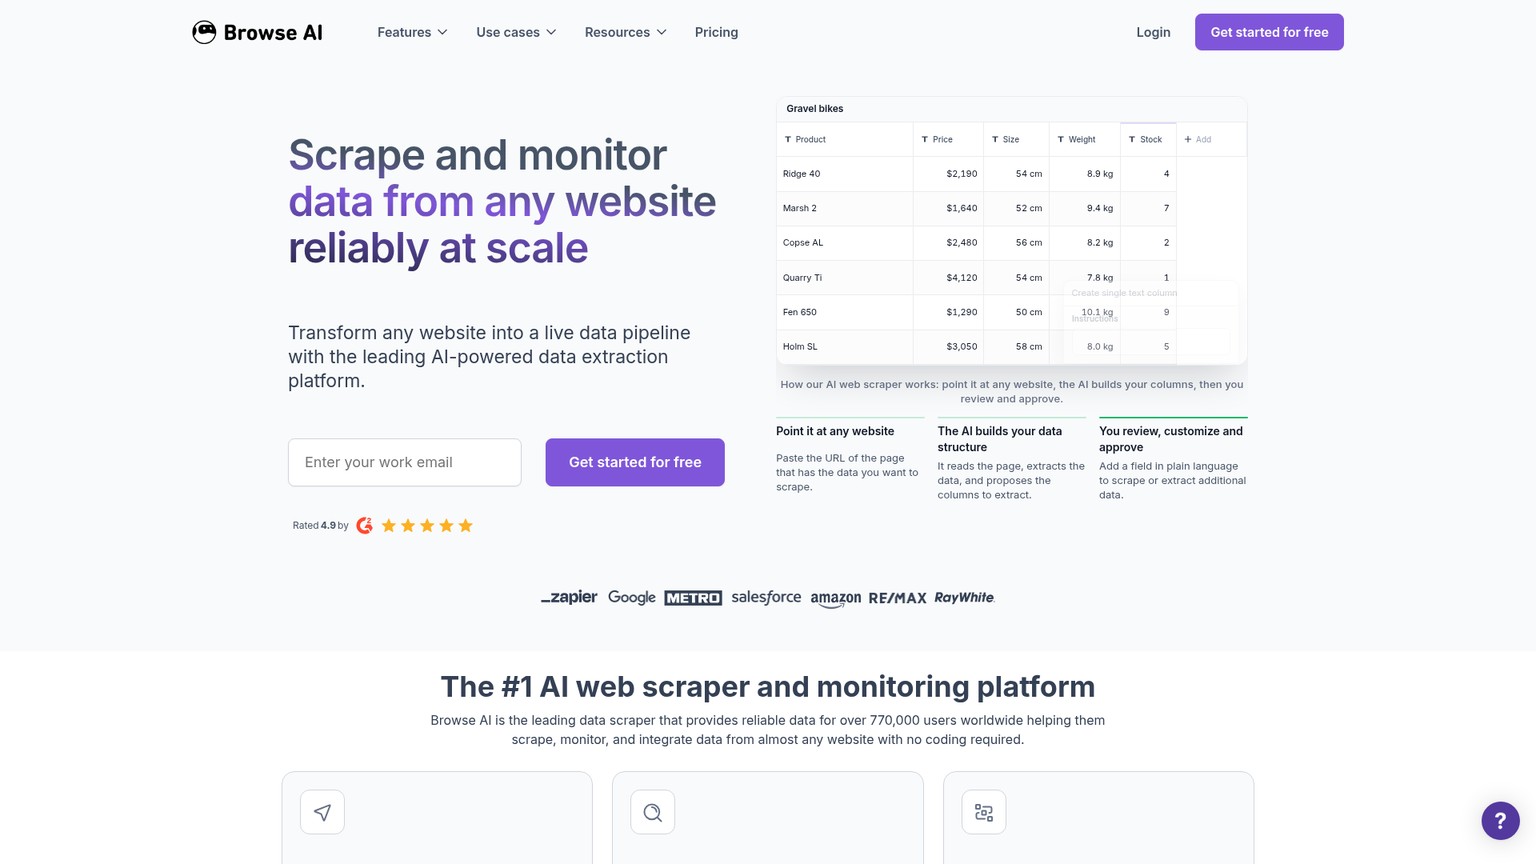
Ideal para: Quem precisa de extração recorrente e monitoramento de mudanças sem manter o código de um scraper.
Destaque: Robôs gravados, monitoramento agendado e integrações com planilhas e fluxos de trabalho.
Preço: Personal $19/mês na cobrança anual, $228 antecipados, com 12,000 créditos anuais.
Opção gratuita: Plano Free com 50 créditos/mês, 2 domínios e robôs ilimitados.
Browse AI cobra um crédito por visita a uma página padrão ou por dez linhas extraídas, conforme o maior consumo. Uma página de lista com 50 produtos custa 5 créditos; visitar as 50 páginas de detalhes acrescenta mais 50, supondo páginas padrão. Assim, “uma lista de produtos” vira uma coleta de 55 créditos quando os detalhes fazem parte do requisito. Sites premium podem custar mais, então confira a cobrança exibida para a tarefa. Preços e exemplos de créditos do Browse AI.
Na oferta anual vigente, os planos são Free por $0, Personal por $19/mês com 12,000 créditos/ano, Professional por $69/mês com 60,000 créditos/ano e Premium a partir de $500/mês na cobrança anual. Personal inclui 5 domínios e 3 usuários; Professional inclui 10 domínios e 10 usuários. Os créditos anuais são liberados de uma só vez. Premium acrescenta um serviço gerenciado de configuração, manutenção e transformação de dados.
A opção de cobrança mensal da página apresenta Personal por $48/mês com 2,000 créditos mensais e Professional por $87/mês com 5,000. Portanto, a oferta anual de $19 do Personal também muda a franquia. Compare a cota efetiva junto com o período de cobrança. Professional anual totaliza $828 antecipados; Personal anual, $228.
O limite de domínios pode chegar antes do limite de créditos. Um fluxo que confere poucos campos em muitos sites de fornecedores pode precisar de domínios adicionais mesmo consumindo poucos dados. Na contratação anual, domínios extras custam $4/mês no Personal e $2.40/mês no Professional. Há recargas de créditos nos planos anuais, com mínimo de 1,000 créditos; o Personal lista $0.024/crédito, e o Professional, $0.017-$0.013/crédito.
Em um fluxo de preços de fornecedores, mantenha o identificador do produto e a moeda junto com o valor. Um robô que extrai um número não consegue decidir se o preço promocional, o preço para membros ou o valor de uma embalagem diferente deve substituir seu registro de compras. Essa interpretação vem da regra de comparação e da fila de revisão.
- Tarefas gravadas permitem inspecionar as instruções de extração.
- Monitoramento, acesso à API e webhooks são listados nos planos.
- Integrações com Google Sheets, Airtable, Zapier e Make atendem a fluxos comuns de operações.
- Domínios adicionais e recargas de créditos anuais podem ampliar um plano.
- Listas com muitas linhas e visitas a páginas de detalhes somam cobranças.
- Os limites de domínios podem exigir um adicional antes de os créditos acabarem.
- A oferta anual mais barata anunciada tem uma cota diferente da do Personal mensal.
- Mudanças no site e campos ambíguos ainda exigem alguém responsável por conferir o resultado.
Escolha Browse AI quando a pessoa responsável pela base de dados também precisar ajustar o robô. Prefira uma API quando a extração for um recurso do seu produto e a engenharia já cuidar do agendamento, do esquema e do tratamento de falhas.
3. Bright Data: escolha o produto antes de comparar o preço
Bright Data é um fornecedor de dados da web que reúne redes de proxies, Scraper APIs prontas e Web Unlocker. Entra na seleção quando o acesso aos sites de destino ou o volume de coleta é o gargalo. Um desenvolvedor de e-commerce pode contratar um scraper específico para um site que devolva registros de produtos; um scraper personalizado já existente pode precisar apenas de proxies residenciais. Essas contratações resolvem camadas diferentes do trabalho e usam unidades de cobrança diferentes.
Ideal para: Coletas em que importam o acesso ao destino, a localização geográfica ou um scraper específico por site mantido pelo fornecedor.
Destaque: Produtos separados para proxies, desbloqueio e registros estruturados.
Preço: Web Scraper API PAYG $1.5/1K registros; proxies residenciais PAYG $8/GB antes do cupom temporário.
Opção gratuita: Scraper API com 5K registros/mês gratuitos; teste de proxies residenciais à parte.
Use Scraper API quando a entrega desejada for o registro. As APIs específicas por site retornam dados estruturados e listam proxies, desbloqueio, interpretação dos dados, execução, armazenamento e tráfego de saída como inclusos. Os planos são Free Tier com 5K registros/mês, PAYG por $1.5/1K registros, Scale por $499/mês com 384,000 registros e $1.3/1K registros adicionais, e Enterprise com preço personalizado. Confira o esquema de entrada e saída do scraper de destino antes de assumir que todos os campos necessários estão incluídos. Preços da Web Scraper API.
Use Web Unlocker quando seu código precisar de gestão de acesso. A página lista gerenciamento automático de proxies, novas tentativas, rotação de IP e resolução de CAPTCHA. Free Tier inclui 5K requisições/mês; PAYG custa $1.5/1K requisições; a oferta Scale exibida custa $499/mês para 383K requisições, com $1.3/1K adicionais. Enterprise tem preço personalizado. A Bright Data esclarece que Web Unlocker não é um navegador interativo para navegar ou clicar nas etapas de um fluxo. Preços e limitações do Web Unlocker.
Use proxies residenciais quando quiser manter o próprio scraper. O cartão detalhado do PAYG mostra $8/GB, reduzidos a $4/GB pela promoção RESIGB50 de três meses. Os pacotes mensais promocionais exibidos são $499 com 141 GB, $999 com 332 GB e $1,999 com 798 GB. Acima de 1 TB, a página orienta solicitar uma cotação personalizada. A medição de banda inclui o tráfego enviado ao destino e recebido dele, além dos registros finais guardados na sua base. Preços de proxies residenciais.
Essa última diferença define o orçamento. Uma requisição que baixa imagens ou outros recursos da página pode consumir banda sem produzir registros úteis adicionais. Uma API de registros inclui esses custos de acesso no preço anunciado por registro; com proxies brutos, você continua responsável pelas requisições, pela interpretação dos dados e pelas verificações de qualidade. O preço por GB só permite calcular o custo por anúncio aceito depois que você mede o fluxo real.
O principal risco é contratar a camada errada. Melhorar o acesso por IP não corrige um parser que seleciona o campo errado. Um scraper de registros mantido por terceiros pode não preservar o comportamento exato da extração personalizada da qual você já depende. Defina o contrato dos dados antes de comparar dois preços que apenas compartilham o nome do fornecedor.
- Scraper APIs específicas por site podem reduzir o trabalho de extração personalizada.
- Produtos por registro, requisição e banda permitem à engenharia contratar a camada necessária.
- O preço da Scraper API inclui os custos de acesso e interpretação descritos na página.
- Franquias gratuitas recorrentes das APIs permitem avaliar os destinos compatíveis.
- A variedade de produtos exige precisão na contratação.
- O tráfego residencial continua sendo cobrado em GB, sem garantia de registros válidos.
- A tarifa promocional de proxies é temporária.
- Web Unlocker não substitui um fluxo com navegador interativo.
Escolha Bright Data quando faltar infraestrutura de acesso ou um scraper adequado mantido pelo fornecedor. Para um pequeno monitor sob responsabilidade de operações, Browse AI é um ponto de partida mais direto; para ingestão de documentação, comece pelas APIs que entregam conteúdo de páginas.
4. Context.dev: dados para agentes e monitoramento na mesma API
Context.dev é uma API de contexto da web cujo site lista scraping, mapeamento de URLs, crawling, processamento em lotes, respostas com fontes e monitores. Atende a desenvolvedores que querem páginas prontas para agentes e atualizações agendadas entregues dentro de uma aplicação. Um assistente apoiado em documentação pode ingerir as fontes iniciais e depois receber atualizações dos monitores por webhook: uma mensagem HTTP enviada à aplicação quando ocorre um evento. Para esse uso, vale avaliá-lo ao lado do Firecrawl; o enriquecimento de marcas é outra oferta do produto, sem determinar a escolha para scraping.
Ideal para: Agentes ou produtos que combinam extração de páginas e monitoramento de fontes por webhook.
Destaque: Scrape, Map, Crawl, Batches e Monitors em uma única API.
Preço: Developer $19/mês com 7,500 créditos mensais.
Opção gratuita: Free Tier com 1,000 créditos/mês, sem cartão, e 10 monitores.
O site lista Markdown, HTML, capturas de tela e campos estruturados, com renderização e proxies incluídos no scrape básico. Os monitores verificam páginas de forma agendada e enviam atualizações para um webhook. Trata-se de uma integração para desenvolvedores: sua aplicação ainda precisa receber a atualização, validá-la e decidir o que alterar nas etapas seguintes. O modelo de responsabilidade difere do de um robô gravado que alimenta uma planilha sob controle de operações. Descrição do produto Context.dev.
Na cobrança mensal, os planos são Free Tier por $0 com 1,000 créditos, Developer por $19 com 7,500, Pro por $99 com 125,000, Growth por $299 com 500,000 e Scale por $499 com 1,000,000. Enterprise tem preço personalizado e lista 2,000,000+ créditos/mês. Os limites de requisições simultâneas das funções principais sobem de 1 no Free para 10 no Developer, 100 no Pro, 250 no Growth e 500 no Scale. Preços do Context.dev.
Um scrape padrão usa 1 crédito. A extração bem-sucedida de JSON acrescenta 4, totalizando 5 créditos por página padrão; ações no navegador elevam o scrape básico para 2 antes da extração. Portanto, incluir renderização e proxies na base não faz toda requisição custar um crédito. O saldo de 7,500 créditos do Developer cobre 1,500 páginas com JSON padrão quando usado exclusivamente nessa operação.
Para novas assinaturas pagas, as recargas custam $2.20 por 1,000 créditos no Developer, $1.80 no Pro, $1.40 no Growth e $1.00 no Scale, cobrados em blocos de 1,000 créditos. Assinaturas existentes mantêm suas tarifas. Assim, é possível comparar um plano pequeno com recargas a um plano maior antes de fazer um upgrade apenas porque o saldo incluído acabou.
O limite específico do crawl é de 500 páginas em uma chamada de Crawl. Sites maiores usam Batches no modo crawl. Divida a ingestão de acordo com esse limite e garanta que os resultados cheguem ao seu armazenamento antes de considerar o lote concluído. Um endpoint de coleta e uma base de conhecimento persistente são partes diferentes da arquitetura.
O outro limite aparece nas entregas parcialmente bem-sucedidas. Context.dev informa que a maioria das requisições com falha não é cobrada, mas respostas de página não encontrada são cobradas, e uma resposta pode reunir saídas com falha e uma saída bem-sucedida. Confira as saídas retornadas e key_metadata.credits_consumed, sem confundir o sucesso externo da resposta com um registro completo.
- Conteúdo de páginas e monitoramento agendado por webhook atendem ao mesmo fluxo de dados para agentes.
- Renderização e proxies estão incluídos no preço do scrape básico.
- O plano gratuito recorrente inclui uma pequena franquia de monitores.
- Blocos de recarga publicados permitem calcular um orçamento concreto para cargas pequenas.
- Extração de JSON e ações no navegador aumentam o consumo de créditos.
- Uma chamada de Crawl tem limite; fontes maiores exigem Batches.
- A entrega por webhook ainda depende da lógica da aplicação e de armazenamento.
- Saídas parciais e páginas não encontradas que geram cobrança exigem verificações de aceitação.
Escolha Context.dev quando essa combinação de recursos da API e seu orçamento de créditos atenderem ao agente. Compare-o ao Firecrawl com as mesmas fontes representativas e o mesmo esquema de saída. Uma franquia inicial maior, por si só, não sustenta uma alegação de qualidade superior.
5. Apify: faz mais sentido quando o Actor certo já existe
Apify é uma plataforma na nuvem para programas reutilizáveis de scraping e automação chamados Actors. É uma boa escolha quando já existe um Actor adequado e mantido para o seu destino: a lógica de extração pode valer mais do que um endpoint genérico de busca de páginas. Quem atualiza uma base de diretórios de empresas pode configurar a entrada do Actor, salvar a tarefa e agendar execuções recorrentes. O limite depende do comportamento e da cobrança do Actor escolhido, além da assinatura da plataforma.
Ideal para: Sites ou tarefas de extração específicos que já contam com um Actor adequado.
Destaque: Programas reutilizáveis na nuvem com agendamento de tarefas e integrações.
Preço: Starter $19/mês + pagamento por uso, incluindo $19 em uso.
Opção gratuita: Plano Free com $5/mês em uso, sem exigir cartão.
O plano Free da Apify custa $0 e oferece $5 para gastar na Store ou no uso da plataforma. Starter custa $19/mês + pagamento por uso, com $19 incluídos; Scale custa $199 com $199 incluídos; Business custa $999 com $999 incluídos. Enterprise tem preço personalizado. A computação custa $0.2 por unidade de computação no Free e no Starter, $0.16 no Scale e $0.13 no Business. Uma unidade de computação equivale a um GB de RAM utilizado por uma hora. Preços da Apify.
O saldo incluído em dólares não representa uma franquia fixa de páginas. O Actor escolhido pode ter preço próprio, enquanto recursos da plataforma, proxies, armazenamento e transferência afetam a conta conforme a carga de trabalho. Compare a execução completa que entrega registros aceitos, em vez de se orientar apenas pelo preço de entrada atraente do programa no marketplace.
Em uma execução explicitamente hipotética, considerando apenas computação, um GB de RAM por dez horas consome dez unidades de computação. No Starter, isso equivale a $2 de uso computacional. O cálculo não informa quantos anúncios serão retornados nem quais cobranças adicionais haverá. Até dizer que $19 compram 95 unidades de computação pressupõe que todo o saldo seja usado em computação, o que pode não acontecer em uma tarefa real de scraping.
As ferramentas de agendamento da Apify executam tarefas salvas com um fuso horário escolhido e enviam notificações por webhook. A documentação informa que novos agendamentos ficam desativados por padrão; salvar um agendamento, portanto, não comprova que a próxima execução acontecerá. Confira se ele está ativado e qual é a próxima execução exibida. Documentação de agendamentos da Apify.
No exemplo do diretório, inspecione a paginação, a cobertura de localidades, os identificadores de saída e o histórico de manutenção do Actor antes de contratar. Um Actor que coleta uma lista de categorias pode não enriquecer cada empresa listada com todos os campos esperados pelo seu CRM. Guarde amostras de registros aceitos e rejeitados e deixe os campos ausentes visíveis.
- Um Actor adequado pode fornecer lógica de extração específica para o destino.
- Tarefas salvas e agendamentos permitem coletas recorrentes.
- O marketplace também inclui fluxos de crawling de conteúdo de páginas.
- O uso incluído dá margem para avaliar a execução completa de uma tarefa pequena.
- Não há um preço universal da Apify por página ou registro.
- As cobranças específicas do Actor podem pesar mais que o plano da plataforma.
- A entrada e a saída da tarefa ainda precisam ser validadas conforme os requisitos da sua base.
- É preciso ativar um novo agendamento antes de contar com ele.
Escolha Apify quando o Actor eliminar um trabalho relevante de extração e o custo da execução completa for aceitável. Use uma API direta de scraping quando a tarefa for principalmente “obter estas páginas conhecidas” e o marketplace acrescentar complexidade sem poupar trabalho.
6. ScrapingBee: busca gerenciada com multiplicadores explícitos por requisição
ScrapingBee é uma API de scraping que gerencia opções de renderização e proxies em um fluxo de extração mantido pelo desenvolvedor. Atende a quem quer preservar o código de interpretação e agendamento, delegando a parte difícil da obtenção das páginas. Por exemplo, um serviço de dados de produtos pode solicitar uma página renderizada e aplicar suas regras existentes de campos ao conteúdo retornado. O primeiro limite a considerar no orçamento é o consumo de créditos das configurações que realmente funcionam no destino.
Ideal para: Desenvolvedores que mantêm a lógica de extração personalizada e substituem a camada de busca de páginas.
Destaque: Controles de renderização e proxies e Auto-Mode com custo máximo em créditos.
Preço: Freelance $49/mês com 250,000 créditos de API.
Opção gratuita: 1,000 créditos de API, sem cartão; nenhum plano gratuito recorrente anunciado.
A sequência completa de planos publicada é Freelance por $49/mês com 250,000 créditos, Startup por $99 com 1,000,000, Business por $249 com 3,000,000 e Business + por $599 com 8,000,000. Enterprise 14 custa $999 com 14,000,000; Enterprise 24, $1,599 com 24,000,000; Enterprise 41, $2,399 com 41,000,000; Enterprise 69, $3,599 com 69,000,000. Capacidades maiores devem ser negociadas com o fornecedor. Os preços não incluem o imposto sobre valor agregado (VAT). Preços do ScrapingBee.
Esses valores representam créditos, não requisições. A documentação informa os seguintes custos de busca: 1 crédito para proxy clássico sem JavaScript, 5 com JavaScript, 10 para proxy premium sem JavaScript, 25 para proxy premium com JavaScript e 75 para proxy stealth com JavaScript. A extração por IA acrescenta mais 5 créditos. A renderização de JavaScript é o comportamento padrão. Custos das requisições do ScrapingBee.
Portanto, a franquia de 250,000 créditos do Freelance cobre, no máximo, 50,000 requisições clássicas com JavaScript, 10,000 requisições premium com JavaScript ou 3,333 requisições completas stealth com JavaScript, se todos os créditos forem usados apenas naquela configuração. São cálculos da franquia, sem medir taxas de sucesso. Recursos extras e destinos com necessidades diferentes alteram esses resultados.
O Auto-Mode pode testar configurações e cobrar pela que funcionar, sem cobrança caso todas falhem. A configuração max_cost limita quais configurações ele pode tentar. Mas a documentação informa que o modo não escolhe automaticamente instruções de espera ou cliques específicas para cada página. Se o preço desejado só aparecer após uma seleção ou um carregamento assíncrono, você ainda precisa definir o comportamento necessário. Documentação do Auto-Mode.
Esse é o limite: a configuração de busca não define a intenção da extração. Uma resposta HTML correta pode conter um espaço reservado vazio, o preço da região padrão ou uma seleção que seu cliente não faria. Guarde as evidências da resposta e confira o campo de negócio, indo além do sucesso da chamada de API.
- Atende a um scraper personalizado cuja interpretação e cujo agendamento devem permanecer no seu código.
- Configurações de renderização e proxies têm custos em créditos publicados.
- Auto-Mode permite limitar o custo de uma configuração de acesso.
- Simultaneidade e capacidade aumentam conforme uma sequência explícita de planos.
- A mesma franquia de créditos anunciada cobre quantidades muito diferentes de requisições.
- A extração por IA gera uma cobrança adicional de créditos.
- Auto-Mode não fornece configurações de espera ou cliques específicas para o destino.
- A oferta gratuita é um teste, sem franquia permanente para trabalho agendado.
Escolha ScrapingBee quando o controle da requisição for valioso e você já souber validar a resposta. Prefira uma API de registros ou um Actor adequado da Apify quando o trabalho que deseja eliminar for a manutenção das regras de extração do destino.
7. Octoparse: tarefas visuais e agendamento na nuvem em planos pagos
Octoparse é uma aplicação visual de scraping para quem está disposto a criar e manter tarefas de extração. Faz sentido para coletas recorrentes de catálogos ou anúncios quando a equipe de operações precisa de um construtor de tarefas em vez de uma integração por API. Um analista de compras pode definir os campos da lista e dos detalhes e depois levar o fluxo aprovado para a execução paga na nuvem. O plano Free é útil para avaliação local, mas não atende à expectativa de um fluxo de dados sem supervisão.
Ideal para: Quem cria tarefas visuais de extração e contrata execução na nuvem quando necessário.
Destaque: Scraping por tarefas, com agendamento na nuvem e exportação automática nos planos pagos.
Preço: Standard a partir de $69/mês na cobrança anual.
Opção gratuita: Free Plan com 10 tarefas locais e 50,000 linhas exportadas/mês.
Free inclui 10 tarefas, execução no dispositivo local, até 10,000 linhas por exportação e 50,000 linhas de exportação mensal. Standard acrescenta extração na nuvem, agendamento de tarefas, exportação automática e Data Export API, com 100 tarefas e até 3 processos simultâneos na nuvem. Professional permite 250 tarefas e até 20 processos simultâneos na nuvem, além de Advanced API e suporte adicional. Enterprise lista 750+ tarefas e 40+ processos simultâneos na nuvem. Detalhes dos planos do Octoparse.
Os planos publicados são Free por $0, Standard a partir de $69/mês, Professional por $249/mês e Enterprise com preço personalizado. Os dois valores pagos são cobrados anualmente. Trate esses equivalentes mensais como ofertas anuais e confirme o valor da fatura na contratação antes de prever o desembolso. Preços do Octoparse.
A unidade de cobrança é uma assinatura com limites de tarefas e processos, em vez de um crédito padrão por requisição. Isso pode atender a um fluxo com bastante extração dentro de um conjunto administrável de tarefas, mas “exportação ilimitada de dados” nos planos pagos não significa trabalho ilimitado em paralelo na nuvem. Os três processos simultâneos na nuvem do Standard podem ser o limite relevante muito antes de você chegar a 100 tarefas salvas.
Os adicionais continuam separados. A página de preços lista proxies residenciais por $3/GB, resolução de CAPTCHA por $1-1.5 por mil e modelos com pagamento por resultado por $0.001-3 por mil resultados. A assinatura paga não inclui gratuitamente todos os custos avançados de acesso.
Para um fluxo de catálogos de fornecedores, comece localmente com uma tarefa pequena e valide a cobertura da lista e dos detalhes. Depois, confirme como a execução na nuvem trata a mesma entrada, onde a exportação é entregue e quem recebe as falhas. Mesmo um analista que saiba criar a tarefa precisa de uma rotina para conferir se os registros esperados foram coletados.
- A criação visual de tarefas atende a quem quer controlar as instruções de extração.
- Tarefas locais gratuitas permitem avaliar um fluxo antes de contratar a nuvem.
- Standard inclui explicitamente agendamento e exportação automática.
- Limites de tarefas e processos na nuvem deixam clara a capacidade de execução.
- A execução gratuita é local e não entrega a tarefa sem supervisão na nuvem.
- O volume de exportação pago não elimina limites de tarefas ou simultaneidade.
- Adicionais de proxies, CAPTCHA e modelos podem gerar cobranças por uso.
- A tarifa de entrada exige cobrança anual.
Escolha Octoparse quando a criação visual de tarefas trouxer uma vantagem relevante e os limites de processos na nuvem atenderem ao agendamento. Browse AI é a primeira opção mais direta para um monitor gravado; uma API se encaixa melhor quando a extração faz parte de um produto de software.
8. Zyte: preço de acesso conforme o site de destino
Zyte é um fornecedor de dados da web cuja Zyte API cobra por respostas bem-sucedidas conforme a dificuldade do site e a solicitação de conteúdo HTTP ou renderização no navegador. Atende a desenvolvedores que operam um coletor e querem gestão automática de acesso sem contratar um conjunto bruto de proxies. Um serviço de anúncios pode manter sua própria base e interpretação dos dados enquanto orça o modo de resposta realmente necessário para cada destino. O menor preço só é útil quando vem acompanhado do compromisso de gasto e da categoria de site a que se aplica.
Ideal para: Coletores mantidos por desenvolvedores com orçamento de acesso específico por destino.
Destaque: Cobrança por resposta bem-sucedida, com tarifas separadas para HTTP e navegador.
Preço: PAYG HTTP $0.13-$1.27 por 1,000; navegador $1.01-$16.08 por 1,000.
Opção gratuita: $5 de crédito por 30 dias, sem compromisso; nenhum plano gratuito recorrente anunciado.
As tarifas PAYG HTTP para destinos Simple, Easy, Moderate, Complex e Advanced são $0.13, $0.23, $0.44, $0.70 e $1.27 por 1,000 respostas. As tarifas PAYG com navegador são $1.01, $2.01, $4.02, $8.04 e $16.08. Assim, o mesmo volume de requisições pode gerar contas muito diferentes conforme o destino e a necessidade de conteúdo renderizado. Preços da Zyte.
Compromissos mensais de gasto reduzem essas tarifas. Um compromisso de $100 lista HTTP por $0.10-$0.95 e navegador por $0.75-$12.00 por 1,000. Com $200, as faixas são $0.08-$0.76 e $0.60-$9.60. Com $500, são $0.06-$0.61 e $0.48-$7.68. O preço de Enterprise deve ser consultado com a equipe de vendas. O destaque “a partir de $0.06” da página pertence à sequência de compromissos de gasto; não é o preço de entrada PAYG HTTP.
Para um exemplo ilustrativo de 100,000 respostas bem-sucedidas, a tarifa Simple PAYG HTTP resulta em $13 de uso. A tarifa Simple com navegador resulta em $101; a Advanced com navegador, em $1,608. São cálculos com as tarifas publicadas, sem afirmar em qual categoria seu site ficará. Recursos avançados podem gerar cobranças adicionais; use o estimador do fornecedor para o site específico e o modo de saída pretendido.
O limite aqui é a viabilidade econômica de cada destino. Um destino HTTP de baixa complexidade e um destino avançado renderizado não devem compartilhar o mesmo custo presumido por página. Segmente a lista de URLs por destino e modo, guarde a contagem de respostas aceitas e compare os planos com compromisso de gasto conforme essa composição.
O acesso bem-sucedido também deixa o contrato de extração sob sua responsabilidade. Seu parser ainda precisa obter o identificador correto do anúncio, os campos e as verificações de completude. Se uma API de registros mantida pelo fornecedor ou um Actor já entregar a base de que você precisa, o preço menor de acesso, sozinho, pode não justificar a manutenção da extração personalizada.
- Preços separados de HTTP e navegador permitem um orçamento preciso por destino.
- Cinco categorias de dificuldade mostram variações que um preço único de entrada pode esconder.
- Compromissos mensais oferecem uma sequência visível de tarifas.
- A API lista recursos de renderização, rotação de IP e geolocalização.
- A menor tarifa em destaque exige um compromisso mensal de gasto.
- Renderizar no navegador pode mudar bastante a viabilidade econômica.
- Recursos avançados podem custar mais.
- A resposta ainda precisa de interpretação e validação dos requisitos de negócio.
Escolha Zyte quando seu fluxo de engenharia precisar de acesso gerenciado e puder medir a composição dos destinos. Comece pela estimativa PAYG antes de assumir um compromisso apenas para obter o menor número da página.
Quanto custa coletar dados da web de forma agendada?
Conte as operações repetidas e defina o formato de saída antes de comparar preços de entrada. Use este exemplo explícito de planejamento: uma pessoa à frente de um negócio revisita 120 páginas conhecidas diariamente em um mês de 30 dias, gerando 3,600 visitas a páginas. Considere páginas comuns, sem ações extras no navegador, chamadas de descoberta, cobranças de endpoints de monitoramento ou novas tentativas cobradas. É uma planilha de orçamento, sem carga de trabalho medida nem promessa de acesso aos destinos.
Para scrapes básicos em Markdown, essas 3,600 visitas consomem 3,600 créditos tanto no Firecrawl quanto no Context.dev. Firecrawl Hobby inclui 5,000 créditos por $19/mês, e Context.dev Developer inclui 7,500 por $19/mês. As duas assinaturas mensais de entrada cobrem esse volume específico de scraping. Firecrawl, Context.dev.
Se você solicitar JSON estruturado bem-sucedido nas mesmas páginas padrão, a necessidade passa a 18,000 créditos em cada serviço. Firecrawl Hobby precisa de 13 blocos adicionais de 1,000 créditos por $5: $19 + $65 = $84/mês. Context.dev Developer, usando a tarifa publicada para novas assinaturas, precisa de 11 blocos adicionais de 1,000 créditos por $2.20: $19 + $24.20 = $43.20/mês. O arredondamento por blocos deixa alguns créditos sem uso no cálculo do Context.dev.
Um monitor sem código exige a mesma conta de frequência. No Browse AI, 3,600 verificações de páginas padrão/mês viram 43,200/ano, antes de considerar mais linhas ou destinos premium. Os 60,000 créditos anuais do Professional cobrem esse volume ilustrativo; os 12,000 do Personal não. A franquia mensal do Professional é de 5,000 créditos por $87, enquanto o Professional anual custa $69/mês com $828 pagos antecipadamente. Browse AI.
Proxies brutos exigem outra planilha. Comece pelos GB medidos e acrescente hospedagem do scraper, trabalho de extração e tratamento de exceções. Uma API de registros começa pelos registros entregues que geram cobrança. Apify começa pelo Actor escolhido e pelo uso de recursos. Não transforme nenhum desses custos em uma promessa por página sem medir a tarefa real.
Qual ferramenta faz sentido para cada equipe?
A regra de decisão é definir se você precisa de conteúdo de páginas, de um monitor mantido por operações, de um registro pronto específico para o destino ou de acesso para um código que já mantém. O upgrade pago deve resolver o limite que você está enfrentando. Uma lista maior de recursos, sozinha, não justifica a contratação.
A melhor ferramenta depende de quem corrige a próxima execução
Se a engenharia cuida do recurso de dados, avalie uma API que retorne o conteúdo e os metadados necessários. Se operações cuida de um processo baseado em planilhas, avalie um robô visual que a pessoa responsável consiga inspecionar. Se ninguém cuida das falhas ainda, atribua essa responsabilidade antes de aumentar a frequência de coleta.
A escolha muda quando muda a responsabilidade. Um desenvolvedor pode tornar uma API de scraping o componente adequado para um produto. Essa mesma API pode ser uma compra inadequada para alguém de operações que precisa de um resultado diário e não tem uma aplicação para recebê-lo. Por outro lado, uma tarefa gravada pode ser rápida de avaliar, mas criar atrito quando a extração se torna um recurso central do produto.
Web scraping com IA exige um esquema e uma regra de aceitação
Trate a extração como um contrato de dados. Para um registro de preço, defina identificador do produto, variante, valor numérico, moeda, URL de origem e horário da coleta. Decida como lidar com valores ausentes ou ambíguos antes da primeira atualização automatizada. Um objeto JSON limpo é um formato; um registro correto para o negócio depende da avaliação conforme esse contrato.
Na ingestão de documentos, guarde a fonte e o horário da obtenção e exclua elementos repetidos de navegação sem relevância quando fizer sentido. Preserve a resposta original quando uma verificação automática rejeitar uma página. Essas evidências permitem à pessoa responsável distinguir uma mudança no site de uma definição de campo equivocada.
Qual scraper com IA atende melhor a um agente?
Comece com Firecrawl para um fluxo de scrape, crawl e map voltado a páginas. Acrescente Context.dev à seleção quando sua combinação de processamento em lotes e monitoramento por webhook atender à aplicação. Se um Actor adequado da Apify já coletar os campos necessários do destino, avalie essa execução completa junto com as APIs genéricas de páginas.
Compare as opções com um conjunto fixo de fontes e a mesma saída esperada. Inclua uma página comum, uma página renderizada, uma relação entre lista e detalhes e uma página com um campo ambíguo. A franquia de entrada ajuda a calcular o custo, mas não comprova que um serviço produza dados melhores.
Web scraping com Python: ferramentas para uma coleta agendada
Um fluxo em Python pode chamar uma API e manter agendamento, interpretação, persistência e validação na própria aplicação. Escolha Firecrawl ou Context.dev quando quiser conteúdo de páginas ou extração estruturada gerenciada. Escolha ScrapingBee ou Zyte quando a interpretação dos dados deva continuar sob seu controle e a busca de páginas for o componente a substituir.
Esse controle extra traz trabalho de operação. Diferencie claramente erro de transporte, página de erro do destino, campo ausente e registro rejeitado pelas regras de negócio. Não repita cegamente as tentativas para todas as categorias: uma regra de extração errada não melhora só porque a mesma requisição foi executada de novo.
Qual opção gratuita tem uma franquia recorrente útil?
Firecrawl e Context.dev anunciam 1,000 créditos mensais cada. Browse AI oferece 50 créditos mensais em 2 domínios. Apify fornece $5/mês em uso, e Bright Data Scraper API fornece 5K registros/mês. Essas franquias podem atender a pequenas avaliações ou tarefas recorrentes modestas, desde que a operação necessária caiba nelas.
Para uma única página padrão verificada diariamente em um mês de 30 dias, a franquia de 50 créditos do Browse AI cobre as 30 verificações. É um exemplo útil de monitor gratuito, desde que a página não seja um destino premium e o número de linhas extraídas não aumente a cobrança. Os 1,000 créditos do ScrapingBee e os $5 da Zyte são testes; Octoparse Free roda localmente. Essas diferenças pesam mais do que o rótulo “gratuito”.
Ferramentas open source: quando vale manter a própria infraestrutura?
O núcleo do Firecrawl, que pode ser hospedado por você, é uma opção quando o controle do código ou da infraestrutura justifica operar os serviços. O código aberto elimina a assinatura do fornecedor para esse núcleo, mas não fornece hospedagem, monitoramento, recuperação nem um engenheiro para corrigir a próxima falha.
Use o guia de hospedagem própria do Firecrawl para avaliar essa responsabilidade operacional antes de tratá-lo como a forma mais barata de fazer scraping. Para uma equipe pequena de produto que só precisa de um endpoint que retorne páginas conhecidas, planos gerenciados de entrada podem evitar um projeto separado de infraestrutura. Escolha hospedagem própria para um requisito concreto de controle, com alguém capaz de sustentá-la.
Como as ferramentas foram selecionadas
O comparativo prioriza adequação ao uso, transparência da cobrança e o limite que muda a decisão de contratação. Na apuração deste comparativo, foram consultadas as páginas de preços e a documentação relevante dos fabricantes, e os valores foram conferidos em 6 de outubro de 2026. Os exemplos de custo são cálculos baseados nessas tarifas publicadas e em premissas explícitas de carga de trabalho. Não houve teste prático dos produtos, e o artigo não apresenta um ranking de velocidade, precisão ou taxa de sucesso.
Firecrawl, Bright Data, Browse AI e Context.dev são ferramentas parceiras deste site; Apify, ScrapingBee, Octoparse e Zyte oferecem alternativas independentes. A parceria não torna proxies brutos a compra certa para um monitor de operações, nem um robô gravado a API certa para um recurso de software. As recomendações seguem essas distinções de responsabilidade.
Os critérios práticos são: o produto retorna a saída necessária? Quem cuida da configuração e dos reparos? Qual operação repetida gera cobrança? Que cota ou limite de simultaneidade chega primeiro? O que acontece com uma resposta incompleta ou rejeitada? Um marketplace maior ou um preço inicial mais baixo não responde a essas perguntas sozinho.
Catálogos de frameworks e bibliotecas de navegador ficaram fora da seleção porque o leitor está escolhendo um serviço recorrente, um fluxo sem código ou infraestrutura de acesso. Operar um navegador interativamente é uma exigência diferente quando a tarefa depende de muita navegação, além da coleta de páginas.
Confira os termos do site de destino e o robots.txt antes de agendar a coleta.
Escolhas que vale evitar
Evite uma contratação inadequada, mesmo quando o produto é bom em outro uso. Estas são as escolhas com maior chance de criar o trabalho que a compra deveria eliminar.
- Octoparse Free para um fluxo na nuvem sem supervisão. As tarefas rodam localmente. Contrate a execução na nuvem exigida pelo processo ou escolha um serviço com o modelo operacional adequado.
- Proxies residenciais da Bright Data para comprar uma base pronta. Eles fornecem acesso; requisições, interpretação e aceitação continuam sob sua responsabilidade. Use uma Scraper API adequada quando quiser comprar o registro.
- A oferta anual em destaque do Browse AI Personal para um monitor grande e frequente. A franquia anual de 12,000 créditos não cobre a tarefa ilustrativa de 43,200 créditos por ano. Dimensione primeiro visitas, linhas, destinos premium e domínios.
- O destaque de $0.06 da Zyte como cotação PAYG. É o menor valor da categoria com compromisso de $500. Estime o destino e o modo reais antes de assumir esse compromisso.
- O total de créditos do ScrapingBee como garantia de requisições. Configurações de renderização e proxies podem consumir vários créditos na mesma requisição. Faça o orçamento com a configuração que funciona.
- Firecrawl ou Context.dev como um sistema completo de qualidade de dados. Ambos podem entregar conteúdo que você precisa rejeitar. Guarde evidências do status e da saída e proteja os registros seguintes contra atualizações incompletas.
O produto a evitar é aquele que deixa você mantendo justamente a camada que esperava delegar. Uma divisão precisa de responsabilidades vale mais do que um ranking geral confiante.
O que fazer na segunda-feira
Faça uma avaliação pequena e agendada, com uma pessoa responsável. Selecione dez URLs representativas, defina os campos ou o conteúdo dos documentos esperados e estabeleça o que tornará uma resposta inaceitável. Para uma tarefa sem código, grave o fluxo; para uma API, conecte-a ao agendador e ao armazenamento.
Execute uma vez por dia durante sete dias. Preserve a resposta original, o status do destino, a saída, as unidades de cobrança consumidas e a contagem de registros aceitos. Inspecione paginação, valores ausentes, identificadores duplicados e mudanças que devem ou não gerar uma atualização.
Depois, calcule o mês completo com a composição de destinos observada. Selecione a opção menos complexa que cumpra os requisitos de entrega e responsabilidade e mantenha as verificações de aceitação depois do teste. Um fluxo de dados fica pronto para produção quando entrega resultados úteis de forma repetível, além da primeira requisição bem-sucedida.
Quais são boas ferramentas de web scraping?
Firecrawl e Context.dev atendem à obtenção de conteúdo de páginas para agentes; Browse AI e Octoparse atendem a fluxos de extração visual; Bright Data, Zyte e ScrapingBee atendem a diferentes necessidades de acesso e busca de páginas. Apify é especialmente útil quando já existe o Actor certo para o destino específico. Escolha primeiro a entrega e a pessoa responsável, depois compare a conta mensal completa.
O ChatGPT consegue fazer scraping de sites?
ChatGPT pode abrir sites e reunir informações com seu recurso de navegador, conforme a documentação oficial da OpenAI. Isso pode atender a uma coleta interativa. Para preços, anúncios ou documentos de agentes coletados de forma recorrente, avalie separadamente agendamento, esquema de saída, resultados salvos e responsabilidade pelas falhas. A escolha aqui é qual serviço fornece esse fluxo recorrente, além da capacidade de um assistente de IA de ler uma página.
Qual é a melhor IA para web scraping?
Escolha o serviço de extração e a saída esperada antes de selecionar um modelo de linguagem. Firecrawl e Context.dev entram na seleção para Markdown ou campos estruturados; Browse AI atende a um robô mantido por operações. A melhor opção é a que retorna as informações necessárias nas suas fontes representativas com um custo total aceitável.
Web scraping ficou ultrapassado?
Confira primeiro se o destino oferece uma API ou um feed adequado. Quando a informação necessária só é publicada em páginas, a extração continua sendo uma opção. Para contratar, a distinção útil é quem cuida da obtenção, da extração, do agendamento e da validação. O rótulo de IA do produto não resolve essa divisão.
Quais são as 10 melhores ferramentas de web scraping?
Esta seleção cobre oito produtos para três necessidades recorrentes: dados para agentes, monitoramento sem código e acesso em escala. Escolha dentro desses usos em vez de acrescentar ferramentas apenas para chegar a dez. Um projeto de automação de navegador ou um framework hospedado por você envolve uma decisão de responsabilidade diferente da dos serviços comparados aqui.
Receba o AI Business Workflow Audit Checklist pela newsletter e mapeie a entrega, o agendamento, as regras de aceitação e a pessoa responsável antes de adotar um fluxo de dados da web.
- Última atualização
- 6 de out. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

RAG IA e memória de agentes: o que guardar e quanto custa
Entenda como a memória de agentes conecta contexto, sessões, arquivos e RAG, quanto custa manter tudo isso e como evitar dados desatualizados e vazamentos.5 de out. de 2026Build
Pinecone pricing: custos de 1M a 100M de vetores em 2026
Entenda os preços do Pinecone: Starter grátis, Builder a $20, mínimos dos planos pagos e custos de 1M a 100M de vetores conforme o volume de consultas.5 de out. de 2026Build
Lovable alternatives em 2026: quando vale trocar de ferramenta
Compare alternativas ao Lovable pelo custo real, backend e exportação de código. Veja quando Replit, Emergent, Bolt, Blink, Base44 e v0 fazem sentido.5 de out. de 2026Build
LLM observability em 2026: quais ferramentas compensam para sua equipe?
Compare seis ferramentas de LLM observability: preços para 100,000 execuções mensais, custos por tamanho de equipe, licenças e suporte a OpenTelemetry.5 de out. de 2026Build
OpenCode na prática: instalação, modelos e custos
Aprenda a instalar e usar OpenCode, conectar modelos e Ollama, configurar AGENTS.md e plugins e entender a cobrança de API e os custos do Zen.4 de out. de 2026Build
Hospedagem Netlify: preços, créditos e planos em 2026
Veja os preços da hospedagem Netlify, os limites de créditos e quanto custam um site, um app Next.js e uma agência. Compare Free, Personal e Pro.4 de out. de 2026Build
Softr vale a pena? Preços, planos e limites em outubro de 2026
Softr vale a pena para portais de clientes e sistemas internos? Veja preços em USD, planos, limites de usuários e recursos de IA antes de escolher.4 de out. de 2026Build