Web scraping nel 2026: 8 strumenti a confronto, tra costi e limiti
Confronta 8 strumenti di web scraping per agenti AI, monitoraggio no-code e raccolta su larga scala: prezzi, crediti, limiti e costi delle attività ricorrenti.




Per ottenere pagine pulite da dare in lettura a un agente AI, il primo strumento da valutare è Firecrawl. Per un monitoraggio gestibile da chi segue le attività operative, Browse AI; quando invece il problema è accedere ai siti da cui raccogliere i dati, Bright Data. Nel web scraping, gli strumenti migliori rispondono a esigenze diverse: Firecrawl e Context.dev partono entrambi da $19/mese con fatturazione mensile, ma chiedere dati strutturati in JSON cambia il consumo di crediti. Prima del fornitore, scegli il risultato da ottenere, la frequenza delle esecuzioni e chi interverrà quando qualcosa non funziona.
Web scraping: gli strumenti a colpo d'occhio
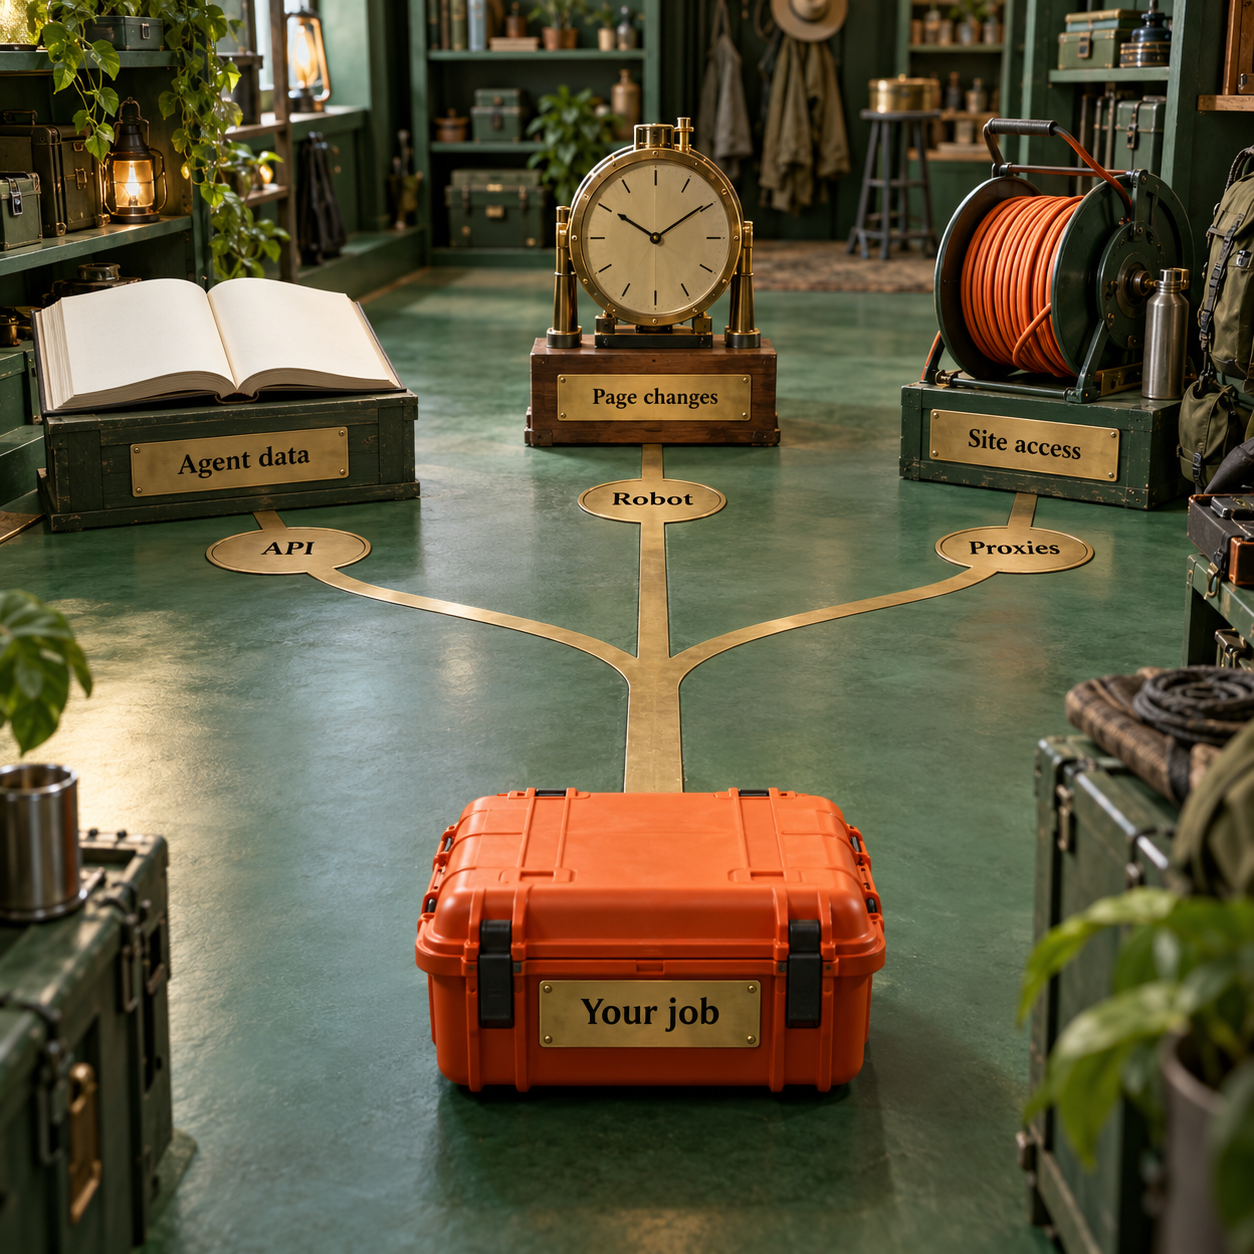
Acquista il componente che manca al tuo flusso di lavoro. Un'API di scraping è un servizio che il tuo software chiama per recuperare i dati di una pagina: è adatta a uno sviluppatore che costruisce un agente o un dataset. Un robot no-code serve a chi deve ripetere una raccolta dati senza programmare. Una rete di proxy, che instrada il traffico attraverso altri indirizzi IP, è utile se hai già uno scraper e vuoi migliorarne l'accesso ai siti di destinazione.
Prezzi e quote riportati qui sotto sono stati verificati sulle pagine ufficiali dei produttori il 6 ottobre 2026. Le tariffe annuali sono indicate come tali; le prove gratuite sono distinte dalle quote che si rinnovano. La colonna del prezzo di partenza riporta l'offerta a pagamento più accessibile, mentre l'ultima mostra cosa puoi valutare senza sottoscrivere un piano a pagamento.
La tabella aiuta a restringere la scelta: un record consegnato, una pagina visitata e un gigabyte non sono unità equivalenti. Il coupon RESIGB50 di Bright Data pubblicizza uno sconto del 50% sui proxy per tre mesi. Usa questa tariffa temporanea nel budget della prova; per la previsione dei costi ricorrenti, considera quella ordinaria.
Prima il risultato, poi chi se ne occuperà
Qui si confrontano tre esigenze di acquisto diverse: se cambia il lavoro da svolgere, cambia lo strumento. Un founder che carica documentazione in un assistente, un responsabile operativo che controlla i prezzi dei concorrenti e uno sviluppatore che aggiorna un grande dataset di annunci non dovrebbero partire dallo stesso confronto tra prodotti.
Prima esigenza: trasformare le pagine in materiale utile a un agente
Parti da Firecrawl o Context.dev se ti servono contenuti di pagina o campi strutturati all'interno della tua applicazione. Markdown è testo leggibile che conserva titoli e link: è utile quando un agente AI deve consultare il documento. JSON organizza i dati in campi con un nome, come prodotto, prezzo, valuta e disponibilità: serve quando il flusso di lavoro richiede un record da validare e confrontare.
La differenza incide sia sulla qualità sia sul costo. A un assistente per il supporto può bastare una pagina di documentazione ripulita. Per un avviso sui prezzi servono invece il campo del prezzo, la valuta, la variante corretta del prodotto e un timestamp. Dare una pagina a un modello non stabilisce quale dei prezzi presenti interessi alla tua attività.
Distingui anche scrape, che recupera una pagina, crawl, che segue i link di un sito per recuperarne più di una, e map, che individua gli URL. Se mantieni già un elenco affidabile di URL, ripetere la ricerca delle pagine può aggiungere lavoro senza migliorare il flusso dei dati. Se la documentazione del sito continua a crescere, individuare le nuove pagine fa parte del compito.
Seconda esigenza: controllare pagine note senza dover mantenere codice
Scegli Browse AI per registrare un'attività di estrazione e monitorare le modifiche con uno strumento gestibile da un operatore. Valuta Octoparse se si adattano meglio al tuo processo la progettazione visuale delle attività e l'estrazione cloud a pagamento. Qui un robot è una sequenza salvata di azioni e istruzioni di estrazione, non un sostituto universale di un dipendente.
Per esempio, un responsabile operativo può aver bisogno ogni mattina di nome, prezzo e disponibilità dei prodotti di un fornitore. Il risultato utile è un foglio di calcolo con colonne stabili e una segnalazione chiara quando un campo scompare. Chi gestisce il processo deve poter esaminare l'attività e adattarla quando il sito cambia.
Prima della frequenza, decidi cosa considerare una modifica. Un cambiamento nel piè di pagina non dice nulla sulle scorte. Se un elenco riordina le righe, non dovrebbe sembrare che tutti i prodotti siano stati sostituiti. Conserva un identificatore stabile, confronta i campi rilevanti e manda in revisione i dati mancanti, invece di sovrascrivere senza avviso il valore valido del giorno precedente.
Terza esigenza: raccogliere dati su larga scala quando il problema è l'accesso
Valuta Bright Data, Zyte o ScrapingBee quando il tuo software gestisce già pianificazione e dataset, ma recuperare le pagine diventa la parte difficile. Un servizio di sblocco gestisce aspetti dell'accesso come i nuovi tentativi e la scelta dei proxy. Non definisce automaticamente il significato dei dati nel tuo dataset.
Bright Data offre anche Scraper API per siti specifici: può quindi fornire un record più completo, anziché il solo accesso alla rete. Apify copre un'altra esigenza utile: un Actor mantenuto per il sito che ti interessa potrebbe già implementare l'estrazione necessaria. Un Actor è un programma cloud riutilizzabile che configuri ed esegui.
La scelta dipende da chi mantiene ciascun componente. Se vuoi usare una logica di estrazione mantenuta da altri, valuta una Scraper API o un Actor. Se vuoi conservare il tuo codice di parsing, valuta un'API per recuperare le pagine o un servizio proxy. Pagare per il solo accesso aspettandosi un dataset pronto è un errore costoso.
Otto strumenti e i limiti da conoscere
Ogni strumento qui sotto risponde a un'attività ricorrente precisa. La numerazione facilita la consultazione; la scelta migliore per ciascun compito dipende dal risultato, dai limiti e dalle responsabilità descritti nella relativa sezione.
1. Firecrawl: da valutare per primo per le pagine destinate agli agenti
Firecrawl è un'API di scraping che trasforma i siti in contenuti di pagina utilizzabili: è la prima opzione da valutare per un agente che consulta documentazione. Le funzioni Scrape, Crawl e Map coprono rispettivamente il recupero delle pagine, la scansione del sito e l'individuazione degli URL, mantenendo distinti questi tre compiti. Un founder che costruisce un assistente per il supporto può mappare la documentazione, selezionare i percorsi rilevanti e raccogliere quelle pagine in Markdown. Sceglilo se il risultato richiesto è il contenuto pulito delle pagine; riconsidera la scelta se ti serve soprattutto un monitoraggio su foglio di calcolo gestito da un operatore.
Ideale per: Uno sviluppatore che fornisce documentazione, articoli o pagine di riferimento a un agente AI.
Punto di forza: Funzioni separate per scrape, crawl e map, con Markdown ed estrazione strutturata.
Prezzi: Hobby $19/mese, oppure $16/mese con fatturazione annuale; 5,000 crediti mensili.
Offerta gratuita: Piano Free ricorrente con 1,000 crediti/mese, senza carta richiesta.
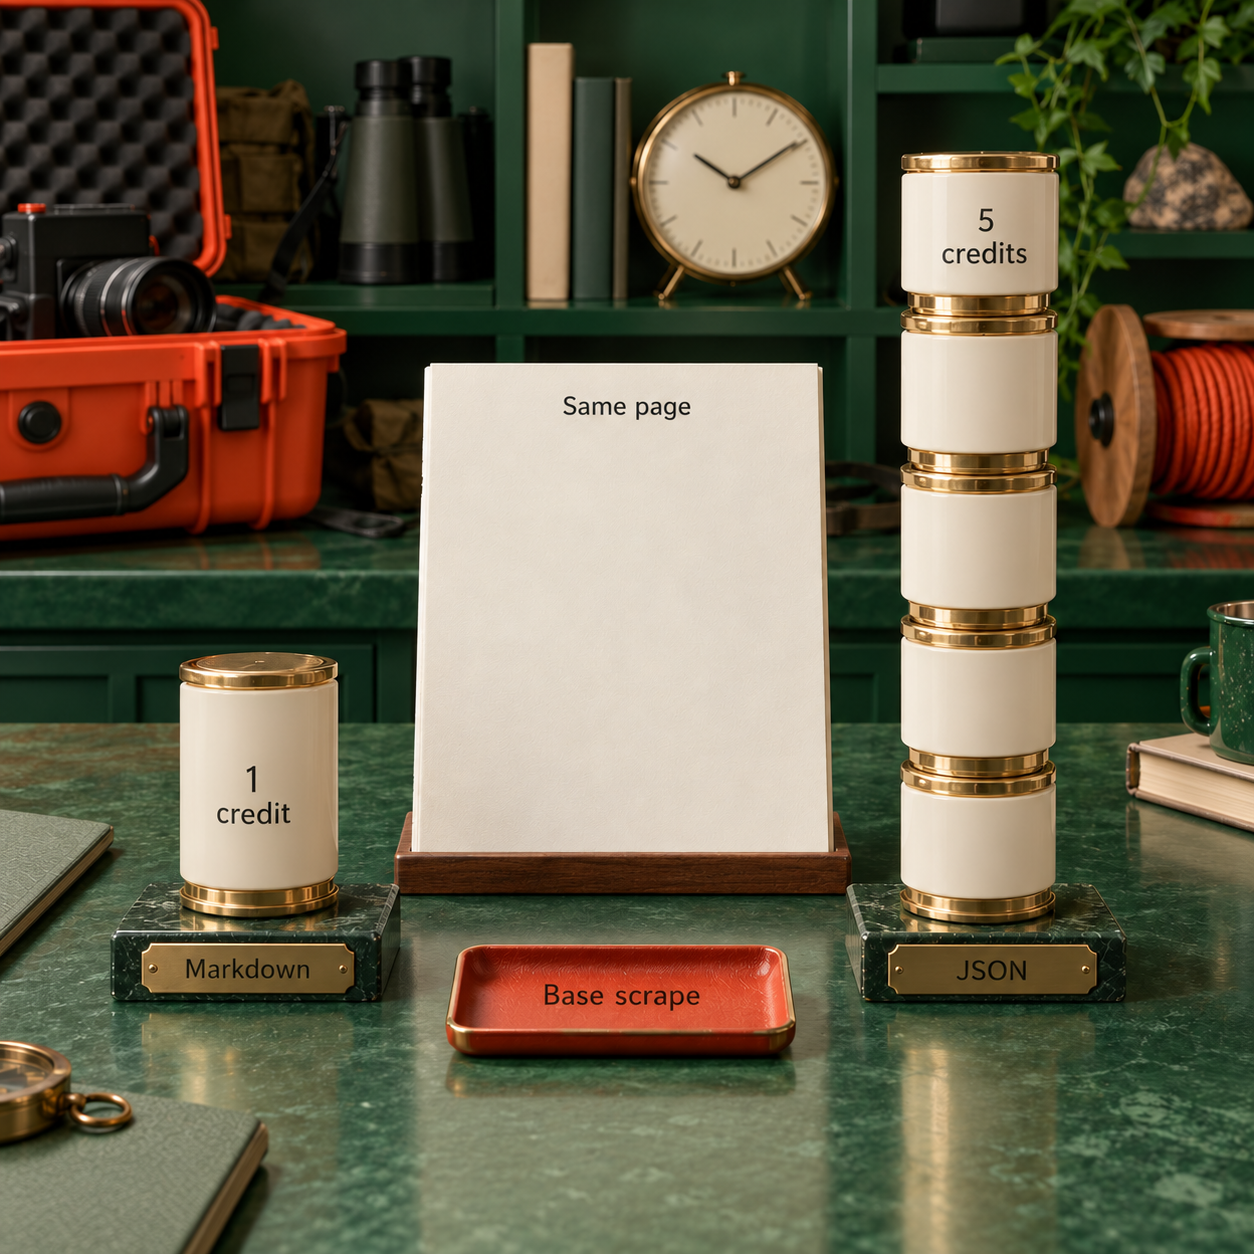
Una pagina recuperata con scrape o crawl di base costa 1 credito. L'estrazione JSON aggiunge 4 crediti, quindi una richiesta standard che restituisce pagina e JSON costa 5 crediti. Hobby consente perciò 5,000 pagine di base oppure 1,000 pagine JSON standard, se tutto il saldo viene usato per quella sola operazione. Lo stesso abbonamento cambia molto in base al risultato richiesto. Dettagli dei prezzi di Firecrawl.
Con fatturazione mensile, i piani sono Free a $0, Hobby a $19 per 5,000 crediti, Standard a $99 per 100,000, Growth a $399 per 500,000 e Scale a $749 per 1,000,000. Enterprise ha un prezzo personalizzato. Gli equivalenti mensili dell'offerta annuale pubblicati sono $16, $83, $333 e $599/mese, con fatture annuali rispettivamente di $190, $990, $3,990 e $7,190. Sono le cifre mostrate dal produttore, con i suoi arrotondamenti. Tutti i piani Firecrawl.
Il primo limite riguarda la dimensione richiesta del crawl. La documentazione di Firecrawl indica un limite predefinito di 10,000 pagine e spiega che un'attività può essere rifiutata se i crediti residui non coprono il limite richiesto. Per un piccolo sito sul piano Hobby può quindi servire un limit esplicito più basso, prima ancora di recuperare la prima pagina. Il limite successivo è il numero di richieste simultanee: Hobby ne consente 5, Standard 25, Growth 50 e Scale 100. Avere più crediti non elimina il limite alle richieste parallele del piano in uso. Comportamento del crawl.
Conta anche la verifica del risultato. Firecrawl dichiara che uno scrape senza risultati non viene addebitato; una pagina di errore restituita dal sito, per esempio 403 o 404, costa invece un credito. Controlla lo stato del sito e il contenuto ricevuto prima di inserirlo nella base di conoscenza. Una pagina di errore convertita perfettamente in Markdown resta una pagina di errore.
- Scrape, crawl e map permettono di scegliere separatamente come individuare e recuperare le pagine.
- Markdown è adatto all'acquisizione di documenti; JSON a uno schema di campi definito.
- La quota gratuita ricorrente permette di valutare un piccolo carico di lavoro programmato.
- Le ricariche a pagamento consentono di aumentare l'utilizzo prima di cambiare piano.
- L'estrazione strutturata riduce sensibilmente il numero di pagine di base coperto dalla quota.
- Un limite di crawl predefinito elevato può superare il saldo di un piccolo account.
- Le pagine di errore restituite possono essere fatturate e richiedono una validazione da parte tua.
- I crediti Hobby, Standard e Growth normalmente non si trasferiscono al periodo successivo.
Mappa le fonti prima di raccogliere tutto
Usa il playground Map per individuare gli URL della documentazione. Conserva i percorsi che rispondono alle domande effettive del tuo assistente. La mappatura individua gli indirizzi; lo scraping delle pagine è un'operazione separata.
Scegli il risultato utile meno costoso
Parti da Markdown per un assistente che consulta documenti. Usa uno schema JSON quando il flusso successivo richiede campi con un nome. Prima di considerare lo schema sufficientemente chiaro, verificalo su una pagina prodotto rappresentativa che mostri sia il prezzo ordinario sia quello scontato.
Imposta un limite di crawl coperto dai crediti
Per l'insieme esemplificativo di 120 pagine, imposta un
limitesplicito di 120. Filtra i percorsi, invece di lasciare che il crawler consumi il saldo su pagine del blog o dell'account non pertinenti.Salva il risultato e gli elementi per validarlo
Conserva nel tuo sistema di archiviazione l'URL di origine, l'ora della raccolta, lo stato restituito dal sito e il contenuto. La documentazione di Firecrawl indica che i risultati dei crawl completati restano disponibili via API per 24 ore: la risposta dell'API non dovrebbe quindi essere la tua unica copia.
Pianifica consapevolmente l'esecuzione successiva
Fai rivisitare dallo scheduler della tua applicazione l'insieme delle fonti approvate. Tieni separati nel budget i costi di individuazione delle pagine, estrazione e monitoraggio, e decidi chi riceve una segnalazione quando una fonte smette di restituire il contenuto atteso.
Se devi sostituire una configurazione Firecrawl esistente, il confronto tra le alternative a Firecrawl approfondisce migrazione e criteri di accettazione. Cambiare fornitore è una decisione diversa dal passare dall'acquisizione di documenti al monitoraggio no-code.
2. Browse AI: il monitoraggio nelle mani dell'operatore
Browse AI è una piattaforma no-code per scraping e monitoraggio che registra un'attività in un robot riutilizzabile. È adatta a chi segue prezzi dei prodotti, offerte di lavoro o voci di directory su un insieme noto di siti. L'operatore può registrare i campi da estrarre e inviare i risultati a un foglio di calcolo o a un flusso di lavoro collegato. Il limite decisivo nasce dalla combinazione di pagine, righe estratte e domini monitorati: «robot illimitati» non significa dati illimitati.
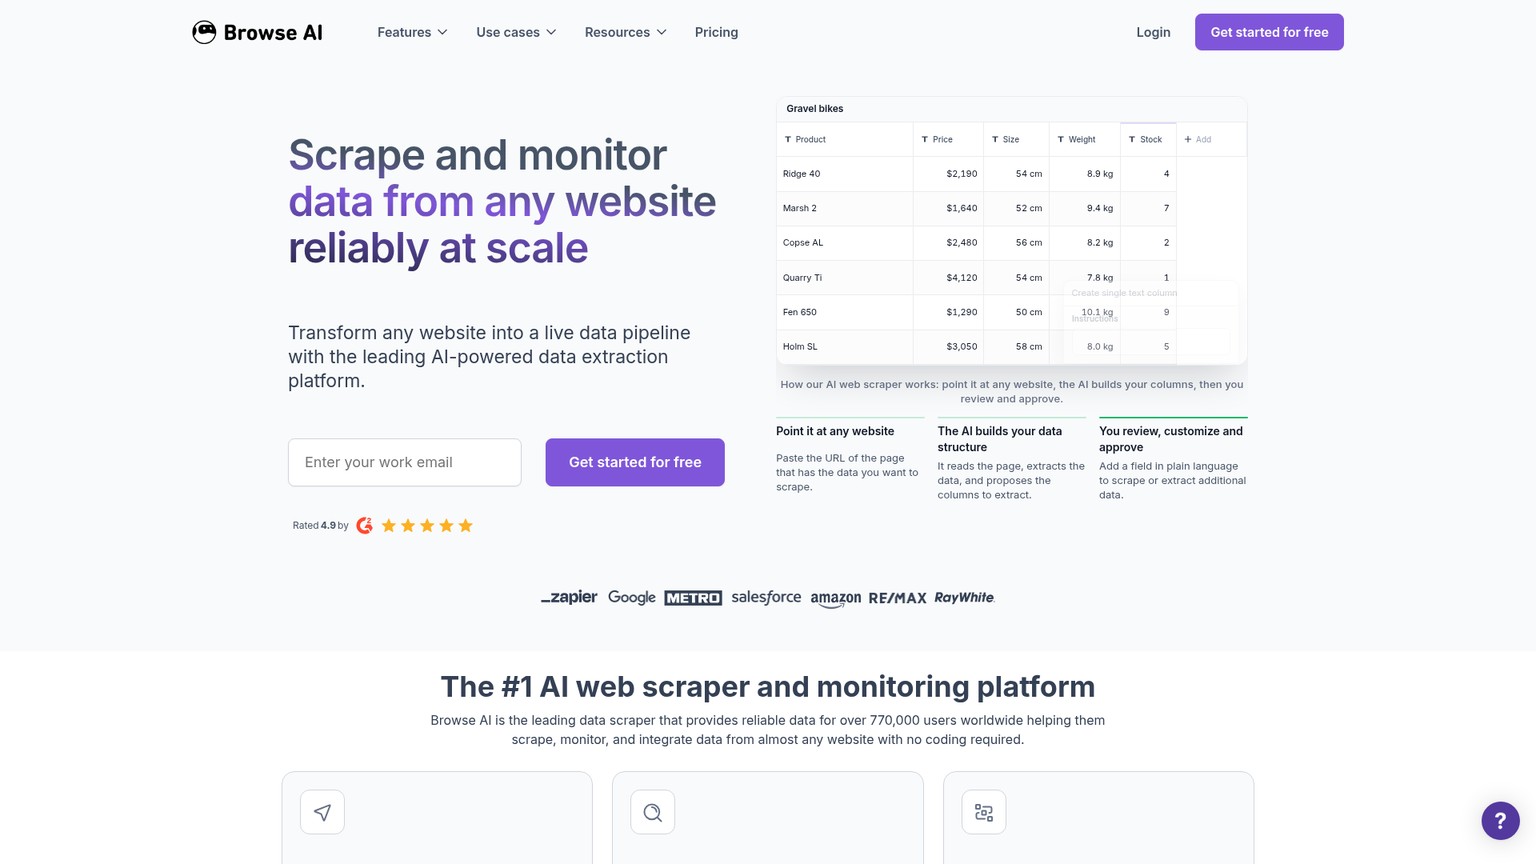
Ideale per: Un operatore che ha bisogno di estrazioni ricorrenti e monitoraggio delle modifiche senza mantenere il codice di uno scraper.
Punto di forza: Robot registrati, monitoraggio programmato e integrazioni con fogli di calcolo e flussi di lavoro.
Prezzi: Personal $19/mese con fatturazione annuale, $228 anticipati e 12,000 crediti annuali.
Offerta gratuita: Piano Free con 50 crediti/mese, 2 domini e robot illimitati.
Browse AI addebita un credito per visita a una pagina standard oppure per dieci righe estratte, applicando il conteggio più alto. Una pagina elenco con 50 prodotti costa 5 crediti; visitare tutte le 50 pagine di dettaglio ne aggiunge altri 50, ipotizzando pagine standard. Se servono anche i dettagli, «un elenco di prodotti» diventa quindi una raccolta da 55 crediti. I siti premium possono costare di più: controlla il costo indicato per l'attività. Prezzi di Browse AI ed esempi di consumo dei crediti.
L'offerta annuale pubblicata comprende Free a $0, Personal a $19/mese con 12,000 crediti/anno, Professional a $69/mese con 60,000 crediti/anno e Premium da $500/mese con fatturazione annuale. Personal include 5 domini e 3 utenti; Professional 10 domini e 10 utenti. I crediti annuali vengono assegnati tutti in anticipo. Premium aggiunge un servizio gestito per configurazione, manutenzione e trasformazione dei dati.
L'opzione con fatturazione mensile riporta Personal a $48/mese per 2,000 crediti mensili e Professional a $87/mese per 5,000. L'offerta annuale Personal da $19 non è dunque la stessa quota con una diversa data di pagamento. Confronta la quantità di crediti effettiva oltre alla durata dell'abbonamento. Professional annuale richiede $828 anticipati; Personal annuale $228.
Il limite dei domini può arrivare prima di quello dei crediti. Un processo che controlla pochi campi su molti siti di fornitori può richiedere domini aggiuntivi anche se usa pochi dati. Con l'offerta annuale, i domini extra sono indicati a $4/mese su Personal e $2.40/mese su Professional. I piani annuali consentono ricariche di crediti, con un minimo di 1,000 crediti: Personal indica $0.024/credito e Professional $0.017-$0.013/credito.
Per monitorare i prezzi dei fornitori, conserva accanto al valore un identificatore del prodotto e la valuta. Un robot che estrae un numero non può decidere se un prezzo in promozione, riservato ai membri o riferito a una confezione diversa debba sostituire il dato usato per gli acquisti. Questo significato viene dalla tua regola di confronto e dal processo di revisione.
- Le attività registrate permettono all'operatore di esaminare le istruzioni di estrazione.
- Monitoraggio, accesso API e webhook sono indicati nei vari piani.
- Le integrazioni con Google Sheets, Airtable, Zapier e Make supportano i flussi operativi più comuni.
- Domini aggiuntivi e ricariche annuali di crediti possono estendere un piano.
- Elenchi con molte righe e visite alle pagine di dettaglio fanno aumentare insieme il costo.
- I limiti sui domini possono rendere necessario un componente aggiuntivo prima di esaurire i crediti.
- L'offerta annuale più economica pubblicizzata ha una quota diversa da Personal mensile.
- Modifiche ai siti e campi ambigui richiedono comunque un responsabile che controlli il risultato.
Scegli Browse AI quando chi risponde del dataset deve anche poter modificare il robot. Scegli invece un'API quando l'estrazione è una funzionalità del tuo prodotto e il team di sviluppo gestisce già pianificazione, schema e problemi di esecuzione.
3. Bright Data: scegli il prodotto prima di confrontare il prezzo
Bright Data è un fornitore di dati web che offre reti di proxy, Scraper API già pronte e Web Unlocker. Va valutato quando il limite è l'accesso ai siti o il volume della raccolta. Uno sviluppatore ecommerce potrebbe acquistare uno scraper per un sito specifico che restituisce record di prodotto; uno scraper personalizzato già esistente potrebbe invece aver bisogno di proxy residenziali. Sono acquisti che risolvono parti diverse del lavoro e usano unità di fatturazione diverse.
Ideale per: Raccolte in cui contano l'accesso al sito, l'area geografica o uno scraper mantenuto per una fonte specifica.
Punto di forza: Prodotti distinti per proxy, sblocco dell'accesso e record strutturati.
Prezzi: Web Scraper API PAYG $1.5/1K record; proxy residenziali PAYG $8/GB prima del coupon temporaneo.
Offerta gratuita: Scraper API offre 5K record/mese gratis; la prova dei proxy residenziali è separata.
Usa Scraper API quando il risultato da acquistare è il record. Le API per siti specifici restituiscono dati strutturati e indicano come inclusi proxy, sblocco, parsing, esecuzione, archiviazione e trasferimento in uscita. I piani sono Free Tier con 5K record/mese, PAYG a $1.5/1K record, Scale a $499/mese con 384,000 record e $1.3/1K record aggiuntivi, poi Enterprise con prezzo personalizzato. Controlla lo schema di input e output dello scraper scelto prima di presumere che comprenda ogni campo necessario. Prezzi di Web Scraper API.
Usa Web Unlocker quando al tuo codice serve una gestione dell'accesso. La pagina indica gestione automatica dei proxy, nuovi tentativi, rotazione degli IP e risoluzione dei CAPTCHA. Free Tier include 5K richieste/mese; PAYG costa $1.5/1K richieste; l'offerta Scale mostrata è di $499/mese per 383K richieste, con $1.3/1K aggiuntive. Enterprise ha un prezzo personalizzato. Bright Data precisa che Web Unlocker non è un browser interattivo per navigare o fare clic lungo un flusso di lavoro. Prezzi e limiti di Web Unlocker.
Usa i proxy residenziali se vuoi mantenere lo scraper. La scheda dettagliata PAYG mostra $8/GB, ridotti a $4/GB dalla promozione RESIGB50 di tre mesi. I pacchetti mensili promozionali esposti sono $499 con 141 GB, $999 con 332 GB e $1,999 con 798 GB. Oltre 1 TB, la pagina rimanda a un preventivo personalizzato. La banda conteggiata comprende il traffico inviato al sito e ricevuto dal sito, non soltanto i record finali conservati nel tuo database. Prezzi dei proxy residenziali.
Quest'ultima distinzione determina il budget. Una richiesta che scarica immagini o altre risorse della pagina può consumare banda senza produrre altri record utili. Un'API di record include i costi di accesso nel prezzo pubblicizzato per record; con i soli proxy, richieste, parsing e controlli di qualità restano a tuo carico. Il prezzo per GB non permette di conoscere il costo per annuncio accettato finché non misuri il flusso effettivo.
Il rischio principale è acquistare il componente sbagliato. Un accesso IP migliore non corregge un parser che seleziona il campo errato. Uno scraper di record mantenuto da altri non conserverà necessariamente il comportamento di estrazione personalizzato su cui già fai affidamento. Definisci i requisiti dei dati prima di confrontare prezzi che hanno in comune soltanto il nome del fornitore.
- Le Scraper API per siti specifici possono ridurre il lavoro di estrazione personalizzato.
- Prodotti fatturati per record, richieste o banda permettono agli sviluppatori di acquistare il componente necessario.
- Il prezzo di Scraper API include i costi di accesso e parsing descritti nella sua pagina.
- Le quote API gratuite ricorrenti permettono di valutare i siti supportati.
- L'ampiezza dell'offerta richiede una scelta di acquisto precisa.
- Il traffico residenziale resta fatturato in GB, senza garantire record validi.
- La tariffa promozionale dei proxy è temporanea.
- Web Unlocker non sostituisce un flusso di lavoro con browser interattivo.
Bright Data è la scelta da valutare quando manca l'infrastruttura di accesso o uno scraper mantenuto adatto al sito. Per un piccolo monitoraggio gestito da un operatore, Browse AI è un punto di partenza più diretto; per acquisire documentazione, parti dalle API che restituiscono il contenuto delle pagine.
4. Context.dev: dati per agenti e monitoraggio nella stessa API
Context.dev è un'API per fornire contesto web; il suo sito elenca scraping, mappatura degli URL, crawling, elaborazioni in batch, risposte con fonti e monitoraggio. È adatta a uno sviluppatore che vuole pagine utilizzabili dagli agenti e aggiornamenti programmati da ricevere in un'applicazione. Un assistente basato sulla documentazione può acquisire le fonti iniziali e poi ricevere gli aggiornamenti tramite webhook: un messaggio HTTP inviato alla sua applicazione quando si verifica un evento. Per questo compito merita di essere valutata insieme a Firecrawl; l'arricchimento dei dati sui brand è un'altra parte dell'offerta, non il motivo per sceglierla per lo scraping.
Ideale per: Un agente o prodotto che combina estrazione delle pagine e monitoraggio delle fonti via webhook.
Punto di forza: Scrape, Map, Crawl, Batches e Monitors in un'unica API.
Prezzi: Developer $19/mese con 7,500 crediti mensili.
Offerta gratuita: Free Tier con 1,000 crediti/mese, senza carta e con 10 monitor.
Il sito indica Markdown, HTML, screenshot e campi strutturati, con rendering e proxy inclusi nello scrape di base. I monitor controllano le pagine a intervalli programmati e inviano gli aggiornamenti a un webhook. È un'integrazione per sviluppatori: la tua applicazione deve comunque ricevere l'aggiornamento, validarlo e decidere cosa modificare nei passaggi successivi. La responsabilità operativa è diversa da quella di un robot registrato che un operatore usa per alimentare un foglio di calcolo. Descrizione del prodotto Context.dev.
I piani mensili sono Free Tier a $0 per 1,000 crediti, Developer a $19 per 7,500, Pro a $99 per 125,000, Growth a $299 per 500,000 e Scale a $499 per 1,000,000. Enterprise ha un prezzo personalizzato e indica 2,000,000+ crediti/mese. I limiti delle richieste simultanee di base salgono da 1 su Free a 10 su Developer, 100 su Pro, 250 su Growth e 500 su Scale. Prezzi di Context.dev.
Uno scrape standard usa 1 credito. L'estrazione JSON riuscita ne aggiunge 4, per un totale di 5 crediti per pagina standard; le azioni nel browser portano lo scrape di base a 2 prima dell'estrazione. Rendering e proxy inclusi nella base non significano quindi che ogni richiesta costi un credito. Il saldo di 7,500 crediti di Developer copre 1,500 pagine JSON standard se viene usato esclusivamente per quell'operazione.
Per i nuovi abbonamenti, le ricariche a pagamento costano $2.20 per 1,000 crediti su Developer, $1.80 su Pro, $1.40 su Growth e $1.00 su Scale, con fatturazione in blocchi di 1,000 crediti. Gli abbonamenti esistenti mantengono le proprie tariffe. Chi acquista può quindi confrontare un piano piccolo con ricariche e un piano più grande, invece di passare al piano superiore soltanto perché il saldo incluso è terminato.
Il limite dichiarato per il crawl è di 500 pagine in una singola chiamata Crawl. I siti più grandi richiedono Batches in modalità crawl. Organizza di conseguenza l'acquisizione e assicurati che i risultati arrivino nel tuo sistema di archiviazione prima di considerare il batch completato. Un endpoint di raccolta e una base di conoscenza persistente sono componenti distinti dell'architettura.
L'altro limite riguarda i risultati riusciti solo in parte. Context.dev dichiara che la maggior parte delle richieste fallite non viene fatturata, ma le risposte di pagina non trovata sì; una risposta può inoltre contenere risultati falliti accanto a uno riuscito. Controlla i risultati restituiti e key_metadata.credits_consumed, anziché considerare una risposta complessivamente riuscita equivalente a un record completo.
- Contenuto delle pagine e monitoraggio programmato via webhook si inseriscono nello stesso flusso di dati per agenti.
- Rendering e proxy sono inclusi nel prezzo dello scrape di base.
- Il piano gratuito ricorrente comprende una piccola quota di monitoraggio.
- I blocchi di ricarica pubblicati permettono di calcolare un budget concreto per piccoli carichi di lavoro.
- Estrazione JSON e azioni nel browser aumentano il consumo di crediti.
- Una singola chiamata Crawl ha un limite; le fonti più grandi richiedono Batches.
- La consegna via webhook richiede comunque logica applicativa e archiviazione.
- Risultati parziali e pagine non trovate fatturabili richiedono controlli di accettazione.
Scegli Context.dev se questa combinazione di funzioni API e budget di crediti si adatta al tuo agente. Confrontala con Firecrawl usando le stesse fonti rappresentative e lo stesso schema di output, senza trasformare la maggiore quota del piano di ingresso in una promessa di qualità priva di riscontri.
5. Apify: dà il meglio quando l'Actor giusto esiste già
Apify è una piattaforma cloud per programmi riutilizzabili di scraping e automazione chiamati Actors. È una scelta valida quando esiste già un Actor adatto e mantenuto per il sito che ti interessa: la sua logica di estrazione può valere più di un endpoint generico per recuperare pagine. Un operatore che aggiorna un dataset di aziende da una directory può configurare l'input dell'Actor, salvare l'attività e programmarne le esecuzioni. Il limite dipende dal comportamento e dalla fatturazione dell'Actor scelto, non soltanto dall'abbonamento alla piattaforma.
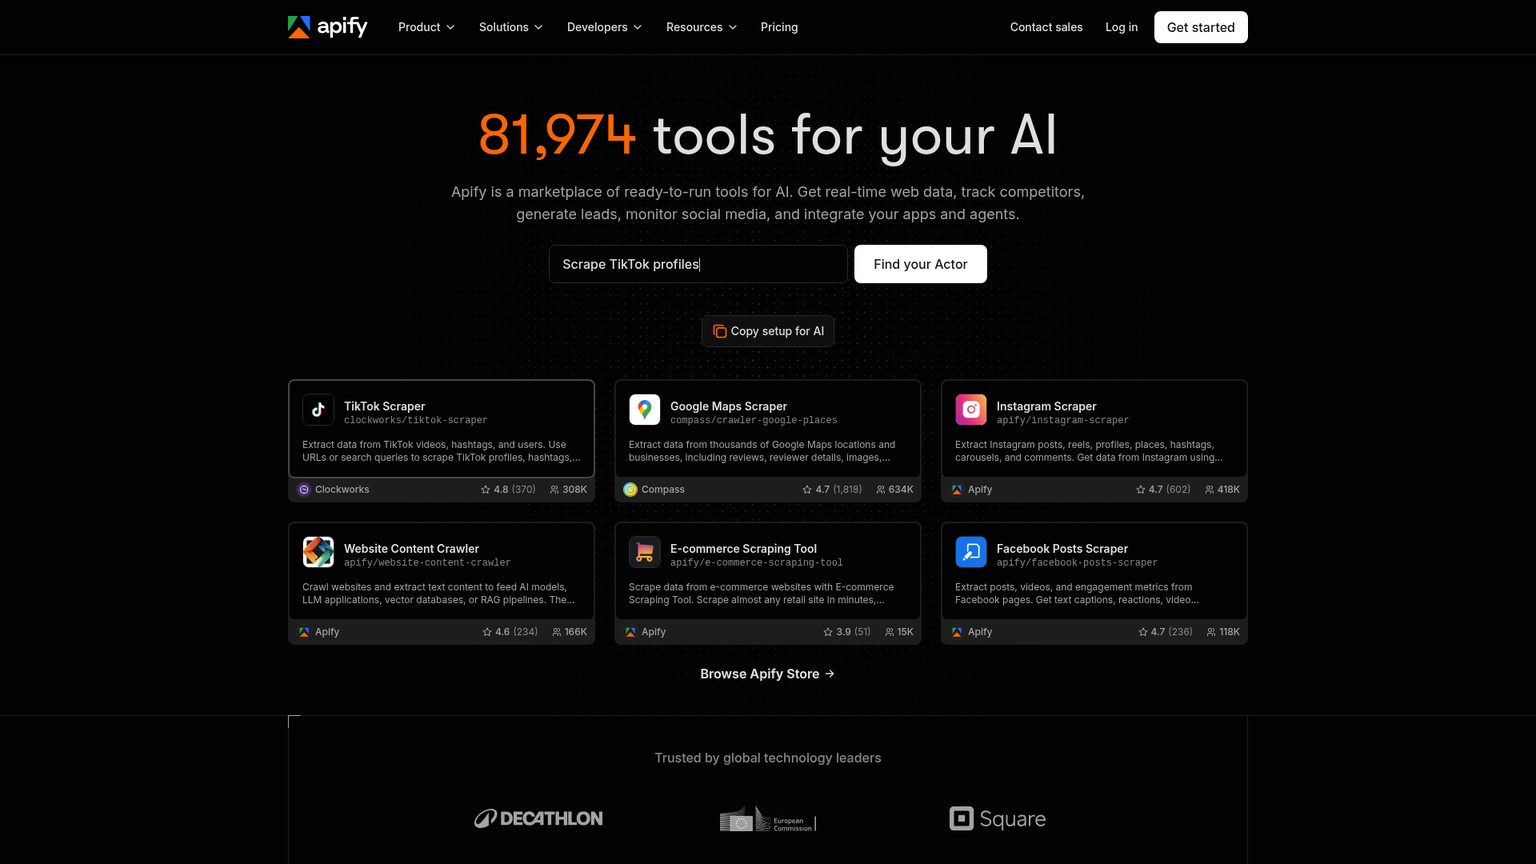
Ideale per: Un sito o un'attività di estrazione per cui esiste già un Actor adatto.
Punto di forza: Programmi cloud riutilizzabili con pianificazione delle attività e integrazioni.
Prezzi: Starter $19/mese + consumo, con $19 di utilizzo inclusi.
Offerta gratuita: Piano Free con $5/mese di utilizzo, senza carta richiesta.
Il piano Free di Apify costa $0 e comprende $5 da spendere nello Store o nell'utilizzo della piattaforma. Starter costa $19/mese + consumo, con $19 inclusi; Scale $199 con $199 inclusi; Business $999 con $999 inclusi. Enterprise ha un prezzo personalizzato. Il calcolo costa $0.2 per unità su Free e Starter, $0.16 su Scale e $0.13 su Business. Un'unità di calcolo corrisponde a un GB di RAM utilizzato per un'ora. Prezzi di Apify.
Non considerare il saldo incluso in dollari una quota fissa di pagine. L'Actor scelto può avere un prezzo proprio, mentre risorse della piattaforma, proxy, archiviazione e trasferimento incidono sulla fattura in base al carico di lavoro. Confronta il costo dell'intera esecuzione che restituisce record accettabili, non soltanto l'invitante prezzo di partenza del programma nel marketplace.
In un esempio dichiaratamente ipotetico limitato al calcolo, un GB di RAM per dieci ore consuma dieci unità di calcolo. Su Starter sono $2 di utilizzo. Il dato non dice nulla sul numero di annunci restituiti o sui costi aggiuntivi. Anche affermare che $19 acquistano 95 unità di calcolo presuppone che ogni dollaro vada al calcolo, condizione che un'attività reale di scraping potrebbe non rispettare.
Gli strumenti di pianificazione di Apify possono eseguire attività salvate con un fuso orario scelto e inviare notifiche via webhook. La documentazione indica che le nuove pianificazioni sono disabilitate per impostazione predefinita: salvarne una non dimostra che la prossima esecuzione avverrà. Controlla che sia abilitata e verifica la prossima esecuzione mostrata. Documentazione delle pianificazioni Apify.
Nell'esempio della directory, prima di decidere controlla paginazione, copertura geografica, identificatori nei risultati e cronologia di manutenzione dell'Actor. Un Actor che raccoglie un elenco di categoria non necessariamente arricchisce ogni azienda elencata con tutti i campi richiesti dal tuo CRM. Conserva un campione dei record accettati e rifiutati, rendendo visibili i campi mancanti.
- Un Actor adatto può fornire la logica di estrazione per un sito specifico.
- Attività salvate e pianificazioni supportano la raccolta ricorrente.
- Il marketplace include anche flussi di crawling dei contenuti delle pagine.
- L'utilizzo incluso permette di valutare l'esecuzione completa di un piccolo lavoro.
- Non esiste un prezzo Apify universale per pagina o record.
- I costi specifici dell'Actor possono pesare più del piano della piattaforma.
- Input e output dell'attività devono comunque essere validati rispetto ai requisiti del dataset.
- Una nuova pianificazione deve essere abilitata prima di farvi affidamento.
Scegli Apify quando l'Actor elimina una parte significativa del lavoro di estrazione e il costo dell'esecuzione completa è accettabile. Usa un'API di scraping diretta se il compito consiste soprattutto nel «recuperare queste pagine note» e il marketplace aggiunge complessità senza risparmiarti lavoro.
6. ScrapingBee: recupero gestito delle pagine, con moltiplicatori espliciti
ScrapingBee è un'API di scraping che gestisce rendering e opzioni proxy per un flusso di estrazione curato dallo sviluppatore. È adatta a chi vuole conservare il codice di parsing e pianificazione delegando gli aspetti più difficili del recupero delle pagine. Un servizio di dati sui prodotti, per esempio, può richiedere una pagina renderizzata e applicare al contenuto ricevuto le proprie regole sui campi. Il primo limite da mettere a budget è il costo in crediti della configurazione che funziona davvero sul sito scelto.
Ideale per: Uno sviluppatore che mantiene la logica di estrazione personalizzata e sostituisce il componente che recupera le pagine.
Punto di forza: Controlli per rendering e proxy, e Auto-Mode con un costo massimo in crediti.
Prezzi: Freelance $49/mese con 250,000 crediti API.
Offerta gratuita: 1,000 crediti API senza carta; nessun piano gratuito ricorrente pubblicizzato.
L'intera offerta pubblicata comprende Freelance a $49/mese per 250,000 crediti, Startup a $99 per 1,000,000, Business a $249 per 3,000,000 e Business + a $599 per 8,000,000. Enterprise 14 costa $999 per 14,000,000; Enterprise 24 $1,599 per 24,000,000; Enterprise 41 $2,399 per 41,000,000; Enterprise 69 $3,599 per 69,000,000. Per capacità superiori occorre contattare il fornitore. I prezzi escludono l'IVA. Prezzi di ScrapingBee.
Si tratta di crediti, non di richieste. I costi documentati per recuperare le pagine sono 1 credito con proxy classico senza JavaScript, 5 con JavaScript, 10 con proxy premium senza JavaScript, 25 con proxy premium e JavaScript, e 75 con proxy stealth e JavaScript. L'estrazione AI aggiunge altri 5 crediti. Il rendering JavaScript è attivo per impostazione predefinita. Costi delle richieste ScrapingBee.
La quota di 250,000 crediti di Freelance copre quindi al massimo 50,000 richieste con proxy classico e JavaScript, 10,000 con proxy premium e JavaScript oppure 3,333 richieste complete con proxy stealth e JavaScript, se tutti i crediti vengono usati per una sola configurazione. Sono calcoli sulla quota, non misurazioni dei tassi di riuscita. Funzioni aggiuntive e un insieme di siti eterogeneo cambiano il conteggio.
Auto-Mode può provare più configurazioni e addebitare quella che riesce, senza costi se falliscono tutte. L'impostazione max_cost limita le configurazioni che può tentare. La documentazione precisa però che non sceglie automaticamente istruzioni di attesa o clic specifiche per la pagina. Se il prezzo desiderato appare soltanto dopo una selezione o un caricamento asincrono, devi ancora definire quel comportamento. Documentazione di Auto-Mode.
Questo è il limite: la configurazione per recuperare una pagina non definisce cosa vuoi estrarre. Una risposta HTML corretta può contenere un segnaposto vuoto, il prezzo della regione predefinita o una selezione che il tuo cliente non farebbe. Conserva gli elementi della risposta necessari alla verifica e controlla il campo utile alla tua attività, senza fermarti al successo della chiamata API.
- Si adatta a uno scraper personalizzato di cui vuoi conservare parsing e pianificazione nel tuo codice.
- Le impostazioni di rendering e proxy hanno costi in crediti pubblicati.
- Auto-Mode permette di porre un tetto al costo della configurazione di accesso.
- Capacità e richieste simultanee aumentano secondo una progressione di piani esplicita.
- La stessa quota di crediti pubblicizzata copre numeri di richieste molto diversi.
- L'estrazione AI comporta un costo aggiuntivo in crediti.
- Auto-Mode non fornisce impostazioni di attesa o clic specifiche per il sito.
- L'offerta gratuita è una prova, non una quota permanente per attività programmate.
Scegli ScrapingBee se vuoi controllare la richiesta e sai già come validare la risposta. Preferisci un'API di record o un Actor Apify adatto se il lavoro che vuoi smettere di fare è mantenere le regole di estrazione per il sito.
7. Octoparse: attività visuali, con pianificazione cloud nei piani a pagamento
Octoparse è un'applicazione visuale di scraping adatta a un operatore disposto a progettare e mantenere le attività di estrazione. Ha senso per raccogliere periodicamente cataloghi o annunci quando serve un ambiente per costruire le attività, anziché un'integrazione API. Un analista degli acquisti può definire i campi dell'elenco e delle pagine di dettaglio, poi trasferire il processo validato all'esecuzione cloud a pagamento. Il piano Free è utile per una valutazione locale, ma non va considerato la base di un flusso non presidiato.
Ideale per: Un operatore che costruisce attività di estrazione visuali e acquista l'esecuzione cloud quando serve.
Punto di forza: Scraping organizzato in attività, con pianificazione cloud a pagamento ed esportazione automatica.
Prezzi: Standard da $69/mese con fatturazione annuale.
Offerta gratuita: Free Plan con 10 attività locali e 50,000 righe esportate/mese.
Free include 10 attività, esecuzione sul dispositivo locale, fino a 10,000 righe per esportazione e 50,000 righe esportate al mese. Standard aggiunge estrazione cloud, pianificazione delle attività, esportazione automatica e Data Export API, con 100 attività e fino a 3 processi cloud simultanei. Professional consente 250 attività e fino a 20 processi cloud simultanei, oltre ad Advanced API e assistenza aggiuntiva. Enterprise indica 750+ attività e 40+ processi cloud simultanei. Dettagli dei piani Octoparse.
I piani pubblicati sono Free a $0, Standard da $69/mese, Professional a $249/mese ed Enterprise con prezzo personalizzato. Entrambe le cifre dei piani a pagamento prevedono fatturazione annuale. Tratta questi equivalenti mensili come offerte annuali e verifica l'importo della fattura al checkout prima di prevedere l'esborso. Prezzi di Octoparse.
L'unità di fatturazione è un abbonamento con limiti su attività e processi, non un credito standard per richiesta. Può adattarsi a un flusso con molta estrazione distribuita su un insieme gestibile di attività, ma «esportazione dati illimitata» nei piani a pagamento non significa lavoro cloud parallelo illimitato. I tre processi cloud simultanei di Standard possono diventare il limite rilevante molto prima di raggiungere 100 attività salvate.
I componenti aggiuntivi restano separati. La pagina dei prezzi indica proxy residenziali a $3/GB, risoluzione dei CAPTCHA a $1-1.5 per mille e template con pagamento per risultato a $0.001-3 per mille risultati. Un abbonamento a pagamento non rende gratuito ogni costo di accesso avanzato.
Per raccogliere il catalogo di un fornitore, parti in locale con una piccola attività e verifica la copertura di elenco e dettagli. Poi controlla come l'esecuzione cloud gestisce lo stesso input, dove arriva l'esportazione e chi viene informato di un errore. Anche un analista capace di costruire l'attività ha bisogno di una procedura operativa per verificare che siano stati raccolti i record attesi.
- La progettazione visuale si adatta a chi vuole gestire direttamente le istruzioni di estrazione.
- Le attività locali gratuite permettono di valutare il processo prima di acquistare il cloud.
- Standard include esplicitamente pianificazione ed esportazione automatica.
- I limiti su attività e processi cloud rendono chiari i confini dell'esecuzione.
- L'esecuzione gratuita è locale e non fornisce il lavoro cloud non presidiato richiesto.
- Il volume di esportazione a pagamento non elimina i limiti su attività o processi simultanei.
- Proxy, CAPTCHA e template aggiuntivi possono comportare costi a consumo.
- La tariffa di ingresso richiede fatturazione annuale.
Scegli Octoparse quando progettare le attività in modo visuale offre un vantaggio concreto e i limiti dei processi cloud si adattano alla pianificazione. Browse AI è il primo candidato più diretto per un monitoraggio registrato; un'API è più adatta quando l'estrazione deve far parte di un prodotto software.
8. Zyte: il costo dell'accesso dipende dal sito
Zyte è un fornitore di dati web la cui Zyte API fattura le risposte riuscite in base alla difficoltà del sito e alla richiesta di contenuto HTTP o rendering nel browser. È adatta a uno sviluppatore che gestisce la raccolta e vuole automatizzare l'accesso senza acquistare una flotta di proxy. Un servizio di annunci può mantenere dataset e parsing propri, calcolando il budget per la modalità di risposta effettivamente necessaria su ciascun sito. Il prezzo minimo è utile soltanto se specifichi anche la soglia di spesa e la fascia del sito a cui si riferisce.
Ideale per: Una raccolta gestita dallo sviluppatore con un budget di accesso specifico per sito.
Punto di forza: Prezzi per risposte riuscite, con tariffe HTTP e browser separate.
Prezzi: PAYG HTTP $0.13-$1.27 per 1,000; browser $1.01-$16.08 per 1,000.
Offerta gratuita: $5 di credito per 30 giorni, senza impegno; nessun piano gratuito ricorrente pubblicizzato.
Le tariffe PAYG HTTP per siti nelle fasce Simple, Easy, Moderate, Complex e Advanced sono $0.13, $0.23, $0.44, $0.70 e $1.27 per 1,000 risposte. Le tariffe PAYG browser sono $1.01, $2.01, $4.02, $8.04 e $16.08. A parità di richieste, la fattura può quindi cambiare molto secondo il sito e la necessità di contenuti renderizzati. Prezzi di Zyte.
Gli impegni di spesa mensili riducono queste tariffe. Con un impegno di $100, HTTP è indicato a $0.10-$0.95 e browser a $0.75-$12.00 per 1,000. A $200, gli intervalli sono $0.08-$0.76 e $0.60-$9.60. A $500 sono $0.06-$0.61 e $0.48-$7.68. I prezzi Enterprise vanno richiesti al reparto commerciale. Il «da $0.06» della pagina appartiene ai piani con impegno di spesa: non è il prezzo di ingresso PAYG HTTP.
Per un esempio di 100,000 risposte riuscite, la tariffa Simple PAYG HTTP produce un costo di utilizzo di $13. La tariffa Simple browser porta a $101; Advanced browser a $1,608. Sono calcoli basati sui prezzi pubblicati, non un'affermazione sulla fascia in cui rientrerà il tuo sito. Le funzioni avanzate possono aggiungere costi: usa quindi lo stimatore del fornitore per il sito specifico e la modalità di output desiderata.
Il limite da valutare è l'economia del singolo sito. Un sito HTTP poco complesso e uno avanzato che richiede rendering non dovrebbero condividere un unico costo per pagina presunto. Suddividi gli URL per sito e modalità, conserva il conteggio delle risposte accettate e confronta i piani con impegno di spesa rispetto a quella distribuzione.
Anche quando l'accesso riesce, i requisiti dell'estrazione restano a tuo carico. Il parser deve ancora restituire l'identificatore corretto dell'annuncio, i campi richiesti e i controlli di completezza. Se un'API di record mantenuta o un Actor restituisce già il dataset necessario, il solo prezzo di accesso più basso potrebbe non giustificare il mantenimento di un'estrazione personalizzata.
- Le tariffe HTTP e browser separate consentono un budget preciso per ciascun sito.
- Cinque fasce di difficoltà mostrano variazioni che un prezzo di ingresso unico può nascondere.
- Gli impegni mensili offrono una progressione tariffaria visibile.
- L'API indica funzioni di rendering, rotazione degli IP e geolocalizzazione.
- La tariffa minima pubblicizzata richiede un impegno mensile.
- Il rendering nel browser può cambiare sensibilmente i costi.
- Le funzioni avanzate possono costare di più.
- La risposta richiede comunque parsing e validazione rispetto alle esigenze dell'attività.
Scegli Zyte quando il team di sviluppo ha bisogno di accesso gestito e può misurare la composizione dei siti da raccogliere. Parti dalla stima PAYG, invece di sottoscrivere un impegno soltanto per ottenere la cifra più bassa stampata nella pagina.
Quanto costa raccogliere dati web a intervalli programmati?
Conta le operazioni ripetute e il formato del risultato prima di confrontare i prezzi di ingresso. Ecco un esempio esplicito per pianificare il budget: un founder rivisita 120 pagine note ogni giorno per un mese di 30 giorni, totalizzando 3,600 visite. Ipotizziamo pagine ordinarie, nessuna azione aggiuntiva nel browser, nessuna chiamata per individuare URL, nessun costo degli endpoint di monitoraggio e nessun nuovo tentativo fatturabile. È un foglio di calcolo per il budget, non un carico di lavoro misurato né una promessa di accesso ai siti.
Per scrape di base in Markdown, quelle 3,600 visite usano 3,600 crediti sia su Firecrawl sia su Context.dev. Firecrawl Hobby include 5,000 crediti per $19/mese e Context.dev Developer 7,500 per $19/mese. Entrambi gli abbonamenti mensili di ingresso coprono il volume di scraping specificato. Firecrawl, Context.dev.
Se richiedi un'estrazione strutturata JSON riuscita sulle stesse pagine standard, il fabbisogno sale a 18,000 crediti per entrambi. Firecrawl Hobby richiede 13 blocchi aggiuntivi da 1,000 crediti a $5: $19 + $65 = $84/mese. Context.dev Developer, con la tariffa pubblicata per i nuovi abbonamenti, richiede 11 blocchi aggiuntivi da 1,000 crediti a $2.20: $19 + $24.20 = $43.20/mese. L'arrotondamento ai blocchi lascia alcuni crediti inutilizzati nel calcolo di Context.dev.
Anche un monitor no-code richiede lo stesso calcolo della frequenza. Su Browse AI, 3,600 controlli mensili di pagine standard diventano 43,200/anno, prima di considerare più righe o siti premium. I 60,000 crediti annuali di Professional coprono questo volume esemplificativo; i 12,000 di Personal no. Professional mensile offre 5,000 crediti per $87, mentre Professional annuale costa $69/mese con $828 pagati in anticipo. Browse AI.
Per i soli proxy serve un calcolo diverso. Parti dai GB misurati, poi aggiungi hosting dello scraper, lavoro di estrazione e gestione delle eccezioni. Un'API di record parte dai record consegnati fatturabili. Apify parte dall'Actor scelto e dalle risorse utilizzate. Non trasformare nessuno di questi modelli in una promessa di costo per pagina senza misurare il lavoro effettivo.
Quale strumento scegliere per il tuo lavoro?
La regola è capire se ti servono contenuti di pagina, un monitor gestito da un operatore, record pronti per un sito specifico o accesso per codice che mantieni già. Il passaggio a un piano a pagamento dovrebbe risolvere il limite che hai incontrato, non premiare semplicemente un fornitore perché ha un elenco di funzioni più lungo.
La scelta dipende da chi risolverà il prossimo problema
Se la funzionalità basata sui dati è responsabilità del team di sviluppo, valuta un'API che restituisca contenuti e metadati necessari. Se le attività operative seguono un processo su foglio di calcolo, valuta un robot visuale che l'operatore possa esaminare. Se nessuno è ancora responsabile degli errori, assegna quel ruolo prima di aumentare la frequenza di raccolta.
Quando cambia la responsabilità, cambia anche lo strumento adatto. Uno sviluppatore può rendere un'API di scraping il componente giusto di un prodotto. La stessa API può essere un acquisto sbagliato per chi ha bisogno di un risultato quotidiano e non ha un'applicazione in cui riceverlo. Viceversa, un'attività registrata può essere rapida da valutare ma diventare un ostacolo quando l'estrazione si trasforma in una funzionalità centrale del prodotto.
Web scraping con AI: servono uno schema e criteri di accettazione
Tratta l'estrazione come un contratto sui dati. Per un record di prezzo, definisci identificatore del prodotto, variante, importo numerico, valuta, URL di origine e ora della raccolta. Decidi come gestire valori mancanti o ambigui prima del primo aggiornamento automatico. Un oggetto JSON pulito è un formato; stabilire se il record è corretto per la tua attività richiede di verificarlo rispetto a quei requisiti.
Per acquisire documenti, conserva fonte e ora del recupero ed escludi, dove opportuno, gli elementi di navigazione ripetuti e irrilevanti. Mantieni la risposta originale quando un controllo automatico rifiuta una pagina. Questi elementi permettono al responsabile di distinguere un sito modificato da una definizione errata del campo.
Quale web scraper AI scegliere per un agente?
Parti da Firecrawl per un flusso orientato alle pagine con scrape, crawl e map. Aggiungi Context.dev al confronto se la combinazione di batch e monitoraggio via webhook si adatta all'applicazione. Se un Actor Apify adeguato raccoglie già i campi necessari dal sito, valuta quell'esecuzione completa insieme alle API generiche per le pagine.
Confronta gli strumenti su un insieme fisso di fonti e con un risultato atteso identico. Includi una pagina ordinaria, una che richiede rendering, un rapporto tra elenco e dettaglio e una pagina con un campo ambiguo. La quota del piano di ingresso è un dato per il budget, non una prova che un servizio produca dati migliori.
Web scraping con Python: quali strumenti puoi programmare?
Un flusso Python può chiamare un'API e mantenere pianificazione, parsing, persistenza e validazione nella propria applicazione. Scegli Firecrawl o Context.dev se vuoi contenuti di pagina o estrazione strutturata gestita. Scegli ScrapingBee o Zyte se vuoi conservare il controllo del parsing e sostituire il componente che recupera le pagine.
Il controllo aggiuntivo comporta lavoro operativo. Distingui chiaramente un errore di trasporto, una pagina di errore del sito, un campo mancante e un record rifiutato in base ai requisiti dell'attività. Non riprovare alla cieca in tutti i casi: una regola di estrazione sbagliata non migliora perché viene eseguita di nuovo la stessa richiesta.
Web scraping gratis: quali quote si rinnovano?
Firecrawl e Context.dev pubblicizzano ciascuno 1,000 crediti mensili. Browse AI offre 50 crediti mensili su 2 domini. Apify mette a disposizione $5/mese di utilizzo e Bright Data Scraper API 5K record/mese. Queste quote possono supportare piccole valutazioni o attività ricorrenti contenute, se l'operazione richiesta rientra nei limiti.
Per una singola pagina standard controllata ogni giorno in un mese di 30 giorni, la quota di 50 crediti di Browse AI copre i 30 controlli. È un esempio concreto di monitoraggio gratuito, a condizione che il sito non sia premium e che il numero di righe estratte non aumenti il costo. I 1,000 crediti di ScrapingBee e i $5 di Zyte sono prove; Octoparse Free gira in locale. Queste differenze contano più dell'etichetta «gratis».
Strumenti open source: chi gestirà il servizio?
Il core di Firecrawl, disponibile per il self-hosting, è un'opzione quando il controllo del sorgente o dell'infrastruttura giustifica la gestione dei servizi. L'open source elimina l'abbonamento al fornitore per quel core; non fornisce hosting, monitoraggio, ripristino o uno sviluppatore che risolva il prossimo problema.
Consulta la guida al self-hosting di Firecrawl per valutare queste responsabilità prima di considerarlo il modo più economico di fare scraping. Per un piccolo team di prodotto che vuole soltanto un endpoint capace di restituire pagine note, i piani gestiti di ingresso possono evitare un progetto infrastrutturale separato. Scegli il self-hosting per un'esigenza concreta di controllo e con un responsabile in grado di mantenerlo.
Come sono stati scelti gli strumenti
Il confronto privilegia l'adeguatezza al compito, la trasparenza della fatturazione e il limite che cambia la decisione di acquisto. Per l'articolo originale sono state consultate le pagine dei prezzi e la documentazione pertinente dei produttori; le cifre sono state verificate il 6 ottobre 2026. Gli esempi di costo sono calcoli basati su quelle tariffe pubblicate e su ipotesi di carico esplicite. Non è stata effettuata una prova pratica dei prodotti e non viene proposta una classifica di velocità, accuratezza o tasso di riuscita.
Firecrawl, Bright Data, Browse AI e Context.dev sono strumenti partner di questo sito; Apify, ScrapingBee, Octoparse e Zyte offrono alternative indipendenti. Essere partner non rende i soli proxy l'acquisto giusto per il monitoraggio di un operatore, né un robot registrato l'API giusta per una funzionalità software. Le raccomandazioni seguono queste distinzioni.
I criteri pratici sono: il prodotto restituisce il risultato necessario? Chi si occupa di configurarlo e ripararlo? Quale operazione ripetuta viene fatturata? Quale quota o limite di richieste simultanee si raggiunge per primo? Cosa succede a una risposta incompleta o rifiutata? Un marketplace più ampio o un prezzo promozionale più basso, da soli, non rispondono a queste domande.
I cataloghi di framework e librerie per browser sono stati esclusi dalla selezione perché qui si sceglie un servizio ricorrente, un flusso no-code o un'infrastruttura di accesso. L'uso interattivo del browser è un requisito distinto quando il lavoro richiede molta navigazione, anziché la semplice raccolta delle pagine.
Prima di programmare la raccolta, controlla le condizioni d'uso del sito e il file robots.txt.
Gli acquisti da evitare
Evita lo strumento inadatto al compito, anche se è valido per altri usi. Queste sono le scelte che più facilmente creano il lavoro che l'acquisto avrebbe dovuto eliminare.
- Octoparse Free per un flusso cloud non presidiato. Le attività vengono eseguite in locale. Acquista l'esecuzione cloud richiesta dal processo oppure scegli un servizio con il modello operativo adatto.
- Proxy residenziali Bright Data aspettandosi un dataset pronto. Forniscono accesso; richieste, parsing e accettazione restano a tuo carico. Usa una Scraper API adatta se vuoi acquistare il record.
- Il prezzo annuale di Browse AI Personal per un monitoraggio frequente e ampio. La quota annuale di 12,000 crediti non copre il lavoro esemplificativo da 43,200 crediti l'anno. Calcola prima visite, righe, siti premium e domini.
- Il «da $0.06» di Zyte come preventivo PAYG. È il minimo della fascia con impegno di $500. Stima sito e modalità effettivi prima di assumere quell'impegno.
- Il totale dei crediti ScrapingBee come garanzia sul numero di richieste. Rendering e impostazioni proxy possono consumare più crediti per la stessa richiesta. Metti a budget la configurazione che funziona.
- Firecrawl o Context.dev come sistema completo di qualità dei dati. Entrambi possono consegnare contenuti che dovrai rifiutare. Conserva stato e dati restituiti per verificarli e proteggi i record successivi dagli aggiornamenti incompleti.
Il prodotto da evitare è quello che ti lascia mantenere il componente che pensavi avrebbe gestito al tuo posto. Definire un confine preciso è più utile di una classifica generale espressa con sicurezza.
Da dove partire lunedì
Avvia una piccola valutazione programmata, con un responsabile chiaramente individuato. Seleziona dieci URL rappresentativi, definisci i campi o i contenuti documentali attesi e stabilisci cosa rende una risposta inaccettabile. Per un'attività no-code, registra il flusso; per un'API, collegala al tuo scheduler e al tuo sistema di archiviazione.
Esegui la raccolta una volta al giorno per sette giorni. Conserva risposta originale, stato del sito, output, unità di fatturazione consumate e numero di record accettati. Controlla paginazione, valori mancanti, identificatori duplicati e modifiche che devono o non devono provocare un aggiornamento.
Poi calcola il costo del mese completo usando la distribuzione dei siti osservata. Scegli l'opzione meno complessa che soddisfa i requisiti di risultato e responsabilità, e mantieni i controlli di accettazione dopo la prova. Un flusso di dati è pronto per la produzione quando fornisce risultati utili e ripetibili, non alla prima richiesta riuscita.
Quali strumenti conviene usare per il web scraping?
Firecrawl e Context.dev sono adatti ai contenuti di pagina per agenti; Browse AI e Octoparse ai flussi di estrazione visuale; Bright Data, Zyte e ScrapingBee a esigenze diverse di accesso e recupero delle pagine. Apify è particolarmente utile quando esiste già l'Actor giusto per il sito specifico. Scegli prima il risultato e chi lo gestirà, poi confronta il costo mensile completo.
ChatGPT può fare scraping dei siti web?
ChatGPT può aprire siti e raccogliere informazioni tramite la sua funzione browser, come descritto nella documentazione ufficiale di OpenAI. Può essere utile per una raccolta interattiva. Per prezzi, annunci o documenti destinati agli agenti da raccogliere periodicamente, valuta separatamente pianificazione, schema di output, risultati salvati e responsabilità degli errori. Qui la scelta riguarda il servizio che fornisce quel flusso ricorrente, più che la capacità di un assistente AI di leggere una pagina.
Quale AI è più adatta al web scraping?
Scegli il servizio di estrazione e il risultato atteso prima del modello linguistico. Firecrawl e Context.dev vanno valutati per Markdown o campi strutturati; Browse AI per un robot gestito da un operatore. La scelta migliore è quella che restituisce le informazioni necessarie sulle tue fonti rappresentative a un costo complessivo accettabile.
Il web scraping è superato?
Controlla prima se il sito offre un'API o un feed adeguato. Quando le informazioni necessarie sono pubblicate soltanto nelle pagine, l'estrazione resta un'opzione. Per l'acquisto conta chi gestisce recupero, estrazione, pianificazione e validazione, più dell'etichetta AI del prodotto.
Quali sono i 10 migliori strumenti di web scraping?
Questa selezione comprende otto prodotti per tre attività ricorrenti: dati per agenti, monitoraggio no-code e accesso su larga scala. Scegli all'interno di queste esigenze, invece di aggiungere strumenti solo per arrivare a dieci. Un progetto di automazione del browser o un framework self-hosted comporta responsabilità diverse da quelle dei servizi confrontati qui.
Ottieni la AI Business Workflow Audit Checklist tramite la newsletter e definisci risultato, pianificazione, regole di accettazione e responsabile prima di impegnarti in un flusso di dati web.
- Ultimo aggiornamento
- 6 ott 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

AI agent memory: cosa conservare, dove e a quale costo
Come progettare la memoria degli agenti AI: contesto, sessioni, archivi e skill, costi dei fornitori e rimedi a dati obsoleti e fughe tra utenti.5 ott 2026Build
Pinecone pricing: piani e costi per 1M–100M di vettori
Pinecone pricing: dal piano gratuito ai costi per 1M–100M di vettori. Scopri minimi mensili, limiti e quanto incidono le query sulla fattura in dollari.5 ott 2026Build
Lovable Alternatives: costi, limiti e quando cambiare
Confronta le alternative a Lovable per costi, crediti, backend ed esportazione del codice. Scopri quando cambiare piattaforma e quando conviene restare.5 ott 2026Build
LLM observability: costi e strumenti per il tuo team
Confronta Langfuse, LangSmith, Helicone, Phoenix, Braintrust e Datadog: prezzi, costi per team, self-hosting e OpenTelemetry per scegliere con criterio.5 ott 2026Build
OpenCode: dal primo avvio a una modifica verificata
Installa OpenCode, collega i tuoi modelli e affronta un bug reale. Guida a AGENTS.md, plugin e costi API e Zen, con un metodo per verificare ogni modifica.4 ott 2026Build
Netlify hosting: quanto costano piani e crediti nel 2026
Quanto costa Netlify? Confronta Free, Personal e Pro e calcola i crediti per un sito aziendale, un’app Next.js o un’agenzia, con esempi di budget mensile.4 ott 2026Build
Softr: recensione, costi e scelta del piano a ottobre 2026
Recensione di Softr per portali clienti e strumenti interni: prezzi mensili e annuali, limiti di utenti e record, funzioni IA e guida alla scelta del piano.4 ott 2026Build