Scraping web en 2026 : huit outils, trois usages à distinguer
Quel outil de scraping web choisir pour une IA, une veille sans code ou une collecte à grande échelle ? Comparez huit solutions, leurs tarifs et limites.




Le scraping web répond à des besoins très différents. Firecrawl est le premier outil à examiner pour fournir à un agent IA des pages propres et lisibles ; Browse AI, pour confier la veille à un responsable métier ; et Bright Data, pour collecter des données lorsque l’accès aux sites devient le principal obstacle. Firecrawl et Context.dev démarrent tous deux à 19 USD/mois avec une facturation mensuelle, mais demander du JSON structuré change la consommation de crédits. Avant de choisir un fournisseur, définissez le résultat attendu, la fréquence des collectes et la personne qui interviendra en cas d’échec.
Scraping web : les outils à comparer en un coup d’œil
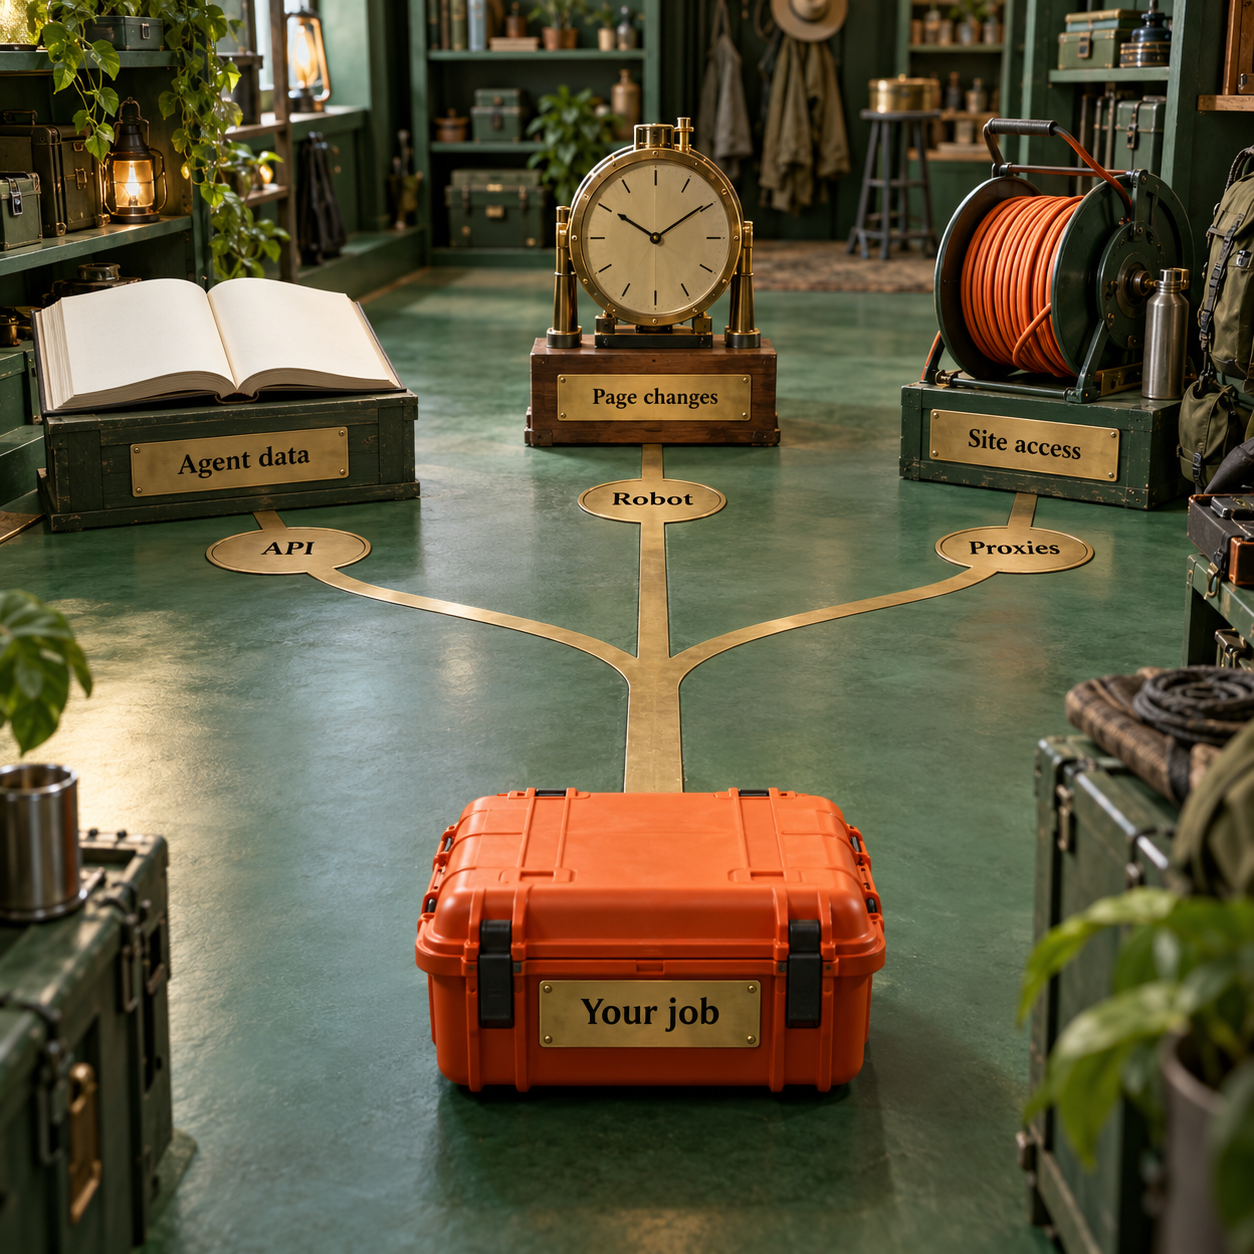
Achetez la brique qui manque à votre workflow. Une API de scraping est un service que votre logiciel appelle pour récupérer les données d’une page : elle convient au développeur qui construit un agent ou un jeu de données. Un robot no-code convient au responsable métier qui doit répéter une collecte. Un réseau de proxies fait transiter le trafic par d’autres adresses IP : il sert à améliorer l’accès aux sites d’un scraper que vous possédez déjà.
Les tarifs et quotas ci-dessous ont été vérifiés sur les pages des éditeurs le 6 octobre 2026. Les offres annuelles sont signalées, et les essais gratuits sont distingués des quotas qui se renouvellent. La colonne des tarifs indique l’offre payante de départ ; la dernière précise ce qu’il est possible d’évaluer sans abonnement payant.
Ce tableau aide à établir une sélection ; il ne rend pas équivalents un enregistrement livré, une page visitée et un gigaoctet. Le code RESIGB50 de Bright Data annonce une réduction de 50 % sur les proxies pendant trois mois. Utilisez ce tarif temporaire pour le budget d’essai, puis le tarif habituel pour les dépenses récurrentes.
Définissez le résultat attendu, puis qui en sera responsable
Trois décisions d’achat se cachent derrière ce comparatif : quand le besoin change, l’outil change aussi. Un fondateur qui charge de la documentation dans un assistant, un responsable métier qui surveille les prix concurrents et un développeur qui actualise un vaste jeu d’annonces n’ont pas intérêt à comparer les produits de la même façon.
Premier besoin : fournir à un agent des pages exploitables
Commencez par Firecrawl ou Context.dev si votre application doit recevoir le contenu des pages ou des champs structurés. Le Markdown conserve les titres et les liens dans un texte lisible : il convient à un agent IA qui doit consulter un document. Le JSON organise l’information en champs nommés, par exemple le produit, le prix, la devise et la disponibilité : il convient à un workflow qui doit valider et comparer des enregistrements.
Cette distinction joue autant sur la qualité que sur le coût. Un assistant de support peut souvent travailler à partir d’une page de documentation propre. Une alerte tarifaire a besoin du champ prix, de sa devise, de la bonne variante du produit et d’un horodatage. Transmettre une page à un modèle ne lui indique pas lequel des prix affichés intéresse votre entreprise.
Distinguez aussi scrape, qui récupère une page, crawl, qui suit les liens d’un site pour en récupérer plusieurs, et map, qui découvre les URL. Si vous disposez déjà d’une liste d’URL fiable, répéter la découverte peut ajouter du travail sans améliorer le flux. Si la documentation du site s’enrichit régulièrement, la découverte fait partie du besoin.
Deuxième besoin : surveiller des pages connues sans faire maintenir du code à l’équipe métier
Choisissez Browse AI pour enregistrer une tâche d’extraction et confier le suivi des changements à un responsable métier. Choisissez Octoparse si la conception visuelle des tâches et une extraction cloud payante correspondent mieux au processus. Ici, un robot est une suite d’actions et de consignes d’extraction enregistrées, pas un remplaçant universel pour un salarié.
Un responsable des opérations peut, par exemple, avoir besoin chaque matin du titre, du prix et de la disponibilité des produits d’un fournisseur. Le résultat utile est un tableur aux colonnes stables, avec une anomalie clairement signalée lorsqu’un champ disparaît. La personne qui exploite les données doit pouvoir examiner la tâche et l’ajuster quand le site change.
Définissez ce qui constitue un changement avant de choisir la fréquence. Une modification du pied de page n’a aucun intérêt pour le suivi des stocks. Le réordonnancement d’une liste ne doit pas donner l’impression que tous les produits ont été remplacés. Conservez un identifiant stable, comparez les champs pertinents et faites examiner les données manquantes plutôt que d’écraser silencieusement une valeur valide de la veille.
Troisième besoin : collecter à grande échelle lorsque l’accès bloque
Retenez Bright Data, Zyte ou ScrapingBee lorsque votre logiciel gère déjà la planification et le jeu de données, mais que la récupération des pages cibles devient difficile. Un service de déblocage prend en charge des mécanismes d’accès comme les nouvelles tentatives et le choix des proxies. Il ne définit pas pour autant le sens de vos données.
Bright Data propose aussi des Scraper APIs propres à certains sites : le service peut donc vendre un enregistrement plus complet, au-delà du seul accès réseau. Apify occupe une autre place utile : un Actor maintenu pour votre cible peut déjà réaliser l’extraction dont vous avez besoin. Un Actor est un programme cloud réutilisable que vous configurez et exécutez.
Le choix dépend de ce que vous voulez continuer à gérer. Pour déléguer la maintenance de la logique d’extraction, évaluez une Scraper API ou un Actor. Pour conserver votre propre logique d’analyse, évaluez une API de récupération des pages ou un service de proxies. Payer pour de l’accès brut en attendant un jeu de données prêt à l’emploi crée un décalage coûteux.
Huit outils, et les limites qui peuvent changer votre choix
Chaque outil de cette sélection répond à un besoin récurrent précis. La numérotation facilite la lecture ; pour un usage donné, le meilleur choix dépend du résultat, des limites et des responsabilités décrits dans chaque fiche.
1. Firecrawl : le premier candidat pour alimenter un agent en pages lisibles
Firecrawl est une API de scraping qui transforme les sites web en contenu exploitable. C’est la première option à évaluer pour un agent fondé sur de la documentation. Ses fonctions Scrape, Crawl et Map distinguent la récupération d’une page, le parcours d’un site et la découverte d’URL. Un fondateur qui construit un assistant de support peut cartographier la documentation, sélectionner les chemins pertinents, puis explorer ces pages pour obtenir du Markdown. Retenez Firecrawl lorsque le livrable est un contenu propre ; revoyez ce choix si le besoin principal est une veille dans un tableur gérée par l’équipe métier.
Pour qui : Un développeur qui fournit de la documentation, des articles ou des pages de référence à un agent IA.
Point fort : Des fonctions scrape, crawl et map distinctes, avec Markdown et extraction structurée.
Tarif : Hobby à 19 USD/mois, ou 16 USD/mois avec facturation annuelle ; 5 000 crédits mensuels.
Essai gratuit : Une offre Free récurrente de 1 000 crédits/mois, sans carte bancaire.
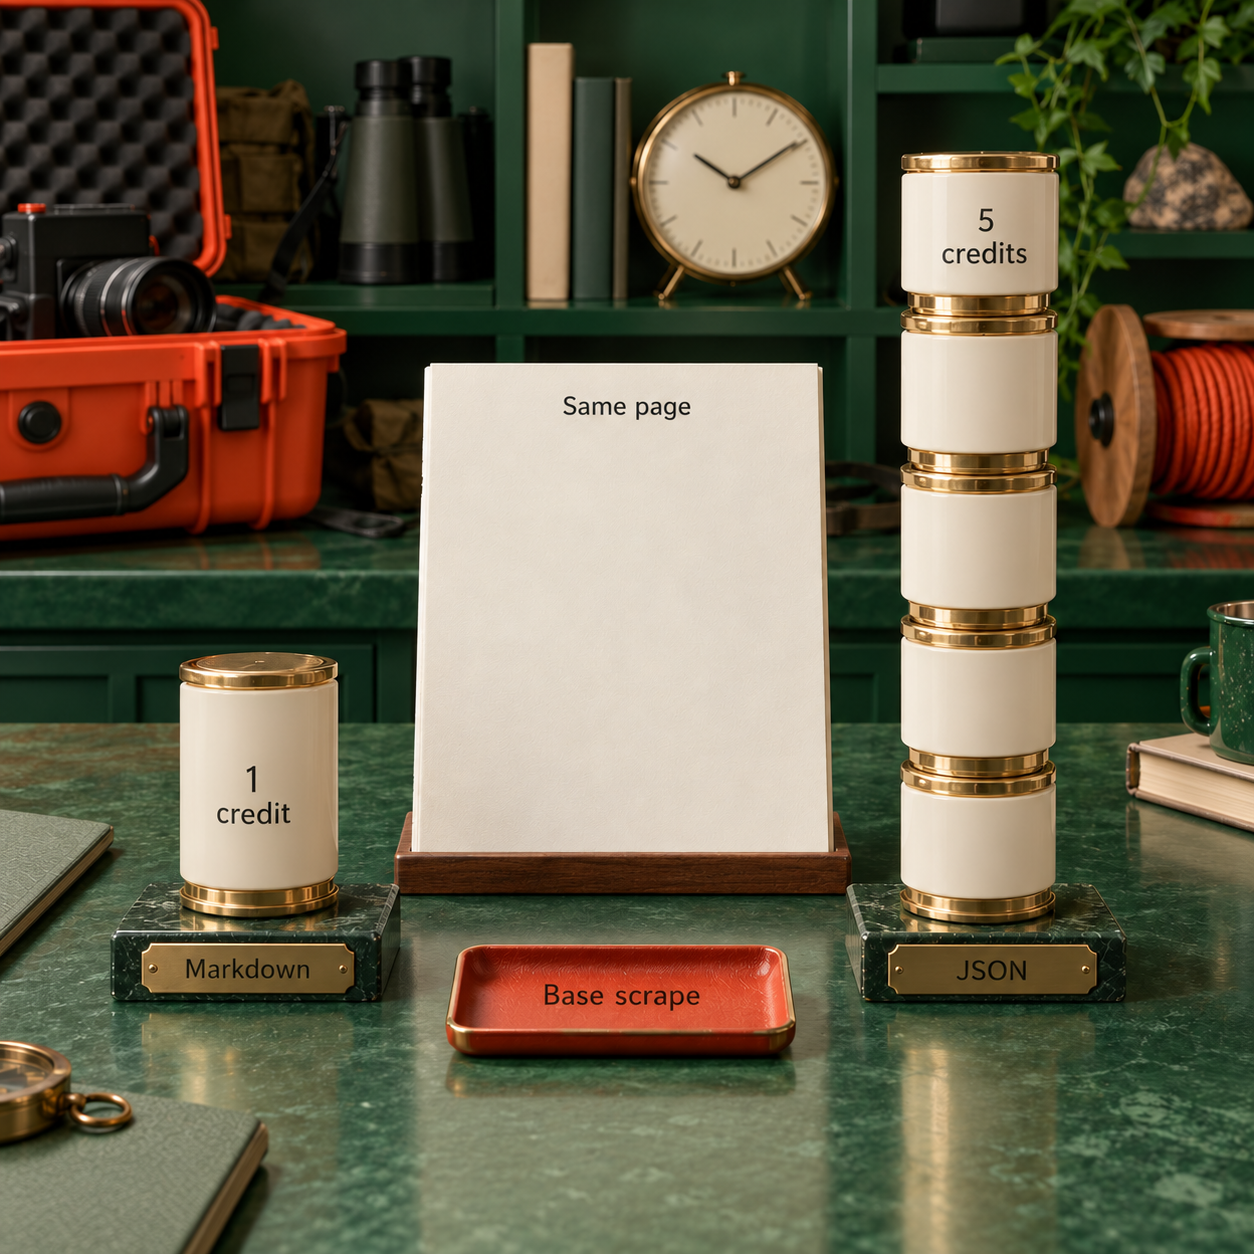
Une page récupérée par scrape ou crawl simple coûte 1 crédit. L’extraction JSON ajoute 4 crédits, soit 5 crédits pour une requête standard qui récupère la page et son JSON. Hobby permet donc de traiter 5 000 pages simples ou 1 000 pages JSON standard si tout le solde est consacré à cette seule opération. Le même abonnement ne couvre pas du tout le même volume selon le résultat demandé. Détail des tarifs Firecrawl.
Avec facturation mensuelle, la gamme complète comprend Free à 0 USD, Hobby à 19 USD pour 5 000 crédits, Standard à 99 USD pour 100 000, Growth à 399 USD pour 500 000 et Scale à 749 USD pour 1 000 000. Enterprise est sur devis. Les équivalents mensuels affichés pour une facturation annuelle sont de 16, 83, 333 et 599 USD/mois, avec des factures annuelles respectives de 190, 990, 3 990 et 7 190 USD. Ce sont les chiffres affichés par l’éditeur, avec ses arrondis. Toutes les offres Firecrawl.
La première limite concerne la taille du crawl demandé. La documentation de Firecrawl indique une limite par défaut de 10 000 pages ; le service peut refuser une tâche si les crédits restants ne couvrent pas la limite demandée. Même pour un petit site avec Hobby, il peut donc être nécessaire de réduire explicitement limit avant la récupération de la première page. La limite suivante est celle des requêtes simultanées : 5 avec Hobby, 25 avec Standard, 50 avec Growth et 100 avec Scale. Acheter davantage de crédits ne supprime pas le plafond de parallélisme de votre offre. Fonctionnement du crawl.
La validation des résultats compte aussi. Firecrawl indique qu’une extraction sans résultat n’est pas facturée, mais qu’une page d’erreur renvoyée par le site cible, par exemple une 403 ou une 404, coûte un crédit. Vérifiez le statut du site et le contenu reçu avant de les intégrer à votre base de connaissances. Une page d’erreur proprement convertie en Markdown reste une page d’erreur.
- Scrape, crawl et map permettent de décider séparément de la découverte et de la récupération.
- Le Markdown convient à l’ingestion documentaire ; le JSON, à un schéma de champs défini.
- Le quota gratuit récurrent permet d’évaluer une petite collecte planifiée.
- Les recharges payantes augmentent le volume sans imposer un changement d’offre immédiat.
- L’extraction structurée réduit nettement le nombre de pages couvert par le quota de base.
- Une limite de crawl élevée par défaut peut dépasser le solde d’un petit compte.
- Les pages d’erreur renvoyées peuvent être facturées et doivent être validées de votre côté.
- Les crédits Hobby, Standard et Growth ne sont généralement pas reportés.
Cartographiez la source avant de tout collecter
Utilisez le playground Map pour découvrir les URL de la documentation. Conservez les chemins qui répondent aux questions que votre assistant doit traiter. La cartographie découvre des adresses ; leur extraction est une autre opération.
Choisissez le résultat utile le moins coûteux
Commencez par le Markdown pour un assistant documentaire. Utilisez un schéma JSON si le workflow en aval exige des champs nommés. Vérifiez une page produit représentative affichant à la fois un prix habituel et un prix remisé avant de considérer le schéma comme suffisamment clair.
Fixez une limite de crawl compatible avec votre solde
Pour l’exemple de 120 pages sources, fixez explicitement
limità 120. Filtrez les chemins pour éviter que le crawler ne consomme le solde sur des pages de blog ou de compte sans rapport avec le besoin.Stockez le résultat et les éléments qui permettent de le valider
Conservez l’URL source, l’heure de collecte, le statut du site cible et le contenu dans votre propre stockage. Selon la documentation de Firecrawl, les résultats des crawls terminés restent disponibles via l’API pendant 24 heures : la réponse récupérée ne doit donc pas être votre seule copie.
Préparez explicitement la collecte suivante
Faites revisiter les sources validées par le planificateur de votre application. Séparez dans le budget les frais de découverte, d’extraction et de suivi, puis désignez la personne qui recevra une alerte lorsqu’une source ne renvoie plus le contenu attendu.
Si vous cherchez à remplacer votre installation Firecrawl, le comparatif des alternatives à Firecrawl approfondit la migration et les critères de validation. Changer de fournisseur et passer de l’ingestion documentaire à une veille sans code sont deux décisions différentes.
2. Browse AI : le choix le plus direct pour une veille gérée par l’équipe métier
Browse AI est une plateforme d’extraction et de suivi sans code qui enregistre une tâche sous forme de robot réutilisable. Elle convient à un responsable métier qui surveille des prix produits, des offres d’emploi ou des fiches d’annuaire sur un ensemble de sites connus. Il peut enregistrer les champs à extraire et envoyer les résultats vers un tableur ou un workflow connecté. Sa limite déterminante combine pages, lignes extraites et domaines surveillés : « robots illimités » ne veut donc pas dire données illimitées.
Pour qui : Un responsable métier qui doit répéter des extractions et détecter des changements sans maintenir le code d’un scraper.
Point fort : Robots enregistrés, suivi planifié et intégrations avec les tableurs et les workflows.
Tarif : Personal à 19 USD/mois avec facturation annuelle, soit 228 USD d’avance, pour 12 000 crédits annuels.
Essai gratuit : Offre Free avec 50 crédits/mois, 2 domaines et un nombre illimité de robots.
Browse AI facture un crédit par visite de page standard ou par tranche de dix lignes extraites, en retenant le montant le plus élevé. Une page listant 50 produits coûte 5 crédits ; visiter les 50 fiches détaillées ajoute 50 crédits si ce sont des pages standard. Une « liste de produits » devient ainsi une collecte de 55 crédits lorsque les détails font partie du besoin. Les sites premium peuvent coûter davantage : examinez le coût affiché pour la tâche. Tarifs Browse AI et exemples de consommation.
La gamme annuelle affichée comprend Free à 0 USD, Personal à 19 USD/mois avec 12 000 crédits/an, Professional à 69 USD/mois avec 60 000 crédits/an et Premium à partir de 500 USD/mois avec facturation annuelle. Personal inclut 5 domaines et 3 utilisateurs ; Professional, 10 domaines et 10 utilisateurs. Les crédits annuels sont attribués dès le départ. Premium ajoute un service géré pour la configuration, la maintenance et les transformations de données.
L’option de facturation mensuelle indique Personal à 48 USD/mois pour 2 000 crédits mensuels et Professional à 87 USD/mois pour 5 000. L’offre annuelle Personal à 19 USD ne se résume donc pas au même quota avec une autre date de paiement. Comparez le volume réel autant que la durée de facturation. Professional annuel demande 828 USD d’avance ; Personal annuel, 228 USD.
Le plafond de domaines peut être atteint avant celui des crédits. Un workflow qui vérifie quelques champs sur de nombreux sites fournisseurs peut avoir besoin de domaines supplémentaires tout en consommant peu de données. Avec facturation annuelle, les domaines supplémentaires sont affichés à 4 USD/mois sur Personal et 2,40 USD/mois sur Professional. Les offres annuelles permettent des recharges à partir de 1 000 crédits ; Personal affiche 0,024 USD/crédit et Professional de 0,017 à 0,013 USD/crédit.
Pour suivre les prix fournisseurs, conservez un identifiant produit et la devise à côté du montant. Un robot qui extrait un nombre ne peut pas décider si un prix promotionnel, un tarif réservé aux membres ou un autre conditionnement doit remplacer votre donnée d’achat. Ce sont votre règle de comparaison et votre file de vérification qui donnent un sens à cette valeur.
- Les tâches enregistrées permettent au responsable métier d’examiner les consignes d’extraction.
- Le suivi, l’accès API et les webhooks sont annoncés dans les différentes offres.
- Les intégrations Google Sheets, Airtable, Zapier et Make couvrent des workflows métier courants.
- Les domaines supplémentaires et les recharges annuelles permettent d’étendre une offre.
- Les longues listes et les visites de fiches détaillées cumulent les coûts.
- Le plafond de domaines peut imposer une option avant l’épuisement des crédits.
- L’offre annuelle la moins chère annoncée n’a pas le même quota que Personal mensuel.
- Les changements du site et les champs ambigus exigent toujours qu’une personne examine le résultat.
Choisissez Browse AI si la personne responsable du jeu de données doit aussi pouvoir ajuster le robot. Préférez une API si l’extraction est une fonction de votre produit et que l’équipe technique gère déjà sa planification, son schéma et ses échecs.
3. Bright Data : choisissez le produit avant de comparer le prix
Bright Data fournit des données web à travers des réseaux de proxies, des Scraper APIs prêtes à l’emploi et Web Unlocker. Il mérite d’être retenu lorsque l’accès aux sites cibles ou le volume de collecte est le facteur limitant. Un développeur e-commerce peut acheter un scraper propre à un site qui renvoie des fiches produits, tandis qu’un scraper sur mesure existant peut avoir besoin de proxies résidentiels. Ces achats prennent en charge des couches différentes et utilisent des unités de facturation différentes.
Pour qui : Une collecte où l’accès à la cible, la localisation géographique ou un scraper maintenu pour un site précis sont déterminants.
Point fort : Des produits distincts pour les proxies, le déblocage et les enregistrements structurés.
Tarif : Web Scraper API en PAYG à 1,5 USD/1K enregistrements ; proxies résidentiels en PAYG à 8 USD/Go avant le code promotionnel temporaire.
Essai gratuit : Scraper API offre 5K enregistrements/mois gratuits ; l’essai des proxies résidentiels est distinct.
Utilisez Scraper API lorsque vous voulez acheter des enregistrements. Ses API propres à des sites renvoient des données structurées et annoncent comme inclus les proxies, le déblocage, l’analyse, l’exécution, le stockage et le transfert sortant. La gamme comprend Free Tier avec 5K enregistrements/mois, PAYG à 1,5 USD/1K enregistrements, Scale à 499 USD/mois avec 384 000 enregistrements et 1,3 USD/1K enregistrements supplémentaires, puis Enterprise sur devis. Vérifiez les schémas d’entrée et de sortie du scraper ciblé avant de supposer que tous les champs nécessaires sont inclus. Tarifs Web Scraper API.
Utilisez Web Unlocker lorsque votre code doit déléguer la gestion de l’accès. La page annonce la gestion automatique des proxies, les nouvelles tentatives, la rotation des IP et la résolution des CAPTCHA. Free Tier inclut 5K requêtes/mois ; PAYG coûte 1,5 USD/1K requêtes ; l’offre Scale affichée est de 499 USD/mois pour 383K requêtes, puis 1,3 USD/1K supplémentaires. Enterprise est sur devis. Bright Data précise que Web Unlocker n’est pas un navigateur interactif permettant de naviguer ou de cliquer dans un workflow. Tarifs et limites de Web Unlocker.
Utilisez les proxies résidentiels lorsque vous voulez conserver votre scraper. La fiche PAYG détaillée affiche 8 USD/Go, ramenés à 4 USD/Go par la promotion RESIGB50 de trois mois. Les forfaits mensuels promotionnels affichés sont de 499 USD avec 141 Go, 999 USD avec 332 Go et 1 999 USD avec 798 Go. Au-delà de 1 To, la page renvoie vers un devis personnalisé. La bande passante comptabilise le trafic envoyé au site cible et reçu de celui-ci, pas seulement les enregistrements finaux conservés dans votre base. Tarifs des proxies résidentiels.
Cette dernière distinction détermine le budget. Télécharger des images ou d’autres ressources peut consommer de la bande passante sans produire d’enregistrements utiles supplémentaires. Une API d’enregistrements intègre ces frais d’accès dans le prix annoncé ; des proxies bruts vous laissent gérer les requêtes, l’analyse et les contrôles qualité. Un prix au Go ne révèle pas le coût d’une annonce validée tant que vous n’avez pas mesuré le workflow réel.
La principale limite est l’achat de la mauvaise couche. Un meilleur accès par IP ne corrige pas un parseur qui sélectionne le mauvais champ. Un scraper d’enregistrements maintenu ne reproduit pas nécessairement le comportement d’extraction sur mesure dont vous dépendez déjà. Définissez les données attendues avant de comparer deux tarifs qui partagent simplement le même nom de fournisseur.
- Les Scraper APIs propres à des sites peuvent réduire le travail d’extraction sur mesure.
- Les produits facturés par enregistrement, requête ou volume permettent à l’équipe technique d’acheter la couche nécessaire.
- Le tarif de Scraper API inclut les frais d’accès et d’analyse décrits sur sa page.
- Les quotas API gratuits récurrents permettent d’évaluer les cibles prises en charge.
- L’étendue de la gamme exige de savoir précisément ce que l’on achète.
- Le trafic résidentiel est facturé au Go, sans garantie d’enregistrements valides.
- Le tarif promotionnel des proxies est temporaire.
- Web Unlocker ne remplace pas un workflow de navigation interactive.
Bright Data convient lorsque la pièce manquante est l’infrastructure d’accès ou un scraper maintenu adapté à la cible. Pour une petite veille gérée par l’équipe métier, Browse AI est un point de départ plus direct ; pour l’ingestion documentaire, commencez par les API qui renvoient le contenu des pages.
4. Context.dev : extraction et suivi des sources dans la même API
Context.dev est une API de contexte web dont le site présente l’extraction, la cartographie d’URL, le crawl, les traitements par lots, les réponses sourcées et les moniteurs. Elle convient au développeur qui veut transmettre à son application des pages exploitables par un agent et des mises à jour planifiées. Un assistant documentaire peut ingérer les sources initiales, puis recevoir les mises à jour du moniteur par webhook, c’est-à-dire un message HTTP envoyé à l’application lorsqu’un événement survient. Context.dev mérite ainsi une place à côté de Firecrawl pour cet usage ; l’enrichissement de données de marque est une autre offre du produit, pas la raison de le choisir pour le scraping.
Pour qui : Un agent ou un produit qui combine extraction de pages et suivi des sources par webhook.
Point fort : Scrape, Map, Crawl, Batches et Monitors réunis dans une API.
Tarif : Developer à 19 USD/mois avec 7 500 crédits mensuels.
Essai gratuit : Free Tier avec 1 000 crédits/mois, sans carte bancaire, et 10 moniteurs.
Le site annonce du Markdown, du HTML, des captures d’écran et des champs structurés, avec rendu et proxies inclus dans l’extraction de base. Ses moniteurs vérifient les pages selon une planification et transmettent les mises à jour à un webhook. Il s’agit d’une intégration pour développeur : votre application reçoit toujours la mise à jour, la valide et décide de ce qu’elle doit modifier en aval. La répartition des responsabilités diffère de celle d’un robot enregistré qui alimente le tableur d’une équipe métier. Présentation de Context.dev.
La gamme mensuelle comprend Free Tier à 0 USD pour 1 000 crédits, Developer à 19 USD pour 7 500, Pro à 99 USD pour 125 000, Growth à 299 USD pour 500 000 et Scale à 499 USD pour 1 000 000. Enterprise est sur devis et annonce 2 000 000+ crédits/mois. Les plafonds de requêtes simultanées de l’API principale passent de 1 sur Free à 10 sur Developer, 100 sur Pro, 250 sur Growth et 500 sur Scale. Tarifs Context.dev.
Une extraction standard consomme 1 crédit. L’extraction JSON réussie ajoute 4 crédits, soit 5 crédits par page standard ; les actions dans le navigateur font passer le coût de base à 2 avant l’extraction. Le rendu et les proxies inclus ne signifient donc pas que toutes les requêtes coûtent un crédit. Les 7 500 crédits de Developer couvrent 1 500 pages JSON standard si le solde est entièrement consacré à cette opération.
Pour les nouveaux abonnements, les recharges coûtent 2,20 USD pour 1 000 crédits sur Developer, 1,80 USD sur Pro, 1,40 USD sur Growth et 1,00 USD sur Scale, avec facturation par blocs de 1 000 crédits. Les abonnements existants conservent leurs tarifs. Vous pouvez donc comparer une petite offre assortie de recharges à une offre supérieure, au lieu de monter en gamme uniquement parce que le solde inclus est épuisé.
La limite de crawl explicite est de 500 pages par appel Crawl. Les sites plus importants passent par Batches en mode crawl. Organisez l’ingestion en conséquence et vérifiez que les résultats atteignent votre stockage avant de considérer le lot comme terminé. Un point d’accès de collecte et une base de connaissances durable sont deux éléments distincts de l’architecture.
L’autre limite est celle des résultats partiellement réussis. Context.dev indique que la plupart des requêtes échouées ne sont pas facturées, mais que les réponses « introuvable » le sont ; une réponse peut aussi contenir des sorties échouées à côté d’une sortie réussie. Examinez les sorties reçues et key_metadata.credits_consumed : un statut global de réussite ne prouve pas que l’enregistrement est complet.
- Le contenu des pages et le suivi planifié par webhook s’intègrent au même workflow de données pour agents.
- Le rendu et les proxies sont inclus dans le tarif de l’extraction de base.
- L’offre gratuite récurrente inclut un petit quota de moniteurs.
- Les blocs de recharge publiés permettent de chiffrer un petit volume précisément.
- L’extraction JSON et les actions dans le navigateur augmentent la consommation de crédits.
- Un appel Crawl est limité ; les sources plus volumineuses nécessitent Batches.
- La livraison par webhook exige toujours une logique applicative et du stockage.
- Les sorties partielles et les pages introuvables facturées doivent être contrôlées.
Retenez Context.dev si cette combinaison de fonctions API et son budget de crédits conviennent à votre agent. Comparez-le à Firecrawl avec les mêmes sources représentatives et le même schéma de sortie, sans déduire une meilleure qualité du seul quota de départ plus généreux.
5. Apify : surtout intéressant lorsque le bon Actor existe déjà
Apify est une plateforme cloud de programmes réutilisables de scraping et d’automatisation, appelés Actors. C’est un choix solide lorsqu’un Actor maintenu correspond déjà à votre cible : sa logique d’extraction peut avoir plus de valeur qu’un point d’accès générique de récupération des pages. Un responsable métier qui actualise un annuaire d’entreprises peut configurer les entrées de l’Actor, enregistrer la tâche et planifier ses exécutions. La limite dépend du comportement et de la facturation de l’Actor choisi, pas seulement de l’abonnement à la plateforme.
Pour qui : Une cible ou une tâche d’extraction précise pour laquelle un Actor adapté existe déjà.
Point fort : Programmes cloud réutilisables, avec planification des tâches et intégrations.
Tarif : Starter à 19 USD/mois + consommation à l’usage, avec 19 USD d’utilisation inclus.
Essai gratuit : Offre Free avec 5 USD/mois d’utilisation, sans carte bancaire.
L’offre Free d’Apify coûte 0 USD et fournit 5 USD à utiliser sur le Store ou la plateforme. Starter coûte 19 USD/mois + consommation à l’usage, avec 19 USD inclus ; Scale coûte 199 USD avec 199 USD inclus ; Business, 999 USD avec 999 USD inclus. Enterprise est sur devis. Le calcul coûte 0,2 USD par unité sur Free et Starter, 0,16 USD sur Scale et 0,13 USD sur Business. Une unité de calcul correspond à un Go de RAM utilisé pendant une heure. Tarifs Apify.
Ne traitez pas le solde en dollars inclus comme un quota fixe de pages. L’Actor choisi peut avoir son propre tarif ; les ressources de la plateforme, les proxies, le stockage et les transferts influent aussi sur la facture selon la tâche. Comparez le coût de l’exécution complète qui produit des enregistrements validés, pas seulement le tarif d’appel séduisant du programme sur la place de marché.
Prenons un exemple explicitement hypothétique limité au calcul : un Go de RAM utilisé pendant dix heures consomme dix unités de calcul. Sur Starter, cela représente 2 USD de calcul. Ce montant ne dit rien du nombre d’annonces renvoyées ni des frais supplémentaires. Même l’affirmation selon laquelle 19 USD permettent d’acheter 95 unités suppose que chaque dollar soit consacré au calcul, ce qui n’est pas nécessairement le cas d’une tâche réelle de scraping.
Les fonctions de planification d’Apify peuvent exécuter des tâches enregistrées dans un fuseau horaire choisi et envoyer des notifications par webhook. La documentation précise que les nouvelles planifications sont désactivées par défaut : enregistrer une planification ne garantit donc pas que la prochaine exécution aura lieu. Vérifiez son activation et la prochaine exécution affichée. Documentation de la planification Apify.
Pour l’exemple de l’annuaire, examinez la pagination, la couverture géographique, les identifiants de sortie et l’historique de maintenance de l’Actor avant de vous engager. Un Actor qui collecte une liste d’entreprises dans une catégorie n’enrichit pas nécessairement chaque fiche avec tous les champs attendus par votre CRM. Conservez un échantillon d’enregistrements acceptés et rejetés, et rendez visibles les champs manquants.
- Un Actor adapté peut fournir la logique d’extraction propre à la cible.
- Les tâches enregistrées et les planifications permettent une collecte récurrente.
- La place de marché propose aussi des workflows d’exploration du contenu des pages.
- Le crédit d’utilisation inclus permet d’évaluer l’exécution complète d’une petite tâche.
- Il n’existe pas de prix Apify universel par page ou par enregistrement.
- Les frais propres à l’Actor peuvent peser davantage que l’offre de la plateforme.
- Les entrées et les sorties doivent toujours être validées selon les exigences de votre jeu de données.
- Une nouvelle planification doit être activée avant que vous puissiez compter dessus.
Choisissez Apify lorsque l’Actor supprime un travail d’extraction substantiel et que son coût d’exécution complet est acceptable. Préférez une API directe si la tâche consiste surtout à récupérer des pages connues et que la place de marché ajoute de la complexité sans vous faire gagner de travail.
6. ScrapingBee : déléguer la récupération, en tenant compte des multiplicateurs
ScrapingBee est une API de scraping qui gère le rendu et les options de proxies pour un workflow d’extraction piloté par un développeur. Elle convient à l’ingénieur qui veut conserver son code d’analyse et de planification tout en déléguant les difficultés de récupération des pages. Un service de données produits peut, par exemple, demander une page avec rendu et appliquer ses règles de champs existantes au contenu reçu. La première limite à budgéter est le coût en crédits des réglages qui fonctionnent réellement sur la cible.
Pour qui : Un développeur qui conserve sa logique d’extraction sur mesure et remplace la couche de récupération.
Point fort : Contrôle du rendu et des proxies, et Auto-Mode avec un coût maximal en crédits.
Tarif : Freelance à 49 USD/mois avec 250 000 crédits API.
Essai gratuit : 1 000 crédits API, sans carte bancaire ; aucune offre gratuite récurrente annoncée.
La gamme publiée complète comprend Freelance à 49 USD/mois pour 250 000 crédits, Startup à 99 USD pour 1 000 000, Business à 249 USD pour 3 000 000 et Business + à 599 USD pour 8 000 000. Enterprise 14 coûte 999 USD pour 14 000 000 ; Enterprise 24, 1 599 USD pour 24 000 000 ; Enterprise 41, 2 399 USD pour 41 000 000 ; Enterprise 69, 3 599 USD pour 69 000 000. Pour une capacité supérieure, il faut contacter l’éditeur. Les prix sont hors TVA. Tarifs ScrapingBee.
Il s’agit de crédits, pas de requêtes. Les coûts de récupération documentés sont de 1 crédit pour un proxy classique sans JavaScript, 5 avec JavaScript, 10 pour un proxy premium sans JavaScript, 25 pour un proxy premium avec JavaScript et 75 pour un proxy stealth avec JavaScript. L’extraction par IA ajoute 5 crédits. Le rendu JavaScript est activé par défaut. Coût des requêtes ScrapingBee.
Les 250 000 crédits de Freelance correspondent donc au maximum à 50 000 requêtes JavaScript classiques, 10 000 requêtes JavaScript premium ou 3 333 requêtes JavaScript stealth complètes si tous les crédits financent cette seule configuration. Ce sont des calculs de quota, pas des taux de réussite mesurés. Les fonctions supplémentaires et un ensemble de cibles hétérogène changent ces volumes.
Auto-Mode peut essayer plusieurs configurations et facturer celle qui réussit, sans frais si elles échouent toutes. Son réglage max_cost limite les configurations qu’il peut tenter. La documentation précise toutefois qu’il ne choisit pas automatiquement les consignes d’attente ou de clic propres à la page. Si le prix attendu n’apparaît qu’après une sélection ou un chargement asynchrone, vous devez encore définir le comportement nécessaire. Documentation d’Auto-Mode.
C’est la limite à retenir : configurer la récupération ne définit pas ce qu’il faut extraire. Une réponse HTML correcte peut contenir un emplacement vide, le prix d’une région par défaut ou une sélection que votre client ne ferait pas. Conservez la réponse comme élément de contrôle et vérifiez le champ métier, au lieu de vous arrêter à la réussite de l’appel API.
- Convient à un scraper sur mesure dont l’analyse et la planification doivent rester dans votre code.
- Les coûts en crédits du rendu et des réglages de proxies sont publiés.
- Auto-Mode permet de plafonner le coût d’une configuration d’accès.
- Les capacités et le nombre de requêtes simultanées augmentent selon une gamme d’offres explicite.
- Un même quota de crédits annoncé couvre des nombres de requêtes très différents.
- L’extraction par IA entraîne une consommation de crédits supplémentaire.
- Auto-Mode ne fournit pas les réglages d’attente ou de clic propres à la cible.
- L’offre gratuite est un essai, pas un quota permanent pour des tâches planifiées.
Choisissez ScrapingBee si vous souhaitez contrôler la requête et savez déjà valider la réponse. Préférez une API d’enregistrements ou un Actor Apify adapté si le travail que vous voulez déléguer est la maintenance des règles d’extraction de la cible.
7. Octoparse : des tâches visuelles, avec planification cloud dans les offres payantes
Octoparse est une application visuelle de scraping destinée au responsable métier prêt à concevoir et à maintenir ses tâches d’extraction. Elle convient à la collecte récurrente de catalogues ou d’annonces lorsqu’il faut un éditeur de tâches plutôt qu’une intégration API. Un analyste achats peut définir les champs des listes et des fiches détaillées, puis transférer le workflow validé vers une exécution cloud payante. L’offre Free est utile pour une évaluation locale ; il serait en revanche erroné de compter sur elle pour un flux sans intervention.
Pour qui : Un responsable métier qui crée des tâches visuelles d’extraction et achète l’exécution cloud lorsque nécessaire.
Point fort : Scraping organisé en tâches, avec planification cloud payante et export automatique.
Tarif : Standard à partir de 69 USD/mois avec facturation annuelle.
Essai gratuit : Free Plan avec 10 tâches locales et 50 000 lignes exportées/mois.
Free inclut 10 tâches, une exécution sur l’appareil local, jusqu’à 10 000 lignes par export et 50 000 lignes exportées par mois. Standard ajoute l’extraction cloud, la planification des tâches, l’export automatique et la Data Export API, avec 100 tâches et jusqu’à 3 processus cloud simultanés. Professional autorise 250 tâches et jusqu’à 20 processus cloud simultanés, avec l’Advanced API et une assistance supplémentaire. Enterprise annonce 750+ tâches et 40+ processus cloud simultanés. Détail des offres Octoparse.
La gamme publiée comprend Free à 0 USD, Standard à partir de 69 USD/mois, Professional à 249 USD/mois et Enterprise sur devis. Les deux montants payants correspondent à une facturation annuelle. Traitez ces équivalents mensuels comme des offres annuelles et confirmez le montant de la facture au paiement avant de prévoir votre sortie de trésorerie. Tarifs Octoparse.
La facturation repose sur un abonnement limité en tâches et en processus, pas sur un crédit standard par requête. Cela peut convenir à une extraction importante répartie entre un nombre raisonnable de tâches. Mais « export de données illimité » dans les offres payantes ne signifie pas exécution cloud parallèle illimitée. Les trois processus simultanés de Standard peuvent devenir la contrainte bien avant les 100 tâches enregistrées.
Les options sont facturées séparément. La page tarifaire affiche les proxies résidentiels à 3 USD/Go, la résolution des CAPTCHA de 1 à 1,5 USD pour mille et les modèles facturés au résultat de 0,001 à 3 USD pour mille résultats. Un abonnement payant ne rend pas gratuits tous les coûts d’accès avancé.
Pour un catalogue fournisseur, commencez en local avec une petite tâche et vérifiez la couverture des listes et des fiches détaillées. Confirmez ensuite comment l’exécution cloud traite la même entrée, où arrive l’export et qui est informé d’un échec. Savoir construire la tâche ne dispense pas l’analyste d’une routine de contrôle des enregistrements collectés.
- La conception visuelle convient au responsable métier qui veut maîtriser les consignes d’extraction.
- Les tâches locales gratuites permettent d’évaluer un workflow avant de payer pour le cloud.
- Standard inclut explicitement la planification et l’export automatique.
- Les plafonds de tâches et de processus cloud rendent les limites d’exécution visibles.
- L’exécution gratuite est locale : elle ne fournit pas le fonctionnement cloud sans intervention recherché.
- Le volume d’export payant ne supprime pas les limites de tâches ou de simultanéité.
- Les options de proxies, de CAPTCHA et de modèles peuvent ajouter des frais à l’usage.
- Le tarif de départ exige une facturation annuelle.
Choisissez Octoparse si la conception visuelle des tâches apporte un avantage réel et si ses plafonds de processus cloud conviennent à la planification. Browse AI est le premier candidat le plus direct pour une veille enregistrée ; une API convient mieux lorsque l’extraction est intégrée à un produit logiciel.
8. Zyte : un tarif d’accès qui dépend du site cible
Zyte est un fournisseur de données web dont Zyte API facture les réponses réussies selon la difficulté du site et le mode demandé, contenu HTTP ou rendu navigateur. Il convient au développeur qui exploite un collecteur et veut automatiser la gestion de l’accès sans acheter un ensemble de proxies bruts. Un service d’annonces peut conserver son jeu de données et son analyse tout en budgétant le mode de réponse réellement nécessaire pour chaque cible. Le tarif minimal n’est utile que si vous précisez aussi le niveau de difficulté et l’engagement auxquels il correspond.
Pour qui : Un collecteur géré par un développeur, avec un budget d’accès adapté à chaque cible.
Point fort : Facturation des réponses réussies, avec tarifs HTTP et navigateur distincts.
Tarif : PAYG HTTP de 0,13 à 1,27 USD pour 1 000 ; navigateur de 1,01 à 16,08 USD pour 1 000.
Essai gratuit : Crédit de 5 USD pendant 30 jours, sans engagement ; aucune offre gratuite récurrente annoncée.
Les tarifs HTTP en PAYG pour les cibles Simple, Easy, Moderate, Complex et Advanced sont respectivement de 0,13, 0,23, 0,44, 0,70 et 1,27 USD pour 1 000 réponses. Les tarifs navigateur en PAYG sont de 1,01, 2,01, 4,02, 8,04 et 16,08 USD. Un même nombre de requêtes peut donc produire une facture très différente selon la cible et la nécessité d’un rendu. Tarifs Zyte.
Les engagements mensuels réduisent ces tarifs. Avec un engagement de 100 USD, les prix annoncés vont de 0,10 à 0,95 USD en HTTP et de 0,75 à 12,00 USD en mode navigateur, pour 1 000 réponses. À 200 USD, les fourchettes sont de 0,08 à 0,76 USD et de 0,60 à 9,60 USD. À 500 USD, elles passent à 0,06–0,61 USD et 0,48–7,68 USD. Les tarifs Enterprise se négocient avec l’équipe commerciale. L’accroche « à partir de 0,06 USD » appartient à la gamme avec engagement ; ce n’est pas le tarif d’entrée HTTP en PAYG.
Pour un exemple de 100 000 réponses réussies, le tarif HTTP PAYG Simple donne une facture d’utilisation de 13 USD. Le tarif navigateur Simple donne 101 USD ; le tarif navigateur Advanced, 1 608 USD. Ces calculs utilisent les tarifs publiés et ne préjugent pas du niveau dans lequel sera classé votre site. Des fonctions avancées peuvent ajouter des frais : utilisez l’estimateur de l’éditeur propre au site avec le mode de sortie prévu.
La limite à retenir est l’économie propre à chaque cible. Une cible HTTP peu complexe et une cible avancée avec rendu ne doivent pas partager le même coût supposé par page. Segmentez la liste d’URL par cible et par mode, conservez le nombre de réponses acceptées et comparez les offres avec engagement à partir de cette répartition.
Réussir l’accès vous laisse aussi la responsabilité de l’extraction. Votre parseur doit encore obtenir le bon identifiant d’annonce, les bons champs et vérifier leur complétude. Si une API d’enregistrements maintenue ou un Actor fournit déjà le jeu de données nécessaire, un tarif d’accès inférieur ne suffit pas forcément à justifier la maintenance d’une extraction sur mesure.
- Les tarifs HTTP et navigateur distincts permettent de budgéter chaque cible précisément.
- Cinq niveaux de difficulté rendent visible une variation qu’un simple tarif d’entrée peut masquer.
- Les engagements mensuels offrent une grille de tarifs explicite.
- L’API annonce le rendu, la rotation des IP et la géolocalisation.
- Le tarif d’appel le plus bas exige un engagement mensuel.
- Le rendu navigateur peut modifier fortement le coût de la collecte.
- Les fonctions avancées peuvent être facturées en supplément.
- La réponse reçue doit toujours être analysée et validée selon vos règles métier.
Choisissez Zyte si votre workflow technique a besoin d’un accès géré et peut mesurer la répartition des cibles. Commencez par une estimation en PAYG avant de souscrire un engagement dans le seul but d’obtenir le plus petit chiffre affiché.
Quel budget prévoir pour une collecte planifiée ?
Comptez les opérations répétées et le format de sortie avant de comparer les tarifs d’entrée. Prenons un exemple explicite de planification : un fondateur revisite 120 pages connues chaque jour pendant un mois de 30 jours, soit 3 600 visites. On suppose des pages ordinaires, aucune action supplémentaire dans le navigateur, aucun appel de découverte, aucun frais d’endpoint de suivi et aucune nouvelle tentative facturable. C’est une feuille de calcul budgétaire, pas une charge mesurée ni une promesse d’accès aux cibles.
Pour des extractions Markdown simples, ces 3 600 visites consomment 3 600 crédits chez Firecrawl comme chez Context.dev. Firecrawl Hobby inclut 5 000 crédits pour 19 USD/mois, et Context.dev Developer en inclut 7 500 pour 19 USD/mois. Les deux abonnements mensuels d’entrée couvrent ce volume d’extraction précis. Firecrawl, Context.dev.
Demander du JSON structuré réussi sur les mêmes pages standard porte le besoin à 18 000 crédits chez chacun. Firecrawl Hobby nécessite 13 blocs supplémentaires de 1 000 crédits à 5 USD : 19 USD + 65 USD = 84 USD/mois. Context.dev Developer, au tarif publié pour les nouveaux abonnements, nécessite 11 blocs supplémentaires de 1 000 crédits à 2,20 USD : 19 USD + 24,20 USD = 43,20 USD/mois. L’arrondi aux blocs laisse quelques crédits inutilisés dans le calcul Context.dev.
Le calcul de fréquence est le même pour une veille sans code. Chez Browse AI, 3 600 vérifications de pages standard par mois deviennent 43 200 par an, avant les volumes de lignes supérieurs ou les cibles premium. Les 60 000 crédits annuels de Professional couvrent ce volume théorique ; les 12 000 de Personal ne suffisent pas. Professional mensuel fournit 5 000 crédits pour 87 USD, tandis que Professional annuel revient à 69 USD/mois avec 828 USD payés d’avance. Browse AI.
Les proxies bruts demandent un autre calcul. Partez du nombre de Go mesuré, puis ajoutez l’hébergement du scraper, le travail d’extraction et le traitement des anomalies. Une API d’enregistrements se chiffre à partir des enregistrements livrés facturables. Apify se chiffre à partir de l’Actor choisi et des ressources consommées. N’en déduisez pas un coût garanti par page sans mesurer la tâche réelle.
Quel outil de scraping choisir selon votre équipe ?
La règle de décision est précise : avez-vous besoin du contenu des pages, d’une veille gérée par l’équipe métier, d’enregistrements prêts à l’emploi propres à une cible ou d’accès pour du code que vous maintenez déjà ? Une montée en gamme doit résoudre la limite rencontrée, pas simplement récompenser un fournisseur pour une liste de fonctions plus longue.
Le bon outil dépend de qui répare la prochaine collecte
Si l’équipe technique gère la fonction de données, retenez une API qui renvoie le contenu et les métadonnées nécessaires. Si l’équipe métier gère un processus dans un tableur, retenez un robot visuel qu’elle peut examiner. Si personne n’est encore responsable des échecs, attribuez ce rôle avant d’augmenter la fréquence.
Le choix change avec la responsabilité. Une API de scraping peut être la bonne brique pour un développeur qui construit un produit, mais un mauvais achat pour un responsable métier qui attend un résultat quotidien et n’a aucune application où le recevoir. À l’inverse, une tâche enregistrée peut être rapide à évaluer, puis devenir contraignante lorsque l’extraction est une fonction centrale du produit.
Scraping web et IA : définissez le schéma et les règles de validation
Traitez l’extraction comme un contrat de données. Pour un enregistrement de prix, définissez l’identifiant produit, la variante, le montant numérique, la devise, l’URL source et l’heure de collecte. Décidez du traitement des valeurs absentes ou ambiguës avant la première mise à jour automatique. Un objet JSON propre est un format ; un enregistrement métier correct se juge par rapport à ce contrat.
Pour l’ingestion documentaire, conservez la source et l’heure de récupération, et excluez les éléments de navigation répétés sans intérêt lorsque c’est pertinent. Gardez la réponse originale lorsqu’un contrôle automatique rejette une page. Ces éléments permettent au responsable de distinguer un changement du site d’une mauvaise définition de champ.
Pour un agent IA, le résultat attendu guide le choix du scraper
Commencez par Firecrawl pour le workflow scrape/crawl/map centré sur les pages. Ajoutez Context.dev si la combinaison des traitements par lots et du suivi par webhook convient à votre application. Si un Actor Apify adapté collecte déjà les champs nécessaires sur la cible, évaluez son exécution complète à côté des API génériques de pages.
Comparez sur un ensemble de sources fixe avec le même résultat attendu. Incluez une page ordinaire, une page nécessitant un rendu, une relation entre liste et fiches détaillées, et une page avec un champ ambigu. Un quota d’entrée est un élément de coût, pas une preuve de meilleure qualité des données.
Scraping Python : quels outils intégrer à votre planification ?
Un workflow Python peut appeler une API tout en conservant dans l’application la planification, l’analyse, la persistance et la validation. Choisissez Firecrawl ou Context.dev pour obtenir le contenu des pages ou une extraction structurée gérée. Choisissez ScrapingBee ou Zyte pour garder la maîtrise de l’analyse et remplacer uniquement la récupération des pages.
Ce contrôle supplémentaire demande du travail d’exploitation. Distinguez une erreur de transport, une page d’erreur du site cible, un champ manquant et un enregistrement rejeté par les règles métier. Ne relancez pas aveuglément toutes ces situations : répéter la même requête ne corrige pas une mauvaise règle d’extraction.
Web scraping gratuit : privilégiez un quota qui se renouvelle
Firecrawl et Context.dev annoncent chacun 1 000 crédits mensuels. Browse AI fournit 50 crédits mensuels sur 2 domaines. Apify donne 5 USD/mois d’utilisation, et Bright Data Scraper API fournit 5K enregistrements/mois. Ces offres peuvent couvrir de petites évaluations ou des tâches récurrentes modestes si l’opération concernée respecte le quota.
Pour une seule page standard vérifiée chaque jour pendant un mois de 30 jours, les 50 crédits de Browse AI couvrent les 30 vérifications. C’est un exemple utile de veille gratuite, à condition que la page ne soit pas une cible premium et que le nombre de lignes extraites n’augmente pas le coût. Les 1 000 crédits de ScrapingBee et les 5 USD de Zyte sont des essais ; Octoparse Free s’exécute en local. Ces différences comptent davantage que l’étiquette « gratuit ».
Open source : l’équipe doit aussi prendre en charge l’exploitation
Le cœur auto-hébergeable de Firecrawl est une option lorsque la maîtrise du code source ou de l’infrastructure justifie d’exploiter les services soi-même. L’open source supprime l’abonnement fournisseur pour ce cœur ; il ne fournit ni l’hébergement, ni le suivi, ni la reprise après incident, ni l’ingénieur qui résoudra le prochain échec.
Consultez le guide d’auto-hébergement de Firecrawl pour évaluer cette responsabilité avant d’y voir la manière la moins chère de scraper. Pour une petite équipe produit qui a seulement besoin d’un endpoint renvoyant des pages connues, les offres gérées d’entrée peuvent éviter un projet d’infrastructure distinct. Choisissez l’auto-hébergement pour un besoin concret de contrôle, avec une personne capable d’en assurer l’exploitation dans la durée.
Comment cette sélection a été établie
Le comparatif privilégie l’adéquation au besoin, la transparence de la facturation et la limite qui fait changer la décision d’achat. Les pages tarifaires et la documentation pertinente des éditeurs ont été consultées pour établir le comparatif, et les chiffres ont été vérifiés le 6 octobre 2026. Les exemples de coûts sont des calculs fondés sur ces tarifs publiés et sur des hypothèses de charge explicites. Il ne s’agit pas d’un essai pratique des produits, et aucun classement de vitesse, de précision ou de taux de réussite n’est avancé.
Firecrawl, Bright Data, Browse AI et Context.dev sont des outils partenaires du site ; Apify, ScrapingBee, Octoparse et Zyte offrent des alternatives indépendantes. Ce statut ne rend pas les proxies bruts adaptés à une veille métier, ni un robot enregistré adapté au rôle d’API dans un produit logiciel. Les recommandations suivent les limites de chaque usage.
Les critères pratiques sont les suivants : le produit renvoie-t-il le résultat nécessaire ? Qui gère sa configuration et ses réparations ? Quelle opération répétée est facturée ? Quel quota ou plafond de simultanéité sera atteint en premier ? Que devient une réponse incomplète ou rejetée ? Une place de marché plus vaste ou un prix d’appel plus bas ne suffisent pas à répondre à ces questions.
Les catalogues de frameworks et de bibliothèques de navigation restent hors de cette sélection, car elle s’adresse à un lecteur qui choisit un service récurrent, un workflow sans code ou une infrastructure d’accès. Le pilotage interactif d’un navigateur répond à un besoin distinct lorsque la tâche exige beaucoup de navigation plutôt qu’une collecte de pages.
Vérifiez les conditions du site cible et son fichier robots.txt avant de planifier une collecte.
Les achats à éviter selon votre besoin
Évitez un outil mal adapté, même s’il excelle dans un autre usage. Les choix suivants risquent le plus de créer le travail que l’achat devait supprimer.
- Octoparse Free pour un flux cloud sans intervention. Ses tâches s’exécutent en local. Payez l’exécution cloud nécessaire au processus ou choisissez un service dont le fonctionnement convient.
- Les proxies résidentiels Bright Data pour acheter un jeu de données prêt à l’emploi. Ils fournissent l’accès ; les requêtes, l’analyse et la validation restent à votre charge. Utilisez une Scraper API adaptée si ce que vous voulez acheter est l’enregistrement.
- Le prix d’appel annuel de Browse AI Personal pour une veille fréquente et volumineuse. Les 12 000 crédits annuels ne couvrent pas l’exemple de 43 200 crédits par an. Dimensionnez d’abord les visites, les lignes, les cibles premium et les domaines.
- L’accroche Zyte à 0,06 USD comme tarif PAYG. Elle correspond au bas de la grille avec engagement de 500 USD. Estimez la cible et le mode réels avant de souscrire cet engagement.
- Le total de crédits ScrapingBee comme garantie de requêtes. Le rendu et les réglages de proxies peuvent consommer plusieurs crédits pour une même requête. Budgétez la configuration qui fonctionne.
- Firecrawl ou Context.dev comme système complet de qualité des données. Les deux peuvent livrer du contenu que vous devez rejeter. Conservez le statut et les sorties pour les contrôler, et protégez les enregistrements en aval contre les mises à jour incomplètes.
Le produit à éviter est celui qui vous laisse maintenir la couche que vous pensiez lui déléguer. Une limite de responsabilité précise vaut mieux qu’un classement général péremptoire.
Par quoi commencer lundi ?
Lancez une petite évaluation planifiée avec une personne clairement responsable. Choisissez dix URL représentatives, définissez les champs ou le contenu documentaire attendus et précisez ce qui rendra une réponse inacceptable. Pour une tâche sans code, enregistrez le workflow ; pour une API, reliez-la à votre planificateur et à votre stockage.
Exécutez la collecte une fois par jour pendant sept jours. Conservez la réponse originale, le statut du site cible, la sortie, les unités de facturation consommées et le nombre d’enregistrements acceptés. Examinez la pagination, les valeurs absentes, les identifiants en doublon et les changements qui doivent, ou non, déclencher une mise à jour.
Calculez ensuite le coût du mois complet à partir de la répartition des cibles observée. Choisissez l’option la moins complexe qui satisfait les exigences de résultat et de responsabilité, puis maintenez les contrôles après l’essai. Un flux devient exploitable en production parce qu’il fournit régulièrement des résultats utiles, pas parce que sa première requête a réussi.
Quels outils choisir pour le scraping web ?
Firecrawl et Context.dev conviennent au contenu des pages pour les agents ; Browse AI et Octoparse, aux workflows d’extraction visuels ; Bright Data, Zyte et ScrapingBee, à différents besoins d’accès et de récupération. Apify est particulièrement utile lorsqu’un Actor adapté à la cible existe déjà. Définissez d’abord le résultat et son responsable, puis comparez la facture mensuelle complète.
ChatGPT peut-il extraire les données de sites web ?
ChatGPT peut ouvrir des sites et collecter de l’information avec sa fonction de navigateur, comme le décrit la documentation officielle OpenAI. Cela peut servir à une collecte interactive. Pour des prix, des annonces ou des documents destinés à un agent qui doivent être actualisés régulièrement, évaluez séparément la planification, le schéma de sortie, la sauvegarde des résultats et la responsabilité des échecs. Le choix porte ici sur le service qui fournit ce workflow récurrent, au-delà de la capacité d’un assistant IA à lire une page.
Quelle IA choisir pour le scraping web ?
Choisissez le service d’extraction et le résultat attendu avant le modèle de langage. Firecrawl et Context.dev méritent d’être retenus pour du Markdown ou des champs structurés ; Browse AI convient à un robot géré par l’équipe métier. Le meilleur choix fournit les informations nécessaires sur vos sources représentatives à un coût complet acceptable.
Le scraping web est-il dépassé ?
Vérifiez d’abord si la cible propose une API ou un flux adapté. Lorsque l’information nécessaire n’est publiée que sous forme de pages, l’extraction reste une option. La distinction utile pour l’achat est de savoir qui gère la récupération, l’extraction, la planification et la validation, plutôt que de se fier à une étiquette IA.
Quels sont les 10 meilleurs outils de scraping web ?
Cette sélection couvre huit produits pour trois besoins récurrents : données pour agents, veille sans code et accès à grande échelle. Choisissez dans ces catégories plutôt que d’ajouter des outils pour atteindre dix. Un projet d’automatisation de navigateur ou un framework auto-hébergé implique une responsabilité différente de celle des services comparés ici.
Recevez l’AI Business Workflow Audit Checklist via la newsletter, puis définissez le résultat, la planification, les règles de validation et le responsable avant de vous engager dans un workflow de données web.
- Dernière mise à jour
- 6 oct. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Agent memory : quelle mémoire faut-il à vos agents IA ?
Comprenez la mémoire des agents IA : contexte, sessions, stockage durable, coûts et méthodes pour corriger les faits périmés et isoler les données clients.5 oct. 2026Build
Base de données vectorielle : combien coûte Pinecone en 2026 ?
Tarifs Pinecone en 2026 : Starter gratuit, Builder à $20, minimums payants et coûts de 1M à 100M vecteurs selon les requêtes. Calculez votre budget.5 oct. 2026Build
Lovable gratuit ou payant : le guide des alternatives en 2026
Comparez les alternatives à Lovable gratuit ou payant : tarifs en dollars, crédits, backend et export du code pour choisir sans sous-estimer la migration.5 oct. 2026Build
LLM observability en 2026 : quel outil choisir selon votre équipe et votre budget ?
Comparez six outils d’observabilité LLM : coûts selon la taille de votre équipe, limites gratuites, licences et hébergement pour choisir en production.5 oct. 2026Build
OpenCode : le guide pour coder avec le modèle de votre choix
Installez OpenCode, connectez votre modèle, corrigez un vrai bug et configurez AGENTS.md et les plugins. Comprenez les coûts de l’API et de Zen.4 oct. 2026Build
Netlify Pricing : quel budget prévoir pour vos projets ?
Netlify Pricing : comparez Free, Personal et Pro, calculez vos crédits et estimez le budget mensuel d’un site vitrine, d’une app Next.js ou d’une agence.4 oct. 2026Build
Softr Airtable : avis, tarifs et limites pour un portail client
Softr Airtable, portail client ou outil interne : découvrez les tarifs, les droits d’accès, les limites de données et l’IA pour choisir la bonne offre.4 oct. 2026Build