Парсеры сайтов в 2026 году: 8 сервисов под разные задачи
Сравниваем 8 сервисов для парсинга сайтов: данные для агентов ИИ, мониторинг без кода и сбор в масштабе. Цены, лимиты и расчёт регулярных расходов.




Если агенту ИИ нужны очищенные страницы, начните с Firecrawl. Для мониторинга, которым сможет управлять специалист без разработки, подойдёт Browse AI, а если сбор данных упирается в доступ к сайтам — Bright Data. Лучшие парсеры сайтов решают разные задачи: Firecrawl и Context.dev стоят от $19/месяц при помесячной оплате, но получение структурированного JSON меняет расход кредитов. Сначала определите нужный результат, расписание и того, кто исправит сбой, — затем выбирайте сервис.
Парсеры сайтов: краткое сравнение
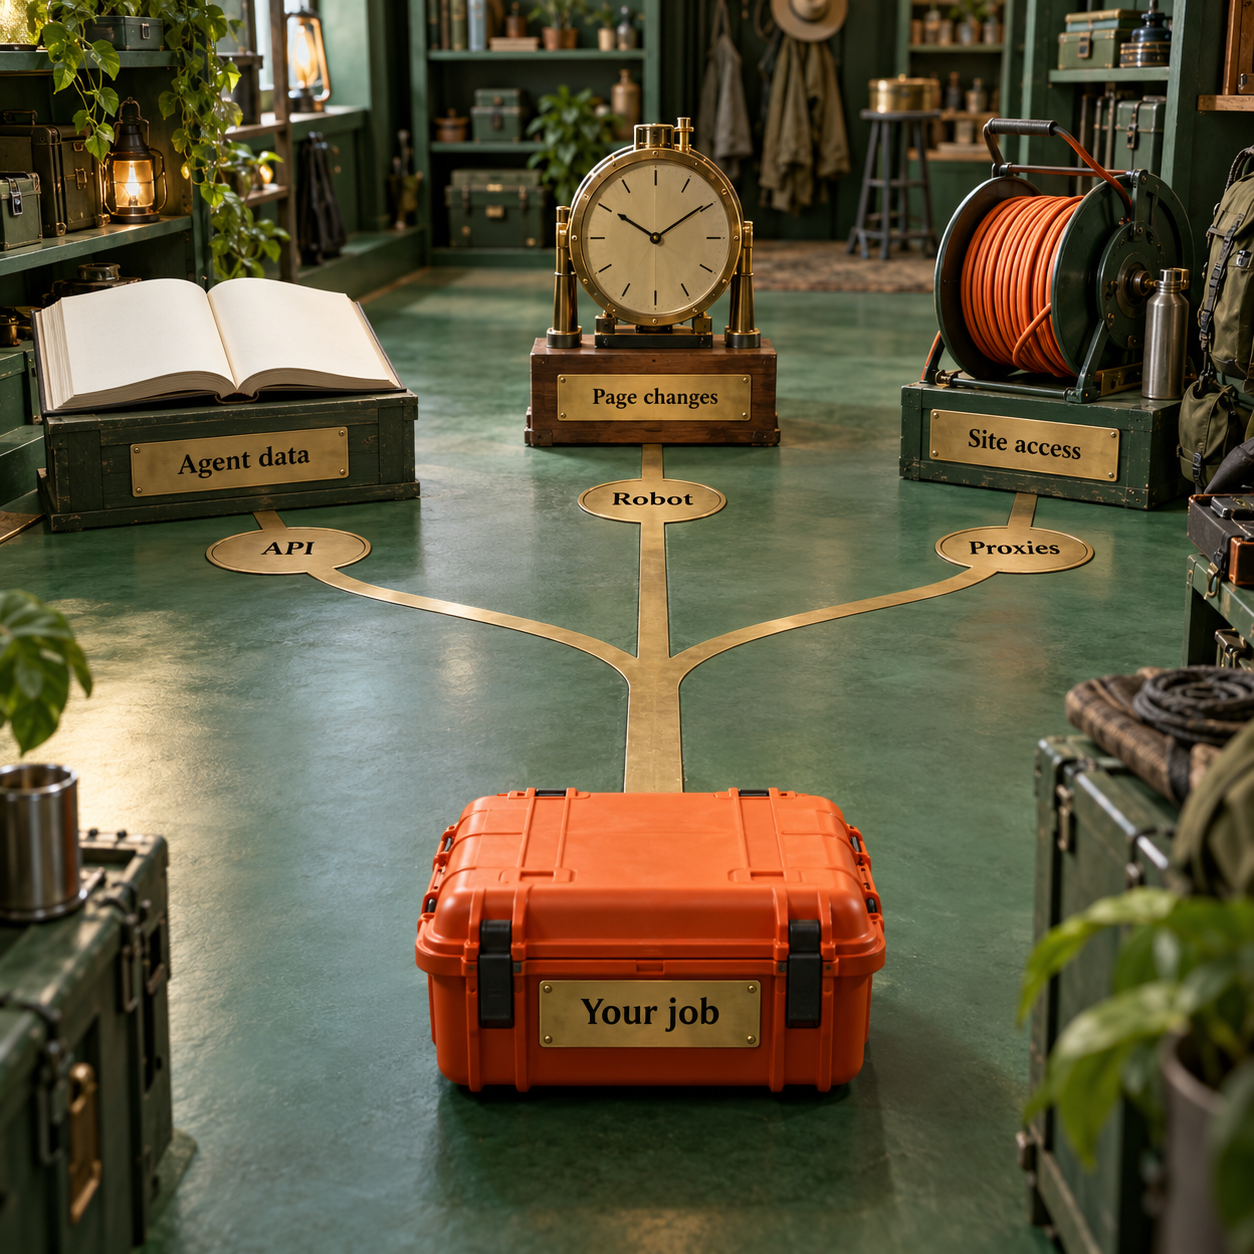
Покупайте тот компонент, которого не хватает вашему процессу. API для парсинга — сервис, к которому программа обращается за данными страниц, — подходит разработчику агента или набора данных. Робот без кода нужен специалисту, который регулярно выполняет одну и ту же задачу по сбору данных. Прокси-сеть, направляющая трафик через другие IP-адреса, пригодится, если собственный парсер уже есть, но ему нужен более надёжный доступ к целевым сайтам.
Цены и лимиты ниже сверены с действующими страницами разработчиков 6 октября 2026 года. Годовые предложения отмечены отдельно; пробный доступ не смешивается с бесплатными лимитами, которые возобновляются. В колонке с начальной ценой указано стартовое платное предложение, а в последней — что можно проверить без платного тарифа.
Таблица помогает сузить выбор: доставленная запись, посещённая страница и гигабайт не равнозначны. Купон Bright Data RESIGB50 даёт заявленную скидку 50% на три месяца. Временную цену учитывайте в бюджете проверки, а для регулярных расходов закладывайте обычную.
Сначала результат, затем ответственный
Здесь три разных сценария покупки, и для каждого нужен свой инструмент. Основателю, который загружает документацию в ассистента, специалисту, следящему за ценами конкурентов, и разработчику, обновляющему большой набор объявлений, нужны разные критерии сравнения.
Задача первая: подготовить страницы для агента
Начните с Firecrawl или Context.dev, если приложение должно получать содержимое страниц или структурированные поля. Markdown — читаемый текст с сохранёнными заголовками и ссылками; он удобен, когда агенту ИИ нужен документ. JSON хранит именованные поля, например товар, цену, валюту и наличие; он подходит процессу, которому нужна запись для проверки и сравнения.
От этого выбора зависят и качество, и стоимость. Ассистенту поддержки часто достаточно очищенной страницы документации. Для уведомления о цене нужны само значение, валюта, правильный вариант товара и время сбора. Если просто отправить страницу модели, она не узнает, какая из нескольких цен важна именно для вашего бизнеса.
Различайте scrape — получение одной страницы, crawl — переход по ссылкам сайта для сбора нескольких страниц, и map — обнаружение URL. Если надёжный список адресов уже есть, повторный поиск может добавить работу без пользы для потока данных. Если документация сайта постоянно растёт, поиск новых страниц становится частью задачи.
Задача вторая: следить за известными страницами без поддержки кода
Выбирайте Browse AI, если специалисту нужен записанный сценарий извлечения данных и мониторинг изменений, которым он сможет управлять сам. Octoparse стоит рассмотреть, когда удобнее визуально проектировать задачи и запускать сбор в платном облаке. Робот здесь — сохранённая последовательность действий и инструкций по извлечению данных, а не универсальная замена сотруднику.
Например, руководителю операционной команды каждое утро нужны название, цена и наличие товаров из списка поставщика. Полезный результат — таблица со стабильными колонками и явным сообщением, если поле исчезло. Ответственный должен уметь проверить сценарий и поправить его после изменений на сайте.
Прежде чем выбирать частоту проверок, решите, что считать изменением. Обновление подвала страницы ничего не говорит о наличии товара. Перестановка строк в списке не должна выглядеть как замена всех товаров. Сохраняйте устойчивый идентификатор, сравнивайте значимые поля и отправляйте пропуски на проверку, вместо того чтобы молча затирать вчерашнее корректное значение.
Задача третья: собирать данные в масштабе, когда мешает доступ
Рассмотрите Bright Data, Zyte или ScrapingBee, если ваша программа уже управляет расписанием и набором данных, а сложность — в получении целевых страниц. Сервис обхода блокировок берёт на себя повторные попытки и выбор прокси. Смысл записей в вашем наборе данных он автоматически не определяет.
Bright Data также предлагает Scraper API для конкретных сайтов: можно покупать более полную запись, а не только сетевой доступ. У Apify другой полезный подход: поддерживаемый Actor для нужного сайта может уже выполнять вашу задачу извлечения. Actor — облачная программа, которую можно настроить и запускать многократно.
Выбор зависит от того, кто поддерживает решение. Если нужна чужая готовая логика извлечения, оцените Scraper API или Actor. Если собственную логику разбора важно сохранить, смотрите на API получения страниц или прокси. Покупать только доступ и ожидать готовый набор данных — дорогое несовпадение ожиданий с возможностями продукта.
Восемь сервисов и ограничения, которые влияют на выбор
Каждый сервис ниже полезен для конкретной повторяющейся задачи. Нумерация помогает ориентироваться в списке; подходящий вариант внутри каждого сценария зависит от результата, лимитов и распределения ответственности, описанных в его разделе.
1. Firecrawl: с чего начать сбор страниц для агента
Firecrawl — API для преобразования сайтов в пригодное для работы содержимое страниц. Его стоит первым проверить для агента, который опирается на документацию. Функции Scrape, Crawl и Map отвечают за получение страниц, обход сайта и обнаружение URL; эти задачи здесь разделены. Основатель, создающий ассистента поддержки, может найти страницы документации, выбрать нужные пути и собрать их в Markdown. Firecrawl подходит, когда нужен очищенный текст страниц. Если главная задача — мониторинг таблицы под управлением специалиста, стоит пересмотреть выбор.
Кому подходит: Разработчику, который передаёт агенту ИИ документацию, статьи или справочные страницы.
Главное преимущество: Отдельные функции scrape, crawl и map, поддержка Markdown и структурированного извлечения.
Цена: Hobby $19/месяц или $16/месяц при годовой оплате; 5,000 кредитов в месяц.
Бесплатный доступ: Возобновляемый тариф Free с 1,000 кредитов/месяц, банковская карта не нужна.
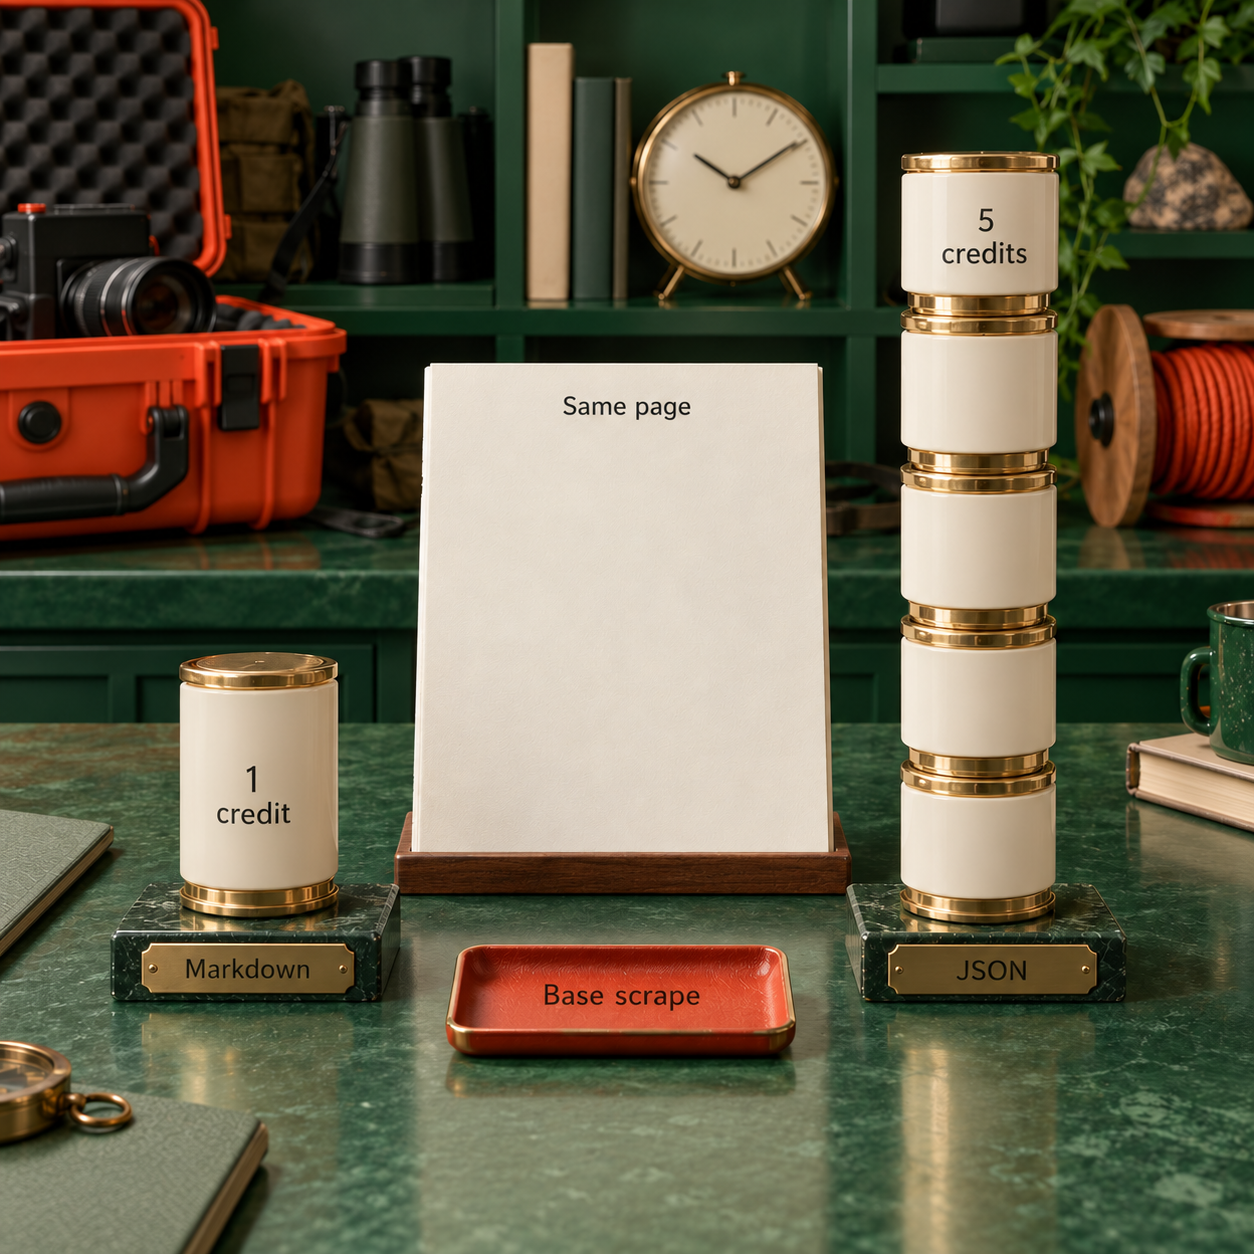
Базовое получение страницы через scrape или crawl стоит 1 кредит. Извлечение JSON добавляет 4 кредита, поэтому стандартный запрос страницы вместе с JSON обходится в 5 кредитов. Лимита Hobby хватит на 5,000 базовых страниц или 1,000 стандартных страниц с JSON, если тратить весь баланс только на эту операцию. Одна и та же подписка даёт очень разный объём в зависимости от нужного результата. Подробности тарифов Firecrawl.
При помесячной оплате тарифы выглядят так: Free — $0, Hobby — $19 за 5,000 кредитов, Standard — $99 за 100,000, Growth — $399 за 500,000, Scale — $749 за 1,000,000. Для Enterprise цена индивидуальная. На странице указаны годовые эквиваленты $16, $83, $333 и $599/месяц; соответствующие годовые счета — $190, $990, $3,990 и $7,190. Это значения, опубликованные разработчиком, включая его округления. Все тарифы Firecrawl.
Первое ограничение — заданный объём обхода. Согласно документации Firecrawl, лимит по умолчанию составляет 10,000 страниц, и задача может быть отклонена, если оставшихся кредитов не хватает на заданный лимит. Поэтому даже для небольшого сайта на Hobby иногда нужно явно уменьшить limit ещё до получения первой страницы. Следующее ограничение — параллельность: Hobby допускает 5 одновременных запросов, Standard — 25, Growth — 50, Scale — 100. Покупка дополнительных кредитов не снимает лимит параллельных запросов текущего тарифа. Как работает обход.
Нужна и проверка пригодности результата. По информации Firecrawl, запрос без результата не оплачивается, но за полученную страницу с ошибкой целевого сайта, например 403 или 404, списывается кредит. Прежде чем добавлять данные в базу знаний, проверяйте статус сайта и содержимое ответа. Аккуратно преобразованная в Markdown страница ошибки остаётся страницей ошибки.
- Функции scrape, crawl и map позволяют отдельно выбирать способ поиска и получения страниц.
- Markdown удобен для загрузки документов, JSON — для заданной схемы полей.
- Возобновляемый бесплатный лимит позволяет проверить небольшую задачу по расписанию.
- Платное пополнение увеличивает объём использования без смены тарифа.
- Структурированное извлечение заметно сокращает базовый лимит страниц.
- Большой лимит обхода по умолчанию может превышать баланс небольшого аккаунта.
- Полученные страницы ошибок могут оплачиваться и требуют вашей проверки.
- Кредиты Hobby, Standard и Growth обычно не переносятся на следующий период.
Найдите нужные страницы до полного сбора
Используйте песочницу Map, чтобы обнаружить URL документации. Оставьте пути, которые помогают отвечать на реальные вопросы к ассистенту. Map находит адреса; получение самих страниц — отдельная операция.
Выберите самый экономный формат, решающий задачу
Для ассистента, работающего с документами, начните с Markdown. Если дальнейшему процессу нужны именованные поля, используйте схему JSON. Прежде чем считать схему однозначной, проверьте характерную страницу товара, на которой есть и обычная цена, и цена со скидкой.
Задайте лимит обхода по своему бюджету
Для условного набора из 120 страниц явно установите
limitв 120. Фильтруйте пути, чтобы обход не тратил баланс на посторонние страницы блога или личного кабинета.Сохраните результат и данные для его проверки
В собственном хранилище сохраняйте исходный URL, время сбора, статус целевого сайта и содержимое. В документации Firecrawl указано, что результаты завершённого обхода доступны через API в течение 24 часов, поэтому ответ сервиса не должен оставаться единственной копией.
Продумайте следующий запуск
Настройте планировщик приложения на повторный сбор согласованного набора источников. Разделите в бюджете расходы на поиск страниц, извлечение и мониторинг. Назначьте получателя уведомлений на случай, если источник перестанет возвращать ожидаемое содержимое.
Если вы ищете замену существующему решению на Firecrawl, в сравнении альтернатив Firecrawl подробнее разобраны миграция и критерии приёмки данных. Смена поставщика и переход от загрузки документов к мониторингу без кода — разные решения.
2. Browse AI: мониторинг под управлением специалиста
Browse AI — платформа для парсинга и мониторинга без кода: она записывает задачу в виде робота, который можно запускать повторно. Подходит специалисту, отслеживающему цены товаров, вакансии или записи в каталогах на известном наборе сайтов. Он может записать выбор полей и направить результат в таблицу или связанный процесс. Ключевое ограничение складывается из страниц, извлечённых строк и отслеживаемых доменов: «неограниченное число роботов» не означает неограниченный объём данных.
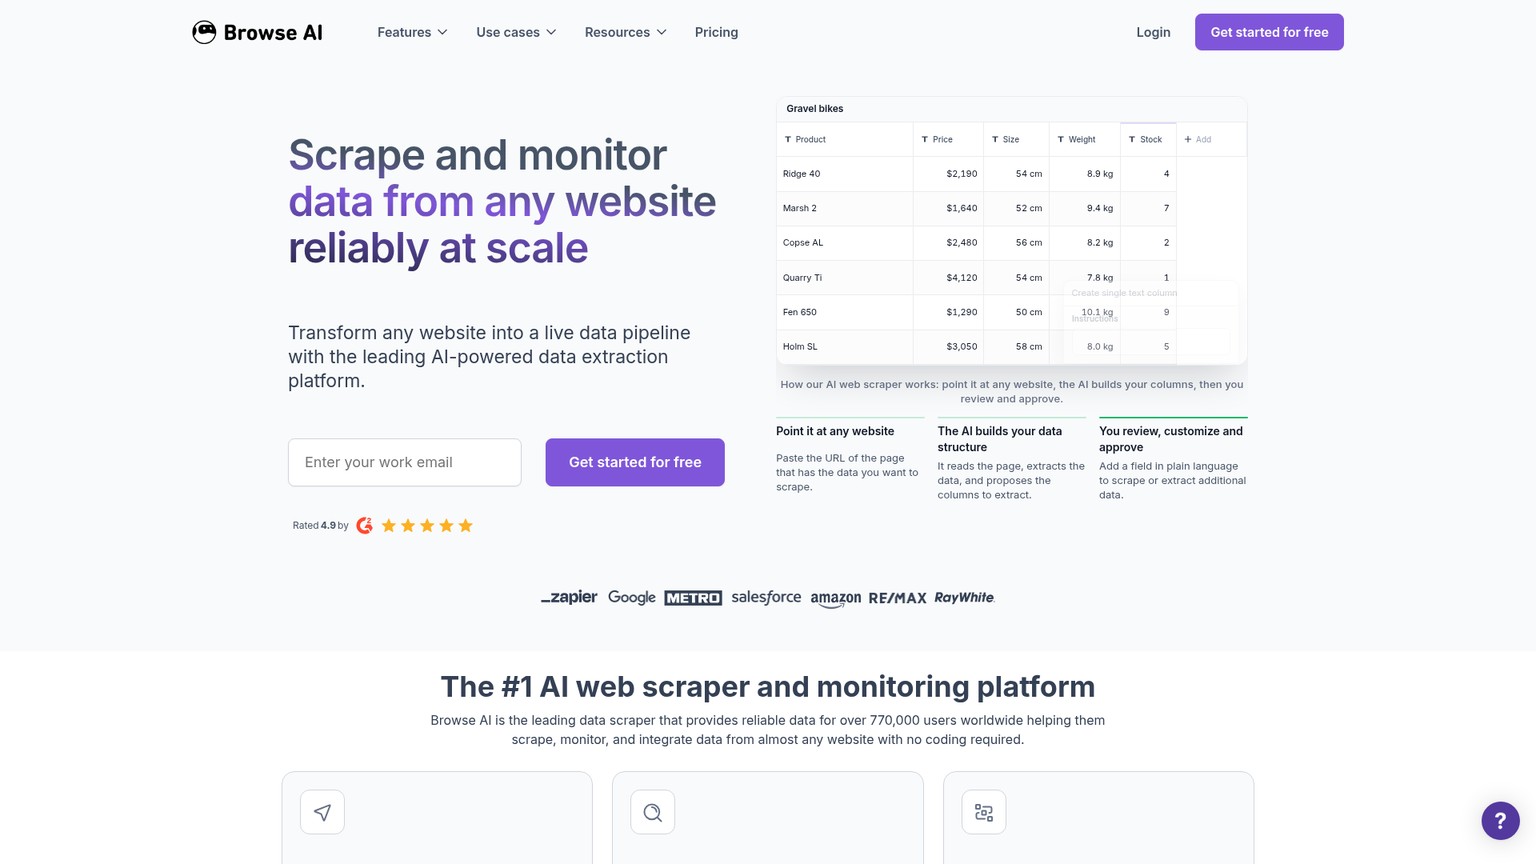
Кому подходит: Специалисту, которому нужны регулярный сбор и отслеживание изменений без поддержки кода парсера.
Главное преимущество: Записанные роботы, мониторинг по расписанию и интеграции с таблицами и рабочими процессами.
Цена: Personal $19/месяц при годовой оплате, $228 сразу; 12,000 кредитов на год.
Бесплатный доступ: Тариф Free с 50 кредитами/месяц, 2 доменами и неограниченным числом роботов.
Browse AI списывает один кредит за посещение стандартной страницы или за каждые десять извлечённых строк — выбирается больший расход. Страница списка с 50 товарами стоит 5 кредитов; посещение всех 50 карточек добавляет ещё 50, если это стандартные страницы. В итоге сбор «одного списка товаров» обходится в 55 кредитов, когда нужны ещё и подробные карточки. Премиальные сайты могут стоить дороже: смотрите расход, показанный для задачи. Тарифы Browse AI и примеры расчёта кредитов.
Действующие годовые предложения: Free — $0, Personal — $19/месяц с 12,000 кредитов/год, Professional — $69/месяц с 60,000 кредитов/год, Premium — от $500/месяц при годовой оплате. Personal включает 5 доменов и 3 пользователей; Professional — 10 доменов и 10 пользователей. Годовой баланс кредитов начисляется сразу. Premium добавляет услугу настройки, поддержки и преобразования данных.
При помесячной оплате на странице указаны Personal за $48/месяц с 2,000 кредитов в месяц и Professional за $87/месяц с 5,000. Поэтому годовой Personal за $19 — не тот же объём с другой датой оплаты. Сравнивайте реальные лимиты вместе со сроком подписки. Годовой Professional требует $828 сразу; годовой Personal — $228.
Лимит доменов может закончиться раньше кредитов. Процесс, проверяющий несколько полей на множестве сайтов поставщиков, может потребовать дополнительных доменов даже при небольшом объёме данных. Для годовой подписки дополнительный домен стоит $4/месяц на Personal и $2.40/месяц на Professional. На годовых тарифах можно докупать кредиты, минимум 1,000: для Personal указано $0.024/кредит, для Professional — $0.017-$0.013/кредит.
В процессе отслеживания цен поставщиков храните рядом с суммой идентификатор товара и валюту. Робот, извлекающий число, не может решить, должна ли акционная цена, цена для участников или стоимость другой упаковки заменить запись в закупочной системе. Этот смысл задают ваши правила сравнения и очередь проверки.
- Записанный сценарий позволяет специалисту проверить инструкции по извлечению.
- Мониторинг, доступ к API и вебхуки заявлены на всех тарифах.
- Интеграции с Google Sheets, Airtable, Zapier и Make поддерживают распространённые рабочие процессы.
- Дополнительные домены и пополнение годового баланса расширяют возможности тарифа.
- Большое число строк и посещение карточек суммируют расходы.
- Лимит доменов может потребовать доплаты ещё до исчерпания кредитов.
- У самого дешёвого годового предложения другой лимит, чем у помесячного Personal.
- Изменения сайта и неоднозначные поля по-прежнему требуют ответственного за проверку результата.
Выбирайте Browse AI, когда ответственный за набор данных должен сам уметь менять робота. API удобнее, если извлечение — функция вашего продукта, а разработчики уже отвечают за расписание, схему и обработку сбоев.
3. Bright Data: сначала выберите продукт, затем сравнивайте цены
Bright Data — поставщик веб-данных, который предлагает прокси-сети, готовые Scraper API и Web Unlocker. Его стоит рассмотреть, когда ограничением становится доступ к целевым сайтам или объём сбора. Разработчик сервиса электронной торговли может купить парсер конкретного сайта, возвращающий товарные записи, а существующему собственному парсеру могут понадобиться резидентные прокси. Эти покупки решают разные части задачи и оплачиваются в разных единицах.
Кому подходит: Для сбора, в котором важны доступ к целевому сайту, география или поддерживаемый парсер конкретного сайта.
Главное преимущество: Отдельные продукты для прокси, обхода блокировок и получения структурированных записей.
Цена: Web Scraper API PAYG $1.5 за 1K записей; резидентные прокси PAYG $8/GB до временной скидки по купону.
Бесплатный доступ: Scraper API даёт 5K записей/месяц бесплатно; пробный доступ к резидентным прокси предоставляется отдельно.
Выбирайте Scraper API, если нужен результат в виде записи. API для конкретных сайтов возвращают структурированные данные; в цену заявлены прокси, обход блокировок, разбор, выполнение, хранение и исходящий трафик. Тарифы: Free Tier с 5K записей/месяц, PAYG по $1.5 за 1K записей, Scale за $499/месяц с 384,000 записей и дополнительными записями по $1.3 за 1K, затем Enterprise с индивидуальными условиями. Проверьте схему входных и выходных данных выбранного парсера: не стоит заранее считать, что в ней есть все нужные поля. Тарифы Web Scraper API.
Выбирайте Web Unlocker, если вашему коду нужна помощь с доступом. На странице перечислены автоматическое управление прокси, повторные попытки, ротация IP и решение CAPTCHA. Free Tier включает 5K запросов/месяц; PAYG стоит $1.5 за 1K запросов; опубликованное предложение Scale — $499/месяц за 383K запросов с дополнительными по $1.3 за 1K. Для Enterprise условия индивидуальные. Bright Data отдельно указывает, что Web Unlocker не является интерактивным браузером для навигации и выполнения последовательности кликов. Тарифы и ограничения Web Unlocker.
Выбирайте резидентные прокси, если хотите сохранить сам парсер. В подробной карточке PAYG указано $8/GB; цена снижена до $4/GB по трёхмесячной акции RESIGB50. Опубликованные акционные месячные пакеты: $499 за 141 GB, $999 за 332 GB и $1,999 за 798 GB. Для объёмов выше 1 TB страница предлагает индивидуальный расчёт. В трафик входит всё, что отправляется целевому сайту и получается от него, а не только итоговые записи, сохранённые в вашей базе. Тарифы резидентных прокси.
Именно это различие определяет бюджет. Запрос, загружающий изображения и другие ресурсы страницы, расходует трафик, даже если полезных записей не становится больше. В API готовых записей расходы на доступ входят в заявленную цену записи. При покупке прокси запросы, разбор и проверка качества остаются вашей задачей. Цена за GB не покажет стоимость принятого объявления, пока вы не измерите реальный процесс.
Главный риск — купить не тот компонент. Улучшенный доступ через IP не исправит парсер, который выбирает неверное поле. Поддерживаемый сервис готовых записей, в свою очередь, не обязательно сохранит точное поведение вашего нестандартного извлечения. Определите требования к данным, прежде чем сравнивать две цены только потому, что у них один поставщик.
- Scraper API для конкретных сайтов могут сократить работу над собственным извлечением.
- Продукты с оплатой за записи, запросы и трафик позволяют разработчикам покупать нужный компонент.
- В цену Scraper API включены расходы на доступ и разбор, перечисленные на его странице.
- Возобновляемые бесплатные лимиты API позволяют проверить поддерживаемые сайты.
- Широкий ассортимент требует точно определить, какой продукт нужен.
- Резидентные прокси оплачиваются по GB и не гарантируют корректные записи.
- Акционная цена прокси действует временно.
- Web Unlocker не заменяет интерактивную работу в браузере.
Bright Data стоит выбирать, если не хватает инфраструктуры доступа или подходящего поддерживаемого парсера. Для небольшого мониторинга под управлением специалиста проще начать с Browse AI, а для загрузки документации — с API, возвращающих содержимое страниц.
4. Context.dev: данные для агента и мониторинг через один API
Context.dev — API веб-контекста. На его сайте перечислены сбор страниц, поиск URL, обход сайтов, пакетная обработка, ответы с источниками и мониторинг. Подходит разработчику, который хочет получать в приложение страницы для агента и обновления по расписанию. Ассистент на основе документации может сначала загрузить источники, а затем получать обновления мониторинга через вебхук — HTTP-сообщение, отправляемое приложению при наступлении события. Для этой задачи Context.dev стоит рассматривать вместе с Firecrawl; обогащение данных о брендах — дополнительное направление продукта, а не причина выбирать его для парсинга.
Кому подходит: Агенту или продукту, который сочетает извлечение страниц с мониторингом источников через вебхуки.
Главное преимущество: Scrape, Map, Crawl, Batches и Monitors в одном API.
Цена: Developer $19/месяц с 7,500 кредитов в месяц.
Бесплатный доступ: Free Tier с 1,000 кредитов/месяц, без банковской карты, с 10 мониторами.
Сайт заявляет Markdown, HTML, снимки экрана и структурированные поля; рендеринг и прокси включены в базовый сбор страницы. Мониторы проверяют страницы по расписанию и отправляют обновления на вебхук. Это интеграция для разработчика: приложение всё равно должно принять обновление, проверить его и решить, что менять дальше. Ответственность здесь устроена иначе, чем в случае записанного робота, который специалист использует для таблицы. Описание продукта Context.dev.
Помесячные тарифы: Free Tier — $0 за 1,000 кредитов, Developer — $19 за 7,500, Pro — $99 за 125,000, Growth — $299 за 500,000, Scale — $499 за 1,000,000. Для Enterprise цена индивидуальная, заявлено 2,000,000+ кредитов/месяц. Основные лимиты одновременных запросов растут от 1 на Free до 10 на Developer, 100 на Pro, 250 на Growth и 500 на Scale. Тарифы Context.dev.
Стандартный сбор страницы расходует 1 кредит. Успешное извлечение JSON добавляет 4, то есть получается 5 кредитов за стандартную страницу; действия в браузере повышают базовый расход до 2 ещё до извлечения. Поэтому включённые в базовую цену рендеринг и прокси не делают любой запрос однокредитным. Баланса Developer в 7,500 кредитов хватит на 1,500 стандартных страниц с JSON, если использовать его только для этой операции.
Для новых подписок платное пополнение стоит $2.20 за 1,000 кредитов на Developer, $1.80 на Pro, $1.40 на Growth и $1.00 на Scale; оплата идёт блоками по 1,000 кредитов. Действующие подписки сохраняют свои ставки. Поэтому можно сравнить небольшой тариф с пополнением и более крупный тариф, а не переходить на следующий только из-за исчерпания включённого баланса.
Ограничение обхода — 500 страниц за один вызов Crawl. Для более крупных сайтов используются Batches в режиме обхода. Разбейте загрузку с учётом этого лимита и убедитесь, что результаты попали в ваше хранилище, прежде чем считать пакет завершённым. Метод сбора и надёжная база знаний — разные части архитектуры.
Ещё одно ограничение — частично успешный результат. По информации Context.dev, большинство неудачных запросов не оплачивается, но ответы «не найдено» оплачиваются. Кроме того, в одном ответе могут соседствовать успешные и неудачные результаты. Проверяйте полученные данные и key_metadata.credits_consumed: общий успешный статус ответа не означает, что запись полная.
- Содержимое страниц и мониторинг через вебхуки по расписанию подходят для одного процесса подготовки данных агенту.
- Рендеринг и прокси входят в базовую стоимость сбора страницы.
- Возобновляемый бесплатный тариф включает небольшой лимит мониторов.
- Опубликованные цены блоков пополнения позволяют точно рассчитать небольшую нагрузку.
- Извлечение JSON и действия в браузере увеличивают расход кредитов.
- У одного вызова Crawl есть лимит; для более крупных источников нужны Batches.
- Доставка через вебхук всё равно требует логики приложения и хранилища.
- Частичные результаты и оплачиваемые страницы «не найдено» требуют проверки пригодности данных.
Выбирайте Context.dev, если сочетание возможностей API и расход кредитов подходит вашему агенту. Сравнивайте его с Firecrawl на одинаковых характерных источниках и одной схеме результата: больший начальный лимит сам по себе не доказывает более высокое качество.
5. Apify: особенно полезен, когда нужный Actor уже есть
Apify — облачная платформа для многократно используемых программ сбора и автоматизации, которые называются Actors. Это сильный вариант, если для целевого сайта уже есть подходящий поддерживаемый Actor: готовая логика извлечения может оказаться ценнее универсального API получения страниц. Специалист, обновляющий каталог компаний, может настроить входные параметры Actor, сохранить задачу и назначить повторные запуски. Ограничение определяется поведением и оплатой выбранного Actor, а не только подпиской на платформу.
Кому подходит: Для конкретного сайта или задачи извлечения, для которых уже есть подходящий Actor.
Главное преимущество: Повторно используемые облачные программы с расписанием задач и интеграциями.
Цена: Starter $19/месяц + оплата по мере использования; включено $19 на использование.
Бесплатный доступ: Тариф Free с $5/месяц на использование, банковская карта не нужна.
Тариф Apify Free стоит $0 и даёт $5 на Store или ресурсы платформы. Starter — $19/месяц + оплата по мере использования, с включёнными $19; Scale — $199 с включёнными $199; Business — $999 с включёнными $999. Для Enterprise цена индивидуальная. Вычисления стоят $0.2 за вычислительную единицу на Free и Starter, $0.16 на Scale и $0.13 на Business. Вычислительная единица — один GB оперативной памяти, используемый в течение одного часа. Тарифы Apify.
Не считайте включённый долларовый баланс фиксированным лимитом страниц. У выбранного Actor может быть собственная цена; ресурсы платформы, прокси, хранение и передача данных также влияют на счёт в зависимости от задачи. Сравнивать нужно стоимость полного запуска, который возвращает пригодные записи, а не привлекательную начальную цену программы в каталоге.
В явно условном примере, где учитываются только вычисления, один GB оперативной памяти в течение десяти часов расходует десять вычислительных единиц. На Starter это $2 за вычисления. Из этого ничего нельзя вывести о числе полученных объявлений или дополнительных платежах. Даже утверждение, что за $19 можно получить 95 вычислительных единиц, предполагает, что весь баланс уйдёт на вычисления; реальная задача парсинга может этому условию не соответствовать.
Планировщик Apify позволяет запускать сохранённые задачи с выбранным часовым поясом и доставлять уведомления через вебхуки. Согласно документации, новые расписания по умолчанию отключены: сохранённое расписание ещё не доказывает, что следующий запуск состоится. Проверьте, включено ли оно, и посмотрите указанное время следующего запуска. Документация планировщика Apify.
В примере с каталогом до покупки проверьте пагинацию, охват регионов, идентификаторы результата и историю поддержки Actor. Actor, который собирает список категории, не обязательно дополняет каждую компанию всеми полями, нужными вашей CRM. Сохраняйте примеры принятых и отклонённых записей, а пропущенные поля делайте заметными.
- Подходящий Actor может предоставить готовую логику извлечения для конкретного сайта.
- Сохранённые задачи и расписания позволяют организовать регулярный сбор.
- В каталоге есть и сценарии обхода сайтов со сбором содержимого страниц.
- Включённого баланса может хватить, чтобы проверить полный запуск небольшой задачи.
- Единой цены Apify за страницу или запись нет.
- Оплата конкретного Actor может влиять на расходы сильнее тарифа платформы.
- Входные параметры и результат задачи всё равно нужно проверять на соответствие вашему набору данных.
- Новое расписание необходимо включить, прежде чем на него полагаться.
Выбирайте Apify, если Actor заметно сокращает работу над извлечением и стоимость полного запуска приемлема. Прямой API для парсинга удобнее, когда задача сводится к получению известных страниц, а каталог добавляет сложность без экономии труда.
6. ScrapingBee: получение страниц с понятными множителями стоимости
ScrapingBee — API для парсинга, который управляет рендерингом и настройками прокси в процессе извлечения под контролем разработчика. Подходит инженеру, который хочет сохранить код разбора и расписания, передав сервису сложности получения страниц. Например, сервис товарных данных может запросить отрисованную страницу и применить к ответу свои правила выбора полей. Первое, что нужно заложить в бюджет, — расход кредитов при настройках, которые действительно работают на целевом сайте.
Кому подходит: Разработчику, который сохраняет собственную логику извлечения и заменяет компонент получения страниц.
Главное преимущество: Управление рендерингом и прокси, а также Auto-Mode с максимальной стоимостью в кредитах.
Цена: Freelance $49/месяц с 250,000 кредитов API.
Бесплатный доступ: 1,000 кредитов API без банковской карты; возобновляемый бесплатный тариф не заявлен.
Полная опубликованная линейка: Freelance — $49/месяц за 250,000 кредитов, Startup — $99 за 1,000,000, Business — $249 за 3,000,000, Business + — $599 за 8,000,000. Enterprise 14 стоит $999 за 14,000,000; Enterprise 24 — $1,599 за 24,000,000; Enterprise 41 — $2,399 за 41,000,000; Enterprise 69 — $3,599 за 69,000,000. Более высокие объёмы обсуждаются с поставщиком. Цены не включают НДС. Тарифы ScrapingBee.
Это кредиты, а не запросы. По документации получение страницы стоит 1 кредит с обычным прокси без JavaScript, 5 — с JavaScript, 10 — с премиальным прокси без JavaScript, 25 — с премиальным прокси и JavaScript, 75 — с прокси stealth и JavaScript. Извлечение с помощью ИИ добавляет ещё 5 кредитов. Рендеринг JavaScript включён по умолчанию. Стоимость запросов ScrapingBee.
Таким образом, лимит Freelance в 250,000 кредитов позволяет выполнить максимум 50,000 запросов с обычным прокси и JavaScript, 10,000 — с премиальным прокси и JavaScript или 3,333 полных запроса с прокси stealth и JavaScript, если весь баланс расходуется на одну конфигурацию. Это расчёт лимита, а не измеренная доля успешных запросов. Дополнительные функции и сочетание разных целевых сайтов меняют результат.
Auto-Mode может пробовать разные конфигурации и списывать кредиты за ту, которая сработала; если не сработала ни одна, плата равна нулю. Параметр max_cost ограничивает набор конфигураций, которые разрешено попробовать. Но, согласно документации, режим не подбирает автоматически инструкции ожидания или кликов для конкретной страницы. Если нужная цена появляется только после выбора опции или асинхронной загрузки, соответствующее поведение придётся задать вам. Документация Auto-Mode.
Ключевое ограничение: настройка получения страницы не определяет, какие данные вам нужны. В корректном HTML-ответе может оказаться пустой шаблон, цена для региона по умолчанию или вариант, который ваш клиент не выбрал бы. Сохраняйте исходный ответ и проверяйте значимое для бизнеса поле, а не останавливайтесь на успешном вызове API.
- Подходит собственному парсеру, в котором разбор и расписание должны остаться в вашем коде.
- Расход кредитов для настроек рендеринга и прокси опубликован.
- Auto-Mode позволяет ограничить стоимость конфигурации доступа.
- Параллельность и объём растут по явно заданной линейке тарифов.
- Один и тот же заявленный баланс кредитов даёт очень разное число запросов.
- Извлечение с помощью ИИ оплачивается дополнительными кредитами.
- Auto-Mode не задаёт ожидания и клики для конкретного сайта.
- Бесплатное предложение — пробный доступ, а не постоянный лимит для задач по расписанию.
Выбирайте ScrapingBee, если вам важен контроль запроса и вы уже умеете проверять ответ. API готовых записей или подходящий Actor в Apify удобнее, если вы хотите перестать поддерживать правила извлечения целевого сайта.
7. Octoparse: визуальные задачи с облачным расписанием на платном тарифе
Octoparse — приложение для визуального парсинга, подходящее специалисту, который готов проектировать и поддерживать задачи извлечения. Его стоит рассмотреть для регулярного сбора каталогов или объявлений, если нужен конструктор задач, а не интеграция с API. Аналитик по закупкам может задать поля списка и карточек, а затем перенести проверенный процесс в платное облако. Тариф Free полезен для локальной проверки, но на его основе нельзя рассчитывать на автономный поток данных.
Кому подходит: Специалисту, который создаёт визуальные задачи извлечения и при необходимости покупает облачный запуск.
Главное преимущество: Парсинг на основе задач с платным облачным расписанием и автоматическим экспортом.
Цена: Standard от $69/месяц при годовой оплате.
Бесплатный доступ: Free Plan с 10 локальными задачами и экспортом 50,000 строк/месяц.
Free включает 10 задач, выполнение на локальном устройстве, до 10,000 строк за один экспорт и 50,000 экспортируемых строк в месяц. Standard добавляет облачный сбор, расписание задач, автоматический экспорт и Data Export API; лимиты — 100 задач и до 3 одновременных облачных процессов. Professional допускает 250 задач и до 20 одновременных облачных процессов, а также включает Advanced API и дополнительную поддержку. Для Enterprise заявлены 750+ задач и 40+ одновременных облачных процессов. Условия тарифов Octoparse.
Опубликованная линейка: Free — $0, Standard — от $69/месяц, Professional — $249/месяц, Enterprise — индивидуальная цена. Оба платных предложения оплачиваются за год. Учитывайте эти месячные эквиваленты как годовые предложения и уточняйте сумму счёта при оформлении, прежде чем планировать денежные расходы. Тарифы Octoparse.
Единица оплаты здесь — подписка с лимитами задач и процессов, а не стандартный кредит за запрос. Это может подойти процессу с большим объёмом извлечения в рамках управляемого числа задач. Но «неограниченный экспорт данных» на платных тарифах не означает неограниченную параллельную работу в облаке. Три одновременных облачных процесса на Standard могут стать ограничением задолго до достижения 100 сохранённых задач.
Дополнения оплачиваются отдельно. На странице тарифов указаны резидентные прокси по $3/GB, решение CAPTCHA по $1-1.5 за тысячу и шаблоны с оплатой за результат по $0.001-3 за тысячу результатов. Платная подписка не включает бесплатно все дополнительные расходы на доступ.
Для каталога поставщика начните с небольшой локальной задачи и проверьте охват списка и карточек. Затем убедитесь, как облачный запуск обрабатывает те же входные данные, куда попадает экспорт и кто видит сбой. Аналитику, умеющему собрать задачу, всё равно нужен регулярный процесс проверки полноты полученных записей.
- Визуальная настройка подходит специалисту, который хочет сам управлять инструкциями извлечения.
- Бесплатные локальные задачи позволяют проверить процесс до покупки облака.
- В Standard явно включены расписание и автоматический экспорт.
- Лимиты задач и облачных процессов показывают границы выполнения.
- Бесплатные задачи выполняются локально и не обеспечивают нужный автономный облачный запуск.
- Объём платного экспорта не снимает лимиты задач и параллельности.
- Прокси, CAPTCHA и шаблоны могут добавить оплату по использованию.
- Начальная цена требует годовой оплаты.
Выбирайте Octoparse, если визуальное проектирование задач даёт ощутимую пользу, а лимиты облачных процессов подходят расписанию. Для записанного мониторинга проще начать с Browse AI; если извлечение должно работать внутри программного продукта, удобнее API.
8. Zyte: стоимость доступа зависит от целевого сайта
Zyte — поставщик веб-данных. Его Zyte API оценивает успешные ответы по сложности сайта и по тому, запрашиваете ли вы HTTP-содержимое или браузерный рендеринг. Подходит разработчику системы сбора, которому нужно автоматическое обеспечение доступа без покупки отдельного набора прокси. Сервис объявлений может сохранить собственный набор данных и логику разбора, рассчитывая бюджет по режиму ответа, необходимому для каждого сайта. Минимальная цена полезна только вместе с условиями обязательных расходов и уровнем сложности, к которым она относится.
Кому подходит: Системе сбора под управлением разработчика с бюджетом доступа для конкретных сайтов.
Главное преимущество: Оплата успешных ответов с отдельными ставками для HTTP и браузера.
Цена: PAYG HTTP $0.13-$1.27 за 1,000; браузер $1.01-$16.08 за 1,000.
Бесплатный доступ: $5 кредита на 30 дней без обязательств; возобновляемый бесплатный тариф не заявлен.
Для сайтов уровней Simple, Easy, Moderate, Complex и Advanced цены PAYG HTTP составляют соответственно $0.13, $0.23, $0.44, $0.70 и $1.27 за 1,000 ответов. Цены PAYG для браузера — $1.01, $2.01, $4.02, $8.04 и $16.08. Поэтому одинаковое число запросов может давать очень разный счёт в зависимости от сайта и необходимости отрисованного содержимого. Тарифы Zyte.
Обязательный месячный объём расходов снижает ставки. При обязательстве на $100 указаны HTTP по $0.10-$0.95 и браузер по $0.75-$12.00 за 1,000. При $200 диапазоны — $0.08-$0.76 и $0.60-$9.60. При $500 — $0.06-$0.61 и $0.48-$7.68. Условия Enterprise обсуждаются с отделом продаж. Заголовок страницы «от $0.06» относится к тарифам с обязательным объёмом расходов; это не начальная цена PAYG HTTP.
В условном примере со 100,000 успешных ответов ставка Simple PAYG HTTP даёт $13 за использование. Ставка Simple для браузера — $101, Advanced для браузера — $1,608. Это расчёты по опубликованным ценам, а не утверждение, что ваш сайт попадёт в определённый уровень. Дополнительные функции могут повышать стоимость: используйте калькулятор поставщика для конкретного сайта и нужного режима результата.
Ключевое ограничение — экономика конкретного сайта. Нельзя закладывать одинаковую стоимость страницы для простого HTTP-источника и сложного сайта с рендерингом. Разделите список URL по сайтам и режимам, сохраняйте число принятых ответов и сравнивайте тарифы с обязательными расходами на основе этой структуры.
Успешный доступ оставляет требования к извлечению на вашей стороне. Парсеру всё ещё нужны правильный идентификатор объявления, поля и проверки полноты. Если поддерживаемый API записей или Actor уже возвращает нужный набор данных, более низкая цена доступа сама по себе может не оправдать сохранение собственной логики извлечения.
- Раздельные цены HTTP и браузера помогают точно рассчитывать бюджет по сайтам.
- Пять уровней сложности показывают разброс, который может скрываться за единой начальной ценой.
- Месячные обязательства дают видимую шкалу снижения ставок.
- API заявляет рендеринг, ротацию IP и геолокацию.
- Минимальная цена в заголовке требует месячного обязательства.
- Браузерный рендеринг может существенно менять экономику.
- Дополнительные функции могут оплачиваться отдельно.
- Ответ всё равно требует разбора и проверки по бизнес-правилам.
Выбирайте Zyte, если процесс разработки требует управляемого доступа и вы можете измерить состав целевых сайтов. Начните с расчёта PAYG, а не покупайте подписку только ради самого маленького числа на странице.
Сколько стоит парсинг сайтов по расписанию
Сначала посчитайте повторяющиеся операции и формат результата, затем сравнивайте начальные цены. Возьмём явный пример для планирования: основатель ежедневно проверяет 120 известных страниц в течение 30-дневного месяца — всего 3,600 посещений. Предположим, что страницы обычные, дополнительных действий в браузере нет, поиск URL не вызывается, отдельный метод мониторинга не оплачивается и оплачиваемых повторных попыток нет. Это расчёт бюджета, а не измеренная нагрузка или обещание доступа к сайтам.
При базовом сборе в Markdown эти 3,600 посещений расходуют 3,600 кредитов и на Firecrawl, и на Context.dev. Firecrawl Hobby включает 5,000 кредитов за $19/месяц, Context.dev Developer — 7,500 за $19/месяц. Обе начальные помесячные подписки покрывают заданный объём такого сбора. Firecrawl, Context.dev.
Если для тех же стандартных страниц запрашивать успешное структурированное извлечение JSON, каждому сервису потребуется 18,000 кредитов. Для Firecrawl Hobby нужно докупить 13 блоков по 1,000 кредитов за $5: $19 + $65 = $84/месяц. Для Context.dev Developer по опубликованной ставке для новых подписок нужны 11 блоков по 1,000 за $2.20: $19 + $24.20 = $43.20/месяц. Округление до целых блоков оставляет в расчёте Context.dev немного неиспользованных кредитов.
Для мониторинга без кода нужна та же арифметика частоты. В Browse AI 3,600 стандартных проверок страниц/месяц превращаются в 43,200/год ещё до увеличения числа строк или премиальных сайтов. Годовые 60,000 кредитов Professional покрывают этот условный объём, а 12,000 Personal — нет. Помесячный Professional даёт 5,000 кредитов за $87; годовой Professional стоит $69/месяц с оплатой $828 сразу. Browse AI.
Для прокси нужен другой расчёт. Начните с измеренного объёма в GB, затем добавьте хостинг парсера, работу над извлечением и обработку исключений. Для API записей отправная точка — оплачиваемые доставленные записи. Для Apify — выбранный Actor и использование ресурсов. Не превращайте эти единицы в обещание цены за страницу, пока не измерите реальную задачу.
Какой сервис выбрать под свою задачу
Главный критерий — что именно вам нужно: содержимое страниц, мониторинг под управлением специалиста, готовые записи с конкретного сайта или доступ для кода, который вы уже поддерживаете. Переход на платный или более дорогой тариф должен устранять ваше реальное ограничение, а не вознаграждать поставщика за длинный список функций.
Выбор парсера зависит от того, кто исправит следующий сбой
Если за функцию работы с данными отвечает разработка, рассматривайте API, возвращающий нужное содержимое и метаданные. Если таблицами и процессом управляет операционная команда, выбирайте визуального робота, которого специалист сможет проверить. Если ответственного за сбои ещё нет, назначьте его до увеличения частоты сбора.
Выбор инструмента меняется вместе с ответственностью. Для разработчика API парсинга может быть подходящим компонентом продукта. Для специалиста, которому нужен ежедневный результат и у которого нет приложения для его получения, тот же API может оказаться неудачной покупкой. И наоборот: записанную задачу можно быстро проверить, но она способна усложнить работу, когда извлечение становится основной функцией продукта.
Парсингу с помощью ИИ нужны схема данных и правила проверки
Рассматривайте извлечение как договорённость о составе и качестве данных. Для записи о цене задайте идентификатор товара, вариант, числовую сумму, валюту, URL источника и время сбора. Решите, как обрабатывать отсутствующие и неоднозначные значения, до первого автоматического обновления. Корректный объект JSON — это формат; корректная бизнес-запись — результат проверки по заданным требованиям.
При загрузке документов сохраняйте источник и время получения, а ненужную повторяющуюся навигацию исключайте там, где это уместно. Если автоматическая проверка отклоняет страницу, оставляйте исходный ответ. Эти данные помогут ответственному отличить изменение сайта от ошибочного определения поля.
Какой парсер с ИИ выбрать для агента
Начните с Firecrawl для процесса scrape/crawl/map, ориентированного на страницы. Добавьте Context.dev к сравнению, если приложению подходит сочетание пакетной обработки и мониторинга через вебхуки. Если подходящий Actor в Apify уже собирает необходимые поля целевого сайта, проверьте такой полный запуск вместе с универсальными API страниц.
Сравнивайте на фиксированном наборе источников с одинаковым ожидаемым результатом. Включите обычную страницу, страницу с рендерингом, связку списка и карточек, а также страницу с неоднозначным полем. Начальный лимит влияет на стоимость, но не доказывает, что один сервис даёт данные лучше другого.
Парсинг сайтов на Python: что подключить к расписанию
Приложение на Python может обращаться к API, сохраняя у себя расписание, разбор, хранение и проверку. Выбирайте Firecrawl или Context.dev, если нужно содержимое страниц либо структурированное извлечение силами сервиса. Выбирайте ScrapingBee или Zyte, если хотите оставить разбор под своим контролем, а заменить только получение страниц.
Дополнительный контроль требует сопровождения. Различайте транспортную ошибку, страницу ошибки целевого сайта, отсутствие поля и запись, отклонённую по бизнес-правилам. Не повторяйте все запросы вслепую: неверное правило извлечения не станет лучше от повторного запуска.
Как выбрать бесплатный парсер с возобновляемым лимитом
Firecrawl и Context.dev заявляют по 1,000 кредитов в месяц. Browse AI даёт 50 кредитов в месяц для 2 доменов. Apify предоставляет $5/месяц на использование, Bright Data Scraper API — 5K записей/месяц. Эти лимиты могут подойти для небольших проверок или умеренных регулярных задач, если нужная операция в них укладывается.
Если проверять одну стандартную страницу ежедневно в течение 30-дневного месяца, лимит Browse AI в 50 кредитов покрывает 30 проверок. Это полезный пример бесплатного мониторинга при условии, что сайт не премиальный, а число извлечённых строк не повышает расход. У ScrapingBee 1,000 кредитов и у Zyte $5 — пробный доступ; Octoparse Free работает локально. Эти различия важнее пометки «бесплатно».
Парсеры с открытым кодом, которые команда может поддерживать сама
Ядро Firecrawl, которое можно развернуть самостоятельно, подходит, когда контроль над исходным кодом или инфраструктурой оправдывает обслуживание сервисов. Открытый код позволяет обойтись без подписки поставщика на это ядро, но не предоставляет хостинг, мониторинг, восстановление или инженера, который исправит следующий сбой.
Прежде чем считать это самым дешёвым способом парсинга, оцените объём сопровождения по руководству по самостоятельному развёртыванию Firecrawl. Небольшой продуктовой команде, которой нужен лишь API для получения известных страниц, начальные облачные тарифы могут помочь избежать отдельного инфраструктурного проекта. Выбирайте собственное развёртывание под конкретное требование к контролю и с ответственным, который сможет его поддерживать.
Как составлено сравнение
В основе сравнения — соответствие задаче, прозрачность оплаты и ограничение, которое меняет решение о покупке. При его подготовке были изучены страницы тарифов и соответствующая документация разработчиков; значения проверены 6 октября 2026 года. Примеры стоимости — расчёты по опубликованным ставкам с явно заданной нагрузкой. Практического тестирования продуктов не проводилось; рейтинг по скорости, точности или доле успешных запросов не заявляется.
Firecrawl, Bright Data, Browse AI и Context.dev — партнёрские инструменты этого сайта; Apify, ScrapingBee, Octoparse и Zyte представлены как независимые альтернативы. Партнёрский статус не делает прокси подходящей покупкой для мониторинга под управлением специалиста, а записанного робота — подходящим API для программной функции. Рекомендации исходят из этих различий.
Практические критерии: возвращает ли продукт нужный результат; кто отвечает за настройку и исправления; какая повторяющаяся операция оплачивается; какой лимит объёма или параллельности заканчивается первым; что происходит с неполным или отклонённым ответом? Большой каталог или низкая рекламная цена сами по себе на эти вопросы не отвечают.
Каталоги фреймворков и браузерных библиотек не вошли в основной список: здесь выбирают регулярный сервис, процесс без кода или инфраструктуру доступа. Интерактивная работа в браузере — отдельная задача, если процесс требует существенной навигации, а не только получения страниц.
Перед настройкой сбора по расписанию проверьте условия целевого сайта и robots.txt.
В каких случаях лучше выбрать другой вариант
Избегайте несоответствия задаче, даже если продукт хорош в другом сценарии. Следующие решения чаще всего создают ту работу, от которой покупка должна была избавить.
- Octoparse Free для автономного облачного потока. Его задачи выполняются локально. Оплатите облачный запуск, который нужен вашему процессу, или выберите сервис с подходящей моделью работы.
- Резидентные прокси Bright Data для покупки готового набора данных. Они предоставляют доступ, но запросы, разбор и приёмка остаются на вас. Если хотите покупать записи, используйте подходящий Scraper API.
- Годовая рекламная цена Browse AI Personal для частого масштабного мониторинга. Годового лимита в 12,000 кредитов недостаточно для условной задачи на 43,200 кредитов в год. Сначала посчитайте посещения, строки, премиальные сайты и домены.
- Цена Zyte $0.06 в заголовке как ставка PAYG. Это нижняя граница тарифа с обязательными расходами $500. Перед покупкой такого обязательства оцените реальные сайты и режимы.
- Баланс кредитов ScrapingBee как гарантия числа запросов. Рендеринг и настройки прокси могут тратить несколько кредитов на один запрос. Рассчитывайте бюджет для конфигурации, которая работает.
- Firecrawl или Context.dev как полноценная система качества данных. Оба сервиса могут вернуть содержимое, которое придётся отклонить. Сохраняйте статус и исходный результат, защищайте дальнейшие записи от неполных обновлений.
Избегать стоит продукта, после покупки которого вы всё ещё поддерживаете компонент, ожидавшийся от сервиса. Чёткое распределение задач полезнее уверенного общего рейтинга.
Что сделать в понедельник
Проведите небольшую проверку по расписанию с одним ответственным. Выберите десять характерных URL, определите ожидаемые поля или содержимое документов и обозначьте, какой ответ считать непригодным. Для задачи без кода запишите сценарий; для API подключите планировщик и хранилище.
Запускайте сбор раз в день в течение семи дней. Сохраняйте исходный ответ, статус целевого сайта, результат, расход единиц оплаты и число принятых записей. Проверяйте пагинацию, отсутствующие значения, дубли идентификаторов и изменения, которые должны либо не должны вызывать обновление.
Затем рассчитайте полный месяц по наблюдавшемуся составу сайтов. Выберите самый простой вариант, который отвечает требованиям к результату и распределению ответственности, и оставьте проверки качества после завершения пробного периода. Поток данных готов к рабочему использованию, когда стабильно даёт полезный результат, а не после первого успешного запроса.
Какие инструменты подходят для парсинга сайтов?
Firecrawl и Context.dev подходят для получения содержимого страниц агентам; Browse AI и Octoparse — для визуальных процессов извлечения; Bright Data, Zyte и ScrapingBee — для разных задач доступа и получения страниц. Apify особенно полезен, если уже есть нужный Actor для конкретного сайта. Сначала определите результат и ответственного, затем сравнивайте полные месячные расходы.
Может ли ChatGPT собирать данные с сайтов?
ChatGPT может открывать сайты и собирать информацию с помощью браузерной функции, описанной в официальной документации OpenAI. Это может подойти для интерактивной задачи сбора. Для регулярного получения цен, объявлений или документов агенту отдельно оцените расписание, схему результата, сохранение данных и ответственного за сбои. Здесь важно выбрать сервис, обеспечивающий такой регулярный процесс, а не выяснить, способен ли ассистент ИИ прочитать страницу.
Какой ИИ лучше подходит для парсинга сайтов?
Прежде чем выбирать языковую модель, определите сервис извлечения и ожидаемый результат. Firecrawl и Context.dev стоит рассматривать для Markdown или структурированных полей; Browse AI — для робота под управлением специалиста. Подходящий вариант возвращает нужную информацию с ваших характерных источников при приемлемой полной стоимости.
Парсинг сайтов уже устарел?
Сначала проверьте, предлагает ли целевой сайт подходящий API или поток данных. Если нужная информация опубликована только на страницах, извлечение остаётся возможным вариантом. Для покупки важнее понять, кто отвечает за получение, извлечение, расписание и проверку, чем наличие ИИ в описании продукта.
Какие парсеры сайтов входят в топ-10?
В этом списке восемь продуктов для трёх регулярных задач: данные для агента, мониторинг без кода и масштабный доступ. Выбирайте внутри этих сценариев, а не добавляйте инструменты ради числа десять. Проект браузерной автоматизации или фреймворк на собственной инфраструктуре требует другого распределения ответственности, чем сравниваемые здесь сервисы.
Получите AI Business Workflow Audit Checklist через рассылку. Прежде чем внедрять процесс работы с веб-данными, определите результат, расписание, правила приёмки и ответственного.
- Последнее обновление
- 6 окт. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

Память ИИ-агента: что сохранять и сколько это стоит
Как устроена память ИИ-агента: контекст, состояние сессии, долговременные хранилища и навыки. Разбираем расходы, устаревшие факты и утечки данных пользователей.5 окт. 2026 г.Build
Тарифы Pinecone в 2026: планы, расчёт затрат и экономия на RAG
Тарифы Pinecone: бесплатный Starter, Builder за $20 и минимальные платежи. Расчёты для 1M–100M векторов, лимиты запросов и способы снизить расходы на RAG.5 окт. 2026 г.Build
Аналоги Lovable в 2026 году: цены, бэкенд и перенос кода
Сравниваем аналоги Lovable по цене, кредитам, бэкенду и экспорту кода. Когда выбрать Replit, Emergent, Bolt, Blink, Base44 или v0, а когда остаться.5 окт. 2026 г.Build
Мониторинг LLM в 2026 году: шесть платформ и расходы команды
Сравниваем Langfuse, LangSmith, Helicone, Arize Phoenix, Braintrust и Datadog: расходы на 100,000 запусков в месяц, размер команды и условия развёртывания.5 окт. 2026 г.Build
Как пользоваться OpenCode: от установки до проверенного кода
Установите OpenCode, подключите модель и выполните первую задачу с проверкой кода. Разберитесь в AGENTS.md, плагинах, оплате API и стоимости OpenCode Zen.4 окт. 2026 г.Build
Тарифы Netlify в 2026 году: сколько стоит хостинг на практике
Разбираем тарифы Netlify Free, Personal и Pro, расход кредитов и месячный бюджет для сайта, приложения Next.js и агентства с 10 клиентскими проектами.4 окт. 2026 г.Build
Обзор Softr: какой тариф выбрать для портала и CRM
Обзор Softr для клиентских порталов и CRM: тарифы, лимиты пользователей и записей, функции ИИ и правила доступа. Узнайте, какой план подходит вашему бизнесу.4 окт. 2026 г.Build