웹 크롤링 툴 8종 비교: 용도별 추천과 과금 구조 (2026)
웹 크롤링 툴 8종의 요금과 과금 구조를 비교합니다. Firecrawl, Browse AI, Bright Data, Context.dev 등의 무료 제공량과 운영 한계를 확인하세요. AI 에이전트용 문서 수집, 노코드 모니터링, 대규모 수집 중 필요한 작업에 맞춰 선택할 수 있습니다.




웹 크롤링 툴은 필요한 결과물에 따라 골라야 합니다. AI 에이전트가 읽을 수 있도록 페이지를 정리하려면 Firecrawl을, 운영 담당자가 직접 관리할 모니터링에는 Browse AI를, 사이트 접근이 수집의 걸림돌이라면 Bright Data를 먼저 검토하면 됩니다. Firecrawl과 Context.dev는 모두 월 단위 결제 시 월 $19부터 시작하지만, 구조화된 JSON을 요청하면 크레딧 비용이 달라집니다. 업체를 고르기 전에 결과물, 실행 주기, 수집이 실패했을 때 복구할 담당자부터 정해야 합니다.
웹 크롤링 툴 비교: 용도와 요금 한눈에 보기
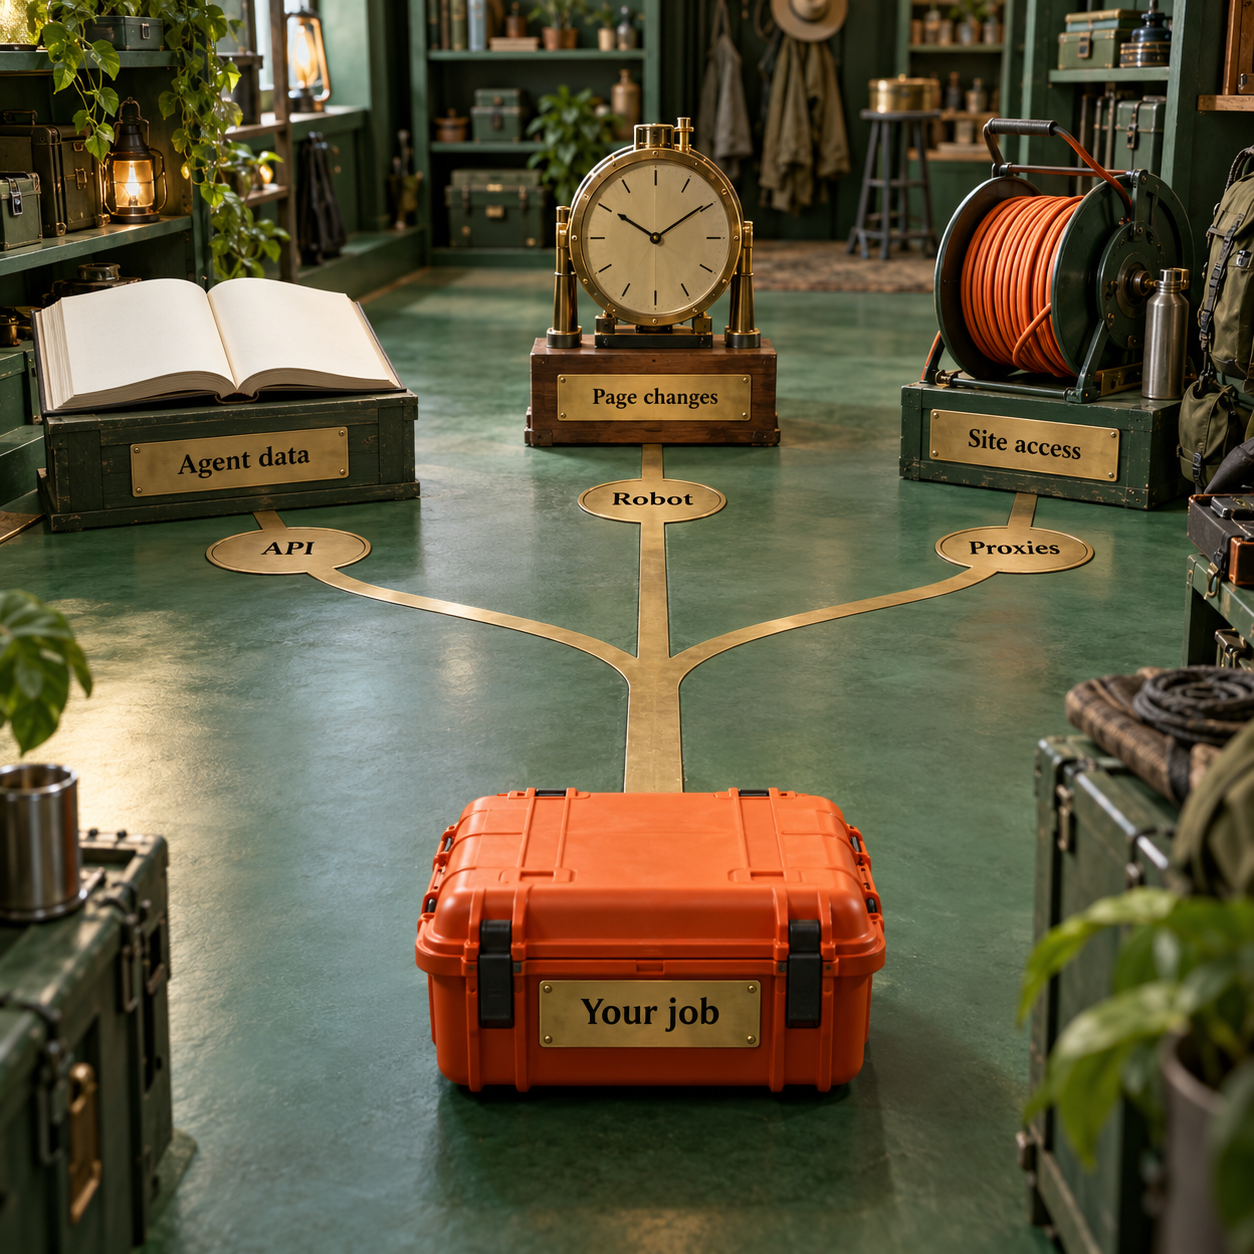
워크플로에 부족한 기능을 구매해야 합니다. 스크래핑 API는 소프트웨어가 호출해 페이지 데이터를 가져오는 서비스로, 에이전트나 데이터셋을 만드는 개발자에게 적합합니다. 반복 수집 작업이 필요한 운영 담당자에게는 노코드 로봇이 맞습니다. 다른 IP 주소를 통해 트래픽을 보내는 프록시 네트워크는 이미 운영 중인 스크래퍼의 대상 사이트 접근성을 개선할 때 필요합니다.
아래 요금과 제공량은 2026년 10월 6일 각 업체의 실제 서비스 페이지에서 확인했습니다. 연간 결제 요금은 따로 표시했으며, 일회성 무료 체험과 정기적으로 갱신되는 무료 제공량을 구분했습니다. 시작 요금 열은 가장 낮은 유료 상품을, 마지막 열은 유료 요금제 없이 시험할 수 있는 범위를 보여줍니다.
이 표는 검토할 후보를 추린 것입니다. 전달받은 레코드, 방문한 페이지, 전송량 GB를 같은 단위로 취급해서는 안 됩니다. Bright Data의 프록시 쿠폰 RESIGB50은 세 달 동안 50% 할인을 제공합니다. 이 한시적 요금은 체험 예산에 반영하고, 반복 운영 예산은 정상 요금으로 잡아야 합니다.
결과물과 운영 담당자부터 정하세요
이 글에서 다루는 구매 결정은 세 가지이며, 작업이 달라지면 적합한 툴도 달라집니다. 문서를 어시스턴트에 넣으려는 창업자, 경쟁사 가격을 살피는 운영 담당자, 대규모 목록 데이터셋을 갱신하는 개발자가 모두 같은 기준으로 제품을 비교해서는 안 됩니다.
용도 하나: 에이전트가 활용할 페이지 데이터 만들기
애플리케이션에 페이지 본문이나 구조화된 필드가 필요하다면 **Firecrawl 또는 Context.dev**부터 검토하면 됩니다. Markdown은 제목과 링크를 보존한 읽기 쉬운 텍스트이므로 AI 에이전트에 문서를 전달할 때 유용합니다. JSON은 상품, 가격, 통화, 재고 상태처럼 이름이 붙은 필드의 집합입니다. 검증하고 비교할 수 있는 레코드가 필요한 워크플로에 적합합니다.
이 차이는 품질과 비용에 모두 영향을 줍니다. 고객 지원 어시스턴트는 잘 정리된 문서 페이지로도 충분한 경우가 많습니다. 반면 가격 알림에는 가격 필드, 통화, 정확한 상품 옵션, 타임스탬프가 필요합니다. 페이지를 모델에 전달하는 것만으로 여러 가격 중 업무에 필요한 가격이 무엇인지 정해지지는 않습니다.
페이지를 가져오는 스크래핑(scrape), 사이트 링크를 따라 여러 페이지를 가져오는 크롤링(crawl), URL을 발견하는 **매핑(map)**도 구분해야 합니다. 이미 신뢰할 수 있는 URL 목록을 관리한다면 탐색을 반복해도 데이터 공급에는 도움이 되지 않고 작업만 늘어날 수 있습니다. 사이트 문서가 계속 늘어난다면 URL 탐색도 수집 작업에 포함해야 합니다.
용도 둘: 운영 담당자가 코드 없이 지정된 페이지 살펴보기
운영 담당자가 관리할 수 있는 녹화형 추출 작업과 변경 모니터링이 필요하면 **Browse AI**를 고르면 됩니다. 작업을 시각적으로 설계하고 유료 클라우드에서 추출하는 방식이 더 적합하다면 **Octoparse**를 검토하면 됩니다. 여기서 로봇은 동작 순서와 추출 지침을 저장한 작업이며, 직원의 업무 전반을 대신하는 존재는 아닙니다.
예를 들어 운영 책임자가 매일 아침 공급업체 상품 목록에서 상품명, 가격, 재고 상태를 받아야 할 수 있습니다. 필요한 결과물은 열 구조가 일정한 스프레드시트와 필드가 사라졌을 때 분명히 드러나는 예외입니다. 운영 담당자가 작업을 확인하고 사이트 변경에 맞춰 수정할 수 있어야 합니다.
실행 주기를 정하기 전에 무엇을 변경으로 볼지부터 정해야 합니다. 페이지 하단이 바뀌는 것은 재고 상태와 무관합니다. 목록의 행 순서가 바뀌었다고 모든 상품이 교체된 것으로 처리해서도 안 됩니다. 일관된 식별자를 유지하고 필요한 필드를 비교하며, 누락된 데이터는 검토 대상으로 보내야 합니다. 전날의 유효한 값을 조용히 덮어쓰는 방식은 피해야 합니다.
용도 셋: 사이트 접근 문제를 해결하며 대규모로 수집하기
소프트웨어가 이미 실행 일정과 데이터셋을 관리하지만 대상 페이지를 가져오는 일이 어려워지고 있다면 **Bright Data, Zyte, ScrapingBee**를 후보로 검토하면 됩니다. 차단 해제 서비스는 재시도와 프록시 선택 같은 접근 동작을 관리합니다. 데이터셋이 무엇을 의미해야 하는지까지 자동으로 정해 주지는 않습니다.
Bright Data는 사이트별 Scraper API도 제공하므로 네트워크 접근을 넘어 완성도 높은 레코드를 구매할 수 있습니다. Apify도 별도로 검토할 가치가 있습니다. 원하는 추출 작업을 이미 구현하고 유지보수하는 대상별 Actor가 있을 수 있기 때문입니다. Actor는 설정해서 실행할 수 있는 재사용 가능한 클라우드 프로그램입니다.
결정 기준은 누가 어떤 부분을 맡느냐입니다. 다른 업체가 유지보수하는 추출 로직이 필요하다면 Scraper API나 Actor를 평가해야 합니다. 자체 파싱 로직을 유지해야 한다면 페이지 요청 API나 프록시 서비스를 평가해야 합니다. 단순 접근 비용을 지불하면서 완성된 데이터셋까지 기대하면 비용과 요구사항이 어긋납니다.
8개 툴의 강점과 먼저 마주치는 한계
아래 툴은 각각 특정 반복 작업에 적합해 후보에 포함했습니다. 번호는 후보를 찾아보기 쉽게 붙였습니다. 같은 용도에서 가장 적합한 툴은 각 항목에 설명한 결과물, 제한, 운영 책임에 따라 달라집니다.
1. Firecrawl: 에이전트용 페이지 수집의 첫 후보
Firecrawl은 웹사이트를 활용 가능한 페이지 콘텐츠로 바꾸는 스크래핑 API입니다. 문서를 기반으로 답하는 에이전트를 만들 때 먼저 평가할 만합니다. Scrape, Crawl, Map은 각각 페이지 가져오기, 사이트 순회, URL 탐색을 담당해 서로 다른 작업을 구분합니다. 고객 지원 어시스턴트를 만드는 창업자라면 문서 URL을 매핑하고 필요한 경로를 고른 뒤 해당 페이지를 크롤링해 Markdown으로 가져올 수 있습니다. 잘 정리된 페이지 본문이 결과물이라면 적합하지만, 운영 담당자가 관리하는 스프레드시트 모니터링이 주목적이라면 다시 검토해야 합니다.
추천 대상: 문서, 기사, 참고 페이지를 AI 에이전트에 공급하는 개발자입니다.
핵심 기능: scrape, crawl, map을 구분해 제공하며 Markdown과 구조화된 추출을 지원합니다.
요금: Hobby 월 $19, 연간 결제 시 월 $16이며 매월 5,000크레딧을 제공합니다.
무료 이용: 카드 등록 없이 매월 1,000크레딧이 갱신되는 Free 요금제가 있습니다.
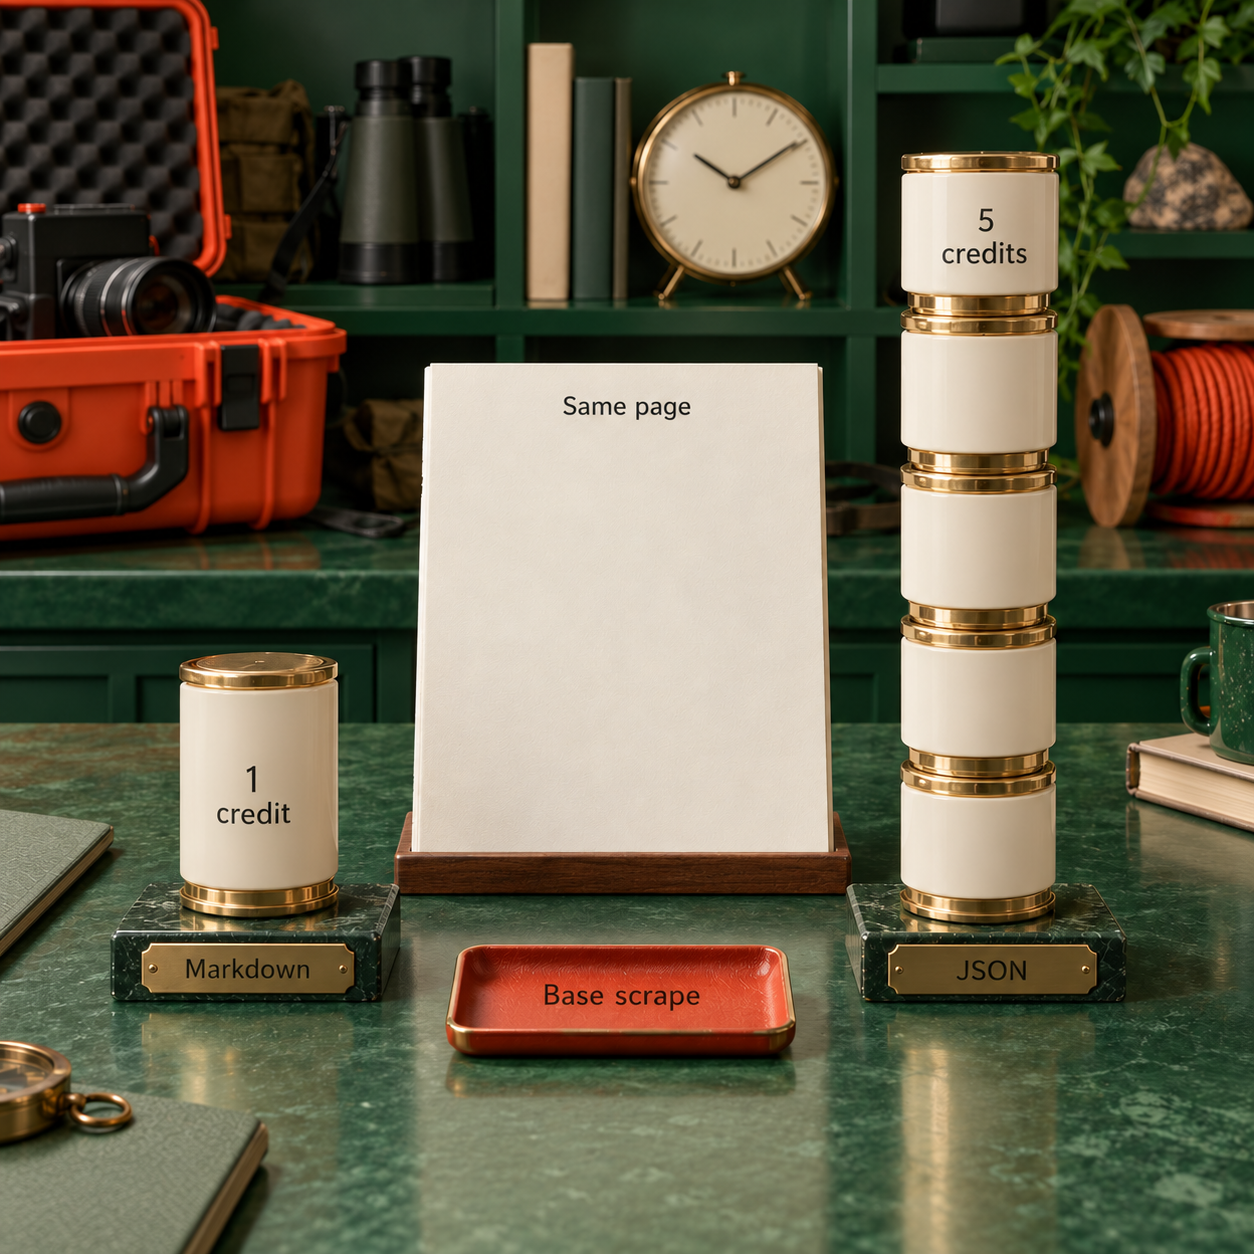
기본 스크래핑이나 크롤링은 페이지당 1크레딧을 사용합니다. JSON 추출은 4크레딧이 추가되므로 표준 페이지 수집과 JSON 추출을 함께 요청하면 5크레딧입니다. 따라서 Hobby의 잔액을 해당 작업에만 쓴다면 기본 페이지 5,000개 또는 표준 JSON 페이지 1,000개를 처리할 수 있습니다. 같은 구독이라도 어떤 결과물을 요청하느냐에 따라 제공량의 의미가 크게 달라집니다. Firecrawl 요금 상세.
월 단위 결제 요금은 Free $0, Hobby $19에 5,000크레딧, Standard $99에 100,000크레딧, Growth $399에 500,000크레딧, Scale $749에 1,000,000크레딧입니다. Enterprise는 맞춤 견적입니다. 연간 결제의 월 환산 표시는 순서대로 $16, $83, $333, $599이며, 실제 연간 청구액은 각각 $190, $990, $3,990, $7,190입니다. 반올림을 포함해 업체가 표시한 수치를 그대로 옮겼습니다. Firecrawl 전체 요금제.
먼저 마주치는 한계는 요청한 크롤링 규모입니다. Firecrawl 크롤링 문서에 따르면 기본 제한은 10,000페이지이며, 잔여 크레딧으로 요청한 제한량을 감당할 수 없으면 작업이 거절될 수 있습니다. 따라서 Hobby로 작은 사이트를 수집하더라도 첫 페이지를 가져오기 전에 limit을 더 낮게 지정해야 할 수 있습니다. 다음은 동시 요청 제한입니다. Hobby는 5개, Standard는 25개, Growth는 50개, Scale은 100개를 허용합니다. 크레딧을 추가해도 현재 요금제의 동시 요청 제한은 없어지지 않습니다. 크롤링 동작 설명.
결과를 받아들일지 판단하는 검증도 필요합니다. Firecrawl은 결과가 전혀 없는 스크래핑에는 과금하지 않는다고 설명하지만, 대상 사이트의 403이나 404 오류 페이지가 반환되면 1크레딧이 차감됩니다. 지식 베이스에 넣기 전에 대상 사이트의 상태 코드와 반환 내용을 확인해야 합니다. Markdown으로 깔끔하게 변환된 오류 페이지도 여전히 오류 페이지입니다.
- Scrape, crawl, map을 통해 URL 탐색과 페이지 수집을 따로 결정할 수 있습니다.
- Markdown은 문서 수집에, JSON은 정의된 필드 스키마에 적합합니다.
- 정기 무료 제공량으로 소규모 예약 작업을 평가할 수 있습니다.
- 유료 크레딧 충전으로 요금제를 바꾸기 전에 사용량을 늘릴 수 있습니다.
- 구조화된 추출을 사용하면 기본 제공량으로 처리할 수 있는 페이지 수가 크게 줄어듭니다.
- 기본 크롤링 제한이 커서 소규모 계정의 잔액을 초과할 수 있습니다.
- 반환된 오류 페이지도 과금될 수 있으므로 별도 검증이 필요합니다.
- Hobby, Standard, Growth의 크레딧은 일반적으로 이월되지 않습니다.
전체 수집 전에 출처 URL을 탐색하세요
Map 플레이그라운드에서 문서 URL을 찾아보세요. 어시스턴트가 실제로 답해야 할 질문과 관련된 경로를 남기면 됩니다. 매핑은 주소를 발견하는 작업이며, 해당 주소를 스크래핑하는 것은 별도 작업입니다.
필요한 결과물 중 비용이 가장 낮은 형식을 고르세요
문서 기반 어시스턴트라면 Markdown부터 시작하면 됩니다. 후속 워크플로에 이름이 붙은 필드가 필요할 때는 JSON 스키마를 사용합니다. 스키마가 명확하다고 가정하기 전에 정상가와 할인가가 모두 표시된 대표 상품 페이지를 검증해야 합니다.
예산에 맞는 크롤링 제한을 지정하세요
예시로 든 120페이지의 출처 목록이라면
limit을 120으로 명시합니다. 크롤러가 무관한 블로그나 계정 페이지에 잔액을 쓰지 않도록 경로 필터를 적용해야 합니다.결과와 검증 근거를 함께 저장하세요
출처 URL, 수집 시각, 대상 사이트의 상태 코드, 콘텐츠를 자체 저장소에 보관합니다. Firecrawl 문서에 따르면 완료된 크롤링 결과는 API에서 24시간 동안 조회할 수 있습니다. API 조회 결과만 유일한 사본으로 남겨서는 안 됩니다.
다음 실행의 범위와 대응 방식을 정하세요
애플리케이션 스케줄러가 검증을 통과한 출처 목록을 다시 방문하도록 설정합니다. 예산에서는 탐색, 추출, 모니터링 비용을 따로 관리하고, 출처에서 기대한 콘텐츠가 나오지 않을 때 예외를 받을 담당자를 정해야 합니다.
기존 Firecrawl 구성을 교체해야 한다면 Firecrawl 대안 비교에서 마이그레이션과 결과 검증 기준을 더 자세히 살펴볼 수 있습니다. 공급업체를 바꾸는 결정과 문서 수집을 노코드 모니터링으로 바꾸는 결정은 다릅니다.
2. Browse AI: 운영 담당자가 관리하는 모니터링에 적합
Browse AI는 작업을 녹화해 재사용 가능한 로봇으로 만드는 노코드 스크래핑·모니터링 플랫폼입니다. 정해진 사이트에서 상품 가격, 채용 공고, 디렉터리 항목을 추적하는 운영 담당자에게 적합합니다. 추출할 필드를 기록하고 결과를 스프레드시트나 연결된 워크플로로 보낼 수 있습니다. 실질적인 한계는 페이지 수, 추출 행 수, 모니터링할 도메인의 조합에서 결정됩니다. 따라서 로봇 수가 무제한이라는 안내를 데이터도 무제한이라는 뜻으로 읽어서는 안 됩니다.
추천 대상: 스크래퍼 코드를 관리하지 않고 반복 추출과 변경 모니터링을 해야 하는 운영 담당자입니다.
핵심 기능: 녹화형 로봇, 예약 모니터링, 스프레드시트·워크플로 연동입니다.
요금: Personal은 연간 결제 시 월 $19이며, $228을 선결제하고 연간 12,000크레딧을 받습니다.
무료 이용: Free 요금제는 월 50크레딧, 도메인 2개, 무제한 로봇을 제공합니다.
Browse AI는 표준 페이지 방문 한 건당 1크레딧, 또는 추출한 10행당 1크레딧 중 더 큰 비용을 적용합니다. 상품 50개가 있는 목록 페이지는 5크레딧을 사용합니다. 표준 페이지라는 가정 아래 상세 페이지 50개를 모두 방문하면 50크레딧이 더 들어갑니다. 상세 정보까지 필요하다면 상품 목록 하나를 수집하는 데 55크레딧이 드는 셈입니다. 프리미엄 사이트는 더 비쌀 수 있으므로 작업에 표시되는 비용을 확인해야 합니다. Browse AI 요금과 크레딧 예시.
실제 페이지의 연간 요금제는 Free $0, Personal 월 $19에 연간 12,000크레딧, Professional 월 $69에 연간 60,000크레딧, Premium 연간 결제 시 월 $500부터입니다. Personal은 도메인 5개와 사용자 3명, Professional은 도메인 10개와 사용자 10명을 포함합니다. 연간 크레딧은 한 번에 지급됩니다. Premium에는 설정, 유지보수, 데이터 변환을 맡는 관리형 서비스가 추가됩니다.
월 단위 결제에서는 Personal이 월 $48에 매월 2,000크레딧, Professional이 월 $87에 매월 5,000크레딧입니다. 따라서 월 $19로 표시된 연간 Personal 상품은 같은 제공량을 결제 시점만 바꿔 파는 상품이 아닙니다. 결제 기간과 실제 할당량을 함께 비교해야 합니다. 연간 Professional의 선결제액은 $828, 연간 Personal은 $228입니다.
크레딧보다 도메인 제한에 먼저 도달할 수 있습니다. 여러 공급업체 사이트에서 필드를 조금씩 확인하는 워크플로라면 데이터 사용량이 적어도 도메인을 추가해야 할 수 있습니다. 연간 결제의 추가 도메인 요금은 Personal에서 월 $4, Professional에서 월 $2.40으로 안내합니다. 연간 요금제는 최소 1,000크레딧부터 충전할 수 있으며, Personal은 크레딧당 $0.024, Professional은 크레딧당 $0.017-$0.013입니다.
공급업체 가격을 추적한다면 가격 값 옆에 상품 식별자와 통화도 보관해야 합니다. 숫자를 추출하는 로봇은 할인가, 회원가, 다른 포장 단위의 가격 중 무엇으로 구매 기록을 갱신해야 하는지 판단할 수 없습니다. 그 의미는 비교 규칙과 검토 대기열에서 정해야 합니다.
- 녹화된 작업을 통해 운영 담당자가 추출 지침을 확인할 수 있습니다.
- 요금제 전반에 모니터링, API 접근, 웹훅이 안내되어 있습니다.
- Google Sheets, Airtable, Zapier, Make 연동으로 일반적인 운영 워크플로를 구성할 수 있습니다.
- 도메인 추가와 연간 크레딧 충전으로 요금제의 사용 범위를 늘릴 수 있습니다.
- 행이 많은 목록과 상세 페이지 방문이 겹치면 비용이 누적됩니다.
- 크레딧이 남아 있어도 도메인 제한 때문에 추가 구매가 필요할 수 있습니다.
- 가장 저렴하게 광고하는 연간 상품은 월 단위 Personal과 할당량이 다릅니다.
- 사이트 변경이나 모호한 필드는 담당자가 결과를 확인해야 합니다.
데이터셋 담당자가 로봇도 직접 조정할 수 있어야 한다면 Browse AI가 적합합니다. 추출이 제품 내부 기능이고 개발팀이 이미 일정, 스키마, 실패 대응을 맡고 있다면 API를 선택하는 편이 맞습니다.
3. Bright Data: 요금 비교 전에 필요한 제품부터 선택
Bright Data는 프록시 네트워크, 사전 구축된 Scraper API, Web Unlocker를 제공하는 웹 데이터 업체입니다. 대상 사이트 접근이나 수집량이 제약이라면 검토할 만합니다. 전자상거래 개발자는 상품 레코드를 반환하는 사이트별 스크래퍼를 구매할 수 있고, 이미 자체 스크래퍼가 있다면 주거용 프록시 접근만 필요할 수 있습니다. 서로 다른 계층을 해결하는 구매이므로 과금 단위도 다릅니다.
추천 대상: 대상 사이트 접근, 지역, 유지보수되는 사이트별 스크래퍼가 중요한 수집 작업입니다.
핵심 기능: 프록시, 차단 해제, 구조화된 레코드 제품을 별도로 제공합니다.
요금: Web Scraper API 종량제는 레코드 1K당 $1.5, 주거용 프록시 종량제는 한시적 쿠폰 적용 전 $8/GB입니다.
무료 이용: Scraper API는 매월 5K레코드를 무료로 제공하며, 주거용 프록시 체험은 별도입니다.
완성된 레코드가 필요하면 Scraper API를 사용합니다. 사이트별 API가 구조화된 데이터를 반환하며, 프록시, 차단 해제, 파싱, 실행 환경, 저장소, 외부 데이터 전송을 포함한다고 안내합니다. Free Tier는 월 5K레코드, 종량제는 레코드 1K당 $1.5입니다. Scale은 월 $499에 384,000레코드를 포함하고 추가 레코드는 1K당 $1.3이며, Enterprise는 맞춤 견적입니다. 필요한 필드가 모두 들어 있다고 가정하기 전에 대상 스크래퍼의 입력·출력 스키마를 확인해야 합니다. Web Scraper API 요금.
자체 코드에 접근 처리가 필요하면 Web Unlocker를 사용합니다. 해당 페이지는 자동 프록시 관리, 재시도, IP 순환, CAPTCHA 처리를 안내합니다. Free Tier는 월 5K요청, 종량제는 요청 1K당 $1.5입니다. 표시된 Scale 상품은 월 $499에 383K요청을 포함하며 추가 요청은 1K당 $1.3입니다. Enterprise는 맞춤 견적입니다. Bright Data는 Web Unlocker가 워크플로에서 이동하거나 클릭하는 대화형 브라우저가 아니라고 명시합니다. Web Unlocker 요금과 제한.
스크래퍼 자체를 유지하려면 주거용 프록시를 사용합니다. 상세 종량제 카드에는 $8/GB가 표시되어 있으며, 세 달간 적용되는 RESIGB50 프로모션으로 $4/GB가 됩니다. 표시된 월간 프로모션 패키지는 $499에 141 GB, $999에 332 GB, $1,999에 798 GB입니다. 1 TB를 넘으면 맞춤 견적을 요청하도록 안내합니다. 과금 전송량은 데이터베이스에 보관한 최종 레코드만이 아니라 대상 사이트에 보내고 받는 트래픽을 모두 포함합니다. 주거용 프록시 요금.
이 마지막 차이가 예산을 결정합니다. 이미지나 다른 페이지 리소스를 내려받는 요청은 유용한 레코드가 늘지 않아도 전송량을 사용합니다. 레코드 API는 안내된 레코드 가격에 이런 접근 비용을 포함하지만, 프록시만 구매하면 요청, 파싱, 품질 검사는 직접 맡아야 합니다. 실제 워크플로를 측정하기 전에는 GB 요금만으로 검증을 통과한 목록 항목당 비용을 알 수 없습니다.
핵심 한계는 필요와 다른 계층을 구매하는 것입니다. IP 접근성이 좋아져도 잘못된 필드를 선택하는 파서는 고쳐지지 않습니다. 유지보수되는 레코드 스크래퍼가 기존에 의존하던 자체 추출 동작을 정확히 유지해 준다는 보장도 없습니다. 같은 업체 이름 아래 표시된 가격 두 개를 비교하기 전에 데이터 계약부터 정의해야 합니다.
- 사이트별 Scraper API로 자체 추출 작업을 줄일 수 있습니다.
- 레코드, 요청, 전송량 제품이 나뉘어 있어 개발팀이 필요한 계층을 구매할 수 있습니다.
- Scraper API 요금에는 해당 페이지에 설명된 접근·파싱 비용이 포함됩니다.
- 정기 무료 API 제공량으로 지원되는 대상을 평가할 수 있습니다.
- 제품군이 넓으므로 무엇을 구매할지 정확히 정해야 합니다.
- 주거용 프록시 트래픽은 GB 단위 과금이며 유효한 레코드를 보장하지 않습니다.
- 프로모션 프록시 요금은 한시적입니다.
- Web Unlocker는 대화형 브라우저 워크플로를 대신하지 않습니다.
접근 인프라나 적합한 유지보수형 스크래퍼가 부족하다면 Bright Data를 선택할 만합니다. 운영 담당자가 맡는 작은 모니터링 작업은 Browse AI부터 검토하는 편이 더 직접적이며, 문서 수집이라면 페이지 콘텐츠를 반환하는 API부터 살펴보면 됩니다.
4. Context.dev: 에이전트 데이터와 모니터링을 하나의 API로
Context.dev는 스크래핑, URL 매핑, 크롤링, 배치 처리, 출처를 제시하는 답변, 모니터링을 제공한다고 안내하는 웹 컨텍스트 API입니다. 에이전트용 페이지와 정기 업데이트를 애플리케이션으로 받고 싶은 개발자에게 적합합니다. 문서 기반 어시스턴트가 처음에 출처를 수집한 뒤 웹훅으로 모니터링 업데이트를 받을 수 있습니다. 웹훅은 이벤트가 발생할 때 애플리케이션으로 보내는 HTTP 메시지입니다. 이 용도에서 Firecrawl과 함께 검토할 만하며, 브랜드 정보 보강은 추가 제품 기능일 뿐 스크래핑용으로 선택하는 이유는 아닙니다.
추천 대상: 페이지 추출과 웹훅 기반 출처 모니터링을 결합하는 에이전트나 제품입니다.
핵심 기능: 하나의 API에서 Scrape, Map, Crawl, Batches, Monitors를 제공합니다.
요금: Developer는 월 $19이며 매월 7,500크레딧을 제공합니다.
무료 이용: Free Tier는 카드 등록 없이 월 1,000크레딧과 모니터 10개를 제공합니다.
사이트는 Markdown, HTML, 스크린샷, 구조화된 필드를 지원하며 기본 스크래핑에 렌더링과 프록시가 포함된다고 안내합니다. 모니터는 정해진 주기로 페이지를 확인하고 업데이트를 웹훅으로 보냅니다. 개발자가 연동하는 기능이므로, 업데이트를 받은 애플리케이션이 검증하고 후속 데이터를 어떻게 바꿀지 결정해야 합니다. 운영 담당자에게 녹화형 스프레드시트 로봇을 맡기는 방식과는 책임 구조가 다릅니다. Context.dev 제품 설명.
월간 요금제는 Free Tier $0에 1,000크레딧, Developer $19에 7,500크레딧, Pro $99에 125,000크레딧, Growth $299에 500,000크레딧, Scale $499에 1,000,000크레딧입니다. Enterprise는 맞춤 견적이며 월 2,000,000+크레딧을 안내합니다. 기본 동시 요청 제한은 Free 1개, Developer 10개, Pro 100개, Growth 250개, Scale 500개로 늘어납니다. Context.dev 요금.
표준 스크래핑은 1크레딧을 사용합니다. JSON 추출이 성공하면 4크레딧이 더해져 표준 페이지당 5크레딧입니다. 브라우저 동작을 사용하면 추출 비용을 더하기 전 기본 스크래핑 비용이 2크레딧으로 올라갑니다. 렌더링과 프록시가 기본으로 포함된다고 모든 요청이 1크레딧인 것은 아닙니다. Developer의 7,500크레딧을 이 작업에만 사용하면 표준 JSON 페이지 1,500개를 처리할 수 있습니다.
신규 구독의 유료 충전 요금은 1,000크레딧당 Developer $2.20, Pro $1.80, Growth $1.40, Scale $1.00이며, 1,000크레딧 단위로 청구됩니다. 기존 구독은 기존 요금을 유지합니다. 따라서 기본 잔액이 소진됐다는 이유만으로 상위 요금제로 바꾸기보다 작은 요금제에 크레딧을 충전하는 비용과 비교할 수 있습니다.
크롤링의 명확한 한계는 Crawl 호출 한 번에 500페이지입니다. 더 큰 사이트는 Batches의 크롤링 모드를 사용합니다. 이에 맞춰 수집 구조를 나누고, 결과가 저장소에 도착했는지 확인한 뒤 배치가 끝났다고 판단해야 합니다. 수집 엔드포인트와 영구 보관되는 지식 베이스는 별도의 구성 요소입니다.
또 다른 한계는 일부만 성공한 결과입니다. Context.dev는 실패한 요청 대부분에 과금하지 않지만, 찾을 수 없는 페이지의 응답에는 과금하며, 한 응답 안에 성공한 결과와 실패한 결과가 함께 들어갈 수 있다고 설명합니다. 바깥쪽 응답이 성공이라는 이유로 레코드가 완전하다고 판단하지 말고 반환 결과와 key_metadata.credits_consumed를 확인해야 합니다.
- 페이지 콘텐츠와 예약 웹훅 모니터링을 같은 에이전트 데이터 워크플로에 넣을 수 있습니다.
- 기본 스크래핑 요금에 렌더링과 프록시가 포함됩니다.
- 정기 무료 요금제에 소규모 모니터 제공량이 포함됩니다.
- 충전 단위와 요금이 공개되어 소규모 작업 예산을 구체적으로 계산할 수 있습니다.
- JSON 추출과 브라우저 동작은 크레딧 사용량을 늘립니다.
- Crawl 단일 호출에 제한이 있어 더 큰 출처는 Batches가 필요합니다.
- 웹훅 전달 이후에도 애플리케이션 로직과 저장소가 필요합니다.
- 일부만 반환된 결과와 과금되는 미발견 페이지를 검증해야 합니다.
API 기능의 조합과 크레딧 예산이 에이전트에 맞는다면 Context.dev를 선택하면 됩니다. Firecrawl과 비교할 때는 같은 대표 출처와 출력 스키마를 사용해야 합니다. 시작 요금제의 제공량이 더 많다는 사실을 근거 없는 품질 우위로 해석해서는 안 됩니다.
5. Apify: 적합한 Actor가 이미 있을 때 강점이 큰 플랫폼
Apify는 Actor라는 재사용 가능한 스크래핑·자동화 프로그램을 실행하는 클라우드 플랫폼입니다. 수집 대상에 맞는 유지보수형 Actor가 이미 있다면 좋은 선택입니다. 범용 페이지 요청 엔드포인트보다 추출 로직 자체가 더 가치 있을 수 있기 때문입니다. 업체 디렉터리 데이터셋을 갱신하는 운영 담당자는 Actor의 입력을 설정하고 작업을 저장한 뒤 반복 실행 일정을 잡을 수 있습니다. 한계를 결정하는 것은 플랫폼 구독만이 아니라 선택한 Actor의 동작과 과금 방식입니다.
추천 대상: 적합한 Actor가 이미 제공되는 특정 수집 대상이나 추출 작업입니다.
핵심 기능: 작업 예약과 연동 기능을 갖춘 재사용 가능한 클라우드 프로그램입니다.
요금: Starter는 월 $19 + 사용량 과금이며 $19 상당의 사용량을 포함합니다.
무료 이용: 카드 등록 없이 월 $5 상당의 사용량을 제공하는 Free 요금제가 있습니다.
Apify의 Free는 $0이며 Store나 플랫폼 사용에 쓸 수 있는 $5를 제공합니다. Starter는 월 $19 + 사용량 과금에 $19를 포함합니다. Scale은 $199에 $199, Business는 $999에 $999 상당의 사용량을 포함합니다. Enterprise는 맞춤 요금입니다. 컴퓨팅 단위당 비용은 Free와 Starter $0.2, Scale $0.16, Business $0.13입니다. 컴퓨팅 단위 하나는 RAM 1 GB를 한 시간 동안 사용하는 양입니다. Apify 요금.
포함된 달러 잔액을 고정된 페이지 제공량으로 취급해서는 안 됩니다. 선택한 Actor 자체에 요금이 있을 수 있고, 플랫폼 리소스, 프록시, 저장소, 전송량이 실제 작업에 따라 청구액에 영향을 줍니다. 비교해야 할 것은 마켓플레이스 프로그램의 매력적인 시작 요금이 아니라 검증을 통과한 레코드를 반환하는 전체 실행 비용입니다.
컴퓨팅만 사용하는 가상의 실행을 예로 들면, RAM 1 GB를 열 시간 사용하면 컴퓨팅 단위 열 개를 소비합니다. Starter에서는 컴퓨팅 사용료 $2입니다. 이 계산으로 반환되는 목록 항목 수나 추가 요금은 알 수 없습니다. $19로 컴퓨팅 단위 95개를 쓸 수 있다는 설명도 전액을 컴퓨팅에만 쓴다는 가정에 따른 것입니다. 실제 스크래핑 작업은 그 가정과 다를 수 있습니다.
Apify의 예약 도구는 선택한 시간대에 맞춰 저장된 작업을 실행하고 웹훅 알림을 보낼 수 있습니다. 문서에 따르면 새 일정은 기본적으로 비활성화되어 있으므로 일정을 저장했다고 다음 실행이 보장되는 것은 아닙니다. 활성화 상태와 표시된 다음 실행 시각을 확인해야 합니다. Apify 예약 실행 문서.
디렉터리 예시에서는 구매 전에 페이지네이션, 지역 포함 범위, 출력 식별자, Actor의 유지보수 이력을 확인해야 합니다. 카테고리 목록을 수집하는 Actor가 목록에 있는 모든 업체의 정보를 CRM에서 요구하는 필드까지 보강해 주는 것은 아닙니다. 검증을 통과한 레코드와 거절된 레코드의 표본을 남기고 누락된 필드가 드러나게 해야 합니다.
- 적합한 Actor가 대상별 추출 로직을 제공할 수 있습니다.
- 저장된 작업과 일정으로 반복 수집을 운영할 수 있습니다.
- 마켓플레이스에는 페이지 콘텐츠를 크롤링하는 워크플로도 있습니다.
- 포함된 사용량으로 소규모 작업의 전체 실행을 평가할 수 있습니다.
- Apify 전체에 적용되는 단일 페이지당·레코드당 요금은 없습니다.
- Actor별 비용이 플랫폼 요금제보다 더 중요할 수 있습니다.
- 작업의 입력과 출력이 데이터셋 요구사항을 충족하는지 검증해야 합니다.
- 새 일정을 활성화해야 예약 실행을 기대할 수 있습니다.
Actor가 상당한 추출 작업을 대신하고 전체 실행 비용도 적절하다면 Apify를 선택하면 됩니다. 작업이 주로 지정된 페이지를 가져오는 것이고 마켓플레이스가 수고를 덜어주지 못한 채 복잡성만 더한다면 직접 호출하는 스크래핑 API가 적합합니다.
6. ScrapingBee: 요청 설정별 비용이 명확한 페이지 수집 API
ScrapingBee는 개발자가 운영하는 추출 워크플로에서 렌더링과 프록시 옵션을 처리하는 스크래핑 API입니다. 파싱과 예약 실행 코드는 유지하면서 까다로운 페이지 요청 처리를 맡기려는 개발자에게 적합합니다. 예를 들어 상품 데이터 서비스가 렌더링된 페이지를 요청한 뒤, 반환된 콘텐츠에 기존 필드 규칙을 적용할 수 있습니다. 예산을 잡을 때 먼저 확인할 것은 해당 사이트에서 실제로 작동하는 설정의 크레딧 비용입니다.
추천 대상: 자체 추출 로직을 유지하면서 페이지 요청 계층을 교체하려는 개발자입니다.
핵심 기능: 렌더링·프록시 제어와 최대 크레딧 비용을 지정할 수 있는 Auto-Mode입니다.
요금: Freelance는 월 $49이며 API 크레딧 250,000개를 제공합니다.
무료 이용: 카드 등록 없이 API 크레딧 1,000개를 체험할 수 있으며 정기 무료 요금제는 안내하지 않습니다.
공개된 전체 요금제는 Freelance 월 $49에 250,000크레딧, Startup $99에 1,000,000크레딧, Business $249에 3,000,000크레딧, Business + $599에 8,000,000크레딧입니다. Enterprise 14는 $999에 14,000,000크레딧, Enterprise 24는 $1,599에 24,000,000크레딧, Enterprise 41은 $2,399에 41,000,000크레딧, Enterprise 69는 $3,599에 69,000,000크레딧입니다. 더 큰 용량은 업체와 협의해야 합니다. 요금에는 VAT가 포함되지 않습니다. ScrapingBee 요금.
표시된 제공량은 요청 수가 아니라 크레딧입니다. 문서에 안내된 페이지 요청 비용은 JavaScript 없는 일반 프록시 1크레딧, JavaScript 포함 시 5크레딧, JavaScript 없는 프리미엄 프록시 10크레딧, JavaScript 포함 프리미엄 프록시 25크레딧, JavaScript 포함 스텔스 프록시 75크레딧입니다. AI 추출은 5크레딧이 더 들며 JavaScript 렌더링은 기본으로 켜져 있습니다. ScrapingBee 요청 비용.
따라서 Freelance의 250,000크레딧을 해당 설정 하나에만 사용한다면 일반 JavaScript 요청은 최대 50,000건, 프리미엄 JavaScript 요청은 10,000건, 스텔스 JavaScript 요청은 온전한 요청 기준 3,333건입니다. 이는 제공량으로 계산한 수치이며 측정된 성공률이 아닙니다. 추가 기능이나 서로 다른 대상 사이트의 조합에 따라 달라집니다.
Auto-Mode는 여러 설정을 시도하고 성공한 설정에 대해 과금하며, 모든 설정이 실패하면 과금하지 않습니다. max_cost를 지정하면 시도할 수 있는 설정의 비용을 제한합니다. 다만 문서에 따르면 페이지별 대기나 클릭 지침까지 자동으로 선택하지는 않습니다. 필요한 가격이 옵션 선택이나 비동기 로딩 후에 나타난다면 해당 동작은 직접 정의해야 합니다. Auto-Mode 문서.
여기서의 한계는 페이지 요청 설정만으로 추출 의도가 정해지지 않는다는 점입니다. 정상 HTML 응답에도 빈 자리 표시자, 기본 지역의 가격, 고객이 선택하지 않을 옵션이 들어 있을 수 있습니다. API 호출이 성공했다고 확인을 끝내지 말고 응답 근거를 보관하며 업무에 필요한 필드를 검증해야 합니다.
- 파싱과 예약 실행을 자체 코드에 남겨야 하는 맞춤 스크래퍼에 적합합니다.
- 렌더링·프록시 설정별 크레딧 비용이 공개되어 있습니다.
- Auto-Mode에서 접근 설정에 쓸 최대 비용을 제한할 수 있습니다.
- 요금제 단계에 따라 동시 실행 수와 용량을 늘릴 수 있습니다.
- 같은 크레딧 제공량으로 가능한 요청 수가 설정에 따라 크게 달라집니다.
- AI 추출에는 크레딧이 추가로 듭니다.
- Auto-Mode는 대상별 대기나 클릭 설정을 대신하지 않습니다.
- 무료 제공량은 체험용이며 지속적인 예약 작업용 할당량이 아닙니다.
요청을 직접 제어하는 것이 중요하고 응답 검증 방법도 이미 알고 있다면 ScrapingBee가 적합합니다. 대상 사이트의 추출 규칙을 유지보수하는 일을 줄이고 싶다면 레코드 API나 적합한 Apify Actor를 우선 검토해야 합니다.
7. Octoparse: 시각적으로 설계하되 클라우드 예약은 유료
Octoparse는 추출 작업을 설계하고 유지보수할 운영 담당자에게 적합한 시각적 스크래핑 애플리케이션입니다. 반복적으로 카탈로그나 목록을 수집할 때 API 연동보다 작업 빌더가 필요하다면 검토할 만합니다. 구매 분석 담당자가 목록·상세 필드를 정의하고 검증된 워크플로를 유료 클라우드 실행으로 옮길 수 있습니다. Free 요금제는 로컬 평가에 유용하지만 무인 데이터 공급까지 가능하다고 가정해서는 안 됩니다.
추천 대상: 추출 작업을 시각적으로 만들고 필요할 때 클라우드 실행을 구매하는 운영 담당자입니다.
핵심 기능: 작업 기반 스크래핑, 유료 클라우드 예약 실행, 자동 내보내기입니다.
요금: Standard는 연간 결제 시 월 $69부터입니다.
무료 이용: Free Plan에서 로컬 작업 10개와 월 50,000행 내보내기를 제공합니다.
Free는 작업 10개, 로컬 기기에서의 실행, 내보내기 한 번당 최대 10,000행, 월간 내보내기 50,000행을 제공합니다. Standard는 클라우드 추출, 작업 예약, 자동 내보내기, Data Export API를 추가하며 작업 100개와 최대 3개의 동시 클라우드 프로세스를 허용합니다. Professional은 작업 250개와 최대 20개의 동시 클라우드 프로세스, Advanced API와 추가 지원을 제공합니다. Enterprise는 작업 750+개와 동시 클라우드 프로세스 40+개를 안내합니다. Octoparse 요금제 상세.
공개된 요금제는 Free $0, Standard 월 $69부터, Professional 월 $249, Enterprise 맞춤 견적입니다. 두 유료 금액은 모두 연간 결제 기준입니다. 표시된 월 환산액을 연간 상품으로 이해하고, 현금 지출을 예측하기 전에 결제 화면에서 실제 청구액을 확인해야 합니다. Octoparse 요금.
과금 단위는 요청당 표준 크레딧이 아니라 작업 수와 프로세스 수가 제한된 구독입니다. 관리 가능한 수의 작업 안에서 많은 데이터를 추출하는 워크플로에 적합할 수 있습니다. 다만 유료 요금제의 무제한 데이터 내보내기는 클라우드 작업을 무제한으로 병렬 실행한다는 뜻이 아닙니다. Standard에서는 저장된 작업 100개를 채우기 훨씬 전에 동시 클라우드 프로세스 세 개가 제약이 될 수 있습니다.
부가 기능 비용은 별도입니다. 요금 페이지에는 주거용 프록시 $3/GB, CAPTCHA 처리 1,000건당 $1-1.5, 결과당 과금 템플릿은 결과 1,000건당 $0.001-3으로 안내되어 있습니다. 유료 구독을 해도 모든 고급 접근 비용이 무료로 포함되는 것은 아닙니다.
공급업체 카탈로그를 수집한다면 작은 작업을 로컬에서 먼저 실행해 목록·상세 정보가 제대로 수집되는지 검증해야 합니다. 이후 같은 입력을 클라우드 실행에서 어떻게 처리하는지, 내보낸 결과가 어디에 저장되는지, 실패를 누가 확인하는지 점검합니다. 작업을 만들 수 있는 분석 담당자에게도 기대한 레코드를 수집했는지 확인하는 운영 절차가 필요합니다.
- 추출 지침을 직접 관리하려는 운영 담당자에게 시각적 작업 설계가 적합합니다.
- 클라우드 상품을 구매하기 전에 무료 로컬 작업으로 워크플로를 평가할 수 있습니다.
- Standard는 예약 실행과 자동 내보내기를 명시적으로 포함합니다.
- 작업 수와 클라우드 프로세스 제한으로 실행 범위를 확인할 수 있습니다.
- 무료 실행은 로컬이므로 무인 클라우드 작업을 제공하지 않습니다.
- 유료 내보내기 제공량이 늘어도 작업 수나 동시 실행 제한은 남습니다.
- 프록시, CAPTCHA, 템플릿 부가 기능으로 사용료가 추가될 수 있습니다.
- 시작 요금은 연간 결제 조건입니다.
시각적 작업 설계가 실질적인 장점이고 클라우드 프로세스 제한이 일정에 맞는다면 Octoparse를 선택하면 됩니다. 녹화형 모니터링은 Browse AI부터 검토하는 편이 더 직접적입니다. 추출이 소프트웨어 제품 내부에 들어가는 기능이라면 API가 더 적합합니다.
8. Zyte: 대상 사이트에 따라 달라지는 접근 비용
Zyte는 Zyte API에서 성공 응답을 기준으로 과금하는 웹 데이터 업체입니다. 사이트 난이도와 HTTP 콘텐츠·브라우저 렌더링 중 무엇을 요청하는지에 따라 요금이 달라집니다. 프록시를 직접 구매해 관리하지 않고 사이트 접근을 자동 처리하려는 수집기 개발자에게 적합합니다. 목록 정보를 제공하는 서비스라면 자체 데이터셋과 파싱을 유지하면서 대상마다 실제로 필요한 응답 모드에 맞춰 예산을 잡을 수 있습니다. 최저 요금은 그 요금에 붙는 약정과 사이트 등급까지 확인해야 의미가 있습니다.
추천 대상: 대상별 접근 예산을 관리하는 개발자 운영 수집기입니다.
핵심 기능: 성공 응답 기준 과금과 HTTP·브라우저의 별도 요금입니다.
요금: 종량제 HTTP는 1,000건당 $0.13-$1.27, 브라우저는 1,000건당 $1.01-$16.08입니다.
무료 이용: 약정 없이 30일 동안 사용할 수 있는 크레딧 $5를 제공하며, 정기 무료 요금제는 안내하지 않습니다.
대상 등급 Simple, Easy, Moderate, Complex, Advanced의 종량제 HTTP 요금은 응답 1,000건당 각각 $0.13, $0.23, $0.44, $0.70, $1.27입니다. 종량제 브라우저 요금은 $1.01, $2.01, $4.02, $8.04, $16.08입니다. 따라서 요청량이 같아도 대상과 렌더링 필요 여부에 따라 청구액은 크게 달라집니다. Zyte 요금.
월간 약정을 하면 단가가 낮아집니다. $100 약정에서는 1,000건당 HTTP $0.10-$0.95, 브라우저 $0.75-$12.00입니다. $200에서는 각각 $0.08-$0.76과 $0.60-$9.60, $500에서는 $0.06-$0.61과 $0.48-$7.68입니다. Enterprise 요금은 영업팀과 협의해야 합니다. 페이지의 $0.06부터라는 문구는 약정 요금제에 해당하며 종량제 HTTP 시작 요금이 아닙니다.
성공 응답 100,000건을 예로 들면 Simple 종량제 HTTP 요금의 사용료는 $13입니다. Simple 브라우저 요금은 $101, Advanced 브라우저 요금은 $1,608입니다. 공개 요금으로 계산한 예시이며, 실제 대상 사이트가 특정 등급에 속한다는 주장은 아닙니다. 고급 기능에는 추가 요금이 붙을 수 있으므로 원하는 출력 모드를 설정해 업체의 사이트별 견적 도구를 사용해야 합니다.
명확한 한계는 대상별 비용 구조입니다. 난이도가 낮은 HTTP 대상과 고난도 렌더링 대상에 같은 페이지당 비용을 가정해서는 안 됩니다. 대상과 모드에 따라 URL 목록을 나누고 검증을 통과한 응답 수를 보관하며, 그 조합에 맞춰 약정 요금제를 비교해야 합니다.
접근이 성공해도 추출 요구사항은 직접 책임져야 합니다. 파서에는 올바른 목록 식별자, 필드, 완전성 검사가 필요합니다. 유지보수되는 레코드 API나 Actor가 이미 필요한 데이터셋을 반환한다면, 접근 비용이 더 낮다는 이유만으로 자체 추출 작업을 계속 유지할 가치는 없을 수 있습니다.
- HTTP와 브라우저 요금이 구분되어 대상별 예산을 정확히 잡을 수 있습니다.
- 다섯 난이도 등급이 있어 단일 시작 요금에 가려질 수 있는 비용 차이가 드러납니다.
- 월간 약정별 요금 단계가 공개되어 있습니다.
- API는 렌더링, IP 순환, 지역 지정 기능을 안내합니다.
- 가장 낮게 표시된 요금에는 월간 약정이 필요합니다.
- 브라우저 렌더링은 비용 구조를 크게 바꿀 수 있습니다.
- 고급 기능은 추가 비용이 들 수 있습니다.
- 응답을 받은 뒤에도 파싱과 업무 기준에 따른 검증이 필요합니다.
개발 워크플로에 관리형 접근이 필요하고 대상 구성을 측정할 수 있다면 Zyte를 선택하면 됩니다. 페이지에 표시된 가장 작은 숫자만 보고 구독하기보다 종량제 견적부터 확인해야 합니다.
정기 수집의 실제 월 비용은 얼마일까요?
시작 요금을 비교하기 전에 반복 횟수와 출력 형식부터 계산해야 합니다. 다음과 같은 명시적 계획 예시를 사용합니다. 창업자가 지정된 페이지 120개를 30일 동안 매일 다시 방문하면 총 3,600회입니다. 일반 페이지이며 추가 브라우저 동작, 탐색 호출, 별도 모니터링 엔드포인트 비용, 과금되는 재시도는 없다고 가정합니다. 실제로 측정한 작업이나 대상 사이트 접근을 보장하는 수치가 아니라 예산 계산 예시입니다.
기본 Markdown 스크래핑이면 3,600회 방문에 Firecrawl과 Context.dev 모두 3,600크레딧을 사용합니다. Firecrawl Hobby는 월 $19에 5,000크레딧, Context.dev Developer는 월 $19에 7,500크레딧을 제공합니다. 두 시작 요금제 모두 이 조건의 스크래핑 양을 감당합니다. Firecrawl, Context.dev.
같은 표준 페이지에서 구조화된 JSON 추출이 성공하면 두 서비스 모두 18,000크레딧이 필요합니다. Firecrawl Hobby에서는 $5짜리 1,000크레딧 묶음을 13개 추가해야 하므로 $19 + $65 = 월 $84입니다. Context.dev Developer는 공개된 신규 구독 요금을 적용하면 $2.20짜리 1,000크레딧 묶음 11개를 추가해야 하므로 $19 + $24.20 = 월 $43.20입니다. Context.dev는 묶음 단위로 올림해 구매하므로 계산 후 일부 크레딧이 남습니다.
노코드 모니터링도 실행 빈도를 같은 방식으로 계산해야 합니다. Browse AI에서 표준 페이지 확인 3,600회/월은 더 많은 행이나 프리미엄 대상의 비용을 더하기 전에도 43,200회/년입니다. 이 예시의 작업량은 Professional의 연간 60,000크레딧으로 감당할 수 있지만 Personal의 12,000크레딧으로는 부족합니다. 월 단위 Professional은 $87에 매월 5,000크레딧이며, 연간 Professional은 월 환산 $69에 $828을 선결제합니다. Browse AI.
프록시만 구매한다면 계산 방식이 달라집니다. 측정한 GB 사용량부터 잡고 스크래퍼 호스팅, 추출 작업, 예외 처리 비용을 더해야 합니다. 레코드 API는 전달받은 과금 대상 레코드 수부터, Apify는 선택한 Actor와 리소스 사용량부터 계산합니다. 실제 작업을 측정하지 않은 채 어느 서비스든 페이지당 비용을 보장하는 것처럼 환산해서는 안 됩니다.
상황별로 어떤 툴을 골라야 할까요?
선택 기준은 페이지 본문, 운영 담당자가 맡을 모니터링, 완성된 대상별 레코드, 기존 코드의 사이트 접근 중 무엇이 필요한가입니다. 유료 업그레이드는 지금 부딪힌 한계를 해결해야 합니다. 기능 목록이 더 길다는 이유만으로 비용을 늘려서는 안 됩니다.
크롤링 프로그램은 다음 실패를 누가 복구하는지에 따라 고릅니다
개발팀이 데이터 기능을 맡는다면 필요한 콘텐츠와 메타데이터를 반환하는 API를 추려야 합니다. 운영팀이 스프레드시트 기반 업무를 맡는다면 운영 담당자가 확인할 수 있는 시각적 로봇을 검토해야 합니다. 아직 실패 대응 담당자가 없다면 수집 빈도를 높이기 전에 그 역할부터 배정해야 합니다.
운영 책임이 바뀌면 적합한 툴도 바뀝니다. 개발자에게 스크래핑 API는 제품에 필요한 구성 요소가 될 수 있습니다. 하지만 매일 결과를 받아야 하는 운영 담당자에게 그 결과를 수신할 애플리케이션이 없다면 같은 API가 부적절한 구매일 수 있습니다. 반대로 녹화형 작업은 빠르게 평가할 수 있어도 추출이 제품의 핵심 기능이 되면 불편이 늘어날 수 있습니다.
AI 크롤링에는 스키마와 결과 검증 기준이 필요합니다
추출을 데이터 계약으로 다뤄야 합니다. 가격 레코드라면 상품 식별자, 옵션, 숫자형 금액, 통화, 출처 URL, 수집 시각을 정의합니다. 자동 갱신을 처음 실행하기 전에 누락되거나 모호한 값을 어떻게 처리할지도 정해야 합니다. 깔끔한 JSON 객체는 형식이고, 올바른 업무 레코드인지는 그 계약에 맞춰 판단해야 합니다.
문서를 수집할 때는 출처와 가져온 시각을 보관하고, 필요한 경우 무관하게 반복되는 탐색 메뉴를 제외합니다. 자동 검사에서 페이지가 거절되면 원본 응답도 남겨야 합니다. 이 근거가 있어야 담당자가 사이트 변경과 잘못된 필드 정의를 구분할 수 있습니다.
에이전트용 AI 스크래퍼는 필요한 출력에 따라 선택합니다
페이지 중심의 scrape/crawl/map 워크플로는 Firecrawl부터 검토하면 됩니다. 배치 처리와 웹훅 모니터링의 조합이 애플리케이션에 맞는다면 Context.dev도 후보에 넣습니다. 적합한 Apify Actor가 이미 대상의 필수 필드를 수집한다면 범용 페이지 API와 함께 전체 실행을 평가해야 합니다.
출처 목록을 고정하고 기대하는 출력도 동일하게 맞춘 뒤 선택해야 합니다. 일반 페이지, 렌더링이 필요한 페이지, 목록·상세 관계, 모호한 필드가 있는 페이지를 포함합니다. 시작 요금제의 제공량은 비용 계산 요소이며, 어느 서비스의 데이터가 더 우수하다는 증거는 아닙니다.
Python 개발자의 예약 수집에는 어떤 API가 맞을까요?
Python 워크플로에서는 API를 호출하고 예약 실행, 파싱, 영구 저장, 검증은 자체 애플리케이션에 둘 수 있습니다. 페이지 본문이나 관리형 구조화 추출이 필요하면 Firecrawl 또는 Context.dev를 선택합니다. 파싱은 직접 제어하고 페이지 요청 부분만 교체하려면 ScrapingBee 또는 Zyte가 적합합니다.
제어 범위가 넓어지면 운영 작업도 늘어납니다. 전송 오류, 대상 사이트의 오류 페이지, 필드 누락, 업무 기준에 따라 거절된 레코드를 분명히 구분해야 합니다. 모든 유형을 무작정 재시도해서는 안 됩니다. 같은 요청을 다시 보낸다고 잘못된 추출 규칙이 나아지지는 않습니다.
무료 웹 스크래핑 툴은 정기 제공량부터 확인하세요
Firecrawl과 Context.dev는 각각 매월 1,000크레딧을 안내합니다. Browse AI는 도메인 2개에 걸쳐 월 50크레딧, Apify는 월 $5 상당의 사용량, Bright Data Scraper API는 월 5K레코드를 제공합니다. 필요한 작업이 해당 제공량 안에 들어간다면 작은 평가나 소규모 반복 작업에 사용할 수 있습니다.
표준 페이지 하나를 30일 동안 매일 확인한다면 Browse AI의 50크레딧으로 30회 확인을 감당할 수 있습니다. 프리미엄 대상이 아니고 추출 행 수로 비용이 늘지 않는다는 조건에서 실용적인 무료 모니터링 예시입니다. ScrapingBee의 1,000크레딧과 Zyte의 $5는 체험용이며, Octoparse Free는 로컬에서 실행됩니다. 무료라는 표시보다 이런 차이가 더 중요합니다.
오픈소스로 직접 운영하려면 무엇을 고려해야 할까요?
소스나 인프라 제어가 서비스 운영 부담을 감수할 만한 이유라면 자체 호스팅 가능한 Firecrawl의 핵심 기능을 검토할 수 있습니다. 오픈소스를 사용하면 해당 핵심 기능의 업체 구독료는 없어집니다. 하지만 호스팅, 모니터링, 복구, 다음 실패를 해결할 개발자까지 제공되는 것은 아닙니다.
가장 저렴한 스크래핑 방법이라고 판단하기 전에 Firecrawl 자체 호스팅 가이드에서 직접 맡아야 할 운영 범위를 살펴보세요. 지정된 페이지를 반환하는 엔드포인트만 필요한 작은 제품팀이라면 관리형 시작 요금제를 통해 별도의 인프라 프로젝트를 피할 수 있습니다. 자체 호스팅은 구체적인 제어 요구사항이 있고 운영을 지속할 담당자가 있을 때 선택해야 합니다.
비교 기준과 확인 방법
웹 스크래핑(web scraping) 툴을 비교할 때 용도 적합성, 과금의 투명성, 구매 결정을 바꾸는 한계를 우선했습니다. 원문 작성 과정에서 요금 페이지와 관련 업체 문서를 열어 확인했으며, 수치는 2026년 10월 6일 기준으로 검증했습니다. 비용 예시는 공개 요금과 명시한 작업량 가정으로 계산했습니다. 제품을 직접 사용해 시험한 비교가 아니며, 속도·정확도·성공률 순위를 주장하지 않습니다.
Firecrawl, Bright Data, Browse AI, Context.dev는 이 사이트의 파트너 툴입니다. Apify, ScrapingBee, Octoparse, Zyte는 독립적인 대안으로 포함했습니다. 파트너라는 이유로 운영 담당자의 모니터링에 프록시만 구매하는 것이 적합해지거나, 소프트웨어 기능용 API를 녹화형 로봇으로 대신할 수 있는 것은 아닙니다. 추천은 이러한 역할의 차이를 기준으로 합니다.
실무에서는 필요한 결과물을 반환하는지, 설정과 복구를 누가 맡는지, 어떤 반복 작업에 과금하는지, 할당량과 동시 실행 제한 중 무엇에 먼저 도달하는지, 불완전하거나 거절된 응답을 어떻게 처리하는지 확인해야 합니다. 마켓플레이스가 더 크거나 홍보용 최저가가 더 낮다는 사실만으로는 답할 수 없는 질문입니다.
프레임워크와 브라우저 라이브러리 목록은 순위 후보에서 제외했습니다. 이 글은 반복 실행 서비스, 노코드 워크플로, 접근 인프라를 고르는 독자를 위한 비교이기 때문입니다. 페이지 수집보다 여러 화면을 이동하는 작업의 비중이 크다면 대화형 브라우저 조작을 별도의 요구사항으로 봐야 합니다.
예약 수집을 설정하기 전에 대상 사이트의 이용약관과 robots.txt를 확인하세요.
이런 선택은 피해야 합니다
다른 용도에서 좋은 제품이라도 지금 작업에 맞지 않으면 피해야 합니다. 아래 선택은 구매로 줄이려던 일을 오히려 남길 가능성이 큽니다.
- 무인 클라우드 데이터 공급에 Octoparse Free를 선택하는 경우입니다. 작업은 로컬에서 실행됩니다. 업무에 필요한 클라우드 실행을 구매하거나 적합한 운영 방식의 서비스를 선택해야 합니다.
- 완성된 데이터셋을 기대하며 Bright Data 주거용 프록시를 구매하는 경우입니다. 프록시는 접근을 제공하며 요청, 파싱, 결과 검증은 직접 맡아야 합니다. 레코드를 구매하려는 것이라면 적합한 Scraper API를 사용해야 합니다.
- 빈번하고 큰 규모의 모니터링을 Browse AI Personal의 연간 시작 요금만 보고 선택하는 경우입니다. 연간 12,000크레딧으로는 예시의 연간 43,200크레딧 작업을 감당하지 못합니다. 방문 수, 행 수, 프리미엄 대상, 도메인 수부터 계산해야 합니다.
- Zyte의 $0.06부터라는 문구를 종량제 견적으로 보는 경우입니다. $500 약정 등급의 최저 요금입니다. 약정을 구매하기 전에 실제 대상과 모드의 비용을 추산해야 합니다.
- ScrapingBee의 총 크레딧을 요청 수 보장으로 이해하는 경우입니다. 렌더링과 프록시 설정에 따라 같은 요청에 여러 크레딧이 들 수 있습니다. 작동하는 설정을 기준으로 예산을 잡아야 합니다.
- Firecrawl이나 Context.dev를 완전한 데이터 품질 관리 시스템으로 보는 경우입니다. 두 서비스 모두 사용하면 안 되는 콘텐츠를 반환할 수 있습니다. 상태 코드와 출력 근거를 보관하고 불완전한 갱신으로부터 후속 레코드를 보호해야 합니다.
피해야 할 제품은 대신 맡아줄 것이라 기대했던 부분을 여전히 직접 유지보수하게 만드는 제품입니다. 확신에 찬 종합 순위보다 정확한 역할 구분이 더 유용합니다.
이번 주에 시작할 실행 계획
책임자 한 명을 정하고 작은 규모로 예약 평가를 실행하세요. 대표 URL 열 개를 고르고, 기대하는 필드나 문서 내용을 정의하며, 어떤 응답을 부적합하다고 판단할지 정합니다. 노코드 작업이라면 워크플로를 녹화하고, API라면 스케줄러와 저장소에 연결합니다.
일주일 동안 매일 한 번 실행합니다. 원본 응답, 대상 사이트의 상태 코드, 출력, 소비한 과금 단위, 검증을 통과한 레코드 수를 보관합니다. 페이지네이션, 누락 값, 중복 식별자, 갱신을 일으켜야 하는 변경과 그렇지 않은 변경을 확인합니다.
이후 관찰한 대상 구성을 바탕으로 한 달 전체 비용을 계산합니다. 결과물과 운영 책임 요구사항을 충족하는 가장 단순한 선택지를 고르고, 체험이 끝난 뒤에도 검증 절차를 유지합니다. 첫 요청의 성공보다 유용한 결과가 반복해서 나오는지가 실제 운영에 투입할 기준입니다.
웹 스크래핑에 어떤 툴이 좋을까요?
Firecrawl과 Context.dev는 에이전트용 페이지 콘텐츠에, Browse AI와 Octoparse는 시각적 추출 워크플로에 적합합니다. Bright Data, Zyte, ScrapingBee는 서로 다른 접근·페이지 요청 요구사항을 해결합니다. Apify는 대상에 맞는 Actor가 이미 있을 때 특히 유용합니다. 결과물과 운영 담당자부터 정한 뒤 전체 월 비용을 비교해야 합니다.
ChatGPT로 웹사이트를 스크래핑할 수 있나요?
OpenAI 공식 문서에 설명된 브라우저 기능으로 ChatGPT는 웹사이트를 열고 정보를 수집할 수 있습니다. 이는 대화형 수집 작업에 활용할 수 있습니다. 가격, 목록, 에이전트용 문서를 반복 수집하려면 실행 일정, 출력 스키마, 결과 저장, 실패 대응 담당자를 별도로 검토해야 합니다. 여기서의 선택은 AI 어시스턴트가 페이지를 읽을 수 있느냐보다 어떤 서비스가 반복 워크플로를 제공하느냐입니다.
웹 스크래핑에는 어떤 AI가 가장 적합한가요?
언어 모델을 고르기 전에 추출 서비스와 기대하는 출력을 선택해야 합니다. Markdown이나 구조화된 필드가 필요하면 Firecrawl과 Context.dev를 검토하고, 운영 담당자가 관리할 로봇에는 Browse AI가 적합합니다. 대표 출처에서 필요한 정보를 반환하면서 전체 비용도 적절한 선택지가 가장 잘 맞습니다.
웹 스크래핑은 이제 낡은 방식인가요?
먼저 대상 사이트가 적합한 API나 피드를 제공하는지 확인해야 합니다. 필요한 정보가 페이지로만 공개된다면 추출은 여전히 선택지가 됩니다. 구매 시 중요한 구분은 제품이 AI를 내세우는지가 아니라 페이지 요청, 추출, 예약 실행, 검증을 누가 맡는지입니다.
웹 스크래핑 툴 상위 10개는 무엇인가요?
이 글은 에이전트 데이터, 노코드 모니터링, 대규모 접근이라는 세 가지 반복 작업에 맞춰 여덟 제품을 비교합니다. 열 개를 채우려고 툴을 추가하기보다 해당 용도 안에서 선택해야 합니다. 브라우저 자동화 프로젝트나 자체 호스팅 프레임워크는 여기서 비교한 서비스와 다른 운영 책임을 요구합니다.
뉴스레터에서 AI Business Workflow Audit Checklist를 받아보세요. 웹 데이터 워크플로를 도입하기 전에 결과물, 일정, 결과 검증 규칙, 운영 담당자를 정리할 수 있습니다.
- 마지막 업데이트
- 2026년 10월 6일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

에이전트 메모리(agent memory) 설계: 상태 저장부터 비용 계산까지
에이전트 메모리(agent memory)는 무엇을 저장해야 할까요? 컨텍스트, 세션 상태, 장기 저장소, 파일·스킬을 구분하고 Claude·OpenAI·Google의 기능과 비용을 비교합니다. 월간 비용 계산과 오래된 사실 수정, 사용자 간 정보 유출과 메모리 오염의 해법을 설명합니다.2026년 10월 5일Build
Pinecone 가격 가이드: 요금제별 한도와 검색 범위에 따른 비용
Pinecone 가격을 Starter·Builder·Standard·Enterprise 요금제별로 정리합니다. 1M부터 100M 벡터의 저장·검색 비용과 네임스페이스 분리에 따른 차이, 무료 한도, 초기 적재와 추가 과금까지 살펴보고 실제 워크로드에 맞는 월 예산을 계산하세요.2026년 10월 5일Build
바이브 코딩 툴 비교(2026): Lovable 대안, 비용과 백엔드로 고르는 법
Lovable 대안을 찾고 있다면 구독료만 비교해서는 안 됩니다. Replit, Emergent, Blink, Bolt.new, Base44, v0, Whacka의 가격과 크레딧, 백엔드, 코드 내보내기를 비교하고, 기존 앱을 옮길 때 확인할 운영비와 마이그레이션 기준을 살펴봅니다.2026년 10월 5일Build
LLM observability 툴 비교: 2026년 팀 규모별 비용과 선택 기준
LLM observability 툴을 팀 규모별로 비교합니다. 월 100,000회 실행을 기준으로 Langfuse, LangSmith, Helicone, Phoenix, Braintrust, Datadog의 비용과 무료 한도, 셀프 호스팅, OpenTelemetry 지원을 살펴봅니다.2026년 10월 5일Build
OpenCode 사용법: 설치부터 첫 버그 수정과 비용 확인까지
OpenCode 사용법을 실제 버그 수정 흐름으로 익힙니다. 설치와 기존 구독·API 키 연결, Ollama 로컬 모델 설정부터 AGENTS.md, 플러그인, Zen 비용까지 살펴보고, 계획·테스트·diff 검토로 첫 작업을 마무리하는 방법과 모델 사용료 계산 기준을 안내합니다.2026년 10월 4일Build
Netlify 무료 제한과 유료 요금: 크레딧으로 계산하는 월 비용 (2026)
Netlify 무료 제한은 어디까지일까요? Free·Personal·Pro의 월 요금과 크레딧 한도를 비교하고, 마케팅 사이트·Next.js 앱·고객 사이트를 운영하는 에이전시의 월 비용을 계산합니다. 추가 충전, 사이트 일시 중지, 크레딧 이월 조건까지 함께 확인하세요.2026년 10월 4일Build
Softr 리뷰: 고객 포털·사내 툴에 맞는 요금제 고르기
Softr로 고객 포털과 사내 툴을 만들기 전 확인할 요금과 권한을 정리했습니다. 월·연 결제 가격, Team·Client 사용자 과금, 레코드 한도, AI 기능과 데이터 연동 조건을 비교하고 업무에 맞는 요금제를 고릅니다. 2026년 10월 4일 확인한 공개 자료 기준 리뷰입니다.2026년 10월 4일Build