Firecrawl 대안 7선: 실전 웹 크롤러 비용·기능 비교
Firecrawl 대안 7종을 웹 크롤러 기능, Markdown·JSON 출력, 검수 통과 페이지 비용, 이전 난이도로 비교합니다. Apify, Crawl4AI, ScrapFly 등 팀의 URL 탐색 범위와 운영 방식에 맞는 선택 기준을 한눈에 확인하세요.




Firecrawl을 대신할 웹 크롤러는 검수 통과 페이지가 10,000개일 때부터 비용 차이가 선명해집니다. 이 모델에서 Firecrawl은 벤더 비용 $83에 운영자 작업 세 시간이 들고, ScrapFly는 $30에 세 시간이 듭니다. 하지만 청구액이 낮다고 항상 더 저렴한 대안은 아닙니다. URL 탐색, 렌더링 재시도, JSON 추출, 후속 청킹 비용이 그 차이를 없앨 수 있기 때문입니다.
핵심 답변: Firecrawl 교체는 파이프라인 교체입니다
폭넓은 관리형 대안이 필요하면 Apify Website Content Crawler, 인프라 통제가 핵심이면 Crawl4AI, 크롤링과 구조화 추출을 하나의 크레딧 풀로 처리하려면 ScrapFly, URL 목록을 이미 다른 시스템에서 제공한다면 Jina Reader를 선택하는 편이 좋습니다. ScrapingBee, Zyte API, Bright Data Crawl API는 사이트를 Markdown으로 바꾸는 기본 워크플로보다 접근이 까다로운 페이지를 확보하는 일이 더 중요할 때 강해집니다.
비용을 계산할 때 봐야 할 단위는 요청 수도, 발견한 URL 수도 아닙니다. 검색 증강 생성 파이프라인까지 도달한 ‘검수 통과 페이지’가 기준입니다. 즉, 필요한 Markdown과 JSON 필드, 링크, 메타데이터가 온전히 남아 모델이 쓸 수 있는 원문을 받아야 합니다. 표가 사라지거나 비어 있는 가격 필드를 지어내고 청커까지 망가뜨린 저가 응답은 결국 비용을 낸 실패입니다.
비교 기준이 되는 Firecrawl
Firecrawl을 기준점으로 삼는 이유는 Crawl 엔드포인트 하나에 URL 탐색, 렌더링, 페이지 처리가 묶여 있고 결과를 Markdown 또는 스키마에 맞춘 JSON으로 반환하기 때문입니다. 크롤링한 페이지당 1크레딧, JSON 모드에 추가로 4크레딧이 부과되므로 이 비교의 기준은 시도한 페이지당 5크레딧입니다.
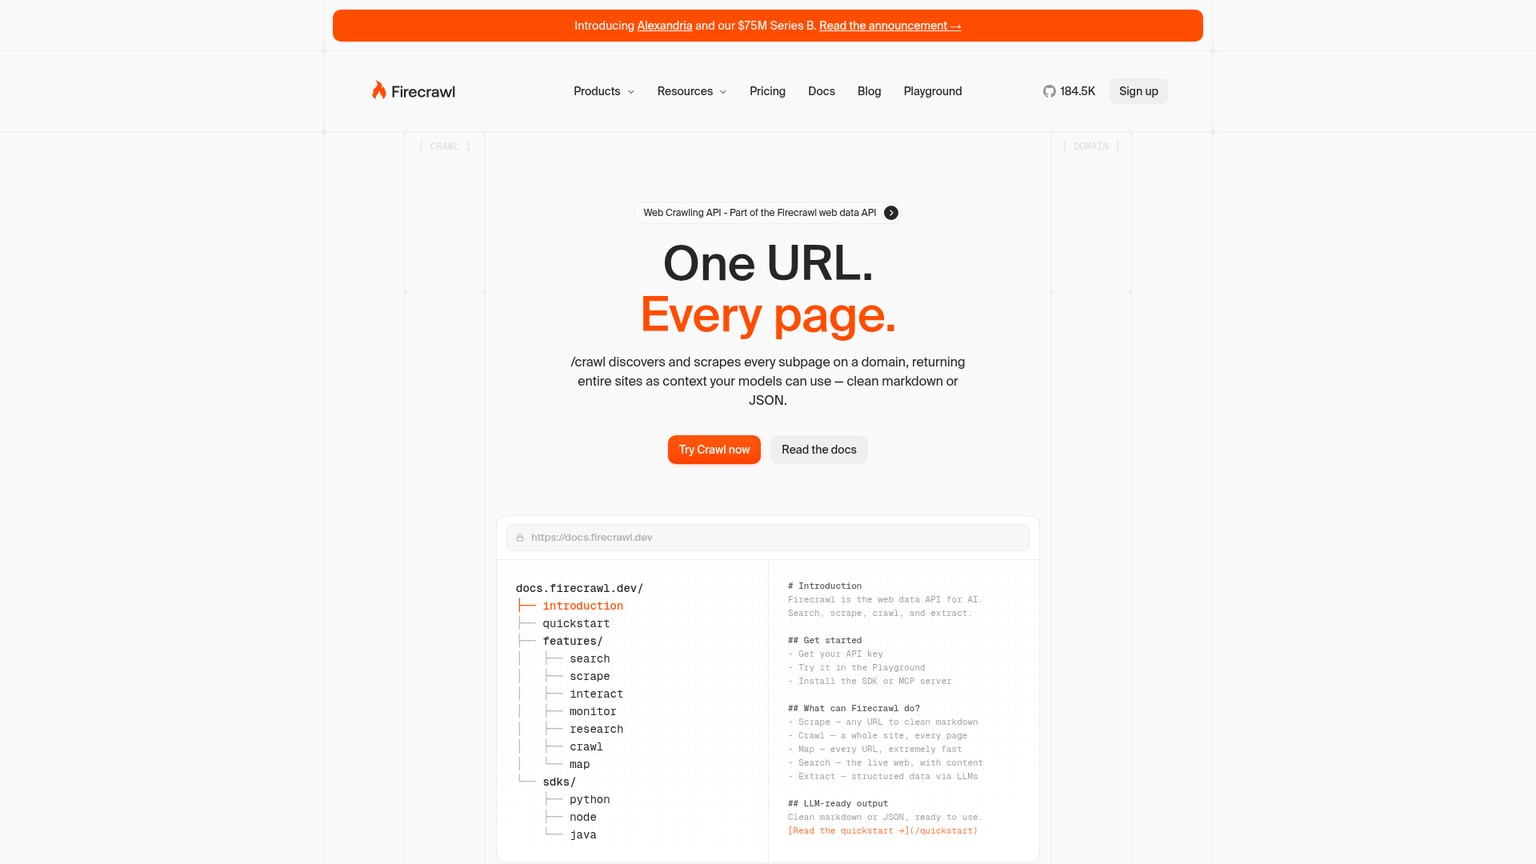
이처럼 여러 단계가 한데 묶여 있어 겉보기에는 더 저렴한 대안보다 Firecrawl을 유지하는 편이 나을 수 있습니다. Firecrawl은 크롤 범위, 서브도메인, 경로, 깊이, 페이지 스트리밍 전달도 처리합니다. Reader API는 URL당 비용이 더 낮아도 URL 탐색은 팀의 몫일 수 있고, 접근 API는 보호된 페이지를 가져오더라도 Markdown 변환과 스키마 정규화를 후속 단계에 남길 수 있습니다.
검수 통과 페이지 기준으로 본 Firecrawl 요금
현재 Firecrawl 요금제는 1,000크레딧을 제공하는 Free $0, 연간 결제 기준 5,000크레딧의 Hobby 월 $16, 100,000크레딧의 Standard $83, 500,000크레딧의 Growth $333, 1,000,000크레딧의 Scale $599, 맞춤형 Enterprise로 구성됩니다. 초과 사용료는 Hobby가 1,500크레딧당 $9, Standard가 35,000크레딧당 $47, Growth가 175,000크레딧당 $177, Scale이 350,000크레딧당 $397입니다. 이 가격과 한도, 크롤 기능은 2026년 9월 25일 Firecrawl Crawl 최신 페이지에서 확인했습니다.
벤더가 성공으로 처리했지만 로컬 검수 게이트를 통과하지 못하는 응답에 10%의 여유분을 두면, Markdown과 JSON을 모두 갖춘 검수 통과 페이지 1,000개에는 5,500크레딧이 필요합니다. Hobby에 초과 사용 블록 하나를 더하면 $25입니다. 만 개에는 55,000크레딧이 필요하므로 Standard $83, 십만 개에는 550,000크레딧이 필요하므로 Growth와 초과 사용 블록 하나를 합쳐 $510입니다.
검색은 별도 계층입니다. 쿼리에서 작업이 시작되고 이미 아는 사이트나 URL 목록이 아니라 순위화된 출처가 필요하다면, 먼저 AI 검색 API 비교에서 검색 계층을 결정한 뒤 선택한 URL을 추출 계층으로 넘기십시오.
Firecrawl 대안 웹 크롤러 한눈에 비교하기
아래 표는 문서에 명시된 적합성을 평가한 것이며, 실제 출력 품질을 측정한 결과가 아닙니다. 가격은 2026년 9월 25일 각 회사의 공식 페이지에서 확인했습니다. 벤더가 상시 무료 사용량을 제공하는 경우도 ‘무료 체험’에 포함했습니다.
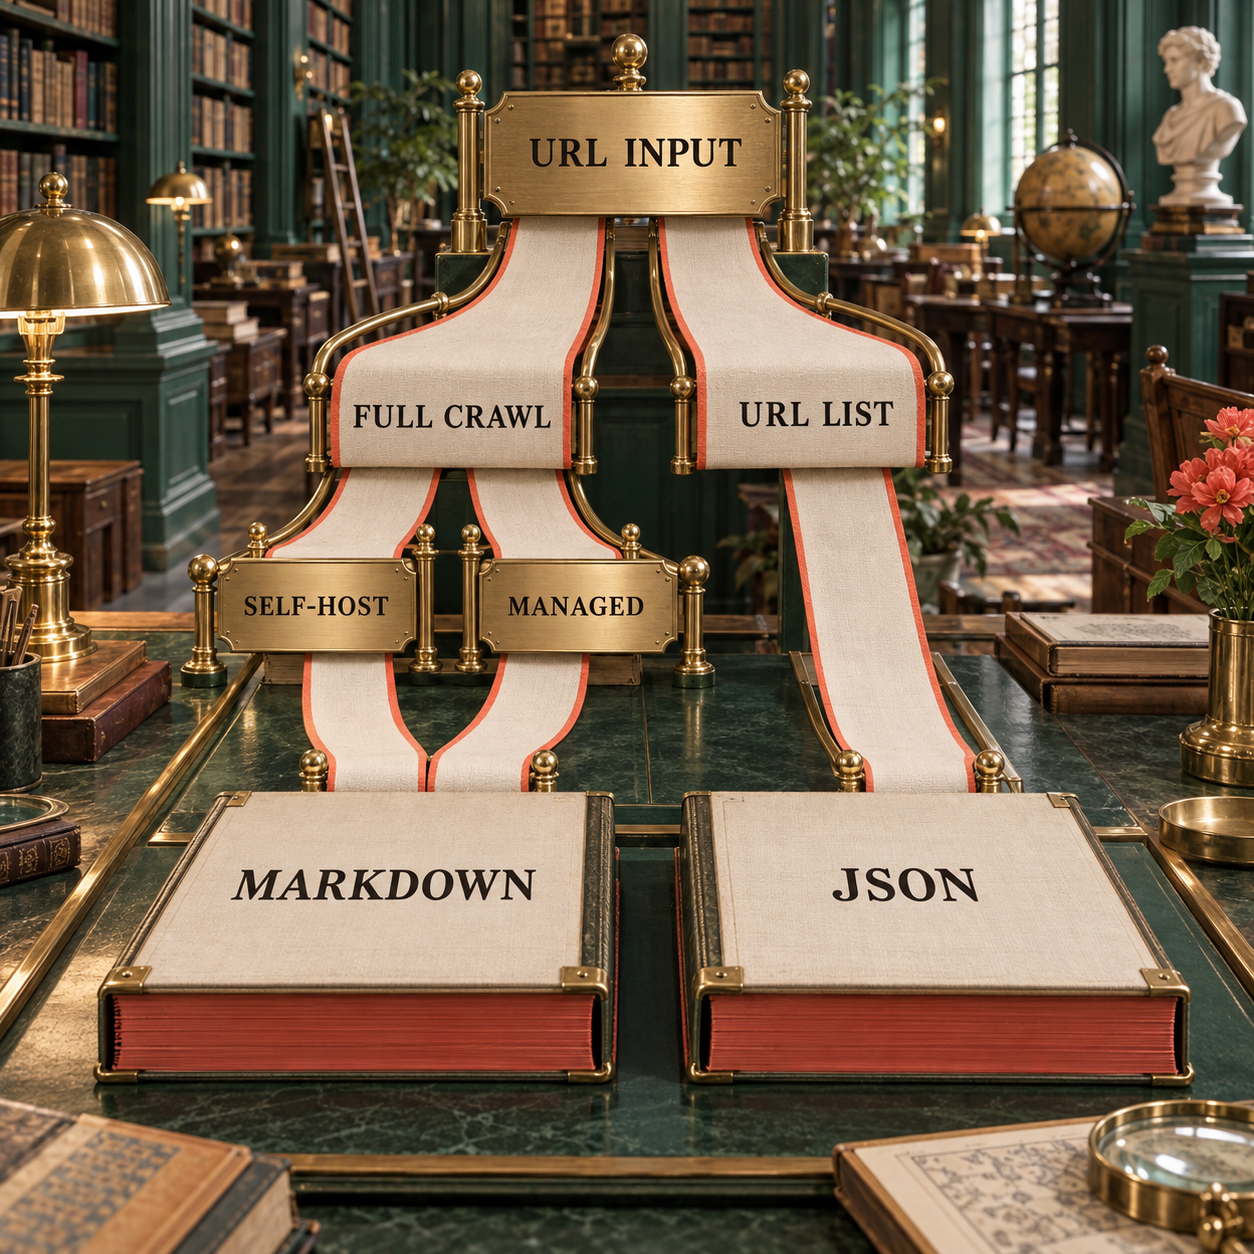
‘웹 추출’이라는 말 안에는 서로 다른 세 가지 제품이 들어가므로 모든 상황에서 이기는 하나의 툴은 없습니다. 크롤러는 사이트를 탐색하고, Reader는 전달받은 URL을 변환하며, 접근 계층은 렌더링이나 차단을 뚫습니다. 팀이 직접 운영하고 싶지 않은 단계를 빠짐없이 맡으면서도 범위가 가장 좁은 제품을 선택해야 합니다.
선정 기준
현재 공개된 공식 자료에서 유용한 페이지 콘텐츠와 기계 판독 가능한 출력으로 이어지는 신뢰할 만한 경로를 모두 확인할 수 있는 후보만 포함했습니다. 검색 전용 API는 순위 기반 URL 탐색 서비스일 뿐 크롤러를 대체하지 못하므로 제외했습니다. 프록시 전용 서비스도 IP만 제공할 뿐 깨끗한 Markdown, 필수 JSON, 저장 가능한 크롤 매니페스트를 만들지 못해 제외했습니다.
비교 기준은 다음 다섯 가지 검수 항목입니다.
- 탐색: 사이트를 순회하고 범위를 지키며 정규 URL 매니페스트를 남길 수 있습니까, 아니면 다른 구성 요소가 모든 URL을 제공해야 합니까?
- 렌더링과 접근: JavaScript를 실행하고, 비용이 무한히 늘어나는 재시도 없이 해당 사이트의 접근 조건을 처리할 수 있습니까?
- 출력 계약: Markdown에서 제목, 표, 코드, 링크를 보존합니까? 또 불투명한 두 번째 변환 없이 필수 JSON 필드를 채울 수 있습니까?
- 증거: 각 테스트 URL마다 요청, 원본 응답, 정규화된 출력, 헤더, 설정, 콘텐츠 해시, 판정을 저장할 수 있습니까?
- 총비용: 탐색, 렌더링, 추출, 성공했지만 거부된 응답의 재시도, 최소 약정, 운영자 시간에 얼마가 듭니까?
이 글을 위해 후보를 직접 실행하지는 않았습니다. 따라서 통과율이나 지연 시간 순위를 주장하지 않습니다. 아래의 품질 관련 설명은 모두 문서로 확인한 기능이며, 비용 비교는 가정을 공개한 모델입니다.
고정된 20개 URL 검수 세트
벤더가 준비한 데모 URL만 보고 이전을 결정해서는 안 됩니다. 기존 설정과 새 설정에 같은 고정 검수 세트를 적용하고 모든 응답을 저장하십시오. 서로 다른 실패를 드러내도록 다음과 같이 콘텐츠 유형을 섞었습니다.
- 코드와 긴 문서: MDN Fetch API, Python 클래스, Rust 소유권, RFC 9110 HTML, HTTPBin HTML.
- 표, 링크, 구조화 페이지: MDN table 레퍼런스, W3C table 튜토리얼, Wikipedia 웹 스크래핑, Books to Scrape 카탈로그, 고정된 상품 페이지 하나.
- 페이지네이션과 JavaScript: Quotes to Scrape, JavaScript 경로, 스크롤 경로, MDN JavaScript 가이드, HTTPBin 링크 정규화.
- 인코딩과 PDF: HTTPBin Unicode, RFC 9110 PDF, 두 단으로 구성된 연구 PDF, 최소 구성 W3C PDF, IRS Form W-9.
모든 결과에는 source_url, final_url, title, markdown, links, status_code, fetched_at, content_sha256가 있어야 합니다. 상품 페이지에는 entity_name, amount, currency가 추가로 필요하고, 연구 PDF에는 published_at이 필요합니다. 검수 세트 매니페스트에서 허용한 경우에만 필드를 명시적으로 null로 둘 수 있습니다. 누락과 null은 같지 않습니다.
툴, 버전, 설정 조합마다 디렉터리 하나를 만들어 저장하십시오. 각 URL에 대해 request.json, 응답 헤더, 수정하지 않은 본문, normalized.json, verdict.json, SHA-256 다이제스트를 보관합니다. 판정에는 pass: false만 적지 말고 처음 실패한 규칙을 밝혀야 합니다. 그래야 벤더나 파서, 페이지가 바뀐 뒤에도 다른 엔지니어가 판단을 재현할 수 있습니다.
검수 통과 페이지 비용 계산표
이 모델은 월 1,000개, 10,000개, 100,000개의 검수 통과 페이지를 기준으로 하며, 벤더는 성공으로 처리했지만 로컬 스키마 또는 Markdown 게이트가 거부한 응답에 대비해 10%를 추가합니다. 이 응답들은 비용이 청구되는 재시도입니다. 명시적인 벤더 실패는 각 벤더가 공개한 환불 정책에 따라 처리합니다.
기본 공식은 단순합니다. 벤더 또는 호스트에 내는 비용에 탐색, 렌더링, 추출, 유료 재시도 비용을 더하고, 운영자 시간에 팀의 제반 비용 포함 시간당 인건비를 곱해 합산합니다. 아래 표는 벤더 현금 비용과 작업 시간을 분리해 표시하므로 모든 벤더 공식을 다시 만들지 않고도 시간당 $100이라는 가정을 바꿀 수 있습니다.
운영자 시간당 $100을 적용하면 10,000페이지 총비용은 Firecrawl $383, Apify $419, Crawl4AI $1,248, ScrapFly $330, Jina $401.10, ScrapingBee $449, Zyte $555.22, Bright Data $516.50입니다. Jina 수치는 신뢰할 수 있는 URL 매니페스트가 이미 있을 때만 유효하며, 전체 사이트 크롤 비용이 아닙니다. Bright Data와 Zyte는 이 비교에서 사용하는 네이티브 Markdown 출력 계약을 제품 페이지에 명시하지 않으므로 작업 시간에 후속 Markdown 변환과 스키마 작업을 포함했습니다.
추출 비용 항목은 의도적으로 분리했습니다. Firecrawl은 크롤 1크레딧에 JSON 4크레딧을 사용합니다. 이 시나리오에서 ScrapingBee는 JavaScript 5크레딧에 AI 5크레딧을, ScrapFly는 브라우저 또는 Unblocker 5크레딧에 추출 모델 5크레딧을 사용합니다. Zyte는 티어 3 브라우저 가격에 고정형 맞춤 속성 추출 한 번을 더합니다. Apify는 결정론적 JSON 구조를 사용하고, 공식 상한 추정치를 적용한 원시 HTTP 페이지 80%와 헤드리스 페이지 20%로 계산했습니다. 선택형 AI 요약은 포함하지 않았습니다.
Jina는 시도당 출력 토큰 2,000개를 million당 $0.050의 요율로 사용한다고 가정합니다. 소비 가치는 매우 낮지만 현금 흐름은 큰 단위로 움직입니다. 무료 토큰 10 million개를 소진하면 가장 작은 충전 상품도 토큰 1 billion개에 $50입니다. Crawl4AI는 세 처리량 구간에서 DigitalOcean 호스트 비용을 각각 $24, $48, $96으로 가정했지만, 이는 용량을 측정한 결과가 아니라 계획을 위한 입력값입니다.
1. Apify Website Content Crawler: 가장 폭넓은 관리형 대안
Apify Website Content Crawler는 탐색, JavaScript 렌더링, Markdown, 영속 데이터셋을 하나의 서비스에서 필요로 하는 팀에 가장 폭넓은 관리형 대안입니다. 원시 HTTP 또는 헤드리스 Firefox로 크롤링하고 각 결과를 데이터셋 레코드로 저장한 뒤 JSON이나 CSV로 내보냅니다. API가 같다고 가장하지 않으면서도 Firecrawl과 유사한 형태로 이전할 수 있습니다.
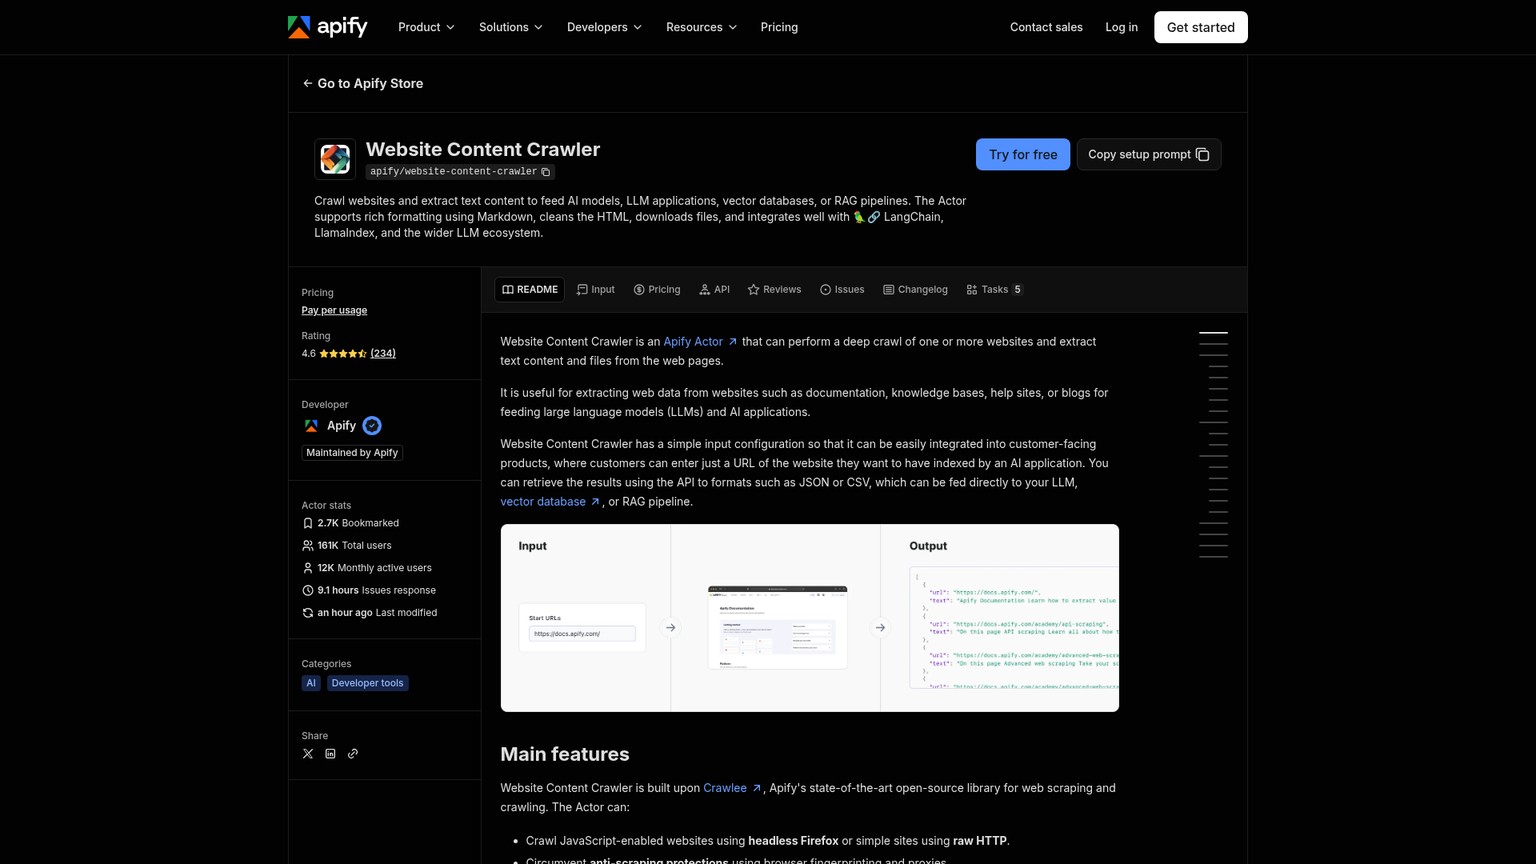
가장 뚜렷한 장점은 크롤을 하나의 작업으로 제어할 수 있다는 점입니다. 범위, 출력, 저장된 데이터셋 레코드를 함께 관리하고 PDF 같은 파일도 내려받을 수 있습니다. 분명한 한계는 의미 기반 추출입니다. Actor의 JSON 데이터셋은 텍스트, Markdown, 메타데이터를 담은 구조화 봉투이지만, 비즈니스용 맞춤 스키마를 만들려면 결정론적 규칙이나 다른 Actor 또는 모델 단계가 여전히 필요합니다.
Actor가 공개한 추정치는 명시된 기준에서 원시 HTTP 페이지 1,000개당 약 $0.20, 헤드리스 페이지 1,000개당 $0.50~$5입니다. 선택형 AI 요약은 페이지 1,000개당 약 $2~$3를 더하며, 제목이 없는 페이지는 1,000개당 약 $7까지 올라갑니다. 필수 JSON 필드를 요약으로 대체할 수 없으므로 위 모델에서는 이 부가 기능을 제외했습니다.
Apify 요금제는 매월 $5 사용량과 동시 실행 5개를 제공하는 Free $0, $19 사용량과 동시 실행 32개의 Starter $19, $199 사용량·컴퓨트 유닛 $0.16·동시 실행 128개의 Scale $199, $999 사용량·컴퓨트 유닛 $0.13·동시 실행 256개의 Business $999, 맞춤형 Enterprise입니다. Free는 사용량이 소진되면 중단됩니다. 유료 요금제는 초과 사용으로 계속되며, 남은 사용량은 이월되지 않습니다. 이 플랫폼 조건은 Apify 최신 가격 페이지를 기준으로 했습니다.
추천 대상: 관리형 크롤 작업을 교체하려는 소규모 제품 또는 데이터 팀. 특히 실행 이력과 데이터셋 내보내기가 중요할 때 적합합니다.
핵심 강점: 전체 사이트 탐색, 브라우저 렌더링, Markdown, 영속 JSON 데이터셋 레코드를 하나의 관리형 실행에서 처리합니다.
가격: Free $0, Starter $19, Scale $199, Business $999, Enterprise 맞춤형. 실제 Actor 비용에는 실행에 사용한 컴퓨트, 스토리지, 프록시, 전송량도 포함됩니다.
무료 체험: 상시 제공되는 Free 요금제에 카드 등록 없이 월 $5의 플랫폼 사용량이 포함됩니다.
- 원시 HTTP와 헤드리스 Firefox로 저렴한 정적 페이지와 JavaScript 페이지를 모두 처리할 수 있습니다.
- 데이터셋 레코드 덕분에 저장된 응답을 검토하고 내보내기 쉽습니다.
- 크롤 범위, 파일 다운로드, 메타데이터, Markdown을 하나의 관리형 작업에서 다룹니다.
- 플랫폼 청구액이 단일 페이지 크레딧이 아니라 컴퓨트, 스토리지, 전송량, 프록시 사용량에 걸쳐 나뉩니다.
- JSON 데이터셋 레코드가 곧바로 후속 코드에서 요구하는 비즈니스 스키마가 되는 것은 아닙니다.
- AI 요약은 별도 Actor 비용이 들며 추출 검수 통과를 보장하지도 않습니다.
다섯 단계로 진행하는 Apify 이전 테스트
고정 URL 매니페스트 불러오기
프로덕션 도메인 전체가 아니라 검수용 URL 20개로 시작합니다. Actor 입력값, 크롤러 유형, 페이지 한도, 범위를 고정해 두 번째 실행도 같은 조건을 뜻하도록 만드십시오.
브라우저가 꼭 필요하다고 확인되기 전에는 원시 HTTP 사용하기
정적 페이지에는 저렴한 경로를 유지하고 JavaScript 검수 페이지만 헤드리스 렌더링으로 보냅니다. 각 결과와 함께 선택한 크롤러 모드를 저장하십시오.
Markdown과 데이터셋 레코드 내보내기
수정하지 않은
markdown, 정규 URL, 메타데이터, 링크를 보존합니다. 그 레코드를 별도의 결정론적 단계에서 필요한 로컬 JSON 스키마로 변환하십시오.청킹 전에 거부하기
정규화한 레코드에 표, 코드, 링크, 필수 필드 검사를 적용합니다. 규칙 하나라도 실패하면 해당 URL을 벡터 인덱스가 아니라 재시도 원장으로 보냅니다.
검수 통과 페이지만 기준으로 가격 계산하기
Actor, 프록시, 스토리지, 운영자 비용 전체를 검수 통과 페이지 수로 나눕니다. 크롤 범위를 늘리기 전에 그 결과를 Firecrawl 기준값과 비교하십시오.
2. Crawl4AI: 셀프 호스팅에 가장 적합한 대안
인프라 소유권, 데이터 경계, 재사용 가능한 추출 규칙이 필수 조건이라면 Crawl4AI가 가장 적합한 셀프 호스팅 선택지입니다. Markdown을 만들고 CSS, XPath 또는 LLM 전략을 이용한 구조화 추출을 지원하므로 요청당 소프트웨어 비용 없이 검색용 텍스트와 JSON 필드를 모두 처리할 수 있습니다.
지금은 라이선스 가격보다 보안상 최소 버전이 더 중요합니다. 0.9.4는 2026년 9월 23일에 출시됐으며, 서버 측 요청 위조 경로 두 개와 환경값을 노출할 수 있는 설정 신뢰 경계 결함을 포함한 보안 권고 세 건을 수정했습니다. API를 외부에 노출하기 전에 v0.9.4 이상으로 버전을 고정하고 프로젝트 보안 공지를 검토해야 합니다.
Crawl4AI와 Firecrawl의 차이
Firecrawl은 관리형 큐, 브라우저, 크레딧, 결과 전달, 지원까지 크롤을 둘러싼 운영 서비스를 판매합니다. Crawl4AI는 크롤러와 추출 시스템을 제공하고 배포, 업그레이드, 관측 가능성, 프록시 전략, 장애 대응은 팀이 맡습니다. 이 책임들이 이미 공용 플랫폼 역량으로 갖춰진 팀이라면 선택이 뒤집힐 수 있지만, 엔지니어 한 명이 이 프로젝트만을 위해 전부 새로 만들어야 하는 상황이라면 그렇지 않습니다.
셀프 호스팅 권장 사양은 최소 4 GB RAM, Docker 20.10 이상, Compose 2.24 이상입니다. 비용 계산표는 DigitalOcean의 현재 Basic Droplet 가격을 사용해 4 GiB는 $24, 8 GiB는 $48, 16 GiB는 $96으로 잡았습니다. 이 규격은 시나리오 입력값일 뿐이며, 이번 작업에서 페이지 처리량을 측정하지는 않았습니다.
추천 대상: 기존 컨테이너 플랫폼과 엄격한 데이터 경계를 갖추고 크롤러 운영을 책임질 엔지니어가 있는 팀.
핵심 강점: 오픈소스 통제권과 결정론적인 CSS 또는 XPath 추출 스키마를 결합해 페이지별 모델 비용을 피할 수 있습니다.
가격: 소프트웨어 라이선스 $0. 이 모델은 월 $24, $48, $96의 호스트에 필요에 따라 프록시, 스토리지, 모니터링, 모델 호출, 인건비를 더합니다.
무료 체험: 소프트웨어는 오픈소스이며 인프라는 포함되지 않습니다.
- 팀이 통제하는 인프라 안에서 Markdown 생성과 구조화 추출을 실행합니다.
- CSS와 XPath 스키마를 쓰면 구조가 안정적인 사이트를 저렴하고 결정론적으로 처리할 수 있습니다.
- 이제 프로젝트의 셀프 호스팅 서버는 인증을 사용하고 루프백을 안전하게 다루는 설정이 기본값입니다.
- 프록시 평판, 브라우저 용량, 패치, 큐, 복구가 모두 팀의 책임이 됩니다.
- 실제 실행 기록 없이는 호스트 크기만으로 검수 통과 페이지 처리량을 알 수 없습니다.
- LLM 추출을 사용하면 모델 토큰 비용과 데이터 경계 검토가 별도 제공자 또는 로컬 모델로 이동합니다.
Firecrawl 셀프 호스팅 가이드는 Firecrawl 저장소와 Firecrawl Cloud 사이의 별도 선택을 다룹니다. 같은 계산표에 패치와 가용성을 책임지는 사람의 비용까지 넣기 전에는 Crawl4AI의 $0 라이선스를 절감액으로 계산하지 마십시오.
3. ScrapFly: 소규모 팀의 크롤링·추출 통합 대안
하나의 계정으로 접근, 크롤링, Markdown 변환, 타입이 지정된 추출까지 처리하려는 소규모 팀에는 ScrapFly가 가장 강력한 대안입니다. 여러 제품이 하나의 크레딧 풀을 공유하며, 추출 계층은 HTML, Markdown, XML, JSON, CSV, RSS, 일반 텍스트를 받습니다. 별도 벤더를 이어 붙이지 않고 결정론적 템플릿, 사전 학습 모델, JSON 스키마 프롬프트를 선택할 수 있습니다.
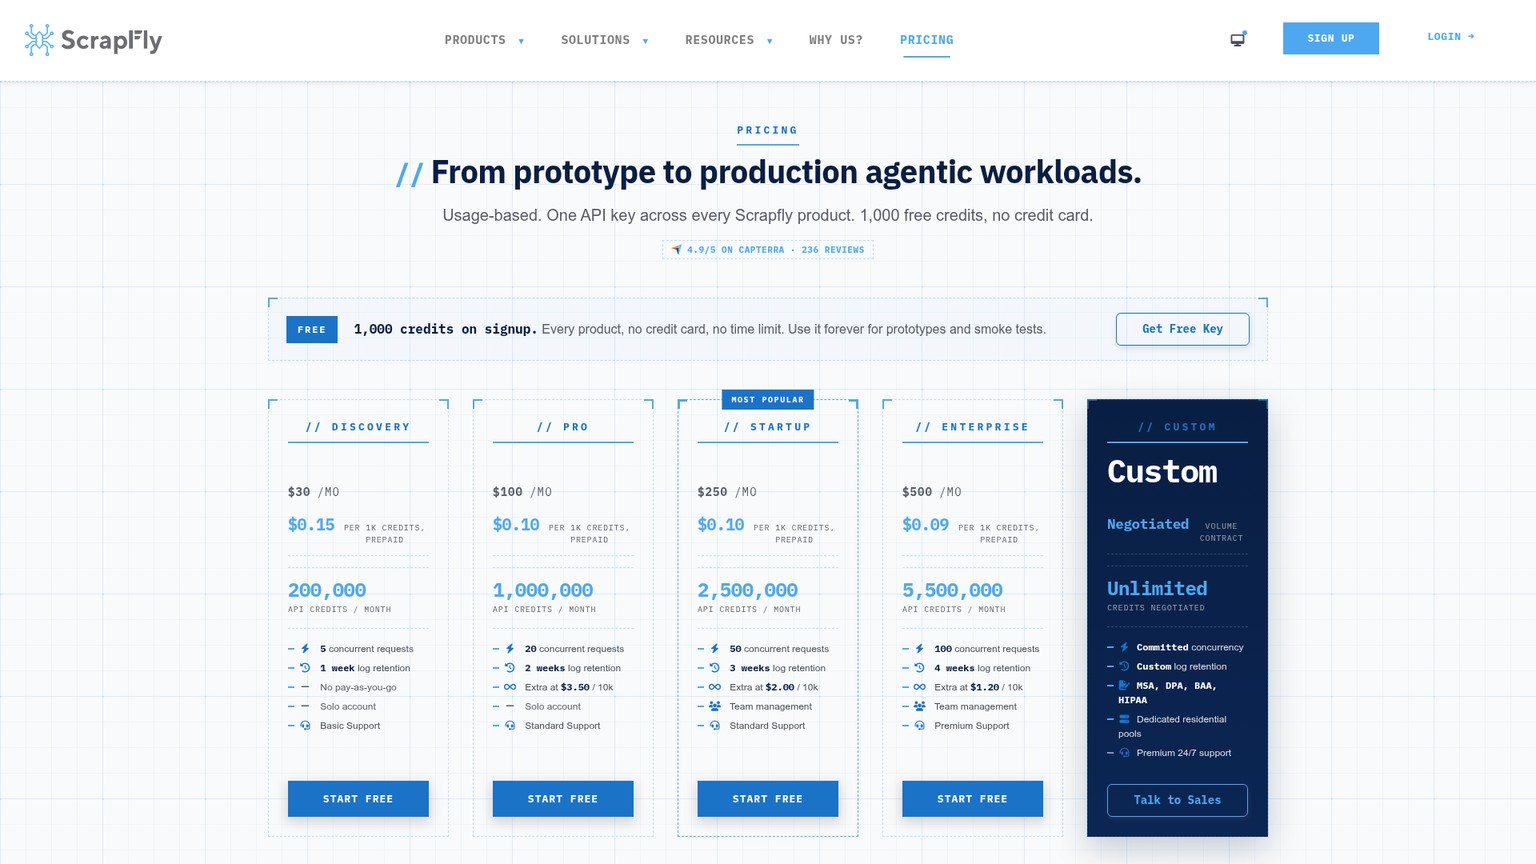
설정을 고정하면 크레딧 모델은 이해하기 쉽습니다. 단순 데이터센터 HTTP 요청은 1크레딧, JavaScript 렌더링 또는 Unblocker는 5크레딧, 주거용 라우팅은 25크레딧, 전체 페이지 스크린샷은 60크레딧입니다. 템플릿 추출에는 1크레딧이 추가되고, 추출 프롬프트나 모델에는 5크레딧이 듭니다. 500 KB를 넘는 문서는 500 KB가 추가될 때마다 추출 기본 요금이 반복 부과됩니다.
따라서 이 글의 시나리오는 성공한 시도당 10크레딧입니다. 브라우저 또는 Unblocker 5크레딧에 추출 5크레딧을 더한 값입니다. 재시도 여유분 10%를 적용하면 검수 통과 페이지당 11크레딧이 됩니다. 이 모델에는 주거용 라우팅을 넣지 않았으므로 이를 요구하는 대상이라면 결과가 크게 달라집니다.
현재 요금제는 일회성 1,000크레딧을 주는 Free, 월 $30에 200,000크레딧과 동시 요청 5개를 제공하는 Discovery, $100에 1,000,000크레딧과 동시 요청 20개의 Pro, $250에 2,500,000크레딧과 동시 요청 50개의 Startup, $500에 5,500,000크레딧과 동시 요청 100개의 Enterprise, 협의형 Custom입니다. Discovery는 할당량을 소진하면 중단됩니다. Pro 초과 사용료는 10,000크레딧당 $3.50, Startup은 $2, Enterprise는 $1.20입니다. 남은 크레딧은 이월되지 않습니다. 이 조건은 ScrapFly 최신 가격을 기준으로 했습니다.
추천 대상: 하나의 청구서로 관리형 크롤러, 접근 제어, 타입 지정 추출을 이용하려는 소규모 팀.
핵심 강점: 같은 크레딧 풀로 크롤러, 브라우저, Unblocker, 세 가지 추출 전략에 비용을 지불할 수 있습니다.
가격: Free 1,000크레딧, Discovery $30, Pro $100, Startup $250, Enterprise $500, Custom 협의형.
무료 체험: 가입 시 카드 등록과 명시된 만료일 없이 1,000크레딧을 제공합니다.
- 템플릿이 안정적인 레이아웃에서는 모델 비용을 줄일 수 있습니다.
- 사전 학습 및 프롬프트 기반 추출로 별도 모델 벤더 없이 타입이 지정된 JSON을 반환합니다.
- 실패한 요청에는 크레딧을 부과하지 않으며, 응답에서 소비한 크레딧을 확인할 수 있습니다.
- 어려운 페이지에서는 브라우저, 주거용 라우팅, 추출 옵션의 비용이 빠르게 누적됩니다.
- 500 KB를 넘는 문서는 추출 요금이 배수로 늘어납니다.
- Discovery에는 초과 사용이 없으므로 프로덕션 작업에는 Pro가 필요하거나 할당량 소진 전에 확실히 중단해야 합니다.
이 시나리오에서 검수 통과 페이지 10,000개를 처리할 때 계산표상 최저 비용은 ScrapFly입니다. $30에 운영자 작업 세 시간으로, Firecrawl의 $83과 세 시간보다 저렴합니다. 그러나 월 현금 차이 $53만으로 허술한 이전을 정당화할 수는 없습니다. 고정 검수 세트를 통과하고, 프로덕션 대상이 25크레딧의 주거용 경로를 피하며, 스키마에 추가 정리가 필요 없을 때만 설득력이 생깁니다.
4. URL 목록이 이미 있다면 Jina Reader
URL 탐색이 이미 해결돼 있고 전달된 각 URL을 깔끔한 Markdown 또는 스키마에 맞춘 JSON으로 바꿔야 한다면, 가변비용이 가장 낮은 변환기는 Jina Reader입니다. 기본 엔진은 헤드리스 브라우저에서 JavaScript를 렌더링하며, direct 엔진은 더 단순한 HTTP 경로를 사용합니다. ReaderLM-v2는 구조화 출력을 위해 JSON 스키마나 자연어 지시를 받습니다.
장점이 곧 경계이기도 합니다. Reader는 URL 하나를 읽습니다. 전체 사이트의 범위 규칙, 크롤 프런티어, 중복 정책, 크롤 매니페스트를 대신하지 않습니다. 사이트맵이나 검색 단계, 내부 카탈로그가 URL 목록을 안정적으로 공급한다면 이처럼 좁은 역할이 오히려 장점입니다. 그렇지 않다면 URL 탐색 비용을 계산표에 다시 넣어야 합니다.
Reader의 기본 사용은 무료입니다. 새 키에는 토큰 10 million개가 포함되며, 키를 사용하면 출력 토큰이 차감됩니다. 토큰 1 billion개 충전은 $50, 즉 million당 $0.050이고, 11 billion개는 $500, 즉 million당 $0.045입니다. 실패한 요청에서는 토큰이 차감되지 않습니다. 속도 제한은 키 없이 분당 20회, 무료 또는 유료 키로 500회, premium 키로 5,000회입니다. 모든 수치는 Jina Reader 최신 페이지를 기준으로 했습니다.
계산표는 성공한 시도당 출력 토큰 2,000개를 가정합니다. 재시도 여유분을 반영하면 검수 통과 페이지 1,000개의 토큰 소비 가치는 $0.11, 10,000개는 $1.10, 100,000개는 $11입니다. 이는 결제 시 실제로 청구되는 현금이 아니라 경제적 사용 가치입니다. 무료 풀을 소진한 뒤 가장 작은 구매 단위는 여전히 $50입니다.
추천 대상: 신뢰할 수 있는 URL 매니페스트를 갖추고 저비용으로 페이지를 Markdown 또는 JSON으로 변환해야 하는 파이프라인.
핵심 강점: 범위가 명확한 Reader API 안에서 출력 토큰 과금, JavaScript 렌더링, JSON 스키마 추출을 제공합니다.
가격: 기본 Reader 사용은 무료이고, 새 키마다 토큰 10 million개를 제공합니다. 유료 팩은 1 billion개에 $50 또는 11 billion개에 $500입니다.
무료 체험: 새 API 키에 토큰 10 million개를 제공합니다.
- 기본 렌더러가 변환 전에 클라이언트 측 JavaScript를 처리합니다.
- JSON 스키마와 지시 모드로 같은 Reader에서 구조화 필드를 만들 수 있습니다.
- 실패한 요청은 토큰을 소비하지 않습니다.
- 사이트 탐색, 범위, 크롤 상태 영속화를 다른 구성 요소가 맡아야 합니다.
- 무료 풀을 소진한 뒤에는 현재 소비 가치가 훨씬 작아도 $50 토큰 팩이 최소 결제 단위입니다.
- 출력 토큰 비용은 페이지 길이와 응답 형식에 따라 달라집니다.
Jina는 $11에 여섯 시간으로 100,000페이지 구간의 겉보기 최저 비용이지만, 이는 URL 매니페스트가 제공된다는 가정에서만 성립합니다. 신뢰하기 어려운 탐색 작업과 수동 중복 제거를 더하면 해당 행을 Firecrawl이나 Apify와 비교할 수 없습니다. 빠진 크롤 작업을 숨기는 용도가 아니라 실제로 구성 요소 경계가 분명할 때 사용하십시오.
5. 크레딧 상한을 걸 수 있는 ScrapingBee 웹 스크래핑 API
페이지 한 건에 들어갈 수 있는 최대 비용을 제한하고 싶은 팀에는 ScrapingBee가 가장 적합한 요청 단위 대안입니다. 페이지를 Markdown 또는 JSON 응답으로 반환하고 CSS 추출 규칙을 적용하며, 레이아웃이 셀렉터로 처리하기에 충분히 안정적이지 않을 때 AI 추출을 추가할 수 있습니다.
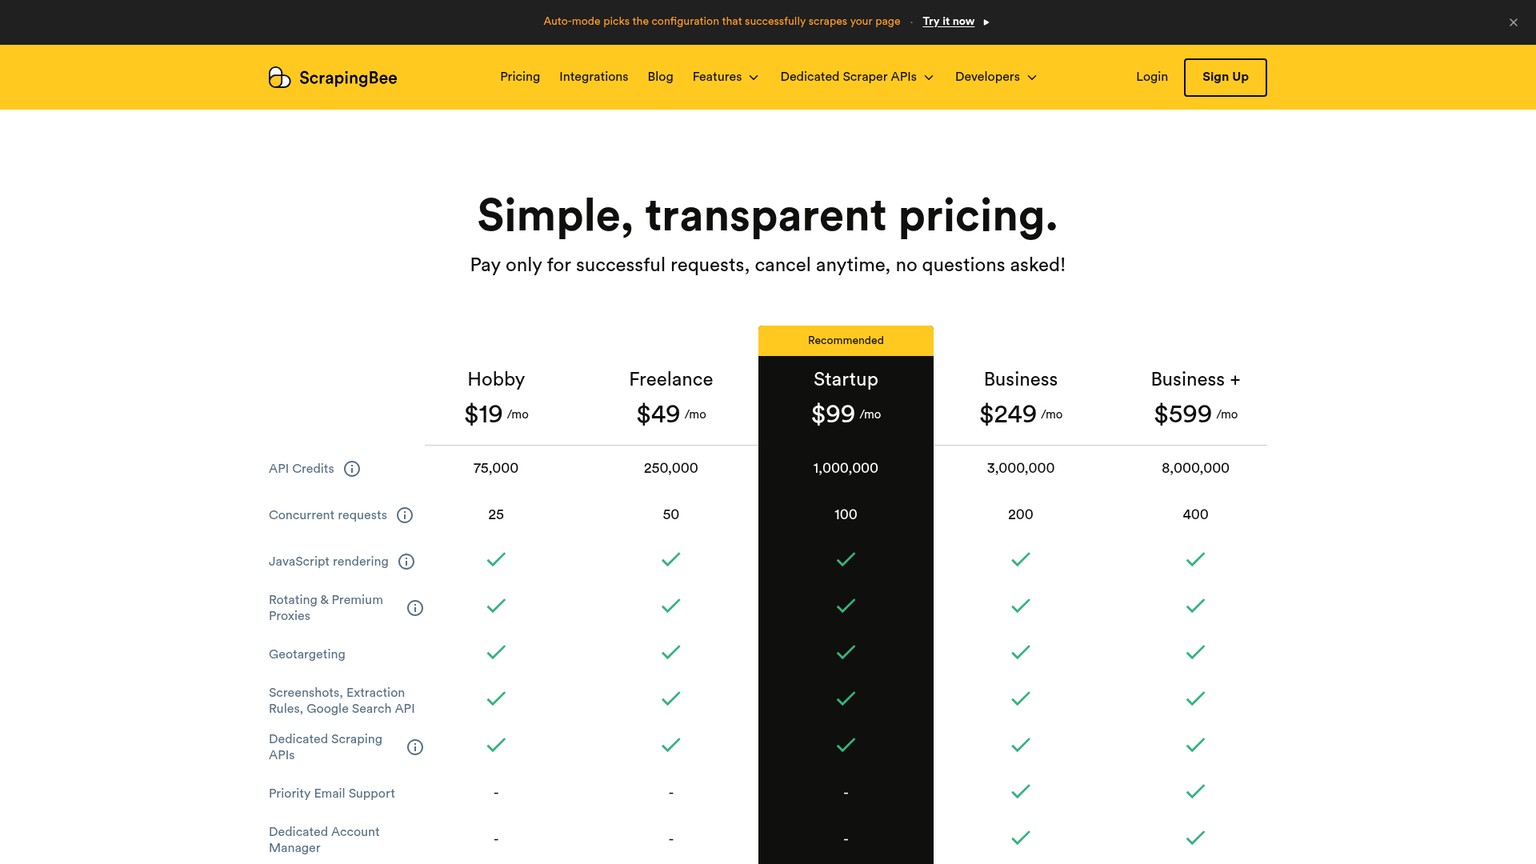
유용한 제어 장치는 크레딧 단계입니다. classic HTTP는 1크레딧, classic JavaScript는 5크레딧, JavaScript 없는 premium은 10크레딧, JavaScript를 쓴 premium은 25크레딧, JavaScript를 쓴 stealth는 75크레딧입니다. AI 기능에는 5크레딧이 추가됩니다. auto 모드는 성공한 설정의 비용을 부과하고 모든 설정이 실패하면 비용을 부과하지 않으며 최대 비용 상한을 설정할 수 있습니다.
한계는 오케스트레이션입니다. ScrapingBee는 요청한 페이지를 가져오지만, Firecrawl의 사이트 탐색과 크롤 프런티어를 가장 유사하게 대체하는 제품은 아닙니다. 팀이 URL 매니페스트, 범위, 중복 처리, 작업 상태를 책임지고, 벤더 실패와 로컬 검수 게이트가 거부한 성공 응답을 구분해야 합니다.
현재 요금제는 월 $19에 75,000크레딧과 동시 요청 25개의 Hobby, $49에 250,000크레딧과 50개의 Freelance, $99에 1,000,000크레딧과 100개의 Startup, $249에 3,000,000크레딧과 200개의 Business, $599에 8,000,000크레딧과 400개의 Business+입니다. 평가용으로 카드 등록 없이 1,000크레딧을 제공합니다. 이 수치는 ScrapingBee 최신 요금제를 기준으로 했습니다.
추천 대상: URL 탐색을 이미 직접 운영하면서 렌더링, premium 프록시, 요청당 비용에 명확한 상한이 필요한 팀.
핵심 강점: auto 모드가 접근 방식을 단계적으로 높이는 동안 max_cost로 응답 하나가 소비할 수 있는 비용을 제한합니다.
가격: Hobby $19, Freelance $49, Startup $99, Business $249, Business+ $599.
무료 체험: 카드 등록 없이 1,000크레딧을 제공합니다.
- 하나의 요청 API에서 Markdown, CSS 추출, AI 추출을 사용할 수 있습니다.
- 1, 5, 10, 25, 75크레딧 단계로 접근 비용을 명확하게 확인할 수 있습니다.
- auto 모드는 내부 설정이 모두 실패하면 크레딧을 부과하지 않습니다.
- 사이트 탐색과 크롤 영속화는 제품 범위 밖에 남습니다.
- 벤더가 성공으로 처리했어도 팀의 스키마가 거부하면 비용을 낸 시도입니다.
- AI 추출을 더하기 전에도 classic JavaScript에서 stealth JavaScript로 바뀌면 크레딧 사용량이 15배로 늘 수 있습니다.
이 모델에서 JavaScript와 AI 추출을 함께 쓰면 시도당 10크레딧이 듭니다. 재시도 여유분을 적용하면 검수 통과 페이지당 11크레딧이므로, 1,000페이지는 Hobby $19, 10,000페이지는 Freelance $49, 100,000페이지는 Business $249에 해당합니다. 1.1 million크레딧이 Startup의 1 million 한도를 넘기 때문입니다.
6. 사이트별 안티봇 요금에 강한 Zyte API
대상마다 접근 난도가 크게 다르고 벤더가 사이트별 가격 티어를 정해 주길 원한다면 Zyte API가 가장 잘 맞습니다. 필요한 데이터센터 또는 주거용 경로와 렌더링, 접근 작업을 응답 가격에 묶고 성공한 응답에만 요금을 부과합니다.
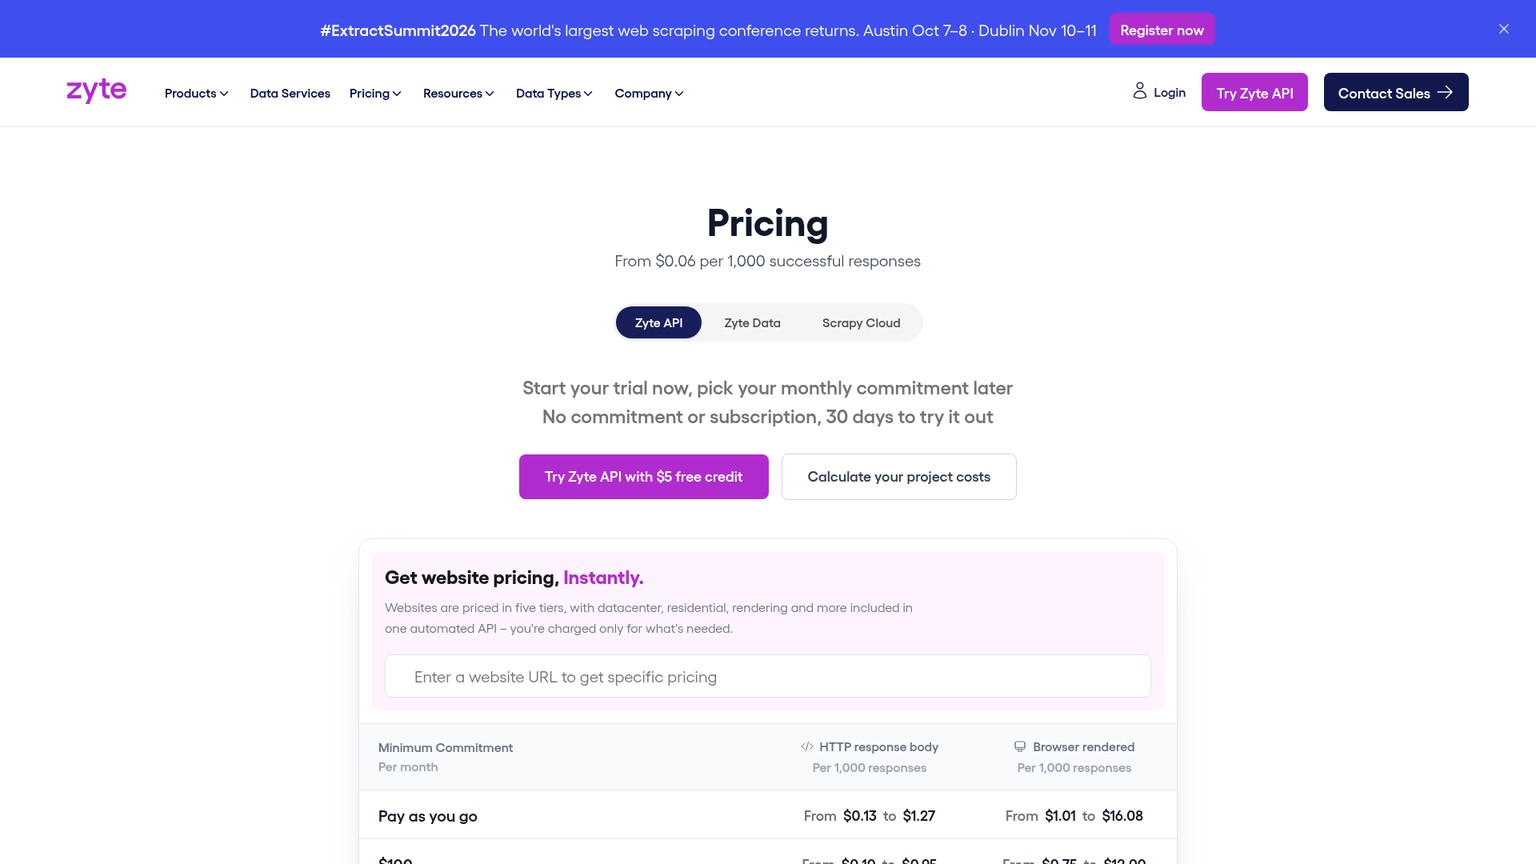
사이트 티어 1~5의 PAYG HTTP 응답 1,000개당 가격은 각각 $0.13, $0.23, $0.44, $0.70, $1.27입니다. 브라우저 렌더링 가격은 $1.01, $2.01, $4.02, $8.04, $16.08입니다. 월 $100 약정에서는 브라우저 요율이 $0.75, $1.50, $3, $6, $12로 내려가고, $200 약정에서는 $0.60, $1.20, $2.40, $4.80, $9.60, $500 약정에서는 $0.48, $0.96, $1.92, $3.84, $7.68입니다.
HTTP 약정 요율도 중요합니다. 티어 1~5는 $100 약정에서 1,000개당 $0.10, $0.17, $0.33, $0.53, $0.95이고, $200 약정에서는 $0.08, $0.14, $0.26, $0.42, $0.76, $500 약정에서는 $0.06, $0.11, $0.21, $0.34, $0.61입니다. Enterprise는 추가 협의 할인을 제공합니다. Zyte 최신 가격 페이지에는 30일 동안 사용할 수 있는 $5 체험 크레딧도 명시돼 있습니다.
맞춤 속성에는 $0.001의 고정형 extract 방식이나 입력 토큰 1,000개당 $0.002, 출력 토큰 1,000개당 $0.01인 생성형 방식을 사용할 수 있습니다. 자동 추출은 데이터 유형당 $0.0004~$0.0016입니다. 덕분에 모델 사용량을 구분되지 않은 요금제 안에 숨기지 않고 계산표에 추출 비용을 명확히 분리할 수 있습니다.
이 비교에서 걸리는 지점은 출력입니다. Zyte 문서에는 HTTP 본문, 브라우저 HTML, 구조화 필드는 있지만 네이티브 Markdown 응답 계약은 없습니다. 따라서 후속 HTML-to-Markdown 변환과 회귀 테스트가 이전 작업에 남습니다.
추천 대상: 대상 난도와 브라우저 필요 여부, 접근 인프라가 벤더 비용의 대부분을 좌우하는 다중 도메인 추출.
핵심 강점: 사이트별 요청 티어 다섯 개를 제공하며 실패하거나 속도 제한에 걸린 응답에는 요금을 부과하지 않습니다.
가격: 약정 없는 PAYG, 월 $100·$200·$500 약정, 추가 할인형 Enterprise. 응답 가격은 사이트 티어와 HTTP 또는 브라우저 출력 여부에 따라 달라집니다.
무료 체험: 약정 없이 30일간 $5크레딧을 제공합니다.
- 대상별 티어가 접근 인프라 비용을 하나의 응답 가격으로 묶습니다.
- 성공 응답 기준 과금이므로 속도 제한이나 벤더가 실패로 선언한 응답에는 직접 비용이 없습니다.
- 고정형과 토큰 과금형 맞춤 속성 덕분에 추출 비용이 드러납니다.
- 네이티브 Markdown은 문서화된 출력이 아니므로 변환을 직접 맡아야 합니다.
- 대상의 티어가 바뀔 수 있고 성공 응답도 로컬 콘텐츠 게이트를 통과하지 못할 수 있습니다.
- 전체 사이트 탐색과 후속 크롤 상태 설계를 의도적으로 구성해야 합니다.
계산표는 티어 3 브라우저 렌더링에 고정형 맞춤 추출 한 번을 더합니다. 세 처리량 구간에서 모델링한 벤더 사용료는 각각 $5.52, $55.22, $374입니다. 이는 모든 Zyte 작업에 적용되는 가격이 아니라 하나의 시나리오이므로 실제로 크롤링할 도메인에 받은 견적으로 티어를 바꾸십시오.
7. 보호된 사이트를 대규모로 수집할 때 강한 Bright Data Crawl API
보호된 사이트 접근, 프록시 인프라, 동시성이 요구사항의 중심이라면 Bright Data Crawl API가 가장 강력한 후보입니다. 가격에 JavaScript 렌더링, 주거용 프록시, 검증, CAPTCHA 해결, 지역 타기팅, 탐색, JSON 또는 CSV 파싱, 무제한 동시성이 포함됩니다.
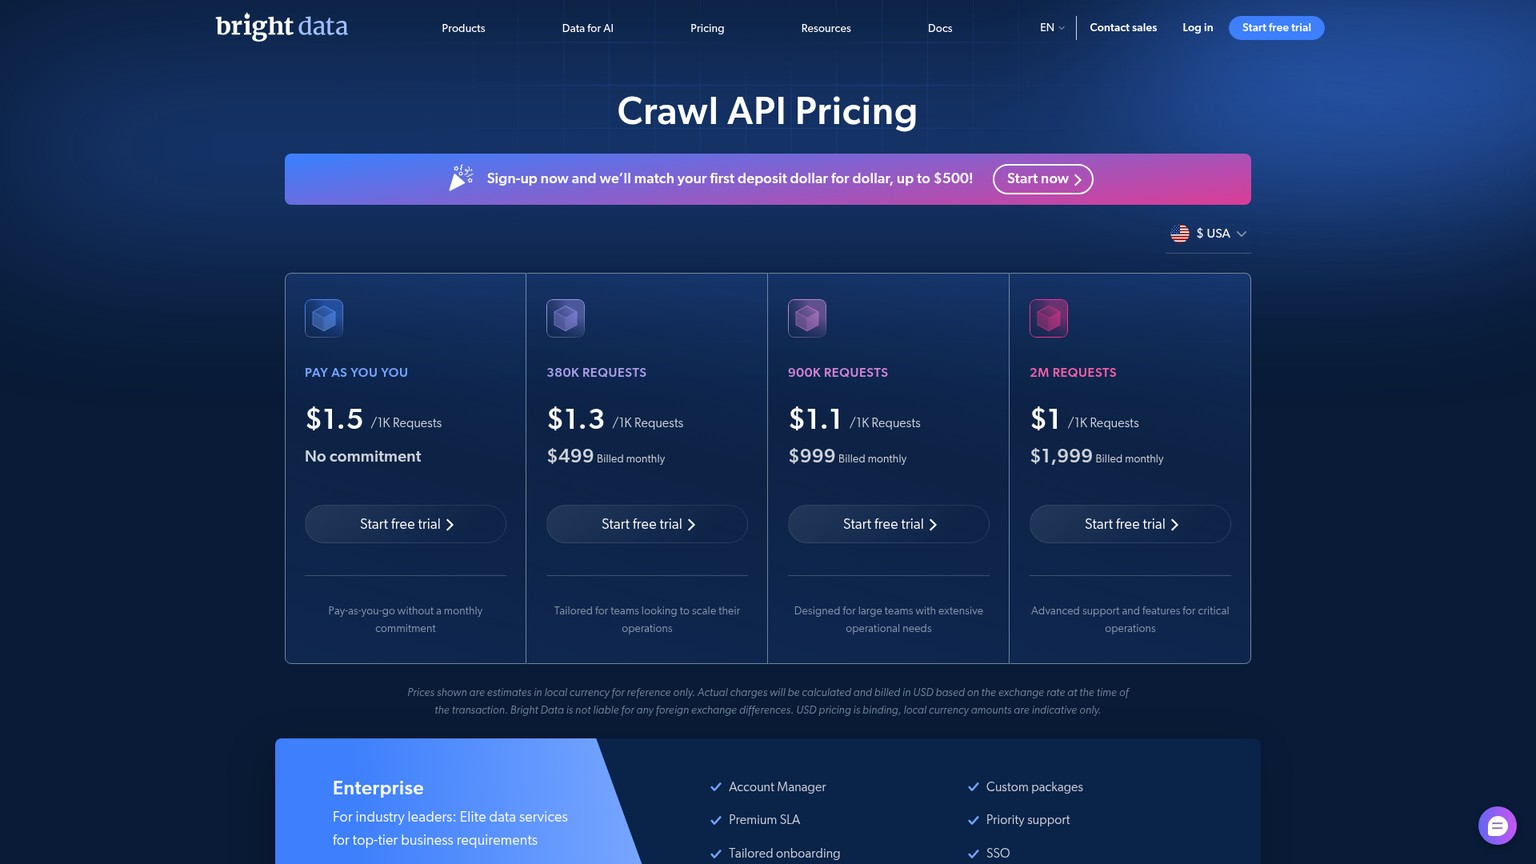
약정 없는 PAYG는 요청 1,000개당 $1.50부터 시작합니다. 380,000회 요청 요금제는 월 $499로 1,000개당 $1.30이며, 900,000회는 $999로 1,000개당 $1.10, 2 million회는 $1,999로 1,000개당 $1입니다. Enterprise는 맞춤형입니다. 이는 현재 Bright Data Crawl API 가격입니다.
중요한 한계는 Zyte와 같습니다. 문서화된 전달 형식은 NDJSON과 CSV이며 네이티브 Markdown이 아닙니다. 안정적인 제목, 코드 펜스, 표, 출처 링크를 Markdown으로 요구하는 검색 파이프라인이라면 변환기도 프로덕션 구성 요소입니다. 변환 실패와 운영자 시간도 분모에 넣어야 합니다.
PAYG 요율에서 비용이 청구되는 재시도 여유분 10%를 적용하면 검수 통과 페이지 1,000개의 벤더 현금 비용은 $1.65, 10,000개는 $16.50, 100,000개는 $165입니다. 이 작은 요청 비용만 보고 총비용으로 오해해서는 안 됩니다. 계산표에는 Markdown 변환, 스키마 정규화, 검토에 각각 네 시간, 다섯 시간, 여덟 시간을 배정했으며, 까다로운 대상은 요청 동작 자체를 바꿀 수 있습니다.
추천 대상: 네이티브 Markdown보다 관리형 접근 작업이 더 중요하고 보호된 도메인을 높은 동시성으로 수집해야 하는 경우.
핵심 강점: Crawl API 가격에 렌더링, 주거용 라우팅, CAPTCHA 처리, 검증, 무제한 동시성이 포함됩니다.
가격: PAYG는 요청 1,000개당 $1.50, 380,000개에 $499, 900,000개에 $999, 2 million개에 $1,999, Enterprise는 맞춤형.
무료 체험: 현재 가격 카드에는 무료 체험이 표시돼 있지만 보이는 요금 조건에는 크레딧 금액이 적혀 있지 않습니다.
- 여러 구성 요소가 필요할 접근 인프라를 하나로 묶어 제공합니다.
- 무제한 동시성은 전달 기한이 엄격한 대규모 작업에 적합합니다.
- NDJSON과 CSV로 제공자 대시보드를 스크래핑하지 않고도 기계 판독 가능한 결과를 받을 수 있습니다.
- 네이티브 Markdown은 문서화된 출력 계약이 아닙니다.
- PAYG 요청 비용만 보면 변환, 스키마, 검수 통과 페이지 리뷰 작업이 가려집니다.
- 원시 HTTP만으로 원활히 처리되는 공개 문서 사이트에는 폭넓은 접근 스택이 불필요한 부담입니다.
팀이 직접 운영할 수 있는 오픈소스 웹 크롤러 대안
이 후보군에서 가장 분명한 오픈소스 대안은 Crawl4AI이지만, Firecrawl도 셀프 호스팅할 수 있는 코어를 공개합니다. 중요한 차이는 저장소를 복제할 수 있느냐가 아닙니다. 오픈 배포판이 비즈니스 파이프라인에 필요한 탐색, 브라우저 접근, 큐, 영속성, 관측 가능성, 출력 계약을 재현할 수 있느냐입니다.
Crawl4AI는 0.9.4 이상으로 고정하고 인증을 필수화하며, 비공개 평가 인스턴스를 적절한 인터페이스에 바인딩하고, 모든 결과 세트와 함께 정확한 이미지 또는 패키지 버전을 저장하십시오. 템플릿이 안정적이라면 CSS 또는 XPath 추출을 우선 사용하고, LLM 추출 제공자는 별도 비용 및 데이터 경계로 분리해야 합니다. 모델의 월 운영자 작업 8~20시간은 벤치마크가 아닙니다. 패치, 프록시 실패, 스키마 변화, 복구를 무료라고 부르지 말고 비용으로 계산하라는 기준입니다.
Firecrawl 코어는 Cloud와 셀프 호스팅 사이의 선택을 별도 아키텍처 결정으로 다뤄야 합니다. 저장소를 사용하면 벤더 크레딧 비용은 사라질 수 있지만 PostgreSQL, Redis, RabbitMQ, 브라우저 워커, 모니터링, 업그레이드가 팀의 업무로 추가됩니다. 위에 링크한 셀프 호스팅 전용 글에는 이 결정을 위한 검증 팩이 포함돼 있습니다.
웹 스크래핑에 가장 적합한 AI 웹 크롤러는 무엇입니까?
정답은 입력 경계에 따라 달라집니다. 입력이 도메인이고 완전한 Markdown·JSON 코퍼스를 만들어야 한다면 Firecrawl 또는 Apify부터 검토한 뒤 ScrapFly의 비용을 계산하십시오. 신뢰할 수 있는 URL 목록이 이미 입력으로 들어온다면 Jina Reader는 크롤 장치를 덜어 내 훨씬 저렴해질 수 있습니다. 접근이 가장 어려운 문제라면 ScrapingBee의 비용 상한, Zyte의 사이트 티어, Bright Data의 통합 접근 스택을 비교해야 합니다.
웹 스크래핑 AI 에이전트에는 검수 게이트가 필요합니다
에이전트가 200 응답만 보고 검색에 사용할 준비가 됐다고 판단하게 해서는 안 됩니다. 필수 필드, 최소 Markdown 길이, 표와 코드 보존, 정규화된 링크, 콘텐츠 해시, 허용 콘텐츠 유형, 명시적인 null 규칙으로 구성된 결정론적 게이트를 제공하십시오. 에이전트는 실패를 다른 경로로 보낼 수 있지만 작업을 계속하려고 계약을 면제해서는 안 됩니다.
다음 네 가지 지점에서 선택이 달라집니다.
- Firecrawl 유지: 고정 검수 세트를 통과하고 여섯 달의 절감액으로 이전과 병행 운영 비용을 회수할 수 없을 때 적합합니다.
- Apify 선택: 단일 페이지 크레딧 값보다 관리형 크롤 작업, 영속 데이터셋, 유연한 Actor 워크플로가 더 중요할 때 적합합니다.
- Crawl4AI 선택: 팀이 컨테이너, 접근 라우팅, 온콜 대응을 이미 운영하거나 데이터 경계 때문에 관리형 처리를 사용할 수 없을 때 적합합니다.
- 더 좁은 API 선택: URL 탐색이 이미 해결됐거나 보호된 페이지 접근이 작업의 중심일 때 적합합니다. Jina, ScrapingBee, Zyte, Bright Data의 장점은 그 경계를 명확히 적어 뒀을 때만 살아납니다.
가장 보기 좋은 플레이그라운드 출력만 보고 고르지 마십시오. 선택한 설정은 같은 검수 세트를 통과하고 같은 증거를 저장하며 동일한 후속 청크를 만들어야 합니다. 한 개의 글 페이지에서 더 깔끔해 보이는 툴도 프로덕션 검수를 좌우하는 표, PDF, JavaScript 경로에서는 실패할 수 있습니다.
Firecrawl의 직접 대안으로 피해야 할 선택
인접한 제품 범주를 구입해 놓고 파이프라인이 완성됐다고 생각해서는 안 됩니다. 아래 툴도 쓸모는 있지만, 이 글에서 정의한 Firecrawl 작업 전체를 대체하지는 못합니다.
- Exa와 Tavily: 검색 제공자 평가에 남겨 두십시오. 이번 교체 범위는 도메인 또는 URL 목록이 정해진 뒤부터 시작해 검수 통과 페이지 본문을 만들어야 하므로 후보에서 제외했습니다.
- Playwright와 Puppeteer만 사용: 브라우저 자동화는 구성 요소일 뿐 관리형 크롤 매니페스트, Markdown 계약, 재시도 원장, 구조화 전달 시스템이 아닙니다. 이 계층들을 직접 구축하려는 경우에만 선택하십시오.
- 프록시 전용 서비스: 응답에 접근했다고 해서 내비게이션이 정리되고, 링크가 보존되며, JSON이 검증되고, 청크 경계가 안정적으로 유지되는 것은 아닙니다.
- 유지보수되지 않는 크롤러 포크: 브라우저 버전이나 보안 수정, 대상의 동작이 바뀌었는데 릴리스 경로를 책임지는 사람이 없다면 무료 저장소가 장애로 돌아옵니다.
마케팅 벤치마크를 이전의 증거로 사용해서도 안 됩니다. 정확히 같은 설정을 저장된 20개 URL 검수 세트에 실행한 것이 아니라면 그 수치는 다른 사람의 워크로드를 설명할 뿐입니다. 이 글이 인위적인 통과율이나 지연 시간 순위표를 공개하지 않는 이유입니다.
소규모 팀을 위한 이전 워크시트
안전하게 이전하려면 고정 검수 세트와 대표 프로덕션 샘플에서 정규화한 출력, 재시도 동작, 청크가 일치할 때까지 Firecrawl과 후보를 병행해야 합니다. 워크시트에는 담당자 한 명, 버전이 지정된 스키마 하나, 롤백 트리거 하나가 필요합니다.
1. 입력과 탐색 계약 고정하기
URL이 도메인 크롤, 사이트맵, 검색 API, 큐, 내부 데이터베이스 중 어디에서 오는지 기록합니다. 허용 도메인, 서브도메인 정책, 포함·제외 경로, 깊이, 페이지 상한, 정규화, 중복 규칙을 저장하십시오. 다른 구성 요소가 이 행 전체를 공급하지 않는다면 Jina 또는 ScrapingBee 테스트를 Firecrawl과 비교할 수 없습니다.
2. 출력 스키마 동결하기
필수 필드와 타입에 버전을 지정합니다. 최소한 source_url, final_url, title, markdown, links, status_code, fetched_at, content_sha256를 보존하십시오. null을 허용하는 비즈니스 필드와 페이지 실패를 뜻하는 필드를 구분합니다. 원본 응답도 보존해야 크롤러 비용을 다시 내지 않고 파서 변경 사항을 재실행할 수 있습니다.
3. 재시도를 회계 이벤트로 정의하기
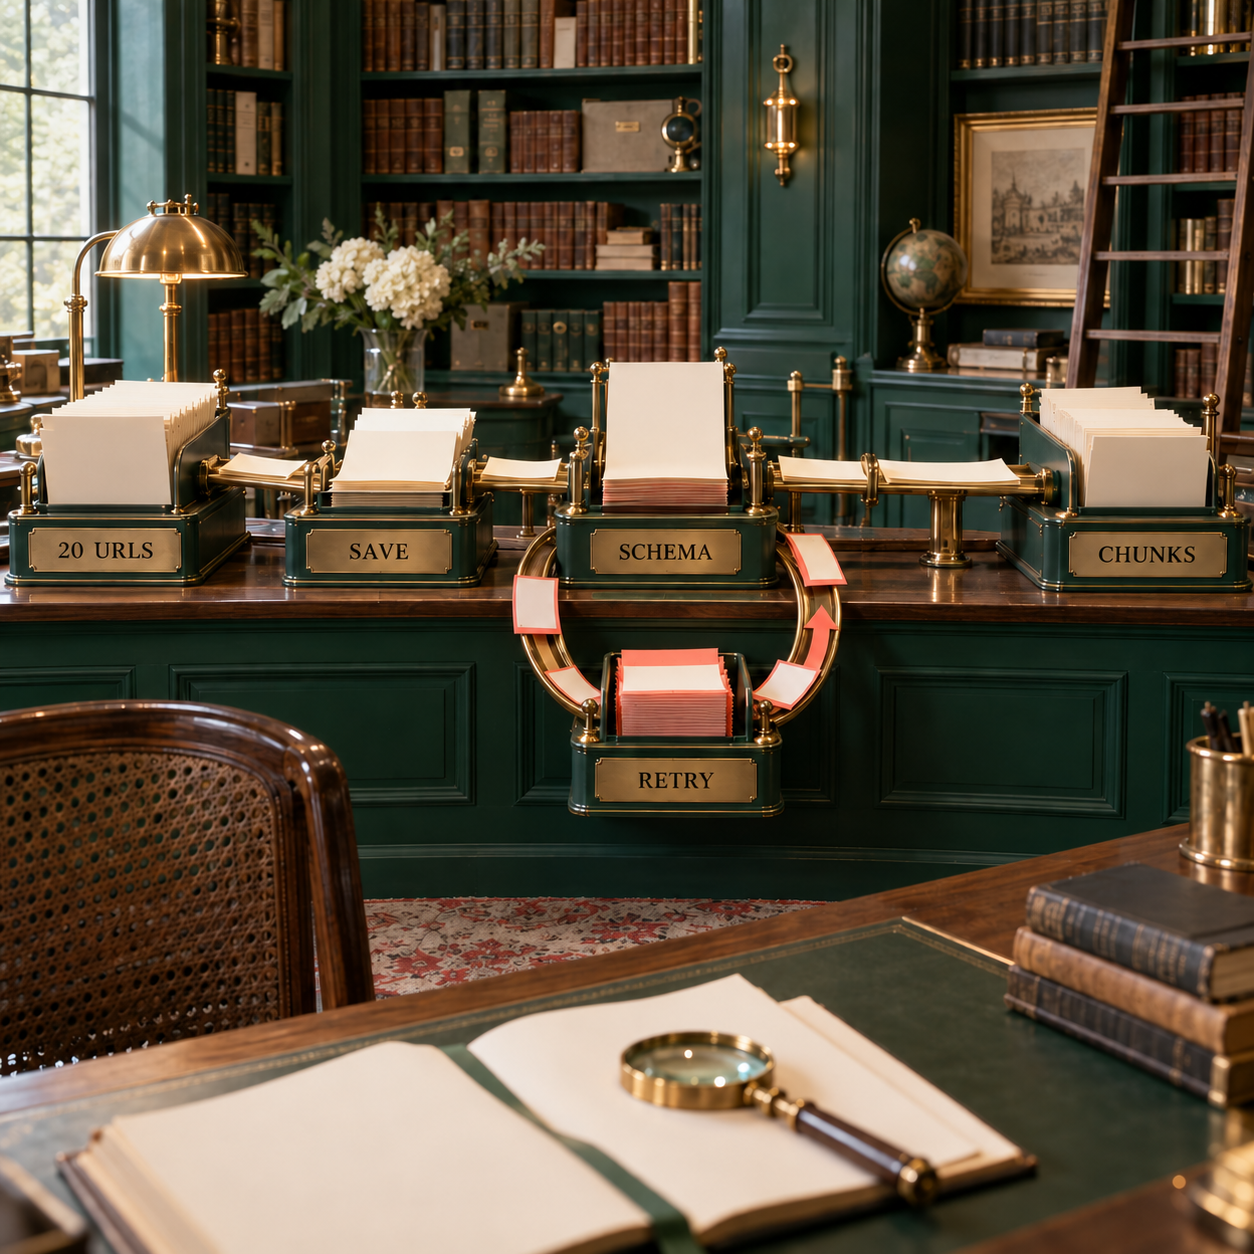
시도할 때마다 벤더 상태, HTTP 상태, 검수 판정, 재시도 사유, 크레딧 또는 요청 비용, 다음 작업을 저장합니다. 전송 오류, 벤더가 선언한 실패, 접근 차단, 빈 콘텐츠, 스키마 실패, 후속 변환 실패를 분리하십시오. 재시도 상한을 두고 이를 넘긴 항목은 보이지 않는 지출 루프를 만드는 대신 dead-letter queue로 보냅니다.
4. 증거 묶음 저장하기
툴, 릴리스, 설정 해시, 실행 날짜, 검수 세트 ID를 키로 삼은 경로를 사용합니다. 요청, 헤더, 수정하지 않은 응답, 정규화된 JSON, Markdown, 판정, 다이제스트를 저장하십시오. 검수자는 어떤 렌더러, 추출 모드, 스키마가 각 승인 청크를 만들었는지 답할 수 있어야 합니다.
5. 후속 청킹 회귀 테스트하기
다시 임베딩하기 전에 제목 계층, 코드 펜스, 표, 링크 대상, 문서 순서, 콘텐츠 해시를 비교합니다. 그런 다음 청크 수, 청크 경계, 출처 인용을 비교하십시오. Markdown 문자열이 더 깔끔해져도 제목이 사라지거나 표의 행이 여러 청크로 갈라지면 검색 동작이 달라질 수 있습니다.
6. 검수 통과 코퍼스의 가격 계산하고 롤백 기준 세우기
벤더 현금 비용, 호스트 비용, 추출 토큰, 유료 재시도, 스토리지, 운영자 시간을 합산합니다. 요청 수가 아니라 검수 통과 페이지 수로 나누십시오. 필수 필드 실패, 예상하지 못한 대상 티어, 청크 수의 중대한 증가, 운영자 시간 상한처럼 롤백을 실행할 조건을 출시 전에 정합니다. 새 경로가 이 검증 구간을 통과할 때까지 기존 경로를 유지하십시오.
소규모 팀에 가장 먼저 필요한 산출물은 벤더 점수가 아닙니다. 검수 세트 URL별로 한 행을 만들고 두 시스템의 열을 둔 워크시트입니다. 각 행에 저장된 증거가 채워져야 통과와 실패를 취향이 아니라 검토 가능한 판단으로 바꿀 수 있습니다.
자주 묻는 질문
웹 스크래핑은 불법입니까?
모든 경우에 적용되는 예·아니요 답변은 없습니다. 미국에서는 Department of Justice CFAA 정책이 기술적 접근 경계와 단순한 계약 제한을 구분하지만, 계약, 저작권, 개인정보 보호, 데이터 사용, 접근 제어, 관할권에 따라 판단은 달라질 수 있습니다. 이는 법률 자문이 아니며, 프로덕션 수집은 정확한 대상과 용도에 관해 법률 전문가의 검토를 받아야 합니다.
Firecrawl은 비싼가요?
검수 통과 출력에 따라 다릅니다. Crawl은 페이지당 1크레딧이고 JSON은 4크레딧을 추가하므로, 이 모델에서 재시도 여유분 10%를 둔 검수 통과 페이지 10,000개에는 55,000크레딧이 필요하며 Standard $83으로 처리할 수 있습니다. 운영자 작업과 이전 비용이 이 청구액보다 더 클 수 있습니다.
가장 좋은 웹 스크래핑 툴은 무엇입니까?
이 후보군에서 가장 폭넓은 관리형 대안은 Apify Website Content Crawler입니다. 셀프 호스팅이 필수라면 Crawl4AI가 더 강하고, 관리형 크롤링과 추출을 결합하려면 ScrapFly가 유력합니다. Jina Reader는 신뢰할 수 있는 URL 목록이 이미 있을 때만 앞섭니다.
Firecrawl을 셀프 호스팅할 수 있습니까?
가능합니다. 셀프 호스팅 코어를 사용하면 팀이 통제권을 갖지만 데이터베이스, 큐, 브라우저 워커, 업그레이드, 보안, 접근 라우팅, 모니터링도 직접 책임집니다. Firecrawl Cloud와 같은 운영형 제품은 아닙니다.
Firecrawl 대안에는 무엇이 있습니까?
이 글에서 비교한 일곱 가지 대안은 Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API, Bright Data Crawl API입니다. 전체 크롤러, 제공된 URL을 읽는 Reader, 접근 우선 API로 나뉩니다.
셀프 호스팅은 합법입니까?
통제하는 인프라에서 소프트웨어를 실행하는 문제와 그 소프트웨어가 무엇에 접근하는지는 일반적으로 별개의 문제입니다. 권한, 접근 제어, 사이트 약관, 저작권, 개인정보 보호, 데이터 보호 규정, 사용 목적은 각각 따로 검토해야 합니다.
셀프 호스팅할 가치가 있습니까?
필수 데이터 경계, 맞춤화, 공용 플랫폼 역량의 가치가 운영 작업보다 크다면 가치가 있습니다. 적은 월 API 비용만 없애려고 새로운 온콜 부담을 만드는 것은 대체로 가치가 없습니다.
무료 호스팅에는 어떤 위험이 있습니까?
무료 인스턴스는 절전 상태에 들어가거나 CPU 또는 메모리를 제한하고, 스토리지를 초기화하며, 평판이 약한 IP를 공유할 수 있습니다. 프로덕션 복구를 보장하지 않을 수도 있습니다. 이런 한계 때문에 실제 원인은 소프트웨어가 아닌데도 크롤러가 불안정해 보일 수 있습니다.
웹사이트를 무료로 셀프 호스팅할 수 있습니까?
취미용 웹사이트나 크롤러 평가는 무료 제공량 안에 들어갈 수 있습니다. 그러나 프로덕션 크롤에는 컴퓨트, 스토리지, 대역폭, 접근 인프라, 모니터링, 백업, 운영자 시간이 필요하므로 호스트 비용이 $0이라고 운영비까지 $0인 것은 아닙니다.
Firecrawl은 오픈소스입니까?
Firecrawl은 셀프 호스팅 가능한 오픈소스 코어를 공개합니다. Firecrawl Cloud에는 관리형 인프라와 운영 서비스가 더해지므로 저장소만으로 Cloud 제품의 비용 또는 안정성 경계를 재현할 수는 없습니다.
- 마지막 업데이트
- 2026년 9월 25일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

AI 코드 리뷰 도구 7선: CodeRabbit 대안 비용 비교
AI 코드 리뷰 도구를 찾는 팀을 위해 CodeRabbit과 Greptile, cubic, Qodo, PR-Agent, Kodus, Cursor Bugbot, GitHub Copilot의 가격, Git 호스트, 데이터 경계, 셀프호스팅 조건을 같은 기준으로 비교했습니다.2026년 9월 25일Build
CodeRabbit vs Greptile: AI 코드 리뷰 도구, 무엇을 고를까
CodeRabbit과 Greptile의 요금, 리뷰 한도, 플랫폼 지원, 런타임 검증을 비교합니다. 작성자 다섯 명의 100·300·600회 리뷰 비용표와 반복 리뷰, 작성자별 과금 구조를 바탕으로 어떤 AI 코드 리뷰 도구가 워크로드에 맞는지 확인하세요.2026년 9월 25일Build
AI 에이전트를 PC에서 실행하는 법: Perplexity Portable Computer 가이드
AMD Ryzen AI Max Windows PC에서 Perplexity Portable Computer로 AI 에이전트 로컬 실행법을 알아봅니다. 지원 사양, 모델 설치, 폴더 권한, 3개 예외 테스트, 예약 작업과 클라우드 승인에 따른 비용·데이터 경계까지 단계별로 정리했습니다.2026년 9월 25일Build
AgentRun 리뷰: AI 에이전트 프레임워크가 필요한 순간
AgentRun beta.4를 직접 설치해 4가지 지원 시나리오와 31개 테스트로 검증했습니다. 스키마 검사, 호출 제한, 에스컬레이션, 실제 비용과 한계를 바탕으로 이 AI 에이전트 프레임워크가 어떤 팀에 적합한지 정리하고 현실적인 도입 판단 기준을 제시합니다.2026년 9월 24일Build
Perplexity API Fast Search와 기본 web, 무엇을 써야 할까?
Perplexity API의 Fast Search와 기본 web을 가격, 지연 시간, 검색 품질로 비교합니다. 10,000회 호출 비용, Photon의 차이, 반복 조회와 모호한 리서치를 나누는 실전 라우팅 기준, 근거를 지키는 전환 테스트까지 한 번에 확인하세요.2026년 9월 24일Build
AI 에이전트 비용 누수의 시작: 유료 폴백이 기본 경로가 된 날
샌드박스의 파일 전달 실패가 유료 이미지 폴백을 기본 경로로 바꿔 공유 잔액을 소진시킨 실제 사례를 분석합니다. AI 에이전트 비용 누수를 막기 위해 아티팩트 전달, 완료 상태, 예산 통제를 운영 환경에서 어떻게 설계하고 검증해야 하는지 실무 관점에서 짚습니다.2026년 9월 24일Build
Cursor 가격 분석: Rollouts 무료 크레딧 뒤의 실제 비용
Cursor 가격을 기준으로 Rollouts가 정말 무료인지 따져봅니다. Teams의 사용자당 월 $40 요금, 10일 크레딧, 공개되지 않은 이후 사용료를 분리하고, 개발자·운영자·구매 담당자가 도입 전에 확인할 핵심 비용과 테스트 기준을 정리했습니다.2026년 9월 24일Build