Web scraping: 7 alternativas a Firecrawl comparadas
Comparamos 7 alternativas a Firecrawl para web scraping por costos, rastreo, Markdown, JSON, alojamiento propio y carga operativa en equipos pequeños.




Al comparar alternativas a Firecrawl para web scraping, el punto de quiebre aparece en 10,000 páginas aceptadas: en este modelo, Firecrawl cuesta $83 en cargos del proveedor más tres horas de operación, mientras que ScrapFly cuesta $30 más tres horas. La factura más baja no convierte automáticamente a una opción en el reemplazo más barato: el descubrimiento, los reintentos con renderizado, la extracción de JSON y la fragmentación posterior pueden borrar la diferencia.
Alternativas a Firecrawl para web scraping: la respuesta breve
Elija Apify Website Content Crawler si busca el reemplazo gestionado más completo; Crawl4AI si el control de la infraestructura es prioritario; ScrapFly si un mismo saldo de créditos debe cubrir rastreo y extracción estructurada; y Jina Reader si otro sistema ya proporciona las URL. ScrapingBee, Zyte API y Bright Data Crawl API ganan terreno cuando acceder a páginas difíciles importa más que disponer de un flujo nativo que convierta un sitio en Markdown.
La unidad relevante no es una solicitud ni una URL descubierta. Es una página aceptada que llega al pipeline de generación aumentada por recuperación: el modelo recibe material fuente útil, con el Markdown, los campos JSON, los enlaces y los metadatos necesarios intactos. Una respuesta barata que pierde una tabla, inventa un campo de precio vacío o rompe el fragmentador es un fallo por el que ya se pagó.
Firecrawl como referencia
Firecrawl sirve de referencia porque su endpoint Crawl ya reúne descubrimiento, renderizado y procesamiento de páginas, y después devuelve Markdown o JSON ajustado a un esquema. Cobra 1 crédito por página rastreada y otros 4 créditos en modo JSON; por eso, la referencia pertinente para esta comparación es de 5 créditos por cada intento de página.
Ese paquete explica por qué quedarse puede resultar mejor que adoptar un reemplazo aparentemente más barato. Firecrawl también gestiona el alcance del rastreo, los subdominios, las rutas, la profundidad y la entrega de páginas por streaming. Una API de lectura puede costar menos por URL y dejar el descubrimiento en manos del equipo; una API de acceso puede recuperar páginas protegidas, pero trasladar la conversión a Markdown y la normalización del esquema a etapas posteriores.
Precios de Firecrawl según el modelo de páginas aceptadas
Los planes actuales de Firecrawl son Free a $0 por 1,000 créditos; Hobby a $16 al mes con facturación anual por 5,000 créditos; Standard a $83 por 100,000 créditos; Growth a $333 por 500,000 créditos; Scale a $599 por 1,000,000 créditos; y Enterprise con precio personalizado. Los excedentes cuestan $9 por 1,500 créditos en Hobby, $47 por 35,000 en Standard, $177 por 175,000 en Growth y $397 por 350,000 en Scale. Estas cifras, límites y capacidades de rastreo se comprobaron en la página actual de Firecrawl Crawl el 25 de septiembre de 2026.
Con una reserva del 10% para las respuestas exitosas que no superan la validación local, 1,000 páginas aceptadas con Markdown y JSON requieren 5,500 créditos. Hobby más un bloque de excedente cuesta $25. Diez mil páginas aceptadas necesitan 55,000 créditos, por lo que Standard cuesta $83. Cien mil páginas aceptadas necesitan 550,000 créditos, así que Growth más un bloque de excedente cuesta $510.
La búsqueda es una capa aparte. Si el trabajo comienza con una consulta y necesita fuentes clasificadas, no un sitio conocido ni un conjunto de URL, use la comparativa de API de búsqueda con IA para tomar esa decisión y pase después las URL elegidas a la capa de extracción.
Alternativas a Firecrawl de un vistazo
La tabla puntúa el ajuste documentado, no la calidad medida de los resultados. Los precios se verificaron en páginas oficiales el 25 de septiembre de 2026. «Prueba gratuita» también incluye una asignación gratuita permanente cuando eso es lo que ofrece el proveedor.
No existe un ganador universal porque la expresión «extracción web» engloba tres productos distintos. Un crawler descubre un sitio, un lector convierte una URL que se le entrega y una capa de acceso supera el renderizado o los bloqueos. Conviene comprar el producto más acotado que se haga cargo de todas las etapas que el equipo no desea operar.
Cómo elegimos estas herramientas de web scraping
Un candidato solo entró en la lista cuando su documentación oficial vigente ofrecía una vía creíble tanto hacia contenido útil de las páginas como hacia una salida legible por máquinas. Se excluyeron las API dedicadas únicamente a búsqueda porque el descubrimiento ordenado no reemplaza a un crawler. También se descartaron los servicios que solo ofrecen proxies: una IP no genera Markdown limpio, el JSON requerido ni un manifiesto de rastreo guardado.
La comparación depende de cinco controles de aceptación:
- Descubrimiento: ¿Puede recorrer un sitio, respetar el alcance y conservar un manifiesto de URL canónicas, o debe otro componente aportar cada URL?
- Renderizado y acceso: ¿Puede ejecutar JavaScript y afrontar las condiciones de acceso del sitio sin generar una factura de reintentos sin límite?
- Contrato de salida: ¿Conserva títulos, tablas, código y enlaces en Markdown, y puede completar los campos JSON obligatorios sin una segunda transformación opaca?
- Evidencia: ¿Puede el equipo guardar la solicitud, la respuesta sin procesar, la salida normalizada, los encabezados, la configuración, el hash del contenido y el veredicto de cada URL de prueba?
- Costo completo: ¿Cuánto se paga por descubrimiento, renderizado, extracción, reintentos exitosos pero rechazados, compromisos mínimos y tiempo de operación?
No se ejecutó ninguno de los candidatos para este artículo. Por tanto, aquí no se afirman tasas de aprobación ni clasificaciones de latencia. Todas las observaciones sobre calidad que aparecen a continuación son capacidades documentadas; cada comparación monetaria es un modelo con supuestos visibles.
La prueba fija de aceptación con 20 URL
No migre basándose en la URL de demostración de un proveedor. Ejecute la misma prueba fija con la configuración anterior y la nueva, y guarde todas las respuestas. La selección combina deliberadamente tipos de contenido que dejan al descubierto fallos diferentes:
- Código y documentos extensos: API Fetch de MDN, clases de Python, propiedad en Rust, HTML de RFC 9110 y HTML de HTTPBin.
- Tablas, enlaces y páginas estructuradas: referencia de tablas de MDN, tutorial de tablas de W3C, web scraping en Wikipedia, catálogo Books to Scrape y una página de producto fija.
- Paginación y JavaScript: Quotes to Scrape, su ruta con JavaScript, su ruta con desplazamiento, la guía de JavaScript de MDN y normalización de enlaces de HTTPBin.
- Codificación y PDF: Unicode de HTTPBin, PDF de RFC 9110, un PDF de investigación a dos columnas, un PDF mínimo de W3C y el formulario W-9 del IRS.
Cada resultado debe contener source_url, final_url, title, markdown, links, status_code, fetched_at y content_sha256. Las páginas de producto también requieren entity_name, amount y currency; el PDF de investigación necesita published_at. Un campo solo puede ser explícitamente nulo cuando así lo permita el manifiesto de la prueba. Un campo ausente no equivale a uno nulo.
Guarde un directorio por herramienta, versión y configuración. Para cada URL, conserve request.json, los encabezados de respuesta, el cuerpo sin modificar, normalized.json, verdict.json y el hash SHA-256. El veredicto debe indicar la primera regla incumplida, no limitarse a pass: false. Esa evidencia permite que otro ingeniero reproduzca una decisión después de que cambie el proveedor, el analizador o la página.
Hoja de cálculo del costo por página aceptada
El modelo utiliza 1,000, 10,000 y 100,000 páginas aceptadas al mes, con una reserva del 10% para las respuestas que el proveedor considera exitosas pero que la validación local de esquema o Markdown rechaza. Esos reintentos son facturables. Los fallos explícitos del proveedor se tratan según la política de reembolso que haya publicado cada uno.
La fórmula base es sencilla: efectivo destinado al proveedor o al servidor, más cargos por descubrimiento, renderizado, extracción y reintentos de pago, más las horas de operación multiplicadas por el costo horario total del equipo. La tabla separa el desembolso al proveedor de las horas para que se pueda sustituir el supuesto de $100 por hora sin rehacer la fórmula de cada proveedor.
Con una tarifa de $100 por hora de operación, los totales para 10,000 páginas son $383 con Firecrawl, $419 con Apify, $1,248 con Crawl4AI, $330 con ScrapFly, $401.10 con Jina, $449 con ScrapingBee, $555.22 con Zyte y $516.50 con Bright Data. La cifra de Jina solo se aplica cuando ya existe un manifiesto de URL fiable; no es el total de rastrear un sitio completo. Las horas de Bright Data y Zyte incluyen el trabajo posterior de Markdown y esquema porque ninguna de sus páginas de producto documenta Markdown nativo como el contrato de salida utilizado aquí.
La partida de extracción se detalla de forma deliberada. Firecrawl consume 1 crédito de rastreo más 4 créditos de JSON. ScrapingBee utiliza 5 créditos de JavaScript más 5 de extracción con IA en este escenario. ScrapFly emplea 5 créditos de navegador o Unblocker más 5 del modelo de extracción. Zyte utiliza la tarifa de navegador del nivel 3 más una extracción fija de atributos personalizados. Apify usa un contenedor JSON determinista, un 80% de páginas mediante HTTP directo y un 20% mediante navegador headless al límite superior de la estimación publicada; no se incluyen los resúmenes con IA opcionales.
Jina presupone 2,000 tokens de salida por intento a $0.050 por millón. Su valor de consumo es mínimo, pero el flujo de caja llega por bloques: una vez agotados los 10 millones de tokens gratuitos, la recarga más pequeña publicada es de 1 millardo de tokens por $50. Para Crawl4AI se presuponen servidores de DigitalOcean de $24, $48 y $96 en los tres volúmenes, aunque son datos de planificación y no afirmaciones sobre capacidad medida.
1. Apify Website Content Crawler: el mejor reemplazo gestionado integral
Apify Website Content Crawler es el reemplazo gestionado integral más sólido cuando un equipo necesita descubrimiento, renderizado de JavaScript, Markdown y un conjunto de datos duradero en un solo servicio. Rastrea mediante HTTP directo o Firefox headless, almacena cada resultado como un registro del dataset y exporta JSON o CSV. Así, la forma de la migración se parece a Firecrawl sin fingir que las API son idénticas.
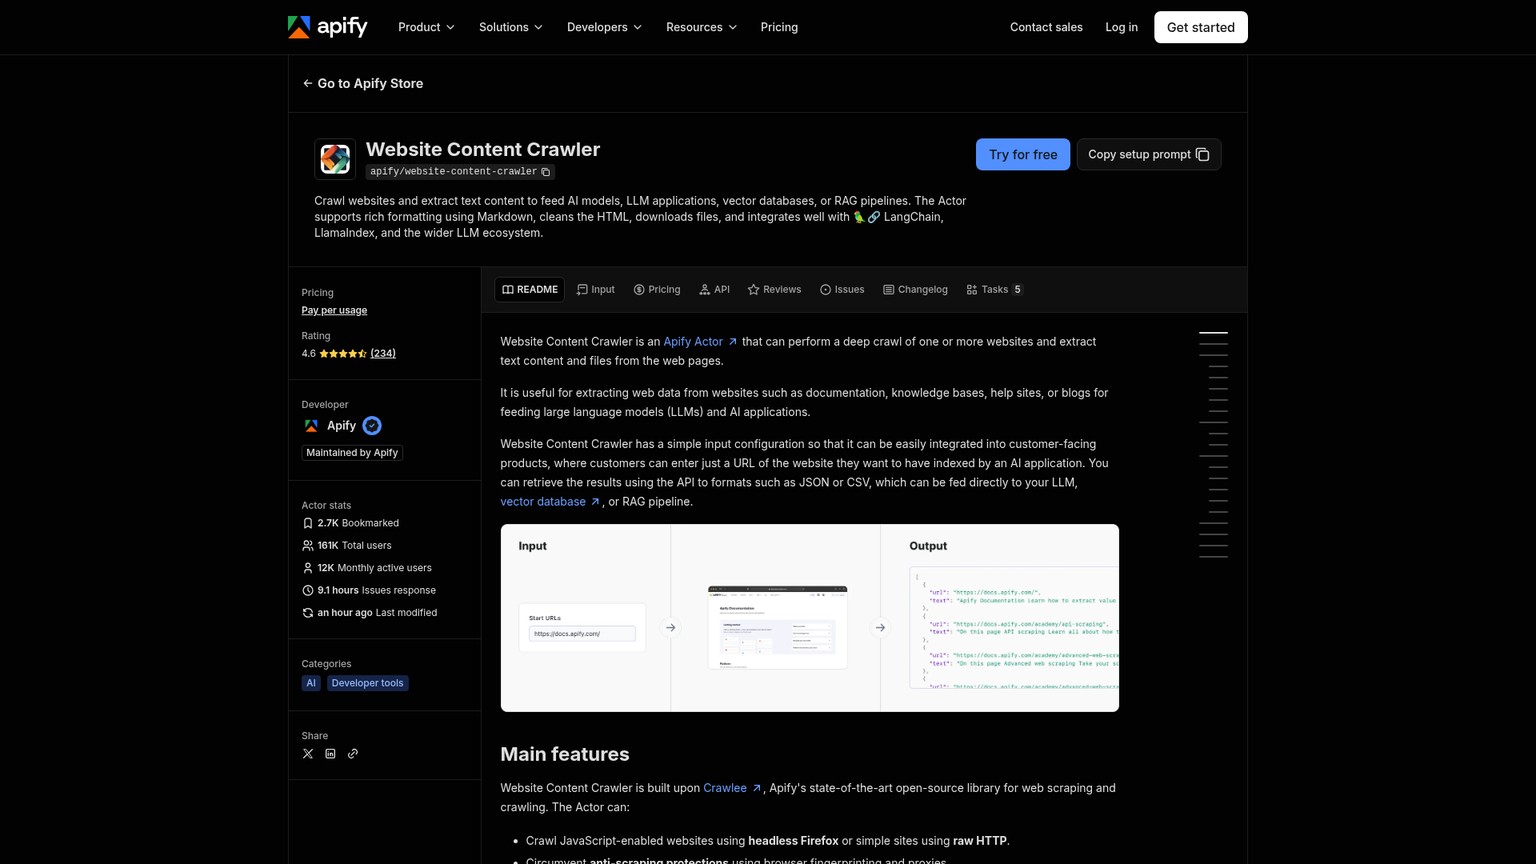
Su ventaja más clara es el control del rastreo como trabajo. El alcance, la salida y los registros persistentes del dataset conviven en el mismo lugar, y se pueden descargar archivos como PDF. Su límite declarado es la extracción semántica: el dataset JSON del Actor es un contenedor estructurado con texto, Markdown y metadatos, pero un esquema empresarial personalizado todavía exige reglas deterministas, otro Actor o una etapa de modelo.
La estimación publicada del Actor es de aproximadamente $0.20 por 1,000 páginas mediante HTTP directo y entre $0.50 y $5 por 1,000 páginas headless con su referencia indicada. Los resúmenes con IA opcionales añaden cerca de $2 a $3 por 1,000 páginas; aquellas sin encabezados pueden llegar a unos $7 por 1,000. El modelo anterior evita ese complemento porque un resumen no sustituye a los campos JSON obligatorios.
Los planes de Apify son Free a $0 con $5 de uso mensual y 5 ejecuciones simultáneas; Starter a $19 con $19 de uso y 32 ejecuciones simultáneas; Scale a $199 con $199 de uso, unidades de cómputo a $0.16 y 128 ejecuciones simultáneas; Business a $999 con $999 de uso, unidades de cómputo a $0.13 y 256 ejecuciones simultáneas; y Enterprise personalizado. El uso gratuito se detiene cuando se agota. Los planes de pago continúan como excedente y el uso no consumido no se acumula. La página actual de precios de Apify es la fuente de estas condiciones de la plataforma.
Ideal para: Un equipo pequeño de producto o datos que sustituye un trabajo de rastreo gestionado, en especial si importan el historial de ejecuciones y las exportaciones de datasets.
Diferencial: Descubrimiento de sitios completos, renderizado en navegador, Markdown y registros JSON persistentes en el mismo trabajo gestionado.
Precio: Free $0; Starter $19; Scale $199; Business $999; Enterprise personalizado. El costo real del Actor también incluye el cómputo, el almacenamiento, los proxies y la transferencia que utilice la ejecución.
Prueba gratuita: El plan Free permanente incluye $5 de uso mensual de la plataforma sin tarjeta.
- HTTP directo y Firefox headless cubren tanto páginas estáticas baratas como páginas con JavaScript.
- Los registros del dataset facilitan revisar y exportar respuestas guardadas.
- El alcance del rastreo, las descargas de archivos, los metadatos y Markdown se reúnen en un trabajo gestionado.
- La factura de la plataforma abarca cómputo, almacenamiento, transferencia y uso de proxies, no un único crédito por página.
- Un registro de dataset en JSON no se convierte automáticamente en el esquema empresarial que espera el código posterior.
- Los resúmenes con IA suman un costo de Actor independiente y aun así no prueban que la extracción sea aceptable.
Prueba de migración a Apify en cinco pasos
Cargue el manifiesto fijo de URL
Empiece con las 20 URL de prueba, no con todo el dominio de producción. Fije la entrada del Actor, el tipo de crawler, el límite de páginas y el alcance para que una segunda ejecución signifique lo mismo.
Use HTTP directo hasta que una página demuestre que necesita navegador
Reserve la ruta barata para las páginas estáticas y envíe las pruebas con JavaScript al renderizado headless. Guarde junto a cada resultado el modo de crawler elegido.
Exporte Markdown y el registro del dataset
Conserve sin cambios
markdown, la URL canónica, los metadatos y los enlaces. Transforme ese registro al esquema JSON local obligatorio en un paso determinista independiente.Rechace antes de fragmentar
Ejecute los controles de tablas, código, enlaces y campos obligatorios sobre el registro normalizado. Si una sola regla falla, la URL pasa al registro de reintentos, no al índice vectorial.
Calcule el precio solo con páginas aceptadas
Divida entre las páginas aceptadas la factura completa del Actor, los proxies, el almacenamiento y la operación. Compare el resultado con la referencia de Firecrawl antes de ampliar el rastreo.
2. Crawl4AI: la mejor alternativa con alojamiento propio
Crawl4AI es la mejor opción con alojamiento propio cuando controlar la infraestructura, mantener los límites de los datos o reutilizar reglas de extracción son requisitos innegociables. Produce Markdown y admite extracción estructurada mediante CSS, XPath o una estrategia con LLM, de modo que puede generar tanto texto para recuperación como campos JSON sin cobrar una licencia de software por solicitud.
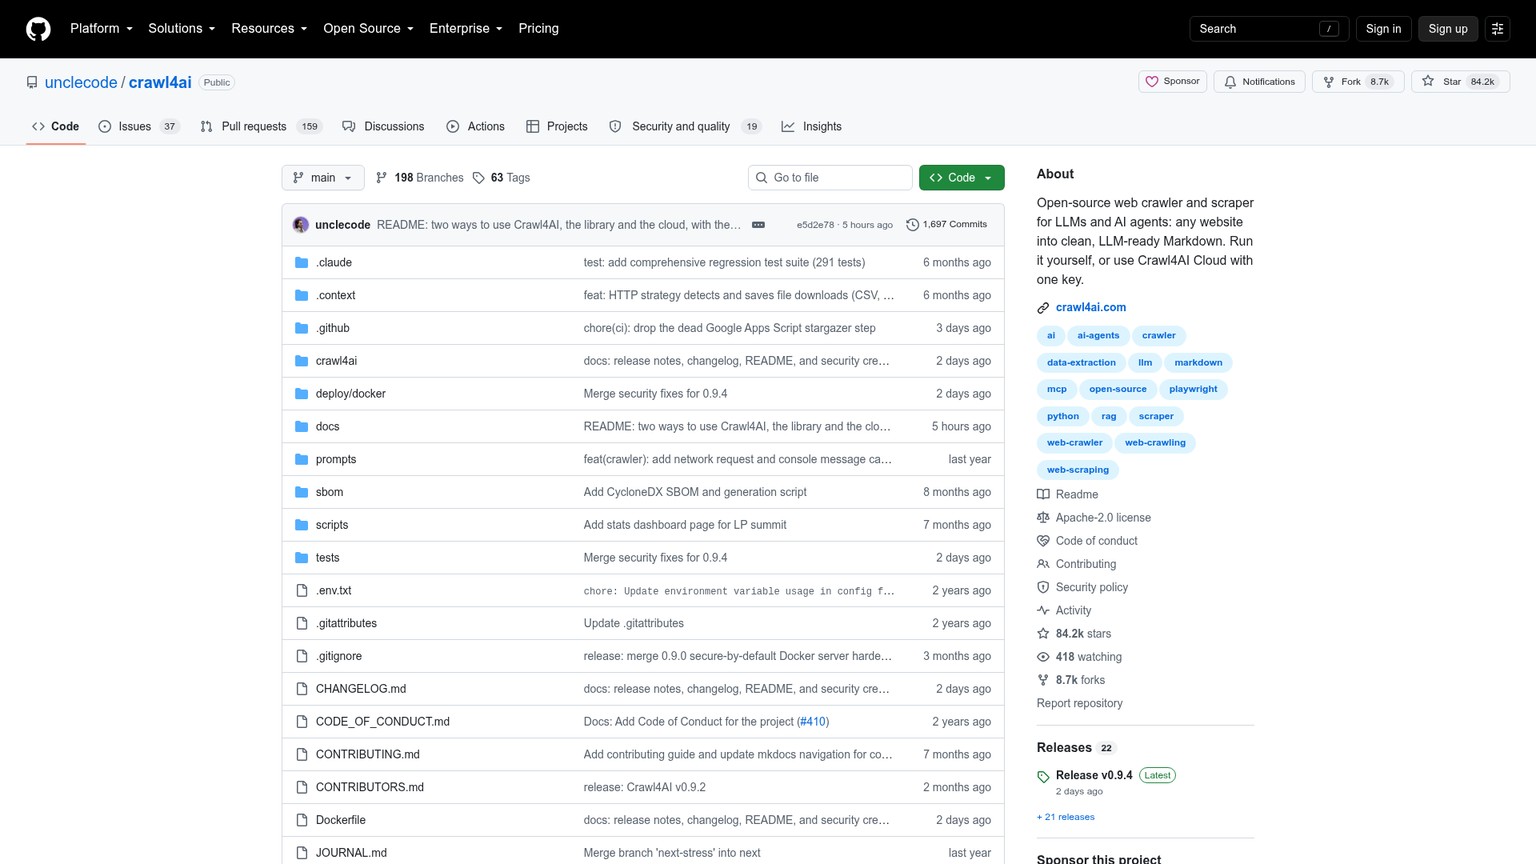
El umbral de seguridad actual importa más que el precio de la licencia. La versión 0.9.4 se publicó el 23 de septiembre de 2026 y corrige tres avisos, entre ellos dos vías de falsificación de solicitudes del lado del servidor y un fallo en el límite de confianza de la configuración que podía exponer valores del entorno. Toda evaluación debería fijar la versión v0.9.4 o una posterior, y revisar los avisos de seguridad del proyecto antes de exponer su API.
Crawl4AI frente a Firecrawl
Firecrawl vende el servicio operado que rodea al rastreo: colas gestionadas, navegadores, créditos, entrega y soporte. Crawl4AI proporciona el crawler y el sistema de extracción, mientras el equipo se hace cargo del despliegue, las actualizaciones, la observabilidad, la estrategia de proxies y la respuesta ante incidentes. La balanza cambia cuando esas responsabilidades ya son capacidades compartidas de la plataforma, no cuando un solo ingeniero debe crearlas para este proyecto.
Para el alojamiento propio se recomiendan al menos 4 GB de RAM, Docker 20.10 o posterior y Compose 2.24 o posterior. La hoja de costos utiliza los precios actuales de los Droplets Basic de DigitalOcean: $24 por 4 GiB, $48 por 8 GiB y $96 por 16 GiB. Esos tamaños solo son datos del escenario; en esta evaluación no se midió el rendimiento por página.
Ideal para: Equipos con una plataforma de contenedores existente, un límite estricto para los datos e ingenieros capaces de operar el crawler.
Diferencial: Control mediante código abierto y esquemas de extracción deterministas con CSS o XPath que pueden evitar el gasto en modelos por página.
Precio: Licencia de software a $0. El modelo utiliza servidores mensuales de $24, $48 y $96, además de proxies, almacenamiento, monitoreo, llamadas a modelos y trabajo según sea necesario.
Prueba gratuita: El software es de código abierto; la infraestructura no está incluida.
- Markdown y la extracción estructurada se ejecutan dentro de la infraestructura que controla el equipo.
- Los esquemas CSS y XPath pueden volver baratos y deterministas los sitios con estructura estable.
- Ahora el servidor alojado por el propio equipo prioriza de forma predeterminada una operación autenticada y segura en loopback.
- La reputación de los proxies, la capacidad del navegador, los parches, las colas y la recuperación pasan a ser responsabilidad del equipo.
- El tamaño del servidor no demuestra el rendimiento de páginas aceptadas sin una ejecución guardada.
- La extracción con LLM traslada el costo de tokens y la revisión del límite de datos a otro proveedor o a un modelo local.
La guía para alojar Firecrawl por cuenta propia aborda la decisión independiente entre el repositorio de Firecrawl y Firecrawl Cloud. No contabilice la licencia de $0 de Crawl4AI como ahorro hasta que la misma hoja incluya a las personas que lo mantienen actualizado y disponible.
3. ScrapFly: la mejor combinación de rastreo y extracción para equipos pequeños
ScrapFly es la alternativa más sólida para equipos pequeños cuando una sola cuenta debe cubrir acceso, rastreo, conversión a Markdown y extracción tipada. Sus productos comparten un saldo de créditos y la capa de extracción acepta HTML, Markdown, XML, JSON, CSV, RSS o texto sin formato. Los equipos pueden usar plantillas deterministas, modelos preentrenados o un prompt con esquema JSON sin tener que conectar proveedores distintos.
El modelo de créditos resulta claro una vez fijada la configuración. Una solicitud HTTP sencilla mediante centro de datos cuesta 1 crédito; el renderizado de JavaScript o Unblocker, 5; el enrutamiento residencial, 25; y una captura de pantalla de página completa, 60. La extracción mediante plantilla suma 1 crédito, mientras que un prompt o modelo de extracción cuesta 5. Los documentos de más de 500 KB repiten el cargo base de extracción por cada 500 KB adicionales.
Así, el escenario del artículo cuesta 10 créditos por intento exitoso: 5 por el navegador o Unblocker más 5 por la extracción. Con la reserva del 10% para reintentos, el resultado es de 11 créditos por página aceptada. El modelo no añade enrutamiento residencial; si un destino lo necesita, la respuesta cambia de forma drástica.
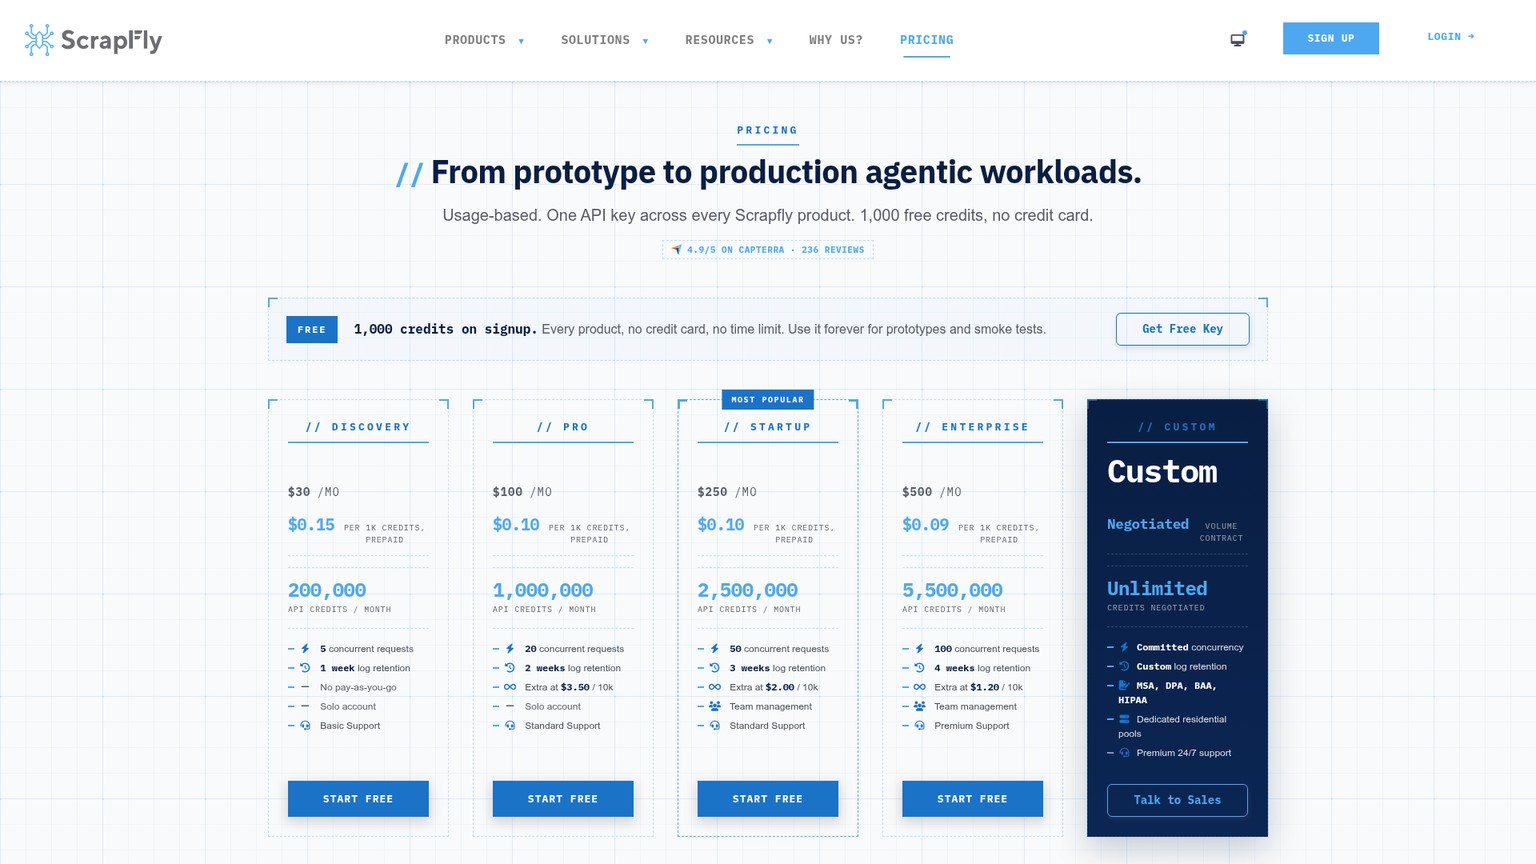
Los planes actuales son Free con 1,000 créditos por única vez; Discovery a $30 al mes con 200,000 créditos y 5 solicitudes simultáneas; Pro a $100 con 1,000,000 de créditos y 20 solicitudes simultáneas; Startup a $250 con 2,500,000 créditos y 50 solicitudes simultáneas; Enterprise a $500 con 5,500,000 créditos y 100 solicitudes simultáneas; y Custom negociado. Discovery se detiene al alcanzar su cuota. El excedente de Pro cuesta $3.50 por 10,000 créditos; el de Startup, $2; y el de Enterprise, $1.20. Los créditos sin utilizar no se acumulan. Estas condiciones proceden de los precios actuales de ScrapFly.
Ideal para: Un equipo pequeño que quiere un crawler gestionado, controles de acceso y extracción tipada en una sola factura.
Diferencial: El mismo saldo de créditos puede financiar el crawler, el navegador, Unblocker y tres estrategias de extracción.
Precio: Free, 1,000 créditos; Discovery, $30; Pro, $100; Startup, $250; Enterprise, $500; Custom negociado.
Prueba gratuita: 1,000 créditos al registrarse, sin tarjeta y sin fecha de caducidad publicada.
- La extracción con plantillas puede reducir el costo de los modelos en diseños estables.
- La extracción preentrenada y mediante prompts devuelve JSON tipado sin depender de otro proveedor de modelos.
- Las solicitudes fallidas no consumen créditos y la respuesta informa cuántos se utilizaron.
- Las opciones de navegador, conexión residencial y extracción se acumulan con rapidez en páginas difíciles.
- Los documentos de más de 500 KB multiplican el cargo de extracción.
- Discovery no admite excedentes; los trabajos de producción necesitan Pro o una detención estricta antes de agotar la cuota.
ScrapFly gana la hoja de cálculo con 10,000 páginas aceptadas en este escenario concreto: $30 más tres horas de operación, frente a $83 más tres con Firecrawl. Esa diferencia mensual de $53 en efectivo es demasiado pequeña para justificar una migración imprecisa. Solo resulta convincente si se supera la prueba fija, los destinos de producción evitan la ruta residencial de 25 créditos y el esquema no requiere limpieza adicional.
4. Jina Reader: la mejor opción cuando ya existe una lista de URL
Jina Reader es el convertidor con menor costo variable cuando el descubrimiento ya está resuelto y cada URL proporcionada debe convertirse en Markdown limpio o JSON con la forma de un esquema. Su motor predeterminado renderiza JavaScript en un navegador headless, mientras el motor directo recorre la ruta HTTP más sencilla. ReaderLM-v2 admite un esquema JSON o una instrucción en lenguaje natural para producir una salida estructurada.
Su ventaja también marca su frontera: Reader lee una URL. No sustituye las reglas de alcance de un sitio completo, la frontera de rastreo, la política de duplicados ni el manifiesto del rastreo. Si un sitemap, una etapa de búsqueda o un catálogo interno aporta una lista fiable de URL, ese cometido acotado puede ser una virtud. Si no es así, el costo del descubrimiento debe volver a la hoja de cálculo.
El uso básico de Reader es gratuito. Una clave nueva incluye 10 millones de tokens, y al usarla se cobran los tokens de salida. Una recarga de 1 millardo de tokens cuesta $50, o $0.050 por millón; una recarga de 11 millardos cuesta $500, o $0.045 por millón. Las solicitudes fallidas no descuentan tokens. Los límites son de 20 solicitudes por minuto sin clave, 500 con una clave gratuita o de pago y 5,000 con una clave premium. Todas las cifras proceden de la página actual de Jina Reader.
La hoja presupone 2,000 tokens de salida por cada intento exitoso. Así, después de la reserva para reintentos, el valor de los tokens consumidos es de $0.11 por 1,000 páginas aceptadas, $1.10 por 10,000 y $11 por 100,000. Estos son valores de uso económico, no el importe cobrado al pagar. Una vez agotado el saldo gratuito, la compra mínima publicada sigue siendo de $50.
Ideal para: Un pipeline con un manifiesto fiable de URL que necesita conversión de páginas a Markdown o JSON a bajo costo.
Diferencial: Cobro por tokens de salida, renderizado de JavaScript y extracción con esquema JSON en una API de lectura acotada.
Precio: El uso básico de Reader es gratuito; cada clave nueva recibe 10 millones de tokens; los paquetes de pago cuestan $50 por 1 millardo o $500 por 11 millardos.
Prueba gratuita: 10 millones de tokens con una clave de API nueva.
- El renderizador predeterminado procesa JavaScript del lado del cliente antes de convertir la página.
- Los modos de esquema JSON e instrucciones pueden obtener campos estructurados con el mismo lector.
- Las solicitudes fallidas no consumen tokens.
- El descubrimiento del sitio, el alcance y la persistencia del estado del rastreo requieren otro componente.
- Un paquete de tokens de $50 es el desembolso mínimo una vez agotado el saldo gratuito, aunque el consumo actual valga mucho menos.
- El costo de los tokens de salida varía según la longitud de la página y el formato de respuesta.
Jina parece ser el ganador en costo para 100,000 páginas, con $11 más seis horas, pero solo bajo el supuesto de que se proporciona el manifiesto. Añadir un trabajo de descubrimiento poco fiable y deduplicación manual volvería esa fila incomparable con Firecrawl o Apify. Úselo cuando el límite del componente sea real, no para ocultar trabajo de rastreo ausente.
5. ScrapingBee: la mejor API de scraping con límite de créditos
ScrapingBee es la mejor alternativa por solicitud cuando un equipo quiere limitar cuánto puede costar una sola página. Puede devolver Markdown de la página o una respuesta JSON, aplicar reglas de extracción CSS y añadir extracción con IA cuando los diseños no son lo bastante estables para usar selectores.
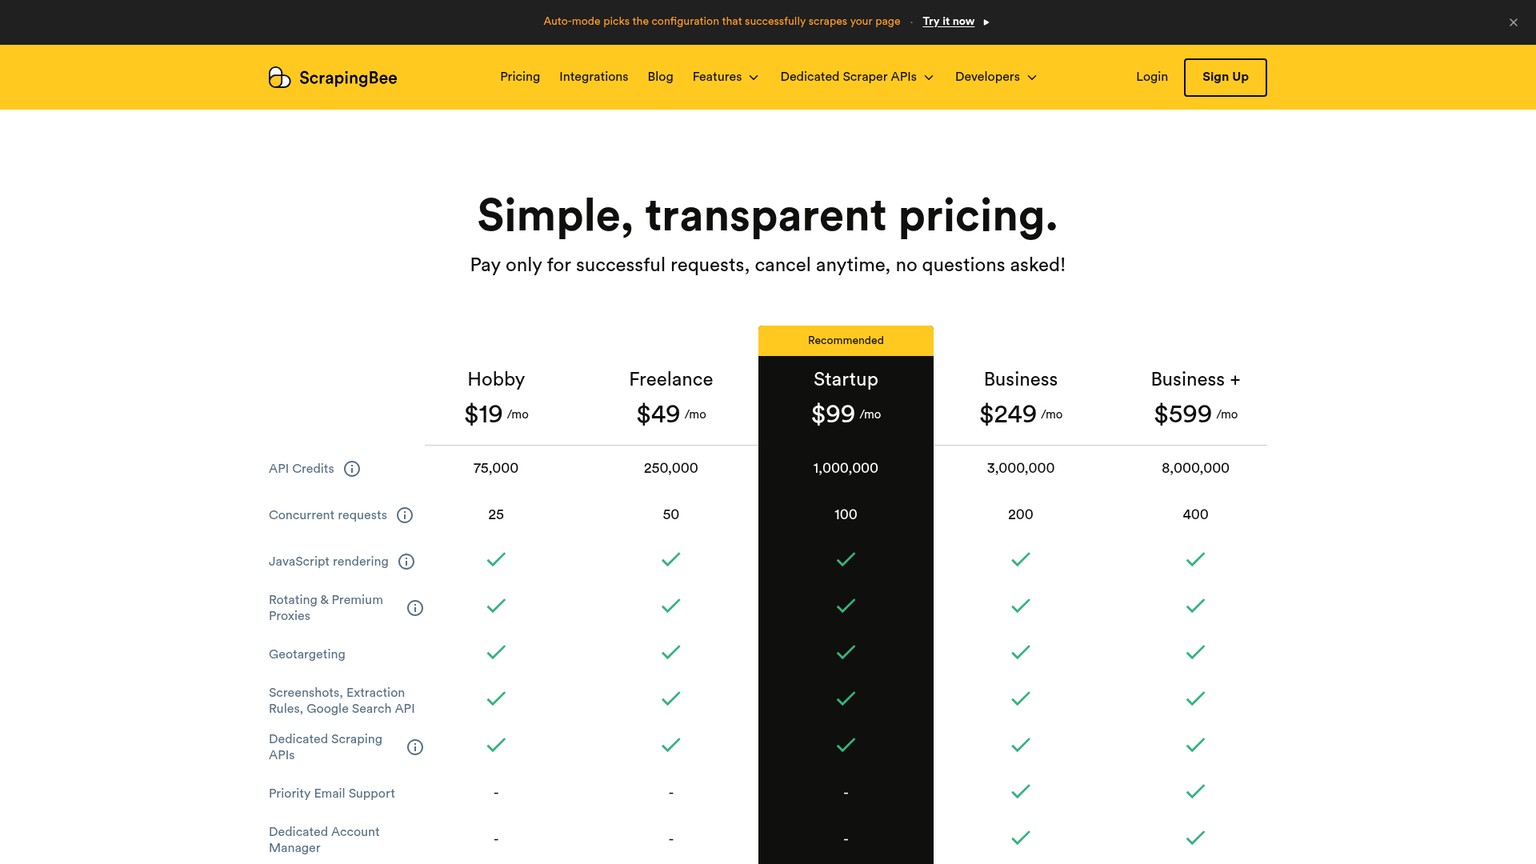
El control útil es la escala de créditos. HTTP clásico cuesta 1 crédito; JavaScript clásico, 5; premium sin JavaScript, 10; premium con JavaScript, 25; y stealth con JavaScript, 75. Las funciones de IA suman 5 créditos. El modo Auto cobra por la configuración que funciona, no cobra nada si todas fallan y permite fijar un costo máximo.
El límite está en la orquestación. ScrapingBee recupera las páginas solicitadas, pero no es el equivalente más cercano al descubrimiento de sitios y la frontera de rastreo de Firecrawl. El equipo debe encargarse del manifiesto de URL, el alcance, los duplicados y el estado del trabajo; después, tiene que distinguir entre un fallo del proveedor y una respuesta exitosa que no supera su validación local.
Los planes actuales son Hobby a $19 al mes por 75,000 créditos y 25 solicitudes simultáneas; Freelance a $49 por 250,000 y 50; Startup a $99 por 1,000,000 y 100; Business a $249 por 3,000,000 y 200; y Business+ a $599 por 8,000,000 y 400. La asignación para evaluar el servicio es de 1,000 créditos sin tarjeta. Estas cifras proceden de los planes actuales de ScrapingBee.
Ideal para: Equipos que ya gestionan el descubrimiento y necesitan límites explícitos para el renderizado, los proxies premium y el costo de cada solicitud.
Diferencial: El modo Auto puede intensificar el acceso mientras max_cost limita el consumo de una sola respuesta.
Precio: Hobby $19; Freelance $49; Startup $99; Business $249; Business+ $599.
Prueba gratuita: 1,000 créditos sin tarjeta.
- Markdown, la extracción CSS y la extracción con IA están disponibles en una sola API de solicitudes.
- La escala de 1, 5, 10, 25 y 75 créditos permite inspeccionar el costo del acceso.
- El modo Auto no cobra nada cuando fallan todas sus configuraciones internas.
- El descubrimiento del sitio y la persistencia del rastreo quedan fuera de los límites del producto.
- Un intento exitoso para el proveedor que el esquema local rechaza sigue siendo de pago.
- El consumo puede multiplicarse por 15 entre JavaScript clásico y JavaScript stealth, incluso antes de añadir la extracción con IA.
En el modelo, JavaScript más extracción con IA consume 10 créditos por intento. La reserva para reintentos eleva el resultado a 11 por página aceptada: 1,000 páginas caben en Hobby por $19; 10,000, en Freelance por $49; y 100,000, en Business por $249, porque 1.1 millones de créditos superan el límite de 1 millón de Startup.
6. Zyte API: la mejor tarifa antibot por sitio
Zyte API encaja mejor cuando la dificultad de acceso varía mucho según el destino y el comprador quiere que el proveedor asigne un nivel de precio a cada sitio. Incluye en el precio de la respuesta la ruta necesaria por centro de datos o red residencial, el renderizado y el trabajo de acceso, y solo cobra las respuestas exitosas.
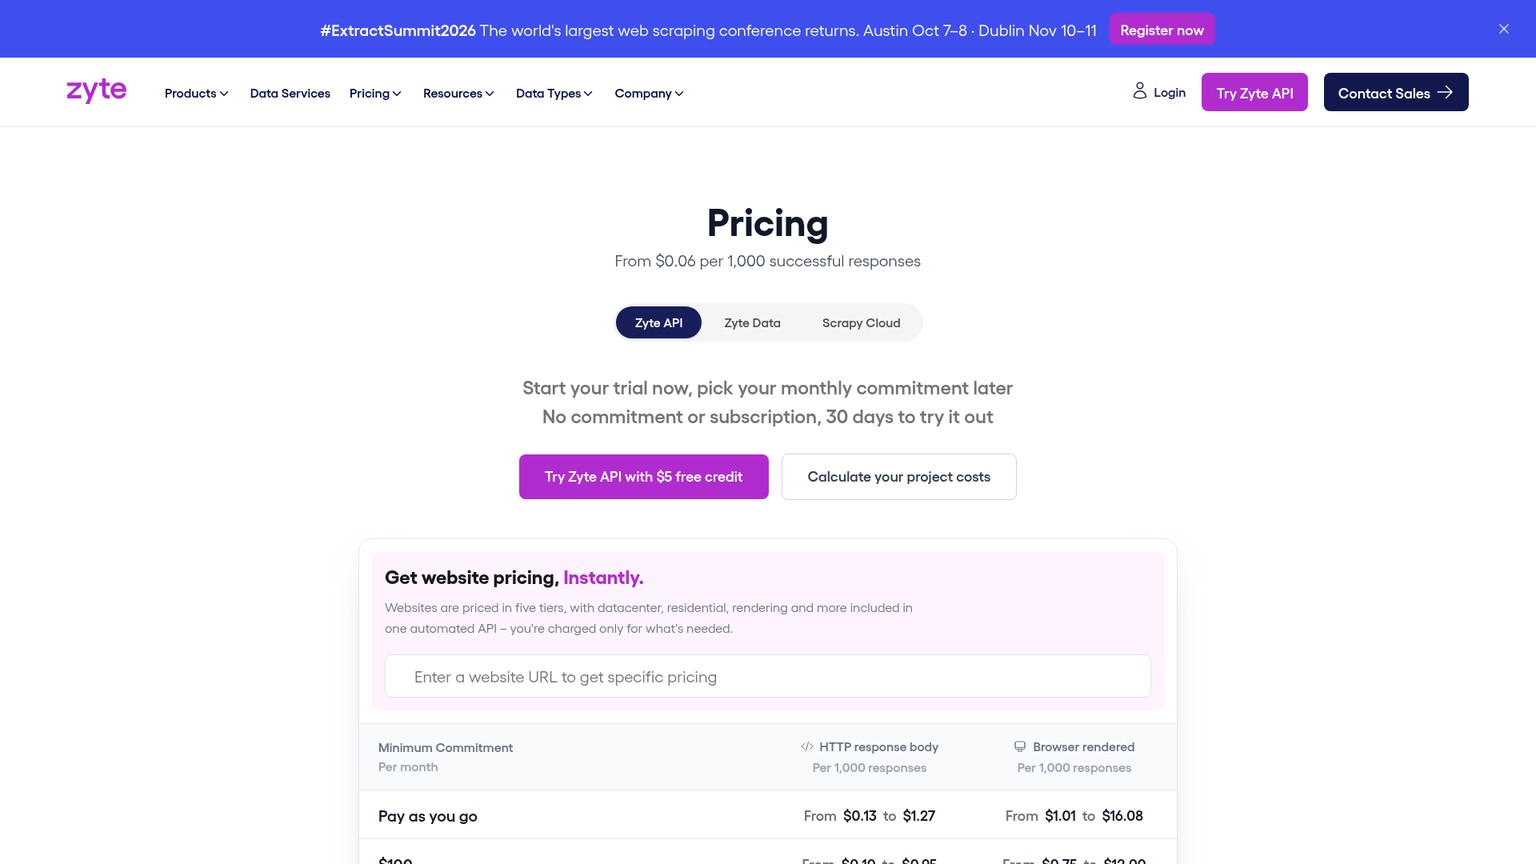
Los precios HTTP de pago por uso por cada 1,000 respuestas son $0.13, $0.23, $0.44, $0.70 y $1.27 para los niveles de sitio del 1 al 5. Las respuestas renderizadas en navegador cuestan $1.01, $2.01, $4.02, $8.04 y $16.08. Con un compromiso mensual de $100, esas tarifas de navegador pasan a $0.75, $1.50, $3, $6 y $12; con $200, son $0.60, $1.20, $2.40, $4.80 y $9.60; con $500, son $0.48, $0.96, $1.92, $3.84 y $7.68.
Los esquemas de compromisos para HTTP también son importantes. Con $100, los niveles del 1 al 5 cuestan $0.10, $0.17, $0.33, $0.53 y $0.95 por 1,000. Con $200, cuestan $0.08, $0.14, $0.26, $0.42 y $0.76. Con $500, cuestan $0.06, $0.11, $0.21, $0.34 y $0.61. Enterprise ofrece más descuentos negociados. La página actual de precios de Zyte también incluye $5 de crédito de prueba durante 30 días.
Los atributos personalizados pueden usar un método fijo extract por $0.001 o uno generativo por $0.002 cada 1,000 tokens de entrada y $0.01 cada 1,000 tokens de salida. La extracción automática cuesta entre $0.0004 y $0.0016 por tipo de datos. Así se obtiene una partida de extracción clara en la hoja de cálculo, en lugar de esconder el uso del modelo dentro de un plan indiferenciado.
El límite de esta comparación es la salida. Zyte documenta cuerpos HTTP, HTML de navegador y campos estructurados, no un contrato de respuesta en Markdown nativo. Por tanto, una conversión posterior de HTML a Markdown y sus pruebas de regresión siguen formando parte de la migración.
Ideal para: Extracción en varios dominios cuando la dificultad del destino, la necesidad de un navegador y la infraestructura de acceso determinan la mayor parte de la factura del proveedor.
Diferencial: Cinco niveles de solicitud por sitio y ningún cargo por respuestas fallidas o limitadas por tasa.
Precio: PAYG sin compromiso; compromisos mensuales de $100, $200 y $500; Enterprise con descuentos adicionales. El precio de la respuesta depende del nivel del sitio y de si la salida es HTTP o de navegador.
Prueba gratuita: $5 de crédito durante 30 días, sin compromiso.
- El nivel específico del destino integra la infraestructura de acceso en un único precio por respuesta.
- Cobrar solo las respuestas exitosas elimina el costo directo de los límites de tasa y los fallos declarados por el proveedor.
- Los atributos personalizados con precio fijo o por tokens hacen visibles los cargos de extracción.
- Markdown nativo no es una salida documentada, por lo que la conversión queda en manos del equipo.
- El nivel de un destino puede cambiar, y una respuesta exitosa aún puede fallar la validación local de contenido.
- El descubrimiento del sitio completo y el diseño posterior del estado de rastreo requieren una configuración deliberada.
La hoja utiliza renderizado en navegador de nivel 3 más una extracción personalizada fija. El resultado es un consumo estimado del proveedor de $5.52, $55.22 y $374 en los tres volúmenes. Es un escenario, no un precio universal de Zyte; sustituya el nivel por la cotización de los dominios que rastreará.
7. Bright Data Crawl API: la mejor opción a escala para sitios protegidos
Bright Data Crawl API es el candidato más sólido cuando el acceso a sitios protegidos, la infraestructura de proxies y la concurrencia dominan los requisitos. Su precio incluye renderizado de JavaScript, proxies residenciales, validación, resolución de CAPTCHA, geolocalización, descubrimiento, análisis a JSON o CSV y concurrencia ilimitada.
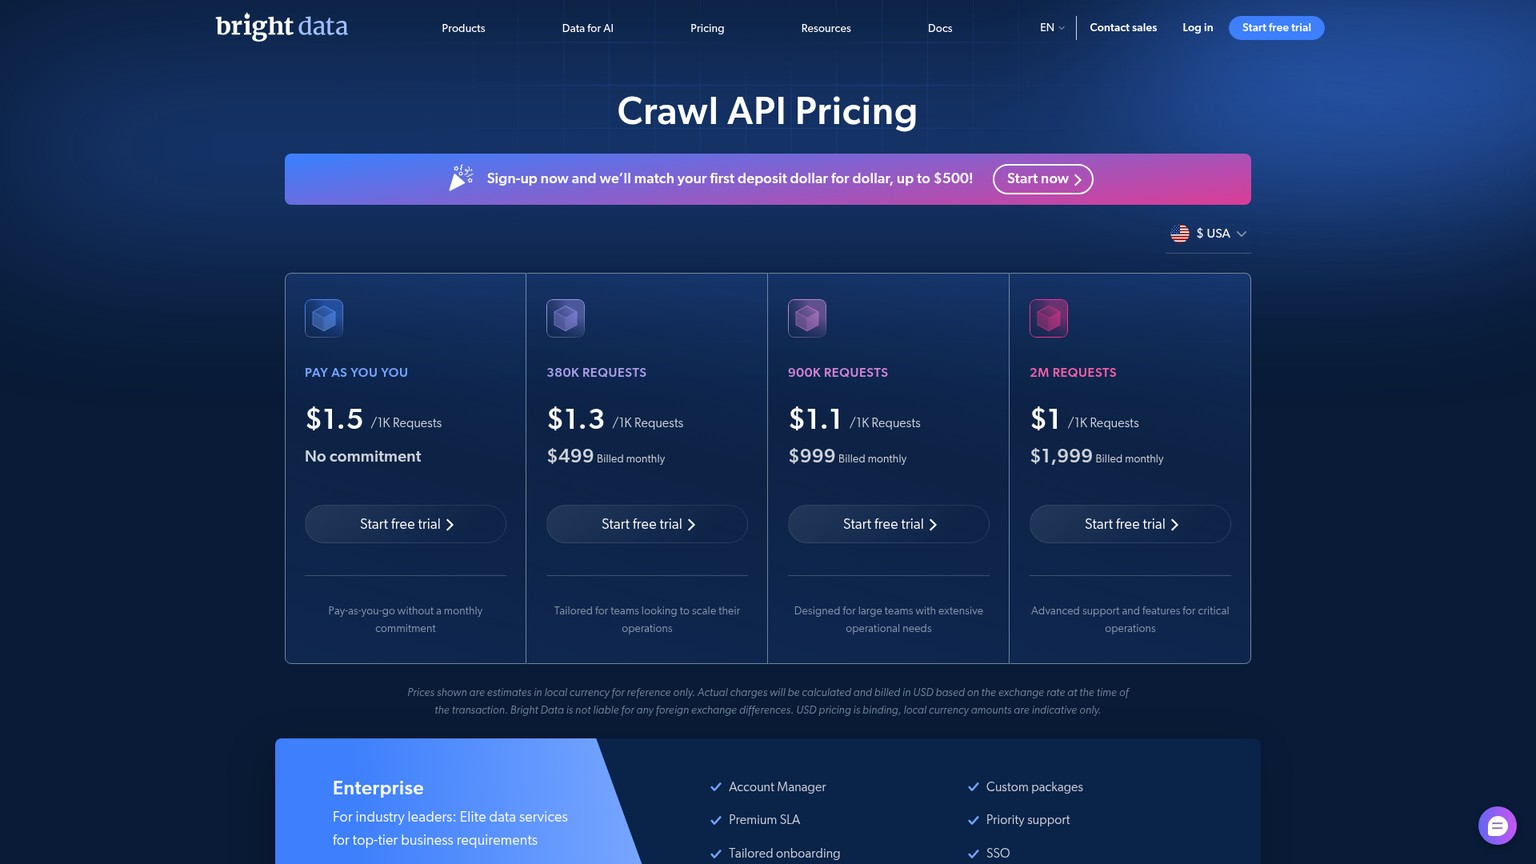
El producto parte de $1.50 por 1,000 solicitudes de pago por uso sin compromiso. El plan de 380,000 solicitudes cuesta $499 al mes, a $1.30 por 1,000; 900,000 solicitudes cuestan $999, a $1.10 por 1,000; y 2 millones de solicitudes cuestan $1,999, a $1 por 1,000. Enterprise es personalizado. Estos son los precios actuales de Bright Data Crawl API.
El límite importante es el mismo que afecta a Zyte: los formatos de entrega documentados son NDJSON y CSV, no Markdown nativo. En un pipeline de recuperación que exige encabezados, bloques de código, tablas y enlaces de origen estables en Markdown, el convertidor es un componente de producción. Sus fallos y el tiempo de operación deben entrar en el denominador.
Con tarifas de pago por uso, una reserva facturable del 10% para reintentos sitúa el desembolso al proveedor en $1.65 por 1,000 páginas aceptadas, $16.50 por 10,000 y $165 por 100,000. Esas cifras pequeñas por solicitud no deben interpretarse como costos completos. La hoja asigna cuatro, cinco y ocho horas a la conversión a Markdown, la normalización del esquema y la revisión; un destino difícil puede cambiar el comportamiento de las solicitudes.
Ideal para: Recopilación con alta concurrencia en dominios protegidos, donde el acceso gestionado aporta más valor que Markdown nativo.
Diferencial: Renderizado, enrutamiento residencial, gestión de CAPTCHA, validación y concurrencia ilimitada incluidos en el precio de Crawl API.
Precio: PAYG a $1.50 por 1,000 solicitudes; $499 por 380,000; $999 por 900,000; $1,999 por 2 millones; Enterprise personalizado.
Prueba gratuita: Las tarjetas de precios actuales ofrecen una prueba gratuita, pero las condiciones visibles del plan no indican la cantidad de crédito.
- Se incluye la infraestructura de acceso que, de otro modo, exigiría varios componentes.
- La concurrencia ilimitada se adapta a trabajos grandes con plazos de entrega estrictos.
- NDJSON y CSV permiten una entrega legible por máquinas sin extraer datos del panel del proveedor.
- Markdown nativo no forma parte del contrato de salida documentado.
- El costo PAYG por solicitud oculta por sí solo el trabajo de conversión, esquema y revisión de páginas aceptadas.
- La amplia pila de acceso supone una sobrecarga innecesaria para sitios públicos de documentación que HTTP directo procesa sin problemas.
Alternativas a Firecrawl de código abierto que un equipo puede operar
Crawl4AI es la alternativa de código abierto más clara de esta selección, aunque Firecrawl también publica un núcleo que puede alojarse por cuenta propia. La diferencia importante no es si se puede clonar un repositorio, sino si el despliegue abierto reproduce el descubrimiento, el acceso mediante navegador, las colas, la persistencia, la observabilidad y el contrato de salida de los que depende el pipeline empresarial.
En Crawl4AI, fije la versión 0.9.4 o una posterior, exija autenticación, configure de forma segura las interfaces de red de las instancias privadas de evaluación y guarde la versión exacta de la imagen o el paquete con cada conjunto de resultados. En plantillas estables, priorice la extracción mediante CSS o XPath; después, aísle cualquier proveedor de extracción con LLM como una frontera independiente de costo y datos. Las 8 a 20 horas mensuales de operación del modelo no son un benchmark: son una invitación a poner precio a los parches, los fallos de proxies, los cambios de esquema y la recuperación, en lugar de considerarlos gratuitos.
Para el núcleo de Firecrawl, trate la elección entre Cloud y alojamiento propio como una decisión de arquitectura independiente. El repositorio puede eliminar una partida de créditos del proveedor, pero añade PostgreSQL, Redis, RabbitMQ, workers de navegador, monitoreo y actualizaciones a la carga del equipo. El artículo específico sobre alojamiento propio enlazado arriba incluye un paquete de verificación para tomar esa decisión.
¿Cuál es la mejor IA para web scraping?
La mejor opción depende del límite de entrada. Si la entrada es un dominio y la salida debe ser un corpus completo en Markdown y JSON, empiece por Firecrawl o Apify y después calcule el costo de ScrapFly. Si la entrada ya es una lista fiable de URL, Jina Reader elimina la maquinaria de rastreo y puede ser mucho más barato. Si el acceso es lo difícil, compare el límite de costo de ScrapingBee con los niveles por sitio de Zyte y la pila de acceso integrada de Bright Data.
Los agentes de IA para web scraping necesitan una validación de aceptación
Un agente nunca debería decidir que una respuesta 200 está lista para recuperación. Asígnele una validación determinista: campos obligatorios, longitud mínima de Markdown, conservación de tablas y código, enlaces normalizados, hash de contenido, tipo de contenido permitido y reglas explícitas para valores nulos. El agente puede dirigir los fallos, pero no debe renunciar al contrato para mantener un trabajo en marcha.
La decisión cambia en cuatro puntos:
- Quédese con Firecrawl cuando supere la prueba y los ahorros de seis meses no compensen la migración ni el trabajo de ejecutar ambos sistemas.
- Elija Apify cuando importen más un trabajo de rastreo gestionado, un dataset persistente y un flujo flexible con Actors que una cifra única de créditos por página.
- Elija Crawl4AI cuando el equipo ya gestione contenedores, enrutamiento de acceso y cobertura de guardia, o cuando un límite de datos impida usar procesamiento gestionado.
- Elija una API más acotada cuando el descubrimiento ya esté resuelto o el acceso a páginas protegidas domine el trabajo. Jina, ScrapingBee, Zyte y Bright Data solo muestran su mayor fortaleza si esa frontera está por escrito.
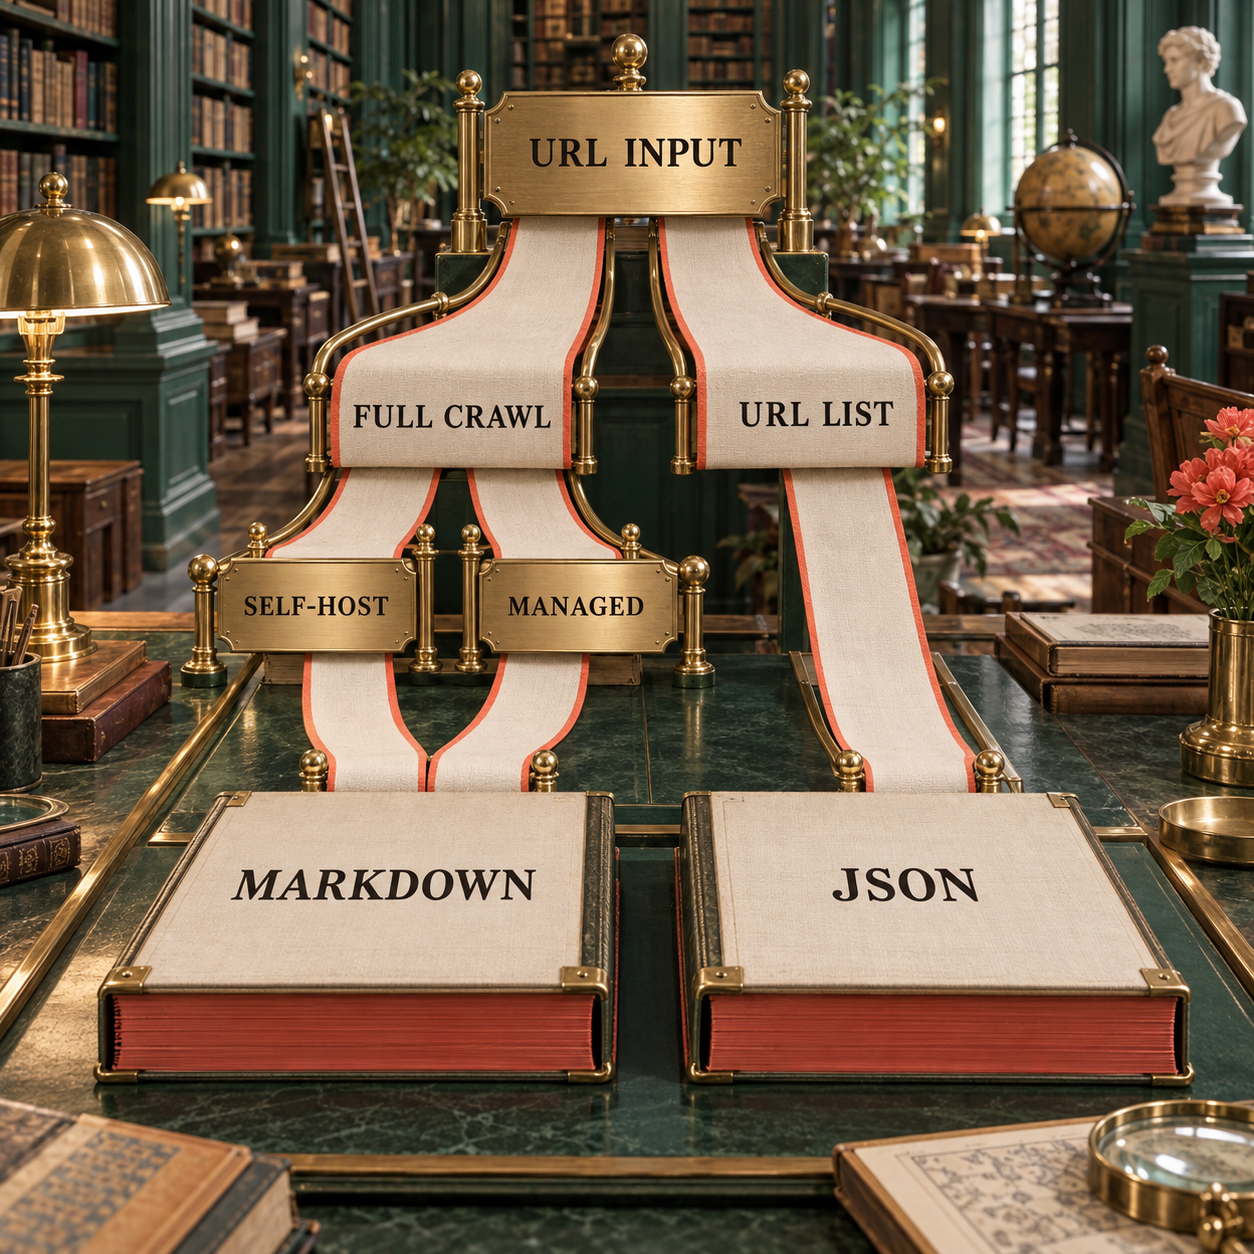
No decida por el resultado más atractivo de un entorno de pruebas. La configuración elegida debe superar la misma prueba, guardar las mismas evidencias y producir los mismos fragmentos posteriores. Una herramienta que parece más limpia con una página de artículo puede fallar en la tabla, el PDF o la ruta de JavaScript que determina la aceptación en producción.
Qué opciones evitar como reemplazo directo
Evite comprar un producto de una categoría contigua y fingir que el pipeline está completo. Estas herramientas pueden ser útiles, pero no sustituyen todo el trabajo de Firecrawl definido aquí:
- Exa y Tavily: manténgalos en la evaluación de proveedores de búsqueda. Quedaron fuera de esta selección porque este reemplazo comienza después de elegir un dominio o conjunto de URL y debe producir cuerpos de página aceptados.
- Playwright y Puppeteer por sí solos: la automatización del navegador es un componente, no un manifiesto de rastreo gestionado, un contrato de Markdown, un registro de reintentos ni un sistema de entrega estructurada. Elíjalos solo si la intención es construir esas capas.
- Un servicio que solo ofrece proxies: acceder a una respuesta no limpia la navegación, conserva enlaces, valida JSON ni mantiene estables los límites de los fragmentos.
- Un fork de crawler sin mantenimiento: un repositorio gratuito se convierte en un incidente cuando cambian las versiones del navegador, las correcciones de seguridad o el comportamiento del destino y nadie controla la ruta de publicación.
Tampoco utilice un benchmark comercial como prueba de migración. Si la configuración exacta no se ejecutó contra la prueba guardada de 20 URL, la cifra describe la carga de trabajo de otra persona. Este artículo no publica deliberadamente una tasa de aprobación sintética ni una clasificación de latencia.
Hoja de migración para un equipo pequeño
Una migración segura mantiene Firecrawl y el candidato en paralelo hasta que las salidas normalizadas, el comportamiento de los reintentos y los fragmentos coincidan en la prueba fija y en una muestra representativa de producción. La hoja necesita un responsable, un esquema versionado y un disparador de reversión.
1. Fije el contrato de entrada y descubrimiento
Registre si las URL proceden de un rastreo de dominio, un sitemap, una API de búsqueda, una cola o una base de datos interna. Guarde los dominios permitidos, la política de subdominios, las rutas incluidas y excluidas, la profundidad, el límite de páginas, la canonicalización y las reglas de duplicados. Una prueba con Jina o ScrapingBee no se puede comparar con Firecrawl salvo que otro componente proporcione toda esta fila.
2. Congele el esquema de salida
Versione los campos y tipos obligatorios. Como mínimo, conserve source_url, final_url, title, markdown, links, status_code, fetched_at y content_sha256. Marque qué campos empresariales pueden ser nulos y cuáles hacen que la página falle. Preserve la respuesta sin procesar para poder volver a ejecutar un cambio del analizador sin pagar de nuevo al crawler.
3. Defina los reintentos como eventos contables
Guarde para cada intento el estado del proveedor, el estado HTTP, el veredicto de aceptación, el motivo del reintento, el costo en créditos o solicitudes y la siguiente acción. Distinga entre errores de transporte, fallos declarados por el proveedor, bloqueos de acceso, contenido vacío, errores de esquema y fallos de conversión posteriores. Limite los reintentos y envíe los elementos agotados a una cola de mensajes fallidos, en lugar de crear un ciclo de gasto invisible.
4. Guarde el paquete de evidencias
Use una ruta definida por herramienta, versión, hash de configuración, fecha de ejecución e identificador de la prueba. Almacene la solicitud, los encabezados, la respuesta sin modificar, el JSON normalizado, el Markdown, el veredicto y el resumen. Un revisor debe poder identificar qué renderizador, modo de extracción y esquema generaron cada fragmento aceptado.
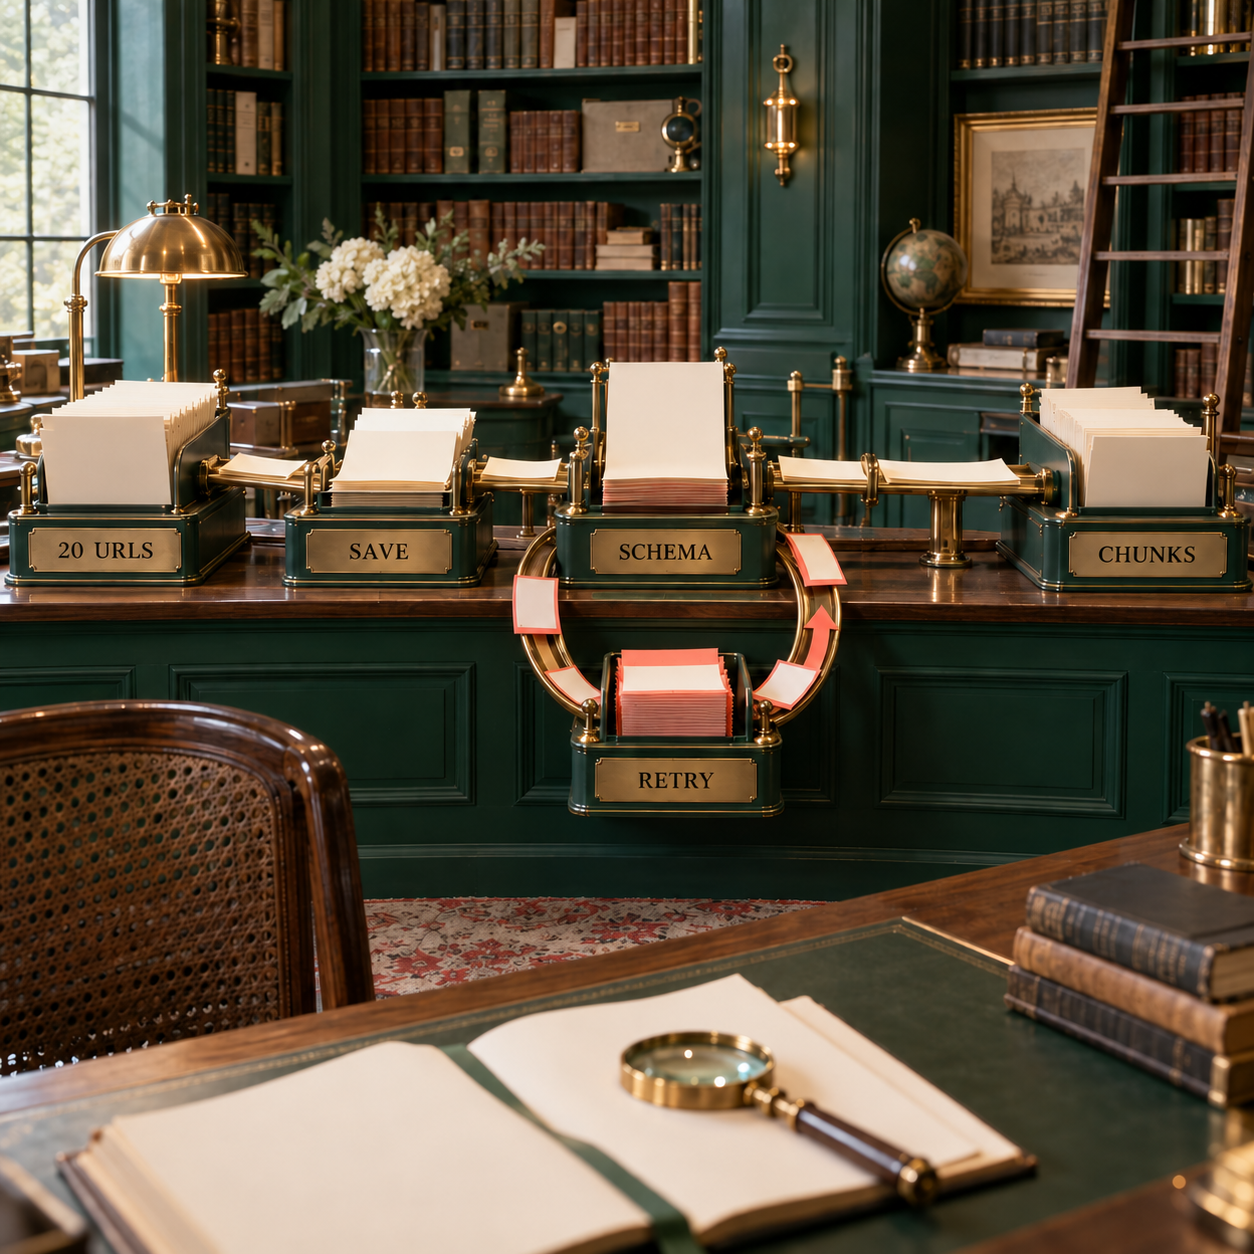
5. Ejecute pruebas de regresión sobre la fragmentación posterior
Compare la jerarquía de encabezados, los bloques de código, las tablas, los destinos de los enlaces, el orden del documento y los hashes de contenido antes de volver a generar embeddings. Después compare la cantidad de fragmentos, sus límites y las citas de las fuentes. Una cadena Markdown más limpia puede cambiar el comportamiento de recuperación si desaparecen los encabezados o las filas de una tabla se dividen entre fragmentos.
6. Calcule el costo del corpus aceptado y establezca la reversión
Sume el efectivo destinado al proveedor, el costo del servidor, los tokens de extracción, los reintentos de pago, el almacenamiento y las horas de operación. Divida el total entre las páginas aceptadas, no entre las solicitudes. Establezca un disparador de reversión antes del lanzamiento, por ejemplo, el fallo de un campo obligatorio, un nivel inesperado para un destino, un aumento sustancial en el número de fragmentos o un límite de horas de operación. Mantenga disponible la ruta anterior hasta que la nueva supere ese periodo.
Para un equipo pequeño, el primer artefacto útil no es la puntuación de un proveedor. Es una hoja con una fila por cada URL de prueba y columnas para ambos sistemas. Cuando la fila contiene evidencia guardada, aprobar o rechazar se vuelve una decisión revisable y deja de ser una preferencia.
Preguntas frecuentes
¿Es ilegal hacer web scraping?
No existe una respuesta universal de sí o no. En Estados Unidos, la política del Departamento de Justicia sobre la CFAA distingue los límites técnicos de acceso de una simple restricción contractual, pero los contratos, los derechos de autor, la privacidad, el uso de datos, los controles de acceso y la jurisdicción aún pueden cambiar el análisis. Esto no es asesoría legal; una recopilación en producción merece la revisión de un abogado para los destinos y usos concretos.
¿Firecrawl es caro?
Depende de la salida aceptada. El rastreo consume 1 crédito por página y JSON suma 4, por lo que 10,000 páginas aceptadas con una reserva del 10% para reintentos necesitan 55,000 créditos en este modelo y caben en Standard por $83. El trabajo operativo y el costo de migración pueden pesar más que esa factura.
¿Cuál es la mejor herramienta de web scraping?
Apify Website Content Crawler es el reemplazo gestionado más amplio de esta selección. Crawl4AI es más sólido cuando el alojamiento propio es obligatorio; ScrapFly destaca al combinar rastreo y extracción gestionados; y Jina Reader gana solo cuando ya existe una lista de URL fiable.
¿Se puede alojar Firecrawl por cuenta propia?
Sí. El núcleo para alojamiento propio da el control al equipo, pero este también se hace cargo de las bases de datos, las colas, los workers de navegador, las actualizaciones, la seguridad, el enrutamiento de acceso y el monitoreo. No es el mismo producto operativo que Firecrawl Cloud.
¿Qué alternativas a Firecrawl existen?
Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API y Bright Data Crawl API son las siete alternativas comparadas aquí. Se dividen en crawlers completos, lectores que reciben URL y API centradas primero en el acceso.
¿Es legal el alojamiento propio?
Ejecutar software en una infraestructura bajo control propio suele ser una cuestión distinta de aquello a lo que accede ese software. La autorización, los controles de acceso, las condiciones del sitio, los derechos de autor, la privacidad, las normas de protección de datos y el uso previsto aún requieren su propia revisión.
¿Vale la pena alojarlo por cuenta propia?
Vale la pena cuando un límite de datos obligatorio, la personalización o una capacidad compartida de la plataforma compensan el trabajo operativo. Por lo general, no conviene crear una nueva superficie de guardia solo para eliminar una factura mensual modesta de API.
¿Qué riesgos tiene el alojamiento gratuito?
Las instancias gratuitas pueden entrar en reposo, limitar CPU o memoria, rotar el almacenamiento, compartir una reputación de IP deficiente y no ofrecer garantías de recuperación en producción. Estas limitaciones pueden hacer que un crawler parezca poco fiable aunque el software no sea la causa.
¿Puedo alojar gratis un sitio web por mi cuenta?
Un sitio personal o una evaluación de crawler puede caber en una asignación gratuita. Un rastreo de producción sigue necesitando cómputo, almacenamiento, ancho de banda, infraestructura de acceso, monitoreo, copias de seguridad y tiempo de operación, por lo que una partida de servidor de $0 no equivale a un costo operativo de $0.
¿Firecrawl es de código abierto?
Firecrawl publica un núcleo de código abierto que se puede alojar por cuenta propia. Firecrawl Cloud añade infraestructura gestionada y servicios operativos, de modo que el repositorio por sí solo no reproduce los límites de costo ni de fiabilidad del producto Cloud.
- Última actualización
- 25 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Alternativas a CodeRabbit: 7 opciones según precio y control
Comparamos 7 alternativas a CodeRabbit por precio, privacidad, compatibilidad con Git y control operativo para elegir la opción que mejor encaja con su equipo.25 sept 2026Build
CodeRabbit vs Greptile: precios, límites y cuál elegir
Comparamos CodeRabbit vs Greptile en precio, límites, profundidad de revisión y compatibilidad para saber qué revisor de código con IA encaja mejor.25 sept 2026Build
Perplexity Computer en local: guía para Windows con AMD
Guía para usar Perplexity Computer en local con Windows y Ryzen AI Max: requisitos, permisos, prueba de archivos y control del acceso a la nube.25 sept 2026Build
AgentRun a prueba: flujos de trabajo con IA bajo control
Probamos AgentRun beta.4 para flujos de trabajo con IA: contratos tipados, ramas visibles, llamadas limitadas y escalamiento explícito frente a otras opciones.24 sept 2026Build
Perplexity Search API: Fast Search o web por defecto
Comparamos Fast Search y el modo web de Perplexity Search API en precio, latencia y cobertura, con una regla práctica para enrutar cada consulta.24 sept 2026Build
Agentes de IA: el costo oculto de un fallback que agotó el saldo
Un fallo en un flujo de agentes de IA convirtió el fallback de imágenes en la ruta predeterminada, agotó un saldo compartido y dejó artículos incompletos.24 sept 2026Build
Cursor gratis: cuánto cuesta Rollouts en realidad
¿Cursor gratis incluye Rollouts? No. Comparamos acceso, créditos de 10 días y costos de Teams y Enterprise para saber qué pagar después, sin sorpresas.24 sept 2026Build