Webクローラー比較:Firecrawl代替7選を料金・機能・移行コストで検証
Firecrawlの代替となるWebクローラー7製品を、Markdown・JSON出力、探索範囲、レンダリング、料金、運用工数で比較。1,000〜100,000件の採用ページを基準に、Apify、Crawl4AI、ScrapFlyなどの向き不向きと、安全な移行手順まで具体的に整理します。




Firecrawlの代わりになるWebクローラーは、受け入れ判定を通過したページが10,000件になると差がはっきりします。この試算では、Firecrawlはベンダー料金$83に運用担当者3時間、ScrapFlyは$30に3時間です。ただし、請求額が安いだけで移行後の総コストも下がるとは限りません。URL探索、レンダリングの再試行、JSON抽出、後段のチャンク分割まで含めると、この差は簡単に消えるためです。
結論:Firecrawlの代替にはパイプライン全体の置き換えが必要です
幅広い用途をカバーするマネージド型の移行先ならApify Website Content Crawler、インフラを自社で管理すること自体が目的ならCrawl4AI、クロールと構造化抽出を同じクレジット枠で賄いたいならScrapFly、URL一覧を別システムですでに用意できるならJina Readerが有力です。 サイト全体をMarkdownにする機能より、アクセスしにくいページの取得を優先する場合は、ScrapingBee、Zyte API、Bright Data Crawl APIの適性が上がります。
比較すべき単位は、リクエスト数でも発見したURL数でもありません。検索拡張生成パイプラインまで届いた「採用ページ」です。つまり、必要なMarkdown、JSONフィールド、リンク、メタデータが欠けず、モデルが取得済みのソースとして実際に使えるページを指します。料金が安くても、表が欠ける、価格フィールドが空になる、チャンク処理が壊れるといったレスポンスは、費用の発生した失敗です。
比較基準となるFirecrawl
Firecrawlを基準にする理由は、CrawlエンドポイントがURL探索、レンダリング、ページ処理をまとめて行い、Markdownまたはスキーマに沿ったJSONを返すからです。クロールしたページごとに1クレジット、JSONモードでさらに4クレジットかかるため、この比較では1回の試行につき5クレジットを基準にします。
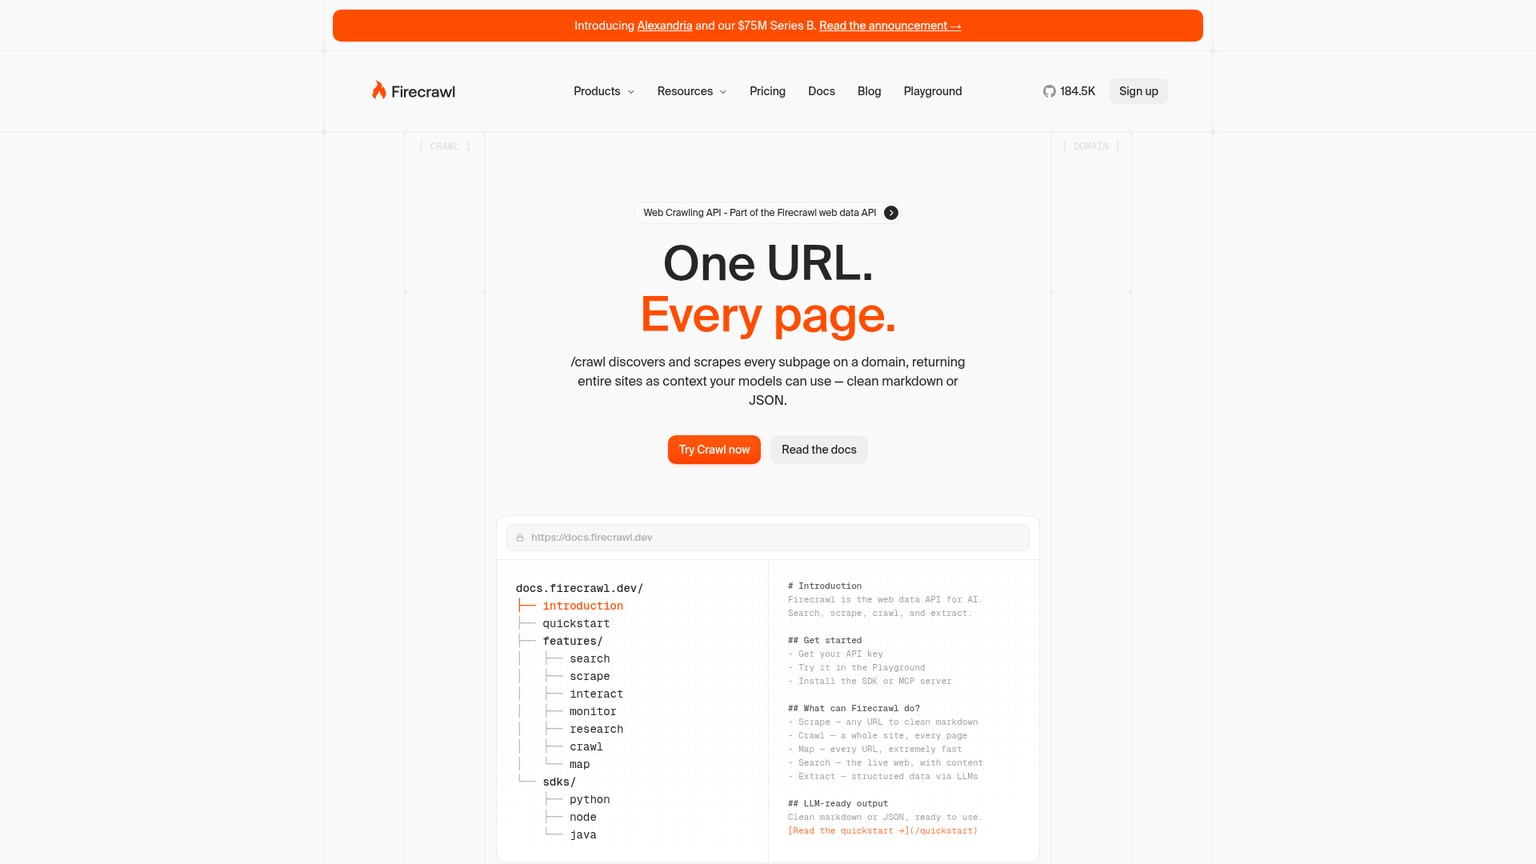
この一体型の構成があるため、一見安い製品へ移るより、Firecrawlを使い続けたほうが有利な場合があります。Firecrawlは、クロール範囲、サブドメイン、パス、深さ、ページのストリーミング配信も扱います。Reader APIはURL単価が安くても探索を自社で担う必要があり、アクセス用APIは保護されたページを取得できても、その後のMarkdown変換やスキーマ正規化が残ることがあります。
採用ページ基準で見るFirecrawlの料金
Firecrawlの現行プランは、1,000クレジットのFreeが$0、年払いで5,000クレジットのHobbyが月$16、100,000クレジットのStandardが$83、500,000クレジットのGrowthが$333、1,000,000クレジットのScaleが$599、Enterpriseは個別見積もりです。超過料金は、Hobbyが1,500クレジットごとに$9、Standardが35,000ごとに$47、Growthが175,000ごとに$177、Scaleが350,000ごとに$397です。これらの金額、上限、クロール機能は、2026年9月25日にFirecrawlの現行Crawlページで確認されています。
ベンダー上は成功でもローカルの受け入れゲートで落ちるレスポンスに10%の予備枠を設けると、MarkdownとJSONを備えた採用ページ1,000件には5,500クレジットが必要です。Hobbyに超過枠を1つ足して$25になります。10,000件なら55,000クレジットなのでStandardの$83、100,000件なら550,000クレジットなのでGrowthに超過枠を1つ足して$510です。
検索は別のレイヤーです。既知のサイトやURL一覧ではなく、検索クエリから始めて順位付きの情報源を得る必要があるなら、まずAI検索APIの比較で検索部分を選び、選定したURLを抽出レイヤーへ渡します。
Firecrawl代替Webクローラーの早見表
この表が評価するのは、公開ドキュメントから判断できる適合度であり、実測した出力品質ではありません。価格は2026年9月25日に各社の一次情報で確認されています。「無料トライアル」には、ベンダーが恒久的な無料枠を提供している場合、その枠も含めています。
万能な勝者はいません。「Web抽出」という言葉には、実際には3種類の製品が含まれるからです。クローラーはサイト内のURLを発見し、Readerは与えられたURLを変換し、アクセスレイヤーはレンダリングやブロックを突破します。自社で運用したくない工程をすべて担える範囲で、最も小さい製品を選ぶのが基本です。
比較対象を選んだ基準
現行の一次資料を確認し、有用なページ本文と機械可読な出力の両方に到達できると判断できた製品だけを候補にしました。 検索専用APIは、順位付きのURL発見がクローラーの代替にならないため除外しました。プロキシ専用サービスも、IPアドレスだけではクリーンなMarkdown、必要なJSON、保存可能なクロールマニフェストを作れないため対象外です。
比較では、次の5つの受け入れ条件を重視します。
- 探索: サイトを巡回し、スコープを守り、正規URLのマニフェストを保持できますか。それとも、別コンポーネントがすべてのURLを渡す必要がありますか。
- レンダリングとアクセス: JavaScriptを実行し、再試行費用が際限なく増えない形で対象サイトのアクセス条件に対応できますか。
- 出力契約: Markdown内の見出し、表、コード、リンクを保持し、不透明な変換処理をもう1段挟まずに必須JSONフィールドを満たせますか。
- 証跡: 各テストURLについて、リクエスト、未加工レスポンス、正規化済み出力、ヘッダー、設定、コンテンツハッシュ、判定結果を保存できますか。
- 総コスト: 探索、レンダリング、抽出、成功扱いだが不採用となったレスポンスの再試行、最低利用額、担当者の工数まで含めると、いくらかかりますか。
この記事では、候補製品を実際には実行していません。そのため、通過率やレイテンシの順位は示していません。以下の品質に関する記述はすべて文書化された機能であり、金額比較は前提を明示した試算です。
固定した20 URLの受け入れテスト
ベンダーのデモURLだけで移行を決めてはいけません。旧構成と新構成に同じ固定テストを実行し、すべてのレスポンスを保存します。テストには、異なる失敗を顕在化させるコンテンツ形式を意図的に混ぜています。
- コードと長文ドキュメント: MDN Fetch API、Pythonのクラス、Rustの所有権、RFC 9110 HTML、HTTPBin HTML。
- 表、リンク、構造化ページ: MDNのtable要素リファレンス、W3Cの表チュートリアル、WikipediaのWebスクレイピング、Books to Scrapeカタログ、固定した商品ページ1件。
- ページネーションとJavaScript: Quotes to Scrape、JavaScriptルート、スクロールルート、MDN JavaScriptガイド、HTTPBinのリンク正規化。
- 文字コードとPDF: HTTPBin Unicode、RFC 9110 PDF、2段組みの研究PDF、最小構成のW3C PDF、IRS Form W-9。
すべての結果に、source_url、final_url、title、markdown、links、status_code、fetched_at、content_sha256が必要です。商品ページにはentity_name、amount、currencyも必要で、研究PDFにはpublished_atが必要です。明示的なnullを許せるのは、テストマニフェストで許可されたフィールドだけです。フィールド欠落とnullは同じではありません。
ツール、バージョン、設定の組み合わせごとにディレクトリを分けて保存します。各URLについて、request.json、レスポンスヘッダー、未変更の本文、normalized.json、verdict.json、SHA-256ダイジェストを残します。判定にはpass: falseだけでなく、最初に失敗したルールを記録します。この証跡があれば、ベンダー、パーサー、対象ページが変わった後でも、別のエンジニアが判断を再現できます。
採用ページ単価の試算表
このモデルでは、月間の採用ページを1,000件、10,000件、100,000件とし、ベンダー上は成功でもローカルのスキーマまたはMarkdownゲートで不採用になるレスポンスに10%の予備枠を設けています。 これらは課金対象の再試行です。ベンダーが明示的に失敗とするレスポンスは、各社が公開する返金ポリシーに従って扱います。
基本式はシンプルです。ベンダーまたはホストへの支払いに、探索、レンダリング、抽出、課金対象の再試行を足し、さらに担当者の工数へ社内の時間単価を掛けます。表ではベンダーへの支払いと時間を分けているため、1時間$100という前提を変えても各社の式を作り直す必要はありません。
担当者の時間単価を$100とすると、10,000ページ時の合計はFirecrawlが$383、Apifyが$419、Crawl4AIが$1,248、ScrapFlyが$330、Jinaが$401.10、ScrapingBeeが$449、Zyteが$555.22、Bright Dataが$516.50です。Jinaの数値は、信頼できるURLマニフェストがすでにある場合に限られ、サイト全体をクロールする総額ではありません。Bright DataとZyteの工数には、後段のMarkdown処理とスキーマ処理を含めています。両社の製品ページでは、ここで必要とする出力契約としてネイティブMarkdownが明記されていないためです。
抽出費用は意図的に別項目としています。Firecrawlはクロール1クレジットにJSON用4クレジットを加算します。このシナリオでScrapingBeeはJavaScriptに5クレジット、AIに5クレジットを使います。ScrapFlyはブラウザまたはUnblockerに5クレジット、抽出モデルに5クレジットを使います。Zyteはティア3のブラウザ料金に固定カスタム属性抽出1回を追加します。Apifyは決定的なJSONエンベロープを使い、80%をraw HTTP、20%をヘッドレスページとして、公開されているヘッドレス料金の上限で計算しています。任意のAI要約は含めていません。
Jinaは1回の試行につき出力2,000トークン、100万トークンあたり$0.050と仮定します。消費分の価値は小さいものの、実際の支払いはまとまった単位です。無料の10 millionトークンを使い切ると、記載されている最小の追加購入は1 billionトークンで$50です。Crawl4AIは3つの処理量に対してDigitalOceanの$24、$48、$96ホストを想定していますが、これは計画用の入力値であり、実測した処理能力ではありません。
1. Apify Website Content Crawler:総合力で選ぶマネージド型の移行先
Apify Website Content Crawlerは、URL探索、JavaScriptレンダリング、Markdown、永続化されたデータセットを1つのサービスで必要とするチームにとって、幅広く使える有力なマネージド型移行先です。raw HTTPまたはヘッドレスFirefoxでクロールし、各結果をデータセットレコードとして保存して、JSONまたはCSVでエクスポートします。APIが同一だと見せかけることなく、Firecrawlに近い形で移行できます。
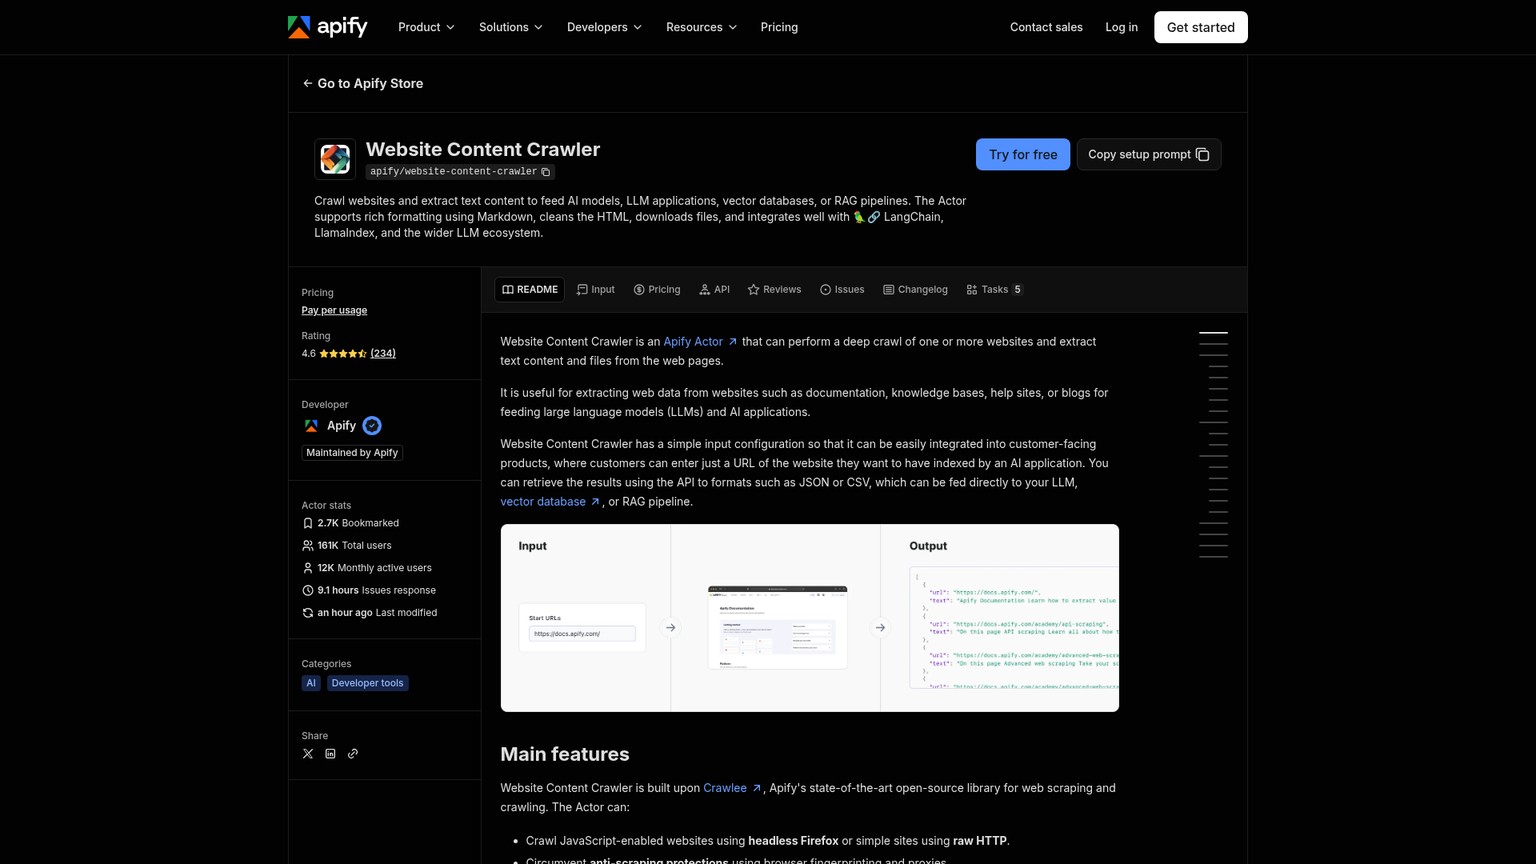
最大の利点は、クロールを1つのジョブとして管理できることです。スコープ、出力、保存済みデータセットレコードがまとまり、PDFなどのファイルもダウンロードできます。明確な境界は意味抽出です。ActorのJSONデータセットはテキスト、Markdown、メタデータを含む構造化エンベロープですが、業務固有のスキーマを作るには、決定的なルール、別のActor、またはモデル処理が必要です。
Actorが公開する概算は、基準条件でraw HTTPページ1,000件あたり約$0.20、ヘッドレスページ1,000件あたり$0.50〜$5です。任意のAI要約は1,000ページあたり約$2〜$3が追加され、見出しのないページでは約$7に達します。要約は必須JSONフィールドの代わりにならないため、上のモデルではこの追加機能を除外しています。
Apifyのプランは、毎月$5分の利用枠と同時実行5件を含むFreeが$0、$19分の利用枠と同時実行32件のStarterが$19、$199分の利用枠、コンピュートユニット$0.16、同時実行128件のScaleが$199、$999分の利用枠、コンピュートユニット$0.13、同時実行256件のBusinessが$999、Enterpriseは個別見積もりです。Freeは利用枠を使い切ると停止します。有料プランは超過分も継続し、未使用枠は翌月に繰り越されません。これらのプラットフォーム条件は、Apifyの現行料金ページに基づきます。
最適な用途: マネージドクロールジョブを置き換えたい小規模なプロダクトチームやデータチーム。特に、実行履歴とデータセットのエクスポートを重視する場合に向きます。
特徴: サイト全体の探索、ブラウザレンダリング、Markdown、永続化されたJSONデータセットレコードを同じマネージドジョブで扱えます。
料金: Free $0、Starter $19、Scale $199、Business $999、Enterpriseは個別見積もりです。実際のActor費用には、実行時に使ったコンピュート、ストレージ、プロキシ、転送も加わります。
無料トライアル: 恒久的なFreeプランに、カード不要で毎月$5分のプラットフォーム利用枠が含まれます。
- raw HTTPとヘッドレスFirefoxにより、安価な静的ページとJavaScriptページの両方を処理できます。
- データセットレコードがあるため、保存済みレスポンスの確認とエクスポートが容易です。
- クロール範囲、ファイルのダウンロード、メタデータ、Markdownが1つのマネージドジョブにまとまります。
- 請求はページ単位の単一クレジットではなく、コンピュート、ストレージ、転送、プロキシ利用にまたがります。
- JSONデータセットレコードが、そのまま後段コードの求める業務スキーマになるわけではありません。
- AI要約には別途Actor費用がかかり、それでも抽出結果が受け入れ条件を満たす保証にはなりません。
5ステップで進めるApify移行テスト
固定URLマニフェストを読み込む
本番ドメイン全体ではなく、20件のテストURLから始めます。Actorの入力、クローラー形式、ページ上限、スコープを固定し、2回目の実行でも同じ条件になるようにします。
ブラウザが必要と判明するまではraw HTTPを使う
静的ページは安価な経路に残し、JavaScriptのテストページだけをヘッドレスレンダリングへ送ります。各結果とともに、選択したクローラーモードを保存します。
Markdownとデータセットレコードを書き出す
変更を加えていない
markdown、正規URL、メタデータ、リンクを保持します。そのレコードを、別の決定的な工程で必要なローカルJSONスキーマへ変換します。チャンク分割の前に不採用を判定する
正規化済みレコードに対し、表、コード、リンク、必須フィールドのチェックを実行します。1つでもルールに違反したURLは、ベクトルインデックスではなく再試行台帳へ送ります。
採用ページだけで単価を出す
Actor、プロキシ、ストレージ、担当者の全費用を採用ページ数で割ります。クロール範囲を広げる前に、その結果をFirecrawlの基準値と比べます。
2. Crawl4AI:セルフホストで管理するなら最有力
Crawl4AIは、インフラの所有、データ境界、再利用可能な抽出ルールが必須要件となる場合に有力なセルフホスト型です。Markdownを生成し、CSS、XPath、LLM戦略による構造化抽出に対応するため、リクエスト単位のソフトウェア料金なしで、検索用テキストとJSONフィールドの両方を扱えます。
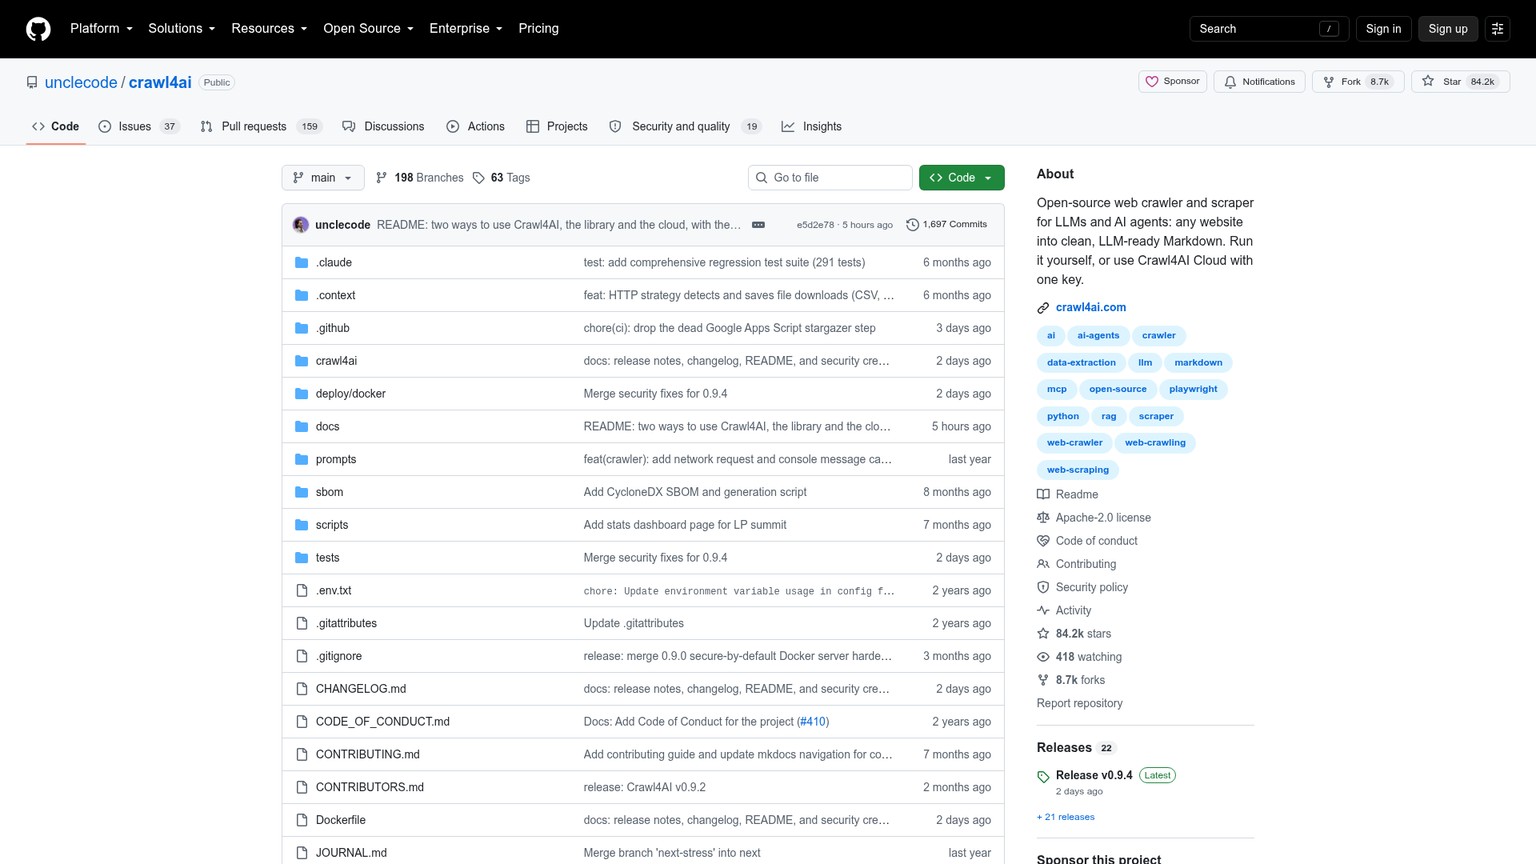
現在はライセンス価格より、セキュリティ上の最低ラインが重要です。バージョン0.9.4は2026年9月23日に公開され、2つのサーバーサイドリクエストフォージェリ経路と、環境変数の値を露出させる可能性がある設定上の信頼境界の不備を含む3件のアドバイザリを修正しました。APIを外部公開する前に、v0.9.4以降へ固定し、プロジェクトのセキュリティ通知を確認する必要があります。
Crawl4AIとFirecrawlの違い
Firecrawlが販売するのは、マネージドキュー、ブラウザ、クレジット、配信、サポートまで含むクロール運用サービスです。一方、Crawl4AIが提供するのはクローラーと抽出システムであり、デプロイ、アップグレード、可観測性、プロキシ戦略、インシデント対応は利用チームが担います。これらがすでに共通基盤として整っている場合に選択が逆転します。このプロジェクトのために1人のエンジニアが一から構築する場合ではありません。
セルフホストの推奨要件は、4 GB以上のRAM、Docker 20.10以降、Compose 2.24以降です。コスト表では、DigitalOceanの現行Basic Droplet料金から、4 GiBを$24、8 GiBを$48、16 GiBを$96として使っています。これらのサイズはシナリオ上の入力値にすぎず、今回ページ処理能力を実測したわけではありません。
最適な用途: 既存のコンテナ基盤、厳格なデータ境界、クローラー運用を担えるエンジニアを持つチーム。
特徴: オープンソースによる管理に加え、ページ単位のモデル費用を避けられる決定的なCSSまたはXPath抽出スキーマを使えます。
料金: ソフトウェアライセンスは$0です。このモデルでは月額$24、$48、$96のホストを使い、必要に応じてプロキシ、ストレージ、監視、モデル呼び出し、人件費を加えます。
無料トライアル: ソフトウェアはオープンソースですが、インフラは含まれません。
- Markdownと構造化抽出を、チームが管理するインフラ内で実行できます。
- CSSとXPathのスキーマにより、安定したサイトを低コストかつ決定的に処理できます。
- セルフホストサーバーのデフォルトは、認証を有効にし、ループバックを安全に扱う方向へ改善されています。
- プロキシの信頼性、ブラウザ容量、パッチ適用、キュー、復旧が自社の責任になります。
- 保存済みの実行結果がなければ、ホストサイズだけで採用ページの処理能力は判断できません。
- LLM抽出を使うと、モデルトークン費用とデータ境界の審査が別プロバイダーまたはローカルモデルへ移ります。
Firecrawlセルフホストガイドでは、FirecrawlリポジトリとFirecrawl Cloudのどちらを使うかという別の判断を扱っています。同じ試算表にパッチ適用と可用性を担う人員を含めるまでは、Crawl4AIの$0ライセンスをそのまま削減額として数えてはいけません。
3. ScrapFly:小規模チーム向けのクロール・抽出一体型
ScrapFlyは、アクセス、クロール、Markdown変換、型付き抽出を1つのアカウントで賄いたい小規模チームに適した選択肢です。各製品が同じクレジット枠を共有し、抽出レイヤーはHTML、Markdown、XML、JSON、CSV、RSS、プレーンテキストを受け取れます。決定的なテンプレート、事前学習済みモデル、JSONスキーマ付きプロンプトを選べるため、複数ベンダーをつなぎ合わせる必要がありません。
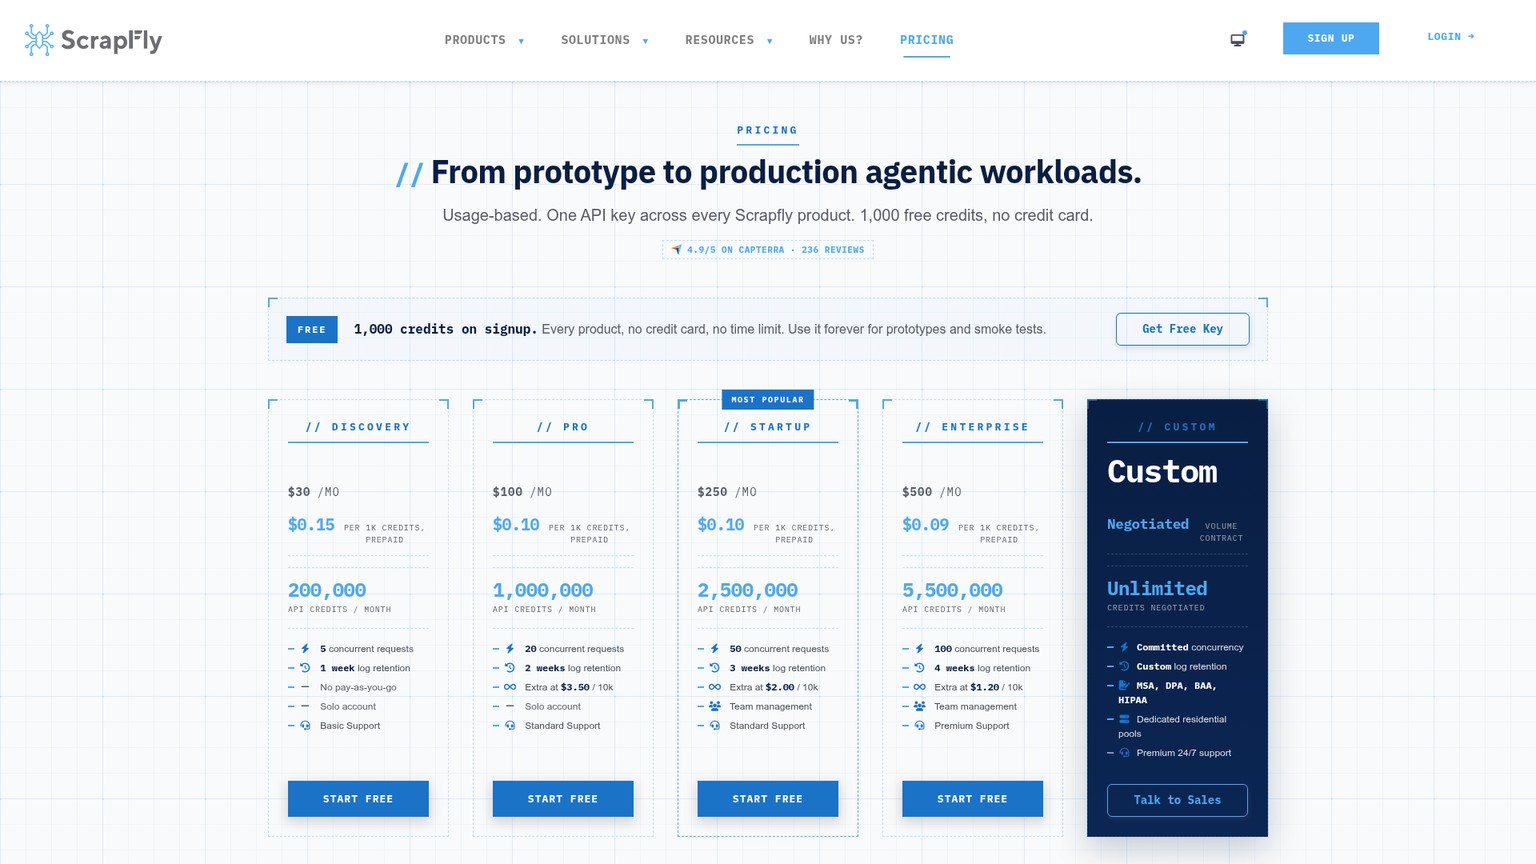
設定を固定すれば、クレジット体系は明快です。データセンター経由の単純なHTTPリクエストは1クレジット、JavaScriptレンダリングまたはUnblockerは5、住宅IPルーティングは25、ページ全体のスクリーンショットは60です。テンプレート抽出はさらに1クレジット、抽出プロンプトまたはモデルは5クレジットです。500 KBを超えるドキュメントでは、追加の500 KBごとに抽出の基本料金が繰り返し加算されます。
したがって、この記事のシナリオは成功した試行1回あたり10クレジットです。ブラウザまたはUnblockerに5、抽出に5を使います。再試行の予備枠10%を加えると、採用ページ1件あたり11クレジットです。住宅IPルーティングはモデルに含めていないため、それが必要な対象では結論が大きく変わります。
現行プランは、初回限り1,000クレジットのFree、200,000クレジットと同時リクエスト5件を含む月$30のDiscovery、1,000,000クレジットと同時20件の$100のPro、2,500,000クレジットと同時50件の$250のStartup、5,500,000クレジットと同時100件の$500のEnterprise、個別交渉のCustomです。Discoveryは上限に達すると停止します。Proの超過料金は10,000クレジットあたり$3.50、Startupは$2、Enterpriseは$1.20です。未使用クレジットは繰り越されません。これらの条件はScrapFlyの現行料金に基づきます。
最適な用途: マネージドクローラー、アクセス制御、型付き抽出を1つの請求にまとめたい小規模チーム。
特徴: 同じクレジット枠をクローラー、ブラウザ、Unblocker、3種類の抽出方式に利用できます。
料金: Free 1,000クレジット、Discovery $30、Pro $100、Startup $250、Enterprise $500、Customは個別交渉です。
無料トライアル: 登録時に1,000クレジットが付与され、カードは不要で、有効期限の記載はありません。
- 安定したレイアウトではテンプレート抽出によりモデル費用を削減できます。
- 事前学習済み抽出とプロンプト抽出が型付きJSONを返すため、別のモデルベンダーが不要です。
- 失敗したリクエストは0クレジットで、レスポンスには消費クレジットが記録されます。
- 難しいページでは、ブラウザ、住宅IP、抽出の各オプションが重なり、費用が急増します。
- 500 KBを超えるドキュメントは抽出料金が倍増していきます。
- Discoveryには超過枠がないため、本番ジョブではProを使うか、上限到達前に確実に停止させる必要があります。
このシナリオで10,000件の採用ページを処理する場合、試算上の最安はScrapFlyです。$30と担当者3時間で、Firecrawlの$83と3時間を下回ります。ただし、月$53の現金支出差だけでは、曖昧な検証のまま移行する根拠にはなりません。固定テストに合格し、本番対象で25クレジットの住宅IP経路を避けられ、スキーマの追加修正が不要な場合に初めて説得力が生まれます。
4. Jina Reader:URL一覧がすでにある場合に最適
Jina Readerは、URL探索が解決済みで、与えられた各URLをクリーンなMarkdownまたはスキーマに沿ったJSONへ変換したい場合に、変動費を抑えやすい選択肢です。デフォルトエンジンはヘッドレスブラウザでJavaScriptをレンダリングし、directエンジンはより単純なHTTP経路を使います。ReaderLM-v2は、構造化出力用のJSONスキーマまたは自然言語の指示を受け付けます。
利点と製品境界は表裏一体です。Readerが読むのは1つのURLであり、サイト全体のスコープ規則、クロールフロンティア、重複排除ポリシー、クロールマニフェストの代わりにはなりません。サイトマップ、検索工程、社内カタログがURL一覧を確実に供給するなら、この狭い役割が強みになります。そうでなければ、探索費用を試算表へ戻す必要があります。
Readerの基本利用は無料です。新しいキーには10 millionトークンが含まれ、キーを使うと出力トークンに対して課金されます。1 billionトークンの追加購入は$50、つまり100万トークンあたり$0.050です。11 billionトークンは$500、100万トークンあたり$0.045です。失敗したリクエストではトークンが差し引かれません。レート上限は、キーなしで毎分20リクエスト、無料または有料キーで500、premiumキーで5,000です。すべての数値はJina Readerの現行ページに基づきます。
試算表では、成功した各試行を出力2,000トークンと仮定しています。再試行の予備枠を加えると、採用ページ1,000件で$0.11、10,000件で$1.10、100,000件で$11相当を消費します。これは経済的な利用価値であり、決済時の請求額ではありません。無料枠を使い切った後も、記載されている最小購入額は$50です。
最適な用途: 信頼できるURLマニフェストがあり、低コストでページをMarkdownまたはJSONへ変換したいパイプライン。
特徴: 出力トークン課金、JavaScriptレンダリング、JSONスキーマ抽出を、用途を絞ったReader APIで利用できます。
料金: Readerの基本利用は無料で、新しいキーごとに10 millionトークンが付与されます。有料パックは1 billionが$50、11 billionが$500です。
無料トライアル: 新しいAPIキーに10 millionトークンが含まれます。
- デフォルトのレンダラーは、変換前にクライアント側JavaScriptを処理します。
- JSONスキーマモードと指示モードにより、同じReaderから構造化フィールドを生成できます。
- 失敗したリクエストはトークンを消費しません。
- サイト探索、スコープ、クロール状態の永続化には別コンポーネントが必要です。
- 無料枠の後は、現在の消費価値がはるかに小さくても、$50のトークンパックが最小の支払い単位です。
- 出力トークン費用はページの長さとレスポンス形式によって変動します。
100,000ページでは、Jinaが$11と6時間で見かけ上の最安になりますが、URLマニフェストが提供済みという前提に限られます。信頼性の低い探索ジョブと手作業の重複排除を足すと、FirecrawlやApifyの行とは比較できません。クロール作業の欠落を隠すためではなく、コンポーネント境界が本当に成立するときに使うべきです。
5. ScrapingBee:クレジット上限を設定しやすいスクレイピングAPI
ScrapingBeeは、1ページにかかる最大費用を制限したいチームに適した、リクエスト単位の選択肢です。ページのMarkdownまたはJSONレスポンスを返し、CSS抽出ルールを適用できます。レイアウトがセレクターで安定して扱えない場合は、AI抽出も追加できます。
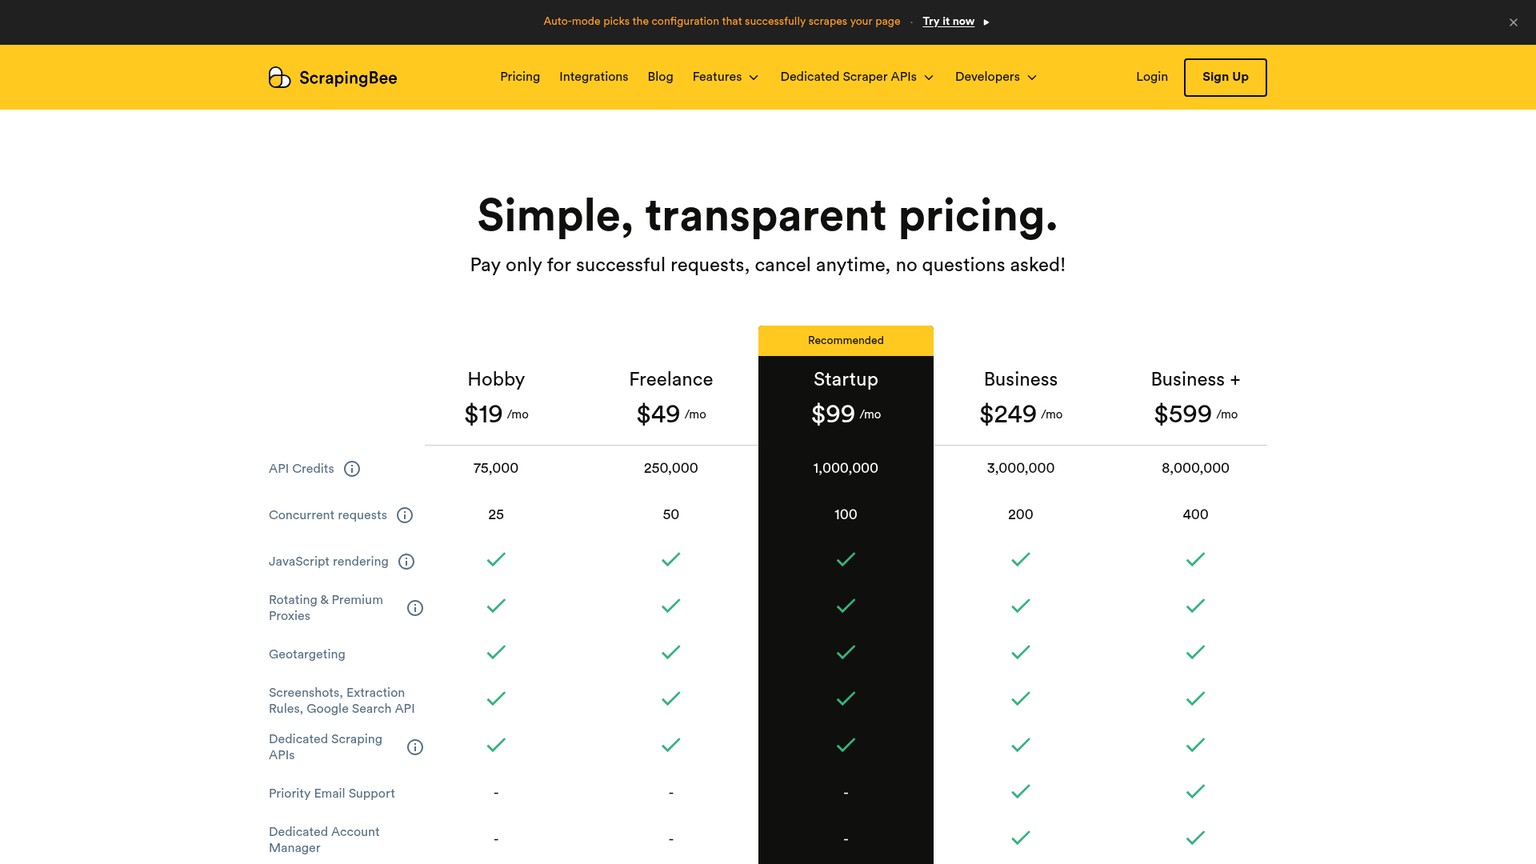
有用なのは段階式のクレジット制御です。classic HTTPは1クレジット、classic JavaScriptは5、JavaScriptなしのpremiumは10、JavaScriptありのpremiumは25、JavaScriptありのstealthは75です。AI機能は5クレジットを追加します。Autoモードは成功した構成の料金だけを課金し、すべての内部構成が失敗すれば0で、最大コストの上限も設定できます。
境界となるのはオーケストレーションです。ScrapingBeeは指定されたページを取得しますが、Firecrawlのサイト探索やクロールフロンティアに最も近い製品ではありません。利用チームがURLマニフェスト、スコープ、重複処理、ジョブ状態を管理し、ベンダー側の失敗と、ローカルの受け入れゲートで落ちた成功レスポンスを区別する必要があります。
現行プランは、75,000クレジットと同時25リクエストを含む月$19のHobby、250,000クレジットと同時50件の$49のFreelance、1,000,000クレジットと同時100件の$99のStartup、3,000,000クレジットと同時200件の$249のBusiness、8,000,000クレジットと同時400件の$599のBusiness+です。評価用として、カード不要の1,000クレジットが用意されています。これらの数値はScrapingBeeの現行プランに基づきます。
最適な用途: 探索機能をすでに所有し、レンダリング、premiumプロキシ、リクエスト単位の費用に明確な上限を設けたいチーム。
特徴: Autoモードでアクセス方法を段階的に強化しながら、max_costで1レスポンスが消費できる上限を設定できます。
料金: Hobby $19、Freelance $49、Startup $99、Business $249、Business+ $599です。
無料トライアル: カード不要で1,000クレジットです。
- Markdown、CSS抽出、AI抽出を1つのリクエストAPIで利用できます。
- 1、5、10、25、75クレジットの段階があり、アクセス費用を把握しやすい設計です。
- すべての内部構成が失敗すると、Autoモードの課金は0です。
- サイト探索とクロール状態の永続化は製品の範囲外です。
- ベンダー上は成功でも自社スキーマで不採用になったレスポンスは課金対象です。
- AI抽出を加える前の段階でも、classic JavaScriptからstealth JavaScriptへ移るとクレジット消費が15倍に増えます。
このモデルでは、JavaScriptとAI抽出で1回の試行に10クレジットを使います。再試行の予備枠を含めると採用ページ1件あたり11になり、1,000件は$19のHobby、10,000件は$49のFreelance、100,000件は$249のBusinessに収まります。1.1 millionクレジットがStartupの1 millionを超えるためです。
6. Zyte API:サイト別のボット対策料金で選ぶ
Zyte APIは、対象ごとにアクセス難易度が大きく異なり、ベンダーにサイト別の料金ティアを割り当ててほしい場合に適しています。必要なデータセンターまたは住宅IPの経路、レンダリング、アクセス処理をレスポンス価格にまとめ、成功レスポンスだけに課金します。
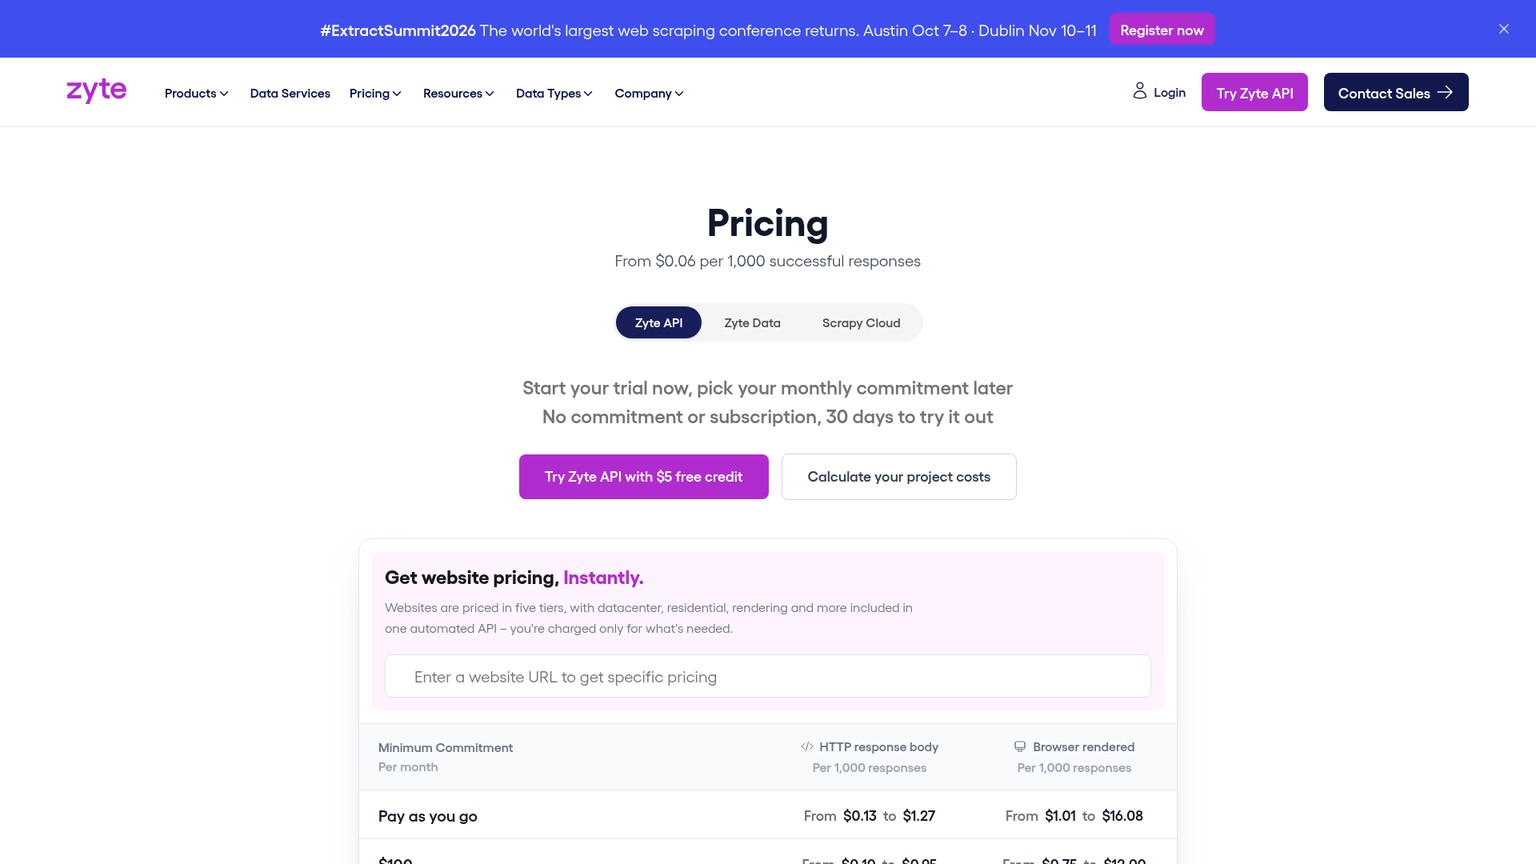
従量課金のHTTP料金は、サイトティア1〜5について、1,000レスポンスあたり$0.13、$0.23、$0.44、$0.70、$1.27です。ブラウザレンダリング料金は$1.01、$2.01、$4.02、$8.04、$16.08です。月$100の利用契約ではブラウザ料金が$0.75、$1.50、$3、$6、$12になり、$200では$0.60、$1.20、$2.40、$4.80、$9.60、$500では$0.48、$0.96、$1.92、$3.84、$7.68になります。
HTTPの利用契約別料金も重要です。$100ではティア1〜5が1,000件あたり$0.10、$0.17、$0.33、$0.53、$0.95です。$200では$0.08、$0.14、$0.26、$0.42、$0.76、$500では$0.06、$0.11、$0.21、$0.34、$0.61です。Enterpriseには、さらに個別交渉による割引があります。Zyteの現行料金ページには、30日間のトライアルクレジット$5も記載されています。
カスタム属性は、固定のextract方式なら$0.001、生成方式なら入力1,000トークンあたり$0.002、出力1,000トークンあたり$0.01です。自動抽出はデータ型1つあたり$0.0004〜$0.0016です。モデル利用を区別のつかないプラン料金へ隠さず、試算表に抽出費用を明確な行として載せられます。
この比較での境界は出力です。Zyteが文書化しているのはHTTP本文、ブラウザHTML、構造化フィールドであり、ネイティブMarkdownのレスポンス契約ではありません。そのため、後段のHTMLからMarkdownへの変換と回帰テストは、移行後も必要です。
最適な用途: 複数ドメインからの抽出で、対象の難易度、ブラウザの必要性、アクセス基盤がベンダー料金の大半を決める場合。
特徴: サイト別に5段階のリクエストティアがあり、失敗またはレート制限されたレスポンスには課金されません。
料金: 最低利用額のないPAYG、月$100、$200、$500の利用契約、さらに割引されるEnterpriseがあります。レスポンス単価はサイトティアと、HTTP出力かブラウザ出力かで変わります。
無料トライアル: 最低利用額なしで、30日間$5分のクレジットです。
- 対象別のティアにアクセス基盤が含まれ、レスポンス単価へまとまります。
- 成功レスポンス課金のため、レート制限とベンダー判定の失敗には直接費用が発生しません。
- 固定料金とトークン料金のカスタム属性により、抽出費用が見える形になります。
- ネイティブMarkdownは文書化された出力ではないため、変換処理を自社で担います。
- 対象サイトのティアが変わる可能性があり、成功レスポンスでもローカルのコンテンツゲートに落ちることがあります。
- サイト全体の探索と後段のクロール状態管理には、意図的な設計が必要です。
試算表では、ティア3のブラウザレンダリングに固定カスタム抽出1回を加えています。3つの処理量におけるベンダー利用額は$5.52、$55.22、$374です。これはシナリオであり、Zyteの普遍的な単価ではありません。実際にクロールするドメインへの見積もりでティアを置き換えてください。
7. Bright Data Crawl API:保護サイトを大規模に処理する選択肢
Bright Data Crawl APIは、保護サイトへのアクセス、プロキシ基盤、同時実行数が要件の中心となる場合に有力です。料金には、JavaScriptレンダリング、住宅IPプロキシ、検証、CAPTCHA処理、地域指定、探索、JSONまたはCSVの解析、無制限の同時実行が含まれます。
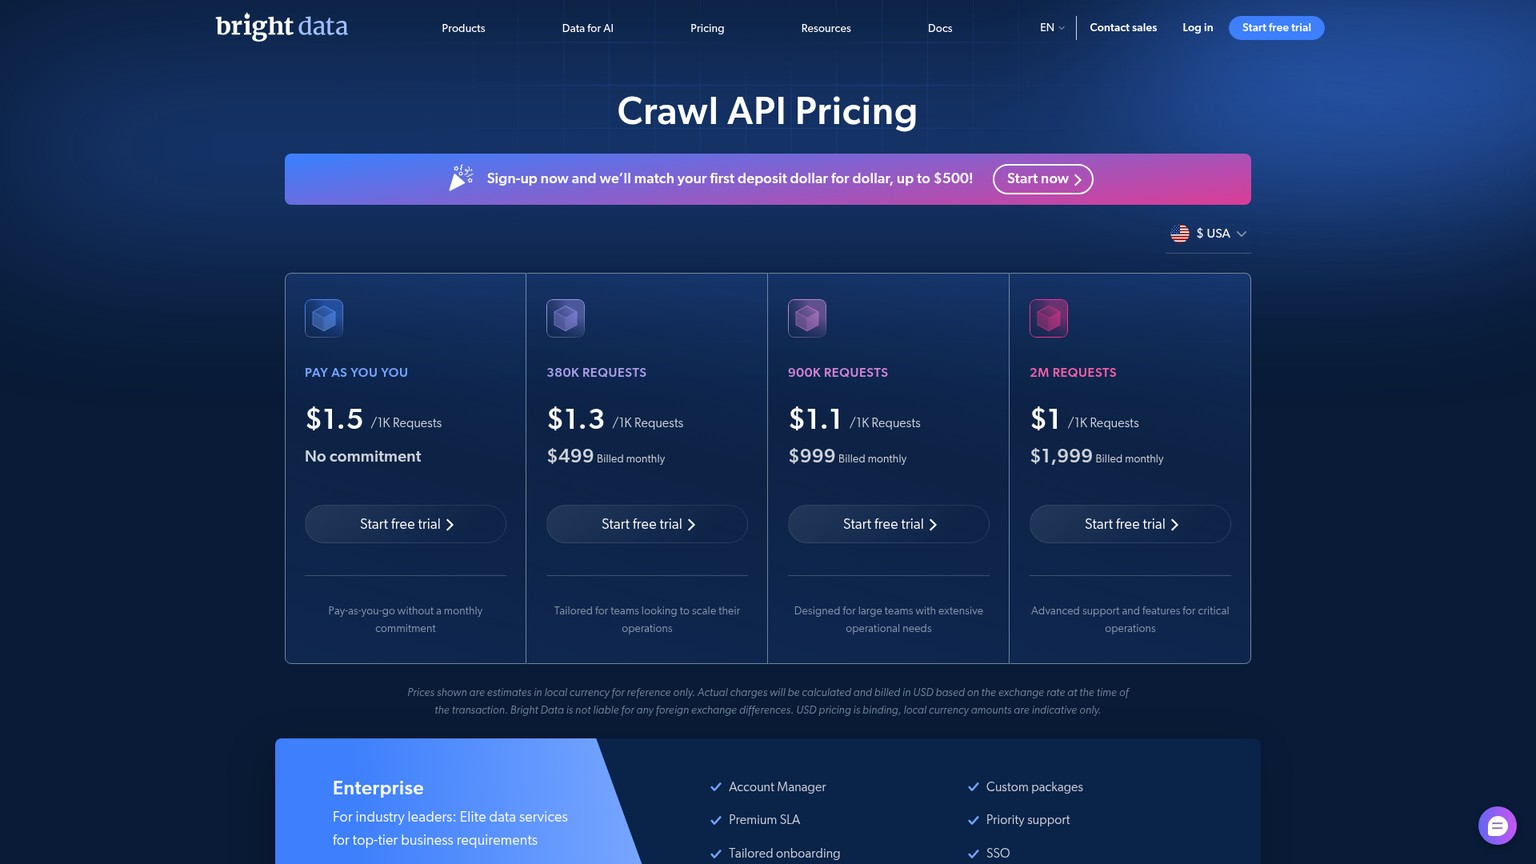
最低利用額のない従量課金は、1,000リクエストあたり$1.50からです。380,000リクエストのプランは月$499で1,000件あたり$1.30、900,000リクエストは$999で1,000件あたり$1.10、2 millionリクエストは$1,999で1,000件あたり$1です。Enterpriseは個別見積もりです。これらはBright Data Crawl APIの現行料金です。
重要な境界はZyteと同じです。文書化された配信形式はNDJSONとCSVで、ネイティブMarkdownではありません。安定した見出し、コードフェンス、表、ソースリンクをMarkdownで必要とする検索パイプラインでは、変換処理も本番コンポーネントです。その失敗と担当者の工数も分母へ含める必要があります。
従量課金の場合、課金対象の再試行に10%の予備枠を設けると、ベンダーへの支払いは採用ページ1,000件で$1.65、10,000件で$16.50、100,000件で$165です。これらの小さい金額を総コストと誤解してはいけません。試算表では、Markdown変換、スキーマ正規化、レビューにそれぞれ4時間、5時間、8時間を割り当てています。難しい対象ではリクエスト挙動も変わる可能性があります。
最適な用途: ネイティブMarkdownよりマネージド型のアクセス処理に価値がある、保護ドメインからの高並行収集。
特徴: レンダリング、住宅IPルーティング、CAPTCHA処理、検証、無制限の同時実行がCrawl APIの料金に含まれます。
料金: PAYGは1,000リクエストあたり$1.50、380,000件で$499、900,000件で$999、2 million件で$1,999、Enterpriseは個別見積もりです。
無料トライアル: 現行の料金カードには無料トライアルがありますが、表示されているプラン条件にクレジット額の記載はありません。
- 本来は複数コンポーネントが必要なアクセス基盤をまとめて利用できます。
- 無制限の同時実行は、厳しい納期のある大規模ジョブに向きます。
- NDJSONとCSVで機械可読な結果を受け取れるため、ベンダーのダッシュボードをスクレイピングする必要がありません。
- ネイティブMarkdownは文書化された出力契約ではありません。
- PAYGのリクエスト単価だけでは、変換、スキーマ、採用ページのレビュー作業が隠れます。
- raw HTTPで容易に取得できる公開ドキュメントサイトには、広範なアクセス機能が過剰です。
オープンソースで運用できるFirecrawl代替
この候補の中で最も明確なオープンソースの選択肢はCrawl4AIですが、Firecrawlもセルフホスト可能なコアを公開しています。 大切なのはリポジトリをクローンできるかどうかではありません。業務パイプラインが依存するURL探索、ブラウザアクセス、キュー、永続化、可観測性、出力契約を、オープンな構成で再現できるかどうかです。
Crawl4AIでは0.9.4以降に固定し、認証を必須にして、非公開の評価インスタンスを適切にバインドし、結果セットごとに正確なイメージまたはパッケージのバージョンを保存します。安定したテンプレートではCSSまたはXPath抽出を優先し、LLM抽出プロバイダーは独立した費用項目かつデータ境界として切り離します。モデル上の月8〜20時間という運用工数はベンチマークではありません。パッチ適用、プロキシ障害、スキーマドリフト、復旧を無料扱いせず、価格へ含めるための目安です。
Firecrawlコアについては、Cloudとセルフホストの比較を独立したアーキテクチャ判断として扱います。リポジトリを使えばベンダーのクレジット費用をなくせますが、PostgreSQL、Redis、RabbitMQ、ブラウザワーカー、監視、アップグレードがチームの作業に加わります。前述のセルフホスト専用記事には、この判断に使える検証パックがあります。
Webスクレイピングに最適なAIとWebクローラーは?
最適な製品は、入力の境界によって決まります。 入力がドメインで、出力に完全なMarkdownとJSONのコーパスが必要なら、FirecrawlまたはApifyから検討し、次にScrapFlyの費用を計算します。信頼できるURL一覧が入力としてすでにあるなら、Jina Readerはクロール機構を省けるため、大幅に安くなる可能性があります。アクセス自体が難所なら、ScrapingBeeの費用上限、Zyteのサイトティア、Bright Dataの一体型アクセス機能を比べます。
WebスクレイピングAIエージェントにも受け入れゲートが必要です
200レスポンスだから検索処理に使える、とエージェントに判断させてはいけません。必須フィールド、Markdownの最小長、表とコードの保持、正規化済みリンク、コンテンツハッシュ、許可するコンテンツ形式、明示的なnull規則からなる決定的なゲートを与えます。エージェントは失敗を適切な経路へ振り分けられますが、ジョブを止めないために契約を免除してはなりません。
判断が変わるポイントは4つです。
- Firecrawlを継続: 固定テストに合格し、6か月分の削減額でも移行と並行稼働の費用を回収できない場合。
- Apifyを選択: マネージドクロールジョブ、永続化データセット、柔軟なActorワークフローが、ページ単位の単純なクレジット額より重要な場合。
- Crawl4AIを選択: チームがコンテナ、アクセス経路、オンコール体制をすでに所有している場合、またはデータ境界の要件によってマネージド処理を利用できない場合。
- 用途を絞ったAPIを選択: URL探索が解決済み、または保護ページへのアクセスがジョブの中心となる場合。Jina、ScrapingBee、Zyte、Bright Dataが強いのは、この境界が明文化されているときだけです。
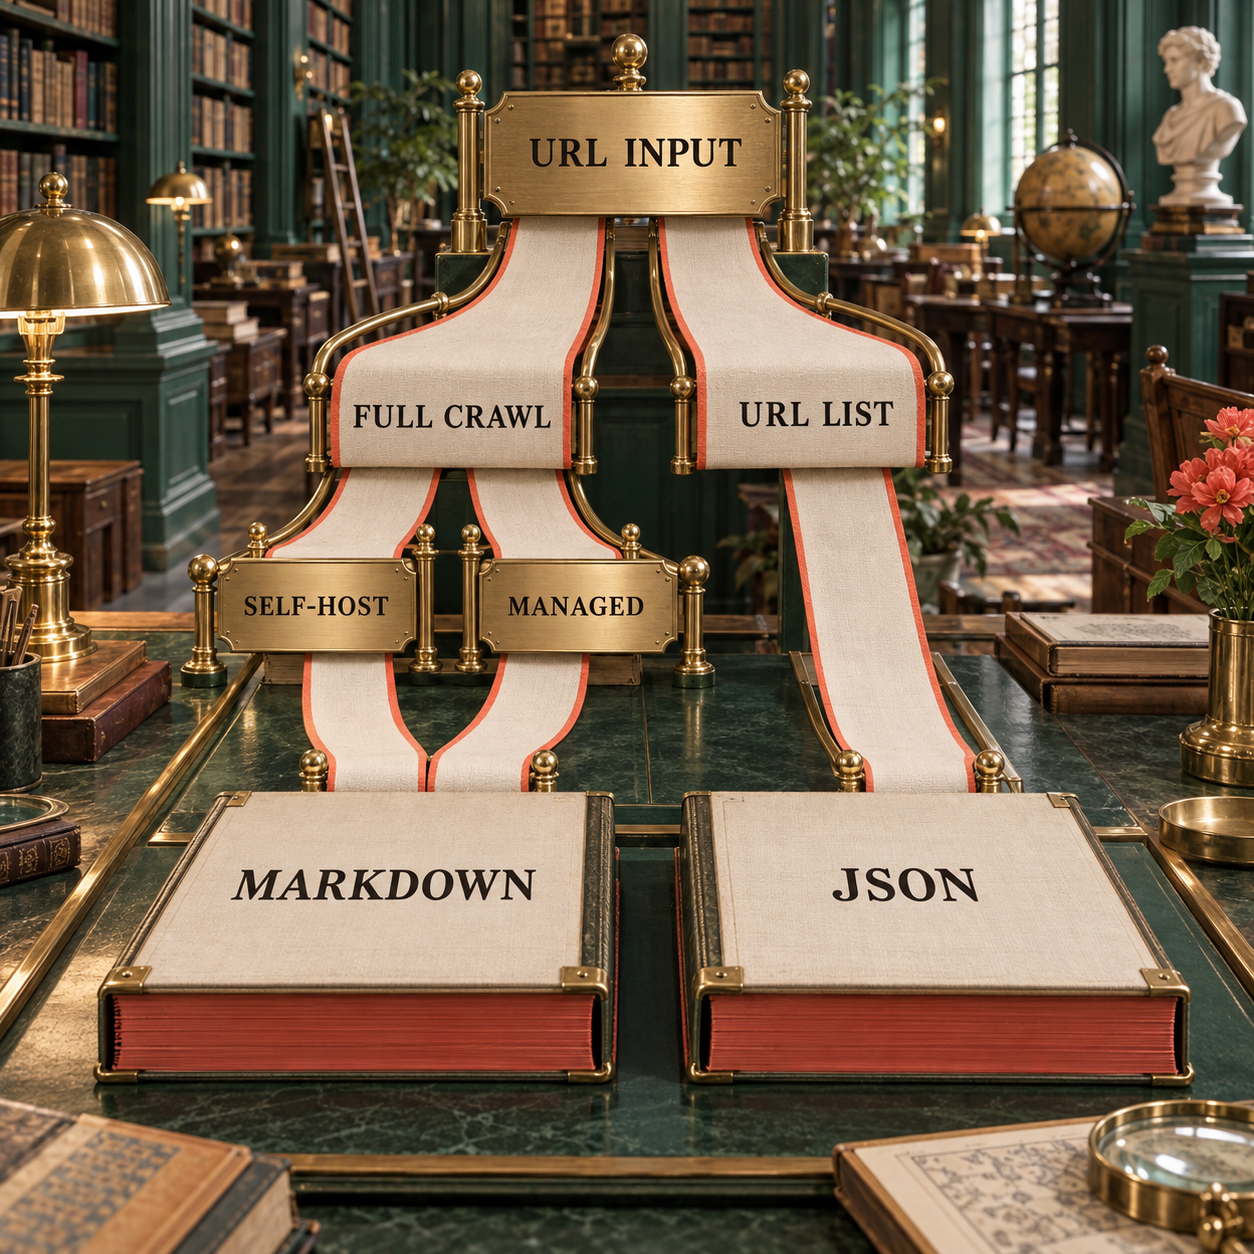
プレイグラウンドで最も見栄えのよい出力だけを見て選んではいけません。採用する構成は同じテストに合格し、同じ証跡を保存し、後段で同じチャンクを生成する必要があります。記事ページ1件ではきれいに見えるツールでも、本番の採否を左右する表、PDF、JavaScriptルートで失敗することがあります。
Firecrawlの直接的な代替として避けるべきもの
隣接カテゴリの製品を買い、パイプラインが完成したと見なすのは避けてください。 次のツールにも用途はありますが、ここで定義したFirecrawlの仕事全体は置き換えられません。
- ExaとTavily: 検索プロバイダーの評価対象に残します。今回の置き換えはドメインまたはURL一覧を選んだ後から始まり、受け入れ可能なページ本文を生成する必要があるため、この候補からは外しました。
- PlaywrightまたはPuppeteer単体: ブラウザ自動化は構成要素であり、マネージド型クロールマニフェスト、Markdown契約、再試行台帳、構造化配信システムではありません。これらのレイヤーを構築すること自体が目的の場合だけ選びます。
- プロキシ専用サービス: レスポンスへアクセスできても、ナビゲーションの除去、リンクの保持、JSONの検証、チャンク境界の安定化は行えません。
- メンテナンスされていないクローラーのフォーク: ブラウザのバージョン、セキュリティ修正、対象サイトの挙動が変わったとき、リリース経路の担当者がいなければ、無料のリポジトリがインシデントの原因になります。
マーケティング用ベンチマークを移行の証明に使うことも避けてください。保存済みの20 URLテストにまったく同じ構成を実行していなければ、その数値は別の誰かのワークロードを示すだけです。この記事では意図的に、合成した通過率やレイテンシの順位表を掲載していません。
小規模チーム向け移行ワークシート
安全に移行するには、固定テストと本番を代表するサンプルで、正規化出力、再試行の挙動、チャンクが一致するまで、Firecrawlと候補製品を並行稼働させます。 ワークシートには、責任者1人、バージョン管理されたスキーマ1つ、ロールバック条件1つが必要です。
1. 入力と探索の契約を固定する
URLの取得元がドメインクロール、サイトマップ、検索API、キュー、社内データベースのどれかを記録します。許可ドメイン、サブドメイン方針、対象・除外パス、深さ、ページ上限、正規化、重複ルールも保存します。別コンポーネントがこの行全体を担わない限り、JinaやScrapingBeeの試験結果をFirecrawlと比較することはできません。
2. 出力スキーマを凍結する
必須フィールドと型をバージョン管理します。最低限、source_url、final_url、title、markdown、links、status_code、fetched_at、content_sha256を保持します。nullを許可する業務フィールドと、欠落時にページを不採用とするフィールドを区別します。パーサー変更時にクローラー料金を再度払わず再実行できるよう、未加工レスポンスを保存します。
3. 再試行を会計イベントとして定義する
各試行について、ベンダーの状態、HTTPステータス、受け入れ判定、再試行理由、クレジットまたはリクエスト費用、次の処理を保存します。通信エラー、ベンダー判定の失敗、アクセスブロック、空のコンテンツ、スキーマエラー、後段の変換エラーを分けます。再試行回数に上限を設け、上限へ達した項目は、見えない支出ループを作らずデッドレターキューへ送ります。
4. 証跡一式を保存する
ツール、リリース、設定ハッシュ、実行日、テストIDをキーにしたパスを使います。リクエスト、ヘッダー、未加工レスポンス、正規化済みJSON、Markdown、判定、ダイジェストを保存します。どのレンダラー、抽出モード、スキーマが各採用チャンクを作ったか、レビュー担当者が確認できる状態にします。
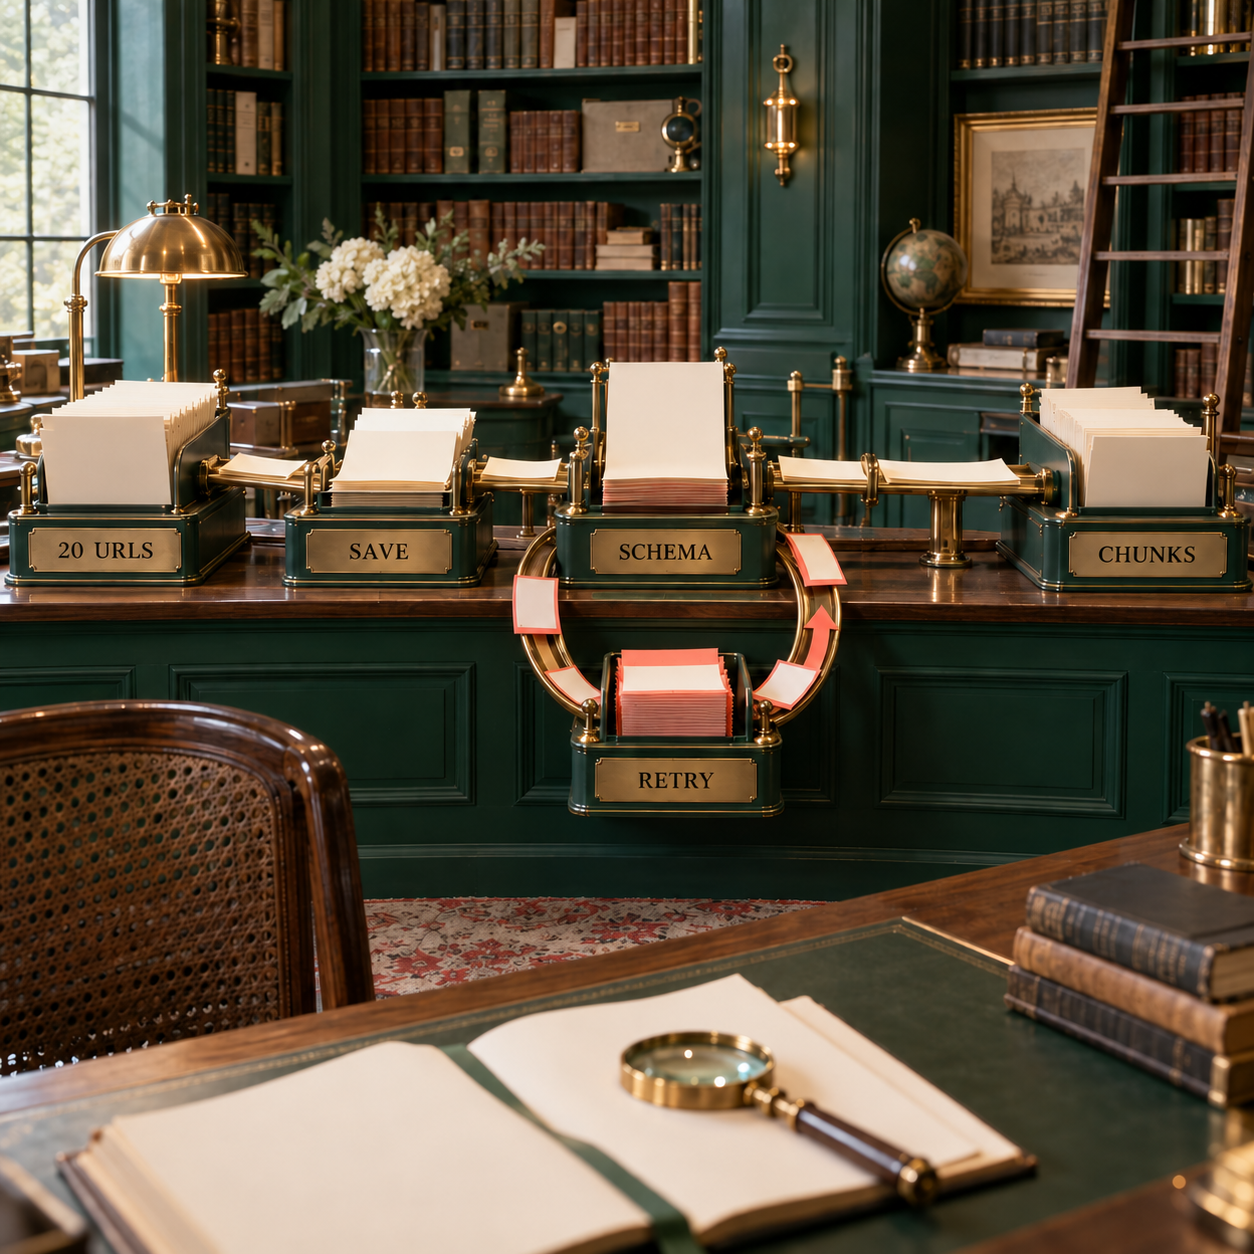
5. 後段のチャンク処理を回帰テストする
再埋め込みを行う前に、見出し階層、コードフェンス、表、リンク先、ドキュメント順序、コンテンツハッシュを比較します。続いて、チャンク数、チャンク境界、出典リンクを比べます。見た目がきれいなMarkdownでも、見出しが消えたり表の行が複数チャンクに分断されたりすれば、検索挙動が変わる可能性があります。
6. 採用コーパスの費用を計算し、ロールバック条件を決める
ベンダーへの支払い、ホスト費用、抽出トークン、課金対象の再試行、ストレージ、担当者の工数を合計します。リクエスト数ではなく採用ページ数で割ります。必須フィールドの失敗、想定外の対象ティア、チャンク数の大幅増加、運用工数の上限など、ロールバック条件をリリース前に決めます。新しい経路がその評価期間を通過するまで、旧経路を利用可能な状態に保ちます。
小規模チームにとって、最初に役立つ成果物はベンダーの点数ではありません。テストURLごとに1行を割り当て、両方のシステムの列を持つワークシートです。各行に証跡が入れば、合格か不合格かを好みではなく、レビュー可能な判断として扱えます。
よくある質問
Webスクレイピングは違法ですか?
一律に「はい」または「いいえ」と答えることはできません。米国では、米司法省のCFAA方針が技術的なアクセス境界と単なる契約制限を区別していますが、契約、著作権、プライバシー、データ利用、アクセス制御、法域によっても判断は変わります。これは法的助言ではありません。本番での収集は、対象と用途を特定したうえで専門家に相談すべきです。
Firecrawlは高いですか?
採用できる出力を基準にすると答えが変わります。Crawlはページあたり1クレジットで、JSONは4を追加します。このモデルでは、10%の再試行予備枠を含む採用ページ10,000件に55,000クレジットが必要で、$83のStandardに収まります。担当者の作業と移行費用は、この請求額より大きくなることがあります。
おすすめのWebスクレイピングツールは?
この候補の中で最も幅広く使えるマネージド型の移行先はApify Website Content Crawlerです。セルフホストが必須ならCrawl4AI、マネージドクロールと抽出をまとめるならScrapFlyが有力です。Jina Readerが有利なのは、信頼できるURL一覧がすでにある場合に限られます。
Firecrawlはセルフホストできますか?
はい。セルフホスト版のコアによりチームが管理権を持てますが、データベース、キュー、ブラウザワーカー、アップグレード、セキュリティ、アクセス経路、監視もチームの責任になります。Firecrawl Cloudと同じ運用製品ではありません。
Firecrawlの代替には何がありますか?
この記事では、Apify Website Content Crawler、Crawl4AI、ScrapFly、Jina Reader、ScrapingBee、Zyte API、Bright Data Crawl APIの7製品を比較しました。サイト全体のクローラー、指定URLを読むReader、アクセス重視のAPIという3種類に分かれます。
セルフホストは合法ですか?
自分で管理するインフラ上でソフトウェアを動かすことと、そのソフトウェアが何へアクセスするかは、一般に別の問題です。認可、アクセス制御、サイト規約、著作権、プライバシー、データ保護規則、利用目的は、それぞれ確認する必要があります。
セルフホストには価値がありますか?
必須のデータ境界、カスタマイズ性、共通基盤の能力が運用作業を上回る場合には価値があります。小さな月額API費用をなくすためだけに、新しいオンコール対象を増やすのは通常見合いません。
無料ホスティングにはどんなリスクがありますか?
無料インスタンスは、スリープ、CPUやメモリの制限、ストレージの入れ替え、信頼性の低い共有IP、復旧保証の欠如といった制約を持つ場合があります。その結果、原因がソフトウェアになくてもクローラーが不安定に見えることがあります。
Webサイトを無料でセルフホストできますか?
趣味のWebサイトやクローラー評価なら無料枠に収まる場合があります。本番クロールには、コンピュート、ストレージ、帯域幅、アクセス基盤、監視、バックアップ、担当者の時間が必要です。したがって、ホスト費用が$0でも運用費用が$0になるわけではありません。
Firecrawlはオープンソースですか?
Firecrawlはセルフホスト可能なオープンソースのコアを公開しています。Firecrawl Cloudにはマネージドインフラと運用サービスが加わるため、リポジトリだけでCloud製品と同じコストや信頼性の境界を再現できるわけではありません。
- 最終更新
- 2026年9月25日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

AI コードレビューで選ぶCodeRabbit代替ツール7選
CodeRabbitの代替7製品を、Gitホスト対応、データ境界、料金単位、セルフホスト可否で比較。5人・300回のAI コードレビューを基準に、Greptile、cubic、Qodo、PR-Agent、Kodus、Cursor Bugbot、GitHub Copilotの費用、選び方、乗り換え条件を整理します。2026年9月25日Build
AI コードレビュー比較:GreptileとCodeRabbitはどちらを選ぶ?
AI コードレビューのGreptileとCodeRabbitを、料金体系、レビュー上限、対応Gitホスト、実行時検証の違いで比較。5人チームの費用試算を基に、定常的なPRにはCodeRabbit、深度調整やT-Rexが必要なレビューにはGreptileを選ぶ判断基準を解説します。2026年9月25日Build
Perplexity Portable Computerの使い方:AMD WindowsでローカルAIを動かす
Perplexity Portable ComputerをAMD Ryzen AI Max搭載Windows PCでローカル実行する条件と設定手順を解説。GPUアクセス可能メモリ24 GB、モデル選択、フォルダー権限、クラウド承認、定期実行まで、既知の例外3件を使った検証方法とともに整理します。2026年9月25日Build
AgentRun レビュー:beta.4を実測、導入価値と限界を検証
AgentRun レビューとしてbeta.4をサポート業務で実測。分岐制御、型付き状態、エスカレーション、料金、LangGraph.jsやTemporalとの違いを検証し、31行のTypeScript関数より導入価値が出る条件、ホスト側に残る実装負担、採用前に確認すべき制約まで具体的なテスト結果から解説します。2026年9月24日Build
Perplexity APIのFast Searchと標準webを比較:料金・速度・検索品質
Perplexity APIのFast Searchと標準webを、料金、レイテンシ、検索品質、情報源の網羅性で比較。10,000回の検索費用は$10対$50です。反復的な検索にはfast、曖昧で網羅性が重要な調査にはwebを使い分ける判断基準と、本番導入前に確認すべき検証手順を実務目線で解説します。2026年9月24日Build
AIエージェント コストの盲点:有料フォールバックが既定経路になった日
AIエージェント コストの盲点を、実際の公開障害から読み解きます。画像ファイルの受け渡しが止まり、有料フォールバックが既定経路となり、共有残高は$8.30から$0へ。カバーや埋め込みが欠けてもジョブはdoneのままでした。サンドボックス境界、認証情報の所有、完了条件、従量課金の監視をどう設計し直すべきかを解説します。2026年9月24日Build
Cursor 料金を検証:Rolloutsは無料で使えるのか
Cursor Rolloutsは無料ではなく、Teamsは1ユーザー月額$40、Enterpriseは個別見積もりです。10日間のローンチクレジットでTeamsは約50件、Enterpriseは約500件の変更を試せますが、その後の単価は未公表。料金の仕組みと導入判断を整理します。2026年9月24日Build