7 ferramentas de web scraping para substituir o Firecrawl
Compare ferramentas de web scraping para pipelines de IA por rastreamento, saída em Markdown e JSON, esforço de migração e custo por página útil.




Entre as ferramentas de web scraping capazes de substituir o Firecrawl, a diferença aparece em 10,000 páginas aprovadas: neste modelo, o Firecrawl custa $83 em taxas do fornecedor mais três horas de operação, enquanto o ScrapFly custa $30 mais três horas. A fatura menor não significa, por si só, uma substituição mais barata: descoberta, novas tentativas com renderização, extração em JSON e divisão do conteúdo em chunks podem apagar essa diferença.
Resposta curta: trocar o Firecrawl é trocar um pipeline
Escolha o Apify Website Content Crawler se você precisa da alternativa gerenciada mais próxima e abrangente; o Crawl4AI, se o controle da infraestrutura é o objetivo; o ScrapFly, se um único saldo de créditos deve cobrir rastreamento e extração estruturada; e o Jina Reader, se outro sistema já fornece as URLs. ScrapingBee, Zyte API e Bright Data Crawl API ganham força quando acessar páginas difíceis importa mais do que ter um fluxo nativo de site para Markdown.
A unidade relevante não é uma requisição nem uma URL descoberta. É a página aprovada que chega ao pipeline de geração aumentada por recuperação — ou seja, o modelo recebe material-fonte útil, com Markdown, campos JSON, links e metadados obrigatórios intactos. Uma resposta barata que perde uma tabela, inventa um campo de preço vazio ou quebra o chunker é um fracasso pago.
Firecrawl: a referência
O Firecrawl serve de referência porque seu endpoint Crawl já reúne descoberta, renderização e processamento de páginas, entregando depois Markdown ou JSON no formato de um schema. A cobrança é de 1 crédito por página rastreada e mais 4 créditos no modo JSON. Portanto, a base relevante desta comparação é de 5 créditos por página tentada.
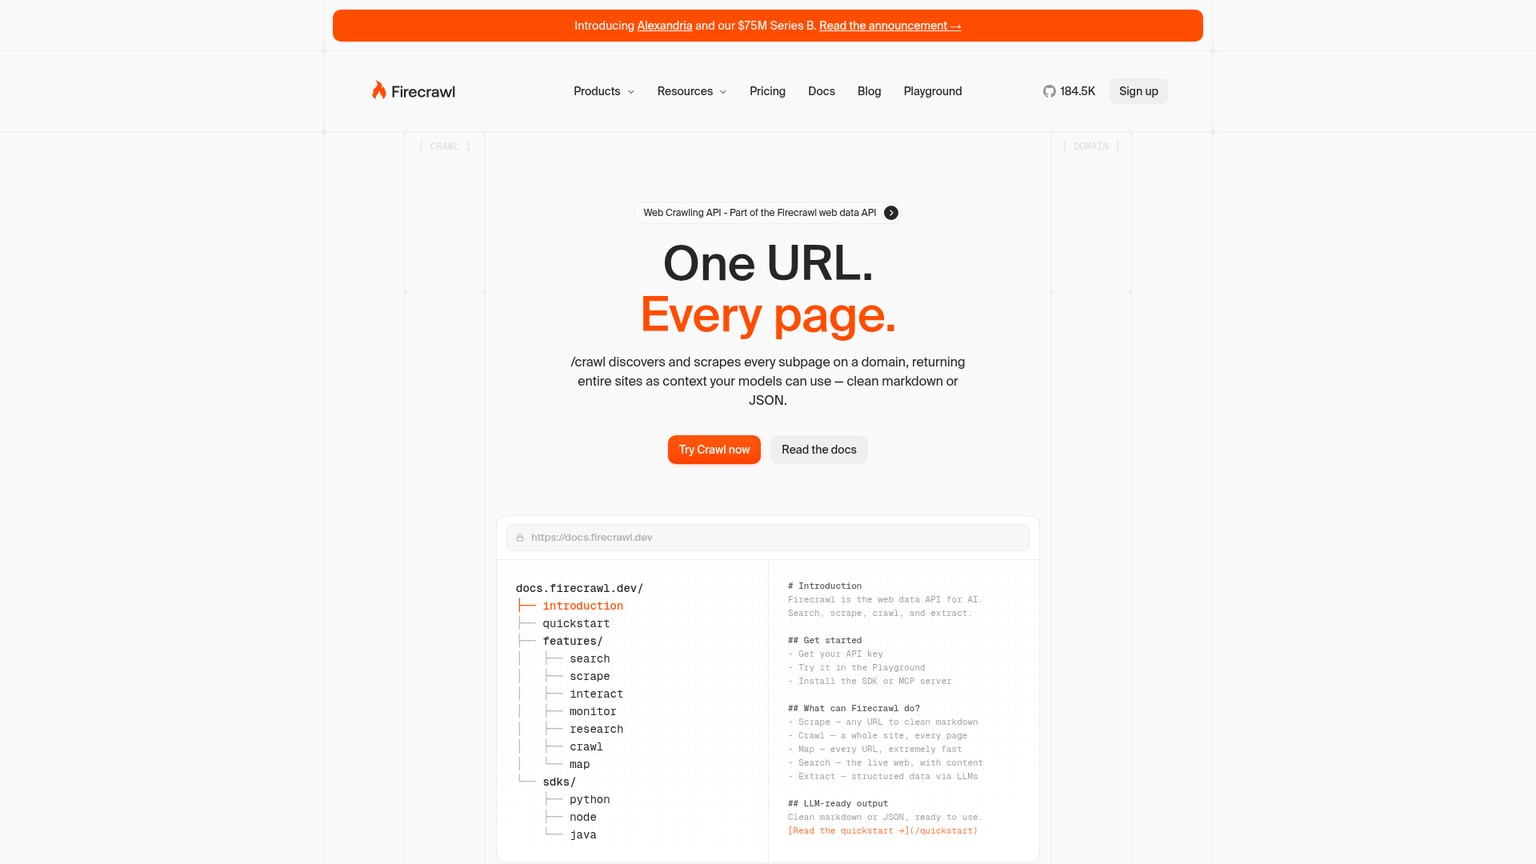
Esse pacote explica por que permanecer no Firecrawl pode ser melhor do que migrar para uma opção aparentemente mais barata. A ferramenta também administra escopo de rastreamento, subdomínios, caminhos, profundidade e entrega contínua das páginas. Uma API de leitura pode cobrar menos por URL, mas deixar a descoberta com sua equipe; uma API de acesso pode buscar páginas protegidas, mas transferir a conversão para Markdown e a normalização do schema para as etapas seguintes.
Preços do Firecrawl no modelo por página aprovada
Os planos atuais do Firecrawl são Free, a $0 por 1,000 créditos; Hobby, a $16 por mês com cobrança anual por 5,000 créditos; Standard, a $83 por 100,000 créditos; Growth, a $333 por 500,000 créditos; Scale, a $599 por 1,000,000 créditos; e Enterprise, com preço personalizado. O excedente custa $9 por 1,500 créditos no Hobby, $47 por 35,000 no Standard, $177 por 175,000 no Growth e $397 por 350,000 no Scale. Esses valores, limites e recursos de rastreamento foram conferidos na página atual do Firecrawl Crawl em 25 de setembro de 2026.
Com uma reserva de 10% para respostas bem-sucedidas que não passam pelo gate local de aprovação, 1,000 páginas aprovadas em Markdown e JSON exigem 5,500 créditos. O Hobby mais um bloco excedente custa $25. Dez mil páginas aprovadas exigem 55,000 créditos, portanto o Standard custa $83. Cem mil páginas aprovadas exigem 550,000 créditos, o que leva ao Growth mais um bloco excedente, por $510.
A busca é uma camada separada. Se o trabalho começa por uma consulta e exige fontes ranqueadas, em vez de um site conhecido ou um conjunto de URLs, use o comparativo de APIs de busca com IA para essa decisão e depois envie as URLs escolhidas à camada de extração.
Ferramentas de web scraping: visão geral
A tabela avalia a adequação documentada, não a qualidade medida das saídas. Os preços foram verificados nas páginas oficiais em 25 de setembro de 2026. “Teste grátis” também inclui uma franquia gratuita permanente quando essa é a oferta do fornecedor.
Não existe um vencedor universal, porque a expressão “extração da web” esconde três produtos diferentes. Um crawler descobre um site, um reader converte uma URL fornecida e uma camada de acesso atravessa renderização ou bloqueios. Compre o produto mais restrito que cubra todas as etapas que sua equipe não quer operar.
Como as opções foram selecionadas
Uma opção só entrou na lista quando seus materiais oficiais atuais indicaram um caminho confiável tanto para conteúdo útil das páginas quanto para uma saída legível por máquina. APIs exclusivas de busca ficaram de fora porque descoberta ranqueada não substitui um crawler. Serviços que oferecem apenas proxy também foram excluídos: um IP não produz Markdown limpo, JSON com os campos obrigatórios nem um manifesto de rastreamento salvo.
A comparação se apoia em cinco verificações de aprovação:
- Descoberta: a ferramenta consegue percorrer um site, respeitar o escopo e preservar um manifesto de URLs canônicas ou outro componente precisa fornecer cada URL?
- Renderização e acesso: ela executa JavaScript e lida com as condições de acesso do site sem gerar uma conta ilimitada de novas tentativas?
- Contrato de saída: preserva títulos, tabelas, código e links no Markdown e consegue preencher os campos JSON obrigatórios sem uma segunda transformação opaca?
- Evidências: a equipe consegue salvar requisição, resposta bruta, saída normalizada, headers, configuração, hash do conteúdo e veredito de cada URL do fixture?
- Custo total: quanto se paga por descoberta, renderização, extração, novas tentativas bem-sucedidas porém rejeitadas, compromissos mínimos e tempo de operação?
Nenhuma opção foi executada para este artigo. Portanto, não há taxas de aprovação nem rankings de latência alegados. Toda afirmação sobre qualidade abaixo descreve um recurso documentado; toda comparação em dólares é um modelo cujas premissas estão expostas.
O fixture fixo de aprovação com 20 URLs
Não migre usando uma URL de demonstração do fornecedor. Execute o mesmo fixture fixo com a configuração antiga e a nova, depois salve todas as respostas. O conjunto mistura deliberadamente formatos de conteúdo que revelam falhas distintas:
- Código e documentos longos: Fetch API no MDN, classes em Python, ownership no Rust, RFC 9110 em HTML e HTML do HTTPBin.
- Tabelas, links e páginas estruturadas: referência de tabelas do MDN, tutorial de tabelas do W3C, web scraping na Wikipedia, catálogo Books to Scrape e uma página fixa de produto.
- Paginação e JavaScript: Quotes to Scrape, sua rota em JavaScript, sua rota de rolagem, guia de JavaScript do MDN e normalização de links do HTTPBin.
- Codificação e PDFs: Unicode no HTTPBin, RFC 9110 em PDF, um artigo científico em PDF com duas colunas, um PDF mínimo do W3C e formulário W-9 do IRS.
Todo resultado deve conter source_url, final_url, title, markdown, links, status_code, fetched_at e content_sha256. Páginas de produto também exigem entity_name, amount e currency; o artigo científico em PDF exige published_at. Um campo só pode ser explicitamente nulo quando o manifesto do fixture permitir. Campo ausente não é o mesmo que nulo.
Salve um diretório por ferramenta, versão e configuração. Para cada URL, preserve request.json, os headers da resposta, o corpo sem alterações, normalized.json, verdict.json e o digest SHA-256. O veredito deve identificar a primeira regra que falhou, não apenas pass: false. Com essas evidências, outro engenheiro consegue reproduzir uma decisão mesmo depois que fornecedor, parser ou página mudarem.
Planilha de custo por página aprovada
O modelo considera 1,000, 10,000 e 100,000 páginas aprovadas por mês, com uma reserva de 10% para respostas que o fornecedor classifica como bem-sucedidas, mas que o gate local de schema ou Markdown rejeita. Essas novas tentativas são cobradas. Falhas explícitas do fornecedor seguem a política de reembolso publicada por cada um.
A fórmula-base é simples: dinheiro gasto com fornecedor ou hospedagem, mais cobranças de descoberta, renderização, extração e novas tentativas pagas, mais as horas de operação multiplicadas pelo custo horário total da equipe. A tabela mostra dinheiro pago ao fornecedor e horas separadamente para que a premissa de $100 por hora possa ser substituída sem refazer todas as fórmulas.
Com a hora de operação a $100, os totais para 10,000 páginas ficam em $383 no Firecrawl, $419 no Apify, $1,248 no Crawl4AI, $330 no ScrapFly, $401.10 no Jina, $449 no ScrapingBee, $555.22 no Zyte e $516.50 no Bright Data. O valor do Jina só se aplica quando já existe um manifesto de URLs confiável; não representa o total de um rastreamento completo de site. As horas de Bright Data e Zyte incluem o trabalho posterior de Markdown e schema, pois nenhuma das páginas dos produtos documenta Markdown nativo como contrato de saída usado aqui.
A linha de extração foi deixada explícita de propósito. O Firecrawl usa 1 crédito de crawl mais 4 créditos de JSON. O ScrapingBee usa 5 créditos de JavaScript mais 5 créditos de IA neste cenário. O ScrapFly usa 5 créditos de navegador ou Unblocker mais 5 créditos do modelo de extração. O Zyte usa o preço de navegador do tier 3 mais uma extração fixa de atributo personalizado. O Apify usa um envelope JSON determinístico, com 80% das páginas em HTTP bruto e 20% em headless pelo limite superior da estimativa publicada; resumos opcionais por IA não estão incluídos.
O Jina considera 2,000 tokens de saída por tentativa a $0.050 por milhão. O valor do consumo é minúsculo, mas o desembolso ocorre em blocos: depois que os 10 milhões de tokens gratuitos acabam, a menor recarga listada é de 1 bilhão de tokens por $50. O Crawl4AI considera hospedagens da DigitalOcean a $24, $48 e $96 nos três volumes, mas esses valores são premissas de planejamento, não alegações de capacidade medida.
1. Apify Website Content Crawler: melhor substituição gerenciada no geral
O Apify Website Content Crawler é a substituição gerenciada mais sólida e abrangente para equipes que precisam reunir descoberta, renderização de JavaScript, Markdown e um dataset persistente em um só serviço. Ele rastreia via HTTP bruto ou Firefox headless, armazena cada resultado como um registro do dataset e exporta JSON ou CSV. O formato da migração fica próximo ao do Firecrawl sem fingir que as APIs são iguais.
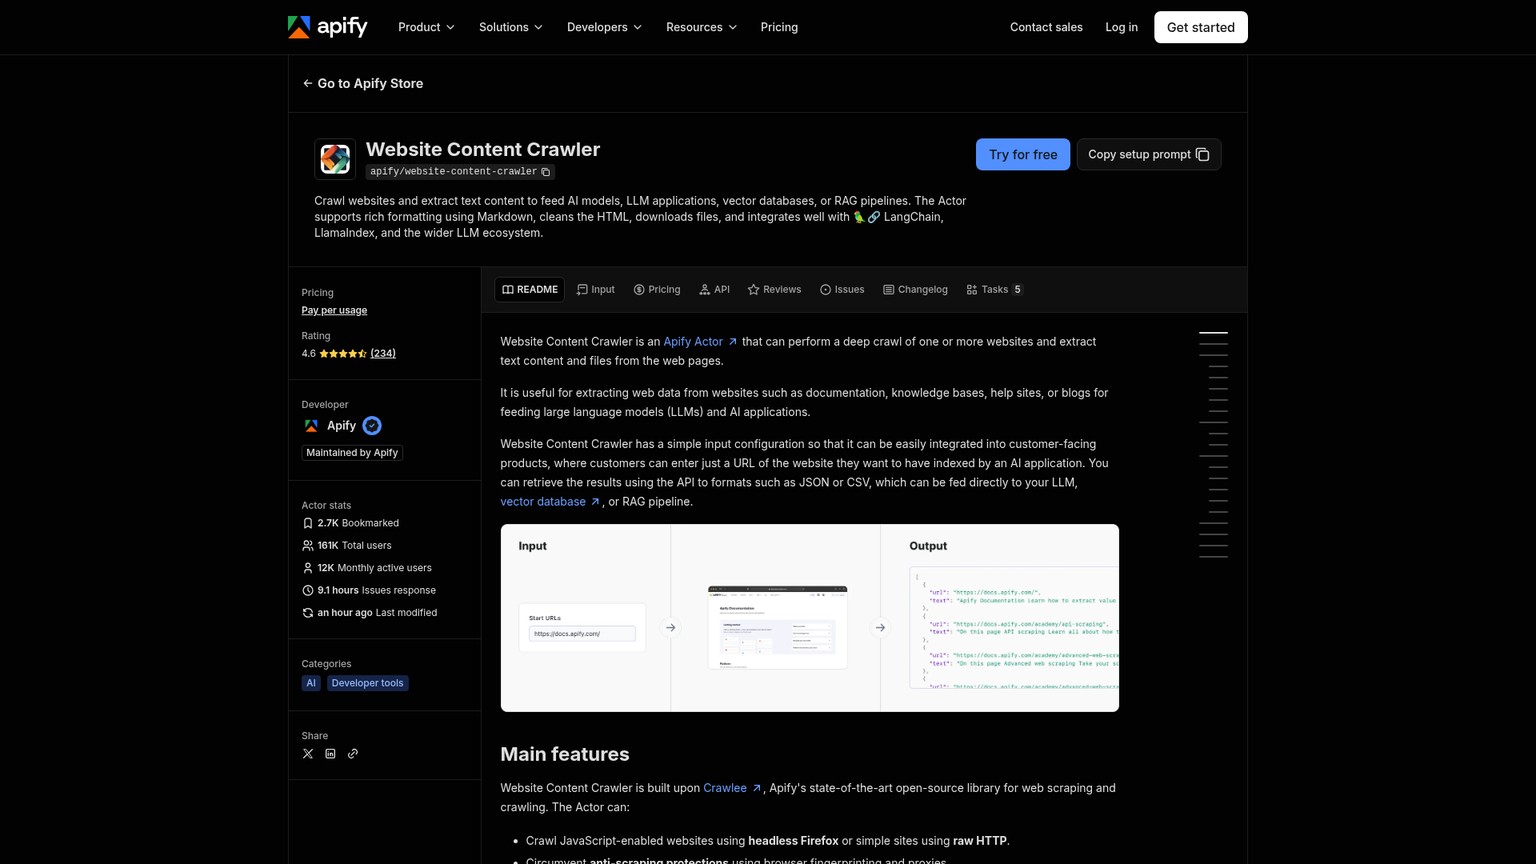
A vantagem mais evidente é controlar o rastreamento como um job. Escopo, saída e registros salvos no dataset ficam juntos, e arquivos como PDFs podem ser baixados. A limitação declarada está na extração semântica: o dataset JSON do Actor é um envelope estruturado com texto, Markdown e metadados, mas um schema de negócio personalizado ainda exige regras determinísticas, outro Actor ou uma etapa com modelo.
A estimativa publicada pelo Actor é de aproximadamente $0.20 por 1,000 páginas em HTTP bruto e de $0.50 a $5 por 1,000 páginas headless na referência informada. Resumos opcionais por IA acrescentam cerca de $2 a $3 por 1,000 páginas; em páginas sem títulos, o valor chega a aproximadamente $7 por 1,000. O modelo acima não inclui esse adicional, porque um resumo não substitui campos JSON obrigatórios.
Os planos do Apify são Free, a $0, com $5 de uso mensal e 5 execuções simultâneas; Starter, a $19, com $19 de uso e 32 execuções simultâneas; Scale, a $199, com $199 de uso, unidades computacionais a $0.16 e 128 execuções simultâneas; Business, a $999, com $999 de uso, unidades computacionais a $0.13 e 256 execuções simultâneas; e Enterprise personalizado. No Free, o uso para quando a franquia termina. Nos planos pagos, o consumo excedente continua sendo cobrado e a franquia não utilizada não acumula. A página atual de preços do Apify é a fonte desses termos da plataforma.
Melhor para: Uma pequena equipe de produto ou dados que quer substituir um job gerenciado de rastreamento, especialmente quando o histórico de execuções e a exportação dos datasets importam.
Destaque: Descoberta do site inteiro, renderização no navegador, Markdown e registros persistentes em dataset JSON na mesma execução gerenciada.
Preço: Free $0; Starter $19; Scale $199; Business $999; Enterprise personalizado. O custo real do Actor também inclui computação, armazenamento, proxies e transferência consumidos pela execução.
Teste grátis: O plano Free permanente inclui $5 de uso mensal na plataforma sem exigir cartão.
- HTTP bruto e Firefox headless atendem tanto páginas estáticas baratas quanto páginas em JavaScript.
- Os registros do dataset simplificam a revisão e a exportação de respostas salvas.
- Escopo do rastreamento, download de arquivos, metadados e Markdown ficam em um único job gerenciado.
- A fatura da plataforma reúne computação, armazenamento, transferência e uso de proxies, em vez de um único crédito por página.
- Um registro em dataset JSON não é automaticamente o schema de negócio esperado pelo seu código nas etapas seguintes.
- Resumos por IA geram um custo separado de Actor e ainda não comprovam a aprovação da extração.
Um teste de migração para o Apify em cinco etapas
Carregue o manifesto fixo de URLs
Comece pelas 20 URLs do fixture, não pelo domínio de produção inteiro. Fixe a entrada do Actor, o tipo de crawler, o limite de páginas e o escopo para que uma segunda execução represente a mesma coisa.
Use HTTP bruto até a página provar que precisa de navegador
Mantenha o caminho barato para páginas estáticas e envie os fixtures em JavaScript para renderização headless. Salve com cada resultado o modo de crawler escolhido.
Exporte o Markdown e o registro do dataset
Preserve
markdownsem alterações, a URL canônica, os metadados e os links. Converta esse registro para o schema JSON local obrigatório em uma etapa determinística separada.Rejeite antes de dividir em chunks
Execute as verificações de tabelas, código, links e campos obrigatórios no registro normalizado. Uma única regra reprovada envia a URL ao histórico de novas tentativas, não ao índice vetorial.
Calcule o preço somente das páginas aprovadas
Divida a conta completa de Actor, proxy, armazenamento e operação pelo número de páginas aprovadas. Compare o resultado com a referência do Firecrawl antes de ampliar o rastreamento.
2. Crawl4AI: melhor alternativa self-hosted
O Crawl4AI é a melhor escolha self-hosted quando controle da infraestrutura, fronteiras de dados ou regras reutilizáveis de extração são requisitos rígidos. Ele produz Markdown e permite extração estruturada com CSS, XPath ou uma estratégia baseada em LLM. Assim, pode cobrir texto para recuperação e campos JSON sem uma taxa de software por requisição.
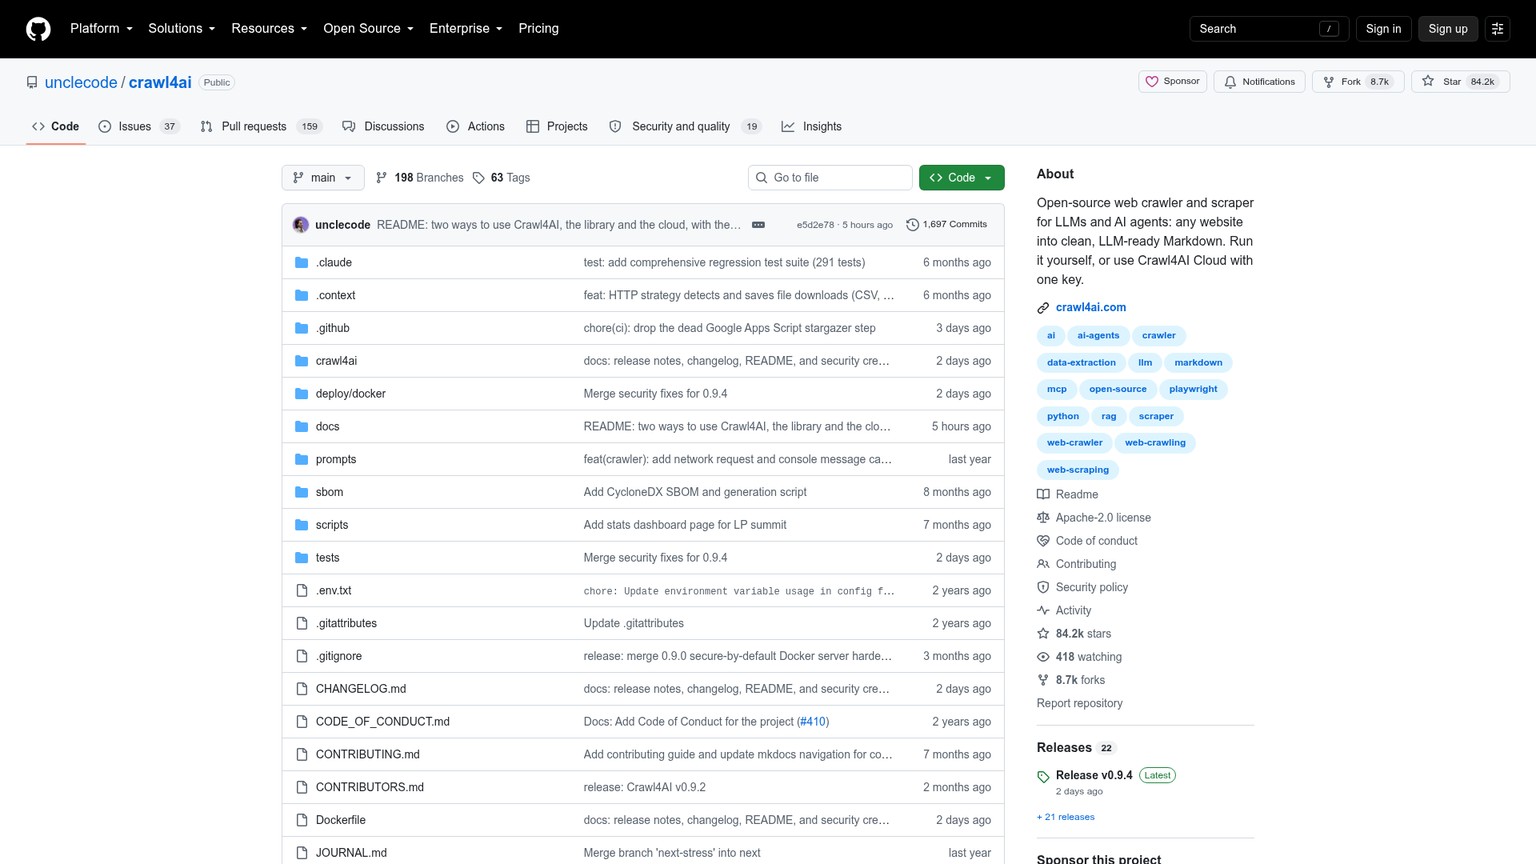
Hoje, o patamar mínimo de segurança pesa mais do que o preço da licença. A versão 0.9.4 foi lançada em 23 de setembro de 2026 e corrige três alertas, entre eles dois caminhos de server-side request forgery e uma falha na fronteira de confiança da configuração que poderia expor valores do ambiente. Toda avaliação deve fixar a v0.9.4 ou posterior e consultar os avisos de segurança do projeto antes de expor sua API.
Crawl4AI vs. Firecrawl
O Firecrawl vende o serviço operado em torno do rastreamento: filas gerenciadas, navegadores, créditos, entrega e suporte. O Crawl4AI fornece o crawler e o sistema de extração, enquanto sua equipe assume implantação, upgrades, observabilidade, estratégia de proxies e resposta a incidentes. A escolha muda quando essas responsabilidades já fazem parte de uma plataforma compartilhada — não quando um único engenheiro precisa criá-las para este projeto.
A hospedagem própria recomenda no mínimo 4 GB de RAM, Docker 20.10 ou posterior e Compose 2.24 ou posterior. A planilha de custos usa os preços atuais dos Basic Droplets da DigitalOcean: $24 por 4 GiB, $48 por 8 GiB e $96 por 16 GiB. Esses tamanhos servem apenas como premissas do cenário; nenhuma vazão de páginas foi medida nesta análise.
Melhor para: Equipes que já têm uma plataforma de containers, uma fronteira de dados rígida e engenheiros capazes de assumir a operação do crawler.
Destaque: Controle open source combinado a schemas determinísticos de extração por CSS ou XPath, capazes de evitar gasto com modelos por página.
Preço: Licença de software a $0. O modelo usa hospedagens mensais de $24, $48 e $96, além de proxies, armazenamento, monitoramento, chamadas a modelos e trabalho conforme a necessidade.
Teste grátis: O software é open source; a infraestrutura não está incluída.
- Markdown e extração estruturada rodam na infraestrutura controlada pela equipe.
- Schemas em CSS e XPath podem tornar sites estáveis baratos e determinísticos.
- Agora, por padrão, o servidor self-hosted do projeto tende a uma operação autenticada e protegida no loopback.
- Reputação de proxies, capacidade dos navegadores, correções, filas e recuperação passam a ser responsabilidade da sua equipe.
- O tamanho da hospedagem não comprova a vazão de páginas aprovadas sem uma execução salva.
- A extração por LLM transfere o custo de tokens e a análise da fronteira de dados para outro fornecedor ou para um modelo local.
O guia de self-hosting do Firecrawl aborda separadamente a escolha entre o repositório do Firecrawl e o Firecrawl Cloud. Não contabilize a licença de $0 do Crawl4AI como economia antes de incluir, na mesma planilha, as pessoas que mantêm o sistema atualizado e disponível.
3. ScrapFly: melhor combinação de rastreamento e extração para equipes pequenas
O ScrapFly é a alternativa mais forte para equipes pequenas quando uma única conta precisa cobrir acesso, rastreamento, conversão para Markdown e extração tipada. Os produtos compartilham o mesmo saldo de créditos, e a camada de extração aceita HTML, Markdown, XML, JSON, CSV, RSS ou texto simples. É possível usar templates determinísticos, modelos pré-treinados ou um prompt com schema JSON sem juntar fornecedores diferentes.
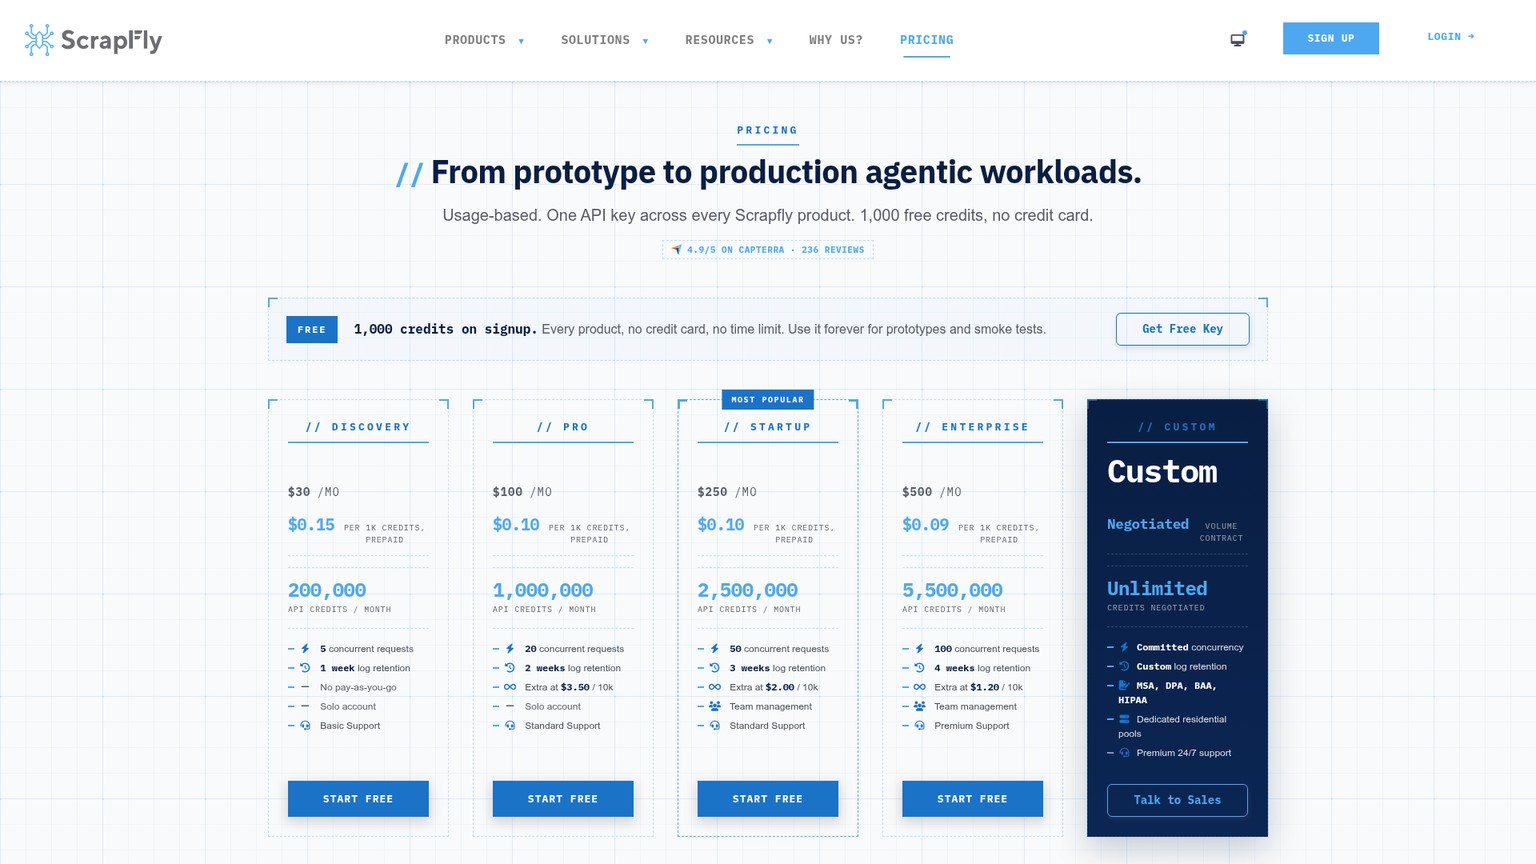
O modelo de créditos fica claro depois que a configuração é definida. Uma requisição HTTP simples por datacenter custa 1 crédito; renderização de JavaScript ou Unblocker, 5; roteamento residencial, 25; e uma captura de tela da página inteira, 60. A extração por template custa mais 1 crédito, enquanto um prompt ou modelo de extração custa 5. Em documentos com mais de 500 KB, a cobrança-base de extração se repete a cada 500 KB adicionais.
Assim, o cenário do artigo custa 10 créditos por tentativa bem-sucedida: 5 pelo navegador ou Unblocker mais 5 pela extração. Com a reserva de 10% para novas tentativas, o total chega a 11 créditos por página aprovada. O modelo não soma roteamento residencial; um alvo que precise dele muda bastante o resultado.
Os planos atuais são Free, com 1,000 créditos concedidos uma única vez; Discovery, a $30 por mês, com 200,000 créditos e 5 requisições simultâneas; Pro, a $100, com 1,000,000 de créditos e 20 requisições simultâneas; Startup, a $250, com 2,500,000 créditos e 50 requisições simultâneas; Enterprise, a $500, com 5,500,000 créditos e 100 requisições simultâneas; e Custom negociado. O Discovery interrompe o serviço ao atingir a cota. O excedente do Pro custa $3.50 por 10,000 créditos; o do Startup, $2; e o do Enterprise, $1.20. Créditos não usados não acumulam. Os termos vêm da página atual de preços do ScrapFly.
Melhor para: Uma equipe pequena que quer um crawler gerenciado, controles de acesso e extração tipada na mesma fatura.
Destaque: O mesmo saldo de créditos pode financiar crawler, navegador, Unblocker e três estratégias de extração.
Preço: Free com 1,000 créditos; Discovery $30; Pro $100; Startup $250; Enterprise $500; Custom negociado.
Teste grátis: 1,000 créditos ao criar a conta, sem cartão e sem prazo de validade informado.
- A extração por template pode reduzir o gasto com modelos em layouts estáveis.
- Modelos pré-treinados e extração por prompt entregam JSON tipado sem outro fornecedor de modelos.
- Requisições que falham custam zero créditos, enquanto a resposta informa os créditos consumidos.
- Navegador, conexão residencial e opções de extração se acumulam rapidamente em páginas difíceis.
- Documentos acima de 500 KB multiplicam a cobrança de extração.
- O Discovery não aceita excedentes, então jobs de produção precisam do Pro ou de uma interrupção rígida antes que a cota se esgote.
O ScrapFly vence a planilha em 10,000 páginas aprovadas neste cenário específico: $30 mais três horas de operação, contra $83 mais três no Firecrawl. A diferença mensal de $53 em dinheiro é pequena demais para justificar uma migração imprecisa. Ela só se torna convincente se o fixture fixo passar, os alvos em produção não exigirem o caminho residencial de 25 créditos e o schema dispensar tratamento adicional.
4. Jina Reader: melhor quando você já tem a lista de URLs
O Jina Reader é o conversor de baixo custo variável mais indicado quando a descoberta já está resolvida e cada URL fornecida precisa virar Markdown limpo ou JSON no formato de um schema. O engine padrão renderiza JavaScript em um navegador headless, enquanto o engine direto segue a rota HTTP mais simples. O ReaderLM-v2 aceita um schema JSON ou uma instrução em linguagem natural para produzir saída estruturada.
Sua vantagem também define seu limite: o Reader lê uma URL. Ele não substitui regras de escopo para um site inteiro, fronteira de rastreamento, política de duplicação nem manifesto de crawl. Se um sitemap, uma etapa de busca ou um catálogo interno fornece a lista de URLs de forma confiável, essa função restrita pode ser uma virtude. Caso contrário, o custo da descoberta precisa voltar à planilha.
O uso básico do Reader é gratuito. Uma chave nova inclui 10 milhões de tokens, e os tokens de saída são cobrados quando a chave é usada. Uma recarga de 1 bilhão de tokens custa $50, ou $0.050 por milhão; uma recarga de 11 bilhões custa $500, ou $0.045 por milhão. Requisições com falha não descontam tokens. Os limites são de 20 requisições por minuto sem chave, 500 com uma chave gratuita ou paga e 5,000 com uma chave premium. Todos os dados vêm da página atual do Jina Reader.
A planilha considera 2,000 tokens de saída por tentativa bem-sucedida. Com a reserva para novas tentativas, o valor dos tokens consumidos fica em $0.11 por 1,000 páginas aprovadas, $1.10 por 10,000 e $11 por 100,000. Esses são valores econômicos de uso, não o dinheiro cobrado no checkout. Depois da franquia gratuita, a menor compra listada continua sendo de $50.
Melhor para: Um pipeline com manifesto de URLs confiável que precisa converter páginas em Markdown ou JSON a baixo custo.
Destaque: Cobrança por token de saída, renderização de JavaScript e extração por schema JSON em uma API de leitura específica.
Preço: O uso básico do Reader é grátis; toda chave nova recebe 10 milhões de tokens; os pacotes pagos custam $50 por 1 bilhão ou $500 por 11 bilhões.
Teste grátis: 10 milhões de tokens com uma chave de API nova.
- O renderizador padrão processa o JavaScript do lado do cliente antes da conversão.
- Os modos com schema JSON e instrução conseguem gerar campos estruturados no mesmo reader.
- Requisições com falha não consomem tokens.
- Descoberta do site, escopo e persistência do estado do rastreamento exigem outro componente.
- Um pacote de $50 é o menor desembolso depois da franquia grátis, mesmo quando o consumo atual vale muito menos.
- O custo por token de saída varia de acordo com o tamanho da página e o formato da resposta.
O Jina parece vencer em custo para 100,000 páginas, a $11 mais seis horas, mas somente sob a premissa de que o manifesto é fornecido. Acrescentar um job de descoberta pouco confiável e deduplicação manual tornaria essa linha incomparável com Firecrawl ou Apify. Use-o quando a fronteira do componente for real, não para esconder trabalho de rastreamento que ficou de fora.
5. ScrapingBee: melhor API de scraping com limite de créditos
O ScrapingBee é a melhor alternativa por requisição para equipes que querem limitar quanto uma única página pode custar. Ele pode retornar o Markdown da página ou uma resposta JSON, aplicar regras de extração por CSS e adicionar extração por IA quando o layout não é estável o bastante para seletores.
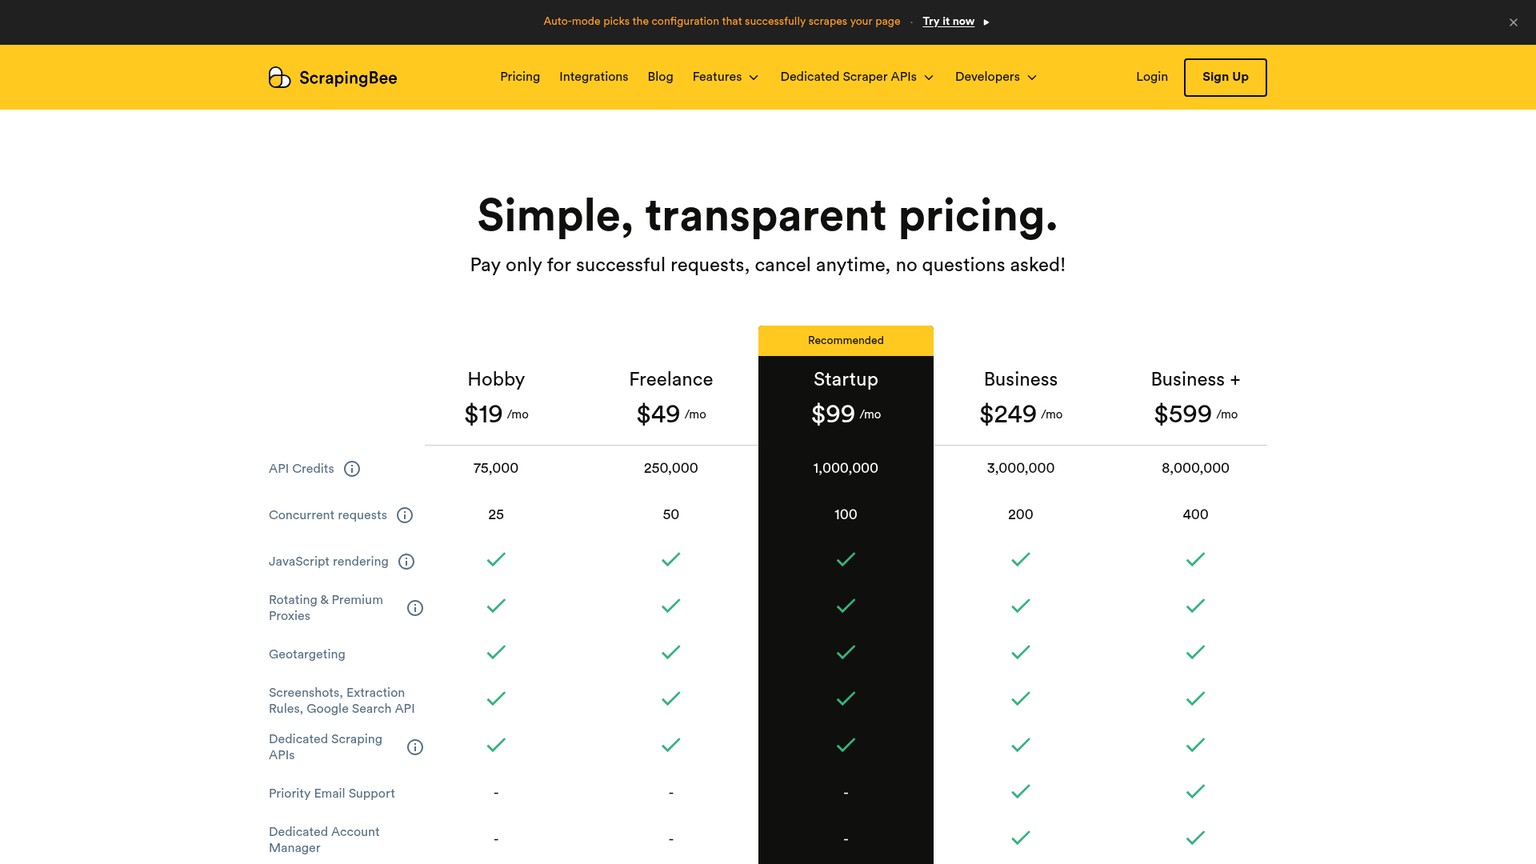
O controle útil é a escala de créditos. HTTP clássico custa 1 crédito; JavaScript clássico, 5; premium sem JavaScript, 10; premium com JavaScript, 25; e stealth com JavaScript, 75. Recursos de IA acrescentam 5 créditos. O modo Auto cobra a configuração que funcionar, não cobra nada se todas falharem e permite definir um teto de custo.
A limitação está na orquestração. O ScrapingBee busca as páginas solicitadas; ele não é o equivalente mais próximo da descoberta de sites e da fronteira de rastreamento do Firecrawl. A equipe precisa cuidar do manifesto de URLs, escopo, duplicatas e estado do job, além de distinguir uma falha do fornecedor de uma resposta bem-sucedida rejeitada pelo gate local.
Os planos atuais são Hobby, a $19 por mês, com 75,000 créditos e 25 requisições simultâneas; Freelance, a $49, com 250,000 e 50; Startup, a $99, com 1,000,000 e 100; Business, a $249, com 3,000,000 e 200; e Business+, a $599, com 8,000,000 e 400. A franquia de avaliação é de 1,000 créditos, sem cartão. Os números vêm dos planos atuais do ScrapingBee.
Melhor para: Equipes que já controlam a descoberta e precisam de tetos explícitos de custo por requisição, renderização e proxy premium.
Destaque: O modo Auto pode escalar o acesso, enquanto max_cost limita o consumo de uma única resposta.
Preço: Hobby $19; Freelance $49; Startup $99; Business $249; Business+ $599.
Teste grátis: 1,000 créditos sem cartão.
- Markdown, extração por CSS e extração por IA estão disponíveis na mesma API de requisições.
- A escala de 1, 5, 10, 25 e 75 créditos torna o custo de acesso transparente.
- O modo Auto cobra zero quando todas as configurações internas falham.
- Descoberta de sites e persistência do rastreamento continuam fora dos limites do produto.
- Uma resposta que o fornecedor considera bem-sucedida, mas que seu schema rejeita, ainda é uma tentativa paga.
- O consumo de créditos pode aumentar 15 vezes entre JavaScript clássico e JavaScript stealth antes mesmo de somar a extração por IA.
No modelo, JavaScript mais extração por IA consome 10 créditos por tentativa. A reserva para novas tentativas eleva esse número a 11 por página aprovada: 1,000 páginas cabem no Hobby por $19; 10,000, no Freelance por $49; e 100,000, no Business por $249, pois 1.1 milhão de créditos ultrapassa o 1 milhão do Startup.
6. Zyte API: melhor preço anti-bot por site
A Zyte API é a melhor opção quando a dificuldade de acesso varia muito entre os alvos e o comprador quer que o fornecedor atribua um nível de preço a cada site. Ela reúne no valor da resposta o caminho necessário via datacenter ou conexão residencial, além de renderização e trabalho de acesso, e cobra somente respostas bem-sucedidas.
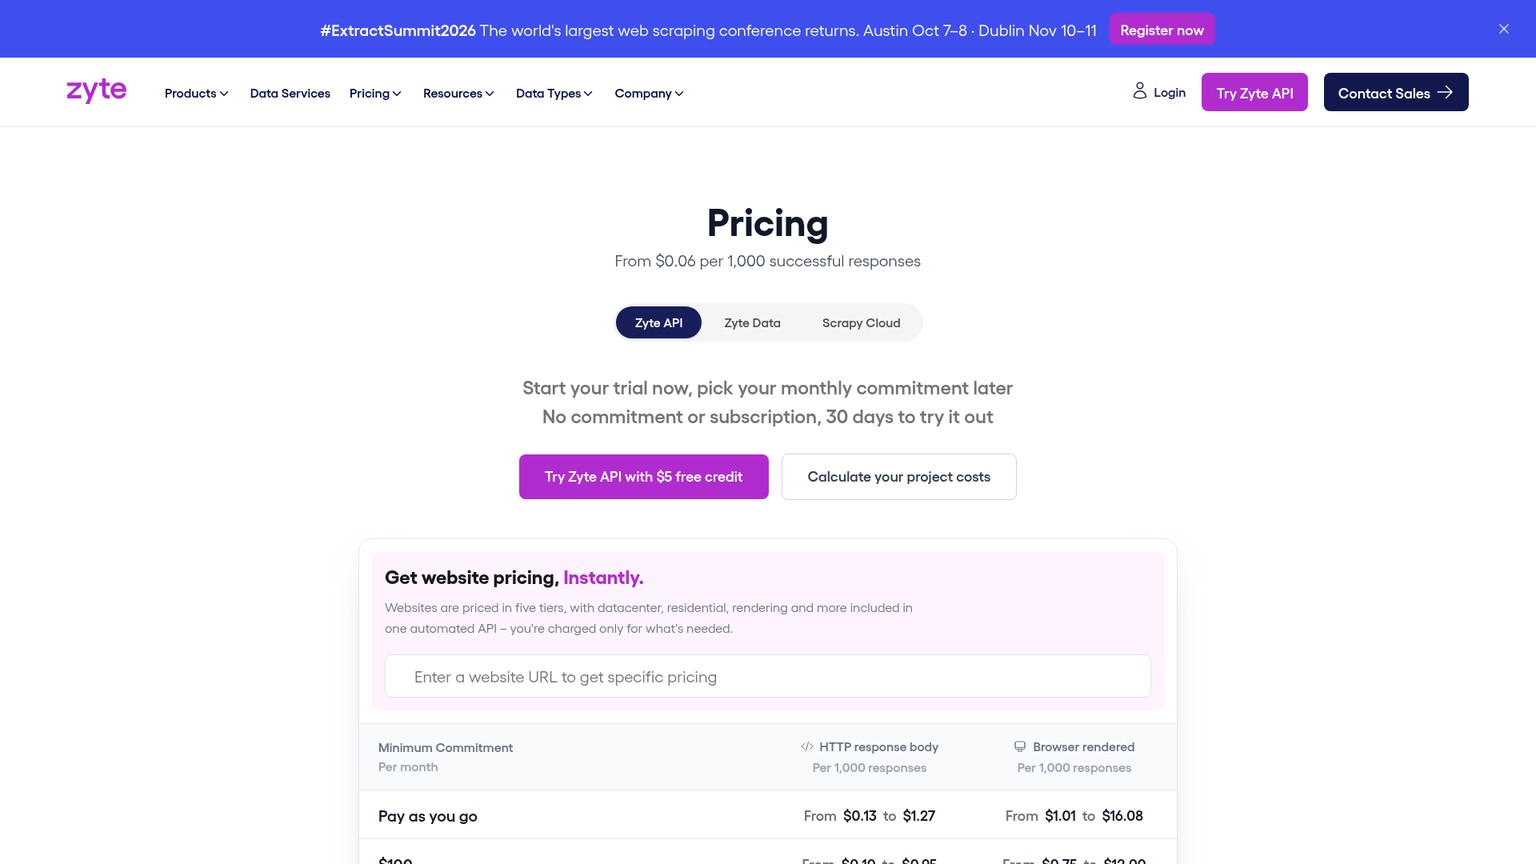
Os preços de HTTP no modelo pay-as-you-go, por 1,000 respostas, são $0.13, $0.23, $0.44, $0.70 e $1.27 para os níveis de site 1 a 5. Com renderização no navegador, são $1.01, $2.01, $4.02, $8.04 e $16.08. Em um compromisso mensal de $100, os valores com navegador caem para $0.75, $1.50, $3, $6 e $12; a $200, ficam em $0.60, $1.20, $2.40, $4.80 e $9.60; e a $500, em $0.48, $0.96, $1.92, $3.84 e $7.68.
As tabelas de compromisso para HTTP também importam. A $100, os níveis 1 a 5 custam $0.10, $0.17, $0.33, $0.53 e $0.95 por 1,000. A $200, custam $0.08, $0.14, $0.26, $0.42 e $0.76. A $500, custam $0.06, $0.11, $0.21, $0.34 e $0.61. O Enterprise oferece outros descontos negociados. A página atual de preços da Zyte também informa $5 em créditos de teste por 30 dias.
Os atributos personalizados podem usar o método fixo extract, a $0.001, ou o método generativo, a $0.002 por 1,000 tokens de entrada e $0.01 por 1,000 tokens de saída. A extração automática custa de $0.0004 a $0.0016 por tipo de dado. Assim, a planilha ganha uma linha de extração clara, em vez de esconder o uso de modelos dentro de um plano indiferenciado.
O limite relevante para esta comparação é a saída. A Zyte documenta corpos HTTP, HTML do navegador e campos estruturados, não um contrato nativo de resposta em Markdown. Portanto, uma conversão posterior de HTML para Markdown e seus testes de regressão continuam fazendo parte da migração.
Melhor para: Extração em múltiplos domínios quando dificuldade dos alvos, necessidade de navegador e infraestrutura de acesso determinam a maior parte da conta do fornecedor.
Destaque: Cinco níveis de preço por site e nenhuma cobrança por respostas malsucedidas ou limitadas por taxa.
Preço: PAYG sem compromisso; compromissos mensais de $100, $200 e $500; Enterprise com outros descontos. O preço da resposta depende do nível do site e do uso de saída HTTP ou de navegador.
Teste grátis: $5 em créditos por 30 dias, sem compromisso.
- O nível específico de cada alvo incorpora a infraestrutura de acesso em um único preço por resposta.
- A cobrança por resposta bem-sucedida elimina o custo direto de limites de taxa e falhas declaradas pelo fornecedor.
- Atributos personalizados com preço fixo ou por token tornam visíveis os custos de extração.
- Markdown nativo não é a saída documentada, portanto a conversão fica com sua equipe.
- O nível atribuído a um alvo pode mudar, e respostas bem-sucedidas ainda podem reprovar no gate local de conteúdo.
- Descoberta do site inteiro e definição posterior do estado do rastreamento exigem configuração deliberada.
A planilha usa renderização de navegador no tier 3 mais uma extração fixa personalizada. Isso resulta em $5.52, $55.22 e $374 de uso estimado do fornecedor nos três volumes. É um cenário, não um preço universal da Zyte; substitua o nível pelo valor cotado para os domínios que você rastreará.
7. Bright Data Crawl API: melhor para sites protegidos em escala
A Bright Data Crawl API é a opção mais forte quando acesso a sites protegidos, infraestrutura de proxies e simultaneidade dominam os requisitos. O preço inclui renderização de JavaScript, proxies residenciais, validação, resolução de CAPTCHA, segmentação geográfica, descoberta, parsing para JSON ou CSV e simultaneidade ilimitada.
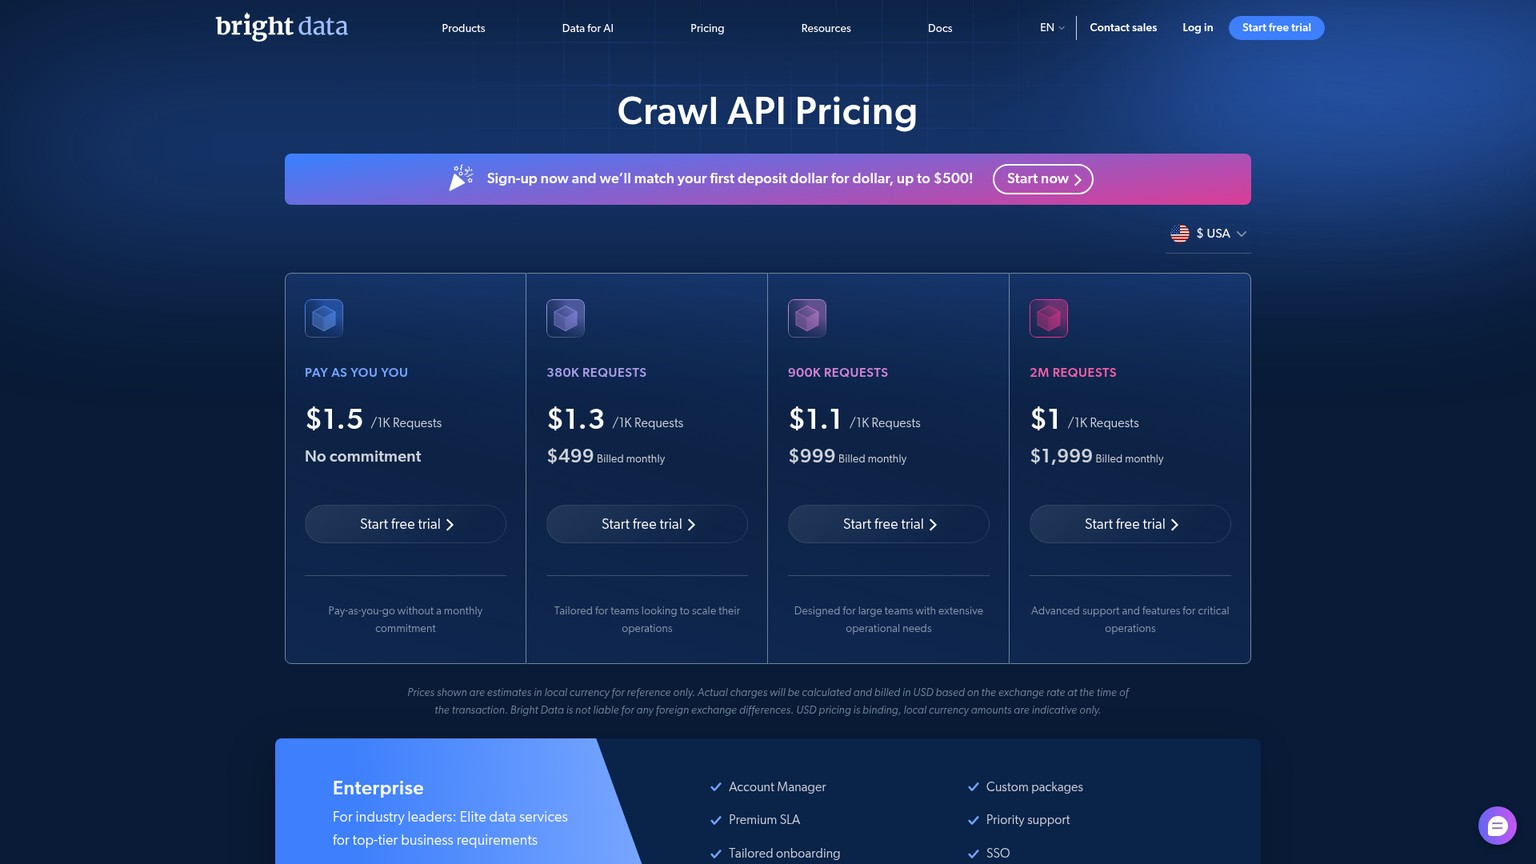
O produto começa em $1.50 por 1,000 requisições no pay-as-you-go, sem compromisso. O plano de 380,000 requisições custa $499 por mês, ou $1.30 por 1,000; 900,000 requisições custam $999, ou $1.10 por 1,000; e 2 milhões custam $1,999, ou $1 por 1,000. O Enterprise é personalizado. Estes são os preços atuais da Bright Data Crawl API.
A limitação importante é a mesma da Zyte: os formatos de entrega documentados são NDJSON e CSV, não Markdown nativo. Para um pipeline de recuperação que exige títulos, blocos de código, tabelas e links de origem estáveis em Markdown, o conversor é um componente de produção. Suas falhas e o tempo de operação entram no denominador.
Nos preços pay-as-you-go, uma reserva de 10% para novas tentativas cobradas leva o gasto com fornecedor a $1.65 para 1,000 páginas aprovadas, $16.50 para 10,000 e $165 para 100,000. Esses valores pequenos por requisição não devem ser lidos como custos totais. A planilha atribui quatro, cinco e oito horas para conversão em Markdown, normalização de schema e revisão, e um alvo difícil pode mudar o comportamento das requisições.
Melhor para: Coleta de alta simultaneidade em domínios protegidos, quando o acesso gerenciado vale mais do que o Markdown nativo.
Destaque: Renderização, roteamento residencial, tratamento de CAPTCHA, validação e simultaneidade ilimitada incluídos no preço da Crawl API.
Preço: PAYG a $1.50 por 1,000 requisições; $499 por 380,000; $999 por 900,000; $1,999 por 2 milhões; Enterprise personalizado.
Teste grátis: Os cartões de preços atuais oferecem teste grátis, mas não informam a quantidade de créditos nos termos visíveis do plano.
- A infraestrutura de acesso, que de outra forma exigiria vários componentes, vem incluída.
- A simultaneidade ilimitada atende jobs grandes com janelas de entrega rígidas.
- NDJSON e CSV permitem entrega legível por máquina sem extrair dados do painel do fornecedor.
- Markdown nativo não é o contrato de saída documentado.
- O custo PAYG por requisição, isoladamente, esconde conversão, schema e revisão das páginas aprovadas.
- A ampla estrutura de acesso é uma sobrecarga desnecessária para sites públicos de documentação que funcionam bem com HTTP bruto.
Alternativas open source ao Firecrawl que sua equipe pode operar
O Crawl4AI é a alternativa open source mais evidente desta seleção, mas o Firecrawl também publica um núcleo que pode ser hospedado pela própria equipe. A distinção importante não é se um repositório pode ser clonado. É saber se a implantação aberta reproduz descoberta, acesso por navegador, filas, persistência, observabilidade e o contrato de saída dos quais o pipeline da empresa depende.
Para o Crawl4AI, fixe a versão 0.9.4 ou posterior, exija autenticação, vincule corretamente as instâncias privadas de avaliação e salve a versão exata da imagem ou do pacote com cada conjunto de resultados. Prefira extração por CSS ou XPath em templates estáveis e isole qualquer fornecedor de extração por LLM como uma fronteira separada de custo e dados. As 8 a 20 horas mensais de operação do modelo não são um benchmark; são um lembrete para precificar correções, falhas de proxy, mudanças de schema e recuperação, em vez de tratar tudo isso como gratuito.
No núcleo do Firecrawl, encare a escolha entre Cloud e self-hosting como uma decisão de arquitetura própria. O repositório pode remover uma linha de créditos do fornecedor, mas acrescenta PostgreSQL, Redis, RabbitMQ, workers de navegador, monitoramento e upgrades à carga de trabalho da equipe. O artigo específico sobre hospedagem própria, indicado acima, traz um pacote de verificação para essa decisão.
Qual é a melhor IA para web scraping?
A melhor escolha depende da fronteira de entrada. Se a entrada for um domínio e a saída precisar ser um corpus completo em Markdown e JSON, comece por Firecrawl ou Apify e depois calcule o ScrapFly. Se a entrada já for uma lista confiável de URLs, o Jina Reader remove a estrutura de rastreamento e pode custar muito menos. Se o desafio for o acesso, compare o teto de custo do ScrapingBee com os níveis por site da Zyte e o pacote de acesso da Bright Data.
Agentes de IA para web scraping precisam de um gate de aprovação
Um agente nunca deve decidir que uma resposta 200 já está pronta para recuperação. Forneça um gate determinístico: campos obrigatórios, tamanho mínimo do Markdown, preservação de tabelas e código, links normalizados, hash do conteúdo, tipo de conteúdo permitido e regras explícitas de valores nulos. O agente pode encaminhar as falhas, mas não deve ignorar o contrato apenas para manter o job em andamento.
A decisão muda em quatro situações:
- Permaneça no Firecrawl quando ele passar pelo fixture e a economia em seis meses não pagar a migração e a operação em paralelo.
- Escolha o Apify quando um job gerenciado de rastreamento, um dataset persistente e o workflow flexível do Actor importarem mais do que um único valor de crédito por página.
- Escolha o Crawl4AI quando a equipe já operar containers, roteamento de acesso e cobertura de plantão, ou quando uma fronteira de dados tornar o processamento gerenciado inaceitável.
- Escolha uma API mais específica quando a descoberta já estiver resolvida ou o acesso a páginas protegidas dominar o job. Jina, ScrapingBee, Zyte e Bright Data só são as opções mais fortes quando essa fronteira está registrada.
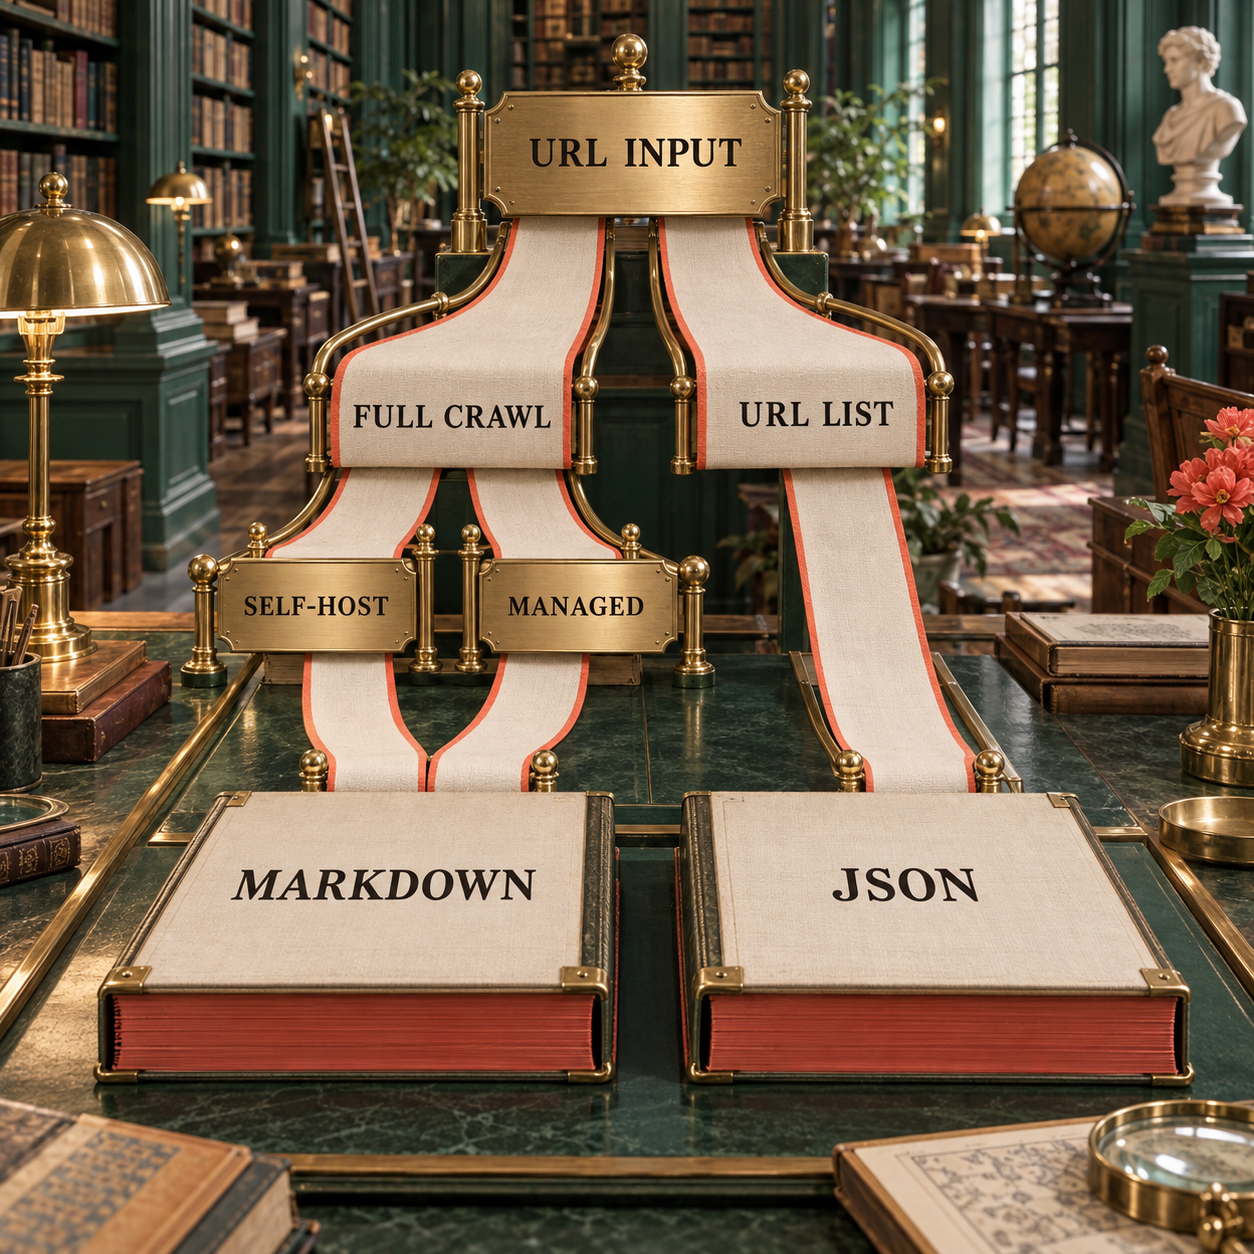
Não escolha pela saída mais bonita no playground. A configuração selecionada precisa passar pelo mesmo fixture, salvar as mesmas evidências e produzir os mesmos chunks nas etapas seguintes. Uma ferramenta que parece mais limpa em uma página de artigo ainda pode falhar na tabela, no PDF ou na rota em JavaScript que determina a aprovação em produção.
O que evitar como substituição direta
Não compre um produto de uma categoria vizinha fingindo que o pipeline está completo. Estas ferramentas podem ser úteis, mas não substituem o job completo do Firecrawl definido aqui:
- Exa e Tavily: mantenha as duas na avaliação de provedores de busca. Elas ficaram fora desta seleção porque a substituição analisada começa depois que um domínio ou conjunto de URLs já foi escolhido e precisa produzir corpos de página aprovados.
- Apenas Playwright e Puppeteer: automação de navegador é um componente básico, não um manifesto de rastreamento gerenciado, contrato de Markdown, histórico de novas tentativas ou sistema de entrega estruturada. Escolha essa opção somente se a intenção for construir essas camadas.
- Um serviço apenas de proxy: acessar uma resposta não limpa a navegação, preserva links, valida JSON nem mantém estáveis os limites dos chunks.
- Um fork de crawler sem manutenção: um repositório gratuito vira um incidente quando as versões dos navegadores, as correções de segurança ou o comportamento dos alvos mudam e ninguém é responsável pelo ciclo de releases.
Evite também usar um benchmark de marketing como prova de migração. Se a configuração exata não foi executada com o fixture salvo de 20 URLs, o número descreve o trabalho de outra pessoa. Este artigo, intencionalmente, não publica uma taxa sintética de aprovação nem uma tabela de classificação por latência.
Planilha de migração para uma equipe pequena
Uma migração segura mantém Firecrawl e a alternativa em paralelo até que as saídas normalizadas, o comportamento das novas tentativas e os chunks coincidam no fixture fixo e em uma amostra representativa da produção. A planilha precisa de um responsável, um schema versionado e um gatilho de rollback.
1. Fixe o contrato de entrada e descoberta
Registre se as URLs vêm do rastreamento de um domínio, de um sitemap, de uma API de busca, de uma fila ou de um banco de dados interno. Salve os domínios permitidos, a política de subdomínios, caminhos incluídos e excluídos, profundidade, limite de páginas, regras de canonicalização e duplicação. Um teste do Jina ou ScrapingBee não é comparável ao Firecrawl se outro componente não preencher essa linha inteira.
2. Congele o schema de saída
Versione os campos e tipos obrigatórios. Preserve, no mínimo, source_url, final_url, title, markdown, links, status_code, fetched_at e content_sha256. Indique quais campos de negócio podem ser nulos e quais reprovam a página. Preserve a resposta bruta para poder executar novamente uma mudança de parser sem pagar outro rastreamento.
3. Trate novas tentativas como eventos contábeis
Em cada tentativa, salve status do fornecedor, status HTTP, veredito de aprovação, motivo da nova tentativa, custo em crédito ou requisição e próxima ação. Separe erros de transporte, falhas declaradas pelo fornecedor, bloqueios de acesso, conteúdo vazio, falhas de schema e falhas posteriores de conversão. Limite as novas tentativas e envie os itens esgotados a uma dead-letter queue, em vez de criar um ciclo invisível de gastos.
4. Salve o pacote de evidências
Use um caminho formado por ferramenta, release, hash da configuração, data da execução e ID do fixture. Armazene requisição, headers, resposta sem alterações, JSON normalizado, Markdown, veredito e digest. Um revisor deve conseguir descobrir qual renderizador, modo de extração e schema gerou qualquer chunk aprovado.
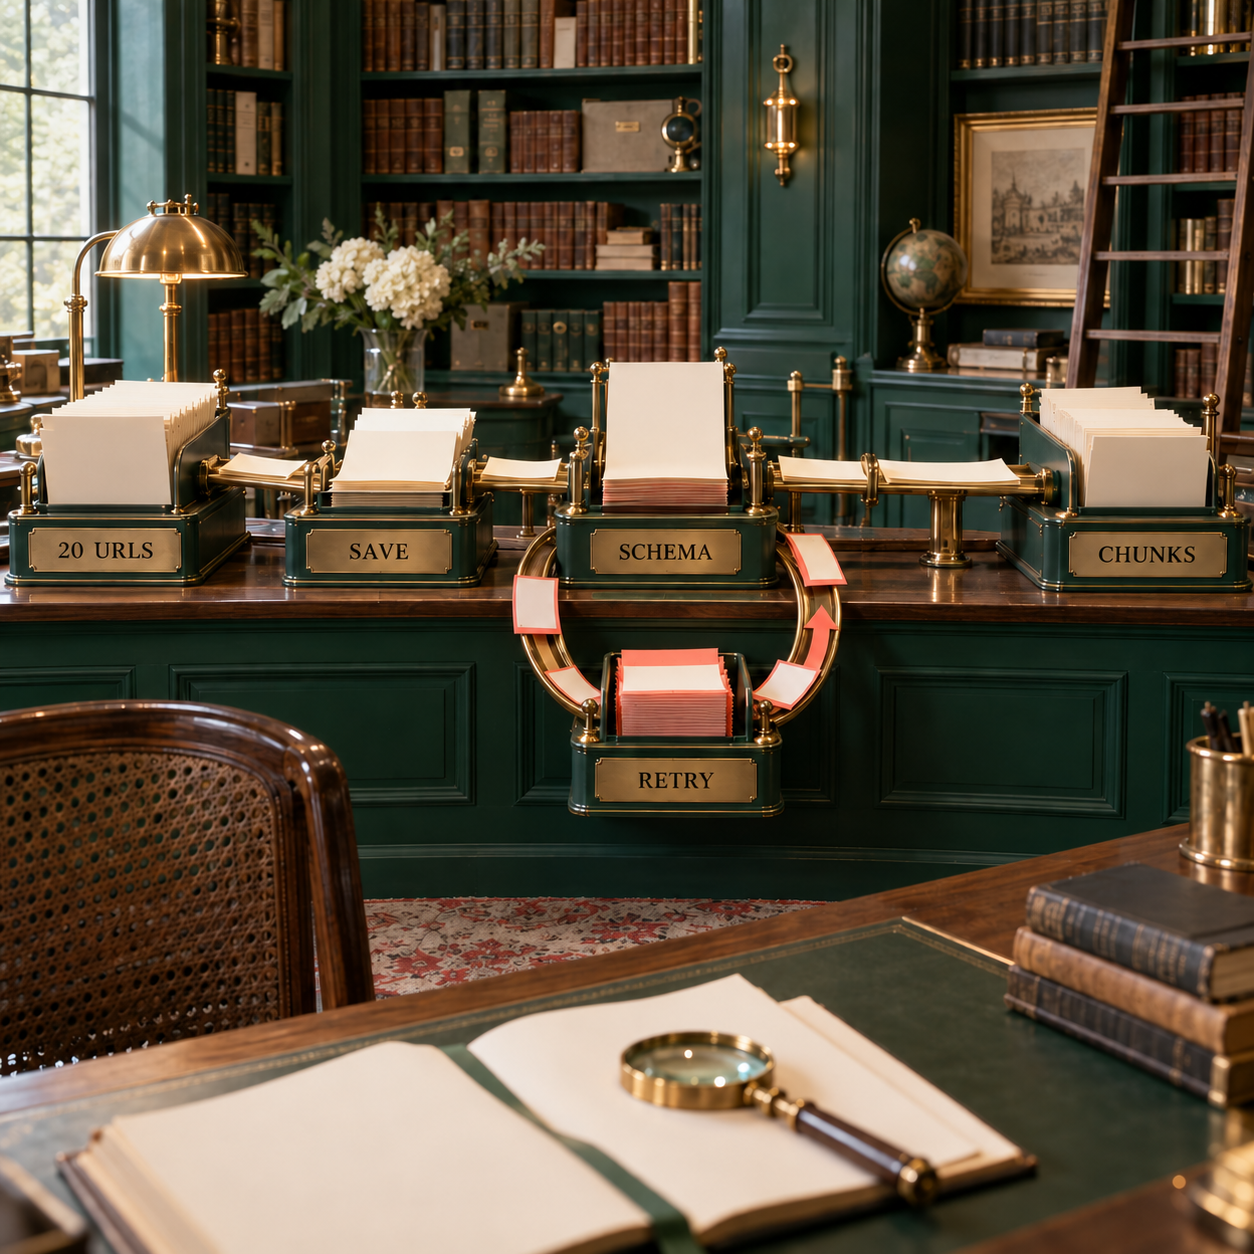
5. Faça a regressão da divisão em chunks
Compare a hierarquia de títulos, os blocos de código, as tabelas, os destinos dos links, a ordem do documento e os hashes de conteúdo antes de gerar novos embeddings. Depois, compare a quantidade e os limites dos chunks, além das citações das fontes. Uma string Markdown mais limpa ainda pode mudar o comportamento da recuperação se os títulos sumirem ou se as linhas das tabelas forem separadas entre chunks.
6. Calcule o corpus aprovado e defina o rollback
Some dinheiro pago ao fornecedor, custo de hospedagem, tokens de extração, novas tentativas pagas, armazenamento e horas de operação. Divida pelas páginas aprovadas, não pelas requisições. Defina um gatilho de rollback antes do lançamento, como a falha de um campo obrigatório, um nível de alvo inesperado, um aumento relevante na quantidade de chunks ou um teto de horas de operação. Mantenha o caminho anterior disponível até o novo passar por essa janela.
Para uma equipe pequena, o primeiro artefato útil não é uma nota do fornecedor. É uma planilha com uma linha para cada URL do fixture e colunas para os dois sistemas. Depois que a linha contém evidências salvas, a aprovação ou reprovação pode ser revisada, em vez de depender de preferência.
Perguntas frequentes
Fazer web scraping é ilegal?
Não existe uma resposta universal de “sim” ou “não”. Nos Estados Unidos, a política do Department of Justice sobre a CFAA diferencia barreiras técnicas de acesso de uma simples restrição contratual, mas contrato, direitos autorais, privacidade, uso dos dados, controles de acesso e jurisdição ainda podem mudar a análise. Isto não é aconselhamento jurídico; uma coleta em produção exige orientação profissional sobre os alvos e o uso específicos.
O Firecrawl é caro?
Depende da saída aprovada. O rastreamento custa 1 crédito por página e o JSON acrescenta 4; portanto, 10,000 páginas aprovadas com uma reserva de 10% para novas tentativas exigem 55,000 créditos neste modelo e cabem no Standard a $83. O trabalho operacional e o custo da migração podem pesar mais do que essa fatura.
Qual é a melhor ferramenta de web scraping?
O Apify Website Content Crawler é a substituição gerenciada mais abrangente desta seleção. O Crawl4AI é mais forte quando self-hosting é obrigatório, o ScrapFly se destaca ao combinar rastreamento gerenciado e extração, e o Jina Reader só vence quando já existe uma lista confiável de URLs.
É possível hospedar o Firecrawl por conta própria?
Sim. O núcleo self-hosted dá controle à equipe, mas ela também assume bancos de dados, filas, workers de navegador, upgrades, segurança, roteamento de acesso e monitoramento. Não é o mesmo produto operacional que o Firecrawl Cloud.
Quais são algumas alternativas ao Firecrawl?
Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API e Bright Data Crawl API são as sete alternativas comparadas aqui. Elas se dividem entre crawlers completos, readers que recebem URLs e APIs voltadas primeiro ao acesso.
Self-hosting é legal?
Executar software em uma infraestrutura sob seu controle costuma ser uma questão separada daquilo que o software acessa. Autorização, controles de acesso, termos do site, direitos autorais, privacidade, regras de proteção de dados e finalidade de uso ainda precisam de avaliações próprias.
Vale a pena fazer self-hosting?
Vale quando uma fronteira de dados obrigatória, a personalização ou um recurso compartilhado da plataforma compensam o trabalho operacional. Em geral, não vale criar uma nova demanda de plantão apenas para eliminar uma conta mensal modesta de API.
Quais são os riscos da hospedagem gratuita?
Instâncias gratuitas podem entrar em suspensão, limitar CPU ou memória, trocar o armazenamento, compartilhar uma reputação de IP fraca e não oferecer garantia de recuperação em produção. Essas limitações podem fazer um crawler parecer pouco confiável mesmo quando o software não é a causa.
Posso hospedar um site por conta própria e de graça?
Um site como hobby ou uma avaliação de crawler pode caber em uma franquia gratuita. Um rastreamento em produção ainda envolve computação, armazenamento, largura de banda, infraestrutura de acesso, monitoramento, backups e tempo de operação; portanto, uma linha de hospedagem a $0 não significa custo operacional de $0.
O Firecrawl é open source?
O Firecrawl publica um núcleo open source que pode ser hospedado pela própria equipe. O Firecrawl Cloud acrescenta infraestrutura gerenciada e serviços operacionais, por isso o repositório sozinho não reproduz os limites de custo ou confiabilidade do produto Cloud.
- Última atualização
- 25 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Alternativas ao CodeRabbit: qual escolher para sua equipe?
Compare alternativas ao CodeRabbit por preço, suporte a provedores Git, privacidade e cobrança, de serviços gerenciados a opções self-hosted.25 de set. de 2026Build
Greptile vs CodeRabbit: qual review de código com IA vale mais?
Greptile vs CodeRabbit: compare preços, créditos, limites, plataformas e profundidade da revisão de código com IA antes de escolher para sua equipe.25 de set. de 2026Build
Como usar Perplexity Portable Computer no Windows com AMD
Veja como usar Perplexity Portable Computer em um PC Windows com AMD, validar os requisitos, limitar o acesso a pastas e automatizar tarefas locais.25 de set. de 2026Build
AgentRun na prática: vale a pena para orquestração de agentes de IA?
O AgentRun organiza workflows de agentes de IA com estado tipado, chamadas limitadas e escalonamento explícito. Veja testes, custos e quando adotar.24 de set. de 2026Build
Perplexity Search API: Fast Search ou busca web?
Compare Fast Search e a busca web padrão da Perplexity em preço, latência e cobertura para escolher o melhor modo da API em cada consulta do seu agente.24 de set. de 2026Build
Agentes de IA: quando o fallback pago vira o caminho padrão
Um fallback pago drenou o saldo compartilhado e deixou artigos sem capa nem embeddings. Entenda como corrigir o handoff sem expor credenciais.24 de set. de 2026Build
Cursor preço: o Rollouts é grátis? Planos, créditos e custos
Cursor Rollouts exige Teams ou Enterprise. Entenda os créditos de lançamento por 10 dias, cerca de 50 ou 500 alterações, e os custos a conferir.24 de set. de 2026Build