Web scraping IA : 7 alternatives à Firecrawl comparées
Comparez 7 alternatives à Firecrawl pour vos pipelines IA : crawl, sorties Markdown et JSON, effort de migration et coût par page réellement exploitable.




Les alternatives à Firecrawl se départagent autour de 10,000 pages acceptées : dans ce modèle de web scraping IA, Firecrawl représente $83 de frais fournisseur et trois heures d’exploitation, tandis que ScrapFly revient à $30 et trois heures. La facture la plus basse ne désigne pas forcément le remplacement le moins cher : la découverte des pages, les nouvelles tentatives avec rendu, l’extraction JSON et le découpage en aval peuvent effacer l’écart.
Web scraping IA : remplacer Firecrawl, c’est remplacer un pipeline
Choisissez Apify Website Content Crawler pour obtenir l’alternative managée la plus proche et la plus complète, Crawl4AI si la maîtrise de l’infrastructure est prioritaire, ScrapFly pour réunir crawl et extraction structurée dans un même pool de crédits, et Jina Reader lorsqu’un autre système fournit déjà les URL. ScrapingBee, Zyte API et Bright Data Crawl API deviennent plus pertinents quand l’accès à des pages difficiles compte davantage qu’un workflow natif allant du site au Markdown.
La bonne unité de mesure n’est ni la requête ni l’URL découverte, mais la page acceptée qui parvient jusqu’au pipeline de génération augmentée par récupération. Autrement dit, le modèle reçoit une source exploitable dont le Markdown, les champs JSON, les liens et les métadonnées exigés sont tous restés intacts. Une réponse peu coûteuse qui perd un tableau, renvoie un champ de prix vide ou casse le découpage reste un échec payé.
Firecrawl : le point de comparaison
Firecrawl sert de référence parce que son endpoint Crawl regroupe déjà découverte, rendu et traitement des pages, puis renvoie du Markdown ou du JSON conforme à un schéma. La facturation est de 1 crédit par page explorée, auxquels s’ajoutent 4 crédits en mode JSON : la base pertinente pour ce comparatif est donc de 5 crédits par tentative de page.
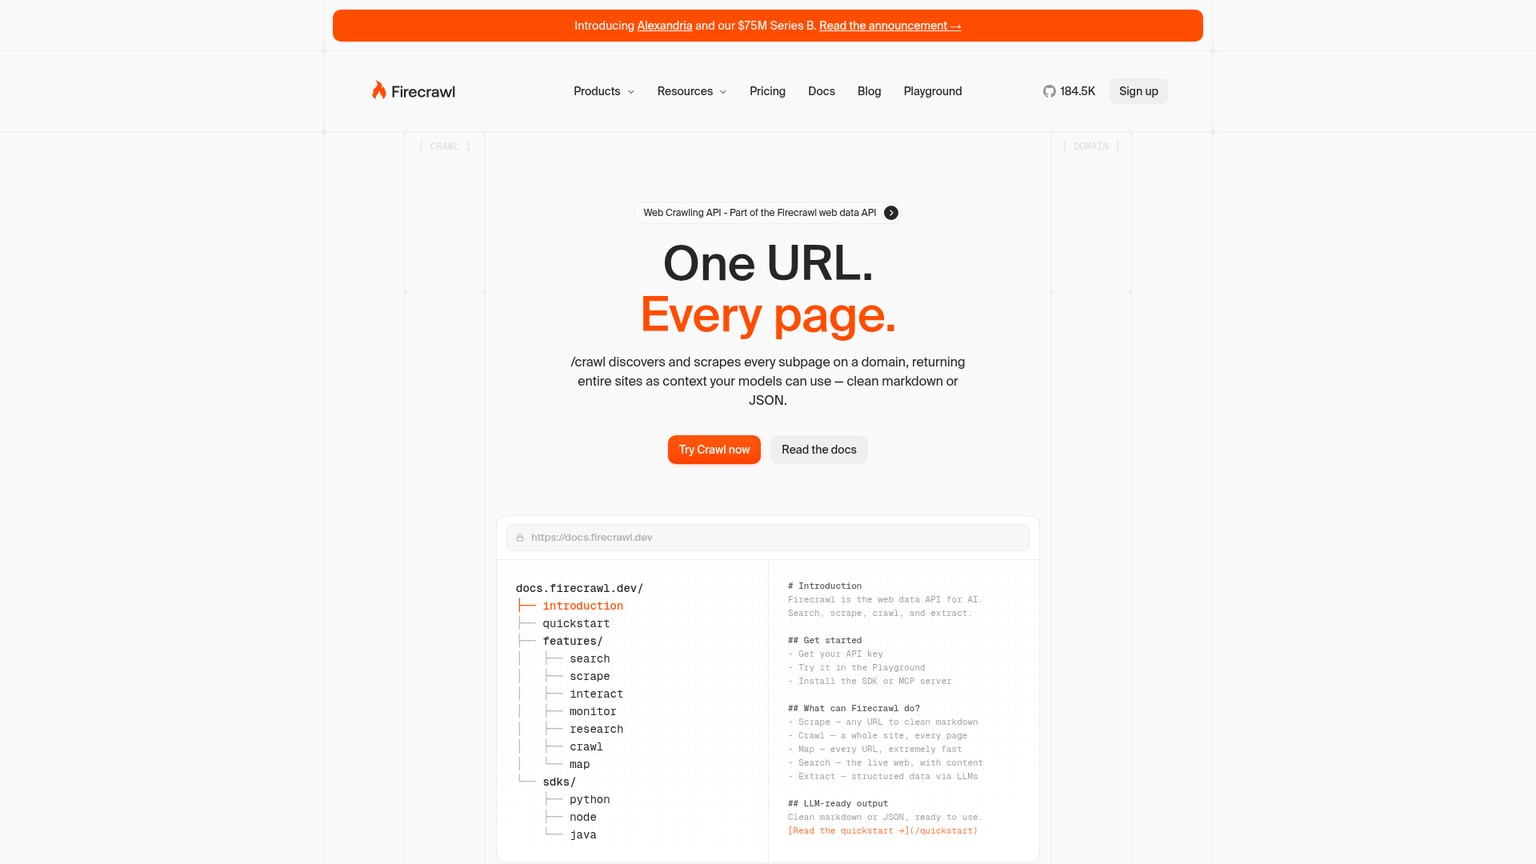
C’est précisément ce regroupement qui peut rendre le statu quo plus avantageux qu’une solution apparemment moins chère. Firecrawl gère aussi le périmètre du crawl, les sous-domaines, les chemins, la profondeur et la livraison progressive des pages. Une API de lecture peut coûter moins cher par URL tout en laissant la découverte à votre équipe ; une API d’accès peut récupérer des pages protégées tout en reportant la conversion Markdown et la normalisation du schéma sur l’aval.
Le prix de Firecrawl calculé par page acceptée
Les offres actuelles de Firecrawl sont Free à $0 pour 1,000 crédits, Hobby à $16 par mois avec facturation annuelle pour 5,000 crédits, Standard à $83 pour 100,000 crédits, Growth à $333 pour 500,000 crédits, Scale à $599 pour 1,000,000 crédits, puis Enterprise sur devis. Les dépassements coûtent $9 par bloc de 1,500 crédits avec Hobby, $47 par 35,000 avec Standard, $177 par 175,000 avec Growth et $397 par 350,000 avec Scale. Ces tarifs, limites et fonctions de crawl ont été vérifiés sur la page Crawl actuelle de Firecrawl le 25 septembre 2026.
Avec une réserve de 10% pour les réponses réussies qui échouent au contrôle d’acceptation local, 1,000 pages Markdown et JSON acceptées demandent 5,500 crédits. Hobby complété par un bloc de dépassement revient à $25. Dix mille pages acceptées exigent 55,000 crédits : Standard coûte alors $83. Cent mille pages acceptées nécessitent 550,000 crédits : Growth plus un bloc de dépassement atteint $510.
La recherche constitue une couche distincte. Si la tâche commence par une requête et demande des sources classées plutôt qu’un site connu ou un ensemble d’URL, utilisez le comparatif des API de recherche IA pour trancher, puis transmettez les URL retenues à la couche d’extraction.
Alternatives à Firecrawl : le comparatif express
Le tableau évalue l’adéquation documentée, pas la qualité mesurée des résultats. Les prix ont été vérifiés sur les pages officielles le 25 septembre 2026. La mention « essai gratuit » englobe aussi une allocation gratuite permanente lorsque c’est la formule proposée par le fournisseur.
Il n’existe pas de vainqueur universel, car l’expression « extraction web » recouvre trois produits différents. Un crawler découvre un site, un outil de lecture convertit une URL déjà fournie et une couche d’accès franchit les obstacles de rendu ou de blocage. Achetez le produit le plus ciblé qui prend en charge toutes les étapes que votre équipe ne veut pas opérer.
Comment les solutions ont été retenues
Une solution n’a intégré la sélection que si sa documentation officielle actuelle décrit un chemin crédible vers un contenu de page exploitable et une sortie lisible par machine. Les API limitées à la recherche ont été écartées : une découverte classée ne remplace pas un crawler. Même logique pour les services de proxy seuls : une adresse IP ne produit ni Markdown propre, ni JSON conforme aux champs requis, ni manifeste de crawl enregistré.
Le comparatif repose sur cinq contrôles d’acceptation :
- Découverte : l’outil peut-il parcourir un site, respecter un périmètre et conserver un manifeste d’URL canoniques, ou faut-il lui fournir chaque URL depuis un autre composant ?
- Rendu et accès : sait-il exécuter JavaScript et gérer les conditions d’accès du site sans déclencher une facture de nouvelles tentatives incontrôlable ?
- Contrat de sortie : préserve-t-il les titres, tableaux, blocs de code et liens en Markdown, et peut-il renseigner les champs JSON obligatoires sans seconde transformation opaque ?
- Preuves : l’équipe peut-elle enregistrer, pour chaque URL de test, la requête, la réponse brute, la sortie normalisée, les en-têtes, la configuration, le hash du contenu et le verdict ?
- Coût complet : combien faut-il payer pour la découverte, le rendu, l’extraction, les nouvelles tentatives réussies mais rejetées, les engagements minimaux et le temps d’exploitation ?
Aucune solution n’a été testée dans le cadre de cet article. Aucun taux de réussite ni classement de latence n’est donc revendiqué. Chaque appréciation de qualité ci-dessous décrit une capacité documentée ; chaque comparaison en dollars repose sur un modèle dont les hypothèses sont explicites.
Le jeu fixe de 20 URL pour l’acceptation
Ne fondez pas une migration sur l’URL de démonstration d’un fournisseur. Exécutez le même jeu fixe sur l’ancienne et la nouvelle configuration, puis conservez toutes les réponses. Ce jeu mêle volontairement des formats de contenu qui révèlent des défaillances différentes :
- Code et documents longs : API Fetch de MDN, classes Python, ownership en Rust, RFC 9110 en HTML et HTML de HTTPBin.
- Tableaux, liens et pages structurées : référence MDN sur les tableaux, tutoriel W3C sur les tableaux, page Wikipédia sur le web scraping, catalogue Books to Scrape et une fiche produit fixe.
- Pagination et JavaScript : Quotes to Scrape, son parcours JavaScript, son parcours avec défilement, le guide JavaScript de MDN et la normalisation des liens de HTTPBin.
- Encodage et PDF : Unicode sur HTTPBin, RFC 9110 en PDF, un article de recherche en PDF sur deux colonnes, un PDF W3C minimal et le formulaire W-9 de l’IRS.
Chaque résultat doit contenir source_url, final_url, title, markdown, links, status_code, fetched_at et content_sha256. Pour les pages produit, entity_name, amount et currency sont également obligatoires ; pour le PDF de recherche, il faut published_at. Un champ ne peut être explicitement null que si le manifeste du jeu de tests l’autorise. Un champ manquant n’est pas un champ null.
Conservez un répertoire par outil, version et configuration. Pour chaque URL, gardez request.json, les en-têtes de réponse, le corps non modifié, normalized.json, verdict.json et l’empreinte SHA-256. Le verdict doit indiquer la première règle en échec, et pas seulement pass: false. Grâce à ces preuves, un autre ingénieur pourra reproduire la décision même après une évolution du fournisseur, du parseur ou de la page.
La feuille de calcul du coût par page acceptée
Le modèle retient 1,000, 10,000 et 100,000 pages acceptées par mois, avec une réserve de 10% pour les réponses que le fournisseur juge réussies mais que le contrôle local de schéma ou de Markdown rejette. Ces nouvelles tentatives sont facturables. Les échecs explicites du fournisseur suivent sa politique de remboursement publiée.
La formule de base est simple : trésorerie versée au fournisseur ou à l’hébergeur, plus les frais de découverte, de rendu, d’extraction et de nouvelles tentatives payantes, auxquels s’ajoutent les heures d’exploitation multipliées par le coût horaire chargé de l’équipe. Le tableau sépare les dépenses fournisseur des heures afin de remplacer l’hypothèse de $100 de l’heure sans refaire toutes les formules.
À $100 par heure d’exploitation, les totaux pour 10,000 pages s’établissent à $383 pour Firecrawl, $419 pour Apify, $1,248 pour Crawl4AI, $330 pour ScrapFly, $401.10 pour Jina, $449 pour ScrapingBee, $555.22 pour Zyte et $516.50 pour Bright Data. Le montant de Jina ne vaut que si un manifeste d’URL fiable existe déjà : ce n’est pas le coût d’un crawl complet de site. Les heures attribuées à Bright Data et Zyte couvrent le travail de Markdown et de schéma en aval, car aucune des deux pages produit ne documente une sortie Markdown native correspondant au contrat utilisé ici.
La ligne consacrée à l’extraction est volontairement détaillée. Firecrawl consomme 1 crédit de crawl et 4 crédits JSON. Dans ce scénario, ScrapingBee utilise 5 crédits JavaScript plus 5 crédits IA. ScrapFly utilise 5 crédits de navigateur ou d’Unblocker plus 5 crédits de modèle d’extraction. Zyte combine la tarification navigateur de niveau 3 avec une extraction unique d’attributs personnalisés. Apify emploie une enveloppe JSON déterministe, 80% de pages en HTTP brut et 20% en mode headless au plafond estimé publié ; les résumés IA facultatifs ne sont pas inclus.
Pour Jina, l’hypothèse est de 2,000 tokens de sortie par tentative à $0.050 le million. La valeur de consommation est minime, mais les décaissements arrivent par paliers : lorsque les 10 millions de tokens gratuits sont épuisés, la plus petite recharge indiquée porte sur 1 milliard de tokens à $50. Pour Crawl4AI, le modèle retient des serveurs DigitalOcean à $24, $48 et $96 selon le volume ; ce sont des hypothèses de planification, pas des mesures de capacité.
1. Apify Website Content Crawler : la meilleure alternative managée globale
Apify Website Content Crawler est l’alternative managée généraliste la plus solide pour une équipe qui veut réunir découverte, rendu JavaScript, Markdown et dataset durable dans un seul service. Il explore les pages en HTTP brut ou avec Firefox headless, enregistre chaque résultat dans un dataset et exporte en JSON ou CSV. La forme de la migration reste ainsi proche de Firecrawl, sans laisser croire que les API sont identiques.
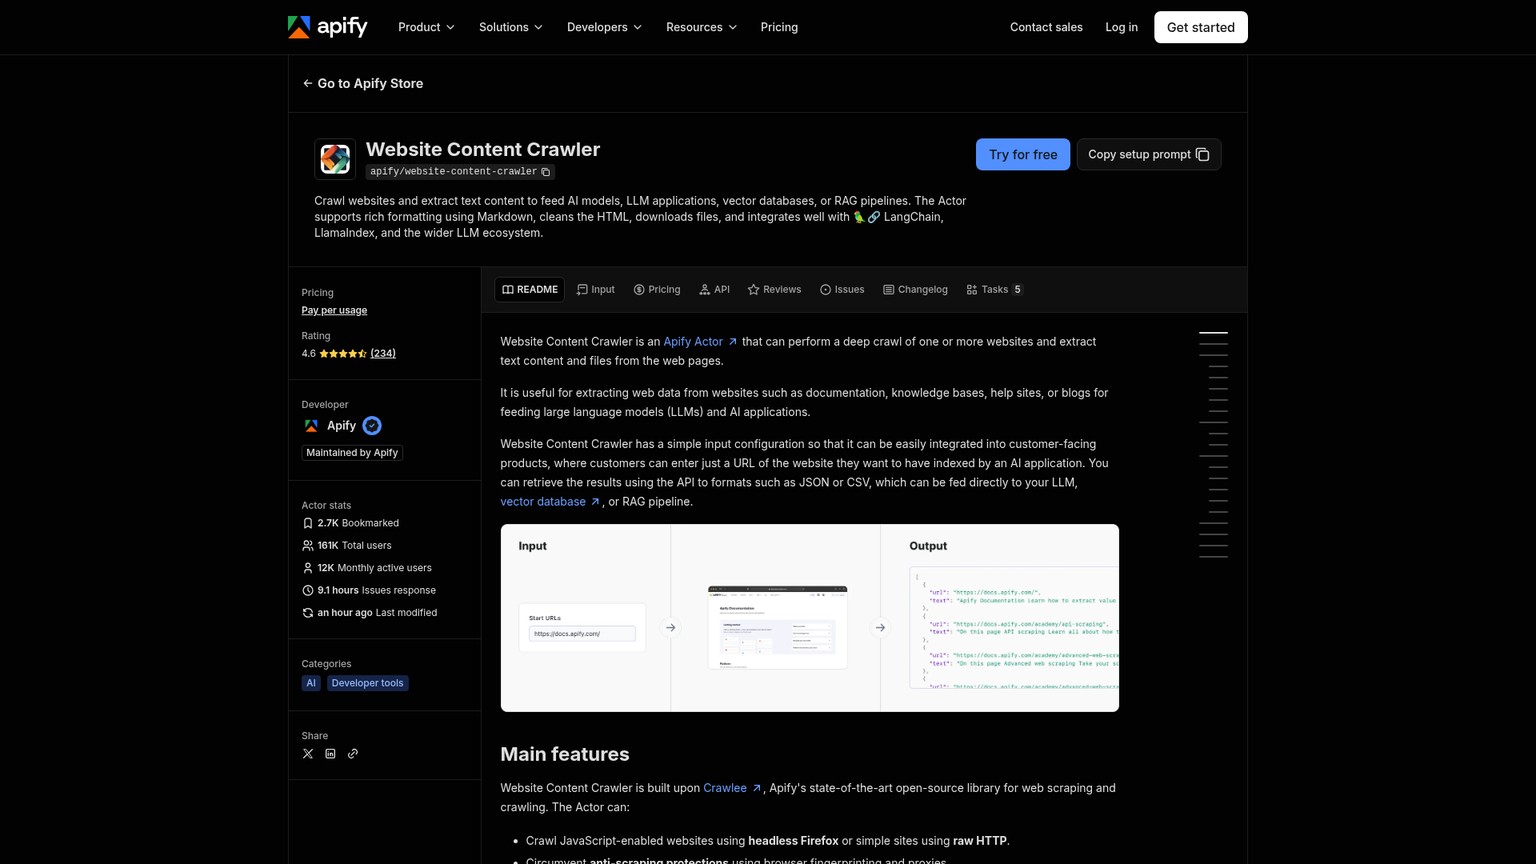
Son avantage le plus net tient au pilotage du crawl comme une tâche complète. Périmètre, sortie et enregistrements persistants du dataset restent réunis, et les fichiers comme les PDF peuvent être téléchargés. Sa limite clairement identifiée concerne l’extraction sémantique : le dataset JSON de l’Actor est une enveloppe structurée avec texte, Markdown et métadonnées, mais un schéma métier personnalisé demande encore des règles déterministes, un autre Actor ou une étape de modèle.
L’estimation publiée pour l’Actor est d’environ $0.20 par 1,000 pages en HTTP brut et de $0.50 à $5 par 1,000 pages traitées en headless dans son scénario de référence. Les résumés IA facultatifs ajoutent environ $2 à $3 par 1,000 pages, et jusqu’à près de $7 par 1,000 pour les pages dépourvues de titres. Le modèle ci-dessus exclut cette option, car un résumé ne remplace pas les champs JSON obligatoires.
Les offres Apify sont Free à $0 avec $5 d’utilisation mensuelle et 5 exécutions simultanées ; Starter à $19 avec $19 d’utilisation et 32 exécutions simultanées ; Scale à $199 avec $199 d’utilisation, des unités de calcul à $0.16 et 128 exécutions simultanées ; Business à $999 avec $999 d’utilisation, des unités de calcul à $0.13 et 256 exécutions simultanées ; puis Enterprise sur mesure. L’utilisation s’arrête quand le quota Free est épuisé. Les offres payantes basculent en dépassement, et l’allocation inutilisée n’est pas reportée. La page tarifaire actuelle d’Apify fait foi pour ces conditions de plateforme.
Idéal pour : une petite équipe produit ou data qui remplace un crawl managé, notamment si l’historique d’exécution et les exports de dataset comptent.
Point fort : découverte d’un site complet, rendu navigateur, Markdown et enregistrements persistants du dataset JSON réunis dans une même exécution managée.
Prix : Free $0 ; Starter $19 ; Scale $199 ; Business $999 ; Enterprise sur mesure. Le coût réel de l’Actor inclut aussi le calcul, le stockage, les proxies et le transfert consommés pendant l’exécution.
Essai gratuit : l’offre Free permanente comprend $5 d’utilisation mensuelle de la plateforme, sans carte bancaire.
- HTTP brut et Firefox headless couvrent à la fois les pages statiques peu coûteuses et les pages JavaScript.
- Les enregistrements de dataset facilitent l’examen et l’export des réponses conservées.
- Périmètre du crawl, téléchargement de fichiers, métadonnées et Markdown sont réunis dans une tâche managée.
- La facture de la plateforme additionne calcul, stockage, transfert et proxies au lieu d’un crédit unique par page.
- Un enregistrement JSON de dataset ne correspond pas automatiquement au schéma métier attendu par le code en aval.
- Les résumés IA ajoutent un coût d’Actor distinct sans démontrer pour autant que l’extraction passe le contrôle d’acceptation.
Tester une migration vers Apify en cinq étapes
Charger le manifeste d’URL fixe
Commencez par les 20 URL du jeu de tests, pas par l’ensemble du domaine de production. Figez l’entrée de l’Actor, le type de crawler, la limite de pages et le périmètre afin qu’une deuxième exécution mesure la même chose.
Rester en HTTP brut tant qu’une page ne justifie pas le navigateur
Gardez le chemin économique pour les pages statiques et envoyez les cas JavaScript vers le rendu headless. Enregistrez le mode de crawler choisi avec chaque résultat.
Exporter le Markdown et l’enregistrement du dataset
Conservez sans modification
markdown, l’URL canonique, les métadonnées et les liens. Transformez ensuite cet enregistrement vers le schéma JSON local requis au cours d’une étape déterministe séparée.Rejeter avant le découpage
Appliquez les contrôles de tableaux, code, liens et champs requis à l’enregistrement normalisé. Dès qu’une règle échoue, envoyez l’URL dans le registre des nouvelles tentatives plutôt que dans l’index vectoriel.
Ne chiffrer que les pages acceptées
Divisez la facture complète de l’Actor, des proxies, du stockage et de l’exploitation par le nombre de pages acceptées. Comparez ce résultat à la référence Firecrawl avant d’élargir le crawl.
2. Crawl4AI : la meilleure alternative auto-hébergée
Crawl4AI est le meilleur choix en auto-hébergement lorsque la maîtrise de l’infrastructure, les frontières de données ou des règles d’extraction réutilisables sont incontournables. Il produit du Markdown et prend en charge l’extraction structurée avec CSS, XPath ou une stratégie LLM. Il peut donc fournir à la fois le texte destiné à la récupération et les champs JSON, sans coût logiciel par requête.
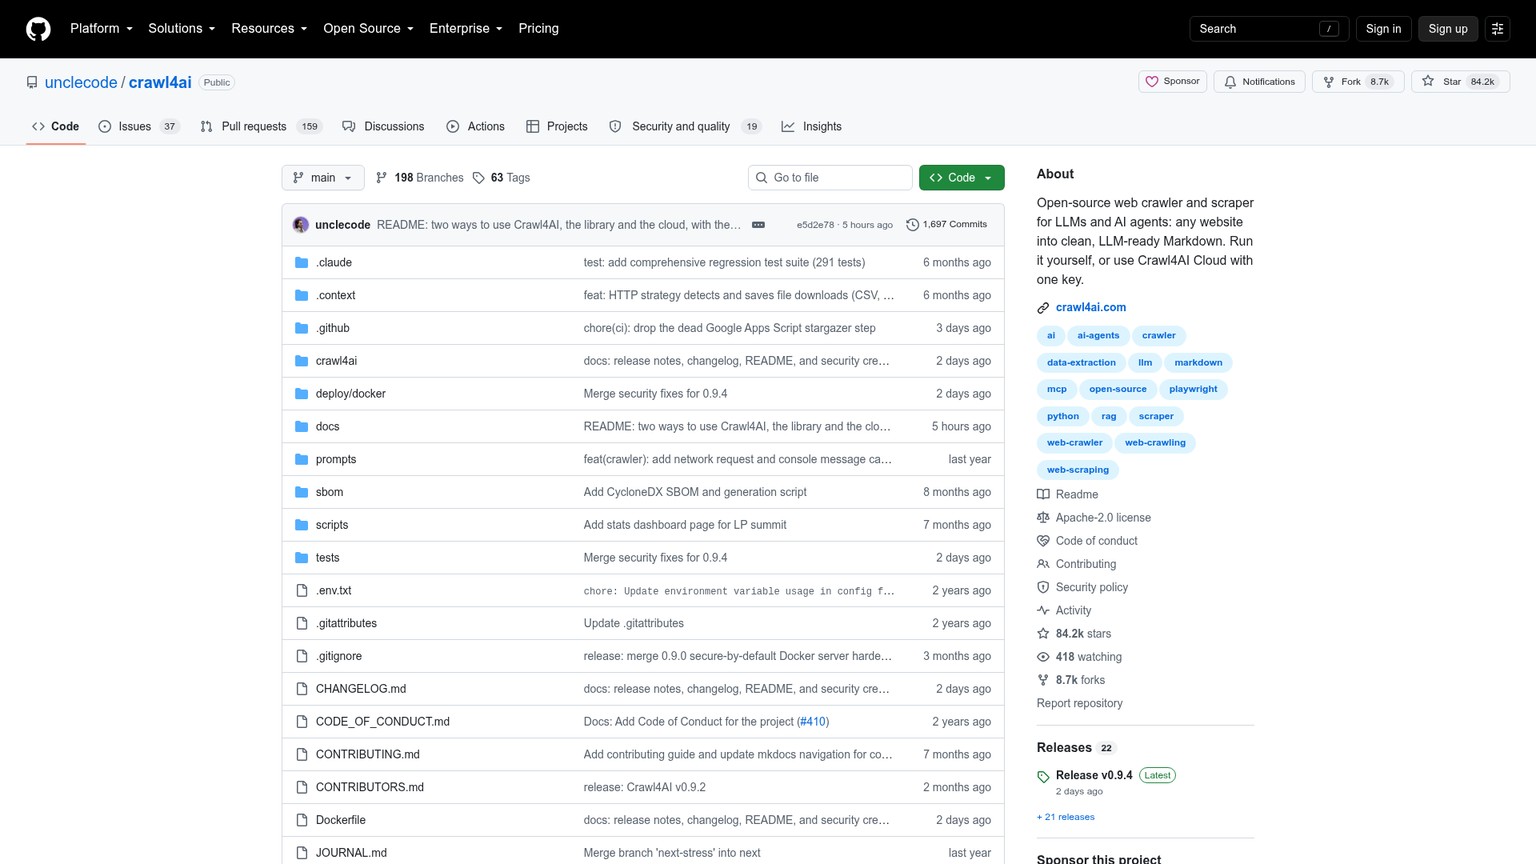
Le niveau de sécurité minimal actuel compte davantage que le prix de la licence. La version 0.9.4, publiée le 23 septembre 2026, corrige trois avis de sécurité, dont deux chemins de falsification de requête côté serveur et un défaut de frontière de confiance dans la configuration susceptible d’exposer des valeurs d’environnement. Toute évaluation doit épingler la v0.9.4 ou une version ultérieure, puis examiner les avis de sécurité du projet avant d’exposer son API.
Crawl4AI face à Firecrawl
Firecrawl vend le service opéré autour du crawl : files d’attente, navigateurs, crédits, livraison et support sont gérés. Crawl4AI fournit le crawler et le système d’extraction, tandis que votre équipe assume le déploiement, les mises à niveau, l’observabilité, la stratégie de proxies et la gestion des incidents. Le choix bascule lorsque ces responsabilités sont déjà mutualisées sur une plateforme interne, et non lorsqu’un seul ingénieur doit les créer pour ce projet.
Une configuration auto-hébergée demande au moins 4 GB de RAM, Docker 20.10 ou une version ultérieure et Compose 2.24 ou une version ultérieure. La feuille de coûts retient les tarifs actuels des Basic Droplets de DigitalOcean : $24 pour 4 GiB, $48 pour 8 GiB et $96 pour 16 GiB. Ces tailles servent uniquement d’hypothèses de scénario ; aucun débit de pages n’a été mesuré pendant cette analyse.
Idéal pour : les équipes disposant déjà d’une plateforme de conteneurs, d’une frontière de données stricte et d’ingénieurs capables d’opérer le crawler.
Point fort : le contrôle open source, associé à des schémas d’extraction déterministes en CSS ou XPath qui peuvent éviter une dépense de modèle par page.
Prix : licence logicielle à $0. Le modèle utilise des hébergements mensuels à $24, $48 et $96, auxquels peuvent s’ajouter proxies, stockage, supervision, appels de modèles et travail humain.
Essai gratuit : le logiciel est open source ; l’infrastructure n’est pas fournie.
- Le Markdown et l’extraction structurée s’exécutent dans l’infrastructure contrôlée par l’équipe.
- Sur les sites stables, les schémas CSS et XPath permettent une extraction économique et déterministe.
- Le serveur auto-hébergé privilégie désormais par défaut une configuration authentifiée et limitée à l’interface de bouclage.
- Réputation des proxies, capacité des navigateurs, correctifs, files d’attente et reprise deviennent la responsabilité de l’équipe.
- La taille de l’hébergement ne démontre pas le débit de pages acceptées sans exécution enregistrée.
- L’extraction LLM déplace le coût des tokens et l’examen de la frontière de données vers un fournisseur distinct ou un modèle local.
Le guide d’auto-hébergement de Firecrawl traite séparément le choix entre le dépôt Firecrawl et Firecrawl Cloud. Ne comptabilisez pas la licence à $0 de Crawl4AI comme une économie tant que la même feuille n’intègre pas les personnes chargées de ses correctifs et de sa disponibilité.
3. ScrapFly : le meilleur compromis crawl-extraction pour une petite équipe
ScrapFly est l’alternative la plus convaincante pour une petite équipe qui veut couvrir accès, crawl, conversion Markdown et extraction typée avec un seul compte. Ses produits puisent dans le même pool de crédits, et la couche d’extraction accepte HTML, Markdown, XML, JSON, CSV, RSS ou texte brut. Il est possible d’utiliser des templates déterministes, des modèles préentraînés ou un prompt fondé sur un schéma JSON, sans assembler plusieurs fournisseurs.
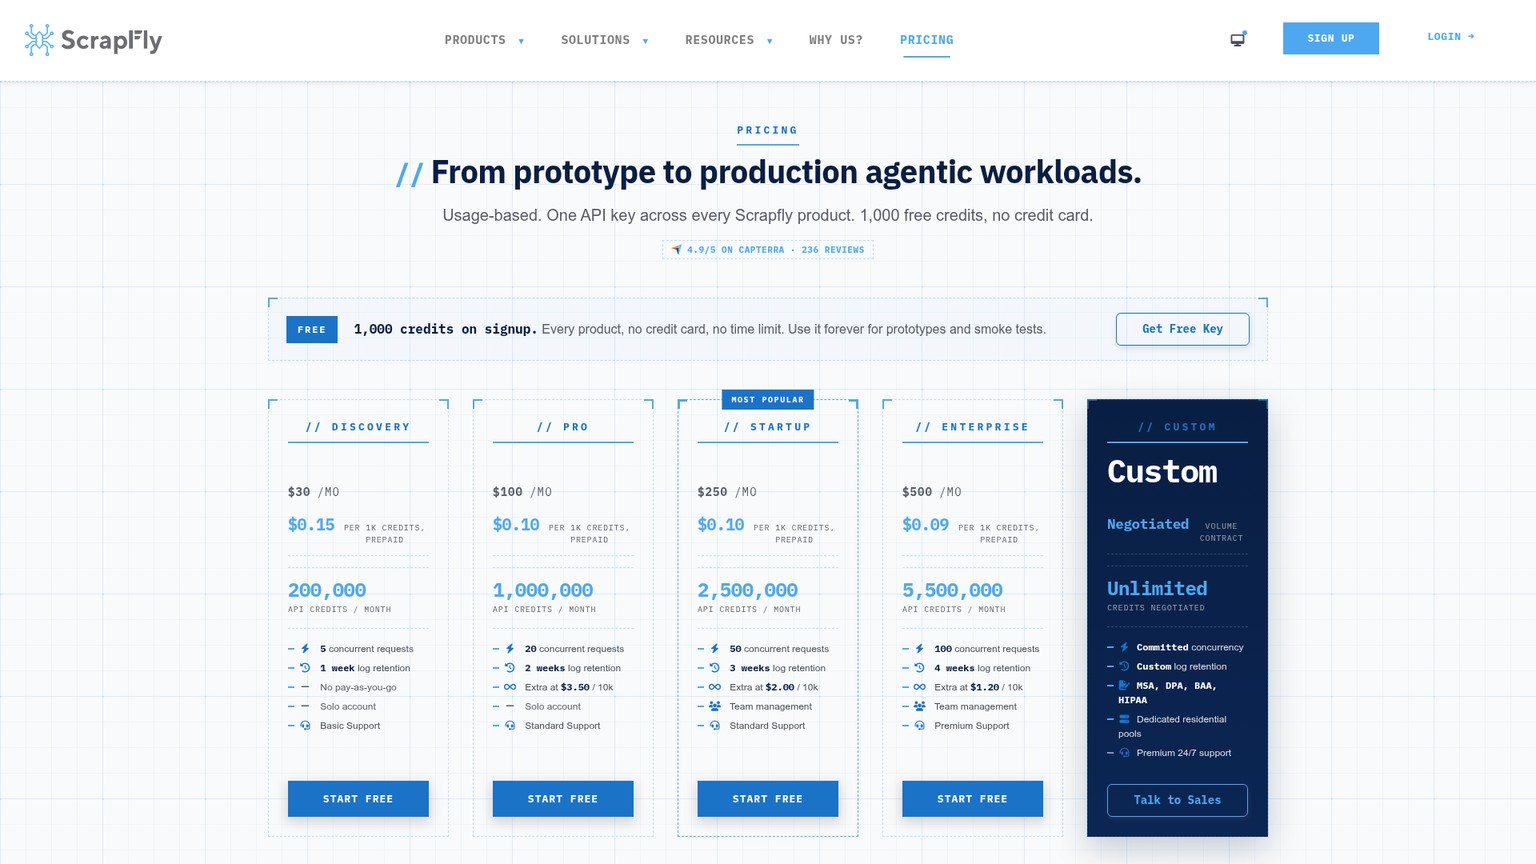
Le modèle de crédits devient lisible dès que la configuration est figée. Une requête HTTP simple depuis un datacenter vaut 1 crédit, le rendu JavaScript ou Unblocker en vaut 5, le routage résidentiel 25 et une capture pleine page 60. L’extraction par template ajoute 1 crédit, contre 5 pour un prompt ou un modèle d’extraction. Au-delà de 500 KB, la charge de base de l’extraction se répète pour chaque tranche supplémentaire de 500 KB.
Le scénario de l’article revient donc à 10 crédits par tentative réussie : 5 pour le navigateur ou Unblocker, plus 5 pour l’extraction. Avec la réserve de 10% pour les nouvelles tentatives, on obtient 11 crédits par page acceptée. Le routage résidentiel n’est pas inclus ; dès qu’une cible l’exige, le résultat change nettement.
Les offres actuelles sont Free avec 1,000 crédits uniques ; Discovery à $30 par mois avec 200,000 crédits et 5 requêtes simultanées ; Pro à $100 avec 1,000,000 crédits et 20 requêtes simultanées ; Startup à $250 avec 2,500,000 crédits et 50 requêtes simultanées ; Enterprise à $500 avec 5,500,000 crédits et 100 requêtes simultanées ; puis Custom négociée. Discovery s’arrête à son quota. Le dépassement de Pro coûte $3.50 par 10,000 crédits, celui de Startup $2 et celui d’Enterprise $1.20. Les crédits inutilisés ne sont pas reportés. Ces conditions proviennent de la page tarifaire actuelle de ScrapFly.
Idéal pour : une petite équipe qui recherche un crawler managé, des contrôles d’accès et une extraction typée sur une seule facture.
Point fort : un même pool de crédits finance le crawler, le navigateur, Unblocker et trois stratégies d’extraction.
Prix : Free 1,000 crédits ; Discovery $30 ; Pro $100 ; Startup $250 ; Enterprise $500 ; Custom négociée.
Essai gratuit : 1,000 crédits à l’inscription, sans carte bancaire ni date d’expiration indiquée.
- L’extraction par template réduit le coût des modèles sur les mises en page stables.
- Les approches préentraînées et guidées par prompt renvoient du JSON typé sans fournisseur de modèle séparé.
- Les requêtes en échec ne coûtent aucun crédit, tandis que la réponse indique les crédits consommés.
- Navigateur, routage résidentiel et options d’extraction se cumulent rapidement sur les pages difficiles.
- Les documents de plus de 500 KB multiplient le coût d’extraction.
- Discovery ne permet aucun dépassement ; une tâche de production exige donc Pro ou un arrêt strict avant épuisement du quota.
Dans cette configuration précise, ScrapFly arrive en tête de la feuille de calcul pour 10,000 pages acceptées : $30 et trois heures d’exploitation, contre $83 et trois heures avec Firecrawl. Un écart mensuel de $53 ne suffit pas à justifier une migration mal cadrée. Il devient convaincant seulement si le jeu fixe passe, si les cibles de production évitent le routage résidentiel à 25 crédits et si le schéma ne demande aucun nettoyage supplémentaire.
4. Jina Reader : le meilleur choix avec une liste d’URL existante
Jina Reader est le convertisseur au coût variable le plus faible lorsque la découverte est déjà réglée et que chaque URL fournie doit devenir du Markdown propre ou du JSON conforme à un schéma. Son moteur par défaut exécute JavaScript dans un navigateur headless, tandis que le moteur direct emprunte la voie HTTP plus simple. ReaderLM-v2 accepte un schéma JSON ou une instruction en langage naturel pour produire une sortie structurée.
Son avantage définit aussi sa limite : Reader traite une URL. Il ne remplace ni les règles de périmètre d’un site complet, ni sa file d’exploration, ni sa politique de déduplication, ni son manifeste. Si un sitemap, une couche de recherche ou un catalogue interne fournit une liste fiable, cette spécialisation devient un atout. Dans le cas contraire, le coût de découverte doit réintégrer la feuille de calcul.
L’usage de base de Reader est gratuit. Une nouvelle clé comprend 10 millions de tokens, puis les tokens de sortie sont facturés dès qu’une clé est utilisée. Une recharge de 1 milliard de tokens coûte $50, soit $0.050 par million ; une recharge de 11 milliards coûte $500, soit $0.045 par million. Les requêtes en échec ne consomment aucun token. Les limites sont de 20 requêtes par minute sans clé, 500 avec une clé gratuite ou payante et 5,000 avec une clé premium. Tous ces chiffres viennent de la page actuelle de Jina Reader.
La feuille de calcul suppose 2,000 tokens de sortie par tentative réussie. Après la réserve pour les nouvelles tentatives, la valeur consommée atteint $0.11 pour 1,000 pages acceptées, $1.10 pour 10,000 et $11 pour 100,000. Il s’agit de valeurs d’usage économique, pas du montant prélevé au paiement. Une fois le quota gratuit épuisé, l’achat minimal indiqué reste de $50.
Idéal pour : un pipeline doté d’un manifeste d’URL fiable qui cherche une conversion économique des pages en Markdown ou JSON.
Point fort : facturation aux tokens de sortie, rendu JavaScript et extraction selon un schéma JSON dans une API de lecture ciblée.
Prix : l’usage de base de Reader est gratuit ; chaque nouvelle clé reçoit 10 millions de tokens ; les packs payants coûtent $50 pour 1 milliard ou $500 pour 11 milliards.
Essai gratuit : 10 millions de tokens avec une nouvelle clé API.
- Le moteur par défaut exécute le JavaScript côté client avant la conversion.
- Les modes par schéma JSON et par instruction peuvent extraire des champs structurés depuis le même service de lecture.
- Les requêtes en échec ne consomment pas de tokens.
- La découverte du site, le périmètre et la persistance de l’état de crawl nécessitent un autre composant.
- Un pack de tokens à $50 constitue le décaissement minimal après le quota gratuit, même si la consommation du moment vaut beaucoup moins.
- Le coût des tokens de sortie dépend de la longueur de la page et du format de réponse.
Jina affiche le coût apparent le plus bas à 100,000 pages, avec $11 et six heures, mais uniquement sous l’hypothèse d’un manifeste fourni. Ajouter une découverte peu fiable et une déduplication manuelle rendrait cette ligne incomparable avec Firecrawl ou Apify. Retenez Jina lorsque cette séparation entre composants existe réellement, pas pour masquer le travail de crawl manquant.
5. ScrapingBee : la meilleure API de scraping avec plafond de crédits
ScrapingBee est la meilleure alternative à l’échelle de la requête pour une équipe qui veut plafonner le coût maximal d’une page. L’API peut renvoyer le contenu en Markdown ou dans une réponse JSON, appliquer des règles d’extraction CSS et recourir à l’extraction IA lorsque les mises en page ne sont pas assez stables pour des sélecteurs.
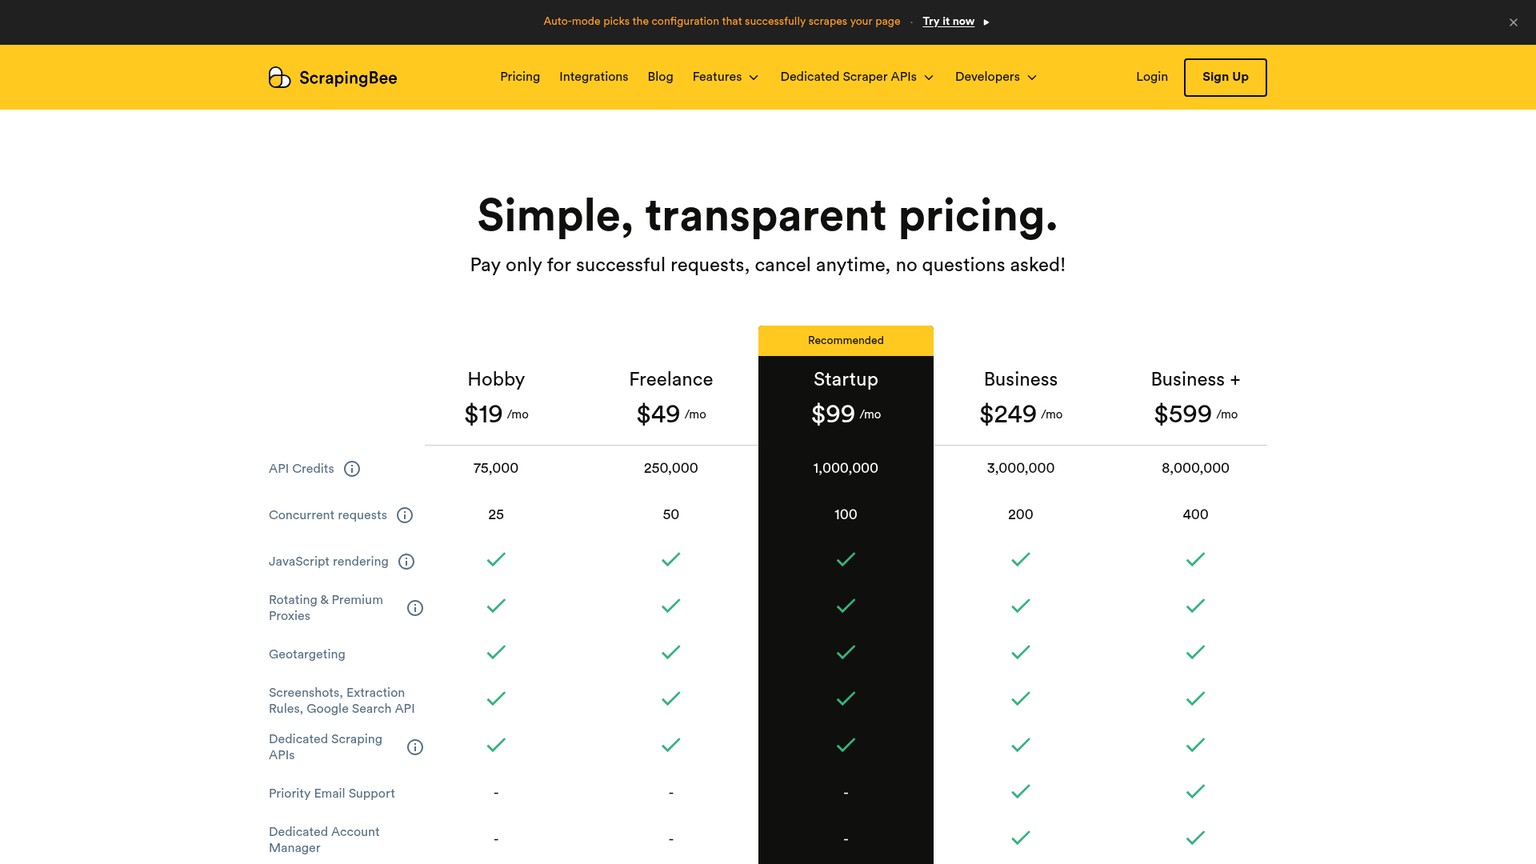
Le véritable levier de contrôle est l’échelle de crédits. Le HTTP Classic coûte 1 crédit, le JavaScript Classic 5, le mode premium sans JavaScript 10, le mode premium avec JavaScript 25 et le mode stealth avec JavaScript 75. Les fonctions IA ajoutent 5 crédits. Le mode Auto facture la configuration qui réussit, ne facture rien si toutes échouent et permet de fixer un plafond de coût.
La limite concerne l’orchestration. ScrapingBee récupère les pages demandées ; ce n’est pas l’équivalent le plus proche de la découverte de site et de la file d’exploration de Firecrawl. Une équipe doit gérer le manifeste d’URL, le périmètre, les doublons et l’état des tâches, puis distinguer l’échec fournisseur d’une réponse réussie rejetée par son contrôle d’acceptation local.
Les offres actuelles sont Hobby à $19 par mois pour 75,000 crédits et 25 requêtes simultanées ; Freelance à $49 pour 250,000 et 50 ; Startup à $99 pour 1,000,000 et 100 ; Business à $249 pour 3,000,000 et 200 ; Business+ à $599 pour 8,000,000 et 400. L’allocation d’évaluation est de 1,000 crédits sans carte bancaire. Ces chiffres proviennent des offres actuelles de ScrapingBee.
Idéal pour : les équipes qui gèrent déjà la découverte et veulent choisir explicitement le rendu, le proxy premium et le plafond de coût de chaque requête.
Point fort : le mode Auto peut intensifier les moyens d’accès tout en limitant, via max_cost, ce qu’une réponse est autorisée à consommer.
Prix : Hobby $19 ; Freelance $49 ; Startup $99 ; Business $249 ; Business+ $599.
Essai gratuit : 1,000 crédits sans carte bancaire.
- Markdown, extraction CSS et extraction IA sont disponibles dans une seule API de requêtes.
- L’échelle à 1, 5, 10, 25 et 75 crédits rend le coût d’accès vérifiable.
- Le mode Auto ne facture rien lorsque toutes ses configurations internes échouent.
- La découverte du site et la persistance du crawl restent hors du périmètre du produit.
- Une réponse réussie côté fournisseur mais rejetée par votre schéma reste une tentative payante.
- La consommation peut être multipliée par 15 entre JavaScript Classic et JavaScript stealth, avant même d’ajouter l’extraction IA.
Dans le modèle, JavaScript plus extraction IA consomme 10 crédits par tentative. La réserve porte ce chiffre à 11 par page acceptée : 1,000 pages tiennent dans Hobby à $19, 10,000 dans Freelance à $49 et 100,000 dans Business à $249, car 1.1 million de crédits dépasse le quota de 1 million de Startup.
6. Zyte API : la meilleure tarification anti-bot par site
Zyte API convient particulièrement lorsque la difficulté d’accès varie fortement selon la cible et que l’acheteur veut laisser le fournisseur affecter un niveau tarifaire à chaque site. Le prix de la réponse englobe le parcours nécessaire en datacenter ou via une adresse résidentielle, le rendu et le travail d’accès ; seules les réponses réussies sont facturées.
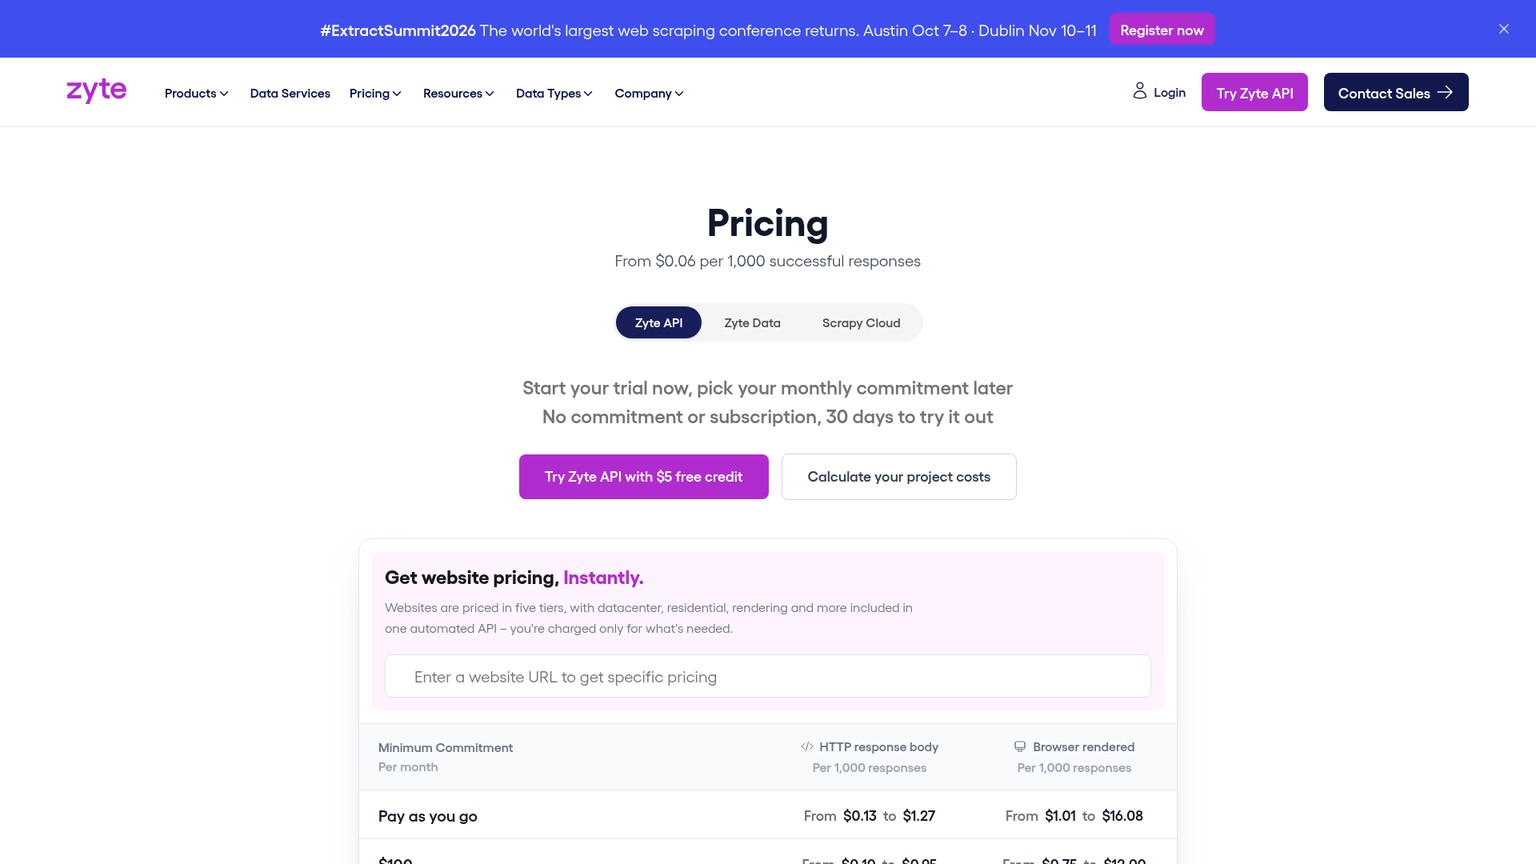
En paiement à l’usage, les tarifs HTTP par 1,000 réponses sont de $0.13, $0.23, $0.44, $0.70 et $1.27 pour les niveaux de site 1 à 5. Les réponses rendues par navigateur coûtent $1.01, $2.01, $4.02, $8.04 et $16.08. Avec un engagement mensuel de $100, ces tarifs navigateur descendent à $0.75, $1.50, $3, $6 et $12 ; à $200, ils passent à $0.60, $1.20, $2.40, $4.80 et $9.60 ; à $500, à $0.48, $0.96, $1.92, $3.84 et $7.68.
Les grilles d’engagement HTTP comptent également. À $100, les niveaux 1 à 5 coûtent $0.10, $0.17, $0.33, $0.53 et $0.95 par 1,000. À $200, ils reviennent à $0.08, $0.14, $0.26, $0.42 et $0.76. À $500, ils coûtent $0.06, $0.11, $0.21, $0.34 et $0.61. Enterprise ajoute des remises négociées. La page tarifaire actuelle de Zyte annonce aussi $5 de crédit d’essai pendant 30 jours.
Les attributs personnalisés peuvent utiliser une méthode fixe extract à $0.001, ou une méthode générative à $0.002 par 1,000 tokens d’entrée et $0.01 par 1,000 tokens de sortie. L’extraction automatique coûte de $0.0004 à $0.0016 par type de donnée. La dépense d’extraction peut ainsi apparaître clairement dans la feuille de calcul, au lieu d’enfouir l’usage du modèle dans une offre indifférenciée.
Pour ce comparatif, la limite se situe dans la sortie. Zyte documente les corps HTTP, le HTML rendu par navigateur et les champs structurés, mais pas de contrat de réponse Markdown natif. Une conversion HTML vers Markdown en aval et ses tests de régression restent donc indispensables à la migration.
Idéal pour : l’extraction sur plusieurs domaines lorsque la difficulté des cibles, le besoin de navigateur et l’infrastructure d’accès constituent l’essentiel de la facture fournisseur.
Point fort : cinq niveaux de requêtes par site et aucune facturation pour les réponses en échec ou limitées par le débit.
Prix : PAYG sans engagement ; engagements mensuels de $100, $200 et $500 ; Enterprise avec remises supplémentaires. Le prix de la réponse dépend du niveau du site et du choix entre sortie HTTP ou navigateur.
Essai gratuit : $5 de crédit pendant 30 jours, sans engagement.
- Le niveau propre à la cible intègre l’infrastructure d’accès dans un prix unique par réponse.
- La facturation des seules réponses réussies élimine le coût direct des limitations de débit et des échecs déclarés par le fournisseur.
- Les attributs personnalisés, fixes ou tarifés aux tokens, rendent les frais d’extraction visibles.
- Le Markdown natif n’est pas la sortie documentée : la conversion reste à votre charge.
- Le niveau d’une cible peut changer, et une réponse réussie peut tout de même échouer au contrôle local du contenu.
- La découverte d’un site complet et la conception de l’état de crawl en aval demandent une configuration délibérée.
La feuille de calcul associe un rendu navigateur de niveau 3 à une extraction fixe d’attributs personnalisés. Les usages fournisseur modélisés s’élèvent ainsi à $5.52, $55.22 et $374 pour les trois volumes. Il s’agit d’un scénario, pas d’un prix Zyte universel : remplacez le niveau par le devis correspondant aux domaines réellement explorés.
7. Bright Data Crawl API : le meilleur choix à grande échelle sur les sites protégés
Bright Data Crawl API est le candidat le plus solide lorsque l’accès aux sites protégés, l’infrastructure de proxies et le parallélisme dominent le cahier des charges. Le prix inclut le rendu JavaScript, les proxies résidentiels, la validation, la résolution des CAPTCHA, le géociblage, la découverte, l’analyse JSON ou CSV et un parallélisme illimité.
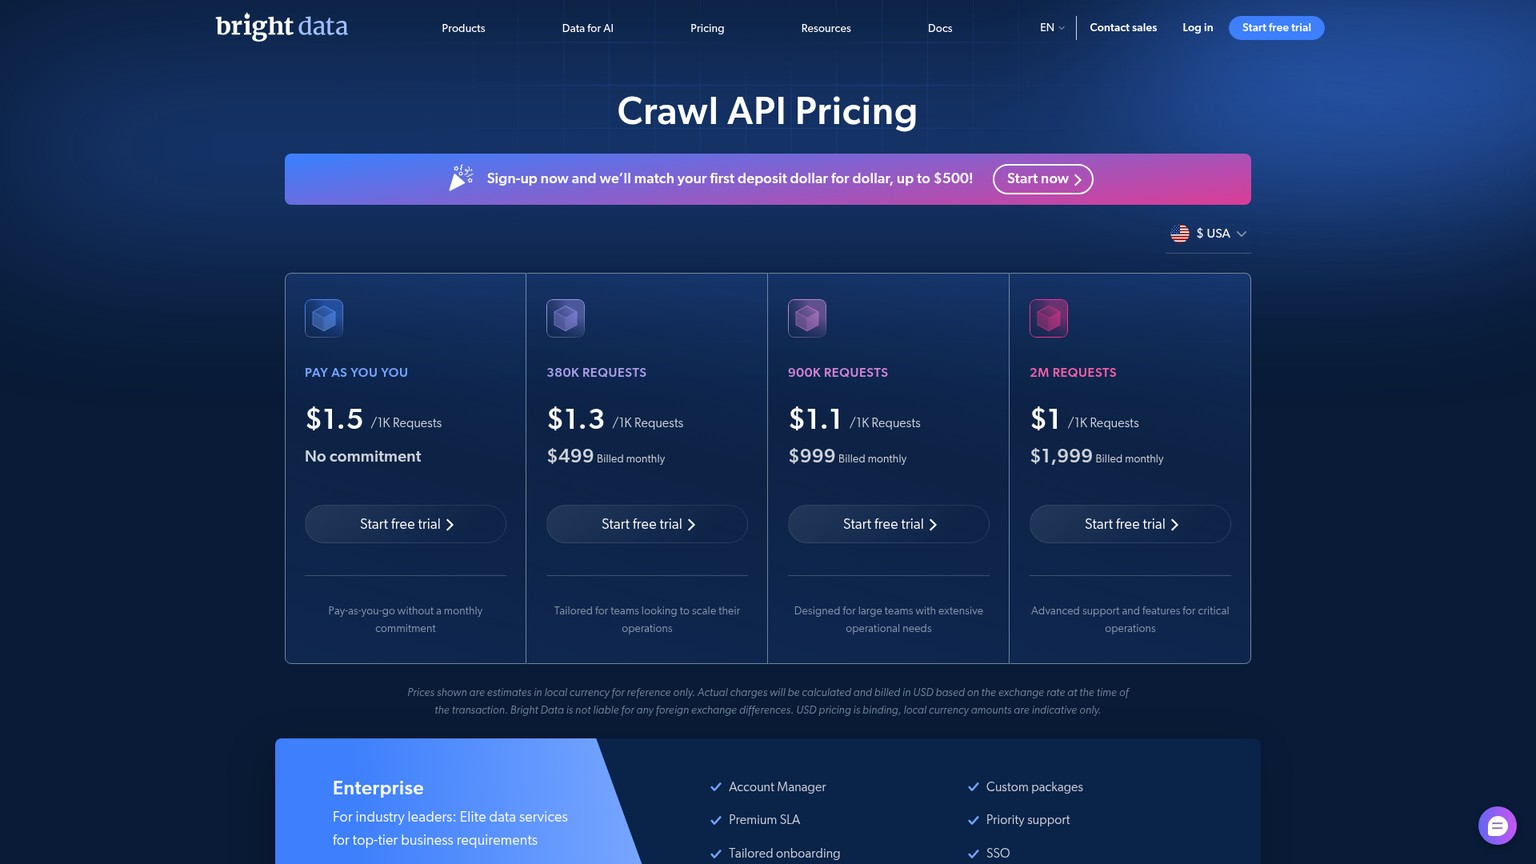
Le produit démarre à $1.50 par 1,000 requêtes en paiement à l’usage, sans engagement. L’offre de 380,000 requêtes coûte $499 par mois, soit $1.30 par 1,000 ; 900,000 requêtes coûtent $999, soit $1.10 par 1,000 ; et 2 millions de requêtes coûtent $1,999, soit $1 par 1,000. Enterprise est sur mesure. Ce sont les tarifs actuels de Bright Data Crawl API.
La limite importante est la même que pour Zyte : les formats de livraison documentés sont NDJSON et CSV, pas le Markdown natif. Pour un pipeline de récupération qui exige des titres stables, des blocs de code, des tableaux et des liens sources en Markdown, le convertisseur est un composant de production. Ses échecs et le temps d’exploitation doivent entrer dans le dénominateur.
Au tarif à l’usage, une réserve de 10% pour les nouvelles tentatives facturables porte la dépense fournisseur à $1.65 pour 1,000 pages acceptées, $16.50 pour 10,000 et $165 pour 100,000. Ces petits montants par requête ne doivent pas être confondus avec un coût complet. La feuille prévoit quatre, cinq et huit heures pour la conversion Markdown, la normalisation du schéma et la revue ; une cible difficile peut aussi modifier le comportement des requêtes.
Idéal pour : la collecte à très fort parallélisme sur des domaines protégés, lorsque l’accès managé vaut davantage qu’une sortie Markdown native.
Point fort : rendu, routage résidentiel, gestion des CAPTCHA, validation et parallélisme illimité inclus dans le prix de Crawl API.
Prix : PAYG à $1.50 par 1,000 requêtes ; $499 pour 380,000 ; $999 pour 900,000 ; $1,999 pour 2 millions ; Enterprise sur mesure.
Essai gratuit : les encarts tarifaires actuels proposent un essai gratuit, sans préciser le montant du crédit dans les conditions visibles.
- L’infrastructure d’accès, qui nécessiterait autrement plusieurs composants, est regroupée.
- Le parallélisme illimité convient aux tâches volumineuses assorties de délais de livraison stricts.
- NDJSON et CSV assurent une livraison lisible par machine sans devoir scraper le tableau de bord du fournisseur.
- Le Markdown natif ne fait pas partie du contrat de sortie documenté.
- Le coût PAYG par requête masque à lui seul la conversion, le schéma et la revue des pages acceptées.
- Cette pile d’accès étendue constitue une surcharge inutile pour des sites de documentation publics qu’un simple HTTP brut sait traiter.
Crawler web open source : les alternatives à Firecrawl qu’une équipe peut opérer
Crawl4AI est l’alternative open source la plus évidente de cette sélection, mais Firecrawl publie lui aussi un cœur auto-hébergeable. La vraie différence n’est pas de savoir si un dépôt peut être cloné. Il faut déterminer si le déploiement ouvert reproduit la découverte, l’accès navigateur, les files d’attente, la persistance, l’observabilité et le contrat de sortie dont dépend le pipeline métier.
Avec Crawl4AI, épinglez la version 0.9.4 ou une version ultérieure, imposez l’authentification, configurez correctement l’interface d’écoute des instances privées d’évaluation et enregistrez l’image ou la version exacte du paquet avec chaque jeu de résultats. Sur les templates stables, préférez l’extraction CSS ou XPath ; isolez ensuite tout fournisseur d’extraction LLM comme un poste de coût et une frontière de données distincts. Les 8 à 20 heures mensuelles d’exploitation retenues dans le modèle de coûts ne sont pas un benchmark : elles obligent à chiffrer les correctifs, les défaillances de proxies, la dérive du schéma et la reprise, au lieu de les déclarer gratuits.
Pour le cœur de Firecrawl, traitez le choix entre Cloud et auto-hébergement comme une décision d’architecture à part entière. Le dépôt peut supprimer une ligne de crédits fournisseur, mais il ajoute PostgreSQL, Redis, RabbitMQ, des workers navigateur, la supervision et les mises à niveau à la charge de l’équipe. L’article dédié à l’auto-hébergement lié plus haut fournit un dossier de vérification pour cette décision.
Quelle est la meilleure IA pour le web scraping ?
Le meilleur choix dépend de la nature des entrées. Si l’entrée est un domaine et que la sortie doit former un corpus Markdown et JSON complet, commencez par Firecrawl ou Apify, puis chiffrez ScrapFly. Si vous disposez déjà d’une liste d’URL fiable, Jina Reader évite toute la mécanique de crawl et peut revenir bien moins cher. Si l’accès est le point difficile, comparez le plafond de coût de ScrapingBee aux niveaux par site de Zyte et à la pile d’accès intégrée de Bright Data.
Les agents IA de web scraping ont besoin d’un contrôle d’acceptation
Un agent ne doit jamais décider qu’une réponse 200 est prête à entrer dans le pipeline de récupération. Donnez-lui un contrôle déterministe : champs obligatoires, longueur minimale du Markdown, préservation des tableaux et du code, liens normalisés, hash du contenu, type de contenu autorisé et règles explicites pour les valeurs null. L’agent peut router les échecs, mais ne doit pas contourner le contrat pour faire avancer une tâche.
La décision bascule dans quatre cas :
- Restez avec Firecrawl s’il passe le jeu de tests et si les économies sur six mois ne remboursent pas la migration et le fonctionnement en parallèle.
- Choisissez Apify si une tâche de crawl managée, un dataset persistant et la souplesse du workflow Actor comptent davantage qu’un prix unique par crédit de page.
- Choisissez Crawl4AI si l’équipe gère déjà les conteneurs, le routage d’accès et les astreintes, ou si une frontière de données rend le traitement managé inacceptable.
- Choisissez une API plus ciblée si la découverte est déjà prise en charge ou si l’accès aux pages protégées domine la tâche. Jina, ScrapingBee, Zyte et Bright Data ne donnent le meilleur d’eux-mêmes que lorsque ce périmètre est formalisé.
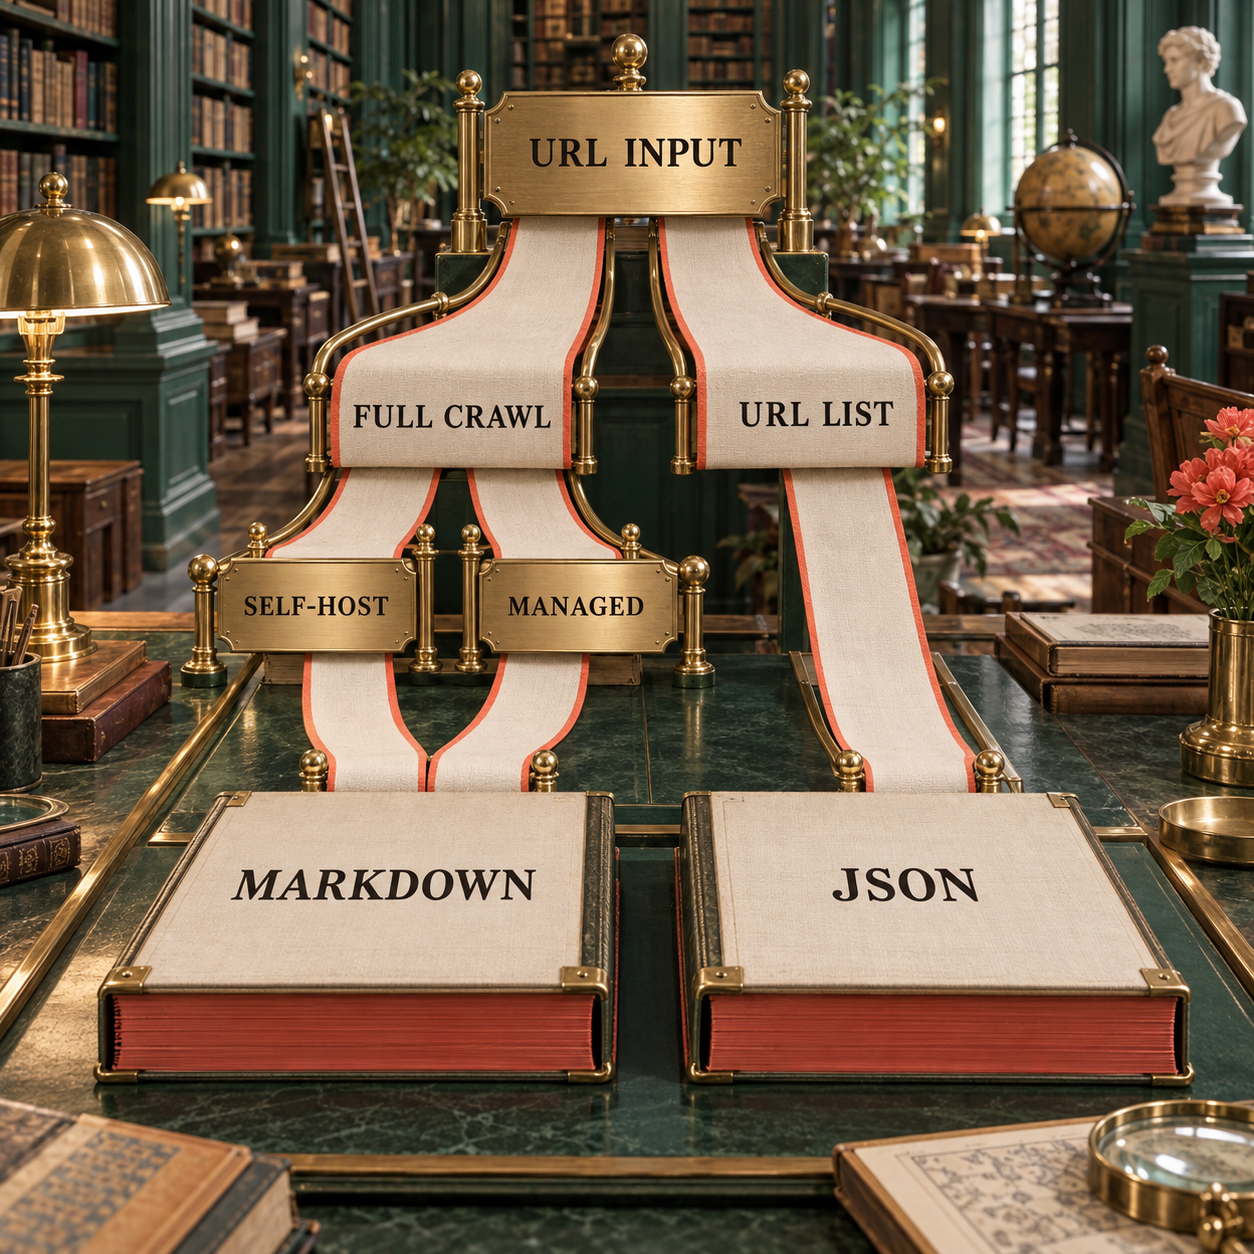
Ne choisissez pas l’outil dont le playground produit simplement le résultat le plus séduisant. La configuration retenue doit passer le même jeu de tests, conserver les mêmes preuves et produire les mêmes segments en aval. Un outil apparemment plus propre sur une page d’article peut encore échouer sur le tableau, le PDF ou le parcours JavaScript qui détermine l’acceptation en production.
Les solutions à écarter comme remplacement direct
Évitez d’acheter un produit voisin en prétendant que le pipeline est complet. Les outils suivants peuvent être utiles, mais ils ne remplacent pas le travail Firecrawl complet défini ici :
- Exa et Tavily : conservez-les dans l’évaluation des moteurs de recherche. Ils ne figurent pas dans cette sélection parce que le remplacement étudié commence après le choix d’un domaine ou d’un ensemble d’URL et doit produire des corps de page acceptés.
- Playwright et Puppeteer seuls : l’automatisation du navigateur est une brique, pas un manifeste de crawl managé, un contrat Markdown, un registre de nouvelles tentatives ni un système de livraison structurée. Ne les choisissez que si l’objectif est précisément de construire ces couches.
- Un service de proxy seul : obtenir une réponse ne nettoie pas la navigation, ne conserve pas les liens, ne valide pas le JSON et ne stabilise pas les limites des segments.
- Un fork de crawler non maintenu : un dépôt gratuit devient un incident lorsque les versions des navigateurs, les correctifs de sécurité ou le comportement des cibles évoluent et que personne n’assume le cycle de publication.
Évitez également de prendre un benchmark marketing pour une preuve de migration. Tant que la configuration exacte n’a pas été exécutée sur le jeu fixe de 20 URL et enregistrée, le chiffre décrit la charge de travail de quelqu’un d’autre. Cet article ne publie volontairement aucun taux de réussite synthétique ni classement de latence.
Grille de migration pour une petite équipe
Une migration sûre maintient Firecrawl et la solution candidate en parallèle tant que les sorties normalisées, le comportement des nouvelles tentatives et les segments ne concordent pas sur le jeu fixe et sur un échantillon représentatif de la production. La grille exige un responsable, un schéma versionné et un déclencheur de retour arrière.
1. Figer l’entrée et le contrat de découverte
Consignez si les URL proviennent du crawl d’un domaine, d’un sitemap, d’une API de recherche, d’une file d’attente ou d’une base interne. Enregistrez les domaines autorisés, la politique de sous-domaines, les chemins inclus et exclus, la profondeur, la limite de pages, la normalisation canonique des URL et les règles de déduplication. Un test Jina ou ScrapingBee n’est comparable à Firecrawl que si un autre composant fournit toute cette ligne.
2. Figer le schéma de sortie
Versionnez les champs et types requis. Conservez au minimum source_url, final_url, title, markdown, links, status_code, fetched_at et content_sha256. Indiquez quels champs métier peuvent être null et lesquels font échouer la page. Gardez la réponse brute afin de relancer un changement de parseur sans repayer le crawler.
3. Traiter les nouvelles tentatives comme des événements comptables
Pour chaque tentative, enregistrez le statut fournisseur, le statut HTTP, le verdict d’acceptation, le motif de la nouvelle tentative, le coût en crédits ou en requêtes et l’action suivante. Distinguez les erreurs de transport, les échecs déclarés par le fournisseur, les blocages d’accès, les contenus vides, les échecs de schéma et les erreurs de conversion en aval. Plafonnez les tentatives et envoyez les éléments qui ont épuisé leurs essais dans une file de lettres mortes afin d’éviter une boucle de dépenses invisible.
4. Conserver le dossier de preuves
Utilisez un chemin composé de l’outil, de sa version, du hash de configuration, de la date d’exécution et de l’identifiant du jeu de tests. Stockez la requête, les en-têtes, la réponse non modifiée, le JSON normalisé, le Markdown, le verdict et l’empreinte. Un relecteur doit pouvoir déterminer quel moteur de rendu, quel mode d’extraction et quel schéma ont produit chaque segment accepté.
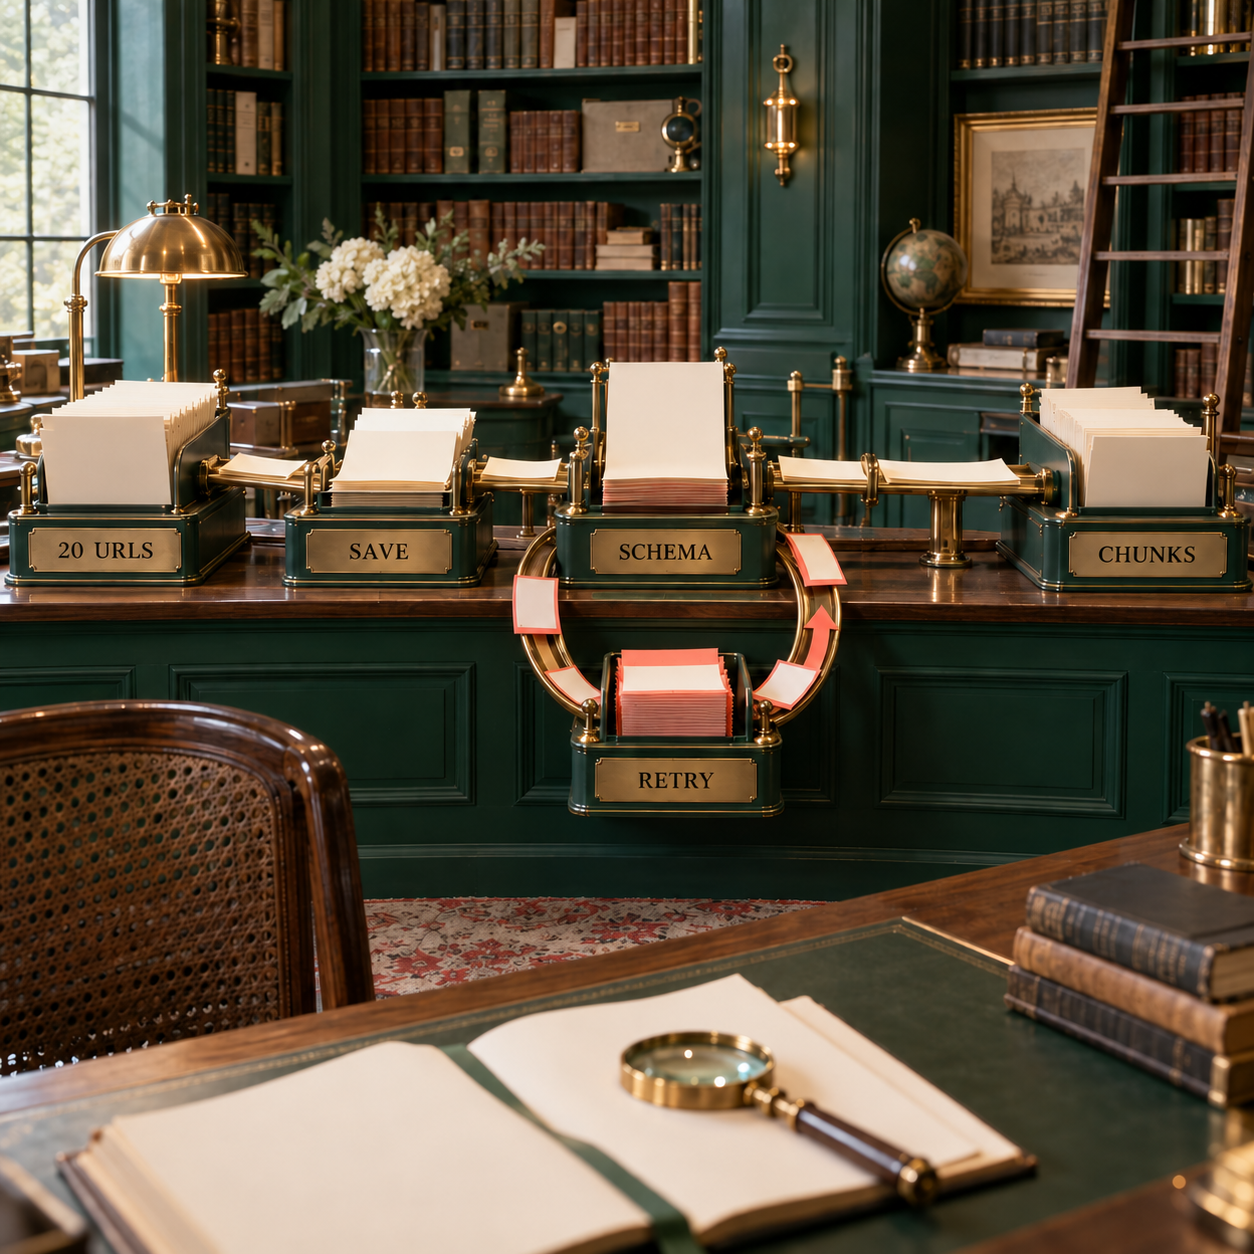
5. Tester la régression du découpage en aval
Comparez la hiérarchie des titres, les blocs de code, les tableaux, les cibles des liens, l’ordre du document et les empreintes de contenu avant toute nouvelle vectorisation. Comparez ensuite le nombre de segments, leurs limites et les citations de sources. Même un Markdown plus propre peut modifier la récupération si les titres disparaissent ou si les lignes d’un tableau sont séparées entre plusieurs segments.
6. Chiffrer le corpus accepté et fixer le retour arrière
Additionnez les dépenses fournisseur, l’hébergement, les tokens d’extraction, les nouvelles tentatives payantes, le stockage et les heures d’exploitation. Divisez par les pages acceptées, pas par les requêtes. Fixez le déclencheur de retour arrière avant le lancement : par exemple, l’échec d’un champ requis, un niveau tarifaire de cible inattendu, une hausse significative du nombre de segments ou un plafond d’heures d’exploitation. Gardez l’ancien parcours disponible jusqu’à la fin de cette période de validation.
Pour une petite équipe, le premier livrable utile n’est pas une note attribuée à un fournisseur. C’est une feuille comportant une ligne par URL du jeu de tests et des colonnes pour les deux systèmes. Une fois les preuves enregistrées sur chaque ligne, la réussite ou l’échec devient vérifiable au lieu de relever d’une préférence.
Questions fréquentes
Le web scraping est-il illégal ?
Il n’existe pas de réponse universelle par oui ou par non. Aux États-Unis, la politique du Department of Justice sur le CFAA distingue les barrières techniques d’accès d’une simple restriction contractuelle. Le contrat, le droit d’auteur, la vie privée, l’usage des données, les contrôles d’accès et la juridiction peuvent néanmoins changer l’analyse. Ceci n’est pas un avis juridique ; une collecte en production mérite l’avis d’un juriste sur les cibles et l’usage précis.
Firecrawl est-il cher ?
Tout dépend de la sortie acceptée. Le crawl coûte 1 crédit par page et le JSON en ajoute 4. Dans ce modèle, 10,000 pages acceptées avec une réserve de 10% pour les nouvelles tentatives nécessitent donc 55,000 crédits et tiennent dans Standard à $83. Le travail d’exploitation et le coût de migration peuvent peser davantage que cette facture.
Quel est le meilleur outil de web scraping ?
Apify Website Content Crawler est l’alternative managée la plus large de cette sélection. Crawl4AI est plus pertinent lorsque l’auto-hébergement est obligatoire, ScrapFly se distingue pour l’association d’un crawl managé et de l’extraction, tandis que Jina Reader ne l’emporte que si une liste d’URL fiable existe déjà.
Peut-on auto-héberger Firecrawl ?
Oui. Le cœur auto-hébergé donne le contrôle à l’équipe, qui doit alors gérer ses bases de données, ses files d’attente, ses workers navigateur, ses mises à niveau, sa sécurité, son routage d’accès et sa supervision. Ce n’est pas le même produit opérationnel que Firecrawl Cloud.
Quelles sont les alternatives à Firecrawl ?
Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API et Bright Data Crawl API sont les sept alternatives comparées ici. Elles se répartissent entre crawlers complets, outils de lecture alimentés par des URL et API centrées sur l’accès.
L’auto-hébergement est-il légal ?
Exécuter un logiciel sur une infrastructure contrôlée est généralement une question distincte de ce à quoi ce logiciel accède. L’autorisation, les contrôles d’accès, les conditions du site, le droit d’auteur, la vie privée, les règles de protection des données et l’usage prévu exigent encore leur propre examen.
L’auto-hébergement en vaut-il la peine ?
Oui, lorsqu’une frontière de données imposée, une personnalisation ou une plateforme mutualisée compensent le travail d’exploitation. Ajouter un nouveau service à assurer en astreinte uniquement pour supprimer une modeste facture API mensuelle est rarement rentable.
Quels sont les risques d’un hébergement gratuit ?
Une instance gratuite peut se mettre en veille, limiter le CPU ou la mémoire, utiliser un stockage éphémère, partager des adresses IP de faible réputation et n’offrir aucune garantie de reprise en production. Ces limites peuvent faire paraître un crawler peu fiable alors que le logiciel n’est pas en cause.
Peut-on auto-héberger un site gratuitement ?
Un site amateur ou une évaluation de crawler peut tenir dans une allocation gratuite. Un crawl en production consomme toujours du calcul, du stockage, de la bande passante, une infrastructure d’accès, de la supervision, des sauvegardes et du temps d’exploitation : une ligne d’hébergement à $0 ne signifie pas un coût opérationnel de $0.
Firecrawl est-il open source ?
Firecrawl publie un cœur open source auto-hébergeable. Firecrawl Cloud y ajoute une infrastructure managée et des services d’exploitation ; le dépôt seul ne reproduit donc ni la structure de coûts ni le périmètre de fiabilité du produit Cloud.
- Dernière mise à jour
- 25 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

7 alternatives à CodeRabbit pour la revue de code IA
Comparez 7 alternatives à CodeRabbit : prix, hébergement, confidentialité et coûts pour 300 revues, afin de choisir selon vos contraintes réelles.25 sept. 2026Build
CodeRabbit ou Greptile : quel outil de revue de code IA choisir ?
CodeRabbit ou Greptile ? Comparez tarifs, limites de revue, intégrations Git et coûts réels pour choisir l’outil adapté à votre équipe de développement.25 sept. 2026Build
Perplexity Windows : configurer Portable Computer en local
Configurez Perplexity Portable Computer sur un PC Windows AMD compatible, testez l’inférence locale et maîtrisez permissions, coûts et passages cloud.25 sept. 2026Build
AgentRun : test d’un framework agent IA TypeScript
AgentRun encadre les workflows d’agents IA en TypeScript. Test des branches, schémas, escalades, coûts et limites face à LangGraph.js et Temporal.24 sept. 2026Build
Perplexity Search API : Fast Search ou mode web par défaut ?
Fast Search coûte cinq fois moins cher, mais le mode web couvre mieux les requêtes complexes. Voici comment router chaque recherche dans Perplexity Search API.24 sept. 2026Build
Agent IA : le coût caché d’un fallback mal conçu
Un agent IA peut faire exploser les coûts lorsqu’un fallback payant devient le chemin par défaut. Voici les signaux de la panne et le correctif durable.24 sept. 2026Build
Cursor gratuit ? Rollouts reste payant après les crédits
Cursor Rollouts n’est pas gratuit : accès dès Teams à $40 par utilisateur, crédits de 10 jours et tarif d’usage encore non publié. Voici quoi vérifier.24 sept. 2026Build