Firecrawl Docker : auto-hébergement, vérification et coûts réels
Déployez Firecrawl avec Docker, validez un vrai scrape et comparez sur 30 jours le coût réel de l’auto-hébergement à celui de Firecrawl Cloud.



L’auto-hébergement de Firecrawl donne la main sur le code et l’infrastructure ; il ne transforme pas un service managé en solution gratuite. Pour déployer Firecrawl Docker sérieusement, épinglez v2.11.162, validez une vraie requête /v2/scrape, conservez les preuves, puis chiffrez le travail d’exploitation. Dans le calcul sur 30 jours ci-dessous, Firecrawl Cloud coûte $0 pour 1,000 pages simples et $44 pour 10,000, tandis que l’auto-hébergement atteint $725.20 le premier mois dès lors que l’on compte explicitement six heures d’exploitation supposées.
Firecrawl Docker : le Cloud reste moins cher à cette échelle
Auto-hébergez Firecrawl lorsque l’accès au code, la maîtrise de l’infrastructure ou une frontière réseau imposée justifient de prendre la stack en charge. Choisissez le Cloud si le besoin consiste simplement à convertir des URL publiques en contenu propre. Firecrawl aboutit à la même conclusion dans son guide d’auto-hébergement : le Cloud est le chemin pris en charge le plus rapide vers la production, tandis que l’auto-hébergement laisse toute la mécanique à votre équipe.
Les montants de l’auto-hébergement forment un budget, pas une promesse de débit. Firecrawl ne publie aucune configuration minimale validée et cette exécution n’a pas permis de vérifier si la machine chiffrée supporte l’un ou l’autre volume. Le véritable motif pour accepter ce surcoût reste le contrôle. Les économies doivent être démontrées sur vos pages, avec votre nombre de requêtes simultanées et votre taux d’échec.
Ce que l’auto-hébergement de Firecrawl apporte vraiment
Vous obtenez le moteur central de Firecrawl sur une infrastructure que vous maîtrisez, ainsi que la responsabilité de chaque dépendance qui l’entoure. Voyez le Cloud comme une cuisine professionnelle déjà dotée de son personnel, et l’auto-hébergement comme le plan de cette cuisine. Le plan est utile, inspectable et adaptable. Il ne fournit ni les cuisiniers, ni les contrôles incendie, ni la surveillance des chambres froides, ni l’équipe de nuit.
La stack épinglée par défaut prend en charge les routes principales de scrape, crawl, map et search. Le traitement Fetch et Playwright est inclus. Elle dépend aussi de services comme PostgreSQL, Redis et RabbitMQ, sans que l’endpoint de readiness vérifie le fonctionnement de toute la chaîne.
Cette limite est importante : {"status":"ok"} prouve seulement qu’un endpoint HTTP a répondu. Elle ne prouve pas qu’une page peut sortir de la machine, être rendue, traverser les workers et revenir au format Markdown. Un scrape réussi constitue la preuve minimale exploitable.
Installer la version prévue par ce guide
Utilisez Firecrawl v2.11.162, et non la branche mouvante main. Le tag a été créé le 30 juillet 2026 et pointe vers le commit 7666c1f9ae8720a6bba271e0f60b6a217f8a5210. L’épinglage garantit que le code, le fichier Compose et les instructions d’installation correspondent au même état du projet.
Les prérequis officiels sont Git, Docker Engine ou Docker Desktop, Docker Compose v2, curl, un port 3002 disponible et une machine suffisamment dimensionnée pour compiler et exécuter plusieurs services. Firecrawl ne publie aucune configuration minimale validée.
Épingler le code source
Clonez Firecrawl, puis faites un checkout de
v2.11.162. Notez le commit obtenu pour qu’un prochain opérateur puisse reproduire le déploiement.Créer l’environnement de référence
Désactivez l’authentification de la base de données uniquement pour cette évaluation sur un réseau de confiance, conservez
postgrescomme nom de base PostgreSQL et utilisez un mot de passe aléatoire d’au moins 32 caractères. Ne commitez pas.env.Compiler et contrôler tous les services
Démarrez la stack Compose, puis examinez
docker compose ps --all. Les services persistants doivent être en cours d’exécution et les tâches d’initialisation ponctuelles doivent être terminées.Prouver qu’un vrai scrape fonctionne
Contrôlez la readiness, puis appelez
/v2/scrapesurhttps://example.com. Ne vous contentez pas de la réponse de readiness.
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
git rev-parse HEAD

db_password="$(openssl rand -hex 32)"
printf 'USE_DB_AUTHENTICATION=false\nPOSTGRES_USER=postgres\nPOSTGRES_PASSWORD=%s\nPOSTGRES_DB=postgres\n' \
  "$db_password" > .env

docker compose up --build -d
docker compose ps --all

curl --fail --silent --show-error --max-time 5 \
  http://localhost:3002/v0/health/readiness

curl --fail-with-body --silent --show-error --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
Le scrape n’est validé que si la réponse contient success: true, du Markdown et des métadonnées avec statusCode: 200. Les métadonnées exactes peuvent varier selon la cible. Si la readiness passe mais que le scrape échoue, inspectez les logs de l’API et de Playwright : le voyant vert n’a pas sollicité ces chemins.
Conserver un dossier de vérification transmissible
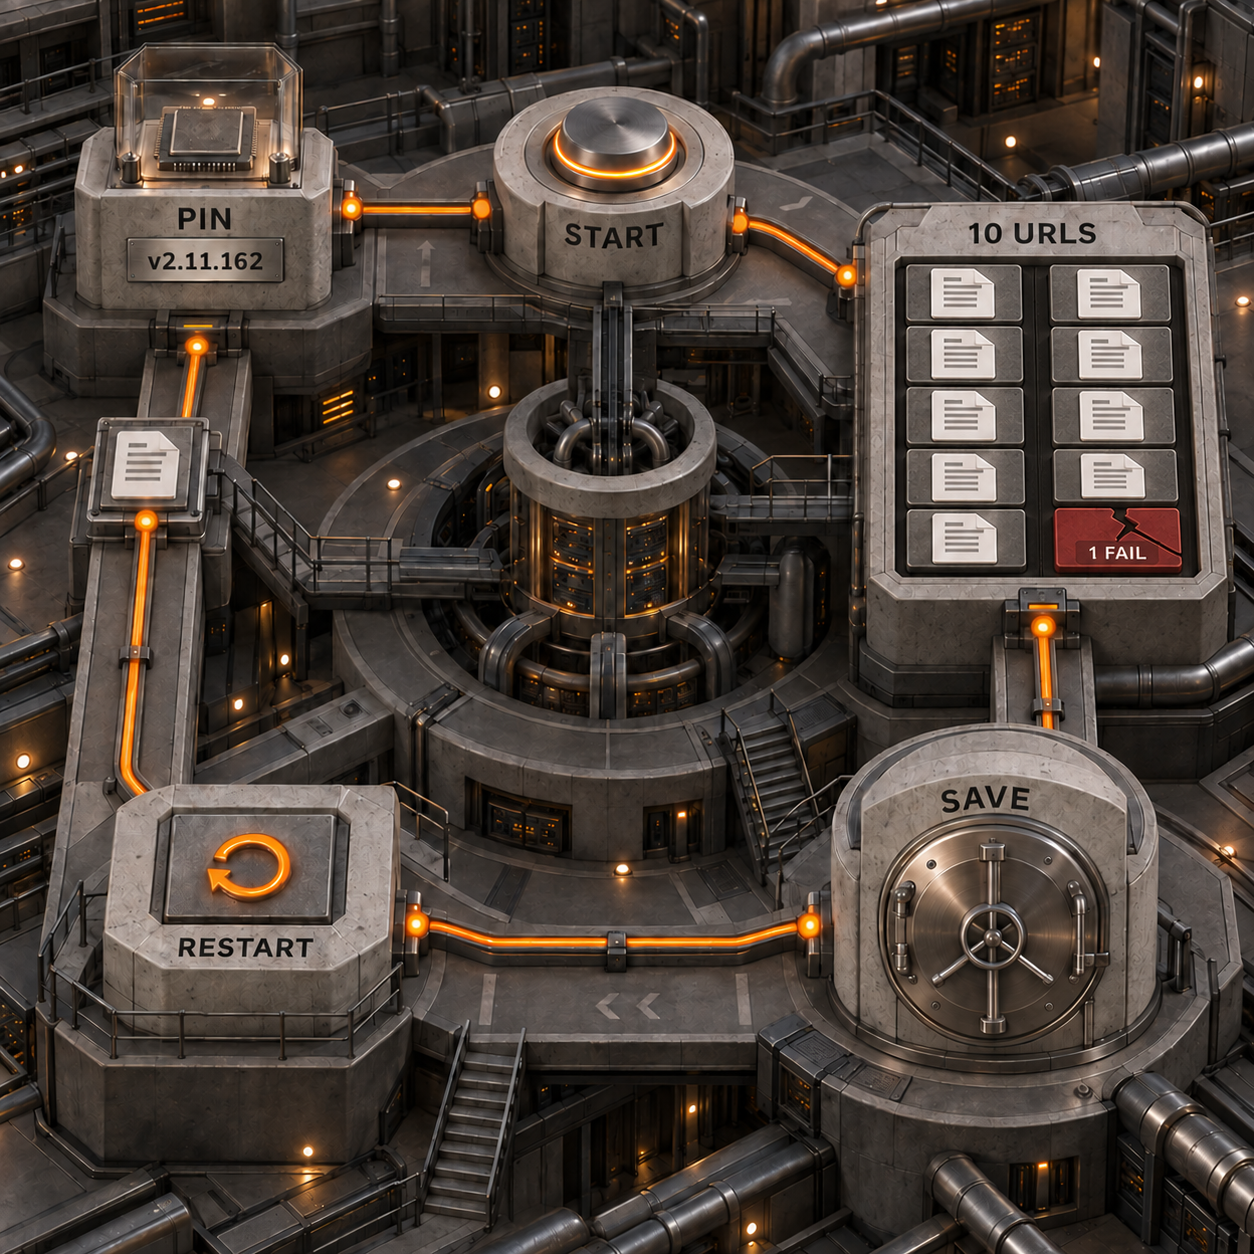
Une installation n’est pas vérifiée tant que ses preuves brutes ne survivent pas à la session du terminal. Le script ci-dessous part du dépôt épinglé et crée un répertoire horodaté qui contient les caractéristiques de la machine, la version exacte, le temps de build, l’état des conteneurs, la réponse de readiness, 10 réponses brutes de scrape, un récapitulatif, un instantané des ressources, le résultat du redémarrage et un deuxième scrape réussi.
La dixième URL utilise le domaine réservé .invalid : le jeu de test comprend ainsi un échec volontaire sans dépendre de la panne d’un site réel. Les neuf autres cibles sont des pages publiques fixes. Installez jq avant de lancer le script, car il construit le JSON des requêtes et lit les champs de résultat.
#!/usr/bin/env bash
set -euo pipefail

base_url="${FIRECRAWL_BASE_URL:-http://localhost:3002}"
stamp="$(date -u +%Y%m%dT%H%M%SZ)"
out="firecrawl-verification-${stamp}"
mkdir -p "$out/responses"

actual_release="$(git describe --tags --exact-match)"
[[ "$actual_release" == "v2.11.162" ]] || {
  printf 'Expected v2.11.162, found %s\n' "$actual_release" >&2
  exit 1
}

{
  printf 'checked_at_utc=%s\n' "$(date -u +%FT%TZ)"
  printf 'release=%s\n' "$actual_release"
  printf 'commit=%s\n' "$(git rev-parse HEAD)"
  printf 'cpus=%s\n' "$(getconf _NPROCESSORS_ONLN)"
  awk '/MemTotal/ {printf "memory_kib=%s\n", $2}' /proc/meminfo
  uname -a
  docker version
  docker compose version
} > "$out/host.txt" 2>&1

setup_start="$(date +%s)"
docker compose up --build -d > "$out/compose-up.log" 2>&1
printf '%s\n' "$(( $(date +%s) - setup_start ))" > "$out/setup-seconds.txt"
docker compose ps --all --format json > "$out/containers-before.json"
curl --fail --silent --show-error --max-time 5 \
  "$base_url/v0/health/readiness" > "$out/readiness.json"

targets=(
  https://example.com
  https://example.org
  https://example.net
  https://httpbin.org/html
  https://www.iana.org/help/example-domains
  https://www.rfc-editor.org/rfc/rfc9110
  https://www.w3.org/TR/PNG/iso_8859-1.txt
  https://docs.python.org/3/
  https://www.firecrawl.dev/
  https://fixture-failure.invalid/
)

printf 'index\turl\tcurl_exit\tsuccess\tstatus_code\n' > "$out/summary.tsv"
i=0
for target in "${targets[@]}"; do
  i=$((i + 1))
  response="$out/responses/$(printf '%02d' "$i").json"
  payload="$(jq -n --arg url "$target" \
    '{url:$url,formats:["markdown"],timeout:60000}')"
  if curl --silent --show-error --max-time 75 -X POST \
    "$base_url/v2/scrape" -H 'Content-Type: application/json' \
    -d "$payload" > "$response"; then curl_exit=0; else curl_exit=$?; fi
  success="$(jq -r '.success // false' "$response" 2>/dev/null || printf false)"
  status="$(jq -r '.data.metadata.statusCode // .error // "none"' \
    "$response" 2>/dev/null || printf unreadable)"
  printf '%s\t%s\t%s\t%s\t%s\n' \
    "$i" "$target" "$curl_exit" "$success" "$status" >> "$out/summary.tsv"
done

docker stats --no-stream --format json > "$out/container-stats.json"
docker compose restart > "$out/restart.log" 2>&1
for attempt in $(seq 1 60); do
  if curl --fail --silent --max-time 5 "$base_url/v0/health/readiness" \
    > "$out/readiness-after-restart.json"; then break; fi
  sleep 2
done
docker compose ps --all --format json > "$out/containers-after.json"
jq -n '{url:"https://example.com",formats:["markdown"],timeout:60000}' | \
  curl --fail-with-body --silent --show-error --max-time 75 \
    -X POST "$base_url/v2/scrape" -H 'Content-Type: application/json' -d @- \
    > "$out/restart-scrape.json"

jq -e -s 'all(.[]; .success == true and .data.metadata.statusCode == 200)' \
  "$out/responses/01.json" "$out/restart-scrape.json" >/dev/null
printf 'Saved verification record: %s\n' "$out"
Ne publiez aucune conclusion positive à partir de ce dossier tant que le premier scrape et celui effectué après redémarrage ne réussissent pas tous les deux. Conservez aussi chaque réponse en échec. Un échec renseigne sur le DNS, l’accès sortant, les protections anti-bot, l’état de la cible ou la stack elle-même ; le supprimer appauvrit le dossier.
Savoir où s’arrête la stack par défaut
Firecrawl auto-hébergé comprend les routes centrales, pas l’intégralité de l’offre Firecrawl. N’ajoutez un service que lorsqu’un besoin mesuré le justifie, pas simplement parce qu’une option de configuration existe.
Pour comparer les options Cloud de recherche et de récupération au-delà de cette décision de déploiement, le comparatif des API de recherche IA élargit l’analyse aux autres fournisseurs. Le choix d’un scraper de remplacement constitue une autre décision d’achat.
À qui l’auto-hébergement profite le plus
Les meilleurs candidats disposent déjà d’une équipe plateforme et d’une exigence de contrôle. À faible volume, un prix par page inférieur ne suffit pas.
Les mauvais candidats sont tout aussi faciles à reconnaître. Une équipe produit de deux personnes qui souhaite un seul endpoint de scrape fiable achète un chantier d’exploitation inutile. Une équipe qui dépend d’Agent, Browser, Interact, des captures d’écran, des actions sur les pages ou d’un scraping avancé managé part également du mauvais côté de la frontière fonctionnelle.
Calcul sur 30 jours : le contrôle a un coût réel
Pour 1,000 et 10,000 pages simples, Firecrawl managé est moins cher selon des hypothèses explicites et prudentes. Le budget auto-hébergé utilise un Droplet Basic de DigitalOcean doté de 8 vCPU, 16 GiB de RAM et 320 GiB de SSD à $96 par mois, auquel s’ajoutent un Volume persistant de 100 GiB à $10 et une provision de $19.20 pour une sauvegarde hebdomadaire. DigitalOcean affichait ces prix le 22 septembre 2026.
Le choix de 16 GiB ne correspond pas à un minimum officiel. C’est une hypothèse budgétaire éclairée par le fichier Compose épinglé, qui plafonne le service API à 8 GiB et Playwright à 4 GiB, tandis que la base de données, le cache, la file d’attente et les autres processus ont eux aussi besoin de mémoire. Seul un test de charge permet de dimensionner la machine.
Le temps d’exploitation est le poste principal. Ce calcul suppose quatre heures d’installation et deux heures de maintenance pendant les 30 premiers jours, à un coût chargé de $100 par heure. Il s’agit d’une hypothèse, pas d’un tarif de marché. Remplacez-la par votre propre chiffre.
Firecrawl Cloud facture un crédit par page simple scrapée. Le forfait Free comprend 1,000 crédits à $0. Pour 10,000 pages avec une facturation mensuelle, le forfait Hobby coûte $19 pour 5,000 crédits, puis 5,000 crédits Hobby supplémentaires reviennent à cinq tranches de $5, soit $44 au total. Le prix annuel du forfait Hobby ramène ce mois effectif à $41, mais impose une facturation annuelle.
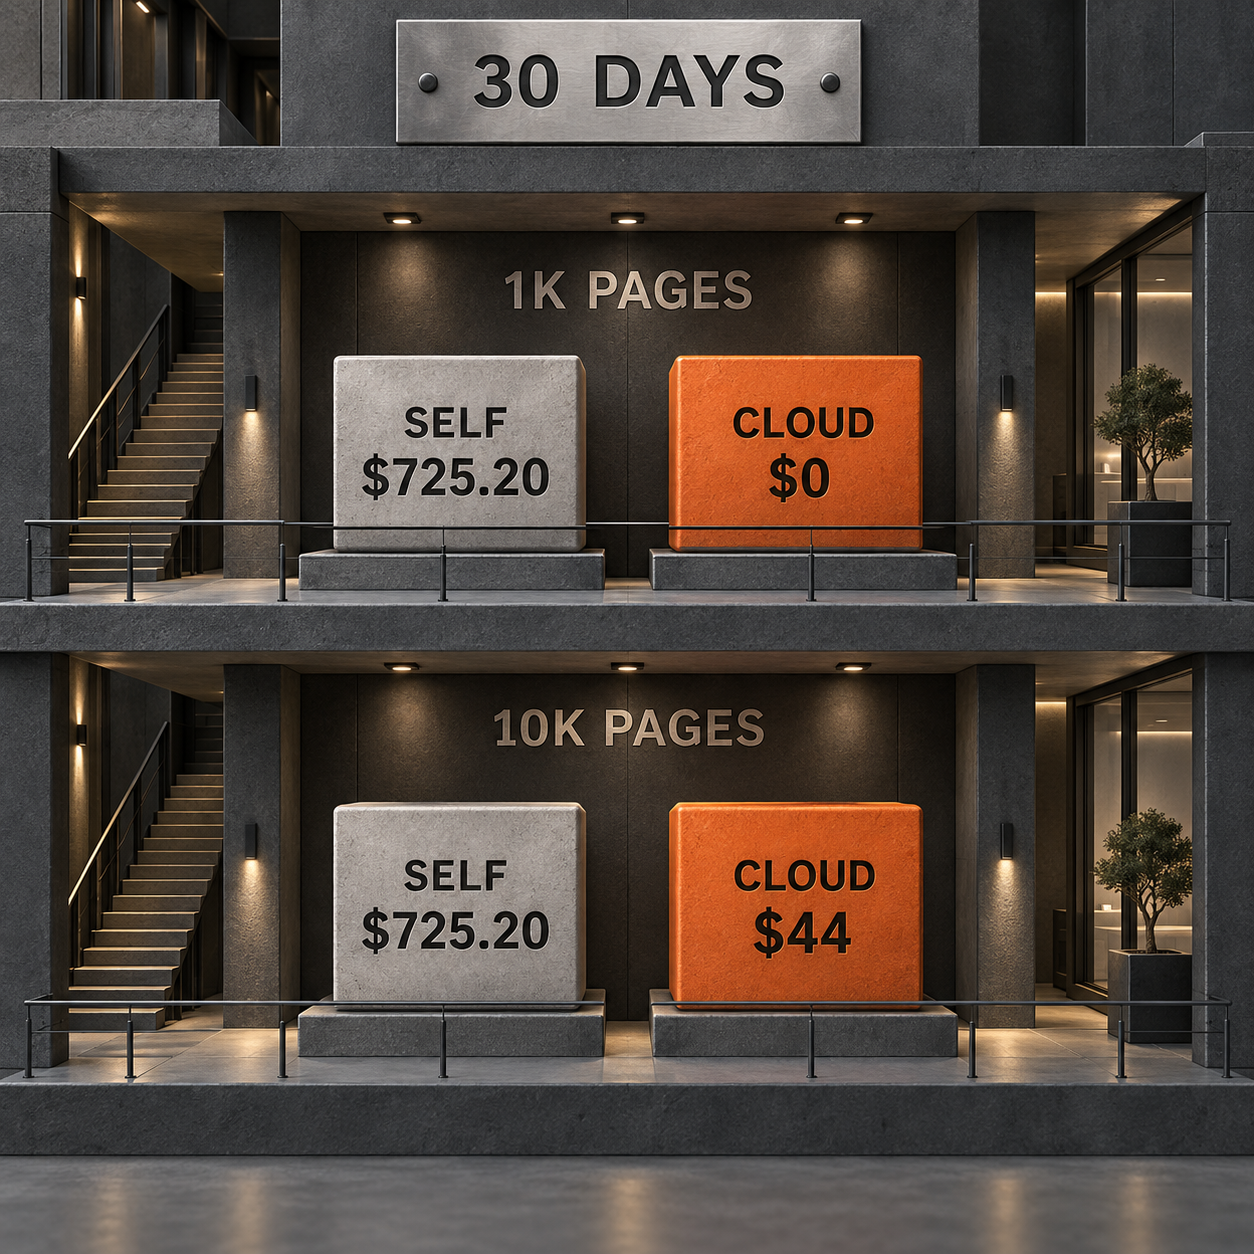
Ce modèle exclut les taxes, les fournisseurs de LLM optionnels, les frais de proxy, Fire-engine, la haute disponibilité, les transferts excédentaires, l’analyse juridique et la résolution des incidents. Il n’accorde pas non plus à la machine auto-hébergée un débit qui n’a pas été démontré. Pour simuler un mois ultérieur, retirer les quatre heures d’installation ramène l’auto-hébergement à $325.20, toujours au-dessus du Cloud pour les deux volumes étudiés.
La conclusion n’est pas que l’auto-hébergement ne peut jamais faire économiser de l’argent. Les économies ne commencent qu’après avoir validé la capacité par un benchmark et atteint un volume suffisant pour répartir les coûts fixes d’infrastructure et d’exploitation sur davantage de pages traitées avec succès. À 10,000 pages, l’exigence de contrôle doit justifier un surcoût de $681.20 le premier mois dans ce calcul.
Trois produits à construire autour de cet écart
Le dossier de vérification représente l’opportunité la plus solide : il transforme une installation ambiguë en preuves sans concurrencer Firecrawl. L’unique instantané de recherche en direct a renvoyé huit recherches associées et neuf questions People Also Ask. Cinq recherches associées portent sur Docker, Docker Compose, l’usage gratuit, la comparaison avec le Cloud ou les clés API, tandis que les questions demandent explicitement si Firecrawl est cher et sûr.
1. Kit de readiness et de vérification pour l’auto-hébergement
Le produit est un CLI local accompagné d’un rapport destiné aux responsables techniques. Il vérifie la version, la machine, l’état de Compose, le véritable chemin de scrape, l’échec attendu, le comportement après redémarrage et les lacunes avant la production, puis génère une archive signée pour validation.
Le signal de demande est direct : les recherches associées Google comprennent Firecrawl self-host Docker, Firecrawl self-host docker compose et Firecrawl self-host API key. La plus petite version commercialisable se limite à une commande, au jeu de test fixe, à un rapport HTML et à des contrôles de caviardage. La difficulté vient de la diversité des environnements. Un rapport peut prouver ce qui a été exécuté ; il ne peut pas garantir que chaque cible ou chaque version future se comportera de la même façon.
2. Calculateur de coûts Cloud contre auto-hébergement
Le produit est un calculateur de déploiement alimenté par le nombre de pages réussies, les options, le nombre de requêtes simultanées, le coût opérateur, l’objectif de reprise et les fonctions requises. Il place les crédits Cloud face aux coûts d’infrastructure et de main-d’œuvre, en rendant chaque hypothèse visible.
L’instantané de recherche contient Firecrawl self-hosted vs cloud, tandis que People Also Ask comprend Is Firecrawl expensive? et Is there a free version of Firecrawl available?. Les prix observés fournissent des repères concrets : $0 pour 1,000 crédits Cloud, $19 par mois pour 5,000 crédits Hobby et $5 par tranche de 1,000 crédits Hobby supplémentaires. Le MVP est une grille tarifaire versionnée avec export du calcul. La difficulté réside dans la capacité de l’auto-hébergement : sans benchmark de l’acheteur, le calculateur doit afficher une fourchette plutôt qu’un faux seuil de rentabilité.
3. Blueprint de durcissement pour la production
Le produit est un module d’infrastructure assumé, destiné aux équipes qui ont validé l’évaluation et doivent maintenant mettre en place l’authentification, TLS, la persistance des données, les sauvegardes, les tests de restauration, la supervision, les secrets et le contrôle des flux sortants.
Le signal de demande se partage entre la question People Also Ask Is Firecrawl safe to use? et la recherche associée Firecrawl self-host API key. Le guide de Firecrawl énumère lui-même chaque décision manquante avant la production : la valeur réside donc dans la mise en œuvre et ses preuves, pas dans l’idée que ces responsabilités n’auraient jamais été documentées. Le MVP comprend une cible cloud prise en charge, du code d’infrastructure épinglé à une version, des alertes et un exercice de reprise. La difficulté est juridique : un module réutilisable ne peut pas certifier la sécurité ou la conformité d’un client.
Limites et conclusion sans détour
N’auto-hébergez pas Firecrawl pour économiser $19 avant d’avoir mesuré le travail d’exploitation. La configuration de référence désactive l’authentification de l’API, n’emploie pas TLS, n’ajoute aucun stockage durable pour PostgreSQL, Redis et RabbitMQ, et n’est pas hautement disponible. L’exposer à un réseau non fiable transformerait un raccourci d’évaluation en faute de sécurité.
Ne supposez pas que la stack par défaut reproduit le Cloud fonction par fonction. Les formats LLM nécessitent un fournisseur. Fire-engine est séparé. Les captures d’écran et les actions ne sont pas accessibles par les chemins par défaut. Agent, Browser, Interact, les dashboards et les contrôles d’entreprise restent des fonctionnalités Cloud ou nécessitent des services vérifiés séparément.
Ne dimensionnez pas la production à partir des limites Compose ni de ce calcul. Un plafond de mémoire n’est pas une recommandation de machine. Exécutez le jeu de test fixe, ajoutez des pages représentatives de votre propre charge, mesurez la concurrence et les catégories d’échec, puis testez la restauration d’une sauvegarde et le rollback d’une mise à niveau.
La meilleure raison de poursuivre est une exigence de contrôle à laquelle le Cloud ne peut pas répondre pour l’équipe. La moins bonne tient en un mot : « gratuit ».
Ce qu’il faut faire lundi
Accordez à un ingénieur un créneau d’évaluation de deux heures sur une machine privée et jetable. Épinglez v2.11.162, lancez l’unique scrape du guide officiel, exécutez le script de vérification qui conserve les preuves et arrêtez-vous si le scrape après redémarrage échoue. Remplacez ensuite le coût opérateur de $100 dans le calcul par votre coût chargé et formulez en une phrase l’exigence de contrôle. Si elle reste vague, choisissez le Cloud. Si elle est concrète, planifiez les contrôles de production avant d’augmenter le volume.
Firecrawl est-il cher ?
Tout dépend du mode de déploiement et du volume de pages. Firecrawl Cloud coûte $0 pour les 1,000 premiers crédits de pages simples chaque mois. Dans ce calcul, 10,000 pages simples coûtent $44 avec le forfait Hobby mensuel et le paiement à l’usage, tandis que le premier mois auto-hébergé simulé atteint $725.20 en comptant six heures d’exploitation supposées. L’auto-hébergement n’a de sens financier qu’une fois que votre benchmark et vos exigences de contrôle justifient son travail fixe.
Existe-t-il une version gratuite de Firecrawl ?
Oui. Firecrawl propose une voie de déploiement open source, et Firecrawl Cloud dispose d’un forfait Free avec 1,000 crédits par mois. L’open source supprime le prix du forfait Firecrawl, pas les coûts de calcul, de stockage, de sécurité, de supervision, de mise à niveau, de reprise et de temps opérateur.
Firecrawl est-il sûr ?
La configuration d’évaluation n’est sûre qu’au sein d’un réseau de confiance doté de contrôles appropriés sur la machine et le réseau. Elle désactive l’authentification de la base de données et ne comprend ni conception d’authentification pour la production, ni TLS, ni stockage durable, ni haute disponibilité, ni reprise. La sécurité dépend de la mise en œuvre et du test de ces contrôles avant toute exposition.
Comment auto-héberger Firecrawl avec Docker Compose ?
Installez Git, Docker, Docker Compose v2 et curl. Faites un checkout de v2.11.162, créez le fichier .env de référence avec ses quatre valeurs, exécutez docker compose up --build -d, contrôlez chaque service et la readiness, puis exigez une réponse réussie à POST /v2/scrape. Conservez les résultats bruts et recommencez le scrape après un redémarrage.
Firecrawl auto-hébergé a-t-il besoin d’une clé API ?
L’évaluation sur réseau de confiance définit USE_DB_AUTHENTICATION=false ; les requêtes locales n’utilisent donc pas de clé API. Ce n’est pas une architecture de production exposée au public. Selon Firecrawl, l’authentification en production exige une conception complète et prise en charge de l’identité et de la base de données, ainsi que des contrôles réseau et TLS. Une seule variable d’environnement ne suffit pas.
Si vous souhaitez un déploiement épinglé à une version et observable, conçu autour de vos exigences de contrôle, découvrez les systèmes d’IA en production.
- Dernière mise à jour
- 22 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Agent IA : pourquoi un retry payant exige une validation humaine
Un agent IA a relancé des rendus payants sans accord humain. Voici où placer le contrôle qui sépare diagnostic, autorisation et décision de dépense.22 sept. 2026Build
MindStudio : créer un agent IA no code, à quel prix ?
MindStudio vaut-il le détour pour créer un agent IA ? Analyse des workflows, tarifs, limites et coûts réels pour 1,000 ou 10,000 tâches terminées.22 sept. 2026Build
Logiciel de dictée vocale : Superwhisper ou Wispr Flow ?
Superwhisper ou Wispr Flow ? Comparez prix, confidentialité, plateformes et fonctions d’équipe pour choisir le logiciel de dictée vocale adapté.22 sept. 2026Build
Agence d’intelligence artificielle : 4 offres d’automatisation comparées
Comparez 4 agences d’automatisation IA selon leurs preuves, leur coût total à 90 jours, leur support et leurs conditions de sortie avant de signer.22 sept. 2026Build
Comment utiliser Claude Code Projects : guide pratique de la bêta
Apprenez comment utiliser Claude Code Projects pour répartir des tâches cloud, partager le contexte et contrôler branches, coûts, usages et validations.21 sept. 2026Build
Automatisation service client : router les tickets avec Jev
Automatisation service client avec Jev : routez les tickets, interprétez la confiance du modèle et basculez les cas ambigus vers un agent humain.21 sept. 2026Build
Claude Code AGENTS.md : activer la lecture native
Claude Code peut désormais lire AGENTS.md sans fichier passerelle. Découvrez les versions, réglages et limites à vérifier pour activer ce mode.19 sept. 2026Build