Firecrawl Docker selbst hosten: Setup, Belege und echte Kosten
Firecrawl mit Docker selbst hosten: versioniertes Setup, belastbare Scrape-Prüfung und ein 30-Tage-Kostenvergleich mit Firecrawl Cloud im Detail.



Beim Self-Hosting mit Firecrawl Docker bleibt die Kontrolle über Code und Infrastruktur im eigenen Haus – kostenlos wird der Managed Service dadurch nicht. Entscheidend ist, v2.11.162 festzuschreiben, einen echten Aufruf von /v2/scrape nachzuweisen und die Belege zu sichern. Erst danach lässt sich der Betriebsaufwand seriös kalkulieren. Im folgenden 30-Tage-Modell kostet Firecrawl Cloud $0 für 1,000 einfache Seiten und $44 für 10,000. Das Self-Hosting kommt im ersten Monat dagegen auf $725.20, sobald die ausdrücklich angenommenen sechs Arbeitsstunden für den Betrieb einfließen.
Kurzantwort: In dieser Größenordnung ist Cloud günstiger
Firecrawl selbst zu hosten lohnt sich, wenn Quellcodezugriff, Infrastrukturkontrolle oder eine zwingende Netzwerkgrenze den Betrieb des gesamten Stacks rechtfertigen. Geht es lediglich darum, öffentliche URLs in saubere Inhalte umzuwandeln, ist Cloud die bessere Wahl. Zum selben Ergebnis kommt Firecrawl im eigenen Self-Hosting-Leitfaden: Cloud ist der schnellste unterstützte Weg in den Produktivbetrieb, beim Self-Hosting trägt das eigene Team hingegen die Verantwortung für die gesamte Technik.
Die Self-Hosting-Werte sind ein Budget, kein Leistungsversprechen. Firecrawl nennt keine verifizierte Mindestgröße für den Host, und in diesem Durchlauf ließ sich nicht prüfen, ob die angesetzte Maschine eines der beiden Volumen bewältigt. Der belastbare Grund für den Aufpreis heißt Kontrolle. Ob sich Kosten sparen lassen, muss mit den eigenen Seiten, der eigenen Parallelität und der tatsächlichen Fehlerquote nachgewiesen werden.
Was Self-Hosting mit Firecrawl tatsächlich liefert
Auf der eigenen Infrastruktur läuft die zentrale Firecrawl-Engine – zusammen mit der Verantwortung für alle umliegenden Abhängigkeiten. Cloud lässt sich mit einer professionell besetzten Großküche vergleichen, Self-Hosting eher mit dem Bauplan dafür. Der Plan ist nützlich, einsehbar und anpassbar. Köche, Brandschutzprüfung, Kühlkontrolle und Nachtschicht sind nicht enthalten.
Der festgeschriebene Standard-Stack unterstützt die zentralen Routen für Scrape, Crawl, Map und Search. Auch Fetch- und Playwright-Verarbeitung sind enthalten. Hinzu kommen Abhängigkeiten wie PostgreSQL, Redis und RabbitMQ. Der Readiness-Endpunkt prüft jedoch nicht, ob diese gesamte Kette funktioniert.
Diese Grenze ist entscheidend: {"status":"ok"} belegt lediglich, dass ein einzelner HTTP-Endpunkt geantwortet hat. Daraus folgt noch nicht, dass eine Seite den Host verlassen, gerendert, von den Workern verarbeitet und als Markdown zurückgegeben werden kann. Ein erfolgreicher Scrape ist der kleinste brauchbare Nachweis.
Firecrawl Docker installieren: die passende Version festschreiben
Verwendet werden sollte Firecrawl v2.11.162, nicht der fortlaufend veränderte Branch main. Der Tag wurde am 30. Juli 2026 erstellt und verweist auf Commit 7666c1f9ae8720a6bba271e0f60b6a217f8a5210. Durch das Pinning beziehen sich Code, Compose-Datei und Installationsanleitung auf denselben Stand.
Offiziell vorausgesetzt werden Git, Docker Engine oder Docker Desktop, Docker Compose v2, curl, ein freier Port 3002 sowie ausreichend Hostkapazität, um mehrere Dienste zu bauen und auszuführen. Eine verifizierte Mindestgröße für die Maschine veröffentlicht Firecrawl nicht.
Quellcode festschreiben
Firecrawl klonen und
v2.11.162auschecken. Der resultierende Commit wird dokumentiert, damit ein später zuständiges Betriebsteam das Deployment reproduzieren kann.Basisumgebung anlegen
Die Datenbankauthentifizierung wird ausschließlich für diese Auswertung in einem vertrauenswürdigen Netz deaktiviert. Der PostgreSQL-Datenbankname bleibt
postgres; als Passwort dient eine zufällige Zeichenfolge mit mindestens 32 Zeichen. Die.envgehört nicht ins Repository.Alle Dienste bauen und prüfen
Nach dem Start des Compose-Stacks zeigt
docker compose ps --allden Zustand aller Dienste. Dauerhaft laufende Dienste sollten aktiv, einmalige Initialisierungsschritte abgeschlossen sein.Einen echten Scrape nachweisen
Nach der Readiness-Prüfung folgt ein Aufruf von
/v2/scrapefürhttps://example.com. Eine bloße Readiness-Antwort reicht nicht aus.
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
git rev-parse HEAD

db_password="$(openssl rand -hex 32)"
printf 'USE_DB_AUTHENTICATION=false\nPOSTGRES_USER=postgres\nPOSTGRES_PASSWORD=%s\nPOSTGRES_DB=postgres\n' \
  "$db_password" > .env

docker compose up --build -d
docker compose ps --all

curl --fail --silent --show-error --max-time 5 \
  http://localhost:3002/v0/health/readiness

curl --fail-with-body --silent --show-error --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
Der Scrape gilt erst dann als bestanden, wenn die Antwort success: true, zurückgegebenes Markdown und Metadaten mit statusCode: 200 enthält. Die genauen Metadaten können je nach Ziel variieren. Ist die Readiness-Prüfung erfolgreich, der Scrape aber nicht, müssen die API- und Playwright-Logs untersucht werden: Der grüne Herzschlag hat diese Pfade nicht getestet.
Einen Prüfbericht für die technische Übergabe sichern
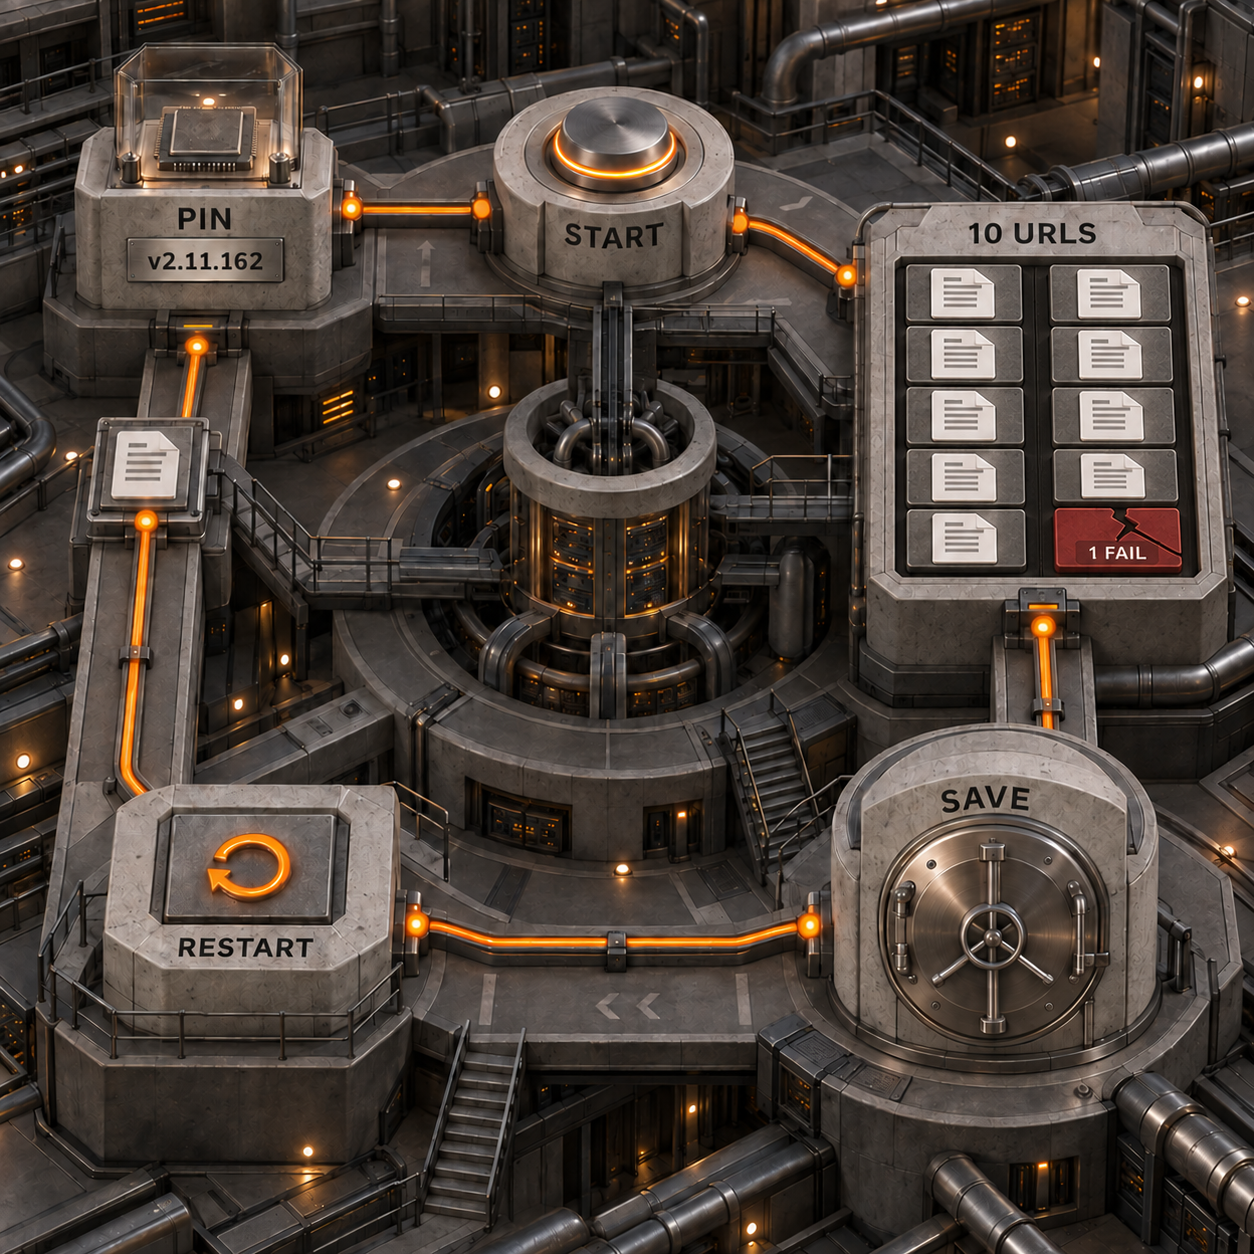
Eine Installation ist erst verifiziert, wenn ihre Rohbelege die Terminalsitzung überdauern. Das folgende Skript startet im Repository der festgeschriebenen Version. Es legt ein Verzeichnis mit Zeitstempel an und speichert darin Hostspezifikation, exakte Version, Build-Dauer, Containerstatus, Readiness-Ausgabe, 10 rohe Scrape-Antworten, eine Zusammenfassung, einen Ressourcen-Snapshot, die Neustartausgabe und einen zweiten erfolgreichen Scrape.
Die zehnte URL verwendet die reservierte Domain .invalid. So enthält die Testmenge einen beabsichtigten Fehler, ohne darauf angewiesen zu sein, dass eine reale Website ausfällt. Bei den übrigen neun Zielen handelt es sich um feste öffentliche Seiten. Vor dem Skript muss jq installiert sein, da es den JSON-Inhalt der Anfragen erzeugt und Ergebnisfelder ausliest.
#!/usr/bin/env bash
set -euo pipefail

base_url="${FIRECRAWL_BASE_URL:-http://localhost:3002}"
stamp="$(date -u +%Y%m%dT%H%M%SZ)"
out="firecrawl-verification-${stamp}"
mkdir -p "$out/responses"

actual_release="$(git describe --tags --exact-match)"
[[ "$actual_release" == "v2.11.162" ]] || {
  printf 'Expected v2.11.162, found %s\n' "$actual_release" >&2
  exit 1
}

{
  printf 'checked_at_utc=%s\n' "$(date -u +%FT%TZ)"
  printf 'release=%s\n' "$actual_release"
  printf 'commit=%s\n' "$(git rev-parse HEAD)"
  printf 'cpus=%s\n' "$(getconf _NPROCESSORS_ONLN)"
  awk '/MemTotal/ {printf "memory_kib=%s\n", $2}' /proc/meminfo
  uname -a
  docker version
  docker compose version
} > "$out/host.txt" 2>&1

setup_start="$(date +%s)"
docker compose up --build -d > "$out/compose-up.log" 2>&1
printf '%s\n' "$(( $(date +%s) - setup_start ))" > "$out/setup-seconds.txt"
docker compose ps --all --format json > "$out/containers-before.json"
curl --fail --silent --show-error --max-time 5 \
  "$base_url/v0/health/readiness" > "$out/readiness.json"

targets=(
  https://example.com
  https://example.org
  https://example.net
  https://httpbin.org/html
  https://www.iana.org/help/example-domains
  https://www.rfc-editor.org/rfc/rfc9110
  https://www.w3.org/TR/PNG/iso_8859-1.txt
  https://docs.python.org/3/
  https://www.firecrawl.dev/
  https://fixture-failure.invalid/
)

printf 'index\turl\tcurl_exit\tsuccess\tstatus_code\n' > "$out/summary.tsv"
i=0
for target in "${targets[@]}"; do
  i=$((i + 1))
  response="$out/responses/$(printf '%02d' "$i").json"
  payload="$(jq -n --arg url "$target" \
    '{url:$url,formats:["markdown"],timeout:60000}')"
  if curl --silent --show-error --max-time 75 -X POST \
    "$base_url/v2/scrape" -H 'Content-Type: application/json' \
    -d "$payload" > "$response"; then curl_exit=0; else curl_exit=$?; fi
  success="$(jq -r '.success // false' "$response" 2>/dev/null || printf false)"
  status="$(jq -r '.data.metadata.statusCode // .error // "none"' \
    "$response" 2>/dev/null || printf unreadable)"
  printf '%s\t%s\t%s\t%s\t%s\n' \
    "$i" "$target" "$curl_exit" "$success" "$status" >> "$out/summary.tsv"
done

docker stats --no-stream --format json > "$out/container-stats.json"
docker compose restart > "$out/restart.log" 2>&1
for attempt in $(seq 1 60); do
  if curl --fail --silent --max-time 5 "$base_url/v0/health/readiness" \
    > "$out/readiness-after-restart.json"; then break; fi
  sleep 2
done
docker compose ps --all --format json > "$out/containers-after.json"
jq -n '{url:"https://example.com",formats:["markdown"],timeout:60000}' | \
  curl --fail-with-body --silent --show-error --max-time 75 \
    -X POST "$base_url/v2/scrape" -H 'Content-Type: application/json' -d @- \
    > "$out/restart-scrape.json"

jq -e -s 'all(.[]; .success == true and .data.metadata.statusCode == 200)' \
  "$out/responses/01.json" "$out/restart-scrape.json" >/dev/null
printf 'Saved verification record: %s\n' "$out"
Ein Erfolg darf auf Grundlage dieses Protokolls erst gemeldet werden, wenn sowohl der erste Scrape als auch der Scrape nach dem Neustart bestanden wurden. Auch fehlgeschlagene Antworten gehören ins Archiv. Sie liefern Hinweise auf DNS, ausgehende Verbindungen, Anti-Bot-Verhalten, den Status des Ziels oder den Stack selbst. Wer sie löscht, schwächt den Beleg.
Die Grenzen des Standard-Stacks kennen
Self-hosted Firecrawl umfasst die Kernrouten, aber nicht jede Produktoberfläche von Firecrawl. Zusätzliche Dienste sollten nur eine gemessene Anforderung erfüllen – nicht bloß deshalb hinzukommen, weil es dafür eine Konfigurationsoption gibt.
Für Such- und Abrufoptionen in der Cloud, die über diese Deployment-Entscheidung hinausgehen, ordnet der Vergleich von KI-Such-APIs das weitere Anbieterfeld ein. Ersatzlösungen für den Scraper sind eine eigene Kaufentscheidung.
Für wen sich Firecrawl Self-Hosting am meisten lohnt
Am besten passt das Modell zu Teams, die bereits eine Plattformfunktion und eine konkrete Kontrollanforderung haben. Ein niedriger Seitenpreis allein genügt bei kleinem Volumen nicht.
Ebenso eindeutig sind die ungeeigneten Fälle. Ein Produktteam aus zwei Personen, das nur einen verlässlichen Scrape-Endpunkt benötigt, kauft sich ein unnötiges Betriebsprojekt ein. Auch wer von Agent, Browser, Interact, Screenshots, Seitenaktionen oder verwaltetem erweitertem Scraping abhängt, startet auf der falschen Seite der Funktionsgrenze.
Die 30-Tage-Rechnung: Kontrolle hat einen konkreten Preis
Bei 1,000 und 10,000 einfachen Seiten ist Managed Firecrawl unter den ausdrücklich genannten, konservativen Annahmen günstiger. Das Self-Hosting-Budget setzt einen DigitalOcean Basic Droplet mit 8 vCPUs, 16 GiB RAM und 320 GiB SSD für $96 pro Monat an. Hinzu kommen ein persistentes Volume mit 100 GiB für $10 sowie $19.20 als Ansatz für wöchentliche Backups. Diese Preise führte DigitalOcean am 22. September 2026.
Die Wahl von 16 GiB ist keine offizielle Mindestanforderung. Sie dient ausschließlich der Budgetierung und orientiert sich an der festgeschriebenen Compose-Datei: Dort ist der API-Dienst auf 8 GiB und Playwright auf 4 GiB begrenzt, während Datenbank, Cache, Queue und weitere Prozesse ebenfalls Arbeitsspeicher benötigen. Die richtige Hostgröße lässt sich nur mit einem Lasttest bestimmen.
Der größere Posten ist die Arbeitszeit. Für die ersten 30 Tage setzt diese Rechnung vier Stunden für die Einrichtung und zwei Stunden für Wartung an, jeweils zu Vollkosten von $100 pro Stunde. Das ist eine Annahme, kein Marktpreis, und sollte durch den eigenen Wert ersetzt werden.
Bei Firecrawl Cloud kostet eine einfache gescrapte Seite einen Credit. Im Free-Tarif sind 1,000 Credits für $0 enthalten. Für 10,000 Seiten bei monatlicher Abrechnung kostet Hobby $19 für 5,000 Credits. Weitere 5,000 Hobby-Credits schlagen mit fünf Aufschlägen zu je $5 zu Buche, sodass insgesamt $44 entstehen. Der jährliche Hobby-Preis senkt den effektiven Monatsbetrag auf $41, setzt jedoch eine jährliche Abrechnung voraus.
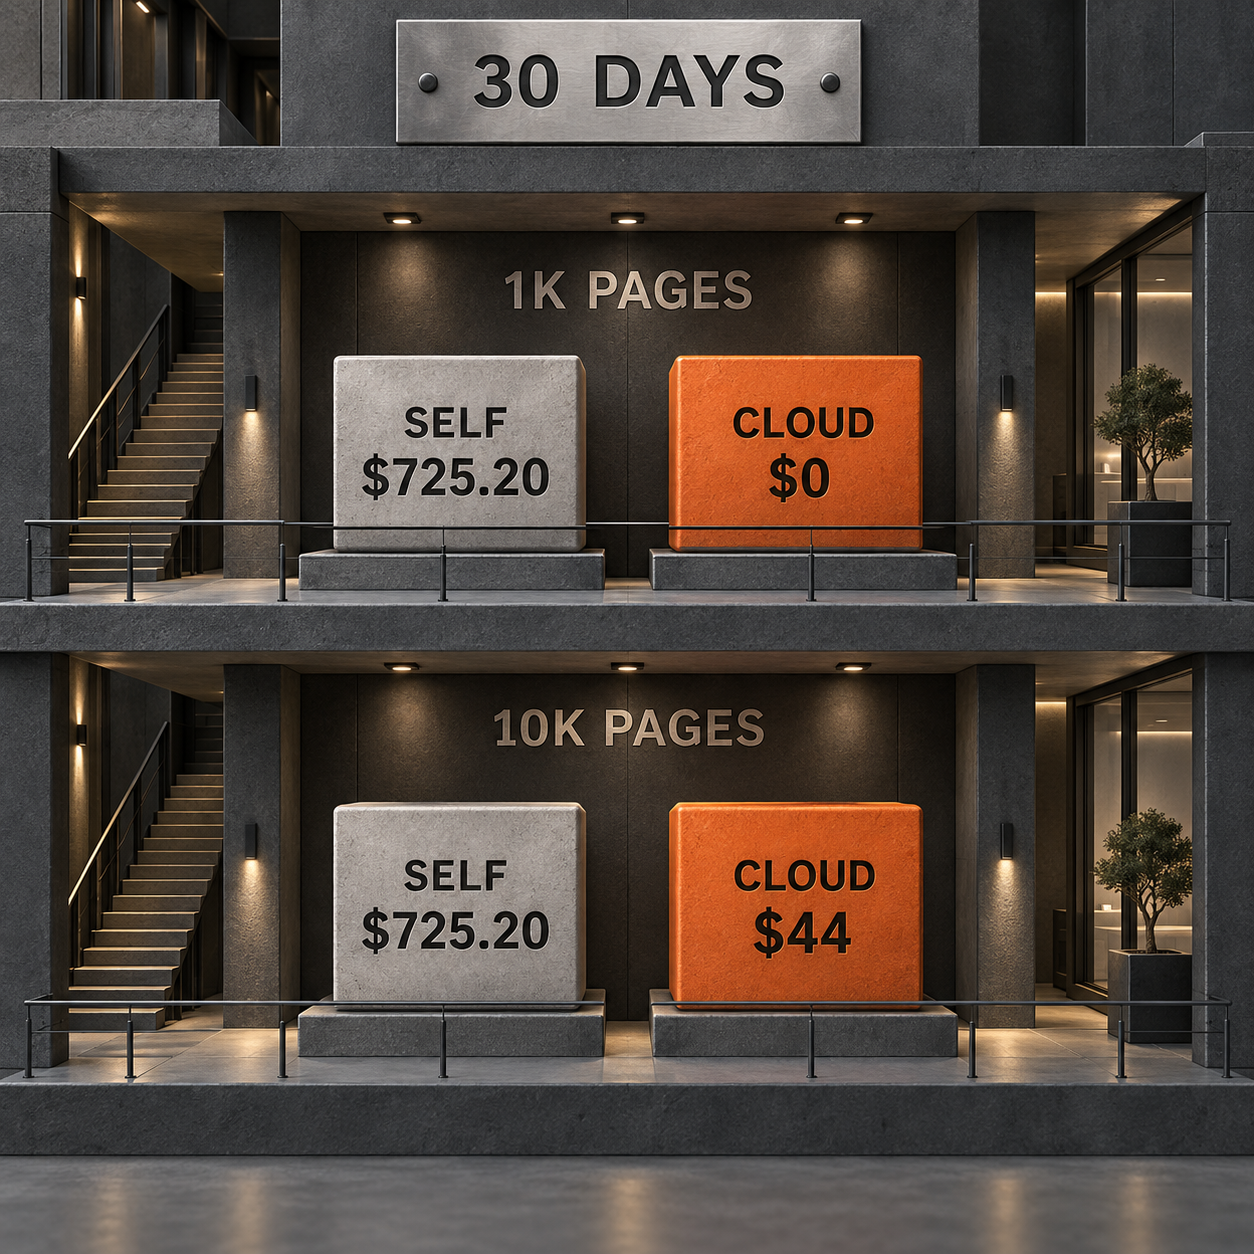
Nicht berücksichtigt sind Steuern, optionale LLM-Anbieter, Proxygebühren, Fire-engine, Hochverfügbarkeit, zusätzlicher Datentransfer, rechtliche Prüfung und Störungsbehebung. Außerdem erhält die Self-Hosting-Maschine keinen unbewiesenen Leistungsvorschuss. In einem beispielhaften Folgemonat entfallen die vier Einrichtungsstunden; damit sinkt das Self-Hosting auf $325.20, liegt aber bei beiden Volumen weiterhin über Cloud.
Die Schlussfolgerung lautet nicht, dass Self-Hosting niemals Geld sparen kann. Einsparungen beginnen erst, wenn ein Benchmark die Kapazität belegt und genügend Volumen die festen Infrastruktur- und Personalkosten auf mehr erfolgreiche Seiten verteilt. Bei 10,000 Seiten muss die Kontrollanforderung in dieser Rechnung einen Aufpreis von $681.20 im ersten Monat rechtfertigen.
Drei Produkte, die diese Lücke sinnvoll nutzen
Das größte Potenzial hat ein Verifizierungspaket: Es macht aus einer mehrdeutigen Installation belastbare Belege, ohne mit Firecrawl selbst zu konkurrieren. Der einzelne Live-Such-Snapshot lieferte acht verwandte Suchanfragen und neun „People Also Ask“-Fragen. Fünf verwandte Suchen betreffen Docker, Docker Compose, kostenlose Nutzung, den Cloud-Vergleich oder API-Schlüssel. Die Fragen thematisieren ausdrücklich, ob Firecrawl teuer und sicher ist.
1. Prüf- und Bereitschaftspaket für Self-Hosting
Das Produkt ist eine lokale CLI mit Bericht für Engineering-Verantwortliche. Sie prüft Version, Host, Compose-Status, den echten Scrape-Pfad, den erwarteten Fehler, das Verhalten nach einem Neustart und offene Punkte für den Produktivbetrieb. Anschließend erstellt sie ein signiertes Archiv zur Prüfung.
Das Nachfragesignal ist eindeutig: Zu den verwandten Google-Suchen gehören Firecrawl self-host Docker, Firecrawl self-host docker compose und Firecrawl self-host API key. Die kleinste verkaufbare Version besteht aus einem Befehl, der festen Testmenge, einem HTML-Bericht und Funktionen zur Schwärzung. Die Einschränkung liegt in der Vielfalt der Umgebungen. Ein Bericht kann belegen, was ausgeführt wurde; er kann kein identisches Verhalten bei jedem Ziel oder künftigen Release versprechen.
2. Kostenplaner für Cloud und Self-Hosting
Dieses Produkt ist ein Deployment-Rechner, der erfolgreiche Seiten, Optionen, Parallelität, Personalkostensatz, Wiederherstellungsziel und benötigte Funktionen berücksichtigt. Er stellt Cloud-Credits den Infrastruktur- und Personalkosten gegenüber und macht jede Annahme sichtbar.
Der Such-Snapshot enthält Firecrawl self-hosted vs cloud; unter „People Also Ask“ finden sich Is Firecrawl expensive? und Is there a free version of Firecrawl available?. Die aktuellen Preisanker sind konkret: $0 für 1,000 Cloud-Credits, bei monatlicher Abrechnung $19 für 5,000 Hobby-Credits und $5 für jeweils weitere 1,000 Hobby-Credits. Das MVP besteht aus einer versionierten Preistabelle und einem exportierbaren Berechnungsblatt. Der Haken ist die Self-Hosting-Kapazität: Ohne Benchmark des Käufers muss der Rechner eine Spanne statt eines erfundenen Break-even-Punkts ausgeben.
3. Blueprint für den gehärteten Produktivbetrieb
Das Produkt ist ein meinungsstarkes Infrastrukturmodul für Teams, die die Auswertung bestanden haben und nun Authentifizierung, TLS, persistente Daten, Backups, Wiederherstellungstests, Monitoring, Secrets und kontrollierten ausgehenden Datenverkehr benötigen.
Das Nachfragesignal verteilt sich auf die „People Also Ask“-Frage Is Firecrawl safe to use? und die verwandte Suche Firecrawl self-host API key. Der Firecrawl-Leitfaden selbst nennt jede noch offene Entscheidung für den Produktivbetrieb. Der Wert liegt somit in Implementierung und Nachweis – nicht darin, die dokumentierte Verantwortung kleinzureden. Das MVP umfasst ein unterstütztes Cloud-Ziel, versionierte Infrastruktur als Code, Warnmeldungen und eine Wiederherstellungsübung. Die Einschränkung ist die Haftung: Ein wiederverwendbares Modul kann die Sicherheits- oder Compliance-Lage eines Kunden nicht zertifizieren.
Grenzen und ein ehrliches Fazit
Firecrawl selbst zu hosten, nur um vor einer Messung des Betriebsaufwands $19 zu sparen, ist keine tragfähige Entscheidung. In der Basisinstallation ist die API-Authentifizierung deaktiviert. Zudem fehlen TLS, persistenter Speicher für PostgreSQL, Redis und RabbitMQ sowie Hochverfügbarkeit. In einem nicht vertrauenswürdigen Netz würde aus einer Abkürzung für die Auswertung ein Sicherheitsfehler.
Der Standard-Stack ist auch nicht funktionsgleich mit Cloud. LLM-Formate benötigen einen Anbieter, Fire-engine wird separat betrieben, und Screenshots sowie Aktionen stehen in den Standardpfaden nicht zur Verfügung. Agent, Browser, Interact, Dashboards und Enterprise-Kontrollen bleiben Cloud-Oberflächen oder erfordern separat geprüfte Dienste.
Weder aus den Compose-Limits noch aus dieser Rechnung sollte eine Dimensionierung für den Produktivbetrieb abgeleitet werden. Eine Arbeitsspeichergrenze ist keine Hostempfehlung. Zuerst wird die feste Testmenge ausgeführt, dann um repräsentative Seiten aus der eigenen Arbeitslast ergänzt. Danach folgen Messungen von Parallelität und Fehlerklassen sowie Tests für die Wiederherstellung von Backups und das Zurückrollen eines Upgrades.
Der stärkste Grund für den nächsten Schritt ist eine Kontrollanforderung des Teams, die Cloud nicht erfüllt. Der schwächste ist das Wort „kostenlos“.
Der konkrete Schritt für Montag
Für die Auswertung erhält eine technische Fachkraft zwei Stunden auf einem kurzlebigen, privaten Host. Dort wird v2.11.162 festgeschrieben, der offizielle einzelne Scrape ausgeführt und anschließend das gespeicherte Prüfskript gestartet. Schlägt der Scrape nach dem Neustart fehl, endet der Test. Danach wird der angesetzte Personalkostensatz von $100 durch den eigenen Vollkostensatz ersetzt und in einem Satz festgehalten, welche Kontrollanforderung erfüllt werden muss. Bleibt dieser Satz vage, ist Cloud die richtige Wahl. Ist er konkret, müssen die Kontrollen für den Produktivbetrieb geplant werden, bevor das Volumen steigt.
Ist Firecrawl teuer?
Das hängt vom Deployment und vom Seitenvolumen ab. Firecrawl Cloud kostet für die ersten 1,000 Credits für einfache Seiten in jedem Monat $0. In dieser Rechnung kosten 10,000 einfache Seiten mit dem monatlich abgerechneten Hobby-Tarif und nutzungsabhängigen Zusatzcredits $44. Der beispielhafte erste Monat im Self-Hosting kostet dagegen $725.20, einschließlich sechs angenommener Arbeitsstunden. Finanziell sinnvoll wird Self-Hosting erst, wenn der eigene Benchmark und die Kontrollanforderungen den festen Aufwand rechtfertigen.
Gibt es eine kostenlose Version von Firecrawl?
Ja. Firecrawl bietet einen Open-Source-Deploymentpfad, und Firecrawl Cloud hat einen Free-Tarif mit 1,000 Credits pro Monat. Open Source beseitigt die Firecrawl-Tarifkosten, nicht aber die Ausgaben für Rechenleistung, Speicher, Sicherheit, Monitoring, Upgrades, Wiederherstellung und Arbeitszeit.
Ist Firecrawl sicher?
Die Basis für diese Auswertung ist nur innerhalb eines vertrauenswürdigen Netzes mit geeigneten Host- und Netzwerkkontrollen sicher. Sie deaktiviert die Datenbankauthentifizierung und enthält weder ein Authentifizierungskonzept für den Produktivbetrieb noch TLS, persistenten Speicher, Hochverfügbarkeit oder Wiederherstellung. Vor einer externen Freigabe müssen diese Kontrollen implementiert und getestet sein.
Wie lässt sich Firecrawl mit Docker Compose selbst hosten?
Erforderlich sind Git, Docker, Docker Compose v2 und curl. Nach dem Auschecken von v2.11.162 wird die Basisdatei .env mit vier Werten angelegt. Anschließend folgen docker compose up --build -d, die Prüfung sämtlicher Dienste, der Readiness-Test und schließlich eine erfolgreiche Antwort auf POST /v2/scrape. Die Rohdaten werden gespeichert, und nach einem Neustart wird der Scrape wiederholt.
Benötigt selbst gehostetes Firecrawl einen API Key?
Die Auswertung im vertrauenswürdigen Netz setzt USE_DB_AUTHENTICATION=false; lokale Anfragen verwenden daher keinen API Key. Für einen öffentlichen Produktivbetrieb reicht das nicht. Firecrawl verlangt dafür ein vollständiges, unterstütztes Identitäts- und Datenbankkonzept sowie Netzwerkkontrollen und TLS. Eine einzelne Umgebungsvariable genügt nicht.
Wenn ein versioniertes, beobachtbares Deployment rund um die eigenen Kontrollanforderungen gefragt ist, bietet der Bereich KI-Produktionssysteme den passenden Einstieg.
- Zuletzt aktualisiert
- 22. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

KI-Agenten: Warum bezahlte Retries eine Freigabe brauchen
Wenn KI-Agenten fertige Renderings selbst verwerfen, wird Qualitätskontrolle zur Kaufentscheidung. So stoppt menschliche Freigabe bezahlte Retries.22. Sept. 2026Build
KI Agent erstellen mit MindStudio: Kosten und Grenzen
Mit MindStudio einen KI Agent erstellen: Die Analyse erklärt Funktionen, Preise, Modellkosten, Teamgrenzen und den belastbaren 20-Datensatz-Prüfplan.22. Sept. 2026Build
Wispr Flow oder Superwhisper: Welche Diktier-App passt?
Wispr Flow oder Superwhisper? Der Vergleich zeigt Preise, Datenschutz, Offline-Modi und Teamfunktionen – samt klarem Entscheidungsweg für den Arbeitsalltag.22. Sept. 2026Build
KI Automatisierung: Agenturen, Preise und Auswahl
Welche Agentur bringt KI Automatisierung zuverlässig in Produktion? Der Vergleich zeigt Anbieter, Preise, Pilotkriterien und sichere Übergaben.22. Sept. 2026Build
Claude Code einrichten: Projects Beta richtig nutzen
Claude Code einrichten, Beta-Zugang prüfen, Kontext zwischen Cloud-Threads teilen und verstehen, welche Grenzen bei Nutzung und lokalen Tools gelten.21. Sept. 2026Build
Kundenservice-Automatisierung mit Jev: Ticket-Routing in der Praxis
Jev routet Support-Tickets, bewertet Schweregrad und Dringlichkeit und zeigt anhand seiner Konfidenzwerte, wann ein Mensch die Entscheidung übernehmen sollte.21. Sept. 2026Build
Claude Code Anleitung: So lädt Claude Code AGENTS.md
Diese Claude Code Anleitung zeigt, wann AGENTS.md ab v2.1.277 direkt geladen wird, welche Dateien Vorrang haben und wie sich das Setup sicher testen lässt.19. Sept. 2026Build