Firecrawl self host: guida a Docker, verifica e costi
Come installare Firecrawl self host con Docker Compose, verificare uno scrape reale e confrontare costi e limiti con Firecrawl Cloud in 30 giorni.



Con Firecrawl self host si ottiene il controllo del codice e dell'infrastruttura, non un servizio gestito gratuito. Occorre fissare la versione v2.11.162, dimostrare il funzionamento con una vera richiesta /v2/scrape, conservare le prove e infine quantificare il lavoro operativo. Nel prospetto su 30 giorni, Firecrawl Cloud costa $0 per 1,000 pagine base e $44 per 10,000, mentre il modello self-host arriva a $725.20 nel primo mese includendo le sei ore di lavoro operativo esplicitamente ipotizzate.
In breve: a questi volumi Cloud costa meno
Firecrawl self host ha senso quando l'accesso al codice sorgente, il controllo dell'infrastruttura o un perimetro di rete obbligatorio giustificano la gestione dell'intero stack. Cloud è la scelta più lineare quando basta trasformare URL pubblici in contenuti puliti. Firecrawl arriva alla stessa conclusione nella sua guida al self-hosting: Cloud è il percorso supportato più rapido verso la produzione, mentre con il self-hosting tutta la macchina operativa passa sotto la responsabilità del team.
Le cifre del self-hosting sono un budget, non una promessa di capacità. Firecrawl non pubblica una configurazione host minima verificata e in questo ambiente non è stato possibile provare se la macchina preventivata regga uno dei due volumi. Il sovrapprezzo si giustifica davvero con il controllo. Qualsiasi risparmio va dimostrato sulle proprie pagine, con il proprio livello di concorrenza e il proprio tasso di errore.
Cosa offre davvero Firecrawl self host
Si ottiene il motore principale di Firecrawl su un'infrastruttura controllata direttamente, insieme all'onere di gestire tutte le dipendenze che lo circondano. Cloud è paragonabile a una cucina professionale con personale; il self-hosting consegna il progetto della cucina. Il progetto è utile, ispezionabile e adattabile, ma non comprende cuochi, controlli antincendio, verifiche della refrigerazione o turno di notte.
Lo stack predefinito della versione fissata supporta le route principali per scrape, crawl, map e search. Include anche l'elaborazione Fetch e Playwright. Dipende inoltre da servizi come PostgreSQL, Redis e RabbitMQ, mentre l'endpoint di readiness non verifica il funzionamento dell'intera catena.
È una distinzione importante: {"status":"ok"} dimostra soltanto che un endpoint HTTP ha risposto. Non prova che una pagina possa uscire dall'host, essere renderizzata, attraversare i worker e tornare in formato Markdown. Uno scrape riuscito è la verifica minima davvero utile.
Installare la release prevista dalla guida
Usare Firecrawl v2.11.162, non il branch mobile main. Il tag è stato creato il 30 luglio 2026 e punta al commit 7666c1f9ae8720a6bba271e0f60b6a217f8a5210. Fissare la versione fa sì che codice, file Compose e istruzioni di configurazione facciano riferimento allo stesso stato del progetto.
I prerequisiti ufficiali sono Git, Docker Engine o Docker Desktop, Docker Compose v2, curl, una porta 3002 disponibile e risorse sufficienti sull'host per compilare ed eseguire più servizi. Firecrawl non pubblica requisiti minimi verificati per la macchina.
Fissare il codice sorgente
Clonare Firecrawl ed eseguire il checkout di
v2.11.162. Registrare il commit risultante, così chi gestirà il sistema in futuro potrà riprodurre il deployment.Creare l'ambiente di base
Disattivare l'autenticazione del database soltanto per questa valutazione su rete fidata, mantenere
postgrescome nome del database PostgreSQL e usare una password casuale di almeno 32 caratteri. Non eseguire il commit di.env.Compilare e controllare ogni servizio
Avviare lo stack Compose, quindi esaminare
docker compose ps --all. I servizi persistenti devono risultare in esecuzione e le inizializzazioni una tantum devono essere completate.Dimostrare uno scrape reale
Controllare la readiness, quindi chiamare
/v2/scrapeperhttps://example.com. La sola risposta di readiness non basta.
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
git rev-parse HEAD

db_password="$(openssl rand -hex 32)"
printf 'USE_DB_AUTHENTICATION=false\nPOSTGRES_USER=postgres\nPOSTGRES_PASSWORD=%s\nPOSTGRES_DB=postgres\n' \
  "$db_password" > .env

docker compose up --build -d
docker compose ps --all

curl --fail --silent --show-error --max-time 5 \
  http://localhost:3002/v0/health/readiness

curl --fail-with-body --silent --show-error --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
Lo scrape supera la verifica solo se la risposta contiene success: true, il Markdown restituito e i metadati con statusCode: 200. I metadati esatti possono variare in base al sito di destinazione. Se la readiness risponde ma lo scrape fallisce, occorre esaminare i log dell'API e di Playwright: il segnale verde non ha esercitato quei percorsi.
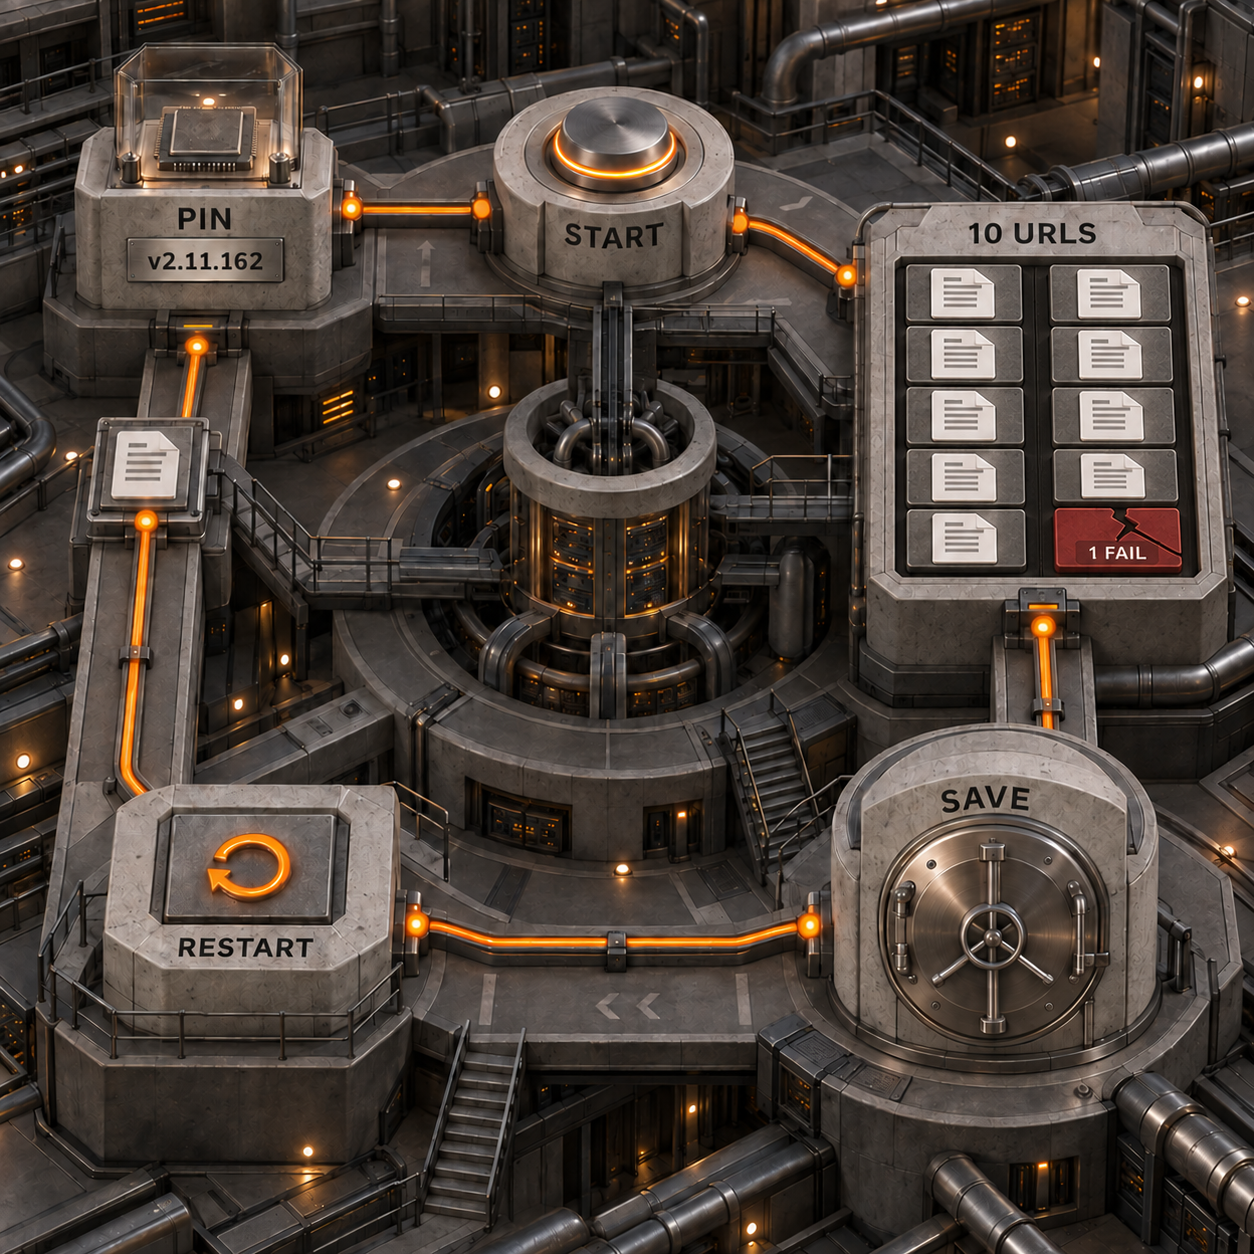
Salvare una verifica da consegnare a un altro tecnico
La configurazione non è verificata finché le prove grezze non sopravvivono alla sessione del terminale. Lo script seguente parte dal repository fissato e crea una directory con data e ora. Al suo interno salva specifiche dell'host, release esatta, tempo di compilazione, stato dei container, output di readiness, 10 risposte grezze di scrape, riepilogo, un'istantanea delle risorse, output del riavvio e un secondo scrape riuscito.
Il decimo URL usa il dominio riservato .invalid, così il set di prova comprende un errore intenzionale senza dipendere dalla rottura di un sito reale. Gli altri nove obiettivi sono pagine pubbliche fisse. Prima di eseguire lo script va installato jq, perché viene usato sia per costruire il JSON delle richieste sia per leggere i campi dei risultati.
#!/usr/bin/env bash
set -euo pipefail

base_url="${FIRECRAWL_BASE_URL:-http://localhost:3002}"
stamp="$(date -u +%Y%m%dT%H%M%SZ)"
out="firecrawl-verification-${stamp}"
mkdir -p "$out/responses"

actual_release="$(git describe --tags --exact-match)"
[[ "$actual_release" == "v2.11.162" ]] || {
  printf 'Expected v2.11.162, found %s\n' "$actual_release" >&2
  exit 1
}

{
  printf 'checked_at_utc=%s\n' "$(date -u +%FT%TZ)"
  printf 'release=%s\n' "$actual_release"
  printf 'commit=%s\n' "$(git rev-parse HEAD)"
  printf 'cpus=%s\n' "$(getconf _NPROCESSORS_ONLN)"
  awk '/MemTotal/ {printf "memory_kib=%s\n", $2}' /proc/meminfo
  uname -a
  docker version
  docker compose version
} > "$out/host.txt" 2>&1

setup_start="$(date +%s)"
docker compose up --build -d > "$out/compose-up.log" 2>&1
printf '%s\n' "$(( $(date +%s) - setup_start ))" > "$out/setup-seconds.txt"
docker compose ps --all --format json > "$out/containers-before.json"
curl --fail --silent --show-error --max-time 5 \
  "$base_url/v0/health/readiness" > "$out/readiness.json"

targets=(
  https://example.com
  https://example.org
  https://example.net
  https://httpbin.org/html
  https://www.iana.org/help/example-domains
  https://www.rfc-editor.org/rfc/rfc9110
  https://www.w3.org/TR/PNG/iso_8859-1.txt
  https://docs.python.org/3/
  https://www.firecrawl.dev/
  https://fixture-failure.invalid/
)

printf 'index\turl\tcurl_exit\tsuccess\tstatus_code\n' > "$out/summary.tsv"
i=0
for target in "${targets[@]}"; do
  i=$((i + 1))
  response="$out/responses/$(printf '%02d' "$i").json"
  payload="$(jq -n --arg url "$target" \
    '{url:$url,formats:["markdown"],timeout:60000}')"
  if curl --silent --show-error --max-time 75 -X POST \
    "$base_url/v2/scrape" -H 'Content-Type: application/json' \
    -d "$payload" > "$response"; then curl_exit=0; else curl_exit=$?; fi
  success="$(jq -r '.success // false' "$response" 2>/dev/null || printf false)"
  status="$(jq -r '.data.metadata.statusCode // .error // "none"' \
    "$response" 2>/dev/null || printf unreadable)"
  printf '%s\t%s\t%s\t%s\t%s\n' \
    "$i" "$target" "$curl_exit" "$success" "$status" >> "$out/summary.tsv"
done

docker stats --no-stream --format json > "$out/container-stats.json"
docker compose restart > "$out/restart.log" 2>&1
for attempt in $(seq 1 60); do
  if curl --fail --silent --max-time 5 "$base_url/v0/health/readiness" \
    > "$out/readiness-after-restart.json"; then break; fi
  sleep 2
done
docker compose ps --all --format json > "$out/containers-after.json"
jq -n '{url:"https://example.com",formats:["markdown"],timeout:60000}' | \
  curl --fail-with-body --silent --show-error --max-time 75 \
    -X POST "$base_url/v2/scrape" -H 'Content-Type: application/json' -d @- \
    > "$out/restart-scrape.json"

jq -e -s 'all(.[]; .success == true and .data.metadata.statusCode == 200)' \
  "$out/responses/01.json" "$out/restart-scrape.json" >/dev/null
printf 'Saved verification record: %s\n' "$out"
Non va dichiarato il successo finché non superano la verifica sia il primo scrape sia quello successivo al riavvio. Vanno conservate anche tutte le risposte di errore: documentano problemi di DNS, traffico in uscita, sistemi anti-bot, stato del sito di destinazione o dello stack. Eliminarle renderebbe il verbale meno utile.
Dove termina lo stack predefinito
Firecrawl in self-hosting comprende le route principali, non l'intera offerta di prodotti Firecrawl. Conviene aggiungere servizi solo quando lo richiede un'esigenza misurata, non perché esiste un'opzione di configurazione.
Per valutare le alternative Cloud di ricerca e recupero dei dati oltre questa scelta di deployment, il confronto tra API di ricerca AI esamina il mercato più ampio. La scelta di scraper sostitutivi è un problema di acquisto distinto.
Chi trae più vantaggio dal self-hosting
I casi più adatti hanno già una funzione di piattaforma e un requisito di controllo. A volumi ridotti, il solo costo inferiore per pagina non basta.
Anche i casi poco adatti sono evidenti. Un team di prodotto di due persone che cerca un solo endpoint di scrape affidabile finirebbe per acquistare un progetto operativo di cui non ha bisogno. Parte inoltre dal lato sbagliato del confine funzionale chi dipende da Agent, Browser, Interact, screenshot, azioni sulle pagine o scraping avanzato gestito.
Il prospetto su 30 giorni: il controllo ha un costo reale
Per 1,000 e 10,000 pagine base, Firecrawl gestito è più economico con queste ipotesi esplicite e prudenti. Il budget self-host usa un Basic Droplet DigitalOcean con 8 vCPU, 16 GiB di RAM e SSD da 320 GiB a $96 al mese, oltre a un Volume persistente da 100 GiB a $10 e una quota di $19.20 per il backup settimanale. DigitalOcean indicava questi prezzi il 22 settembre 2026.
La scelta di 16 GiB non è un requisito minimo ufficiale. È un'ipotesi di budget basata sul file Compose fissato, che limita il servizio API a 8 GiB e Playwright a 4 GiB, mentre database, cache, coda e altri processi hanno comunque bisogno di risorse. Solo un test del carico di lavoro può dimensionare l'host.
Il tempo dell'operatore è la voce più rilevante. Il prospetto ipotizza quattro ore di configurazione e due di manutenzione nei primi 30 giorni, a un costo aziendale di $100 l'ora. È un'ipotesi, non una tariffa di mercato: va sostituita con il proprio dato.
Firecrawl Cloud addebita un credito per ogni pagina base sottoposta a scrape. Il piano Free include 1,000 crediti a $0. Per 10,000 pagine con fatturazione mensile, Hobby costa $19 per 5,000 crediti; altri 5,000 crediti Hobby richiedono cinque incrementi da $5, per un totale di $44. Il prezzo annuale di Hobby riduce il costo mensile effettivo a $41, ma richiede la fatturazione annuale.
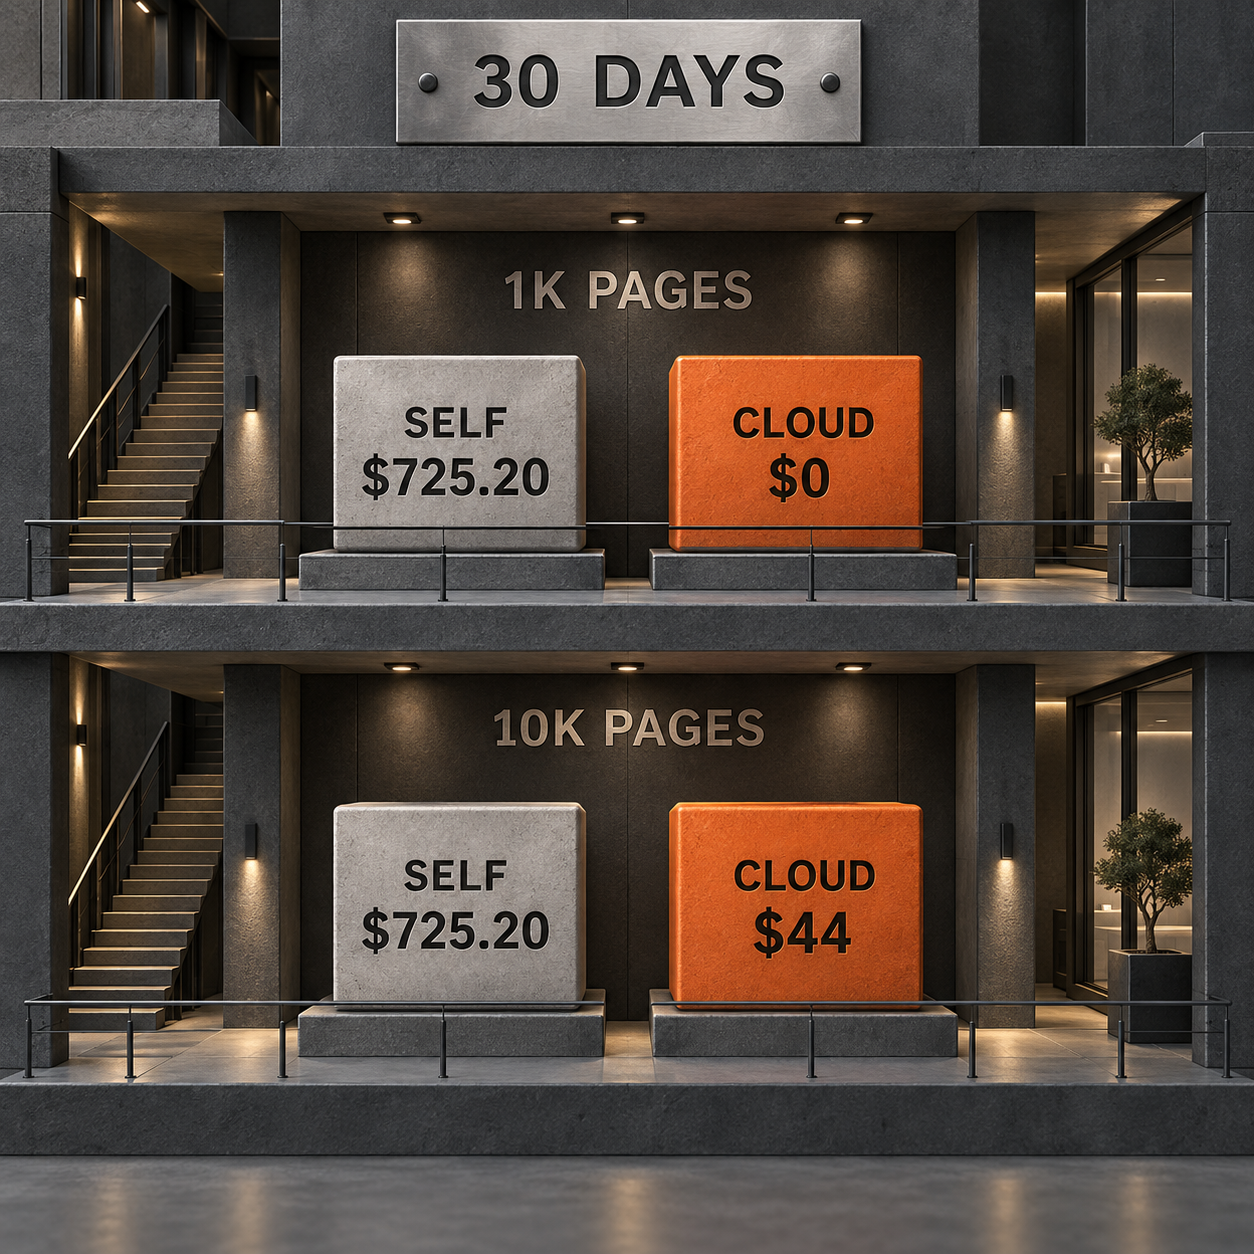
Il modello esclude imposte, provider LLM opzionali, costi dei proxy, Fire-engine, alta disponibilità, traffico eccedente, revisione legale e gestione degli incidenti. Inoltre, non attribuisce alla macchina self-host alcuna capacità non dimostrata. In un mese successivo puramente illustrativo, eliminando le quattro ore di configurazione, il self-hosting scende a $325.20 e rimane comunque più caro di Cloud per entrambi i volumi considerati.
La conclusione non è che il self-hosting non possa mai far risparmiare. Il risparmio inizia soltanto quando un benchmark dimostra la capacità e il volume è sufficiente a distribuire infrastruttura fissa e tempo dell'operatore su più pagine completate. Con 10,000 pagine, in questo prospetto il requisito di controllo deve giustificare un sovrapprezzo di $681.20 nel primo mese.
Tre prodotti da costruire intorno a questa lacuna
L'opportunità più solida è il pacchetto di verifica: trasforma una configurazione ambigua in prove senza competere con Firecrawl. La singola istantanea della ricerca live ha restituito otto ricerche correlate e nove domande People Also Ask. Cinque ricerche correlate riguardano Docker, Docker Compose, uso gratuito, confronto con Cloud o chiavi API; le domande chiedono esplicitamente se Firecrawl sia costoso e sicuro.
1. Pacchetto di readiness e verifica per il self-hosting
Il prodotto è una CLI locale con report, pensata per chi guida un team di ingegneria. Controlla release, host, stato di Compose, percorso reale dello scrape, errore previsto, comportamento al riavvio e lacune rispetto alla produzione, quindi crea un archivio firmato da sottoporre a revisione.
Il segnale di domanda è diretto: tra le ricerche correlate di Google compaiono Firecrawl self-host Docker, Firecrawl self-host docker compose e Firecrawl self-host API key. La versione minima vendibile comprende un unico comando, il set di test fisso, un report HTML e controlli di oscuramento. Il limite è la varietà degli ambienti: un report può dimostrare che cosa è stato eseguito, ma non può promettere lo stesso comportamento per ogni destinazione o release futura.
2. Calcolatore dei costi Cloud e self-host
Il prodotto è un calcolatore di deployment che accetta pagine completate, opzioni, concorrenza, costo orario dell'operatore, obiettivo di ripristino e funzionalità richieste. Affianca i crediti Cloud ai costi di infrastruttura e personale, mostrando ogni ipotesi.
L'istantanea della ricerca include Firecrawl self-hosted vs cloud, mentre People Also Ask comprende Is Firecrawl expensive? e Is there a free version of Firecrawl available?. I riferimenti di prezzo live sono concreti: $0 per 1,000 crediti Cloud, $19 al mese per 5,000 crediti Hobby e $5 per ogni blocco aggiuntivo di 1,000 crediti Hobby. L'MVP è una tabella dei prezzi versionata con esportazione del prospetto. Resta il problema della capacità self-host: senza il benchmark dell'acquirente, il calcolatore deve mostrare un intervallo, non un falso punto di pareggio.
3. Progetto per l'hardening della produzione
Il prodotto è un modulo infrastrutturale strutturato per i team che hanno superato la valutazione e ora devono aggiungere autenticazione, TLS, dati persistenti, backup, test di ripristino, monitoraggio, segreti e traffico in uscita controllato.
Il segnale di domanda si divide tra la domanda People Also Ask Is Firecrawl safe to use? e la ricerca correlata Firecrawl self-host API key. La guida di Firecrawl elenca tutte le decisioni mancanti per la produzione: il valore sta nell'implementazione e nelle prove, non nel fingere che le responsabilità non fossero documentate. L'MVP comprende un'unica destinazione cloud supportata, codice infrastrutturale legato a una versione, avvisi e una prova di ripristino. Il limite è la responsabilità: un modulo riutilizzabile non può certificare la sicurezza o la conformità del cliente.
Limiti e valutazione onesta
Non conviene gestire Firecrawl in proprio per risparmiare $19 prima di avere misurato il lavoro operativo. La configurazione di base disattiva l'autenticazione API, non include TLS, non aggiunge storage persistente per PostgreSQL, Redis e RabbitMQ e non è ad alta disponibilità. Esporla a una rete non fidata trasformerebbe una scorciatoia di valutazione in un errore di sicurezza.
Non va dato per scontato che lo stack predefinito corrisponda a Cloud funzionalità per funzionalità. I formati LLM richiedono un provider. Fire-engine è separato. Screenshot e azioni non sono disponibili nei percorsi predefiniti. Agent, Browser, Interact, dashboard e controlli enterprise restano funzionalità Cloud oppure richiedono servizi da verificare separatamente.
Le soglie del file Compose e questo prospetto non bastano per dimensionare la produzione. Un limite di memoria non equivale a un host consigliato. Occorre eseguire il set di test fisso, aggiungere pagine rappresentative del proprio carico di lavoro, misurare concorrenza e categorie di errore, quindi provare il ripristino dei backup e il rollback di un aggiornamento.
La ragione più solida per procedere è un requisito di controllo che Cloud non può soddisfare per il team. La più debole è la parola «gratis».
La mossa da fare lunedì
Assegnare a un tecnico una finestra di valutazione di due ore su un host temporaneo e privato. Fissare v2.11.162, eseguire il singolo scrape ufficiale, lanciare lo script di verifica con salvataggio delle prove e interrompere il test se lo scrape successivo al riavvio non riesce. Poi sostituire nel prospetto la tariffa di $100 per l'operatore con il proprio costo aziendale e scrivere una frase che definisca il requisito di controllo. Se resta vaga, scegliere Cloud. Se è concreta, progettare i controlli di produzione prima di aumentare i volumi.
Firecrawl è costoso?
Dipende dal tipo di deployment e dal volume di pagine. Firecrawl Cloud costa $0 per i primi 1,000 crediti di pagine base ogni mese. In questo prospetto, 10,000 pagine base costano $44 con Hobby mensile e consumo aggiuntivo, mentre il primo mese self-host illustrativo costa $725.20 includendo sei ore ipotetiche di lavoro dell'operatore. Il self-hosting acquista senso economico solo quando benchmark e requisiti di controllo ne giustificano il lavoro fisso.
Esiste una versione gratuita di Firecrawl?
Sì. Firecrawl offre un percorso di deployment open source e Firecrawl Cloud ha un piano Free con 1,000 crediti al mese. L'open source elimina il costo del piano Firecrawl, non quello di capacità di calcolo, storage, sicurezza, monitoraggio, aggiornamenti, ripristino e lavoro dell'operatore.
Firecrawl è sicuro?
La configurazione di valutazione è sicura soltanto all'interno di una rete fidata, con controlli adeguati su host e rete. Disattiva l'autenticazione del database e non comprende un progetto di autenticazione per la produzione, TLS, storage persistente, alta disponibilità o ripristino. La sicurezza dipende dall'implementazione e dal collaudo di questi controlli prima dell'esposizione.
Come si installa Firecrawl self host con Docker Compose?
Installare Git, Docker, Docker Compose v2 e curl. Eseguire il checkout di v2.11.162, creare il file .env di base con quattro valori, lanciare docker compose up --build -d, controllare ogni servizio, verificare la readiness e infine richiedere una risposta riuscita da POST /v2/scrape. Salvare i risultati grezzi e ripetere lo scrape dopo un riavvio.
Firecrawl self host richiede una chiave API?
La valutazione su rete fidata imposta USE_DB_AUTHENTICATION=false, quindi le richieste locali non usano una chiave API. Non è un'architettura per la produzione pubblica. Firecrawl indica che l'autenticazione in produzione richiede una progettazione completa e supportata di identità e database, oltre a controlli di rete e TLS. Una sola variabile d'ambiente non basta.
Per un deployment legato a una versione precisa, osservabile e costruito intorno ai propri requisiti di controllo, sono disponibili i servizi per sistemi AI in produzione.
- Ultimo aggiornamento
- 22 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Agenti AI: perché i retry a pagamento richiedono approvazione umana
Un agente ha speso $5.48 prima della verifica umana. Ecco perché i retry a pagamento degli agenti AI richiedono un’autorizzazione indipendente.22 set 2026Build
Agenti AI con MindStudio: quanto costa e quando conviene
MindStudio conviene davvero per creare agenti AI? Analisi di workflow, prezzi, limiti e costi operativi, con un piano di prova su 20 record.22 set 2026Build
Wispr Flow o Superwhisper: confronto tra app di dettatura AI
Wispr Flow o Superwhisper? Confronto su prezzi, privacy, dettatura offline e funzioni per team, con un protocollo pratico per scegliere senza slogan.22 set 2026Build
Guida all'automazione AI: le migliori agenzie e quanto costano
Confronta le migliori agenzie di automazione AI per servizi, costi su 90 giorni, supporto, proprietà e uscita. Include un test pilota in 20 casi.22 set 2026Build
Claude Code Projects: guida pratica al coordinatore cloud
Scopri come usare Claude Code Projects per coordinare thread cloud, condividere il contesto e controllare branch, consumi e limiti della beta.21 set 2026Build
Gestione ticket assistenza con Jev: routing e controllo umano
Scopri come usare Jev per classificare i ticket, stimare gravità e urgenza e automatizzare il routing, mantenendo il controllo umano sui casi incerti.21 set 2026Build
Configurare Claude Code per leggere AGENTS.md
Scopri come configurare Claude Code per leggere AGENTS.md, scegliere il file di istruzioni corretto e gestire provider, versioni e file CLAUDE.md.19 set 2026Build