Firecrawl Docker: cómo autohospedarlo y cuánto cuesta
Aprende a desplegar Firecrawl con Docker, verificar un scraping real y comparar el costo de autohospedarlo frente a Firecrawl Cloud durante 30 días.



Alojar Firecrawl Docker en infraestructura propia aporta control sobre el código y la infraestructura, no un servicio gestionado gratuito. Fija v2.11.162, demuestra una solicitud real a /v2/scrape, guarda las pruebas y después calcula el trabajo operativo. En la hoja de costos de 30 días que aparece más adelante, Firecrawl Cloud cuesta $0 por 1,000 páginas básicas y $44 por 10,000, mientras que el modelo autohospedado llega a $725.20 durante el primer mes al contabilizar seis horas de operación asumidas de forma explícita.
La respuesta breve: Cloud gana en costos a esta escala
Conviene autohospedar Firecrawl cuando el acceso al código, el control de la infraestructura o un límite de red obligatorio justifican hacerse cargo del stack. Si el objetivo solo es convertir URL públicas en contenido limpio, conviene elegir Cloud. Firecrawl llega a la misma conclusión en su guía de autohospedaje: Cloud es la vía con soporte más rápida para llegar a producción; con el autohospedaje, el equipo asume la operación de toda la maquinaria.
Las cifras del autohospedaje son un presupuesto, no una promesa de capacidad. Firecrawl no publica un tamaño mínimo de host verificado, y en esta ejecución no fue posible comprobar si la máquina presupuestada soporta alguno de esos volúmenes. La razón legítima para aceptar el sobreprecio es el control. El ahorro debe demostrarse con las páginas, la concurrencia y la tasa de fallos de cada caso real.
Qué ofrece realmente el autohospedaje
Se obtiene el motor central de Firecrawl en infraestructura bajo control propio, junto con la responsabilidad de operar todas las dependencias que lo rodean. Cloud se parece a una cocina comercial con personal; el autohospedaje, a recibir los planos de esa cocina. Los planos son útiles, se pueden inspeccionar y admiten adaptaciones, pero no incluyen cocineros, inspecciones contra incendios, controles de refrigeración ni turno nocturno.
El stack predeterminado de la versión fijada admite las rutas principales de scrape, crawl, map y search. También incluye Fetch y el procesamiento con Playwright. A su vez, depende de servicios como PostgreSQL, Redis y RabbitMQ, y el endpoint de disponibilidad no verifica que toda la cadena funcione.
Ese límite importa: {"status":"ok"} solo confirma que respondió un endpoint HTTP. No demuestra que una página pueda salir del host, renderizarse, pasar por los workers y regresar como Markdown. Un scraping exitoso es la prueba mínima útil.
Firecrawl Docker: instala la versión indicada en la guía
Usa Firecrawl v2.11.162, no la rama cambiante main. El tag se creó el 30 de julio de 2026 y apunta al commit 7666c1f9ae8720a6bba271e0f60b6a217f8a5210. Fijar la versión permite que el código, el archivo de Compose y las instrucciones de configuración correspondan al mismo estado del proyecto.
Los requisitos oficiales son Git, Docker Engine o Docker Desktop, Docker Compose v2, curl, un puerto 3002 disponible y capacidad suficiente en el host para compilar y ejecutar varios servicios. Firecrawl no publica una configuración mínima de máquina verificada.
Fija el código fuente
Clona Firecrawl y cambia a
v2.11.162. Registra el commit resultante para que otro operador pueda reproducir el despliegue más adelante.Crea el entorno base
Desactiva la autenticación de la base de datos solo para esta evaluación en una red de confianza, conserva
postgrescomo nombre de la base de datos de PostgreSQL y utiliza una contraseña aleatoria de al menos 32 caracteres. No incluyas.enven ningún commit.Compila e inspecciona todos los servicios
Inicia el stack de Compose y revisa
docker compose ps --all. Los servicios persistentes deben estar en ejecución y las tareas de inicialización de una sola ejecución deben haber finalizado.Demuestra un scraping real
Comprueba la disponibilidad y luego llama a
/v2/scrapeconhttps://example.com. No te detengas en la respuesta del endpoint de disponibilidad.
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
git rev-parse HEAD

db_password="$(openssl rand -hex 32)"
printf 'USE_DB_AUTHENTICATION=false\nPOSTGRES_USER=postgres\nPOSTGRES_PASSWORD=%s\nPOSTGRES_DB=postgres\n' \
  "$db_password" > .env

docker compose up --build -d
docker compose ps --all

curl --fail --silent --show-error --max-time 5 \
  http://localhost:3002/v0/health/readiness

curl --fail-with-body --silent --show-error --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
El scraping solo pasa la prueba si la respuesta contiene success: true, devuelve contenido Markdown e incluye metadatos con statusCode: 200. Los metadatos exactos pueden variar según el destino. Si la disponibilidad responde correctamente pero el scraping falla, revisa los logs de la API y de Playwright: el indicador verde no recorrió esas rutas.
Guarda un registro de verificación que pueda usar otro ingeniero
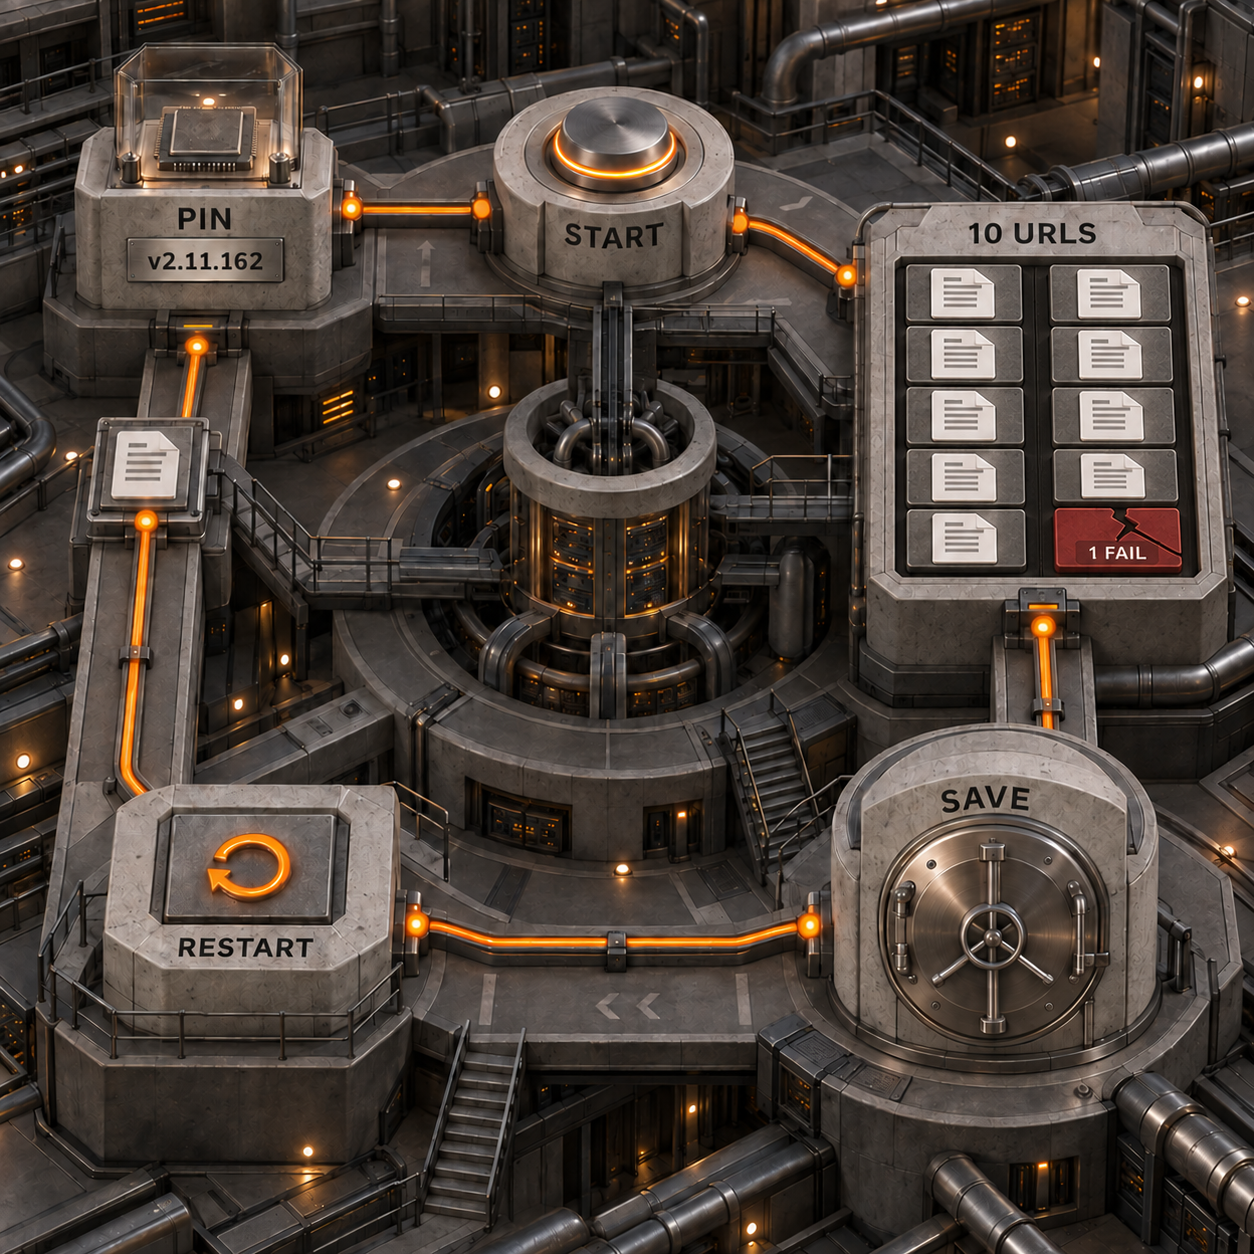
Una instalación no está verificada hasta que sus pruebas sin procesar sobreviven a la sesión de terminal. El siguiente script parte del repositorio con versión fijada y escribe un directorio con marca de tiempo que contiene las especificaciones del host, la versión exacta, el tiempo de compilación, el estado de los contenedores, la salida de disponibilidad, 10 respuestas de scraping sin procesar, un resumen, una captura de recursos, la salida del reinicio y un segundo scraping exitoso.
La décima URL utiliza el dominio reservado .invalid, de modo que el conjunto contiene un fallo deliberado sin depender de la caída de un sitio real. Los otros nueve destinos son páginas públicas fijas. Instala jq antes de ejecutar el script, ya que lo utiliza para construir el JSON de las solicitudes y leer los campos de los resultados.
#!/usr/bin/env bash
set -euo pipefail

base_url="${FIRECRAWL_BASE_URL:-http://localhost:3002}"
stamp="$(date -u +%Y%m%dT%H%M%SZ)"
out="firecrawl-verification-${stamp}"
mkdir -p "$out/responses"

actual_release="$(git describe --tags --exact-match)"
[[ "$actual_release" == "v2.11.162" ]] || {
  printf 'Expected v2.11.162, found %s\n' "$actual_release" >&2
  exit 1
}

{
  printf 'checked_at_utc=%s\n' "$(date -u +%FT%TZ)"
  printf 'release=%s\n' "$actual_release"
  printf 'commit=%s\n' "$(git rev-parse HEAD)"
  printf 'cpus=%s\n' "$(getconf _NPROCESSORS_ONLN)"
  awk '/MemTotal/ {printf "memory_kib=%s\n", $2}' /proc/meminfo
  uname -a
  docker version
  docker compose version
} > "$out/host.txt" 2>&1

setup_start="$(date +%s)"
docker compose up --build -d > "$out/compose-up.log" 2>&1
printf '%s\n' "$(( $(date +%s) - setup_start ))" > "$out/setup-seconds.txt"
docker compose ps --all --format json > "$out/containers-before.json"
curl --fail --silent --show-error --max-time 5 \
  "$base_url/v0/health/readiness" > "$out/readiness.json"

targets=(
  https://example.com
  https://example.org
  https://example.net
  https://httpbin.org/html
  https://www.iana.org/help/example-domains
  https://www.rfc-editor.org/rfc/rfc9110
  https://www.w3.org/TR/PNG/iso_8859-1.txt
  https://docs.python.org/3/
  https://www.firecrawl.dev/
  https://fixture-failure.invalid/
)

printf 'index\turl\tcurl_exit\tsuccess\tstatus_code\n' > "$out/summary.tsv"
i=0
for target in "${targets[@]}"; do
  i=$((i + 1))
  response="$out/responses/$(printf '%02d' "$i").json"
  payload="$(jq -n --arg url "$target" \
    '{url:$url,formats:["markdown"],timeout:60000}')"
  if curl --silent --show-error --max-time 75 -X POST \
    "$base_url/v2/scrape" -H 'Content-Type: application/json' \
    -d "$payload" > "$response"; then curl_exit=0; else curl_exit=$?; fi
  success="$(jq -r '.success // false' "$response" 2>/dev/null || printf false)"
  status="$(jq -r '.data.metadata.statusCode // .error // "none"' \
    "$response" 2>/dev/null || printf unreadable)"
  printf '%s\t%s\t%s\t%s\t%s\n' \
    "$i" "$target" "$curl_exit" "$success" "$status" >> "$out/summary.tsv"
done

docker stats --no-stream --format json > "$out/container-stats.json"
docker compose restart > "$out/restart.log" 2>&1
for attempt in $(seq 1 60); do
  if curl --fail --silent --max-time 5 "$base_url/v0/health/readiness" \
    > "$out/readiness-after-restart.json"; then break; fi
  sleep 2
done
docker compose ps --all --format json > "$out/containers-after.json"
jq -n '{url:"https://example.com",formats:["markdown"],timeout:60000}' | \
  curl --fail-with-body --silent --show-error --max-time 75 \
    -X POST "$base_url/v2/scrape" -H 'Content-Type: application/json' -d @- \
    > "$out/restart-scrape.json"

jq -e -s 'all(.[]; .success == true and .data.metadata.statusCode == 200)' \
  "$out/responses/01.json" "$out/restart-scrape.json" >/dev/null
printf 'Saved verification record: %s\n' "$out"
No publiques una afirmación de éxito basada en este registro hasta que hayan pasado tanto el primer scraping como el realizado después del reinicio. Conserva también cada respuesta fallida. Un fallo aporta información sobre DNS, salida de red, medidas antibot, estado del destino o el propio stack; eliminarlo resta valor al registro.
Identifica dónde termina el stack predeterminado
Firecrawl autohospedado incluye las rutas principales, no todas las funciones del producto Firecrawl. Añade servicios cuando exista una necesidad medida, no solo porque haya una opción de configuración.
Para evaluar opciones de búsqueda y recuperación en Cloud más allá de esta decisión de despliegue, la comparativa de API de búsqueda con IA analiza el panorama general de proveedores. Los scrapers alternativos constituyen una decisión de compra distinta.
Quién obtiene más valor del autohospedaje
Los mejores candidatos ya cuentan con una función de plataforma y tienen una necesidad concreta de control. Un menor precio por página no basta cuando el volumen es pequeño.
Los casos poco adecuados son igual de claros. Un equipo de producto de dos personas que solo busca un endpoint de scraping confiable estaría comprando un proyecto de operaciones innecesario. También empieza del lado equivocado del límite funcional cualquier equipo que dependa de Agent, Browser, Interact, capturas de pantalla, acciones sobre páginas o scraping avanzado gestionado.
Hoja de costos de 30 días: el control tiene un precio real
Con 1,000 y 10,000 páginas básicas, Firecrawl gestionado resulta más barato bajo supuestos explícitos y conservadores. El presupuesto autohospedado utiliza un Droplet Basic de DigitalOcean con 8 vCPU, 16 GiB de RAM y un SSD de 320 GiB por $96 al mes, más un Volume persistente de 100 GiB por $10 y una provisión semanal para copias de seguridad de $19.20. DigitalOcean mostraba esos precios el 22 de septiembre de 2026.
La elección de 16 GiB no representa un mínimo oficial. Es un supuesto presupuestario basado en el archivo de Compose de la versión fijada, que limita el servicio de API a 8 GiB y Playwright a 4 GiB mientras la base de datos, la caché, la cola y los demás procesos también necesitan recursos. Solo una prueba de carga permite dimensionar el host.
El tiempo de operación es la partida más alta. Esta hoja asume cuatro horas de instalación y dos horas de mantenimiento durante los primeros 30 días, con un costo laboral total de $100 por hora. Es un supuesto, no una tarifa de mercado. Sustitúyelo por la cifra correspondiente a tu equipo.
Firecrawl Cloud cobra un crédito por cada página básica procesada. El plan Free incluye 1,000 créditos por $0. Para 10,000 páginas con facturación mensual, Hobby cuesta $19 por 5,000 créditos y otros 5,000 créditos de Hobby cuestan cinco incrementos de $5, lo que da un total de $44. El precio anual de Hobby reduce ese mes efectivo a $41, pero exige facturación anual.
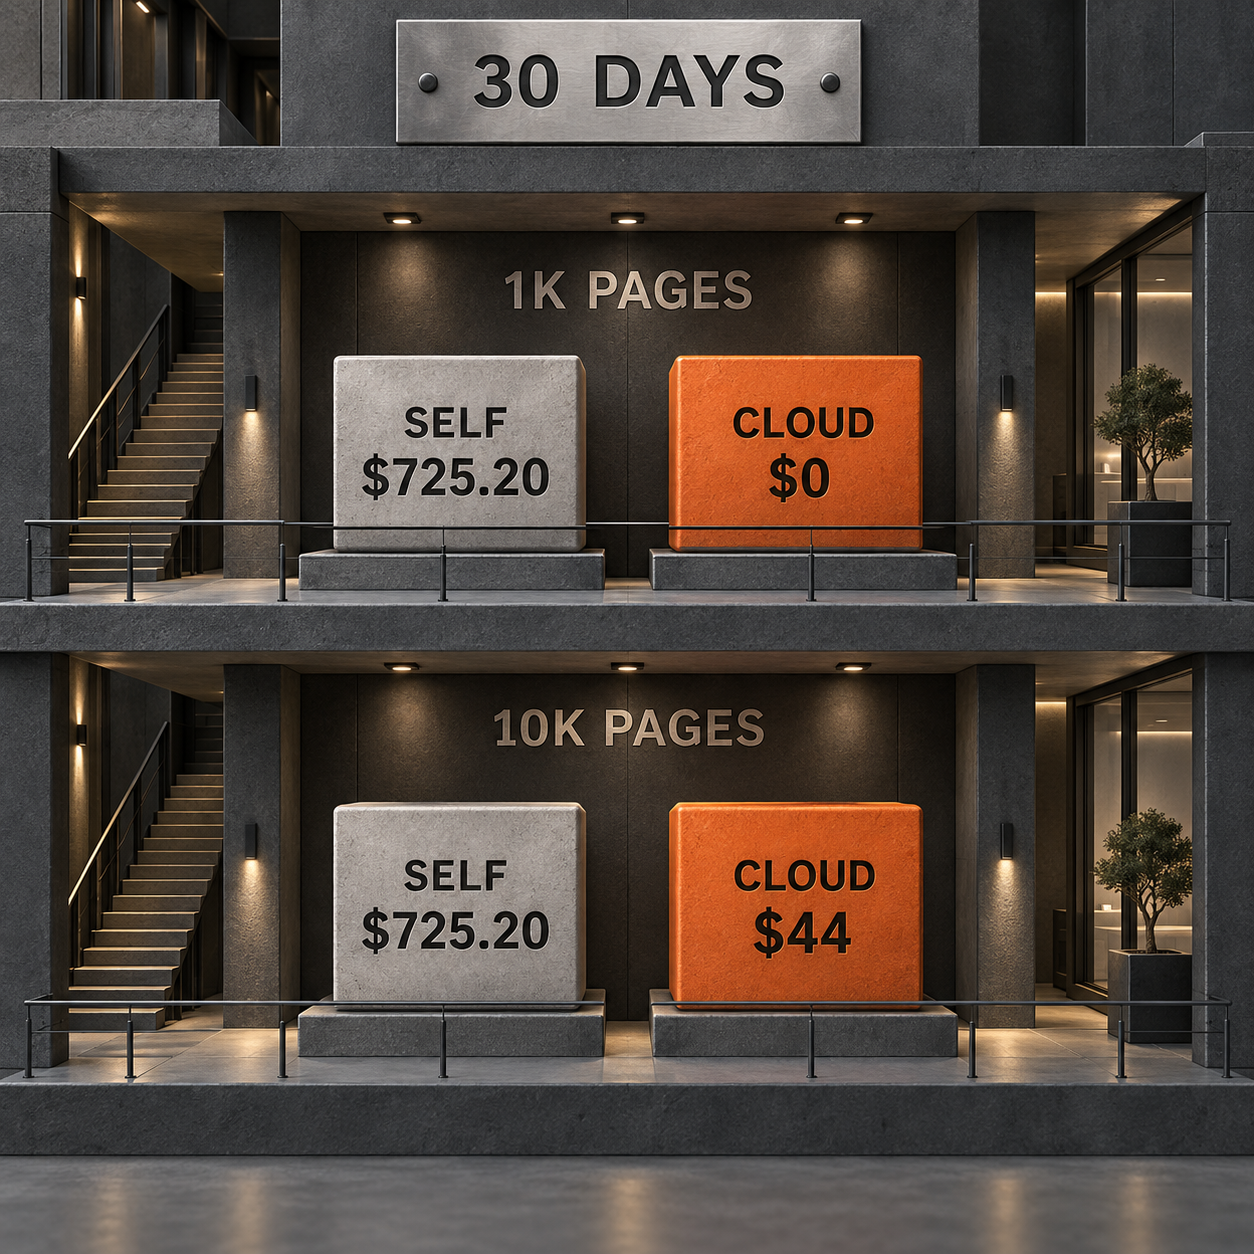
Este modelo excluye impuestos, proveedores de LLM opcionales, tarifas de proxy, Fire-engine, alta disponibilidad, transferencia excedente, revisión legal y resolución de incidentes. Tampoco atribuye a la máquina autohospedada una capacidad que no se haya demostrado. En el ejemplo de un mes posterior, eliminar las cuatro horas de instalación reduce el autohospedaje a $325.20, todavía por encima de Cloud en ambos volúmenes modelados.
La conclusión no es que el autohospedaje nunca pueda ahorrar dinero. El ahorro comienza únicamente después de que un benchmark demuestre la capacidad y haya suficiente volumen para repartir el costo fijo de infraestructura y operación entre más páginas procesadas con éxito. Con 10,000 páginas, el requisito de control debe justificar un sobreprecio de $681.20 durante el primer mes de esta hoja.
Tres productos que aprovechan esta brecha
La oportunidad más sólida es el paquete de verificación, porque convierte una instalación ambigua en pruebas sin competir con Firecrawl. La única captura de búsqueda en vivo devolvió ocho búsquedas relacionadas y nueve preguntas de People Also Ask. Cinco búsquedas relacionadas tratan sobre Docker, Docker Compose, uso gratuito, comparación con Cloud o claves de API, mientras que las preguntas consultan de forma explícita si Firecrawl es caro y seguro.
1. Paquete de preparación y verificación para autohospedaje
El producto consiste en una CLI local y un informe para responsables de ingeniería. Comprueba la versión, el host, el estado de Compose, la ruta real de scraping, el fallo esperado, el comportamiento tras reiniciar y las carencias de producción; después genera un archivo firmado para revisión.
La señal de demanda es directa: entre las búsquedas relacionadas de Google aparecen Firecrawl self-host Docker, Firecrawl self-host docker compose y Firecrawl self-host API key. La versión vendible más pequeña consta de un comando, el conjunto fijo, un informe HTML y controles de redacción de datos. El reto es la variedad de entornos. Un informe puede demostrar qué se ejecutó, pero no garantizar que todos los destinos o versiones futuras se comporten de la misma manera.
2. Calculadora de costos: Cloud frente a autohospedaje
El producto es una calculadora de despliegue que recibe como variables las páginas procesadas con éxito, las opciones, la concurrencia, la tarifa del operador, el objetivo de recuperación y las funciones necesarias. Presenta los créditos de Cloud junto con el costo de infraestructura y trabajo, y hace visible cada supuesto.
La captura de búsqueda incluye Firecrawl self-hosted vs cloud, y entre las preguntas de People Also Ask están Is Firecrawl expensive? y Is there a free version of Firecrawl available?. Las referencias de precios vigentes son concretas: $0 por 1,000 créditos de Cloud, $19 al mes por 5,000 créditos de Hobby y $5 por cada 1,000 créditos adicionales de Hobby. El MVP es una tabla de precios versionada con exportación de la hoja de cálculo. El reto es la capacidad del entorno autohospedado: sin el benchmark del comprador, la calculadora debe mostrar un intervalo, no un punto de equilibrio ficticio.
3. Plano para endurecer un despliegue de producción
El producto es un módulo de infraestructura prescriptivo para equipos que superaron la evaluación y ahora necesitan autenticación, TLS, datos persistentes, copias de seguridad, pruebas de restauración, monitoreo, secretos y salida de red controlada.
La señal de demanda se reparte entre la pregunta de People Also Ask Is Firecrawl safe to use? y la búsqueda relacionada Firecrawl self-host API key. La propia guía de Firecrawl enumera todas las decisiones pendientes para producción, así que el valor está en la implementación y las pruebas, no en fingir que esas responsabilidades no estaban documentadas. El MVP abarca un destino de nube compatible, código de infraestructura con versión fijada, alertas y un simulacro de recuperación. El reto es la responsabilidad: un módulo reutilizable no puede certificar la postura de seguridad o cumplimiento de un cliente.
Límites y conclusión sin rodeos
No autohospedes Firecrawl para ahorrar $19 antes de medir el trabajo operativo. La configuración base desactiva la autenticación de la API, no tiene TLS, no añade almacenamiento duradero para PostgreSQL, Redis y RabbitMQ y no ofrece alta disponibilidad. Exponerla a una red que no sea de confianza convertiría un atajo de evaluación en un error de seguridad.
No des por hecho que el stack predeterminado reproduce todas las funciones de Cloud. Los formatos con LLM necesitan un proveedor. Fire-engine se instala por separado. Las capturas de pantalla y las acciones no están disponibles en las rutas predeterminadas. Agent, Browser, Interact, los paneles de control y los controles empresariales siguen siendo funciones de Cloud o requieren servicios verificados por separado.
No dimensionemos producción a partir de los límites de Compose ni de esta hoja. Un límite de memoria no equivale a una configuración de host recomendada. Ejecuta el conjunto fijo, añade páginas representativas de tu propia carga de trabajo, mide la concurrencia y las clases de fallos, y después prueba la restauración de copias de seguridad y la reversión de una actualización.
La razón más sólida para continuar es un requisito de control que Cloud no pueda satisfacer para el equipo. La más débil es la palabra «gratis».
El paso para el lunes
Asigna a un ingeniero una ventana de evaluación de dos horas en un host privado y desechable. Fija v2.11.162, ejecuta el scraping individual de la guía oficial, corre el script de verificación guardado y detente si el scraping posterior al reinicio no pasa. Después sustituye la tarifa de operador de $100 de la hoja por tu costo total y escribe una frase que nombre el requisito de control. Si la frase es vaga, usa Cloud. Si es concreta, planifica los controles de producción antes de aumentar el volumen.
¿Firecrawl es caro?
Depende del despliegue y del volumen de páginas. Firecrawl Cloud cuesta $0 por los primeros 1,000 créditos mensuales de páginas básicas. En esta hoja, 10,000 páginas básicas cuestan $44 con Hobby mensual más pago por uso, mientras que el primer mes autohospedado de ejemplo cuesta $725.20 con seis horas de operación asumidas. El autohospedaje solo tiene sentido financiero cuando el benchmark y los requisitos de control justifican su trabajo fijo.
¿Hay una versión gratuita de Firecrawl?
Sí. Firecrawl ofrece una vía de despliegue open source, y Firecrawl Cloud tiene un plan Free con 1,000 créditos al mes. El código abierto elimina el cargo del plan de Firecrawl, no el costo de cómputo, almacenamiento, seguridad, monitoreo, actualizaciones, recuperación y tiempo de operación.
¿Es seguro usar Firecrawl?
La configuración base de evaluación solo es segura dentro de una red de confianza con controles adecuados de host y red. Desactiva la autenticación de la base de datos y no incluye un diseño de autenticación para producción, TLS, almacenamiento duradero, alta disponibilidad ni recuperación. La seguridad depende de implementar y probar esos controles antes de exponer el servicio.
¿Cómo se autohospeda Firecrawl con Docker Compose?
Instala Git, Docker, Docker Compose v2 y curl. Cambia a v2.11.162, crea el archivo .env base con cuatro valores, ejecuta docker compose up --build -d, inspecciona todos los servicios, comprueba la disponibilidad y después exige una respuesta exitosa de POST /v2/scrape. Guarda los resultados sin procesar y repite el scraping después de reiniciar.
¿Firecrawl autohospedado necesita una clave de API?
La evaluación en una red de confianza establece USE_DB_AUTHENTICATION=false, por lo que sus solicitudes locales no utilizan una clave de API. Eso no constituye un diseño para producción pública. Firecrawl indica que la autenticación en producción requiere un diseño completo y compatible de identidad y base de datos, además de controles de red y TLS. Una sola variable de entorno no basta.
Si necesitas un despliegue observable, con versión fijada y diseñado alrededor de tus requisitos de control, consulta sistemas de IA en producción.
- Última actualización
- 22 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Agentes de IA: cuándo un reintento necesita aprobación humana
Un agente rechazó resultados y compró nuevas renderizaciones antes de la revisión humana. Así se impone aprobación en cada reintento de pago.22 sept 2026Build
MindStudio AI bajo la lupa: precios, funciones y límites
Analizamos MindStudio, sus precios y límites, y calculamos el costo real de crear agentes de IA sin código para flujos de trabajo empresariales.22 sept 2026Build
Superwhisper o Wispr Flow: qué herramienta de dictado conviene más
Compara Superwhisper y Wispr Flow en precio, privacidad, plataformas y correcciones para elegir la herramienta de dictado que mejor se adapta a cada trabajo.22 sept 2026Build
Automatización de procesos con IA: qué agencia elegir
Compara agencias de automatización de procesos con IA por precio, soporte, pruebas y entrega. Incluye un modelo de costos a 90 días para elegir con criterio.22 sept 2026Build
Claude Code Projects: guía para coordinar tareas en paralelo
Aprende a configurar Claude Code Projects, repartir tareas entre hilos en la nube y controlar el contexto, el consumo y los límites de la beta.21 sept 2026Build
Automatización de atención al cliente con Jev: guía práctica
Aprende a usar Jev para clasificar tickets, medir su gravedad y detectar urgencia, con umbrales de confianza y revisión humana antes de automatizar.21 sept 2026Build
Claude Code y AGENTS.md: cómo activar las instrucciones compartidas
Configura Claude Code para que lea AGENTS.md, elige el modo correcto, comprueba qué archivo carga y evita fallos por proveedor, versión o configuración.19 sept 2026Build