Firecrawl API com hospedagem própria: instalação e custos
Entenda como instalar a Firecrawl API em infraestrutura própria, validar scrapes reais e comparar o custo operacional com o Firecrawl Cloud em 30 dias.



Hospedar a Firecrawl API por conta própria dá controle sobre o código e a infraestrutura, mas não entrega um serviço gerenciado de graça. Fixe a versão v2.11.162, comprove uma chamada real a /v2/scrape, guarde as evidências e só então calcule o trabalho operacional. Na planilha de 30 dias abaixo, o Firecrawl Cloud custa $0 para 1,000 páginas básicas e $44 para 10,000. Já o modelo em infraestrutura própria chega a $725.20 no primeiro mês quando entram na conta as seis horas de operação assumidas explicitamente.
Firecrawl API: nesta escala, Cloud vence no custo
Hospede o Firecrawl por conta própria quando o acesso ao código, o controle da infraestrutura ou uma fronteira de rede obrigatória justificarem assumir toda a stack. Escolha o Cloud quando a necessidade for apenas transformar URLs públicas em conteúdo limpo. O próprio Firecrawl chega à mesma conclusão em seu guia de self-hosting: o Cloud é o caminho mais rápido e com suporte até a produção; na hospedagem própria, sua equipe responde por toda a operação.
Os valores da hospedagem própria são um orçamento, não uma promessa de capacidade. O Firecrawl não publica uma configuração mínima de máquina já validada, e este ambiente não permitiu testar se o servidor cotado sustenta qualquer um dos volumes. Controle é o motivo defensável para pagar mais. Qualquer economia precisa ser comprovada com suas páginas, sua concorrência e sua taxa de falhas.
O que você realmente ganha com a hospedagem própria
Você recebe o núcleo do Firecrawl em uma infraestrutura sob seu controle — e também a responsabilidade de operar todas as dependências ao redor dele. Pense no Cloud como uma cozinha profissional com equipe; o self-hosting entrega a planta dessa cozinha. A planta pode ser inspecionada, adaptada e tem valor, mas não inclui cozinheiros, vistoria contra incêndio, inspeção dos refrigeradores nem turno da noite.
A stack padrão fixada oferece as rotas principais de scrape, crawl, map e search. O processamento com Fetch e Playwright está incluído. A stack também depende de serviços como PostgreSQL, Redis e RabbitMQ, e o endpoint de prontidão não confirma que toda essa cadeia funciona.
Essa diferença importa porque {"status":"ok"} mostra apenas que um endpoint HTTP respondeu. Não prova que uma página consegue sair da máquina, renderizar, atravessar os workers e voltar em Markdown. Um scrape bem-sucedido é a evidência mínima aceitável.
Como instalar a versão do Firecrawl com Docker Compose
Use o Firecrawl v2.11.162, não o branch main, que muda continuamente. A tag foi criada em 30 de julho de 2026 e aponta para o commit 7666c1f9ae8720a6bba271e0f60b6a217f8a5210. Fixar a versão mantém o código, o arquivo do Compose e as instruções de instalação na mesma referência.
Os pré-requisitos oficiais são Git, Docker Engine ou Docker Desktop, Docker Compose v2, curl, a porta 3002 disponível e capacidade suficiente na máquina para compilar e executar vários serviços. O Firecrawl não publica uma configuração mínima de hardware validada.
Fixe o código-fonte
Clone o Firecrawl e faça checkout de
v2.11.162. Registre o commit resultante para que outra pessoa consiga reproduzir o deploy no futuro.Crie o ambiente básico
Desative a autenticação do banco de dados apenas nesta avaliação em rede confiável, mantenha
postgrescomo nome do banco PostgreSQL e use uma senha aleatória de pelo menos 32 caracteres. Não faça commit do.env.Compile e inspecione todos os serviços
Suba a stack do Compose e confira
docker compose ps --all. Os serviços contínuos devem estar em execução, e as tarefas de inicialização pontuais devem ter sido concluídas.Comprove um scrape real
Verifique a prontidão e depois chame
/v2/scrapeparahttps://example.com. Não encerre a validação ao receber apenas a resposta de prontidão.
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
git rev-parse HEAD

db_password="$(openssl rand -hex 32)"
printf 'USE_DB_AUTHENTICATION=false\nPOSTGRES_USER=postgres\nPOSTGRES_PASSWORD=%s\nPOSTGRES_DB=postgres\n' \
  "$db_password" > .env

docker compose up --build -d
docker compose ps --all

curl --fail --silent --show-error --max-time 5 \
  http://localhost:3002/v0/health/readiness

curl --fail-with-body --silent --show-error --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
O scrape só passa quando a resposta contém success: true, Markdown retornado e metadados com statusCode: 200. Os metadados exatos podem variar conforme o destino. Se a prontidão passar e o scrape falhar, examine os logs da API e do Playwright: o sinal verde de vida não exercitou esses caminhos.
Como salvar um registro de verificação reutilizável
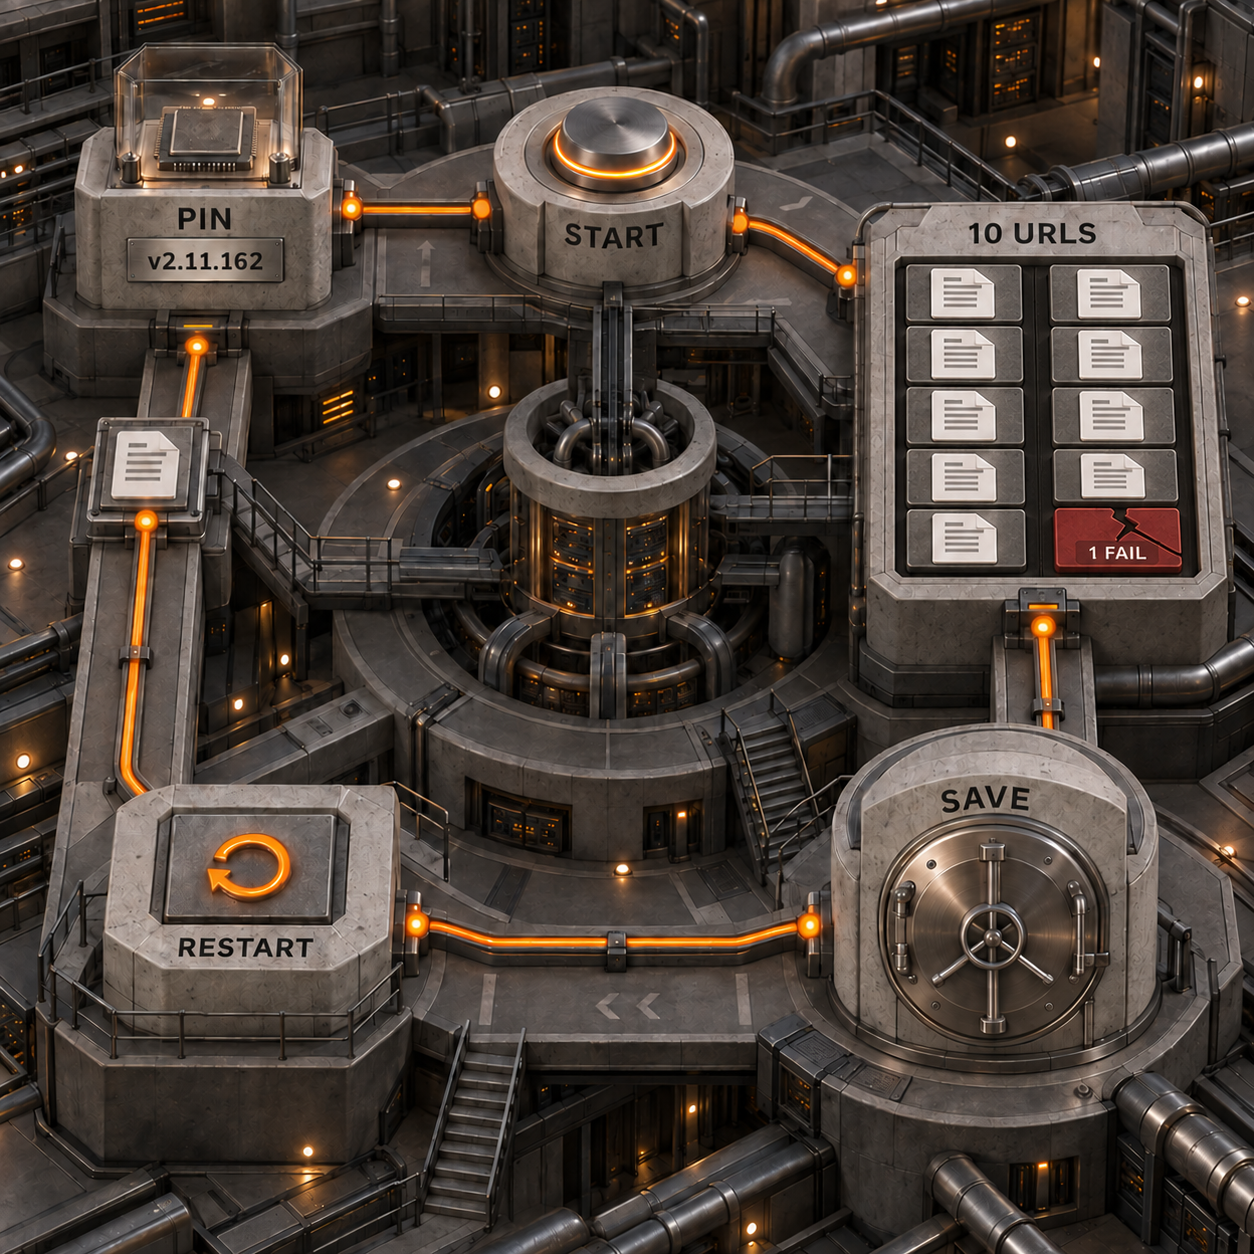
A instalação só está verificada quando as evidências brutas sobrevivem à sessão do terminal. Partindo do repositório na versão fixada, o script abaixo grava um diretório com timestamp que reúne as especificações da máquina, a versão exata, o tempo de build, o estado dos contêineres, a resposta de prontidão, 10 respostas brutas de scrape, um resumo, uma captura de recursos, o resultado da reinicialização e um segundo scrape bem-sucedido.
A décima URL usa o domínio reservado .invalid, portanto o conjunto inclui uma falha proposital sem depender da indisponibilidade de um site real. Os outros nove destinos são páginas públicas fixas. Instale jq antes de executar o script, pois ele monta o JSON das requisições e lê os campos dos resultados.
#!/usr/bin/env bash
set -euo pipefail

base_url="${FIRECRAWL_BASE_URL:-http://localhost:3002}"
stamp="$(date -u +%Y%m%dT%H%M%SZ)"
out="firecrawl-verification-${stamp}"
mkdir -p "$out/responses"

actual_release="$(git describe --tags --exact-match)"
[[ "$actual_release" == "v2.11.162" ]] || {
  printf 'Expected v2.11.162, found %s\n' "$actual_release" >&2
  exit 1
}

{
  printf 'checked_at_utc=%s\n' "$(date -u +%FT%TZ)"
  printf 'release=%s\n' "$actual_release"
  printf 'commit=%s\n' "$(git rev-parse HEAD)"
  printf 'cpus=%s\n' "$(getconf _NPROCESSORS_ONLN)"
  awk '/MemTotal/ {printf "memory_kib=%s\n", $2}' /proc/meminfo
  uname -a
  docker version
  docker compose version
} > "$out/host.txt" 2>&1

setup_start="$(date +%s)"
docker compose up --build -d > "$out/compose-up.log" 2>&1
printf '%s\n' "$(( $(date +%s) - setup_start ))" > "$out/setup-seconds.txt"
docker compose ps --all --format json > "$out/containers-before.json"
curl --fail --silent --show-error --max-time 5 \
  "$base_url/v0/health/readiness" > "$out/readiness.json"

targets=(
  https://example.com
  https://example.org
  https://example.net
  https://httpbin.org/html
  https://www.iana.org/help/example-domains
  https://www.rfc-editor.org/rfc/rfc9110
  https://www.w3.org/TR/PNG/iso_8859-1.txt
  https://docs.python.org/3/
  https://www.firecrawl.dev/
  https://fixture-failure.invalid/
)

printf 'index\turl\tcurl_exit\tsuccess\tstatus_code\n' > "$out/summary.tsv"
i=0
for target in "${targets[@]}"; do
  i=$((i + 1))
  response="$out/responses/$(printf '%02d' "$i").json"
  payload="$(jq -n --arg url "$target" \
    '{url:$url,formats:["markdown"],timeout:60000}')"
  if curl --silent --show-error --max-time 75 -X POST \
    "$base_url/v2/scrape" -H 'Content-Type: application/json' \
    -d "$payload" > "$response"; then curl_exit=0; else curl_exit=$?; fi
  success="$(jq -r '.success // false' "$response" 2>/dev/null || printf false)"
  status="$(jq -r '.data.metadata.statusCode // .error // "none"' \
    "$response" 2>/dev/null || printf unreadable)"
  printf '%s\t%s\t%s\t%s\t%s\n' \
    "$i" "$target" "$curl_exit" "$success" "$status" >> "$out/summary.tsv"
done

docker stats --no-stream --format json > "$out/container-stats.json"
docker compose restart > "$out/restart.log" 2>&1
for attempt in $(seq 1 60); do
  if curl --fail --silent --max-time 5 "$base_url/v0/health/readiness" \
    > "$out/readiness-after-restart.json"; then break; fi
  sleep 2
done
docker compose ps --all --format json > "$out/containers-after.json"
jq -n '{url:"https://example.com",formats:["markdown"],timeout:60000}' | \
  curl --fail-with-body --silent --show-error --max-time 75 \
    -X POST "$base_url/v2/scrape" -H 'Content-Type: application/json' -d @- \
    > "$out/restart-scrape.json"

jq -e -s 'all(.[]; .success == true and .data.metadata.statusCode == 200)' \
  "$out/responses/01.json" "$out/restart-scrape.json" >/dev/null
printf 'Saved verification record: %s\n' "$out"
Não publique uma alegação de sucesso com base nesse registro até que o primeiro scrape e o scrape após a reinicialização tenham passado. Guarde também todas as respostas com falha. Elas revelam informações sobre DNS, saída de rede, mecanismos antibot, status do destino ou a própria stack; descartá-las torna o registro menos útil.
Onde termina a stack padrão
O Firecrawl self-hosted inclui as rotas principais, não todos os recursos oferecidos pela Firecrawl. Acrescente serviços somente quando uma necessidade medida exigir, e não apenas porque existe uma opção de configuração.
Para avaliar opções de busca e recuperação no Cloud além desta decisão de deploy, o comparativo de APIs de busca para IA analisa outros fornecedores. Substituir a ferramenta de scraping é uma decisão de compra diferente.
Quem mais se beneficia do Firecrawl self-hosted
Os melhores candidatos já têm uma equipe de plataforma e uma exigência de controle. Um preço menor por página, sozinho, não basta em volumes pequenos.
Os casos inadequados são igualmente claros. Uma equipe de produto com duas pessoas que só quer um endpoint de scrape confiável está comprando um projeto de operações do qual não precisava. Quem depende de Agent, Browser, Interact, capturas de tela, ações na página ou scraping avançado gerenciado também começa do lado errado dessa divisão de recursos.
Planilha de 30 dias: controle tem custo real
Para 1,000 e 10,000 páginas básicas, o Firecrawl gerenciado sai mais barato sob premissas explícitas e conservadoras. O orçamento da hospedagem própria usa um Droplet Basic da DigitalOcean com 8 vCPUs, 16 GiB de RAM e SSD de 320 GiB por $96 mensais, além de um Volume persistente de 100 GiB por $10 e uma reserva de $19.20 para backup semanal. A DigitalOcean informava esses preços em 22 de setembro de 2026.
A escolha de 16 GiB não é um mínimo oficial. É uma premissa de orçamento baseada no arquivo do Compose fixado, que limita o serviço da API a 8 GiB e o Playwright a 4 GiB, enquanto banco de dados, cache, fila e outros processos ainda precisam de memória. Só um teste com a carga real pode dimensionar a máquina.
O tempo de quem opera é a maior linha da conta. Esta planilha assume quatro horas de instalação e duas de manutenção nos primeiros 30 dias, a uma taxa total de $100 por hora. É uma premissa, não um valor de mercado. Substitua pelo seu próprio custo.
O Firecrawl Cloud cobra um crédito por página básica processada. O plano Free inclui 1,000 créditos por $0. Para 10,000 páginas no pagamento mensal, o Hobby custa $19 por 5,000 créditos, e outros 5,000 créditos Hobby exigem cinco blocos adicionais de $5, totalizando $44. O preço anual do Hobby reduz esse mês efetivo para $41, mas exige cobrança anual.
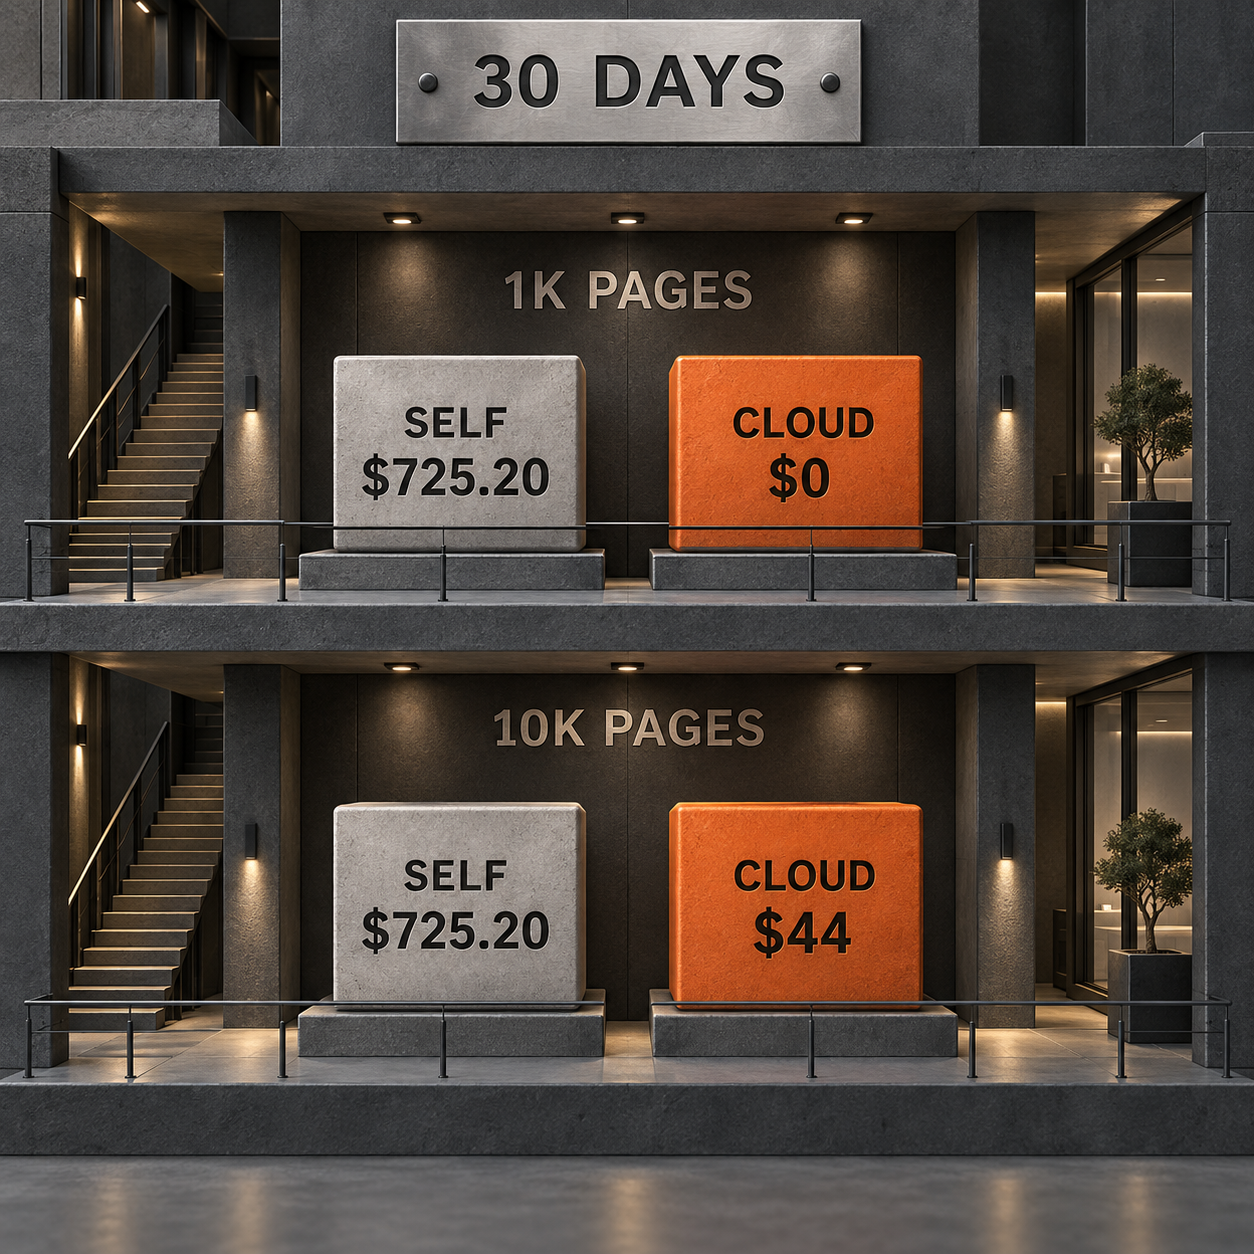
O modelo não inclui impostos, provedores de LLM opcionais, custos de proxy, Fire-engine, alta disponibilidade, transferência excedente, análise jurídica nem correção de incidentes. Também não atribui à máquina própria uma capacidade que ainda não foi comprovada. Em um exemplo de mês posterior, retirar as quatro horas de instalação reduz o self-hosting para $325.20, ainda acima do Cloud nos dois volumes modelados.
A conclusão não é que a hospedagem própria jamais possa economizar dinheiro. A economia só começa depois que um benchmark comprova a capacidade e há volume suficiente para diluir os custos fixos de infraestrutura e operação entre mais páginas processadas com sucesso. Com 10,000 páginas, a exigência de controle precisa justificar um prêmio de $681.20 no primeiro mês desta planilha.
Três produtos que aproveitam essa lacuna
A oportunidade mais forte é o pacote de verificação, pois ele transforma uma instalação ambígua em evidência sem concorrer com o próprio Firecrawl. A única captura de busca ao vivo retornou oito pesquisas relacionadas e nove perguntas do People Also Ask. Cinco pesquisas relacionadas tratam de Docker, Docker Compose, uso gratuito, comparação com o Cloud ou chaves de API, enquanto as perguntas querem saber explicitamente se o Firecrawl é caro e seguro.
1. Pacote de prontidão e verificação para self-hosting
O produto seria uma CLI local acompanhada de um relatório para líderes de engenharia. Ele verificaria versão, máquina, estado do Compose, caminho real do scrape, falha esperada, comportamento após reinicialização e lacunas para produção; no fim, geraria um arquivo assinado para revisão.
O sinal de demanda é direto: as pesquisas relacionadas do Google incluem Firecrawl self-host Docker, Firecrawl self-host docker compose e Firecrawl self-host API key. A menor versão vendável reúne um comando, o conjunto fixo de testes, um relatório HTML e controles para ocultar dados sensíveis. O desafio é a variedade de ambientes. Um relatório comprova o que foi executado, mas não pode prometer o mesmo comportamento para qualquer destino ou versão futura.
2. Calculadora de custos: Cloud versus self-hosted
O produto seria uma calculadora de deploy que recebe páginas processadas com sucesso, opções, concorrência, custo do operador, objetivo de recuperação e recursos obrigatórios. Ela colocaria os créditos do Cloud ao lado dos custos de infraestrutura e trabalho, sempre deixando cada premissa visível.
A captura de busca inclui Firecrawl self-hosted vs cloud, e o People Also Ask traz Is Firecrawl expensive? e Is there a free version of Firecrawl available?. As referências de preço ao vivo são concretas: $0 por 1,000 créditos no Cloud, $19 mensais por 5,000 créditos Hobby e $5 por mais 1,000 créditos Hobby. O MVP é uma tabela de preços versionada com exportação da planilha. O desafio é a capacidade da hospedagem própria: sem o benchmark do comprador, a calculadora precisa mostrar um intervalo em vez de inventar um ponto de equilíbrio.
3. Blueprint de preparação para produção
O produto seria um módulo de infraestrutura opinativo para equipes que concluíram a avaliação e agora precisam de autenticação, TLS, dados persistentes, backups, testes de restauração, monitoramento, segredos e saída de rede controlada.
O sinal de demanda se divide entre a pergunta Is Firecrawl safe to use?, do People Also Ask, e a pesquisa relacionada Firecrawl self-host API key. O próprio guia do Firecrawl enumera todas as decisões pendentes para produção; portanto, o valor está na implementação e nas evidências, não em fingir que essas responsabilidades não estavam documentadas. O MVP oferece um ambiente de nuvem com suporte, código de infraestrutura com versão fixada, alertas e um exercício de recuperação. O desafio é a responsabilidade legal. Um módulo reutilizável não pode certificar a postura de segurança ou conformidade do cliente.
Limites e a avaliação honesta
Não hospede o Firecrawl por conta própria para economizar $19 antes de medir o trabalho operacional. A configuração básica desativa a autenticação da API, não oferece TLS, não adiciona armazenamento durável para PostgreSQL, Redis e RabbitMQ e não tem alta disponibilidade. Expô-la a uma rede não confiável transformaria um atalho de avaliação em um erro de segurança.
Não suponha que a stack padrão reproduz todos os recursos do Cloud. Formatos com LLM precisam de um provedor. O Fire-engine é separado. Capturas de tela e ações não estão disponíveis nos caminhos padrão. Agent, Browser, Interact, painéis e controles empresariais continuam sendo superfícies do Cloud ou exigem serviços validados à parte.
Não dimensione a produção pelos limites do Compose nem por esta planilha. Um limite de memória não é uma recomendação de máquina. Execute o conjunto fixo, acrescente páginas representativas da sua carga, meça a concorrência e as classes de falha e depois teste a restauração de backup e o rollback de uma atualização.
O melhor motivo para avançar é uma exigência de controle que o Cloud não consegue atender para a equipe. O pior é a palavra “grátis”.
O que fazer na segunda-feira
Dê a uma pessoa da engenharia uma janela de duas horas em uma máquina descartável e privada. Fixe v2.11.162, faça o scrape único do guia oficial, execute o script de verificação com evidências salvas e pare se o scrape após a reinicialização não passar. Depois, troque a taxa de $100 da planilha pelo custo real da sua operação e escreva uma frase que nomeie a exigência de controle. Se a frase for vaga, escolha o Cloud. Se for concreta, planeje os controles de produção antes de aumentar o volume.
O Firecrawl é caro?
Depende do modelo de deploy e do volume de páginas. O Firecrawl Cloud custa $0 nos primeiros 1,000 créditos mensais para páginas básicas. Nesta planilha, 10,000 páginas básicas custam $44 com o Hobby mensal e o pagamento por uso, enquanto o primeiro mês ilustrativo da hospedagem própria custa $725.20 com seis horas assumidas de operação. O self-hosting só faz sentido financeiro quando seu benchmark e suas exigências de controle justificam o trabalho fixo.
Existe uma versão gratuita do Firecrawl?
Sim. O Firecrawl oferece um caminho de deploy open source, e o Firecrawl Cloud tem um plano Free com 1,000 créditos mensais. O código aberto elimina a cobrança do plano Firecrawl, não os custos de computação, armazenamento, segurança, monitoramento, atualizações, recuperação e trabalho operacional.
É seguro usar o Firecrawl?
A configuração de avaliação só é segura dentro de uma rede confiável, com controles adequados na máquina e na rede. Ela desativa a autenticação do banco de dados e não inclui um projeto de autenticação para produção, TLS, armazenamento durável, alta disponibilidade nem recuperação. A segurança depende da implementação e do teste desses controles antes de qualquer exposição.
Como hospedar o Firecrawl com Docker Compose?
Instale Git, Docker, Docker Compose v2 e curl. Faça checkout de v2.11.162, crie o .env básico com quatro valores, execute docker compose up --build -d, inspecione todos os serviços, confira a prontidão e exija uma resposta bem-sucedida de POST /v2/scrape. Salve os resultados brutos e repita o scrape depois de uma reinicialização.
O Firecrawl self-hosted precisa de uma chave de API?
A avaliação em rede confiável define USE_DB_AUTHENTICATION=false, portanto suas requisições locais não usam uma chave de API. Isso não é um projeto para produção exposta. Segundo o Firecrawl, a autenticação em produção exige uma solução completa e compatível de identidade e banco de dados, além de controles de rede e TLS. Uma única variável de ambiente não basta.
Se você precisa de um deploy com versão fixada e observabilidade, desenhado em torno das suas exigências de controle, conheça os sistemas de IA em produção.
- Última atualização
- 22 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Agentes de IA: quando um retry pago exige aprovação humana
Entenda por que retries pagos de agentes de IA precisam de aprovação humana no ponto da recompra, mesmo em fluxos que já mantêm pessoas no circuito.22 de set. de 2026Build
Automação com IA no MindStudio: preços, limites e quando vale a pena
Veja como o MindStudio organiza automação com IA, quanto custam os planos e o uso de modelos e quais limites testar antes de adotar a plataforma.22 de set. de 2026Build
Wispr Flow ou Superwhisper: qual app de ditado compensa?
Compare Wispr Flow e Superwhisper em preço, privacidade, uso offline e recursos para equipes antes de escolher seu aplicativo de ditado por voz.22 de set. de 2026Build
Consultoria de inteligência artificial: como escolher a melhor
Veja como escolher uma consultoria de inteligência artificial por preço, suporte, controle e saída, com custos de 90 dias e um piloto de 20 casos.22 de set. de 2026Build
Como usar Claude Code Projects para coordenar tarefas em paralelo
Aprenda como usar Claude Code Projects para coordenar tarefas em threads na nuvem, configurar contexto, revisar branches e controlar o uso na versão beta.21 de set. de 2026Build
Automação de atendimento ao cliente com Jev: roteamento seguro de tickets
Aprenda a aplicar automação de atendimento ao cliente com Jev para rotear tickets, medir severidade e urgência e manter a revisão humana no fluxo.21 de set. de 2026Build
Claude Code + AGENTS.md: como ativar a leitura nativa
Aprenda a fazer o Claude Code ler AGENTS.md nativamente, escolher o modo certo, evitar conflitos com CLAUDE.md e validar tudo em uma sessão nova.19 de set. de 2026Build