بدائل Firecrawl: مقارنة 7 أدوات للزحف واستخراج البيانات
مقارنة عملية لأفضل بدائل Firecrawl من حيث الزحف، واستخراج Markdown وJSON، والتكلفة لكل صفحة مقبولة، مع ورقة ترحيل تساعد الفرق الصغيرة على الاختيار.




بدائل Firecrawl تنقسم عند عتبة 10,000 صفحة مقبولة. في هذا النموذج، تبلغ رسوم Firecrawl لدى المزوّد $83، إضافة إلى ثلاث ساعات عمل للمشغّل، بينما تبلغ تكلفة ScrapFly $30 مع ثلاث ساعات عمل أيضًا. لكن الفاتورة الأقل لا تعني تلقائيًا أن البديل أوفر؛ فقد تلتهم عملية اكتشاف الصفحات، وإعادة محاولات العرض، واستخراج JSON، والتقسيم اللاحق للنصوص كامل الفارق.
الخلاصة: بدائل Firecrawl تعني استبدال منظومة كاملة
اختر Apify Website Content Crawler إذا كنت تريد أقرب بديل مُدار واسع النطاق، وCrawl4AI إذا كانت السيطرة على البنية التحتية هي الأولوية، وScrapFly إذا أردت رصيدًا واحدًا يغطي الزحف والاستخراج المنظّم، وJina Reader عندما يتولى نظام آخر توفير عناوين URL. وتزداد قوة ScrapingBee وZyte API وBright Data Crawl API عندما يكون الوصول إلى الصفحات الصعبة أهم من مسار أصلي يحوّل الموقع كاملًا إلى Markdown.
الوحدة المهمة ليست الطلب ولا عنوان URL المكتشف، بل الصفحة المقبولة التي تصل إلى منظومة التوليد المعزّز بالاسترجاع. أي أن النموذج يتلقى مادة مصدر قابلة للاستخدام، مع سلامة Markdown وحقول JSON والروابط والبيانات الوصفية المطلوبة. فالاستجابة الرخيصة التي تُسقط جدولًا، أو تُنشئ حقل سعر فارغًا، أو تعطل أداة تقسيم النص هي إخفاق مدفوع التكلفة.
Firecrawl: خط الأساس
يمثل Firecrawl خط الأساس لأن نقطة نهاية Crawl لديه تجمع مسبقًا بين اكتشاف الصفحات وعرضها ومعالجتها، ثم تعيد Markdown أو JSON مطابقًا لمخطط محدد. ويحتسب 1 رصيد لكل صفحة يجري زحفها، مع 4 أرصدة إضافية لوضع JSON، لذلك يساوي خط الأساس المناسب لهذه المقارنة 5 أرصدة لكل محاولة صفحة.
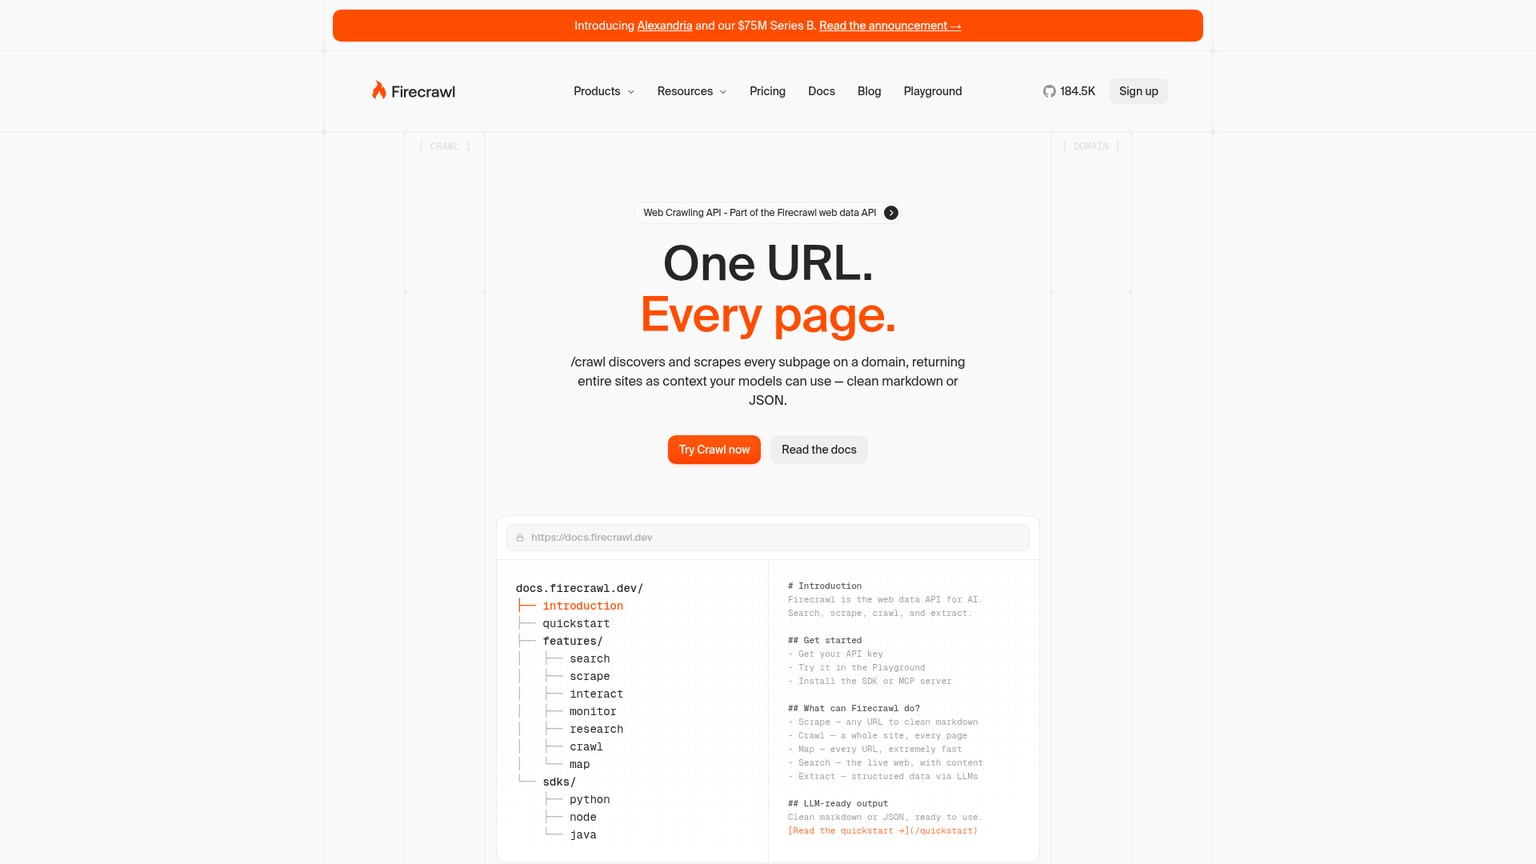
لهذا السبب قد يكون الاستمرار معه أوفر من بديل يبدو أرخص. يدير Firecrawl أيضًا نطاق الزحف والنطاقات الفرعية والمسارات والعمق وتسليم الصفحات المتدفق. قد تنخفض تكلفة واجهة Reader لكل عنوان URL، لكنها تترك اكتشاف الصفحات لفريقك؛ وقد تنجح واجهة وصول في جلب الصفحات المحمية، لكنها تترك تحويل Markdown وتوحيد المخطط للمراحل اللاحقة.
تسعير Firecrawl وفق نموذج الصفحة المقبولة
خطط Firecrawl الحالية هي Free بسعر $0 مقابل 1,000 رصيد، وHobby بسعر $16 شهريًا عند الفوترة السنوية مقابل 5,000 رصيد، وStandard بسعر $83 مقابل 100,000 رصيد، وGrowth بسعر $333 مقابل 500,000 رصيد، وScale بسعر $599 مقابل 1,000,000 رصيد، وEnterprise بتسعير مخصص. وتبلغ الزيادة $9 لكل 1,500 رصيد في Hobby، و$47 لكل 35,000 في Standard، و$177 لكل 175,000 في Growth، و$397 لكل 350,000 في Scale. جرى التحقق من هذه الأرقام والحدود وإمكانات الزحف عبر صفحة Firecrawl Crawl الحالية بتاريخ 25 سبتمبر 2026.
مع احتياطي 10% للاستجابات الناجحة التي لا تجتاز بوابة القبول المحلية، تحتاج 1,000 صفحة Markdown وJSON مقبولة إلى 5,500 رصيد. تصبح التكلفة $25 لخطة Hobby مع حزمة زيادة واحدة. وتحتاج عشرة آلاف صفحة مقبولة إلى 55,000 رصيد، فتكون Standard بسعر $83. أما مئة ألف صفحة مقبولة فتحتاج إلى 550,000 رصيد، فتبلغ التكلفة $510 لخطة Growth مع حزمة زيادة واحدة.
البحث طبقة منفصلة. إذا بدأت المهمة باستعلام وكانت تحتاج مصادر مرتبة بدلًا من موقع معروف أو مجموعة عناوين URL، فاستخدم مقارنة واجهات بحث الذكاء الاصطناعي لاتخاذ هذا القرار، ثم مرّر العناوين المختارة إلى طبقة الاستخراج.
نظرة سريعة على بدائل Firecrawl
يقيس الجدول مدى الملاءمة الموثّقة، لا جودة المخرجات المقاسة. جرى التحقق من الأسعار عبر صفحات الطرف الأول بتاريخ 25 سبتمبر 2026. ويشمل «الإصدار التجريبي المجاني» أيضًا الحصة المجانية الدائمة حين يكون هذا هو عرض المزوّد.
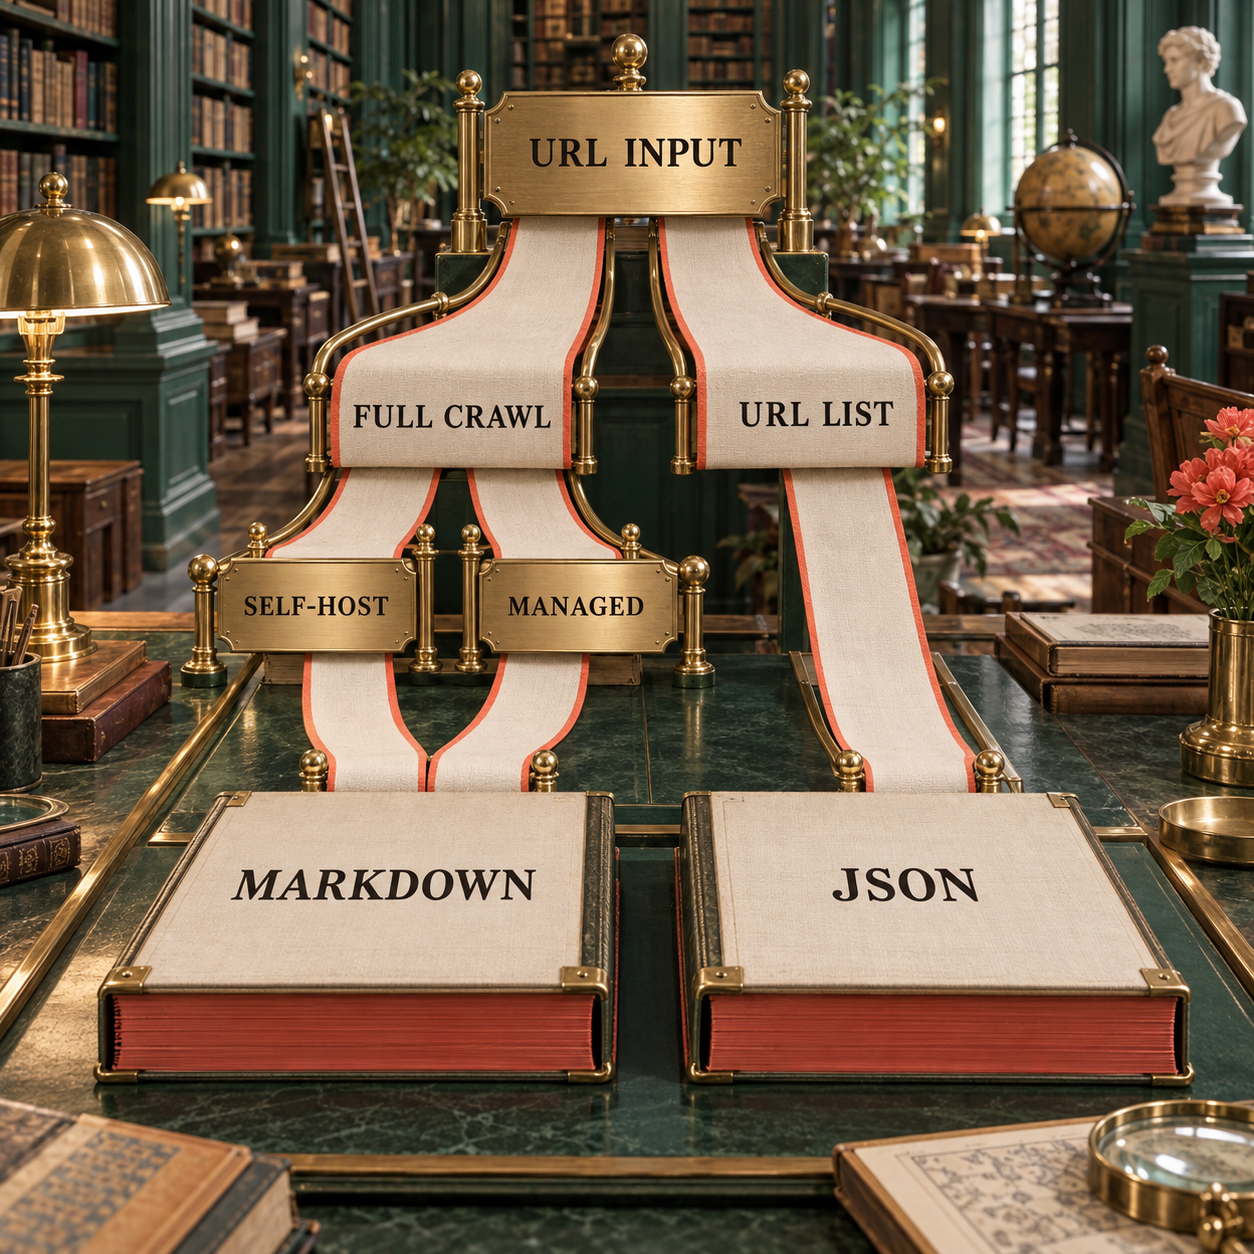
لا يوجد فائز يناسب الجميع، لأن عبارة «استخراج بيانات الويب» تخفي ثلاثة منتجات مختلفة: الزاحف يكتشف الموقع، وReader يحوّل عنوان URL جاهزًا، وطبقة الوصول تتعامل مع العرض أو الحظر. اشترِ أضيق منتج يتولى كل مرحلة لا يريد فريقك تشغيلها بنفسه.
كيف اخترنا هذه الأدوات؟
لم يدخل القائمة إلا كل خيار تدعم وثائقه الحالية من الطرف الأول مسارًا موثوقًا إلى محتوى صفحة مفيد ومخرجات قابلة للمعالجة آليًا. استبعدنا واجهات البحث فقط، لأن الاكتشاف المرتب لا يستبدل الزاحف. واستبعدنا خدمات الوكيل فقط، لأن عنوان IP لا ينتج Markdown نظيفًا ولا JSON مطلوبًا ولا سجل زحف محفوظًا.
تقوم المقارنة على خمسة اختبارات قبول:
- الاكتشاف: هل يستطيع اجتياز الموقع، واحترام النطاق، والاحتفاظ بسجل عناوين URL أساسية، أم يجب على مكوّن آخر توفير كل عنوان؟
- العرض والوصول: هل يستطيع تنفيذ JavaScript والتعامل مع شروط وصول الموقع من دون فاتورة إعادة محاولات مفتوحة؟
- عقد المخرجات: هل يحافظ على العناوين والجداول والشيفرة والروابط في Markdown، وهل يستطيع استيفاء حقول JSON المطلوبة من دون تحويل مبهم ثانٍ؟
- الأدلة: هل يمكن للفريق حفظ الطلب والاستجابة الخام والمخرجات الموحّدة والرؤوس والإعداد وبصمة المحتوى والحكم لكل عنوان URL في العينة؟
- التكلفة الكاملة: ما المدفوع مقابل الاكتشاف والعرض والاستخراج وإعادة المحاولات الناجحة لكن المرفوضة والحد الأدنى للالتزام ووقت المشغّل؟
لم نشغّل أي مرشح من أجل هذا المقال. لذلك لا ندّعي معدلات نجاح أو ترتيبًا لزمن الاستجابة. كل عبارة عن الجودة أدناه تصف قدرة موثّقة، وكل مقارنة بالدولار هي نموذج تظهر افتراضاته بوضوح.
عينة القبول الثابتة المكوّنة من 20 عنوان URL
لا تُجرِ ترحيلًا اعتمادًا على عنوان URL تجريبي يختاره المزوّد. استخدم العينة الثابتة نفسها مع الإعداد القديم والجديد، ثم احفظ كل استجابة. تمزج العينة عمدًا أشكال محتوى تكشف أنواعًا مختلفة من الإخفاق:
- الشيفرة والمستندات الطويلة: واجهة MDN Fetch API، وفئات Python، وملكية Rust، وRFC 9110 بصيغة HTML، وHTTPBin HTML.
- الجداول والروابط والصفحات المنظّمة: مرجع الجداول في MDN، ودليل الجداول من W3C، واستخلاص بيانات الويب في Wikipedia، وكتالوج Books to Scrape، وصفحة منتج ثابتة.
- ترقيم الصفحات وJavaScript: Quotes to Scrape، ومسار JavaScript فيه، ومسار التمرير، ودليل JavaScript من MDN، وتوحيد الروابط في HTTPBin.
- الترميز وملفات PDF: Unicode في HTTPBin، وRFC 9110 بصيغة PDF، وورقة بحثية بعمودين بصيغة PDF، وملف PDF بسيط من W3C، ونموذج IRS W-9.
يجب أن تحتوي كل نتيجة على source_url وfinal_url وtitle وmarkdown وlinks وstatus_code وfetched_at وcontent_sha256. وتتطلب صفحات المنتجات أيضًا entity_name وamount وcurrency، فيما تتطلب الورقة البحثية published_at. لا يجوز أن تكون قيمة الحقل فارغة صراحة إلا عندما يسمح سجل العينة بذلك؛ فالحقل المفقود ليس حقلًا بقيمة فارغة.
احفظ مجلدًا مستقلًا لكل أداة وإصدار وإعداد. ولكل عنوان URL، احتفظ بملفات request.json ورؤوس الاستجابة والجسم غير المعدّل وnormalized.json وverdict.json وبصمة SHA-256. يجب أن يذكر الحكم أول قاعدة فشلت، لا أن يكتفي بـpass: false. تتيح هذه الأدلة لمهندس آخر إعادة إنتاج القرار بعد تغير المزوّد أو المحلل أو الصفحة.
ورقة حساب تكلفة الصفحة المقبولة
يستخدم النموذج 1,000 و10,000 و100,000 صفحة مقبولة شهريًا، مع احتياطي 10% للاستجابات التي يعدّها المزوّد ناجحة لكن ترفضها بوابة المخطط أو Markdown المحلية. وتُحتسب إعادة المحاولات هذه ضمن الفاتورة. أما إخفاقات المزوّد الصريحة فتُعامل وفق سياسة الاسترداد المنشورة لكل مزوّد.
المعادلة الأساسية بسيطة: رسوم المزوّد أو الاستضافة، مضافًا إليها تكاليف الاكتشاف والعرض والاستخراج وإعادة المحاولات المدفوعة، ثم ساعات المشغّل مضروبة في التكلفة الإجمالية للساعة لدى الفريق. يعرض الجدول النقد المدفوع للمزوّد والساعات كلًا على حدة، حتى يمكن استبدال افتراض $100 للساعة من دون إعادة بناء معادلة كل مزوّد.
عند احتساب ساعة المشغّل بسعر $100، تصبح إجماليات 10,000 صفحة: $383 لـFirecrawl، و$419 لـApify، و$1,248 لـCrawl4AI، و$330 لـScrapFly، و$401.10 لـJina، و$449 لـScrapingBee، و$555.22 لـZyte، و$516.50 لـBright Data. ينطبق رقم Jina فقط عند وجود سجل عناوين URL موثوق مسبقًا؛ فهو ليس إجمالي زحف موقع كامل. وتشمل ساعات Bright Data وZyte أعمال Markdown والمخطط اللاحقة، لأن أيًا من صفحتي المنتج لا يوثّق Markdown أصليًا بوصفه عقد المخرجات المستخدم هنا.
سطر الاستخراج مقصود وواضح. يستخدم Firecrawl مقدار 1 رصيد زحف مع 4 أرصدة JSON. ويستخدم ScrapingBee عدد 5 أرصدة JavaScript مع 5 أرصدة AI في هذا السيناريو. ويستخدم ScrapFly عدد 5 أرصدة للمتصفح أو Unblocker مع 5 أرصدة لنموذج الاستخراج. ويستخدم Zyte تسعير المتصفح من المستوى 3 مع عملية استخراج واحدة لسمة مخصصة ثابتة. ويستخدم Apify غلاف JSON حتميًا، بنسبة 80% من صفحات HTTP الخام و20% من صفحات headless وفق التقدير الأعلى المنشور لها؛ ولا تشمل الحسبة الملخصات الاختيارية بالذكاء الاصطناعي.
يفترض Jina عدد 2,000 رمز مخرجات لكل محاولة، بسعر $0.050 لكل مليون. قيمة الاستهلاك ضئيلة، لكن التدفق النقدي يأتي على دفعات: بعد نفاد 10 ملايين رمز مجانية، أصغر تعبئة مدرجة هي 1 مليار رمز بسعر $50. ويفترض Crawl4AI مضيفات DigitalOcean بسعر $24 و$48 و$96 للأحجام الثلاثة، لكنها مدخلات تخطيط وليست ادعاءات عن سعة مقاسة.
1. Apify Website Content Crawler: أفضل بديل مُدار شامل
يعد Apify Website Content Crawler أقوى بديل مُدار واسع النطاق عندما يحتاج الفريق إلى اكتشاف الصفحات، وعرض JavaScript، وMarkdown، ومجموعة بيانات دائمة ضمن خدمة واحدة. يزحف عبر HTTP خام أو Firefox بنمط headless، ويحفظ كل نتيجة كسجل في مجموعة بيانات، ويصدّر JSON أو CSV. لذلك يبدو مسار الترحيل قريبًا من Firecrawl من دون الادعاء بأن واجهتي API متطابقتان.
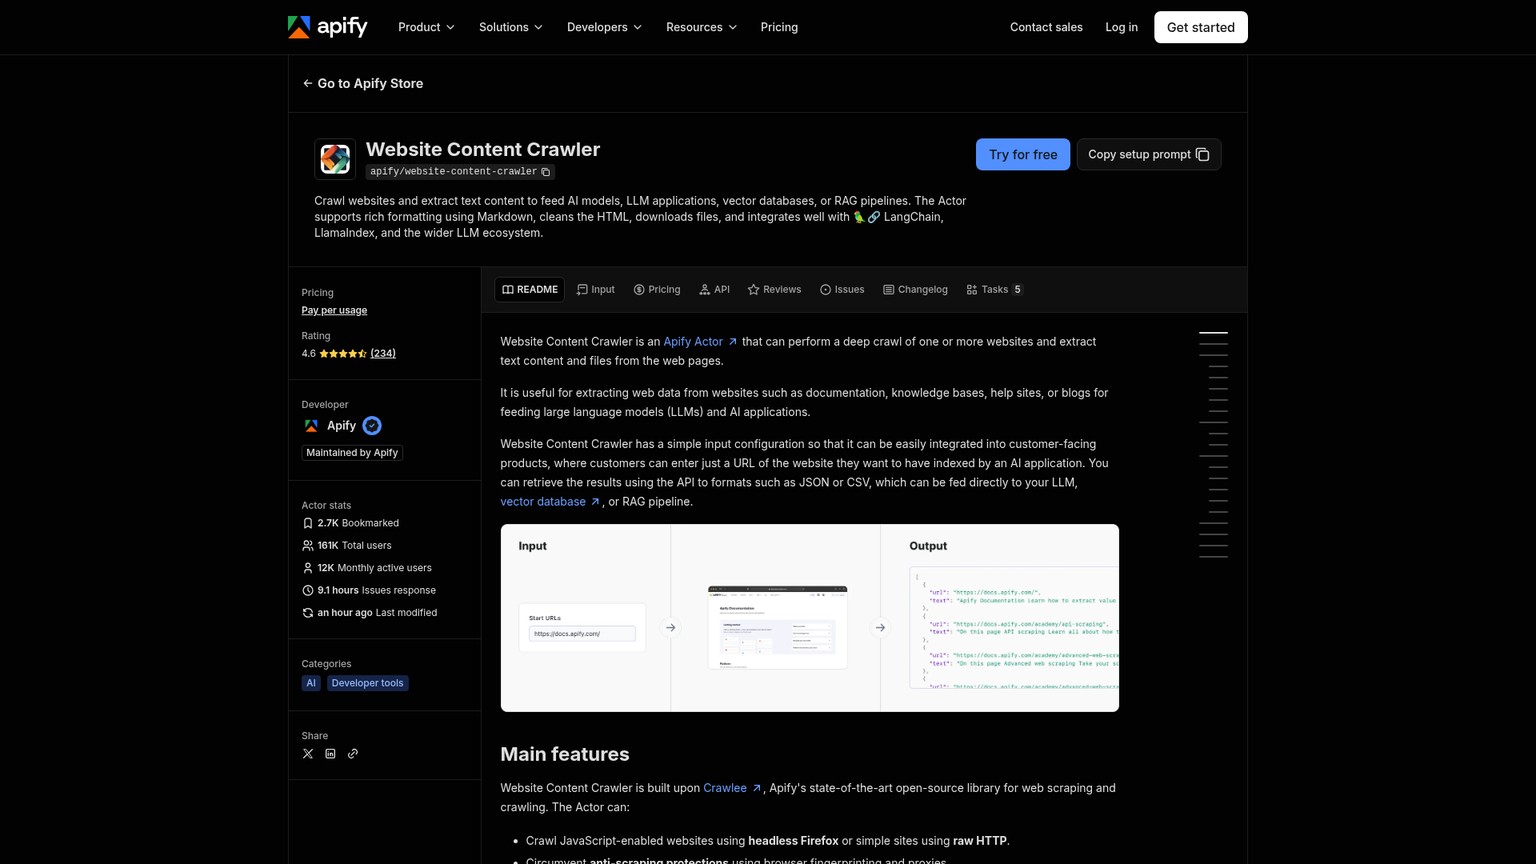
أوضح مزاياه هو التحكم في الزحف باعتباره مهمة متكاملة. يجتمع النطاق والمخرجات وسجلات مجموعة البيانات المحفوظة، ويمكن تنزيل ملفات مثل PDF. أما الحد الواضح فهو الاستخراج الدلالي: تمثل مجموعة بيانات JSON الخاصة بـActor غلافًا منظّمًا يحتوي على النص وMarkdown والبيانات الوصفية، لكن مخطط الأعمال المخصص يظل بحاجة إلى قواعد حتمية أو Actor آخر أو مرحلة نموذج.
يبلغ التقدير المنشور لـActor نحو $0.20 لكل 1,000 صفحة HTTP خام، ومن $0.50 إلى $5 لكل 1,000 صفحة headless وفق خطه الأساسي المعلن. وتضيف ملخصات الذكاء الاصطناعي الاختيارية قرابة $2 إلى $3 لكل 1,000 صفحة، وقد تصل الصفحات التي تفتقر إلى عناوين إلى نحو $7 لكل 1,000. يتجنب النموذج أعلاه هذه الإضافة، لأن الملخص لا يستبدل حقول JSON المطلوبة.
خطط Apify هي Free بسعر $0 مع استخدام شهري بقيمة $5 و5 عمليات متزامنة؛ وStarter بسعر $19 مع استخدام بقيمة $19 و32 عملية متزامنة؛ وScale بسعر $199 مع استخدام بقيمة $199 ووحدات حوسبة بسعر $0.16 و128 عملية متزامنة؛ وBusiness بسعر $999 مع استخدام بقيمة $999 ووحدات حوسبة بسعر $0.13 و256 عملية متزامنة؛ وEnterprise المخصصة. يتوقف الاستخدام المجاني عند نفاده، بينما تستمر الخطط المدفوعة برسوم زيادة، ولا يُرحّل الاستخدام غير المستهلك. صفحة تسعير Apify الحالية هي مصدر شروط المنصة هذه.
الأنسب لـ: فريق منتج أو بيانات صغير يستبدل مهمة زحف مُدارة، ولا سيما عندما يهمه سجل التشغيل وتصدير مجموعات البيانات.
الميزة الأبرز: اكتشاف الموقع كاملًا، وعرض المتصفح، وMarkdown، وسجلات JSON الدائمة في مجموعة البيانات ضمن تشغيل مُدار واحد.
التسعير: Free بسعر $0؛ وStarter بسعر $19؛ وScale بسعر $199؛ وBusiness بسعر $999؛ وEnterprise المخصصة. تشمل تكلفة Actor الفعلية أيضًا الحوسبة والتخزين والوكلاء ونقل البيانات التي يستهلكها التشغيل.
الإصدار التجريبي المجاني: تتضمن خطة Free الدائمة استخدامًا شهريًا بقيمة $5 من دون بطاقة.
- يغطي HTTP الخام وFirefox بنمط headless الصفحات الثابتة الرخيصة وصفحات JavaScript معًا.
- تسهّل سجلات مجموعة البيانات مراجعة الاستجابات المحفوظة وتصديرها.
- يجتمع نطاق الزحف وتنزيل الملفات والبيانات الوصفية وMarkdown في مهمة مُدارة واحدة.
- تتوزع فاتورة المنصة بين الحوسبة والتخزين والنقل واستخدام الوكلاء بدلًا من رصيد موحد للصفحة.
- لا يتحول سجل JSON في مجموعة البيانات تلقائيًا إلى مخطط الأعمال الذي تتوقعه شيفرتك اللاحقة.
- تضيف ملخصات الذكاء الاصطناعي تكلفة Actor مستقلة، ولا تثبت مع ذلك قبول الاستخراج.
تجربة ترحيل إلى Apify من خمس خطوات
حمّل سجل عناوين URL الثابت
ابدأ بعناوين العينة الـ20، لا بالنطاق الإنتاجي كاملًا. ثبّت مدخلات Actor ونوع الزاحف وحد الصفحات والنطاق، حتى يحمل التشغيل الثاني المعنى نفسه.
استخدم HTTP الخام حتى تثبت الصفحة حاجتها إلى متصفح
احتفظ بالمسار الرخيص للصفحات الثابتة، ووجّه عينات JavaScript إلى العرض بنمط headless. احفظ وضع الزاحف المختار مع كل نتيجة.
صدّر Markdown وسجل مجموعة البيانات
احتفظ بـ
markdownغير المعدّل، وعنوان URL الأساسي، والبيانات الوصفية، والروابط. ثم حوّل هذا السجل إلى مخطط JSON المحلي المطلوب في خطوة حتمية منفصلة.ارفض قبل تقسيم النصوص
شغّل اختبارات الجداول والشيفرة والروابط والحقول المطلوبة على السجل الموحّد. يذهب أي إخفاق في قاعدة إلى سجل إعادة المحاولات، لا إلى فهرس المتجهات.
سعّر الصفحات المقبولة فقط
اقسم كامل فاتورة Actor والوكلاء والتخزين والمشغّل على عدد الصفحات المقبولة. قارن النتيجة بخط Firecrawl الأساسي قبل توسيع الزحف.
2. Crawl4AI: أفضل بديل للاستضافة الذاتية
يعد Crawl4AI أفضل خيار للاستضافة الذاتية عندما تكون ملكية البنية التحتية، أو حدود البيانات، أو قواعد الاستخراج القابلة لإعادة الاستخدام متطلبات لا تقبل التنازل. ينتج Markdown ويدعم الاستخراج المنظّم عبر CSS أو XPath أو استراتيجية تعتمد نموذجًا لغويًا كبيرًا، وبذلك يستطيع تغطية نصوص الاسترجاع وحقول JSON من دون رسوم برمجية لكل طلب.
الحد الأمني الحالي أهم من سعر الترخيص. صدر الإصدار 0.9.4 في 23 سبتمبر 2026، ويعالج ثلاث نشرات أمنية، بينها مساران لتزوير الطلبات من جهة الخادم وخلل في حدود الثقة للإعدادات قد يكشف قيم البيئة. يجب أن تثبّت أي عملية تقييم v0.9.4 أو إصدارًا أحدث، وأن تراجع تنبيهات أمن المشروع قبل إتاحة واجهته.
مقارنة Crawl4AI مع Firecrawl
يبيع Firecrawl الخدمة المُشغّلة المحيطة بالزحف: طوابير مُدارة، ومتصفحات، وأرصدة، وتسليم، ودعم. أما Crawl4AI فيوفر نظام الزحف والاستخراج، فيما يتولى فريقك النشر والترقيات والمراقبة واستراتيجية الوكلاء والاستجابة للحوادث. يرجح الخيار الثاني عندما تكون هذه المسؤوليات أصلًا إمكانات مشتركة في المنصة، لا عندما يضطر مهندس واحد إلى إنشائها لهذا المشروع.
توصي الاستضافة الذاتية بذاكرة RAM لا تقل عن 4 GB، وDocker 20.10 أو أحدث، وCompose 2.24 أو أحدث. تستخدم ورقة التكلفة أسعار DigitalOcean Basic Droplet الحالية البالغة $24 لسعة 4 GiB، و$48 لسعة 8 GiB، و$96 لسعة 16 GiB. هذه الأحجام مدخلات للسيناريو فقط؛ فلم يُقَس معدل معالجة الصفحات في هذه الجولة.
الأنسب لـ: فرق لديها منصة حاويات قائمة، وحد صارم للبيانات، ومهندسون قادرون على تشغيل الزاحف.
الميزة الأبرز: تحكم مفتوح المصدر مع مخططات استخراج حتمية عبر CSS أو XPath يمكنها تجنب إنفاق النموذج لكل صفحة.
التسعير: ترخيص البرنامج بسعر $0. يستخدم النموذج مضيفات شهرية بقيمة $24 و$48 و$96، إضافة إلى الوكلاء والتخزين والمراقبة واستدعاءات النماذج والعمل عند الحاجة.
الإصدار التجريبي المجاني: البرنامج مفتوح المصدر؛ ولا يشمل البنية التحتية.
- يعمل Markdown والاستخراج المنظّم داخل بنية تحتية يسيطر عليها الفريق.
- يمكن لمخططات CSS وXPath أن تجعل المواقع المستقرة رخيصة وحتمية.
- يوجّه المشروع خادمه المستضاف ذاتيًا افتراضيًا نحو تشغيل يتطلب المصادقة وأكثر أمانًا على واجهة loopback.
- تصبح سمعة الوكلاء وسعة المتصفح والتصحيحات والطوابير والاستعادة مسؤولية فريقك.
- لا يثبت حجم المضيف قدرة الصفحات المقبولة من دون تشغيل محفوظ.
- ينقل استخراج النموذج اللغوي الكبير تكلفة رموز النموذج ومراجعة حدود البيانات إلى مزوّد مستقل أو نموذج محلي.
يتناول دليل استضافة Firecrawl ذاتيًا القرار المنفصل بين مستودع Firecrawl وFirecrawl Cloud. لا تحتسب ترخيص Crawl4AI البالغ $0 وفرًا قبل أن تضيف ورقة الحساب نفسها الأشخاص الذين يبقونه محدّثًا ومتاحًا.
3. ScrapFly: أفضل مزيج للفرق الصغيرة بين الزحف والاستخراج
يعد ScrapFly أقوى بديل لفريق صغير يريد من حساب واحد أن يغطي الوصول والزحف وتحويل Markdown والاستخراج محدد الأنواع. تتشارك منتجاته رصيدًا واحدًا، وتقبل طبقة الاستخراج HTML أو Markdown أو XML أو JSON أو CSV أو RSS أو نصًا عاديًا. ويمكن للفرق استخدام قوالب حتمية أو نماذج مدرّبة مسبقًا أو مطالبة بمخطط JSON، من دون ربط مزوّدين منفصلين.
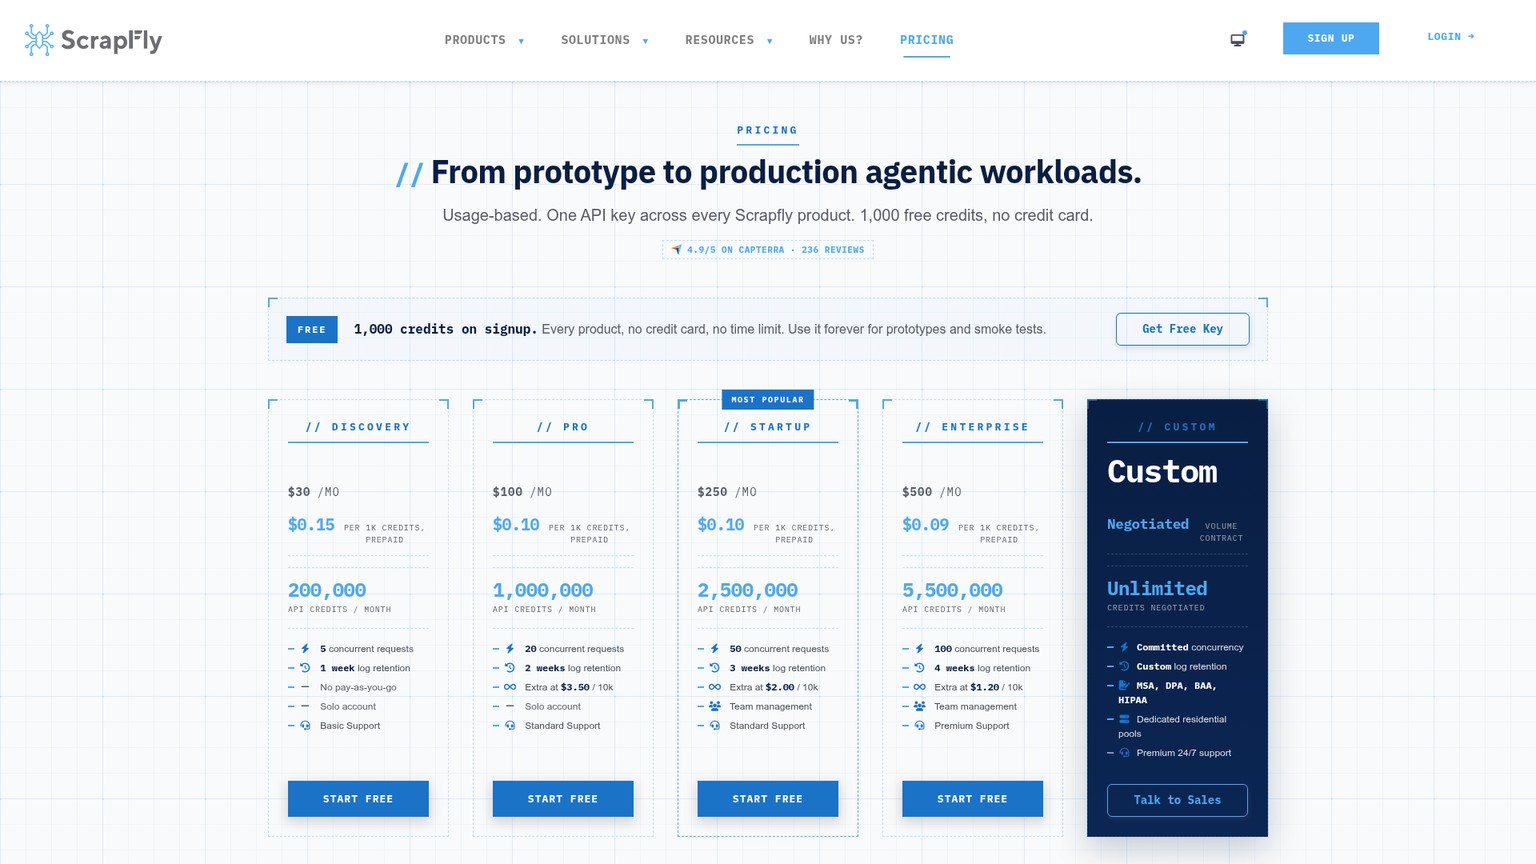
يصبح نموذج الأرصدة واضحًا بعد تثبيت الإعداد. يستهلك طلب HTTP بسيط عبر مركز بيانات 1 رصيد، ويستهلك عرض JavaScript أو Unblocker عدد 5 أرصدة، والتوجيه السكني 25 رصيدًا، ولقطة صفحة كاملة 60 رصيدًا. ويكلف الاستخراج بالقالب 1 رصيد إضافي، بينما تكلف مطالبة الاستخراج أو النموذج 5 أرصدة. أما المستندات التي تتجاوز 500 KB فتكرر رسم الاستخراج الأساسي مع كل 500 KB إضافية.
لذلك تبلغ تكلفة سيناريو المقال 10 أرصدة لكل محاولة ناجحة: 5 للمتصفح أو Unblocker، و5 للاستخراج. ومع احتياطي إعادة المحاولة 10%، تصبح 11 رصيدًا لكل صفحة مقبولة. لا يضيف النموذج توجيهًا سكنيًا؛ وأي هدف يحتاجه سيغير النتيجة بوضوح.
الخطط الحالية هي Free مع 1,000 رصيد لمرة واحدة؛ وDiscovery بسعر $30 شهريًا مع 200,000 رصيد و5 طلبات متزامنة؛ وPro بسعر $100 مع 1,000,000 رصيد و20 طلبًا متزامنًا؛ وStartup بسعر $250 مع 2,500,000 رصيد و50 طلبًا متزامنًا؛ وEnterprise بسعر $500 مع 5,500,000 رصيد و100 طلب متزامن؛ وCustom بالتفاوض. تتوقف Discovery عند حصتها. تبلغ زيادة Pro مقدار $3.50 لكل 10,000 رصيد، وStartup مقدار $2، وEnterprise مقدار $1.20. لا تُرحّل الأرصدة غير المستخدمة. تأتي هذه الشروط من تسعير ScrapFly الحالي.
الأنسب لـ: فريق صغير يريد زاحفًا مُدارًا وضوابط وصول واستخراجًا محدد الأنواع ضمن فاتورة واحدة.
الميزة الأبرز: يستطيع رصيد واحد تمويل الزاحف والمتصفح وUnblocker واستراتيجيات الاستخراج الثلاث.
التسعير: Free مع 1,000 رصيد؛ وDiscovery بسعر $30؛ وPro بسعر $100؛ وStartup بسعر $250؛ وEnterprise بسعر $500؛ وCustom بالتفاوض.
الإصدار التجريبي المجاني: 1,000 رصيد عند التسجيل، من دون بطاقة أو مدة انتهاء معلنة.
- يمكن لاستخراج القوالب خفض تكلفة النموذج في التخطيطات المستقرة.
- تعيد النماذج المدرّبة مسبقًا والاستخراج بالمطالبة مخرجات JSON محددة الأنواع من دون مزوّد نموذج منفصل.
- لا تستهلك الطلبات الفاشلة أرصدة، بينما تعرض الاستجابة مقدار ما استُهلك.
- تتراكم خيارات المتصفح والسكني والاستخراج بسرعة على الصفحات الصعبة.
- تضاعف المستندات الأكبر من 500 KB رسوم الاستخراج.
- لا تدعم Discovery الزيادة، لذلك تحتاج مهام الإنتاج إلى Pro أو إلى إيقاف صارم قبل نفاد الحصة.
يتصدر ScrapFly ورقة الحساب عند 10,000 صفحة مقبولة في هذا السيناريو تحديدًا: $30 مع ثلاث ساعات عمل للمشغّل، مقابل $83 مع ثلاث ساعات لـFirecrawl. فارق $53 النقدي شهريًا أصغر من أن يبرر ترحيلًا غير منضبط. لا يصبح مقنعًا إلا إذا اجتاز العينة الثابتة، وتجنبت أهداف الإنتاج المسار السكني ذي 25 رصيدًا، ولم يحتج المخطط إلى تنظيف إضافي.
4. Jina Reader: الأفضل عندما تكون قائمة عناوين URL جاهزة
يعد Jina Reader أفضل محوّل منخفض التكلفة المتغيرة عندما يكون اكتشاف الصفحات محلولًا بالفعل، ويحتاج كل عنوان URL جاهز إلى Markdown نظيف أو JSON مطابق لمخطط. يعرض محركه الافتراضي JavaScript في متصفح headless، فيما يسلك المحرك المباشر مسار HTTP الأبسط. ويقبل ReaderLM-v2 مخطط JSON أو تعليمات بلغة طبيعية لإنتاج مخرجات منظّمة.
ميزته هي حدوده أيضًا: يقرأ Reader عنوان URL، لكنه لا يستبدل قواعد نطاق موقع كامل، ولا طابور الزحف، ولا سياسة التكرار، ولا سجل الزحف. إذا كانت خريطة موقع أو مرحلة بحث أو فهرس داخلي توفر قائمة URL موثوقة، فقد يكون هذا الدور الضيق ميزة. وإلا وجب إعادة تكلفة الاكتشاف إلى ورقة الحساب.
الاستخدام الأساسي لـReader مجاني. يتضمن المفتاح الجديد 10 ملايين رمز، وتُحتسب رموز المخرجات عند استخدام المفتاح. تبلغ تكلفة تعبئة 1 مليار رمز $50، أي $0.050 لكل مليون؛ وتبلغ تعبئة 11 مليار رمز $500، أي $0.045 لكل مليون. لا تخصم الطلبات الفاشلة رموزًا. حدود المعدل هي 20 طلبًا في الدقيقة من دون مفتاح، و500 مع مفتاح مجاني أو مدفوع، و5,000 مع مفتاح premium. تأتي كل الأرقام من صفحة Jina Reader الحالية.
تفترض ورقة الحساب 2,000 رمز مخرجات لكل محاولة ناجحة. فتبلغ قيمة الرموز المستهلكة بعد احتياطي إعادة المحاولة $0.11 لكل 1,000 صفحة مقبولة، و$1.10 لكل 10,000، و$11 لكل 100,000. هذه قيم استخدام اقتصادية، وليست المبلغ النقدي عند الدفع. وبعد نفاد الحصة المجانية، يظل أصغر شراء مدرج $50.
الأنسب لـ: منظومة لديها سجل عناوين URL موثوق وتحتاج تحويل الصفحات إلى Markdown أو JSON بتكلفة منخفضة.
الميزة الأبرز: فوترة رموز المخرجات، وعرض JavaScript، والاستخراج وفق مخطط JSON داخل واجهة Reader ضيقة النطاق.
التسعير: استخدام Reader الأساسي مجاني؛ ويحصل كل مفتاح جديد على 10 ملايين رمز؛ والحزم المدفوعة $50 مقابل 1 مليار رمز أو $500 مقابل 11 مليارًا.
الإصدار التجريبي المجاني: 10 ملايين رمز مع مفتاح API جديد.
- يتعامل العارض الافتراضي مع JavaScript في جهة العميل قبل التحويل.
- يمكن لوضعي مخطط JSON والتعليمات إنتاج حقول منظّمة من Reader نفسه.
- لا تستهلك الطلبات الفاشلة رموزًا.
- يحتاج اكتشاف الموقع والنطاق واستمرار حالة الزحف إلى مكوّن آخر.
- حزمة رموز بقيمة $50 هي أصغر دفعة نقدية بعد الحصة المجانية، حتى حين تكون قيمة الاستهلاك الحالي أقل بكثير.
- تتغير تكلفة رموز المخرجات بحسب طول الصفحة وتنسيق الاستجابة.
يبدو Jina الخيار الأقل تكلفةً ظاهريًا عند 100,000 صفحة بسعر $11 مع ست ساعات، لكن ضمن افتراض السجل الجاهز فقط. إضافة مهمة اكتشاف غير موثوقة وإزالة التكرار يدويًا ستجعل هذا الصف غير قابل للمقارنة مع Firecrawl أو Apify. استخدمه عندما يكون حد المكوّن حقيقيًا، لا لإخفاء أعمال زحف ناقصة.
5. ScrapingBee: أفضل API للاستخلاص بسقف أرصدة
يعد ScrapingBee أفضل بديل على مستوى الطلب عندما يريد الفريق تحديد الحد الأعلى لتكلفة أي صفحة. يمكنه إعادة Markdown للصفحة أو استجابة JSON، وتطبيق قواعد استخراج CSS، وإضافة استخراج بالذكاء الاصطناعي عندما لا تكون التخطيطات مستقرة بما يكفي للمحددات.
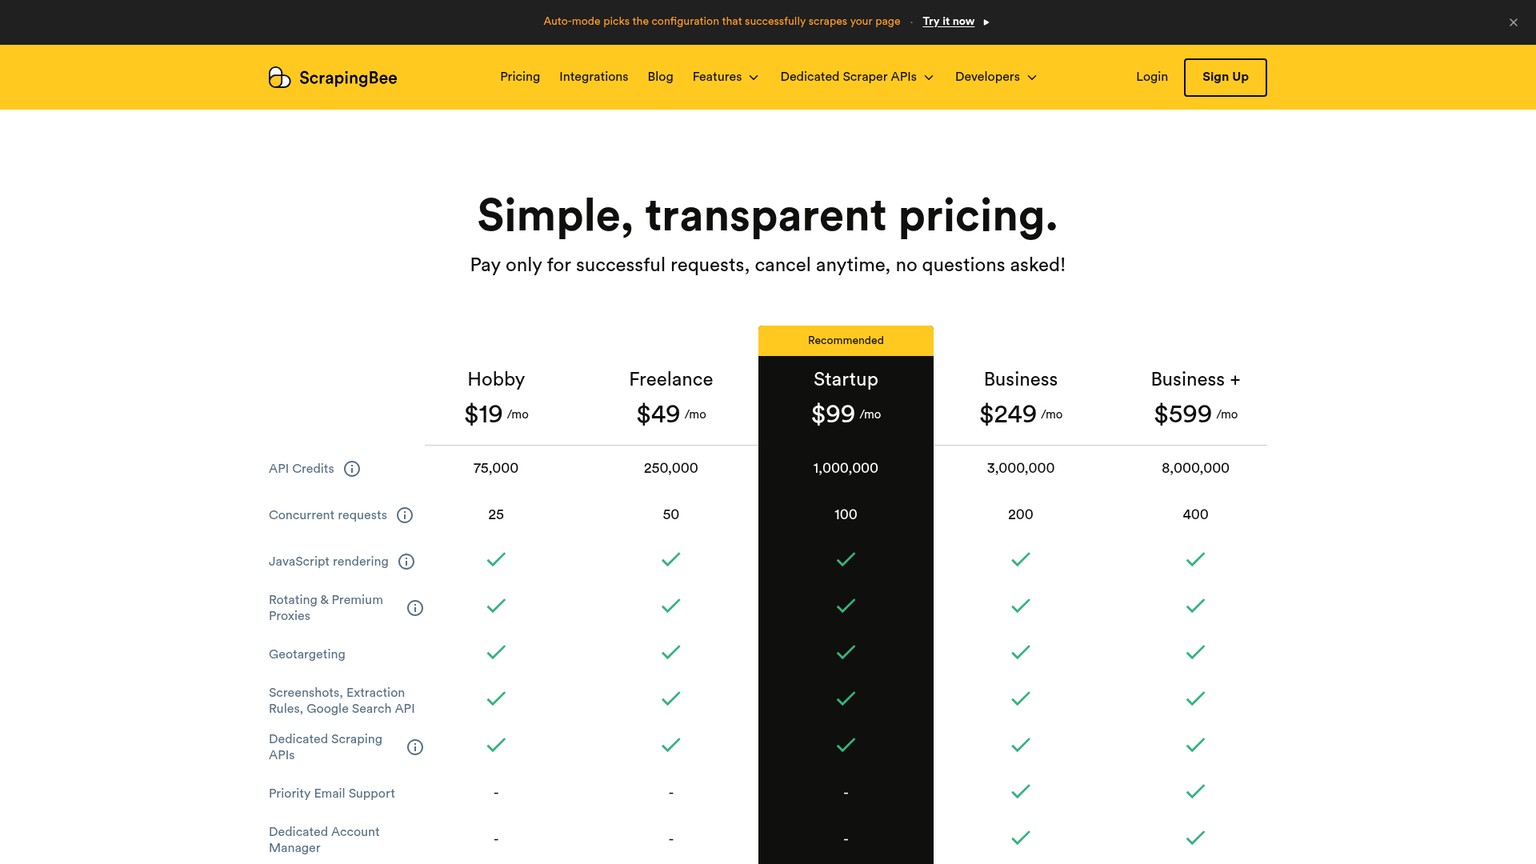
أداة التحكم المفيدة هنا هي سلّم الأرصدة. يكلف HTTP التقليدي 1 رصيد، وJavaScript التقليدي 5، وpremium من دون JavaScript عدد 10، وpremium مع JavaScript عدد 25، وstealth مع JavaScript عدد 75. وتضيف ميزات AI عدد 5 أرصدة. يفرض الوضع التلقائي تكلفة الإعداد الذي ينجح، ولا يفرض شيئًا إذا فشلت كل الإعدادات، كما يتيح سقفًا أعلى للتكلفة.
العقبة هي التنسيق التشغيلي. يجلب ScrapingBee الصفحات المطلوبة، لكنه ليس أقرب نظير لاكتشاف المواقع وطابور الزحف في Firecrawl. يجب أن يمتلك الفريق سجل عناوين URL والنطاق ومعالجة التكرار وحالة المهمة، ثم يميز بين إخفاق المزوّد والاستجابة الناجحة التي ترفضها بوابة القبول المحلية.
الخطط الحالية هي Hobby بسعر $19 شهريًا مقابل 75,000 رصيد و25 طلبًا متزامنًا؛ وFreelance بسعر $49 مقابل 250,000 و50؛ وStartup بسعر $99 مقابل 1,000,000 و100؛ وBusiness بسعر $249 مقابل 3,000,000 و200؛ وBusiness+ بسعر $599 مقابل 8,000,000 و400. وتبلغ حصة التقييم 1,000 رصيد من دون بطاقة. تأتي هذه الأرقام من خطط ScrapingBee الحالية.
الأنسب لـ: فرق تمتلك الاكتشاف بالفعل وتحتاج حدودًا صريحة لتكلفة العرض والوكلاء المميزين وكل طلب.
الميزة الأبرز: يستطيع الوضع التلقائي تصعيد أسلوب الوصول، بينما يحد max_cost مما قد تستهلكه استجابة واحدة.
التسعير: Hobby بسعر $19؛ وFreelance بسعر $49؛ وStartup بسعر $99؛ وBusiness بسعر $249؛ وBusiness+ بسعر $599.
الإصدار التجريبي المجاني: 1,000 رصيد من دون بطاقة.
- يتوفر Markdown واستخراج CSS والاستخراج بالذكاء الاصطناعي في واجهة طلبات واحدة.
- يجعل سلم الأرصدة 1 و5 و10 و25 و75 تكلفة الوصول قابلة للفحص.
- لا يفرض الوضع التلقائي رسومًا عندما تفشل كل إعداداته الداخلية.
- يبقى اكتشاف الموقع واستمرار الزحف خارج حدود المنتج.
- تظل محاولة المزوّد الناجحة التي يرفضها مخططك محاولة مدفوعة.
- قد ترتفع الأرصدة 15 ضعفًا من JavaScript التقليدي إلى JavaScript بنمط stealth قبل إضافة استخراج AI.
يستخدم JavaScript مع استخراج AI عدد 10 أرصدة لكل محاولة في النموذج. ويرفع احتياطي إعادة المحاولة العدد إلى 11 لكل صفحة مقبولة، فتقع 1,000 صفحة ضمن Hobby بسعر $19، و10,000 ضمن Freelance بسعر $49، و100,000 ضمن Business بسعر $249، لأن 1.1 مليون رصيد تتجاوز حد Startup البالغ 1 مليون.
6. Zyte API: أفضل تسعير لمكافحة الحظر بحسب الموقع
يناسب Zyte API الحالات التي تختلف فيها صعوبة الوصول بشدة بين الأهداف، ويريد المشتري أن يعيّن المزوّد شريحة تسعير لكل موقع. فهو يضم مسار مركز البيانات أو المسار السكني اللازم، والعرض، وأعمال الوصول ضمن سعر الاستجابة، ولا يحتسب إلا الاستجابات الناجحة.
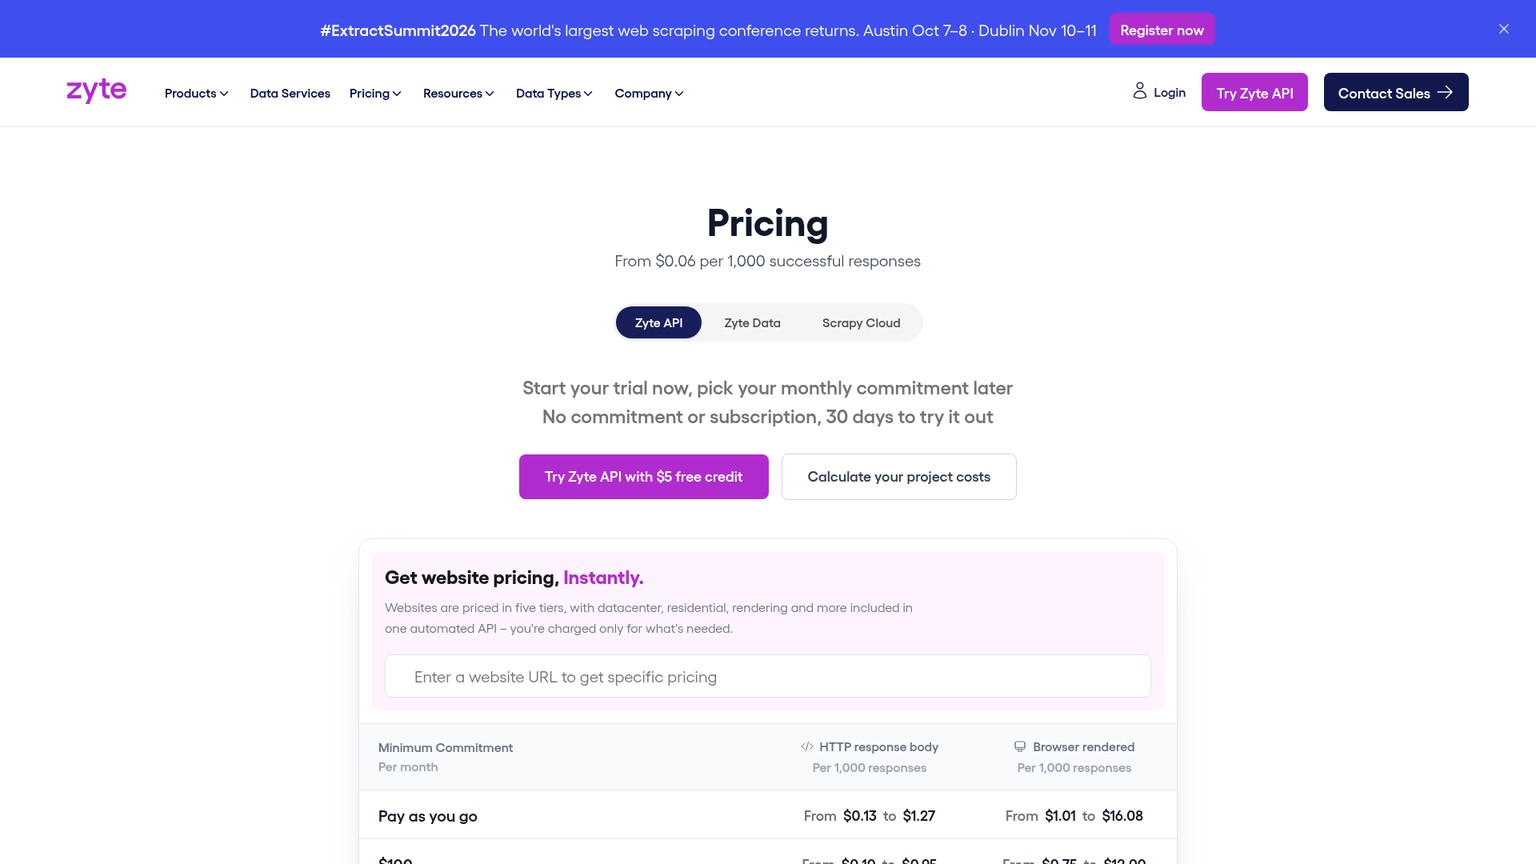
تبلغ أسعار HTTP بنظام الدفع حسب الاستخدام لكل 1,000 استجابة $0.13 و$0.23 و$0.44 و$0.70 و$1.27 عبر شرائح المواقع من 1 إلى 5. وتبلغ أسعار العرض بالمتصفح $1.01 و$2.01 و$4.02 و$8.04 و$16.08. ومع التزام شهري قدره $100، تصبح أسعار المتصفح $0.75 و$1.50 و$3 و$6 و$12؛ وعند $200 تصبح $0.60 و$1.20 و$2.40 و$4.80 و$9.60؛ وعند $500 تصبح $0.48 و$0.96 و$1.92 و$3.84 و$7.68.
جداول التزام HTTP مهمة أيضًا. عند $100، تكلف الشرائح من 1 إلى 5 مقدار $0.10 و$0.17 و$0.33 و$0.53 و$0.95 لكل 1,000. وعند $200، تكلف $0.08 و$0.14 و$0.26 و$0.42 و$0.76. وعند $500، تكلف $0.06 و$0.11 و$0.21 و$0.34 و$0.61. وتوفر Enterprise خصومات تفاوضية إضافية. كما تدرج صفحة تسعير Zyte الحالية رصيدًا تجريبيًا بقيمة $5 لمدة 30 يومًا.
يمكن للسمات المخصصة استخدام طريقة extract ثابتة بسعر $0.001، أو طريقة توليدية بسعر $0.002 لكل 1,000 رمز إدخال و$0.01 لكل 1,000 رمز إخراج. ويتراوح الاستخراج التلقائي بين $0.0004 و$0.0016 لكل نوع بيانات. وبذلك يظهر سطر واضح للاستخراج في ورقة الحساب بدلًا من إخفاء استخدام النموذج داخل خطة غير مفصّلة.
العقبة في هذه المقارنة هي المخرجات. توثّق Zyte أجسام HTTP وHTML الصادر من المتصفح والحقول المنظّمة، ولا توثّق استجابة Markdown أصلية. لذلك يظل تحويل HTML إلى Markdown واختبارات الانحدار التابعة له جزءًا من الترحيل.
الأنسب لـ: استخراج متعدد النطاقات تكون فيه صعوبة الهدف والحاجة إلى المتصفح وبنية الوصول هي العوامل الرئيسية المحركة لفاتورة المزوّد.
الميزة الأبرز: خمس شرائح طلب بحسب الموقع، ومن دون رسوم على الاستجابات غير الناجحة أو المحدودة بالمعدل.
التسعير: PAYG من دون التزام؛ والتزامات شهرية بقيمة $100 و$200 و$500؛ وEnterprise بخصومات إضافية. يعتمد سعر الاستجابة على شريحة الموقع وعلى مخرجات HTTP أو المتصفح.
الإصدار التجريبي المجاني: رصيد $5 لمدة 30 يومًا من دون التزام.
- تجمع الشريحة الخاصة بالهدف بنية الوصول في سعر استجابة واحد.
- تلغي فوترة الاستجابات الناجحة التكلفة المباشرة لحدود المعدل والإخفاقات التي يعلنها المزوّد.
- تجعل السمات المخصصة الثابتة والمسعّرة بالرموز تكلفة الاستخراج ظاهرة.
- لا توثّق الخدمة Markdown أصليًا، لذلك يبقى التحويل مسؤوليتك.
- قد تتغير شريحة الهدف، وقد تظل الاستجابات الناجحة تفشل في بوابة المحتوى المحلية.
- يتطلب اكتشاف الموقع كاملًا وتصميم حالة الزحف اللاحقة إعدادًا متعمّدًا.
تستخدم ورقة الحساب عرض المتصفح من الشريحة 3 مع استخراج مخصص ثابت واحد. وينتج من ذلك استخدام مفترض بقيمة $5.52 و$55.22 و$374 عبر الأحجام الثلاثة. هذا سيناريو لا سعر موحد لـZyte؛ استبدل الشريحة بعرض الأسعار الخاص بالنطاقات التي ستزحف إليها.
7. Bright Data Crawl API: الأفضل للتوسع في المواقع المحمية
يعد Bright Data Crawl API أقوى مرشح عندما يهيمن الوصول إلى المواقع المحمية، وبنية الوكلاء، والتزامن على المتطلبات. يشمل سعره عرض JavaScript والوكلاء السكنيين والتحقق وحل CAPTCHA والاستهداف الجغرافي والاكتشاف وتحليل JSON أو CSV، مع تزامن غير محدود.
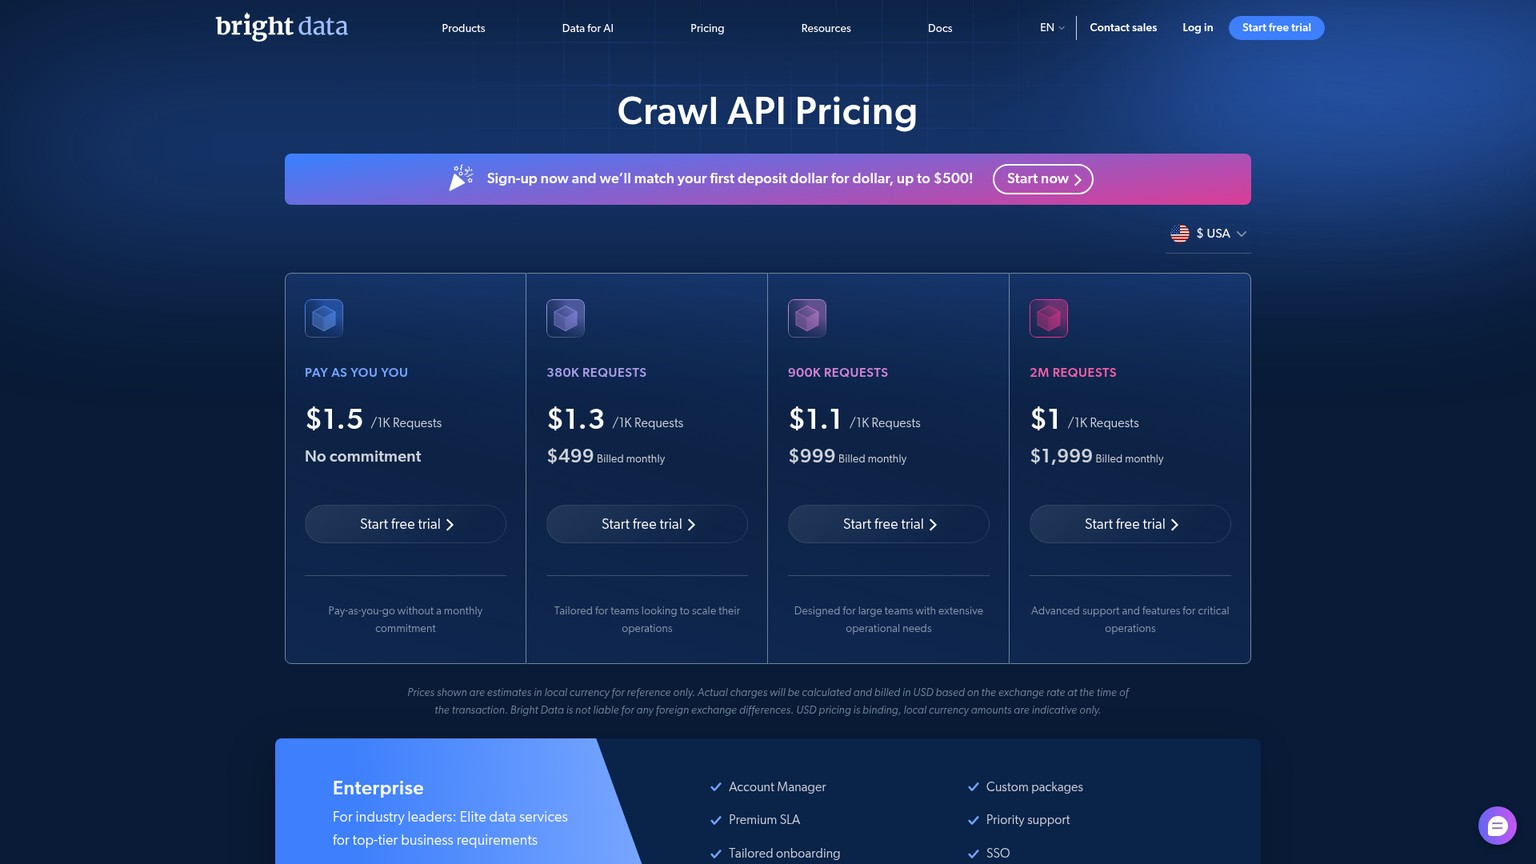
يبدأ المنتج من $1.50 لكل 1,000 طلب بنظام الدفع حسب الاستخدام ومن دون التزام. تبلغ خطة 380,000 طلب $499 شهريًا، أي $1.30 لكل 1,000؛ وتكلف 900,000 طلب مقدار $999، أي $1.10 لكل 1,000؛ وتكلف 2 مليون طلب $1,999، أي $1 لكل 1,000. وتسعير Enterprise مخصص. هذه هي أسعار Bright Data Crawl API الحالية.
العقبة المهمة هي نفسها التي تواجه Zyte: صيغ التسليم الموثّقة هي NDJSON وCSV، لا Markdown أصلي. وبالنسبة إلى منظومة استرجاع تحتاج ثبات العناوين وكتل الشيفرة والجداول وروابط المصادر في Markdown، يصبح المحوّل مكوّنًا إنتاجيًا. ويجب إدخال إخفاقاته ووقت المشغّل في المقام.
عند أسعار الدفع حسب الاستخدام، يرفع احتياطي إعادة المحاولة القابل للفوترة بنسبة 10% التكلفة النقدية للمزوّد إلى $1.65 لكل 1,000 صفحة مقبولة، و$16.50 لكل 10,000، و$165 لكل 100,000. لا ينبغي قراءة أرقام الطلبات الصغيرة هذه على أنها التكلفة الكاملة. تخصص ورقة الحساب أربع ساعات وخمسًا وثمانيًا لتحويل Markdown وتوحيد المخطط والمراجعة، وقد يغير الهدف الصعب سلوك الطلبات.
الأنسب لـ: جمع عالي التزامن من نطاقات محمية، حيث تكون أعمال الوصول المُدارة أثمن من Markdown الأصلي.
الميزة الأبرز: العرض والتوجيه السكني والتعامل مع CAPTCHA والتحقق والتزامن غير المحدود ضمن سعر Crawl API.
التسعير: PAYG بسعر $1.50 لكل 1,000 طلب؛ و$499 مقابل 380,000؛ و$999 مقابل 900,000؛ و$1,999 مقابل 2 مليون؛ وEnterprise المخصصة.
الإصدار التجريبي المجاني: تعرض بطاقات التسعير الحالية إصدارًا تجريبيًا مجانيًا، لكنها لا تذكر قيمة الرصيد في شروط الخطة الظاهرة.
- تُضمّن بنية الوصول التي كانت ستحتاج إلى عدة مكونات.
- يناسب التزامن غير المحدود المهام الكبيرة ذات مواعيد التسليم الصارمة.
- يتيح NDJSON وCSV تسليمًا قابلًا للمعالجة آليًا من دون استخلاص لوحة تحكم المزوّد.
- لا يمثل Markdown الأصلي عقد المخرجات الموثّق.
- تخفي تكلفة طلب PAYG وحدها أعمال التحويل والمخطط ومراجعة الصفحة المقبولة.
- تمثل حزمة الوصول الواسعة عبئًا زائدًا لمواقع التوثيق العامة التي يتعامل معها HTTP الخام بسهولة.
بدائل Firecrawl مفتوحة المصدر التي تستطيع الفرق تشغيلها
Crawl4AI هو أوضح بديل مفتوح المصدر في هذه القائمة المختصرة، لكن Firecrawl ينشر أيضًا نواة قابلة للاستضافة الذاتية. الفارق المهم ليس إمكان استنساخ مستودع، بل قدرة النشر المفتوح على إعادة إنتاج اكتشاف الصفحات والوصول عبر المتصفح والطوابير والاستمرارية والمراقبة وعقد المخرجات الذي تعتمد عليه منظومة العمل.
بالنسبة إلى Crawl4AI، ثبّت الإصدار 0.9.4 أو أحدث، واشترط المصادقة، واضبط ربط نسخ التقييم الخاصة على نحو مناسب، واحفظ صورة الحاوية أو إصدار الحزمة الدقيق مع كل مجموعة نتائج. فضّل استخراج CSS أو XPath للقوالب المستقرة، ثم اعزل أي مزوّد استخراج بنموذج لغوي كبير على أنه بند تكلفة مستقل وحد مستقل للبيانات. ساعات المشغّل الشهرية من 8 إلى 20 في النموذج ليست معيارًا؛ بل تذكير بتسعير التصحيحات وإخفاقات الوكلاء وانحراف المخطط والاستعادة بدلًا من عدّها مجانية.
أما نواة Firecrawl، فتعامل مع الاختيار بين Cloud والاستضافة الذاتية كقرار معماري مستقل. يستطيع المستودع إزالة بند أرصدة المزوّد، لكنه يضيف PostgreSQL وRedis وRabbitMQ وعمّال المتصفح والمراقبة والترقيات إلى عبء الفريق. ويتضمن مقال الاستضافة الذاتية المخصص المرتبط أعلاه حزمة تحقق لهذا القرار.
ما أفضل أداة ذكاء اصطناعي لاستخراج بيانات الويب؟
يتبع الخيار الأفضل حدود المدخلات. إذا كان المدخل نطاقًا ويجب أن يكون المخرج مجموعة كاملة من محتوى Markdown وJSON، فابدأ بـFirecrawl أو Apify، ثم سعّر ScrapFly. وإذا كان المدخل قائمة URL موثوقة جاهزة، يزيل Jina Reader آليات الزحف وقد يكون أرخص بكثير. وإذا كان الوصول هو الجزء الصعب، فقارن سقف تكلفة ScrapingBee بشرائح المواقع لدى Zyte وحزمة الوصول المدمجة من Bright Data.
وكلاء الذكاء الاصطناعي لاستخراج بيانات الويب يحتاجون إلى بوابة قبول
يجب ألا يقرر الوكيل مطلقًا أن استجابة 200 جاهزة للاسترجاع. امنحه بوابة حتمية: الحقول المطلوبة، والحد الأدنى لطول Markdown، والحفاظ على الجداول والشيفرة، والروابط الموحّدة، وبصمة المحتوى، ونوع المحتوى المسموح، وقواعد القيم الفارغة الصريحة. يستطيع الوكيل توجيه الإخفاقات، لكن لا يجوز له التنازل عن العقد لمجرد استمرار المهمة.
ينقلب القرار في أربعة مواضع:
- استمر مع Firecrawl عندما يجتاز العينة، ولا تستطيع وفورات ستة أشهر سداد تكلفة الترحيل والتشغيل المزدوج.
- اختر Apify عندما تكون مهمة الزحف المُدارة، ومجموعة البيانات الدائمة، ومسار Actor المرن أهم من رقم موحد لرصيد الصفحة.
- اختر Crawl4AI عندما يمتلك الفريق الحاويات وتوجيه الوصول والتغطية عند الطلب، أو عندما تجعل حدود البيانات المعالجة المُدارة غير مقبولة.
- اختر API أضيق عندما يكون الاكتشاف مُنجزًا بالفعل أو يكون الوصول إلى الصفحات المحمية هو المهيمن. تتفوق Jina وScrapingBee وZyte وBright Data فقط عندما تُكتب هذه الحدود بوضوح.
لا تختر بناءً على أجمل مخرجات في بيئة تجريبية. يجب أن يجتاز الإعداد المختار العينة نفسها، ويحفظ الأدلة نفسها، وينتج التقسيمات اللاحقة نفسها. قد تبدو أداة أنظف في صفحة مقال واحدة، ثم تفشل في الجدول أو PDF أو مسار JavaScript الذي يحسم قبول الإنتاج.
أدوات لا تصلح بديلًا مباشرًا
تجنب شراء فئة مجاورة والتعامل معها كأن المنظومة اكتملت. قد تكون الأدوات التالية مفيدة، لكنها لا تستبدل مهمة Firecrawl الكاملة المعرّفة هنا:
- Exa وTavily: أبقهما ضمن تقييم مزوّدي البحث. استُبعدا من هذه القائمة لأن الاستبدال هنا يبدأ بعد اختيار نطاق أو مجموعة عناوين URL، ويجب أن ينتج محتوى صفحات مقبولًا.
- Playwright وPuppeteer وحدهما: أتمتة المتصفح لبنة بناء، وليست سجل زحف مُدارًا، ولا عقد Markdown، ولا سجل إعادة محاولات، ولا نظام تسليم منظّمًا. اخترهما فقط عندما يكون بناء تلك الطبقات هو المقصود.
- خدمة وكيل فقط: الوصول إلى استجابة لا ينظف عناصر التنقل، ولا يحتفظ بالروابط، ولا يتحقق من JSON، ولا يحافظ على ثبات حدود التقسيم.
- نسخة متفرعة من زاحف بلا صيانة: يتحول المستودع المجاني إلى حادثة عندما تتغير إصدارات المتصفح أو الإصلاحات الأمنية أو سلوك الهدف، ولا يملك أحد مسار الإصدار.
تجنب أيضًا اعتماد معيار تسويقي دليلًا على الترحيل. ما لم يُشغّل الإعداد نفسه على عينة عناوين URL الـ20 المحفوظة، فالرقم يصف عبء عمل يخص طرفًا آخر. لا ينشر هذا المقال عمدًا أي معدل نجاح اصطناعي أو جدول ترتيب لزمن الاستجابة.
ورقة ترحيل لفريق صغير
يبقي الترحيل الآمن Firecrawl والمرشح يعملان بالتوازي حتى تتطابق المخرجات الموحّدة وسلوك إعادة المحاولات والتقسيمات في العينة الثابتة وعينة إنتاج ممثّلة. تحتاج الورقة إلى مالك واحد، ومخطط واحد مضبوط الإصدارات، وشرط واحد للتراجع.
1. ثبّت عقد المدخلات والاكتشاف
سجّل ما إذا كانت عناوين URL تأتي من زحف نطاق، أو خريطة موقع، أو واجهة بحث، أو طابور، أو قاعدة بيانات داخلية. واحفظ النطاقات المسموحة وسياسة النطاقات الفرعية ومسارات التضمين والاستبعاد والعمق وحد الصفحات وقواعد التوحيد والتكرار. لا تقارن تجربة Jina أو ScrapingBee مع Firecrawl ما لم يوفّر مكوّن آخر هذا الصف كاملًا.
2. جمّد مخطط المخرجات
اضبط إصدارات الحقول والأنواع المطلوبة. واحتفظ، على الأقل، بـsource_url وfinal_url وtitle وmarkdown وlinks وstatus_code وfetched_at وcontent_sha256. حدّد حقول الأعمال التي يجوز أن تكون فارغة والحقول التي يؤدي غيابها إلى رفض الصفحة. احتفظ بالاستجابة الخام حتى يمكن إعادة تطبيق أي تغيير في المحلّل من دون دفع تكلفة الزاحف مرة أخرى.
3. عرّف إعادة المحاولات كأحداث محاسبية
احفظ لكل محاولة حالة المزوّد، وحالة HTTP، وحكم القبول، وسبب إعادة المحاولة، وتكلفة الرصيد أو الطلب، والإجراء التالي. افصل أخطاء النقل، وإخفاقات المزوّد المعلنة، وحالات حظر الوصول، والمحتوى الفارغ، وإخفاقات المخطط، وإخفاقات التحويل اللاحقة. ضع حدًا للمحاولات، ووجّه العناصر المستنفدة إلى طابور رسائل مهملة بدلًا من إنشاء حلقة إنفاق خفية.
4. احفظ حزمة الأدلة
استخدم مسارًا مفهرسًا بحسب الأداة والإصدار وبصمة الإعداد وتاريخ التشغيل ومعرّف العينة. خزّن الطلب والرؤوس والاستجابة غير المعدّلة وJSON الموحّد وMarkdown والحكم والبصمة. يجب أن يستطيع المراجع تحديد العارض ووضع الاستخراج والمخطط الذي أنشأ أي تقسيم مقبول.
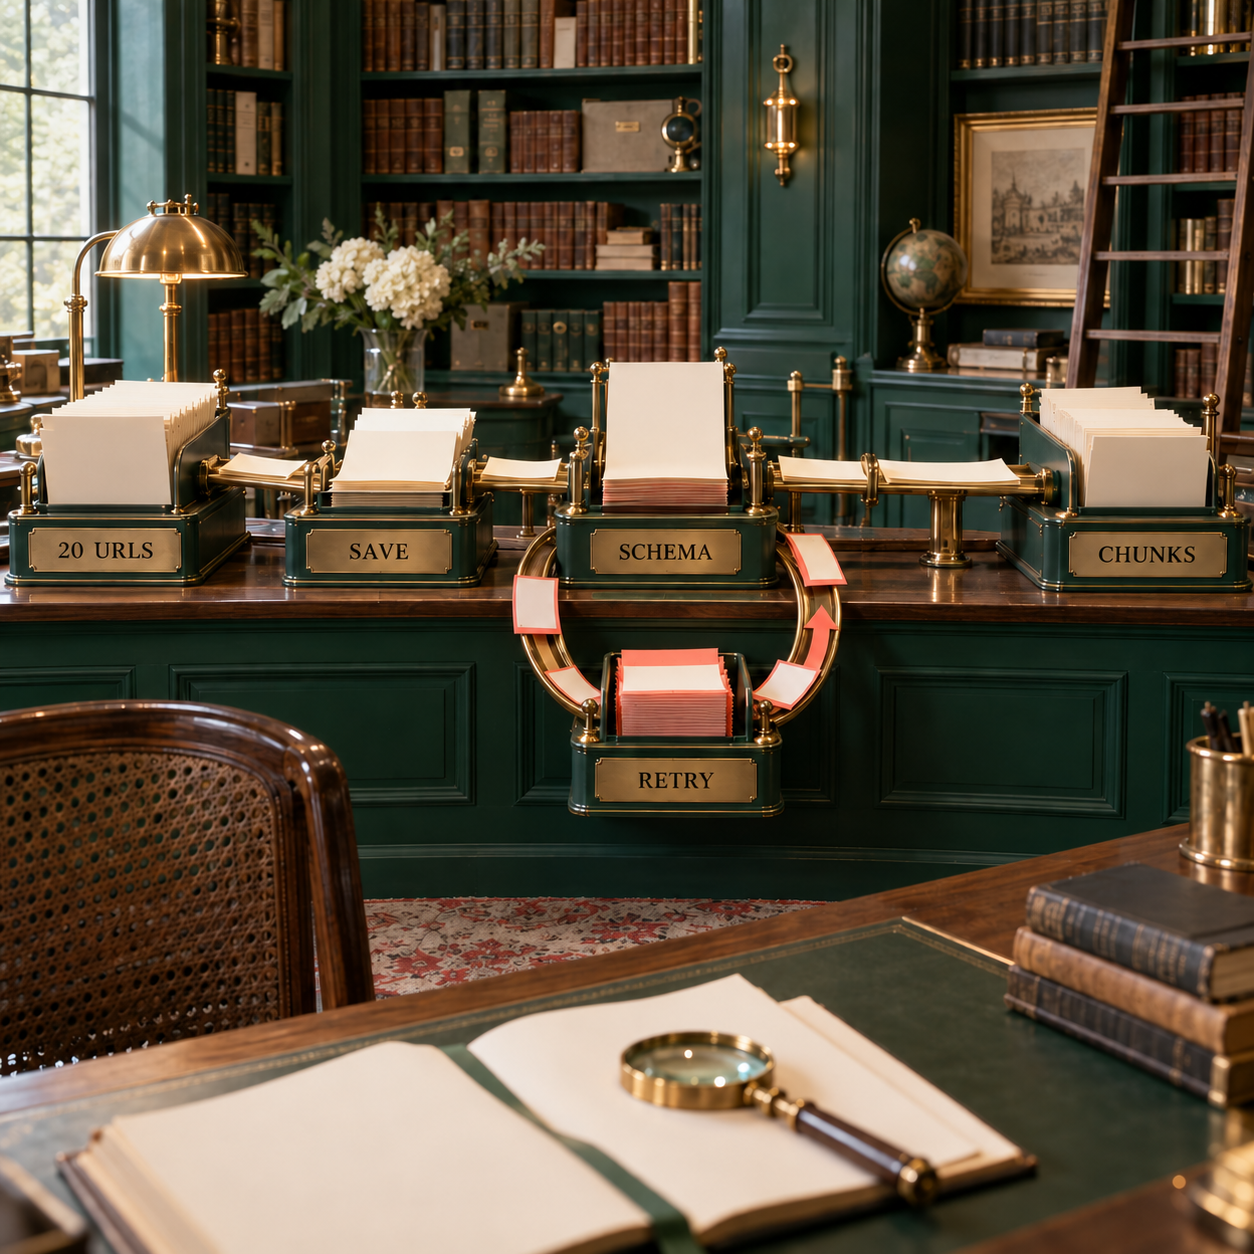
5. اختبر تقسيم النصوص اللاحق ضد الانحدار
قارن تسلسل العناوين وكتل الشيفرة والجداول وأهداف الروابط وترتيب المستند وبصمات المحتوى قبل إعادة تضمين أي شيء. ثم قارن عدد التقسيمات وحدودها واستشهادات المصادر. قد يغير نص Markdown أنظف سلوك الاسترجاع إذا اختفت العناوين أو انقسمت صفوف الجداول بين التقسيمات.
6. سعّر مجموعة الصفحات المقبولة وحدد التراجع
اجمع رسوم المزوّد وتكلفة المضيف ورموز الاستخراج وإعادة المحاولات المدفوعة والتخزين وساعات المشغّل. اقسم الناتج على الصفحات المقبولة، لا الطلبات. حدّد شرطًا للتراجع قبل الإطلاق، مثل إخفاق حقل مطلوب، أو شريحة هدف غير متوقعة، أو زيادة جوهرية في عدد التقسيمات، أو تجاوز سقف ساعات المشغّل. وأبقِ المسار القديم متاحًا حتى يجتاز الجديد فترة المراقبة تلك.
أول مخرج مفيد لفريق صغير ليس درجة المزوّد، بل ورقة تحتوي على صف لكل عنوان URL في العينة وأعمدة لكلا النظامين. بعد أن يحمل الصف أدلة محفوظة، يصبح النجاح أو الإخفاق قابلًا للمراجعة بدلًا من كونه تفضيلًا.
الأسئلة الشائعة
هل استخلاص بيانات الويب غير قانوني؟
لا توجد إجابة عامة بنعم أو لا. في الولايات المتحدة، تميّز سياسة وزارة العدل بشأن CFAA بين حواجز الوصول التقنية ومجرد قيد تعاقدي، لكن العقود وحقوق النشر والخصوصية واستخدام البيانات وضوابط الوصول والولاية القضائية قد تغيّر التحليل. هذه ليست استشارة قانونية؛ ويستحق جمع البيانات في بيئة الإنتاج رأي مستشار بشأن الأهداف والاستخدام المحددين.
هل Firecrawl باهظ التكلفة؟
يعتمد ذلك على المخرجات المقبولة. يكلف Crawl مقدار 1 رصيد لكل صفحة، ويضيف JSON عدد 4 أرصدة، لذا تحتاج 10,000 صفحة مقبولة مع احتياطي إعادة محاولة 10% إلى 55,000 رصيد في هذا النموذج، وتناسب Standard بسعر $83. وقد يكون عمل المشغّل وتكلفة الترحيل أهم من تلك الفاتورة.
ما أفضل أداة لاستخراج بيانات الويب؟
Apify Website Content Crawler هو البديل المُدار الأوسع في هذه القائمة المختصرة. ويتفوق Crawl4AI عندما تكون الاستضافة الذاتية إلزامية، ويبرز ScrapFly عند الجمع بين الزحف المُدار والاستخراج، ولا يفوز Jina Reader إلا عند وجود قائمة URL موثوقة مسبقًا.
هل يمكن استضافة Firecrawl ذاتيًا؟
نعم. تمنح النواة المستضافة ذاتيًا الفريق السيطرة، لكنه يتحمل عندئذ مسؤولية قواعد البيانات والطوابير وعمّال المتصفح والترقيات والأمان وتوجيه الوصول والمراقبة. وهي ليست المنتج التشغيلي نفسه مثل Firecrawl Cloud.
ما أبرز بدائل Firecrawl؟
يقارن هذا الدليل سبعة بدائل هي Apify Website Content Crawler وCrawl4AI وScrapFly وJina Reader وScrapingBee وZyte API وBright Data Crawl API. وتنقسم إلى زواحف كاملة، وأدوات Reader لعناوين URL الجاهزة، وواجهات تضع الوصول أولًا.
هل الاستضافة الذاتية قانونية؟
تشغيل البرنامج على بنية تحتية تسيطر عليها يختلف عمومًا عن السؤال المتعلق بما يصل إليه البرنامج. ولا تزال الأذونات وضوابط الوصول وشروط المواقع وحقوق النشر والخصوصية وقواعد حماية البيانات والاستخدام المقصود تحتاج إلى مراجعة مستقلة.
هل تستحق الاستضافة الذاتية العناء؟
تستحقه عندما تفوق قيمة حدود البيانات المطلوبة أو التخصيص أو قدرات المنصة المشتركة عبء التشغيل. وغالبًا لا يستحق إنشاء عبء مناوبة جديد فقط لإزالة فاتورة API شهرية متواضعة.
ما مخاطر الاستضافة المجانية؟
قد تدخل النسخ المجانية في السكون، أو تحد من CPU أو الذاكرة، أو تدوّر التخزين، أو تشترك في سمعة IP ضعيفة، ولا تقدم ضمانًا للاستعادة في الإنتاج. وقد تجعل هذه الحدود الزاحف يبدو غير موثوق حتى عندما لا يكون البرنامج هو السبب.
هل يمكنني استضافة موقع ذاتيًا مجانًا؟
قد يقع موقع هواية أو تقييم زاحف ضمن حصة مجانية. لكن زحف الإنتاج يظل يحتاج إلى الحوسبة والتخزين والنطاق الترددي وبنية الوصول والمراقبة والنسخ الاحتياطية ووقت المشغّل، لذلك لا يعني بند استضافة بقيمة $0 أن تكلفة التشغيل $0.
هل Firecrawl مفتوح المصدر؟
ينشر Firecrawl نواة مفتوحة المصدر قابلة للاستضافة الذاتية. ويضيف Firecrawl Cloud بنية تحتية مُدارة وخدمات تشغيلية، لذلك لا يعيد المستودع وحده إنتاج حدود تكلفة منتج Cloud أو موثوقيته.
- آخر تحديث
- 25 سبتمبر 2026
- التصنيف
- Build
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.

أفضل أدوات AI code review: بدائل CodeRabbit العملية
قارن أفضل بدائل CodeRabbit لمراجعة الكود بالذكاء الاصطناعي حسب السعر، ودعم منصات Git، وحدود البيانات، والاستضافة الذاتية قبل نقل سير عمل فريقك.25 سبتمبر 2026Build
AI code review: متى تختار Greptile ومتى تختار CodeRabbit؟
مقارنة عملية بين Greptile وCodeRabbit في الأسعار وحدود المراجعة ودعم Git وتكلفة الفرق، مع نموذج قرار يوضح متى يناسبك كل منتج قبل الاشتراك فعليًا.25 سبتمبر 2026Build
كيفية استخدام Perplexity Portable Computer محلياً على Windows وAMD
دليل عملي لتشغيل Perplexity Portable Computer محلياً على أجهزة AMD بنظام Windows، من فحص المتطلبات وضبط الصلاحيات إلى اختبار الملفات وجدولة المهام بأمان.25 سبتمبر 2026Build
مراجعة AgentRun: هل تستحق مكانًا في سير عمل الوكلاء؟
اختبار عملي لـ AgentRun beta.4 يوضح ضبط فروع سير العمل، وحدود استدعاءات الوكلاء، والتصعيد، والتكلفة، ومتى تكون دالة TypeScript أبسط خيار لفريقك.24 سبتمبر 2026Build
Perplexity Fast Search أم البحث الافتراضي: أي وضع يناسب عملك؟
مقارنة عملية بين Perplexity Fast Search والبحث الافتراضي من حيث التكلفة والسرعة وجودة الاسترجاع، مع قاعدة واضحة لتوجيه طلبات الوكلاء بحسب المخاطر.24 سبتمبر 2026Build
تكلفة وكلاء الذكاء الاصطناعي: كيف استنزف مسار الرجوع الميزانية
تحليل لحادثة استنزف فيها مسار رجوع مدفوع رصيداً مشتركاً، وكيف كشفت أن تكلفة وكلاء الذكاء الاصطناعي لا تنفصل عن اكتمال مخرجات النشر المطلوبة.24 سبتمبر 2026Build
اشتراك Cursor وRollouts: أين ينتهي العرض المجاني؟
دليل عملي لفهم اشتراك Cursor المطلوب للوصول إلى Rollouts، ورصيد الإطلاق لمدة 10 أيام، وحدود 50 و500 تغيير، وما يبقى مجهولًا في التسعير بعد انتهائه.24 سبتمبر 2026Build