Firecrawl Alternative: 7 Tools im Kostenvergleich
Sieben Firecrawl-Alternativen im Vergleich: Kosten, Markdown- und JSON-Ausgabe, Migrationsaufwand und Preis je nutzbarer Seite für KI-Pipelines.




Wer eine Firecrawl Alternative sucht, muss bei 10,000 akzeptierten Seiten genauer rechnen: In diesem Modell kostet Firecrawl $83 an Anbietergebühren plus drei Betriebsstunden, ScrapFly dagegen $30 plus drei Stunden. Die niedrigere Rechnung bedeutet nicht automatisch den günstigeren Ersatz, denn Discovery, Rendering-Wiederholungen, JSON-Extraktion und nachgelagertes Chunking können den Unterschied aufzehren.
Die Kurzantwort: Eine Firecrawl Alternative ersetzt eine ganze Pipeline
Apify Website Content Crawler ist die beste Wahl für einen möglichst ähnlichen, breit aufgestellten Managed-Service. Crawl4AI passt, wenn die Kontrolle über die Infrastruktur im Mittelpunkt steht. ScrapFly bündelt Crawling und strukturierte Extraktion in einem Credit-Pool. Jina Reader überzeugt, wenn ein anderes System die URLs bereits liefert. ScrapingBee, Zyte API und Bright Data Crawl API werden interessanter, sobald der Zugriff auf schwierige Seiten wichtiger ist als ein nativer Workflow von der Website zu Markdown.
Entscheidend ist weder ein Request noch eine gefundene URL, sondern eine akzeptierte Seite, die tatsächlich in der Retrieval-Augmented-Generation-Pipeline ankommt. Das Modell muss also brauchbares Quellenmaterial erhalten, in dem Markdown, JSON-Felder, Links und Metadaten vollständig erhalten sind. Eine günstige Antwort, die eine Tabelle verliert, ein leeres Preisfeld erfindet oder den Chunker beschädigt, ist ein bezahlter Fehlschlag.
Firecrawl als Referenz
Firecrawl dient als Referenz, weil sein Crawl-Endpunkt Discovery, Rendering und Seitenverarbeitung bereits bündelt und anschließend Markdown oder schemaförmiges JSON zurückgibt. Pro gecrawlter Seite fällt 1 Credit an, für den JSON-Modus weitere 4 Credits. Für diesen Vergleich liegt die relevante Ausgangsbasis damit bei 5 Credits je Versuch.
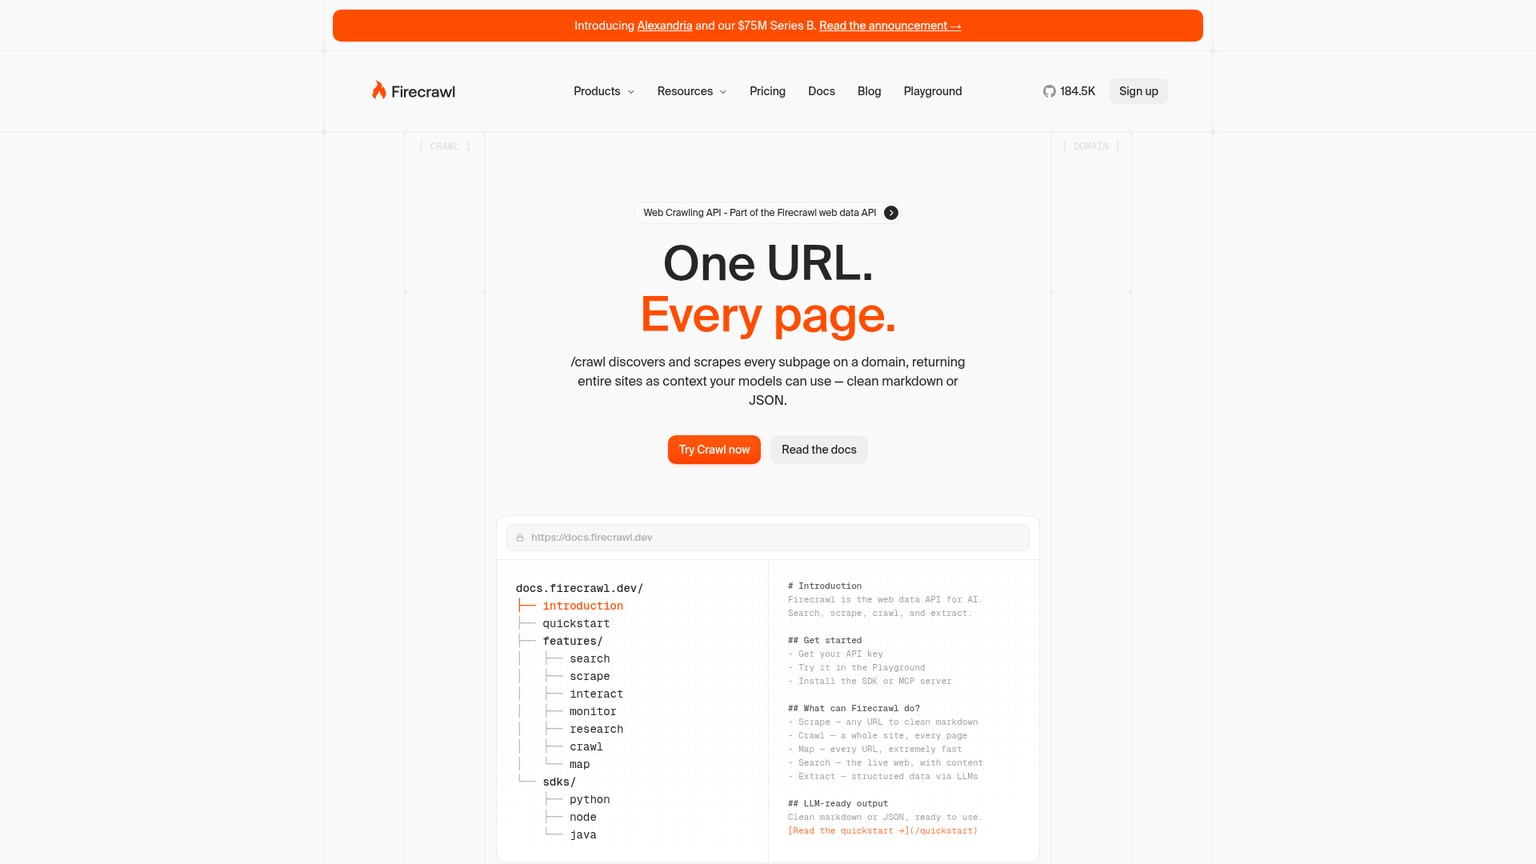
Gerade dieses Paket kann das Bleiben günstiger machen als einen auf den ersten Blick billigeren Wechsel. Firecrawl übernimmt außerdem Crawl-Umfang, Subdomains, Pfade, Tiefe und die gestreamte Auslieferung der Seiten. Eine Reader-API mag je URL weniger kosten, überlässt dem Team aber womöglich die Discovery. Eine Access-API kann geschützte Seiten abrufen, während Markdown-Konvertierung und Schemanormalisierung nachgelagert bleiben.
Firecrawl-Preise im Modell der akzeptierten Seite
Die aktuellen Firecrawl-Tarife sind Free für $0 mit 1,000 Credits, Hobby für $16 pro Monat bei jährlicher Abrechnung mit 5,000 Credits, Standard für $83 mit 100,000 Credits, Growth für $333 mit 500,000 Credits, Scale für $599 mit 1,000,000 Credits sowie Enterprise mit individuellem Preis. Zusätzliche Kontingente kosten bei Hobby $9 je 1,500 Credits, bei Standard $47 je 35,000, bei Growth $177 je 175,000 und bei Scale $397 je 350,000. Preise, Limits und Crawl-Funktionen wurden am 25. September 2026 anhand der aktuellen Firecrawl-Crawl-Seite geprüft.
Bei einer Reserve von 10% für technisch erfolgreiche Antworten, die am lokalen Akzeptanz-Gate scheitern, benötigen 1,000 akzeptierte Seiten mit Markdown und JSON insgesamt 5,500 Credits. Hobby plus ein Zusatzpaket kostet $25. Zehntausend akzeptierte Seiten benötigen 55,000 Credits und passen damit für $83 in Standard. Hunderttausend akzeptierte Seiten erfordern 550,000 Credits und damit Growth plus ein Zusatzpaket für $510.
Die Suche bildet eine eigene Schicht. Beginnt ein Auftrag mit einer Suchanfrage und benötigt gerankte Quellen statt einer bekannten Website oder URL-Liste, gehört zuerst der Vergleich von KI-Such-APIs entschieden. Erst danach gehen die ausgewählten URLs an die Extraktionsschicht.
Firecrawl-Alternativen im Überblick
Die Tabelle bewertet die dokumentierte Eignung, nicht die gemessene Ausgabequalität. Alle Preise wurden am 25. September 2026 auf den jeweiligen Anbieterseiten geprüft. „Kostenloser Test“ schließt auch ein dauerhaftes Gratis-Kontingent ein, sofern der Anbieter ein solches gewährt.
Einen universellen Sieger gibt es nicht, denn hinter dem Begriff „Web-Extraktion“ verbergen sich drei verschiedene Produktarten. Ein Crawler erschließt eine Website, ein Reader konvertiert eine vorgegebene URL, und eine Zugriffsschicht bewältigt Rendering oder Blockaden. Sinnvoll ist das schmalste Produkt, das alle Stufen übernimmt, die das Team nicht selbst betreiben möchte.
So wurden die Web Scraping Tools ausgewählt
In die Auswahl kam nur, wessen aktuelle Primärdokumentation einen belastbaren Weg sowohl zu brauchbaren Seiteninhalten als auch zu maschinenlesbaren Ausgaben belegt. Reine Such-APIs wurden ausgeschlossen, weil eine gerankte Discovery keinen Crawler ersetzt. Reine Proxy-Dienste fehlen ebenfalls: Eine IP-Adresse erzeugt weder sauberes Markdown noch die erforderlichen JSON-Daten oder ein gespeichertes Crawl-Manifest.
Fünf Akzeptanzprüfungen bestimmen den Vergleich:
- Discovery: Kann das Tool eine Website durchlaufen, den festgelegten Umfang einhalten und ein kanonisches URL-Manifest bewahren, oder muss eine andere Komponente jede URL liefern?
- Rendering und Zugriff: Kann es JavaScript ausführen und mit den Zugriffsbedingungen einer Website umgehen, ohne eine unbegrenzte Retry-Rechnung zu erzeugen?
- Ausgabevertrag: Bleiben Überschriften, Tabellen, Code und Links in Markdown erhalten, und lassen sich erforderliche JSON-Felder ohne eine zweite undurchsichtige Transformation erfüllen?
- Nachweise: Kann das Team für jede Test-URL Request, Rohantwort, normalisierte Ausgabe, Header, Konfiguration, Content-Hash und Urteil speichern?
- Gesamtkosten: Was kosten Discovery, Rendering, Extraktion, bezahlte Retries nach erfolgreicher, aber abgelehnter Antwort, Mindestabnahmen und Betriebszeit?
Für diesen Artikel wurde kein Kandidat ausgeführt. Deshalb werden weder Bestehensquoten noch Latenz-Ranglisten behauptet. Jede folgende Qualitätsaussage beschreibt eine dokumentierte Funktion; jeder Dollarvergleich ist ein Modell mit offengelegten Annahmen.
Der feste Akzeptanz-Test mit 20 URLs
Eine Migration sollte nie anhand einer Demo-URL des Anbieters entschieden werden. Stattdessen läuft derselbe feste Testsatz gegen die alte und die neue Konfiguration; jede Antwort wird gespeichert. Die URLs kombinieren bewusst Inhaltsformen, an denen unterschiedliche Fehler sichtbar werden:
- Code und lange Dokumente: MDN Fetch API, Python-Klassen, Rust Ownership, RFC 9110 als HTML und HTTPBin HTML.
- Tabellen, Links und strukturierte Seiten: MDN-Tabellenreferenz, W3C-Tabellentutorial, Wikipedia zu Web Scraping, Books-to-Scrape-Katalog und eine feste Produktseite.
- Paginierung und JavaScript: Quotes to Scrape, dessen JavaScript-Route, dessen Scroll-Route, der MDN-JavaScript-Leitfaden und HTTPBin-Linknormalisierung.
- Zeichenkodierung und PDFs: HTTPBin Unicode, RFC 9110 als PDF, ein zweispaltiges Forschungspapier als PDF, ein minimales W3C-PDF und IRS-Formular W-9.
Jedes Ergebnis muss source_url, final_url, title, markdown, links, status_code, fetched_at und content_sha256 enthalten. Produktseiten benötigen zusätzlich entity_name, amount und currency; das Forschungspapier braucht published_at. Ein Feld darf nur dort ausdrücklich null sein, wo das Testmanifest dies erlaubt. Fehlend ist nicht dasselbe wie null.
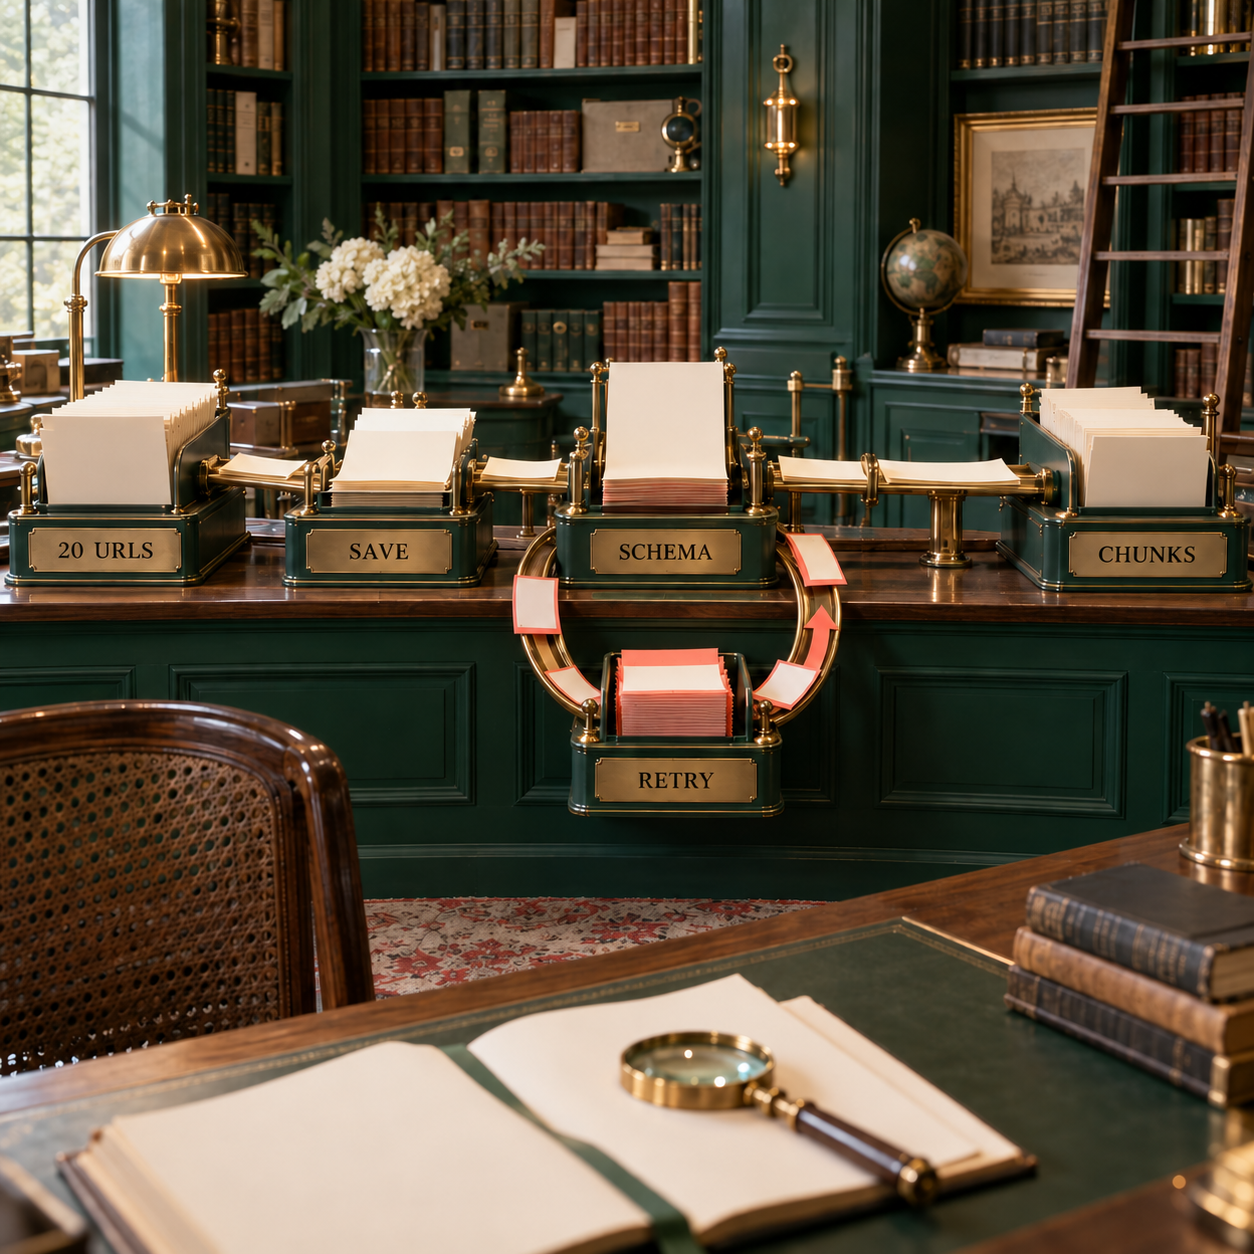
Für jedes Tool, jede Version und jede Konfiguration gehört ein eigenes Verzeichnis angelegt. Pro URL werden request.json, die Response-Header, der unveränderte Body, normalized.json, verdict.json und der SHA-256-Digest aufbewahrt. Das Urteil sollte die erste verletzte Regel nennen, nicht nur pass: false. So kann ein anderer Engineer die Entscheidung nachvollziehen, nachdem sich ein Anbieter, Parser oder eine Seite geändert hat.
Kostenrechnung je akzeptierter Seite
Das Modell rechnet mit 1,000, 10,000 und 100,000 akzeptierten Seiten pro Monat sowie einer Reserve von 10% für Antworten, die der Anbieter als erfolgreich wertet, die aber am lokalen Schema- oder Markdown-Gate scheitern. Diese Retries sind abrechenbar. Explizite Anbieterfehler werden nach der jeweils veröffentlichten Erstattungsregel behandelt.
Die Grundformel ist einfach: Anbieter- oder Host-Kosten plus Discovery, Rendering, Extraktion und bezahlte Retries, ergänzt um Betriebsstunden multipliziert mit dem Vollkostensatz des Teams. Die Tabelle weist Anbieterzahlung und Stunden getrennt aus, damit sich die Annahme von $100 je Stunde ersetzen lässt, ohne jede Anbieterformel neu aufzubauen.
Bei $100 je Betriebsstunde ergeben sich für 10,000 Seiten Gesamtkosten von $383 bei Firecrawl, $419 bei Apify, $1,248 bei Crawl4AI, $330 bei ScrapFly, $401.10 bei Jina, $449 bei ScrapingBee, $555.22 bei Zyte und $516.50 bei Bright Data. Der Jina-Wert gilt nur, wenn bereits ein verlässliches URL-Manifest existiert; er beschreibt keinen vollständigen Website-Crawl. Bei Bright Data und Zyte enthalten die Stunden nachgelagerte Markdown- und Schemaarbeit, weil keine der Produktseiten natives Markdown als den hier verwendeten Ausgabevertrag dokumentiert.
Die Extraktionszeile ist bewusst transparent. Firecrawl verbraucht 1 Crawl-Credit plus 4 JSON-Credits. Bei ScrapingBee umfasst das Szenario 5 JavaScript-Credits plus 5 KI-Credits. ScrapFly nutzt 5 Browser- oder Unblocker-Credits plus 5 Credits für das Extraktionsmodell. Zyte kombiniert Browser-Preisstufe 3 mit einer festen Custom-Attribute-Extraktion. Apify verwendet einen deterministischen JSON-Umschlag sowie 80% rohe HTTP- und 20% Headless-Seiten zum veröffentlichten oberen Headless-Schätzwert; optionale KI-Zusammenfassungen sind nicht eingerechnet.
Für Jina werden 2,000 Ausgabe-Tokens je Versuch angesetzt, zu $0.050 pro Million. Der Verbrauchswert ist winzig, der Zahlungsfluss jedoch sprunghaft: Sind die 10 Millionen kostenlosen Tokens aufgebraucht, umfasst das kleinste angebotene Paket 1 Milliarde Tokens für $50. Für Crawl4AI setzt das Modell DigitalOcean-Hosts zu $24, $48 und $96 für die drei Mengen an. Das sind Planungswerte, keine gemessenen Kapazitätsaussagen.
1. Apify Website Content Crawler: Bester gemanagter Gesamtersatz
Apify Website Content Crawler ist der stärkste breit aufgestellte Managed-Ersatz, wenn ein Team Discovery, JavaScript-Rendering, Markdown und einen dauerhaften Datensatz in einem Dienst benötigt. Das Tool crawlt per Raw HTTP oder Headless Firefox, speichert jedes Ergebnis als Datensatz und exportiert JSON oder CSV. Damit ähnelt die Migrationsform Firecrawl, ohne identische APIs vorzutäuschen.
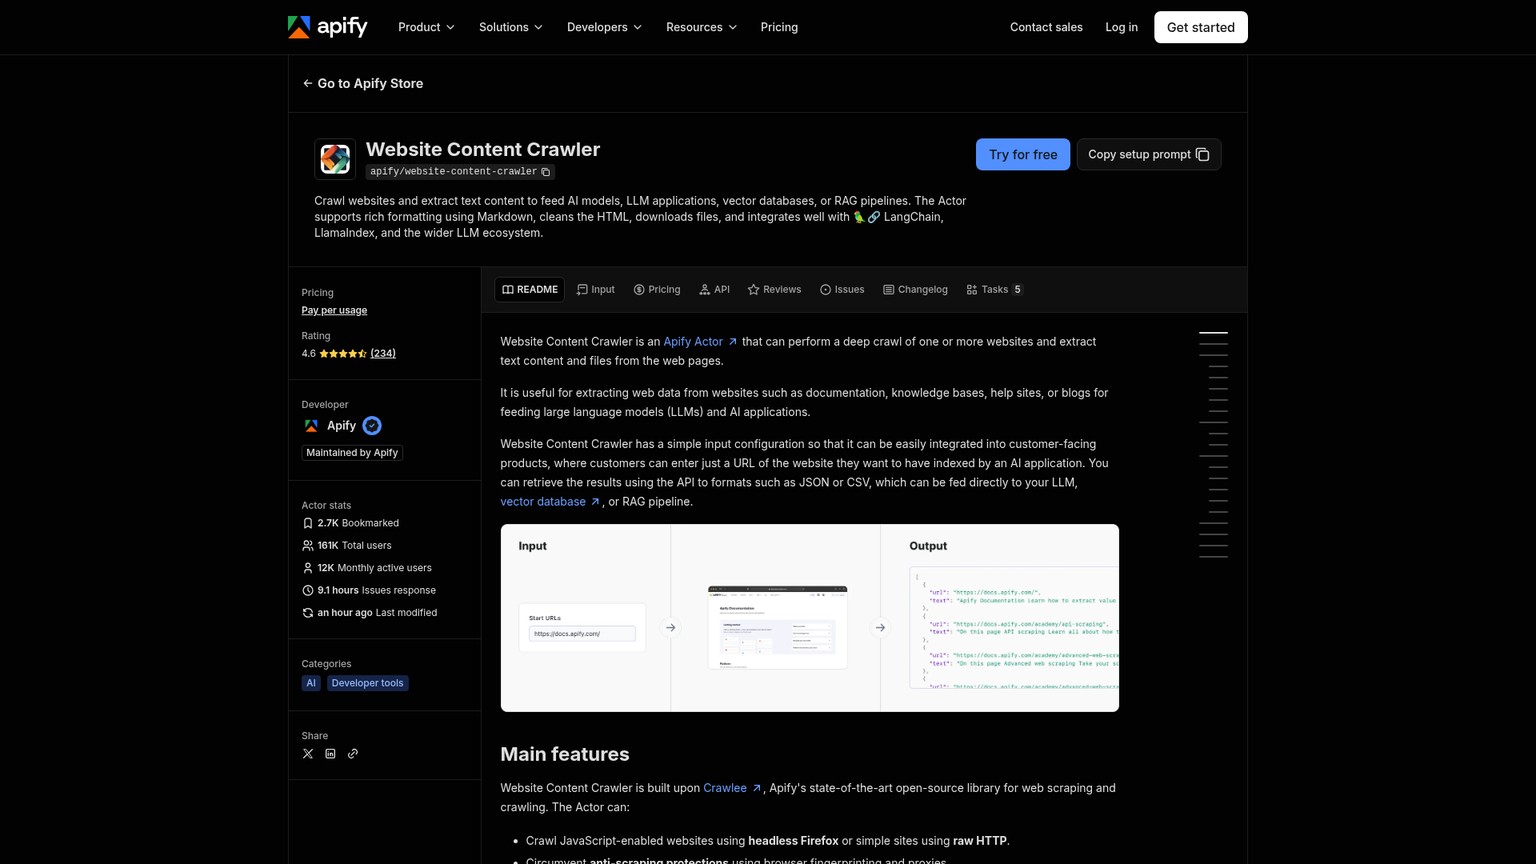
Der klarste Vorteil liegt in der Steuerung des Crawls als zusammenhängender Auftrag. Umfang, Ausgabe und gespeicherte Datensätze bleiben beieinander; auch Dateien wie PDFs lassen sich herunterladen. Die erkennbare Grenze ist die semantische Extraktion: Der JSON-Datensatz des Actors ist ein strukturierter Umschlag mit Text, Markdown und Metadaten. Ein individuelles Geschäftsschema benötigt dennoch deterministische Regeln, einen weiteren Actor oder eine Modellstufe.
Die veröffentlichte Schätzung des Actors liegt am angegebenen Ausgangspunkt bei ungefähr $0.20 je 1,000 Raw-HTTP-Seiten und $0.50 bis $5 je 1,000 Headless-Seiten. Optionale KI-Zusammenfassungen kosten rund $2 bis $3 je 1,000 Seiten; bei Seiten ohne Überschriften können es etwa $7 je 1,000 werden. Das obige Modell verzichtet auf dieses Add-on, weil eine Zusammenfassung kein Ersatz für erforderliche JSON-Felder ist.
Apify bietet Free für $0 mit $5 monatlichem Nutzungsguthaben und 5 gleichzeitigen Runs, Starter für $19 mit $19 Guthaben und 32 gleichzeitigen Runs, Scale für $199 mit $199 Guthaben, Compute Units zu $0.16 und 128 gleichzeitigen Runs, Business für $999 mit $999 Guthaben, Compute Units zu $0.13 und 256 gleichzeitigen Runs sowie ein individuelles Enterprise-Angebot. Im Free-Tarif stoppt die Nutzung nach Verbrauch des Guthabens. Bezahlte Tarife laufen als Mehrverbrauch weiter; ungenutztes Guthaben verfällt. Die aktuelle Apify-Preisseite ist die Quelle dieser Plattformbedingungen.
Am besten geeignet für: Kleine Produkt- oder Datenteams, die einen gemanagten Crawl-Auftrag ersetzen wollen, insbesondere wenn Run-Verlauf und Datensatzexporte wichtig sind.
Besonderheit: Websiteweite Discovery, Browser-Rendering, Markdown und dauerhaft gespeicherte JSON-Datensätze innerhalb desselben gemanagten Runs.
Preis: Free $0; Starter $19; Scale $199; Business $999; Enterprise individuell. Zu den tatsächlichen Actor-Kosten kommen Rechenleistung, Speicher, Proxys und Datentransfer des Runs hinzu.
Kostenloser Test: Der dauerhafte Free-Tarif enthält monatlich $5 Plattformguthaben und erfordert keine Karte.
- Raw HTTP und Headless Firefox decken sowohl günstige statische Seiten als auch JavaScript-Seiten ab.
- Datensätze vereinfachen die Prüfung und den Export gespeicherter Antworten.
- Crawl-Umfang, Dateidownloads, Metadaten und Markdown liegen in einem gemanagten Auftrag.
- Die Plattformrechnung verteilt sich auf Rechenleistung, Speicher, Transfer und Proxy-Nutzung statt auf einen einzigen Seiten-Credit.
- Ein JSON-Datensatz ist nicht automatisch das Geschäftsschema, das der nachgelagerte Code erwartet.
- KI-Zusammenfassungen verursachen separate Actor-Kosten und belegen noch keine akzeptierte Extraktion.
Apify-Migration in fünf Schritten testen
Das feste URL-Manifest laden
Begonnen wird mit den 20 Test-URLs, nicht mit der gesamten Produktionsdomain. Actor-Eingabe, Crawler-Typ, Seitenlimit und Umfang werden fixiert, damit ein zweiter Lauf tatsächlich dasselbe bedeutet.
Raw HTTP nutzen, bis eine Seite den Browserbedarf belegt
Statische Seiten bleiben auf dem günstigen Pfad, JavaScript-Testfälle werden zum Headless-Rendering geleitet. Der gewählte Crawler-Modus wird mit jedem Ergebnis gespeichert.
Markdown und Datensatz exportieren
Das unveränderte
markdown, die kanonische URL, Metadaten und Links bleiben erhalten. Die Umwandlung dieses Datensatzes in das erforderliche lokale JSON-Schema erfolgt in einem separaten deterministischen Schritt.Vor dem Chunking ablehnen
Tabellen-, Code-, Link- und Pflichtfeldprüfungen laufen gegen den normalisierten Datensatz. Bereits eine verletzte Regel schickt die URL ins Retry-Ledger statt in den Vektorindex.
Nur akzeptierte Seiten bepreisen
Die vollständige Rechnung für Actor, Proxys, Speicher und Betriebszeit wird durch die Zahl akzeptierter Seiten geteilt. Vor einer Ausweitung des Crawls folgt der Vergleich mit der Firecrawl-Basis.
2. Crawl4AI: Beste Self-Hosted-Alternative
Crawl4AI ist die beste selbst gehostete Wahl, wenn Infrastrukturhoheit, Datengrenzen oder wiederverwendbare Extraktionsregeln zwingend sind. Es erzeugt Markdown und unterstützt die strukturierte Extraktion per CSS, XPath oder LLM-Strategie. Damit kann es sowohl Retrieval-Text als auch JSON-Felder abdecken, ohne eine Softwaregebühr je Request zu verlangen.
Die aktuelle Sicherheitsbasis ist wichtiger als der Lizenzpreis. Version 0.9.4 erschien am 23. September 2026 und behebt drei Advisories, darunter zwei Pfade für Server-Side Request Forgery sowie einen Fehler an der Vertrauensgrenze der Konfiguration, über den Umgebungswerte offengelegt werden konnten. Jede Evaluation sollte v0.9.4 oder neuer festschreiben und vor der Freigabe der API die Sicherheitshinweise des Projekts prüfen.
Crawl4AI im Vergleich zu Firecrawl
Firecrawl verkauft den betriebenen Dienst rund um den Crawl: gemanagte Queues, Browser, Credits, Auslieferung und Support. Crawl4AI liefert Crawler und Extraktionssystem, während Deployment, Upgrades, Observability, Proxy-Strategie und Incident Response beim eigenen Team liegen. Die Entscheidung kippt, wenn diese Aufgaben bereits von einer gemeinsamen Plattform getragen werden – nicht, wenn ein einzelner Engineer sie eigens für dieses Projekt aufbauen müsste.
Für Self-Hosting werden mindestens 4 GB RAM, Docker 20.10 oder neuer und Compose 2.24 oder neuer empfohlen. Die Kostenrechnung nutzt die aktuellen Preise für DigitalOcean Basic Droplets: $24 für 4 GiB, $48 für 8 GiB und $96 für 16 GiB. Diese Größen sind lediglich Szenarioannahmen; in diesem Lauf wurde kein Seitendurchsatz gemessen.
Am besten geeignet für: Teams mit vorhandener Container-Plattform, strikter Datengrenze und Engineers, die den Crawler-Betrieb übernehmen können.
Besonderheit: Open-Source-Kontrolle plus deterministische Extraktionsschemata mit CSS oder XPath, die Modellausgaben pro Seite vermeiden können.
Preis: $0 Softwarelizenz. Das Modell setzt monatliche Hosts zu $24, $48 und $96 an; je nach Bedarf kommen Proxys, Speicher, Monitoring, Modellaufrufe und Arbeitszeit hinzu.
Kostenloser Test: Die Software ist Open Source; Infrastruktur ist nicht enthalten.
- Markdown und strukturierte Extraktion laufen innerhalb der selbst kontrollierten Infrastruktur.
- CSS- und XPath-Schemata können stabile Websites günstig und deterministisch verarbeiten.
- Der selbst gehostete Server ist inzwischen standardmäßig stärker auf Authentifizierung und Loopback-Sicherheit ausgerichtet.
- Proxy-Reputation, Browser-Kapazität, Patches, Queues und Wiederherstellung werden zur eigenen Aufgabe.
- Die Host-Größe belegt ohne gespeicherten Testlauf keinen Durchsatz akzeptierter Seiten.
- LLM-Extraktion verschiebt Modell-Token-Kosten und die Prüfung der Datengrenze zu einem weiteren Anbieter oder einem lokalen Modell.
Der Leitfaden zum Self-Hosting von Firecrawl behandelt die separate Entscheidung zwischen dem Firecrawl-Repository und Firecrawl Cloud. Die $0-Lizenz von Crawl4AI darf erst dann als Einsparung gelten, wenn dieselbe Rechnung auch die Personen enthält, die das System patchen und verfügbar halten.
3. ScrapFly: Beste Kombination aus Crawling und Extraktion für kleine Teams
ScrapFly ist die stärkste Alternative für kleine Teams, wenn ein Konto Zugriff, Crawling, Markdown-Konvertierung und typisierte Extraktion abdecken soll. Die Produkte teilen sich einen Credit-Pool; die Extraktionsschicht akzeptiert HTML, Markdown, XML, JSON, CSV, RSS oder Klartext. Teams können deterministische Templates, vortrainierte Modelle oder einen Prompt mit JSON-Schema einsetzen, ohne mehrere Anbieter miteinander zu verbinden.
Das Credit-Modell wird verständlich, sobald die Konfiguration feststeht. Ein einfacher HTTP-Request über ein Rechenzentrumsnetz kostet 1 Credit, JavaScript-Rendering oder Unblocker kosten 5, Residential Routing 25 und ein Screenshot der gesamten Seite 60. Template-Extraktion kostet 1 zusätzlichen Credit, ein Extraktions-Prompt oder -Modell 5. Bei Dokumenten über 500 KB fällt die Extraktionsgrundgebühr für jede weiteren 500 KB erneut an.
Damit kostet das Szenario des Artikels 10 Credits je erfolgreichem Versuch: 5 für Browser oder Unblocker plus 5 für die Extraktion. Einschließlich der Retry-Reserve von 10% sind es 11 Credits je akzeptierter Seite. Residential Routing ist nicht eingerechnet; sobald ein Ziel diesen Pfad benötigt, verändert sich das Ergebnis deutlich.
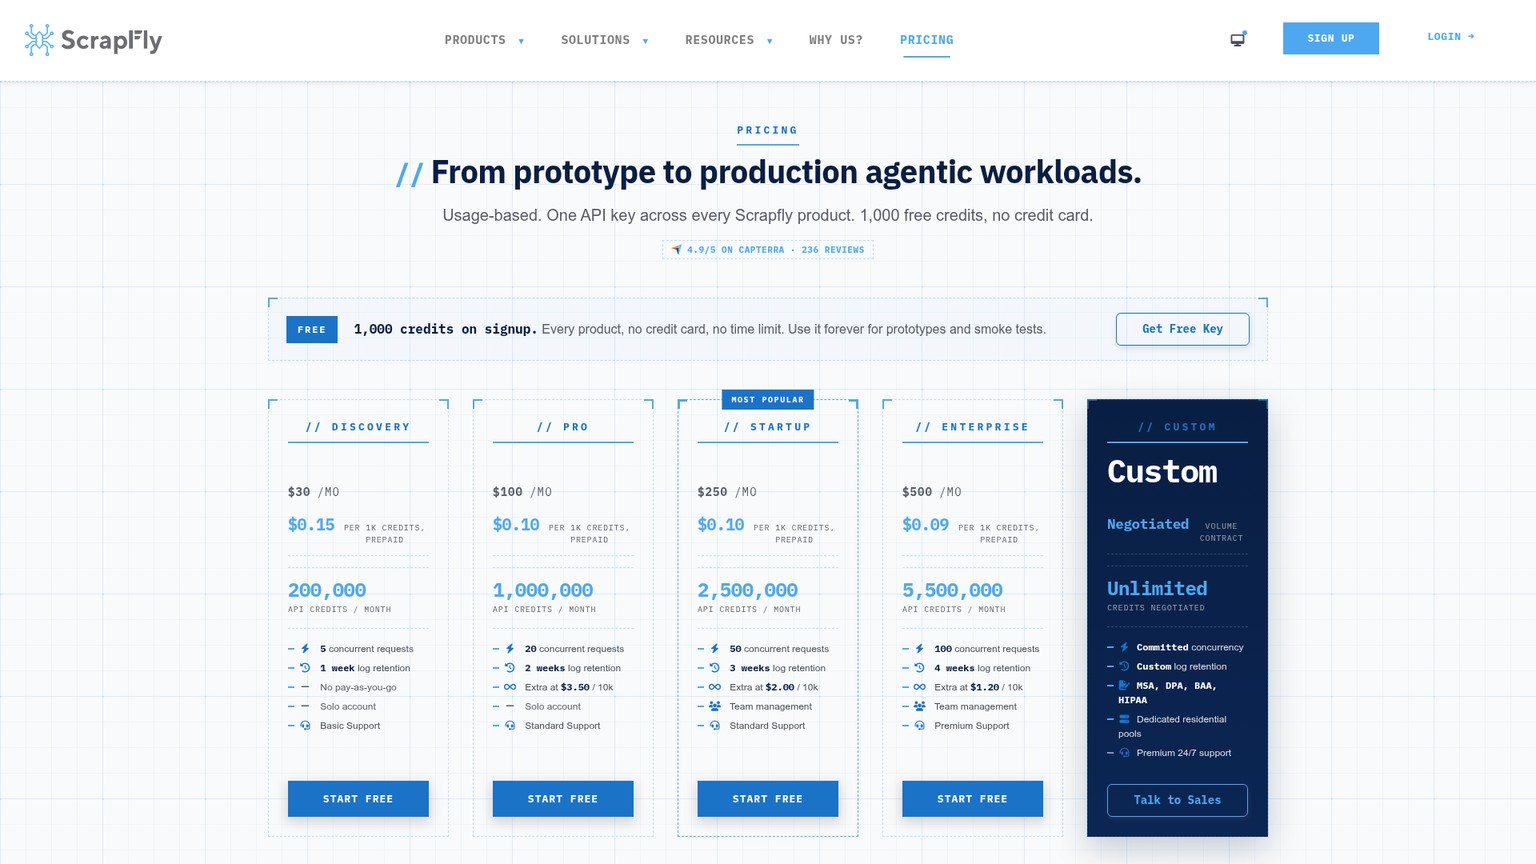
Die aktuellen Tarife sind Free mit einmalig 1,000 Credits, Discovery für $30 pro Monat mit 200,000 Credits und 5 gleichzeitigen Requests, Pro für $100 mit 1,000,000 Credits und 20 gleichzeitigen Requests, Startup für $250 mit 2,500,000 Credits und 50 gleichzeitigen Requests, Enterprise für $500 mit 5,500,000 Credits und 100 gleichzeitigen Requests sowie Custom nach Verhandlung. Discovery stoppt am Kontingent. Bei Pro kostet zusätzlicher Verbrauch $3.50 je 10,000 Credits, bei Startup $2 und bei Enterprise $1.20. Nicht genutzte Credits verfallen. Diese Konditionen stammen aus der aktuellen Preisübersicht von ScrapFly.
Am besten geeignet für: Kleine Teams, die einen gemanagten Crawler, Zugriffskontrollen und typisierte Extraktion auf einer Rechnung möchten.
Besonderheit: Derselbe Credit-Pool finanziert Crawler, Browser, Unblocker und drei Extraktionsstrategien.
Preis: Free 1,000 Credits; Discovery $30; Pro $100; Startup $250; Enterprise $500; Custom nach Verhandlung.
Kostenloser Test: 1,000 Credits bei der Registrierung, ohne Karte und ohne aufgeführtes Ablaufdatum.
- Template-Extraktion kann bei stabilen Layouts die Modellkosten senken.
- Vortrainierte und Prompt-gesteuerte Extraktion liefert typisiertes JSON ohne separaten Modellanbieter.
- Fehlgeschlagene Requests kosten keine Credits; der Response weist den tatsächlichen Verbrauch aus.
- Browser-, Residential- und Extraktionsoptionen summieren sich bei schwierigen Seiten schnell.
- Dokumente über 500 KB vervielfachen die Extraktionsgebühr.
- Discovery bietet keinen Mehrverbrauch, deshalb benötigen Produktionsaufträge Pro oder einen harten Stopp vor Ausschöpfung des Kontingents.
In diesem konkreten Szenario gewinnt ScrapFly die Kostenrechnung bei 10,000 akzeptierten Seiten: $30 plus drei Betriebsstunden gegenüber $83 plus drei bei Firecrawl. Die monatliche Bardifferenz von $53 ist zu gering, um eine unsaubere Migration zu rechtfertigen. Überzeugend wird sie erst, wenn der feste Testsatz besteht, die Produktionsziele den Residential-Pfad mit 25 Credits vermeiden und das Schema keine zusätzliche Bereinigung erfordert.
4. Jina Reader: Beste Wahl bei vorhandener URL-Liste
Jina Reader ist der beste Konverter mit niedrigen variablen Kosten, wenn die Discovery bereits gelöst ist und jede vorgegebene URL in sauberes Markdown oder schemaförmiges JSON umgewandelt werden soll. Die Standard-Engine rendert JavaScript in einem Headless Browser; die Direct Engine nimmt den einfacheren HTTP-Pfad. ReaderLM-v2 akzeptiert für strukturierte Ausgaben ein JSON-Schema oder eine natürlichsprachliche Anweisung.
Der Vorteil ist zugleich die Grenze: Reader liest eine URL. Der Dienst ersetzt weder Umfangsregeln für eine ganze Website noch Crawl-Frontier, Duplikatregeln oder Crawl-Manifest. Liefert eine Sitemap, Suchstufe oder ein interner Katalog zuverlässig die URL-Liste, kann diese enge Aufgabe ein Pluspunkt sein. Andernfalls gehören die Discovery-Kosten zurück in die Rechnung.
Die Basisnutzung von Reader ist kostenlos. Ein neuer Schlüssel enthält 10 Millionen Tokens; bei Verwendung eines Schlüssels werden Ausgabe-Tokens abgerechnet. Ein Paket mit 1 Milliarde Tokens kostet $50 beziehungsweise $0.050 je Million, eines mit 11 Milliarden $500 beziehungsweise $0.045 je Million. Fehlgeschlagene Requests ziehen keine Tokens ab. Die Limits liegen bei 20 Requests pro Minute ohne Schlüssel, 500 mit kostenlosem oder bezahltem Schlüssel und 5,000 mit Premium-Schlüssel. Sämtliche Werte stammen von der aktuellen Jina-Reader-Seite.
Die Rechnung setzt 2,000 Ausgabe-Tokens je erfolgreichem Versuch an. Nach Einrechnung der Retry-Reserve entspricht das einem Token-Verbrauchswert von $0.11 für 1,000 akzeptierte Seiten, $1.10 für 10,000 und $11 für 100,000. Es handelt sich um wirtschaftliche Nutzungswerte, nicht um den Betrag beim Bezahlvorgang. Ist das Gratis-Kontingent verbraucht, bleibt der kleinste aufgeführte Kauf ein Paket für $50.
Am besten geeignet für: Eine Pipeline mit verlässlichem URL-Manifest, die Seiten günstig in Markdown oder JSON konvertieren muss.
Besonderheit: Abrechnung nach Ausgabe-Tokens, JavaScript-Rendering und Extraktion per JSON-Schema in einer schlanken Reader-API.
Preis: Die Basisnutzung von Reader ist kostenlos; jeder neue API-Schlüssel erhält 10 Millionen Tokens; bezahlte Pakete kosten $50 für 1 Milliarde oder $500 für 11 Milliarden.
Kostenloser Test: 10 Millionen Tokens mit einem neuen API-Schlüssel.
- Der Standard-Renderer verarbeitet clientseitiges JavaScript vor der Konvertierung.
- Modi für JSON-Schema und Anweisungen können aus demselben Reader strukturierte Felder erzeugen.
- Fehlgeschlagene Requests verbrauchen keine Tokens.
- Discovery, Umfang und dauerhafte Speicherung des Crawl-Zustands benötigen eine weitere Komponente.
- Nach dem Gratis-Kontingent ist ein Token-Paket für $50 der kleinste Zahlungsschritt, selbst wenn der aktuelle Verbrauch erheblich weniger wert ist.
- Die Kosten der Ausgabe-Tokens hängen von Seitenlänge und Antwortformat ab.
Bei 100,000 Seiten wirkt Jina mit $11 plus sechs Stunden wie der Kostensieger, allerdings nur unter der Annahme eines gelieferten Manifests. Ein unzuverlässiger Discovery-Auftrag plus manuelle Deduplizierung würde diese Zeile mit Firecrawl oder Apify unvergleichbar machen. Das Tool passt, wenn die Komponentengrenze wirklich existiert – nicht, um fehlende Crawl-Arbeit zu kaschieren.
5. ScrapingBee: Beste Web Scraping API mit Credit-Limit
ScrapingBee ist die beste Alternative auf Request-Ebene, wenn ein Team die maximalen Kosten einer einzelnen Seite begrenzen möchte. Die API kann Markdown oder einen JSON-Response zurückgeben, CSS-Extraktionsregeln anwenden und KI-Extraktion ergänzen, wenn Layouts für Selektoren nicht stabil genug sind.
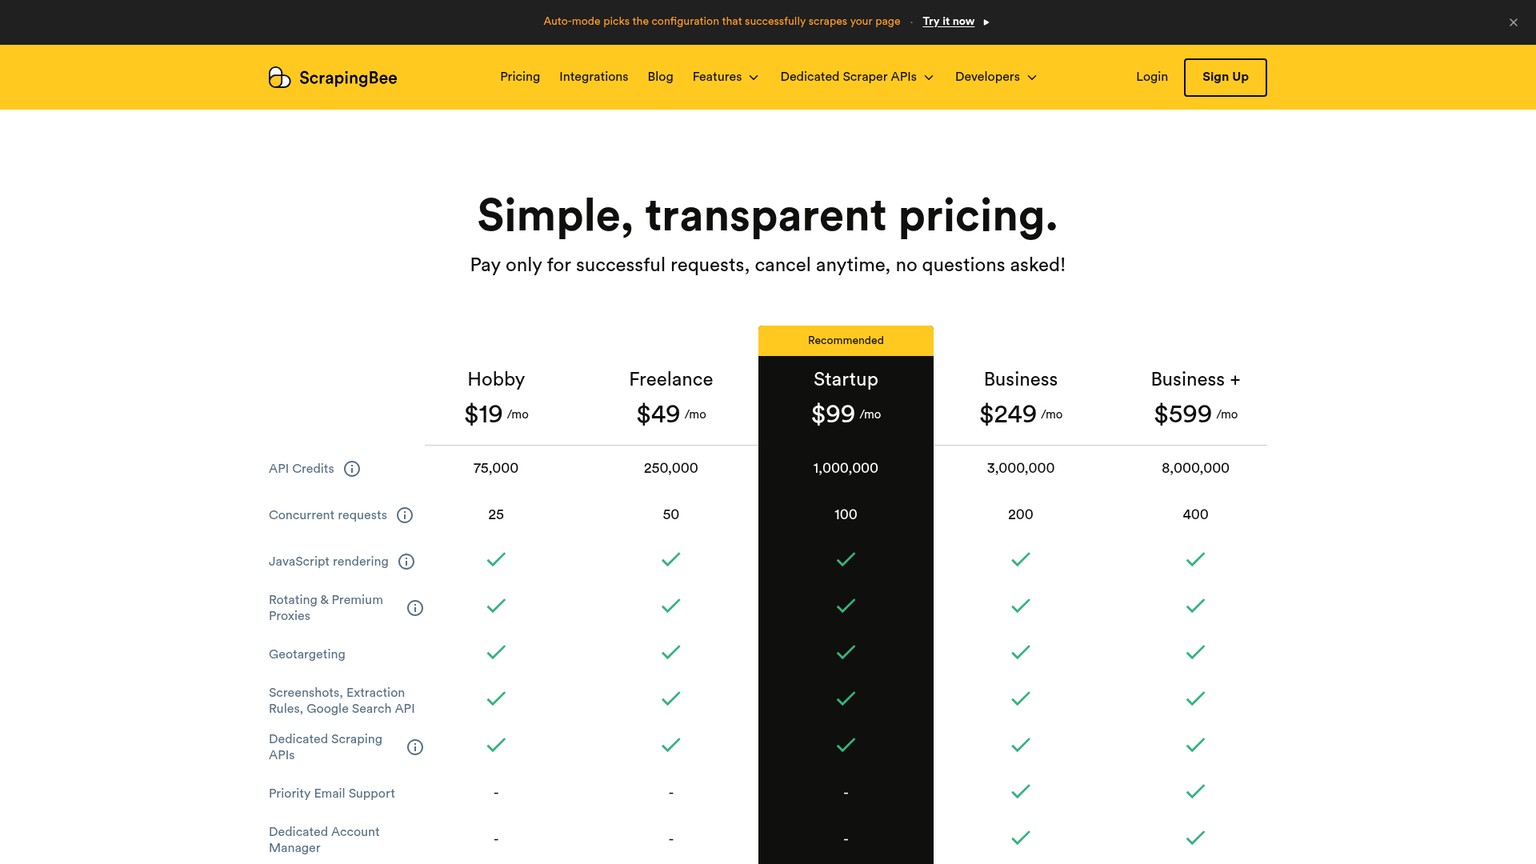
Die nützliche Steuerung liegt in der Credit-Staffel. Klassisches HTTP kostet 1 Credit, klassisches JavaScript 5, Premium ohne JavaScript 10, Premium mit JavaScript 25 und Stealth mit JavaScript 75. KI-Funktionen addieren 5 Credits. Der Auto-Modus berechnet die erfolgreiche Konfiguration, kostet nichts, wenn sämtliche internen Konfigurationen scheitern, und erlaubt eine Obergrenze je Request.
Die Grenze ist die Orchestrierung. ScrapingBee ruft angeforderte Seiten ab; für Firecrawls Website-Discovery und Crawl-Frontier ist es nicht der ähnlichste Ersatz. Das Team muss URL-Manifest, Umfang, Duplikatbehandlung und Auftragsstatus selbst verwalten und dabei einen Anbieterfehler von einer erfolgreichen Antwort unterscheiden, die am lokalen Akzeptanz-Gate scheitert.
Die aktuellen Tarife sind Hobby für $19 pro Monat mit 75,000 Credits und 25 gleichzeitigen Requests, Freelance für $49 mit 250,000 und 50, Startup für $99 mit 1,000,000 und 100, Business für $249 mit 3,000,000 und 200 sowie Business+ für $599 mit 8,000,000 und 400. Für die Evaluation stehen 1,000 Credits ohne Karte bereit. Diese Werte stammen aus den aktuellen Tarifen von ScrapingBee.
Am besten geeignet für: Teams, die Discovery bereits selbst betreiben und explizite Grenzen für Rendering-, Premium-Proxy- und Request-Kosten benötigen.
Besonderheit: Der Auto-Modus kann den Zugriff eskalieren, während max_cost den Verbrauch einer einzelnen Antwort begrenzt.
Preis: Hobby $19; Freelance $49; Startup $99; Business $249; Business+ $599.
Kostenloser Test: 1,000 Credits ohne Karte.
- Markdown, CSS-Extraktion und KI-Extraktion sind in einer Request-API verfügbar.
- Die Staffel mit 1, 5, 10, 25 und 75 Credits macht die Zugriffskosten nachvollziehbar.
- Der Auto-Modus kostet null, wenn alle internen Konfigurationen scheitern.
- Website-Discovery und Crawl-Persistenz bleiben außerhalb der Produktgrenze.
- Ein technisch erfolgreicher Response, der am eigenen Schema scheitert, bleibt ein bezahlter Versuch.
- Der Credit-Verbrauch kann vom klassischen JavaScript bis zum Stealth-JavaScript um das 15-Fache steigen, bevor KI-Extraktion hinzukommt.
Im Modell verbrauchen JavaScript plus KI-Extraktion 10 Credits je Versuch. Die Retry-Reserve erhöht dies auf 11 je akzeptierter Seite. Damit passen 1,000 Seiten für $19 in Hobby, 10,000 für $49 in Freelance und 100,000 für $249 in Business, weil 1.1 Millionen Credits die 1 Million von Startup überschreiten.
6. Zyte API: Beste Anti-Bot-Preise je Website
Zyte API passt am besten, wenn die Zugriffsschwierigkeit je Ziel stark schwankt und der Anbieter jede Website einer Preisstufe zuordnen soll. Der Antwortpreis bündelt den erforderlichen Rechenzentrums- oder Residential-Pfad, Rendering und Zugriffsarbeit; abgerechnet werden nur erfolgreiche Antworten.
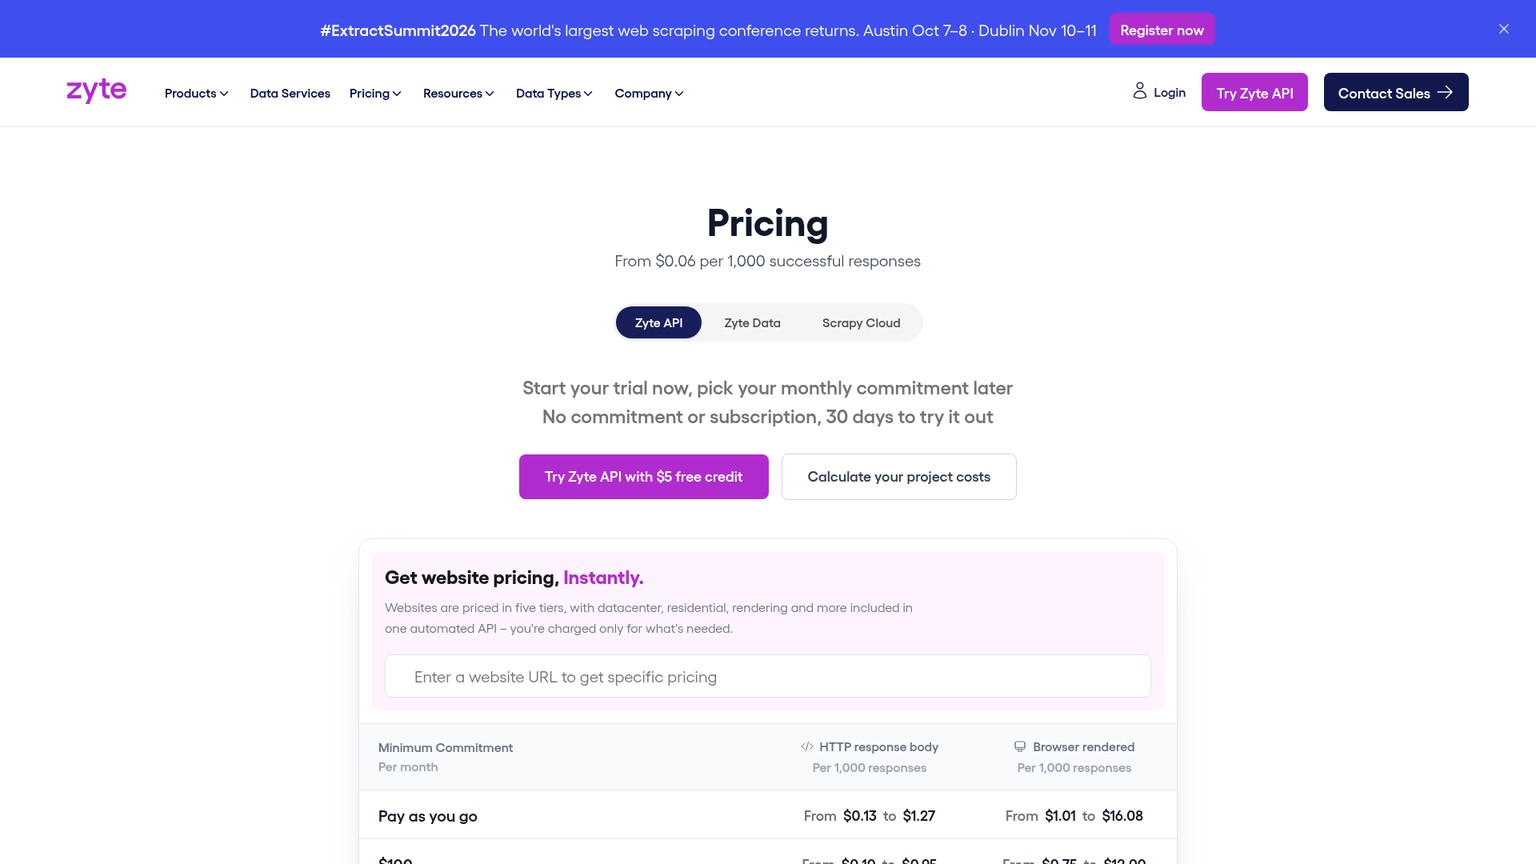
Die Pay-as-you-go-Preise für 1,000 HTTP-Antworten liegen über die Website-Stufen 1 bis 5 bei $0.13, $0.23, $0.44, $0.70 und $1.27. Browser-gerenderte Antworten kosten $1.01, $2.01, $4.02, $8.04 und $16.08. Bei einer monatlichen Abnahme von $100 sinken diese Browser-Preise auf $0.75, $1.50, $3, $6 und $12; bei $200 auf $0.60, $1.20, $2.40, $4.80 und $9.60; bei $500 auf $0.48, $0.96, $1.92, $3.84 und $7.68.
Auch die Abnahmestaffeln für HTTP sind relevant. Bei $100 kosten die Stufen 1 bis 5 je 1,000 Antworten $0.10, $0.17, $0.33, $0.53 und $0.95. Bei $200 sind es $0.08, $0.14, $0.26, $0.42 und $0.76. Bei $500 ergeben sich $0.06, $0.11, $0.21, $0.34 und $0.61. Enterprise bietet weitere ausgehandelte Rabatte. Die aktuelle Zyte-Preisseite nennt außerdem $5 Testguthaben für 30 Tage.
Benutzerdefinierte Attribute können eine feste extract-Methode für $0.001 oder eine generative Methode zu $0.002 je 1,000 Eingabe-Tokens und $0.01 je 1,000 Ausgabe-Tokens nutzen. Automatische Extraktion kostet $0.0004 bis $0.0016 je Datentyp. So erhält die Kostenrechnung eine klare Extraktionszeile, statt die Modellnutzung in einem undifferenzierten Tarif zu verstecken.
Die Grenze in diesem Vergleich ist das Ausgabeformat. Zyte dokumentiert HTTP-Bodys, Browser-HTML und strukturierte Felder, jedoch keinen nativen Markdown-Response-Vertrag. Eine nachgelagerte HTML-zu-Markdown-Konvertierung samt Regressionstests bleibt daher Teil der Migration.
Am besten geeignet für: Domainübergreifende Extraktion, bei der Zielschwierigkeit, Browserbedarf und Zugriffsinfrastruktur den Großteil der Anbieterrechnung bestimmen.
Besonderheit: Fünf Request-Preisstufen je Website und keine Gebühr für erfolglose oder rate-limitierte Antworten.
Preis: PAYG ohne Mindestabnahme; monatliche Abnahmen von $100, $200 und $500; Enterprise mit weiteren Rabatten. Der Antwortpreis hängt von der Website-Stufe sowie HTTP- oder Browser-Ausgabe ab.
Kostenloser Test: $5 Guthaben für 30 Tage ohne Mindestabnahme.
- Die zielabhängige Stufe bündelt die Zugriffsinfrastruktur in einem Antwortpreis.
- Erfolgsabhängige Abrechnung beseitigt direkte Kosten für Rate Limits und vom Anbieter ausgewiesene Fehler.
- Fest- und Token-preisige Custom Attributes machen Extraktionskosten sichtbar.
- Natives Markdown ist nicht als Ausgabe dokumentiert, deshalb bleibt die Konvertierung in eigener Verantwortung.
- Die Stufe eines Ziels kann sich ändern; auch erfolgreiche Antworten können am lokalen Content-Gate scheitern.
- Websiteweite Discovery und die nachgelagerte Gestaltung des Crawl-Zustands erfordern eine bewusste Konfiguration.
Die Kostenrechnung verwendet Browser-Rendering der Stufe 3 plus eine feste benutzerdefinierte Extraktion. Daraus entstehen bei den drei Mengen modellierte Anbieterkosten von $5.52, $55.22 und $374. Das ist ein Szenario, kein allgemeingültiger Zyte-Preis; die Stufe ist durch das Angebot für die tatsächlich zu crawlenden Domains zu ersetzen.
7. Bright Data Crawl API: Beste Wahl für geschützte Websites im großen Maßstab
Bright Data Crawl API ist der stärkste Kandidat, wenn Zugriff auf geschützte Websites, Proxy-Infrastruktur und Parallelität die Anforderungen dominieren. Im Preis enthalten sind JavaScript-Rendering, Residential Proxys, Validierung, CAPTCHA-Lösung, Geotargeting, Discovery, Parsing zu JSON oder CSV und unbegrenzte Parallelität.
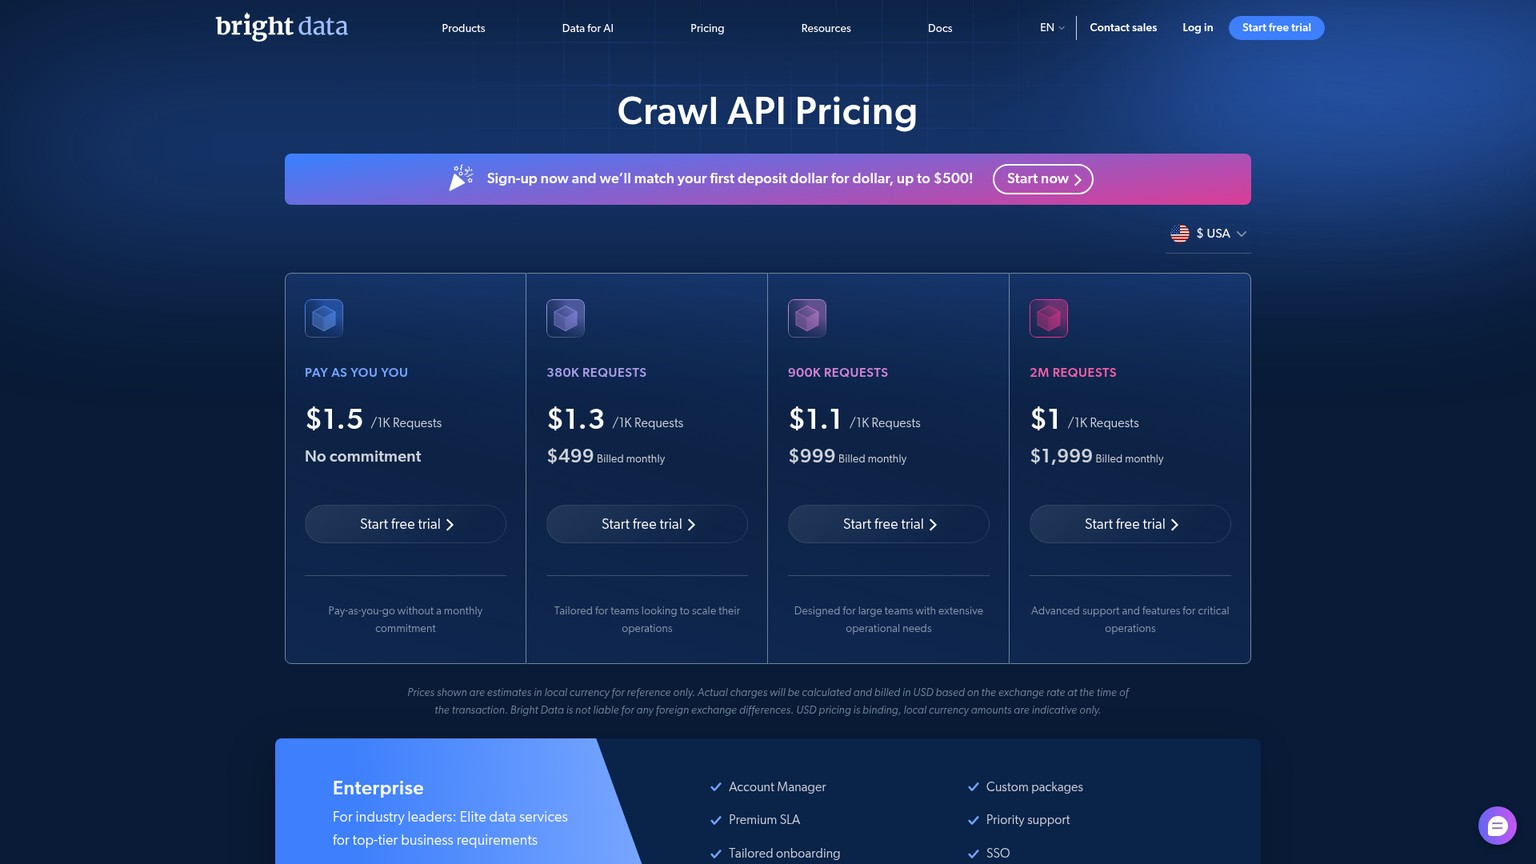
Das Angebot beginnt im Pay-as-you-go-Modell ohne Mindestabnahme bei $1.50 je 1,000 Requests. Der Tarif für 380,000 Requests kostet $499 pro Monat beziehungsweise $1.30 je 1,000; 900,000 Requests kosten $999 zu $1.10 je 1,000; 2 Millionen Requests kosten $1,999 zu $1 je 1,000. Enterprise wird individuell kalkuliert. Dies sind die aktuellen Preise der Bright Data Crawl API.
Die entscheidende Grenze entspricht der von Zyte: Als Auslieferungsformate sind NDJSON und CSV dokumentiert, nicht natives Markdown. Benötigt eine Retrieval-Pipeline stabile Überschriften, Codeblöcke, Tabellen und Quellenlinks in Markdown, wird der Konverter zur Produktionskomponente. Seine Fehler und die Betriebszeit gehören in den Nenner.
Mit den Pay-as-you-go-Preisen führt eine Reserve von 10% für abrechenbare Retries zu Anbieterkosten von $1.65 für 1,000 akzeptierte Seiten, $16.50 für 10,000 und $165 für 100,000. Diese niedrigen Request-Werte sind keine Gesamtkosten. Für Markdown-Konvertierung, Schemanormalisierung und Prüfung setzt die Rechnung vier, fünf und acht Stunden an; ein schwieriges Ziel kann das Request-Verhalten verändern.
Am besten geeignet für: Hochgradig parallele Erfassung geschützter Domains, bei der gemanagte Zugriffsarbeit wertvoller ist als natives Markdown.
Besonderheit: Rendering, Residential Routing, CAPTCHA-Behandlung, Validierung und unbegrenzte Parallelität sind im Preis der Crawl API enthalten.
Preis: PAYG $1.50 je 1,000 Requests; $499 für 380,000; $999 für 900,000; $1,999 für 2 Millionen; Enterprise individuell.
Kostenloser Test: Die aktuellen Preiskarten bieten einen kostenlosen Test, nennen in den sichtbaren Tarifbedingungen jedoch keine Guthabenhöhe.
- Zugriffsinfrastruktur, die sonst mehrere Komponenten erfordern würde, ist gebündelt.
- Unbegrenzte Parallelität eignet sich für große Aufträge mit festen Lieferfenstern.
- NDJSON und CSV ermöglichen eine maschinenlesbare Auslieferung, ohne das Anbieter-Dashboard auszulesen.
- Natives Markdown ist nicht als Ausgabevertrag dokumentiert.
- Der PAYG-Request-Preis allein verbirgt Konvertierungs-, Schema- und Prüfaufwand je akzeptierter Seite.
- Für öffentliche Dokumentationsseiten, die Raw HTTP problemlos verarbeitet, ist der breite Zugriffsstapel unnötiger Ballast.
Open-Source-Firecrawl-Alternativen für den Eigenbetrieb
Crawl4AI ist die klarste Open-Source-Alternative dieser Auswahl, doch auch Firecrawl veröffentlicht einen selbst hostbaren Kern. Entscheidend ist nicht, ob sich ein Repository klonen lässt. Entscheidend ist, ob das offene Deployment Discovery, Browserzugriff, Queues, Persistenz, Observability und den Ausgabevertrag reproduziert, auf die sich die Geschäftspipeline stützt.
Für Crawl4AI sollte Version 0.9.4 oder neuer festgeschrieben, Authentifizierung verlangt, private Evaluationsinstanzen angemessen gebunden und die exakte Image- oder Paketversion mit jedem Ergebnissatz gespeichert werden. Auf stabilen Templates sind CSS- oder XPath-Extraktionen vorzuziehen; jeder LLM-Extraktionsanbieter bleibt als eigene Kosten- und Datengrenze isoliert. Die modellierten 8 bis 20 monatlichen Betriebsstunden sind kein Benchmark. Sie sollen verhindern, dass Patches, Proxy-Fehler, Schema-Drift und Wiederherstellung fälschlich als kostenlos gelten.
Beim Firecrawl-Kern ist Cloud gegenüber Self-Hosting als eigene Architekturentscheidung zu behandeln. Das Repository kann eine Anbieter-Credit-Zeile entfernen, lädt dem Team dafür PostgreSQL, Redis, RabbitMQ, Browser-Worker, Monitoring und Upgrades auf. Der oben verlinkte Self-Hosting-Artikel enthält ein eigenes Prüfpaket für diese Entscheidung.
Welche KI eignet sich am besten für Web Scraping?
Die beste Wahl richtet sich nach der Eingabegrenze. Ist die Eingabe eine Domain und muss die Ausgabe ein vollständiger Markdown-und-JSON-Korpus sein, beginnt die Auswahl bei Firecrawl oder Apify, gefolgt von einer Kostenprüfung für ScrapFly. Liegt bereits eine vertrauenswürdige URL-Liste vor, entfernt Jina Reader die Crawl-Mechanik und kann erheblich günstiger sein. Ist der Zugriff das eigentliche Problem, sollten ScrapingBees Kostenobergrenze, Zytes Website-Stufen und Bright Datas gebündelter Zugriffsstapel gegeneinander antreten.
KI-Agenten für Web Scraping brauchen ein Akzeptanz-Gate
Ein Agent darf eine 200-Antwort nie selbstständig als bereit für das Retrieval einstufen. Er benötigt ein deterministisches Gate: Pflichtfelder, Mindestlänge des Markdowns, Erhalt von Tabellen und Code, normalisierte Links, Content-Hash, erlaubter Content-Type und ausdrückliche Null-Regeln. Der Agent kann Fehler weiterleiten, darf den Vertrag aber nicht aufweichen, nur damit ein Auftrag weiterläuft.
An vier Stellen kippt die Entscheidung:
- Bei Firecrawl bleiben, wenn es die Testfälle besteht und die Einsparungen über sechs Monate Migration und Parallelbetrieb nicht amortisieren.
- Apify wählen, wenn ein gemanagter Crawl-Auftrag, ein gespeicherter Datensatz und ein flexibler Actor-Workflow wichtiger sind als eine einzelne Zahl für Seiten-Credits.
- Crawl4AI wählen, wenn das Team Container, Zugriffs-Routing und Rufbereitschaft bereits betreibt oder eine Datengrenze eine gemanagte Verarbeitung ausschließt.
- Eine schmalere API wählen, wenn Discovery bereits gelöst ist oder der Zugriff auf geschützte Seiten den Auftrag dominiert. Jina, ScrapingBee, Zyte und Bright Data sind nur dann besonders stark, wenn diese Grenze schriftlich festgehalten ist.
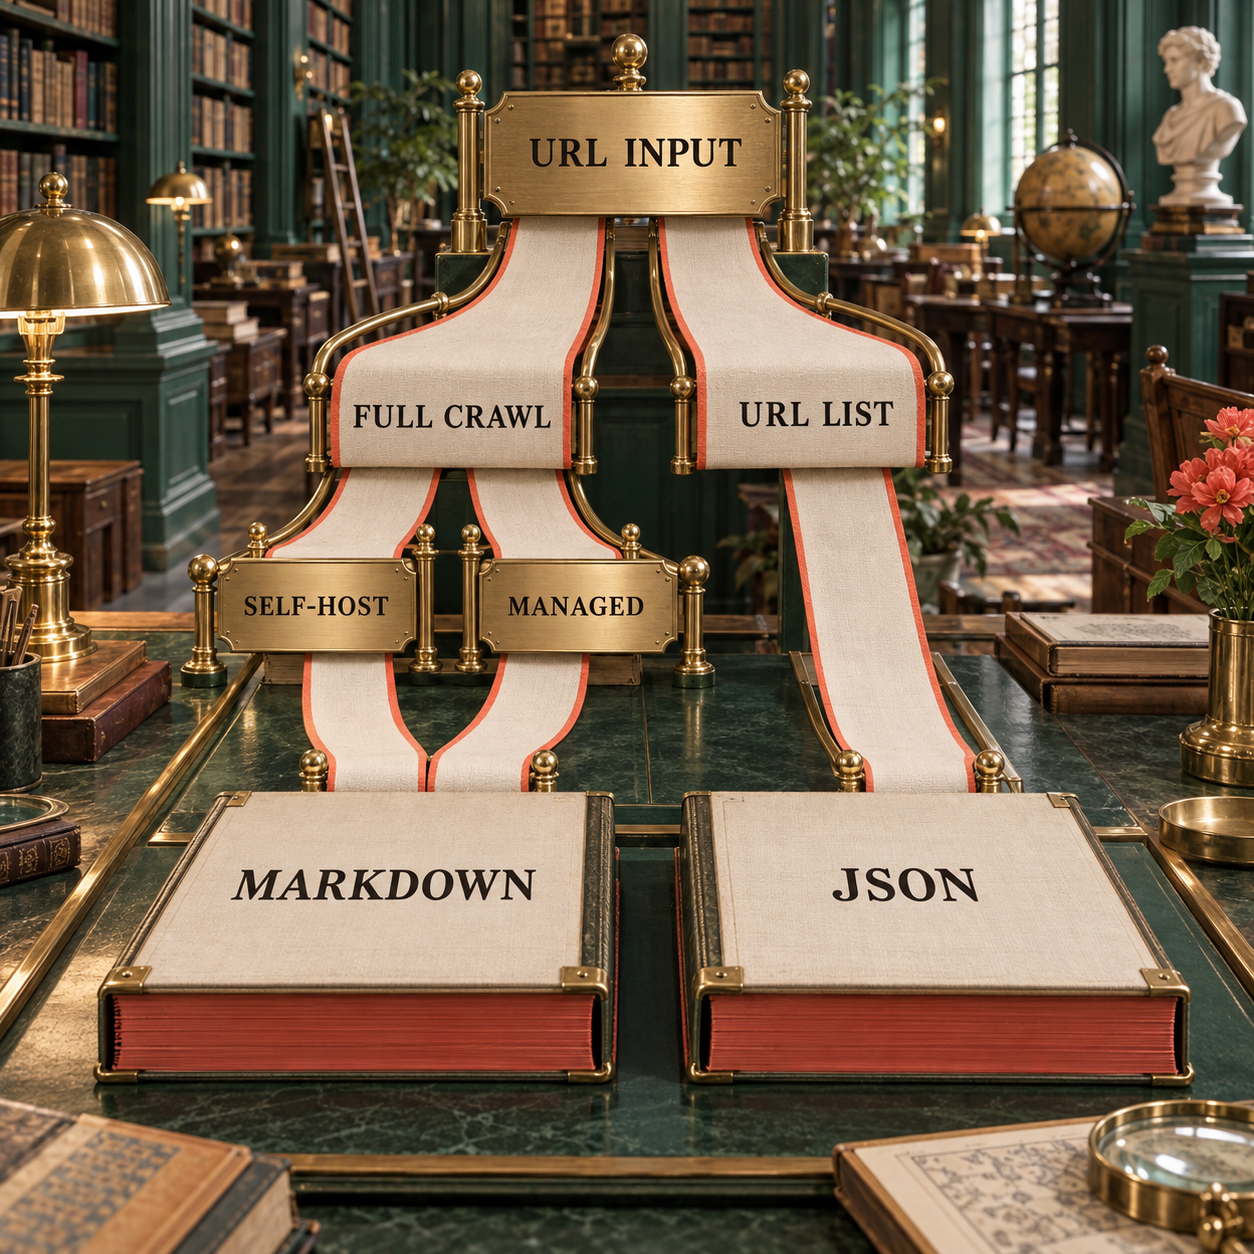
Die schönste Playground-Ausgabe ist kein Auswahlkriterium. Die gewählte Konfiguration muss denselben Testsatz bestehen, dieselben Nachweise speichern und dieselben nachgelagerten Chunks erzeugen. Ein Tool kann auf einer Artikelseite sauberer wirken und trotzdem an genau der Tabellen-, PDF- oder JavaScript-Route scheitern, die über die Produktionsfreigabe entscheidet.
Diese Optionen eignen sich nicht als direkter Ersatz
Ein Produkt aus einer Nachbarkategorie zu kaufen, vervollständigt die Pipeline nicht. Die folgenden Tools können nützlich sein, ersetzen aber nicht den vollständigen Firecrawl-Auftrag, der hier definiert ist:
- Exa und Tavily: Sie gehören in die Bewertung von Suchanbietern. Aus dieser Auswahl wurden sie gestrichen, weil der Ersatz hier erst beginnt, nachdem eine Domain oder URL-Menge feststeht und akzeptierte Seiteninhalte erzeugt werden müssen.
- Playwright und Puppeteer allein: Browser-Automatisierung ist ein Baustein, kein gemanagtes Crawl-Manifest, kein Markdown-Vertrag, kein Retry-Ledger und kein strukturiertes Auslieferungssystem. Sie passen nur, wenn genau diese Schichten selbst gebaut werden sollen.
- Ein reiner Proxy-Dienst: Der Zugriff auf einen Response bereinigt keine Navigation, bewahrt keine Links, validiert kein JSON und hält Chunk-Grenzen nicht stabil.
- Ein nicht gepflegter Crawler-Fork: Ein kostenloses Repository wird zum Incident, wenn sich Browser-Versionen, Sicherheitskorrekturen oder das Verhalten einer Zielseite ändern und niemand den Release-Pfad verantwortet.
Ebenso ungeeignet ist ein Marketing-Benchmark als Migrationsbeleg. Solange nicht die exakte Konfiguration gegen den gespeicherten 20-URL-Testsatz lief, beschreibt die Zahl den Workload eines anderen. Dieser Artikel veröffentlicht bewusst weder eine synthetische Bestehensquote noch eine Latenz-Rangliste.
Migrations-Worksheet für kleine Teams
Eine sichere Migration betreibt Firecrawl und den Kandidaten parallel, bis normalisierte Ausgaben, Retry-Verhalten und Chunks im festen Testsatz sowie in einer repräsentativen Produktionsstichprobe übereinstimmen. Das Worksheet braucht einen Verantwortlichen, ein versioniertes Schema und einen Rollback-Auslöser.
1. Eingabe- und Discovery-Vertrag festschreiben
Zunächst wird festgehalten, ob URLs aus einem Domain-Crawl, einer Sitemap, einer Such-API, Queue oder internen Datenbank stammen. Erlaubte Domains, Subdomain-Regel, ein- und ausgeschlossene Pfade, Tiefe, Seitenlimit, Kanonisierung und Duplikatregeln werden gespeichert. Ein Test von Jina oder ScrapingBee ist nicht mit Firecrawl vergleichbar, solange keine andere Komponente diese gesamte Zeile liefert.
2. Ausgabeschema einfrieren
Pflichtfelder und Typen werden versioniert. Mindestens erhalten bleiben source_url, final_url, title, markdown, links, status_code, fetched_at und content_sha256. Es wird festgelegt, welche Geschäftsfelder null sein dürfen und welche die Seite durchfallen lassen. Der Roh-Response bleibt erhalten, damit eine Parser-Änderung erneut ausgeführt werden kann, ohne den Crawler noch einmal zu bezahlen.
3. Retries als Buchungsereignisse definieren
Für jeden Versuch werden Anbieterstatus, HTTP-Status, Akzeptanzurteil, Retry-Grund, Credit- oder Request-Kosten und die nächste Aktion gespeichert. Transportfehler, vom Anbieter ausgewiesene Fehler, Zugriffsblockaden, leere Inhalte, Schemafehler und nachgelagerte Konvertierungsfehler bleiben getrennt. Retries werden begrenzt; ausgeschöpfte Einträge landen in einer Dead-Letter-Queue statt in einer unsichtbaren Kostenschleife.
4. Nachweispaket speichern
Der Pfad wird nach Tool, Release, Konfigurations-Hash, Laufdatum und Testfall-ID strukturiert. Gespeichert werden Request, Header, unveränderter Response, normalisiertes JSON, Markdown, Urteil und Digest. Ein Reviewer muss nachvollziehen können, welcher Renderer, Extraktionsmodus und welche Schemaversion einen beliebigen akzeptierten Chunk erzeugt haben.
5. Nachgelagertes Chunking regressionsprüfen
Vor einem erneuten Embedding werden Überschriftenhierarchie, Codeblöcke, Tabellen, Linkziele, Dokumentreihenfolge und Content-Hashes verglichen. Danach folgen Chunk-Anzahl, Chunk-Grenzen und Quellenangaben. Selbst ein saubererer Markdown-String kann das Retrieval-Verhalten verändern, wenn Überschriften verschwinden oder Tabellenzeilen auf mehrere Chunks verteilt werden.
6. Akzeptierten Korpus bepreisen und Rollback festlegen
Anbieterzahlung, Host-Kosten, Extraktions-Tokens, bezahlte Retries, Speicher und Betriebsstunden werden addiert. Geteilt wird durch akzeptierte Seiten, nicht durch Requests. Vor dem Start steht ein Rollback-Auslöser fest, etwa ein Pflichtfeldfehler, eine unerwartete Zielstufe, ein wesentlicher Anstieg der Chunk-Zahl oder eine Obergrenze für Betriebsstunden. Der alte Pfad bleibt verfügbar, bis der neue dieses Zeitfenster bestanden hat.
Für ein kleines Team ist der erste nützliche Gegenstand keine Anbieterpunktzahl, sondern ein Worksheet mit je einer Zeile pro Test-URL und Spalten für beide Systeme. Sobald die Zeile gespeicherte Nachweise enthält, wird Bestehen oder Scheitern prüfbar statt zur Geschmacksfrage.
Häufig gestellte Fragen
Ist Web Scraping illegal?
Darauf gibt es keine allgemeingültige Ja-oder-Nein-Antwort. In den USA unterscheidet die CFAA-Richtlinie des Department of Justice technische Zugriffsgrenzen von bloßen Vertragsbeschränkungen. Verträge, Urheberrecht, Datenschutz, Datennutzung, Zugriffskontrollen und Rechtsraum können die Bewertung dennoch verändern. Dies ist keine Rechtsberatung; für eine produktive Datenerhebung sollten die konkreten Ziele und Verwendungszwecke juristisch geprüft werden.
Ist Firecrawl teuer?
Das hängt von der akzeptierten Ausgabe ab. Crawl kostet 1 Credit je Seite, JSON weitere 4. Daher benötigen 10,000 akzeptierte Seiten mit 10% Retry-Reserve in diesem Modell 55,000 Credits und passen für $83 in Standard. Betriebs- und Migrationsaufwand können stärker ins Gewicht fallen als diese Rechnung.
Welches ist das beste Web-Scraping-Tool?
Apify Website Content Crawler ist in dieser Auswahl der breiteste gemanagte Ersatz. Crawl4AI ist stärker, wenn Self-Hosting zwingend ist; ScrapFly eignet sich für die Kombination aus gemanagtem Crawl und Extraktion; Jina Reader gewinnt nur, wenn bereits eine verlässliche URL-Liste existiert.
Lässt sich Firecrawl selbst hosten?
Ja. Der selbst gehostete Kern gibt dem Team Kontrolle, überträgt ihm aber auch Datenbanken, Queues, Browser-Worker, Upgrades, Sicherheit, Zugriffs-Routing und Monitoring. Es ist nicht dasselbe Betriebsprodukt wie Firecrawl Cloud.
Welche Alternativen zu Firecrawl gibt es?
Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API und Bright Data Crawl API sind die sieben hier verglichenen Alternativen. Sie verteilen sich auf vollständige Crawler, Reader für gelieferte URLs und zugriffsorientierte APIs.
Ist Self-Hosting legal?
Software auf eigener Infrastruktur auszuführen ist grundsätzlich eine andere Frage als die nach den Zugriffszielen dieser Software. Autorisierung, Zugriffskontrollen, Website-Bedingungen, Urheberrecht, Datenschutzregeln und der Verwendungszweck müssen weiterhin separat geprüft werden.
Lohnt sich Self-Hosting?
Es lohnt sich, wenn eine zwingende Datengrenze, Anpassungsbedarf oder eine gemeinsame Plattform den Betriebsaufwand aufwiegt. Nur zur Beseitigung einer überschaubaren monatlichen API-Rechnung eine neue Rufbereitschaftsfläche aufzubauen, lohnt sich meist nicht.
Welche Risiken hat kostenloses Hosting?
Kostenlose Instanzen können pausieren, CPU oder Arbeitsspeicher drosseln, Speicher zurücksetzen, eine schwache IP-Reputation teilen und keine Wiederherstellungsgarantie für den Produktivbetrieb bieten. Dadurch kann ein Crawler unzuverlässig wirken, obwohl die Ursache nicht in der Software liegt.
Kann eine Website kostenlos selbst gehostet werden?
Eine Hobby-Website oder Crawler-Evaluation kann in ein Gratis-Kontingent passen. Ein produktiver Crawl verursacht weiterhin Kosten für Rechenleistung, Speicher, Bandbreite, Zugriffsinfrastruktur, Monitoring, Backups und Betriebszeit. Eine Host-Zeile mit $0 bedeutet deshalb keine Betriebskosten von $0.
Ist Firecrawl Open Source?
Firecrawl veröffentlicht einen selbst hostbaren Open-Source-Kern. Firecrawl Cloud ergänzt gemanagte Infrastruktur und Betriebsleistungen; das Repository allein reproduziert daher weder die Kosten- noch die Zuverlässigkeitsgrenze des Cloud-Produkts.
- Zuletzt aktualisiert
- 25. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

CodeRabbit Alternative: 7 Tools für automatisierte Code-Reviews
Sieben CodeRabbit-Alternativen im Vergleich: Kosten, Git-Hosts, Datenschutz und Self-Hosting für Teams, die ihren KI-Code-Reviewer gezielt ersetzen.25. Sept. 2026Build
CodeRabbit Alternative: Wann Greptile die bessere Wahl ist
Greptile oder CodeRabbit? Der Vergleich zeigt Preise, Prüflimits, Git-Plattformen und reale Teamkosten – plus einen belastbaren Testplan vor dem Kauf.25. Sept. 2026Build
Perplexity Windows App: Portable Computer lokal nutzen
Portable Computer in der Perplexity Windows App einrichten: AMD-PC prüfen, Dateiaufgaben lokal testen und Kosten sowie Cloud-Freigaben kontrollieren.25. Sept. 2026Build
AgentRun im Test: KI-Workflow-Automatisierung mit klaren Grenzen
AgentRun im Praxistest: Wie der TypeScript-Interpreter KI-Workflows strukturiert, Agentenaufrufe begrenzt – und wann eine einfache Funktion besser ist.24. Sept. 2026Build
Perplexity Suchmaschine: Fast Search oder Web?
Perplexity Suchmaschine im Vergleich: Fast Search oder Web? Preise, Tempo, Quellenabdeckung und die passende API-Einstellung für KI-Agenten.24. Sept. 2026Build
KI-Agenten-Kosten: Wie Fallbacks das Budget leeren
Ein blockierter Datei-Upload machte den bezahlten Fallback zum Standard. So liefen KI-Agenten-Kosten aus dem Ruder, obwohl Jobs weiter „done“ meldeten.24. Sept. 2026Build
Cursor Rollouts kostenlos? Was Zugang und Nutzung kosten
Ist Cursor Rollouts kostenlos? Nur Teams und Enterprise erhalten Zugang. Was die 10-Tage-Credits abdecken und welche Kosten danach offenbleiben.24. Sept. 2026Build