Web crawler alternativi a Firecrawl: 7 opzioni a confronto
Confronto tra 7 web crawler alternativi a Firecrawl: prezzi, modelli operativi e costi per pagina accettata, con un piano pratico per migrare.




Tra i web crawler alternativi a Firecrawl, il punto di svolta arriva a 10,000 pagine accettate: in questo modello, Firecrawl costa $83 di servizio più tre ore di lavoro operativo, mentre ScrapFly costa $30 più tre ore. La fattura più bassa non indica automaticamente la soluzione più economica: discovery, nuovi tentativi con rendering, estrazione JSON e suddivisione downstream possono annullare il vantaggio.
La risposta breve: sostituire Firecrawl significa sostituire una pipeline
Scegliete Apify Website Content Crawler se cercate il sostituto gestito più completo, Crawl4AI se il controllo dell'infrastruttura è il requisito principale, ScrapFly se un solo monte crediti deve coprire crawling ed estrazione strutturata, e Jina Reader se un altro sistema fornisce già gli URL. ScrapingBee, Zyte API e Bright Data Crawl API diventano più interessanti quando accedere a pagine difficili conta più di un flusso nativo dal sito a Markdown.
L'unità che conta non è una richiesta né un URL scoperto, ma una pagina accettata che raggiunge la pipeline di retrieval-augmented generation: il modello deve ricevere materiale sorgente utile, con Markdown, campi JSON, link e metadati richiesti ancora integri. Una risposta economica che perde una tabella, inventa un campo prezzo vuoto o rompe il chunker è un errore già pagato.
Firecrawl come riferimento
Firecrawl è il riferimento perché il suo endpoint Crawl riunisce discovery, rendering ed elaborazione delle pagine, quindi restituisce Markdown o JSON conforme a uno schema. Il costo è di 1 credito per pagina sottoposta a crawling, più altri 4 crediti in modalità JSON: per questo confronto il valore di riferimento è quindi 5 crediti per ogni pagina tentata.
È proprio questo pacchetto a rendere talvolta più conveniente restare, anche davanti a un'alternativa apparentemente meno cara. Firecrawl gestisce inoltre ambito del crawl, sottodomini, percorsi, profondità e consegna delle pagine in streaming. Una reader API può costare meno per URL ma lasciare la discovery al team; una access API può recuperare pagine protette ma demandare a valle la conversione in Markdown e la normalizzazione dello schema.
Prezzi di Firecrawl nel modello per pagina accettata
I piani attuali di Firecrawl sono Free a $0 per 1,000 crediti, Hobby a $16 al mese con fatturazione annuale per 5,000 crediti, Standard a $83 per 100,000 crediti, Growth a $333 per 500,000 crediti, Scale a $599 per 1,000,000 crediti ed Enterprise con prezzo personalizzato. I costi di eccedenza sono $9 ogni 1,500 crediti per Hobby, $47 ogni 35,000 per Standard, $177 ogni 175,000 per Growth e $397 ogni 350,000 per Scale. Dati, limiti e funzionalità di crawling sono stati verificati sulla pagina Crawl di Firecrawl aggiornata al 25 settembre 2026.
Con una riserva del 10% per le risposte riuscite che non superano il controllo locale di accettazione, 1,000 pagine accettate in Markdown e JSON richiedono 5,500 crediti. Hobby più un blocco di eccedenza costa $25. Diecimila pagine accettate richiedono 55,000 crediti, quindi basta Standard a $83. Centomila pagine accettate richiedono 550,000 crediti, coperti da Growth più un blocco di eccedenza per $510.
La ricerca è un livello distinto. Se il lavoro parte da una query e richiede fonti ordinate per rilevanza, anziché un sito noto o un insieme di URL, usate il confronto tra API di ricerca AI per questa scelta e passate poi gli URL selezionati al livello di estrazione.
Web crawler alternativi a Firecrawl: il confronto rapido
La tabella valuta l'aderenza delle funzionalità documentate, non la qualità misurata dell'output. I prezzi sono stati verificati sulle pagine ufficiali il 25 settembre 2026. Per “prova gratuita” si intende anche una quota gratuita permanente, quando è questa l'offerta del fornitore.
Non esiste un vincitore universale, perché l'espressione “estrazione web” racchiude tre prodotti diversi. Un crawler scopre le pagine di un sito, un reader converte un URL fornito e un livello di accesso supera rendering o blocchi. Conviene acquistare il prodotto più circoscritto che gestisca ogni fase che il team non vuole operare internamente.
Come sono stati scelti questi strumenti
Un candidato è entrato nell'elenco solo quando la documentazione ufficiale attuale mostrava un percorso credibile sia verso contenuti di pagina utilizzabili sia verso un output leggibile dalle macchine. Le API dedicate solo alla ricerca sono state escluse perché la discovery ordinata per rilevanza non sostituisce un crawler. Sono stati esclusi anche i servizi di soli proxy: un indirizzo IP non produce Markdown pulito, il JSON richiesto o un manifest di crawl salvato.
Il confronto ruota attorno a cinque controlli di accettazione:
- Discovery: può attraversare un sito, rispettarne l'ambito e conservare un manifest degli URL canonici, oppure un altro componente deve fornire ogni URL?
- Rendering e accesso: può eseguire JavaScript e gestire le condizioni di accesso del sito senza generare un conto illimitato per i retry?
- Contratto di output: conserva titoli, tabelle, codice e link in Markdown e può soddisfare i campi JSON obbligatori senza una seconda trasformazione opaca?
- Prove: il team può salvare richiesta, risposta grezza, output normalizzato, header, configurazione, hash del contenuto e verdetto per ogni URL del set di test?
- Costo completo: quanto si paga per discovery, rendering, estrazione, retry di risposte riuscite ma rifiutate, impegni minimi e tempo operativo?
Nessun candidato è stato eseguito per questo articolo. Non vengono quindi dichiarate percentuali di superamento dei test né classifiche di latenza. Ogni osservazione sulla qualità descrive una funzionalità documentata; ogni confronto in dollari è un modello con ipotesi esplicite.
Il set fisso di accettazione con 20 URL
Non migrate sulla base dell'URL dimostrativo di un fornitore. Usate lo stesso set fisso con la configurazione vecchia e quella nuova, quindi salvate ogni risposta. Il set combina volutamente tipi di contenuto che fanno emergere problemi differenti:
- Codice e documenti lunghi: MDN Fetch API, classi Python, ownership in Rust, RFC 9110 in HTML e HTML di HTTPBin.
- Tabelle, link e pagine strutturate: riferimento MDN per le tabelle, tutorial W3C sulle tabelle, web scraping su Wikipedia, catalogo Books to Scrape e una pagina prodotto fissa.
- Paginazione e JavaScript: Quotes to Scrape, la sua route JavaScript, la sua route con scorrimento, guida MDN a JavaScript e normalizzazione dei link di HTTPBin.
- Codifica e PDF: Unicode di HTTPBin, RFC 9110 in PDF, un PDF di ricerca a due colonne, un PDF W3C minimale e modulo W-9 dell'IRS.
Ogni risultato deve contenere source_url, final_url, title, markdown, links, status_code, fetched_at e content_sha256. Le pagine prodotto richiedono anche entity_name, amount e currency; per il PDF di ricerca serve published_at. Un campo può essere esplicitamente null solo dove lo consente il manifest del test. Un campo mancante non equivale a null.
Salvate una directory per ciascuna combinazione di strumento, versione e configurazione. Per ogni URL conservate request.json, gli header della risposta, il corpo non modificato, normalized.json, verdict.json e il digest SHA-256. Il verdetto deve indicare la prima regola non superata, non soltanto pass: false. Queste prove consentono a un altro tecnico di riprodurre una decisione dopo un cambiamento del fornitore, del parser o della pagina.
Foglio di calcolo del costo per pagina accettata
Il modello considera 1,000, 10,000 e 100,000 pagine accettate al mese, con una riserva del 10% per le risposte che il fornitore giudica riuscite ma che il controllo locale su schema o Markdown rifiuta. I relativi retry sono fatturabili. Gli errori espliciti del fornitore sono invece trattati secondo la politica di rimborso pubblicata da ciascuno.
La formula di base è semplice: spesa per fornitore o hosting, più costi di discovery, rendering, estrazione e retry a pagamento, più le ore operative moltiplicate per il costo orario complessivo del team. La tabella separa la spesa in denaro dalle ore, così l'ipotesi di $100 l'ora può essere sostituita senza ricostruire ogni formula.
Con un costo operativo di $100 l'ora, i totali per 10,000 pagine sono $383 per Firecrawl, $419 per Apify, $1,248 per Crawl4AI, $330 per ScrapFly, $401.10 per Jina, $449 per ScrapingBee, $555.22 per Zyte e $516.50 per Bright Data. Il dato di Jina vale solo quando esiste già un manifest di URL affidabile: non rappresenta il totale per il crawl di un intero sito. Le ore assegnate a Bright Data e Zyte comprendono il lavoro downstream su Markdown e schema, perché nessuna delle due pagine prodotto documenta Markdown nativo come contratto di output adottato qui.
La voce relativa all'estrazione è volutamente esplicita. Firecrawl usa 1 credito di crawl più 4 crediti JSON. ScrapingBee usa 5 crediti JavaScript più 5 crediti AI in questo scenario. ScrapFly usa 5 crediti per browser o Unblocker più 5 crediti del modello di estrazione. Zyte usa il prezzo browser di livello 3 più un'estrazione fissa di attributi personalizzati. Apify usa un contenitore JSON deterministico, per l'80% pagine HTTP grezze e per il 20% pagine headless al limite superiore pubblicato; i riepiloghi AI opzionali non sono inclusi.
Per Jina si ipotizzano 2,000 token di output per tentativo a $0.050 per milione. Il consumo ha un valore minimo, ma il flusso di cassa procede a scatti: terminati i 10 milioni di token gratuiti, la ricarica minima indicata è 1 miliardo di token per $50. Per Crawl4AI il modello considera host DigitalOcean da $24, $48 e $96 ai tre volumi; sono dati di pianificazione, non misure di capacità.
1. Apify Website Content Crawler: il miglior sostituto gestito in assoluto
Apify Website Content Crawler è il sostituto gestito generalista più convincente per un team che vuole discovery, rendering JavaScript, Markdown e un dataset persistente in un unico servizio. Esegue il crawl tramite HTTP grezzo o Firefox headless, archivia ogni risultato come record del dataset ed esporta JSON o CSV. La forma della migrazione resta così vicina a Firecrawl, senza fingere che le API siano identiche.
Il vantaggio più netto è il controllo del crawl come job. Ambito, output e record salvati del dataset convivono nello stesso punto, ed è possibile scaricare file come i PDF. Il limite dichiarato è l'estrazione semantica: il dataset JSON dell'Actor è un contenitore strutturato con testo, Markdown e metadati, ma per ottenere uno schema di business personalizzato servono ancora regole deterministiche, un altro Actor o una fase con modello.
La stima pubblicata dall'Actor è di circa $0.20 per 1,000 pagine in HTTP grezzo e da $0.50 a $5 per 1,000 pagine headless, secondo il suo riferimento. I riepiloghi AI opzionali aggiungono all'incirca $2–$3 ogni 1,000 pagine, fino a circa $7 ogni 1,000 per le pagine prive di titoli. Il modello precedente esclude questo extra, perché un riepilogo non sostituisce i campi JSON obbligatori.
I piani Apify sono Free a $0 con $5 di utilizzo mensile e 5 esecuzioni concorrenti; Starter a $19 con $19 di utilizzo e 32 esecuzioni concorrenti; Scale a $199 con $199 di utilizzo, unità di calcolo a $0.16 e 128 esecuzioni concorrenti; Business a $999 con $999 di utilizzo, unità di calcolo a $0.13 e 256 esecuzioni concorrenti; infine Enterprise personalizzato. Nel piano Free, il servizio si arresta quando la quota è esaurita. I piani a pagamento proseguono addebitando l'eccedenza e l'utilizzo non consumato non viene trasferito. La fonte di queste condizioni è la pagina prezzi aggiornata di Apify.
Ideale per: un piccolo team di prodotto o data che deve sostituire un job di crawl gestito, soprattutto quando sono importanti la cronologia delle esecuzioni e l'esportazione dei dataset.
Punto di forza: discovery dell'intero sito, rendering nel browser, Markdown e record JSON persistenti nello stesso job gestito.
Prezzi: Free $0; Starter $19; Scale $199; Business $999; Enterprise personalizzato. Il costo effettivo dell'Actor comprende anche calcolo, storage, proxy e trasferimento usati dall'esecuzione.
Prova gratuita: il piano Free permanente include $5 di utilizzo mensile della piattaforma senza carta.
- HTTP grezzo e Firefox headless coprono sia le pagine statiche economiche sia quelle JavaScript.
- I record del dataset semplificano la revisione e l'esportazione delle risposte salvate.
- Ambito del crawl, download dei file, metadati e Markdown convivono nello stesso job gestito.
- La fattura della piattaforma include calcolo, storage, trasferimento e proxy, invece di un unico credito per pagina.
- Un record JSON del dataset non coincide automaticamente con lo schema di business richiesto dal codice downstream.
- I riepiloghi AI comportano un costo Actor separato e non dimostrano comunque il superamento del controllo di estrazione.
Una prova di migrazione ad Apify in cinque passaggi
Caricare il manifest fisso degli URL
Partite dai 20 URL del set di test, non dall'intero dominio di produzione. Fissate input dell'Actor, tipo di crawler, limite di pagine e ambito, così una seconda esecuzione conserverà lo stesso significato.
Usare HTTP grezzo finché una pagina non dimostra di richiedere il browser
Riservate il percorso economico alle pagine statiche e instradate i casi JavaScript al rendering headless. Salvate con ogni risultato anche la modalità di crawling scelta.
Esportare Markdown e record del dataset
Conservate senza modifiche
markdown, URL canonico, metadati e link. Trasformate poi il record nello schema JSON locale richiesto, con un passaggio deterministico distinto.Rifiutare prima del chunking
Eseguite sul record normalizzato i controlli per tabelle, codice, link e campi obbligatori. Una sola regola non superata deve inviare l'URL al registro dei retry, non all'indice vettoriale.
Calcolare il prezzo sulle sole pagine accettate
Dividete il costo complessivo di Actor, proxy, storage e lavoro operativo per le pagine accettate. Confrontate il risultato con il riferimento Firecrawl prima di ampliare il crawl.
2. Crawl4AI: la migliore alternativa self-hosted
Crawl4AI è la scelta self-hosted migliore quando proprietà dell'infrastruttura, confini dei dati o regole di estrazione riutilizzabili sono requisiti rigidi. Produce Markdown e supporta l'estrazione strutturata tramite CSS, XPath o una strategia LLM, coprendo sia il testo per il retrieval sia i campi JSON senza un costo software per richiesta.
Oggi la soglia minima di sicurezza conta più del prezzo della licenza. La versione 0.9.4, pubblicata il 23 settembre 2026, corregge tre advisory, fra cui due percorsi di server-side request forgery e un difetto nel confine di fiducia della configurazione che poteva esporre valori d'ambiente. Ogni valutazione dovrebbe fissare v0.9.4 o una versione successiva e consultare gli avvisi di sicurezza del progetto prima di esporne l'API.
Crawl4AI e Firecrawl a confronto
Firecrawl vende il servizio operativo che circonda il crawl: code gestite, browser, crediti, consegna e supporto. Crawl4AI fornisce crawler e sistema di estrazione, mentre il team si assume deployment, aggiornamenti, osservabilità, strategia proxy e risposta agli incidenti. La scelta si ribalta quando queste responsabilità sono già capacità condivise della piattaforma, non quando un singolo tecnico deve crearle apposta per il progetto.
Per il self-hosting sono consigliati almeno 4 GB di RAM, Docker 20.10 o successivo e Compose 2.24 o successivo. Il foglio dei costi usa i prezzi attuali dei Basic Droplet di DigitalOcean: $24 per 4 GiB, $48 per 8 GiB e $96 per 16 GiB. Queste dimensioni servono solo allo scenario; in questa analisi non è stato misurato il throughput di pagine.
Ideale per: team con una piattaforma container già operativa, un confine dati rigoroso e tecnici in grado di gestire le operazioni del crawler.
Punto di forza: controllo open source e schemi di estrazione CSS o XPath deterministici, capaci di evitare la spesa del modello per ogni pagina.
Prezzi: licenza software a $0. Il modello usa host mensili da $24, $48 e $96, oltre a proxy, storage, monitoraggio, chiamate al modello e lavoro secondo necessità.
Prova gratuita: il software è open source; l'infrastruttura non è inclusa.
- Markdown ed estrazione strutturata restano nell'infrastruttura controllata dal team.
- Gli schemi CSS e XPath possono rendere economici e deterministici i siti con template stabili.
- Il server self-hosted ora privilegia per impostazione predefinita un funzionamento autenticato e sicuro sul loopback.
- Reputazione dei proxy, capacità dei browser, patch, code e ripristino diventano responsabilità del team.
- La dimensione dell'host non dimostra il throughput di pagine accettate in assenza di un'esecuzione salvata.
- L'estrazione LLM sposta il costo dei token e la verifica del confine dati su un fornitore distinto o su un modello locale.
La guida al self-hosting di Firecrawl affronta separatamente la scelta tra il repository Firecrawl e Firecrawl Cloud. Non considerate un risparmio la licenza a $0 di Crawl4AI finché lo stesso foglio di calcolo non include le persone che lo mantengono aggiornato e disponibile.
3. ScrapFly: la migliore combinazione di crawl ed estrazione per piccoli team
ScrapFly è l'alternativa più solida per un piccolo team che vuole riunire accesso, crawling, conversione in Markdown ed estrazione tipizzata nello stesso account. I prodotti condividono un solo monte crediti e il livello di estrazione accetta HTML, Markdown, XML, JSON, CSV, RSS o testo semplice. Il team può usare template deterministici, modelli preaddestrati o un prompt con schema JSON, senza collegare fornitori distinti.
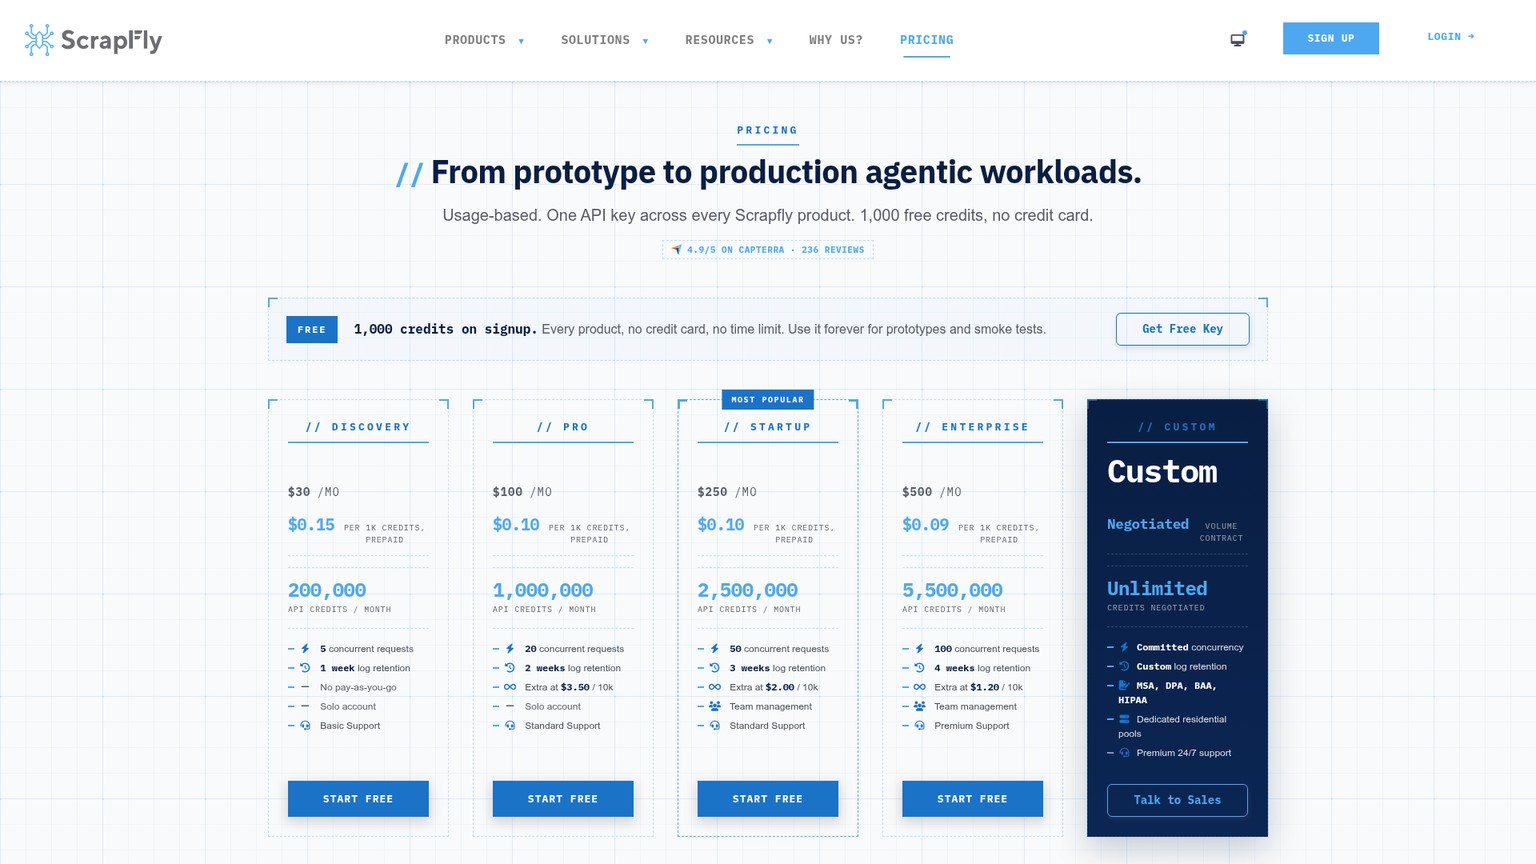
Il modello a crediti è chiaro una volta fissata la configurazione. Una semplice richiesta HTTP da datacenter costa 1 credito, il rendering JavaScript o Unblocker ne costa 5, il routing residenziale 25 e uno screenshot a pagina intera 60. L'estrazione tramite template richiede 1 credito aggiuntivo, mentre un prompt o modello di estrazione ne costa 5. Nei documenti oltre 500 KB, il costo base di estrazione si ripete per ogni ulteriore blocco da 500 KB.
Lo scenario dell'articolo costa quindi 10 crediti per tentativo riuscito: 5 per il browser o Unblocker, più 5 per l'estrazione. Con la riserva di retry del 10% diventano 11 crediti per pagina accettata. Il modello non aggiunge il routing residenziale; un obiettivo che lo richieda cambia nettamente il risultato.
I piani attuali sono Free con 1,000 crediti una tantum; Discovery a $30 al mese con 200,000 crediti e 5 richieste concorrenti; Pro a $100 con 1,000,000 di crediti e 20 richieste concorrenti; Startup a $250 con 2,500,000 crediti e 50 richieste concorrenti; Enterprise a $500 con 5,500,000 crediti e 100 richieste concorrenti; infine Custom negoziato. Discovery si arresta al raggiungimento della quota. L'eccedenza di Pro costa $3.50 ogni 10,000 crediti, quella di Startup $2 e quella di Enterprise $1.20. I crediti inutilizzati non vengono trasferiti. Le condizioni provengono dai prezzi aggiornati di ScrapFly.
Ideale per: un piccolo team che desidera crawler gestito, controlli di accesso ed estrazione tipizzata in un'unica fattura.
Punto di forza: lo stesso monte crediti può alimentare crawler, browser, Unblocker e tre strategie di estrazione.
Prezzi: Free con 1,000 crediti; Discovery $30; Pro $100; Startup $250; Enterprise $500; Custom negoziato.
Prova gratuita: 1,000 crediti alla registrazione, senza carta e senza scadenza indicata.
- L'estrazione tramite template può ridurre il costo del modello sui layout stabili.
- Modelli preaddestrati ed estrazione via prompt restituiscono JSON tipizzato senza un fornitore di modelli distinto.
- Le richieste non riuscite costano zero crediti e la risposta indica i crediti consumati.
- Browser, accesso residenziale e opzioni di estrazione fanno salire rapidamente il costo delle pagine difficili.
- I documenti oltre 500 KB moltiplicano il costo di estrazione.
- Discovery non prevede eccedenze: i job di produzione richiedono Pro o un arresto rigido prima di esaurire la quota.
ScrapFly è il vincitore del foglio di calcolo a 10,000 pagine accettate in questo specifico scenario: $30 più tre ore operative, contro $83 più tre ore per Firecrawl. Una differenza mensile di $53 è troppo piccola per giustificare una migrazione approssimativa. Diventa convincente solo se supera il set fisso, i target di produzione non richiedono il percorso residenziale da 25 crediti e lo schema non esige ulteriore pulizia.
4. Jina Reader: la scelta migliore se l'elenco degli URL esiste già
Jina Reader è il convertitore con il miglior costo variabile quando la discovery è già risolta e ogni URL fornito deve diventare Markdown pulito o JSON conforme a uno schema. Il motore predefinito esegue JavaScript in un browser headless, mentre quello diretto segue il percorso HTTP più semplice. ReaderLM-v2 accetta uno schema JSON o un'istruzione in linguaggio naturale per produrre output strutturato.
Il suo vantaggio coincide con il suo perimetro: Reader legge un URL. Non sostituisce le regole di ambito per un intero sito, la frontiera, la politica sui duplicati o il manifest di crawl. Se una sitemap, una fase di ricerca o un catalogo interno forniscono un elenco affidabile di URL, questa specializzazione è un pregio. In caso contrario, il costo della discovery va reinserito nel foglio di calcolo.
L'uso base di Reader è gratuito. Ogni nuova chiave include 10 milioni di token; quando si usa una chiave vengono addebitati i token di output. Una ricarica da 1 miliardo di token costa $50, pari a $0.050 per milione; una ricarica da 11 miliardi costa $500, pari a $0.045 per milione. Le richieste non riuscite non consumano token. I limiti sono 20 richieste al minuto senza chiave, 500 con una chiave gratuita o a pagamento e 5,000 con una chiave premium. Tutti i dati provengono dalla pagina aggiornata di Jina Reader.
Il foglio di calcolo ipotizza 2,000 token di output per ogni tentativo riuscito. Dopo la riserva per i retry, il valore dei token consumati è $0.11 per 1,000 pagine accettate, $1.10 per 10,000 e $11 per 100,000. Sono valori d'uso economico, non l'importo addebitato al checkout. Una volta terminato il monte gratuito, l'acquisto minimo indicato resta $50.
Ideale per: una pipeline con un manifest di URL affidabile che richiede una conversione economica da pagina a Markdown o JSON.
Punto di forza: fatturazione sui token di output, rendering JavaScript ed estrazione con schema JSON in una reader API circoscritta.
Prezzi: l'uso base di Reader è gratuito; ogni nuova chiave riceve 10 milioni di token; i pacchetti a pagamento costano $50 per 1 miliardo o $500 per 11 miliardi.
Prova gratuita: 10 milioni di token con una nuova chiave API.
- Il renderer predefinito gestisce JavaScript lato client prima della conversione.
- Le modalità con schema JSON e istruzioni possono produrre campi strutturati dallo stesso reader.
- Le richieste non riuscite non consumano token.
- Discovery del sito, ambito e persistenza dello stato di crawl richiedono un altro componente.
- Una confezione di token da $50 è il minimo esborso dopo la quota gratuita, anche se il consumo corrente vale molto meno.
- Il costo dei token di output varia con la lunghezza della pagina e il formato della risposta.
Jina sembra vincere sui costi per 100,000 pagine, con $11 più sei ore, ma soltanto nell'ipotesi di un manifest già fornito. Aggiungere un job di discovery inaffidabile e una deduplicazione manuale renderebbe quella riga non confrontabile con Firecrawl o Apify. Usatelo quando il confine del componente è reale, non per nascondere il lavoro di crawling mancante.
5. ScrapingBee: la migliore API di scraping con tetto ai crediti
ScrapingBee è la migliore alternativa a livello di singola richiesta quando un team vuole limitare il costo massimo di ogni pagina. Può restituire il Markdown della pagina o una risposta JSON, applicare regole di estrazione CSS e aggiungere l'estrazione AI quando i layout non sono abbastanza stabili per i selettori.
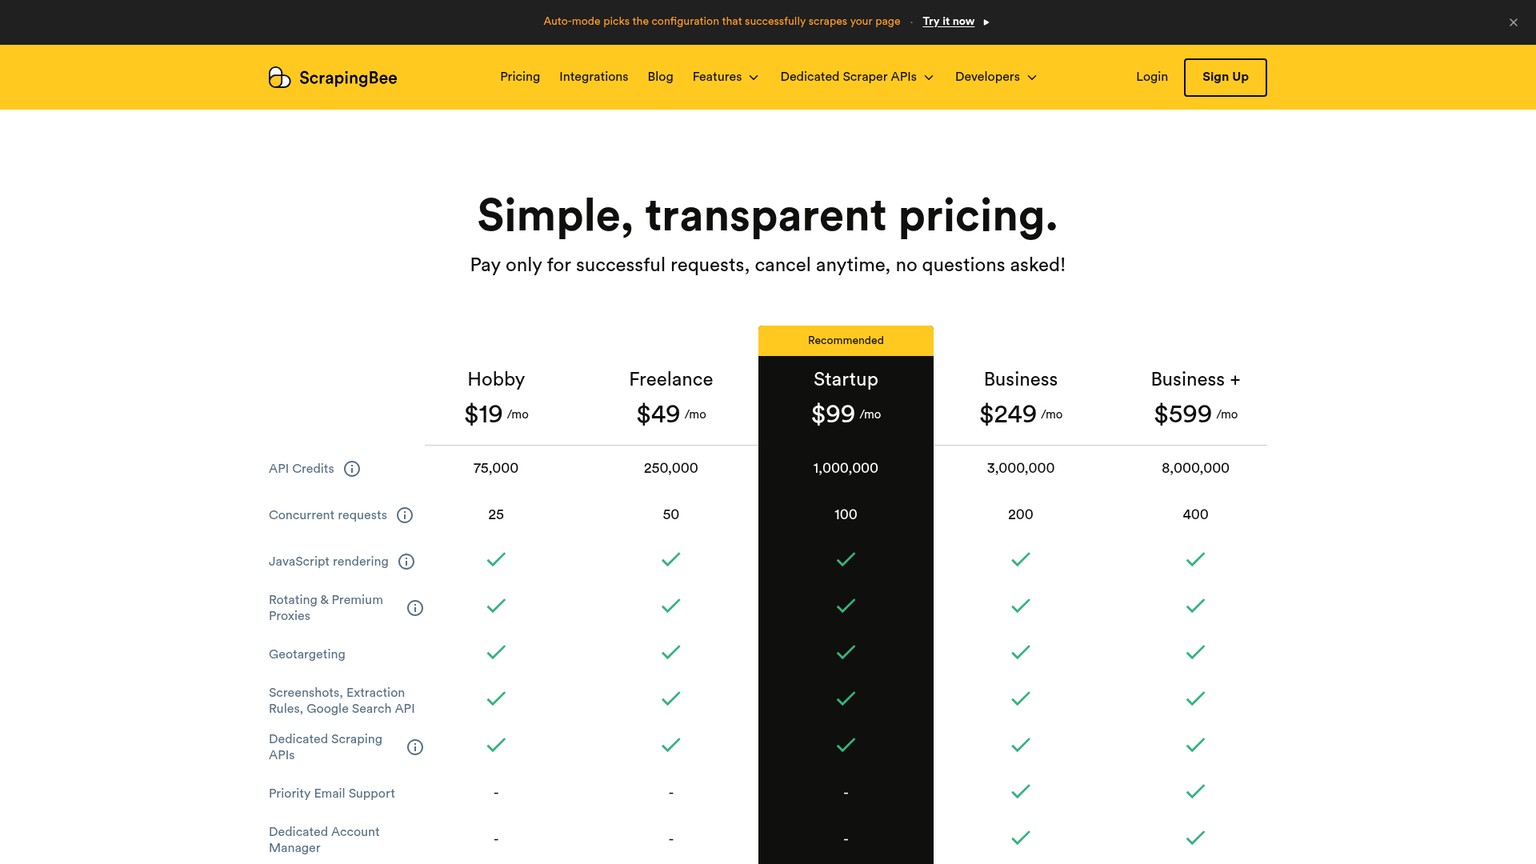
Il controllo utile è la scala dei crediti. Una richiesta HTTP classica costa 1 credito, JavaScript classico 5, premium senza JavaScript 10, premium con JavaScript 25 e stealth con JavaScript 75. Le funzionalità AI aggiungono 5 crediti. La modalità Auto addebita la configurazione che riesce, non costa nulla se falliscono tutte e permette di impostare un tetto massimo.
Il limite è l'orchestrazione. ScrapingBee recupera le pagine richieste, ma non è il sostituto più vicino alla discovery e alla frontiera di crawl di Firecrawl. Il team deve gestire manifest degli URL, ambito, duplicati e stato del job, distinguendo poi tra un errore del fornitore e una risposta riuscita che il controllo di accettazione locale rifiuta.
I piani attuali sono Hobby a $19 al mese per 75,000 crediti e 25 richieste concorrenti; Freelance a $49 per 250,000 e 50; Startup a $99 per 1,000,000 e 100; Business a $249 per 3,000,000 e 200; Business+ a $599 per 8,000,000 e 400. Per la valutazione sono disponibili 1,000 crediti senza carta. I dati provengono dai piani aggiornati di ScrapingBee.
Ideale per: team che gestiscono già la discovery e richiedono tetti espliciti per rendering, proxy premium e costo della singola richiesta.
Punto di forza: la modalità Auto può intensificare l'accesso, mentre max_cost limita quanto può consumare una singola risposta.
Prezzi: Hobby $19; Freelance $49; Startup $99; Business $249; Business+ $599.
Prova gratuita: 1,000 crediti senza carta.
- Markdown, estrazione CSS ed estrazione AI sono disponibili nella stessa API di richiesta.
- La scala da 1, 5, 10, 25 e 75 crediti rende verificabile il costo dell'accesso.
- La modalità Auto addebita zero quando falliscono tutte le configurazioni interne.
- Discovery del sito e persistenza del crawl restano fuori dal perimetro del prodotto.
- Un tentativo riuscito per il fornitore ma rifiutato dallo schema è comunque a pagamento.
- Il consumo può aumentare di 15 volte passando da JavaScript classico a JavaScript stealth, prima ancora di aggiungere l'estrazione AI.
Nel modello, JavaScript più estrazione AI consumano 10 crediti per tentativo. La riserva di retry porta il valore a 11 per pagina accettata: 1,000 pagine rientrano in Hobby a $19, 10,000 in Freelance a $49 e 100,000 in Business a $249, perché 1.1 milioni di crediti superano il limite di 1 milione incluso in Startup.
6. Zyte API: il miglior prezzo anti-bot distinto per sito
Zyte API è la scelta migliore quando la difficoltà di accesso varia molto da un target all'altro e si vuole che il fornitore assegni a ogni sito una fascia di prezzo. Riunisce nel prezzo della risposta il percorso datacenter o residenziale necessario, il rendering e il lavoro di accesso, addebitando soltanto le risposte riuscite.
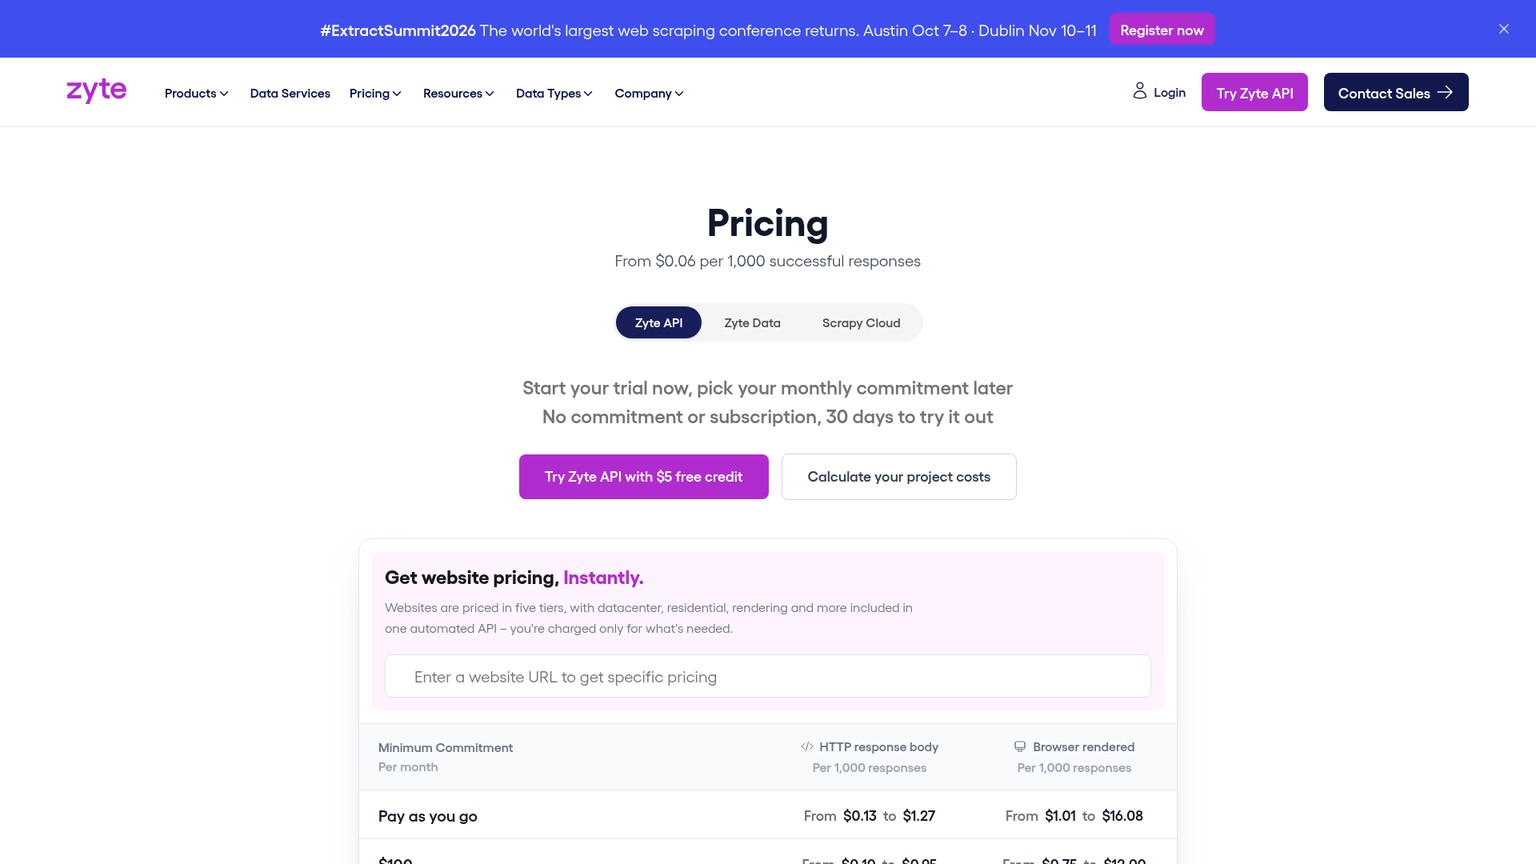
I prezzi HTTP pay-as-you-go per 1,000 risposte sono $0.13, $0.23, $0.44, $0.70 e $1.27 nelle fasce sito da 1 a 5. Per le risposte renderizzate nel browser sono $1.01, $2.01, $4.02, $8.04 e $16.08. Con un impegno mensile di $100, le tariffe browser diventano $0.75, $1.50, $3, $6 e $12; con $200 sono $0.60, $1.20, $2.40, $4.80 e $9.60; con $500 diventano $0.48, $0.96, $1.92, $3.84 e $7.68.
Anche gli scaglioni HTTP con impegno sono rilevanti. A $100, le fasce da 1 a 5 costano $0.10, $0.17, $0.33, $0.53 e $0.95 per 1,000. A $200 costano $0.08, $0.14, $0.26, $0.42 e $0.76. A $500 costano $0.06, $0.11, $0.21, $0.34 e $0.61. Enterprise offre ulteriori sconti negoziati. La pagina prezzi aggiornata di Zyte indica inoltre $5 di credito di prova per 30 giorni.
Gli attributi personalizzati possono usare un metodo fisso extract a $0.001 oppure un metodo generativo a $0.002 per 1,000 token di input e $0.01 per 1,000 token di output. L'estrazione automatica costa da $0.0004 a $0.0016 per tipo di dato. Il foglio può così mostrare una voce di estrazione chiara, anziché nascondere l'uso del modello in un piano indistinto.
Per questo confronto il limite è l'output. Zyte documenta corpi HTTP, HTML del browser e campi strutturati, non una risposta Markdown nativa. La conversione downstream da HTML a Markdown e i relativi test di regressione restano quindi parte della migrazione.
Ideale per: estrazione da più domini quando difficoltà del target, necessità del browser e infrastruttura di accesso determinano gran parte del costo.
Punto di forza: cinque fasce per sito e nessun addebito per risposte non riuscite o soggette a rate limiting.
Prezzi: PAYG senza impegno; impegni mensili di $100, $200 e $500; Enterprise con ulteriori sconti. Il prezzo della risposta dipende dalla fascia del sito e dal tipo di output, HTTP o browser.
Prova gratuita: $5 di credito per 30 giorni, senza impegno.
- La fascia specifica del target incorpora l'infrastruttura di accesso in un unico prezzo per risposta.
- L'addebito delle sole risposte riuscite elimina il costo diretto di rate limit ed errori dichiarati dal fornitore.
- Gli attributi personalizzati a prezzo fisso o basato sui token rendono visibili i costi di estrazione.
- Markdown nativo non è un output documentato, quindi la conversione resta a carico del team.
- La fascia assegnata a un target può cambiare e le risposte riuscite possono comunque non superare il controllo locale sui contenuti.
- Discovery dell'intero sito e progettazione downstream dello stato di crawl richiedono una configurazione esplicita.
Il foglio di calcolo usa il rendering nel browser di fascia 3 più un'estrazione personalizzata fissa. Ne risultano $5.52, $55.22 e $374 di utilizzo stimato ai tre volumi. È uno scenario, non un prezzo Zyte universale: sostituite la fascia con il preventivo relativo ai domini da sottoporre a crawl.
7. Bright Data Crawl API: la scelta migliore per siti protetti su larga scala
Bright Data Crawl API è la candidata più forte quando accesso a siti protetti, infrastruttura proxy e concorrenza dominano i requisiti. Il prezzo comprende rendering JavaScript, proxy residenziali, validazione, risoluzione dei CAPTCHA, geotargeting, discovery, parsing in JSON o CSV e concorrenza illimitata.
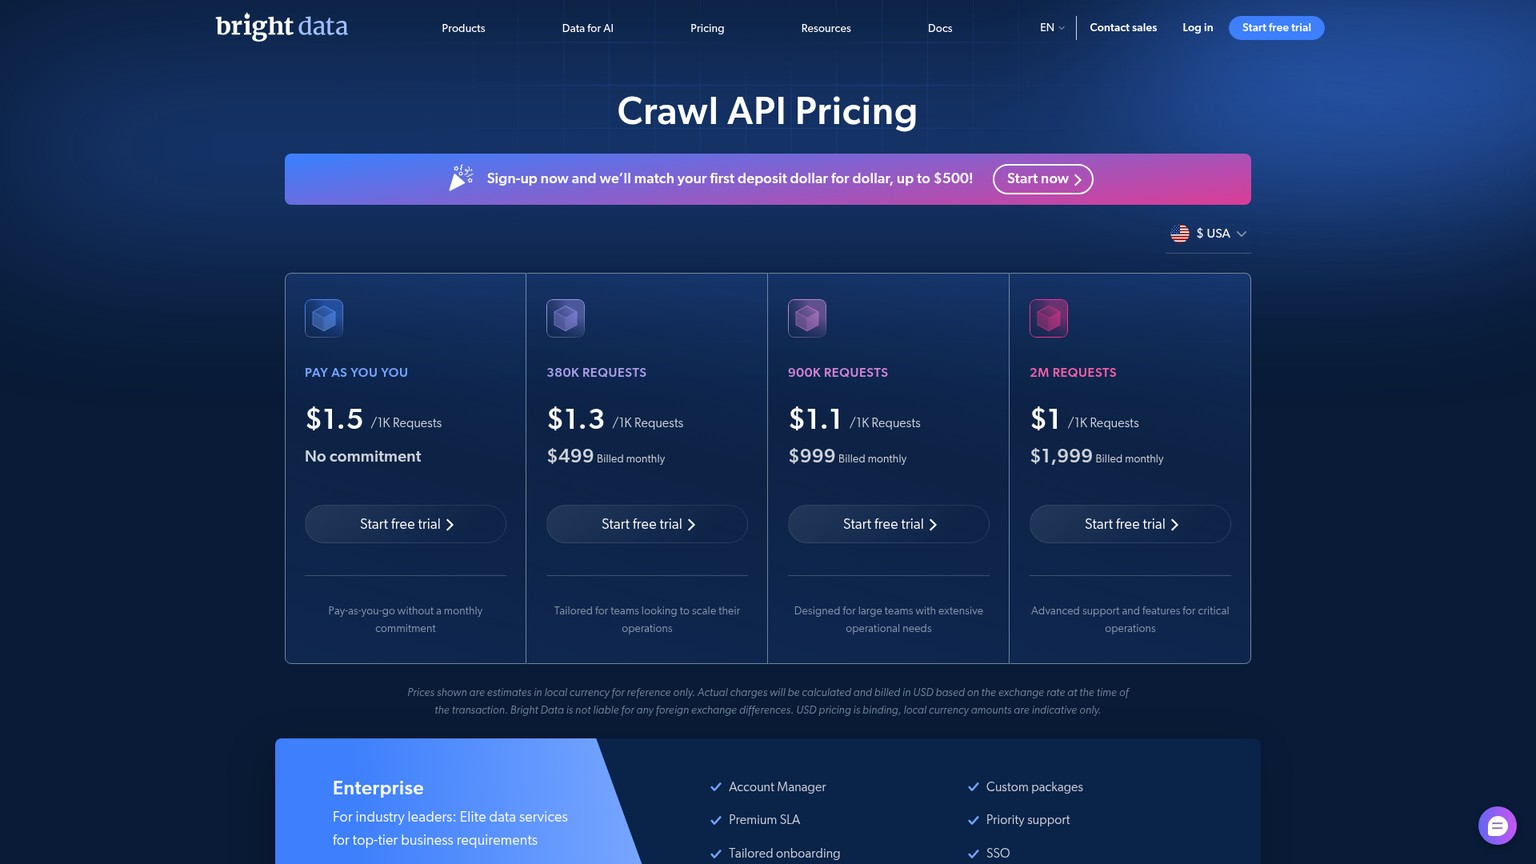
Il servizio parte da $1.50 per 1,000 richieste pay-as-you-go senza impegno. Il piano da 380,000 richieste costa $499 al mese, ossia $1.30 per 1,000; 900,000 richieste costano $999, pari a $1.10 per 1,000; 2 milioni di richieste costano $1,999, cioè $1 per 1,000. Enterprise ha condizioni personalizzate. Sono i prezzi attuali di Bright Data Crawl API.
Il limite importante è lo stesso di Zyte: i formati di consegna documentati sono NDJSON e CSV, non Markdown nativo. Per una pipeline di retrieval che richiede titoli, blocchi di codice, tabelle e link sorgente stabili in Markdown, il convertitore è un componente di produzione. I suoi errori e il tempo operativo vanno inclusi nel denominatore.
Alle tariffe pay-as-you-go, una riserva del 10% per retry fatturabili porta la spesa a $1.65 per 1,000 pagine accettate, $16.50 per 10,000 e $165 per 100,000. Questi importi ridotti per le richieste non rappresentano il costo completo. Il foglio assegna quattro, cinque e otto ore alla conversione Markdown, alla normalizzazione dello schema e alla revisione; un target difficile può modificare il comportamento delle richieste.
Ideale per: raccolte ad alta concorrenza da domini protetti, dove l'accesso gestito vale più del Markdown nativo.
Punto di forza: rendering, routing residenziale, gestione dei CAPTCHA, validazione e concorrenza illimitata inclusi nel prezzo della Crawl API.
Prezzi: PAYG a $1.50 per 1,000 richieste; $499 per 380,000; $999 per 900,000; $1,999 per 2 milioni; Enterprise personalizzato.
Prova gratuita: le schede dei prezzi attuali offrono una prova gratuita, ma nelle condizioni visibili del piano non indicano l'importo del credito.
- L'infrastruttura di accesso che altrimenti richiederebbe più componenti è inclusa.
- La concorrenza illimitata si adatta a job estesi con finestre di consegna rigide.
- NDJSON e CSV offrono una consegna leggibile dalle macchine senza dover estrarre dati dalla dashboard del fornitore.
- Markdown nativo non rientra nel contratto di output documentato.
- Il solo costo PAYG per richiesta nasconde conversione, schema e revisione delle pagine accettate.
- L'ampio stack di accesso è un sovraccosto inutile per siti di documentazione pubblici che funzionano con semplice HTTP.
Web crawler open source alternativi a Firecrawl da gestire internamente
Crawl4AI è l'alternativa open source più evidente in questa selezione, ma anche Firecrawl pubblica un core installabile in self-hosting. La distinzione rilevante non è la possibilità di clonare un repository. Conta invece se il deployment aperto riproduce discovery, accesso via browser, code, persistenza, osservabilità e contratto di output dai quali dipende la pipeline aziendale.
Per Crawl4AI, fissate la versione 0.9.4 o successiva, imponete l'autenticazione, configurate correttamente il binding delle istanze private di valutazione e salvate la versione esatta dell'immagine o del pacchetto con ogni set di risultati. Sui template stabili preferite l'estrazione CSS o XPath, quindi isolate l'eventuale fornitore di estrazione LLM come costo e confine dati separati. Le 8–20 ore operative mensili del modello non sono un benchmark: servono a ricordare di quantificare patch, guasti dei proxy, variazioni dello schema e ripristino, invece di dichiararli gratuiti.
Per il core Firecrawl, considerate il confronto Cloud-self-hosting una scelta architetturale a sé. Il repository può eliminare una voce di crediti del fornitore, ma aggiunge PostgreSQL, Redis, RabbitMQ, browser worker, monitoraggio e aggiornamenti al carico del team. L'articolo dedicato al self-hosting, collegato sopra, include un pacchetto di verifica per questa decisione.
Qual è la migliore AI per il web scraping?
La scelta migliore dipende dal confine dell'input. Se l'input è un dominio e l'output deve essere un corpus completo in Markdown e JSON, partite da Firecrawl o Apify e poi calcolate il prezzo di ScrapFly. Se l'input è già un elenco affidabile di URL, Jina Reader elimina l'infrastruttura di crawl e può essere molto meno costoso. Se la difficoltà è l'accesso, confrontate il tetto di costo di ScrapingBee con le fasce per sito di Zyte e lo stack di accesso integrato di Bright Data.
Gli agenti AI per il web scraping hanno bisogno di un controllo di accettazione
Un agente non dovrebbe mai stabilire che una risposta 200 è pronta per il retrieval. Fornitegli un controllo deterministico: campi obbligatori, lunghezza minima del Markdown, conservazione di tabelle e codice, link normalizzati, hash del contenuto, tipo di contenuto consentito e regole esplicite per i valori null. L'agente può instradare gli errori, ma non deve ignorare il contratto pur di far proseguire il job.
La decisione cambia in quattro punti:
- Restate con Firecrawl quando supera il set di test e i risparmi di sei mesi non ripagano migrazione ed esecuzione parallela.
- Scegliete Apify quando un job di crawl gestito, un dataset persistente e un workflow Actor flessibile contano più di un singolo valore di crediti per pagina.
- Scegliete Crawl4AI quando il team gestisce già container, routing di accesso e reperibilità, oppure quando un confine dati impedisce l'elaborazione gestita.
- Scegliete un'API più circoscritta quando la discovery è già gestita o l'accesso a pagine protette domina il lavoro. Jina, ScrapingBee, Zyte e Bright Data sono più efficaci soltanto quando questo confine è messo per iscritto.
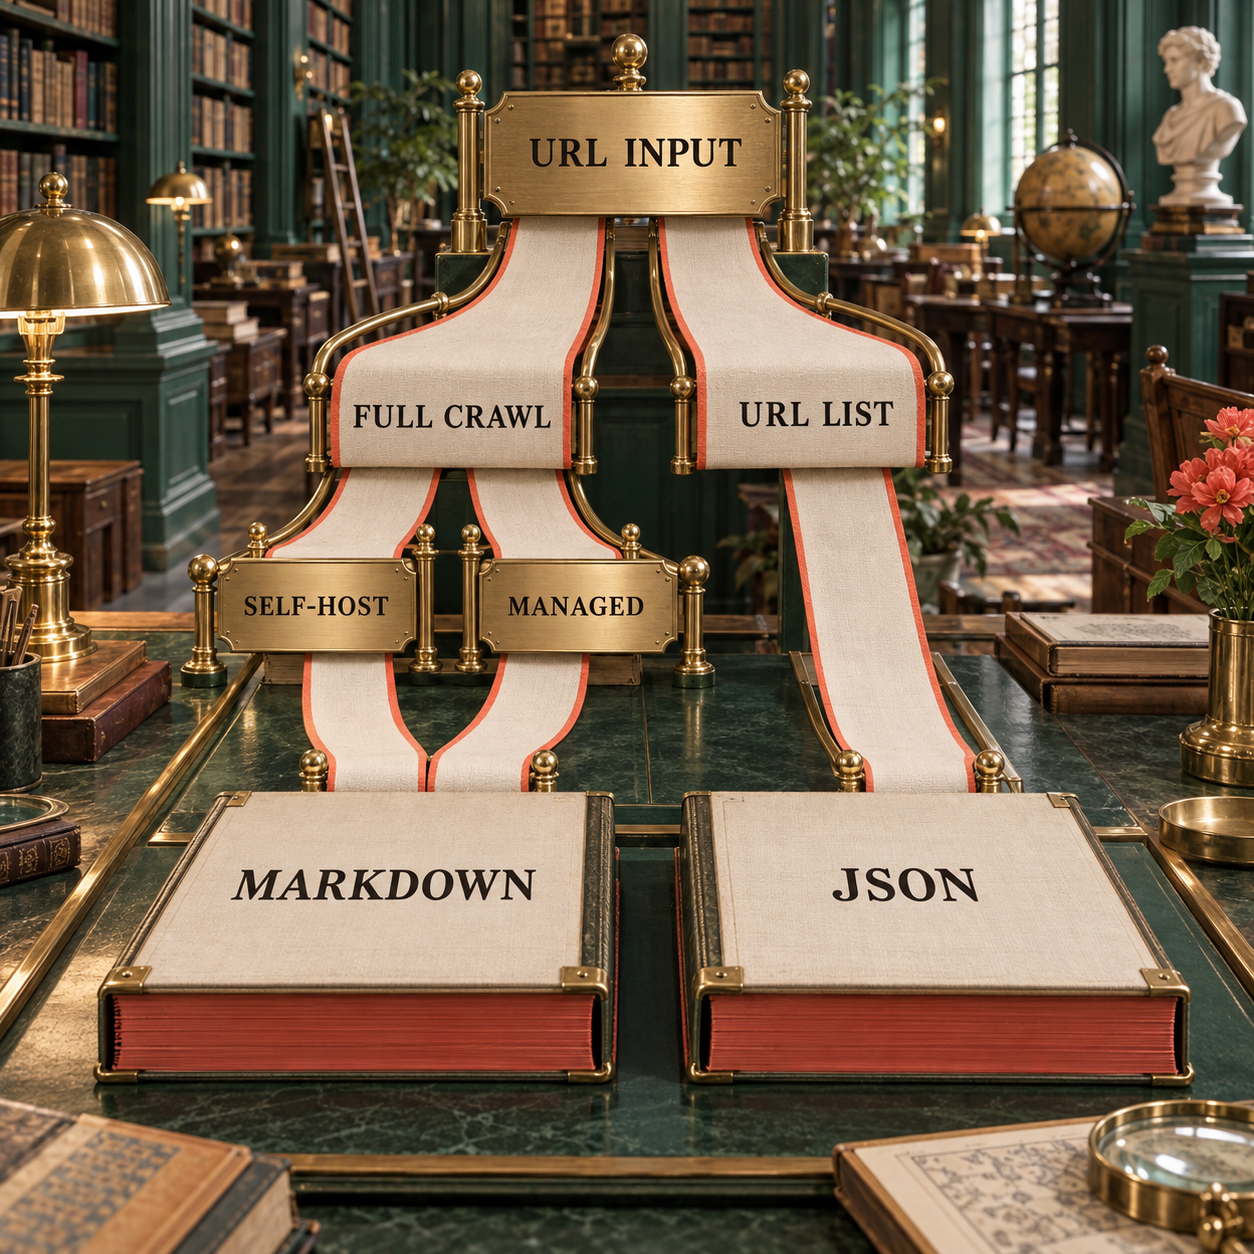
Non scegliete in base all'output più gradevole visto in un playground. La configurazione prescelta deve superare lo stesso set, salvare le stesse prove e produrre gli stessi chunk downstream. Uno strumento che appare più pulito su una pagina articolo può comunque fallire sulla tabella, sul PDF o sulla route JavaScript che determina l'accettazione in produzione.
Quali soluzioni evitare come sostituti diretti
Evitate di acquistare un prodotto di una categoria adiacente fingendo che la pipeline sia completa. Questi strumenti possono essere utili, ma non sostituiscono l'intero job Firecrawl definito qui:
- Exa e Tavily: manteneteli nella valutazione dei fornitori di ricerca. Sono stati esclusi da questa selezione perché la sostituzione qui inizia dopo la scelta di un dominio o di un insieme di URL e deve produrre corpi pagina accettati.
- Playwright e Puppeteer da soli: l'automazione del browser è un componente di base, non un manifest di crawl gestito, un contratto Markdown, un registro dei retry o un sistema di consegna strutturato. Sceglieteli solo se l'obiettivo è costruire questi livelli.
- Un servizio di soli proxy: accedere a una risposta non ripulisce la navigazione, non conserva i link, non convalida il JSON e non mantiene stabili i confini dei chunk.
- Un fork di crawler non più mantenuto: un repository gratuito diventa un incidente quando cambiano versioni del browser, correzioni di sicurezza o comportamento del target e nessuno gestisce il percorso di release.
Evitate anche di usare un benchmark di marketing come prova per la migrazione. Se la configurazione esatta non è stata eseguita contro il set salvato di 20 URL, quel numero descrive il carico di lavoro di qualcun altro. Questo articolo non pubblica volutamente tassi di superamento sintetici né classifiche di latenza.
Foglio operativo per la migrazione di un piccolo team
Una migrazione sicura mantiene Firecrawl e il candidato in parallelo finché output normalizzati, comportamento dei retry e chunk non coincidono sul set fisso e su un campione di produzione rappresentativo. Il foglio richiede un unico responsabile, uno schema versionato e un trigger di rollback.
1. Fissare il contratto di input e discovery
Registrate se gli URL arrivano dal crawl di un dominio, da una sitemap, da una search API, da una coda o da un database interno. Salvate domini consentiti, politica sui sottodomini, percorsi inclusi ed esclusi, profondità, limite di pagine, canonicalizzazione e regole sui duplicati. Un test con Jina o ScrapingBee non è confrontabile con Firecrawl se un altro componente non copre l'intera voce.
2. Bloccare lo schema di output
Versionate campi e tipi richiesti. Conservate almeno source_url, final_url, title, markdown, links, status_code, fetched_at e content_sha256. Indicate quali campi di business possono essere null e quali fanno fallire la pagina. Conservate la risposta grezza per poter rieseguire un parser modificato senza pagare di nuovo il crawler.
3. Definire i retry come eventi contabili
Per ogni tentativo salvate stato del fornitore, stato HTTP, verdetto di accettazione, motivo del retry, costo in crediti o richieste e azione successiva. Separate errori di trasporto, fallimenti dichiarati dal fornitore, blocchi di accesso, contenuti vuoti, errori di schema ed errori di conversione downstream. Impostate un limite ai retry e inviate gli elementi esauriti a una dead-letter queue, invece di creare un ciclo di spesa invisibile.
4. Salvare il pacchetto di prove
Usate un percorso basato su strumento, release, hash della configurazione, data di esecuzione e ID del set. Memorizzate richiesta, header, risposta non modificata, JSON normalizzato, Markdown, verdetto e digest. Un revisore deve poter stabilire quale renderer, modalità di estrazione e schema abbia prodotto ogni chunk accettato.
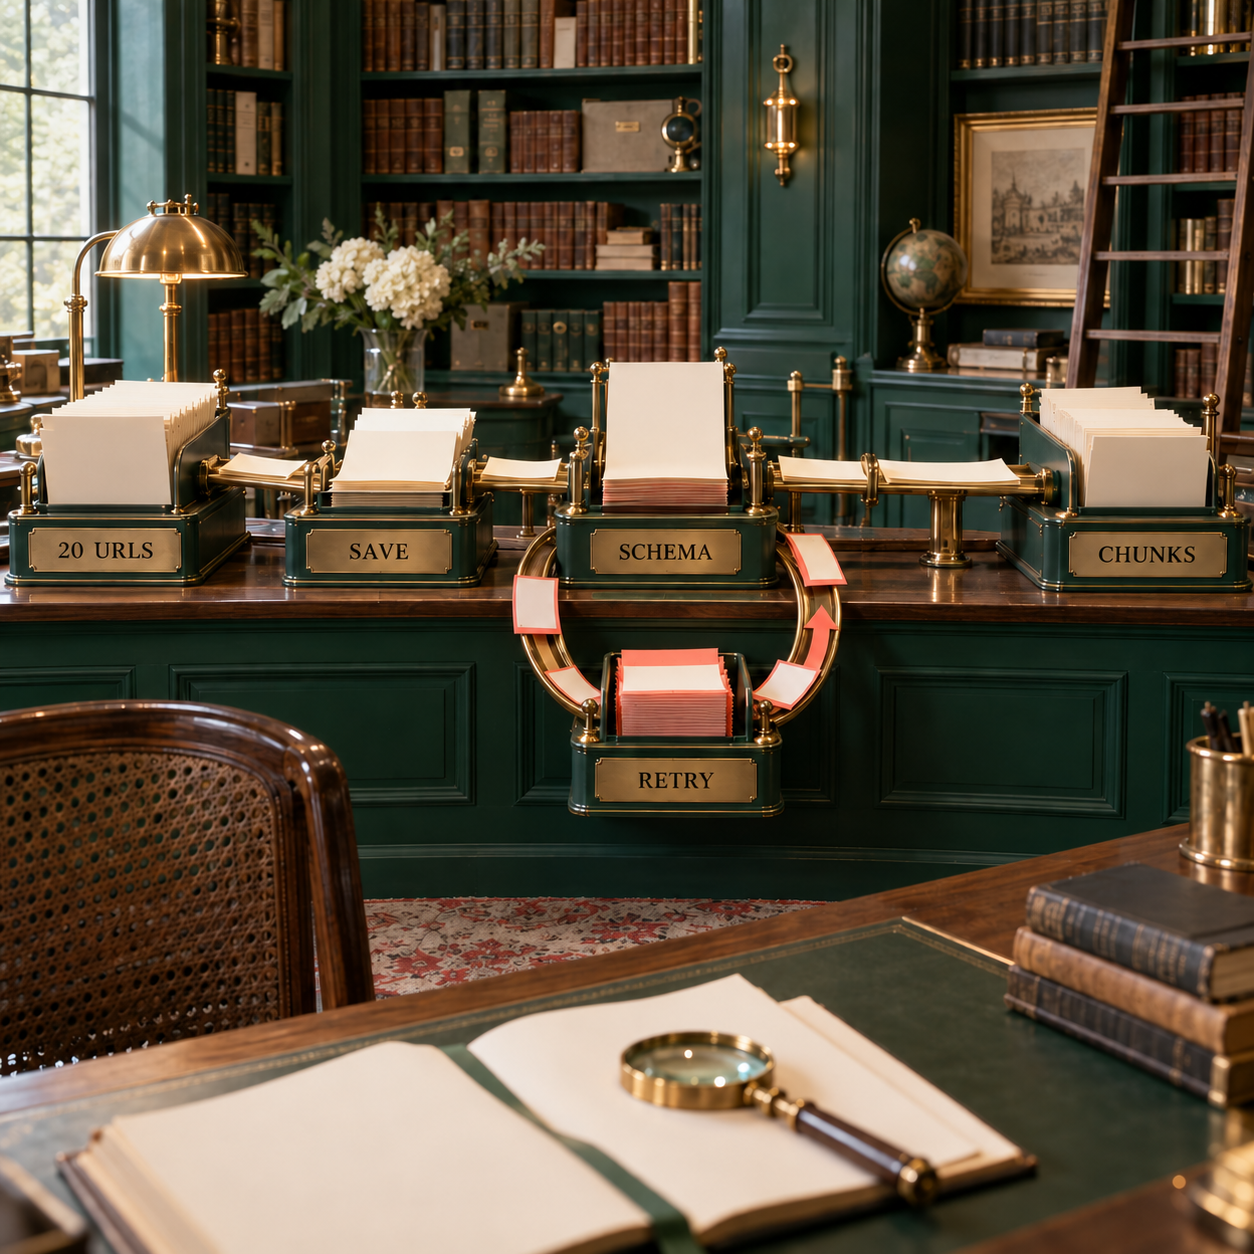
5. Eseguire la regressione del chunking downstream
Prima di rigenerare qualsiasi embedding, confrontate gerarchia dei titoli, blocchi di codice, tabelle, destinazioni dei link, ordine del documento e hash dei contenuti. Quindi confrontate numero dei chunk, relativi confini e citazioni delle fonti. Anche una stringa Markdown più pulita può cambiare il comportamento del retrieval se spariscono i titoli o le righe di una tabella vengono divise tra i chunk.
6. Calcolare il costo del corpus accettato e fissare il rollback
Sommate la spesa del fornitore, il costo dell'host, i token di estrazione, i retry a pagamento, lo storage e le ore operative. Dividete per le pagine accettate, non per le richieste. Definite prima del lancio un trigger di rollback, come l'assenza di un campo obbligatorio, una fascia target imprevista, un aumento rilevante nel numero dei chunk o un tetto di ore operative. Tenete disponibile il percorso precedente finché il nuovo non supera questa finestra.
Per un piccolo team, il primo artefatto utile non è un punteggio assegnato ai fornitori. È un foglio con una riga per ogni URL del set e colonne per entrambi i sistemi. Quando la riga contiene prove salvate, un successo o un errore diventano verificabili invece che opinabili.
Domande frequenti
Il web scraping è illegale?
Non esiste una risposta universale. Negli Stati Uniti, la politica del Department of Justice sul CFAA distingue i confini tecnici di accesso da una semplice restrizione contrattuale; contratto, diritto d'autore, privacy, uso dei dati, controlli di accesso e giurisdizione possono però cambiare l'analisi. Non è una consulenza legale: una raccolta in produzione richiede il parere di un legale sugli specifici target e utilizzi.
Firecrawl è costoso?
Dipende dall'output accettato. Il crawl costa 1 credito per pagina e JSON ne aggiunge 4; nel modello, 10,000 pagine accettate con una riserva di retry del 10% richiedono 55,000 crediti e rientrano in Standard a $83. Il lavoro operativo e il costo di migrazione possono pesare più della fattura.
Qual è il miglior strumento di web scraping?
Apify Website Content Crawler è il sostituto gestito più completo in questa selezione. Crawl4AI è più indicato quando il self-hosting è obbligatorio, ScrapFly offre una combinazione efficace di crawl gestito ed estrazione, mentre Jina Reader vince solo in presenza di un elenco affidabile di URL.
È possibile installare Firecrawl in self-hosting?
Sì. Il core self-hosted offre controllo al team, che però deve gestire anche database, code, browser worker, aggiornamenti, sicurezza, routing di accesso e monitoraggio. Non è lo stesso prodotto operativo di Firecrawl Cloud.
Quali sono le alternative a Firecrawl?
Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API e Bright Data Crawl API sono le sette alternative confrontate qui. Si dividono tra crawler completi, reader per URL forniti e API orientate all'accesso.
Il self-hosting è legale?
Eseguire software su un'infrastruttura sotto il proprio controllo è in genere una questione distinta da ciò a cui quel software accede. Autorizzazione, controlli di accesso, condizioni dei siti, diritto d'autore, privacy, protezione dei dati e uso previsto richiedono comunque una valutazione separata.
Vale la pena scegliere il self-hosting?
Sì, quando un confine dati obbligatorio, la personalizzazione o una piattaforma condivisa compensano il lavoro operativo. In genere non conviene creare un nuovo servizio in reperibilità soltanto per eliminare una modesta fattura API mensile.
Quali rischi comporta l'hosting gratuito?
Le istanze gratuite possono sospendersi, limitare CPU o memoria, ruotare lo storage, condividere indirizzi IP con scarsa reputazione e non offrire garanzie di ripristino in produzione. Questi limiti possono far sembrare inaffidabile un crawler anche quando la causa non è il software.
Posso fare self-hosting gratuito di un sito web?
Un sito amatoriale o la valutazione di un crawler possono rientrare in una quota gratuita. Un crawl di produzione comporta comunque calcolo, storage, larghezza di banda, infrastruttura di accesso, monitoraggio, backup e tempo operativo: una voce host da $0 non equivale a un costo operativo di $0.
Firecrawl è open source?
Firecrawl pubblica un core open source installabile in self-hosting. Firecrawl Cloud aggiunge infrastruttura gestita e servizi operativi, quindi il repository da solo non riproduce i confini di costo e affidabilità del prodotto Cloud.
- Ultimo aggiornamento
- 25 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

AI code review: 7 alternative a CodeRabbit a confronto
Confronto tra 7 alternative a CodeRabbit per AI code review: prezzi, host Git, privacy, self-hosting e costi reali per un team di cinque sviluppatori.25 set 2026Build
AI code review: Greptile o CodeRabbit, quale conviene?
Confronto tra Greptile e CodeRabbit per AI code review: prezzi, limiti, piattaforme, crediti e costi reali per un team di cinque sviluppatori.25 set 2026Build
Perplexity Computer su Windows: guida alla modalità locale
Configura Perplexity Computer in locale su un PC Windows compatibile, scegli il modello giusto e prova un flusso ricorrente sui file con permessi cloud chiari.25 set 2026Build
Workflow AI sotto controllo: AgentRun alla prova
AgentRun mette confini espliciti ai workflow AI: la prova di stato tipizzato, chiamate agli agenti, escalation, costi e limiti della beta.4.24 set 2026Build
Perplexity API: Fast Search o ricerca web predefinita?
Perplexity API a confronto: costi, latenza e copertura di Fast Search e ricerca web, con una regola pratica per scegliere la modalità giusta.24 set 2026Build
Agenti AI: quando il fallback svuota il budget
Un writer in sandbox ha reso il fallback a pagamento il percorso predefinito: come proteggere budget, credenziali e output finali degli agenti AI.24 set 2026Build
Cursor gratis? Quanto costa davvero Rollouts
Cursor gratis non include Rollouts: servono Teams o Enterprise. Scopri cosa coprono i crediti di 10 giorni, i costi ancora ignoti e quando provarlo.24 set 2026Build