Аналоги Firecrawl для веб-скрапинга: что выбрать
Сравниваем аналоги Firecrawl по краулингу, Markdown и JSON, цене принятой страницы и сложности миграции — от Apify и Crawl4AI до ScrapFly и Jina Reader.




Аналоги Firecrawl расходятся по цене на отметке 10,000 принятых страниц: в этой модели Firecrawl обходится в $83 за сервис плюс три часа работы специалиста, а ScrapFly — в $30 плюс те же три часа. Но меньший счёт ещё не означает более дешёвую замену: обнаружение страниц, повторные попытки с рендерингом, извлечение JSON и последующая нарезка на фрагменты могут полностью съесть разницу.
Коротко: выбирая аналоги Firecrawl, вы заменяете весь конвейер
Выбирайте Apify Website Content Crawler, если нужна наиболее близкая управляемая замена широкого профиля; Crawl4AI — если принципиален контроль над инфраструктурой; ScrapFly — если единый пул кредитов должен покрывать краулинг и структурированное извлечение; Jina Reader — если URL уже поступают из другой системы. ScrapingBee, Zyte API и Bright Data Crawl API становятся предпочтительнее, когда доступ к сложным страницам важнее встроенного процесса «сайт — Markdown».
Значимая единица здесь — не запрос и не найденный URL, а принятая страница, дошедшая до конвейера генерации с дополненным поиском. Иными словами, модель получает пригодный исходный материал, в котором сохранены нужный Markdown, поля JSON, ссылки и метаданные. Дешёвый ответ, потерявший таблицу, подставивший пустое поле цены или сломавший нарезку, — это оплаченная неудача.
Firecrawl как точка отсчёта
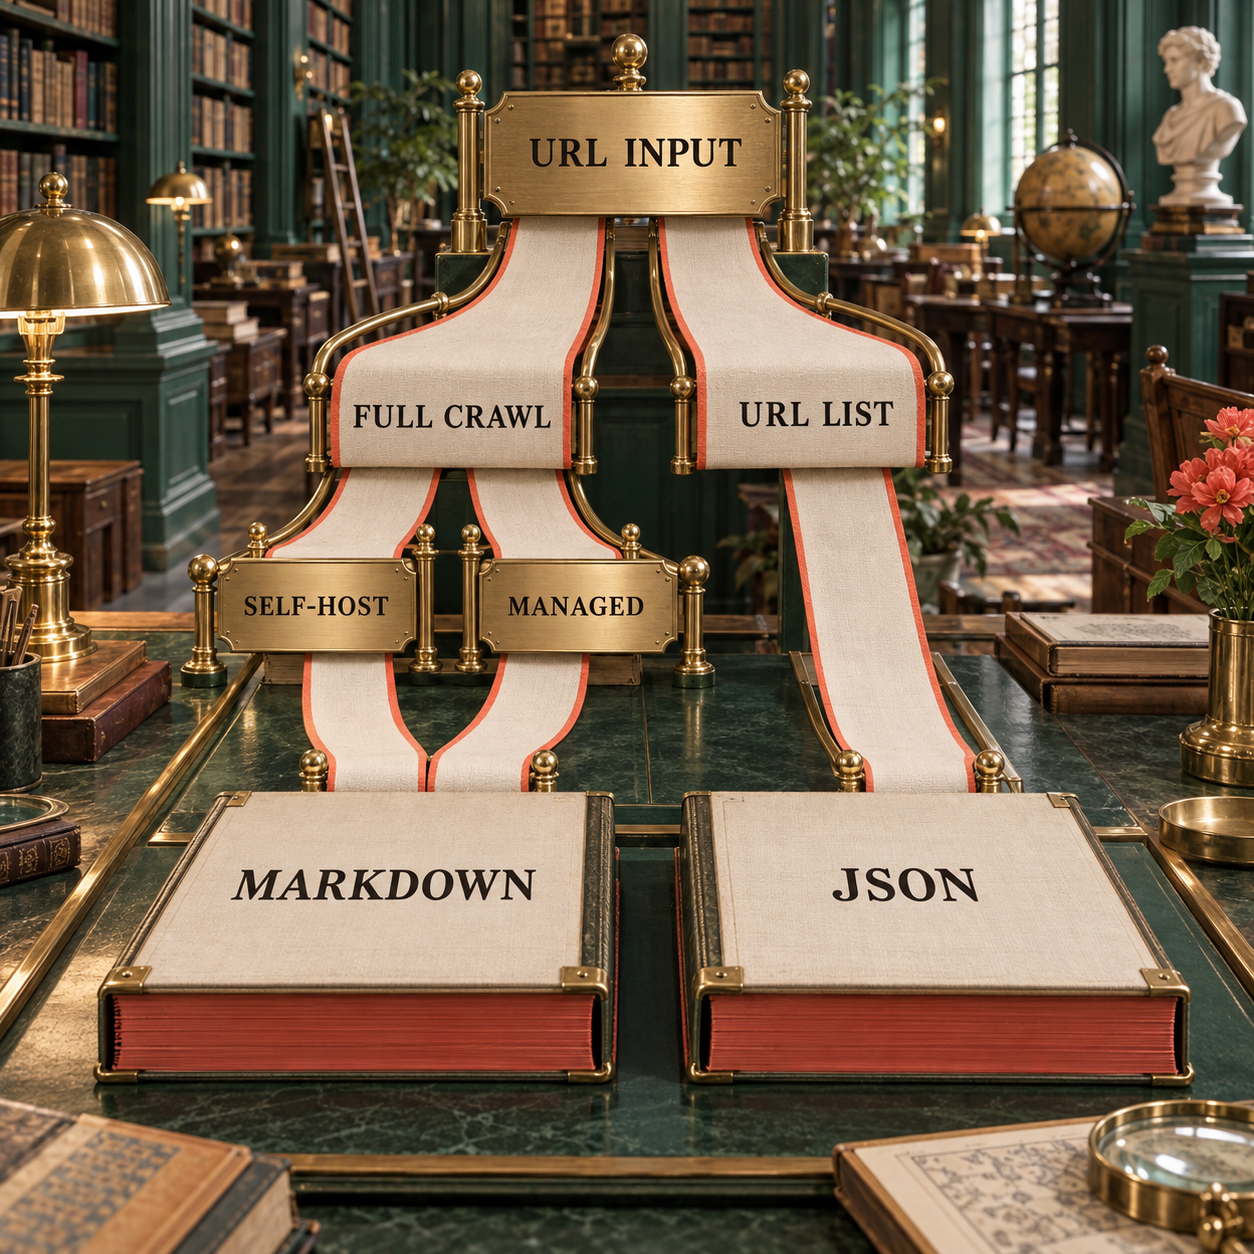
Firecrawl служит точкой отсчёта, поскольку его эндпоинт Crawl уже объединяет обнаружение, рендеринг и обработку страниц, а на выходе отдаёт Markdown либо JSON заданной схемы. Сервис списывает 1 кредит за просканированную страницу и ещё 4 кредита за режим JSON, поэтому для этого сравнения базовая стоимость равна 5 кредитам за каждую попытку.
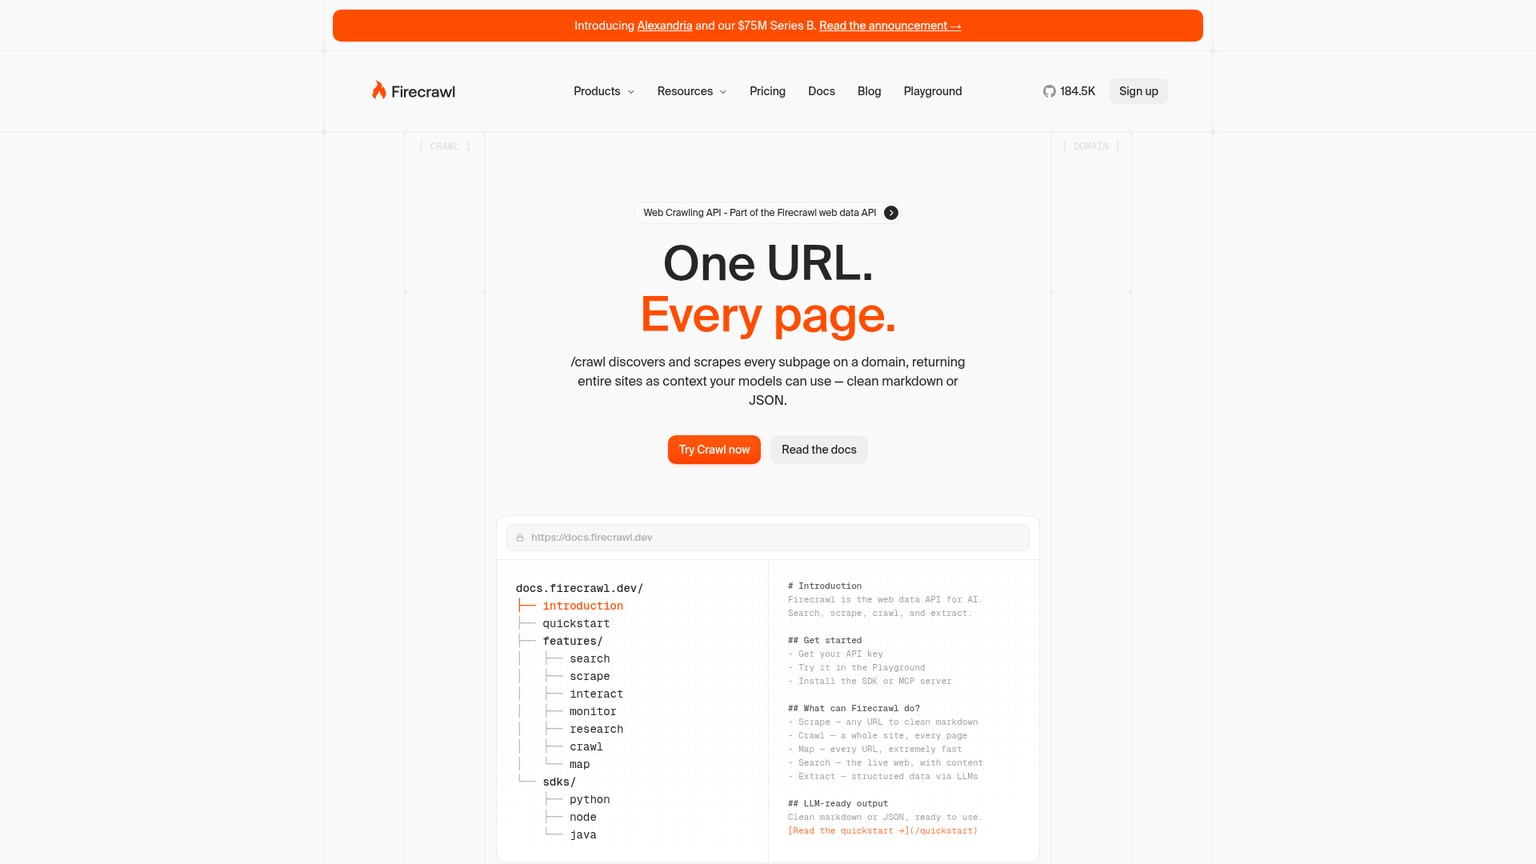
Именно такой комплект может сделать сохранение Firecrawl выгоднее внешне дешёвой замены. Firecrawl также управляет областью обхода, поддоменами, путями, глубиной и потоковой выдачей страниц. Reader API может стоить меньше за URL, но переложить обнаружение на команду; API доступа способен загрузить защищённые страницы, но оставить последующее преобразование в Markdown и нормализацию схемы.
Стоимость Firecrawl в модели принятых страниц
Текущие тарифы Firecrawl: Free за $0 с 1,000 кредитов, Hobby за $16 в месяц при годовой оплате с 5,000 кредитов, Standard за $83 со 100,000 кредитов, Growth за $333 с 500,000 кредитов, Scale за $599 с 1,000,000 кредитов и Enterprise с индивидуальной ценой. Дополнительный пакет стоит $9 за 1,500 кредитов на Hobby, $47 за 35,000 на Standard, $177 за 175,000 на Growth и $397 за 350,000 на Scale. Эти цены, лимиты и возможности краулинга сверены с актуальной страницей Firecrawl Crawl 25 сентября 2026 года.
При резерве 10% на успешные ответы, не прошедшие локальную проверку приёмки, для 1,000 принятых страниц с Markdown и JSON нужно 5,500 кредитов. Hobby с одним дополнительным пакетом обойдётся в $25. Для десяти тысяч принятых страниц требуется 55,000 кредитов, поэтому достаточно Standard за $83. Для ста тысяч понадобится 550,000 кредитов — это Growth с одним дополнительным пакетом за $510.
Поиск — отдельный слой. Если задача начинается с запроса и требует ранжированных источников, а не известного сайта или набора URL, сначала выберите решение с помощью сравнения поисковых API для ИИ, а затем передайте отобранные URL на слой извлечения.
Аналоги Firecrawl: сравнение в одной таблице
В таблице оценивается заявленное соответствие задаче, а не измеренное качество результата. Цены проверены по первичным страницам поставщиков 25 сентября 2026 года. Под «бесплатной пробой» также понимается постоянный бесплатный лимит, если поставщик предлагает именно его.
Универсального победителя нет, поскольку под «извлечением данных из веба» скрываются три разных продукта. Краулер обнаруживает страницы сайта, reader преобразует переданный URL, а слой доступа справляется с рендерингом или блокировками. Покупать стоит самый узкий продукт, который берёт на себя все этапы, не нужные вашей команде в эксплуатации.
Как отбирались инструменты
Кандидат попадал в список, только если его актуальные первичные материалы подтверждали реальный путь и к полезному содержимому страницы, и к машиночитаемому результату. API только для поиска исключены: ранжированное обнаружение не заменяет краулер. Сервисы только с прокси также не рассматривались, потому что один IP-адрес не создаёт чистый Markdown, обязательный JSON или сохранённый манифест обхода.
Сравнение опирается на пять приёмочных проверок:
- Обнаружение: способен ли инструмент обходить сайт, соблюдать заданную область и сохранять манифест канонических URL, или каждый URL должен поступить из другого компонента?
- Рендеринг и доступ: может ли он выполнять JavaScript и учитывать условия доступа сайта без неограниченного счёта за повторы?
- Контракт результата: сохраняются ли заголовки, таблицы, код и ссылки в Markdown и можно ли получить обязательные поля JSON без второго непрозрачного преобразования?
- Доказательства: может ли команда сохранять запрос, исходный ответ, нормализованный результат, заголовки, конфигурацию, хеш содержимого и вердикт для каждого URL из набора?
- Полная стоимость: сколько стоят обнаружение, рендеринг, извлечение, успешные, но отклонённые повторы, минимальные обязательства и время специалиста?
Ни один кандидат специально для этой статьи не запускался. Поэтому здесь нет заявлений о доле успешных ответов или рейтинга задержек. Все оценки качества ниже относятся к документированным возможностям, а все сравнения в долларах — к модели с открыто указанными допущениями.
Фиксированный приёмочный набор из 20 URL
Не принимайте решение о миграции по демонстрационному URL поставщика. Прогоните один и тот же фиксированный набор через старую и новую конфигурации, сохранив каждый ответ. В набор намеренно включены разные типы контента, на которых проявляются разные сбои:
- Код и длинные документы: Fetch API на MDN, классы Python, владение в Rust, RFC 9110 в HTML и HTML на HTTPBin.
- Таблицы, ссылки и структурированные страницы: справочник MDN по таблицам, руководство W3C по таблицам, статья Wikipedia о веб-скрапинге, каталог Books to Scrape и одна фиксированная карточка товара.
- Пагинация и JavaScript: Quotes to Scrape, его маршрут с JavaScript, маршрут с прокруткой, руководство MDN по JavaScript и нормализация ссылок HTTPBin.
- Кодировки и PDF: Unicode на HTTPBin, RFC 9110 в PDF, двухколоночная научная статья в PDF, минимальный PDF от W3C и форма W-9 Налоговой службы США.
Каждый результат должен содержать source_url, final_url, title, markdown, links, status_code, fetched_at и content_sha256. Для карточек товаров также обязательны entity_name, amount и currency, а для научной статьи в PDF — published_at. Явное значение null допустимо только там, где это разрешает манифест набора. Отсутствующее поле и null — не одно и то же.
Создавайте отдельный каталог для каждого инструмента, версии и конфигурации. Для каждого URL сохраняйте request.json, заголовки ответа, неизменённое тело, normalized.json, verdict.json и дайджест SHA-256. В вердикте должно быть названо первое нарушенное правило, а не только указано pass: false. Такой набор доказательств позволит другому инженеру воспроизвести решение после изменения поставщика, парсера или страницы.
Расчёт стоимости принятой страницы
В модели используются 1,000, 10,000 и 100,000 принятых страниц в месяц, а также резерв 10% на ответы, которые поставщик считает успешными, но локальная проверка схемы или Markdown отклоняет. Это оплачиваемые повторы. Явные сбои на стороне поставщика учитываются согласно опубликованным правилам возврата.
Базовая формула проста: плата поставщику или за хостинг плюс стоимость обнаружения, рендеринга, извлечения и оплачиваемых повторов, плюс часы специалиста, умноженные на полную часовую ставку команды. В таблице деньги и часы приведены отдельно, чтобы допущение в $100 за час можно было заменить без пересчёта каждой формулы поставщика.
При ставке $100 за час специалиста итог для 10,000 страниц составляет $383 у Firecrawl, $419 у Apify, $1,248 у Crawl4AI, $330 у ScrapFly, $401.10 у Jina, $449 у ScrapingBee, $555.22 у Zyte и $516.50 у Bright Data. Значение Jina применимо только при наличии надёжного манифеста URL: это не итоговая стоимость обхода всего сайта. В часы Bright Data и Zyte включена последующая работа с Markdown и схемой, поскольку страницы обоих продуктов не заявляют нативный Markdown в качестве используемого здесь контракта результата.
Строка извлечения намеренно показана отдельно. Firecrawl расходует 1 кредит на обход и ещё 4 кредита на JSON. В этом сценарии ScrapingBee использует 5 кредитов JavaScript и 5 кредитов ИИ, ScrapFly — 5 кредитов браузера или Unblocker и 5 кредитов модели извлечения, а Zyte — браузерный тариф уровня 3 плюс одно фиксированное извлечение пользовательского атрибута. Для Apify взята детерминированная оболочка JSON, 80% страниц через обычный HTTP и 20% — через headless-браузер по опубликованной верхней оценке; дополнительные ИИ-сводки не включены.
Для Jina предполагается 2,000 выходных токенов на попытку по $0.050 за миллион. Расход получается крошечным, но платежи идут крупными порциями: когда 10 миллионов бесплатных токенов закончатся, минимальное указанное пополнение составит 1 миллиард токенов за $50. Для Crawl4AI в модели приняты хосты DigitalOcean за $24, $48 и $96 на трёх объёмах, однако это лишь исходные данные для планирования, а не измеренная производительность.
1. Apify Website Content Crawler — лучшая управляемая замена в целом
Apify Website Content Crawler — наиболее сильная универсальная управляемая замена, когда команде нужны обнаружение, рендеринг JavaScript, Markdown и долговечный набор данных в одном сервисе. Инструмент обходит страницы через обычный HTTP или headless Firefox, сохраняет каждый результат как запись набора данных и экспортирует JSON либо CSV. По форме миграция получается близкой к Firecrawl, хотя сами API не идентичны.
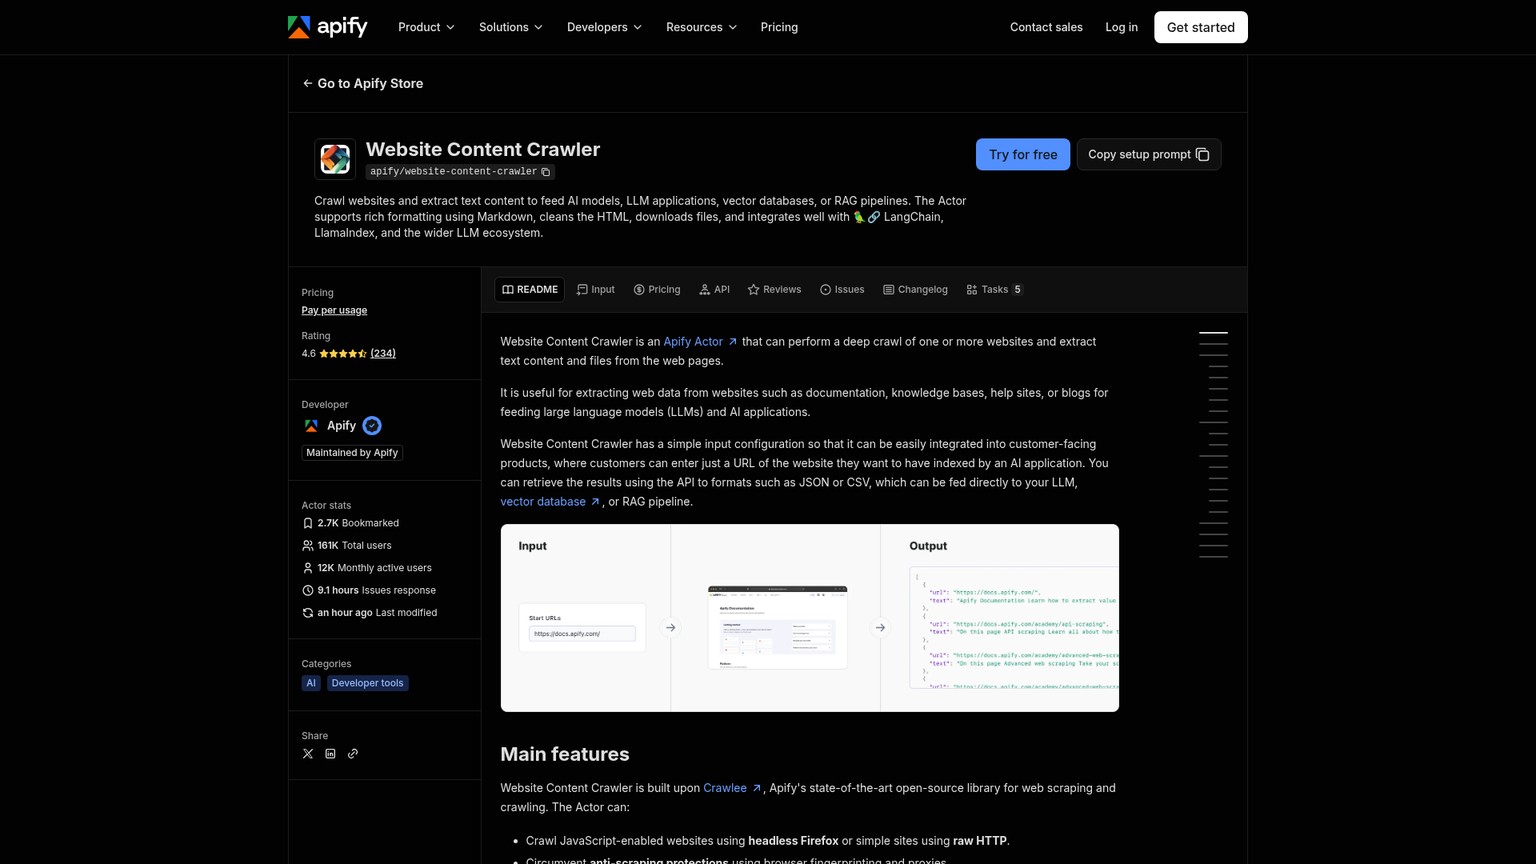
Главное преимущество — управление обходом как заданием. Область, результат и сохранённые записи набора данных находятся вместе; файлы, включая PDF, можно скачивать. Явное ограничение связано с семантическим извлечением: набор данных Actor представляет собой структурированную оболочку с текстом, Markdown и метаданными, но для собственной бизнес-схемы всё равно понадобятся детерминированные правила, другой Actor или этап с моделью.
Опубликованная оценка Actor составляет примерно $0.20 за 1,000 страниц через обычный HTTP и от $0.50 до $5 за 1,000 страниц через headless-браузер при указанной базовой конфигурации. Дополнительные ИИ-сводки прибавляют около $2–$3 за 1,000 страниц, а для страниц без заголовков сумма доходит примерно до $7 за 1,000. В модели выше это дополнение не используется: сводка не заменяет обязательные поля JSON.
Тарифы Apify: Free за $0 с ежемесячным лимитом использования $5 и 5 одновременными запусками; Starter за $19 с лимитом $19 и 32 запусками; Scale за $199 с лимитом $199, вычислительными единицами по $0.16 и 128 запусками; Business за $999 с лимитом $999, вычислительными единицами по $0.13 и 256 запусками; а также индивидуальный Enterprise. На Free работа останавливается после исчерпания лимита. На платных тарифах расход сверх лимита продолжается, а неиспользованный объём не переносится. Источник этих условий — актуальная страница тарифов Apify.
Лучше всего подходит: небольшой продуктовой команде или команде данных, которая заменяет управляемое задание обхода, особенно если важны история запусков и экспорт наборов данных.
Главное преимущество: обнаружение по всему сайту, браузерный рендеринг, Markdown и сохранённые записи набора данных JSON в одном управляемом запуске.
Цена: Free $0; Starter $19; Scale $199; Business $999; Enterprise — индивидуально. Фактическая стоимость Actor также включает вычисления, хранение, прокси и трафик, использованные запуском.
Бесплатная проба: постоянный тариф Free включает $5 ежемесячного использования платформы без карты.
- Обычный HTTP и headless Firefox покрывают и дешёвые статические страницы, и страницы с JavaScript.
- Записи набора данных упрощают проверку и экспорт сохранённых ответов.
- Область обхода, скачивание файлов, метаданные и Markdown объединены в одном управляемом задании.
- Счёт за платформу складывается из вычислений, хранения, трафика и прокси, а не из единого кредита за страницу.
- Запись набора данных JSON не становится автоматически бизнес-схемой, которую ожидает ваш последующий код.
- ИИ-сводки создают отдельные расходы Actor и всё равно не доказывают, что извлечение пройдёт приёмку.
Пробная миграция на Apify за пять шагов
Загрузите фиксированный манифест URL
Начните с 20 URL набора, а не со всего рабочего домена. Зафиксируйте входные данные Actor, тип краулера, лимит страниц и область, чтобы второй запуск означал то же самое.
Используйте обычный HTTP, пока страница не докажет необходимость браузера
Оставьте дешёвый путь для статических страниц, а образцы с JavaScript направляйте в headless-рендеринг. Сохраняйте выбранный режим краулера вместе с каждым результатом.
Экспортируйте Markdown и запись набора данных
Сохраните без изменений
markdown, канонический URL, метаданные и ссылки. В отдельном детерминированном шаге преобразуйте запись в обязательную локальную схему JSON.Отклоняйте результат до нарезки
Проверяйте таблицы, код, ссылки и обязательные поля в нормализованной записи. Нарушение одного правила отправляет URL в журнал повторов, а не в векторный индекс.
Считайте цену только по принятым страницам
Разделите полную стоимость Actor, прокси, хранения и работы специалиста на число принятых страниц. До расширения обхода сравните результат с базовой моделью Firecrawl.
2. Crawl4AI — лучшая альтернатива для самостоятельного развёртывания
Crawl4AI — лучший вариант для самостоятельного развёртывания, если владение инфраструктурой, границы данных или повторно используемые правила извлечения являются жёсткими требованиями. Он создаёт Markdown и поддерживает структурированное извлечение с помощью CSS, XPath или стратегии LLM, поэтому может выдавать и текст для поиска, и поля JSON без платы за каждое обращение к ПО.
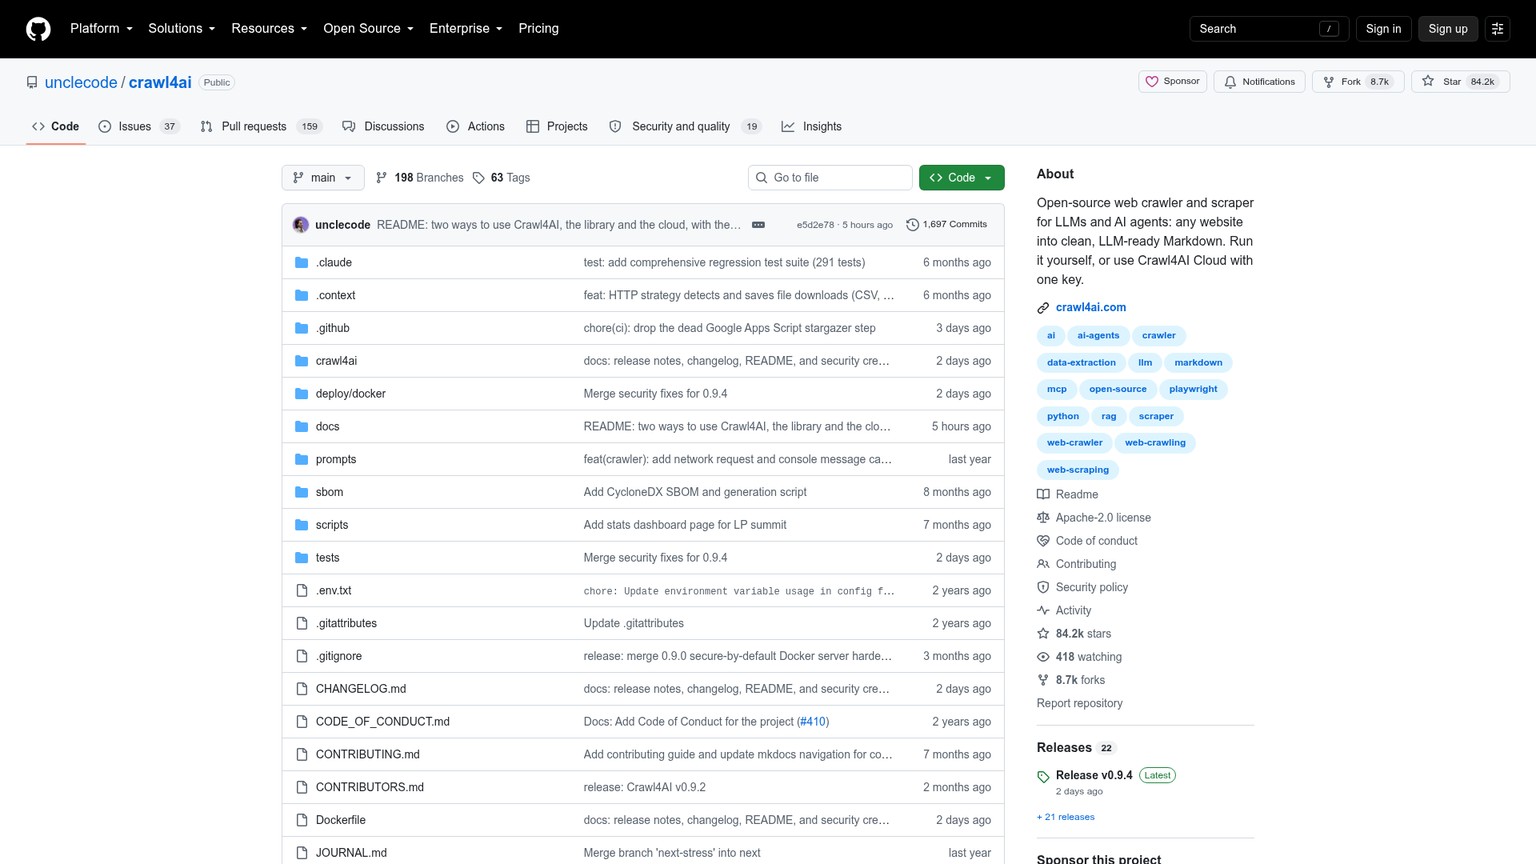
Текущая минимально безопасная версия важнее цены лицензии. Версия 0.9.4 вышла 23 сентября 2026 года и исправила три уязвимости, включая два пути серверной подделки запросов и дефект границы доверия конфигурации, способный раскрыть значения окружения. Для любой оценки следует закрепить v0.9.4 или более позднюю версию и изучить уведомления проекта о безопасности, прежде чем открывать доступ к API.
Crawl4AI и Firecrawl: в чём разница
Firecrawl продаёт готовый к эксплуатации сервис вокруг обхода: управляемые очереди, браузеры, кредиты, доставку и поддержку. Crawl4AI предоставляет краулер и систему извлечения, а развёртывание, обновления, наблюдаемость, стратегию прокси и реагирование на инциденты оставляет вашей команде. Выбор меняется в пользу Crawl4AI, когда всё это уже является общей возможностью платформы, а не отдельной системой, которую одному инженеру придётся строить ради проекта.
Для самостоятельного размещения рекомендуется не менее 4 GB RAM, Docker 20.10 или новее и Compose 2.24 или новее. В расчёте стоимости используются актуальные цены DigitalOcean на Basic Droplet: $24 за 4 GiB, $48 за 8 GiB и $96 за 16 GiB. Эти размеры — лишь параметры сценария; пропускная способность по страницам в этом исследовании не измерялась.
Лучше всего подходит: командам с готовой контейнерной платформой, строгой границей данных и инженерами, способными отвечать за эксплуатацию краулера.
Главное преимущество: контроль благодаря открытому исходному коду и детерминированные схемы извлечения CSS или XPath, позволяющие не тратить средства на модель для каждой страницы.
Цена: лицензия на ПО — $0. В модели используются хосты за $24, $48 и $96 в месяц, а при необходимости добавляются прокси, хранение, мониторинг, обращения к модели и трудозатраты.
Бесплатная проба: ПО имеет открытый исходный код; инфраструктура не входит.
- Markdown и структурированное извлечение работают внутри инфраструктуры команды.
- Схемы CSS и XPath делают обработку стабильных сайтов дешёвой и детерминированной.
- В настройках сервера для самостоятельного размещения проект теперь по умолчанию ориентируется на аутентифицированную и безопасную для loopback-сети работу.
- Репутация прокси, браузерные мощности, исправления, очереди и восстановление становятся вашей ответственностью.
- Размер хоста не доказывает пропускную способность по принятым страницам без сохранённого запуска.
- При извлечении через LLM расходы на токены модели и проверка границы данных переходят к отдельному поставщику или локальной модели.
Руководство по самостоятельному размещению Firecrawl рассматривает отдельный выбор между репозиторием Firecrawl и Firecrawl Cloud. Не считайте лицензию Crawl4AI за $0 экономией, пока в той же таблице не учтены люди, которые будут устанавливать исправления и поддерживать доступность.
3. ScrapFly — лучшее сочетание краулинга и извлечения для небольшой команды
ScrapFly — сильнейшая альтернатива для небольшой команды, если один аккаунт должен покрывать доступ, краулинг, преобразование в Markdown и типизированное извлечение. Продукты используют единый пул кредитов, а слой извлечения принимает HTML, Markdown, XML, JSON, CSV, RSS или обычный текст. Можно применять детерминированные шаблоны, предобученные модели или промпт со схемой JSON, не связывая нескольких поставщиков.
Модель кредитов понятна, если заранее зафиксировать конфигурацию. Простой HTTP-запрос через дата-центр стоит 1 кредит, рендеринг JavaScript или Unblocker — 5, маршрутизация через резидентский прокси — 25, а полноэкранный снимок страницы — 60. Извлечение по шаблону добавляет 1 кредит, по промпту или модели — 5. В документах размером более 500 KB базовая плата за извлечение повторяется за каждые дополнительные 500 KB.
Таким образом, сценарий статьи стоит 10 кредитов за успешную попытку: 5 за браузер или Unblocker и 5 за извлечение. С резервом 10% на повторы получается 11 кредитов за принятую страницу. Резидентская маршрутизация в модель не включена; если она нужна целевому сайту, вывод резко изменится.
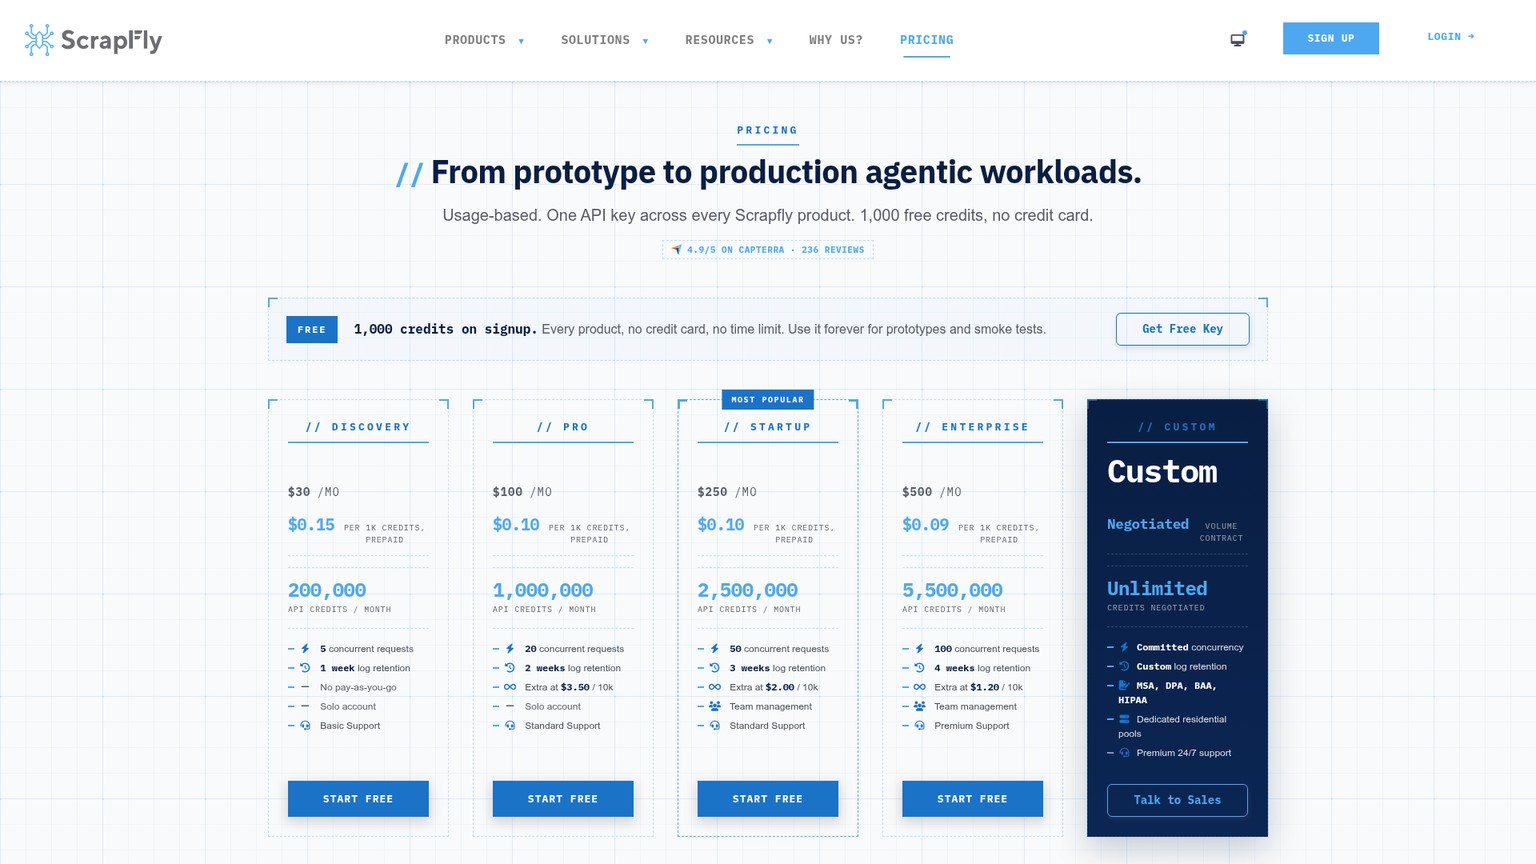
Текущие тарифы: Free с 1,000 разовых кредитов; Discovery за $30 в месяц с 200,000 кредитов и 5 одновременными запросами; Pro за $100 с 1,000,000 кредитов и 20 запросами; Startup за $250 с 2,500,000 кредитов и 50 запросами; Enterprise за $500 с 5,500,000 кредитов и 100 запросами; а также Custom с договорной ценой. Discovery останавливается при исчерпании квоты. Дополнительные 10,000 кредитов стоят $3.50 на Pro, $2 на Startup и $1.20 на Enterprise. Неиспользованные кредиты не переносятся. Условия взяты из актуальных тарифов ScrapFly.
Лучше всего подходит: небольшой команде, которой нужны управляемый краулер, средства доступа и типизированное извлечение в одном счёте.
Главное преимущество: один пул кредитов оплачивает краулер, браузер, Unblocker и три стратегии извлечения.
Цена: Free — 1,000 кредитов; Discovery — $30; Pro — $100; Startup — $250; Enterprise — $500; Custom — по договорённости.
Бесплатная проба: 1,000 кредитов при регистрации, без карты и указанного срока действия.
- Извлечение по шаблону сокращает расходы на модель при стабильной вёрстке.
- Предобученное извлечение и работа по промпту возвращают типизированный JSON без отдельного поставщика моделей.
- Неудачные запросы стоят ноль кредитов, а ответ сообщает фактический расход.
- На сложных страницах стоимость браузера, резидентского доступа и извлечения быстро складывается.
- Документы свыше 500 KB умножают плату за извлечение.
- На Discovery нет перерасхода сверх квоты, поэтому рабочим заданиям нужен Pro или жёсткая остановка до её исчерпания.
В этом конкретном сценарии ScrapFly побеждает в таблице на объёме 10,000 принятых страниц: $30 и три часа специалиста против $83 и трёх часов у Firecrawl. Ежемесячной разницы в $53 недостаточно для небрежной миграции. Она становится убедительной, только если фиксированный набор проходит проверку, рабочим целям не нужен резидентский путь за 25 кредитов, а схема не требует дополнительной очистки.
4. Jina Reader — лучший выбор, когда список URL уже готов
Jina Reader — лучший преобразователь с низкими переменными расходами, если обнаружение уже решено и каждый переданный URL нужно превратить в чистый Markdown или JSON заданной схемы. Движок по умолчанию рендерит JavaScript в headless-браузере, а direct engine использует более простой HTTP-путь. ReaderLM-v2 принимает схему JSON или инструкцию на естественном языке для структурированного вывода.
Преимущество одновременно задаёт границу: Reader читает один URL. Он не заменяет правила области для всего сайта, очередь обхода, политику дубликатов или манифест. Если список URL надёжно приходит из sitemap, поискового этапа или внутреннего каталога, такая узкая задача полезна. Если нет, стоимость обнаружения следует вернуть в расчёт.
Базовое использование Reader бесплатно. Новый ключ включает 10 миллионов токенов, а при работе с ключом списываются выходные токены. Пополнение на 1 миллиард стоит $50, или $0.050 за миллион; на 11 миллиардов — $500, или $0.045 за миллион. Неудачные запросы токены не расходуют. Лимиты составляют 20 запросов в минуту без ключа, 500 с бесплатным или платным ключом и 5,000 с премиальным. Все показатели взяты с актуальной страницы Jina Reader.
В расчёте предполагается 2,000 выходных токенов на каждую успешную попытку. После учёта резерва на повторы стоимость израсходованных токенов равна $0.11 для 1,000 принятых страниц, $1.10 для 10,000 и $11 для 100,000. Это экономическая стоимость использования, а не сумма списания при оплате. После исчерпания бесплатного пула минимальная указанная покупка всё равно составляет $50.
Лучше всего подходит: конвейеру с надёжным манифестом URL, которому нужно недорогое преобразование страниц в Markdown или JSON.
Главное преимущество: оплата выходных токенов, рендеринг JavaScript и извлечение по схеме JSON в узком Reader API.
Цена: базовый Reader бесплатен; каждый новый ключ получает 10 миллионов токенов; платные пакеты стоят $50 за 1 миллиард или $500 за 11 миллиардов.
Бесплатная проба: 10 миллионов токенов с новым API-ключом.
- Рендерер по умолчанию обрабатывает клиентский JavaScript до преобразования.
- Режимы схемы JSON и инструкции создают структурированные поля в том же reader.
- Неудачные запросы не расходуют токены.
- Для обнаружения сайта, управления областью и сохранения состояния обхода нужен другой компонент.
- После бесплатного пула минимальный платёж за пакет токенов составляет $50, даже если текущее потребление стоит гораздо меньше.
- Расход выходных токенов зависит от длины страницы и формата ответа.
На 100,000 страниц Jina выглядит победителем со стоимостью $11 и шестью часами, но только при условии готового манифеста. Если добавить ненадёжное обнаружение и ручное удаление дублей, эта строка станет несопоставимой с Firecrawl или Apify. Выбирайте Jina, когда граница компонента реальна, а не для сокрытия недостающей работы по обходу.
5. ScrapingBee — лучший API для скрапинга с лимитом кредитов
ScrapingBee — лучший вариант на уровне отдельных запросов, когда команда хочет ограничить максимальную стоимость любой страницы. Он умеет возвращать Markdown страницы или ответ JSON, применять правила извлечения CSS и добавлять ИИ-извлечение, если вёрстка недостаточно стабильна для селекторов.
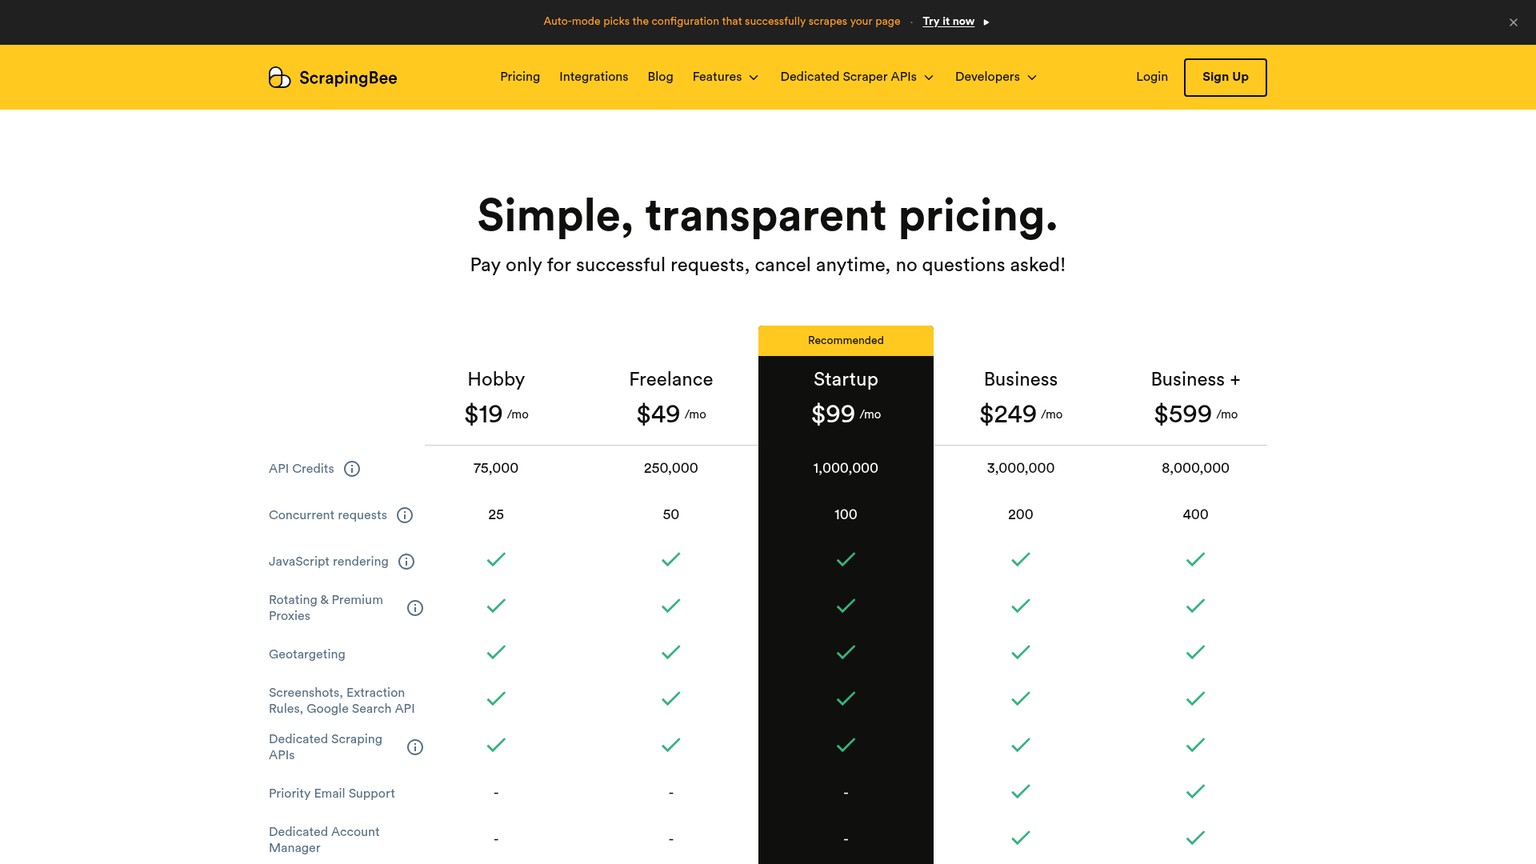
Полезный механизм управления — шкала кредитов. Обычный HTTP стоит 1 кредит, обычный JavaScript — 5, премиальный режим без JavaScript — 10, премиальный с JavaScript — 25, а stealth с JavaScript — 75. Функции ИИ добавляют 5 кредитов. Режим Auto списывает стоимость сработавшей конфигурации, не списывает ничего, если не сработала ни одна, и позволяет задать верхний предел расходов.
Ограничение — оркестрация. ScrapingBee загружает запрошенные страницы, но не является ближайшим аналогом механизма обнаружения сайта и очереди обхода Firecrawl. Команде придётся владеть манифестом URL, областью, обработкой дублей и состоянием задания, а также отличать сбой поставщика от успешного ответа, отклонённого локальной проверкой.
Текущие тарифы: Hobby за $19 в месяц с 75,000 кредитов и 25 одновременными запросами; Freelance за $49 с 250,000 и 50; Startup за $99 с 1,000,000 и 100; Business за $249 с 3,000,000 и 200; Business+ за $599 с 8,000,000 и 400. Пробный лимит — 1,000 кредитов без карты. Эти показатели взяты из актуальных тарифов ScrapingBee.
Лучше всего подходит: командам, которые уже отвечают за обнаружение и нуждаются в явных пределах стоимости рендеринга, премиальных прокси и отдельного запроса.
Главное преимущество: режим Auto может усиливать доступ, а max_cost ограничивает расход на один ответ.
Цена: Hobby — $19; Freelance — $49; Startup — $99; Business — $249; Business+ — $599.
Бесплатная проба: 1,000 кредитов без карты.
- Markdown, извлечение CSS и ИИ-извлечение доступны в одном API запросов.
- Шкала в 1, 5, 10, 25 и 75 кредитов делает стоимость доступа прозрачной.
- Режим Auto не списывает ничего, если все внутренние конфигурации завершились неудачей.
- Обнаружение сайта и сохранение состояния обхода остаются за пределами продукта.
- Успешный с точки зрения поставщика ответ, который отклонила ваша схема, всё равно считается оплаченной попыткой.
- До добавления ИИ-извлечения расход кредитов может вырасти в 15 раз при переходе от обычного JavaScript к stealth JavaScript.
В модели JavaScript вместе с ИИ-извлечением расходует 10 кредитов за попытку. Резерв на повторы повышает значение до 11 за принятую страницу: 1,000 страниц помещаются в Hobby за $19, 10,000 — во Freelance за $49, а 100,000 — в Business за $249, поскольку 1.1 миллиона кредитов превышают 1 миллион в Startup.
6. Zyte API — лучшая антибот-цена для конкретного сайта
Zyte API лучше всего подходит, когда сложность доступа сильно различается между целевыми сайтами, а покупатель хочет, чтобы поставщик назначал каждому сайту ценовой уровень. В стоимость ответа входят нужный маршрут через дата-центр или резидентскую сеть, рендеринг и работа по доступу; оплачиваются только успешные ответы.
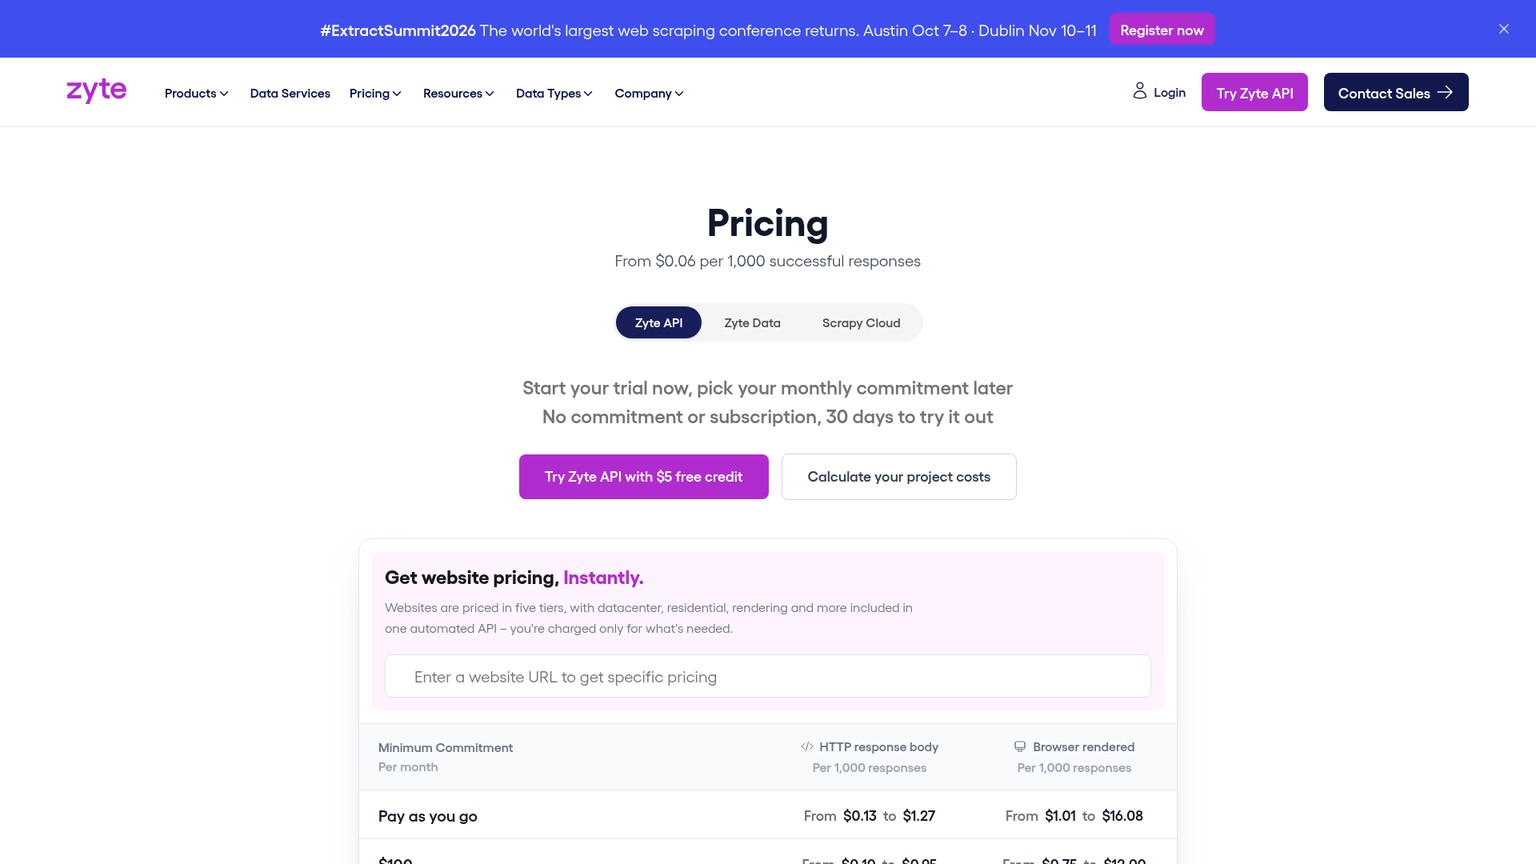
Цены PAYG за 1,000 HTTP-ответов составляют $0.13, $0.23, $0.44, $0.70 и $1.27 для уровней сайтов с 1 по 5. Ответы с браузерным рендерингом стоят $1.01, $2.01, $4.02, $8.04 и $16.08. При ежемесячном обязательстве $100 браузерные ставки снижаются до $0.75, $1.50, $3, $6 и $12; при $200 — до $0.60, $1.20, $2.40, $4.80 и $9.60; при $500 — до $0.48, $0.96, $1.92, $3.84 и $7.68.
График обязательств для HTTP тоже важен. При $100 уровни с 1 по 5 стоят $0.10, $0.17, $0.33, $0.53 и $0.95 за 1,000. При $200 — $0.08, $0.14, $0.26, $0.42 и $0.76. При $500 — $0.06, $0.11, $0.21, $0.34 и $0.61. Enterprise предлагает дополнительные договорные скидки. На актуальной странице тарифов Zyte также указаны $5 пробного кредита на 30 дней.
Для пользовательских атрибутов доступен фиксированный метод extract за $0.001 либо генеративный метод за $0.002 на 1,000 входных токенов и $0.01 на 1,000 выходных. Автоматическое извлечение стоит от $0.0004 до $0.0016 за тип данных. Так в расчёте появляется отдельная понятная строка извлечения вместо скрытого использования модели внутри общего тарифа.
Для этого сравнения ограничением становится формат результата. Zyte документирует тела HTTP-ответов, браузерный HTML и структурированные поля, но не нативный ответ Markdown. Поэтому последующее преобразование HTML в Markdown и его регрессионные тесты остаются частью миграции.
Лучше всего подходит: извлечению из множества доменов, когда основную часть счёта определяют сложность цели, необходимость браузера и инфраструктура доступа.
Главное преимущество: пять уровней запросов для конкретных сайтов и отсутствие платы за неудачные ответы или ответы с ограничением частоты.
Цена: PAYG без обязательств; ежемесячные обязательства $100, $200 и $500; Enterprise с дополнительными скидками. Цена ответа зависит от уровня сайта и выбора HTTP либо браузерного результата.
Бесплатная проба: кредит $5 на 30 дней без обязательств.
- Уровень конкретной цели объединяет инфраструктуру доступа в единую цену ответа.
- Оплата успешных ответов устраняет прямые расходы на ограничения частоты и сбои, признанные поставщиком.
- Фиксированная и токенная цена пользовательских атрибутов делает расходы на извлечение видимыми.
- Нативный Markdown не заявлен в документации, поэтому преобразование остаётся за вами.
- Уровень цели может измениться, а успешные ответы всё равно могут не пройти локальную проверку контента.
- Обнаружение всего сайта и последующее проектирование состояния обхода требуют явной настройки.
В расчёте используется браузерный рендеринг уровня 3 плюс одно фиксированное пользовательское извлечение. В трёх объёмах это даёт $5.52, $55.22 и $374 расходов на сервис. Это сценарий, а не универсальная цена Zyte; подставьте уровень из предложения для сайтов, которые собираетесь обходить.
7. Bright Data Crawl API — лучший вариант для защищённых сайтов в большом масштабе
Bright Data Crawl API — сильнейший кандидат, когда определяющими требованиями становятся доступ к защищённым сайтам, инфраструктура прокси и конкурентность. Цена включает рендеринг JavaScript, резидентские прокси, валидацию, решение CAPTCHA, геотаргетинг, обнаружение, разбор JSON или CSV и неограниченную конкурентность.
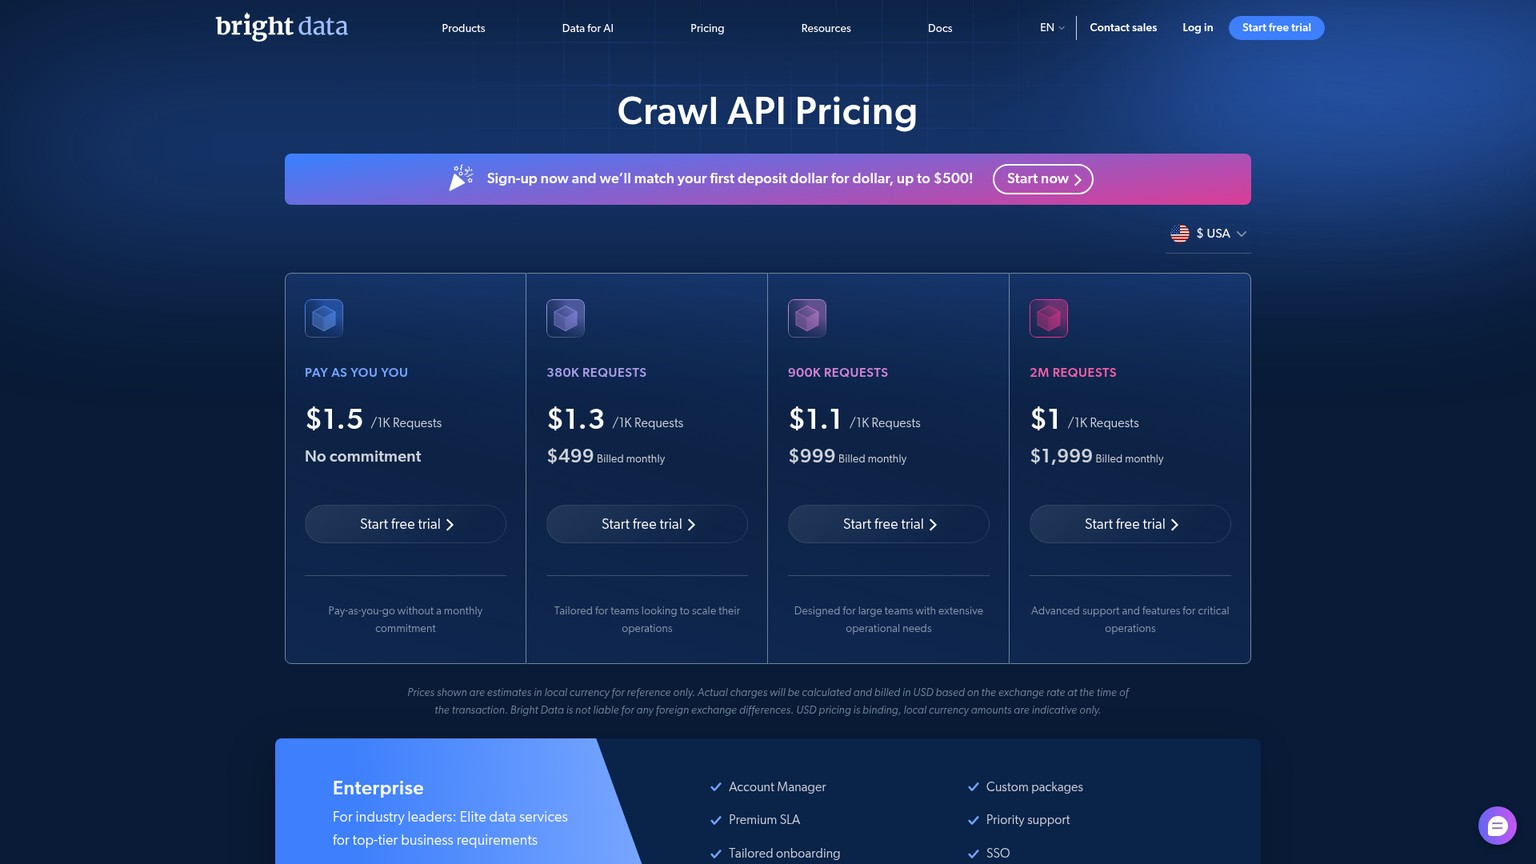
Начальная цена — $1.50 за 1,000 запросов PAYG без обязательств. План на 380,000 запросов стоит $499 в месяц по $1.30 за 1,000; 900,000 запросов — $999 по $1.10 за 1,000; 2 миллиона запросов — $1,999 по $1 за 1,000. Цена Enterprise определяется индивидуально. Таковы актуальные тарифы Bright Data Crawl API.
Ключевое ограничение такое же, как у Zyte: заявленные форматы доставки — NDJSON и CSV, а не нативный Markdown. Для поискового конвейера, которому нужны стабильные заголовки, блоки кода, таблицы и исходные ссылки в Markdown, преобразователь становится рабочим компонентом. Его сбои и время специалистов должны входить в знаменатель.
При ставках PAYG резерв 10% на оплачиваемые повторы доводит расходы на сервис до $1.65 для 1,000 принятых страниц, $16.50 для 10,000 и $165 для 100,000. Такие небольшие суммы за запросы нельзя считать полной стоимостью. В расчёте заложены четыре, пять и восемь часов на преобразование в Markdown, нормализацию схемы и проверку, а сложная цель способна изменить поведение запросов.
Лучше всего подходит: высококонкурентному сбору с защищённых доменов, где управляемая работа по обеспечению доступа ценнее нативного Markdown.
Главное преимущество: рендеринг, резидентская маршрутизация, обработка CAPTCHA, валидация и неограниченная конкурентность входят в цену Crawl API.
Цена: PAYG — $1.50 за 1,000 запросов; $499 за 380,000; $999 за 900,000; $1,999 за 2 миллиона; Enterprise — индивидуально.
Бесплатная проба: на актуальных карточках тарифов предлагается бесплатный период, но объём кредита в видимых условиях не указан.
- Инфраструктура доступа, для которой иначе потребовалось бы несколько компонентов, уже включена.
- Неограниченная конкурентность подходит крупным заданиям с жёсткими сроками доставки.
- NDJSON и CSV дают машиночитаемый результат без скрапинга панели самого поставщика.
- Нативный Markdown не заявлен в качестве контракта результата.
- Цена запросов PAYG сама по себе скрывает работу по преобразованию, схеме и проверке принятых страниц.
- Широкий стек доступа избыточен для публичной документации, с которой справляется обычный HTTP.
Какие аналоги Firecrawl с открытым кодом можно эксплуатировать самостоятельно
Crawl4AI — самая очевидная альтернатива с открытым исходным кодом в этом списке, но Firecrawl тоже публикует ядро для самостоятельного размещения. Важное различие не в том, можно ли клонировать репозиторий, а в том, воспроизводит ли открытое развёртывание обнаружение, браузерный доступ, очереди, постоянное хранение, наблюдаемость и контракт результата, от которых зависит рабочий конвейер.
Для Crawl4AI закрепите версию 0.9.4 или новее, требуйте аутентификацию, корректно привязывайте закрытые оценочные экземпляры и сохраняйте точную версию образа или пакета с каждым набором результатов. На стабильных шаблонах предпочитайте извлечение CSS или XPath, а любого поставщика LLM-извлечения выделяйте как отдельную статью расходов и отдельную границу данных. Заложенные в модель 8–20 часов специалиста в месяц — не бенчмарк, а напоминание учитывать исправления, сбои прокси, дрейф схемы и восстановление вместо того, чтобы называть их бесплатными.
Для ядра Firecrawl рассматривайте выбор между Cloud и самостоятельным размещением как отдельное архитектурное решение. Репозиторий убирает строку кредитов поставщика, но добавляет PostgreSQL, Redis, RabbitMQ, браузерные воркеры, мониторинг и обновления в рабочую нагрузку команды. В упомянутой выше отдельной статье о самостоятельном размещении есть набор проверок для этого решения.
Какой ИИ лучше всего подходит для веб-скрапинга
Лучший выбор определяется границей входных данных. Если на входе домен, а на выходе нужен полный корпус в Markdown и JSON, начните с Firecrawl или Apify, затем рассчитайте ScrapFly. Если на вход уже поступает надёжный список URL, Jina Reader убирает механику обхода и может оказаться намного дешевле. Если главная трудность — доступ, сравните ограничение расходов ScrapingBee, уровни сайтов Zyte и объединённый стек доступа Bright Data.
ИИ-агентам для веб-скрапинга нужна проверка приёмки
Агент не должен самостоятельно решать, что ответ 200 готов для поиска. Задайте ему детерминированную проверку: обязательные поля, минимальную длину Markdown, сохранность таблиц и кода, нормализованные ссылки, хеш содержимого, допустимый тип контента и явные правила null. Агент может маршрутизировать сбои, но не отменять контракт ради продолжения задания.
Решение меняется в четырёх случаях:
- Останьтесь на Firecrawl, если он проходит набор, а экономия за шесть месяцев не окупит миграцию и параллельную эксплуатацию.
- Выбирайте Apify, если управляемое задание обхода, сохранённый набор данных и гибкий процесс Actor важнее единой цены кредита за страницу.
- Выбирайте Crawl4AI, если команда уже управляет контейнерами, маршрутизацией доступа и дежурствами или граница данных исключает управляемую обработку.
- Выбирайте более узкий API, если обнаружение уже реализовано или доминирует доступ к защищённым страницам. Сильные стороны Jina, ScrapingBee, Zyte и Bright Data проявляются только при явно зафиксированной границе.
Не выбирайте инструмент по самому эффектному результату в демонстрационной среде. Конфигурация должна пройти тот же набор, сохранить те же доказательства и создать те же последующие фрагменты. Инструмент, который выглядит аккуратнее на одной странице статьи, всё равно может провалить таблицу, PDF или маршрут JavaScript, определяющий рабочую приёмку.
Что не стоит выбирать как прямую замену
Не покупайте продукт из соседней категории, выдавая его за готовый конвейер. Эти инструменты могут быть полезны, но не заменяют полный процесс Firecrawl, определённый в статье:
- Exa и Tavily: оставьте их для сравнения поставщиков поиска. Они не вошли в этот список, потому что замена здесь начинает работу после выбора домена или набора URL и должна создавать принятые тела страниц.
- Только Playwright или Puppeteer: автоматизация браузера — строительный блок, а не управляемый манифест обхода, контракт Markdown, журнал повторов или система структурированной доставки. Выбирайте их, только если намерены строить эти слои.
- Сервис только с прокси: доступ к ответу не очищает навигацию, не сохраняет ссылки, не валидирует JSON и не удерживает стабильные границы фрагментов.
- Неподдерживаемый форк краулера: бесплатный репозиторий превращается в инцидент, когда меняются версии браузеров, исправления безопасности или поведение цели, а за выпуск никто не отвечает.
Не используйте маркетинговый бенчмарк как доказательство готовности к миграции. Если точная конфигурация не запускалась на сохранённом наборе из 20 URL, показатель описывает чужую нагрузку. Эта статья намеренно не публикует синтетическую долю успеха или турнирную таблицу задержек.
План миграции для небольшой команды
При безопасной миграции Firecrawl и кандидат работают параллельно, пока нормализованные результаты, поведение повторов и фрагменты не совпадут на фиксированном наборе и репрезентативной рабочей выборке. Для плана нужны один ответственный, одна версионируемая схема и одно условие отката.
1. Зафиксируйте контракт входных данных и обнаружения
Запишите, откуда приходят URL: из обхода домена, sitemap, поискового API, очереди или внутренней базы данных. Сохраните разрешённые домены, политику поддоменов, включаемые и исключаемые пути, глубину, лимит страниц, каноникализацию и правила дубликатов. Проба Jina или ScrapingBee несопоставима с Firecrawl, если весь этот ряд не обеспечивает другой компонент.
2. Заморозьте схему результата
Версионируйте обязательные поля и типы. Как минимум сохраняйте source_url, final_url, title, markdown, links, status_code, fetched_at и content_sha256. Укажите, какие бизнес-поля могут быть null, а какие приводят к отклонению страницы. Храните исходный ответ, чтобы после изменения парсера запустить обработку снова и не платить краулеру повторно.
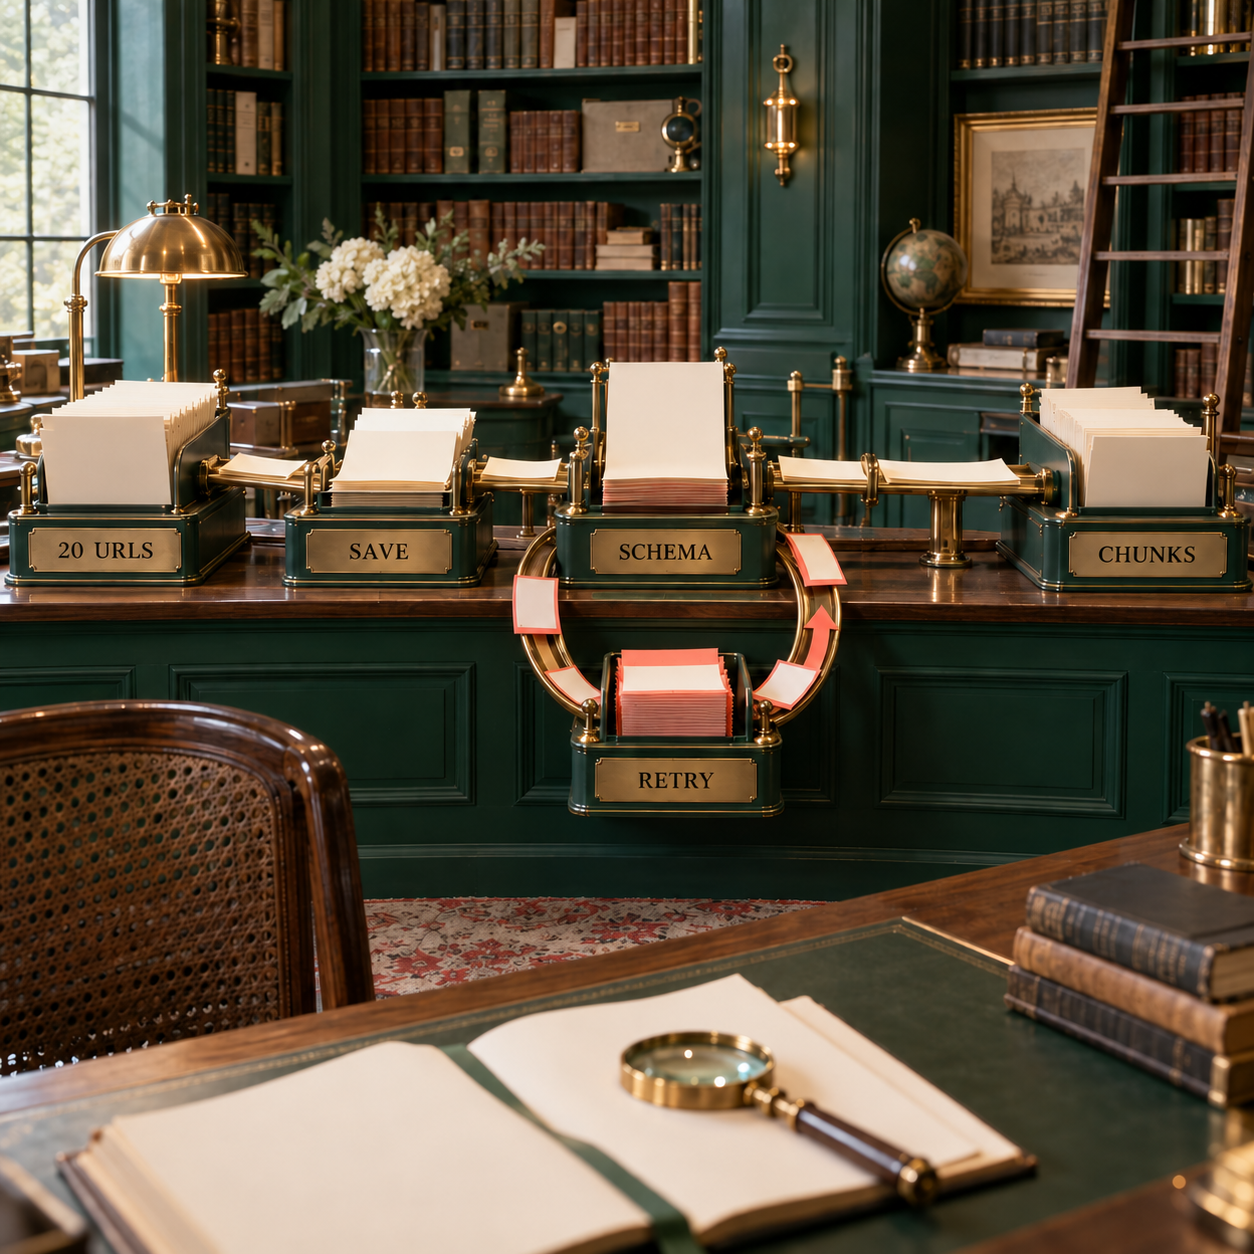
3. Считайте повторные попытки бухгалтерскими событиями
Для каждой попытки сохраняйте статус поставщика, HTTP-статус, вердикт приёмки, причину повтора, стоимость в кредитах или запросах и следующее действие. Разделяйте транспортные ошибки, признанные поставщиком сбои, блокировку доступа, пустой контент, ошибки схемы и сбои последующего преобразования. Ограничивайте повторы, а исчерпанные элементы отправляйте в очередь необработанных сообщений, чтобы не создавать невидимый цикл расходов.
4. Сохраните пакет доказательств
Используйте путь, составленный из инструмента, выпуска, хеша конфигурации, даты запуска и ID набора. Храните запрос, заголовки, неизменённый ответ, нормализованный JSON, Markdown, вердикт и дайджест. Рецензент должен понимать, какой рендерер, режим извлечения и схема создали любой принятый фрагмент.
5. Проведите регрессионную проверку последующей нарезки
До повторного создания эмбеддингов сравните иерархию заголовков, блоки кода, таблицы, цели ссылок, порядок документа и хеши содержимого. Затем сравните число фрагментов, их границы и ссылки на источники. Даже более чистая строка Markdown способна изменить поведение поиска, если исчезнут заголовки или строки таблиц окажутся в разных фрагментах.
6. Рассчитайте цену принятого корпуса и задайте откат
Сложите плату поставщику, стоимость хоста, токены извлечения, оплачиваемые повторы, хранение и часы специалистов. Делите на принятые страницы, а не на запросы. До запуска задайте условие отката — например, отсутствие обязательного поля, неожиданный уровень цели, существенный рост числа фрагментов или превышение лимита рабочих часов. Сохраняйте старый путь, пока новый не пройдёт этот период.
Для небольшой команды первый полезный артефакт — не оценка поставщика, а таблица с одной строкой на каждый URL набора и столбцами для обеих систем. Когда в строке есть сохранённые доказательства, успех или сбой можно проверить, а не выбирать по предпочтению.
Часто задаваемые вопросы
Законен ли веб-скрапинг?
Универсального ответа «да» или «нет» не существует. В США политика Министерства юстиции по CFAA отличает технические границы доступа от простого договорного ограничения, однако договор, авторское право, конфиденциальность, использование данных, средства контроля доступа и юрисдикция всё равно могут изменить оценку. Это не юридическая консультация; рабочий сбор данных требует заключения юриста по конкретным целям и способу использования.
Firecrawl — дорогой сервис?
Это зависит от принятого результата. Crawl расходует 1 кредит на страницу, а JSON добавляет 4, поэтому для 10,000 принятых страниц с резервом 10% на повторы в этой модели нужно 55,000 кредитов — они помещаются в Standard за $83. Работа специалистов и миграция могут стоить больше этого счёта.
Какой инструмент для веб-скрапинга лучше?
Apify Website Content Crawler — самая универсальная управляемая замена в этом списке. Crawl4AI сильнее при обязательном самостоятельном размещении, ScrapFly хорош для объединённого управляемого краулинга и извлечения, а Jina Reader выигрывает только при наличии надёжного списка URL.
Можно ли развернуть Firecrawl самостоятельно?
Да. Самостоятельно размещённое ядро даёт команде контроль, но она же отвечает за базы данных, очереди, браузерные воркеры, обновления, безопасность, маршрутизацию доступа и мониторинг. Это не тот же эксплуатационный продукт, что Firecrawl Cloud.
Какие есть аналоги Firecrawl?
В статье сравниваются семь альтернатив: Apify Website Content Crawler, Crawl4AI, ScrapFly, Jina Reader, ScrapingBee, Zyte API и Bright Data Crawl API. Они делятся на полноценные краулеры, reader-инструменты для переданных URL и API, ориентированные прежде всего на доступ.
Законно ли самостоятельное размещение?
Запуск ПО в собственной инфраструктуре обычно является отдельным вопросом от того, к каким ресурсам оно обращается. Авторизация, средства контроля доступа, условия сайтов, авторское право, конфиденциальность, правила защиты данных и назначение по-прежнему требуют отдельной оценки.
Стоит ли размещать краулер самостоятельно?
Это оправдано, когда обязательная граница данных, настройка или возможности общей платформы перевешивают эксплуатационную работу. Обычно создавать новую систему дежурств только ради исключения скромного ежемесячного счёта за API невыгодно.
Чем рискован бесплатный хостинг?
Бесплатные экземпляры могут засыпать, ограничивать CPU или память, сбрасывать хранилище, использовать IP с плохой общей репутацией и не давать гарантий восстановления. Из-за этого краулер может казаться ненадёжным, хотя причина не в самом ПО.
Можно ли бесплатно разместить собственный сайт?
Любительский сайт или тест краулера могут уложиться в бесплатный лимит. Для рабочего обхода всё равно нужны вычисления, хранение, пропускная способность, инфраструктура доступа, мониторинг, резервные копии и время специалиста, поэтому строка хостинга $0 не означает эксплуатационную стоимость $0.
У Firecrawl открытый исходный код?
Firecrawl публикует открытое ядро для самостоятельного размещения. Firecrawl Cloud добавляет управляемую инфраструктуру и эксплуатационные сервисы, поэтому один репозиторий не воспроизводит стоимость или границу надёжности облачного продукта.
- Последнее обновление
- 25 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

Аналоги CodeRabbit: что выбрать для ИИ-ревью кода
Сравниваем аналоги CodeRabbit по цене, Git-хостам, границам данных и модели оплаты: Greptile, Qodo, PR-Agent, Kodus, Cursor Bugbot и GitHub Copilot.25 сент. 2026 г.Build
Greptile vs CodeRabbit: что выбрать для ревью кода
Сравниваем Greptile и CodeRabbit по цене, лимитам, глубине ревью и поддержке Git-платформ. Расчёты для пяти авторов и понятные критерии выбора.25 сент. 2026 г.Build
Perplexity Portable Computer на AMD: как запустить локально в Windows
Как запустить Perplexity Portable Computer на AMD Ryzen AI Max в Windows: локальная модель, доступ к папкам, тест и границы облачных запросов.25 сент. 2026 г.Build
Обзор AgentRun: когда workflow для ИИ-агентов оправдан
Обзор AgentRun beta.4 на сценариях поддержки: типизированное состояние, лимиты вызовов агента, эскалация, цена и честные границы применения.24 сент. 2026 г.Build
Perplexity Fast Search или web: какой режим выбрать
Сравниваем Perplexity Fast Search и стандартный web: цены, задержку и качество выдачи. Разбираем, какой режим выбрать для ИИ-агентов и исследований.24 сент. 2026 г.Build
Стоимость ИИ-агентов: как резервный сценарий незаметно съел бюджет
Разбираем, как безопасная песочница превратила платный резервный сценарий в основной путь, обнулила общий баланс и скрыла пропавшие артефакты.24 сент. 2026 г.Build
Cursor Rollouts бесплатно? Что дают стартовые кредиты
Разбираем, доступен ли Cursor Rollouts бесплатно, кому дают кредиты на 10 дней, сколько стоит Teams и что известно о цене после их окончания.24 сент. 2026 г.Build