Web scraping: qué herramienta elegir y cuánto te costará
Compara ocho herramientas de web scraping para agentes de IA, seguimiento sin código y extracción a escala. Revisa precios, créditos y límites antes de elegir.




Firecrawl es la primera opción que conviene evaluar si necesitas páginas limpias para un agente de IA; Browse AI, si el seguimiento debe quedar en manos de operaciones; y Bright Data, si el acceso a los sitios limita la extracción. Las mejores herramientas de web scraping resuelven trabajos distintos: tanto Firecrawl como Context.dev parten de $19/mes con facturación mensual, pero pedir JSON estructurado cambia el consumo de créditos. Antes de elegir proveedor, define el resultado, la frecuencia y quién se hará cargo cuando falle una ejecución.
Herramientas de web scraping: comparación rápida
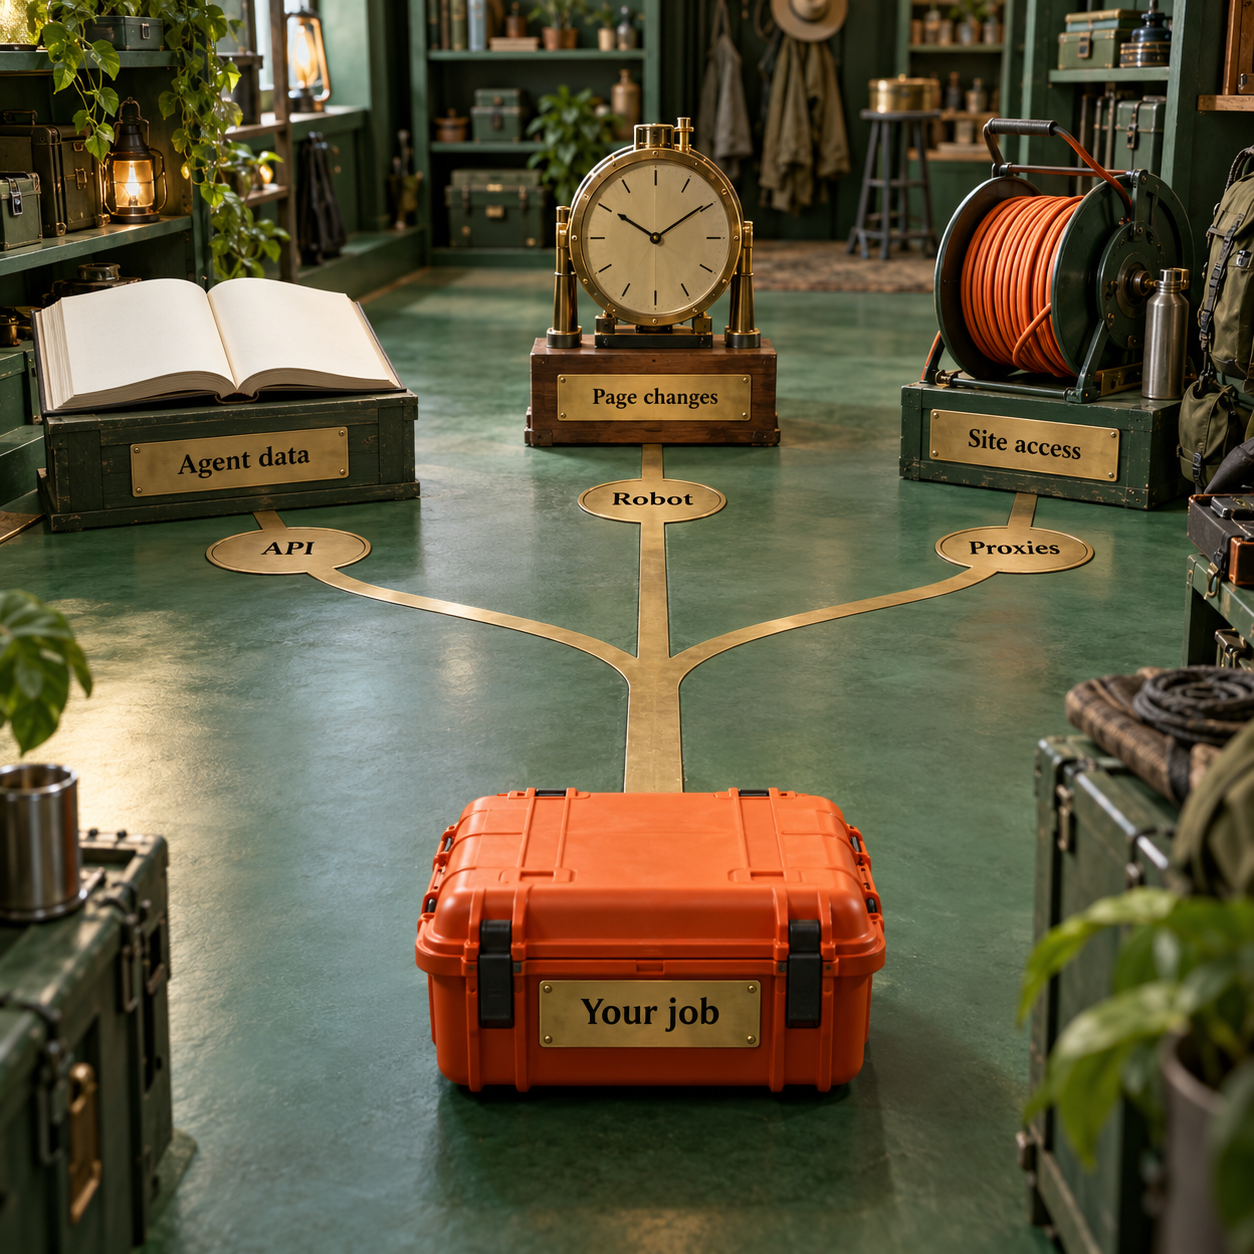
Compra la pieza que le falta a tu flujo de trabajo. Una API de scraping, un servicio al que tu software llama para obtener datos de una página, encaja con quien desarrolla un agente o un conjunto de datos. Un robot sin código encaja con quien necesita repetir una tarea de extracción desde operaciones. Una red de proxies, que dirige el tráfico a través de otras direcciones IP, encaja con un scraper que ya mantienes y que necesita acceder mejor a los sitios de destino.
Los precios y las cuotas siguientes se verificaron en las páginas oficiales de los fabricantes el 6 de octubre de 2026. Las tarifas anuales están identificadas y las pruebas gratuitas se distinguen de las cuotas que se renuevan. La columna de precio inicial muestra la oferta de pago de entrada; la última indica qué puedes evaluar sin contratar un plan.
Esta tabla sirve para seleccionar candidatos: un registro entregado, una página visitada y un gigabyte no son unidades equivalentes. El cupón para proxies de Bright Data, RESIGB50, anuncia un descuento del 50% durante tres meses. Usa esa tarifa temporal para presupuestar la prueba y la tarifa habitual para prever el gasto recurrente.
Define primero el resultado y quién se hará cargo
Aquí hay tres decisiones de compra distintas: cuando cambia el trabajo, cambia la herramienta. Quien incorpora documentación a un asistente, quien sigue los precios de la competencia desde operaciones y quien actualiza un gran conjunto de anuncios desde desarrollo no debería partir de la misma comparación de productos.
Primer uso: convertir páginas en contenido útil para un agente
Empieza por Firecrawl o Context.dev si necesitas incorporar contenido de páginas o campos estructurados a tu aplicación. Markdown conserva encabezados y enlaces en un texto legible; sirve cuando el agente de IA necesita el documento. JSON organiza la información en campos con nombre, como producto, precio, moneda y disponibilidad; sirve cuando el flujo necesita un registro que pueda validar y comparar.
Esa diferencia afecta tanto a la calidad como al costo. Para un asistente de soporte suele bastar una página de documentación limpia. Una alerta de precios necesita el campo de precio, su moneda, la variante correcta del producto y una marca de tiempo. Enviar una página a un modelo no le dice cuál de los distintos precios es el que importa a tu negocio.
También conviene distinguir scrape, que obtiene una página; crawl, que sigue los enlaces de un sitio para obtener varias páginas; y map, que descubre URLs. Si ya mantienes una lista de URLs fiable, repetir el descubrimiento puede añadir trabajo sin mejorar el flujo de datos. Si la documentación del sitio sigue creciendo, descubrir páginas forma parte de la tarea.
Segundo uso: vigilar páginas conocidas sin mantener código desde operaciones
Elige Browse AI si necesitas grabar una tarea de extracción y dejar el seguimiento de cambios en manos de operaciones. Elige Octoparse si encajan mejor el diseño visual de tareas y una configuración de extracción en la nube de pago. En este contexto, un robot es una secuencia guardada de acciones e instrucciones de extracción, no un sustituto general de un empleado.
Por ejemplo, una persona responsable de operaciones puede necesitar cada mañana el nombre, el precio y la disponibilidad de los productos de un proveedor. El resultado útil es una hoja de cálculo con columnas estables y una incidencia clara cuando desaparece un campo. Esa persona debe poder revisar la tarea y ajustarla cuando cambie el sitio.
Define qué cuenta como cambio antes de elegir la frecuencia. Una modificación del pie de página no afecta a la disponibilidad de inventario. Si una lista cambia el orden de sus filas, no debería parecer que todos los productos han sido reemplazados. Conserva un identificador estable, compara los campos pertinentes y envía los datos que falten a revisión en lugar de sobrescribir sin aviso el valor válido del día anterior.
Tercer uso: extraer a escala cuando el problema es acceder al sitio
Incluye Bright Data, Zyte o ScrapingBee entre los candidatos si tu software ya gestiona la programación y el conjunto de datos, pero obtener las páginas de destino se está complicando. Un servicio de desbloqueo se ocupa de aspectos del acceso, como los reintentos y la selección de proxies. Eso no define automáticamente el significado de los datos que recopilas.
Bright Data también ofrece Scraper APIs para sitios concretos, de modo que puedes comprar un registro más completo en lugar de contratar solo acceso a la red. Apify ocupa otro espacio útil: quizá ya exista un Actor mantenido para ese destino que resuelva la extracción que necesitas. Un Actor es un programa reutilizable en la nube que configuras y ejecutas.
La elección depende de quién mantiene cada parte. Si necesitas que otro mantenga la lógica de extracción, evalúa una Scraper API o un Actor. Si quieres conservar tu propia lógica de procesamiento, evalúa una API de obtención de páginas o un servicio de proxies. Pagar por acceso sin más y esperar un conjunto de datos terminado es una confusión costosa.
Ocho herramientas y los límites que condicionan la compra
Cada herramienta de esta lista responde a un trabajo recurrente concreto. La numeración facilita recorrer los candidatos; la mejor opción para cada uso depende del resultado, los límites y las responsabilidades que se explican en su sección.
1. Firecrawl: por dónde empezar si el agente necesita páginas limpias
Firecrawl es una API de scraping que convierte sitios web en contenido utilizable, y la primera opción que conviene evaluar para un agente basado en documentación. Sus funciones Scrape, Crawl y Map cubren la obtención de páginas, el recorrido del sitio y el descubrimiento de URLs, sin tratar esas tareas como si fueran intercambiables. Quien desarrolla un asistente de soporte puede mapear la documentación, seleccionar las rutas pertinentes y rastrear esas páginas para obtener Markdown. Elígelo si el resultado que buscas es contenido de páginas limpio; reconsidera la elección si lo principal es que operaciones gestione el seguimiento desde una hoja de cálculo.
Ideal para: Desarrolladores que incorporan documentación, artículos o páginas de referencia a un agente de IA.
Lo más destacado: Funciones separadas de scrape, crawl y map, con Markdown y extracción estructurada.
Precio: Hobby $19/mes, o $16/mes con facturación anual; 5,000 créditos mensuales.
Prueba gratuita: Plan Free recurrente con 1,000 créditos/mes, sin tarjeta.
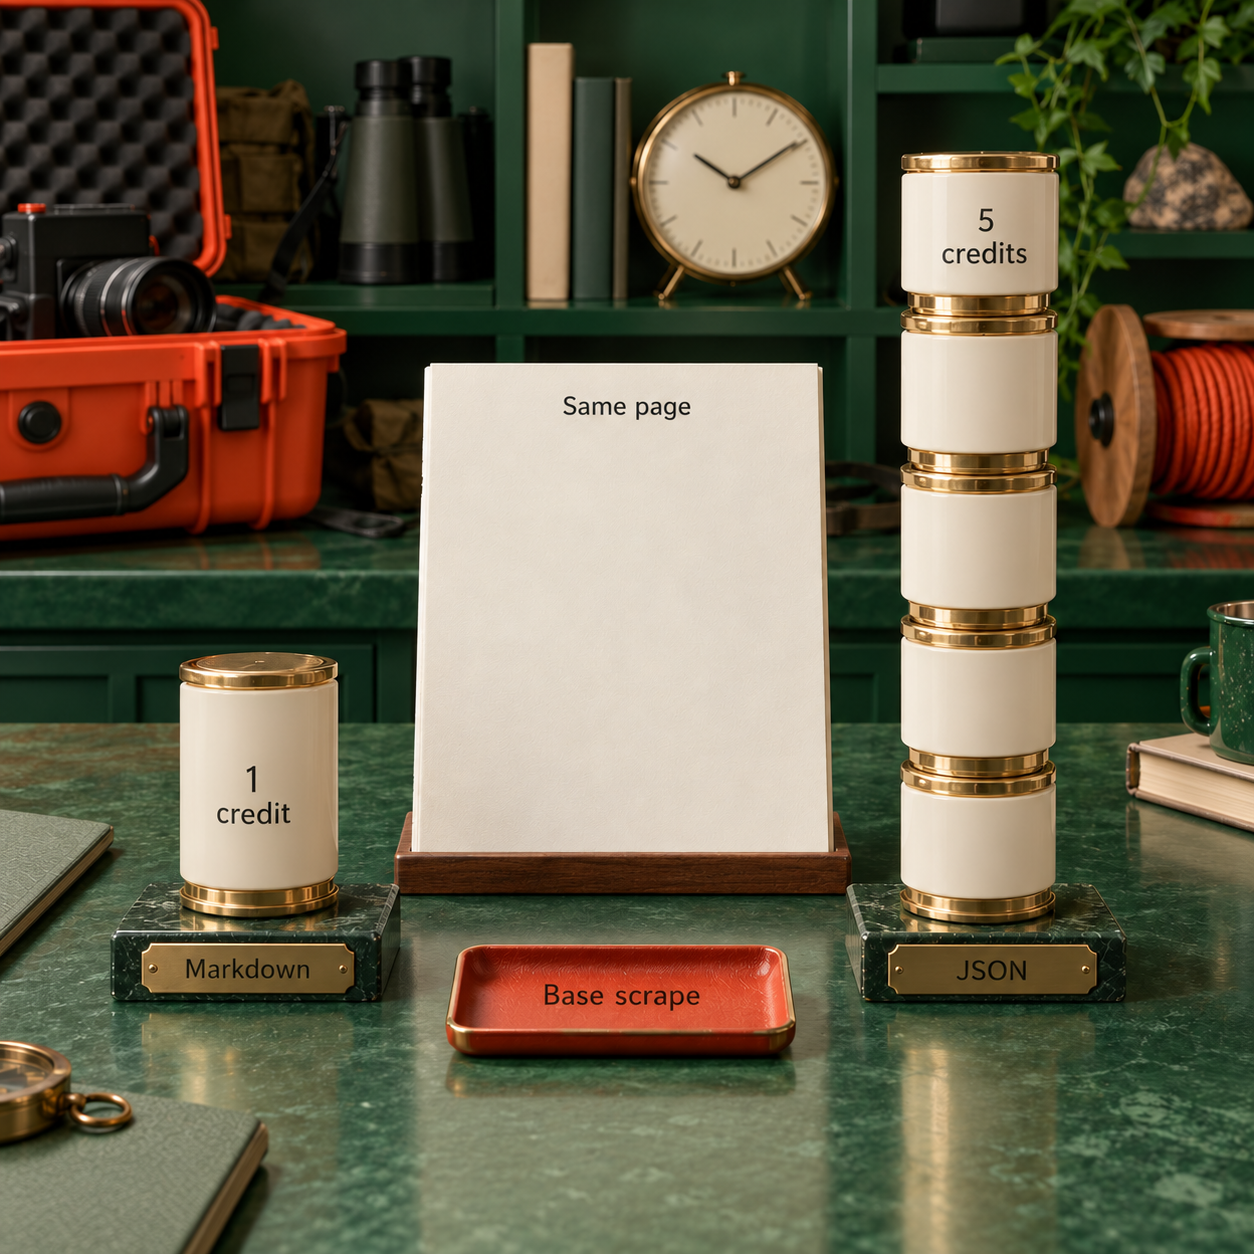
Una página obtenida mediante scrape o crawl básico cuesta 1 crédito. La extracción JSON suma 4 créditos, por lo que una solicitud estándar de página más JSON cuesta 5 créditos. Así, Hobby permite obtener 5,000 páginas básicas o 1,000 páginas con JSON estándar si todo el saldo se dedica a esa operación. La misma suscripción rinde de forma muy distinta según el resultado que solicites. Detalles de precios de Firecrawl.
Con facturación mensual, los planes son Free por $0, Hobby por $19 con 5,000 créditos, Standard por $99 con 100,000, Growth por $399 con 500,000 y Scale por $749 con 1,000,000. Enterprise tiene precio personalizado. Los equivalentes mensuales que se muestran para la contratación anual son $16, $83, $333 y $599/mes, con facturas anuales de $190, $990, $3,990 y $7,190, respectivamente. Son las cifras publicadas por el fabricante, incluidos sus redondeos. Todos los planes de Firecrawl.
El primer límite es el tamaño del rastreo solicitado. La documentación de crawl de Firecrawl establece un límite predeterminado de 10,000 páginas y advierte que puede rechazar una tarea si los créditos restantes no cubren el límite solicitado. Por eso, incluso un sitio pequeño en Hobby puede necesitar un limit inferior explícito antes de obtener la primera página. El siguiente límite es la concurrencia: Hobby permite 5 solicitudes simultáneas; Standard, 25; Growth, 50; y Scale, 100. Tener más créditos no elimina el máximo de solicitudes paralelas de tu plan. Comportamiento de Crawl.
También importa validar qué resultados aceptas. Firecrawl indica que no cobra una extracción que no devuelve ningún resultado, pero una página de error del sitio de destino, como un 403 o un 404, cuesta un crédito. Revisa el estado del destino y el contenido recibido antes de incorporarlo a la base de conocimiento. Una página de error bien convertida a Markdown sigue siendo una página de error.
- Scrape, crawl y map permiten decidir por separado el descubrimiento y la obtención de páginas.
- Markdown encaja con la incorporación de documentos; JSON, con un esquema de campos definido.
- La cuota gratuita recurrente permite evaluar un pequeño trabajo programado.
- Las recargas de pago permiten aumentar el uso antes de cambiar de plan.
- La extracción estructurada reduce considerablemente la cuota básica de páginas.
- Un límite de rastreo predeterminado alto puede superar el saldo de una cuenta pequeña.
- Las páginas de error recibidas pueden generar cargos y necesitan validación propia.
- Los créditos de Hobby, Standard y Growth normalmente no se acumulan para el siguiente periodo.
Mapea la fuente antes de recopilarlo todo
Usa el Map playground para descubrir las URLs de la documentación. Conserva las rutas que respondan a las preguntas reales de tu asistente. Mapear descubre direcciones; extraer su contenido es una operación aparte.
Elige el resultado útil más económico
Empieza con Markdown para un asistente basado en documentos. Usa un esquema JSON cuando el flujo posterior necesite campos con nombre. Antes de dar el esquema por claro, verifica una página de producto representativa que muestre tanto el precio habitual como uno con descuento.
Fija un límite de rastreo que puedas cubrir
Para el conjunto ilustrativo de 120 páginas, establece un
limitexplícito de 120. Filtra por rutas para evitar que el rastreador gaste el saldo en páginas de blog o de cuenta que no vienen al caso.Guarda el resultado y la evidencia que permite validarlo
Conserva en tu propio almacenamiento la URL de origen, la hora de extracción, el estado del destino y el contenido. La documentación de Firecrawl indica que los resultados de un rastreo completado están disponibles mediante la API durante 24 horas; la respuesta de recuperación no debería ser tu única copia.
Planifica expresamente la siguiente ejecución
Haz que el programador de tu aplicación vuelva a visitar el conjunto de fuentes aceptadas. Presupuesta por separado el descubrimiento, la extracción y el seguimiento, y define quién recibe una incidencia cuando una fuente deja de devolver el contenido esperado.
Si necesitas reemplazar tu configuración actual de Firecrawl, la comparación de alternativas a Firecrawl profundiza en la migración y los criterios de aceptación. Cambiar de proveedor es una decisión distinta de pasar de incorporar documentos a realizar seguimiento sin código.
2. Browse AI: seguimiento que puede gestionar operaciones
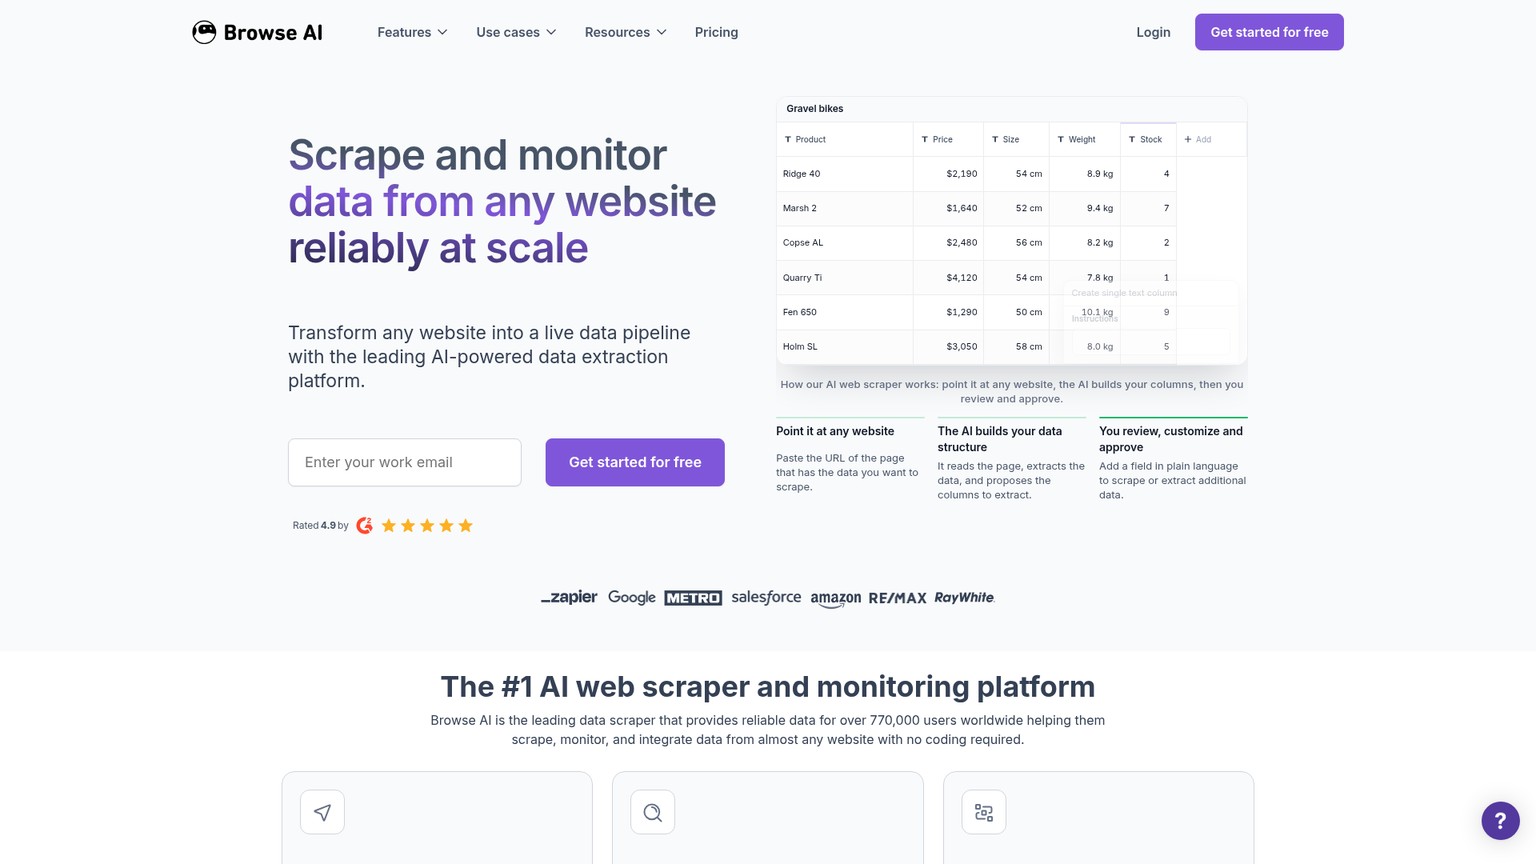
Browse AI es una plataforma de scraping y seguimiento sin código que graba una tarea y la convierte en un robot reutilizable. Encaja con quien sigue precios de productos, ofertas de empleo o entradas de directorios en un conjunto conocido de sitios. La persona responsable puede grabar los campos que quiere extraer y enviar los resultados a una hoja de cálculo o a un flujo conectado. Su límite decisivo combina páginas, filas extraídas y dominios supervisados: «robots ilimitados» no equivale a datos ilimitados.
Ideal para: Quien necesita extracción recurrente y seguimiento de cambios sin mantener código de scraping.
Lo más destacado: Robots grabados, seguimiento programado e integraciones con hojas de cálculo y flujos de trabajo.
Precio: Personal $19/mes con facturación anual, $228 por adelantado y 12,000 créditos anuales.
Prueba gratuita: Plan Free con 50 créditos/mes, 2 dominios y robots ilimitados.
Browse AI cobra un crédito por visita a una página estándar o por cada diez filas extraídas, según lo que consuma más. Una página con una lista de 50 productos cuesta 5 créditos; visitar las 50 páginas de detalle suma otros 50 si son páginas estándar. Así, «una lista de productos» se convierte en una extracción de 55 créditos cuando también necesitas los detalles. Los sitios premium pueden costar más, por lo que conviene revisar el consumo mostrado en la tarea. Precios de Browse AI y ejemplos de créditos.
Los planes anuales publicados son Free por $0, Personal por $19/mes con 12,000 créditos/año, Professional por $69/mes con 60,000 créditos/año y Premium desde $500/mes con facturación anual. Personal incluye 5 dominios y 3 usuarios; Professional, 10 dominios y 10 usuarios. Los créditos anuales se entregan por adelantado. Premium añade un servicio gestionado de configuración, mantenimiento y transformación de datos.
La opción de facturación mensual de la página muestra Personal por $48/mes con 2,000 créditos mensuales y Professional por $87/mes con 5,000. Por tanto, la oferta anual de Personal a $19 no consiste simplemente en pagar la misma cuota en otra fecha. Compara tanto los créditos incluidos como el periodo de facturación. Professional anual supone $828 por adelantado; Personal anual, $228.
El límite de dominios puede llegar antes que el de créditos. Un flujo que comprueba pocos campos en muchos sitios de proveedores puede necesitar dominios adicionales aunque extraiga pocos datos. En los planes anuales, los dominios extra figuran a $4/mes en Personal y $2.40/mes en Professional. Los planes anuales también permiten recargar créditos, con un mínimo de 1,000; Personal publica $0.024/crédito y Professional, $0.017-$0.013/crédito.
Para un flujo de precios de proveedores, guarda un identificador de producto y la moneda junto al valor. Un robot que extrae un número no puede decidir si un precio de oferta, un precio para miembros o un formato de venta distinto debe sustituir el registro de compras. Ese significado lo aportan tu regla de comparación y tu cola de revisión.
- Las tareas grabadas permiten revisar las instrucciones de extracción desde operaciones.
- Los planes incluyen seguimiento, acceso a la API y webhooks.
- Las integraciones con Google Sheets, Airtable, Zapier y Make cubren flujos habituales de operaciones.
- Los complementos de dominios y las recargas anuales de créditos permiten ampliar un plan.
- Las listas con muchas filas y las visitas a páginas de detalle acumulan consumo.
- El límite de dominios puede obligar a comprar un complemento antes de agotar los créditos.
- La oferta anual más económica tiene una cuota distinta de Personal mensual.
- Los cambios del sitio y los campos ambiguos siguen necesitando una persona que revise el resultado.
Elige Browse AI si quien responde por los datos también debe poder ajustar el robot. Opta por una API si la extracción forma parte de tu producto y desarrollo ya se ocupa de la programación, el esquema y la gestión de fallos.
3. Bright Data: elige el producto antes de comparar precios
Bright Data es un proveedor de datos web que reúne redes de proxies, Scraper APIs ya preparadas y Web Unlocker. Conviene evaluarlo cuando el acceso a los sitios de destino o el volumen de extracción son el cuello de botella. Quien desarrolla un comercio electrónico puede comprar un scraper para un sitio concreto que devuelva registros de productos; quien ya tiene un scraper propio quizá necesite acceso mediante proxies residenciales. Son compras que resuelven partes distintas del trabajo y se facturan con unidades diferentes.
Ideal para: Extracción en la que importan el acceso al destino, la ubicación geográfica o un scraper mantenido para un sitio concreto.
Lo más destacado: Productos separados de proxies, desbloqueo y registros estructurados.
Precio: Web Scraper API PAYG $1.5/1K registros; proxies residenciales PAYG $8/GB antes del cupón temporal.
Prueba gratuita: Scraper API ofrece 5K registros/mes gratis; la prueba de proxies residenciales es independiente.
Usa Scraper API si lo que necesitas comprar es el registro. Sus APIs para sitios concretos devuelven datos estructurados e indican que incluyen proxies, desbloqueo, procesamiento, ejecución, almacenamiento y transferencia de salida. Los planes son Free Tier con 5K registros/mes, PAYG a $1.5/1K registros, Scale a $499/mes con 384,000 registros y $1.3/1K registros adicionales, y Enterprise con precio personalizado. Revisa el esquema de entrada y salida del scraper de destino antes de suponer que incluye todos los campos necesarios. Precios de Web Scraper API.
Usa Web Unlocker si tu código necesita delegar la gestión del acceso. La página enumera gestión automática de proxies, reintentos, rotación de IP y resolución de CAPTCHA. Free Tier incluye 5K solicitudes/mes; PAYG cuesta $1.5/1K solicitudes; y la oferta Scale mostrada cuesta $499/mes por 383K solicitudes, con $1.3/1K adicionales. Enterprise tiene precio personalizado. Bright Data aclara que Web Unlocker no es un navegador interactivo para navegar o hacer clic a lo largo de un flujo. Precios y limitaciones de Web Unlocker.
Usa proxies residenciales si quieres conservar el scraper. La ficha detallada de PAYG muestra $8/GB, que se reducen a $4/GB con la promoción RESIGB50 de tres meses. Los paquetes mensuales promocionales publicados son $499 con 141 GB, $999 con 332 GB y $1,999 con 798 GB. Por encima de 1 TB, la página remite a un presupuesto personalizado. El ancho de banda contabiliza el tráfico enviado al sitio de destino y recibido de él, no solo los registros que terminas guardando en la base de datos. Precios de proxies residenciales.
Esa última diferencia determina el presupuesto. Una solicitud que descarga imágenes u otros recursos de la página puede consumir ancho de banda sin aportar más registros útiles. Una API de registros incluye esos costos de acceso en el precio anunciado por registro; con proxies sin más, tú te encargas de las solicitudes, el procesamiento y las comprobaciones de calidad. El precio por GB no permite saber el costo por anuncio aceptado hasta medir el flujo real.
El principal riesgo es comprar la capa equivocada. Mejorar el acceso mediante IP no corrige un parser que selecciona el campo incorrecto. Un scraper de registros mantenido por otro tampoco tiene por qué conservar exactamente el comportamiento de extracción propio del que ya dependes. Define el contrato de datos antes de comparar dos precios solo porque pertenecen al mismo proveedor.
- Las Scraper APIs para sitios concretos pueden reducir el trabajo de extracción propio.
- Los productos por registros, solicitudes y ancho de banda permiten contratar la capa que necesita desarrollo.
- El precio de Scraper API incluye los costos de acceso y procesamiento descritos en su página.
- Las cuotas gratuitas recurrentes de las APIs permiten evaluar destinos compatibles.
- La variedad de productos exige precisar qué se está comprando.
- El tráfico residencial se sigue cobrando por GB, sin garantizar registros válidos.
- La tarifa promocional de proxies es temporal.
- Web Unlocker no sustituye un flujo de navegación interactiva.
Bright Data encaja cuando la pieza que falta es la infraestructura de acceso o un scraper adecuado mantenido por el proveedor. Para un pequeño seguimiento a cargo de operaciones, Browse AI es un punto de partida más directo; para incorporar documentación, empieza por las APIs que devuelven contenido de páginas.
4. Context.dev: datos para agentes y seguimiento desde una misma API
Context.dev es una API de contexto web cuyo sitio enumera scraping, mapeo de URLs, rastreo, lotes, respuestas con fuentes y seguimiento. Encaja con quien desarrolla una aplicación que necesita páginas listas para agentes y actualizaciones programadas. Un asistente basado en documentación puede incorporar las fuentes iniciales y recibir después las actualizaciones de seguimiento mediante un webhook: un mensaje HTTP que llega a su aplicación cuando ocurre un evento. Por eso merece evaluarse junto a Firecrawl para este uso; el enriquecimiento de marcas es otra parte del producto, no el motivo para elegirlo como herramienta de scraping.
Ideal para: Un agente o producto que combina extracción de páginas y seguimiento de fuentes mediante webhooks.
Lo más destacado: Scrape, Map, Crawl, Batches y Monitors en una sola API.
Precio: Developer $19/mes con 7,500 créditos mensuales.
Prueba gratuita: Free Tier con 1,000 créditos/mes, sin tarjeta y con 10 monitores.
El sitio ofrece Markdown, HTML, capturas de pantalla y campos estructurados, con renderizado y proxies incluidos en la extracción básica. Sus monitores comprueban páginas de forma programada y envían actualizaciones a un webhook. Es una integración para desarrollo: tu aplicación recibe la actualización, la valida y decide qué cambiar después. No supone repartir las responsabilidades igual que al entregar a operaciones un robot grabado conectado a una hoja de cálculo. Descripción del producto de Context.dev.
Los planes mensuales son Free Tier por $0 con 1,000 créditos, Developer por $19 con 7,500, Pro por $99 con 125,000, Growth por $299 con 500,000 y Scale por $499 con 1,000,000. Enterprise tiene precio personalizado y anuncia 2,000,000+ créditos/mes. Los límites de solicitudes simultáneas de las funciones principales suben de 1 en Free a 10 en Developer, 100 en Pro, 250 en Growth y 500 en Scale. Precios de Context.dev.
Una extracción estándar consume 1 crédito. Una extracción JSON correcta añade 4, hasta un total de 5 créditos por página estándar; las acciones del navegador elevan la extracción básica a 2 antes de añadir la extracción estructurada. Por tanto, incluir renderizado y proxies en la base no significa que cualquier solicitud cueste un crédito. El saldo de 7,500 créditos de Developer permite obtener 1,500 páginas con JSON estándar si se dedica íntegramente a esa operación.
Las recargas de pago para nuevas suscripciones cuestan $2.20 por 1,000 créditos en Developer, $1.80 en Pro, $1.40 en Growth y $1.00 en Scale, y se facturan en bloques de 1,000 créditos. Las suscripciones existentes conservan sus tarifas. Así puedes comparar un plan pequeño con recargas frente a otro mayor, en lugar de subir de plan solo porque se agotó el saldo incluido.
El límite específico de rastreo es de 500 páginas por llamada a Crawl. Para sitios más grandes se utiliza Batches en modo crawl. Divide la incorporación de fuentes en consecuencia y asegúrate de que los resultados llegan a tu almacenamiento antes de dar el lote por completo. El endpoint de extracción y una base de conocimiento duradera son piezas distintas de la arquitectura.
El otro límite aparece con los resultados parcialmente correctos. Context.dev indica que no cobra la mayoría de las solicitudes fallidas, pero sí las respuestas de recurso no encontrado, y una respuesta puede combinar resultados fallidos con uno correcto. Revisa los resultados devueltos y key_metadata.credits_consumed: una respuesta global correcta no equivale necesariamente a un registro completo.
- El contenido de páginas y el seguimiento programado mediante webhooks encajan en un mismo flujo de datos para agentes.
- El renderizado y los proxies están incluidos en el precio de extracción básica.
- El plan gratuito recurrente incluye una pequeña cuota de monitores.
- Los bloques de recarga publicados permiten presupuestar un trabajo pequeño con cifras concretas.
- La extracción JSON y las acciones del navegador aumentan el consumo de créditos.
- Una llamada a Crawl tiene un límite; las fuentes mayores necesitan Batches.
- La entrega mediante webhook sigue necesitando lógica de aplicación y almacenamiento.
- Los resultados parciales y las páginas no encontradas que generan cargos requieren comprobaciones de aceptación.
Elige Context.dev si esa combinación de funciones de API y presupuesto de créditos encaja con tu agente. Compáralo con Firecrawl usando las mismas fuentes representativas y el mismo esquema de salida; una cuota inicial mayor no demuestra una mejor calidad.
5. Apify: gana valor cuando ya existe el Actor adecuado
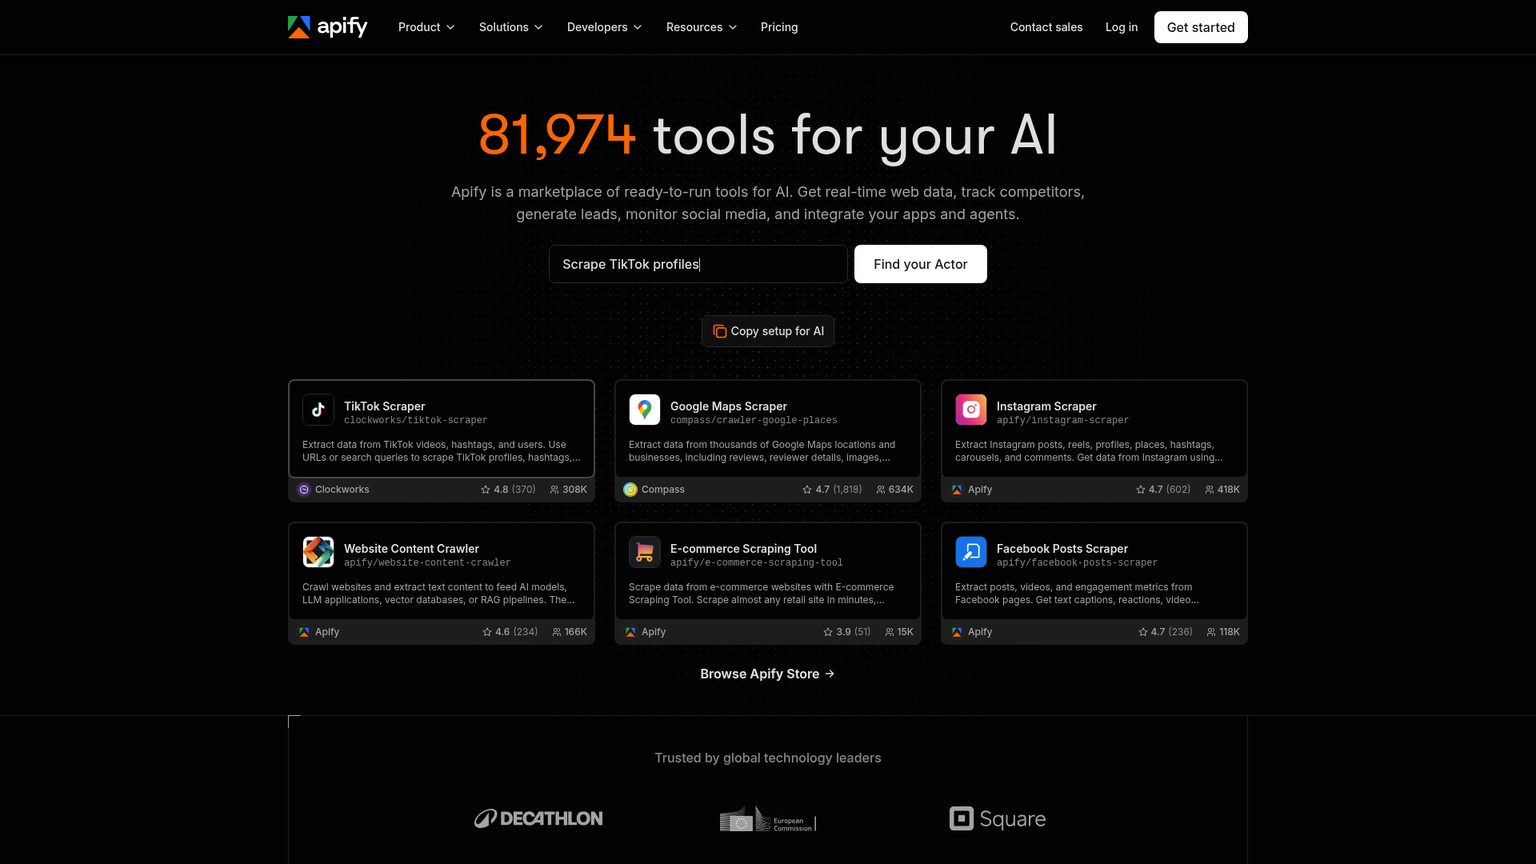
Apify es una plataforma en la nube para programas reutilizables de scraping y automatización llamados Actors. Es una buena opción cuando tu destino ya cuenta con un Actor adecuado y mantenido, porque esa lógica de extracción puede valer más que un endpoint genérico de obtención de páginas. Quien actualiza un conjunto de datos de un directorio de empresas puede configurar la entrada del Actor, guardar la tarea y programar ejecuciones recurrentes. El límite está en el comportamiento y la facturación del Actor elegido, no solo en la suscripción a la plataforma.
Ideal para: Un destino o una tarea de extracción concreta que ya resuelve un Actor adecuado.
Lo más destacado: Programas reutilizables en la nube con programación de tareas e integraciones.
Precio: Starter $19/mes + pago por uso, con $19 de uso incluidos.
Prueba gratuita: Plan Free con $5/mes de uso, sin tarjeta.
El plan Free de Apify cuesta $0 e incluye $5 para gastar en Store o en uso de la plataforma. Starter cuesta $19/mes + pago por uso e incluye $19; Scale cuesta $199 e incluye $199; Business cuesta $999 e incluye $999. Enterprise tiene precio personalizado. El cómputo cuesta $0.2 por unidad en Free y Starter, $0.16 en Scale y $0.13 en Business. Una unidad de cómputo es un GB de RAM utilizado durante una hora. Precios de Apify.
No conviertas el saldo incluido en dólares en una cuota fija de páginas. El Actor elegido puede tener su propio precio; además, los recursos de plataforma, proxies, almacenamiento y transferencias afectan a la factura según la carga de trabajo. Compara la ejecución completa que devuelve registros aceptados, no solo el atractivo precio inicial del programa del catálogo.
En una ejecución expresamente hipotética dedicada solo a cómputo, un GB de RAM durante diez horas consume diez unidades de cómputo. En Starter, eso supone $2 de uso de cómputo. No indica cuántos anuncios se obtendrán ni qué cargos adicionales habrá. Incluso afirmar que $19 compran 95 unidades de cómputo presupone que todo el saldo se destina a cómputo, algo que una tarea real de scraping puede no cumplir.
Las herramientas de programación de Apify permiten ejecutar tareas guardadas con una zona horaria elegida y enviar notificaciones mediante webhooks. Su documentación indica que las nuevas programaciones están desactivadas por defecto: guardar una programación no demuestra que la siguiente ejecución vaya a ocurrir. Comprueba que esté activada y revisa la próxima ejecución mostrada. Documentación de programación de Apify.
En el ejemplo del directorio, revisa la paginación, la cobertura geográfica, los identificadores de salida y el historial de mantenimiento del Actor antes de comprometerte. Un Actor que recopila una lista de categorías no necesariamente enriquece cada empresa de la lista con todos los campos que espera tu CRM. Conserva una muestra de registros aceptados y rechazados, y haz visibles los campos ausentes.
- Un Actor adecuado puede aportar lógica de extracción específica para el destino.
- Las tareas guardadas y las programaciones facilitan la extracción recurrente.
- El catálogo también incluye flujos de rastreo de contenido de páginas.
- El uso incluido permite evaluar una ejecución completa de pequeño tamaño.
- No existe un precio universal de Apify por página o registro.
- Los cargos específicos del Actor pueden pesar más que el plan de plataforma.
- La entrada y la salida de la tarea siguen necesitando validación frente a tus datos.
- Hay que activar una nueva programación antes de confiar en ella.
Elige Apify cuando el Actor te ahorre un trabajo de extracción significativo y el costo de la ejecución completa sea aceptable. Usa una API de scraping directa si el trabajo consiste sobre todo en «obtener estas páginas conocidas» y el catálogo añade complejidad sin ahorrar tareas.
6. ScrapingBee: obtención gestionada con multiplicadores por solicitud
ScrapingBee es una API de scraping que gestiona opciones de renderizado y proxies para un flujo de extracción mantenido por desarrollo. Encaja con quien quiere conservar el código de procesamiento y programación, pero delegar las dificultades al obtener páginas. Por ejemplo, un servicio de datos de productos puede pedir una página renderizada y aplicar sus reglas de campos existentes al contenido recibido. El primer límite que debes presupuestar es el consumo de créditos de la configuración que realmente funciona en el destino.
Ideal para: Desarrolladores que conservan la lógica de extracción propia y reemplazan la capa de obtención de páginas.
Lo más destacado: Controles de renderizado y proxies, y Auto-Mode con un consumo máximo de créditos.
Precio: Freelance $49/mes con 250,000 créditos de API.
Prueba gratuita: 1,000 créditos de API, sin tarjeta; no se anuncia un plan gratuito recurrente.
La lista completa de planes publicados incluye Freelance por $49/mes con 250,000 créditos, Startup por $99 con 1,000,000, Business por $249 con 3,000,000 y Business + por $599 con 8,000,000. Enterprise 14 cuesta $999 con 14,000,000; Enterprise 24, $1,599 con 24,000,000; Enterprise 41, $2,399 con 41,000,000; y Enterprise 69, $3,599 con 69,000,000. Para una capacidad mayor hay que hablar con el proveedor. Los precios no incluyen IVA. Precios de ScrapingBee.
Se trata de créditos, no de solicitudes. Los costos documentados para obtener páginas son 1 crédito con un proxy clásico sin JavaScript, 5 con JavaScript, 10 con un proxy premium sin JavaScript, 25 con un proxy premium con JavaScript y 75 con un proxy stealth con JavaScript. La extracción con IA suma otros 5 créditos. El renderizado de JavaScript está activado por defecto. Costos de las solicitudes de ScrapingBee.
Por tanto, los 250,000 créditos de Freelance alcanzan como máximo para 50,000 solicitudes con proxy clásico y JavaScript, 10,000 con proxy premium y JavaScript o 3,333 solicitudes completas con proxy stealth y JavaScript, si todo el saldo se dedica a esa única configuración. Son cálculos de cuota, no tasas de éxito medidas. Las funciones adicionales y una combinación de destinos cambian esas cifras.
Auto-Mode puede probar configuraciones y cobrar por la que funcione, sin cargo si todas fallan. Su parámetro max_cost limita las configuraciones que puede intentar. Sin embargo, la documentación indica que no elige automáticamente instrucciones de espera o clic específicas para cada página. Si el precio que necesitas solo aparece después de una selección o una carga asíncrona, sigue siendo necesario definir ese comportamiento. Documentación de Auto-Mode.
Ese es el límite: configurar la obtención de una página no define qué quieres extraer. Una respuesta HTML correcta puede contener un espacio vacío, el precio de una región predeterminada o una selección distinta de la que haría tu cliente. Conserva la respuesta como evidencia y verifica el campo de negocio, en lugar de dar el trabajo por terminado con una llamada correcta a la API.
- Encaja con un scraper propio cuyo procesamiento y programación deben seguir en tu código.
- Las opciones de renderizado y proxies tienen costos en créditos publicados.
- Auto-Mode permite limitar cuánto puede costar una configuración de acceso.
- La concurrencia y la capacidad aumentan mediante una escala de planes explícita.
- Una misma cuota anunciada de créditos permite cantidades de solicitudes muy distintas.
- La extracción con IA consume créditos adicionales.
- Auto-Mode no aporta instrucciones de espera o clic específicas para el destino.
- La oferta gratuita es una prueba, no una cuota permanente para trabajo programado.
Elige ScrapingBee si valoras el control de la solicitud y ya sabes cómo validar la respuesta. Prefiere una API de registros o un Actor de Apify adecuado si lo que quieres dejar de hacer es mantener las reglas de extracción del sitio de destino.
7. Octoparse: tareas visuales y programación en la nube con un plan de pago
Octoparse es una aplicación visual de scraping que encaja con quien está dispuesto a diseñar y mantener tareas de extracción desde operaciones. Tiene sentido para recopilar catálogos o anuncios de forma recurrente cuando hace falta un constructor de tareas en lugar de una integración con una API. Una persona que analiza compras puede definir los campos de lista y detalle, y trasladar después el flujo validado a la ejecución en la nube de pago. El plan Free sirve para evaluar localmente, pero no debe tomarse como base de un flujo desatendido.
Ideal para: Quien construye tareas visuales de extracción y contrata ejecución en la nube cuando la necesita.
Lo más destacado: Scraping por tareas con programación en la nube de pago y exportación automática.
Precio: Standard desde $69/mes con facturación anual.
Prueba gratuita: Free Plan con 10 tareas locales y 50,000 filas exportadas/mes.
Free incluye 10 tareas, ejecución en el dispositivo local, hasta 10,000 filas por exportación y 50,000 filas de exportación mensual. Standard añade extracción en la nube, programación de tareas, exportación automática y Data Export API, con 100 tareas y hasta 3 procesos simultáneos en la nube. Professional permite 250 tareas y hasta 20 procesos simultáneos en la nube, además de Advanced API y soporte adicional. Enterprise anuncia 750+ tareas y 40+ procesos simultáneos en la nube. Detalles de los planes de Octoparse.
Los planes publicados son Free por $0, Standard desde $69/mes, Professional por $249/mes y Enterprise con precio personalizado. Ambas tarifas de pago se facturan anualmente. Trata esos equivalentes mensuales como ofertas anuales y confirma el importe de la factura al contratar antes de prever el desembolso. Precios de Octoparse.
La unidad de facturación es una suscripción con límites de tareas y procesos, no un crédito estándar por solicitud. Eso puede encajar con un flujo que extrae mucho dentro de un conjunto manejable de tareas, pero «exportación de datos ilimitada» en los planes de pago no significa ejecución paralela ilimitada en la nube. Los tres procesos simultáneos de Standard pueden limitarte mucho antes de llegar a 100 tareas guardadas.
Los complementos se cobran aparte. La página de precios enumera proxies residenciales a $3/GB, resolución de CAPTCHA a $1-1.5 por mil y plantillas de pago por resultado a $0.001-3 por mil resultados. Una suscripción de pago no incluye gratuitamente todos los costos avanzados de acceso.
Para recopilar catálogos de proveedores, empieza localmente con una tarea pequeña y valida la cobertura de listas y detalles. Después comprueba cómo procesa la ejecución en la nube la misma entrada, dónde llega la exportación y quién ve los fallos. Saber construir la tarea no sustituye una rutina operativa que compruebe si se obtuvieron los registros esperados.
- El diseño visual de tareas encaja con quien quiere mantener las instrucciones de extracción desde operaciones.
- Las tareas locales gratuitas permiten evaluar un flujo antes de contratar la nube.
- Standard incluye expresamente programación y exportación automática.
- Los límites de tareas y procesos en la nube dejan claro el alcance de la ejecución.
- La ejecución gratuita es local y no cubre el trabajo desatendido en la nube.
- El volumen de exportación de pago no elimina los límites de tareas o concurrencia.
- Los complementos de proxies, CAPTCHA y plantillas pueden sumar cargos por uso.
- La tarifa inicial exige facturación anual.
Elige Octoparse si el diseño visual de tareas aporta una ventaja útil y sus límites de procesos en la nube encajan con la programación. Browse AI es la primera opción más directa para un seguimiento grabado; una API encaja mejor cuando la extracción forma parte de un producto de software.
8. Zyte: el precio del acceso depende del sitio de destino
Zyte es un proveedor de datos web cuya Zyte API cobra las respuestas exitosas según la dificultad del sitio y según pidas contenido HTTP o renderizado con navegador. Encaja con quien desarrolla y mantiene un recolector de datos y quiere gestionar el acceso automáticamente sin contratar una flota de proxies sin más. Un servicio de anuncios puede conservar su conjunto de datos y su procesamiento mientras presupuesta el modo de respuesta que necesita cada destino. El precio mínimo solo resulta útil si también se identifica el compromiso de gasto y el nivel del sitio al que corresponde.
Ideal para: Un recolector mantenido por desarrollo con un presupuesto de acceso específico por destino.
Lo más destacado: Precios por respuesta exitosa con tarifas separadas para HTTP y navegador.
Precio: PAYG HTTP $0.13-$1.27 por 1,000; navegador $1.01-$16.08 por 1,000.
Prueba gratuita: $5 de crédito durante 30 días, sin compromiso; no se anuncia un plan gratuito recurrente.
Los precios PAYG de HTTP para destinos Simple, Easy, Moderate, Complex y Advanced son $0.13, $0.23, $0.44, $0.70 y $1.27 por 1,000 respuestas. Los precios PAYG de navegador son $1.01, $2.01, $4.02, $8.04 y $16.08. Así, un mismo volumen de solicitudes puede dar lugar a facturas muy distintas según el destino y la necesidad de contenido renderizado. Precios de Zyte.
Los compromisos de gasto mensual reducen esas tarifas. Con un compromiso de $100, HTTP figura a $0.10-$0.95 y navegador a $0.75-$12.00 por 1,000. Con $200, los intervalos son $0.08-$0.76 y $0.60-$9.60. Con $500, son $0.06-$0.61 y $0.48-$7.68. Los precios de Enterprise se consultan con ventas. El reclamo «desde $0.06» corresponde a los planes con compromiso de gasto; no es el precio inicial de HTTP en PAYG.
Para un ejemplo de 100,000 respuestas exitosas, la tarifa Simple de HTTP en PAYG produce un cargo por uso de $13. La tarifa Simple de navegador produce $101; la tarifa Advanced de navegador, $1,608. Son cálculos con tarifas publicadas, no una afirmación sobre el nivel que tendrá tu sitio. Las funciones avanzadas pueden añadir cargos, así que utiliza el estimador del proveedor para tu sitio concreto y el modo de salida previsto.
El límite que importa es la rentabilidad de cada destino. No conviene asignar un mismo costo supuesto por página a un destino HTTP de baja complejidad y a otro avanzado que necesita renderizado. Divide la lista de URLs por destino y modo, conserva el recuento de respuestas aceptadas y compara los planes con compromiso de gasto frente a esa combinación.
Acceder con éxito tampoco te exime de definir qué extraer. Tu parser sigue necesitando el identificador correcto del anuncio, los campos y las comprobaciones de integridad. Si una API de registros mantenida o un Actor ya devuelve los datos que necesitas, un precio de acceso inferior puede no justificar mantener la extracción propia.
- Los precios separados de HTTP y navegador permiten presupuestar cada destino con precisión.
- Los cinco niveles de dificultad muestran variaciones que un único precio inicial puede ocultar.
- Los compromisos mensuales ofrecen una escala de tarifas visible.
- La API anuncia renderizado, rotación de IP y geolocalización.
- La tarifa más baja del reclamo exige un compromiso mensual.
- El renderizado con navegador puede cambiar mucho el costo.
- Las funciones avanzadas pueden cobrarse aparte.
- La respuesta sigue necesitando procesamiento y validación según las reglas del negocio.
Elige Zyte si tu flujo de desarrollo necesita acceso gestionado y puedes medir la combinación de destinos. Empieza por la estimación PAYG antes de contratar una suscripción solo para conseguir la cifra más baja de la página.
¿Cuánto cuesta un flujo de scraping web programado?
Cuenta el trabajo que se repite y el formato de salida antes de comparar precios iniciales. Utilicemos este ejemplo de planificación explícito: una persona al frente de un negocio vuelve a visitar 120 páginas conocidas cada día durante un mes de 30 días, lo que supone 3,600 visitas. Se asumen páginas normales, sin acciones adicionales de navegador, llamadas de descubrimiento, cargos de endpoints de seguimiento ni reintentos facturables. Es una hoja de presupuesto, no una carga de trabajo medida ni una garantía de acceso a los destinos.
Con extracción básica a Markdown, esas 3,600 visitas consumen 3,600 créditos tanto en Firecrawl como en Context.dev. Firecrawl Hobby incluye 5,000 créditos por $19/mes y Context.dev Developer incluye 7,500 por $19/mes. Ambas suscripciones mensuales de entrada cubren ese volumen de extracción concreto. Firecrawl, Context.dev.
Si pides JSON estructurado obtenido con éxito de las mismas páginas estándar, la necesidad sube a 18,000 créditos en cada servicio. Firecrawl Hobby necesita 13 bloques adicionales de 1,000 créditos a $5: $19 + $65 = $84/mes. Context.dev Developer, con la tarifa publicada para nuevas suscripciones, necesita 11 bloques adicionales de 1,000 créditos a $2.20: $19 + $24.20 = $43.20/mes. El redondeo a bloques deja algunos créditos sin utilizar en el cálculo de Context.dev.
Un seguimiento sin código exige el mismo cálculo de frecuencia. En Browse AI, 3,600 comprobaciones de páginas estándar al mes se convierten en 43,200 al año, antes de añadir más filas o destinos premium. Los 60,000 créditos anuales de Professional cubren ese volumen ilustrativo; los 12,000 de Personal no. Professional mensual incluye 5,000 créditos por $87, mientras que Professional anual cuesta $69/mes con $828 pagados por adelantado. Browse AI.
Los proxies sin más necesitan otra hoja de cálculo. Empieza por los GB medidos y añade el alojamiento de tu scraper, el trabajo de extracción y la gestión de incidencias. Una API de registros parte de los registros entregados que se pueden facturar. Apify parte del Actor elegido y del uso de recursos. No conviertas ninguna de esas unidades en una promesa por página sin medir la tarea real.
Qué conviene elegir según tu trabajo
La regla de decisión es si necesitas contenido de páginas, seguimiento a cargo de operaciones, registros terminados para un destino concreto o acceso para código que ya mantienes. Pasar a un plan de pago debe resolver el límite con el que estás chocando, no premiar a un proveedor por tener una lista de funciones más larga.
Las mejores herramientas dependen de quién arregla la próxima ejecución
Si desarrollo se ocupa de la función de datos, selecciona APIs que devuelvan el contenido y los metadatos necesarios. Si operaciones se ocupa de un proceso basado en hojas de cálculo, selecciona robots visuales que la persona responsable pueda revisar. Si todavía nadie se hace cargo de los fallos, asigna esa responsabilidad antes de aumentar la frecuencia de extracción.
La herramienta adecuada cambia cuando cambia quién se hace cargo. Para un desarrollador, una API de scraping puede ser el componente correcto de un producto. Esa misma API puede ser una mala compra para alguien de operaciones que necesita un resultado diario y no tiene una aplicación donde recibirlo. A la inversa, una tarea grabada puede ser rápida de evaluar y complicar el trabajo cuando la extracción pasa a ser una función central del producto.
El web scraping con IA necesita un esquema y criterios de aceptación
Trata la extracción como un contrato de datos. Para un registro de precio, define el identificador de producto, la variante, el importe numérico, la moneda, la URL de origen y la hora de extracción. Decide cómo tratar los valores ausentes o ambiguos antes de la primera actualización automática. Un objeto JSON limpio es un formato; un registro de negocio correcto exige comprobar que cumple ese contrato.
Para incorporar documentos, conserva la fuente y la hora de obtención, y excluye la navegación repetida irrelevante cuando corresponda. Guarda la respuesta original cuando una comprobación automática rechace una página. Esa evidencia permite a la persona responsable distinguir entre un cambio del sitio y una definición de campo equivocada.
¿Qué scraper con IA conviene para un agente?
Empieza por Firecrawl para el flujo de scrape, crawl y map orientado a páginas. Añade Context.dev a los candidatos si su combinación de lotes y seguimiento mediante webhooks encaja con la aplicación. Si un Actor de Apify adecuado ya recopila los campos que necesita el destino, evalúa esa ejecución completa junto a las APIs genéricas de páginas.
Elige con un conjunto fijo de fuentes y el mismo resultado esperado. Incluye una página normal, una renderizada, una relación entre lista y detalle, y una página con un campo ambiguo. La cuota inicial es un dato de costo, no una prueba de que un servicio produzca mejores datos.
Web scraping con Python: APIs que puedes programar desde tu aplicación
Un flujo en Python puede llamar a una API y mantener la programación, el procesamiento, el almacenamiento y la validación en su propia aplicación. Elige Firecrawl o Context.dev si quieres contenido de páginas o extracción estructurada gestionada. Elige ScrapingBee o Zyte si quieres conservar el control del procesamiento y reemplazar la obtención de páginas.
Ese control adicional también genera trabajo operativo. Distingue claramente entre un error de transporte, una página de error del destino, un campo ausente y un registro rechazado por las reglas del negocio. No reintentes todas las categorías a ciegas: una regla de extracción incorrecta no mejora por repetir la misma solicitud.
Web scraping gratis: busca una cuota que se renueve
Firecrawl y Context.dev anuncian 1,000 créditos mensuales cada uno. Browse AI ofrece 50 créditos mensuales para 2 dominios. Apify aporta $5/mes de uso y Bright Data Scraper API, 5K registros/mes. Pueden servir para evaluaciones pequeñas o trabajos recurrentes modestos si la operación que necesitas cabe en esa cuota.
Para una página estándar comprobada cada día durante un mes de 30 días, los 50 créditos de Browse AI cubren las 30 comprobaciones. Es un ejemplo útil de seguimiento gratuito, siempre que la página no sea un destino premium y la cantidad de filas extraídas no aumente el cargo. Los 1,000 créditos de ScrapingBee y los $5 de Zyte son pruebas; Octoparse Free se ejecuta localmente. Esas diferencias importan más que la etiqueta «gratis».
Código abierto: cuándo tiene sentido mantener tu propio scraper
El núcleo de Firecrawl, que puede alojarse en infraestructura propia, es una opción cuando el control del código o la infraestructura justifica operar los servicios. El código abierto elimina la suscripción al proveedor para ese núcleo; no aporta alojamiento, seguimiento, recuperación ni una persona de desarrollo que resuelva el siguiente fallo.
Usa la guía para alojar Firecrawl por tu cuenta para evaluar esa responsabilidad operativa antes de considerarlo la forma más barata de hacer scraping. Para un equipo de producto pequeño que solo necesita un endpoint que devuelva páginas conocidas, los planes gestionados de entrada pueden evitar un proyecto de infraestructura aparte. Elige alojamiento propio por una necesidad de control concreta y con alguien capaz de sostenerlo.
Cómo se seleccionaron estas herramientas
La comparación prioriza la adecuación al trabajo, la transparencia de la facturación y el límite que cambia la decisión de compra. Para prepararla se consultaron las páginas de precios y la documentación pertinente de los fabricantes, y las cifras se verificaron el 6 de octubre de 2026. Los ejemplos de costo son cálculos con esas tarifas publicadas y supuestos de carga de trabajo explícitos. No se realizó una prueba práctica de los productos ni se establece una clasificación por velocidad, precisión o tasa de éxito.
Firecrawl, Bright Data, Browse AI y Context.dev son herramientas asociadas a este sitio; Apify, ScrapingBee, Octoparse y Zyte aportan alternativas independientes. Esa relación comercial no convierte los proxies sin más en la compra adecuada para el seguimiento de operaciones, ni un robot grabado en la API apropiada para una función de software. Las recomendaciones siguen esos límites.
Los criterios prácticos son: ¿devuelve el producto el resultado necesario?, ¿quién se ocupa de configurarlo y repararlo?, ¿qué operación repetida se factura?, ¿qué cuota o límite de concurrencia se alcanza primero?, ¿y qué ocurre con una respuesta incompleta o rechazada? Un catálogo más grande o un precio promocional inferior no responden por sí solos a esas preguntas.
Los catálogos de frameworks y bibliotecas de navegador quedaron fuera de la lista comparada porque aquí se busca un servicio recurrente, un flujo sin código o infraestructura de acceso. La operación interactiva de un navegador es otra necesidad cuando el trabajo depende de una navegación extensa y no solo de recopilar páginas.
Revisa los términos del sitio de destino y su robots.txt antes de programar la extracción.
Qué elecciones conviene evitar
Evita una mala combinación entre herramienta y trabajo, aunque el producto sea bueno para otro uso. Estas son las decisiones con más probabilidades de crear las tareas que la compra debía eliminar.
- Octoparse Free para un flujo desatendido en la nube. Sus tareas se ejecutan localmente. Contrata la ejecución en la nube que necesita tu proceso o elige un servicio con el modelo operativo adecuado.
- Proxies residenciales de Bright Data para comprar un conjunto de datos terminado. Aportan acceso; las solicitudes, el procesamiento y la aceptación siguen a tu cargo. Usa una Scraper API adecuada si lo que quieres comprar es el registro.
- El precio anual destacado de Browse AI Personal para un seguimiento grande y frecuente. Los 12,000 créditos anuales no alcanzan para el ejemplo de 43,200 créditos al año. Calcula primero visitas, filas, destinos premium y dominios.
- El reclamo de $0.06 de Zyte como tarifa PAYG. Es el extremo inferior del nivel con compromiso de $500. Estima el destino y el modo reales antes de asumir ese compromiso.
- El total de créditos de ScrapingBee como garantía de solicitudes. El renderizado y la configuración de proxies pueden consumir varios créditos en una misma solicitud. Presupuesta la configuración que funciona.
- Firecrawl o Context.dev como sistema completo de calidad de datos. Ambos pueden entregar contenido que debas rechazar. Guarda el estado y la evidencia del resultado, y protege los registros posteriores de actualizaciones incompletas.
El producto que conviene evitar es el que te deja manteniendo la capa que esperabas delegar. Definir ese límite con precisión vale más que una clasificación general presentada con seguridad.
Qué hacer el lunes
Haz una evaluación pequeña y programada con una persona responsable. Selecciona diez URLs representativas, define los campos o el contenido documental que esperas y establece qué hará inaceptable una respuesta. Para una tarea sin código, graba el flujo; para una API, conéctala a tu programador y a tu almacenamiento.
Ejecuta la tarea una vez al día durante siete días. Conserva la respuesta original, el estado del destino, el resultado, las unidades de facturación consumidas y el número de registros aceptados. Revisa la paginación, los valores ausentes, los identificadores duplicados y los cambios que deben o no provocar una actualización.
Después calcula el costo del mes completo con esa combinación de destinos observada. Elige la opción menos compleja que cumpla los requisitos de resultado y responsabilidad, y mantén las comprobaciones de aceptación después de la prueba. Un flujo merece pasar a producción cuando entrega resultados útiles de forma repetible, no por su primera solicitud exitosa.
¿Qué herramientas de web scraping conviene evaluar?
Firecrawl y Context.dev encajan con contenido de páginas para agentes; Browse AI y Octoparse, con flujos de extracción visual; Bright Data, Zyte y ScrapingBee, con distintas necesidades de acceso y obtención de páginas. Apify resulta especialmente útil cuando ya existe el Actor adecuado para el destino. Define primero el resultado y quién se hará cargo, y después compara la factura mensual completa.
¿Puede ChatGPT extraer datos de sitios web?
ChatGPT puede abrir sitios web y recopilar información mediante su función de navegador, tal como explica la documentación oficial de OpenAI. Eso puede servir para una tarea de recopilación interactiva. Para precios, anuncios o documentos de agentes que deban obtenerse de forma recurrente, evalúa por separado la programación, el esquema de salida, los resultados guardados y quién responde por los fallos. Aquí se trata de elegir el servicio que aporta ese flujo recurrente, no solo de saber si un asistente de IA puede leer una página.
¿Qué IA es mejor para hacer web scraping?
Elige el servicio de extracción y el resultado esperado antes de seleccionar un modelo de lenguaje. Firecrawl y Context.dev merecen evaluarse para Markdown o campos estructurados; Browse AI encaja con un robot gestionado desde operaciones. La mejor opción es la que devuelve la información necesaria de tus fuentes representativas con un costo total aceptable.
¿El web scraping ha quedado obsoleto?
Comprueba primero si el sitio de destino ofrece una API o un flujo de datos adecuado. Si la información necesaria solo se publica como páginas, la extracción sigue siendo una opción. La diferencia útil al comprar es quién se ocupa de obtener, extraer, programar y validar los datos, más allá de que el producto se presente como IA.
¿Cuáles son las 10 mejores herramientas de web scraping?
Esta selección incluye ocho productos para tres trabajos recurrentes: datos para agentes, seguimiento sin código y acceso a escala. Elige dentro de esos usos en lugar de añadir herramientas solo para llegar a diez. Un proyecto de automatización de navegador o un framework alojado por tu cuenta plantea una responsabilidad operativa distinta de la de los servicios comparados aquí.
Consigue la AI Business Workflow Audit Checklist a través del boletín y define el resultado, la programación, las reglas de aceptación y la persona responsable antes de comprometerte con un flujo de datos web.
- Última actualización
- 6 oct 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Memoria de agentes de IA (AI agent memory): usos y costos
Aprende qué debe conservar un agente de IA: contexto, sesiones, memoria persistente y archivos. Compara costos y evita datos obsoletos o cruces entre usuarios.5 oct 2026Build
Pinecone pricing: planes y costos de 1M a 100M de vectores
Precios de Pinecone verificados en octubre de 2026: Starter gratis, Builder a $20, mínimos de pago y costos de 1M a 100M de vectores según las consultas.5 oct 2026Build
Lovable gratis y alternativas: precios, límites y cómo elegir
Compara Lovable gratis y sus alternativas por créditos, backend y exportación. Revisa precios, límites y qué implica migrar una app que ya funciona.5 oct 2026Build
LLM observability en 2026: qué herramienta conviene a tu equipo y cuánto cuesta
Compara Langfuse, LangSmith, Helicone, Phoenix, Braintrust y Datadog por tamaño de equipo, costos para 100,000 ejecuciones mensuales y opciones de alojamiento.5 oct 2026Build
OpenCode: tu agente de IA para programar, paso a paso
Aprende a usar OpenCode: instala el agente, conecta tus modelos, configura AGENTS.md y plugins, revisa los cambios y entiende los costos de API y Zen.4 oct 2026Build
Netlify gratis y de pago: planes, créditos y costos en 2026
Compara Netlify gratis, Personal y Pro: precios en USD, consumo de créditos y presupuestos mensuales para un sitio, una app Next.js o una agencia.4 oct 2026Build
Softr: opiniones, precios y límites para elegir bien
Descubre si Softr encaja con tu portal de clientes o herramienta interna: precios, permisos, límites de usuarios y registros, funciones de IA y alternativas.4 oct 2026Build