スクレイピングツール8選:用途と実際の月額費用で選ぶ【2026年版】
スクレイピングツールは、AI向けのページ取得、ノーコードでの変更監視、大規模収集のどこを任せたいかで選びます。Firecrawl、Browse AI、Bright Data、Context.devなど8製品の料金と無料枠、JSON抽出の追加費用、実行上限を比較。運用担当と出力形式に合う選び方がわかります。




スクレイピングで何を任せたいかによって、選ぶツールは変わります。AIエージェントが読める整ったページを取得するならFirecrawl、運用担当者が自分で管理する変更監視ならBrowse AI、対象サイトへのアクセスが収集の障害になっているならBright Dataが最初の候補です。FirecrawlとContext.devはいずれも月払いで$19/月から利用できますが、構造化JSONを求めると必要なクレジット数が変わります。サービスを選ぶ前に、出力形式、実行スケジュール、失敗した処理を直す担当者を決めておきましょう。
スクレイピングツールの料金・用途・無料枠を比較
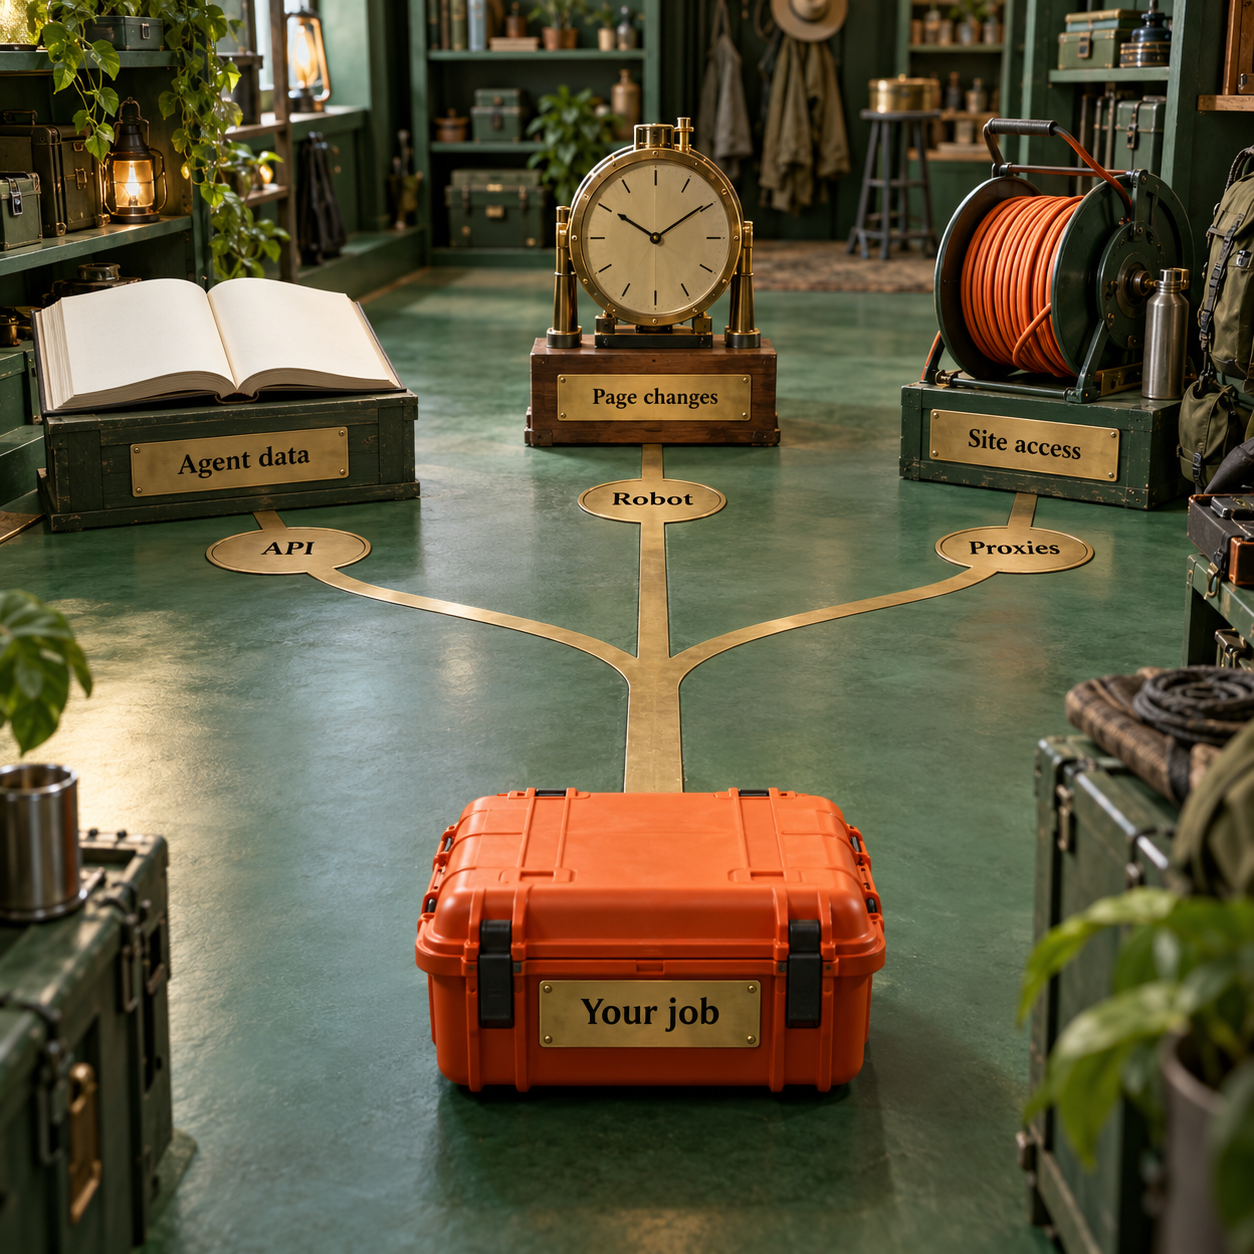
ワークフローに足りない機能を買う、という視点で選びます。 スクレイピングAPIは、ソフトウェアから呼び出してページのデータを取得するサービスです。エージェントやデータセットを作る開発者に向いています。繰り返し実行する収集作業を運用担当者が管理するなら、ノーコードのロボットが適しています。別のIPアドレスを経由して通信するプロキシネットワークは、既存のスクレイパーから対象サイトへのアクセスを改善したい場合の選択肢です。
以下の料金と利用枠は、2026年10月6日に各社の公開ページで確認したものです。年払いの料金はその旨を示し、無料トライアルと定期的に補充される無料枠を区別しています。「有料プランの開始料金」は最初の有料プラン、「無料枠」は有料契約なしで試せる範囲です。
この表は候補を絞るためのものです。納品されたレコード、取得したページ、通信量のGBを同じ単位として比較することはできません。Bright Dataのプロキシ用クーポンRESIGB50は、3か月間50%割引という案内です。一時的な料金は試用時の予算に使い、継続利用の見積もりには通常料金を使います。
出力を決めてから、運用の担当者を決める
ここには性質の異なる3つの購入判断があり、目的が変われば適したツールも変わります。 アシスタントにドキュメントを読み込ませたい創業者、競合の価格を追いたい運用担当者、大規模な掲載情報データセットを更新したい開発者では、比較を始める場所が違います。
用途その1:エージェントが使える形でページを取り込む
アプリケーション内でページ本文や構造化フィールドを使いたいなら、**FirecrawlまたはContext.dev**から検討します。Markdownは見出しやリンクを残した読みやすいテキストで、AIエージェントに文書を渡す用途に向いています。JSONは商品、価格、通貨、在庫状況などの名前付きフィールドでデータを表します。検証や比較ができるレコードをワークフローに渡したい場合に適しています。
出力形式の違いは、品質にも費用にも影響します。サポート用アシスタントなら、整ったドキュメントページがあれば機能することがよくあります。価格アラートには、価格フィールドだけでなく、通貨、正しい商品バリエーション、取得時刻が必要です。複数の価格があるページをモデルに渡しても、業務上どの価格を使うべきかまでは決まりません。
ページを取得するscrape、サイト内のリンクをたどって複数ページを取得するcrawl、URLを見つけるmapも分けて考えます。信頼できるURLリストをすでに管理しているなら、毎回URLを探し直してもデータの配信は改善せず、作業だけが増えることがあります。ドキュメントが増え続けるサイトでは、URLの発見も必要な処理です。
用途その2:コードを管理せずに、決まったページの変化を追う
操作を記録して抽出タスクを作り、運用担当者が変更監視まで管理するなら、**Browse AIを選びます。画面上でタスクを設計し、有料のクラウド抽出環境を使う方が合っているなら、Octoparse**が候補です。ここでいうロボットは、操作手順と抽出指示を保存したものです。従業員の仕事全般を置き換えるものではありません。
たとえば業務責任者が、仕入先の商品一覧から商品名、価格、在庫状況を毎朝取得するケースです。役に立つ成果物は、列の構成が安定したスプレッドシートと、項目が消えたときにわかる例外通知です。サイトが変わった際、担当者自身がタスクを確認し、調整できる必要があります。
実行頻度を選ぶ前に、何を変更とみなすかを決めます。フッターの変更は在庫状況に関係ありません。一覧の並び順が変わっただけで、すべての商品が入れ替わったと判定するのも困ります。変わらない識別子を保持し、必要なフィールドだけを比較します。欠損データは確認に回し、前日の有効な値を黙って上書きしないようにします。
用途その3:サイトへのアクセスが課題になる大規模収集
スケジュールとデータセットは自分のソフトウェアで管理できていて、対象ページの取得が難しくなっているなら、**Bright Data、Zyte、ScrapingBee**が候補です。アクセス制限に対応するサービスは、リトライやプロキシの選択などを管理します。データセットの意味まで自動で決めるわけではありません。
Bright Dataにはサイト別のScraper APIもあり、通信経路だけでなく、より完成したレコードを購入できます。Apifyも有力な選択肢です。必要な抽出処理を実装し、保守されている対象サイト向けのActorが、すでに存在する場合があります。Actorは、設定して実行できる再利用可能なクラウドプログラムです。
どこまで自分で管理するかによって、選択は変わります。抽出ロジックの保守も任せたいなら、Scraper APIやActorを評価します。自分の解析ロジックを維持したいなら、ページ取得APIやプロキシサービスを評価します。完成したデータセットが欲しいのに、通信経路だけを買うと費用と期待がかみ合いません。
8製品の得意分野と、導入前に確認したい制約
各ツールには、継続的な業務の中で得意とする役割があります。 番号は候補を探しやすくするためのものです。同じ用途の中でどれが適しているかは、各節で説明する出力、上限、運用体制によって決まります。
1. Firecrawl:エージェント用のページ取得で最初に試す候補
Firecrawlは、Webサイトを使いやすいページコンテンツに変換するスクレイピングAPIです。ドキュメントを参照するエージェントを作る際、最初に評価したい選択肢です。Scrape、Crawl、Mapはそれぞれページ取得、サイト内の巡回、URLの発見を担い、違う処理として使い分けられます。サポート用アシスタントを作る創業者なら、ドキュメントのURLを洗い出し、必要なパスを選び、そのページをクロールしてMarkdownにできます。整ったページ本文が欲しいときに選び、主な目的が運用担当者によるスプレッドシート監視なら、別の選択肢を検討します。
向いている人: ドキュメント、記事、参考ページをAIエージェントに渡す開発者です。
特徴: scrape、crawl、mapを別々に使え、Markdownと構造化抽出に対応しています。
料金: Hobbyは$19/月、年払いでは$16/月。月間5,000クレジットです。
無料利用: 毎月1,000クレジットが付くFreeプランがあり、カード登録は不要です。
基本的なスクレイピングやクロールは、ページあたり1クレジットです。JSON抽出には4クレジットが追加されるため、標準的なページ取得+JSONのリクエストは5クレジットになります。Hobbyの残高をその処理だけに使うなら、基本取得は5,000ページ、標準的なJSON取得は1,000ページです。同じ契約でも、何を返すように指定するかで利用できる量が大きく変わります。Firecrawlの料金詳細で確認できます。
月払いのプランは、Freeが$0、Hobbyが$19で5,000クレジット、Standardが$99で100,000、Growthが$399で500,000、Scaleが$749で1,000,000です。Enterpriseは個別見積もりです。年払いの月額換算は順に$16、$83、$333、$599/月で、年間請求額は$190、$990、$3,990、$7,190です。端数処理も含め、ここでは提供元の表示どおりの数値を掲載しています。Firecrawlの全プランを参照してください。
最初に注意したいのは、指定するクロール件数です。Firecrawlのクロールドキュメントによると、デフォルトの上限は10,000ページで、指定した上限を残りクレジットで賄えない場合、ジョブが拒否されることがあります。そのため、小さなサイトをHobbyで取得するときでも、最初のページに到達する前にlimitを明示して小さくする必要が生じます。次の制約は同時実行数です。Hobbyは5、Standardは25、Growthは50、Scaleは100リクエストまでです。クレジットを増やしても、現在のプランの同時実行上限は変わりません。クロールの挙動も確認しておきます。
結果を受け入れてよいかの確認も必要です。Firecrawlによると、結果が返らない取得は課金されませんが、対象サイトの403や404といったエラーページが返った場合は1クレジットを消費します。ナレッジベースへ入れる前に、対象サイトのステータスと返された内容を確認します。きれいなMarkdownになっていても、エラーページはエラーページのままです。
- Scrape、Crawl、Mapにより、URLの発見とページ取得を分けて判断できます。
- 文書の取り込みにはMarkdown、定義済みフィールドへの抽出にはJSONが向いています。
- 継続的な無料枠で、小規模な定期処理を評価できます。
- プランを変更する前に、有料のクレジット追加で利用量を増やせます。
- 構造化抽出を使うと、基本取得に比べて処理できるページ数が大きく減ります。
- デフォルトのクロール上限が大きく、少額プランの残高を超える場合があります。
- 返されたエラーページにも課金されることがあり、自分で検証する必要があります。
- Hobby、Standard、Growthのクレジットは、通常は繰り越せません。
収集する前に、対象URLを洗い出す
MapのプレイグラウンドでドキュメントのURLを見つけます。アシスタントが実際に答える質問に関係するパスを残します。Mapはアドレスを探す処理であり、そのページの取得は別の処理です。
必要を満たす、最も安い出力を選ぶ
ドキュメントを参照するアシスタントなら、まずMarkdownを使います。後続のワークフローに名前付きフィールドが必要なら、JSONスキーマを使います。スキーマが明確だと判断する前に、通常価格と割引価格の両方が載る代表的な商品ページで確かめます。
予算内に収まるクロール上限を指定する
例に使う120ページの収集対象なら、
limitを120と明示します。無関係なブログやアカウントページで残高を使い切らないよう、パスのフィルタリングを適用します。結果と、採用判断に使う情報を保存する
取得元URL、収集時刻、対象サイトのステータス、コンテンツを自分のストレージに保存します。Firecrawlのドキュメントでは、完了したクロール結果をAPIで取得できるのは24時間です。取得レスポンスだけを唯一の保存先にしないようにします。
次回の実行条件まで決める
アプリケーションのスケジューラで、採用した収集対象を再訪します。URLの発見、抽出、監視の費用は予算上も分け、期待する内容が返らなくなったときに誰へ例外を通知するかを決めます。
既存のFirecrawl環境を置き換える必要があるなら、Firecrawl代替サービスの比較で移行と採用基準を詳しく確認できます。提供元を切り替える判断と、用途を文書取り込みからノーコード監視へ変える判断は、分けて考えます。
2. Browse AI:運用担当者が管理する監視に向いている
Browse AIは、操作を記録して再利用可能なロボットを作る、ノーコードのスクレイピング・監視プラットフォームです。決まったサイト群の商品価格、求人、ディレクトリ掲載情報を追う運用担当者に向いています。抽出する項目を記録し、結果をスプレッドシートや接続先のワークフローへ送れます。実用上の制約は、ページ数、抽出行数、監視ドメイン数の組み合わせです。「ロボット数無制限」を、データ量も無制限と読まないようにします。
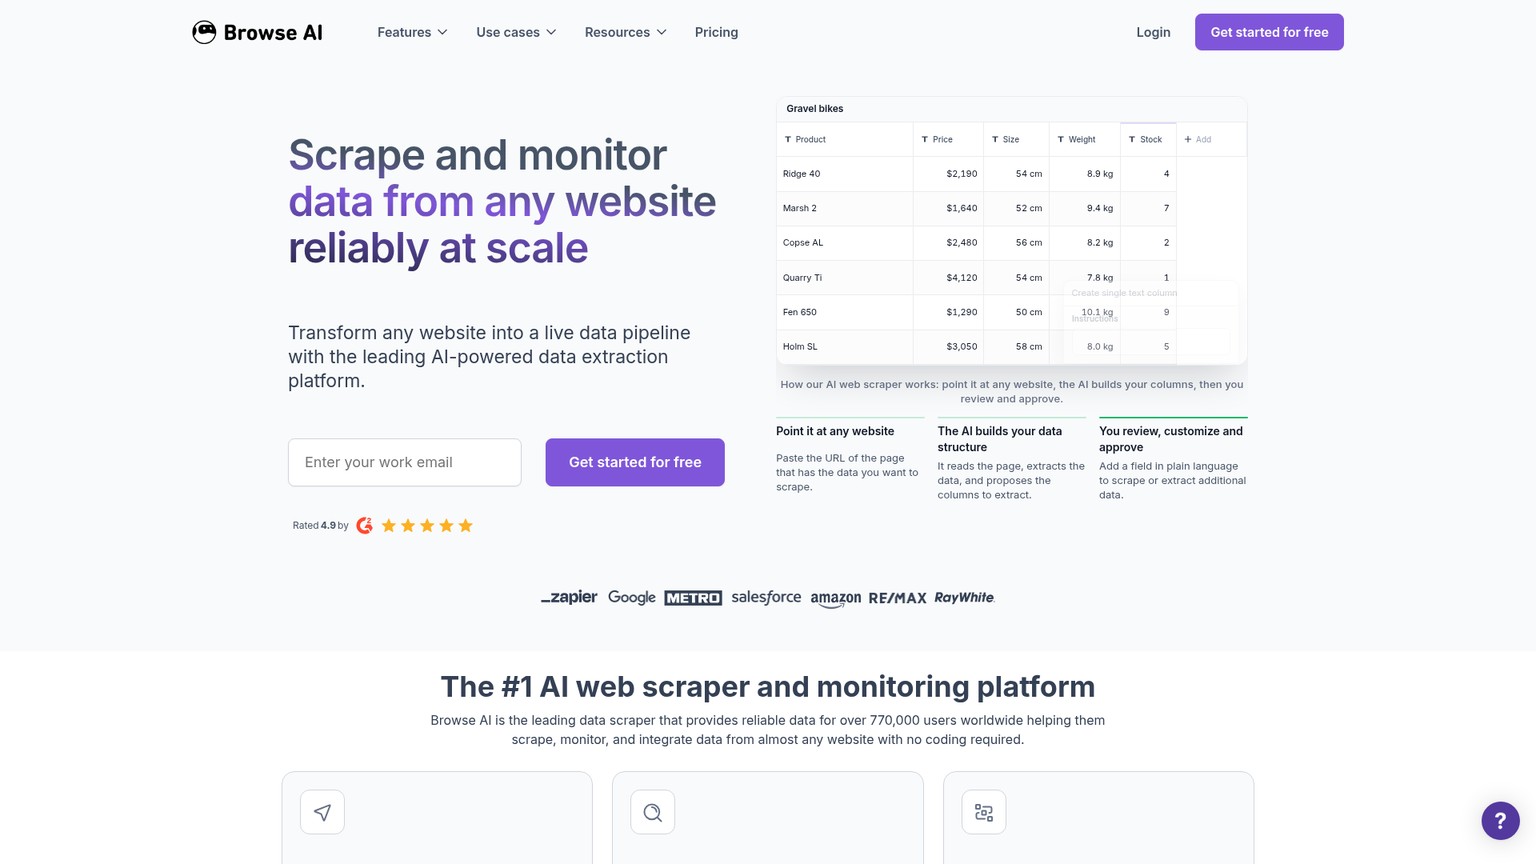
向いている人: スクレイパーのコードを管理せず、定期抽出と変更監視を行いたい運用担当者です。
特徴: 操作を記録するロボット、定期監視、スプレッドシートやワークフローとの連携です。
料金: Personalは年払いで$19/月、$228を一括払い。年間12,000クレジットです。
無料利用: Freeプランは月間50クレジット、2ドメインで、ロボット数は無制限です。
Browse AIの課金は、標準ページの訪問1回につき1クレジット、または抽出10行につき1クレジットで計算し、多い方を適用します。50商品が載る一覧ページは5クレジットです。標準ページという前提で、全50件の詳細ページも訪問すると、さらに50クレジットかかります。「商品一覧1ページ」でも、詳細の取得まで必要なら55クレジットの収集になります。プレミアムサイトは費用が増える場合があるので、タスクに表示される課金額を確認します。Browse AIの料金とクレジット計算例を参照してください。
公開されている年払いのプランは、Freeが$0、Personalが$19/月で年間12,000クレジット、Professionalが$69/月で年間60,000クレジット、Premiumが年払いで$500/月からです。Personalには5ドメインと3ユーザー、Professionalには10ドメインと10ユーザーが含まれます。年間クレジットは契約時にまとめて付与されます。Premiumでは、設定、保守、データ変換を任せるマネージドサービスが加わります。
月払いの選択肢は、Personalが**$48/月で月間2,000クレジット**、Professionalが**$87/月で月間5,000クレジット**です。年払いのPersonal $19は、単に支払日が違う同じ利用枠ではありません。支払い周期と、実際の割当量を両方比較します。年払いのProfessionalは$828、Personalは$228の一括払いです。
クレジットより先に、ドメイン数の上限に達することもあります。多数の仕入先サイトから少数の項目を取得する処理では、データ量が少なくてもドメイン追加が必要になる場合があります。年払い時の追加ドメインは、Personalが$4/月、Professionalが$2.40/月です。年払いプランではクレジットを追加購入でき、最小購入量は1,000クレジットです。Personalは$0.024/クレジット、Professionalは$0.017-$0.013/クレジットと表示されています。
仕入先価格のワークフローでは、値と一緒に商品識別子と通貨を保存します。ロボットが数字を抽出できても、セール価格、会員価格、別の入り数の価格を仕入れ記録に採用すべきかは決められません。その判断を担うのは、比較ルールと確認待ちの仕組みです。
- 記録されたタスクを見て、運用担当者が抽出指示を確認できます。
- 各プランで監視、APIアクセス、Webhookが案内されています。
- Google Sheets、Airtable、Zapier、Makeとの連携で、よく使う業務フローに接続できます。
- ドメイン追加と年間クレジットの追加購入で、利用範囲を広げられます。
- 行数の多い一覧と詳細ページの訪問を組み合わせると、課金量が積み上がります。
- クレジットが残っていても、ドメイン上限によって追加購入が必要になる場合があります。
- 最安の年払いプランと月払いのPersonalでは、割当量が異なります。
- サイト変更や曖昧なフィールドには、結果を確認する担当者が必要です。
データセットの責任者がロボットも調整できるべきなら、Browse AIを選びます。抽出がプロダクト内の機能で、開発チームがスケジュール、スキーマ、障害対応をすでに管理しているなら、APIを選びます。
3. Bright Data:価格比較の前に、買う製品を決める
Bright Dataは、プロキシネットワーク、構築済みのScraper API、Web Unlockerを提供するWebデータサービスです。対象サイトへのアクセスや収集規模が制約になっている場合に、検討したい候補です。EC分野の開発者なら、商品レコードを返すサイト別スクレイパーを購入する場合があります。一方、既存の独自スクレイパーには住宅用プロキシが必要かもしれません。両者は担う処理の範囲も、課金単位も違います。
向いている用途: 対象サイトへのアクセス、地域、または保守されたサイト別スクレイパーが重要な収集です。
特徴: プロキシ、アクセス制限への対応、構造化レコードの取得を、それぞれ別の製品として選べます。
料金: Web Scraper APIのPAYGは$1.5/1Kレコード。住宅用プロキシのPAYGは、期間限定クーポン適用前で$8/GBです。
無料利用: Scraper APIは月間5Kレコードが無料です。住宅用プロキシのトライアルは別枠です。
欲しい成果物がレコードなら、Scraper APIを使います。 サイト別APIが構造化データを返し、プロキシ、アクセス制限への対応、解析、実行環境、ストレージ、送信通信料が含まれると案内されています。料金は、Free Tierが月間5Kレコード、PAYGが$1.5/1Kレコード、Scaleが$499/月で384,000レコードを含み、超過分が$1.3/1Kレコードです。Enterpriseは個別見積もりです。必要な項目がすべて含まれると決めつけず、対象スクレイパーの入力・出力スキーマを確認します。Web Scraper APIの料金を参照してください。
自分のコードにアクセス処理を組み込みたいなら、Web Unlockerを使います。 公開ページには、自動プロキシ管理、リトライ、IPローテーション、CAPTCHA解決が記載されています。Free Tierは月間5Kリクエスト、PAYGは$1.5/1Kリクエストです。表示されているScaleは$499/月で383Kリクエスト、超過分は$1.3/1Kです。Enterpriseは個別見積もりです。Bright Dataは、Web Unlockerが画面遷移やクリックでワークフローを進める対話型ブラウザではないと明記しています。Web Unlockerの料金と制約を確認します。
スクレイパー自体を維持したいなら、住宅用プロキシを使います。 詳細なPAYG料金欄は$8/GBで、3か月間のRESIGB50キャンペーンを適用すると$4/GBです。表示されているキャンペーン価格の月額パッケージは、$499で141 GB、$999で332 GB、$1,999で798 GBです。1 TBを超える場合は個別見積もりが案内されています。通信量には、データベースに残す最終レコードだけでなく、対象サイトとの送受信が含まれます。住宅用プロキシの料金を参照してください。
この通信量の違いが予算を左右します。画像やその他のページリソースをダウンロードすると、有用なレコードが増えなくても通信量を消費します。レコードAPIは、案内されているレコード単価にこうしたアクセス費用を含みます。プロキシだけを使う場合、リクエスト、解析、品質確認は自分の担当です。実際のワークフローを測るまで、GB単価から採用できる掲載情報1件あたりの費用はわかりません。
主な落とし穴は、任せたい処理の範囲と、買う製品がずれることです。IP経由のアクセスが改善しても、間違ったフィールドを選ぶパーサーは直りません。保守されたレコード取得用スクレイパーが、現在の独自抽出とまったく同じ動作を保つとも限りません。同じ会社の価格だからと比較する前に、必要なデータの仕様を定義します。
- サイト別のScraper APIにより、独自の抽出処理を減らせます。
- レコード、リクエスト、通信量の各製品から、開発チームが必要な処理を選べます。
- Scraper APIの価格には、公開ページに記載されたアクセスと解析の費用が含まれます。
- 継続的な無料API枠で、対応する対象サイトを評価できます。
- 製品の種類が多いため、何を買うかを明確にする必要があります。
- 住宅用プロキシはGB課金であり、有効なレコードが得られる保証ではありません。
- 宣伝されているプロキシの割引料金は期間限定です。
- Web Unlockerは、対話型のブラウザ操作を伴うワークフローの代わりにはなりません。
不足しているのがアクセス基盤、または用途に合う保守済みスクレイパーなら、Bright Dataが選択肢です。運用担当者が管理する小規模な監視ならBrowse AIがより直接的な出発点で、ドキュメントの取り込みならページを返すAPIから検討します。
4. Context.dev:ページ取得と監視を同じAPIにまとめる
Context.devはWebコンテキストAPIで、公式サイトにはスクレイピング、URLマッピング、クロール、バッチ、出典付きの回答、監視が案内されています。エージェント用のページと定期更新を、アプリケーション内で受け取りたい開発者に向いています。ドキュメントを参照するアシスタントなら、最初にソースを取り込み、その後はWebhookで監視の更新を受け取れます。Webhookは、イベントの発生時にアプリケーションへ送られるHTTPメッセージです。この用途ではFirecrawlと並ぶ候補になります。ブランド情報の補完は追加の製品領域であり、スクレイピング用途で選ぶ理由とは別です。
向いている用途: ページ抽出とWebhookによるソース監視を組み合わせるエージェントやプロダクトです。
特徴: Scrape、Map、Crawl、Batches、Monitorsを同じAPIで利用できます。
料金: Developerは$19/月で、月間7,500クレジットです。
無料利用: Free Tierは月間1,000クレジット、カード登録不要で、10件のモニターを含みます。
公式サイトでは、Markdown、HTML、スクリーンショット、構造化フィールドが案内され、基本取得にレンダリングとプロキシが含まれています。モニターはページを定期的に確認し、更新をWebhookへ送ります。これは開発者向けの連携です。アプリケーション側で更新を受信し、検証し、後続のデータをどう変えるかを判断する必要があります。運用担当者に、操作を記録したスプレッドシート用ロボットを渡す場合とは管理の形が違います。Context.devの製品説明を参照してください。
月額プランは、Free Tierが$0で1,000クレジット、Developerが$19で7,500、Proが$99で125,000、Growthが$299で500,000、Scaleが$499で1,000,000です。Enterpriseは個別見積もりで、月間2,000,000+クレジットと案内されています。主要な同時リクエスト数の上限は、Freeの1から、Developerの10、Proの100、Growthの250、Scaleの500へ増えます。Context.devの料金で確認できます。
標準的な取得は1クレジットです。成功したJSON抽出は4を追加し、標準ページあたり5クレジットになります。ブラウザ操作を使うと、抽出を加える前の基本取得が2クレジットになります。レンダリングとプロキシが基本料金に含まれていても、すべてのリクエストが1クレジットになるわけではありません。Developerの7,500クレジットを標準的なJSON取得だけに使うなら、1,500ページです。
新規契約の有料クレジット追加料金は、1,000クレジットあたりDeveloperが$2.20、Proが$1.80、Growthが$1.40、Scaleが$1.00です。1,000クレジット単位で課金されます。既存契約は従来の料金を維持します。含まれる残高がなくなったという理由だけで上位プランに移らず、小さなプランに追加購入を組み合わせた場合と比較できます。
クロールで確認したい上限は、Crawlの1回の呼び出しで500ページです。より大きなサイトには、クロールモードのBatchesを使います。取り込み処理をそれに合わせて分割し、バッチを完了扱いにする前に、結果が自分のストレージへ届いていることを確認します。収集用エンドポイントと、データを保持するナレッジベースは、別の構成要素です。
もうひとつの制約は、一部だけ成功した出力です。Context.devによると、失敗したリクエストの大半は課金されませんが、ページが見つからないレスポンスは課金されます。また、同じレスポンス内に、成功した出力と失敗した出力が含まれる場合があります。レスポンス全体が成功扱いでも完全なレコードとは限らないため、各出力とkey_metadata.credits_consumedを確認します。
- ページ本文と定期的なWebhook監視を、同じエージェント用データフローに組み込めます。
- レンダリングとプロキシが基本取得の料金に含まれます。
- 継続的な無料プランには、少数のモニター枠も含まれます。
- 追加クレジットの単価と単位が公開され、小規模な処理の予算を具体的に計算できます。
- JSON抽出とブラウザ操作は、クレジット消費を増やします。
- Crawlの呼び出しには上限があり、大きなソースにはBatchesが必要です。
- Webhookで届いた後も、アプリケーションの処理と保存先が必要です。
- 部分的な出力の採用可否と、ページが見つからない場合の課金に注意が必要です。
API機能の組み合わせとクレジット予算がエージェントに合うなら、Context.devを選びます。Firecrawlとの比較は、同じ代表的なソースと出力スキーマで行います。開始プランの割当量が多いことを、根拠のない品質の優劣に置き換えないようにします。
5. Apify:必要なActorがすでにあるなら有力
Apifyは、Actorと呼ばれる再利用可能なスクレイピング・自動化プログラムのクラウドプラットフォームです。対象に合う保守済みActorがすでにあるなら、有力な選択肢になります。汎用のページ取得エンドポイントより、抽出ロジックそのものに価値がある場合があるためです。企業ディレクトリのデータセットを更新する運用担当者なら、Actorの入力を設定し、タスクとして保存して、繰り返し実行できます。確認すべき制約は、プラットフォームの契約だけでなく、選んだActorの挙動と課金です。
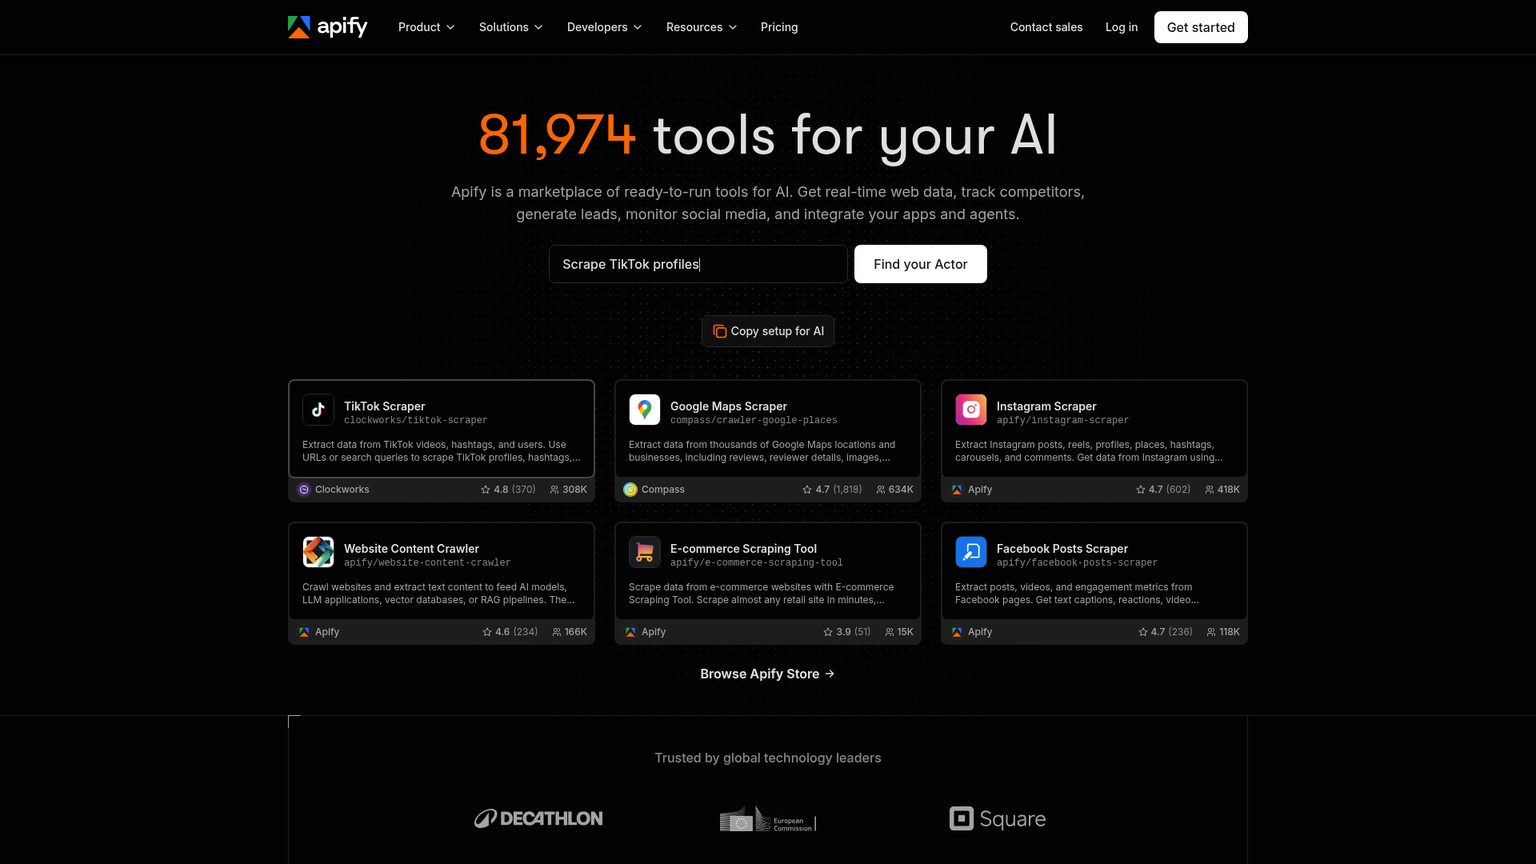
向いている用途: 必要なサイトや抽出処理に対応する適切なActorが、すでにある場合です。
特徴: 再利用可能なクラウドプログラムに、タスクの定期実行と外部連携を組み合わせられます。
料金: Starterは$19/月+従量課金で、利用料$19分を含みます。
無料利用: Freeプランは利用料$5/月分を含み、カード登録は不要です。
ApifyのFreeプランは$0で、Storeまたはプラットフォーム利用に使える$5分が付きます。Starterは$19/月+従量課金で$19分、Scaleは$199で$199分、Businessは$999で$999分を含みます。Enterpriseは個別見積もりです。計算資源の料金は、コンピュートユニットあたりFreeとStarterが$0.2、Scaleが$0.16、Businessが$0.13です。コンピュートユニットとは、RAMを1 GB、1時間使った量です。Apifyの料金を参照してください。
含まれるドル建て残高を、固定のページ枠と考えないようにします。選んだActorに固有の料金がある場合に加え、プラットフォームのリソース、プロキシ、ストレージ、転送量も処理内容に応じて費用に影響します。比較すべきなのは、マーケットプレイスに表示される魅力的な開始価格ではなく、採用できるレコードが返る実行全体の費用です。
計算資源だけを使う仮定の例として、RAM 1 GBを10時間使うと10コンピュートユニットです。Starterでは計算資源の利用料が$2になります。この例から、取得できる掲載情報の件数や追加料金はわかりません。「$19で95コンピュートユニットを使える」という計算も、すべての残高を計算資源に使う前提です。実際のスクレイピング処理では、その前提が成り立たないことがあります。
Apifyのスケジュール機能は、タイムゾーンを指定して保存済みタスクを実行し、Webhook通知を送れます。ドキュメントによると、新規スケジュールはデフォルトで無効です。スケジュールを保存しただけでは、次の処理が動く証拠にはなりません。有効になっているかと、表示される次回実行日時を確認します。Apifyのスケジュールドキュメントを参照してください。
ディレクトリの例では、契約前にページネーション、地域の網羅範囲、出力の識別子、Actorの保守履歴を確認します。カテゴリ一覧を集めるActorが、各企業に対してCRMで必要な全項目を補完してくれるとは限りません。採用したレコードと却下したレコードのサンプルを残し、欠損項目が見えるようにします。
- 適切なActorがあれば、対象サイト固有の抽出ロジックを利用できます。
- 保存したタスクとスケジュールで、定期収集を行えます。
- マーケットプレイスには、ページ本文をクロールするワークフローもあります。
- 含まれる利用料枠で、小さな処理の実行全体を評価できます。
- Apify全体に共通するページ単価やレコード単価はありません。
- Actor固有の料金が、プラットフォームのプランより重要になることがあります。
- タスクの入力と出力は、自分のデータセット仕様に照らして検証する必要があります。
- 新規スケジュールは、有効にしてから運用に使う必要があります。
Actorが相応の抽出作業を減らし、実行全体の費用を許容できるなら、Apifyを選びます。主な用途が「決まったページを取得する」ことで、マーケットプレイスが作業を減らさず複雑さだけを増やすなら、直接呼び出せるスクレイピングAPIを使います。
6. ScrapingBee:ページ取得を任せ、設定ごとのクレジット倍率で予算を組む
ScrapingBeeは、開発者が管理する抽出ワークフローに対し、レンダリングとプロキシの選択肢を提供するスクレイピングAPIです。解析とスケジュールのコードは維持しつつ、難しいページ取得の処理を任せたいエンジニアに向いています。たとえば商品データサービスなら、レンダリング済みのページをリクエストし、返された内容に既存のフィールド抽出ルールを適用できます。最初に予算へ織り込むべき制約は、対象サイトで実際に動く設定のクレジット消費量です。
向いている人: 独自の抽出ロジックを残し、ページ取得の部分だけを置き換える開発者です。
特徴: レンダリングとプロキシを制御でき、Auto-Modeでクレジット消費の上限を設定できます。
料金: Freelanceは$49/月で、250,000 APIクレジットです。
無料利用: カード登録不要の1,000 APIクレジットです。継続的な無料プランの案内はありません。
公開されているプランは、Freelanceが$49/月で250,000クレジット、Startupが$99で1,000,000、Businessが$249で3,000,000、Business +が$599で8,000,000です。Enterprise 14は$999で14,000,000、Enterprise 24は$1,599で24,000,000、Enterprise 41は$2,399で41,000,000、Enterprise 69は$3,599で69,000,000です。それを超える容量は提供元との相談になります。価格にはVATが含まれません。ScrapingBeeの料金を参照してください。
これらはリクエスト数ではなく、クレジット数です。ドキュメントに記載された取得費用は、JavaScriptなしのclassicプロキシが1クレジット、JavaScriptありが5、JavaScriptなしのpremiumプロキシが10、JavaScriptありが25、JavaScriptありのstealthプロキシが75です。AI抽出は、さらに5クレジット追加されます。デフォルトではJavaScriptレンダリングが有効です。ScrapingBeeのリクエスト費用で確認できます。
したがって、Freelanceの250,000クレジットを単一の設定だけに使うなら、JavaScriptありのclassicリクエストは最大50,000回、premiumは10,000回、stealthは完全なリクエストで3,333回です。これは利用枠から計算した回数であり、測定した成功率ではありません。追加機能や対象サイトの組み合わせによって変わります。
Auto-Modeは設定を順に試し、成功した設定に対して課金します。すべての設定が失敗した場合は課金されません。max_costで、試せる設定の費用に上限を設けられます。ただしドキュメントによると、ページ固有の待機やクリック指示は自動では選びません。選択操作や非同期読み込みの後にだけ必要な価格が表示されるなら、その動作は自分で定義する必要があります。Auto-Modeのドキュメントを参照してください。
ここでの制約は、取得設定だけでは、何を抽出したいかは決まらないことです。正常なHTMLレスポンスでも、中身が空のプレースホルダー、デフォルト地域の価格、顧客が選ばない選択肢が含まれる場合があります。API呼び出しの成功で確認を終えず、レスポンスを証拠として残し、業務で使うフィールドを検証します。
- 解析とスケジュールを自分のコードで維持する独自スクレイパーに適しています。
- レンダリングとプロキシ設定ごとのクレジット消費量が公開されています。
- Auto-Modeで、アクセス設定にかける費用の上限を決められます。
- 明示されたプラン構成に沿って、同時実行数と容量を増やせます。
- 同じクレジット枠でも、設定によって実行できるリクエスト数が大きく変わります。
- AI抽出は追加のクレジット課金です。
- Auto-Modeは、対象ページに固有の待機やクリック設定を用意しません。
- 無料枠はトライアルであり、定期処理に使い続けられる利用枠ではありません。
リクエストを制御することに価値があり、返された内容の検証方法もわかっているなら、ScrapingBeeを選びます。対象サイトの抽出ルールの保守を手放したいなら、レコードAPIや適切なApify Actorを優先します。
7. Octoparse:画面上でタスクを設計し、クラウド定期実行は有料で使う
Octoparseは、抽出タスクを自分で設計・保守したい運用担当者向けの、画面操作型スクレイピングアプリケーションです。API連携よりタスクビルダーが必要な、カタログや掲載情報の定期収集に向いています。購買担当のアナリストなら、一覧と詳細の項目を定義し、検証を通ったワークフローを有料のクラウド実行へ移せます。Freeプランはローカルでの評価に便利ですが、無人で動くデータ配信ができるという前提では選べません。
向いている人: 画面上で抽出タスクを作り、必要に応じてクラウド実行を購入する運用担当者です。
特徴: タスク単位のスクレイピングに、有料のクラウド定期実行と自動エクスポートを組み合わせられます。
料金: Standardは年払いで$69/月からです。
無料利用: Free Planはローカル実行10タスク、月間エクスポート50,000行です。
Freeには、10タスク、ローカル端末での実行、1回あたり最大10,000行のエクスポート、月間50,000行のエクスポートが含まれます。Standardでは、クラウド抽出、タスクの定期実行、自動エクスポート、Data Export APIが加わり、100タスクと最大3つのクラウド同時実行が使えます。Professionalは250タスクと最大20のクラウド同時実行に加え、Advanced APIと追加サポートを提供します。Enterpriseは750+タスク、40+のクラウド同時実行と案内されています。Octoparseのプラン詳細を参照してください。
公開料金は、Freeが$0、Standardが$69/月から、Professionalが$249/月、Enterpriseが個別見積もりです。記載した有料プランの両料金は、年払いです。月額換算を年払いの提案として扱い、支出を見積もる前に、決済画面で請求額を確認します。Octoparseの料金で確認できます。
課金の基本は、タスク数と実行プロセス数に上限がある定額契約であり、通常のリクエスト単位のクレジットではありません。管理できる数のタスクの中で多くのデータを抽出する処理には合う場合があります。ただし、有料プランの「データエクスポート無制限」は、クラウドでの並列実行も無制限という意味ではありません。保存できる100タスクを使い切るよりずっと前に、Standardのクラウド同時実行3つが制約になることがあります。
アドオンの料金は別です。料金ページでは、住宅用プロキシが$3/GB、CAPTCHA解決が1,000件あたり$1-1.5、結果単位で課金するテンプレートが1,000件の結果あたり$0.001-3と記載されています。有料契約をすれば、高度なアクセスに関するすべての費用が無料で含まれるわけではありません。
仕入先カタログのワークフローなら、まずローカルで小さなタスクを作り、一覧と詳細を必要な範囲で取得できるか検証します。その後、同じ入力をクラウド実行でどう処理するか、エクスポート先はどこか、失敗を誰が確認するかを確かめます。タスクを作れるアナリストであっても、想定したレコードが取得できたかを確認する運用手順は必要です。
- 画面上でのタスク設計は、抽出指示を自分で管理したい運用担当者に向いています。
- 無料のローカルタスクで、クラウド契約前にワークフローを評価できます。
- Standardには、定期実行と自動エクスポートが明示的に含まれます。
- タスク数とクラウド実行プロセス数の上限が、実行可能な範囲を示します。
- 無料実行はローカルなので、無人のクラウド処理には使えません。
- 有料プランでエクスポート量が増えても、タスク数や同時実行数の上限は残ります。
- プロキシ、CAPTCHA、テンプレートのアドオンで、従量料金が加わる場合があります。
- 開始料金を使うには年払いが必要です。
画面上でタスクを設計できることに価値があり、クラウド実行の上限がスケジュールに合うなら、Octoparseを選びます。操作を記録した監視ならBrowse AIがより直接的な最初の候補で、ソフトウェア製品に抽出を組み込むならAPIが向いています。
8. Zyte:対象サイトに応じてアクセス費用が変わる
ZyteはWebデータサービスで、Zyte APIの成功レスポンス料金はサイトの難易度と、HTTPコンテンツかブラウザレンダリングかで変わります。プロキシ群を直接購入せず、アクセス処理を自動化したい収集システムの開発者に向いています。掲載情報サービスなら、自分のデータセットと解析処理を維持し、対象ごとに本当に必要なレスポンスモードで予算を組めます。最低価格を判断材料にするには、そこに付く月間利用額の契約条件とサイト区分も確認する必要があります。
向いている用途: 開発者が管理し、対象サイト別にアクセス予算を組む収集システムです。
特徴: 成功レスポンスに課金し、HTTPとブラウザで別の料金を適用します。
料金: PAYGはHTTPが1,000レスポンスあたり$0.13-$1.27、ブラウザが1,000レスポンスあたり$1.01-$16.08です。
無料利用: 契約義務のない、30日間有効の$5クレジットです。継続的な無料枠の案内はありません。
対象サイトの区分はSimple、Easy、Moderate、Complex、Advancedです。PAYGのHTTP料金は1,000レスポンスあたり順に$0.13、$0.23、$0.44、$0.70、$1.27、ブラウザ料金は$1.01、$2.01、$4.02、$8.04、$16.08です。同じリクエスト量でも、対象サイトとレンダリングの必要性によって請求額は大きく変わります。Zyteの料金を参照してください。
月間利用額を確約すると、単価が下がります。$100の契約では、1,000レスポンスあたりHTTPが$0.10-$0.95、ブラウザが$0.75-$12.00です。$200ではそれぞれ$0.08-$0.76と$0.60-$9.60、$500では$0.06-$0.61と$0.48-$7.68になります。Enterpriseの価格は営業窓口で相談します。ページの「$0.06から」は月間利用額を確約するプランの価格であり、PAYGのHTTP開始価格ではありません。
成功レスポンス100,000件を例にすると、SimpleのPAYG HTTP単価では利用料が$13です。Simpleのブラウザ単価なら$101、Advancedのブラウザ単価なら$1,608です。公開料金を使った計算例であり、実際の対象サイトが特定の区分になるという主張ではありません。高度な機能には追加料金がかかる場合があるため、予定する出力モードを使い、提供元のサイト別見積もり機能で確認します。
確認したい制約は、対象サイトによって採算が変わることです。複雑さの低いHTTP対象と、高度なレンダリングが必要な対象を、同じ想定ページ単価で見積もるべきではありません。URLリストを対象とモードで分け、採用したレスポンス数を保存し、その構成に対して月間利用額を確約するプランを比較します。
アクセスが成功しても、抽出の仕様を管理するのは自分です。パーサーには、正しい掲載情報の識別子、フィールド、完全性の確認が必要です。保守されたレコードAPIやActorが必要なデータセットをすでに返すなら、アクセス費用が安いだけでは、独自抽出を維持する理由にならない場合があります。
- HTTPとブラウザで料金が分かれ、対象ごとの予算を正確に組めます。
- 難易度の5区分によって、一律の開始価格では隠れがちな差が見えます。
- 月間利用額を確約するプランの単価が段階的に公開されています。
- APIにはレンダリング、IPローテーション、地域指定の機能が案内されています。
- 最安として表示される料金には、月間利用額の確約が必要です。
- ブラウザレンダリングによって、費用が大きく変わることがあります。
- 高度な機能には追加料金がかかる場合があります。
- レスポンスの解析と、業務上の検証は引き続き必要です。
開発側のワークフローでアクセス処理を任せたい場合に、対象サイトの構成を測定できるならZyteを選びます。料金ページの最低価格だけを目的に契約せず、まずPAYGで見積もります。
定期的なWebデータ収集には、実際にいくらかかるか
開始料金を比べる前に、繰り返す処理の回数と出力形式を数えます。 ここでは予算計画の例として、創業者が既知の120ページを30日間毎日再訪し、合計3,600回のページ訪問を行う場合を使います。通常のページを前提とし、追加のブラウザ操作、URL発見の呼び出し、監視エンドポイントの料金、課金対象のリトライは含めません。これは予算計算の例であり、測定した負荷や、対象サイトにアクセスできるという保証ではありません。
基本的なMarkdown取得なら、3,600回の訪問はFirecrawlでもContext.devでも3,600クレジットです。FirecrawlのHobbyは$19/月で5,000クレジット、Context.devのDeveloperは$19/月で7,500クレジットを含みます。どちらの開始プランも、この条件の取得量を月払いの契約枠内で賄えます。FirecrawlとContext.devの料金を参照してください。
同じ標準ページで構造化JSONの抽出が成功する場合は、どちらも18,000クレジットが必要です。FirecrawlのHobbyは、1,000クレジット$5の追加枠を13個購入するため、$19 + $65 = $84/月です。Context.devのDeveloperは、公開されている新規契約の単価で、1,000クレジット$2.20の追加枠を11個購入し、$19 + $24.20 = $43.20/月です。Context.devの計算では、購入単位への切り上げにより、使い切らないクレジットが残ります。
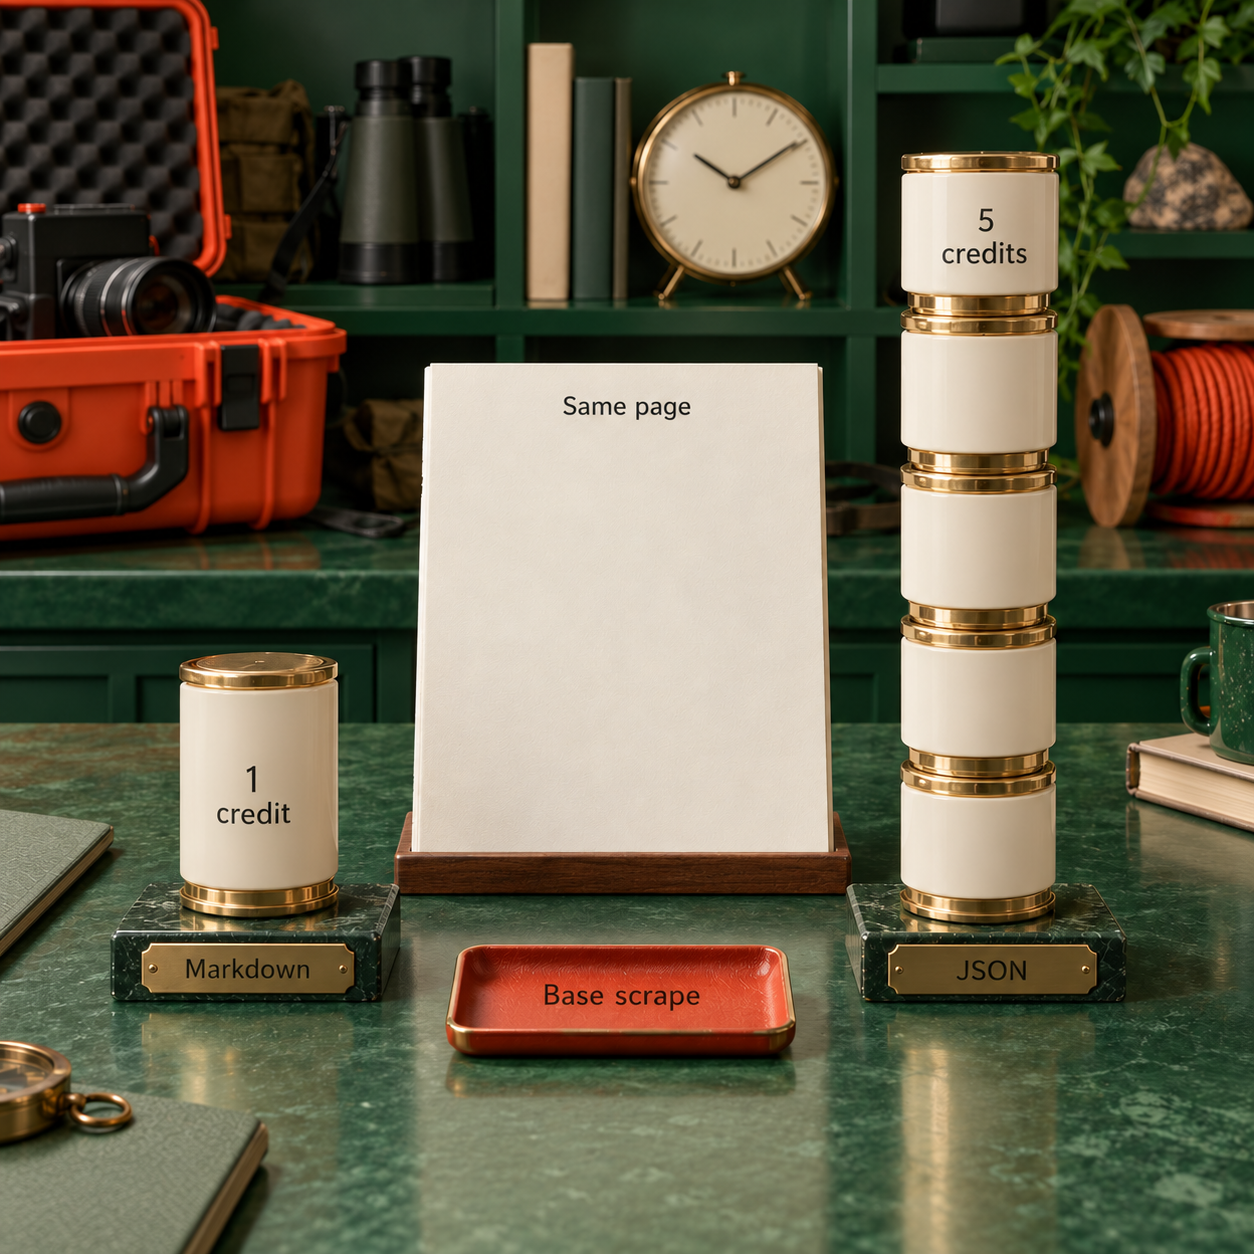
ノーコード監視でも、実行頻度の計算は必要です。Browse AIで標準ページを月間3,600回確認すると、行数の増加やプレミアム対象を除いて年間43,200クレジットです。Professionalの年間60,000クレジットならこの例を賄えますが、Personalの12,000では足りません。月払いのProfessionalは$87で月間5,000クレジット、年払いは$69/月で$828を一括払いです。Browse AIの料金を参照してください。
プロキシだけを使う場合は、別の計算が必要です。実測したGBから始め、スクレイパーのホスティング、抽出作業、例外処理の費用を足します。レコードAPIなら、納品された課金対象レコード数が出発点です。Apifyなら、選んだActorとリソース利用量から計算します。実際の処理を測らずに、いずれもページ単価の保証へ換算しないようにします。
用途と担当者に合うツールは、どれを選べばよいか
判断基準は、必要なのがページ本文、運用担当者が管理する監視、対象サイト別の完成したレコード、既存コードのためのアクセスのどれかです。 有料のアップグレードは、直面している制約を解消するために選びます。機能一覧が長いという理由だけでは決めません。
スクレイピングツールは、次の失敗を直す人で選ぶ
データ機能を開発チームが管理するなら、必要な内容とメタデータを返すAPIを候補にします。スプレッドシートを使う業務を運用担当者が管理するなら、その担当者が確認できる画面操作型のロボットを候補にします。まだ障害対応の責任者がいないなら、収集頻度を増やす前に決めます。
担当者が変わると、適したツールも変わります。開発者は、スクレイピングAPIをプロダクトに適した部品にできます。同じAPIでも、毎日の結果が必要で、受信するアプリケーションを持たない運用担当者には、合わない購入になる場合があります。反対に、操作を記録するタスクはすぐに評価できても、抽出がプロダクトの中核機能になると、使いにくさが生じることがあります。
AIによるスクレイピングにも、スキーマと採用基準が必要
抽出をデータの仕様として扱います。価格レコードなら、商品識別子、バリエーション、金額の数値、通貨、取得元URL、収集時刻を定義します。最初の自動更新の前に、欠損値や曖昧な値の扱いを決めます。整ったJSONオブジェクトは形式です。業務上正しいレコードかどうかは、その仕様に照らして判断します。
文書を取り込む場合は、取得元と取得時刻を残し、必要に応じて無関係な反復ナビゲーションを除きます。自動チェックがページを却下したときも、元のレスポンスは保存します。その証拠があれば、担当者はサイト変更と、フィールド定義の誤りを区別できます。
エージェント向けのAIスクレイパーは、欲しい出力で選ぶ
ページを扱うscrape/crawl/mapのワークフローなら、Firecrawlから始めます。バッチとWebhook監視の組み合わせがアプリケーションに合うなら、Context.devも候補に加えます。適切なApify Actorが対象サイトから必要な項目をすでに取得できるなら、その実行全体を汎用のページAPIと並べて評価します。
収集対象を固定し、期待する出力をそろえて選びます。通常のページ、レンダリングが必要なページ、一覧と詳細の関係、曖昧なフィールドがあるページを含めます。開始プランの利用枠は費用計算の材料であり、どちらがより良いデータを作るかの証拠ではありません。
Pythonでスクレイピングを定期実行するなら、何を任せるか
PythonのワークフローではAPIを呼び出し、スケジュール、解析、保存、検証を自分のアプリケーション内で管理できます。ページ本文やサービス側の構造化抽出が欲しいなら、FirecrawlやContext.devを選びます。解析は自分で制御し、取得部分を置き換えたいなら、ScrapingBeeやZyteを選びます。
制御できる範囲が増えれば、運用作業も増えます。通信エラー、対象サイトのエラーページ、欠損フィールド、業務上却下したレコードを明確に分けます。すべてを無条件にリトライしないようにします。間違った抽出ルールは、同じリクエストをもう一度実行しても改善しません。
無料のスクレイピングは、継続的に使える枠で判断する
FirecrawlとContext.devは、それぞれ月間1,000クレジットを案内しています。Browse AIは2ドメインで月間50クレジットです。Apifyは利用料$5/月分、Bright DataのScraper APIは月間5Kレコードです。必要な処理が利用枠に収まれば、小規模な評価や控えめな定期処理に使えます。
標準ページを1ページ、30日間毎日確認するなら、Browse AIの50クレジット枠で30回の確認を賄えます。プレミアム対象ではなく、抽出行数によって課金が増えない場合には、実用的な無料監視の例です。ScrapingBeeの1,000クレジットとZyteの$5はトライアルで、OctoparseのFreeはローカル実行です。「無料」という表記以上に、この違いが重要です。
オープンソースを自分で運用する場合の選び方
ソースやインフラを管理する必要があり、そのためにサービスを運用する価値があるなら、Firecrawlのセルフホスト可能なコアが選択肢です。オープンソースなら、そのコアに対する提供元の契約料はなくせます。ただし、ホスティング、監視、復旧、次の障害を直すエンジニアまで付いてくるわけではありません。
最安のスクレイピング手段と考える前に、Firecrawlのセルフホストガイドで運用範囲を評価します。既知のページを返すエンドポイントだけが必要な小規模プロダクトチームなら、マネージドの開始プランで別のインフラ構築を避けられる場合があります。具体的な管理要件があり、継続して運用できる担当者がいるときに、セルフホストを選びます。
比較対象と評価基準
用途との適合性、課金のわかりやすさ、購入判断が変わる制約を重視した比較です。 料金ページと関連する提供元のドキュメントを参照し、数値を2026年10月6日に確認しています。費用例は、公開料金と明示した処理量の前提を使った計算です。実機での製品試用は行っておらず、速度、精度、成功率の順位を示すものではありません。
Firecrawl、Bright Data、Browse AI、Context.devは、このサイトのパートナーツールです。Apify、ScrapingBee、Octoparse、Zyteは、それ以外の代替選択肢です。パートナーだからといって、運用担当者の監視にプロキシだけを買うのが適切になったり、ソフトウェア機能に操作記録型のロボットが適したAPIになったりはしません。推奨は、担当する処理の範囲に基づいています。
実用上の評価項目は、必要な出力を返すか、設定と修復を誰が担当するか、どの反復処理に課金されるか、どの割当量や同時実行上限に先に達するか、不完全なレスポンスや却下したレスポンスをどう扱うかです。マーケットプレイスが大きいことや、目を引く開始価格が安いことだけでは、これらの問いに答えられません。
フレームワークやブラウザライブラリの一覧は、この比較の候補から外しています。読者が選ぶ対象を、継続利用するサービス、ノーコードのワークフロー、アクセス基盤に絞っているためです。ページ収集よりも複雑な画面遷移が必要な作業では、対話的なブラウザ操作を別の要件として考えます。
定期収集を設定する前に、対象サイトの利用規約とrobots.txtを確認してください。
選ぶと困りやすい組み合わせ
製品が別の用途に優れていても、自分の用途に合わない選び方は避けます。 次の組み合わせは、購入で減らしたかったはずの作業を生みやすいものです。
- 無人のクラウド配信にOctoparse Freeを使う。 タスクはローカルで動きます。業務に必要なクラウド実行を購入するか、運用方式の合うサービスを選びます。
- Bright Dataの住宅用プロキシを、完成したデータセットのつもりで買う。 提供されるのはアクセスです。リクエスト、解析、採用判断は自分で管理します。レコードを購入したいなら、適切なScraper APIを使います。
- 高頻度で大規模な監視に、Browse AI Personalの年払い表示だけで決める。 年間12,000クレジットでは、例の年間43,200クレジットの処理を賄えません。訪問数、行数、プレミアム対象、ドメイン数を先に計算します。
- Zyteの$0.06を、PAYGの見積もりとして使う。 これは月間$500を確約するプランの最安単価です。契約前に、実際の対象サイトとモードで見積もります。
- ScrapingBeeのクレジット総量を、リクエスト数の保証として読む。 レンダリングやプロキシの設定により、同じリクエストで複数クレジットを使う場合があります。実際に動く構成で予算を組みます。
- FirecrawlやContext.devを、データ品質管理の全体として使う。 どちらも、却下すべき内容を返す場合があります。ステータスと出力の証拠を保存し、不完全な更新から後続のレコードを守ります。
避けたいのは、任せたつもりの処理を結局自分で保守することになる製品選びです。自信に満ちた総合順位より、担当範囲を明確にする方が役に立ちます。
最初に試す、小さな定期実行
1人の責任者を決め、小規模な定期評価を行います。 代表的なURLを10件選び、期待するフィールドや文書内容と、レスポンスを不採用にする条件を定義します。ノーコードならワークフローを記録し、APIならスケジューラと保存先へ接続します。
7日間、毎日1回実行します。元のレスポンス、対象サイトのステータス、出力、消費した課金単位、採用したレコード数を保存します。ページネーション、欠損値、識別子の重複、更新を起こすべき変更と起こすべきでない変更を確認します。
その後、観測した対象サイトの構成で、月間全体の費用を計算します。出力と運用体制の要件を満たす中で、最も複雑さの少ない選択肢を選び、試用後も採用可否のチェックを残します。データ配信を本番運用に進める判断材料は、最初のリクエストが成功したことではなく、有用な結果が繰り返し得られることです。
Webスクレイピングには、どのツールが向いていますか?
エージェント用のページ本文にはFirecrawlとContext.dev、画面上で設計する抽出ワークフローにはBrowse AIとOctoparseが向いています。Bright Data、Zyte、ScrapingBeeは、それぞれ異なるアクセスやページ取得の要件に対応します。対象サイトに合うActorがすでにある場合は、Apifyが特に役立ちます。先に出力と担当者を決め、その後で月額費用の全体を比較します。
ChatGPTでWebサイトをスクレイピングできますか?
OpenAIの公式ドキュメントで説明されているとおり、ChatGPTはブラウザ機能でWebサイトを開き、情報を集められます。対話しながらの収集作業には使えます。価格、掲載情報、エージェント用文書を継続的に取得する場合は、スケジュール、出力スキーマ、結果の保存、障害対応の担当者を別途評価します。ここでの選択は、AIアシスタントがページを読めるかどうかではなく、その定期ワークフローをどのサービスで実現するかです。
スクレイピングには、どのAIが最適ですか?
言語モデルを選ぶ前に、抽出サービスと期待する出力を決めます。Markdownや構造化フィールドが必要ならFirecrawlとContext.dev、運用担当者が管理するロボットならBrowse AIが候補です。代表的なソースから必要な情報を返し、全体の費用を許容できるものが、適した選択肢です。
スクレイピングは、もう古い手法ですか?
まず対象サイトに、用途に合うAPIやフィードがあるか確認します。必要な情報がページとしてしか公開されていない場合、抽出は引き続き選択肢です。購入時に役立つ区別は、製品がAIを名乗るかどうかより、取得、抽出、定期実行、検証を誰が管理するかです。
おすすめのスクレイピングツール10選は?
この記事では、エージェント用データ、ノーコード監視、大規模なアクセスという3つの定期的な用途に向けて、8製品を取り上げています。10製品にそろえるために候補を増やすより、用途の中で選びます。ブラウザ自動化のプロジェクトやセルフホストのフレームワークでは、ここで比べたサービスとは異なる運用判断が必要です。
ニュースレターからAI Business Workflow Audit Checklistを入手し、Webデータのワークフローを契約する前に、出力、スケジュール、採用基準、担当者を整理しておきましょう。
- 最終更新
- 2026年10月6日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

AI メモリの設計入門:エージェントに何を記憶させ、どう使うか
AI メモリを導入する前に、何を残すべきかを見極めましょう。コンテキスト、セッション状態、長期ストア、ファイルとスキルの役割を整理し、Claude・OpenAI・Googleの標準機能と費用を解説します。履歴の再入力とのコスト比較や、古い事実、ユーザー間の情報漏えい、メモリポイズニングへの対策も紹介します。2026年10月5日Build
Pinecone 料金ガイド【2026年】:無料枠から1M〜100Mベクトルの月額まで
Pineconeの料金を2026年10月5日の情報で整理。無料のStarter、月額$20のBuilder、StandardとEnterpriseの最低利用料金に加え、1M・10M・100Mベクトルの試算を解説します。RAGやエージェントのメモリで費用を左右する検索範囲、書き込み、転送量、代替サービスまで確認できます。2026年10月5日Build
AI アプリ開発ツール比較:Lovableの代替候補と料金・移行の判断軸【2026年】
AI アプリ開発でLovableからの乗り換えを検討する方向けに、Replit、Emergent、Blink、Bolt.new、Base44、v0、Whackaを比較。月額料金だけでなく、クレジットの消費、バックエンドの対応範囲、コード出力とデータ移行、本番運用の費用まで確認し、用途に合う選択肢を見極めます。2026年10月5日Build
LangSmith料金を比較:チーム規模で選ぶLLM可観測性ツール6選【2026年】
LangSmith料金を軸に、Langfuse、Helicone、Arize Phoenix、Braintrust、Datadogを比較します。月100,000回の実行を同じ条件で試算し、チーム人数、課金単位、保持期間、セルフホストのライセンス、OpenTelemetry対応から本番運用に合うツールを選びます。2026年10月5日Build
OpenCode 使い方ガイド:導入・モデル接続から料金確認まで
OpenCodeの導入から、ChatGPTやAPIキー、Ollamaの接続、最初のバグ修正までを解説します。AGENTS.mdの整備、PlanとBuildの使い分け、プラグインの追加方法、ZenとAPIの料金、Claude Code・Piとの選び分けを押さえ、差分とテスト、費用を確認して使い始めるガイドです。2026年10月4日Build
Netlify 料金ガイド(2026):無料枠・クレジット・月額費用を解説
Netlifyの料金をFree・Personal・Proで比較し、クレジットの消費と追加購入の仕組みを解説します。マーケティングサイト、Next.jsアプリ、10サイトを運用する制作会社の月額費用を試算。無料枠の条件、Proが割安になる境目、自動チャージの追加費用やサイト停止まで、予算を決める前に確認できます。2026年10月4日Build
Softrレビュー:料金・権限・AI機能から考えるプランの選び方
Softrで顧客ポータルや社内ツールを作る際の料金、権限、AI機能を解説。2026年10月4日確認の月払い・年払いの価格と、Basic・Pro・Businessの条件を比較します。TeamとClientのユーザー数、データベースごとの上限、Airtable連携まで整理し、用途に合うプランと追加費用の考え方を示します。2026年10月4日Build