Web Scraper im Vergleich 2026: Acht Tools für unterschiedliche Aufgaben
Acht Web Scraper im Vergleich: Firecrawl, Browse AI, Bright Data und weitere Tools. Preise, Gratislimits und Zuständigkeiten für wiederkehrende Datenabrufe.




Firecrawl gehört auf die erste Auswahlliste, wenn ein KI-Agent sauber aufbereitete Seiten lesen soll. Browse AI eignet sich für eine Überwachung, die das Fachteam selbst betreuen kann, Bright Data für die Datenerfassung, wenn der Zugriff auf Zielseiten zum Engpass wird. Welcher Web Scraper passt, hängt von der Aufgabe ab: Firecrawl und Context.dev starten bei monatlicher Abrechnung beide bei $19/Monat. Strukturierte JSON-Ausgaben verändern jedoch den Credit-Verbrauch. Vor der Anbieterwahl sollten das Ausgabeformat, der Zeitplan und die Zuständigkeit für fehlgeschlagene Durchläufe feststehen.
Web Scraper im Überblick
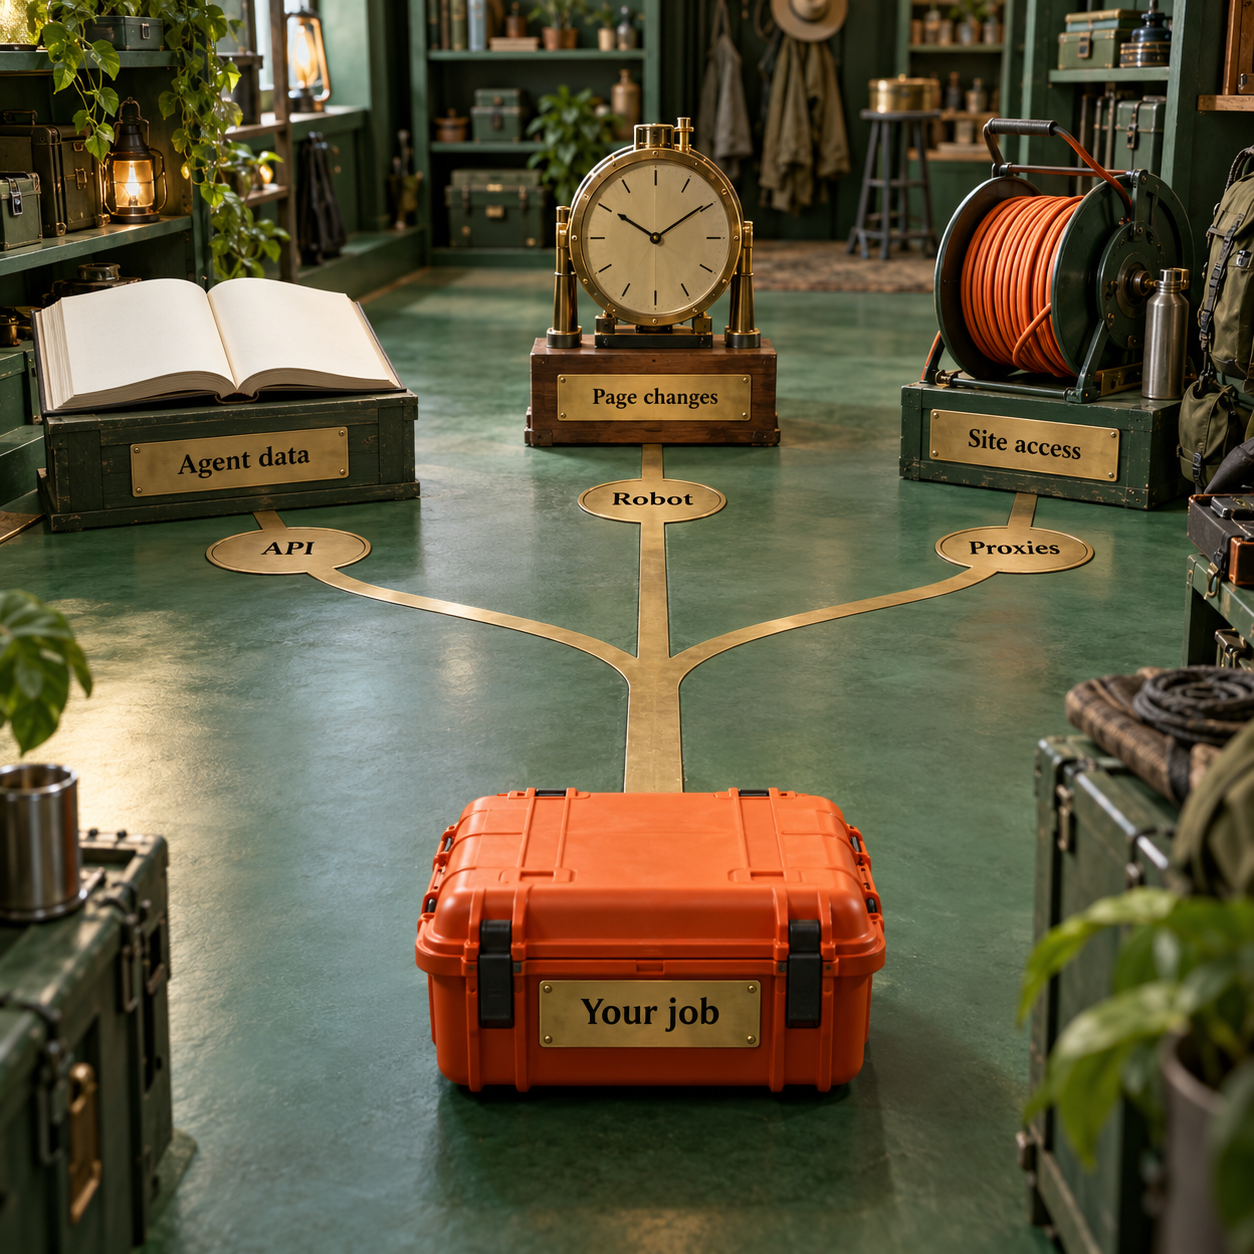
Gekauft wird der Baustein, der im eigenen Workflow fehlt. Eine Scraping-API ist ein Dienst, den die eigene Software zum Abrufen von Seitendaten aufruft. Sie passt zu Entwicklern, die einen Agenten oder einen Datenbestand aufbauen. Ein No-Code-Roboter eignet sich für Fachanwender, die eine wiederholbare Erfassungsaufgabe benötigen. Ein Proxy-Netzwerk leitet den Datenverkehr über andere IP-Adressen und hilft, wenn bereits ein eigener Scraper vorhanden ist, der besseren Zugriff auf Zielseiten braucht.
Die folgenden Preise und Kontingente wurden am 6. Oktober 2026 anhand der veröffentlichten Anbieterseiten geprüft. Preise bei jährlicher Abrechnung sind entsprechend gekennzeichnet; einmalige Testangebote werden von regelmäßig erneuerten Kontingenten unterschieden. Die Einstiegsspalte nennt das günstigste kostenpflichtige Angebot. Die letzte Spalte zeigt, was sich ohne kostenpflichtigen Tarif ausprobieren lässt.
Die Tabelle hilft bei der Vorauswahl. Ein gelieferter Datensatz, eine besuchte Seite und ein Gigabyte sind damit nicht gleichzusetzen. Bright Data bewirbt den Proxy-Gutschein RESIGB50 mit 50% Rabatt für drei Monate. Dieser Aktionspreis gehört ins Testbudget; für die laufende Kostenplanung zählt der reguläre Preis.
Erst das Ergebnis festlegen, dann die Zuständigkeit
Hier geht es um drei unterschiedliche Kaufentscheidungen. Mit der Aufgabe ändert sich auch das passende Tool. Wer als Gründer Dokumentation in einen Assistenten lädt, als Fachanwender Konkurrenzpreise beobachtet oder als Entwickler einen großen Bestand an Angebotsdaten aktualisiert, sollte nicht mit demselben Produktvergleich beginnen.
Aufgabe eins: Seiten für einen Agenten aufbereiten
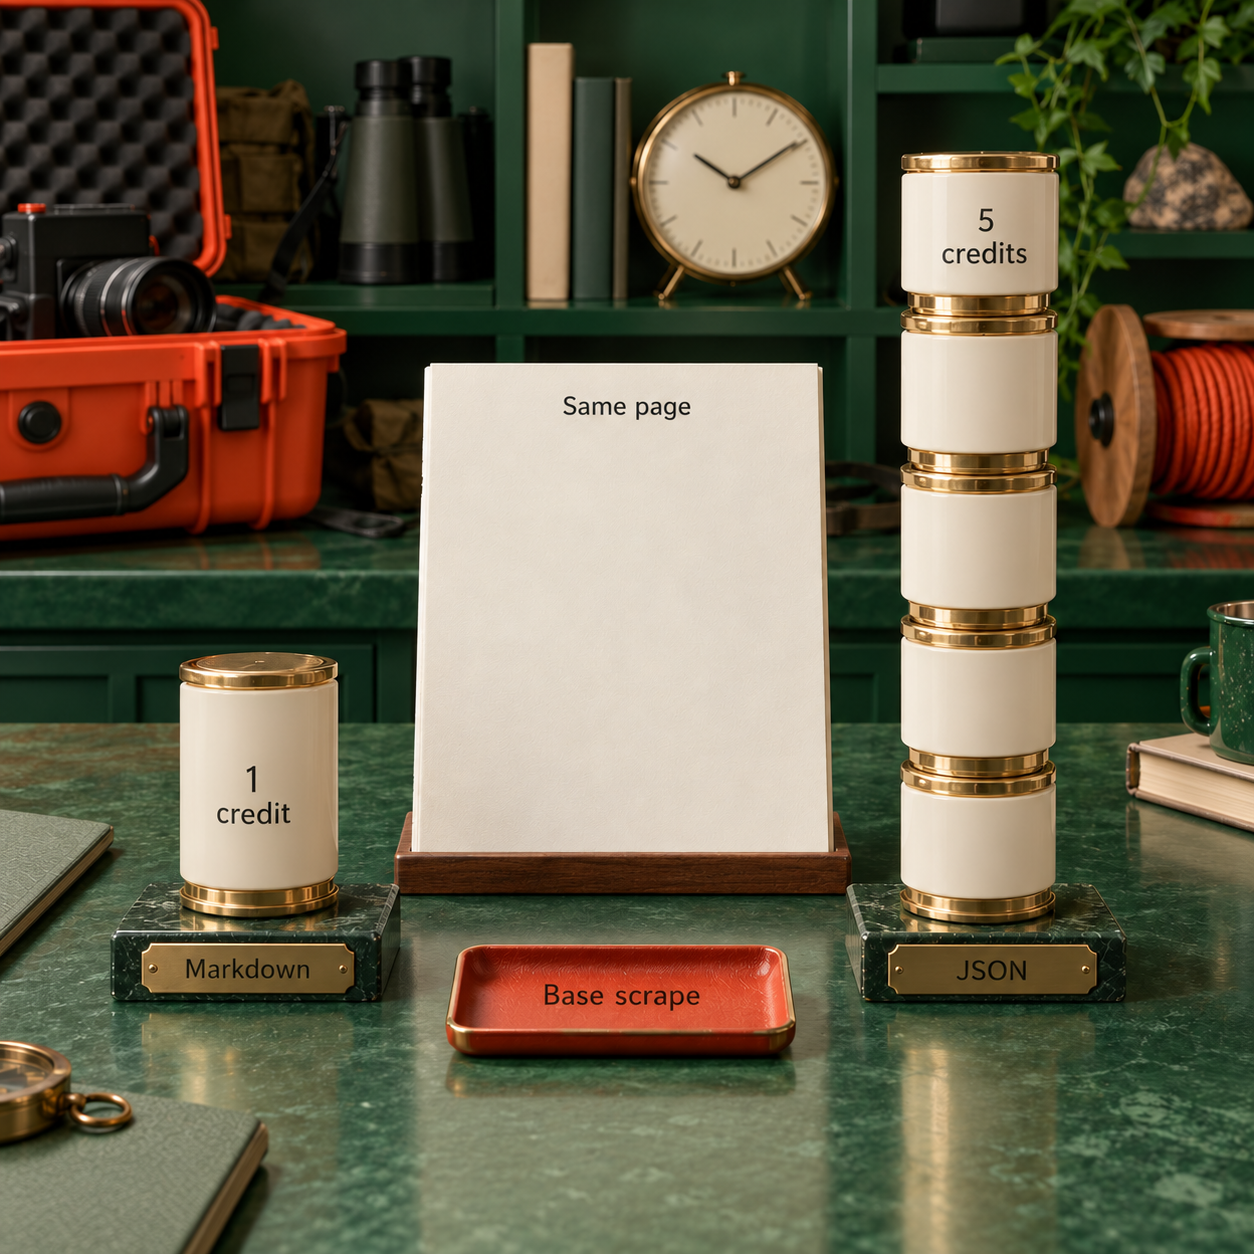
Firecrawl oder Context.dev sind der Ausgangspunkt, wenn Seiteninhalte oder strukturierte Felder in der eigenen Anwendung landen sollen. Markdown erhält Überschriften und Links in einem lesbaren Textformat und eignet sich, wenn ein KI-Agent das Dokument benötigt. JSON enthält benannte Felder, etwa Produkt, Preis, Währung und Verfügbarkeit. Das hilft, wenn ein Workflow einen Datensatz prüfen und vergleichen muss.
Dieser Unterschied beeinflusst die Qualität ebenso wie die Kosten. Ein Support-Assistent kommt oft mit einer sauber aufbereiteten Dokumentationsseite aus. Eine Preisbenachrichtigung braucht dagegen das Preisfeld, die Währung, die richtige Produktvariante und einen Zeitstempel. Eine Seite an ein Modell zu schicken, klärt noch nicht, welcher von mehreren Preisen für das Unternehmen relevant ist.
Auch Scrape, Crawl und Map sollten getrennt betrachtet werden: Scrape ruft eine Seite ab, Crawl folgt den Links einer Website und ruft mehrere Seiten ab, Map ermittelt URLs. Ist bereits eine verlässliche URL-Liste vorhanden, kann die wiederholte Suche nach Adressen Aufwand verursachen, ohne den Datenstrom zu verbessern. Wächst die Dokumentation einer Website laufend, gehört diese Suche hingegen zur Aufgabe.
Aufgabe zwei: bekannte Seiten überwachen, ohne Code pflegen zu müssen
Browse AI passt zu aufgezeichneten Extraktionsaufgaben und zur Überwachung von Änderungen, die ein Fachanwender selbst betreut. Octoparse kommt infrage, wenn die visuelle Gestaltung von Aufgaben und eine kostenpflichtige Cloud-Ausführung besser passen. Ein Roboter ist hier eine gespeicherte Folge von Aktionen und Extraktionsanweisungen, kein allgemeiner Ersatz für Beschäftigte.
Ein Verantwortlicher im operativen Geschäft braucht beispielsweise jeden Morgen Titel, Preis und Verfügbarkeit aus der Produktliste eines Lieferanten. Das nützliche Ergebnis ist eine Tabelle mit stabilen Spalten und einer klaren Fehlermeldung, wenn ein Feld verschwindet. Die zuständige Person sollte die Aufgabe einsehen und anpassen können, sobald sich die Website ändert.
Bevor das Abrufintervall festgelegt wird, muss klar sein, was als Änderung zählt. Ein veränderter Footer sagt nichts über den Lagerbestand aus. Werden die Zeilen einer Liste neu sortiert, darf das nicht so aussehen, als seien sämtliche Produkte ersetzt worden. Dafür braucht es eine stabile Kennung, einen Vergleich der relevanten Felder und eine Prüfung fehlender Daten, statt den gültigen Wert vom Vortag unbemerkt zu überschreiben.
Aufgabe drei: große Datenmengen erfassen, wenn der Zugriff schwierig wird
Bright Data, Zyte oder ScrapingBee gehören auf die Auswahlliste, wenn Zeitplanung und Datenbestand bereits in der eigenen Software liegen, der Abruf der Zielseiten aber zunehmend Probleme bereitet. Ein Unblocker übernimmt Zugriffsaufgaben wie Wiederholungsversuche und die Proxy-Auswahl. Welche Bedeutung die erfassten Daten haben, legt er damit noch nicht fest.
Bright Data bietet auch seitenspezifische Scraper APIs an und kann somit einen vollständigeren Datensatz statt lediglich Netzwerkzugriff liefern. Apify besetzt eine weitere nützliche Position: Ein gepflegter Actor für die jeweilige Zielseite kann die benötigte Extraktionsaufgabe bereits abdecken. Ein Actor ist ein wiederverwendbares Cloud-Programm, das sich konfigurieren und ausführen lässt.
Die Zuständigkeit entscheidet über die Wahl. Soll jemand anderes die Extraktionslogik pflegen, lohnt die Prüfung einer Scraper API oder eines Actors. Soll die eigene Parsing-Logik erhalten bleiben, kommen eine Abruf-API oder ein Proxy-Dienst infrage. Reinen Zugriff zu bezahlen und einen fertigen Datenbestand zu erwarten, ist eine teure Fehlentscheidung.
Acht Tools und ihre entscheidenden Grenzen
Jedes der folgenden Tools eignet sich für eine konkrete, wiederkehrende Aufgabe. Die Nummerierung erleichtert die Orientierung. Welche Wahl innerhalb einer Aufgabe am besten passt, hängt vom gewünschten Ergebnis, den Grenzen und den Zuständigkeiten im jeweiligen Abschnitt ab.
1. Firecrawl: zuerst prüfen, wenn Agenten Seiteninhalte brauchen
Firecrawl ist eine Scraping-API, die Websites in nutzbare Seiteninhalte umwandelt. Für einen Agenten, der auf Dokumentation zugreift, ist sie die erste Option, die es zu prüfen gilt. Die Funktionen Scrape, Crawl und Map decken Seitenabruf, das Durchlaufen einer Website und die URL-Suche ab, ohne diese Aufgaben gleichzusetzen. Ein Gründer kann für einen Support-Assistenten die Dokumentationsadressen ermitteln, relevante Pfade auswählen und die zugehörigen Seiten als Markdown erfassen. Firecrawl passt, wenn saubere Seiteninhalte das Ziel sind. Steht ein vom Fachteam betreuter Tabellenmonitor im Vordergrund, sollte die Wahl neu geprüft werden.
Geeignet für: Entwickler, die Dokumentation, Artikel oder Referenzseiten in einen KI-Agenten einspeisen.
Besonderheit: Getrennte Funktionen für Scrape, Crawl und Map, mit Markdown und strukturierter Extraktion.
Preis: Hobby $19/Monat oder $16/Monat bei jährlicher Abrechnung; 5,000 Credits pro Monat.
Kostenlos testen: Wiederkehrender Tarif Free mit 1,000 Credits/Monat, ohne Kreditkarte.
Eine einfach abgerufene oder gecrawlte Seite kostet 1 Credit. JSON-Extraktion kostet zusätzlich 4 Credits. Ein Standardabruf mit Seite und JSON verbraucht somit 5 Credits. Hobby reicht entsprechend für 5,000 einfache Seiten oder 1,000 Standardseiten mit JSON, sofern das gesamte Guthaben nur für diesen Vorgang verwendet wird. Dasselbe Abo bietet also je nach gewünschter Ausgabe sehr unterschiedliche Kapazitäten. Firecrawl-Preise im Detail.
Bei monatlicher Abrechnung umfasst die Tarifstaffel Free für $0, Hobby für $19 mit 5,000 Credits, Standard für $99 mit 100,000, Growth für $399 mit 500,000 und Scale für $749 mit 1,000,000. Enterprise wird individuell bepreist. Die angezeigten monatlichen Vergleichspreise bei jährlicher Abrechnung betragen $16, $83, $333 und $599/Monat. Die zugehörigen Jahresrechnungen lauten $190, $990, $3,990 und $7,190. Das sind die Angaben des Anbieters einschließlich seiner Rundungen. Alle Firecrawl-Tarife.
Die erste Grenze ist der angeforderte Crawl-Umfang. Laut Firecrawl-Dokumentation liegt das Standardlimit bei 10,000 Seiten. Ein Auftrag kann abgewiesen werden, wenn die verbleibenden Credits das angeforderte Limit nicht decken. Selbst für eine kleine Website kann im Tarif Hobby daher ein ausdrücklich niedrigeres limit nötig sein, noch bevor die erste Seite abgerufen wird. Die nächste Grenze betrifft parallele Anfragen: Hobby erlaubt 5, Standard 25, Growth 50 und Scale 100 gleichzeitige Anfragen. Mehr Credits heben die Parallelitätsgrenze des aktuellen Tarifs nicht auf. Verhalten beim Crawling.
Auch die Prüfung der Ergebnisse zählt. Firecrawl berechnet nach eigenen Angaben keinen Scrape, der kein Ergebnis liefert. Eine zurückgegebene Fehlerseite der Zielwebsite, etwa mit Status 403 oder 404, kostet dagegen einen Credit. Vor der Übernahme in die Wissensbasis sollten der Status der Zielseite und der gelieferte Inhalt geprüft werden. Eine sauber in Markdown umgewandelte Fehlerseite bleibt eine Fehlerseite.
- Scrape, Crawl und Map trennen die Suche nach Seiten von deren Abruf.
- Markdown eignet sich für die Dokumentenaufnahme, JSON für ein festgelegtes Feldschema.
- Das wiederkehrende Gratiskontingent erlaubt die Prüfung einer kleinen, zeitgesteuerten Aufgabe.
- Kostenpflichtige Aufladungen ermöglichen mehr Nutzung vor einem Tarifwechsel.
- Strukturierte Extraktion reduziert das einfache Seitenkontingent deutlich.
- Ein großes Standardlimit beim Crawling kann das Guthaben eines kleinen Kontos übersteigen.
- Zurückgegebene Fehlerseiten können kostenpflichtig sein und müssen selbst geprüft werden.
- Credits in Hobby, Standard und Growth werden normalerweise nicht in den nächsten Zeitraum übertragen.
Zuerst die Quellen ermitteln
Im Map-Playground lassen sich die Dokumentations-URLs ermitteln. Behalten werden die Pfade, die die tatsächlichen Fragen des Assistenten beantworten. Map findet Adressen; deren Abruf ist ein eigener Vorgang.
Die günstigste brauchbare Ausgabe wählen
Für einen Assistenten auf Dokumentationsbasis bietet sich zunächst Markdown an. Ein JSON-Schema ist sinnvoll, wenn der nachgelagerte Workflow benannte Felder benötigt. Bevor das Schema als eindeutig gilt, sollte es an einer repräsentativen Produktseite mit regulärem Preis und Rabattpreis geprüft werden.
Ein finanzierbares Crawl-Limit setzen
Für den beispielhaften Quellenbestand mit 120 Seiten wird
limitausdrücklich auf 120 gesetzt. Pfadfilter verhindern, dass der Crawler das Guthaben für unpassende Blog- oder Kontoseiten verbraucht.Ergebnis und Prüfgrundlage speichern
Quell-URL, Erfassungszeit, Status der Zielseite und Inhalt gehören in den eigenen Speicher. Laut Firecrawl-Dokumentation bleiben abgeschlossene Crawl-Ergebnisse 24 Stunden über die API verfügbar. Die Abrufantwort sollte deshalb nicht die einzige Kopie sein.
Den nächsten Durchlauf gezielt planen
Die Zeitsteuerung der eigenen Anwendung ruft die akzeptierten Quellen erneut ab. Kosten für URL-Suche, Extraktion und Überwachung werden im Budget getrennt erfasst. Zudem muss feststehen, wer eine Fehlermeldung erhält, wenn eine Quelle nicht mehr die erwarteten Inhalte liefert.
Wenn eine bestehende Firecrawl-Installation ersetzt werden soll, behandelt der Vergleich der Firecrawl-Alternativen Migration und Annahmekriterien ausführlicher. Ein Anbieterwechsel ist eine andere Entscheidung als der Wechsel von der Dokumentenaufnahme zur No-Code-Überwachung.
2. Browse AI: Überwachung, die das Fachteam selbst betreuen kann
Browse AI ist eine No-Code-Plattform für Scraping und Überwachung. Sie zeichnet eine Aufgabe als wiederverwendbaren Roboter auf und passt zu Fachanwendern, die Produktpreise, Stellenanzeigen oder Verzeichniseinträge auf bekannten Websites verfolgen. Die zu extrahierenden Felder lassen sich aufzeichnen; die Ergebnisse gelangen in eine Tabelle oder einen angebundenen Workflow. Entscheidend ist die Kombination aus Seiten, extrahierten Zeilen und überwachten Domains. „Unbegrenzte Roboter“ bedeutet deshalb kein unbegrenztes Datenvolumen.
Geeignet für: Fachanwender, die regelmäßig Daten extrahieren und Änderungen überwachen müssen, ohne Scraper-Code zu betreuen.
Besonderheit: Aufgezeichnete Roboter, zeitgesteuerte Überwachung und Anbindung an Tabellen und Workflows.
Preis: Personal $19/Monat bei jährlicher Abrechnung, $228 im Voraus, mit 12,000 Credits pro Jahr.
Kostenlos testen: Tarif Free mit 50 Credits/Monat, 2 Domains und unbegrenzten Robotern.
Browse AI berechnet einen Credit pro Standardseitenbesuch oder pro zehn extrahierte Zeilen; maßgeblich ist der höhere Verbrauch. Eine Listenseite mit 50 Produkten kostet 5 Credits. Werden zusätzlich alle 50 Detailseiten besucht, kommen unter der Annahme von Standardseiten weitere 50 hinzu. Aus „einer Produktliste“ wird damit eine Erfassung für 55 Credits, wenn auch die Details benötigt werden. Premium-Websites können mehr kosten; deshalb sollte die für die Aufgabe angezeigte Gebühr geprüft werden. Browse AI: Preise und Credit-Beispiele.
Die veröffentlichte Staffel bei jährlicher Abrechnung umfasst Free für $0, Personal für $19/Monat mit 12,000 Credits/Jahr, Professional für $69/Monat mit 60,000 Credits/Jahr und Premium ab $500/Monat bei jährlicher Abrechnung. Personal enthält 5 Domains und 3 Nutzer, Professional 10 Domains und 10 Nutzer. Die Jahres-Credits werden im Voraus bereitgestellt. Premium ergänzt einen betreuten Service für Einrichtung, Wartung und Datentransformationen.
Bei monatlicher Abrechnung nennt die Seite für Personal $48/Monat mit 2,000 monatlichen Credits und für Professional $87/Monat mit 5,000. Das jährliche Personal-Angebot für $19 bietet also nicht einfach dasselbe Kontingent zu einem anderen Zahlungstermin. Neben dem Abrechnungszeitraum muss das tatsächliche Kontingent verglichen werden. Professional kostet jährlich $828 im Voraus, Personal $228.
Das Domain-Limit kann früher erreicht sein als das Credit-Limit. Wer wenige Felder auf vielen Lieferanten-Websites prüft, braucht möglicherweise zusätzliche Domains, obwohl kaum Daten anfallen. Bei jährlicher Abrechnung werden zusätzliche Domains für $4/Monat in Personal und $2.40/Monat in Professional angeboten. Aufladungen gibt es für Jahrestarife ab mindestens 1,000 Credits. Personal nennt $0.024/Credit, Professional $0.017-$0.013/Credit.
Bei einem Workflow für Lieferantenpreise sollten Produktkennung und Währung neben dem Preiswert gespeichert werden. Ein Roboter, der eine Zahl extrahiert, entscheidet nicht, ob ein Aktionspreis, Mitgliederpreis oder eine andere Packungsgröße den Einkaufsdatensatz ersetzen soll. Diese Bedeutung liefern die Vergleichsregel und die Warteschlange für manuelle Prüfungen.
- Aufgezeichnete Aufgaben machen die Extraktionsanweisungen für Fachanwender einsehbar.
- Überwachung, API-Zugriff und Webhooks werden tarifübergreifend aufgeführt.
- Integrationen mit Google Sheets, Airtable, Zapier und Make unterstützen gängige operative Abläufe.
- Zusätzliche Domains und Credit-Aufladungen für Jahrestarife können einen Tarif erweitern.
- Listen mit vielen Zeilen und zusätzliche Detailseiten erhöhen gemeinsam den Verbrauch.
- Domain-Grenzen können einen Zusatzkauf nötig machen, bevor die Credits aufgebraucht sind.
- Das günstigste beworbene Jahresangebot hat ein anderes Kontingent als Personal mit monatlicher Abrechnung.
- Bei Website-Änderungen und mehrdeutigen Feldern muss weiterhin jemand das Ergebnis prüfen.
Browse AI passt, wenn die für den Datenbestand verantwortliche Person auch den Roboter anpassen können soll. Eine API ist die bessere Wahl, wenn die Extraktion als Feature im eigenen Produkt läuft und die Entwicklung bereits Zeitplan, Schema und Fehlerbehandlung betreut.
3. Bright Data: erst das Produkt wählen, dann den Preis vergleichen
Bright Data ist ein Webdaten-Anbieter mit Proxy-Netzwerken, vorgefertigten Scraper APIs und Web Unlocker. Er gehört auf die Auswahlliste, wenn der Zugriff auf Zielseiten oder das Erfassungsvolumen den Engpass bildet. Ein E-Commerce-Entwickler kann etwa einen seitenspezifischen Scraper kaufen, der Produktdatensätze liefert. Ein bestehender eigener Scraper benötigt vielleicht stattdessen Residential-Proxys. Diese Käufe übernehmen unterschiedliche Teile der Aufgabe und werden in unterschiedlichen Einheiten abgerechnet.
Geeignet für: Datenerfassung, bei der Zielzugriff, geografischer Standort oder ein gepflegter Scraper für eine bestimmte Website entscheidend sind.
Besonderheit: Getrennte Produkte für Proxys, das Überwinden von Zugriffshürden und strukturierte Datensätze.
Preis: Web Scraper API PAYG $1.5/1K Datensätze; Residential-Proxys PAYG $8/GB vor dem zeitlich begrenzten Gutschein.
Kostenlos testen: Scraper API mit 5K Datensätzen/Monat kostenlos; separater Test für Residential-Proxys.
Scraper API passt, wenn der Datensatz das gewünschte Ergebnis ist. Die seitenspezifischen APIs liefern strukturierte Daten. Proxys, das Überwinden von Zugriffshürden, Parsing, Laufzeit, Speicher und ausgehender Datentransfer werden als enthalten aufgeführt. Die Preisstaffel umfasst Free Tier mit 5K Datensätzen/Monat, PAYG für $1.5/1K Datensätze, Scale für $499/Monat mit 384,000 Datensätzen und $1.3/1K zusätzliche Datensätze sowie Enterprise mit individuellem Preis. Vor der Annahme, dass sämtliche benötigten Felder enthalten sind, sollte das Ein- und Ausgabeschema des jeweiligen Scrapers geprüft werden. Preise der Web Scraper API.
Web Unlocker passt, wenn der eigene Code Unterstützung beim Zugriff braucht. Die Seite nennt automatische Proxy-Verwaltung, Wiederholungsversuche, IP-Rotation und CAPTCHA-Lösung. Free Tier enthält 5K Anfragen/Monat, PAYG kostet $1.5/1K Anfragen. Das angezeigte Scale-Angebot kostet $499/Monat für 383K Anfragen und $1.3/1K zusätzliche Anfragen. Enterprise wird individuell bepreist. Bright Data weist ausdrücklich darauf hin, dass Web Unlocker kein interaktiver Browser ist, der durch einen Workflow navigiert oder klickt. Web Unlocker: Preise und Grenzen.
Residential-Proxys passen, wenn der Scraper selbst erhalten bleiben soll. Die detaillierte PAYG-Preiskarte zeigt $8/GB. Die dreimonatige Aktion RESIGB50 reduziert den Preis auf $4/GB. Die angezeigten monatlichen Aktionspakete kosten $499 mit 141 GB, $999 mit 332 GB und $1,999 mit 798 GB. Oberhalb von 1 TB verweist die Seite auf ein individuelles Angebot. Die Bandbreitenmessung umfasst den zur Zielseite gesendeten und von ihr empfangenen Datenverkehr, nicht nur die am Ende in der Datenbank gespeicherten Datensätze. Preise für Residential-Proxys.
Dieser letzte Unterschied entscheidet über das Budget. Ein Abruf, der Bilder oder andere Seitenressourcen herunterlädt, kann Bandbreite verbrauchen, ohne weitere nützliche Datensätze zu liefern. Eine Datensatz-API berücksichtigt diese Zugriffskosten im beworbenen Datensatzpreis. Bei reinen Proxys bleiben Anfragen, Parsing und Qualitätsprüfung dagegen in eigener Verantwortung. Was ein akzeptierter Angebotseintrag kostet, lässt sich aus dem GB-Preis erst nach Messung des tatsächlichen Workflows ableiten.
Die zentrale Grenze ist der Kauf des falschen Bausteins. Besserer Zugriff über IP-Adressen repariert keinen Parser, der das falsche Feld auswählt. Ein gepflegter Datensatz-Scraper bewahrt wiederum nicht zwangsläufig genau das eigene Extraktionsverhalten, auf das der bestehende Prozess angewiesen ist. Bevor zwei Preise desselben Anbieters verglichen werden, müssen die Anforderungen an die gelieferten Daten feststehen.
- Seitenspezifische Scraper APIs können den Aufwand für eigene Extraktionslogik reduzieren.
- Produkte nach Datensätzen, Anfragen oder Bandbreite lassen die Entwicklung den benötigten Baustein kaufen.
- Der Preis der Scraper API enthält die auf der Produktseite beschriebenen Zugriffs- und Parsing-Kosten.
- Wiederkehrende kostenlose API-Kontingente erlauben die Prüfung unterstützter Zielseiten.
- Die Produktbreite erfordert eine präzise Kaufentscheidung.
- Residential-Datenverkehr wird in GB abgerechnet und garantiert keine gültigen Datensätze.
- Der beworbene Proxy-Aktionspreis gilt nur vorübergehend.
- Web Unlocker ersetzt keinen interaktiven Browser-Workflow.
Bright Data passt, wenn Zugriffsinfrastruktur oder ein geeigneter gepflegter Scraper fehlt. Für einen kleinen Monitor, den das Fachteam betreut, ist Browse AI der direktere Ausgangspunkt. Bei der Aufnahme von Dokumentation sollte die Auswahl mit APIs beginnen, die Seiteninhalte liefern.
4. Context.dev: Agentendaten und Überwachung in derselben API
Context.dev ist eine API für Webkontext. Die eigene Website nennt Scraping, URL-Mapping, Crawling, Batches, Antworten mit Quellen und Monitore. Sie passt zu Entwicklern, die aufbereitete Seiten für Agenten und planmäßige Aktualisierungen in eine Anwendung übernehmen möchten. Ein Assistent auf Dokumentationsbasis kann zunächst die Quellen einlesen und anschließend Monitor-Aktualisierungen über einen Webhook erhalten: eine HTTP-Nachricht, die beim Eintritt eines Ereignisses an die Anwendung gesendet wird. Für diese Aufgabe verdient Context.dev einen Platz neben Firecrawl. Die Anreicherung von Markendaten ist ein zusätzliches Produktangebot, aber kein Auswahlgrund für Scraping.
Geeignet für: Einen Agenten oder ein Produkt, das Seitenextraktion mit Quellenüberwachung per Webhook verbindet.
Besonderheit: Scrape, Map, Crawl, Batches und Monitors in einer API.
Preis: Developer $19/Monat mit 7,500 monatlichen Credits.
Kostenlos testen: Free Tier mit 1,000 Credits/Monat, ohne Kreditkarte und mit 10 Monitoren.
Die Website nennt Markdown, HTML, Screenshots und strukturierte Felder. Rendering und Proxys sind im einfachen Scrape enthalten. Die Monitore prüfen Seiten nach Zeitplan und senden Aktualisierungen an einen Webhook. Das ist eine Integration für Entwickler: Die eigene Anwendung muss die Aktualisierung weiterhin empfangen, prüfen und entscheiden, was nachgelagert geändert wird. Die Zuständigkeit ist damit anders verteilt als bei einem aufgezeichneten Tabellenroboter für Fachanwender. Produktbeschreibung von Context.dev.
Die monatliche Tarifstaffel beginnt mit Free Tier für $0 und 1,000 Credits. Es folgen Developer für $19 mit 7,500, Pro für $99 mit 125,000, Growth für $299 mit 500,000 und Scale für $499 mit 1,000,000. Enterprise wird individuell bepreist und nennt 2,000,000+ Credits/Monat. Die grundlegenden Grenzen für parallele Anfragen steigen von 1 bei Free auf 10 bei Developer, 100 bei Pro, 250 bei Growth und 500 bei Scale. Context.dev-Preise.
Ein Standard-Scrape verbraucht 1 Credit. Erfolgreiche JSON-Extraktion kostet zusätzlich 4, insgesamt also 5 Credits pro Standardseite. Browser-Aktionen erhöhen den einfachen Scrape vor der Extraktion auf 2. Dass Rendering und Proxys enthalten sind, bedeutet daher nicht, dass jede Anfrage einen Credit kostet. Die 7,500 Credits von Developer reichen für 1,500 Standardseiten mit JSON, sofern sie ausschließlich dafür verwendet werden.
Für neue Abonnements kosten Aufladungen pro 1,000 Credits $2.20 bei Developer, $1.80 bei Pro, $1.40 bei Growth und $1.00 bei Scale. Abgerechnet wird in Blöcken von 1,000 Credits. Bestehende Abonnements behalten ihre Preise. So lässt sich ein kleiner Tarif mit Aufladungen gegen einen größeren Tarif rechnen, statt allein wegen eines aufgebrauchten Kontingents zu wechseln.
Die konkrete Crawl-Grenze liegt bei 500 Seiten pro Crawl-Aufruf. Größere Websites nutzen Batches im Crawl-Modus. Das Einlesekonzept muss entsprechend aufgeteilt werden. Bevor ein Batch als abgeschlossen gilt, müssen seine Ergebnisse im eigenen Speicher angekommen sein. Ein Erfassungsendpunkt und eine dauerhafte Wissensbasis sind unterschiedliche Teile der Architektur.
Die andere Grenze sind nur teilweise erfolgreiche Ausgaben. Context.dev berechnet nach eigenen Angaben die meisten fehlgeschlagenen Anfragen nicht. Antworten für nicht gefundene Seiten werden aber berechnet, und eine Antwort kann neben einer erfolgreichen Ausgabe auch fehlgeschlagene Ausgaben enthalten. Deshalb sollten die zurückgegebenen Ausgaben und key_metadata.credits_consumed geprüft werden. Ein äußerer Erfolgsstatus ist kein Beleg für einen vollständigen Datensatz.
- Seiteninhalte und zeitgesteuerte Webhook-Überwachung passen in denselben Workflow für Agentendaten.
- Rendering und Proxys sind im Preis des einfachen Scrapes enthalten.
- Der wiederkehrende Gratistarif enthält ein kleines Monitor-Kontingent.
- Veröffentlichte Aufladungsblöcke ermöglichen eine konkrete Kostenplanung für kleine Aufgaben.
- JSON-Extraktion und Browser-Aktionen erhöhen den Credit-Verbrauch.
- Ein einzelner Crawl-Aufruf ist begrenzt; größere Quellen erfordern Batches.
- Webhook-Zustellung braucht weiterhin Anwendungslogik und Speicher.
- Teilergebnisse und kostenpflichtige Antworten für nicht gefundene Seiten müssen geprüft werden.
Context.dev passt, wenn diese API-Funktionen und das Credit-Budget zum eigenen Agenten passen. Der Vergleich mit Firecrawl sollte dieselben repräsentativen Quellen und dasselbe Ausgabeschema verwenden. Das größere Einstiegskontingent allein begründet keine Aussage über eine bessere Qualität.
5. Apify: besonders stark, wenn der passende Actor schon existiert
Apify ist eine Cloud-Plattform für wiederverwendbare Scraping- und Automatisierungsprogramme, sogenannte Actors. Sie ist eine gute Wahl, wenn für die Zielseite bereits ein geeigneter, gepflegter Actor existiert. Dessen Extraktionslogik kann wertvoller sein als ein allgemeiner Abrufendpunkt. Ein Fachanwender, der einen Datenbestand aus einem Branchenverzeichnis aktualisiert, kann die Eingaben des Actors konfigurieren, die Aufgabe speichern und wiederkehrende Durchläufe planen. Die entscheidende Grenze liegt im Verhalten und der Abrechnung des ausgewählten Actors, nicht allein im Plattformabo.
Geeignet für: Eine bestimmte Zielseite oder Extraktionsaufgabe, die bereits ein passender Actor abdeckt.
Besonderheit: Wiederverwendbare Cloud-Programme mit Zeitplanung und Integrationen.
Preis: Starter $19/Monat + nutzungsabhängige Abrechnung, einschließlich $19 Nutzungsguthaben.
Kostenlos testen: Tarif Free mit $5/Monat Nutzungsguthaben, ohne Kreditkarte.
Apifys Tarif Free kostet $0 und enthält $5 für die Nutzung des Stores oder der Plattform. Starter kostet $19/Monat + nutzungsabhängige Abrechnung mit $19 inklusive, Scale $199 mit $199 inklusive und Business $999 mit $999 inklusive. Enterprise wird individuell bepreist. Rechenleistung kostet bei Free und Starter $0.2 pro Compute Unit, bei Scale $0.16 und bei Business $0.13. Eine Compute Unit entspricht einem GB RAM für eine Stunde. Apify-Preise.
Das enthaltene Dollar-Guthaben ist kein festes Seitenkontingent. Der gewählte Actor kann einen eigenen Preis haben. Plattformressourcen, Proxys, Speicher und Datentransfer beeinflussen je nach Aufgabe ebenfalls die Rechnung. Verglichen werden sollte der vollständige Durchlauf, der akzeptierte Datensätze liefert, nicht nur der attraktive Einstiegspreis eines Marktplatzprogramms.
In einem ausdrücklich hypothetischen Beispiel, das nur Rechenleistung berücksichtigt, verbraucht ein GB RAM über zehn Stunden zehn Compute Units. Auf Starter kostet das $2 an Rechenleistung. Daraus lässt sich weder die Zahl gelieferter Einträge noch die Höhe weiterer Gebühren ableiten. Selbst die Aussage, dass $19 für 95 Compute Units reichen, setzt voraus, dass das gesamte Guthaben für Rechenleistung verwendet wird. Eine praktische Scraping-Aufgabe erfüllt diese Annahme möglicherweise nicht.
Apifys Zeitplanung kann gespeicherte Aufgaben in einer gewählten Zeitzone ausführen und Webhook-Benachrichtigungen senden. Laut Dokumentation sind neue Zeitpläne standardmäßig deaktiviert. Einen Zeitplan zu speichern, beweist deshalb noch nicht, dass der nächste Durchlauf stattfindet. Aktivierungsstatus und angezeigter nächster Ausführungstermin müssen geprüft werden. Apify-Dokumentation zur Zeitplanung.
Beim Beispiel mit dem Branchenverzeichnis sollten vor der Entscheidung Seitennavigation, geografische Abdeckung, Ausgabekennungen und Wartungshistorie des Actors geprüft werden. Ein Actor, der eine Kategorienliste erfasst, reichert nicht zwangsläufig jedes darin genannte Unternehmen um sämtliche Felder an, die das CRM erwartet. Stichproben akzeptierter und abgewiesener Datensätze helfen bei der Prüfung; fehlende Felder müssen sichtbar bleiben.
- Ein passender Actor kann die Extraktionslogik für eine bestimmte Zielseite bereitstellen.
- Gespeicherte Aufgaben und Zeitpläne unterstützen die wiederkehrende Erfassung.
- Der Marktplatz enthält auch Crawling-Workflows für Seiteninhalte.
- Das enthaltene Nutzungsguthaben lässt bei kleinen Aufgaben eine Prüfung des gesamten Durchlaufs zu.
- Es gibt keinen allgemeingültigen Apify-Preis pro Seite oder Datensatz.
- Actor-spezifische Gebühren können wichtiger sein als der Plattformtarif.
- Ein- und Ausgabe der Aufgabe müssen weiterhin anhand der Anforderungen an den eigenen Datenbestand geprüft werden.
- Ein neuer Zeitplan muss aktiviert werden, bevor man sich auf ihn verlassen kann.
Apify passt, wenn der Actor spürbar Extraktionsarbeit übernimmt und die Kosten des gesamten Durchlaufs akzeptabel sind. Eine direkte Scraping-API ist sinnvoller, wenn die Aufgabe im Wesentlichen „diese bekannten Seiten abrufen“ lautet und der Marktplatz zusätzliche Komplexität schafft, ohne Arbeit zu sparen.
6. ScrapingBee: verwalteter Abruf mit klaren Credit-Multiplikatoren
ScrapingBee ist eine Scraping-API, die Rendering und Proxy-Optionen für einen von Entwicklern betreuten Extraktionsworkflow übernimmt. Sie passt, wenn Parsing und Zeitplanung im eigenen Code bleiben sollen, schwierige Zugriffsaufgaben aber ausgelagert werden. Ein Dienst für Produktdaten kann beispielsweise eine gerenderte Seite anfordern und seine bestehenden Feldregeln auf den zurückgegebenen Inhalt anwenden. Für das Budget zählt zuerst der Credit-Verbrauch der Einstellungen, die auf der Zielseite tatsächlich funktionieren.
Geeignet für: Entwickler, die ihre eigene Extraktionslogik behalten und die Abrufschicht ersetzen möchten.
Besonderheit: Steuerung von Rendering und Proxys sowie Auto-Mode mit maximalen Credit-Kosten.
Preis: Freelance $49/Monat mit 250,000 API-Credits.
Kostenlos testen: 1,000 API-Credits, ohne Kreditkarte; kein wiederkehrender Gratistarif ausgewiesen.
Die vollständige veröffentlichte Tarifstaffel umfasst Freelance für $49/Monat mit 250,000 Credits, Startup für $99 mit 1,000,000, Business für $249 mit 3,000,000 und Business + für $599 mit 8,000,000. Enterprise 14 kostet $999 für 14,000,000, Enterprise 24 $1,599 für 24,000,000, Enterprise 41 $2,399 für 41,000,000 und Enterprise 69 $3,599 für 69,000,000. Höhere Kapazitäten werden mit dem Anbieter besprochen. Die Preise verstehen sich ohne Mehrwertsteuer. ScrapingBee-Preise.
Abgerechnet werden Credits, keine Anfragen. Die dokumentierten Abrufkosten betragen 1 Credit für einen klassischen Proxy ohne JavaScript, 5 mit JavaScript, 10 für einen Premium-Proxy ohne JavaScript, 25 für einen Premium-Proxy mit JavaScript und 75 für einen Stealth-Proxy mit JavaScript. KI-Extraktion kostet zusätzlich 5 Credits. JavaScript-Rendering ist standardmäßig aktiviert. ScrapingBee: Kosten pro Anfrage.
Die 250,000 Credits von Freelance reichen somit höchstens für 50,000 klassische JavaScript-Anfragen, 10,000 Premium-JavaScript-Anfragen oder 3,333 vollständige Stealth-JavaScript-Anfragen, wenn sämtliche Credits nur für die jeweilige Konfiguration verwendet werden. Das sind Berechnungen aus dem Kontingent, keine gemessenen Erfolgsquoten. Weitere Features und unterschiedliche Zielseiten verändern die Rechnung.
Auto-Mode kann Konfigurationen ausprobieren und diejenige berechnen, die erfolgreich ist. Scheitern sämtliche Konfigurationen, fällt keine Gebühr an. Die Einstellung max_cost begrenzt, welche Konfigurationen versucht werden dürfen. Laut Dokumentation wählt Auto-Mode aber nicht automatisch seitenspezifische Warte- oder Klickanweisungen. Wird der benötigte Preis erst nach einer Auswahl oder nach asynchronem Laden sichtbar, muss dieses Verhalten weiterhin selbst festgelegt werden. Auto-Mode-Dokumentation.
Dort liegt die Grenze: Die Abrufkonfiguration legt nicht fest, welche Daten gemeint sind. Eine korrekte HTML-Antwort kann einen leeren Platzhalter, den Preis einer voreingestellten Region oder eine Auswahl enthalten, die der eigene Kunde nicht treffen würde. Die Antwort sollte als Prüfgrundlage erhalten bleiben. Entscheidend ist die Prüfung des fachlich relevanten Felds, nicht allein ein erfolgreicher API-Aufruf.
- Passt zu einem eigenen Scraper, dessen Parsing und Zeitplanung im eigenen Code bleiben sollen.
- Für Rendering- und Proxy-Einstellungen sind die Credit-Kosten veröffentlicht.
- Auto-Mode kann die Kosten einer Zugriffskonfiguration begrenzen.
- Parallelität und Kapazität steigen über eine ausdrücklich ausgewiesene Tarifstaffel.
- Dasselbe beworbene Credit-Kontingent ermöglicht sehr unterschiedliche Anfragemengen.
- KI-Extraktion verursacht zusätzliche Credit-Kosten.
- Auto-Mode liefert keine seitenspezifischen Warte- oder Klickeinstellungen.
- Das kostenlose Angebot ist ein Test, kein dauerhaftes Kontingent für zeitgesteuerte Aufgaben.
ScrapingBee passt, wenn Kontrolle über die Anfrage wichtig ist und bereits klar ist, wie die Antwort geprüft wird. Eine Datensatz-API oder ein geeigneter Apify Actor ist vorzuziehen, wenn gerade die Pflege der Extraktionsregeln für die Zielseite abgegeben werden soll.
7. Octoparse: visuelle Aufgaben, Cloud-Zeitplanung im kostenpflichtigen Tarif
Octoparse ist eine visuelle Scraping-Anwendung für Fachanwender, die Extraktionsaufgaben selbst gestalten und pflegen möchten. Sie eignet sich für die wiederkehrende Erfassung von Katalogen oder Angebotseinträgen, wenn ein Aufgabenbaukasten statt einer API-Integration benötigt wird. Ein Einkaufsanalyst kann Listen- und Detailfelder festlegen und den geprüften Workflow anschließend in die kostenpflichtige Cloud-Ausführung überführen. Der Tarif Free ist für die lokale Erprobung nützlich. Für einen unbeaufsichtigten Datenstrom ist er jedoch die falsche Planungsgrundlage.
Geeignet für: Fachanwender, die visuelle Extraktionsaufgaben erstellen und bei Bedarf Cloud-Ausführung hinzukaufen.
Besonderheit: Aufgabenbasiertes Scraping mit kostenpflichtiger Cloud-Zeitplanung und automatischem Export.
Preis: Standard ab $69/Monat bei jährlicher Abrechnung.
Kostenlos testen: Tarif Free mit 10 lokalen Aufgaben und 50,000 exportierten Zeilen/Monat.
Free umfasst 10 Aufgaben, Ausführung auf dem lokalen Gerät, bis zu 10,000 Zeilen pro Export und 50,000 exportierte Zeilen pro Monat. Standard ergänzt Cloud-Extraktion, Zeitplanung, automatischen Export und die Data Export API, mit 100 Aufgaben und bis zu 3 parallelen Cloud-Prozessen. Professional erlaubt 250 Aufgaben und bis zu 20 parallele Cloud-Prozesse und enthält zusätzlich die Advanced API sowie weitere Unterstützung. Enterprise nennt 750+ Aufgaben und 40+ parallele Cloud-Prozesse. Octoparse-Tarife im Detail.
Die veröffentlichte Tarifstaffel lautet Free für $0, Standard ab $69/Monat, Professional für $249/Monat und Enterprise mit individuellem Preis. Beide kostenpflichtigen Preisangaben gelten bei jährlicher Abrechnung. Die monatlichen Vergleichspreise sollten als Jahresangebote behandelt werden. Für die Liquiditätsplanung muss der Rechnungsbetrag vor dem Kauf im Checkout bestätigt werden. Octoparse-Preise.
Die Abrechnung erfolgt über ein Abo mit Aufgaben- und Prozessgrenzen, nicht über einen einheitlichen Credit pro Anfrage. Das kann passen, wenn innerhalb einer überschaubaren Anzahl von Aufgaben viele Daten extrahiert werden. „Unbegrenzter Datenexport“ in kostenpflichtigen Tarifen bedeutet allerdings keine unbegrenzte parallele Cloud-Ausführung. Die drei gleichzeitigen Cloud-Prozesse von Standard können zum Engpass werden, lange bevor 100 gespeicherte Aufgaben erreicht sind.
Zusatzangebote werden separat berechnet. Die Preisseite nennt Residential-Proxys für $3/GB, CAPTCHA-Lösung für $1-1.5 pro tausend und ergebnisabhängig berechnete Vorlagen für $0.001-3 pro tausend Ergebnisse. Ein kostenpflichtiges Abo macht also nicht sämtliche erweiterten Zugriffskosten zu kostenlosen Inklusivleistungen.
Ein Workflow für Lieferantenkataloge sollte lokal mit einer kleinen Aufgabe beginnen und prüfen, ob Listen- und Detaildaten vollständig erfasst werden. Danach ist zu klären, wie die Cloud-Ausführung dieselben Eingaben verarbeitet, wo der Export landet und wer einen Fehler bemerkt. Auch ein Analyst, der die Aufgabe erstellen kann, braucht eine feste Routine zur Kontrolle der erwarteten Datensätze.
- Die visuelle Aufgabengestaltung passt zu Fachanwendern, die Extraktionsanweisungen selbst betreuen möchten.
- Kostenlose lokale Aufgaben erlauben die Erprobung vor dem Kauf einer Cloud-Ausführung.
- Standard enthält ausdrücklich Zeitplanung und automatischen Export.
- Aufgaben- und Cloud-Prozessgrenzen machen die Ausführungsgrenzen sichtbar.
- Die kostenlose Ausführung läuft lokal und liefert damit nicht den benötigten unbeaufsichtigten Cloud-Prozess.
- Das Exportvolumen kostenpflichtiger Tarife hebt Aufgaben- oder Parallelitätsgrenzen nicht auf.
- Zusatzangebote für Proxys, CAPTCHA und Vorlagen können weitere Verbrauchskosten verursachen.
- Der Einstiegspreis setzt jährliche Abrechnung voraus.
Octoparse passt, wenn die visuelle Aufgabengestaltung einen konkreten Vorteil bietet und die Cloud-Prozessgrenzen mit dem Zeitplan vereinbar sind. Browse AI ist die direktere erste Option für einen aufgezeichneten Monitor. Eine API passt besser, wenn die Extraktion Bestandteil eines Softwareprodukts ist.
8. Zyte: Zugriffspreise nach Schwierigkeit der Zielseite
Zyte ist ein Webdaten-Anbieter. Die Zyte API berechnet erfolgreiche Antworten danach, wie schwierig die Zielseite ist und ob HTTP-Inhalt oder Browser-Rendering angefordert wird. Sie passt zu Entwicklern, die eine Datenerfassung betreiben und automatische Zugriffssteuerung nutzen möchten, ohne selbst einen Proxy-Bestand zu kaufen. Ein Dienst für Angebotseinträge kann den eigenen Datenbestand und das Parsing behalten und zugleich den tatsächlich benötigten Antwortmodus jeder Zielseite budgetieren. Der niedrigste Preis ist nur aussagekräftig, wenn auch die zugehörige Mindestabnahme und Schwierigkeitsstufe genannt werden.
Geeignet für: Eine von Entwicklern betreute Datenerfassung mit zielseitenspezifischem Zugriffsbudget.
Besonderheit: Abrechnung erfolgreicher Antworten mit getrennten HTTP- und Browser-Preisen.
Preis: PAYG HTTP $0.13-$1.27 pro 1,000; Browser $1.01-$16.08 pro 1,000.
Kostenlos testen: $5 Guthaben für 30 Tage, ohne Abnahmeverpflichtung; kein wiederkehrender Gratistarif ausgewiesen.
Die PAYG-HTTP-Preise für die Zielstufen Simple, Easy, Moderate, Complex und Advanced betragen $0.13, $0.23, $0.44, $0.70 und $1.27 pro 1,000 Antworten. Die PAYG-Browser-Preise lauten $1.01, $2.01, $4.02, $8.04 und $16.08. Dasselbe Anfragevolumen kann daher je nach Zielseite und Bedarf an gerendertem Inhalt sehr unterschiedliche Rechnungen erzeugen. Zyte-Preise.
Monatliche Abnahmeverpflichtungen senken diese Preise. Bei einer Verpflichtung über $100 werden HTTP-Preise von $0.10-$0.95 und Browser-Preise von $0.75-$12.00 pro 1,000 genannt. Bei $200 liegen die Spannen bei $0.08-$0.76 und $0.60-$9.60, bei $500 bei $0.06-$0.61 und $0.48-$7.68. Enterprise-Preise werden über den Vertrieb vereinbart. Die Angabe „ab $0.06“ auf der Seite gehört zur Staffel mit Abnahmeverpflichtung und ist nicht der PAYG-Einstiegspreis für HTTP.
Bei beispielhaften 100,000 erfolgreichen Antworten ergibt der Simple-PAYG-HTTP-Preis $13 an Nutzungskosten. Mit dem Simple-Browser-Preis sind es $101, mit dem Advanced-Browser-Preis $1,608. Das sind Berechnungen anhand veröffentlichter Preise, keine Aussage darüber, in welche Stufe die eigene Zielseite fällt. Erweiterte Features können zusätzliche Gebühren verursachen. Daher sollte der seitenspezifische Kostenrechner des Anbieters mit dem vorgesehenen Ausgabemodus verwendet werden.
Die entscheidende Grenze sind die Kosten der jeweiligen Zielseite. Für ein einfaches HTTP-Ziel und eine anspruchsvolle gerenderte Zielseite sollte nicht derselbe Seitenpreis angenommen werden. Die URL-Liste wird nach Zielseite und Modus aufgeteilt, die Zahl akzeptierter Antworten gespeichert und die Staffel mit Abnahmeverpflichtung anhand dieser Mischung verglichen.
Erfolgreicher Zugriff lässt die Verantwortung für die Extraktion dennoch beim eigenen Team. Der Parser braucht weiterhin die richtige Eintragskennung, die richtigen Felder und Vollständigkeitsprüfungen. Liefert eine gepflegte Datensatz-API oder ein Actor bereits den benötigten Datenbestand, rechtfertigt der niedrigere Zugriffspreis allein möglicherweise nicht die Pflege einer eigenen Extraktion.
- Getrennte HTTP- und Browser-Preise ermöglichen ein präzises Budget für jede Zielseite.
- Fünf Schwierigkeitsstufen zeigen Unterschiede, die ein pauschaler Einstiegspreis verdecken kann.
- Monatliche Abnahmeverpflichtungen bieten eine sichtbar ausgewiesene Preisstaffel.
- Die API nennt Rendering, IP-Rotation und Geolokalisierung als Funktionen.
- Der günstigste beworbene Preis setzt eine monatliche Abnahmeverpflichtung voraus.
- Browser-Rendering kann die Kosten erheblich verändern.
- Erweiterte Features können zusätzlich kosten.
- Die Antwort muss weiterhin geparst und fachlich geprüft werden.
Zyte passt, wenn der Entwicklungsworkflow verwalteten Zugriff benötigt und die Mischung der Zielseiten messen kann. Ausgangspunkt sollte die PAYG-Schätzung sein, statt allein für die kleinste angezeigte Zahl eine Abnahmeverpflichtung einzugehen.
Was regelmäßig abgerufene Webdaten kosten
Vor dem Vergleich der Einstiegspreise müssen wiederkehrende Arbeit und Ausgabeformat gezählt werden. Das folgende Planungsbeispiel legt die Annahmen ausdrücklich offen: Ein Gründer besucht 120 bekannte Seiten täglich über einen Monat mit 30 Tagen. Das ergibt 3,600 Seitenbesuche. Angenommen werden gewöhnliche Seiten, keine zusätzlichen Browser-Aktionen, keine Aufrufe zur URL-Suche, keine Gebühren für Monitor-Endpunkte und keine kostenpflichtigen Wiederholungsversuche. Das ist eine Budgetrechnung, keine gemessene Aufgabe und keine Zusage zum Zugriff auf die Zielseiten.
Bei einfachen Markdown-Scrapes verbrauchen diese 3,600 Besuche sowohl bei Firecrawl als auch bei Context.dev 3,600 Credits. Firecrawl Hobby enthält 5,000 Credits für $19/Monat, Context.dev Developer 7,500 für $19/Monat. Beide monatlichen Einstiegstarife decken das festgelegte Scraping-Volumen ab. Firecrawl, Context.dev.
Wird auf denselben Standardseiten erfolgreich strukturiertes JSON angefordert, steigt der Bedarf bei beiden auf 18,000 Credits. Firecrawl Hobby braucht 13 zusätzliche Blöcke mit jeweils 1,000 Credits für $5: $19 + $65 = $84/Monat. Context.dev Developer braucht zum veröffentlichten Aufladungspreis für neue Abonnements 11 zusätzliche Blöcke mit jeweils 1,000 Credits für $2.20: $19 + $24.20 = $43.20/Monat. Durch die Aufrundung auf ganze Blöcke bleiben in der Context.dev-Rechnung einige Credits übrig.
Ein No-Code-Monitor braucht dieselbe Rechnung aus Häufigkeit und Umfang. Bei Browse AI werden aus 3,600 Standardseitenprüfungen/Monat 43,200/Jahr, bevor größere Zeilenmengen oder Premium-Ziele berücksichtigt werden. Die 60,000 Jahres-Credits von Professional reichen für dieses Beispielvolumen, die 12,000 von Personal nicht. Bei monatlicher Abrechnung enthält Professional 5,000 Credits für $87. Bei jährlicher Abrechnung kostet Professional $69/Monat mit $828 Vorauszahlung. Browse AI.
Für reine Proxys braucht es eine andere Kalkulation. Ausgangspunkt sind gemessene GB. Hinzu kommen Hosting des Scrapers, Extraktionsarbeit und Fehlerbehandlung. Eine Datensatz-API beginnt bei den abrechenbaren gelieferten Datensätzen, Apify beim gewählten Actor und dessen Ressourcenverbrauch. Ohne Messung der tatsächlichen Aufgabe sollte daraus kein versprochener Seitenpreis abgeleitet werden.
Welches Tool passt zu welchem Team?
Entscheidend ist, ob Seiteninhalte, ein vom Fachteam betreuter Monitor, fertige Datensätze für eine bestimmte Zielseite oder Zugriff für bereits selbst gepflegten Code benötigt werden. Ein kostenpflichtiges Upgrade sollte den erreichten Engpass beheben. Eine längere Feature-Liste allein ist kein Kaufgrund.
Wer kümmert sich um den nächsten fehlgeschlagenen Durchlauf?
Liegt das Datenfeature in der Verantwortung der Entwicklung, kommen APIs auf die Auswahlliste, die die benötigten Inhalte und Metadaten liefern. Liegt ein tabellenbasierter Prozess beim operativen Team, passen visuelle Roboter, deren Arbeitsweise sich dort prüfen lässt. Ist bislang niemand für Fehler zuständig, muss diese Rolle vor einer höheren Erfassungsfrequenz vergeben werden.
Mit der Zuständigkeit ändert sich die Tool-Wahl. Für einen Entwickler kann eine Scraping-API der passende Produktbaustein sein. Für einen Fachanwender, der täglich ein Ergebnis braucht und keine Anwendung zum Empfangen der Daten hat, kann dieselbe API der falsche Kauf sein. Umgekehrt lässt sich eine aufgezeichnete Aufgabe schnell ausprobieren, kann aber hinderlich werden, sobald die Extraktion zu einem zentralen Produktfeature wird.
KI beim Web Scraping braucht ein Schema und klare Annahmekriterien
Extraktion sollte als verbindliche Vereinbarung über die Daten behandelt werden. Für einen Preisdatensatz werden Produktkennung, Variante, numerischer Betrag, Währung, Quell-URL und Erfassungszeit festgelegt. Schon vor der ersten automatischen Aktualisierung muss klar sein, wie fehlende oder mehrdeutige Werte behandelt werden. Ein sauberes JSON-Objekt beschreibt das Format. Ob der Datensatz fachlich korrekt ist, entscheidet die Prüfung anhand dieser Anforderungen.
Bei der Dokumentenaufnahme sollten Quelle und Abrufzeit erhalten bleiben. Unwichtige, wiederholte Navigation kann gegebenenfalls ausgeschlossen werden. Wird eine Seite von einer automatischen Prüfung abgewiesen, bleibt die Originalantwort gespeichert. Diese Prüfgrundlage hilft der zuständigen Person zu unterscheiden, ob sich die Website geändert hat oder ein Feld falsch definiert wurde.
Welcher KI-Web-Scraper passt zu einem Agenten?
Firecrawl ist der Ausgangspunkt für einen seitenorientierten Workflow mit Scrape, Crawl und Map. Context.dev gehört zusätzlich auf die Auswahlliste, wenn die Kombination aus Batches und Webhook-Überwachung zur Anwendung passt. Erfasst ein geeigneter Apify Actor bereits die benötigten Felder der Zielseite, sollte dieser vollständige Durchlauf gemeinsam mit den allgemeinen Seiten-APIs geprüft werden.
Die Auswahl erfolgt mit einem festen Quellenbestand und identischen Anforderungen an die Ausgabe. Dazu gehören eine gewöhnliche Seite, eine gerenderte Seite, eine Listen-Detail-Beziehung und eine Seite mit einem mehrdeutigen Feld. Ein Einstiegskontingent ist ein Kostenfaktor, kein Beleg dafür, dass ein Dienst bessere Daten liefert.
Web Scraping mit Python: welche Tools eignen sich für geplante Abrufe?
Ein Python-Workflow kann eine API aufrufen und Zeitplanung, Parsing, Speicherung und Validierung in der eigenen Anwendung behalten. Firecrawl oder Context.dev passen, wenn Seiteninhalte oder verwaltete strukturierte Extraktion benötigt werden. ScrapingBee oder Zyte passen, wenn das Parsing unter eigener Kontrolle bleiben soll und der Abruf ersetzt werden muss.
Die zusätzliche Kontrolle bringt Betriebsaufwand mit sich. Transportfehler, Fehlerseiten der Zielwebsite, fehlende Felder und fachlich abgewiesene Datensätze müssen klar unterschieden werden. Nicht jede Kategorie sollte blind erneut versucht werden: Eine falsche Extraktionsregel wird nicht dadurch besser, dass dieselbe Anfrage noch einmal läuft.
Web Scraping kostenlos: entscheidend ist ein wiederkehrendes Kontingent
Firecrawl und Context.dev werben jeweils mit 1,000 monatlichen Credits. Browse AI bietet 50 monatliche Credits über 2 Domains. Apify stellt $5/Monat an Nutzungsguthaben bereit, Bright Data Scraper API 5K Datensätze/Monat. Damit sind kleine Erprobungen oder überschaubare wiederkehrende Aufgaben möglich, sofern der benötigte Vorgang in das Kontingent passt.
Wird eine einzelne Standardseite täglich in einem Monat mit 30 Tagen geprüft, decken die 50 Credits von Browse AI die 30 Prüfungen ab. Das ist ein brauchbares Beispiel für einen kostenlosen Monitor, solange die Seite kein Premium-Ziel ist und die Zahl extrahierter Zeilen den Verbrauch nicht erhöht. Die 1,000 Credits von ScrapingBee und die $5 von Zyte sind Testangebote; Octoparse Free läuft lokal. Diese Unterschiede sind wichtiger als das Etikett „kostenlos“.
Open-Source-Scraping: was Teams selbst betreiben müssen
Der selbst betreibbare Kern von Firecrawl kommt infrage, wenn Kontrolle über Quellcode oder Infrastruktur den Betrieb der Dienste rechtfertigt. Open Source spart für diesen Kern das Anbieterabo. Hosting, Überwachung, Wiederherstellung und einen Entwickler für den nächsten Fehler liefert es jedoch nicht mit.
Der Leitfaden zum Firecrawl-Self-Hosting hilft, diese Betriebsgrenze zu beurteilen, bevor Self-Hosting als günstigster Weg zum Scraping gilt. Ein kleines Produktteam, das lediglich einen Endpunkt zum Abrufen bekannter Seiten braucht, kann mit verwalteten Einstiegstarifen ein eigenes Infrastrukturprojekt vermeiden. Für Self-Hosting sollten ein konkreter Kontrollbedarf und eine dauerhaft zuständige Person sprechen.
So entstand die Auswahl
Der Vergleich gewichtet Aufgabeneignung, transparente Abrechnung und die Grenze, an der sich die Kaufentscheidung ändert. Für diesen Vergleich wurden Preisseiten und relevante Anbieterdokumentationen geöffnet; die Preisangaben wurden am 6. Oktober 2026 geprüft. Die Kostenbeispiele sind Berechnungen aus diesen veröffentlichten Preisen und ausdrücklich genannten Annahmen zum Arbeitsumfang. Es fand kein praktischer Produkttest statt. Eine Rangfolge nach Geschwindigkeit, Genauigkeit oder Erfolgsquote wird nicht behauptet.
Firecrawl, Bright Data, Browse AI und Context.dev sind Partner-Tools dieser Website. Apify, ScrapingBee, Octoparse und Zyte bieten unabhängige Alternativen. Ein Partnerstatus macht reine Proxys nicht zum passenden Kauf für einen Monitor im Fachteam und einen aufgezeichneten Roboter nicht zur richtigen API für ein Softwarefeature. Die Empfehlungen richten sich nach diesen Einsatzgrenzen.
Die praktischen Kriterien lauten: Liefert das Produkt die benötigte Ausgabe? Wer ist für Einrichtung und Reparatur zuständig? Welcher wiederholte Vorgang wird berechnet? Welches Kontingent oder Parallelitätslimit wird zuerst erreicht? Und was passiert mit einer unvollständigen oder abgewiesenen Antwort? Ein größerer Marktplatz oder ein niedrigerer Lockpreis beantwortet diese Fragen allein nicht.
Frameworks und Browser-Bibliotheken wurden aus der bewerteten Auswahlliste herausgehalten, weil es hier um einen wiederkehrenden Dienst, einen No-Code-Workflow oder Zugriffsinfrastruktur geht. Interaktive Browser-Bedienung ist eine eigene Anforderung, wenn eine Aufgabe umfangreiche Navigation statt der Erfassung von Seiten verlangt.
Vor der zeitgesteuerten Erfassung sollten die Nutzungsbedingungen und robots.txt der Zielwebsite geprüft werden.
Diese Fehlentscheidungen vermeiden
Auch ein gutes Produkt kann für die konkrete Aufgabe falsch sein. Die folgenden Entscheidungen erzeugen besonders leicht genau die Arbeit, die der Kauf abnehmen sollte.
- Octoparse Free für einen unbeaufsichtigten Cloud-Datenstrom. Die Aufgaben laufen lokal. Benötigt der Prozess Cloud-Ausführung, muss diese bezahlt oder ein Dienst mit passendem Betriebsmodell gewählt werden.
- Residential-Proxys von Bright Data als Kauf eines fertigen Datenbestands. Sie liefern Zugriff. Anfragen, Parsing und Annahmeprüfung bleiben in eigener Verantwortung. Soll der Datensatz gekauft werden, passt eine geeignete Scraper API.
- Der jährliche Einstiegspreis von Browse AI Personal für einen großen, häufig laufenden Monitor. Die 12,000 Jahres-Credits reichen nicht für die beispielhafte Aufgabe mit 43,200 Credits pro Jahr. Besuche, Zeilen, Premium-Ziele und Domains müssen zuerst kalkuliert werden.
- Zytes Angabe $0.06 als PAYG-Preis. Sie ist das untere Ende der Stufe mit $500 Abnahmeverpflichtung. Vor deren Kauf sollten die tatsächliche Zielseite und der Modus kalkuliert werden.
- ScrapingBees Credit-Kontingent als Garantie für eine bestimmte Anfragemenge. Rendering- und Proxy-Einstellungen können für dieselbe Anfrage mehrere Credits verbrauchen. Budgetiert werden muss die funktionierende Konfiguration.
- Firecrawl oder Context.dev als vollständiges System für Datenqualität. Beide können Inhalte liefern, die abgewiesen werden müssen. Status und Ausgabe sollten als Prüfgrundlage gespeichert und nachgelagerte Datensätze vor unvollständigen Aktualisierungen geschützt werden.
Zu vermeiden ist das Produkt, bei dem genau der Baustein selbst gepflegt werden muss, den es eigentlich übernehmen sollte. Eine präzise Grenze hilft mehr als eine selbstsichere Gesamtrangliste.
Der nächste Schritt für Montag
Eine kleine, zeitgesteuerte Erprobung mit klarer Zuständigkeit aufsetzen. Dafür werden zehn repräsentative URLs ausgewählt, die erwarteten Felder oder Dokumentinhalte definiert und die Gründe festgelegt, aus denen eine Antwort unbrauchbar wäre. Bei einer No-Code-Aufgabe wird der Workflow aufgezeichnet. Bei einer API wird sie mit Zeitsteuerung und Speicher verbunden.
Sieben Tage lang läuft die Aufgabe einmal täglich. Originalantwort, Status der Zielseite, Ausgabe, verbrauchte Abrechnungseinheiten und Zahl akzeptierter Datensätze bleiben gespeichert. Geprüft werden Seitennavigation, fehlende Werte, doppelte Kennungen und Änderungen, die eine Aktualisierung auslösen sollen oder eben nicht.
Anschließend wird der ganze Monat anhand der beobachteten Mischung von Zielseiten kalkuliert. Gewählt wird die am wenigsten komplexe Option, die die Anforderungen an Ausgabe und Zuständigkeit erfüllt. Die Annahmeprüfungen bleiben auch nach der Erprobung bestehen. Ein Datenstrom ist durch wiederholbar nützliche Ergebnisse produktionsreif, nicht durch seine erste erfolgreiche Anfrage.
Welche Tools eignen sich für Web Scraping?
Firecrawl und Context.dev passen zu Seiteninhalten für Agenten, Browse AI und Octoparse zu visuellen Extraktionsworkflows. Bright Data, Zyte und ScrapingBee decken unterschiedliche Anforderungen an Zugriff und Abruf ab. Apify ist besonders nützlich, wenn für die Zielseite bereits der passende Actor existiert. Zuerst werden Ausgabe und Zuständigkeit festgelegt, danach die vollständigen monatlichen Kosten verglichen.
Kann ChatGPT Websites scrapen?
ChatGPT kann über seine Browser-Funktion Websites öffnen und Informationen sammeln, wie die offizielle OpenAI-Dokumentation beschreibt. Das kann eine interaktive Erfassungsaufgabe abdecken. Für wiederkehrende Preise, Angebotseinträge oder Agentendokumente müssen Zeitplan, Ausgabeschema, Ergebnisspeicherung und Zuständigkeit bei Fehlern gesondert geprüft werden. Hier geht es darum, welcher Dienst den wiederkehrenden Workflow bereitstellt; die Fähigkeit eines KI-Assistenten, eine Seite zu lesen, beantwortet diese Frage noch nicht.
Welche KI eignet sich am besten für Web Scraping?
Vor der Auswahl eines Sprachmodells sollten der Extraktionsdienst und die erwartete Ausgabe feststehen. Firecrawl und Context.dev gehören für Markdown oder strukturierte Felder auf die Auswahlliste. Browse AI passt zu einem Roboter, den das Fachteam selbst betreut. Die beste Wahl liefert die benötigten Informationen aus repräsentativen eigenen Quellen zu akzeptablen Gesamtkosten.
Ist Web Scraping noch zeitgemäß?
Zuerst sollte geprüft werden, ob die Zielseite eine passende API oder einen Feed anbietet. Werden die benötigten Informationen ausschließlich als Seiten veröffentlicht, bleibt Extraktion eine Option. Für die Kaufentscheidung zählt, wer Abruf, Extraktion, Zeitplanung und Validierung betreut. Ob sich das Produkt als KI bezeichnet, hilft dabei weniger.
Welche sind die Top 10 Web-Scraping-Tools?
Diese Auswahlliste enthält acht Produkte für drei wiederkehrende Aufgaben: Agentendaten, No-Code-Überwachung und Zugriff bei großem Volumen. Die Wahl sollte innerhalb dieser Aufgaben erfolgen, statt die Liste nur auf zehn Tools zu verlängern. Ein Projekt zur Browser-Automatisierung oder ein selbst betriebenes Framework bringt eine andere Entscheidung über Zuständigkeiten mit sich als die hier verglichenen Dienste.
Die AI Business Workflow Audit Checklist gibt es über den Newsletter. Vor der Entscheidung für einen Webdaten-Workflow hilft sie, Ausgabe, Zeitplan, Annahmeregeln und Zuständigkeit festzulegen.
- Zuletzt aktualisiert
- 6. Okt. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Agent Memory: Was KI-Agenten behalten und was es kostet
Was KI-Agenten speichern sollten: Kontext, Sitzungen, Langzeitgedächtnis und Skills. Mit Anbietergrenzen, Kostenbeispielen und Lösungen für typische Fehler.5. Okt. 2026Build
Pinecone Pricing 2026: Tarife, Grenzen und Rechenbeispiele
Pinecone Pricing 2026: Tarife und Kosten für 1M bis 100M Vektoren. Rechenbeispiele zeigen, wie Suchumfang und Nutzung die Monatsrechnung bestimmen.5. Okt. 2026Build
Lovable-Alternative gesucht? Was beim Wechsel wirklich zählt
Welche Lovable-Alternative passt? Replit, Emergent, Bolt, Blink, Base44 und v0 im Vergleich: Preise, Backend, Codeexport und Kosten einer Migration.5. Okt. 2026Build
LLM Observability 2026: Sechs Tools, Teamgrößen und Kosten
Was kosten Langfuse, LangSmith, Helicone, Phoenix, Braintrust und Datadog? Sechs Tools für LLM Observability im Vergleich nach Teamgröße und Hosting.5. Okt. 2026Build
OpenCode-Anleitung: Modelle anbinden, Aufgaben lösen, Kosten prüfen
OpenCode einrichten, vorhandene Modellzugänge nutzen und die erste Aufgabe im Repository lösen: mit Projektregeln, Plugins und klarer API-Kostenrechnung.4. Okt. 2026Build
Netlify Pricing 2026: Was die Tarife wirklich kosten
Netlify Pricing verständlich erklärt: Free, Personal und Pro im Vergleich, Credit-Verbrauch und Monatsbudgets für Websites, Next.js-Apps und Agenturen.4. Okt. 2026Build
Kundenportal erstellen mit Softr: Preise, Rollen und Grenzen
Kundenportal erstellen mit Softr: Welche Tarife, Datenquellen und Zugriffsregeln passen? Die Bewertung erklärt Preise, KI-Funktionen und wichtige Grenzen.4. Okt. 2026Build