LLM Observability 2026: Sechs Tools, Teamgrößen und Kosten
Was kosten Langfuse, LangSmith, Helicone, Phoenix, Braintrust und Datadog? Sechs Tools für LLM Observability im Vergleich nach Teamgröße und Hosting.


Für LLM Observability in einem kleinen Produktionsteam ist Langfuse die naheliegende erste Wahl. Die Plattform verbindet Tracing und Evaluation; die unten durchgerechnete Arbeitslast mit 100,000 Läufen kostet im Core-Tarif $69.80/Monat, ohne Rechenkosten für Modelle und Evaluatoren. Andere Tools passen besser, wenn Evaluationen die Freigabe neuer Versionen bestimmen, ein Gateway gebraucht wird, privates Hosting vorgeschrieben ist oder Störungen im bestehenden Datadog-System untersucht werden sollen.
LLM Observability: Die besten Tools auf einen Blick
Langfuse eignet sich als gemeinsames Produktionsdashboard, LangSmith für die Weiterentwicklung von LangChain-Anwendungen, Helicone für die Anfrageüberwachung am Gateway, Arize Phoenix für eine selbst betriebene private Installation, Braintrust für Release-Entscheidungen anhand von Evaluationen und Datadog Agent Observability für Produktionsstörungen, die mehrere Anwendungsschichten betreffen. Die Teamgröße schlägt vor allem dann auf das Budget durch, wenn jede Person bezahlt werden muss, die einen Fehler untersuchen soll.
Ein Trace dokumentiert einen vollständigen Anwendungslauf. Ein Span steht für einen einzelnen Vorgang darin, etwa einen Modellaufruf, eine Informationsabfrage oder einen Tool-Aufruf. Eine Evaluation, häufig kurz Eval genannt, prüft, ob das Ergebnis eine Regel oder einen Qualitätsmaßstab erfüllt. Alle drei sind nötig, um zu erklären, warum ein Agent nach einer falschen Aktion trotzdem eine plausibel klingende Antwort geliefert hat.
Die Preise wurden am 5. Oktober 2026 anhand der aktuellen Preisseiten der jeweiligen Anbieter geprüft. Alle Dollarbeträge sind USD. Die Einstiegspreise enthalten zusätzliche Nutzung und Gebühren der Modellanbieter nur, wenn dies ausdrücklich angegeben ist. Der Vergleich beruht auf aktuellen Preisen und Dokumentationen; er beansprucht keine durch praktische Tests ermittelte Leistungsrangfolge.
Quellen: Langfuse-Preise, LangSmith-Preise, Helicone-Preise, Arize-Preise, Braintrust-Preise und Datadog-Preise.
Entscheidend ist die Einheit hinter „zuzüglich“. Ein Anbieter, der Anwendungstraces abrechnet, erfasst ein anderes Volumen als einer, der jeden Modellaufruf, jede Observation, jeden Score oder jedes Gigabyte berechnet. Vor dem Tarifvergleich muss deshalb klar sein, welche Datensätze die Anwendung tatsächlich erzeugt.
Was kosten monatlich 100,000 Agentenläufe?
Für dasselbe Agentensystem kann ein Team aus fünf Personen unter den folgenden Annahmen bei Langfuse $69.80 und bei LangSmith $645 zahlen. Die Beträge sagen nichts über die Qualität aus. Der Unterschied entsteht durch die gezählten Ereignisse, enthaltene Kontingente und Nutzergebühren.
Der Rechnung liegt diese ausdrücklich modellierte Produktionslast zugrunde:
- 100,000 vollständige Agentenläufe pro Monat, mit einem Trace je Lauf.
- Fünf beobachtete Vorgänge je Lauf: ein übergeordneter Workflow, zwei Modellaufrufe, eine Informationsabfrage und ein Tool-Aufruf.
- Insgesamt 200,000 Modellaufrufe und 500,000 beobachtete Vorgänge.
- 10,000 extern per Code berechnete Evaluationsscores, jeweils einer pro ausgewähltem Lauf. Zusätzliche Modellaufrufe oder Evaluator-Traces gehören nicht zu diesem Szenario.
- Fünf Nutzer, die Zugriff auf das Dashboard benötigen.
- 5 GB verarbeitete Daten in Braintrust und separat 5 GB abrechnungsrelevanter Speicher in Helicone. Diese Annahmen sind unabhängig voneinander, da die Datenzähler der Anbieter nicht austauschbar sind.
Das entspricht etwa einem Support-Agenten, der eine Anfrage liest, eine Bestellung abruft, ein Tool zur Bestellverwaltung aufruft und ein Modell die abschließende Antwort formulieren lässt. Die Zahlen dienen der Budgetplanung; sie sind keine Messwerte einer produktiven Anwendung. Wiederholungsversuche, Verzweigungen oder plattformintern ausgeführte Evaluatoren erzeugen andere Datensätze.
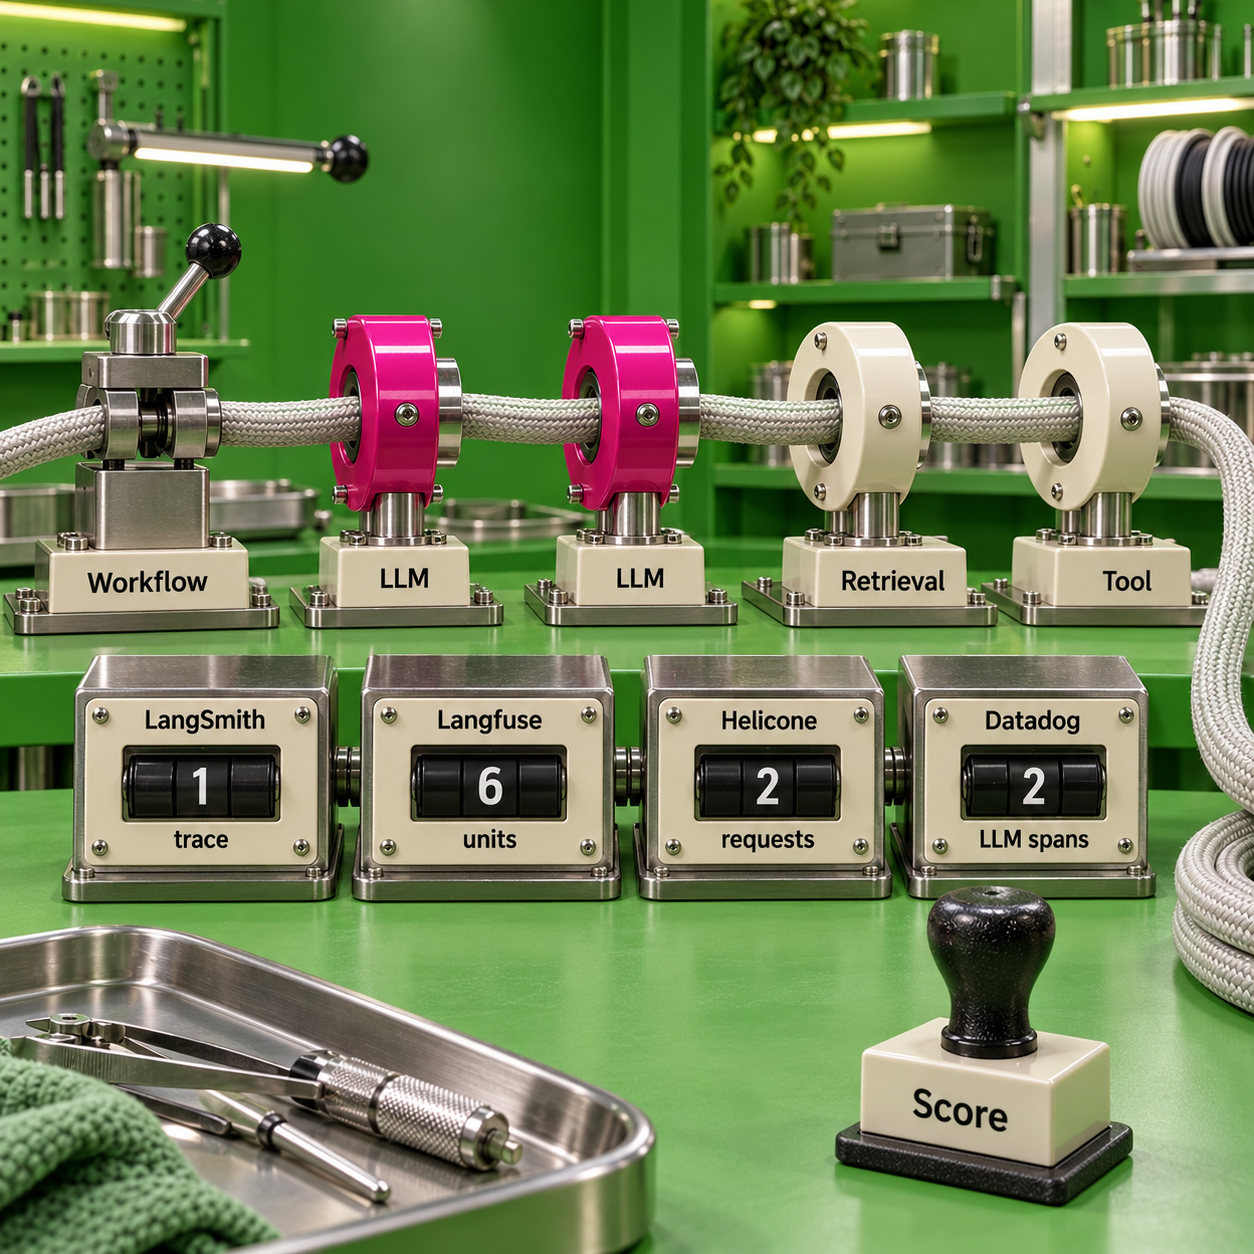
Die Berechnungen verwenden die oben verlinkten aktuellen Anbieterpreise. Bei LangSmith gilt der im Preis-Tooltip genannte Satz von $0.005 je Basis-Trace, mit 10,000 enthaltenen Traces für die gesamte Organisation. Die Spanne bei Helicone bildet einen Widerspruch auf dessen eigener Seite ab: Die Tariftabelle enthält 1 GB kostenlos, der Rechner berechnet den Speicher dagegen ab dem ersten Gigabyte. Phoenix erhebt keine volumenabhängige Lizenzgebühr; für die Infrastrukturkosten ist die tatsächliche Dimensionierung der Installation maßgeblich.
Diese Summen sind kein Pauschalangebot für Agenten mit längeren Traces. Werden aus zwei Modellaufrufen wiederholte Denkschleifen, zählen Datadog und Helicone mehr Modellvorgänge. Zusätzliche Observations und gespeicherte Scores erhöhen bei Langfuse die Einheitenzahl. Größere Dokumente bei unveränderter Trace-Anzahl führen bei Braintrust zu mehr verarbeiteten Bytes. Der Vergleich zum Token-Tracking bei Agenten behandelt ausführlicher, wie sich Ausgaben beim Modellanbieter einem Kunden oder Feature zuordnen lassen.
Nach welchen Kriterien wurden die Tools ausgewählt?
Die Rangfolge beginnt mit einem Kauf, den ein kleines Produktionsteam gut begründen kann. Danach folgen Tools, deren Nutzen an ein bestimmtes Betriebsmodell gebunden ist. Entwickler und KI-Verantwortliche müssen fehlerhafte Ergebnisse untersuchen, Kundenkosten verfolgen und Fehler in Release-Prüfungen überführen. Auch ein Produkt, das nur eine dieser Aufgaben löst, kann als Spezialist die richtige Wahl sein.
Jede Empfehlung beruht auf fünf Kriterien:
- Nachvollziehbare Abrechnung. Es ist erkennbar, ob Traces, Vorgänge, Personen, Scores oder Datenvolumen den Preis bestimmen, einschließlich Freikontingent und nächster Grenze.
- Aussagekräftige Produktionsdaten. Eine fehlerhafte Antwort lässt sich mit den Modellaufrufen, Informationsabfragen und Tool-Vorgängen verbinden, aus denen sie entstanden ist.
- Ein Ablauf zur Verbesserung. Die Daten fließen in Evaluationen, Datensätze, Experimente oder Prüfentscheidungen ein, statt als isolierte Logs liegen zu bleiben.
- Klare Grenzen beim Hosting. Kostenloser Eigenbetrieb, kommerzielle Enterprise-Lizenz und eine kundeneigene Datenebene werden getrennt beschrieben.
- Dokumentierte Instrumentierung. Maßgeblich für die OpenTelemetry-Unterstützung sind die aktuellen Integrationsanleitungen des Anbieters, einschließlich Protokoll und Feldzuordnung, soweit angegeben.
Die sechs Produkte stehen für unterschiedliche Entscheidungen: eine vielseitige Tracing-Plattform, einen auf ein Framework ausgerichteten Entwicklungsprozess, ein Gateway, eine vorrangig lokal betriebene private Plattform, eine Evaluationsplattform und eine Betriebssuite. Ein größerer Katalog würde mehr Optionen liefern, diese konkrete Budget- und Verantwortungsentscheidung aber nicht verbessern. Der Vergleich trifft keine Aussagen über gemessene Aufnahmegeschwindigkeit, Bedienbarkeit, Verfügbarkeit oder Evaluationsgenauigkeit.
„Kostenlos“ bedeutet hier ein nutzbares Kontingent, keine Zusage einer dauerhaft kostenlosen Nutzung. Bei Braintrust Starter und LangSmith Developer können Nutzungsgebühren anfallen. Phoenix kann ohne Lizenzgebühr auskommen, während Datenbankpflege und Bereitschaftsdienst weiterhin relevante Kosten verursachen. Ein kostenloser Tarif passt dann, wenn seine Grenzen zum geplanten Experiment passen.
Sechs Tools nach ihrer Eignung für den Produktionsbetrieb
1. Langfuse: Die erste Wahl für kleine Produktionsteams
Langfuse verbindet für kleine Produktionsteams gemeinsames Tracing, Token- und Kostenverfolgung, Prompt-Verwaltung und Evaluation, ohne im Core-Tarif pro Nutzer abzurechnen. Ein SaaS-Supportassistent kann seine Modellaufrufe mit Kunde, Workflow und Release verknüpfen. So lassen sich teure Fehler neben erfolgreichen Läufen untersuchen. Die wichtigste Budgetgrenze ist die Zahl gespeicherter Datensätze: Eine Agentenausführung kann einen Trace, mehrere Observations und Scores erzeugen. Langfuse passt, wenn Trace und Kosten gemeinsam sichtbar sein sollen und späterer Eigenbetrieb eine realistische Option bleiben soll.
Geeignet für: Kleine oder wachsende Produktteams, in denen Entwickler und KI-Verantwortliche dieselben Produktionsläufe untersuchen müssen
Besonderheit: Unbegrenzt viele Core-Nutzer, Kostenkontext je Trace und ein selbst betreibbarer Kern unter MIT-Lizenz
Preise: Core ab $29/Monat; kostenpflichtige Cloud-Tarife berechnen zusätzliche Nutzung in Einheiten
Kostenlos testen: Hobby erfordert keine Kreditkarte und bietet ein dauerhaftes Kontingent statt einer zeitlich begrenzten Testphase
Was kostet Langfuse? Tarife und entscheidende Grenzen
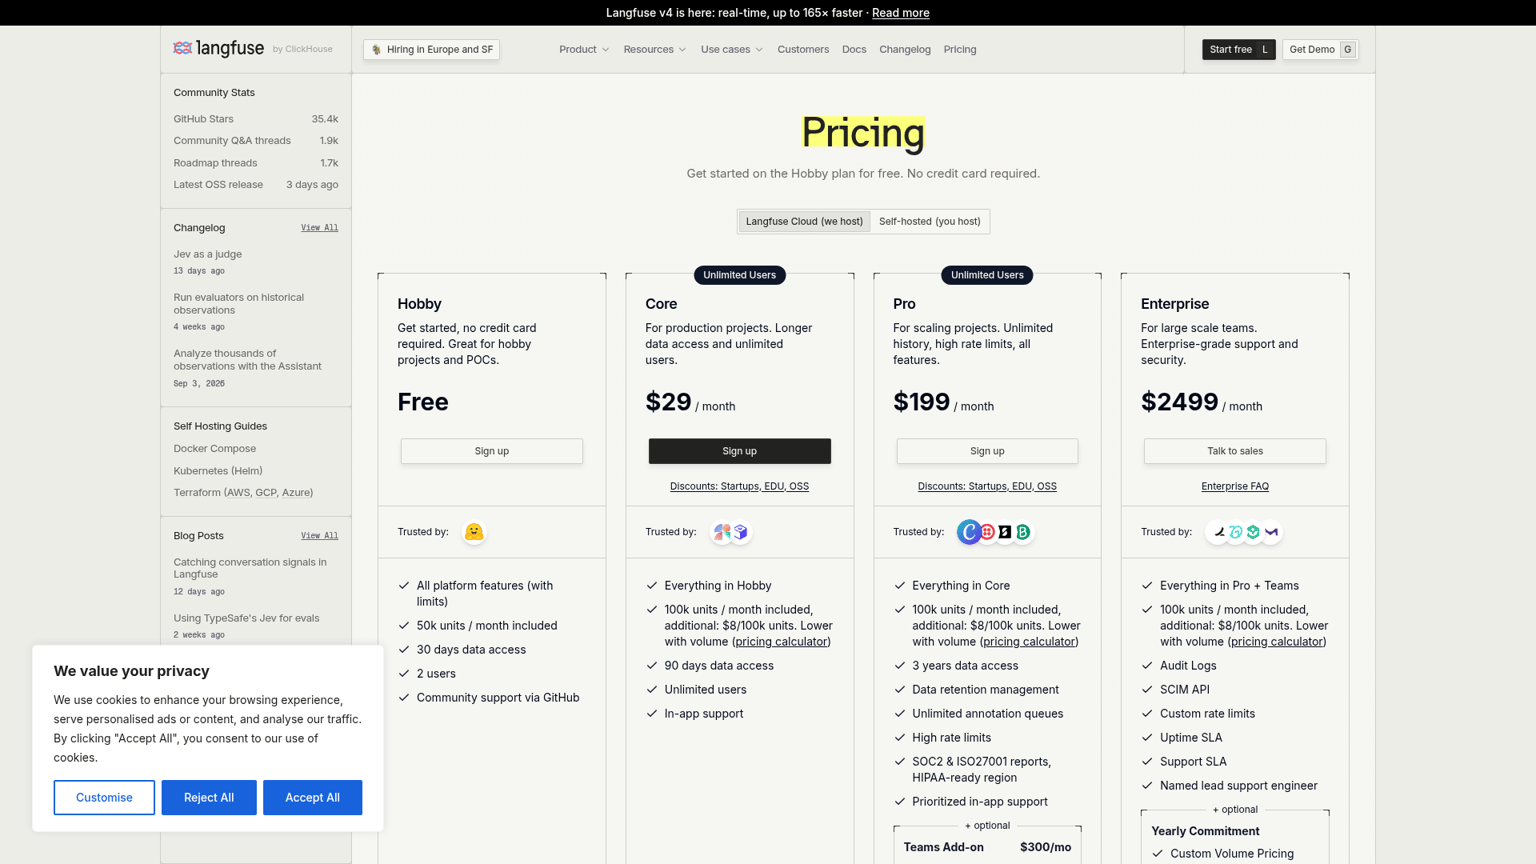
Die aktuelle Preisseite nennt Hobby für $0, mit 50,000 Einheiten/Monat, zwei Nutzern und 30 Tagen Datenzugriff. Core kostet $29/Monat, enthält 100,000 Einheiten, unbegrenzt viele Nutzer und 90 Tage Datenzugriff. Pro kostet $199/Monat, mit demselben Einheitenkontingent, drei Jahren Datenzugriff, Aufbewahrungsverwaltung und höheren Ratenlimits. Das optionale Teams-Add-on für Pro kostet $300/Monat und ergänzt Enterprise-SSO, dessen Erzwingung und feinere Zugriffskontrollen. Enterprise kostet $2,499/Monat, enthält 100,000 Einheiten, Audit-Logs, SCIM und vertragliche Servicezusagen; bei Jahresbindungen sind individuelle Mengenpreise möglich.
Zusätzliche Cloud-Nutzung wird gestaffelt abgerechnet. Für Einheiten von 100,000 bis eine Million gelten $8 je 100,000; von einer Million bis zehn Millionen sind es $7 je 100,000; von zehn Millionen bis fünfzig Millionen $6.50 je 100,000. Der günstigere Satz gilt jeweils für die Einheiten in dieser Stufe. Beim Überschreiten einer Grenze werden die Einheiten der vorherigen Stufe nicht rückwirkend günstiger.
Core begrenzt die Datenaufnahme auf 4,000 Anfragen/Minute, Pro nennt 20,000 Anfragen/Minute. Diese Anfragen sind nicht mit den abrechenbaren Einheiten gleichzusetzen. Ein Batch kann mehrere gespeicherte Ereignisse enthalten. Deshalb müssen sowohl das monatliche Einheitenbudget als auch die vom Exporter erzeugten Lastspitzen geprüft werden.
Langfuse-Traces: Observations und Scores zählen mit
Ein Langfuse-Trace dokumentiert einen Lauf. Die Abrechnungsformel lautet jedoch Traces + Observations + Scores. In der Beispielrechnung ergeben sich 100,000 + 500,000 + 10,000 = 610,000 Einheiten. Core kostet damit $29 + 5.1 × $8 = $69.80/Monat. Dasselbe gespeicherte Volumen kostet im Pro-Tarif $239.80/Monat.
Diese Formel beeinflusst die Instrumentierung. Eine Informationsabfrage und ein Aufruf des Erstattungstools liefern wertvolle Belege, obwohl sie zusätzliche Datensätze erzeugen. Werden sie allein zur Kostensenkung entfernt, lässt sich ein Fehler womöglich nicht mehr erklären. Sinnvoller ist eine bewusst gewählte Stichprobenregel für wenig aussagekräftige erfolgreiche Läufe, während die zur Diagnose teurer oder schädlicher Ergebnisse nötigen Belege erhalten bleiben.
Hosting, Lizenz und OpenTelemetry
Für Self-hosted Open Source fällt unter MIT keine Lizenzgebühr an. Die Nutzung ist unbegrenzt; enthalten sind die zentralen APIs für Tracing, Evaluation, Datensätze und Prompt-Verwaltung. Self-hosted Enterprise ist kommerziell lizenziert und wird individuell bepreist. Laut aktueller Preisseite kommen die Langfuse-Enterprise-Kosten zum jeweiligen kommerziellen ClickHouse-Tarif hinzu. Ein Cloud-Abo und ein Enterprise-Angebot für den Eigenbetrieb sind unterschiedliche Käufe.
Die OpenTelemetry-Dokumentation unterstützt OTLP über HTTP/JSON oder HTTP/protobuf und nennt ausdrücklich keine gRPC-Unterstützung. Der Basisendpunkt lautet /api/public/otel; die Authentifizierung erfolgt per Basic Auth mit dem öffentlichen und geheimen Projektschlüssel. Für die direkte Aufnahme über den aktuellen v4-Pfad ist der Header x-langfuse-ingestion-version: 4 zur Echtzeitverarbeitung nötig. Ohne ihn warnt die Dokumentation vor bis zu zehn Minuten Verzögerung. Nutzer-, Sitzungs-, Release- und weitere Trace-Attribute müssen außerdem an die Spans weitergegeben werden, die später gefiltert und aggregiert werden sollen.
Für ein Plattformteam, das bereits per gRPC an einen Collector exportiert, ist das eine relevante Integrationsgrenze. Der Collector kann ein Protokoll empfangen und ein anderes ausgeben. Der letzte Übertragungsschritt zu Langfuse muss aber zum dokumentierten HTTP-Endpunkt und zur Attributzuordnung passen. Eine angenommene Nutzlast ohne Kundenmetadaten ist noch keine abgeschlossene Integration.
Langfuse mit Python: Den dokumentierten SDK-Einstieg nutzen
Für Python empfiehlt der Anbieter sein eigenes SDK, weil es Langfuse-Felder, deren Weitergabe und den Export verwaltet. Der aktuelle Tracing-Schnellstart beschreibt die Projektschlüssel und LANGFUSE_HOST für die gewählte Region oder die eigene Installation. Der gesamte Geschäftsvorgang sollte im aktuellen Observation-Kontext ausgeführt werden. Informationsabfragen und Tool-Vorgänge gehören in denselben Kontext, damit der Trace die Ursache einer fehlerhaften Antwort festhält.
Soweit möglich, sollten die vom Modellanbieter gemeldeten Nutzungsdaten verwendet werden. Das Kosten-Tracking von Langfuse priorisiert übermittelte Kosten gegenüber geschätzten Modellpreisen; unter Project Settings > Models lassen sich eigene Definitionen hinterlegen. Das ist relevant, wenn ein ausgehandelter Anbietertarif gilt oder ein internes Modell keinen öffentlichen Preis hat. Die angezeigte Schätzung muss zu dem Preis passen, der tatsächlich gesteuert werden soll.
Langfuse mit LangChain: Die ganze Anfrage im selben Kontext halten
Die LangChain-Integration verwendet einen Callback-Handler, der über callbacks beim Aufruf mitgegeben wird. Die umgebende Anfrage erhält einen Trace-Kontext; die Chain wird darunter eingeordnet. Die Dokumentation weist auch auf gepufferte Hintergrundereignisse hin: Kurzlebige Prozesse müssen den Exporter vor dem Beenden leeren oder herunterfahren. In JavaScript-Serverless-Umgebungen müssen die Hintergrund-Callbacks wie in der Anleitung beschrieben abgewartet werden.
Eine erste Einführung sollte sich noch vollständig von Hand prüfen lassen:
Ein Tracing-Projekt für die Produktion anlegen
Cloud-Region oder Adresse der eigenen Installation wählen, Projektschlüssel anlegen und den Host nach dem aktuellen Schnellstart konfigurieren. Produktionsdaten müssen von Entwicklungsdaten unterscheidbar bleiben.
Einen vollständigen Geschäftsvorgang erfassen
Anfragestart, Modellaufrufe, Informationsabfragen und Tools instrumentieren. Kunden-, Workflow-, Release- und Ergebnismetadaten an die passenden Spans hängen und prüfen, ob die benötigten Trace-Attribute weitergegeben werden.
Kosten mit der Anbieterantwort abgleichen
Einen abgeschlossenen Trace öffnen und Modellidentität, Nutzung und Kosten prüfen. Eigene Modellpreise hinterlegen, wenn ein geschätzter öffentlicher Tarif nicht zur Vereinbarung passt.
Einen Score speichern und die Zähler prüfen
Ein bekanntes Beispiel bewerten, die Zuordnung zum vorgesehenen Lauf prüfen und anschließend Trace-, Observation- und Score-Anzahlen mit dem Usage-Management-Dashboard vergleichen. Den Exporter leeren, bevor ein kurzlebiger Worker beendet wird.
- In Core können alle relevanten Prüfer ohne zusätzlichen kostenpflichtigen Nutzerplatz mitarbeiten
- Die Datensätze verbinden Modellaufrufe, Tools, Informationsabfragen, Kosten und Evaluationsscores
- Übermittelte Kosten und eigene Modelldefinitionen berücksichtigen ausgehandelte oder interne Preise
- Der MIT-lizenzierte Kern ermöglicht den Betrieb unter eigener Infrastrukturverantwortung
- Traces, Observations und gespeicherte Scores verbrauchen jeweils Cloud-Kontingent
- Pro und das Teams-Add-on können die Grundgebühr erhöhen, bevor sich die Nutzung ändert
- Der OTel-Empfänger braucht HTTP-Export und korrekt weitergegebene Attribute
2. LangSmith: Für die Weiterentwicklung mit LangChain
LangSmith ist eine Tracing- und Evaluationsplattform für Teams, die Agenten bereits mit LangChain oder LangGraph entwickeln und prüfen. Die Instrumentierung anderer Frameworks ist ebenfalls dokumentiert. Eine Entwicklungsleitung kann einen Produktionsfehler mit einem Datensatz, einer Online- oder Offline-Evaluation, einer menschlichen Prüfung und einer Prompt-Überarbeitung verbinden. Die Budgetgrenze entsteht durch Nutzerplätze plus Traces: Mehr Prüfer erhöhen die Grundgebühr, mehr Traces erzeugen eigene Nutzungsgebühren. LangSmith passt, wenn dieser Entwicklungs- und Evaluationsprozess einen kostenpflichtigen Platz für jeden Prüfer rechtfertigt.
Geeignet für: Entwicklungsteams, die Agenten bereits rund um LangChain oder LangGraph verbessern
Besonderheit: Tracing, Datensätze, Annotationswarteschlangen sowie Online- und Offline-Evaluation im selben Produkt
Preise: Plus $39/Nutzer/Monat, zuzüglich Traces und weiterer Produktnutzung
Kostenlos testen: Developer bietet ein dauerhaftes Freikontingent für einen Nutzer; über die enthaltenen Traces hinaus fallen Nutzungsgebühren an
Aktuelle Tarife und das gemeinsame Trace-Kontingent
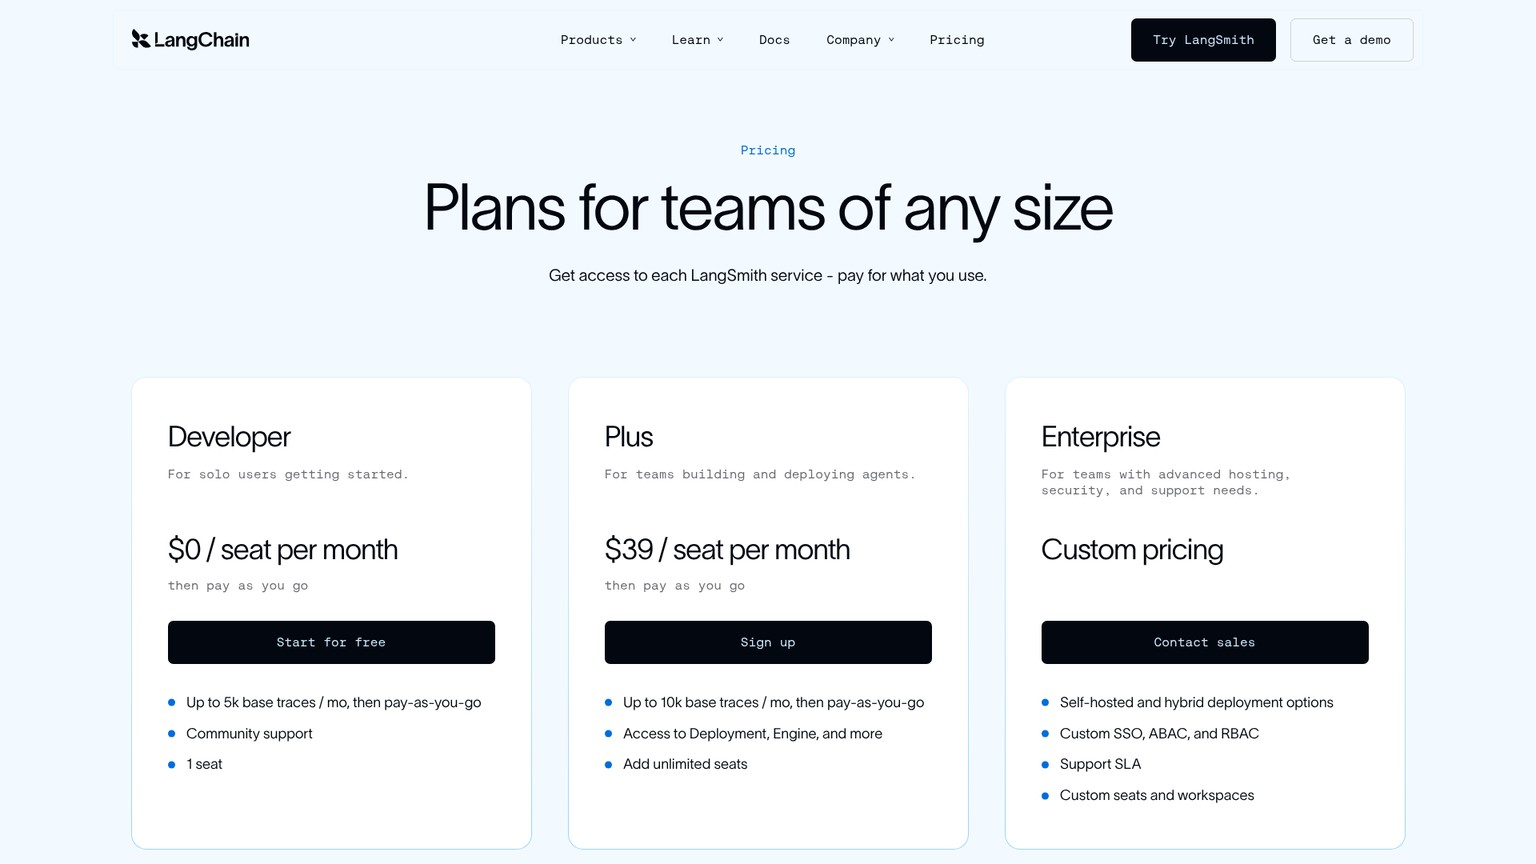
Developer kostet $0 je Nutzer/Monat, erlaubt einen Nutzerplatz und enthält 5,000 Basis-Traces/Monat, bevor nutzungsabhängige Gebühren anfallen. Plus kostet $39 je Nutzer/Monat, erlaubt weitere kostenpflichtige Nutzerplätze und enthält insgesamt 10,000 Basis-Traces pro Monat. Der Preisrechner behandelt dieses Kontingent ausdrücklich als organisationsweit geteilt. Enterprise wird individuell bepreist und bietet hybride sowie selbst betriebene Installationen, Sicherheitskontrollen und Supportvereinbarungen.
Der Preis-Tooltip der aktuellen Seite nennt 0.005 LangChain Standard Units je Basis-Trace und 0.0025 je Upgrade auf verlängerte Trace-Aufbewahrung. Eine LSU entspricht $1. Daraus ergeben sich $0.005 je Basis-Trace und $0.0025 für das Upgrade. Die Basisaufbewahrung beträgt 14 Tage, die verlängerte Aufbewahrung 180 Tage. Ein aus der Erinnerung übernommener alter Trace-Preis eignet sich nicht für ein heute geprüftes Budget.
Für fünf Plus-Nutzer und 100,000 Basis-Traces ergibt sich $195 für Nutzerplätze + $450 für zusätzliche Traces = $645/Monat. Werden 10,000 Traces auf verlängerte Aufbewahrung umgestellt, kommen $25 hinzu. Die Summe steigt auf $670 vor Evaluator-Rechenkosten und weiterer Produktnutzung. Das Upgrade bewahrt die Datensätze länger auf; es ist keine kostenlos enthaltene Folge des Plus-Abos.
Tuned Evaluators haben eine weitere veröffentlichte Abrechnungseinheit: 0.015 LSU je erfolgreichem Perceived Error-Evaluationslauf. Laut Tooltip verlängert ein Tuned Evaluator, der Feedback ergänzt, zugleich die Aufbewahrung des Traces. Für Deployment, Engine, Fleet und Sandboxes gelten eigene Nutzungsregeln. Wird nur Observability gebraucht, sollte auch das Budget auf diesen Dienst begrenzt werden. Ein Nutzerplatz ist keine pauschal enthaltene Agentenlaufzeit.
Warum die Nutzerzahl die Empfehlung verändert
Fünf Entwickler, die Traces untersuchen, sind eine andere Konstellation als fünf Entwickler mit zusätzlicher Produkt- und Qualitätsprüfung. Bei denselben 100,000 Basis-Traces kosten fünfzehn Plus-Nutzer $1,035/Monat: Die Nutzergebühren steigen auf $585, während die zusätzlichen Traces weiterhin $450 kosten. Mehr Nutzer vervielfachen das gemeinsame Trace-Freikontingent nicht.
Das lässt sich rechtfertigen, wenn jeder Prüfer regelmäßig Traces in verbesserte Prompts, Datensätze oder Release-Entscheidungen überführt. Schwieriger wird es, wenn die meisten Personen nur gelegentlich ein Kostendashboard öffnen müssen. Zu klären ist deshalb, wer die Rohdaten prüfen muss, wem ein exportiertes Ergebnis genügt und welcher Arbeitsablauf das Abo sinnvoll nutzt.
Kommerzieller Eigenbetrieb und OpenTelemetry
Selbst betriebenes LangSmith ist ein Enterprise-Add-on mit erforderlichem kommerziellem Lizenzschlüssel. Zur Installation gehören Frontend- und Backend-Dienste sowie ClickHouse, PostgreSQL und Redis. Für den Produktionsbetrieb empfiehlt die Anleitung externe Speicherdienste. Es handelt sich um eine selbst zu betreibende Enterprise-Installation; aus einem Open-Source-Framework folgt keine kostenlose Serverlizenz.
Der OpenTelemetry-Leitfaden beschreibt Traces aus kompatiblen Anwendungen, standardisierte Attributzuordnungen und Collector-Fanout, bei dem derselbe Span-Datenstrom an mehrere Backends geht. Für LangChain und LangGraph lässt sich der integrierte Pfad zusätzlich zum Tracing mit LANGSMITH_OTEL_ENABLED=true aktivieren. Ein standardmäßiger HTTP-Exporter verwendet den Basisendpunkt https://api.smith.langchain.com/otel, die Authentifizierung über x-api-key und optional den Header Langsmith-Project.
Die Form des Endpunkts ist entscheidend. Bei einer gemeinsamen OTLP-Basisvariable hängt der HTTP-Exporter /v1/traces an; eine tracespezifische Variable enthält bereits den vollständigen Pfad. Wird der Signalpfad an beiden Stellen ergänzt, entsteht eine falsche URL. Vor Abschluss des OTel-Exports sollte derselbe Trace im gewählten Projekt auf Modell, Eingaben, Ausgaben und Eltern-Kind-Struktur geprüft werden.
- Für LangChain und LangGraph ist ein integrierter Tracing-Pfad dokumentiert
- Datensätze, Annotationswarteschlangen und Online- sowie Offline-Evaluationen unterstützen einen klaren Verbesserungsprozess
- OTel-Datenaufnahme und Collector-Fanout unterstützen Anwendungen über ein einzelnes Framework hinaus
- Enterprise ermöglicht einen lizenzierten Betrieb des Backends in der eigenen Infrastruktur
- Jeder Plus-Prüfer kostet $39/Monat, auch eingeladene Nutzer, die als Nutzerplätze zählen
- Das enthaltene Trace-Kontingent wird geteilt und nicht pro Nutzer gewährt
- Längere Trace-Aufbewahrung und spezialisierte Evaluatoren verursachen zusätzliche Gebühren
3. Helicone: Wenn das Gateway den Ausschlag gibt
Helicone kombiniert die Beobachtung von Anfragen mit einem KI-Gateway, das Modellanfragen weiterleitet und dabei Routing sowie weitere Steuerungsfunktionen übernimmt. Eine kleine Anwendung, die vor allem Anbieteranfragen prüfen, Ausweichrouten verwalten und Modellausgaben gruppieren muss, erhält an dieser Stelle nützliche Daten. Die Grenze liegt zwischen Gateway und vollständigem Agenten: Ein protokollierter Modellaufruf braucht weiterhin Anwendungskontext, um Informationsabfragen und Geschäftstools zu erklären. Helicone passt, wenn das Gateway bereits Teil der Architektur ist und zunächst Anfragen überwacht werden sollen.
Geeignet für: Produktteams, die Anfrageüberwachung und Gateway-Funktionen gemeinsam benötigen
Besonderheit: Ein OpenAI-kompatibles Gateway mit separatem Pfad für asynchrone Protokollierung
Preise: Pro $79/Monat, zuzüglich gestaffelter Gebühren für protokollierte Anfragen und Speicher
Kostenlos testen: Hobby ist kostenlos; Pro und Team bieten laut Preisseite eine 7-tägige kostenlose Testphase
Aktuelle Tarife einschließlich Lastspitzengrenzen
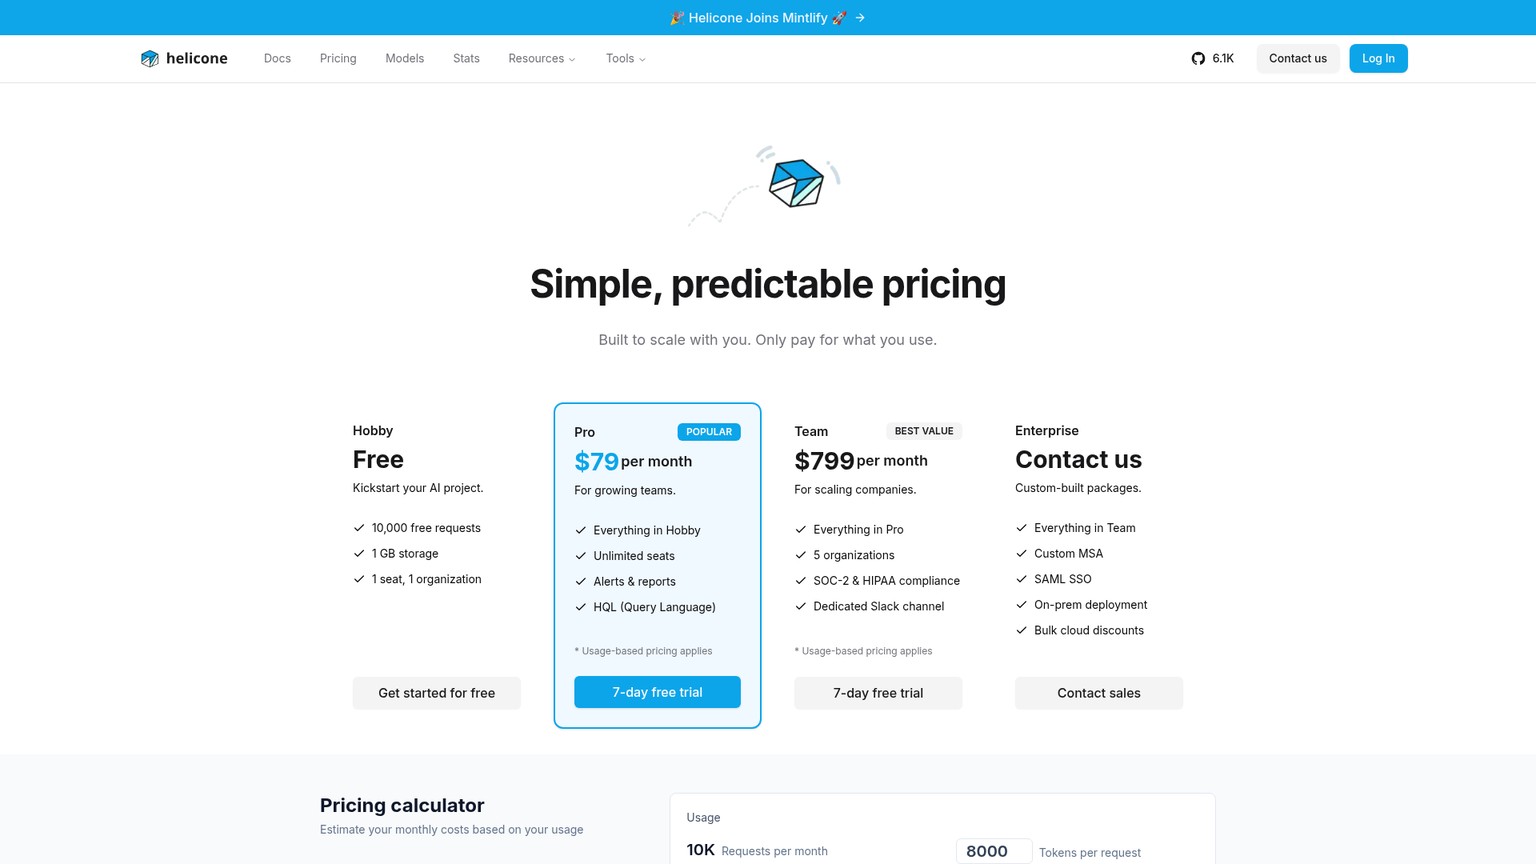
Die aktuelle Preisseite nennt Hobby für $0, mit 10,000 Anfragen/Monat, 1 GB Speicher, einem Nutzer, einer Organisation und sieben Tagen Aufbewahrung. Pro kostet $79/Monat, ergänzt unbegrenzt viele Nutzer, Warnmeldungen, Berichte und die Abfragesprache HQL und bewahrt Daten einen Monat auf. Team kostet $799/Monat und ergänzt fünf Organisationen, drei Monate Aufbewahrung, einen eigenen Slack-Kanal und das genannte Compliance-Angebot. Enterprise wird individuell bepreist, mit SAML-SSO, lokaler Installation und individuellen Vertragsoptionen.
Die Tabelle der kostenpflichtigen Tarife enthält 10,000 kostenlose Anfragen und 1 GB kostenlosen Speicher, danach fallen Nutzungsgebühren an. Die veröffentlichte Aufnahmegrenze für Hobby beträgt 10 Logs/Minute, gegenüber 1,000 bei Pro, 15,000 bei Team und 30,000 bei Enterprise. Ein ausreichendes Monatskontingent schützt nicht davor, dass eine Lastspitze bereits die Aufnahmegrenze überschreitet. Ein warteschlangengesteuerter Dokumentenjob, der viele Datensätze gleichzeitig überträgt, braucht deshalb eine Durchsatzprüfung zusätzlich zur monatlichen Zählung.
Der Wechsel von Pro zu Team kostet $720/Monat mehr, vor zusätzlicher Nutzung. Er sollte durch Anforderungen an Organisationen, Aufbewahrung und Support begründet sein. Eine wachsende Anfragezahl macht diesen Sprung allein noch nicht zur unvermeidbaren nächsten Gebühr.
Anfragekosten und der Widerspruch beim Speicher
Der aktuelle Rechner auf der Preisseite verwendet gestaffelte Anfragepreise: Die ersten 10,000 sind kostenlos, die nächsten 20,000 kosten jeweils $0.0007, die nächsten 60,000 jeweils $0.00035 und Anfragen von 90,001 bis 250,000 jeweils $0.000175. Spätere veröffentlichte Stufen sinken bei wachsendem Volumen auf $0.0000875, $0.00004375 und $0.00002 je Anfrage. Diese Werte stammen aus dem eigenen Rechner von Helicone, nicht aus dem Vergleich eines anderen Anbieters.
Bei 200,000 protokollierten Modellanfragen beträgt der Anfrageanteil $14 + $21 + $19.25 = $54.25. Mit Pro ergeben sich $133.25 vor Speicher. Beide Modellaufrufe des Beispielagenten müssen gezählt werden. Wird die Anwendung pauschal als 100,000 „Anfragen“ erfasst, ist dieser Zähler zu niedrig angesetzt.
Die Speicherstufen des Rechners beginnen bei $3.25/GB für die ersten 30 GB, gefolgt von $2/GB, $1.25/GB, $0.75/GB und $0.50/GB in höheren Stufen. Der Rechner berechnet die erste Stufe jedoch ab null, obwohl die Tariftabelle ein kostenloses Gigabyte verspricht. Bei 5 GB abrechnungsrelevantem Speicher ergeben sich mit Freikontingent $13 Speicherkosten, nach dem Rechner $16.25. Der beispielhafte Pro-Gesamtpreis liegt damit bei $146.25-$149.50.
Gateway, asynchrone Logs und die dokumentierte OTel-Grenze
Der Gateway-Schnellstart verwendet einen OpenAI-kompatiblen Client mit dem Ziel https://ai-gateway.helicone.ai, automatischer Protokollierung und Ausweichrouten. Eigene Schlüssel der Modellanbieter lassen sich ebenfalls verwenden. Ausgaben beim Modellanbieter fallen zusätzlich zum Observability-Abo und den Gebühren für protokollierte Anfragen an.
Der Leitfaden zu Proxy und Async beschreibt die Architekturentscheidung direkt. Die Proxy-Integration setzt Helicone in den Anfragepfad und bietet Gateway-Funktionen wie Caching, Wiederholungssteuerung und eigene Ratenlimits. Asynchrone Protokollierung läuft außerhalb dieses kritischen Pfads, bietet aber nicht dieselben Proxy-Kontrollen. Vor dem Vergleich des Einrichtungsaufwands ist deshalb zu entscheiden, ob Helicone die Anfragen weiterleiten oder im Hintergrund beobachten soll.
Für OpenTelemetry dokumentiert Helicone eine OpenLLMetry-Async-Integration. Die aktuellen Beispiele nutzen die Logger @helicone/async und helicone-async. Das belegt den beschriebenen Integrationspfad. Die zitierte Anleitung liefert jedoch keine Konfiguration für einen allgemeinen OTLP-Empfänger hinter einem Collector. Lautet die Anforderung „nur den Collector-Exporter ändern“, muss genau dieser Weg geprüft werden. Eine OTel-bezogene Integration ist nicht automatisch ein direkt austauschbares OTLP-Backend.
Eigenbetrieb wird für manuelle Installation, Docker Compose, Kubernetes und Cloud-Deployment unterstützt. Das Repository steht unter Apache 2.0. Dedizierter Support und Enterprise-Dienste sind separat zu klären. Für kleine Teams können die laufenden Betriebskosten des Systems die Telemetrierechnung übersteigen, selbst wenn die Softwarelizenz kostenlos ist.
Die Einführung sollte eine Anwendungsfrage beantworten und nicht bei einer sichtbaren Anfrage enden. Workflow- und Kundenkennungen anhängen, einen bekannten Modellaufruf senden, den Datensatz prüfen und sicherstellen, dass eine Sitzung die vorgesehenen Aufrufe verbindet. Danach dieselbe Prüfung mit einem Wiederholungsversuch oder einer fehlgeschlagenen Antwort durchführen. Die Gateway-Ansicht liefert brauchbare Produktionsbelege, sobald erkennbar wird, welcher Geschäftsvorgang die zusätzliche Modellarbeit ausgelöst hat.
- Pro enthält unbegrenzt viele Nutzer für die gemeinsame Anfrageüberwachung
- Gateway und asynchrone Protokollierung ermöglichen eine bewusste Entscheidung über den Anfragepfad
- Gestaffelte Anfragegebühren lassen sich aus der aktuellen Anbieterseite berechnen
- Apache 2.0 und dokumentierte Installationsoptionen ermöglichen Eigenbetrieb
- Modellanfragen sind eine andere Einheit als vollständige Agentenläufe
- Veröffentlichtes Speicherkontingent und Rechner müssen abgeglichen werden
- Asynchrone Protokollierung bietet nicht die Caching-, Wiederholungs- und Ratenlimit-Kontrollen des Gateways
- Die zitierte Integrationsanleitung belegt keinen allgemeinen Datenaufnahmepfad vom Collector zum OTLP-Empfänger
4. Arize Phoenix: Privates Tracing mit eigener Infrastrukturverantwortung
Arize Phoenix ist eine auf lokalen Betrieb ausgerichtete Plattform für Tracing, Evaluation und Experimente, die ohne Lizenzgebühr in der eigenen Infrastruktur laufen kann. Bei der Untersuchung eines Rechercheassistenten kann ein Plattformingenieur Modellaufrufe, abgerufenen Kontext und Tool-Vorgänge prüfen, Fehler in einen Datensatz übernehmen und eine überarbeitete Anwendung vergleichen. Die Grenze ist die Verantwortung: Jemand muss den Dienst betreiben und die Lizenzbedingungen verstehen. Phoenix passt, wenn ein privates, kontrollierbares Tracing- und Evaluationssystem wichtig genug ist, um dafür einen Infrastrukturverantwortlichen zu benennen.
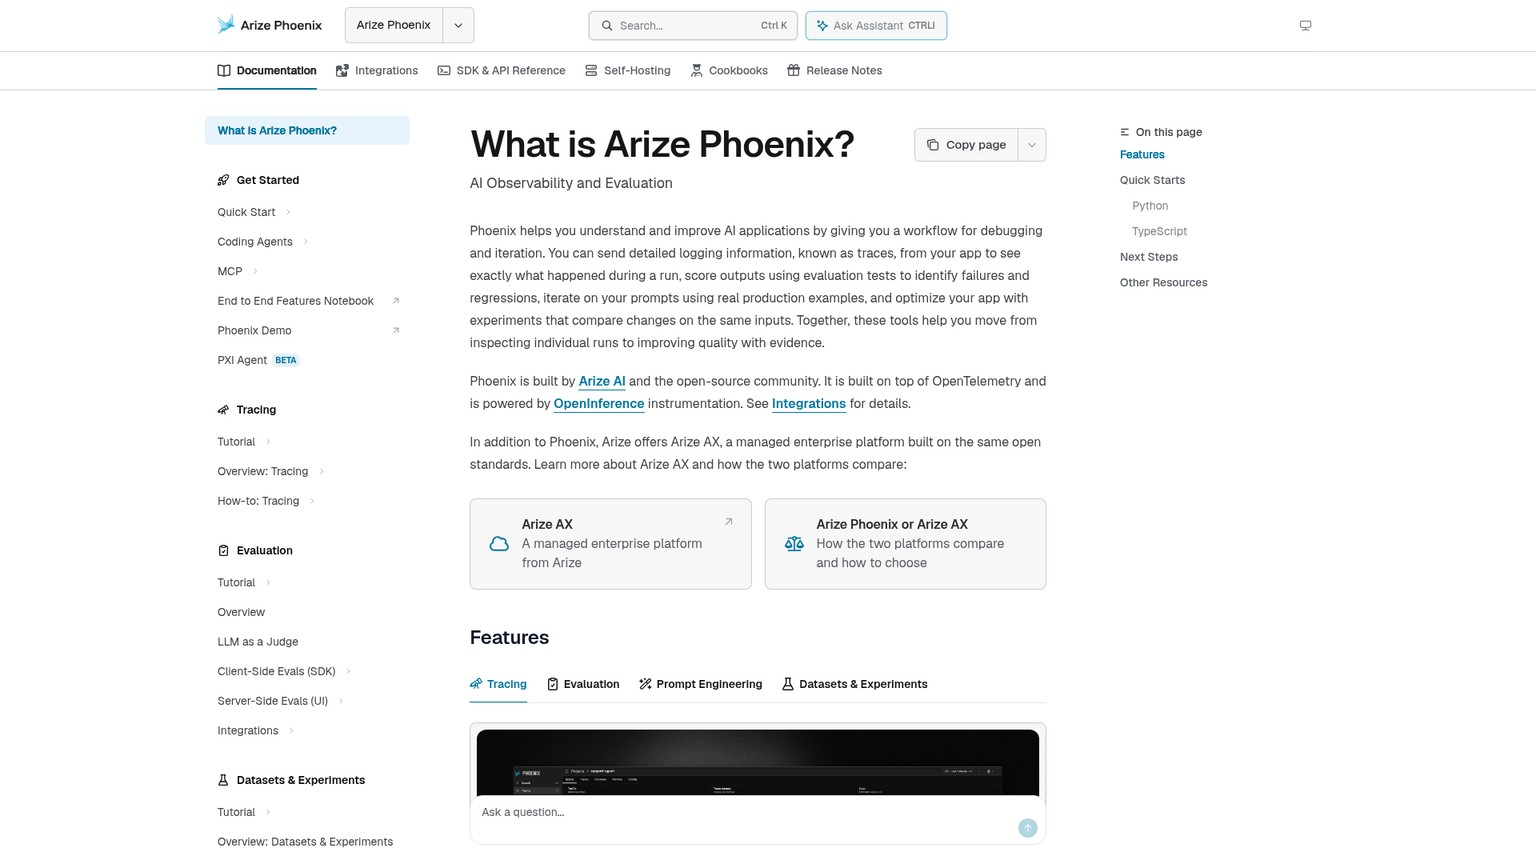
Geeignet für: Technische Teams, die ihr Tracing- und Evaluationsbackend selbst betreiben wollen
Besonderheit: OTLP-Traces und OpenInference-Instrumentierung mit lokalen Datensätzen und Experimenten
Preise: Phoenix im Eigenbetrieb hat keine Lizenzgebühr; auf der aktuellen Arize-Preisseite ist kein kostenpflichtiger Phoenix-Tarif veröffentlicht
Kostenlos testen: Selbst betriebenes Phoenix ist im Rahmen seiner Lizenz kostenlos nutzbar; Arize AX hat einen separaten kostenlosen Tarif
Phoenix und der AX-Tarif für $50 sind getrennte Angebote
Die aktuelle Arize-Preisseite bepreist AX und beschreibt Phoenix separat als vorrangig lokale Plattform. AX Free enthält 25,000 Trace-Spans/Monat, 1 GB Datenaufnahme/Monat, 15 Tage Aufbewahrung sowie unbegrenzt viele Nutzer und Evaluationen. AX Pro kostet $50/Monat, mit 50,000 Spans, 10 GB Datenaufnahme/Monat, 30 Tagen Aufbewahrung sowie unbegrenzt vielen Nutzern und Evaluationen. AX Enterprise wird individuell bepreist, mit vereinbartem Volumen und Aufbewahrungszeitraum sowie SaaS- oder selbst betriebener Installation.
Auf dieser Seite gibt es keinen veröffentlichten Preis für eine kostenpflichtige Phoenix-Instanz und keinen Phoenix-Tarif für Mehrverbrauch. Phoenix mit „$50/Monat“ anzusetzen, würde zwei Produkte vermischen. Für einen verwalteten Arize-Dienst ist AX mit seinen eigenen Span- und Datengrenzen zu prüfen. Für Phoenix muss die selbst betriebene Infrastruktur budgetiert werden.
In der Beispielanwendung entsprechen 500,000 Spans dem Zehnfachen des enthaltenen Span-Volumens von AX Pro. Die öffentliche Seite nennt dafür keinen Mehrverbrauchspreis. Ein Angebot ist deshalb aussagekräftiger als ein hochgerechneter Preis. Bei fünf Spans pro Lauf entspricht das Span-Kontingent von AX Free 5,000 Läufen, das von Pro 10,000, sofern Datenvolumen und übrige Grenzen ebenfalls eingehalten werden.
Bei selbst betriebenem Phoenix bleibt die Softwarelizenz auch beim modellierten Volumen kostenlos. Daraus folgt nicht, dass sich 500,000 gespeicherte Spans kostenlos aufbewahren lassen. Nötig sind eine Speicherregel, eine Schätzung der Nutzlastgröße, Backups und eine benannte Person für Upgrades und Wiederherstellung. Bereits vorhandene Betriebsinfrastruktur und eine neu aufzubauende private Plattform führen zu unterschiedlichen Gesamtkosten.
Lizenz: Die Bedingungen des Backends prüfen
Das Phoenix-Backend verwendet laut aktueller Repository-Lizenz Elastic License 2.0. Sie erlaubt die Nutzung unter ihren Bedingungen und untersagt, wesentliche Produktfunktionen Dritten als gehosteten oder verwalteten Dienst anzubieten. Auch das Umgehen von Lizenzschlüsselfunktionen und das Entfernen von Lizenzhinweisen sind eingeschränkt. Dieses Berechtigungsmodell unterscheidet sich vom MIT-lizenzierten Langfuse-Kern und der Apache-2.0-Lizenz von Helicone.
Diese Unterschiede gehören in die Beschaffungsunterlagen. Verfügbarer Quellcode, kostenlose Nutzung für die eigene Installation und eine freizügige Lizenz zum Weiterverpacken als Dienst sind verschiedene Aussagen. Die Empfehlung dieses Artikels betrifft den Betrieb von Phoenix für Tracing und Evaluation der eigenen Anwendung. Sie setzt kein Recht voraus, Phoenix als gehostetes Produkt weiterzuverkaufen.
Die Anleitung zum Eigenbetrieb nennt keine Lizenzgebühren, Nutzungsgrenzen oder tarifabhängigen Funktionssperren und beschreibt einen vollständig vom Netz getrennten Betrieb. Dokumentiert sind Terminal, Docker/Compose, Kubernetes/Helm und Cloud-Installationen. Auch eine private Installation benötigt eine zur gespeicherten Datenart passende Konfiguration und einen Wiederherstellungsplan.
OpenTelemetry und der Weg von Traces zu Evaluationen
Phoenix nimmt OTLP-Traces an und baut auf OpenTelemetry sowie OpenInference-Instrumentierung auf. Die dokumentierten Datensätze umfassen Modellaufrufe, Informationsabfragen, Tools und eigene Logik. Evaluationen können modellbasierte Bewertungen, Codeprüfungen oder menschliche Annotationen verwenden. Mit Datensätzen und Experimenten lassen sich verschiedene Anwendungsversionen mit denselben Eingaben erneut ausführen. Prompt-Werkzeuge unterstützen Versionierung und erneute Ausführung.
Die Tracing-Einrichtungsanleitung bietet phoenix.otel für Python und @arizeai/phoenix-otel für TypeScript sowie die Organisation nach Projekten und Sitzungen. Teams mit Collector sollten in Phoenix dieselben tatsächlich benötigten semantischen Felder prüfen wie in anderen Systemen. Eine erhaltene Trace-ID ist hilfreich; erst die Information, welcher Vorgang den falschen Kontext abgerufen hat, ermöglicht eine gezielte Korrektur.
Für einen Rechercheassistenten eignet sich ein bekannter Fehler als Einstieg: Das Modell hat aus einem irrelevanten Dokument eine selbstsichere Antwort erzeugt. Zu prüfen ist, ob der Retrieval-Span die nötigen Belege enthält, um ein Suchproblem von einem Problem der Antwortgenerierung zu unterscheiden. Eingabe und erwartetes Verhalten in einem Datensatz sichern, eine Retrieval- oder Prompt-Einstellung ändern und das Ergebnis vergleichen. Das wiederholbare Beispiel verbindet die Beobachtung des Problems mit der Vermeidung seiner Wiederkehr.
- Laut Anleitung gibt es beim Eigenbetrieb weder Softwarelizenzgebühr noch Nutzungsobergrenze
- Die Dokumentation unterstützt einen vollständig vom Netz getrennten Betrieb
- OTLP und OpenInference verbinden Tracing mit gängigen Instrumentierungspfaden
- Datensätze, Experimente und mehrere Evaluationsarten unterstützen Regressionstests
- ELv2 enthält Einschränkungen, die durch die pauschale Bezeichnung als freizügige Lizenz verloren gingen
- Infrastruktur, Aufbewahrung, Upgrades und Wiederherstellung liegen in der Verantwortung der eigenen Organisation
- Grenzen und Preise der kostenpflichtigen AX-Tarife beschreiben kein Phoenix-Abo
5. Braintrust: Wenn Evaluationen über Releases entscheiden
Braintrust ist eine Evaluations- und Observability-Plattform für Teams, die Releases anhand bewerteter Beispiele, Datensätze und Experimente freigeben. Eine KI-Produktverantwortliche kann bei einer Prompt-Überarbeitung Traces untersuchen und prüfen, ob die neue Ausgabe dieselben Kontrollen besteht wie die vorige Version. Die Budgetgrenze liegt bei verarbeiteten Daten und Scores; Modellrechenkosten und längere Aufbewahrung kommen hinzu. Braintrust passt, wenn jemand den Evaluationsprozess verantwortet und dessen Ergebnisse tatsächlich die Veröffentlichung beeinflussen. Solange Grenzen und Funktionen passen, ist Starter der richtige Einstieg.
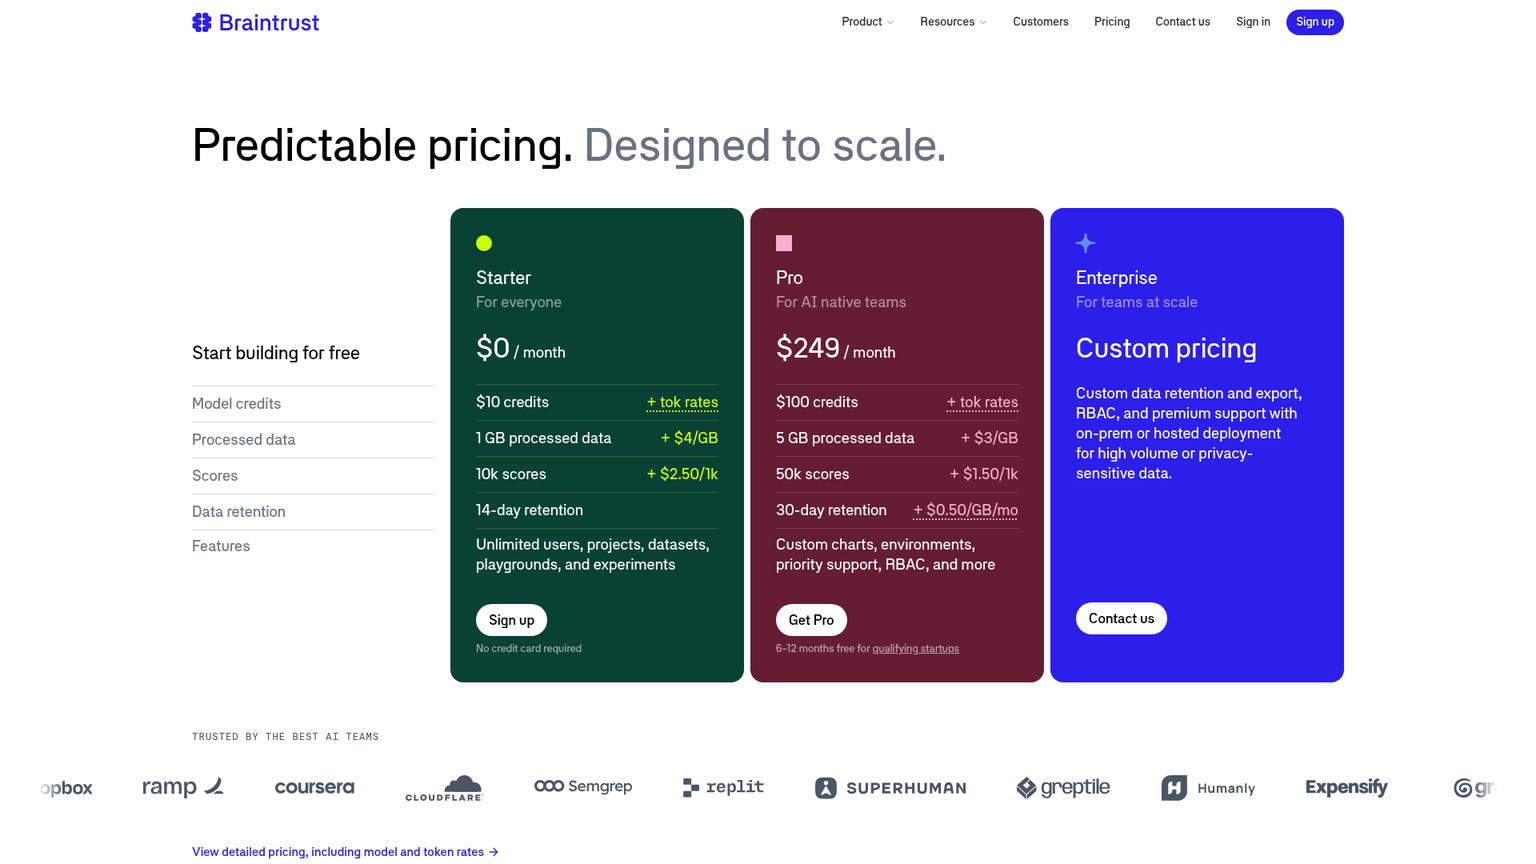
Geeignet für: KI-Produktteams mit gepflegten Evaluationsdatensätzen und Release-Kriterien
Besonderheit: Unbegrenzt viele Nutzer, Projekte, Datensätze, Playgrounds und Experimente in Starter
Preise: Starter hat $0 Plattformgebühr mit kostenpflichtiger zusätzlicher Nutzung; Pro kostet $249/Monat zuzüglich Nutzung
Kostenlos testen: Starter bietet ein dauerhaftes Freikontingent; für den Einstieg ist keine Kreditkarte nötig
Aktuelle Tarife und die beiden Nutzungszähler
Starter hat $0 monatliche Plattformgebühr, 1 GB verarbeitete Daten/Monat, danach $4/GB; 10,000 Scores/Monat, danach $2.50 je 1,000; 14 Tage Aufbewahrung und $10 monatliches Modellguthaben. Nutzer, Projekte, Datensätze, Playgrounds und Experimente sind unbegrenzt. Ein Team kann somit einen gemeinsamen Evaluationsbereich brauchen, ohne sofort Pro zu benötigen.
Pro kostet $249/Monat, mit 5 GB verarbeiteten Daten, danach $3/GB; 50,000 Scores, danach $1.50 je 1,000; 30 Tagen Aufbewahrung, mit zusätzlicher Aufbewahrung für $0.50/GB/Monat; sowie $100 monatlichem Modellguthaben. Hinzu kommen eigene Diagramme, Umgebungen, rollenbasierte Zugriffskontrollen und priorisierter Support. Enterprise wird individuell bepreist, mit vereinbarter Aufbewahrung und Export, Support sowie lokaler oder gehosteter Installation.
Ein Score steht für eine bewertete Ausgabe, unabhängig davon, ob ein bewertendes Modell, eine automatische Evaluation oder eigener Code ihn erzeugt hat. Die Gebühr für Speicherung oder Verarbeitung dieses Scores ist von den Rechenkosten seiner Erzeugung getrennt. Auch das enthaltene Modellguthaben hat einen eigenen Geltungsbereich. Es wird nicht pauschal mit jeder Anbieterrechnung einer Anwendung verrechnet.
Bei den modellierten 5 GB und 10,000 Scores fallen in Starter $16 für zusätzliche Daten und keine Gebühren für zusätzliche Scores an. Pro kostet vor weiterer Nutzung $249. Wenn zunächst gemeinsame Datensätze, Experimente und Traces innerhalb der Funktionsgrenzen des kostenlosen Tarifs genügen, braucht das Upgrade für $249 einen Grund bei Funktionen oder Aufbewahrung.
Wann sich die günstigeren Nutzungsraten auswirken
Bei 100,000 Scores/Monat und weiterhin 5 GB verarbeiteten Daten kostet Starter $241, Pro dagegen $324, jeweils vor Modellnutzung und verlängerter Aufbewahrung. Der niedrigere Einheitspreis von Pro gleicht die Grundgebühr nicht automatisch aus.
Bei derselben Datenmenge liegt der rein nutzungsbezogene Kostengleichstand bei 183,000 Scores/Monat. Beide Tarife erreichen dann $448.50. Unterschiedliches Modellguthaben, Aufbewahrung und Funktionen sind dabei nicht berücksichtigt und können einen früheren Wechsel rechtfertigen. Die Zahl ist eine Budgetschwelle, keine Empfehlung, sinnvolle Zugriffskontrollen aufzuschieben.
Für den Betrieb stellt sich die Frage, welche Prüfungen ihre Kosten wert sind. Ein Support-Workflow kann bei jedem Lauf eine deterministische Prüfung der Tool-Argumente brauchen, aber eine modellbasierte Bewertung der Antwortqualität nur bei einer Stichprobe. Die Prüfungen verfolgen unterschiedliche Zwecke und verursachen unterschiedliche Rechenkosten. Ein gepflegter Datensatz dient den Releases; Stichproben aus der Produktion decken Fehler auf, die darin bisher nicht vorkamen.
Ein hoher Durchschnittsscore sollte nicht die gesamte Release-Entscheidung ersetzen. Beispiele nach Workflow und Ergebnis gruppieren, damit Verbesserungen bei einfachen Antworten keine Verschlechterung bei der schwierigen, für Kunden wichtigen Aktion verdecken. Das ist eine Empfehlung zur Evaluationspraxis und keine Behauptung, eine Plattform liefere automatisch den richtigen Bewertungsmaßstab.
OTel-Datenaufnahme und kommerzielles Hosting der Datenebene
Die OpenTelemetry-Integration dokumentiert einen OTLP-Trace-Exporter, einen Braintrust-Span-Prozessor, einen Log-Exporter und die Weiterleitung von Logs über einen Collector. Der API-Basisendpunkt ist https://api.braintrust.dev/otel. Authentifizierung und der Header x-bt-parent=project_id:... adressieren das gewünschte Projekt. Signalspezifische Endpunkte enthalten den Trace- oder Log-Pfad. Das separate Paket @braintrust/otel unterstützt die dokumentierte JavaScript-Integration.
Nach der Datenaufnahme sollten Eingaben, Ausgaben und Metadaten anhand der Feldzuordnung der Integrationsanleitung geprüft werden. Dass sowohl eine Logzeile als auch ein Anwendungsspan angenommen werden, macht sie noch nicht zu gleichwertigen Evaluationsdatensätzen. Zu bestätigen ist, welches Objekt als Eingabe für das geplante Experiment dienen wird.
Die Deployment-Tarife sehen BYOC und Eigenbetrieb nur für Enterprise vor. Es handelt sich um den Kauf einer kommerziellen Plattform, nicht um eine Open-Source-Backend-Lizenz. Laut Architekturanleitung bleibt die Steuerungsebene, einschließlich Oberfläche, Authentifizierung und Verwaltungsmetadaten, in Braintrusts SaaS. Die Datenebene, auf der Traces, Datensätze und weitere KI-Daten liegen, kann im eigenen Cloud-Konto laufen. Der Browser kommuniziert direkt mit dieser Datenebene.
Diese Unterscheidung kann eine Beschaffungsentscheidung bestimmen. Kontrolle darüber, wo Prompts und Ausgaben liegen, kann eine Vorgabe zum Datenstandort erfüllen, während die Abhängigkeit von der Steuerungsebene des Anbieters bestehen bleibt. Muss jede Produktkomponente offline betrieben werden, sollte diese Architektur vor Vertragsabschluss mit der dokumentierten netzgetrennten Phoenix-Option verglichen werden.
- Starter ermöglicht einen gemeinsamen Evaluationsbereich ohne Nutzergebühren
- Kontingente für verarbeitete Daten und Scores machen getrennte Budgetbestandteile sichtbar
- Pro bietet gezielte zusätzliche Funktionen für Diagramme, Umgebungen, Zugriff und Aufbewahrung
- Dokumentierte OTel-Pfade können einen bestehenden Instrumentierungsdatenstrom aufnehmen
- Große Nutzlasten und viele Scores verursachen unabhängig voneinander Nutzungsgebühren
- Die niedrigeren Einheitspreise von Pro gleichen das Abo für $249 nicht immer aus
- Rechenkosten bewertender Modelle und längere Aufbewahrung brauchen eigene Budgets
- Selbst betriebener Datenspeicher verlagert die SaaS-Steuerungsebene nicht in die eigene Infrastruktur
6. Datadog Agent Observability: Für bestehende Betriebsumgebungen
Datadog Agent Observability ist die aktuelle Anbieterbezeichnung des häufig als Datadog LLM Observability gesuchten Produkts. Es passt besonders zu Teams, die Anwendungsstörungen bereits in Datadog untersuchen. Ein Timeout eines Support-Agenten kann durch einen Modellaufruf, einen langsamen Dienst oder ein Problem in der Nutzersitzung entstehen. Der Nutzen der Plattform liegt darin, die Agentendaten mit diesem weiteren Betriebskontext zu verbinden. Die Grenzen sind Vertragsbindung und Aufbewahrung sowie die Kosten eventuell benötigter weiterer Datadog-Produkte. Datadog passt, wenn die für Störungen verantwortlichen Personen bereits damit arbeiten und der gemeinsame Kontext die Untersuchung verbessert.
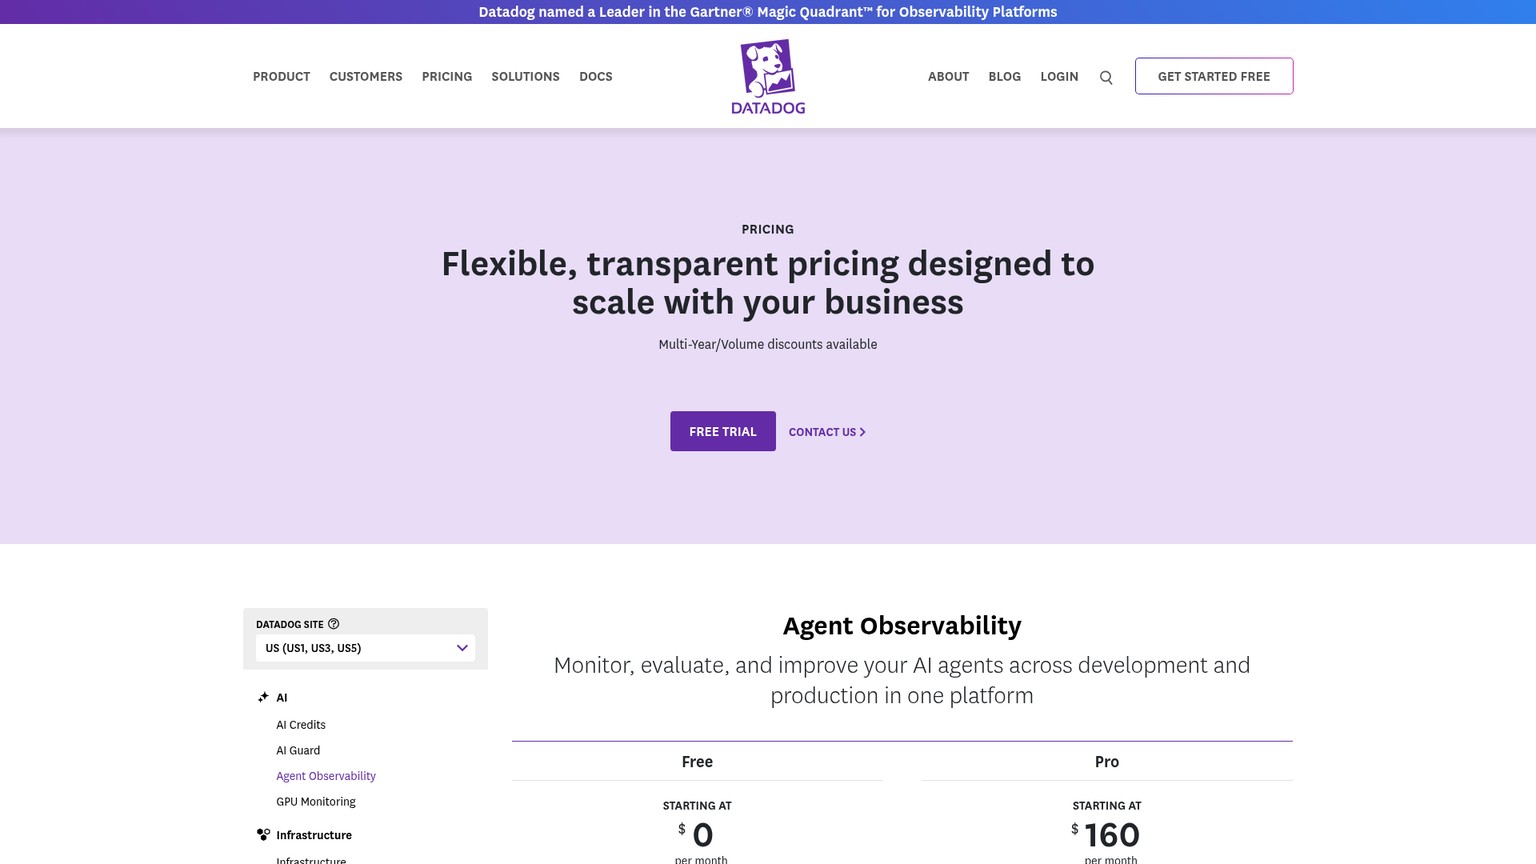
Geeignet für: SRE- oder Plattformteams, die KI-Fehler mit Anwendungs- und Infrastrukturstörungen verbinden
Besonderheit: Abrechnung von LLM-Spans statt sämtlicher Informationsabfragen, Tool- oder Workflow-Vorgänge
Preise: Pro $160/Monat bei Jahresbindung, $200 bei monatlicher Bindung oder $240 bei On-Demand-Nutzung, zuzüglich weiterer LLM-Spans
Kostenlos testen: Free enthält 40,000 LLM-Spans/Monat; die Preisseite bietet auch eine Anmeldung zum Testen
Was kostet Datadog LLM Observability?
Die aktuelle Preisseite nennt Free für $0, mit 40,000 LLM-Spans/Monat, 15 Tagen Trace-Aufbewahrung, unbegrenzt viel Kontext und Evaluationen sowie vollständigem Funktionszugriff. Pro enthält 100,000 LLM-Spans/Monat, ebenfalls mit 15 Tagen Trace-Aufbewahrung. Der Grundpreis beträgt $160/Monat bei jährlicher Abrechnung, $200 bei monatlicher Bindung oder $240 bei On-Demand-Nutzung.
Zusätzliche LLM-Spans kosten $3.50 je 10,000 zum Jahrestarif, $4.20 bei monatlicher Bindung oder $5 bei On-Demand-Nutzung. Für 200,000 LLM-Spans ergeben sich die modellierten Summen $195, $242 beziehungsweise $290. Die Bindung muss ausdrücklich verglichen werden: Der beworbene Jahrestarif ist nicht die Rechnung bei monatlicher Bindung.
Abrechenbar ist ein Modellaufruf, nicht jeder Vorgang im Trace. Laut Anbieter werden Tool-, Retrieval- und umgebende Workflow-Spans nicht als LLM-Spans berechnet. Bei zwei Modellaufrufen je Lauf entspricht das Free-Kontingent 20,000 vollständigen Läufen, vorbehaltlich der übrigen Tarifbedingungen. Mehr instrumentierte Tools müssen die abrechenbare LLM-Span-Zahl nicht erhöhen; eine Denkschleife mit wiederholten Modellaufrufen tut dies dagegen.
Verlängerte Aufbewahrung ist verfügbar, die öffentliche Seite nennt dafür jedoch keinen in diesem Vergleich verwendbaren Tarif. Wenn ältere Störungen untersucht werden müssen, sollte diese Anforderung bepreist werden. Ein vollständig instrumentierter, aber bereits abgelaufener Datensatz hilft bei einer späteren Auseinandersetzung mit einem Kunden nicht weiter.
Datadog für KI-Monitoring im bestehenden Betriebsumfeld
Agent Observability lässt sich eigenständig kaufen; laut Anbieter werden keine anderen Datadog-Abos vorausgesetzt. Die Preisseite beschreibt zugleich den zusätzlichen Nutzen der Verknüpfung mit APM, Infrastrukturüberwachung und Real User Monitoring, wenn diese Produkte genutzt werden. Bei einer Neueinführung müssen sie separat budgetiert werden. Das Observability-Abo bezahlt nicht automatisch den Rest von Datadog.
Die veröffentlichten Tarife umfassen Datensätze, Experimente, Evaluationen, Annotationen und Dashboards. Die Kostenansicht gliedert die Nutzung nach Anbieter, Modell sowie Prompt-Identität oder -Version; Kosten sind auf Trace- und Span-Ebene verfügbar. So kann die für eine Störung verantwortliche Person erkennen, ob mehr Verkehr oder eine veränderte Modellarbeitslast der Anwendung die Ursache ist.
Die Verknüpfung sollte in einer praktischen Eignungsprüfung konkret nachgewiesen werden. Dafür einen fehlgeschlagenen Agentenlauf nehmen und die Anfrage bis zu dem Dienst verfolgen, der die Tool-Antwort liefert. Zu prüfen ist, ob die Trace-Identität über die Systemgrenze erhalten bleibt und ob sich Modelllatenz von anderweitig verbrauchter Zeit unterscheiden lässt. Dieser Untersuchungsablauf begründet den Kauf; ein isoliertes Ausgabendiagramm belegt seinen Nutzen nicht.
SaaS-Lizenzierung und OpenTelemetry
Datadog liefert das Produkt als kommerziellen SaaS-Dienst unter seinem Abonnementvertrag. Die Vertragsbedingungen nennen das MSA als maßgeblich für den gehosteten Dienst. Die aktuelle Produktpreisseite bietet kein selbst betreibbares Agent-Observability-Backend. Ein selbst betriebener Datadog Agent oder OTel Collector bedeutet nicht, dass auch Speicher, Oberfläche und Evaluationsplattform selbst gehostet werden.
Der OpenTelemetry-Leitfaden akzeptiert Traces nach den semantischen GenAI-Konventionen ab 1.37 oder unterstützten OpenInference-Konventionen. Er dokumentiert die direkte Datenaufnahme ohne Datadog Agent oder Agent Observability SDK. Der gezeigte Exporter verwendet OTLP/HTTP protobuf mit den Headern dd-api-key und dd-otlp-source=llmobs.
Für externe Evaluationen gibt es eine besondere Integrationsanforderung: Bei OTel-Spans verlangen die Dokumente das Tag source:otel sowie Trace- und Span-IDs als Zeichenketten im Dezimalformat. Native OTel-IDs sind hexadezimal und müssen vor dem Senden umgewandelt werden. Eine Evaluation sollte gegen einen bekannten Trace geprüft werden. Kompatibles Tracing allein macht die Zuordnung von Evaluationen noch nicht automatisch.
- Nur LLM-Spans bestimmen den veröffentlichten Volumenzähler; Tool- und Retrieval-Spans sind ausgenommen
- Bestehende Datadog-Betriebsteams können Agentendaten mit weiterem Produktionskontext verbinden
- Free und Pro enthalten die genannten Evaluations- und Experimentfunktionen
- Direkte OTel-Datenaufnahme ist ohne erforderlichen Datadog Agent dokumentiert
- Der niedrigste beworbene Preis setzt eine Jahresbindung voraus
- In beiden veröffentlichten Tarifen sind 15 Tage Trace-Aufbewahrung enthalten
- Weitere Datadog-Dienste müssen separat gekauft werden
- Das Produkt ist ein gehostetes kommerzielles Backend, kein selbst betreibbarer Observability-Server
Welches Tool für LLM Monitoring passt zur Teamgröße?
Die Auswahl beginnt bei den Personen, die mit den Daten handeln müssen. Danach folgt die Frage, welcher Zähler mit der Anwendung wächst. Die Personalzahl fließt ins Budget ein. Sie ersetzt nicht die Klärung, ob ein Entwickler, eine KI-Produktverantwortliche oder eine für Störungen zuständige Person die Verantwortung trägt.
Ein oder zwei Entwickler: Das erste Freikontingent sollte eine vollständige Produktionsprüfung ermöglichen. Langfuse Hobby bietet zwei Personen eine gemeinsame Ansicht, obwohl die 50,000 Einheiten schnell verbraucht sind, wenn ein Lauf mehrere Vorgänge erzeugt. LangSmith Developer passt für einen Nutzer. Braintrust Starter ist interessant, wenn ein gepflegter Datensatz und eine bewertete Release-Prüfung bereits das Ziel sind. Phoenix passt, wenn der Eigenbetrieb des Backends bewusst gewählt wird.
Drei bis zehn Personen: Langfuse Core ist die erste Wahl, wenn mehrere Entwickler und ein Produktverantwortlicher regelmäßig Zugriff brauchen. Braintrust Starter kann günstiger sein, wenn Daten-, Score-, Aufbewahrungs- und Funktionsgrenzen zum evaluationsorientierten Arbeitsablauf passen. Helicone Pro rechtfertigt seine Gebühr, wenn Gateway und Anfrageüberwachung Teil des Kaufs sind. LangSmith Plus rechtfertigt die Nutzerkosten, wenn die Prüfer den Entwicklungsprozess aktiv nutzen.
Eine größere Prüfgruppe aus mehreren Funktionen: Vor der Aufnahme von Qualitätssicherung, Produkt oder Support jeden kostenpflichtigen LangSmith-Nutzer mitzählen. Tarife mit unbegrenzt vielen Nutzern können die Grundgebühr stabil halten, während mehr Personen mitarbeiten. Trace-, Daten- und Score-Volumen müssen trotzdem gesteuert werden. Die Entscheidung ändert sich, wenn der spezifische Arbeitsablauf einer Plattform mehr Prüfaufwand spart oder mehr wiederholte Fehler verhindert, als die Preisdifferenz kostet.
Ein SRE- oder Plattformteam, das bereits Datadog nutzt: Datadog ist vorzuziehen, wenn ein Agentenvorfall zusammen mit Diensten und Nutzersitzungen untersucht werden muss. Bestehende Zuständigkeiten und Trace-Kontext können den Nutzen einer separaten Spezialoberfläche verringern. Auch der niedrigere, auf LLM-Spans begrenzte Volumenzähler verdient Beachtung, wenn der Agent viele Vorgänge ohne Modellaufruf ausführt.
Eine Vorgabe zum privaten Hosting: Phoenix und Langfuse unterscheiden sich wesentlich bei Lizenz und Installationsoptionen; Helicone ergänzt eine Apache-lizenzierte Möglichkeit. Selbst betriebenes LangSmith und Braintrust erfordern kommerzielle Enterprise-Vereinbarungen. Braintrusts kundeneigene Datenebene verwendet weiterhin die Steuerungsebene des Anbieters. Bevor ein Tarif als günstig bewertet wird, muss feststehen, was innerhalb der eigenen Infrastruktur bleiben muss.
Die Regel lautet: Für den Arbeitsablauf bezahlen, der eine Produktionsentscheidung verändert, und dann die dadurch entstehenden Datensätze und Nutzer prognostizieren. Lässt sich diese Entscheidung nicht benennen, ist eine enger begrenzte Einführung der passende Anfang.
OpenTelemetry: Übertragungsweg und Felder prüfen
OpenTelemetry-Unterstützung ist nur dann nützlich, wenn die wichtigen Anwendungsfelder bei der Datenaufnahme erhalten bleiben. OTel ist ein standardisiertes Instrumentierungssystem; OTLP ist das Protokoll zur Übertragung seiner Telemetrie. Ein Span-Datenstrom kann erfolgreich ankommen, während dem Backend Modellidentität, Nutzung, Kundenkontext oder die Beziehung zwischen einem Tool und seinem Aufrufer fehlen.
Die dokumentierten Wege unterscheiden sich. Langfuse akzeptiert HTTP JSON oder protobuf am OTLP-Endpunkt und nennt gRPC als nicht unterstützt. LangSmith nimmt OTel-Tracing mit zugeordneten GenAI-, OpenInference- und weiteren Attributen an und dokumentiert Collector-Fanout. Phoenix akzeptiert OTLP und verwendet OpenInference-Instrumentierung. Braintrust dokumentiert Aufnahmewege für Traces, Span-Prozessoren und Logs. Datadog gibt unterstützte GenAI- oder OpenInference-Konventionen vor. Helicone dokumentiert seine asynchrone OpenLLMetry-Integration; die zitierte Anleitung belegt keinen allgemeinen OTLP-Empfänger für einen Collector.
Für eine Eignungsprüfung sollte ein repräsentativer Lauf über den gesamten Übertragungsweg erhalten bleiben. Zu prüfen sind Eltern-Kind-Beziehungen, Modellname, Tokens, Kosten, Regeln für Eingaben und Ausgaben sowie Release-Metadaten. Sind zwei Dienste beteiligt, muss der Kontext die Grenze überqueren. Gruppiert die Plattform Gespräche in Sitzungen, sollte die Sitzungskennung geprüft werden. Eine gemeinsame Trace-ID deckt nicht automatisch das ganze Gespräch ab.
Die Endpunktvariable braucht besondere Aufmerksamkeit. Ein gemeinsamer Basisendpunkt und ein signalspezifischer Trace-Endpunkt sind unterschiedliche Konfigurationsformen. Region, Authentifizierung und Pfade müssen den Anbieteranweisungen entsprechen. Anschließend den Datensatz im Zielprojekt prüfen: Eine erfolgreiche HTTP-Antwort bestätigt die Annahme, nicht die korrekte geschäftliche Zuordnung.
Zum Schluss doppelte Exportwege prüfen. Ein Framework-Callback und eine separate Bibliothek zur automatischen Instrumentierung können denselben Modellaufruf beobachten. Vor der Diagnose eines Kostensprungs muss geklärt werden, ob zusätzliche Modellarbeit entstanden ist oder dieselbe Arbeit doppelt erfasst wurde. Der Vergleich zur Fehleranalyse hilft dabei, den Trace mit einer konkreten Debugging-Frage zu verbinden.
Welche Fehlkäufe sich vermeiden lassen
Auch ein empfohlenes Produkt kann für die konkrete Aufgabe der falsche Kauf sein. Die folgenden Fälle passen nicht zum dokumentierten Abrechnungs- oder Betriebsmodell.
- LangSmith Plus nur für eine gemeinsame Kostenansicht: Die modellierte Arbeitslast für fünf Personen kostet $645 vor Aufbewahrungs-Upgrades und Evaluationsrechenkosten. Der Preis sollte durch den Verbesserungsprozess begründet sein; eine größere Prüfergruppe braucht einen klaren Zweck.
- Braintrust Pro für leichte Evaluationen, die in Starter passen: Die Beispielrechnung ergibt $16 für Starter gegenüber $249 für Pro. Zusätzliche Funktionen, Aufbewahrung oder Support sollten bewusst gekauft werden.
- Beschaffungskalkulationen mit „Phoenix für $50“: Dieser Preis gehört zu AX Pro. Bei der Beispielmenge reicht das öffentliche Span-Kontingent von AX nicht aus, und ein Mehrverbrauchstarif ist nicht veröffentlicht. Die selbst betriebene Phoenix-Infrastruktur hat ein anderes Budget.
- Helicone Hobby für Produktionsworker mit starken Lastspitzen: Ein Monatskontingent von 10,000 Anfragen hebt die veröffentlichte Aufnahmegrenze von 10 Logs/Minute nicht auf. Vor dem Einsatz des kostenlosen Tarifs muss der Verkehrsverlauf geprüft werden.
- Datadogs beworbener Jahrestarif zur Freigabe eines monatlich gebundenen Budgets: $160 ist der Grundpreis zum Jahrestarif. Bei monatlicher Bindung beträgt der Grundpreis $200 und die modellierte Gesamtsumme $242.
- Jede Option zum Eigenbetrieb ohne Verantwortlichen: Eine kostenlose Lizenz weist niemandem die Verantwortung für Backup-Wiederherstellung, Upgrades oder Datenzugriff zu. Auch eine kommerzielle selbst betriebene Datenebene verlagert nicht automatisch das gesamte Produkt in die eigene Umgebung.
Ein scheinbar präzises Kostendiagramm mit fehlenden Nutzungsdaten taugt wenig zur Budgetkontrolle. Die vom Anbieter gemeldete Nutzung einer bekannten Anfrage mit dem gespeicherten Datensatz vergleichen und die Gesamtsumme mit der tatsächlich bezahlten Rechnung abgleichen. Eine Observability-Plattform erklärt Ausgaben. Eine Abbruchregel muss dagegen die nächste Aktion der Anwendung beeinflussen.
Der erste Schritt: Einen Fehler zum Release-Test machen
Vor einer breiteren Einführung einen wertvollen Workflow instrumentieren und einen bekannten Fehler wiederholbar machen. Ein Supportassistent, der eine Bestellabfrage wiederholt, das falsche Dokument auswählt oder eine unbelegte Erstattung formuliert, ist ein guter Kandidat. Die verantwortliche Person kann hier das erwartete Verhalten benennen.
Workflow-Verantwortlichen, Release-Kennung und Geschäftsergebnis festhalten. Den vollständigen Lauf erfassen, seine Modell- und Tool-Vorgänge untersuchen und die Nutzungsfelder prüfen. Auch testen, was bei einem langsamen Exporter oder beim Beenden eines kurzlebigen Workers passiert. Die erste Einführungsprüfung lautet, ob die Daten mit genügend Kontext ankommen, um die Frage des Verantwortlichen zu beantworten.
Anschließend den bekannten Fehler mit einem eindeutigen erwarteten Ergebnis in einen Datensatz aufnehmen. Das kann etwa lauten: „Keine Erstattung ohne Freigabe des Tools zusagen“ oder „Die abgerufene Richtlinie zitieren, die für diesen Kunden gilt“. Für deterministische Regeln eignet sich eine Codeprüfung; wo ein Urteil nötig ist, ein überprüfter Qualitätsmaßstab. Eingabe und Regel aufbewahren, damit spätere Prompt- oder Modelländerungen denselben Test bestehen müssen.
Die Release-Freigabebedingung muss ausdrücklich festgelegt werden. Ein ausreichender Durchschnitt darf einen Fehler bei der zu schützenden Aktion nicht verdecken. Das Ergebnis des benannten schwierigen Falls prüfen und bei einem Fehler den Trace untersuchen. Danach Produktionsstichproben ziehen, um neue Fälle für den Datensatz zu finden.
Vor der nächsten Abo-Entscheidung die tatsächliche Trace-Anzahl, Vorgänge pro Trace, Modellaufrufe, gespeicherte Scores, verarbeitete oder aufbewahrte Bytes, Prüferzahl und nötige Aufbewahrung erfassen. Mit diesen Zahlen die Rechnung neu berechnen. Das sinnvolle Ergebnis der ersten Woche ist ein korrigierter Workflow und ein belastbares Budget, jeweils mit einer benannten verantwortlichen Person.
Häufige Fragen zu LLM Observability
Welches Tool eignet sich am besten für KI-Monitoring?
Langfuse ist die erste Wahl für ein kleines Produktionsteam, das Tracing und Kosten gemeinsam sehen muss. Braintrust passt zu Release-Entscheidungen anhand von Evaluationen, Phoenix zu einem selbst verantworteten privaten Backend und Datadog zu einem bestehenden Betriebsprozess. Zuständigkeit und Hosting-Grenzen entscheiden, welcher Spezialist die Standardwahl ersetzen sollte.
Welche Kennzahlen sind für LLM Observability wichtig?
Relevant sind Tokens und Anbieterkosten, Latenz, Fehler, Wiederholungsversuche, Ergebnisse von Informationsabfragen und Tools sowie Evaluationsergebnisse. Sie sollten nach Kunde, Workflow und Release gruppiert werden. Wenn fehlgeschlagene Läufe und Wiederholungen relevante Kosten verursachen, ist der Preis pro erfolgreichem Geschäftsergebnis aussagekräftiger als die gesamte Token-Anzahl.
Welche sind die 3 wichtigsten Observability-Tools?
Für die drei Produktionsrollen dieses Vergleichs sind Langfuse für allgemeines gemeinsames Tracing, Braintrust für evaluationsorientierte Produktarbeit und Datadog für Betriebskontext die passenden Kandidaten. Diese Auswahl richtet sich nach Rollen; sie behauptet keine gemessene Überlegenheit über sämtliche Funktionen oder Installationsarten hinweg.
Welche Open-Source-Tools gibt es für LLM Observability?
Der Langfuse-Kern ist MIT-lizenziert; das Helicone-Repository verwendet Apache 2.0. Phoenix lässt sich kostenlos selbst betreiben, sein Backend nutzt jedoch Elastic License 2.0 mit Einschränkungen für gehostete Dienste. Maßgeblich ist die tatsächliche Backend-Lizenz. Die Bezeichnung Open Source allein bedeutet noch keine freizügige Lizenz.
Was leisten Tools für LLM Observability?
Sie dokumentieren den Ablauf einer Anwendung mit großen Sprachmodellen, einschließlich Modellaufrufen, Tools, Informationsabfragen, Zeitverhalten, Nutzung und Ausgabeprüfungen. Ein nützliches Ergebnis ist ein erklärbarer fehlgeschlagener Lauf, aus dem sich eine Korrektur und ein wiederholbarer Release-Test ableiten lassen.
Wie hoch sind die Langfuse-Kosten?
Geprüft am 5. Oktober 2026: Hobby ist kostenlos, Core kostet $29/Monat, Pro $199/Monat und Enterprise $2,499/Monat. Das optionale Teams-Add-on für Pro kostet $300/Monat. Bei kostenpflichtigen Tarifen kommen Nutzungsgebühren für Traces, Observations und Scores hinzu. Die modellierte Arbeitslast von 610,000 Einheiten kostet im Core-Tarif $69.80.
Lässt sich Langfuse kostenlos nutzen?
Ja. Hobby enthält 50,000 Einheiten pro Monat, zwei Nutzer und 30 Tage Datenzugriff. Der MIT-lizenzierte Kern lässt sich auch ohne Softwarelizenzgebühr selbst betreiben; Infrastrukturkosten und Betrieb liegen dann in eigener Verantwortung. Für kommerzielle Enterprise-Funktionen gelten separate Bedingungen.
Welche Alternativen gibt es zu Langfuse?
LangSmith passt zur Weiterentwicklung mit LangChain oder LangGraph, Helicone zur Anfrageüberwachung am Gateway, Phoenix zu einem privaten Backend, Braintrust zu Datensätzen und evaluationsgestützten Releases und Datadog zu Agentenstörungen innerhalb einer bestehenden Betriebsumgebung. Vor einem Plattformwechsel müssen die tatsächliche Abrechnungseinheit und die nötige Aufbewahrung verglichen werden.
Kann Langfuse lokal betrieben werden?
Ja. Langfuse dokumentiert Docker-basierten Eigenbetrieb und stellt Installationsanleitungen für den MIT-lizenzierten Kern bereit. Ein lokaler Start liefert noch keine Produktionsbackups, Verfügbarkeit oder Verantwortung für Upgrades. Soll die Installation zum produktiven Tracing-Dienst werden, müssen diese Anforderungen festgelegt werden.
Die Checkliste für das Audit von KI-Geschäftsprozessen herunterladen, um Workflow, Verantwortlichen, Ergebnis und Kontrollpunkt festzulegen, bevor die Produktionswerkzeuge ausgeweitet werden.
- Zuletzt aktualisiert
- 5. Okt. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

OpenCode-Anleitung: Modelle anbinden, Aufgaben lösen, Kosten prüfen
OpenCode einrichten, vorhandene Modellzugänge nutzen und die erste Aufgabe im Repository lösen: mit Projektregeln, Plugins und klarer API-Kostenrechnung.4. Okt. 2026Build
Netlify Pricing 2026: Was die Tarife wirklich kosten
Netlify Pricing verständlich erklärt: Free, Personal und Pro im Vergleich, Credit-Verbrauch und Monatsbudgets für Websites, Next.js-Apps und Agenturen.4. Okt. 2026Build
Kundenportal erstellen mit Softr: Preise, Rollen und Grenzen
Kundenportal erstellen mit Softr: Welche Tarife, Datenquellen und Zugriffsregeln passen? Die Bewertung erklärt Preise, KI-Funktionen und wichtige Grenzen.4. Okt. 2026Build
OpenCode & Co.: Welche Alternative zu Claude Code lohnt sich 2026?
OpenCode, Codex CLI, Pi und Gemini CLI im Vergleich mit Claude Code: Modellkosten, Abolimits und Wechselaufwand zeigen, wann sich ein Umstieg lohnt.4. Okt. 2026Build
MCP Server zentral verwalten: Wann sich ein Gateway lohnt
MCP Server zentral verwalten: Wann ein Gateway sinnvoll ist, was Cloudflare, Docker und Lasso leisten und welche Betriebs- und Lizenzkosten anfallen.4. Okt. 2026Build
OpenAI Pricing 2026: Mit GPT-6.1 Sol das API-Budget planen
OpenAI-API-Kosten für GPT-6.1 Sol, Luna und Astra: drei Monatsbudgets mit Tokenpreisen, Suche, Containern sowie Sprach- und Bildverarbeitung.3. Okt. 2026Build
Pi Coding Agent einrichten: in 28 Minuten zum ersten Test
Pi 1.0 installieren, den vorhandenen Modellzugang verbinden und die erste Aufgabe abschließen: mit AGENTS.md, Preismodell und klar benannten Grenzen.3. Okt. 2026Build