Claude Code MCP: como ajustar o timeout de inicialização
Aprenda a definir o tempo de espera inicial do Claude Code MCP, separar os quatro limites e impedir que automações prossigam sem servidores essenciais.


Defina CLAUDE_CODE_MCP_STARTUP_WAIT_MS como o número máximo de milissegundos que um job do Claude Code MCP pode aguardar pelos servidores MCP antes da primeira interação não interativa. Use 0 para pular essa espera. Assim, jobs agendados ganham um limite claro de prontidão, mas isso não define o timeout de conexão com o MCP, o timeout das ferramentas MCP nem o prazo do job inteiro.
Resposta em uma linha
Use CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check" para permitir até cinco segundos de espera pela inicialização do MCP na primeira interação. Use CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0 quando o job puder começar sem que nenhum servidor MCP esteja pronto.
O Claude Code 2.1.274 introduziu essa variável em 17 de setembro de 2026. A nota de versão define com precisão dois pontos: o valor limita, em milissegundos, a espera da primeira interação não interativa, e 0 significa não esperar. A nota não informa um valor padrão para a nova variável. Defina-o explicitamente em jobs sem supervisão para que uma futura mudança no padrão ou no ambiente da máquina não altere silenciosamente sua política de inicialização.
Uma execução não interativa é iniciada com -p ou --print, como em uma verificação de CI, um job cron ou uma tarefa acionada por SDK. Sessões interativas no terminal não são o alvo dessa opção.
A regra prática é simples:
Essas faixas são recomendações operacionais, não valores padrão da Anthropic. Meça seus próprios servidores antes de padronizá-las.
O que a espera inicial do Claude Code MCP realmente controla
Pense na primeira interação como a partida de um trem e em cada servidor MCP como uma plataforma de conexão. CLAUDE_CODE_MCP_STARTUP_WAIT_MS decide por quanto tempo o trem fica na estação aguardando os passageiros das conexões. A variável não determina por quanto tempo cada passageiro pode continuar tentando chegar à estação, quanto dura o trabalho depois do embarque nem quando a viagem inteira precisa terminar.
Esse escopo estreito é justamente o objetivo. Antes da versão 2.1.274, era comum recorrer a MCP_TIMEOUT, mas essa variável controla outro relógio. Agora, um job agendado pode adotar uma janela curta de prontidão para a primeira interação sem fingir que toda conexão com servidor ou chamada posterior de ferramenta deve seguir o mesmo prazo.
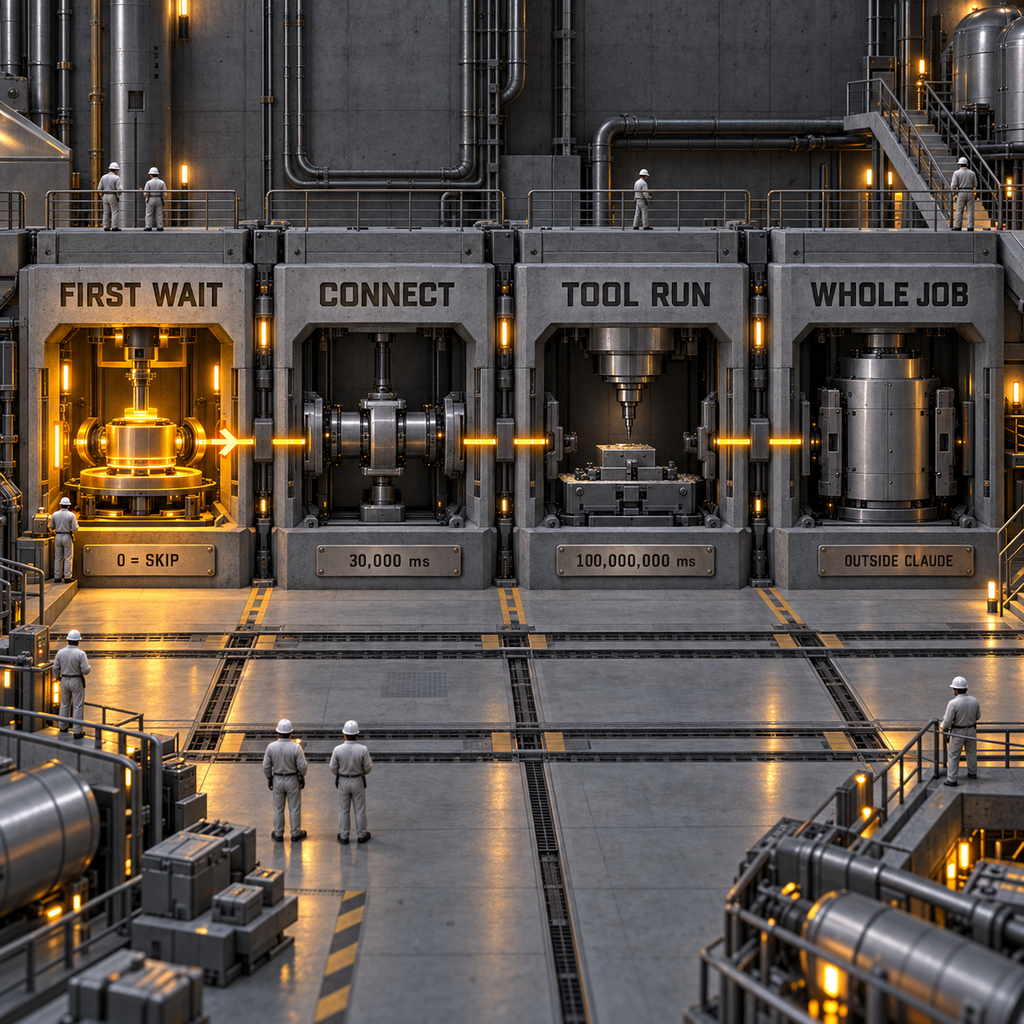
Quatro relógios para quatro decisões de falha
A configuração mais segura dá um nome e uma única função a cada relógio.
Há também MCP_CONNECT_TIMEOUT_MS, cujo padrão é 5,000 ms para um lote bloqueante de conexões na inicialização. Ele vale para comportamentos bloqueantes no início, como MCP_CONNECTION_NONBLOCKING=0, ou para um servidor marcado com alwaysLoad: true. A referência de variáveis de ambiente da Anthropic o diferencia explicitamente de MCP_TIMEOUT.
Nas chamadas de ferramenta, um campo timeout definido para um servidor em .mcp.json substitui MCP_TOOL_TIMEOUT naquele servidor. Isso é útil quando uma consulta ao data warehouse precisa, de forma justificável, de mais tempo que uma busca de ticket. Ainda assim, essa configuração não altera a nova espera da primeira interação.
Essa distinção também explica por que 0 não é um acelerador universal. Com a busca de ferramentas ativada, se o prompt precisar mais tarde de um servidor que ainda está se conectando, o Claude Code aguardará dentro de ToolSearch. Com a busca desativada, ele usa WaitForMcpServers. Pular a espera logo na entrada pode apenas empurrá-la para uma etapa posterior do job.
Um teste executável com servidor lento
Você pode reproduzir esse limite com um servidor stdio local que atrasa somente a resposta de inicialização do MCP. Salve o código abaixo como slow-mcp.mjs:
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
Aponte o Claude Code para ele com slow-mcp.json:
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
Execute CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose.
A opção --strict-mcp-config impede que servidores não relacionados, configurados no usuário ou no projeto, entrem no teste. O formato de stream expõe logo no início o evento system/init, inclusive o nome e o status de cada servidor MCP. Ele também mostra mcp_server_errors quando uma configuração fornecida é inválida.
O que a verificação local mostrou
Uma verificação de inicialização antes da autenticação no Claude Code 2.1.274 usou esse servidor de 5,000 ms. Como o ambiente não estava autenticado, a execução parou na etapa de login. A medição cobre somente a inicialização, exatamente o limite analisado neste teste.
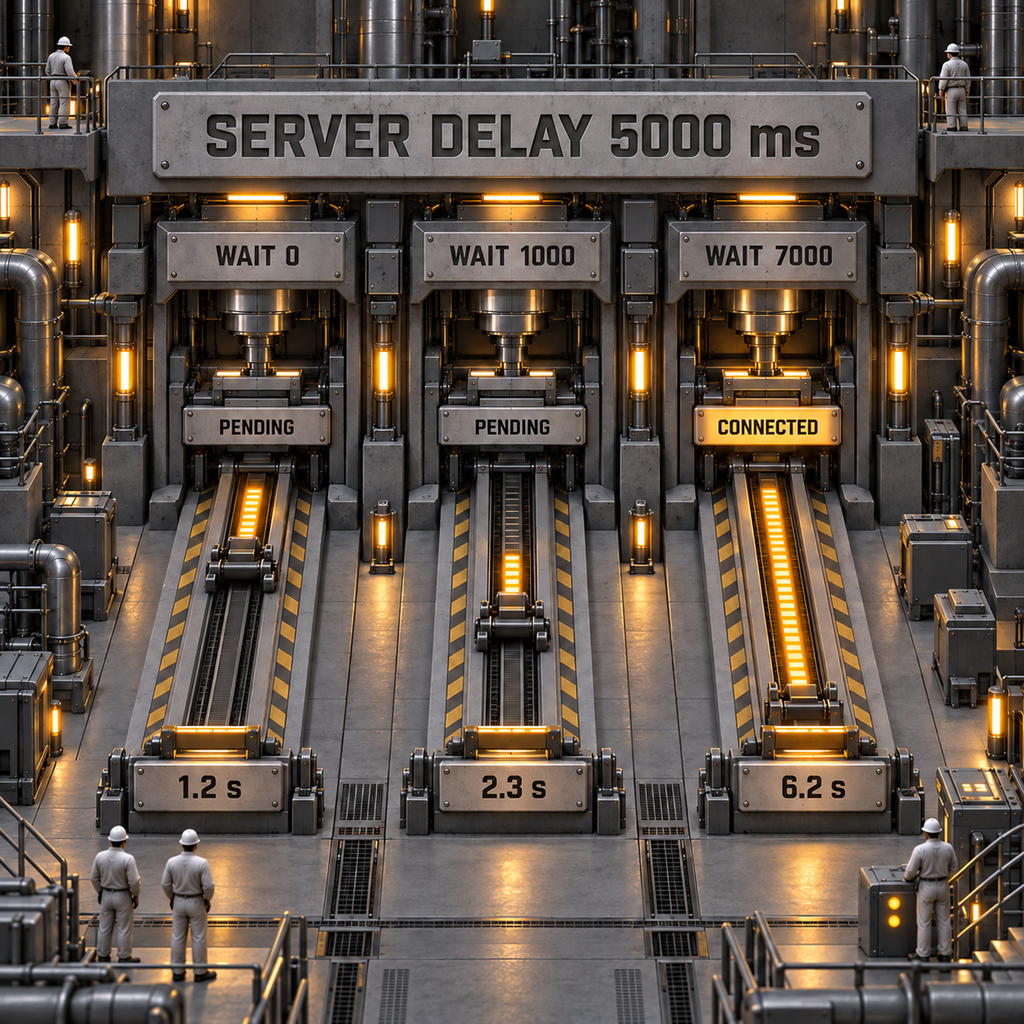
Os tempos decorridos incluem a inicialização do Claude Code e do npx, portanto não devem ser copiados para um objetivo de serviço. O resultado útil é categórico: 0 e 1,000 ms liberaram o gate da primeira interação enquanto o servidor estava pendente, e 7,000 ms permitiram que o mesmo servidor aparecesse como conectado. Nada aqui mede a latência do modelo nem a duração total do job.
Torne a prontidão explícita antes do trabalho de negócio
Um timeout responde apenas: “Por quanto tempo vamos esperar?”. Um job de produção também precisa responder: “Quais ferramentas são obrigatórias?”.
Use um gate em duas partes:
- Antes de iniciar a tarefa de negócio, verifique a saúde de cada endpoint remoto ou comando de servidor local obrigatório. Para servidores configurados e aprovados,
claude mcp listinforma estados como conectado, autenticação necessária ou falha de conexão. - No stream do Claude Code, examine
system/init.mcp_servers. Exija que o servidor indicado tenhastatus: "connected"e rejeite uma entrada não vazia emmcp_server_errorspara esse servidor. Trate servidores em cache ou opcionais conforme uma allowlist explícita.
Se o servidor obrigatório estiver pendente, encerre a execução antes de aceitar qualquer resultado de negócio. Se for opcional, registre o modo degradado e prossiga. Assim, a configuração de espera vira uma entrada da política, não a política inteira.
O cache de descoberta merece atenção especial. Um servidor remoto com uma lista de ferramentas em cache pode aparecer como pendente na inicialização e se conectar na primeira chamada de ferramenta. Esse comportamento ajuda com ferramentas opcionais, mas não cumpre uma promessa rígida de prontidão. O gate de uma ferramenta obrigatória deve exigir uma conexão ativa ou executar sua própria verificação de saúde.
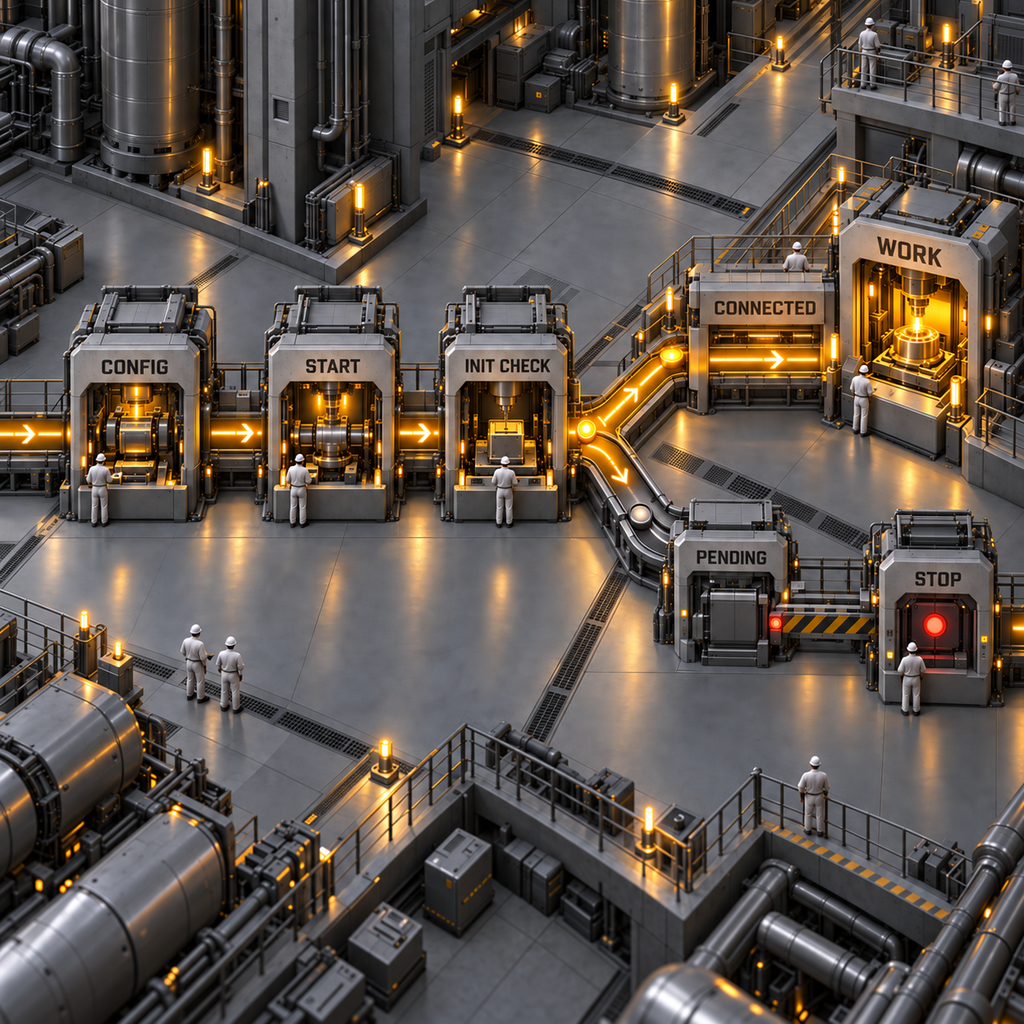
Por fim, aplique ao processo completo um prazo definido no agendador. A espera de inicialização não impede que uma solicitação ao modelo, um comando Bash, um hook ou uma chamada posterior de ferramenta MCP consuma o restante da janela de execução.
A conta de negócio depende principalmente da velocidade da falha
A economia de computação é real, mas fácil de superestimar. Suponha que 10,000 jobs mensais normalmente esperassem 30 segundos inteiros e que você definisse um orçamento de 3 segundos para a primeira interação. A capacidade máxima recuperada seria de 4,500 minutos de runner.
Hoje, o GitHub lista um runner Linux hospedado padrão, com 2 núcleos, a $0.006 por minuto e um runner macOS a $0.062 por minuto. Nessas tarifas, 4,500 minutos representam $27 de tempo em Linux ou $279 de tempo em macOS antes dos minutos incluídos. O GitHub também arredonda o uso de cada job para o minuto inteiro seguinte; por isso, uma redução de 27 segundos talvez nem altere a cobrança caso a duração total permaneça na mesma faixa de faturamento.
O ganho operacional é maior. Um job que reprova na verificação de prontidão em três segundos ainda dá tempo para o agendador tentar novamente, alertar o responsável certo ou acionar um fallback. Já um job que começa silenciosamente sem o banco de dados ou o rastreador de problemas pode gerar um resultado convincente, porém incompleto — e detectar e desfazer esse erro custa mais do que o tempo de runner.
Se você também precisa controlar respostas extensas, o guia de limites de saída de ferramentas do Claude Code aborda essa outra parte do fluxo. Para instalações sem supervisão e políticas de rede, combine esse gate de prontidão com o acesso à rede por comando.
Sete fluxos de trabalho que mais se beneficiam
1. Relatórios financeiros e operacionais agendados
Um profissional de finanças executa às 6 a.m. um relatório que depende de um servidor MCP do data warehouse. Marque esse servidor como obrigatório, acrescente uma pequena margem ao cold start medido e pare se ele não estiver conectado. O ganho não é apenas uma execução mais rápida: isso evita um relatório impecável criado com arquivos do repositório enquanto os números em tempo real estavam indisponíveis.
2. Verificações automáticas de risco em pull requests
Uma equipe de plataforma executa o Claude Code em cada pull request de alto risco e espera usar ferramentas do GitHub, de um rastreador de problemas e de um scanner de segurança. O gate pode tornar obrigatórios o scanner e o GitHub, mantendo o rastreador como opcional. Assim, os desenvolvedores recebem uma falha rápida e explicável em vez de uma revisão que omitiu silenciosamente a evidência mais importante.
3. Jobs de coordenação de releases
Um gerente de releases usa um agente agendado para comparar o trabalho já integrado, os incidentes em aberto e o status da implantação. Cada fonte pode ter uma regra de prontidão própria. Se o servidor MCP de implantação estiver fora do ar, o job para antes de redigir notas que deem a entender que a release é segura.
4. Triagem noturna de suporte
Uma equipe de suporte deixa um job agrupar tickets, consultar o histórico das contas e rascunhar respostas. Os servidores de help desk e de dados dos clientes são obrigatórios; o Slack pode ser opcional. Uma espera limitada mantém a fila andando, enquanto a regra de prontidão evita que o contexto privado do cliente seja presumido quando uma fonte está ausente.
5. Assistentes de resposta a incidentes
Ao receber um alerta, o engenheiro de plantão inicia uma execução de diagnóstico não interativa. Um orçamento curto de inicialização revela se logs e métricas estão realmente acessíveis. Se qualquer um dos servidores obrigatórios estiver indisponível, o wrapper pode encaminhar imediatamente para o runbook manual, em vez de gastar a janela do incidente com um diagnóstico parcial.
6. Runners efêmeros com escalonamento automático
Uma equipe inicia contêineres novos para cada job do agente. Servidores stdio locais podem arcar com o custo de cold start para carregar pacotes, auxiliares de autenticação ou descoberta de esquema. Medir essas inicializações separa um orçamento honesto de prontidão de sete segundos de uma solução improvisada permanente para um servidor problemático.
7. Produtos de agentes multi-tenant
Um produto atende clientes com conexões MCP diferentes. Um tenant pode exigir Salesforce, outro Linear, e um terceiro não usar nenhuma ferramenta externa. Uma lista de servidores obrigatórios por execução permite que a mesma camada de orquestração escolha uma espera curta para cada tenant sem transformar a integração mais lenta no padrão de todos.
Três produtos que vale a pena construir
1. Gate de prontidão MCP para CI com Claude Code
Esta é a oportunidade mais forte. O produto seria um pequeno wrapper de runner que lê a política de servidores obrigatórios, inicia o Claude Code com uma espera explícita, registra system/init e retorna uma falha de prontidão legível por máquina antes de aceitar o resultado do agente.
A demanda é restrita, mas relevante comercialmente: claude code automation registra cerca de 140 buscas mensais nos EUA, crescimento anual de 200% nos dados de sugestões e CPC de $10.88. As pessoas também perguntam como fazer o Claude Code executar automaticamente e como configurar o Claude Code com MCP. São manifestações diretas do problema de configuração.
A menor versão vendável é uma CLI com arquivo de política, anotações no GitHub Actions e evidências em JSON para cada execução. O desafio é a distribuição. A Anthropic pode adicionar políticas nativas de prontidão mais completas, então o valor duradouro precisa estar no histórico entre execuções, nos alertas e no suporte a vários runtimes de agentes.
2. Linter de políticas de timeout
Essa ferramenta examinaria scripts shell, arquivos de CI, configurações e .mcp.json para sinalizar relógios incompatíveis: espera de inicialização igual a zero com ferramentas obrigatórias, prazo curto para o job combinado a um timeout de ferramenta de 28 horas ou integração opcional sem limite.
O termo exato mcp server timeout tem cerca de 10 buscas mensais nos EUA e tendência anual informada de -67%. Uma busca relacionada é MCP_TOOL_TIMEOUT, e as pessoas perguntam como aumentar o timeout do Claude Code. Há demanda suficiente para um recurso dentro do gate de prontidão, mas não para uma empresa independente.
Um MVP precisa de parsers para GitHub Actions, sintaxe comum de shell e configuração MCP do Claude Code, além de correções opinativas. O risco é transmitir falsa segurança: uma configuração estática não conhece a distribuição real do cold start de um servidor sem medições em execução.
3. Telemetria de inicialização para agentes agendados
Esse produto transformaria eventos system/init em uma linha do tempo de latência de conexão, estados pendentes, configurações inválidas e execuções degradadas. Equipes de plataforma pagariam por tendências e alertas em vários repositórios, em vez de ler arquivos JSONL manualmente.
Ele compartilha as 140 buscas mensais por claude code automation, enquanto claude code browser automation acrescenta outras 40 e também registra crescimento anual de 200% nos dados de sugestões. O sinal mais amplo é a adoção do Claude Code em jobs repetíveis, nos quais as evidências de inicialização se tornam um problema operacional.
O MVP é um coletor de eventos, um mapa de servidores obrigatórios e opcionais e alertas quando a prontidão ultrapassa um objetivo de serviço. O desafio é a sensibilidade dos dados. Nomes de MCP e metadados de ferramentas podem revelar sistemas internos; portanto, redação de dados e self-hosting fazem parte do produto, não são um acabamento corporativo para depois.
Limites e uma avaliação realista
Esse controle resolve uma parte pequena, mas valiosa, da automação confiável. Ele não conserta um servidor MCP com defeito, não autentica um conector expirado, não encurta uma chamada posterior de ferramenta e não interrompe todo o processo do Claude Code.
Não use 0 em um job cuja primeira ação útil depende de MCP. A inicialização pode mostrar pending, e a espera talvez reapareça quando a ferramenta for pesquisada. Também não aumente o valor até servidores instáveis parecerem saudáveis. Servidores HTTP e SSE tentam novamente após falhas transitórias na primeira conexão, mas erros de autenticação e recurso não encontrado exigem mudanças na configuração. Uma espera maior apenas adia essa constatação.
Servidores stdio também não se reconectam automaticamente depois de uma queda no meio da sessão. Uma janela generosa de inicialização não diz nada sobre a saúde deles dez minutos depois.
A melhor política é rígida e sem surpresas: uma espera curta e explícita na primeira interação, servidores obrigatórios nomeados, um gate de status, um timeout separado para ferramentas e um prazo externo para o job. Esse conjunto produz falhas úteis em vez de atrasos misteriosos.
Como aumentar o timeout do Claude Code?
Escolha o timeout correspondente à etapa lenta. Use CLAUDE_CODE_MCP_STARTUP_WAIT_MS para a espera de prontidão do MCP na primeira interação não interativa, MCP_TIMEOUT para a inicialização do servidor, MCP_TOOL_TIMEOUT ou um timeout por servidor para executar ferramentas e o limite do próprio runner para o job inteiro.
Como executar o Claude Code automaticamente?
Execute o Claude Code de forma não interativa com -p ou --print, defina o comportamento das permissões para ferramentas sem supervisão, estabeleça um prazo externo no agendador e torne explícita a prontidão do MCP. Só a espera de inicialização não torna um job automatizado seguro.
Por que o Claude Code continua atingindo o timeout?
Primeiro, identifique a etapa nos logs. Um atraso antes de system/init aponta para a inicialização ou a prontidão da conexão. Uma falha durante uma chamada de ferramenta MCP indica limites de ferramenta, inatividade ou solicitação de rede. Um processo encerrado pelo CI aponta para o prazo externo do job.
Como configurar o Claude Code com MCP?
Adicione a configuração MCP ao projeto ou ao usuário, ou forneça um arquivo com --mcp-config. Em jobs repetíveis, acrescente --strict-mcp-config, defina uma espera explícita para a primeira interação e verifique os servidores obrigatórios em system/init, em vez de supor que “configurado” significa “conectado”.
Na segunda-feira, escolha um job agendado do Claude Code, meça o cold start dos servidores MCP obrigatórios, defina a menor espera que reflita a realidade e faça um servidor obrigatório pendente reprovar antes que o resultado seja aceito. Se quiser implementar essa camada de confiabilidade em seus fluxos de agentes, posso ajudar com o sistema de produção.
- Última atualização
- 17 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Cloudflare: como bloquear treinamento de IA sem prejudicar a busca
Configure o Cloudflare para bloquear treinamento de IA sem perder indexação. Veja o ajuste correto, valide o robots.txt e evite bloquear Googlebot e Bingbot.16 de set. de 2026Build
Digitação por voz com Murmure: análise do app offline
Testei o Murmure para digitação por voz offline, com dicionário, regras e LLM opcional. Veja onde ele acerta, quais limites pesam e para quem serve.14 de set. de 2026Build
FFmpeg API da RenderIO: preços, créditos e limites
FFmpeg API da RenderIO: veja preços, cobrança por créditos, limites técnicos e quando compensa migrar entre os planos Starter, Growth e Business.14 de set. de 2026Build
Transcrição de voz com Dictare: preço e custo real
Veja quanto custa o Dictare, o que a transcrição de voz local inclui e quais despesas com agente, máquina e manutenção entram no custo real.13 de set. de 2026Build
Como testar plugins do Claude Code e medir sua contribuição
Veja como testar plugins do Claude Code com evals nativos, comparar resultados com um controle sem plugin e limitar custos antes de levar o teste ao CI.12 de set. de 2026Build
IA de voz no Cloudflare: encontre a origem da latência
Aprenda a usar o turnmetrics do Cloudflare para localizar atrasos, silêncios e falhas em cada etapa de um agente de IA de voz antes de trocar fornecedores.12 de set. de 2026Build
Como colocar legenda em vídeo com SRT usando o Rendi
Veja como colocar legenda em vídeo com um arquivo SRT e a API do Rendi, do envio ao controle de qualidade do MP4, sem manter o FFmpeg na sua infraestrutura.11 de set. de 2026Build