Claude Sonnet 5 em análise: preço real, Opus e tokenizer
Claude Sonnet 5 entrega desempenho próximo ao Opus 4.8 por menos, mas o novo tokenizer eleva o consumo de tokens. Veja preços, vantagens e limites.

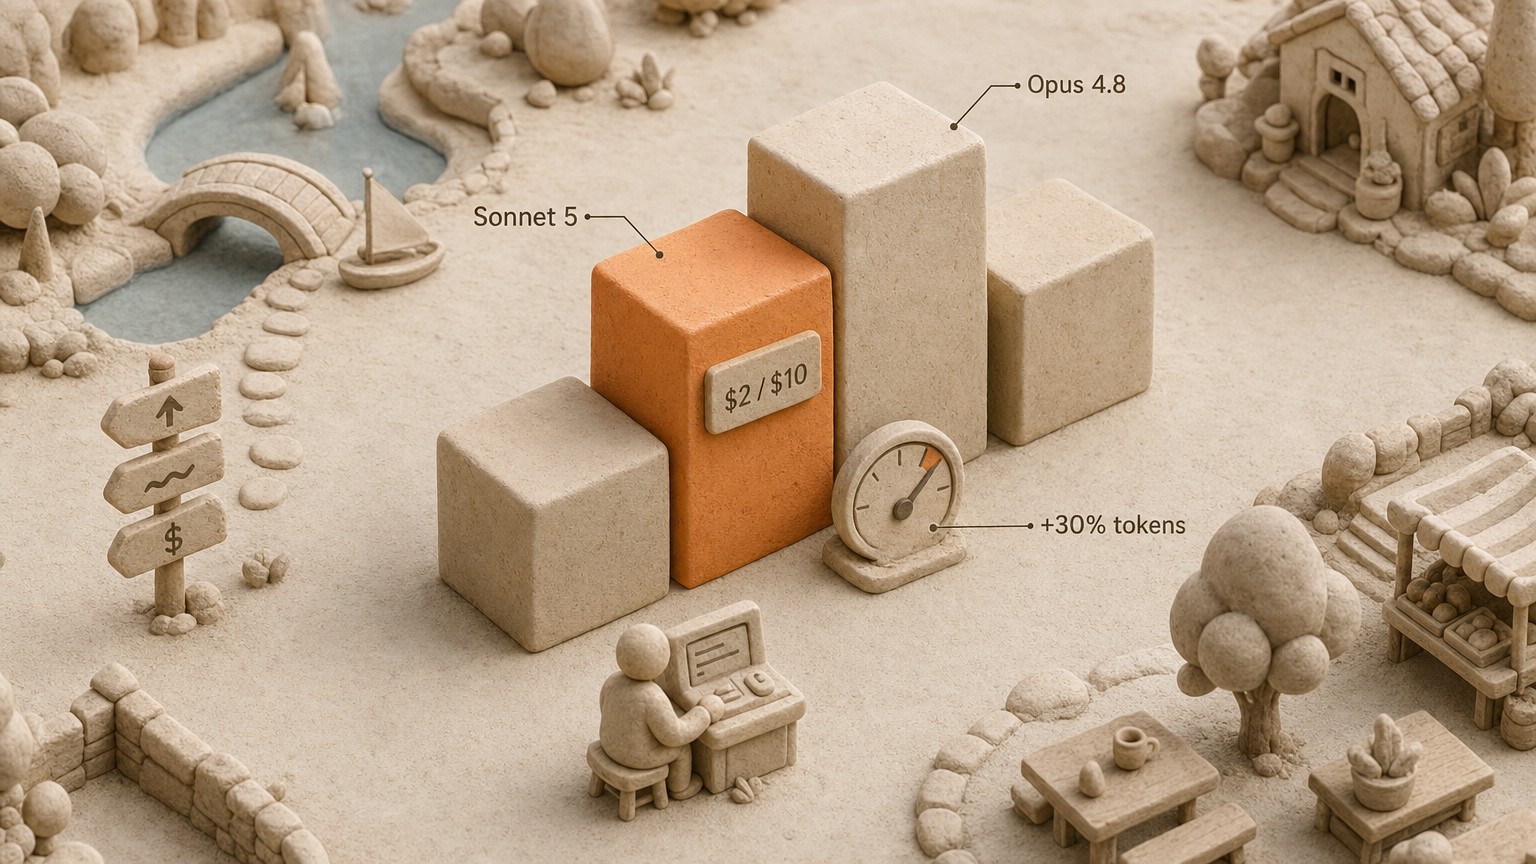
O Claude Sonnet 5 agora é o modelo padrão de todas as contas Free e Pro, chega perto do Opus 4.8 em tarefas com agentes e custa oficialmente $2 por milhão de tokens de entrada até 31 de agosto. O detalhe que não aparece na página de preços: com o novo tokenizer, o mesmo trabalho consome cerca de 30% mais tokens do que no Sonnet 4.6. Na prática, a conta fica mais alta do que o preço anunciado sugere.
Veredito em uma frase
Adote o Sonnet 5 para agentes, programação e automações que usam muitas ferramentas — mas inclua a mudança de tokenizer no cálculo antes de concluir que ele ficou mais barato.
A Anthropic lançou o Sonnet 5 em 30 de junho de 2026 como o modelo Sonnet mais preparado para operar de forma agêntica até agora. Ele planeja trabalhos com várias etapas, controla ferramentas como navegadores e terminais e conclui tarefas nas quais versões anteriores do Sonnet costumavam travar. Na API e no Claude Code, o padrão é effort=high; nessa configuração, o modelo se aproxima do Opus 4.8 em algumas tarefas, embora custe uma fração do preço. Para quem já trabalha no Claude Code ou desenvolve agentes, esta passa a ser a escolha padrão mais sensata.
O motivo para não migrar às pressas é financeiro, não técnico. O preço de lançamento parece um corte, porém o novo tokenizer contabiliza aproximadamente 30% mais tokens para o mesmo texto. Além disso, três mudanças incompatíveis na API podem fazer suas requisições retornarem erro 400 se a migração for feita sem os ajustes necessários. Os dois pontos estão detalhados a seguir.
O que realmente mudou desde o Sonnet 4.6
O Sonnet 5 funciona como uma atualização direta do Sonnet 4.6: abre mão de um pouco do controle manual em troca de muito mais autonomia.
O principal avanço está na capacidade de levar tarefas agênticas até o fim. Segundo a própria Anthropic, os saltos mais claros de capacidade vinham acontecendo nos modelos da categoria Opus. O Sonnet 5 reduz essa distância: seu desempenho fica próximo ao do Opus 4.8 por um preço menor e oferece uma faixa muito mais ampla de opções de custo e velocidade do que o Sonnet 4.6. Em comparação com o 4.6, há melhorias em raciocínio, uso de ferramentas, programação e trabalho intelectual. Parceiros com acesso antecipado relataram que ele conclui tarefas de software com várias etapas e confere o próprio resultado sem receber essa instrução. Nos benchmarks destacados pela Anthropic — busca agêntica (BrowseComp) e uso do computador (OSWorld-Verified) —, há uma evolução inequívoca em relação ao 4.6; com maior nível de esforço, o modelo chega a igualar o Opus 4.8 em algumas tarefas. De acordo com o relatório de segurança da Anthropic, ele também apresenta menos comportamentos indesejáveis do que o 4.6 e é consideravelmente menos capaz em tarefas de cibersegurança do que os modelos Opus atuais — característica que, para a maioria dos usos empresariais, é uma vantagem, não uma perda.
A mudança de comportamento mais útil é simples: o pensamento adaptativo vem ativado por padrão. No Sonnet 4.6, uma requisição sem o campo thinking era executada sem raciocínio. No Sonnet 5, essa mesma requisição passa a raciocinar de forma adaptativa. A qualidade melhora sem configuração adicional, mas, como max_tokens limita a soma do raciocínio e do texto da resposta, um teto de saída calibrado para o 4.6 agora pode cortar a parte visível da resposta. Revise max_tokens em toda carga de trabalho que antes rodava sem raciocínio.
:::callout{variant="note" title="Em termos simples: o que significa "agêntico" aqui"}
Um modelo agêntico não se limita a responder: ele age. Divide um objetivo em etapas, aciona ferramentas — navegador, terminal ou API —, lê os resultados e continua até concluir o trabalho. Ser “mais agêntico” significa travar com menos frequência no meio de uma tarefa composta por várias etapas. É justamente o tipo de trabalho que antes exigia um modelo maior e mais caro.
:::
O preço real: toda a linha Claude 5
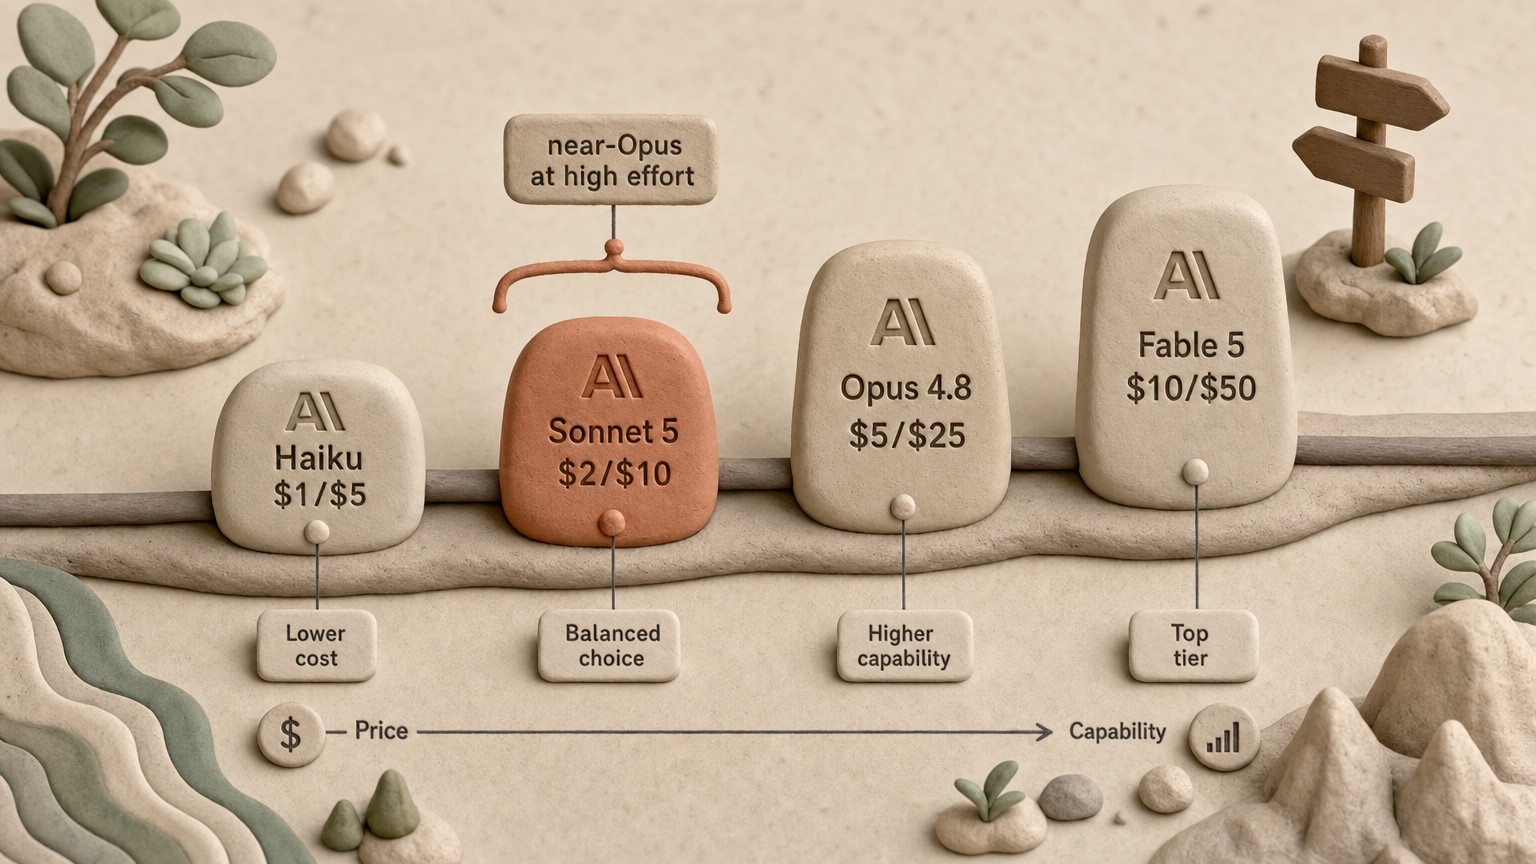
O preço inicial do Sonnet 5 é de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída até 31 de agosto de 2026. Depois, passa para $3 na entrada e $15 na saída. Veja como ele se posiciona diante dos demais modelos da família com os valores atuais:
Quando a comparação é feita por proporção, a decisão fica simples. Durante o preço de lançamento, o Sonnet 5 custa 40% do valor do Opus 4.8 por token; mesmo após agosto, com o preço padrão, custa 60% do Opus. Na outra direção, seu preço padrão é 3x o do Haiku 4.5, cuja janela de contexto chega a 200k, contra 1M no Sonnet 5. O Sonnet 5 foi projetado para ocupar o meio da linha: é mais barato do que o Opus, claramente mais capaz do que o Haiku e mantém a mesma janela de contexto de 1M e o mesmo limite de saída de 128k dos modelos de ponta.
Uma especificação discreta faz diferença em trabalhos longos: o Sonnet 5 mantém 1M tokens de contexto tanto como padrão quanto como máximo — não existe uma variante com contexto menor — e pode chegar a 300k tokens de saída na Batch API com o cabeçalho beta output-300k-2026-03-24. Em comparação com a categoria Opus, ele perde o acesso ao Priority Tier, que não é oferecido no Sonnet 5.
A taxa escondida do tokenizer
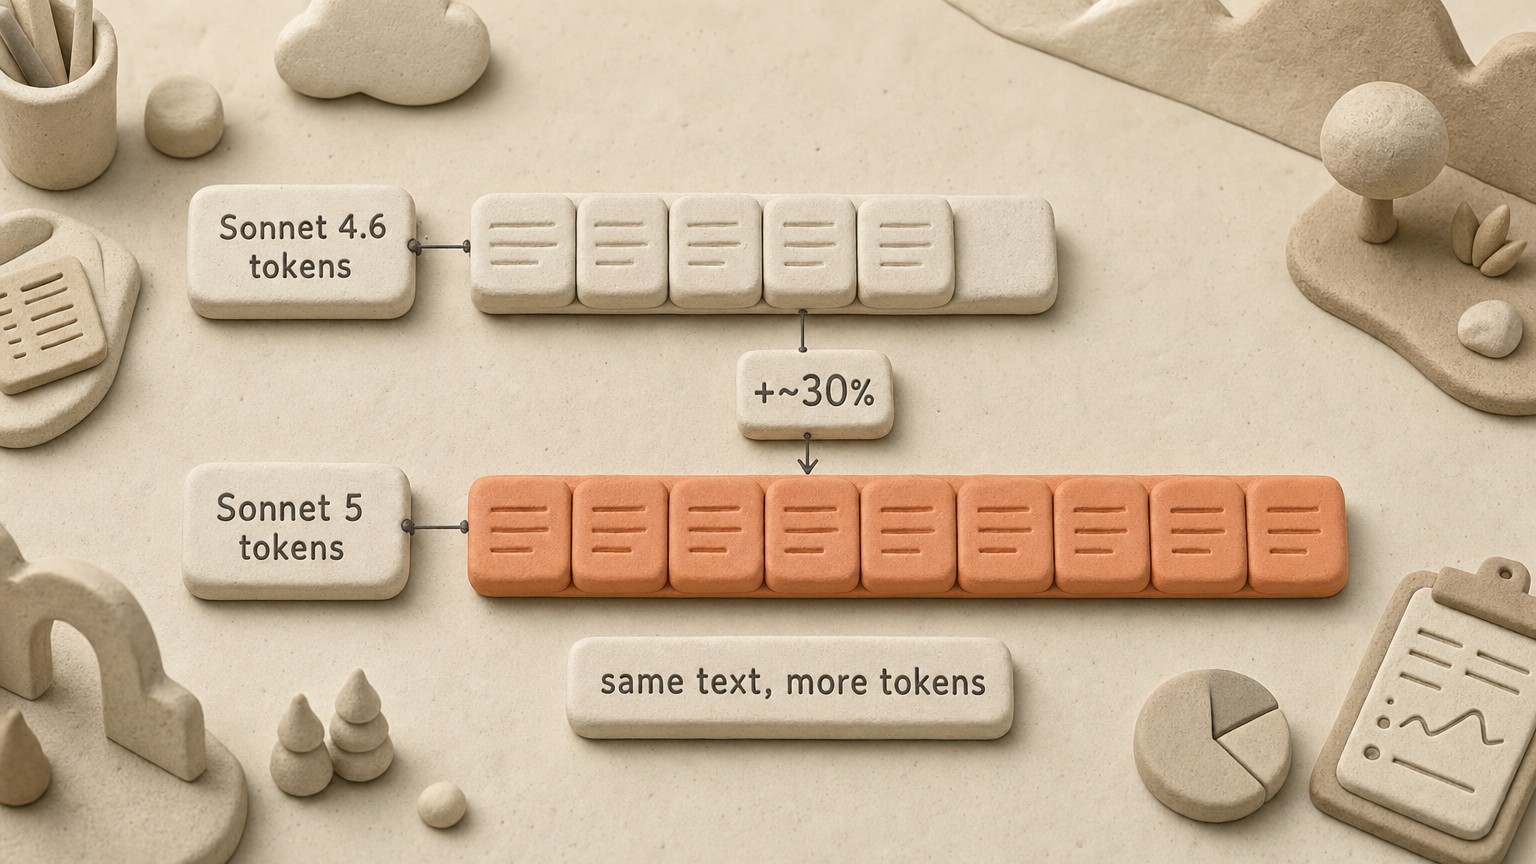
O preço de tabela caiu, mas o custo efetivo por unidade de trabalho não caiu na mesma proporção. Isso acontece porque o Sonnet 5 estreia um tokenizer que transforma o mesmo texto em cerca de 30% mais tokens do que o Sonnet 4.6.
O tokenizer é a parte do modelo que divide o texto nas unidades cobradas, chamadas tokens. O componente usado pelo Sonnet 5 é diferente do que equipava o 4.6, e a Anthropic afirma claramente que o mesmo texto de entrada gera aproximadamente 30% mais tokens — o número exato varia conforme o conteúdo. O preço unitário não mudou. No entanto, como a cobrança é feita por token, uma requisição que somava 10,000 tokens no 4.6 passa a totalizar cerca de 13,000 no novo modelo; antes mesmo de considerar a mudança de preço, um trabalho equivalente custa por volta de 30% mais. Isso também reduz a quantidade real de texto que cabe na janela de contexto de 1M e pode fazer um limite de max_tokens dimensionado para a saída do 4.6 interromper a resposta antes do fim.
A regra prática é: pare de reutilizar contagens de tokens medidas em modelos anteriores e faça uma nova medição no Sonnet 5. Se suas projeções de custo, orçamentos por requisição ou regras para preencher o contexto foram calculados com números do 4.6, agora estão otimistas demais. O mesmo padrão já havia atingido a linha Opus, como expliquei na análise da mudança de tokenizer do Opus 4.7. A correção também é a mesma: conte novamente e só então decida.
Nada disso torna o Sonnet 5 caro. Com o preço de lançamento, ele continua bem abaixo do Opus para uma qualidade de saída comparável. A comparação honesta é “preço anunciado de $2, menos um ganho real de capacidade, mais uma sobrecarga de tokens de ~30%” — e não simplesmente “ficou barato”. Faça as contas com sua própria carga de trabalho antes de contar com qualquer economia.
Três mudanças incompatíveis antes de fazer a troca
A migração do 4.6 é quase toda simples, mas três tipos de requisição que funcionavam até ontem agora retornam erro 400. Resolva esses pontos primeiro; caso contrário, o loop do seu agente será interrompido já na primeira chamada.
Remova os parâmetros de amostragem
Definir
temperature,top_poutop_kcom um valor diferente do padrão faz o Sonnet 5 retornar erro 400. Remova esses parâmetros da requisição; o valor padrão — ou a ausência do parâmetro — é aceito. Para orientar o comportamento, transfira essas instruções para o prompt do sistema. A restrição é nova na categoria Sonnet, embora já se aplicasse ao Opus 4.7.Abandone o pensamento estendido manual
O formato antigo
thinking: {type: "enabled", budget_tokens: N}foi removido e retorna erro 400. Use o pensamento adaptativo com o parâmetroeffort, assim como no Opus 4.8. Para desativar completamente o raciocínio, enviethinking: {type: "disabled"}.Revise max_tokens
Como o pensamento adaptativo vem habilitado por padrão e
max_tokenslimita a soma do raciocínio com a resposta, teste novamente todo teto definido com base no 4.6. As cargas de trabalho que antes funcionavam sem raciocínio são as mais propensas a sofrer cortes.
# Fails on Sonnet 5 (returns 400)
resp = client.messages.create(
    model="claude-sonnet-5",
    temperature=0.7,
    thinking={"type": "enabled", "budget_tokens": 32000},
    max_tokens=4000,
    messages=[...],
)

# Works: no sampling params, adaptive thinking, roomier max_tokens
resp = client.messages.create(
    model="claude-sonnet-5",
    thinking={"type": "adaptive"},
    max_tokens=8000,
    messages=[...],
)
Claude Sonnet 5 vs. Opus 4.8: quando o modelo mais barato é a melhor escolha
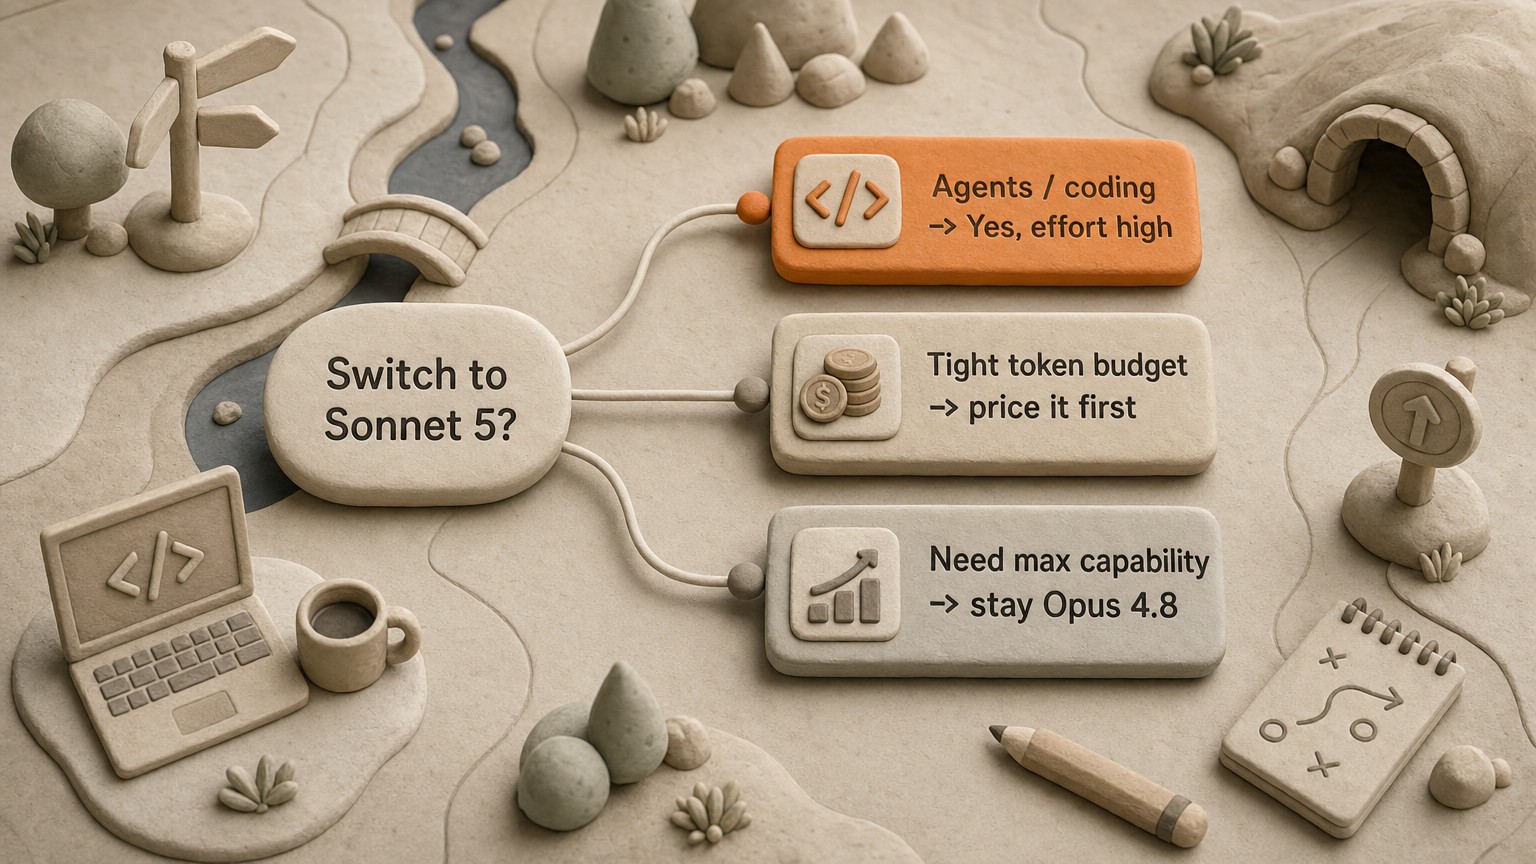
Para programação agêntica e automações que acionam ferramentas, o Sonnet 5 com effort=high deve ser o padrão. Suba para o Opus 4.8 apenas quando a tarefa realmente exigir o limite máximo de capacidade.
O principal argumento a favor do Sonnet 5 é o controle de esforço. Ele oferece os mesmos níveis medium/high/extra-high da categoria Opus, e as curvas de custo e desempenho publicadas pela Anthropic mostram um alcance muito maior do que no 4.6: boa eficiência no esforço médio e, nos níveis superiores, capacidade equivalente à do Opus 4.8 em algumas tarefas. Como o custo corresponde a 40% do Opus no preço de lançamento — e a 60% depois de agosto —, faz mais sentido começar pelo Sonnet 5 e encaminhar apenas tarefas difíceis específicas para o Opus do que pagar a tarifa do Opus em tudo.
Os motivos para permanecer no Opus 4.8 são restritos, mas legítimos: trabalhos em que o topo da curva de capacidade compensa o custo; as tarefas mais difíceis de programação agêntica; execuções autônomas longas nas quais uma única etapa malsucedida sai caro; ou qualquer cenário em que “iguala em algumas tarefas” não basta, porque justamente as tarefas importantes são aquelas em que ele não iguala. Quando trabalhos de produção são delegados sem supervisão e em grande escala, a diferença de preço pode custar menos do que uma única execução ruim do Sonnet.
A recepção sem filtro: por que parte dos usuários chama o modelo de retrocesso
A reação da comunidade ficou dividida, e fingir o contrário seria desonesto. Ao lado dos elogios de que o modelo “conclui tarefas que o 4.6 não conseguia”, tópicos públicos no r/ClaudeAI publicados neste mês trazem títulos diretos como “Sonnet 5 é um retrocesso”, além de uma sequência constante de perguntas como “vale mesmo a pena usar?” e “qual é o consenso?”. Vale reconhecer a distância entre o discurso da Anthropic — “próximo ao Opus 4.8” — e a experiência relatada por alguns usuários.
Dois fatores explicam boa parte dessa diferença. Primeiro, o pensamento adaptativo ativado por padrão muda o formato e a latência das respostas; fluxos ajustados para as respostas mais curtas e sem raciocínio do 4.6 podem parecer diferentes mesmo quando a qualidade aumenta. Segundo, a troca do tokenizer piora a aparência das comparações de custo até que as medições sejam refeitas: a primeira impressão é de um modelo “mais caro”, antes que se perceba que o tokenizer mudou. Nenhum dos dois pontos torna o modelo ruim; apenas mostra que uma atualização direta nunca é totalmente direta. Teste-o com seus prompts reais antes de confiar no veredito de qualquer pessoa — inclusive no meu.
Quem deve migrar agora e quem deve esperar
Você desenvolve agentes, entrega código com o Claude Code ou executa automações que usam muitas ferramentas. Com effort=high, o Sonnet 5 oferece uma capacidade de conclusão próxima à do Opus pelo preço do Sonnet. Migre, mas recalcule primeiro o orçamento de tokens.
O Claude Sonnet 5 já está disponível?
Sim. Ele foi lançado em 30 de junho de 2026 e é o modelo padrão dos planos Free e Pro. Também está disponível para usuários Max, Team e Enterprise, no Claude Code e na Claude API com o identificador claude-sonnet-5.
Quanto custa o Claude Sonnet 5?
O preço inicial da API é de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída até 31 de agosto de 2026; depois, sobe para $3 na entrada e $15 na saída. Isso equivale a 40% do preço do Opus 4.8 durante o período inicial e a 60% posteriormente. Vale lembrar que o novo tokenizer contabiliza cerca de 30% mais tokens para o mesmo texto do que o Sonnet 4.6.
O Sonnet 5 é realmente bom ou representa um retrocesso?
Ele é claramente superior ao Sonnet 4.6 em tarefas agênticas, programação e uso de ferramentas, e se aproxima do Opus 4.8 nos níveis mais altos de esforço. Alguns usuários relatam uma experiência pior, sobretudo porque o pensamento adaptativo agora vem ativado por padrão e a mudança de tokenizer faz os custos parecerem maiores até que sejam medidos novamente. Teste o modelo com seus próprios prompts.
O Claude Sonnet 5 é melhor que o GPT-5.6?
O vencedor varia conforme a tarefa. O ponto forte do Sonnet 5 é levar tarefas agênticas até o fim e usar ferramentas por um preço baixo. Consulte a análise do GPT-5.6 para conhecer o outro lado da comparação.
Vai migrar uma configuração de programação ou agentes e quer ajustar primeiro o que realmente importa? Baixe gratuitamente o checklist de configuração do Claude Code + Codex, com as etapas de configuração e controle de custos que valem a pena executar antes de trocar um modelo em produção, e receba cada nova análise de modelo assim que for publicada.
- Última atualização
- 3 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Nouswise vale a pena? Análise da IA para pesquisa com fontes
Analisamos em detalhes o Nouswise, uma IA para pesquisa com citações: preços, limites, riscos e o que validar antes de adotá-lo no lugar do NotebookLM.10 de set. de 2026AI
IA na construção civil: 5 ferramentas para revisar submittals
Veja quais ferramentas de IA na construção civil conferem submittals contra especificações, com fontes, controle de revisões, preços e testes.9 de set. de 2026AI
IA veterinária: VetGeni ou ScribbleVet — qual vale mais?
VetGeni ou ScribbleVet? Compare preços, limite de notas SOAP, integrações com PIMS, modelos e acesso da equipe antes de escolher a IA veterinária.9 de set. de 2026AI
IA para construção civil: o InspectMind vale a pena?
Veja como a IA para construção civil do InspectMind revisa projetos, quanto custa cada checagem e quais limites pesam antes de adotar a ferramenta.8 de set. de 2026AI
BuildSync ou SpecLens: qual software para construção civil escolher?
Compare BuildSync e SpecLens em submittals, integrações, arquivos, exportações e preços para escolher o software para construção civil ideal para sua obra.8 de set. de 2026AI
Melhores ferramentas de IA veterinária para prontuários de equinos
Compare 8 ferramentas de IA veterinária para prontuários de equinos, com gravação offline, separação por cavalo, preços e integração com PIMS.7 de set. de 2026AI
Claude ou ChatGPT em 2026: qual é a melhor IA para programar?
Claude ou ChatGPT em 2026? Compare código, escrita, imagens, preços e recursos para saber qual assinatura de $20 faz mais sentido para o seu trabalho.6 de set. de 2026AI